


LLM.int8() 完全拆解:系统离群值的涌现与混合精度分解,175B 模型的 8-bit 无损推理
背景:一张卡装不下 175B 的时代
2022 年是开源大模型的分水岭。Meta 放出了 OPT-175B,BigScience 放出了 BLOOM-176B——但绝大多数研究者只能在远处围观:175B 参数以 FP16 存储需要 350GB 显存,按当时最顶级的 A100 80GB 计算,仅权重就要 5 张卡,加上 KV Cache 与中间激活,实际部署需要整机 8 卡甚至跨机。350GB 这个数字对量化意味着什么?如果能把权重压到 8-bit,体积直接减半到 176GB 左右,8 张 24GB 的 RTX 3090(共 192GB)就能装下一个 175B 模型。这正是 LLM.int8() 论文想要撬动的门。
8-bit 量化在当时并不是新东西。卷积网络早就把 INT8 作为推理标准格式,小于 350M 参数的 Transformer 也已有多种 8-bit 量化方案。直觉上,量化 175B 模型只是把同样的事情做得更大:权重的分布没有变,误差是逐元素的,模型越大冗余越多,似乎没理由崩溃。但实验给出的答案非常反直觉——普通 8-bit 量化在参数规模超过 6.7B 时性能会突然崩盘,精度掉到接近随机猜测,而不是缓慢劣化。
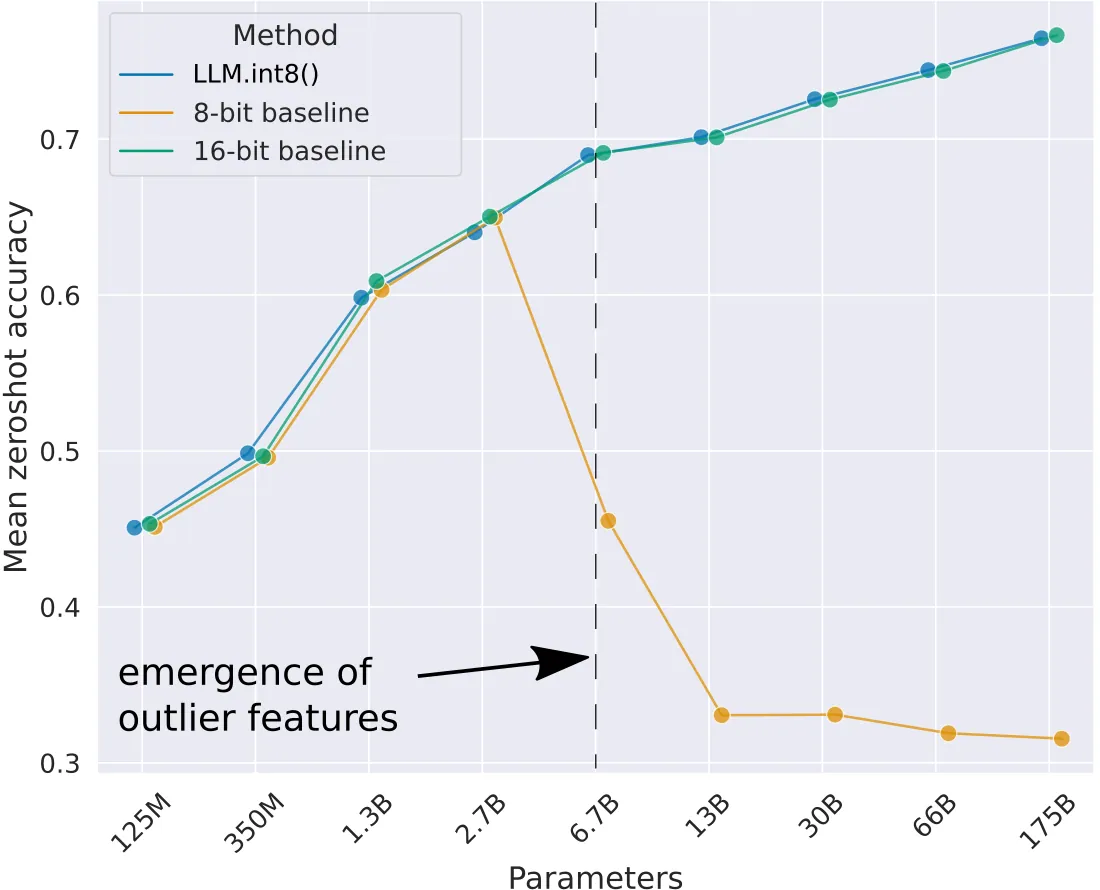
上图是论文 Figure 1:横轴是 OPT 系列模型规模(125M 到 175B),纵轴是 WinoGrande、HellaSwag、PIQA、LAMBADA 四个基准的平均零样本准确率(zero-shot accuracy)。三条曲线分别是 FP16 基线、此前最精确的 8-bit 量化方案(absmax vector-wise,即逐向量绝对最大值量化)、以及本文的 LLM.int8()。在 6.7B 之前,三条线几乎重叠;一旦越过 6.7B,常规 8-bit 方法的准确率断崖式下跌到随机水平,而 LLM.int8() 始终贴着 FP16 基线直到 175B。
LLM.int8() 由 Tim Dettmers(华盛顿大学)联合 Meta AI 的 Mike Lewis、Hugging Face 的 Younes Belkada 与华盛顿大学的 Luke Zettlemoyer 完成,2022 年 8 月发布在 arXiv(编号 2208.07339),同年 11 月发表于 NeurIPS 2022,代码随论文开源为 bitsandbytes 库并集成进 Hugging Face Transformers。它的核心贡献不只是”又一种量化方法”,而是首次在 6.7B 以上规模定位了量化失败的根因——系统涌现的激活离群值(emergent outlier features)——并给出了处理它们的机制。这一发现后来成为整个 LLM 量化领域的公共起点:站内拆解过的 SmoothQuant、AWQ、GPTQ 都以离群值叙事开场。本文从量化误差的数学讲起,完整拆解 LLM.int8() 的两件武器。
量化为什么会崩:一个尺度统治全局
要理解崩盘,先看 8-bit 量化本身。论文聚焦两种基础方案:对称的绝对最大值量化(absmax quantization)与非对称的零点量化(zero-point quantization)。
绝对最大值量化的操作对象是 FP16 输入 ( 为序列维, 为特征维),对它整体乘以一个缩放常数,线性映射到 的整数区间。对整张矩阵用一个缩放常数 ,其值为 127 除以全矩阵的绝对最大值,即矩阵的无穷范数 :
其中 表示四舍五入到最近整数,、 遍历矩阵的行与列, 是量化步长的倒数。反量化时乘回 即可。两个 INT8 矩阵乘完得到 INT32 累加结果 ,近似还原 FP16 结果需要除以两个缩放常数之积:
其中 、 分别是激活与权重的缩放常数(这里仍是 per-tensor 的单个标量)。整个流程的误差来源只有一个地方:量化步长是由全矩阵的最大值唯一决定的。如果矩阵里有一个元素是 100,其余 99.9% 的元素都在 以内,那么步长被拉到 ,幅值 1 的元素量化后只占约 1.3 个台阶,可分辨的信息粒度被压缩到不足 2 bit——绝大多数量化区间(bin)空置,小值被就近取整到同一个整数上,信息被直接抹平。
零点量化的思路:先把分布平移到以 0 为中心再缩放,让非对称分布(比如全为正的 ReLU 输出)也能用满 的全部区间。代价是每个张量多出一个零点偏移 (zero point),计算时先给每个 INT8 元素加上偏移再运算。CPU 上有 pmaddubsw 这类融合”加零点再乘加”的指令,GPU 和 TPU 上没有,只能把乘法展开成四项:
其中 以 INT8 精度计算,其余三项以 INT16/32 精度计算——一次乘法变成四次乘加,GPU 上明显变慢,所以论文的实验以对称 absmax 为主线,零点量化作为对照。
细粒度是改善量化精度的经典手段:既然单尺度管全局会出问题,那就多给几个尺度。row-wise 量化给每行一个尺度,论文采用的向量级量化(vector-wise quantization)更进一步,把矩阵乘法看成 个独立内积,每个内积单独配缩放常数(后文详述)。从论文 Table 1 看,这些方案能把无损伤的规模从 125M 推到 2.7B 左右,但 6.7B 之后全部失效——13B 的 absmax、row-wise、vector-wise 量化困惑度(perplexity)不降反升,比 6.7B 的量化结果还差,呈现明显的”规模越大越糟糕”趋势。这说明失败的原因不在量化粒度,而在于另一个随模型规模相变式涌现(emergent)的因素——离群值。
核心发现:离群值是系统性涌现的,不是噪声
论文对”离群值”给出了操作性定义:给定隐藏状态 ( 序列维、 特征维),一个特征维度 (即某一列)被称为离群特征,需要同时满足三个条件:
- 该维度上存在幅值 的元素;
- 该维度在至少 25% 的 transformer 层中都出现这样的元素;
- 该维度上出现大值的序列位置占全部序列位置的 6% 以上。
阈值的选择是经验性的:把幅值 6 以上的元素全部当作离群值用高精度处理,困惑度退化就趋近于零;层覆盖率的 25% 阈值则是让最小的 125M 模型恰好只检出 1 个离群特征(次常见的候选只在 2% 的层里出现)。注意这套检测只针对注意力投影层(Q/K/V/O)与 FFN 第一个子层(扩展层)的输入激活——论文发现离群值只出现在这些位置上,注意力函数内部与 FFN 收缩层的输入没有这类离群。
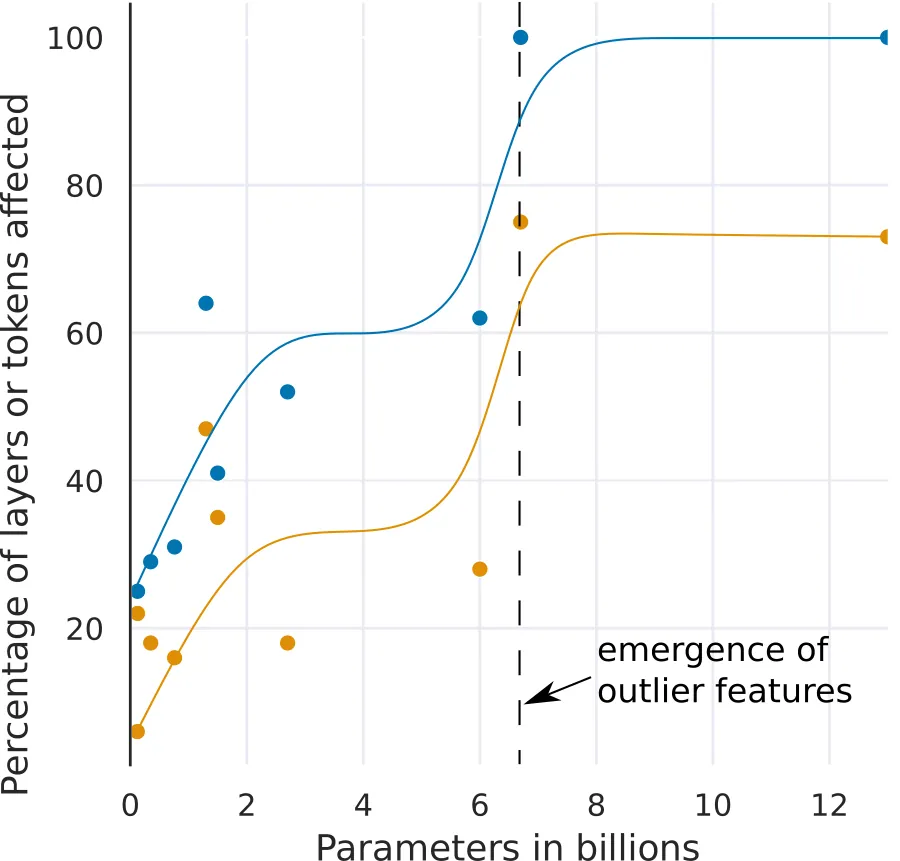
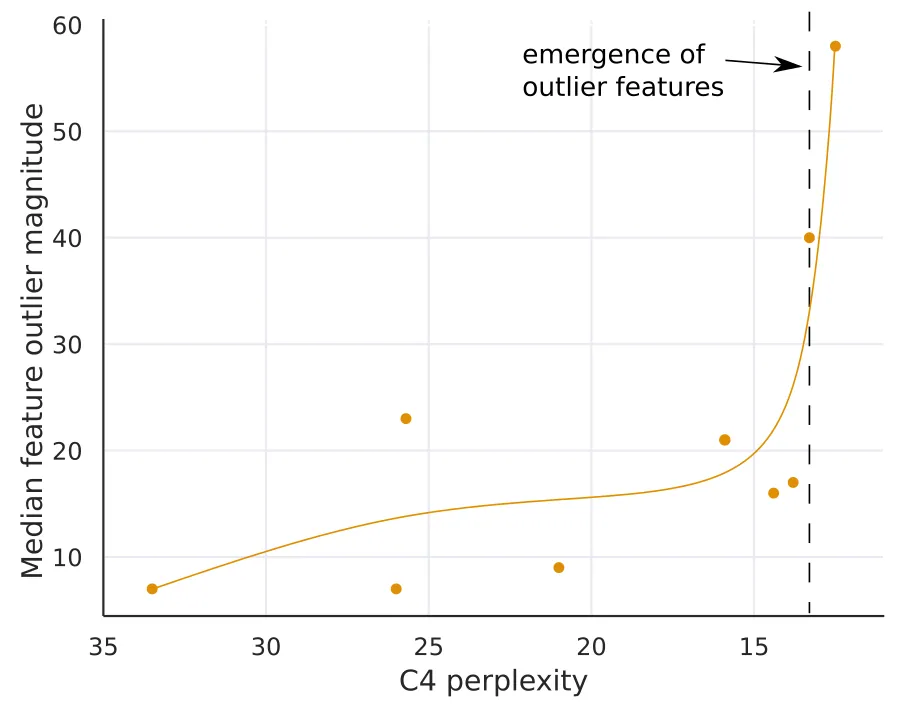
上图是论文 Figure 3(a):横轴为模型参数量,纵轴为”受大值离群特征影响的层占比”与”受影响的序列位置占比”。两条曲线在 6B 到 6.7B 之间出现了陡峭的相变——层覆盖率从 65% 跳到 100%,序列位置覆盖率从 35% 跳到 75%。这个相变点和常规量化方法的崩溃点精确重合,论文因此认为这不是巧合:量化失败的直接原因就是离群值的系统涌现。论文还给出一个补充视角(Figure 3b):如果把横轴换成 C4 困惑度而不是参数量,同一现象呈现的是平滑的指数式增长——说明”涌现”本质上是模型能力(以困惑度衡量)的函数,参数规模只是伴随变量,这与同期关于涌现能力的讨论一脉相承。
离群值有多”大”?论文测量了各模型所有层中最大离群特征的幅值中位数,见下图。在离群值尚未扩散到全部层时,中位幅值平缓;一旦扩散完成,幅值中位数快速抬升——离群值的量级可达普通维度的约 20 倍。这对量化的杀伤是双重的:一方面,20 倍的动态范围把量化区间撑爆(幅值大的元素精度不够,幅值小的元素被取整归零);另一方面,幅值本身还在随规模增长,13B 之后连能处理非对称分布的零点量化也扛不住。
离群值最反直觉的性质是极度稀疏却又极度系统。以 13B 模型为例,每处理一条 2048 token 的序列,整个 transformer 前向过程会产生多达约 15 万个离群元素——但它们只落在至多 7 个特征维度(列)上。也就是说,这 7 个维度的取值几乎在每一个 token 位置、每一层里都很大,而其他上千个维度干干净净。论文统计到 6.7B 规模时这个数字是 6 个维度,13B 时不超过 7 个;按占全部输入特征的比重算,只有约 0.1%。
这些维度对模型有多重要?论文做了”归零实验”:把离群特征维度整列置零后再前向,看注意力与困惑度受到多大影响。结果触目惊心:只清掉这 6-7 个维度,注意力 softmax 的 top-1 概率从约 40% 掉到约 20%,验证集困惑度恶化 600%-1000%;而对照组随机清掉同样数量的普通维度,top-1 概率只下降 0.02%-0.3%,困惑度仅上升 0.1%。这说明离群维度承载着模型预测的关键信息,且对这些维度的数值精度极度敏感——哪怕很小的量化误差都会显著改变输出。顺带地,这也解释了为什么 8-bit 量化对超过 6.7B 的模型必然失败:无论量化粒度多细,只要离群列还在 INT8 管线里,它们的误差就主导一切。
第一件武器:向量级量化
论文的第一层改进,是把量化尺度从 per-tensor(整张矩阵一个)细化到”每个内积一个”。矩阵乘法 (,, 为输出维)本质上是一组独立内积:输出位置 的值是 第 行与 第 列的点积。既然每个点积独立,就可以给 的每一行配一个缩放常数 ,给 的每一列配一个缩放常数 ,互不干扰。反量化时,每个内积结果除以 ;对整个矩阵而言,这等价于除以缩放向量的外积(outer product):
其中 是外积(), 是逐元素乘法, 表示 absmax 或零点量化的整数化操作。与 per-tensor 相比,向量级量化把”一个极端值祸害全局”变成”一个极端值只祸害它所在的行/列”;论文实验里它也稳定优于 row-wise 量化,论文把这归因于权重侧量化精度的提升。Table 1 中 13B 模型上 vector-wise(16.48)与 row-wise(16.49)几乎一样差,说明此时瓶颈已不在权重的尺度划分。
那么向量级量化为什么止步于 2.7B?回到离群值的几何位置:离群在列(特征维 ),而向量级量化的尺度在行(序列维 )。 的每一行对应一个 token,一行里只要混入一个大值列,这行的尺度就被拉大,行内其他普通列全部遭殃;而列方向( 维)恰恰是 GEMM 的归约维,无法在矩阵乘外单独施加尺度。也就是说,无论量化粒度怎么细化,只要粒度不是”按列”,离群列就会持续污染同行元素。可”按列量化激活”在 Tensor Core 上又不可行(这是 SmoothQuant 文章里详细讲过的硬件约束:激活的 per-channel scale 落在归约维上,无法在 MMA 指令序列之间插入)。两条路都被堵死之后,论文转向了第三个思路:把离群列从 8-bit 管线里物理隔离出去。
第二件武器:混合精度分解
既然离群列只占约 0.1% 却几乎出现在每个 token 上,一个自然的想法是:让这 0.1% 的列走 FP16 高精度通道,其余 99.9% 的列继续走 INT8 通道,两条通道各自做完矩阵乘再相加。这就是混合精度分解(mixed-precision decomposition)。
形式化地,给定输入矩阵 ,定义离群维度集合:
论文取阈值 ——与离群检测阈值一致,实验表明把幅值 6 以上的特征全部按离群处理时性能退化趋近于零。利用爱因斯坦求和记号(上标即矩阵列号),分解后的矩阵乘法写成:
这个式子需要逐项拆解。回顾矩阵乘法的本质: 的每个输出元素是 ,即沿归约维 的求和;把求和按维度拆开看,( 的第 列与 的第 行相乘)是一个秩为 1 的外积矩阵,整个 就是 个这样的秩 1 矩阵之和。上式正是把这个和拆成两组——第一项:对离群维度 求和, 与 都保持 FP16,直接做高精度矩阵乘(实质是 与 两个瘦矩阵的乘);第二项:对非离群维度 求和,先把两个子矩阵量化成 INT8 做整数矩阵乘得到 ,再乘上缩放矩阵 (由向量级量化的行、列尺度外积构成)反量化回 FP16。两项都是对同一输出 的近似贡献,相加即得最终结果。
注意两点关键设计。其一,权重的分解跟随激活: 的第 行与 的第 列一一对应(都代表第 个输入特征),激活第 列被判定为离群,权重第 行就必须一起走 FP16 通道。其二,分解是运行时的动态行为,不是静态剪枝——每一层、每一次前向都要先扫描激活矩阵,找出幅值超过 6 的列,再决定这次前向的 集合。这带来一个小型软件栈:扫描找列 + 双通道矩阵乘 + 结果合并。论文用定制的 CUDA 实现完成这一流程(附录 D 的对比显示,定制 kernel 比 PyTorch 默认的逐算子量化路径快得多)。
下图是论文的方法总览。给定 FP16 输入 与权重 ,先按特征维度把它们拆成两组子矩阵:离群组直接进入 16-bit 矩阵乘;常规组先按行、按列求绝对最大值得到缩放向量 、,量化到 INT8 后做 8-bit 矩阵乘,INT32 输出再按外积 反量化回 FP16。两条通道的输出最后在 FP16 精度下累加,得到与全 FP16 几乎一致的 。
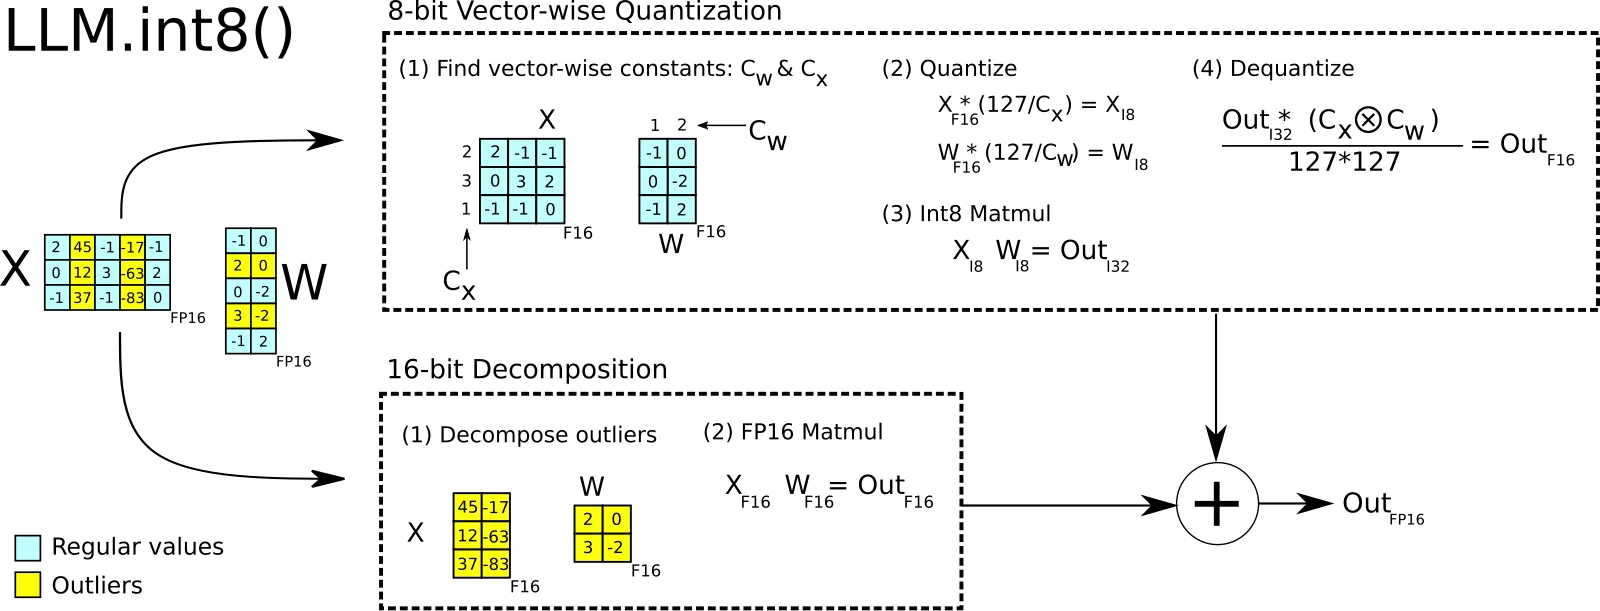
这套设计的经济账非常漂亮。离群维度至多 7 个(),FP16 通道只承担全部乘加运算的约 0.1%:对 13B 模型,输入特征维 是 5120 量级,7 列只占 0.14%,额外开销可忽略。而权重主体以 INT8 存储,显存减半——论文实测 BLOOM-176B 的权重内存占用缩减 1.96 倍。更妙的是,剥离离群列之后,剩余激活的分布近似对称,零点量化的非对称优势随之消失(Table 1 中”LLM.int8 + zeropoint”与”LLM.int8 + absmax”结果几乎相同,都是 12.45),说明分解之后对称 absmax 已经足够;但此时向量级量化相对 row-wise 仍有优势(12.45 vs 12.46 虽然接近,但在 6.7B 与 13B 全尺寸上保持一致),说明对权重的细粒度尺度仍然必要。
实验:无损扩展到 175B
论文用两套实验体系验证:C4 语料验证集的困惑度(对量化退化极其敏感),以及 OPT 系列的零样本任务准确率。下表是困惑度主结果(节选):
| 方法 \ 参数量 | 125M | 1.3B | 2.7B | 6.7B | 13B |
|---|---|---|---|---|---|
| FP32 基线 | 25.65 | 15.91 | 14.43 | 13.30 | 12.45 |
| INT8 absmax(per-tensor) | 87.76 | 16.55 | 15.11 | 14.59 | 19.08 |
| INT8 zeropoint | 56.66 | 16.24 | 14.76 | 13.49 | 13.94 |
| INT8 absmax row-wise | 30.93 | 17.08 | 15.24 | 14.13 | 16.49 |
| INT8 absmax vector-wise | 35.84 | 16.82 | 14.98 | 14.13 | 16.48 |
| LLM.int8()(vector-wise + 分解) | 25.83 | 15.93 | 14.44 | 13.24 | 12.45 |
读表有几点值得注意。一是 125M 处 per-tensor 的 absmax 与 zeropoint 就已经很差(87.76 与 56.66),row-wise 一下子修到 30.93——单尺度管全局的缺陷在小模型上同样存在。二是 6.7B 是分水岭:从这一行开始,所有基于 absmax 的方法困惑度停在 14.1 以上,无法随模型变大而继续下降;到 13B,absmax/row-wise/vector-wise 的困惑度反而比 6.7B 更差(16.5 vs 14.1),量化误差随规模的累积压倒了模型能力的增长。三是 LLM.int8() 在 125M 到 13B 的每个尺度上都恢复到了 FP32 水平——这是论文强调的”可扩展性”:别的方案误差随规模增长,它的误差不增长。
零样本结果对应开头的 Figure 1:OPT-125M 到 OPT-175B 的完整规模带上,LLM.int8() 的平均准确率与 FP16 基线全程重合;作为对照,absmax vector-wise 基线在 6.7B 后跌到随机水平。论文还报告了困惑度之外的生成质量、以及”加载即用”的特性——一个 FP16/FP32 的 175B 检查点可以直接加载、当场转成 INT8 开始推理,不需要校准数据集,也不需要任何微调(这与后来需要 Hessian 校准的 GPTQ 形成鲜明对比)。显存账本方面,BLOOM-176B 权重占用从约 352GB 降到约 180GB(1.96 倍),论文给出的硬件对照表显示:原本要 8 张 A100 80GB 才能跑的 OPT-175B/BLOOM,8-bit 后在 8 张 RTX 3090(24GB)上即可运行;OPT-66B 从 8 卡缩到 4 张 3090;免费版 Colab 的 12GB 显存从只能跑 GPT-2-1.3B 变成能跑 T0/T5-11B。让消费级设备摸到 175B 级模型,是这篇论文最直接的社会影响。
但必须诚实交代速度。LLM.int8() 的卖点是省显存,不是加速。论文附录 D 的基准显示:纯 INT8 矩阵乘(cuBLASLt 实现)相对 FP16 的 cuBLAS 要到”模型维度 5140、隐藏维度 20560”(约 13B 级 FFN 第一层)才开始达到 2 倍——INT8 Tensor Core 的吞吐优势需要足够大的 GEMM 才能吃满;而一旦计入输入量化的开销,收益缩水到 1.6 倍;再加上混合精度分解的双通道执行,最终只有 13B 与 175B 级别的大矩阵乘有净收益,小于 6.7B 的模型反而变慢。端到端上,论文测得 BLOOM-176B 的逐 token 延迟与 FP16 相当(多卡场景通信占大头,量化影响被稀释);Hugging Face 官方博客的实测则显示 BLOOM-176B 的 INT8 推理比 FP16 慢约 15%-23%——每层都要做离群检测、量化、反量化这些额外操作,且 INT8 GEMM 与 FP16 GEMM 无法无缝流水。论文自己也承认,用专门优化的混合精度 CUDA kernel 可以显著改善这些数字。
遗产:一个离群值叙事的三种解法
回头看,LLM.int8() 最大的贡献或许不是方法本身,而是把”离群值”确立为 LLM 量化的头号问题。它的三个关键观察——离群值数量随规模相变涌现、集中在极少数特征维度、这些维度主导模型性能——构成了此后所有量化工作的公共前提,后续工作沿着三条不同的技术路线解决同一个问题:
- 隔离(本文章):把离群列拆出去用 FP16 单独算。优点是加载即用、无需校准;缺点是双通道矩阵乘与逐 token 的离群检测让 INT8 Tensor Core 无法全程饱和,端到端没有吃到 2 倍计算吞吐。
- 迁移:SmoothQuant(站内拆解)发现离群值固定在少数通道且跨 token 稳定,于是用一个数学等价的缩放把激活的量化难度迁移给权重,激活变得平坦、可以用硬件友好的 per-token 量化,实现真正的 W8A8 全 INT8 GEMM——补上了 LLM.int8() 没能兑现的”INT8 Tensor Core 2 倍吞吐”。
- 保护与补偿:GPTQ(站内拆解)不再把激活卷入量化,只量化权重并用二阶误差补偿,把位宽直接压到 4-bit;AWQ(站内拆解)则继承了”少数通道由激活决定重要性”的观察——显著权重通道正是那些输入激活幅值大的通道——按通道缩放权重来保护它们。
同样的结构性观察也延伸到了 KV Cache:站内 KIVI 拆解里,Key 选择按通道(channel)粒度量化而不是按 token,背后的观察是 Key 沿通道方向存在稳定的大动态范围结构——与”离群值栖身于少数维度”属于同一类现象。
那么 LLM.int8() 的 8-bit 权重路线今天为什么不再是主流?原因是多重的:其一,激活必须保持 FP16 意味着 GEMM 无法全程 INT8,速度上先天受限;其二,4-bit weight-only 路线(GPTQ/AWQ)在差不多的精度下把权重又压掉一半;其三,FP8 数据格式随 Hopper 硬件成熟,以更低的精度损失覆盖了 8-bit 场景。但它的遗产仍然活着:bitsandbytes 库至今是 Hugging Face 生态的量化底座(后来的 QLoRA NF4 量化也长在同一个库里),load_in_8bit 让无数人在消费级显卡上第一次跑起了 10B+ 模型;而”outlier”这个词,从此成为每个做量化的人必须首先面对的概念。
小结
LLM.int8() 的故事可以压缩成一条逻辑链:175B 模型装不进显存 → 8-bit 量化看似可行 → 实验发现 6.7B 以上量化必然崩盘 → 定位到系统涌现的激活离群值(稀疏却主宰性能的 0.1% 特征维度)→ 向量级量化解决普通值的精度、混合精度分解把离群列隔离到 FP16 通道 → 175B 模型实现 8-bit 无损推理、显存减半、消费级硬件可及。作为”离群值”叙事的第一站,它奠定了理解 SmoothQuant、AWQ 乃至后续一切 LLM 量化的共同背景——在量化一个模型之前,先问一句:离群值在哪里?
参考资料
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale(arXiv 论文页)
- 论文 HTML 全文与全部插图(ar5iv,本文配图来源)
- NeurIPS 2022 会议论文集收录页(官方 PDF)
- A Gentle Introduction to 8-bit Matrix Multiplication for transformers at scale(Hugging Face 官方博客)
- bitsandbytes 开源仓库(GitHub)
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(arXiv,后续工作参照)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


