


面试疑难(一):Python/C++ 结构体与类、装饰器、vLLM 源码地图与 DeepEP/DeepGEMM
这组问题在问什么
这是一组真实出现在 LLM 推理/部署方向技术面试里的连环问题,按出场顺序是:
- Python、C++ 里面的「结构体和类」,实现上有什么区别?
- Python 的装饰器,讲一下原理。
- 对 vLLM 源码有没有基本了解?
- 了解 DeepEP 和 DeepGEMM 吗?
问题之间其实有清晰的递进逻辑:先考语言底层功底(对象在内存里到底长什么样、语法糖背后发生了什么),再考框架源码阅读能力(能不能讲清楚 vLLM 的分层与一条请求的生命周期),最后考开源生态的敏感度(DeepSeek 开源周放出的通信库和 GEMM 库,是”有没有跟进、能不能看懂系统价值”的直接试金石)。面试官想确认的不是你会背 API,而是你拿到一个推理系统时,能把它拆成”调度层、显存层、算子层、通信层”来理解。
本文按一问一答的形式组织。每问先给”这题考察什么”,再给原理详解,最后给”怎么答才稳”的要点;第四、五问的答案比较长,因为这两问想讲明白本身就需要把 MoE 推理的通信与计算讲透。
第一问:Python、C++ 里的结构体和类,实现上有什么区别
这个问题最容易被答浅。多数人第一反应是”C++ 里 struct 默认公有、class 默认私有”,这没错,但只是语言层的一句话。面试官接着追问”那 Python 呢?Python 里有结构体吗”时,很多人就卡住了。要把这题答全,得从 C 讲起,分三个层次。
C 的 struct:一切的原点
C 语言里的 struct 是纯数据聚合:把若干个成员变量按声明顺序打包成一块连续内存,仅此而已。它没有方法、没有访问控制、没有继承。想在 C 里给”结构体”加行为,只能放函数指针,所以早期面向对象风格(比如 Linux 驱动里的 file_operations)全靠函数指针模拟。
“打包成一块连续内存”这句话背后有一套精确的硬件规则——内存对齐(alignment)。成员不是简单地一个挨一个排,而是每个成员都要落在”其对齐要求”的整数倍地址上。规则是:
- 每个类型有一个对齐值(alignment),通常等于其大小:
char是 1,int是 4,double是 8; - 结构体成员按声明顺序排放,每个成员从”对齐到其对齐值整数倍”的偏移开始;
- 成员之间的空隙叫 padding(填充字节),结构体总大小必须是最大成员对齐值的整数倍。
看一个例子:
struct A { // 假设 64 位 Linux,默认对齐 char c; // 偏移 0,占 1 字节 // 偏移 1-3:padding int i; // 偏移 4,占 4 字节}; // 总大小 8,对齐值 4(成员中最大)sizeof(struct A) 是 8 而不是 5。把成员顺序换一下(int 放前面、char 放后面)大小还是 8;但如果再加一个 double d 放最后,int 之后要补 4 字节 padding,让 double 从偏移 8 开始,总大小变成 16。这就是为什么系统程序员在定义网络协议头、KV 缓存块等结构时要精心排列成员顺序——同样的成员,顺序不同可以差出好几字节,而显存里成千上万个块,每块多 4 字节 padding 就是可观的浪费。
C++ 的 struct 与 class:同一个东西的两种写法
C++ 设计者当初面临一个选择:要不要引入一个全新的 class 关键字把 C 的 struct 丢掉?他们的决定是让 struct 成为 class 的别名,保留两者,仅保留一个语言层区别:
| 区别点 | struct | class |
|---|---|---|
| 默认成员访问权限 | public | private |
| 默认继承方式 | public 继承 | private 继承 |
| 其他一切(成员函数、构造析构、继承、多态、模板、运算符重载) | 完全相同 | 完全相同 |
也就是说,下面两段代码在 C++ 里几乎等价,唯一差别是 x 的默认可见性:
struct Point { int x, y; }; // x、y 默认公有class Point { int x, y; }; // x、y 默认私有为什么 C++ 要保留 struct?三个原因:一是兼容 C 代码(C 代码里的 struct 直接拿到 C++ 编译);二是表达意图——用 struct 声明”我只是个数据聚合”,让读者知道这里没有复杂的类不变量;三是语法便利——struct 默认公有,天然保持 C 的聚合初始化语义(Point p = {1, 2}; 以及 C++20 的指定初始化 Point p = {.x = 1, .y = 2};),class 默认私有做不到。
实现层面,struct 和 class 的对象在内存里的形态完全一致,都遵循 C 的布局规则,再叠加 C++ 特有的几样东西:
- 成员函数不占对象大小。函数编译后是普通代码,放在代码段,调用时通过隐藏的 this 指针知道操作哪个对象,所以
sizeof只统计数据成员和 padding; - 静态成员也不占对象大小,它们存在数据段,属于类而不属于某个对象;
- 空类的大小是 1 字节。因为 C++ 要求同一个类的两个不同对象地址必须不同,空类对象也得占一个字节”占个坑”(作为基类时会被空基类优化 EBO 吃掉,不占空间);
- 一旦类里有虚函数,对象开头(常见实现)会多一个隐藏的 vptr(虚表指针),指向虚函数表,这是”运行时多态”的实现基础;虚函数把类的对齐要求抬上去,混入虚函数成员的结构体大小会明显膨胀;
- 多继承时会有多个 vptr 和多个基类子对象,虚继承还有额外的偏移指针,布局规则由 ABI 决定。
看一张微软官方博客的示意图——它演示的正是”看不见的 vptr”如何影响类的大小:
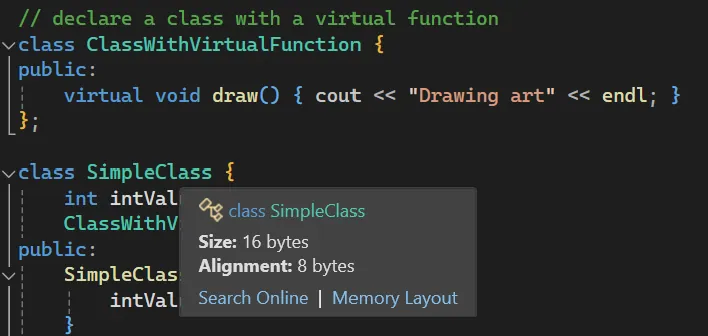
图中类同时包含普通 int 成员和一个带虚函数的成员对象,后者内部藏着 8 字节的 vptr,并把整个类的对齐要求抬到 8 字节,于是成员之间出现肉眼不可见的填充,最终大小显著大于”各成员裸长之和”。Visual Studio 2022 的 Quick Info 会直接显示类型的 Size 与 Alignment,Memory Layout 视图还能交互式查看每个成员的偏移和 padding,是摸清布局的好工具。
再补两个对做系统/推理库的人特别有用的点。其一,平凡可复制类型(trivial)可以放心 memcpy:只要类里没有虚函数、没有自定义拷贝逻辑,它的内存布局就是 C 布局的扩展,memcpy 逐字节搬移完全合法,GPU 侧尤其常用。其二,padding 里的字节是未定义的,所以两个成员相同的对象做 memcmp 可能不相等——序列化、哈希时要用 offsetof/按字段处理,或先 memset 清零。
Python:没有”结构体”,只有一种对象模型
现在到本题的关键:Python 里根本没有 struct 这个关键字,也没有”值类型”与”引用类型”之分,只有一种东西——对象。 所以这半问的正确答法是:先解释 Python 的对象模型,再说清楚”Python 里什么最接近 C 的结构体”。
Python 的对象模型核心是:一切皆对象,对象活在堆上,变量只是名字(引用),赋值是绑定而不是拷贝。每个对象在 CPython 里都是一块堆内存,开头固定是一个对象头(引用计数 + 类型指针),后面跟着类型决定的内容。Python 类与 C++ 类的本质差异在于,实例的字段不是一个预先排好的固定布局,而是一个动态字典:默认情况下,实例属性存在每个实例自己的 __dict__(哈希表)里,属性访问 obj.x 等价于一次字典查找(先查实例 dict,再沿 MRO 查类,中间还经过描述符协议)。
这带来两个工程后果:灵活(运行时随便加属性),但慢且费内存(每个属性都是 dict 的 key/value 包装,每个实例都背着整个 dict)。C++ 里 struct 的成员是编译期定死的偏移,Python 里只能靠 __slots__ 逼近这个效果:
class Point: __slots__ = ("x", "y") # 固定字段,不再生成 __dict__ def __init__(self, x, y): self.x = x self.y = y声明 __slots__ 后,CPython 不给实例分配 __dict__,属性变成一组固定描述符,每个实例的内存省下一个哈希表,访问也更快;代价是不能再动态添加 __dict__ 里没列出的属性,多继承时还要求各父类都支持 __slots__。在 Python 里要找”C 结构体”的对应物,第一答案是 __slots__ 类,而不是普通 class——这正好呼应了题目里”结构体与类”的对比。
日常写推理代码,还有几个”像结构体”的现成工具,值得在答案里点一句:
@dataclass(PEP 557):自动生成__init__/__repr__/__eq__的数据容器,Python 3.10 起支持slots=True,vLLM 这类框架里大量用它定义请求/输出元数据结构;typing.NamedTuple:tuple 的带名子类,不可变、省内存、按位置也按名字访问;struct模块:与 C 结构体内存布局直接对接——struct.calcsize/pack/unpack按 C 编译器的对齐规则把 Python 值压成字节,协议解析必备;ctypes.Structure:声明_fields_后,Python 对象在内存里按 C 布局排布,可以直接把 C 库返回的结构体指针映射成 Python 对象;还有array/memoryview/numpy 的 structured array 等连续内存视图。
对比表与答题要点
| 维度 | C 的 struct | C++ 的 struct/class | Python 的类 |
|---|---|---|---|
| 本质 | 数据聚合 | 数据 + 行为 + 封装 + 多态 | 动态对象模型 |
| 成员布局 | 编译期定死,按声明顺序 + 对齐 | 同 C,另有 vptr/基类子对象 | 实例 __dict__(哈希表)或 __slots__ |
| 对象存放 | 栈上/结构体内嵌(值语义) | 值语义或堆上 | 一律堆上,变量是引用 |
| 访问控制 | 无 | 编译期检查(struct 默认 public) | 惯例约定(_x),无强制 |
| 大小确定时机 | 编译期 | 编译期 | 运行时 |
| 与推理系统相关 | 协议/布局定义 | KV 块结构、CUDA 侧 struct、pybind 绑定 | 调度器记账、dataclass 元数据 |
怎么答才稳:30 秒版本——“C++ 里 struct 和 class 唯一语言层区别是默认访问权限与默认继承方式,实现上都是带对齐规则的内存布局加可选 vptr,成员函数不占对象大小;Python 没有结构体,只有一个堆上的对象模型,实例字段默认放字典里,__slots__/dataclass/struct 模块才是它’像结构体’的一面”。然后挑一两个点展开(对齐 padding 的 sizeof 计算、__slots__ 省内存),再主动联系应用场景(比如:KV cache 块在 CUDA 侧就是固定布局的 struct,在 Python 侧则是 dataclass + tensor 视图),比干背差异高一个档次。
第二问:Python 装饰器
装饰器这题,面试官想听的不是”给函数加功能”,而是你能不能讲清它的本质是函数重绑定,以及装饰器在什么时刻执行。答到这两点,再加一个 functools.wraps,这题就稳了。
本质:函数是一等公民,装饰器是”换绑”
Python 里函数是对象,可以当参数传、当返回值给。那么想给一个函数加日志、计时、缓存,最朴素的做法是手动包一层:
def say_hello(): print("hello")
def with_logging(f): def wrapper(*args, **kwargs): print("call:", f.__name__) return f(*args, **kwargs) return wrapper
say_hello = with_logging(say_hello) # 手动换绑装饰器语法糖 @ 只是把最后一行换了个写法,在函数定义完的那一刻立即执行(模块 import 时,而不是函数被调用时):
@with_logging # 等价于 say_hello = with_logging(say_hello)def say_hello(): print("hello")注意传递和返回的都是函数对象本身(不带括号),不是调用结果。被装饰函数原来的代码没有消失——它被闭包捕获在 wrapper 里,原函数名 say_hello 现在指向的是 wrapper。这就是”不改原代码加功能”的全部秘密:换绑 + 闭包。
通用模板与 functools.wraps
一个”能用”的装饰器需要处理任意签名并透传返回值,标准模板如下:
import functools
def timer(func): @functools.wraps(func) # 把 __name__、__doc__ 等拷到 wrapper 上 def wrapper(*args, **kwargs): start = time.perf_counter() result = func(*args, **kwargs) # 真正的调用 print(f"{func.__name__}: {time.perf_counter() - start:.3f}s") return result return wrapperfunctools.wraps 是进阶题的关键词:它内部调用 update_wrapper,把原函数的 __module__、__name__、__qualname__、__doc__、__annotations__ 拷到 wrapper 上,并把原函数挂在 wrapper.__wrapped__ 上。不写它,装饰后 help(f)、f.__name__ 就全变成 wrapper 的了——调试、文档、序列化都会踩坑。
带参数装饰器与可选参数形式
装饰器本身要接收参数(比如缓存过期时间)时,需要再包一层——装饰器工厂:外层函数收装饰器参数、返回真正的装饰器,内层收被装饰函数:
def retry(max_times=3): def decorator(func): # 这才是"真正的装饰器" def wrapper(*args, **kwargs): for i in range(max_times): try: return func(*args, **kwargs) except Exception: if i == max_times - 1: raise return wrapper return decorator
@retry(max_times=5) # 先调 retry(5) 拿到装饰器,再装饰def fetch(): ...顺带记住一个细节:@retry 和 @retry(...) 是两种形态,前者直接把函数传给 retry,后者先调用工厂。很多库(如 Flask/click)支持两种写法混用,实现上要判断第一个参数是不是函数。
多个装饰器:装饰时自下而上,调用时洋葱式
@deco_a@deco_bdef f(): ...等价于 f = deco_a(deco_b(f)):应用阶段先执行靠近函数的下层(deco_b),再执行上层(deco_a);真正调用 f() 时,执行顺序反过来,从最外层 deco_a 的 wrapper 进入,层层向内,到原函数再逐层返回,像剥洋葱。把 @property、@classmethod 之类叠在一起时,这个顺序会直接决定行为,是常见的追问点。
类装饰器、用类做装饰器、内置装饰器
- 类装饰器:同样作用于类(如
@dataclass就是给类自动生成方法); - 用类做装饰器:类实现
__call__后实例可调用,适合需要保存状态(计数器、注册表)的装饰器; - 内置常用:
@property(本质是描述符,把方法变成属性访问并支持只读)、@staticmethod/@classmethod(后者自动绑定类对象)、functools.lru_cache/cached_property(缓存)、contextlib.contextmanager(把生成器变成上下文管理器,用@contextmanager装饰一个yield函数)。
框架里的装饰器:为什么面试官爱问
在推理框架语境下,装饰器至少有三个典型应用,答出来很加分:
- 路由注册:FastAPI 的
@app.get("/v1/chat/completions")就是装饰器——函数定义时被注册进路由表,vLLM 的 OpenAI 兼容服务入口就是这么组织的; - 注册表模式:用装饰器把实现类登记进字典,实现”插件式”扩展。vLLM 的注意力后端、模型注册都是类似思路:
@xxx.register("name")装饰的类,import 后自动进注册表,选择器按配置挑实现; - 缓存/重试/计时:配置解析、请求重试等横切逻辑用装饰器收敛,避免散落各处。
怎么答才稳:先抛本质(一等函数 + 定义时换绑 + 闭包捕获),再背通用模板 + wraps 的意义,最后用框架实例(FastAPI 路由、注册表)收尾。能补一句”装饰器在 import 时执行,所以滥用会影响启动时间、调试信息丢失要 wraps”就是加分项。
第三问:对 vLLM 源码的基本了解
这是四组问题里最能拉开差距的一题。vLLM 由 UC Berkeley SkyLab 于 2023 年开源(同名论文发表于 SOSP 2023),核心论文讲的是 PagedAttention,但它早已长成一个完整的推理服务系统。源码层面要答好,需要三层:分层架构、一条请求的生命周期、关键目录地图。
分层架构:先讲骨架
vLLM 的代码组织可以压缩成一条链:
入口(HTTP/CLI) → 引擎层(调度 + 批处理 + 请求状态机) → 执行层(张量并行/数据并行/流水线并行的模型执行) → 算子层(注意力后端、GEMM、采样)具体到 2026 年的仓库(V1 引擎时代),关键目录如下,这是一份可以直接背的”源码地图”:
| 层 | 目录 | 职责 |
|---|---|---|
| 入口 | vllm/entrypoints/ | openai/api_server.py(FastAPI 服务)、llm.py/async_llm.py(离线/异步 API) |
| 引擎 | vllm/v1/engine/ | llm_engine.py(同步引擎)、async_llm.py、engine_core(core.py/core_client.py:引擎可放进独立进程,用共享内存张量做零拷贝通信,把 Python 侧与模型执行解耦)、detokenizer.py、input_processor.py、output_processor.py |
| 调度与 KV | vllm/v1/core/ | sched/(调度器)、block_pool.py(物理块池)、kv_cache_manager.py(前缀缓存等逻辑)、kv_cache_coordinator.py |
| 模型执行 | vllm/v1/worker/ | gpu_model_runner.py(把 batch 组装成 GPU 输入并调用模型 forward)、gpu_worker.py、block_table.py |
| 注意力 | vllm/v1/attention/ | backends/ 下每个后端一个文件(flash_attn.py、flashinfer.py、triton_attn.py、mla/ 等),registry.py/selector.py 负责注册与按配置挑选 |
| 采样 | vllm/v1/sample/ | 温度、top-p、投机解码验证等 |
| 其他 | vllm/v1/spec_decode/、structured_output/、cudagraph_dispatcher.py | 投机解码、结构化输出、CUDA Graph 调度 |
注意一点:仓库里还留着 vllm/engine/ 等老目录,那是 V0 引擎的遗留代码——V1 引擎在 2024 年底发布,如今已是默认引擎;面试时能说出”V1 把引擎核心抽进 engine_core 独立进程、注意力后端统一到 vllm/v1/attention/backends”就说明你真的看过源码而不是只读过文档。
一条请求的生命周期
把链条走一遍,vLLM 的源码就活了。一条 prompt 从 HTTP 进来后:
- 入口层:OpenAI 兼容 server 收请求,构造
Request/SamplingParams,交给AsyncLLMEngine; - 引擎层:
LLMEngine把请求切分(chunked prefill 可以按块处理长 prompt),交给调度器; - 调度器(
v1/core/sched):维护 running/waiting/swapped 三个队列,做连续批处理(iteration-level scheduling)——每步只等最快的那个 token 生成完就立刻插入新请求,而不是等整批请求都结束;显存不够时按优先级抢占(preempt 的请求可以 swap 到 CPU 或整块重算); - KV 管理器(
block_pool/kv_cache_manager):为每个请求分配物理 KV 块,维护块表;前缀缓存让共享前缀只存一份,被复用时按引用计数共享; - 模型执行(
gpu_model_runner):把调度器给的这个 step 的请求(含各自的块表)打包成 GPU 输入,调用模型 forward;注意力算子根据后端选择走 FlashAttention/FlashInfer/Triton 等实现; - 采样与输出:对 logits 做温度/top-p 采样(
vllm/v1/sample),生成新 token 和新 KV,再把结果交给输出处理器与 detokenizer 进程流式返回。
这个流程里 vLLM 快的原因全部有源码对应:连续批处理(调度器)、PagedAttention 分页 KV(块表)、前缀缓存(KV 管理器)、CUDA Graph(decode 步默认捕获进 graph,减少 kernel 启动开销)、算子融合与后端选择(注意力后端 + 各家 kernel)。
核心机制:PagedAttention 的块表
vLLM 得名的 PagedAttention 值得单独展开,因为它是”操作系统分页思想搬到显存”的经典。KV Cache 不再为每个请求预留连续的一大块显存,而是切成固定大小(默认 16 token)的逻辑块,经块表(block table)映射到不连续的物理块:
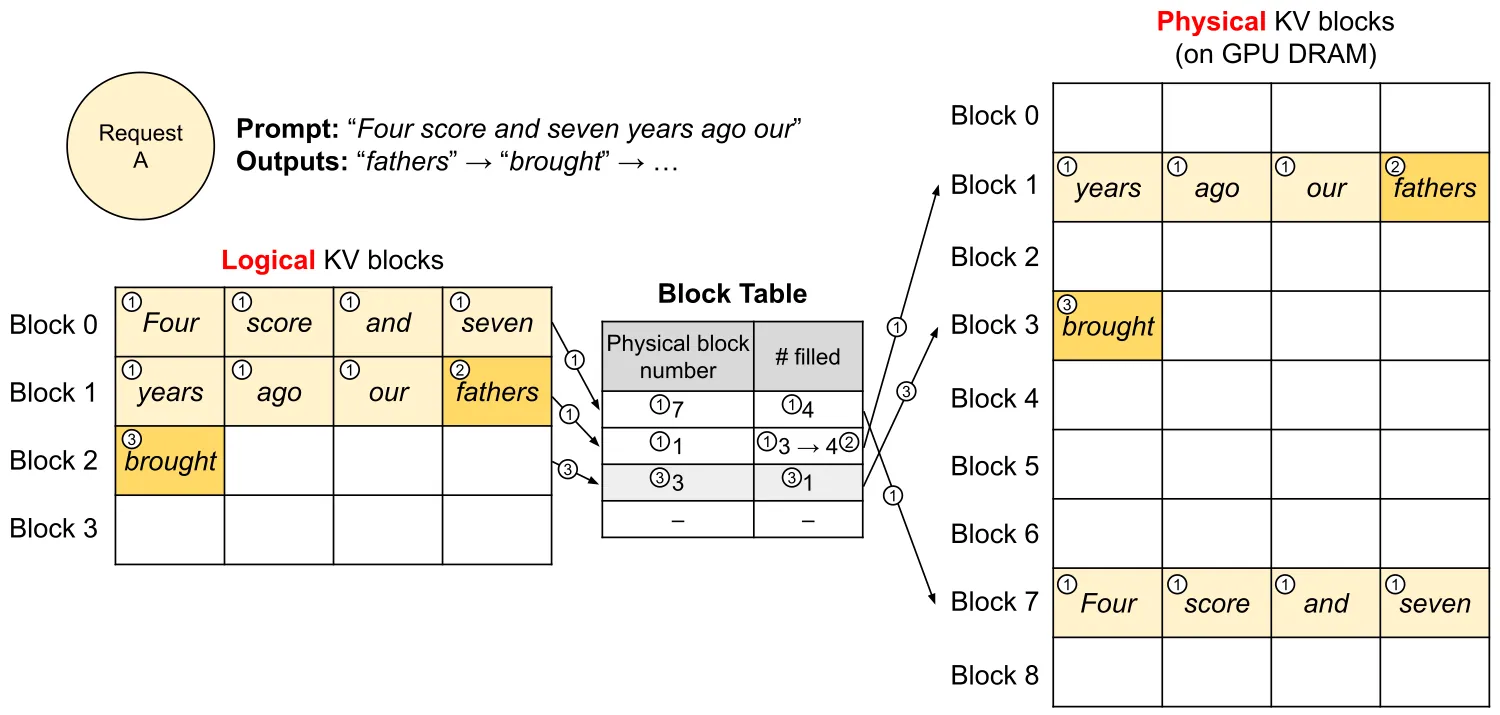
每个请求只持有”逻辑块 → 物理块”的映射表,物理块按需分配,最后一块只浪费块内剩余空间(粒度从整个请求的浪费降到 16 个 token 的浪费),彻底消除碎片和预分配浪费;beam search 时多个序列共享前缀块,靠写时复制(copy-on-write)省显存;解码时注意力 kernel 按块表间接寻址取 K/V。这套机制在源码里对应 vllm/v1/core/block_pool.py 的物理块池与 worker/block_table.py 的块表。
阅读路径建议
源码几千个文件,直接从头啃必弃。推荐顺序:先在 examples/ 跑通 Offline batched inference,再用 LLM 类单步跟一条请求 → 读调度器(vllm/v1/core/sched)→ 读块表与 KV 管理器 → 读 gpu_model_runner 看 batch 怎么进 GPU → 最后挑一个注意力后端读实现。调试时把日志级别调高,VLLM_LOG_LEVEL=DEBUG 能看到每步调度决策,是理解调度器最省力的方式。
怎么答才稳:先给一句话定位(“vLLM 是 2023 年 UC Berkeley 开源的高吞吐推理服务框架,核心是 PagedAttention + 连续批处理”),再背出上面的目录表里 5-6 个关键文件并各说一句职责,然后完整走一遍请求生命周期(能说出 chunked prefill、抢占、前缀缓存这些关键词落地的文件),最后落到”为什么快”的机制上。能讲清 v1/core(调度+KV)与 v1/worker(执行)的分工,这一问基本满分。
第四问:DeepEP
DeepEP 是 DeepSeek 在开源周期间开源(2025 年)的专家并行(EP)通信库,也是 DeepSeek-V3 系列 MoE 模型跨节点推理的通信基座。这一问通常和下一问的 DeepGEMM 连着问,面试官想知道:你知不知道 MoE 推理的瓶颈在通信、以及 DeepSeek 是怎么把通信压到硬件极限的。
背景:MoE 的 all-to-all 通信
MoE(专家混合)模型的每个 token 只激活 top-k 个专家。推理时为了负载均衡和发挥多卡算力,专家要切分到不同的 GPU 上(专家并行,EP),这就带来两类跨卡通信:
- dispatch(分发):每张卡上混着发往各专家的 token,需要把它们按目标专家重新排列、送到对应的卡;
- combine(合并):各专家算完后,把同一 token 的 k 份结果加权求和,送回 token 原来所在的卡。
本质是一个不规则的 all-to-all——不规则在于”每个 token 去哪个专家”由 router 动态决定,每步都可能不同。它有两个痛点:一是 PyTorch 自带的 batch alltoall 会把整个张量当哑数据搬,不感知”哪些 token 发往哪张卡”,还要做多次拷贝和 CPU 同步;二是通信和专家计算天然可以重叠(dispatch 时可以先算本地专家),但默认实现里通信 kernel 占着 SM 不放,重叠无从谈起。DeepEP 的目标就是把这两件事做到极致。
设计:两类内核 + SM 预算可调 + 与计算重叠
DeepEP 的核心设计可以概括为三条(这也是它区别于普通 alltoall 的地方):
- 按场景拆两类内核:prefill(长序列、大批量)要的是吞吐,decode(逐 token 生成)要的是低延迟——DeepEP 分别提供高吞吐内核与低延迟内核,避免”一个内核两头不讨好”;
- 通信占用的 SM 数可配置:通信 kernel 不必占满整张 GPU。留出 SM 给主计算流,配合事件机制(
EventOverlap)实现通信与专家计算的细粒度重叠——dispatch 的数据还在路上时,先算已经收到的本地专家,这是 MoE 推理吞吐的关键; - 内核级优化与低精度支持:支持 FP8 dispatch(数据按 FP8 传、scale 因子随行),直接省一半带宽;decode 场景支持路由元数据(handle)缓存复用——解码时 top-k 路由常常连续多步不变,复用 handle 可以跳过每步的 CPU 同步和布局重算。
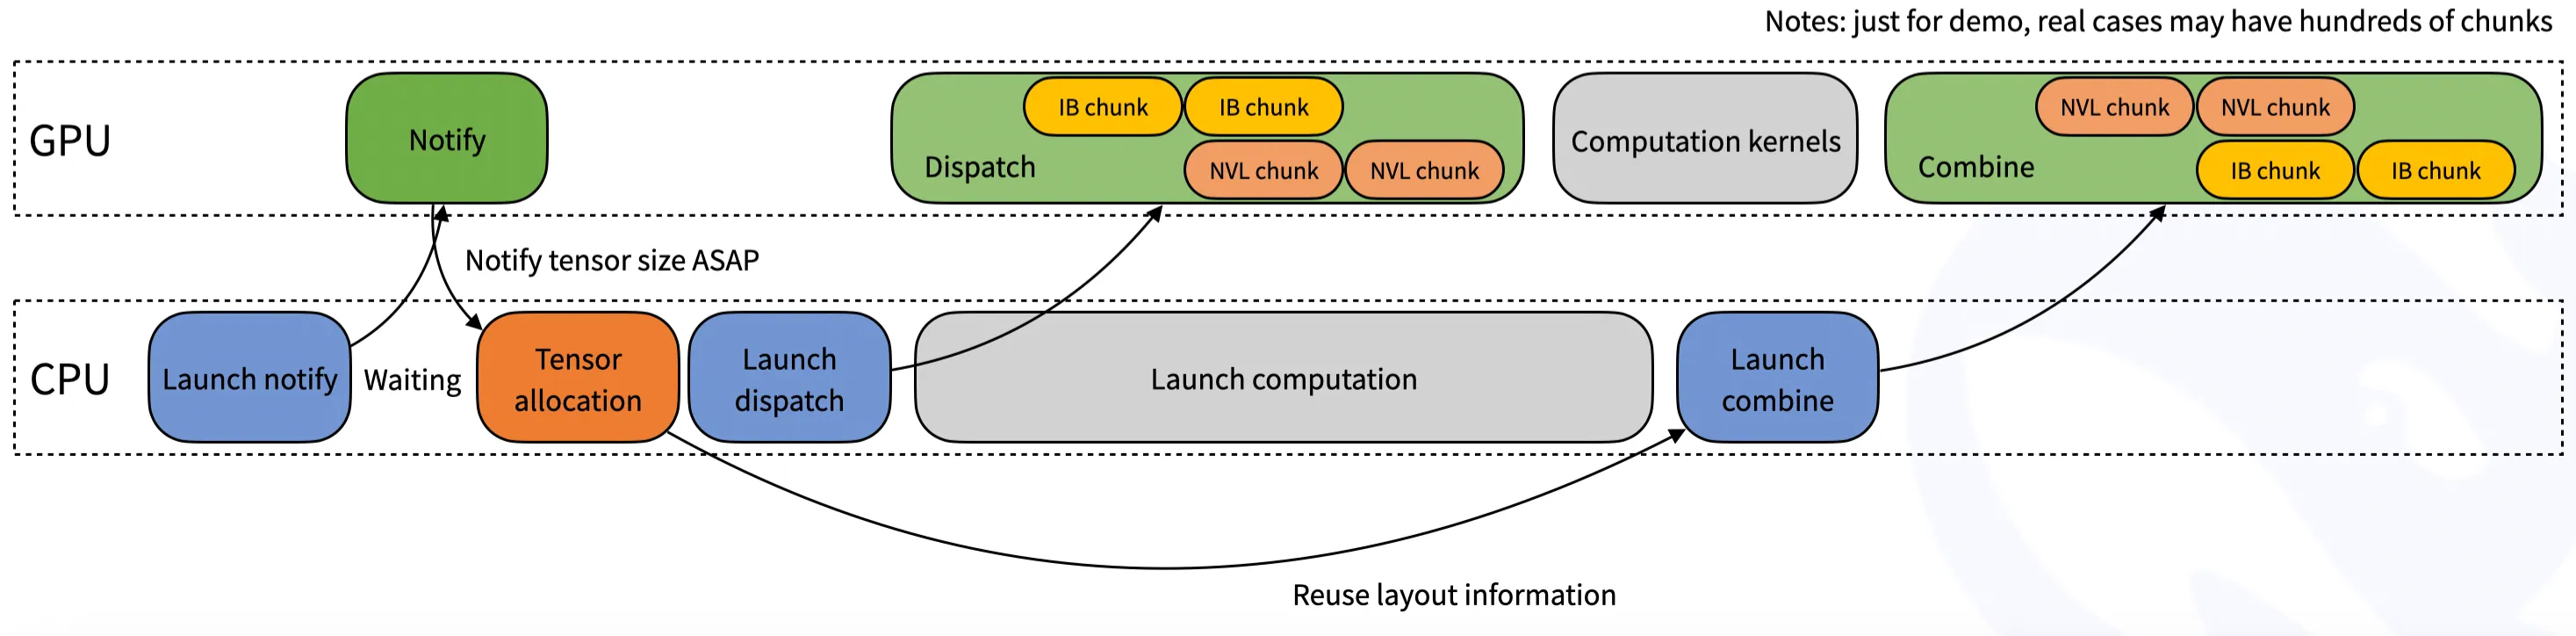
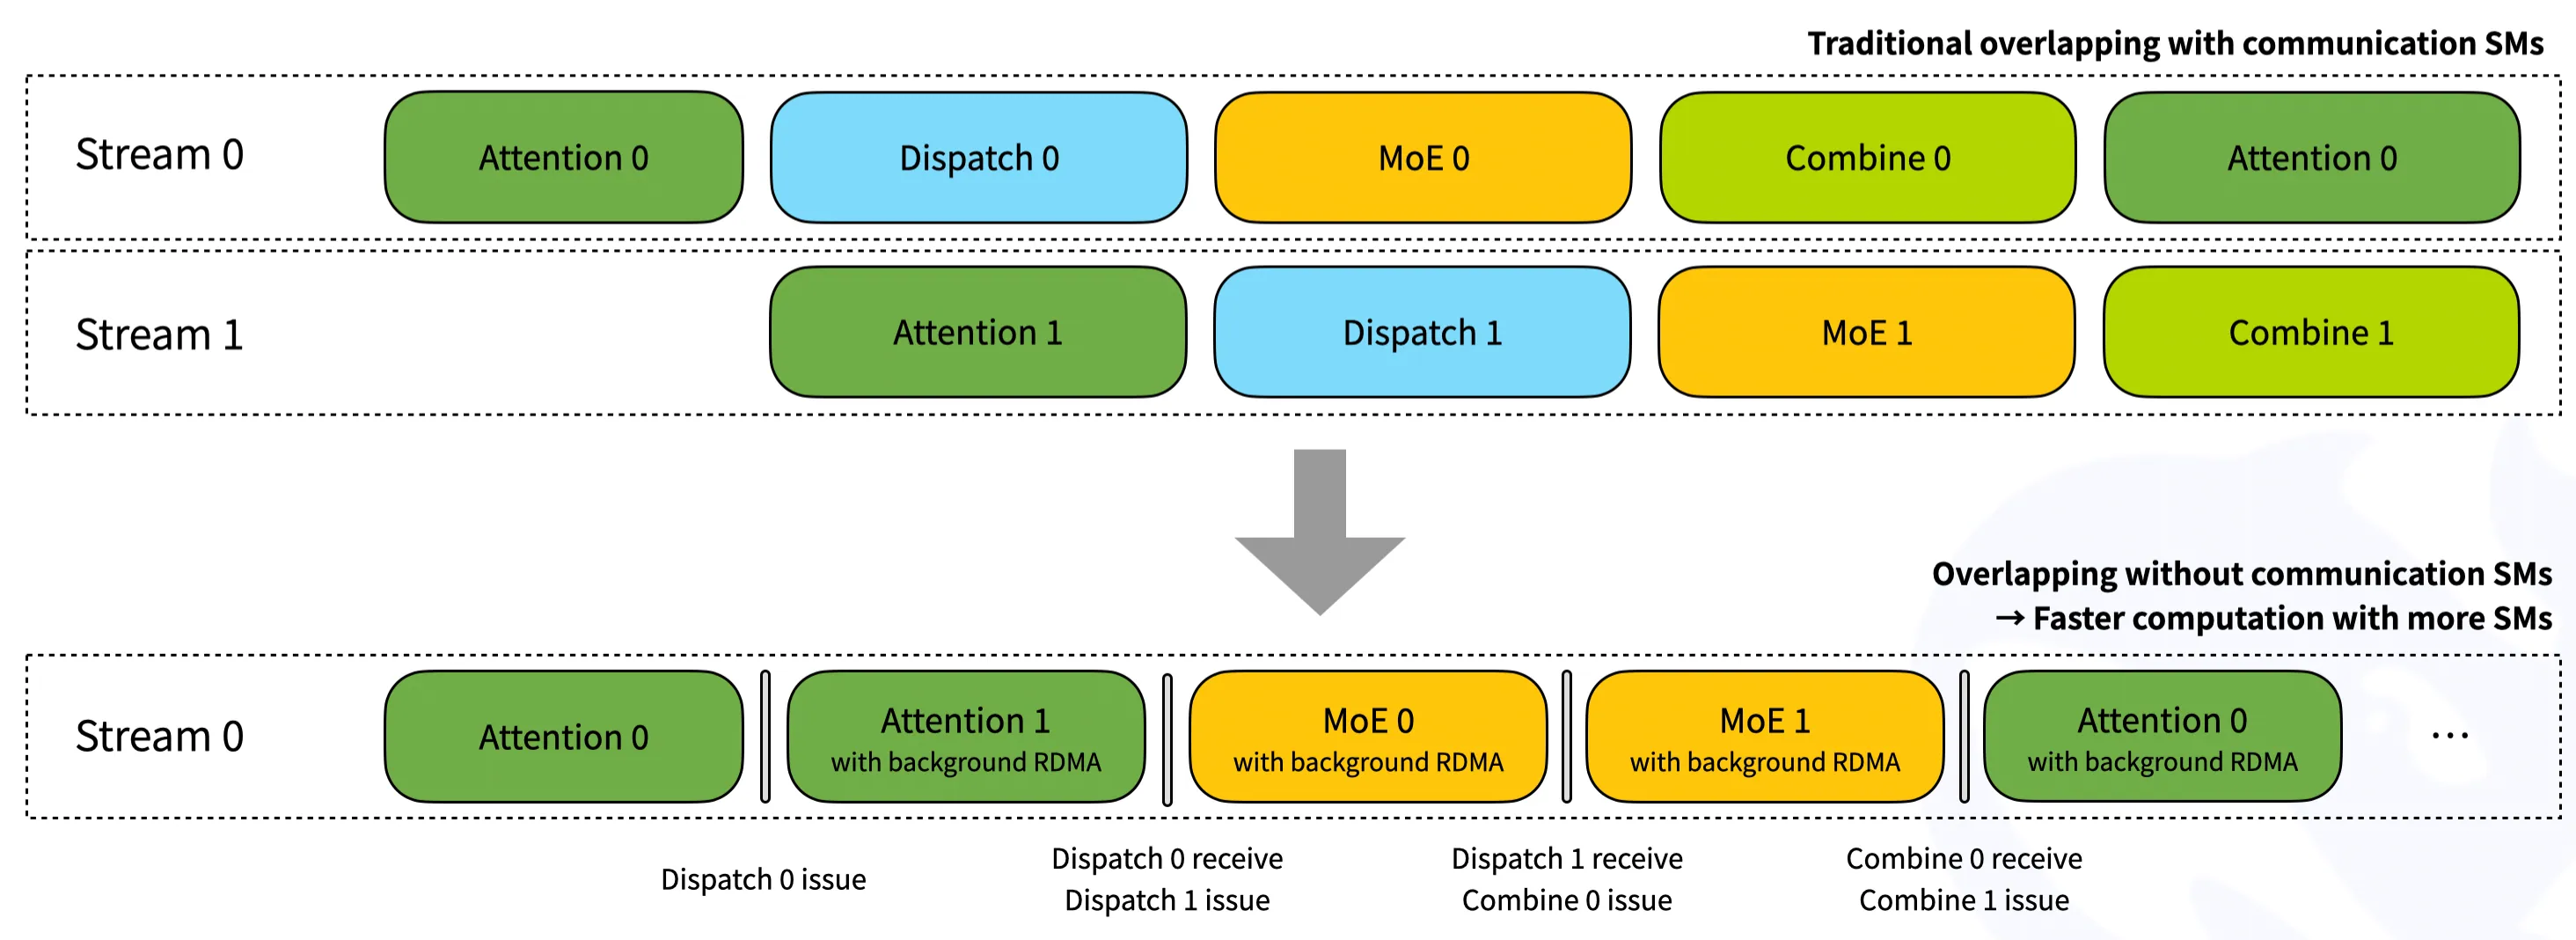
上面两张是官方仓库 README 的配图:高吞吐内核面向 prefill/训练的大块数据传输,低延迟内核面向 decode 的逐 token 小消息。需要说明的是,DeepEP 开源后迭代很快——V2 重构把高吞吐与低延迟 API 统一到单个 ElasticBuffer 接口下,通信后端从 NVSHMEM 换成更轻量的 NCCL Gin 后端(header-only,可复用现有 NCCL communicator),SM 与 QP 数量改为解析式计算(不再需要 auto-tuning),并把 EP 规模上限推到 EP2048;V1 里占 24 个 SM 的旧训练路径在 V2 里降到 4-6 个 SM,官方给出的对比是”峰值性能最高提升 1.3 倍,同时 SM 占用最多省 4 倍”。V2 的 decode 路径 API 形态大致如下(节选):
from deep_ep import ElasticBuffer
buf = ElasticBuffer(group, num_max_tokens_per_rank=..., hidden=..., ...)
# 每步 decode:路由没变就复用 cached_handle,跳过 CPU 同步recv_x, _, _, handle, event = buf.dispatch( x, handle=cached_handle, num_sms=..., async_with_compute_stream=True)# ... 先做不依赖 recv_x 的本地计算 ...event.current_stream_wait() # 需要结果时再等通信完成y = buf.combine(recv_x, handle=handle, ...)性能数字
官方在 V3 的配置(每 batch 8K token、hidden 7168、top-8 专家、FP8 dispatch + BF16 combine)下给出的带宽实测如下(逻辑带宽):
| 架构 | 网络拓扑 | Dispatch 瓶颈带宽 | Combine 瓶颈带宽 | 通信占用 SM |
|---|---|---|---|---|
| SM90 (Hopper) | EP 8 × 2 节点,CX7 RDMA | 90 GB/s | 81 GB/s | 12 |
| SM90 | EP 8 × 4 节点,CX7 RDMA | 61 GB/s | 61 GB/s | 6 |
| SM100 (Blackwell) | EP 8 单节点 NVLink | 726 GB/s | 740 GB/s | 64(满配) |
| SM100 | EP 8 单节点 NVLink | 643 GB/s | 675 GB/s | 24(最少 SM) |
两个读法:跨节点的数字(60-90 GB/s)是单张网卡的 RDMA 带宽量级,说明跨节点通信已经贴到 CX7 网卡上限;单节点 NVLink 的数字(700 GB/s 上下)意味着通信本身不再是瓶颈,可以安心把 SM 让回给计算——这就是”SM 越少越好”设计取舍的由来。作为对比,V2 相对 V1 在同样场景下峰值性能提升最高约 1.3 倍。要理解它和整个 MoE 推理链路如何配合(比如 decode 的低延迟路径如何与 DeepGEMM 的 masked GEMM 衔接),本站另有 DeepEP 完全拆解 与 DeepSeek-V3/R1 推理系统拆解 两篇深文。
怎么答才稳:30 秒版本——“DeepEP 是 DeepSeek 为 MoE 专家并行写的 dispatch/combine 通信库,拆高吞吐/低延迟两类内核,SM 预算可调、与专家计算重叠、支持 FP8,跨节点已把 RDMA 带宽跑满”。然后展开”为什么 MoE 需要专门的通信库”(不规则 all-to-all、默认实现不感知路由、通信计算难重叠),能提 V2 换 NCCL Gin 后端、SM 占用从 24 降到 4-6 就是真读过。
第五问:DeepGEMM
DeepGEMM 是同一批开源里与 DeepEP 打配合的FP8 GEMM 计算库(2025 年开源,同样持续迭代):为 Hopper(SM90)与 Blackwell(SM100)的 Tensor Core 提供 FP8/FP4/BF16 GEMM,代码量被刻意控制在很薄的水平,官方定位是”干净、强、灵活”,核心逻辑只有几百行。它从 CUTLASS/CuTe 借鉴了思想,但不重度依赖它们的模板与代数抽象——这也是它能拿来当”GPU kernel 优化教学材料”的原因。
面试要答的三个设计点
第一,1×128 细粒度缩放(per-block scaling)。FP8 的 E4M3 只有 4 位尾数,动态范围小,量化误差对离群值敏感,所以不能整个矩阵共用一个 scale(per-tensor),而要对矩阵分块、每块一个 scale。DeepGEMM 的布局是:权重在 K 方向按 1×128(1 行 × 128 列)分块,每块一个 FP32 scale。细粒度缩放让 GEMM 精度逼近 BF16,代价是 scale 本身也占带宽,所以要精心安排 scale 的内存布局(要求 TMA 对齐、转置摆放),让主 GEMM 的 wgmma 流水不被取 scale 拖累:
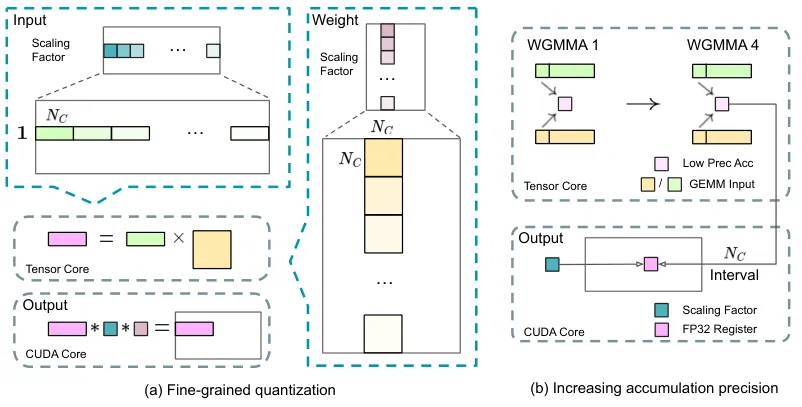
这里有个演进细节值得提:SM90 上 scale 用 FP32 存,到了 SM100 则用 UE8M0(无符号 8 位指数格式)并把 4 个 scale 打包进一个 int——Blackwell 的新数据格式把缩放代价进一步压掉,接口层面用户调 transform_sf_into_required_layout 之类的工具函数完成转换。
第二,面向 wgmma 的 kernel 结构与两级累加。DeepGEMM 默认输入布局是 NT(A 行主、B 列主),主循环用 Hopper 的 wgmma 异步流水把 FP8 乘累加喂给 Tensor Core;累加全程在寄存器里用 FP32 完成(两级累加的含义是:每个 wgmma 段内的局部累加先落在 FP32 累加器,跨段/跨 K 分块再汇总结算),中间不落低精度,这是 FP8 GEMM 精度与吞吐兼得的关键。整个 kernel 刻意不做手工 unroll,依赖 NVCC 编译期展开,代码因此异常短。
第三,全 JIT 编译。DeepGEMM 安装时不需要编译 CUDA——kernel 源码在运行时按实际 shape 现编译现缓存(JIT 模块缓存到 ~/.deep_gemm,支持 NVCC 或 NVRTC,后者编译速度快一个量级)。代价是首次调用有编译延迟,换来的是”一个库适配所有 shape、安装零负担”,这和 DeepEP 的 JIT 设计一脉相承。
API 形态与 MoE 特化
对外接口非常收敛:fp8_gemm_nt 等几个函数就是""的 NT 版(SM100 支持全部四种布局),核心是 grouped GEMM(分组 GEMM)——MoE 里每个专家是独立的小 GEMM,DeepGEMM 按 M 轴分组、N/K 固定(专家同构的前提),两种形态对应两种场景:
- contiguous(连续)布局:训练或 prefill 时 CPU 知道每个专家分到多少 token,把各专家的输入拼成一个大张量、记录每段边界,一次 kernel 扫完所有专家;
- masked(掩码)布局:decode 阶段启用了 CUDA Graph,CPU 每步都不知道各专家确切 token 数,于是带一张 mask,kernel 只算有效部分——官方文档里明说这个 API 就是为配合 DeepEP 低延迟内核的输出设计的。
# 一个 MoE 前向的示意:dispatch 后按专家分组做 FP8 GEMMdeep_gemm.m_grouped_fp8_gemm_nt_contiguous( x_fp8, x_sf, w_experts_fp8, w_sf, ...)最新版本还往前迈了一步:Mega MoE 融合 kernel 把 EP dispatch、第一层线性(FP8×FP4)、SwiGLU 激活、第二层线性、EP combine 全部融进一个 mega-kernel,让 NVLink 通信与 Tensor Core 计算在同一 kernel 内互相重叠(需要对称内存等多进程支持);另外还为 DeepSeek-V3.2 的闪电索引器(lightning indexer)提供了 MQA scoring kernel。它早已不是一个”300 行的教学 GEMM”,而是一套以 GEMM 为核心、向 MoE 全链路融合演进的算子库。
性能与地位
官方基准里,DeepGEMM 在 H800 上的 FP8 GEMM 峰值已报到 1550 TFLOPS,与 cuBLAS 这类厂商调优库持平或略优(官方原话是”性能匹敌甚至超过专家调优的库”);下面这张官方基准图给出的是不同 shape 下与 cuBLAS 的吞吐对比:
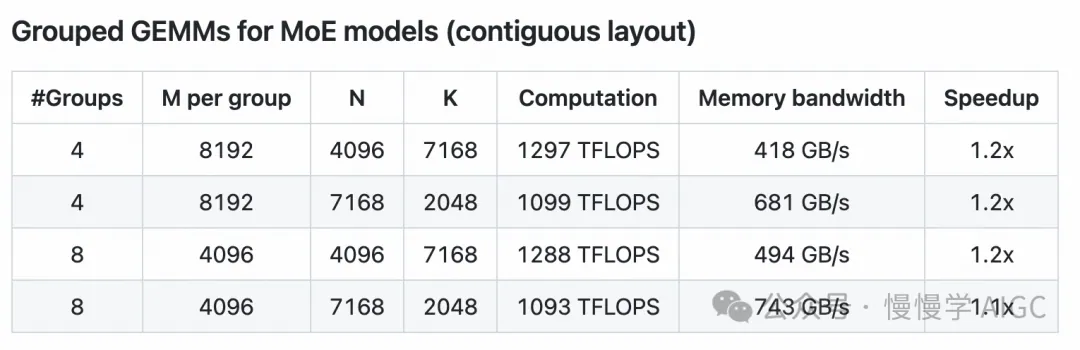
它在系统里的地位可以这样概括:CUTLASS 是给全行业用的重型模板库,DeepGEMM 是给自家模型量身裁的轻量刀——正因为只服务 DeepSeek 已知的 shape 与 MoE 结构,才能砍掉通用性、把代码压到几百行并逼近峰值。细节可参考本站 DeepGEMM 完全拆解。
怎么答才稳:把 DeepEP + DeepGEMM 当成一个整体故事讲——“MoE 推理 = 算力密集的专家 GEMM + 通信密集的 dispatch/combine,DeepSeek 用 DeepGEMM 把 GEMM 推到 FP8 硬件峰值,用 DeepEP 把通信跑到 RDMA/NVLink 上限,再用 masked grouped GEMM 衔接 decode 的通信输出”。能说出 1×128 缩放、两级累加、JIT、masked 布局这四个关键词,面试官就知道你不只是刷过新闻。
把这些答案串起来
最后给几个这组问题常见的追问方向,提前想想不吃亏:
- “如果让你在 vLLM 里集成 DeepEP 当 MoE 通信后端,你会动哪些文件?“——参考答案:vLLM 的模型执行在
gpu_model_runner,注意力/通信类算子通常以 kernel 或自定义 op 形式挂在模型 forward 里;真实做法往往是外层调度不动,把 EP 通信封装成算子并与现有张量并行的通信组对接(vLLM 的distributed层),这题考的是你对”后端抽象 + 注册表”这套插件机制的理解; - “装饰器还能在框架里怎么用?“——往注册表模式、路由注册、缓存、上下文管理四个方向想,vLLM/FastAPI 里都有现成例子;
- “KV 块结构体在 C++ 里你会怎么定义?“——考内存布局实战:字段顺序按对齐排、必要时
#pragma pack、CUDA 侧固定大小、Python 侧用 dataclass 记账、用 tensor 视图而不是逐对象复制; - “DeepEP 的 SM 预算和 FlashAttention 的占不满问题是一回事吗?“——本质都是”SM 是稀缺资源,kernel 之间要分账”,但前者是跨 kernel 重叠的显式预算,后者是单 kernel 内部利用率问题,能区分开说明你真的理解 GPU 执行模型。
四组问题背后的共同主线只有一句话:一个推理系统工程师的功夫,一半在”知道每个字节放在哪、每个 kernel 为什么这么写”,一半在”拿到一个陌生系统能顺着源码把数据流走通”。前者靠语言功底与 GPU 体系结构,后者靠读源码的方法论——这份问答想做的,就是把这两条线都串起来。
参考资料
- vLLM 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023)
- vLLM 官方 GitHub 仓库
- DeepEP 官方 GitHub 仓库
- DeepGEMM 官方 GitHub 仓库
- DeepSeek-V3 技术报告(arXiv:2412.19437)
- PEP 318:函数与方法的装饰器
- Python 官方文档:functools(wraps/update_wrapper)
- Python 官方文档:数据模型(对象、属性访问与描述符)
- Python 官方文档:struct 模块
- cppreference:C++ 类(class/struct)
- Visual Studio Blog:C++ 类的大小、对齐与内存布局(含配图)
- Real Python:Primer on Python Decorators
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


