


GPTQ 完全拆解:二阶信息驱动的权重量化,如何把 175B 模型塞进一张 A100
引言:350 GB 的模型,与一场关于舍入的战争
把一个大语言模型部署到生产环境,第一道坎永远是内存。GPT-3 有 1750 亿参数,FP16 精度下需要 326 GB(按 1024 进制计数;十进制约 350 GB)内存,而 2022 年最强的单卡 A100 也只有 80 GB——论文里的原话是,FP16 推理需要 5 张 80GB A100 才能装下。多卡部署意味着更贵的机器、更复杂的并行策略、更高的服务成本。如果能无损地把模型压到 1/4 体积,一张卡就能跑,成本结构完全不同。
压内存最直接的手段是量化(Quantization):把权重从 FP16(16 位)压到 INT4(4 位),体积直接除以 4。难点在于舍入。最邻近舍入(RTN,Round-to-Nearest)——把每个权重四舍五入到最近的量化格点上——实现最简单,8-bit 时几乎无损,但压到 4-bit 以下误差就失控了。以论文的实测为例:OPT-175B 在 WikiText-2 上 FP16 困惑度(PPL,越低越好)是 8.34,RTN 4-bit 直接掉到 10.54,RTN 3-bit 更是崩到 7300——模型基本不会说人话了。
有没有办法在”训练完之后,不动训练”的前提下,让舍入这件事聪明一点?2022 年 10 月,IST Austria 的 Elias Frantar 联合 ETH Zürich 的 Saleh Ashkboos、Torsten Hoefler 与 Dan Alistarh 在 arXiv 上发表了 GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(arXiv:2210.17323),2023 年 5 月以口头报告(oral)身份亮相 ICLR 2023。它的成绩单是:用约 4 个 GPU 小时把 OPT-175B 压到 3-4 bit,精度几乎无损(4-bit 下 PPL 只涨 0.03),并首次让 175B 模型在单张 A100 上完成生成推理;配合专门的 kernel,比 5 卡 FP16 部署还快 3.25 倍。这个”压缩率翻倍且精度不掉的 weight-only 量化方法”,从此成为大模型量化的事实标准之一——llama.cpp、AutoGPTQ、ExLlama、vLLM 等推理栈至今都在用 GPTQ 格式的模型。
GPTQ 并不是从零发明的理论,而是把一个 30 年前的老算法——最优脑外科手术(OBS,Optimal Brain Surgeon)——从”剪枝”改造成”量化”,再用三个工程技巧把它的复杂度从”量化 175B 需要几百年”压到”四小时”。这篇文章会从剪枝理论讲起,完整推导 OBS 的公式,拆解 GPTQ 的三步改造和最终算法,再用论文的完整实验数据验证每一步决策,最后把它放在量化方法地图上与 AWQ 对照。
从剪枝到量化:OBS 家族的技术谱系
一个旧问题:哪些权重可以动,动了怎么补
神经网络压缩的经典问题,早在 1989-1992 年就被研究过:如果必须删掉(或量化)某些权重,怎么让损失函数掉得最少?
1990 年 LeCun 等人提出最优脑损伤(OBD,Optimal Brain Damage),用损失函数对权重的二阶导数(Hessian 的对角线)衡量每个权重的重要性,删掉”重要性最低”的权重。但 OBD 有个致命简化:它假设权重之间互不影响,只保留了 Hessian 的对角线。
1992 年,Hassibi 和 Stork 在 NIPS 上发表了 Second order derivatives for network pruning: Optimal Brain Surgeon,提出 OBS:考虑完整的 Hessian 矩阵,并且不光选”删哪个”,还给出”删掉它之后,剩余权重应该怎么调整来最小化损失增量”的闭式解。这个”删一个、补一群”的思想,是后面一切工作的种子。为方便对比,OBD 的对应论文是 Optimal Brain Damage。
2022 年,Frantar 和 Alistarh 在 NeurIPS 2022 发表了 OBQ: Optimal Brain Compression: A framework for accurate post-training quantization and pruning,把 OBS 从剪枝推广到量化:把权重置零(剪枝)本质上是”量化到 0 点”的特例,那 OBS 的整套公式自然可以搬到量化上。OBQ 第一次让”用二阶信息做训练后量化”在小模型(ResNet、BERT 量级)上可行。
GPTQ 就是这个谱系的最新一环:OBD → OBS → OBQ → GPTQ,每一代解决前一代的规模瓶颈。下面先完整推导 OBS/OBQ 的核心公式,因为 GPTQ 的所有改动都是围绕它们做的。
逐层量化:把整模型问题切成单层问题
训练后量化(PTQ,Post-Training Quantization)的标准流程是逐层量化(layer-wise quantization):拿一小段校准数据前向跑一遍模型,缓存每一层的输入,然后逐层求解”量化后的权重让这一层输出误差最小”的优化问题。
形式上,设某线性层权重为 (), 是校准数据在该层的输入(, 个样本),目标是找一个量化权重矩阵 ,使量化前后的层输出尽量一致:
其中量化网格(格点集合)在量化前就固定好,每个权重允许自由移动(这正是与 AdaRound 等”逐权重决定向上还是向下舍入”方法的区别:OBQ 家族不满足于±1 格的选择,而是允许权重在网格之外连续移动,靠补偿来弥补)。
把目标函数按 的行拆开,每行的优化独立:
其中 是 的一行。关键观察:这是一个关于 的二次型,它的 Hessian 是:
注意 只依赖输入 ,与权重 的取值完全无关。这一点是整个故事的地基,后面会反复用到。
OBS 公式:量化一个权重,最优地补偿所有剩余权重
设当前这一行还有一组未量化的权重集合 。要量化其中的 到 。相当于对权重向量施加一个扰动 ,其中第 个分量被锁定为 ,其余分量自由调整。我们希望其余分量的调整让损失增量最小。
对损失函数 在当前位置做二阶泰勒展开。假设模型已训练收敛,梯度 :
约束条件是 ( 是第 个标准单位向量,即只有第 个分量被锁死)。用拉格朗日乘子法解这个约束二次规划:
对 求导置零:,即 。代回约束:,解出 。于是最优更新为:
其中 是逆矩阵的第 列, 是第 个对角元。对应地,这个操作带来的损失增量是:
于是”下一个量化谁”的贪心准则一目了然:量化误差平方除以对应的逆对角元,谁最小先量化谁:
直观理解这个公式:分子是”直接舍入的误差平方”,分母是”该权重位置上的逆 Hessian 对角元”。分母越大说明该方向上的误差越难通过其他权重补偿(逆对角线大 ≈ Hessian 该方向曲率小、误差在损失空间里”便宜”),需要优先处理;分母越小说明这个权重的误差很容易被其他权重吸收,可以留到后面。注意 可以落在任意量化网格值上——当网格只有 一个点时,上述公式就退化成剪枝(把权重置 0),这就是 OBQ 统一剪枝与量化的原因。
一个玩具例子:把公式跑一遍
公式容易让人头晕,用一个小例子走一遍。设一行权重 ,输入 (2 个输入维 × 2 个样本)。则:
量化网格取 (2-bit 量级的演示网格)。先算两个候选的贪心准则值:
- 量化 :误差 ,准则值 ;
- 量化 :误差 ,准则值 。
OBS 会先量化 (它的误差在损失空间里便宜得多)。量化 后,对剩余权重 的最优补偿是:
即 从 被推到 ,用来部分抵消 被量化造成的输出偏差。两个细节值得注意:第一,补偿的方向由 的非对角元决定——如果两个权重互不相关( 是对角的), 非对角元为 0,补偿就传不过去;本例中 非对角元 0.6 说明两个输入特征相关, 才”帮得上忙”。第二,两维玩具里只有一个剩余权重可以分担误差,补偿收益有限(量化后层输出距离从 0.204 降到 0.197);真实线性层有几千列,误差被摊到所有剩余权重上,且 OBQ 反复迭代”量化一个、补偿一群”,效果才显现——这也是后面实验部分的重点。
OBQ 的复杂度诅咒
量化一个权重后, 少了一个元素,下次要用 。从头重算逆矩阵是 级别,太贵。好在删除一行一列后的逆可以就地更新——这对应一次高斯消元:
(论文原文该式下标有个笔误,此处按正确形式给出。)这是个秩一更新, 就能完成。
但 OBQ 整体仍然很慢,慢在贪心顺序:每一行独立运行算法,每量化一个权重都要重新扫描全行找准则值最小的下一个目标,并各自维护自己的 (因为各行删列的先后顺序不同, 不同)。对 的权重矩阵,复杂度是 。论文报告,OBQ 量化一个 ResNet-50(2500 万参数)要约 1 个 GPU 小时。线性外推:175B 模型光一层就有数千×数千的矩阵,整体需要几百年。这就是 GPTQ 要解决的问题。
GPTQ 核心思想:三步把 OBQ 推向千亿参数
GPTQ(名称由 OPT 家族名与 PTQ 缩写合并而来)对 OBQ 做了三处改造,每处都对应一个独立的观察。作者称之为”超过三个数量级的计算加速”。
第一步:放弃贪心顺序(Arbitrary Order Insight)
第一处改造最反直觉:量化顺序根本不重要。论文发现,贪心选择”当前误差最小”的权重固然合理,但和”按任意固定顺序量化”相比,最终误差几乎一样,尤其在大模型的宽层上。论文给出的解释是:贪心顺序确实减少了”单个大误差权重”的数量,但这些大误差权重被拖到流程后期才量化——到那时剩余的、可用来补偿的权重已经很少,补偿能力大打折扣。两个效应互相抵消。
这个观察的工程后果是巨大的。既然顺序可以任意定,就定一个对所有行都相同的顺序(比如按列从左到右)。于是:
- 任何时刻,所有行的未量化集合 都相同;
- 只依赖输入、不依赖权重,所以所有行共享同一个 ,它只随”删了哪些列”变化;
- 的更新(上式)每行只需要做 次(每删一列做一次),而不是 次(每量化一个权重做一次)。
复杂度从 降到 ,即快 倍——对大规模模型这是几个数量级的差距。
第二步:懒惰批量更新(Lazy Batch-Updates)
顺序问题解决了,但直接实现仍然慢,瓶颈从计算变成了内存带宽。看更新公式:每次更新要对一个巨大的矩阵 做外积叠加,而每个矩阵元素只摊到几个浮点运算——这种”算得少、读得多”的操作没法喂饱 GPU 的算力,被显存带宽卡死。
论文的关键观察是:第 列的舍入决策只受施加在 列上的更新影响,施加在更后面列上的更新与当前决策无关。所以更新可以”攒着”:
- 把 列分成大小为 的块;
- 块内部逐列量化,误差只补偿到块内的剩余列(以及 对应的 子块);
- 一个块全部处理完后,才用批量版公式一次性把误差传播到所有块外的剩余权重。
批量版公式( 是刚量化的一组列的下标集合, 是删去 行 列后的逆矩阵):
单个权重版的 是 为单元素时的特例:标量除法变成 矩阵求逆( 时开销可忽略),外积变成矩阵乘。论文报告这带来约一个数量级的实际加速,是算法能跑到 175B 规模的关键组件。
第三步:Cholesky 重构(Cholesky Reformulation)
最后一个问题是数值稳定性。反复用高斯消元式就地更新 会累积舍入误差;一旦 失去正定性(变成 indefinite),补偿更新的方向就会出错,把剩余权重往错误方向推,导致该层量化结果彻底崩溃。论文观察:模型超过几十亿参数时,几乎必然有若干层出这个问题,而且模型越大越容易发生。
小模型时代有个补救:阻尼(dampening)——给 的对角线加一个小常数 (论文固定取对角线平均值的 1%),相当于给优化加一个小的 正则,拉回病态方向。但大模型只靠阻尼不够。
论文注意到一件事:量化 时,我们真正需要的只是 的第 行(从对角元开始往右),而不是整个矩阵。而这些行可以一次性、用数值上稳定得多的方式预计算出来——Cholesky 分解。对称正定矩阵有 ( 为下三角)。对比高斯消元式更新与 Cholesky 消元:两者每一步做的事情几乎一样,只是 Cholesky 把第 行多除了一个 的归一化因子。也就是说,把 做一次 Cholesky 分解,得到的三角因子就包含了整个量化过程中需要的全部逆信息,完全不需要反复求逆。论文强调:配合轻度阻尼,用 Cholesky 重构后的算法在千亿参数模型上运行稳定,且成熟的 Cholesky kernel 本身就很快,白赚一笔速度。
完整算法:Algorithm 1 逐行解读
把三步合起来,就是论文的 Algorithm 1。这里给出与原文一致的伪代码:
输入:权重矩阵 W(d_row × d_col), H^{-1} = (2XX^T + λI)^{-1}(由校准输入算出的逆 Hessian), 块大小 B(论文用 128)
Q ← 0_{d_row × d_col} # 量化输出矩阵E ← 0_{d_row × B} # 块内量化误差暂存H^{-1} ← Cholesky(H^{-1})^T # 用三角因子替代逆矩阵
for i = 0, B, 2B, ...: # 外层循环:逐块处理 for j = i, ..., i+B-1: # 内层循环:块内逐列量化 Q_{:,j} ← quant(W_{:,j}) # 1. 量化第 j 列 E_{:,j-i} ← (W_{:,j} - Q_{:,j}) / [H^{-1}]_{jj} # 2. 列误差除以对角元 W_{:,j:(i+B)} ← W_{:,j:(i+B)} - E_{:,j-i} · H^{-1}_{j,j:(i+B)} # 3. 把这一列的误差补偿到块内剩余列 W_{:,(i+B):} ← W_{:,(i+B):} - E · H^{-1}_{i:(i+B),(i+B):} # 4. 块结束后,把所有块内误差一次性补偿到块外剩余列逐行解释:
- 第 1 步把第 列直接舍入到网格(
quant对每个元素独立作用)。注意此时 的第 列已经被前面步骤的补偿更新过,量化的是”被修正过的权重”。 - 第 2 步计算列量化误差向量,除以 ——这正是 OBS 公式 中”标量部分”的负值(符号在下一步的外积里处理)。 此时从 Cholesky 因子的对角元读取。
- 第 3 步是块内的误差补偿:把第 列的误差按 的第 行权重分摊给块内还没量化的列( 到 )。外积更新,每列只动 。
- 第 4 步是懒惰批量更新的收尾:整个 列块量化完成后,把暂存在 里的全部误差一次性外推给块外的所有列。矩阵乘形式,GPU 友好。
内层循环结束后, 里存的就是量化后的权重; 本身被原地改成了”补偿后的残差”,块外列会在后续块中被继续量化——这正是”整个矩阵只被读几轮”的懒惰设计。
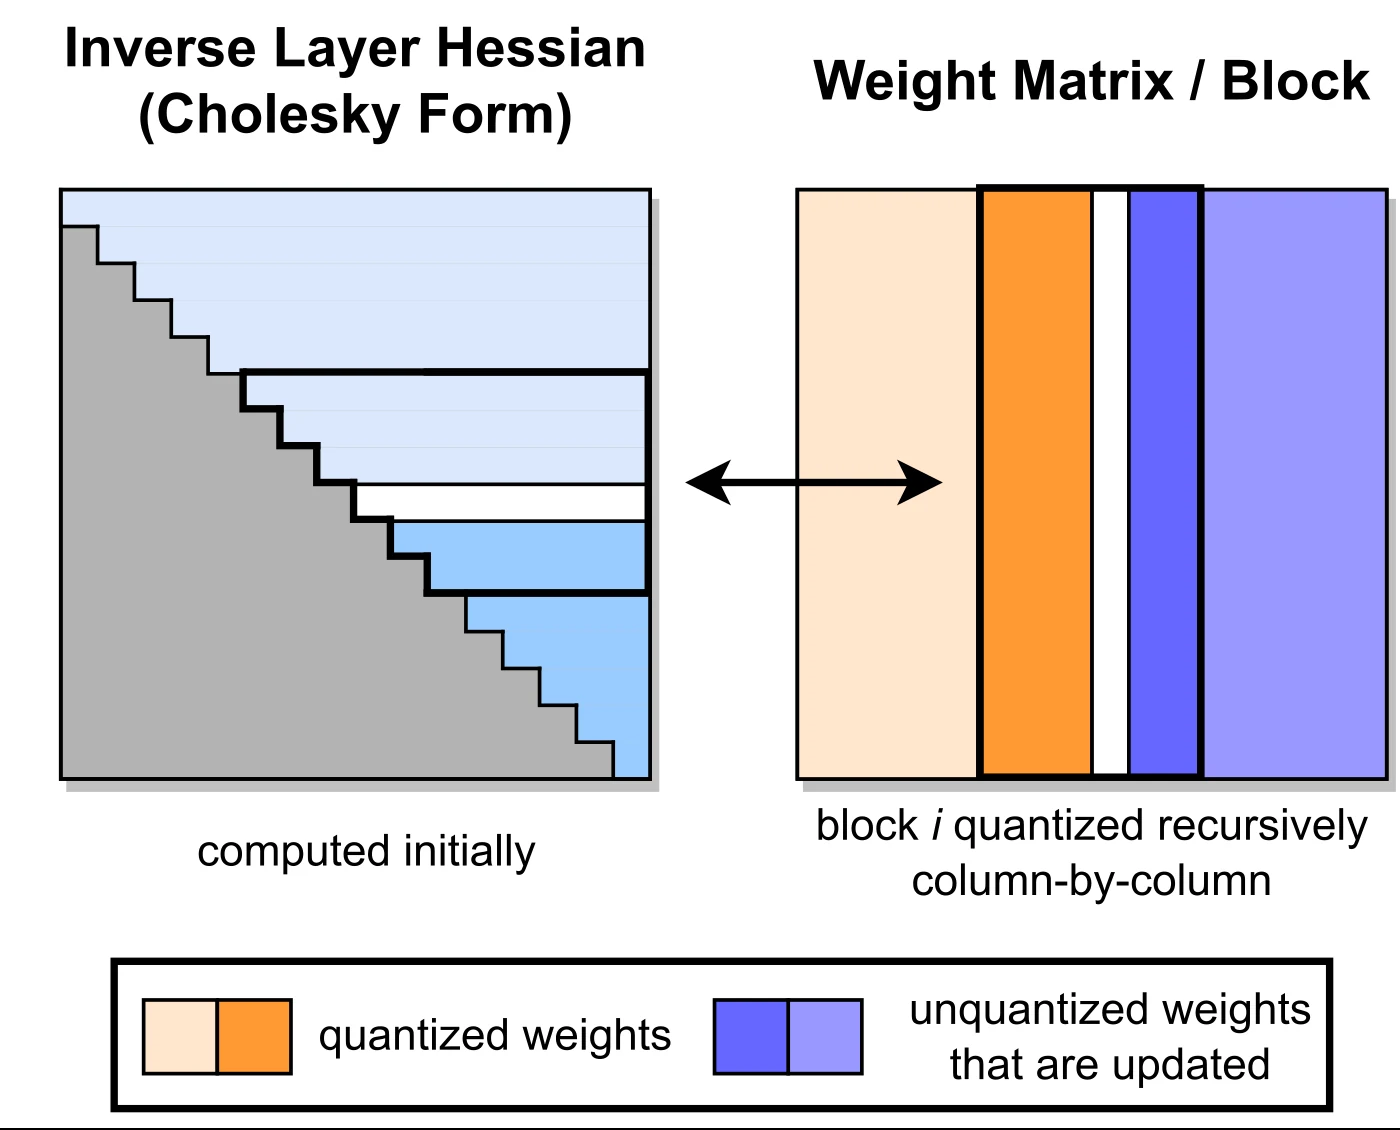
论文还贴了一个小图(论文 Figure 2)说明分块流程:加粗的连续列是当前正在量化的块,块内白色中间列是正在被量化的那一列,蓝色是等待更新的剩余权重。下面这张图就是论文原图:
工程细节:128 条序列、逐块量化与分组
算法讲完了,但”能在纸上跑”和”能在 80GB 显存里跑 175B 模型”之间还有一层工程。
校准数据。 GPTQ 的全部校准数据是 C4 数据集的 128 段、每段 2048 token 的随机片段——即随机网页文本。论文强调这意味着 GPTQ 没有见过任何任务特定数据,评估结果仍然是真正的”零样本”。每段 2048 token 对应每个线性层 个激活样本,足以估计每层的 。
显存控制。 175B 模型全量 FP16 要 350 GB,校准阶段如何不把模型全塞进显存?论文的做法是一次只处理一个 Transformer block(含 6 层):把当前 block 加载进显存,算完该 block 各层的 Hessian 并完成量化,然后把量化后的 block 前向跑一遍,得到下一 block 的输入,再加载下一个 block。这里有个微妙但重要的细节:下一 block 的校准输入不是来自全精度模型,而是来自”已经被量化过一部分”的模型。论文发现这带来明显的精度提升,而且几乎零成本——因为量化本身就在逐块推进,激活本来就现成。
量化网格。 论文默认用 per-row(逐行)的非对称 min-max 网格,与 LLM.int8() 的网格设置一致(这也是 RTN 基线能直接对标 LLM.int8() 的原因)。组大小默认 -1(即 per-channel/per-row,无分组),但论文强调 GPTQ 与任何量化网格都兼容——包括分组量化(group quantization)。
分组量化(grouping)。 分组是把连续 个权重共用一个 scale/zero-point。论文在 175B 模型上测了三档(WikiText-2 PPL,3-bit):
| 设置 | OPT-175B | BLOOM-176B |
|---|---|---|
| FP16 基线 | 8.34 | 8.11 |
| GPTQ 3-bit 无分组 | 8.68 | 8.64 |
| GPTQ 3-bit g1024(约 +0.02 bit) | 8.45 | 8.35 |
| GPTQ 3-bit g128(约 +0.15 bit) | 8.45 | 8.26 |
分组把 PPL 又拉回 0.1-0.3 以内。论文的解释是:分组和 GPTQ 特别合拍——每组的 scale 可以在该层量化过程中用最新更新的权重确定,始终基于最准确的信息。注意这里有个常见的混淆点:GPTQ 论文默认不分组,4-bit 时单靠算法本身就接近无损;后来的社区实现(AutoGPTQ、ExLlama)把 g128 作为默认配置,是因为它在 3-bit 低位下还能再救回一截,这属于工程经验而非论文默认。
运行时。 单张 A100-80GB 上,完整量化 OPT 系列的时间:13B 用时 20.9 分钟、30B 用时 44.9 分钟、66B 用时 1.6 小时、175B 用时 4.2 小时;BLOOM-176B 用时 3.8 小时。作为对照,当时的 SOTA 方法 ZeroQuant-LKD 在 1.3B 模型上就要约 3 小时——线性外推到 175B 是几百小时(数周),而 GPTQ 量化比它大 100 倍的模型只用了约 4 小时。
--act-order 与 --true-sequential(代码仓库里的两个补丁)。 论文发布后,社区发现 GPTQ 在 LLaMA-7B 上表现异常差。官方仓库(IST-DASLab/gptq)随后加入两个技巧修复:--act-order 按激活幅度降序量化列(对应 Hessian 对角元大的列优先),--true-sequential 让 Transformer block 内部的层也按顺序逐层量化而不是整块并行。两者配合把 LLaMA-7B 的 4-bit WikiText-2 PPL 从 7.15 修到 6.09(FP16 是 5.68),OPT-66B 这个”离群模型”的 4-bit 从 9.55 修到 9.34、3-bit 从 14.16 修到 9.95。act-order 的出现也说明一个道理:固定顺序在大多数模型上够用,但 Hessian 对角元异常悬殊的层需要更聪明的顺序——这是 AWQ 论文批评 GPTQ”实现脆弱”的主要依据之一,后面对比部分会展开。
实验结果:3-4 bit 接近无损,RTN 全线崩溃
全家族 WikiText-2 困惑度
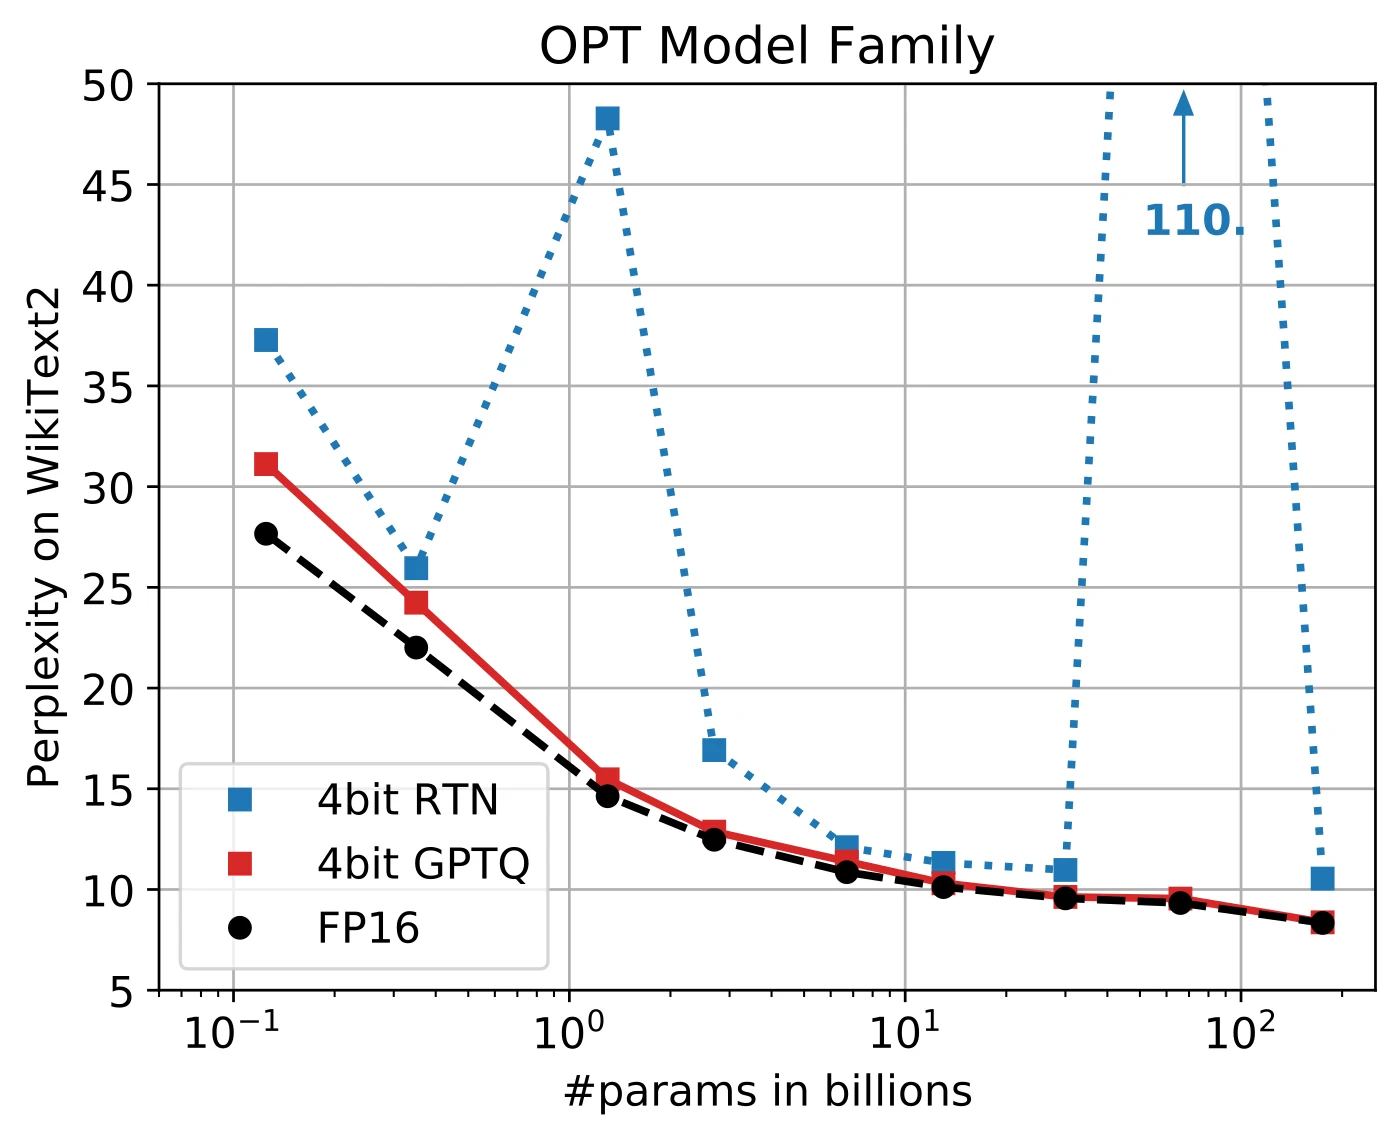
论文的核心实验是 OPT(125M 到 175B 九个尺寸)和 BLOOM(560M 到 176B 六个尺寸)两大模型家族全部量化到 3-bit 和 4-bit,在 WikiText-2 上测 PPL。下表是 OPT 全家族的结果(论文 Table 3):
| 位宽 | 125M | 350M | 1.3B | 2.7B | 6.7B | 13B | 30B | 66B | 175B |
|---|---|---|---|---|---|---|---|---|---|
| FP16 | 27.65 | 22.00 | 14.63 | 12.47 | 10.86 | 10.13 | 9.56 | 9.34 | 8.34 |
| RTN 4-bit | 37.28 | 25.94 | 48.17 | 16.92 | 12.10 | 11.32 | 10.98 | 110 | 10.54 |
| GPTQ 4-bit | 31.12 | 24.24 | 15.47 | 12.87 | 11.39 | 10.31 | 9.63 | 9.55 | 8.37 |
| RTN 3-bit | 1300 | 64.57 | 1.3e4 | 1.6e4 | 5.8e3 | 3.4e3 | 1.6e3 | 6.1e3 | 7.3e3 |
| GPTQ 3-bit | 53.85 | 33.79 | 20.97 | 16.88 | 14.86 | 11.61 | 10.27 | 14.16 | 8.68 |
读这张表抓住四个要点:
- 175B 上 4-bit 几乎无损:GPTQ 8.37 vs FP16 8.34,只涨 0.03;而 RTN 掉 2.2 个点(10.54),比小 10 倍的 FP16 13B 模型(10.13)还差。
- 3-bit 时 RTN 全线崩溃:RTN 3-bit 在大多数模型上 PPL 破千甚至破万(1300 到 1.6e4),基本不可用;GPTQ 3-bit 在 175B 上仍有 8.68。
- 模型越大越好量化:从 125M 到 175B,GPTQ 相对 RTN 的优势单调扩大。这是论文强调的”好消息”——压缩最必要的地方(大模型)恰好是最容易压的地方。唯一的例外是 OPT-66B(3-bit 掉到 14.16),论文归因于该模型的早期层有大量死亡单元(dead units)。
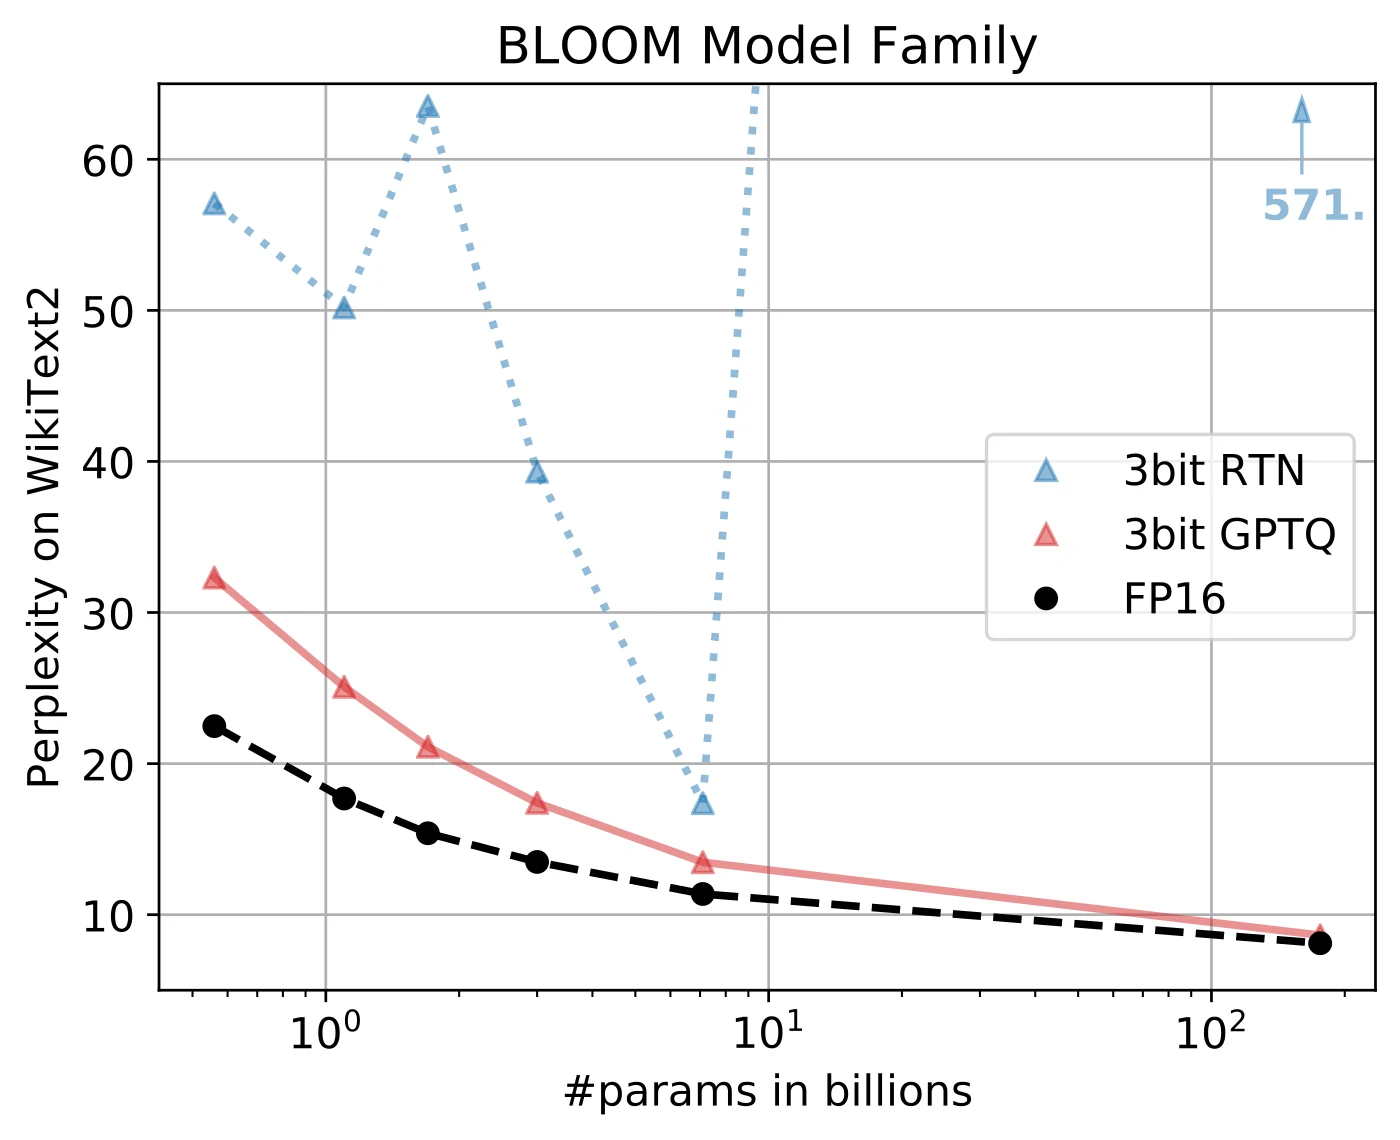
- BLOOM 家族模式相同:BLOOM-176B 上 GPTQ 4-bit 8.21 vs FP16 8.11,3-bit 8.64;只是方法间差距普遍更小——BLOOM 整体更好量化。
论文 Figure 1 用曲线图直观展示了”模型越大、量化损失越小”的趋势(左:OPT 全家族 4-bit;右:BLOOM 全家族 3-bit,与 FP16 基线和 RTN 对比):
175B 双雄:四项任务全景
论文对 OPT-175B 和 BLOOM-176B 做了最详细的评估(WikiText-2、PTB、C4 三个困惑度任务 + LAMBADA 零样本任务,论文 Table 5):
| 方法 | OPT-175B(Wiki2 / PTB / C4 / LAMBADA↑) | BLOOM-176B(Wiki2 / PTB / C4 / LAMBADA↑) |
|---|---|---|
| FP16 基线 | 8.34 / 12.01 / 10.13 / 75.59 | 8.11 / 14.59 / 11.71 / 67.40 |
| RTN 4-bit | 10.54 / 14.22 / 11.61 / 71.34 | 8.37 / 15.00 / 12.04 / 66.70 |
| GPTQ 4-bit | 8.37 / 12.26 / 10.28 / 76.80 | 8.21 / 14.75 / 11.81 / 67.71 |
| RTN 3-bit | 7.3e3 / 8.0e3 / 4.6e3 / 0 | 571 / 107 / 598 / 0.17 |
| GPTQ 3-bit | 8.68 / 12.68 / 10.67 / 76.19 | 8.64 / 15.57 / 12.27 / 65.10 |
| GPTQ 3-bit g1024 | 8.45 / 12.48 / 10.47 / 77.39 | 8.35 / 15.01 / 11.98 / 67.47 |
| GPTQ 3-bit g128 | 8.45 / 12.37 / 10.36 / 76.42 | 8.26 / 14.89 / 11.85 / 67.86 |
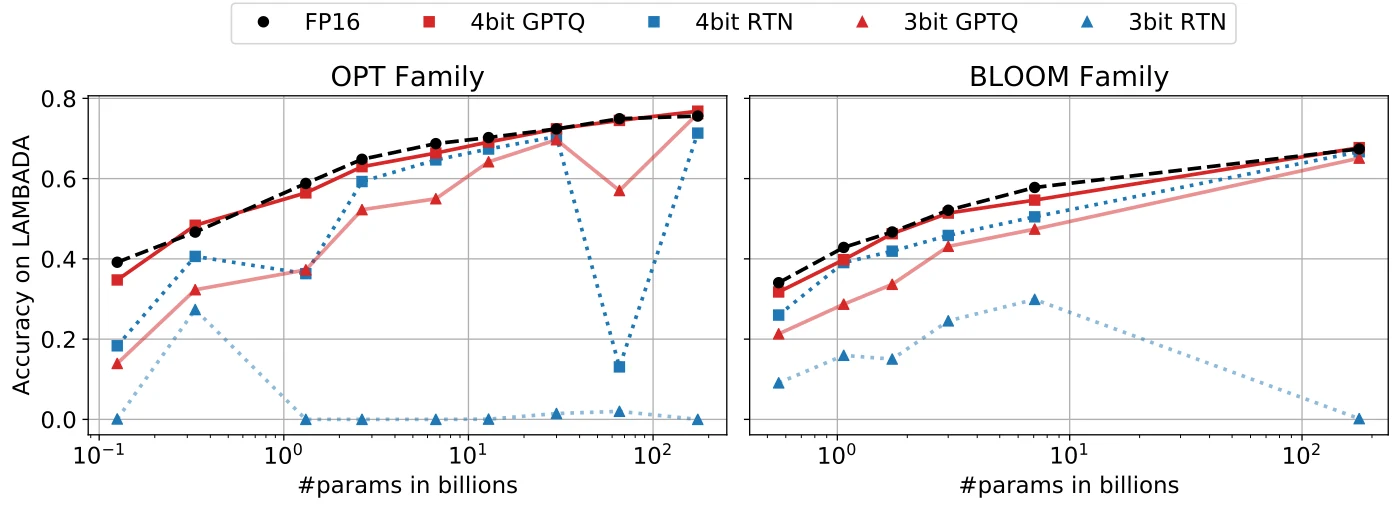
一个有意思的现象:LAMBADA 上 4-bit 的 GPTQ 甚至超过了 FP16 基线(75.59 → 76.80)。论文的解释是 LAMBADA 这类任务对”常见 token 的预测”更敏感,而量化相当于给权重施加了一个轻微的正则化,平滑了某些过拟合的权重——量化偶尔当正则用,这在剪枝文献里也不是新鲜事(“pruning as regularization”)。注意 3-bit 下 RTN 在 LAMBADA 上直接得 0 分,而 GPTQ 还能保持 76 分。
零样本任务与分组效果
论文 Figure 3 把 OPT 和 BLOOM 各模型量化后在 LAMBADA 上的准确率画成条形图:4-bit 时即使是 RTN 也表现尚可,3-bit 时 RTN 全面崩溃而 GPTQ 保持稳定:
分组在中等模型上的效果用 Figure 4 展示(OPT 中等型号 4-bit,对比 g128/g64/g32):分组越细(g 越小),PPL 越接近 FP16:
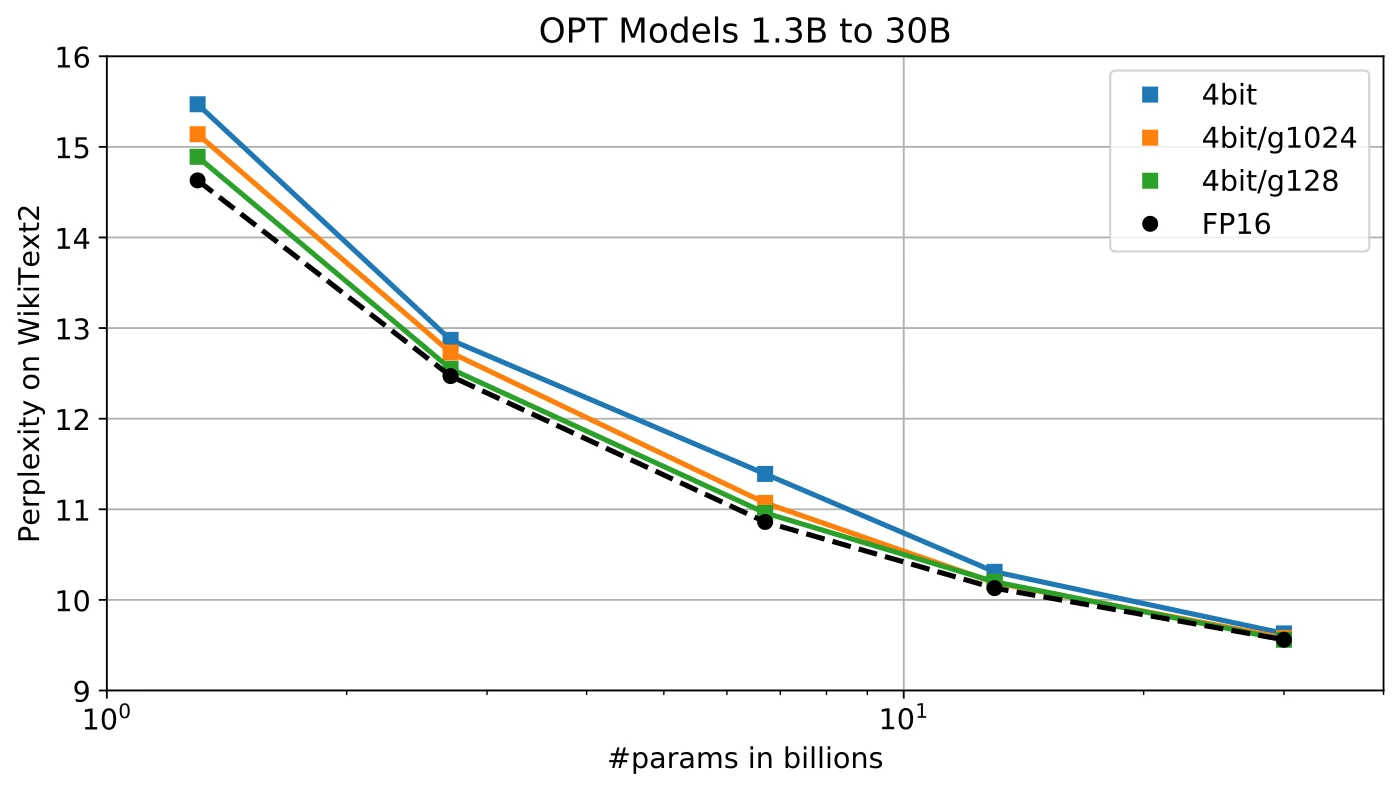
极限量化:2-bit 与三值
论文还测了极端低位。把最大的两个模型压到 2-bit(每组一个 FP16 scale 和一个 2-bit zero-point),WikiText-2 PPL:
| 模型 | FP16 | 2-bit g128(约 2.2 bit) | 2-bit g64 | 2-bit g32(约 2.6 bit) | 3-bit 参考 |
|---|---|---|---|---|---|
| OPT-175B | 8.34 | 9.58 | 9.18 | 8.94 | 8.68 |
| BLOOM-176B | 8.11 | 9.55 | 9.17 | 8.83 | 8.64 |
g128 时只涨 1.2-1.4 个点,g32 时只涨 0.6-0.7——2.6 bit 的 GPTQ 已经比无分组的 3-bit 更好。把分组继续缩到 g8,还可以做三值量化(网格 {-1, 0, +1}):OPT-175B 上 PPL 9.20,只比 FP16 多不到 1 个点。论文顺便提到,这种三值模式在 FPGA 等自定义硬件上尤其有实现价值——这大概是最早把”GPTQ 式量化与 FPGA 存储”联系起来的表述之一。
小模型上的公平对比
在 ResNet-18/50(视觉 PTQ 标准基准)上,GPTQ 与 AdaRound、BRECQ、OBQ 对比:4-bit 打平(RN50:GPTQ 75.71 vs OBQ 75.72 vs AdaRound 75.84),3-bit 略逊于最准的方法(GPTQ 74.87 vs OBQ 75.24),但大幅快于 AdaQuant 这类可比的快速方法,且耗时从 OBQ 的约 1 小时降到不到 1 分钟。在 BERT-base 与 OPT-125M 上对比完整贪心的 OBQ:4-bit 两者相当,3-bit GPTQ 反而略好(论文猜测是 OBQ 的早停离群舍入等启发式在非视觉模型上需要调参)。
部署加速:量化矩阵 × FP16 向量 kernel
量化省内存是理论,把省下来的内存变成生成速度才是工程。GPTQ 的部署思路很干净:量化矩阵 × 全精度向量(W4A16/W3A16,激活保持 FP16)。为什么这对生成任务特别有效?
解码阶段每个 token 要做的核心计算是”读全部权重、做一次矩阵-向量乘”。生成任务是内存带宽受限的:权重读多少字节,时间就花多少,算力反而闲置。把权重从 FP16 压到 3-bit,内存流量直接除以 5+,这就是速度提升的来源。论文实现了一个专门的 CUDA kernel:矩阵-向量乘时动态反量化(dynamic dequantization)——从显存读出 3-bit 整数,现场乘以 scale 还原成 FP16 参与乘加,全程不把反量化结果写回显存,也完全不碰激活量化。
实测数据(论文 Table 6,批大小 1、生成 128 token 的平均每 token 延迟):
| GPU | FP16 延迟(GPU 数) | 3-bit 延迟(GPU 数) | 加速比 |
|---|---|---|---|
| A6000(48GB) | 589 ms(8 卡) | 130 ms(2 卡) | 4.53× |
| A100(80GB) | 230 ms(5 卡) | 71 ms(1 卡) | 3.24× |
3-bit 的 OPT-175B 大约占 63 GB(包含保持 FP16 精度的 embedding 和输出层),加上最多 2048 token 的 KV cache 约 9 GB,正好装进单张 80GB A100——而 FP16 需要 5 卡,当时最强的 8-bit 量化 LLM.int8() 也要 3 卡。A6000 这种带宽较低的卡上收益更夸张:2 卡 3-bit 比 8 卡 FP16 快 4.5 倍。论文还诚实标注了速度提升的来源:几乎全部来自 kernel 减少访存,通信开销在 accelerate 式部署里可忽略。
也要记住论文的自我限定:量化减少的是内存移动,不是计算量——矩阵-向量乘的 FLOPs 没有减少,FP16×INT4 混合精度乘加在当时的硬件上没有原生指令支持,反量化本身还消耗额外算力。这是 2022 年的硬件现实,后来的 Blackwell 等架构才把低精度计算做得更原生。
与 AWQ 的对比:重建与预防,两种量化范式
GPTQ 是 weight-only 量化的”重建派”代表,我们此前拆解过的 AWQ 则是”预防派”代表,两篇合起来读,整个 W4A16 赛道的地图就清楚了。
- GPTQ:事后重建。 量化后,用 Hessian 二阶信息把误差在剩余权重间重新分配,直接最小化 。优点是精度下限高、极端低位(2-bit、三值)也能救;缺点是在特定校准集上做最小化,本质是一种重建,可能过拟合校准集,且实现里有脆弱环节(LLaMA-7B 需要 act-order 补丁,OPT-66B 是天然离群模型)。
- AWQ:事前预防。 不重建、不求二阶信息,只按激活幅度给显著通道乘缩放系数,把量化难度从显著通道身上移走。优点是简单、鲁棒、校准数据只需 16 条;缺点是在误差大到缩放救不回来的极端低位(INT2)下,单打独斗不如 GPTQ。
两者的能力互补也有实验证据:AWQ 论文(arXiv:2306.00978,Table 9)专门做了正交实验,先用 AWQ 缩放、再套 GPTQ 重建,在 INT2-g64 下把与 FP16 的差距进一步缩小。另一个著名对照是 LLaMA-7B:AWQ 论文测出 GPTQ 在该模型 3-bit 下 PPL 高达 8.81,必须配合列重排(GPTQ-R)才压到 6.53,而 AWQ 不需要任何特殊处理直接 6.35。公平地说,GPTQ 官方仓库随后的 act-order 补丁同样把 4-bit 修到 6.09,说明这属于”工程成熟度”问题而非原理缺陷。
生态上,GPTQ 的传播比 AWQ 更早一步:社区维护的 AutoGPTQ 把量化流程自动化成一条命令,GPTQ-for-LLaMA 一度是消费级显卡跑 LLaMA 的首选方案,ExLlama/ExLlamaV2 的 4-bit kernel 直接针对 GPTQ 格式设计,llama.cpp 早期也加载过 GPTQ 模型;vLLM 等推理服务框架的 W4A16 支持同样从 GPTQ 格式起步。它之后的二阶重建思路还被 QuIP、QuIP#、OmniQuant、SpinQuant 等后续工作继承和发展。
局限与边界
把 GPTQ 讲清楚之后,也值得把它的边界标出来:
- 只省访存,不省算力。 生成任务是内存受限的所以快 3-4 倍;但对 prefill 这种计算受限阶段,量化的收益主要来自显存而不是速度,论文也明说”不提供乘法本身的加速”。
- 不做激活量化。 GPTQ 是 W4A16:激活仍是 FP16。KV cache(长上下文时可能比权重还占显存)不在它的射程内——那是 KV cache 量化和缓存管理的战场。论文把激活量化明确列为未来工作。
- 依赖校准数据。 128 段 C4 文本是经验配置:分布离校准集越远,重建的收益越可疑(AWQ 论文用分布漂移实验量化过这一点:PubMed↔Enron 跨分布时 GPTQ 的 PPL 恶化 2.3-4.9,而 AWQ 只有 0.5-0.6)。闭源模型拿不到原始训练分布时,需要自己准备校准集。
- 低位下仍有退化。 3-bit 在 LLaMA-7B 上(8.07 vs FP16 5.68)比大模型差得多;2-bit 以下需要分组辅助。GPTQ 的”接近无损”表述严格成立在 4-bit 和足够大的模型上。
- Hessian 的存储与计算开销。 每层要存 的逆矩阵并做 Cholesky——对隐藏维 12288 的层就是 1.2 亿个元素的密集矩阵,好在这个成本在 4 小时量级内可接受,且一次只处理一个 block。
小结
GPTQ 的全部要点可以压缩成四句话:
- 量化问题可以写成二阶优化——逐层最小化 ,Hessian 只依赖校准输入,是所有行的共享资源;
- OBS 公式给出最优补偿——量化一个权重后,剩余权重的最优调整是 ,沿逆 Hessian 方向把误差摊给所有未量化权重;
- 三个工程改造跨越三个数量级——固定任意顺序(复杂度降 倍)、懒惰批量更新( 列攒批,带宽瓶颈解除)、Cholesky 重构(数值稳定 + 顺带加速);
- 结果经得起规模检验——4 个 GPU 小时量化 175B,4-bit 只掉 0.03 PPL,3-bit 只掉 0.34,单卡 A100 跑 175B 生成比 5 卡 FP16 快 3.25 倍。
它和 AWQ 的关系,是 weight-only 量化里”重建派”与”预防派”的范式对照:GPTQ 用二阶信息把已发生的误差尽量抹平,精度下限更高但依赖校准集、实现里有需要补丁的角落;AWQ 用激活感知缩放让误差不发生,简单鲁棒但极端低位需要与重建方法联手。2022 到 2023 年这段”量化军备竞赛”,GPTQ 开了第一枪,也划定了此后所有 weight-only 方法都要对标的那条精度线。
参考资料
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(论文,arXiv:2210.17323)
- GPTQ 论文 arXiv HTML 全文版(图 1-4 原图来源)
- IST-DASLab/gptq 官方 GitHub 仓库(GPTQ 实现、act-order 补丁、量化矩阵 CUDA kernel)
- OBQ: Optimal Brain Compression: A framework for accurate post-training quantization and pruning(前作论文,arXiv:2208.11580)
- Second order derivatives for network pruning: Optimal Brain Surgeon(OBS 原始论文,NIPS 1992)
- Optimal Brain Damage(OBD 原始论文,NIPS 1989)
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration(对比工作论文,arXiv:2306.00978)
- AutoGPTQ GitHub 仓库(社区最流行的 GPTQ 自动化实现)
- GPTQ-for-LLaMA GitHub 仓库(LLaMA 上的社区移植实现)
- GPTQ 模型量化(知乎专栏,中文社区解读)
- GPTQ:模型量化,穷鬼救星(知乎专栏,中文社区解读)
- 再磕:GPTQ、SparseGPT 与 Hessian 矩阵(知乎专栏,二阶方法深入解读)
- GPTQ 量化的逐列补偿算法:从 OBS 到大规模 Transformer 的优化史(CSDN 技术博客)
- 大模型—模型量化 GPTQ—24(博客园技术博客)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


