


FlashInfer 完全拆解:把分页 KV、动态批处理与定制注意力编译成服务级 Kernel
注意力算子为什么必须理解服务系统
把训练时表现优秀的 FlashAttention kernel 直接搬进在线推理,并不能自动得到高性能服务。训练批次的序列长度通常较整齐,Q、K、V 也往往是连续张量;在线服务却同时面对短提示、长提示、逐 token 解码、分块 Prefill、共享前缀、分页 KV Cache 与投机树。每轮调度之后,批内请求的数量、查询长度和历史长度都可能改变。真正困难的不是再写一个固定形状的注意力 kernel,而是让同一套实现持续适配这些不规则形状。
FlashInfer 由华盛顿大学、NVIDIA、卡内基梅隆大学等团队提出,论文于 2025 年发表于 MLSys。它把自己的定位写得很准确:不是完整推理引擎,而是供 SGLang、vLLM、MLC-Engine 等上层系统调用的注意力引擎。论文版本围绕三件事组织:用块稀疏矩阵统一描述 KV Cache,用 CUDA/CUTLASS 模板与 JIT 生成注意力变体,再用负载均衡调度把动态请求映射到固定规模的 GPU 执行资源。
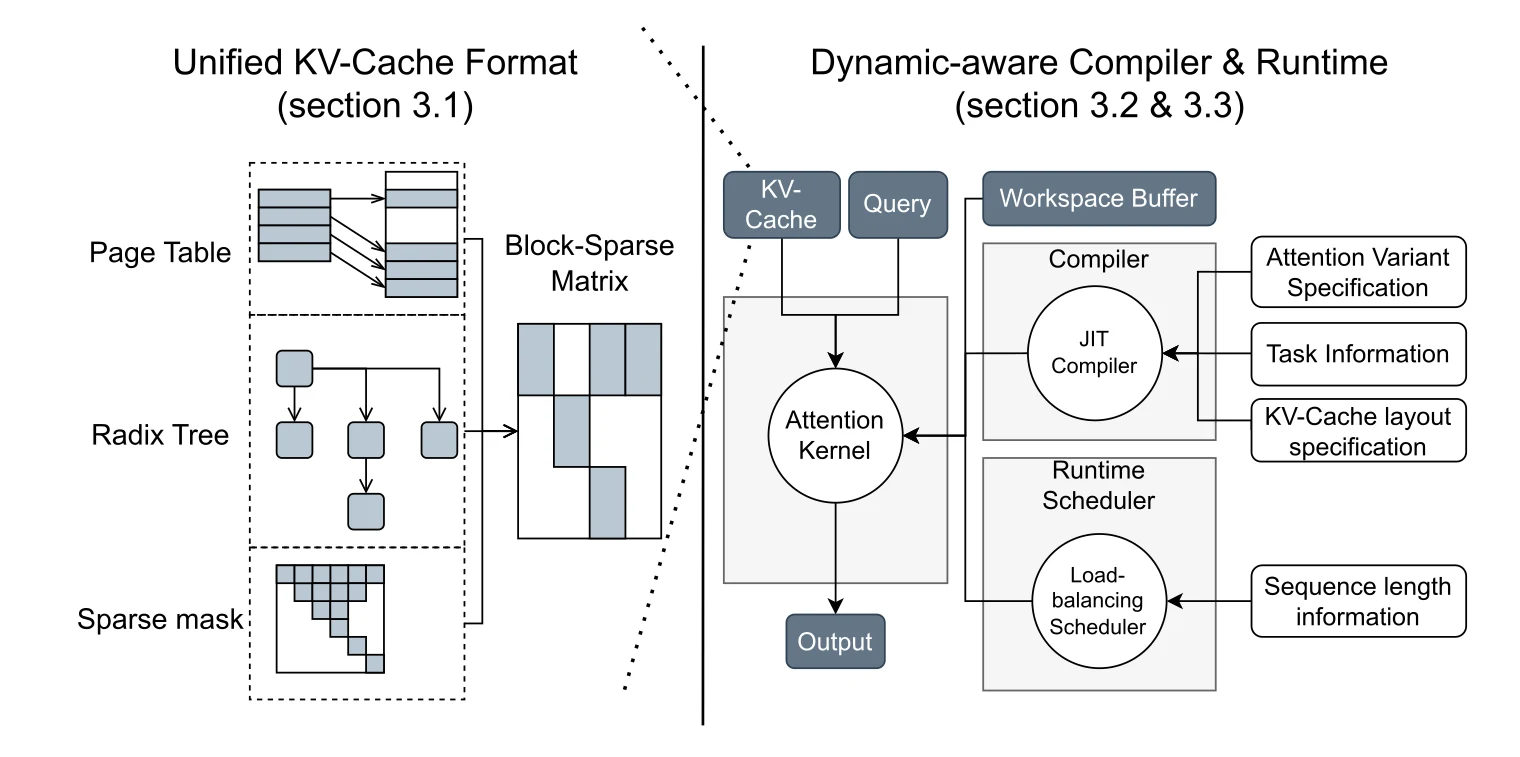
图 1 来自 FlashInfer 论文。左侧的页表、Radix Tree 与稀疏掩码先被翻译成统一 KV 表示;右侧的注意力规格、任务信息与 KV 布局在编译阶段决定 kernel 模板;真正每步变化的序列长度则交给运行时调度器。这个分界很重要:模型结构变化得慢,请求长度变化得快,二者不应走同一条编译路径。
FlashInfer 与 PagedAttention 的关系也由此变得清楚。PagedAttention 主要回答“KV 页怎样分配、共享和回收”;FlashInfer 主要回答“给定页表后,注意力 kernel 怎样高效读取这些页”。它也不是 FlashAttention 的替代算法:其 dense 与 block-sparse 模板仍以 FlashAttention-2/3 的在线 Softmax 和分块流水线为基础,只是把它扩展到服务系统需要的不规则存储、动态调度和可定制打分逻辑。
整篇文章围绕一个核心问题展开:一个服务级注意力引擎,怎样同时守住数学等价性、GPU 利用率与接口可组合性。答案并非某个孤立的 PTX 技巧,而是一条贯穿表示、编译、调度和运行时接口的设计链。
从推理形状出发:Prefill、Decode 与 Ragged Batch
先把一个请求的注意力写成矩阵形式。设查询长度为 ,KV 历史长度为 ,单头维度为 :
,。Prefill 时, 往往与本轮新增上下文一样长,矩阵乘较大,Tensor Core 容易吃饱;Decode 时每个请求通常只有一个新查询,即 ,但仍需读取整个历史 KV。后者每取回大量 K/V 只做少量乘加,常常受显存带宽而非峰值 FLOPS 限制。
论文把 FlashAttention 的渐近计算强度写为:
当 时,它近似为 。因此,把更多 Decode 请求简单拼进 batch 会提高总并行度,却不会改变单份 KV 数据被使用的次数;计算强度并不会像 Prefill 那样自然升高。GQA/MQA 让 个查询头共享一组 KV 头后,同一份 K/V 可服务更多查询,强度近似提高到 。这也是 GQA 不只节省缓存,还能改善 Decode 数据复用的原因,可进一步参考 GQA 完全拆解。
在线批次还有第二层不规则性。假设四个请求的查询长度为 ,KV 长度为 。若把每个请求补齐到相同长度,绝大部分 Q/KV 位置都是 padding,算力和带宽都浪费在无效元素上。FlashInfer 使用 Ragged Tensor 把真实 token 紧密拼接,并以 CSR 风格的前缀和数组标记边界。例如:
qo_indptr = [0, 1, 2, 34, 41]第 个请求的查询区间就是 data[qo_indptr[i]:qo_indptr[i+1]]。长度不再编码进张量的矩形边界,而是进入元数据。当前官方文档要求此类 indptr 与页索引使用 int32;误用 int64 不只是多占空间,还可能造成索引错误。
不规则形状会沿着系统栈向下传播:
- 存储层需要表达每个请求不同的物理 KV 页;
- kernel 需要在不连续页之间收集数据,同时维持合并访存;
- 调度器需要避免一个超长请求独占少数 CTA,其余 SM 提前空闲;
- CUDA Graph 又要求 launch 配置和指针稳定,不能每步随意重建执行图。
FlashInfer 的关键不是消灭这些动态性,而是把它们压缩进少量可更新元数据,让大部分 GPU 执行结构保持稳定。
一套表示容纳多种 KV Cache
页表、Radix Tree、稀疏注意力掩码看似是三种完全不同的数据结构,但从注意力 kernel 的视角,它们都在回答同一个问题:某一块查询需要访问哪些 K/V 块。FlashInfer 因而把“查询块到物理 KV 块的连接关系”看成一个块稀疏矩阵。
页表就是一张块稀疏矩阵
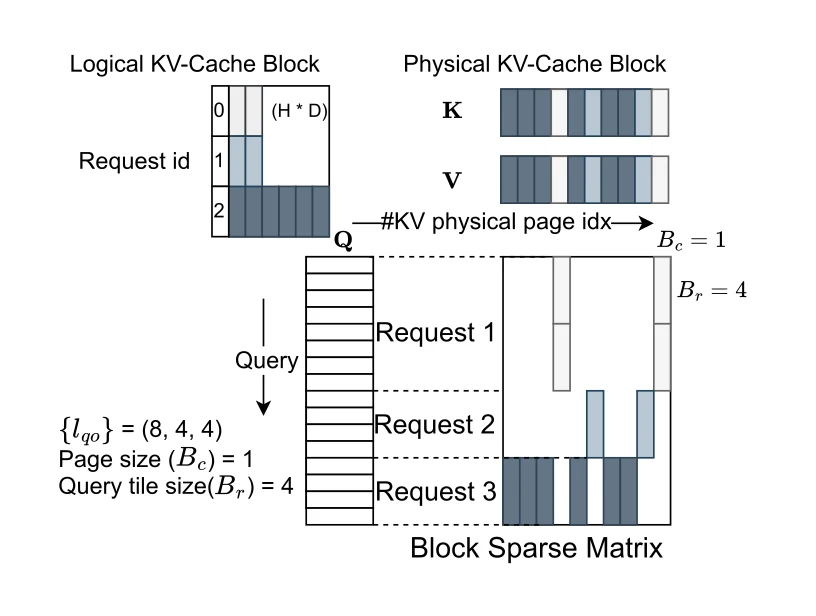
图 2 来自 FlashInfer 论文的统一 KV 格式示意。横轴不是逻辑 token 位置,而是物理 KV 页号;纵轴是查询行。一个非零块表示该组查询需要读取对应物理页。图中的 表示四行查询组成一个 query tile, 表示块列以一个物理页为粒度。
BSR(Block Sparse Row)可以用三组信息描述:
indptr指出每个块行的非零块范围;indices给出这些非零块对应的物理列号;data不必真的保存注意力矩阵元素,而是由物理 KV 页承担。
于是,PagedAttention 的页表可直接翻译成 BSR 索引;RadixAttention 的前缀树可以展开为“哪些请求行连接到同一组前缀页”;KV 剪枝或块稀疏注意力则只是减少部分非零块。kernel 不需要分别理解“页表”“树”和“掩码”的高层语义,只需遍历索引、收集对应 K/V 块并完成注意力计算。
这种抽象没有替上层系统管理显存。按照 FlashInfer 官方文档,物理页的申请、释放、换出与共享仍由推理引擎负责;FlashInfer 接收 kv_page_indptr、kv_page_indices 与 kv_last_page_len,只负责算子执行。若页大小为 ,请求 使用 个页,最后一页有效长度为 ,则它的实际 KV 长度是:
这个边界条件解释了为什么最后一页必须单独传有效长度:物理页通常按固定容量分配,最后一页的尾部并不属于该请求,kernel 不能把它当作有效 token 参与 Softmax。
块大小是复用与碎片的交换条件
由 KV 管理粒度决定, 则与 query tile 对齐。增大 ,一组查询可在共享内存和寄存器里复用相同的 KV 块,减少重复的 HBM 读取;但若这些查询实际访问集合不同,块内就会出现无效位置。块太小则表达灵活,却失去跨查询的数据复用。FlashInfer 支持任意 ,包括接近向量稀疏的细粒度形式,而不是强制稀疏块必须是 。
Composable Format:共享前缀与独有后缀分开算
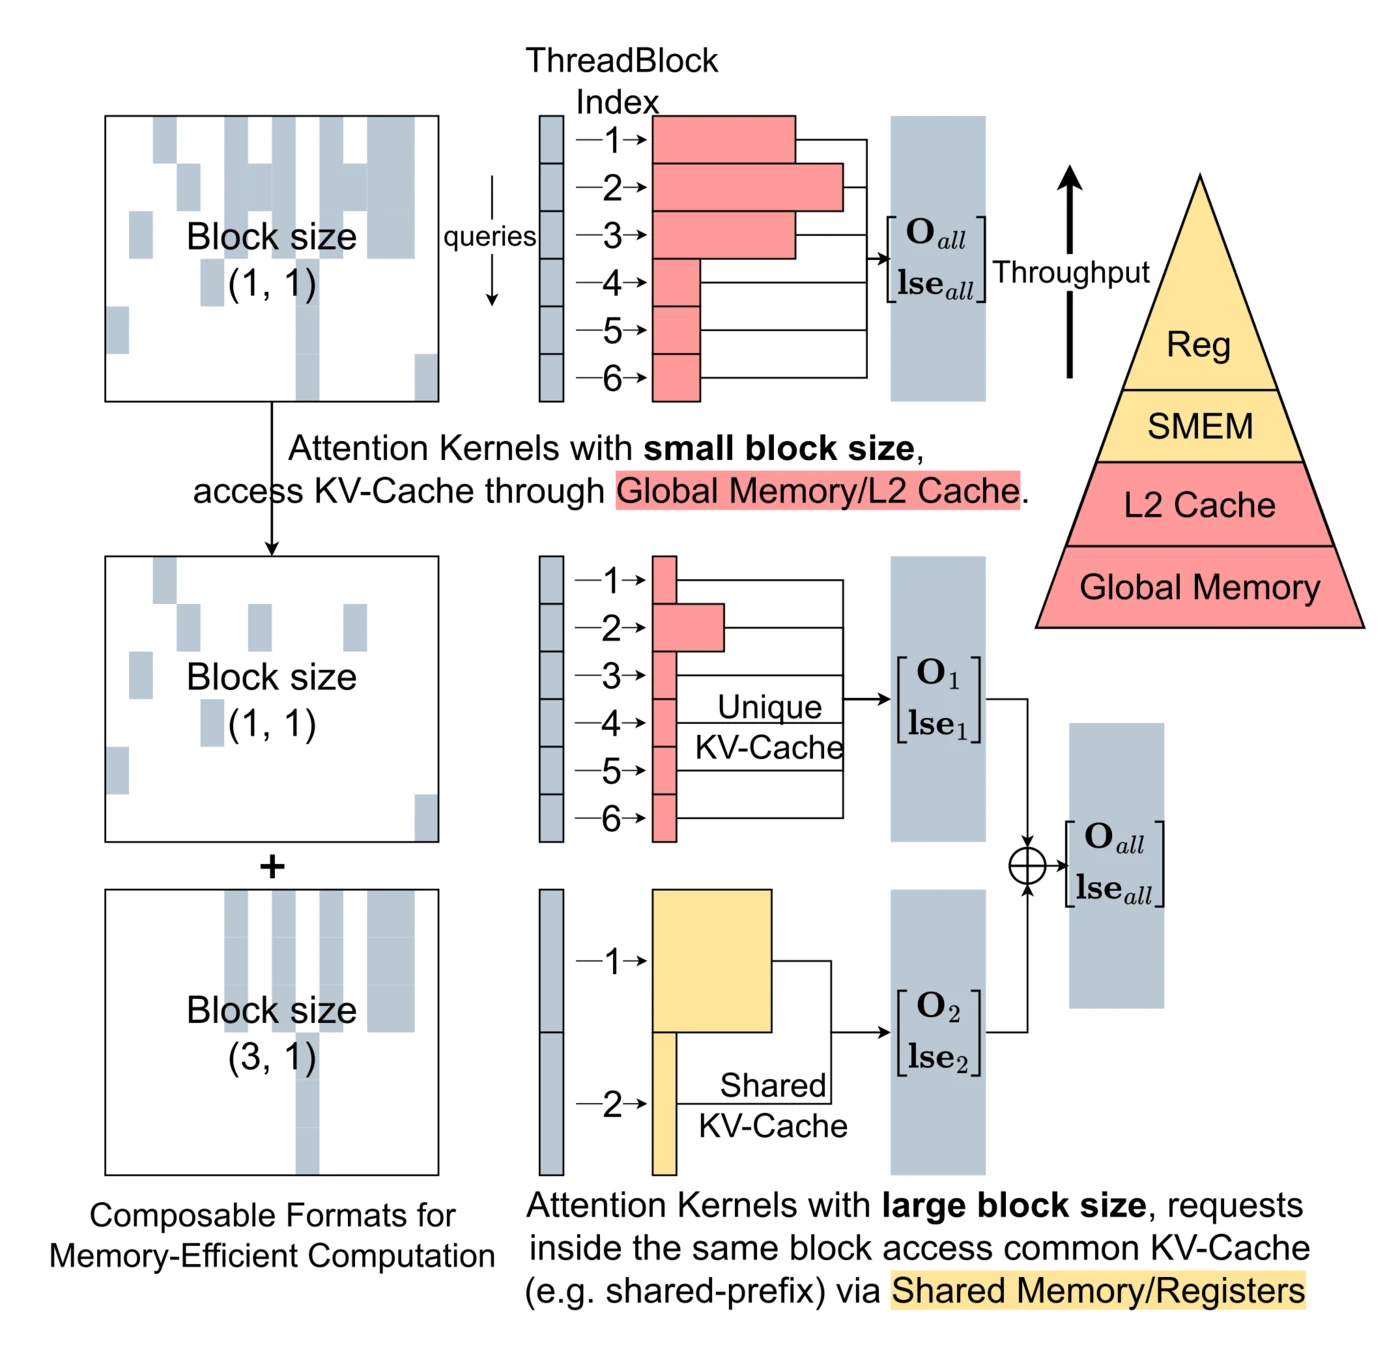
图 3 来自论文。上半部分用单一 块表示全部 KV:即使多个查询共享前缀,不同 thread block 仍会各自从全局内存或 L2 读取同一份数据。下半部分把矩阵拆成两个子格式:共享前缀使用 大行块,使三条查询在一个 CTA 内复用前缀 KV;独有后缀仍使用 ,保留细粒度。
拆分不搬动 KV 数据,只重建不同视图的索引。设共享前缀索引集合为 ,请求自己的后缀为 。先分别计算两个注意力状态,再合并即可得到对 的精确结果。这比把前缀复制到每个请求的连续缓存更省容量,也比让每个请求独立读取前缀更省带宽。
因此,所谓“统一格式”不是把所有场景强塞进一个固定块尺寸,而是建立共同的稀疏语义,再允许多个格式组合。共享前缀、投机树、重要 token 稀疏选择都可在这个语义下共存,真正的差别落到索引构造和块尺寸上。
可定制注意力模板:把变化留给 JIT
统一存储只解决“数据从哪里来”,还没有解决“拿到数据后做什么”。现代模型对标准注意力的改动可能发生在多个位置:Q/K 先做 RoPE,logits 加 ALiBi 或 soft-cap,掩码改成滑窗或自定义块模式,Softmax 甚至被其他归一化替代。为每个组合手写一份 CUDA kernel,会迅速形成难以维护的笛卡尔积。
FlashInfer 的办法是保留稳定的 FlashAttention 骨架,只把变体注入若干固定签名的 functor:
| 注入点 | 作用 | 可承载的典型逻辑 |
|---|---|---|
QueryTransform | Q 进入点积前的变换 | RoPE、归一化、投影融合 |
KeyTransform | K 进入点积前的变换 | RoPE、反量化 |
ValueTransform | V 参与加权求和前的变换 | 反量化、布局变换 |
LogitsTransform | Softmax 前修改分数 | scale、ALiBi、soft-cap |
LogitsMask | 判定某个位置是否有效 | 因果、滑窗、自定义稀疏掩码 |
OutputTransform | 写回前处理输出 | 类型转换、融合后处理 |
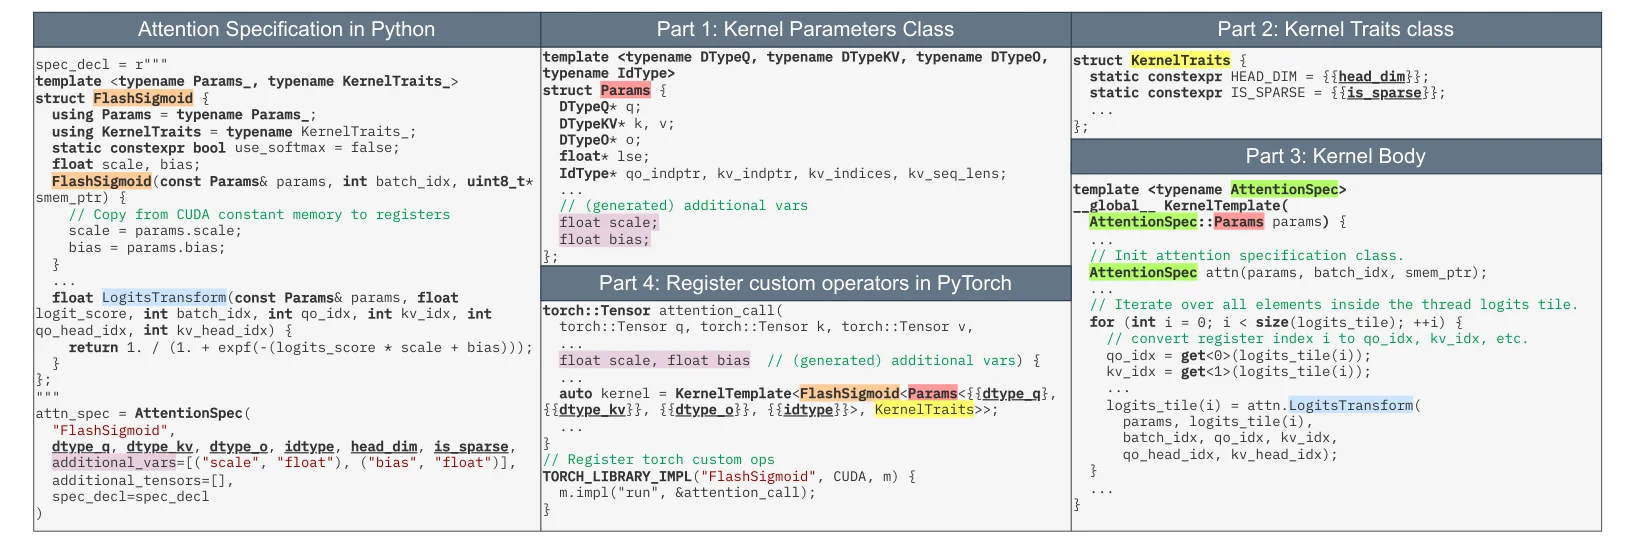
图 4 来自 论文 Figure 5。左侧以 Python 描述注意力规格,中间把额外张量、标量和数据类型整理成 kernel 参数,右侧将 functor 插入 CUDA 模板。生成代码通过 PyTorch JIT 编译并注册成自定义算子;DLPack 接口则让非 PyTorch 运行时也能调用。
这里的 JIT 不是在每个 token 上现编译。模型的头数、head dimension、数据类型、位置编码和掩码规则通常在实例加载后不再变化,可以预热编译并缓存;每轮变化的请求长度和页表索引仍由运行时参数提供。换句话说,JIT 专门消除模型级分支,调度器专门处理请求级动态性。
Tile 选择为什么也要特化
FlashAttention-2 常见的较大 query tile 适合 Prefill,却不适合 的 Decode。若一个 CTA 为 128 行 Q 预留寄存器与共享内存,实际只有一行有效,资源占用和并行度都会恶化。论文中的 FA2 模板覆盖查询 tile 与 KV tile 的组合,并按两步选择:
- 根据批内平均查询长度,选择不小于它的最小 query tile;GQA 场景还把 head group 维度折进有效查询长度,以利用共享 KV 的复用。
- 在寄存器、共享内存和 SM occupancy 的约束下选择 KV tile,避免大 tile 造成寄存器溢出或同时驻留 CTA 数下降。
当 query tile 为 1 时,论文实现使用 CUDA Core,因为 Tensor Core 的最小矩阵行维度为 16;其余 FA2 路径使用 Tensor Core。Hopper 的 FA3 模板则让行 tile 与 WGMMA 的 64 行粒度对齐。这些选择说明“Tensor Core 一定更快”并不成立:工作形状无法填满矩阵指令时,标量/向量 CUDA Core 反而更合适。
灵活性并非免费
模板化的代价主要有三项。第一,首次遇到新规格需要编译,生产环境通常要预热常用组合。第二,变体越多,二进制缓存与测试矩阵越大。第三,任意用户代码会放大数值正确性与边界访问风险,不能只用吞吐测试验收。FlashInfer 的价值不在于让每段 Python 都自动变快,而在于把常见变化限制到少量、可静态展开的注入点,同时保留对 PTX 级优化的控制。
动态请求与静态 CUDA Graph 的矛盾
CUDA Graph 能把多次 kernel launch 预先记录并重放,减少 CPU 发射开销,尤其适合 Decode 这种单个 kernel 很短、每步结构相似的工作负载。它的限制同样鲜明:被捕获 kernel 的 grid 规模、参数地址与依赖关系需要稳定。在线批次却会不断有请求加入、退出,KV 长度也逐 token 增长。
如果完全服从动态请求,每步都重新决定 grid 并重建图,CUDA Graph 的收益消失;如果完全服从静态图,固定的 CTA 分工又会被不断变化的长短请求拖垮。FlashInfer 把“执行外壳”和“工作分派”分开:
- 编译时固定 persistent attention/contraction kernel 的 grid 规模;
- 运行时只更新每个 CTA 的工作队列,以及局部输出到最终输出的映射;
- 这些计划元数据写进地址固定的 workspace,再重放同一张 CUDA Graph。
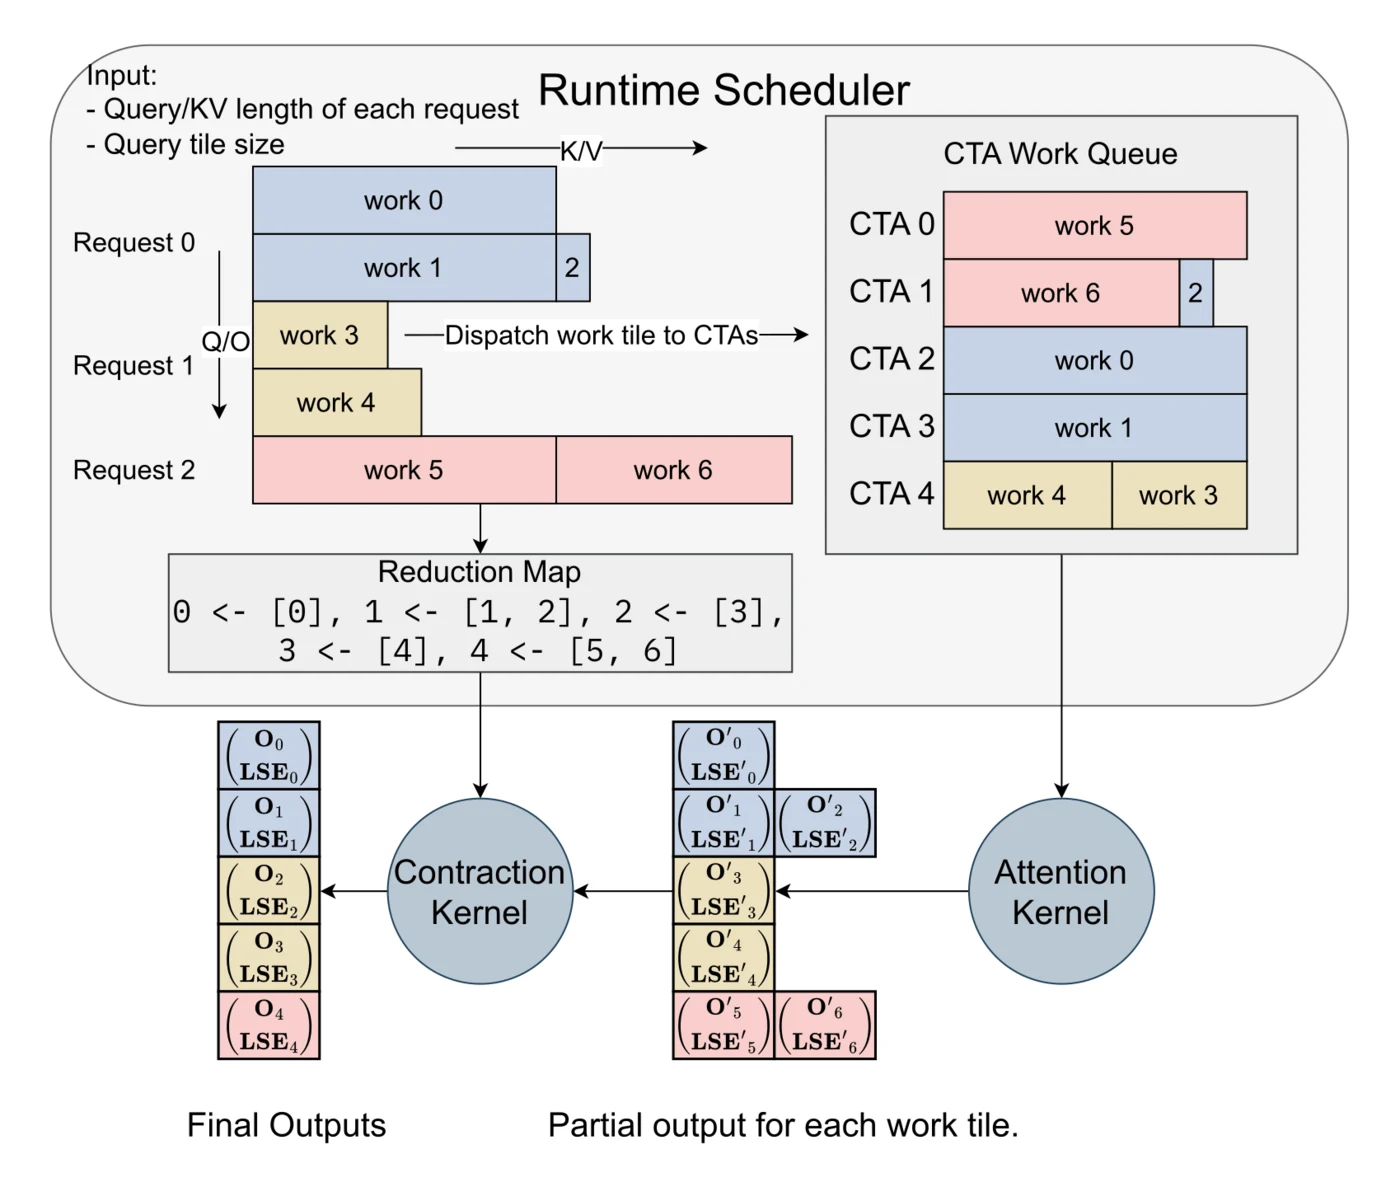
图 5 来自论文。左上角三个请求拥有不同的查询与 KV 长度,调度器先把工作拆成 tile,再分配给固定数量的 CTA。右侧队列描述每个 CTA 要处理哪些 work item;下方 reduction map 描述局部 attention state 最终属于哪个输出。
先切长 KV,再做最长任务优先分配
给定请求 的查询长度 、KV 长度 与 query tile 大小 ,请求会产生 个查询块。论文用全部工作量除以 CTA 数,估算一个 KV chunk 的上限:
是固定 CTA 数。超过 的长 KV 被沿序列维切成多个 chunk,使一个超长请求不再绑定一个 CTA。每个 work item 的估算代价写成:
与 是刻画查询侧和 KV 扫描成本的超参数。调度器把 work item 按长度降序排列,每次把当前最长任务交给累计代价最小的 CTA。这是经典 LPT(Longest Processing Time first)思想:先安排最难塞下的大块,尾部小任务更容易填平队列空隙。
这套算法受 Stream-K 启发,但没有照搬原子累加。注意力局部结果若由 CTA 以不确定顺序原子合并,浮点加法的不结合性会带来逐次运行差异。FlashInfer 显式产生固定 reduction map,以确定顺序合并,换取可复现输出。
固定指针比固定内容更重要
CUDA Graph 不要求 workspace 内容永远相同,却要求捕获后的指针保持有效。FlashInfer 预先为调度元数据和 Split-KV 局部输出划定固定 offset,并按最大容量准备缓冲区。每轮 plan 在 page-locked host buffer 生成新元数据,再用异步拷贝更新 device workspace;run 看到的是相同地址中的新内容。
代价是必须为上界预留空间:最大并发请求数、累计 token 数、head 数与 head dimension 都会影响 workspace。若上界估得过小,运行时无法容纳新计划;估得过大,则会增加保留显存。这不是 kernel 能完全隐藏的细节,而是部署容量规划的一部分。
论文版本的 plan 运行在 CPU,且每个 generation step 都会更新;它能在同一步的多层 Decode 注意力之间复用,因此开销由全部层共同摊薄。当前实现持续演进,但“把不规则分析放在 inspector,把稳定执行放在 executor”仍是接口的核心。
Kernel 内部:分块、在线 Softmax 与 Split-KV
统一索引与调度计划最终要落到数据通路上。FlashInfer 的核心计算仍是 IO-aware attention:Q tile 常驻寄存器/共享内存,K/V 按 tile 流入,分数不写回 HBM,Softmax 统计量与输出在片上递推。与连续 FlashAttention 相比,变化最大的地方是 K/V tile 可能来自不相邻物理页。
先收集到共享内存,再调用稠密矩阵单元
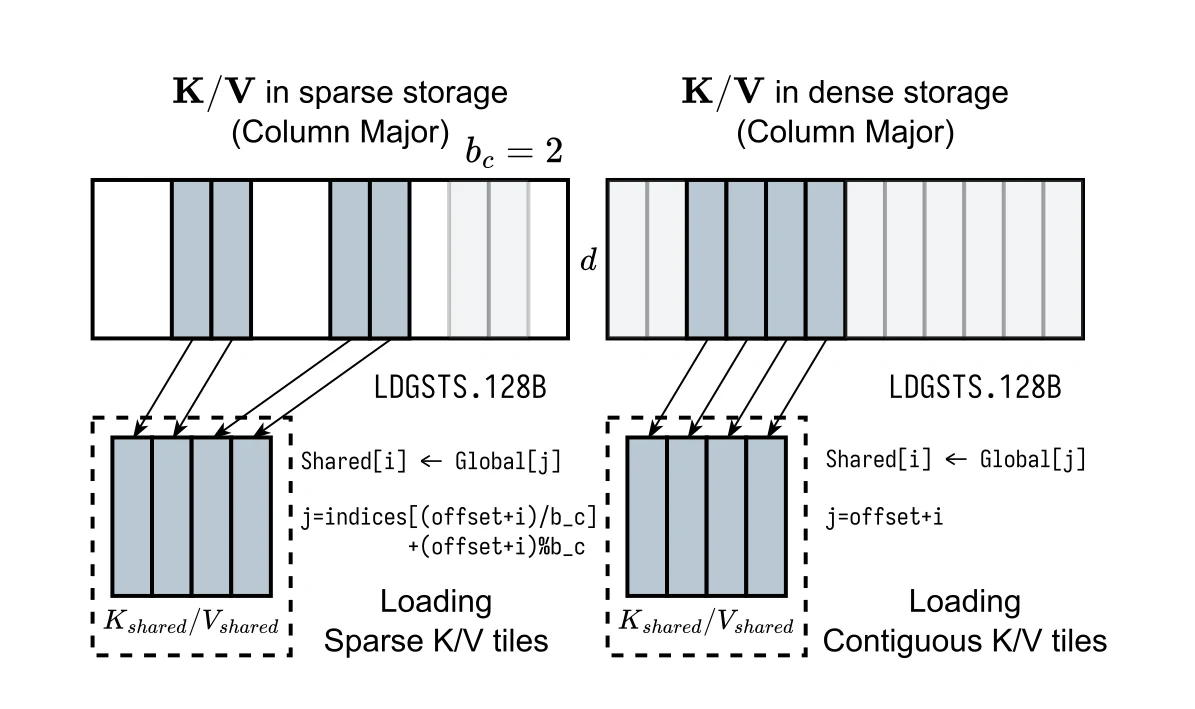
图 6 来自论文。稠密 KV 的地址可由起点加行偏移直接得到;稀疏 KV 则需要先查询 BSR indices,把来自不同物理块的行收集到连续共享内存。进入共享内存以后,两条路径使用相同的稠密 Tensor Core 微内核。这个“稀疏加载、稠密计算”策略避免要求物理页恰好与 MMA tile 对齐。
KV 的最后一维,也就是常见的 128 或 256 维 head dimension,始终保持连续,从而让线程束进行合并访存。论文实现使用 128 字节 LDGSTS 异步拷贝搬运稀疏数据。Hopper TMA 擅长固定步长的多维搬运,却不能直接表达任意页索引;所以论文版本只在连续 KV 上用 TMA,稀疏 gather 仍走 Ampere 风格异步拷贝与手动地址计算。
这一差异会反映到性能上。论文附录报告:Decode 下稀疏与稠密 KV kernel 的差距在 1% 内;Prefill 约有 10% 差距。原因不是稀疏计算本身变多,而是 FA3 稠密路径能用 TMA,稀疏路径需要更多地址寄存器,并可能被迫采用更小 KV tile 以避免 spill。块列足够大时,一个 TMA 操作可以留在单个连续块内,但大块又会削弱稀疏格式的细粒度表达能力。
在线 Softmax 为什么允许任意切块
对某个查询 和索引集合 ,先定义分数的 log-sum-exp:
再定义该集合内部归一化后的局部输出:
二元组 就是 attention state。若 KV 被分为互不重叠的 与 ,令
则合并状态为:
减去 是标准的数值稳定处理,防止指数溢出。这个合并算子满足交换律与结合律,因此 KV 可以按物理页、共享/独有前缀,或调度器决定的 chunk 任意分割,最后仍得到与一次完整 Softmax 数学等价的结果。FlashInfer 把 attention state 作为规范化局部输出,把状态合并当成类似 GEMM 中“求和归约”的基础操作。
Split-KV 解决的是并行度,不是减少计算量
Decode 的 时,batch 和 head 数若不足,天然 CTA 数可能少于 GPU 的 SM 数。Split-KV 把一个长序列切给多个 CTA,每个 CTA 独立扫描一段 K/V 并产生 attention state,再由 contraction 阶段合并。总乘加量没有下降,还多了一次局部输出写入和归约;收益来自更多 SM 同时工作,缩短关键路径。
因此 Split-KV 只应施加给足够长的请求。短请求不拆分时,其 CTA 可直接把结果写入最终输出,绕过 workspace 与 contraction。论文称之为 writethrough 优化,它同时减少临时显存和归约工作。这里的工程判断与分块 GEMM 很相似:切分不足会留下空闲 SM,切分过度则让中间状态和同步开销反噬收益。
同一个状态合并机制还支撑共享前缀的 composable format:前缀只算一次形成一个状态,每个请求再算自己的后缀状态,二者精确合并。存储抽象、负载均衡与数学归约因而不是三个孤立技巧,而是围绕 attention state 串成了一条闭环。
Plan/Run 接口如何接入推理引擎
FlashInfer 把不规则算子常见的 Inspector–Executor 模式显式暴露为 plan 与 run。下面的代码省略错误检查和版本相关参数,只保留当前官方接口的结构:
import torchfrom flashinfer.attention import BatchAttention
attention = BatchAttention(kv_layout="NHD", device="cuda")
# 每轮批次的结构元数据attention.plan( qo_indptr=qo_indptr, kv_indptr=kv_page_indptr, kv_indices=kv_page_indices, kv_len_arr=kv_last_page_len, num_qo_heads=num_qo_heads, num_kv_heads=num_kv_heads, head_dim_qk=head_dim, head_dim_vo=head_dim, page_size=page_size, causal=True,)
# 同一份计划可供多层使用;每层传入自己的 Q 与 KV Cachefor layer in layers: out, lse = attention.run( layer.q, layer.paged_kv_cache, return_lse=True, )plan 消费形状、页表和模型静态参数,选择后端与 tile,生成 CTA 队列、归约映射和所需 workspace 信息;run 只绑定实际 Q/K/V 并发射 kernel。相同批次形状下,计划可跨层复用,因为各层 KV 的内容与地址不同,但请求长度、页映射结构和头配置通常相同。
当前文档推荐的 BatchAttention 还能根据 qo_indptr 与 KV 元数据,在同一批中区分 Prefill 风格和 Decode 风格的请求。早期接口则常分别使用 BatchPrefillWithPagedKVCacheWrapper 与 BatchDecodeWithPagedKVCacheWrapper。API 名字会演进,稳定思想仍是:把调度和选择从热路径执行中拆开,让上层 serving loop 有机会缓存计划、预分配 workspace,并把 run 纳入 CUDA Graph。
一轮 Decode 中各层怎样复用计划
一次生成步可以按以下顺序执行:
- 上层调度器确定本轮存活请求、每个请求要处理的 token 数与 KV 物理页。
- KV 管理器为新 token 分页并更新页表;FlashInfer 不负责申请这些页。
plan根据批次结构生成或命中执行计划,把元数据更新到固定 workspace。- 模型各层依次执行
run,复用相同调度结构但读取各层独立 KV Cache。 - 采样产生下一 token;完成请求离开批次,新请求可能在下一轮加入。
这与 连续批处理 的职责边界不同。连续批处理决定“本轮让哪些请求前进一步”;FlashInfer 决定“给定这些请求,注意力 work item 如何映射到 GPU”。同理,Sarathi-Serve 的分块 Prefill 决定一次给长提示多少 token 预算,可参考 Sarathi-Serve 完全拆解;FlashInfer 接收分块后的 ragged Q 和页表,再选择适合该形状的 kernel 路径。
CUDA Graph 捕获放在哪里
论文接口中,plan 留在图外,run 被捕获。初始化阶段先用 dummy plan 填好 workspace 和稳定地址,再捕获包含多层 run 的图;生成阶段更新真实长度、调用 plan,随后 replay。若系统需要覆盖不同 batch 上界、query tile 或 composable format,可预先捕获多张图,运行时选择最合适的一张。
这种做法与 CUDA Graph 完全拆解 中的 bucket 思路一致:不是让一张图容纳无限动态形状,而是准备有限个静态执行外壳,把细粒度变化编码进地址稳定的缓冲区。工程上还需保证 workspace 生命周期长于图实例,不能在捕获后重新分配导致指针变化。
接口层最容易踩的四个坑
indptr、物理页索引和最后一页长度必须语义一致,尤其不能把 token 长度误当页数。- NHD 与 HND 的最后三维顺序不同。FP16/BF16 下二者差距通常不大,低精度 KV 可能更偏好 HND;布局不匹配不会只是变慢,也可能直接读错数据。
- 打开 CUDA Graph 后,batch 容量和辅助缓冲区形状受捕获配置约束;动态内容可以更新,容量上界不能凭空增长。
return_lse=True会额外返回 attention state 的尺度,适合级联或自定义归约;普通最终输出若不需要组合,应避免无意义的额外写回。
把这些约束视为 API 契约,FlashInfer 才是可插拔 kernel 层;若把页分配、服务调度和算子计划混为一谈,任何局部加速都可能被 Python 元数据处理、重复分配或图失效抵消。
性能结果该怎样解读
论文实验针对 FlashInfer v0.2,硬件为 A100 40GB SXM 与 H100 80GB SXM,软件为 CUDA 12.4、PyTorch 2.4.0,存储和计算使用 FP16。它证明的是前述机制在当时软硬件组合上的有效性,不应直接当作当前版本、任意模型与任意服务负载的固定提速承诺。
端到端数字必须连同服务约束一起读
SGLang v0.3.4 实验使用 Llama 3.1 8B(单张 H100)与 70B(四张 H100),负载包括 ShareGPT 和输入长度在 512 到 2048 间均匀分布的合成数据。系统调节请求率,使 P99 TTFT 保持在 200 ms 以下,再比较中位 ITL 与 TTFT。论文摘要报告相对 Triton 后端的 ITL 降幅为 29% 到 69%。这个设置强调延迟敏感区间,而不是把队列压满后的最大离线吞吐。
StreamingLLM 案例更直接验证了 JIT 融合的意义。团队只用约 20 行 query/key transform 规格,把 RoPE 融入注意力 kernel。Vicuna-13B、MT-Bench 的端到端实验中,不同 recent-window 配置下 ITL 下降 28% 到 30%;kernel 层的带宽利用率相对“RoPE 与 attention 分开执行”提高 1.6 到 3.7 倍。收益来源很具体:省去中间张量的额外读写和一次 kernel 边界,而不是注意力公式少算了什么。
负载均衡在长而不齐的请求上更重要
论文附录给出了 Llama 3.1-8B-Instruct 在 H100 SXM5 上的调度器消融。单位均为毫秒:
| 场景 | 带负载均衡 ITL | 不带负载均衡 ITL | Triton ITL |
|---|---|---|---|
| ShareGPT,请求率 16 | 8.96 | 9.16 | 9.36 |
| 输入 ,请求率 8 | 8.21 | 8.42 | 8.49 |
| 输入 ,请求率 1 | 8.63 | 13.89 | 11.08 |
短上下文里,开启调度器只改善约 0.2 ms;长上下文分布里,不均衡版本从 8.63 ms 恶化到 13.89 ms,甚至落后于 Triton。这个结果支持了调度器的设计动机:当每个 work item 差不多大时,复杂分派价值有限;真正的收益出现在长尾长度使 CTA 尾部效应严重时。
对应 TTFT 数据为:
| 场景 | 带负载均衡 TTFT | 不带负载均衡 TTFT | Triton TTFT |
|---|---|---|---|
| ShareGPT,请求率 16 | 39.05 | 39.42 | 52.92 |
| 输入 ,请求率 8 | 66.78 | 67.38 | 68.48 |
| 输入 ,请求率 1 | 411.02 | 421.60 | 566.30 |
这里 TTFT 的主要差异不全由调度器产生,kernel 模板、融合与后端差异也在起作用,所以不能用“有/无调度器”的差值解释 FlashInfer 对 Triton 的全部优势。
Composable Format 只在复用足够大时占优
共享前缀 kernel 的附录数据说明了适用阈值。后缀长度固定为 128 token:
| 共享前缀长度 | Composable,批 16 | 单一格式,批 16 | Composable,批 64 | 单一格式,批 64 |
|---|---|---|---|---|
| 1024 | 45.17 μs | 46.52 μs | 87.86 μs | 130.49 μs |
| 8192 | 88.67 μs | 226.57 μs | 125.76 μs | 931.75 μs |
| 32768 | 217.42 μs | 945.67 μs | 254.54 μs | 4090 μs |
前缀只有 1024、batch 只有 16 时,两者几乎持平;前缀到 32768、batch 到 64 后,复用同一前缀 KV 的收益才压倒额外的状态合并和格式管理成本。论文也明确指出,真实请求的共享前缀常常更短,kernel 级高倍数未必按比例转化为端到端收益。
并行生成实验呈现相同规律。固定请求率 16、并行分支数 时, 的 ITL 与 TTFT 稳定改善。峰值出现在 :8B 与 70B 模型的 ITL 分别下降 13.73% 和 17.42%,TTFT 分别下降 16.41% 和 22.86%。 太小时共享复用不足, 太大时 ShareGPT 短序列下其他算子开始主导,注意力优化的端到端占比下降。
反例比最好数字更能说明集成成本
论文附录中的 vLLM 集成并非全部获胜。BF16 KV Cache 下,默认后端的中位 ITL/TTFT 为 10.42/35.85 ms,FlashInfer 为 10.63/36.60 ms,反而略慢;E4M3 KV 下则从 12.56/39.74 ms 改善到 10.92/37.93 ms。作者把 BF16 回退归因于集成中的 Python 数组操作等 host 开销,并计划移到 C++ 或设备侧。
这揭示了正确的评测顺序:先用 kernel benchmark 确认形状与路径,再用 profiler 检查 plan、元数据变换、显存分配和 launch,最后才看真实到达分布下的 TTFT、ITL 与吞吐。只比较一个理想形状的 TFLOPS,无法判断服务是否变快。
适用边界与工程取舍
FlashInfer 最适合的问题具有三个特征:KV Cache 非连续或带稀疏结构;请求长度高度动态;注意力规则需要在标准 FlashAttention 骨架上做定制。若工作负载只是固定长度、连续 Q/K/V 的大批 Prefill,成熟的 dense FlashAttention 或 cuDNN SDPA 可能已经足够,额外的页索引和计划层未必产生收益。
| 场景 | FlashInfer 的主要价值 | 需要重点验证的代价 |
|---|---|---|
| Paged KV Decode | 直接遍历物理页,避免整理成连续缓存 | 页大小、布局与 gather 开销 |
| 长短请求混合 | Split-KV 与 CTA 队列降低尾部空闲 | plan 的 CPU/拷贝开销 |
| 共享长前缀 | Composable Format 复用前缀 KV | 前缀太短时收益不足 |
| 滑窗、soft-cap、自定义 mask | JIT functor 融合变体逻辑 | 编译缓存与正确性测试 |
| CUDA Graph Decode | 固定 grid、固定 workspace 地址 | 容量上界和多图 bucket 管理 |
| 低精度 KV | 专用布局与反量化融合机会 | scale 契约、误差与后端支持 |
它不是 KV Cache 管理器
FlashInfer 不决定淘汰哪个前缀、何时抢占请求,也不替系统维护引用计数。上层必须保证同一物理页的生命周期覆盖所有使用它的 run,并处理写时复制等一致性问题。kernel 库做得再快,页表若在异步执行尚未结束时被复用,结果仍会静默错误。缓存替换策略可与 前缀缓存淘汰 的系统层问题分开理解。
稀疏表示不等于自动稀疏加速
BSR 只是表达“哪些块要算”。实际加速要求被跳过的块足够多,且索引、gather 和负载不均衡的代价低于节省的计算与带宽。极细块提供更准确的稀疏性,却增加索引数量与地址计算;大块提高连续搬运和复用,却可能把大量无效 token 带回计算。页大小、稀疏块大小与 query tile 应联合调优,不能各自独立取经验值。
JIT 扩展性会转化成运维矩阵
数据类型、head dimension、GQA 分组、位置编码、mask、GPU 架构与 tile 的每种组合都可能对应不同 kernel 实例。生产部署需要:
- 在发布阶段预热常见规格,避免首请求承担编译延迟;
- 记录编译缓存键和二进制兼容范围,驱动升级后主动失效旧缓存;
- 为每个注意力变体做参考实现对比,覆盖最后一页、空掩码、极长 KV 与混合长度;
- 同时检查输出误差和 LSE,防止局部状态本身正确但合并尺度错误。
后端优势与硬件绑定
论文选择 CUDA/CUTLASS 而非当时的 Triton,理由是需要 warp specialization、TMA、寄存器级资源控制和 PTX 内建函数。好处是能更快采用 NVIDIA GPU 的新指令,代价是硬件相关代码和测试负担更重。论文实现范围从 Turing 到 Hopper:FA2 覆盖较早架构,FA3 服务 Hopper;当前项目已经继续增加新架构和更多算子,但具体支持矩阵应以部署版本的官方文档为准。
优化注意力之后,瓶颈会迁移
短上下文、小模型或高并发场景中,采样、GEMM、通信、Python 调度和网络栈都可能超过注意力占比。FlashInfer 项目如今也扩展到 GEMM、通信与采样算子族,恰恰说明服务优化不能停留在单 kernel。落地时应按 GPU 推理性能分析完全指南 的层次逐步定位:端到端时间线确认瓶颈算子,kernel 指标区分带宽、计算或 occupancy,再决定是否更换 attention backend。
所以,FlashInfer 的真正边界不是“能否调用某个 API”,而是系统是否愿意显式管理形状元数据、编译缓存、workspace 上界与版本契约。它以这些工程复杂度换取对不规则推理工作负载的控制力。
小结
FlashInfer 把服务态注意力拆成四个彼此咬合的层次:
- 用 Ragged Tensor 紧密保存变长 Q/O,用 BSR 统一页表、前缀树与稀疏 KV 访问关系。
- 用 composable format 把共享前缀和独有后缀映射成不同块尺寸,再通过 attention state 精确合并。
- 用 CUDA/CUTLASS 模板与 JIT functor 静态展开模型级变体,按 Prefill、Decode 和硬件资源选择 tile。
- 用
plan/run拆分动态分析与稳定执行,以固定 grid、固定 workspace 地址和可更新元数据兼容 CUDA Graph。
贯穿这四层的是同一个原则:不规则性不能被假装不存在,但可以被压缩为索引、计划与可组合状态。页表解决容量碎片,BSR 把页表变成 kernel 可遍历的稀疏结构;Split-KV 制造并行度,attention state 又保证分块结果能稳定归约;JIT 保留注意力变体的灵活性,静态模板则守住硬件效率。
论文数据也给出了清晰边界。长尾序列、长共享前缀和可融合变体带来明显收益;短前缀、规则形状或 host 元数据开销较大时,优势会缩小甚至回退。判断是否采用 FlashInfer,不能只问“它的 kernel 峰值多高”,而要问请求分布、KV 布局、计划开销和注意力在端到端延迟中的占比是否匹配它的设计。
参考资料
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving(MLSys 2025)
- FlashInfer 论文 arXiv HTML 与官方图
- FlashInfer 官方 GitHub 仓库
- FlashInfer 官方文档:Attention Kernels
- FlashInfer 官方文档:KV-Cache Layout
- FlashInfer 官方文档:Attention States and Recursive Attention
- NVIDIA 技术博客:Run High-Performance LLM Inference Kernels from NVIDIA Using FlashInfer
- PagedAttention:Efficient Memory Management for Large Language Model Serving with PagedAttention
- FlashAttention:Fast and Memory-Efficient Exact Attention with IO-Awareness
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


