


MoHGE 完全拆解:异构分组专家如何重构 MoE 的路由与推理代价
从同构专家到异构专家:问题究竟在哪里
稀疏 MoE 的基本承诺是:参数可以很多,但每个 token 只激活少量专家。假设一层有 个前馈网络专家,路由器只选择其中 个,那么总参数量随 增长,单 token 的前馈计算量却主要由 决定。这也是 MoE 能够扩展模型容量而不让每步计算同比增长的根本原因。
然而,标准 MoE 通常给所有专家配置相同的 FFN 中间维度。无论当前 token 是高频标点、固定搭配,还是需要结合长上下文才能预测的低频实体,路由器虽然可以选择不同专家,却不能选择不同的计算预算。换句话说,传统路由器回答的是“交给谁”,没有回答“应该花多少算力”。
最直接的改法是把专家做成不同尺寸。小专家处理容易 token,大专家处理困难 token,就像动态宽度网络。但这会立刻引出两个系统问题:
- 组合空间不足。如果每种尺寸只有少数几个专家,尺寸和语义专长被绑定在同一个专家编号上。token 想要某种语义能力时,可能被迫接受并不合适的计算规模。
- 设备负载失衡。专家并行通常把不同专家放到不同 GPU。若某张卡放了大专家,另一张卡放了小专家,即使两张卡收到相同数量的 token,计算时间和显存占用也不相等;一次 All-to-All 之后,所有设备仍要等待最慢的那张卡。
MoDSE 在 2024 年尝试了多尺寸专家,并用成对放置缓解设备负载问题;HMoE 同年进一步研究了异构专家及偏向小专家的目标。它们说明“token 难度不同,因此计算预算也应不同”是可行方向,但完全异构的专家集合仍把尺寸选择、专长选择和设备放置纠缠在一起。
中国联通数据科学与人工智能研究院等团队在 2026 年 4 月发布 MoHGE(Mixture of Heterogeneous Grouped Experts),随后发表于 ACL 2026 Industry Track。它的核心不是简单增加几种专家尺寸,而是把上述问题拆成三个相互配合的层次:
- 组间异构:不同组使用不同 FFN 宽度,让 token 能选择计算规模;
- 组内同构:同一组保留多个等宽专家,让同一计算档位仍有语义专门化空间;
- 跨组放置:每张 GPU 都拿到一套从小到大的专家,使设备总容量对齐。
这三个层次分别对应模型结构、路由决策和系统部署。真正值得分析的也正是它们之间的闭环:组路由决定计算档位,专家路由决定具体专长,辅助损失把训练期学到的路由分布塑造成推理期可部署的负载形态。
MoHGE 的整体结构
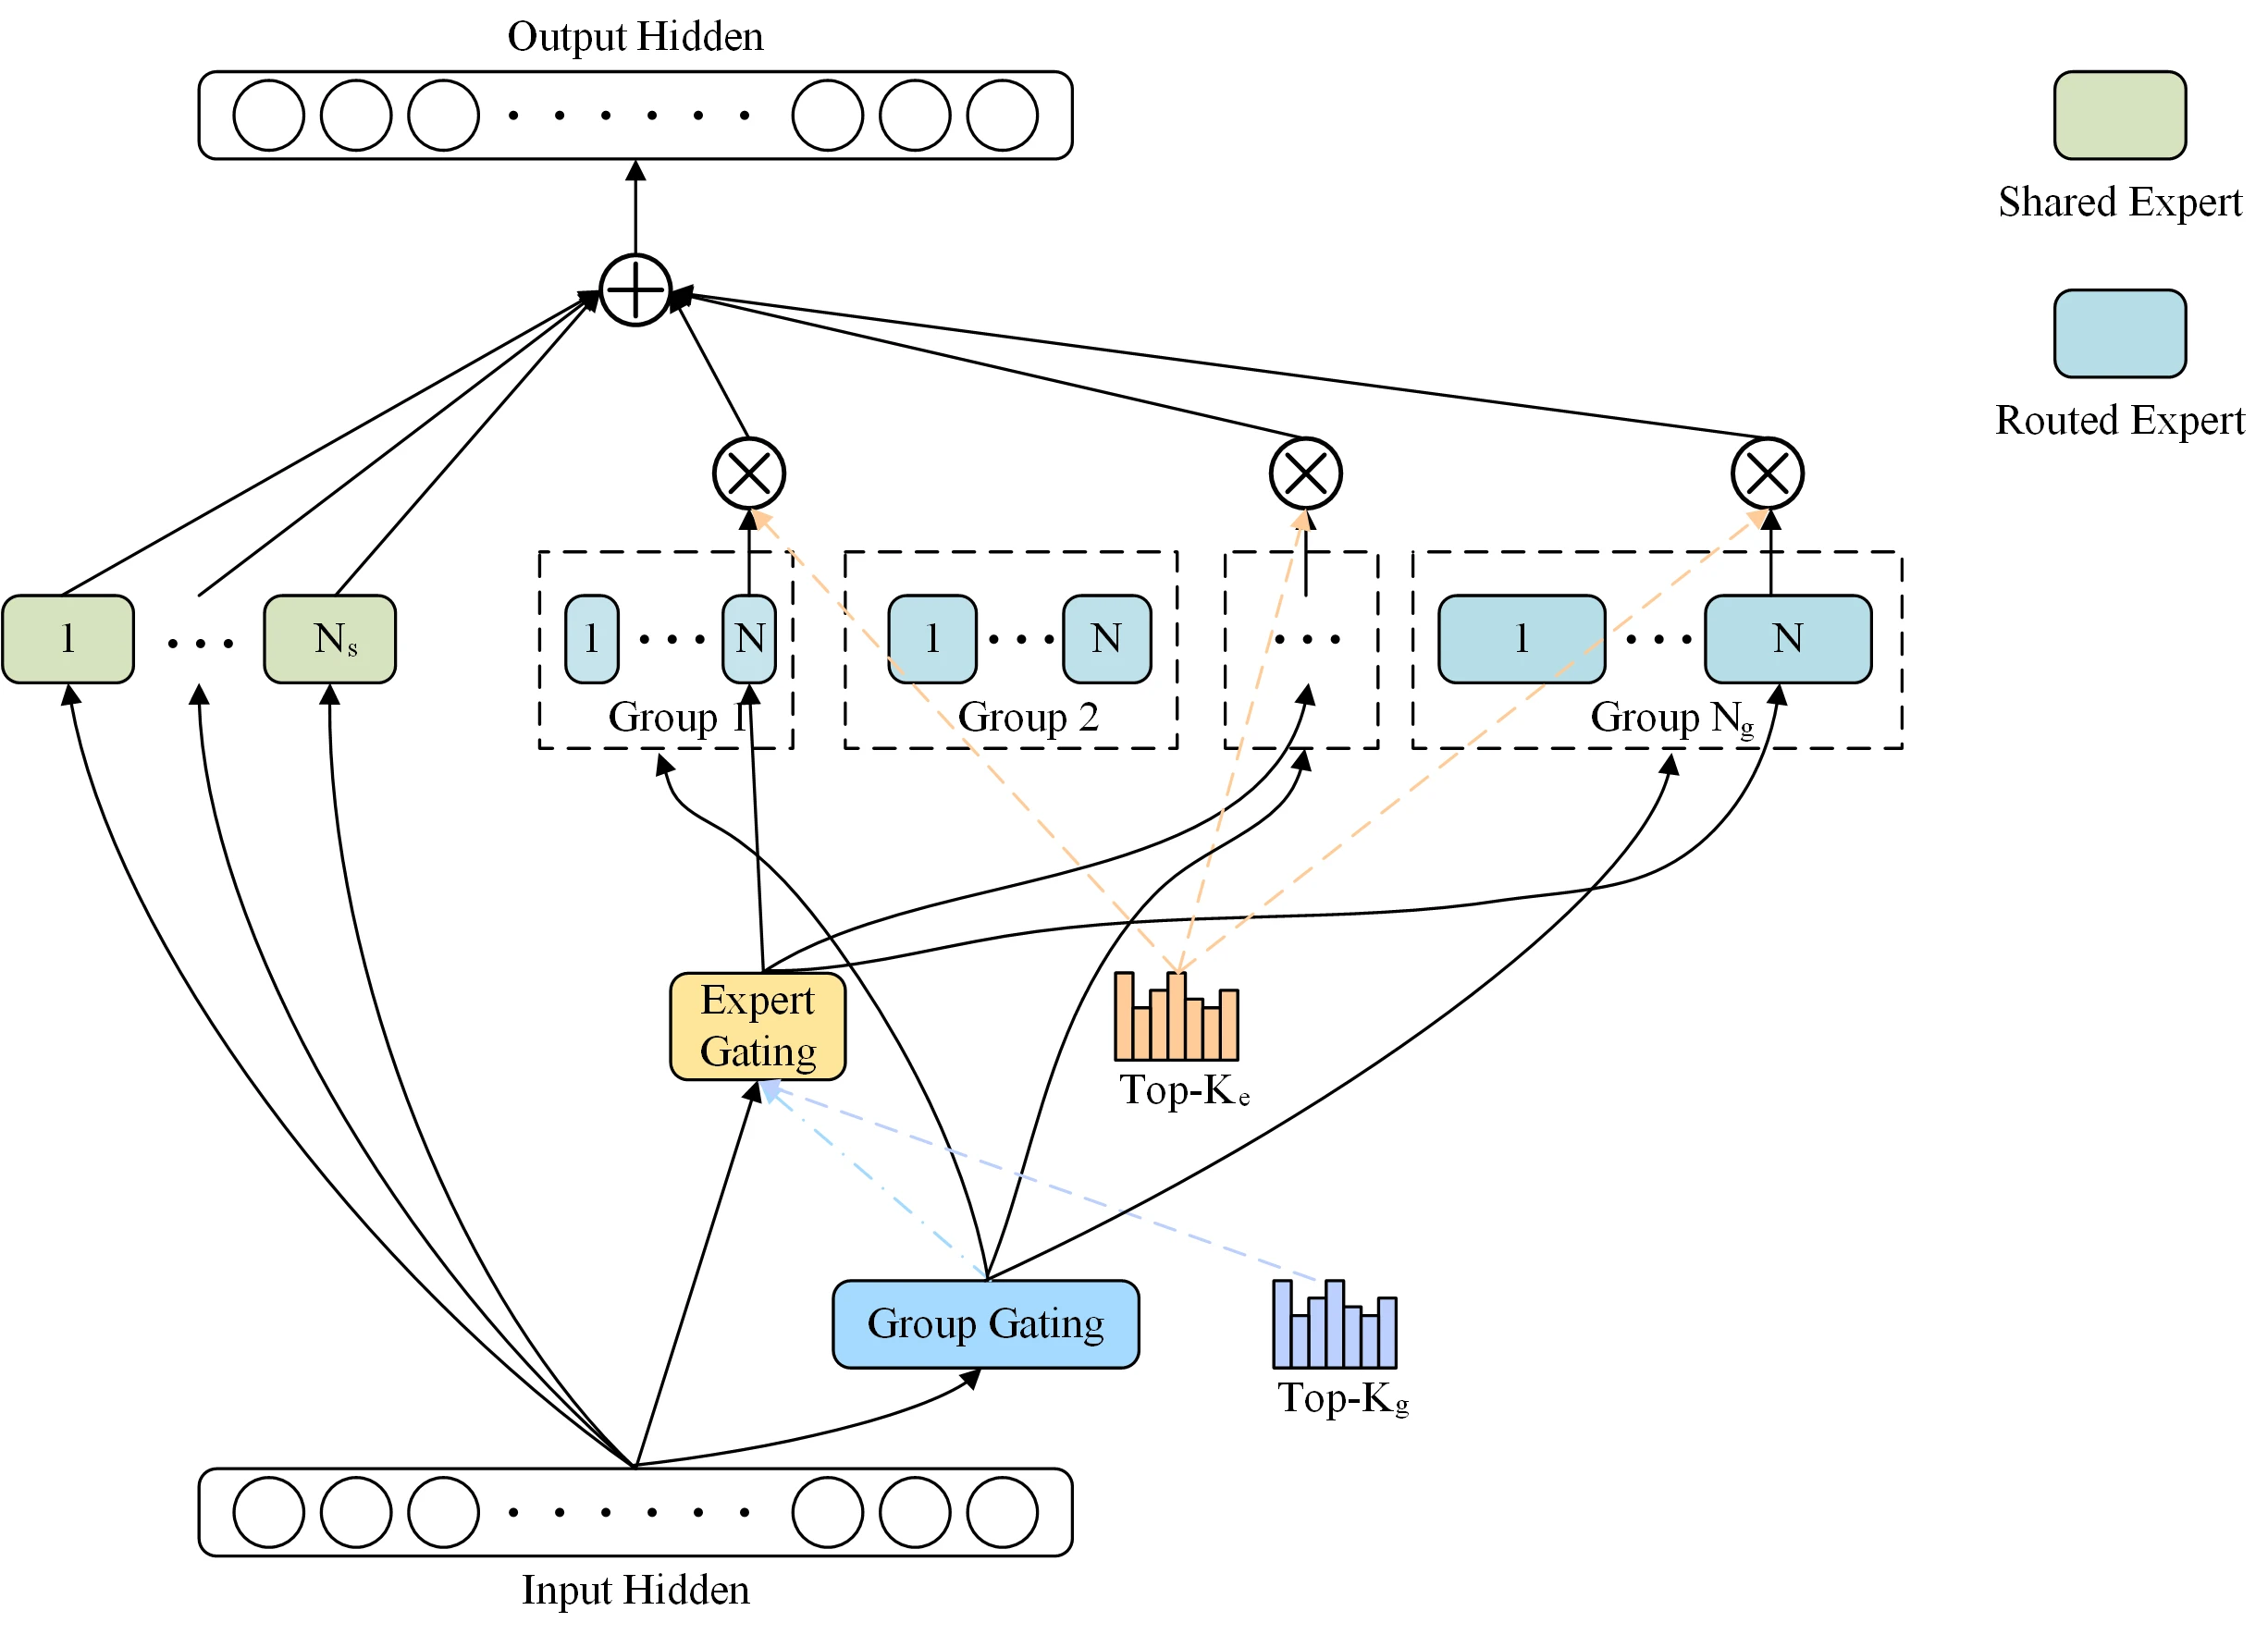
图 1 来自 MoHGE 论文。从下往上看,一份 token 隐状态 同时进入三条路径:共享专家、组路由器和专家路由器。
绿色的共享专家始终被激活,用于承载各类 token 都需要的公共知识;蓝色的 routed experts 被划分为 个组。组 1 的专家最窄,后续各组逐渐变宽,但每一组内部的 个专家宽度相同。图中蓝色 Group Gating 先保留 个候选组,黄色 Expert Gating 再在这些组的专家中进行全局 Top-,最终把选中专家的输出按路由权重相加,并与共享专家输出汇合。
可以把一个 MoHGE 层写成:
其中, 是共享专家数; 表示第 组的第 个路由专家; 是两级路由得到的最终权重。没有被选中的专家权重为 0,因此公式看似遍历所有专家,实际只执行 个路由专家。
论文的 1B、3B、14B 三档配置都使用 、、 和 2 个共享专家。三档总专家数分别为 32、64、128,所以每组分别有 4、8、16 个专家。这里有一个容易忽略的细节:组路由保留 3 组,不代表最终一定从每组取 2 个专家。第二级是在所有候选专家上做全局 Top-6,一个 token 完全可能从某个组取 4 个、另一个组取 2 个,并让第三个候选组没有专家进入最终集合。这种不固定配额的设计保留了组合自由度。
MoHGE 仍然是一个固定激活专家数的稀疏 MoE。动态之处不在 ,而在被选中专家的宽度之和。即使每个 token 都走 6 个专家,6 个小专家和 6 个大专家的激活参数量、矩阵乘规模与执行时间也完全不同。
第一层关键机制:如何构造异构专家
只改变 FFN 宽度,而不改变接口
论文中的“异构”特指 routed expert 的中间维度不同。若采用带门控分支的 SwiGLU FFN,一个专家可以抽象为:
是模型隐藏状态; 与 把隐藏状态投影到宽度 ; 再投影回 ; 表示逐元素乘法。同一组的专家共享 这个形状,但权重参数并不共享,因此它们仍可学习不同专长。
忽略偏置后,一个专家大约有 个参数;若把一次乘加计为 2 FLOPs,处理一个 token 的三次矩阵向量乘约为 FLOPs。于是宽度既是模型容量,也是推理成本的近似线性刻度。所有专家输入、输出维度仍为 ,所以残差连接、注意力层和 Transformer 其余部分不需要理解专家内部尺寸。
为什么要“组内同构、组间异构”
假设有 64 个专家和 8 档宽度。完全异构方案可以让 64 个专家各自取不同宽度,但路由器很难区分“选择这个专家是因为它擅长当前语义”还是“因为它碰巧更大”。MoHGE 为每档宽度提供 8 个专家,相当于把决策坐标拆成两轴:组编号主要表达容量档位,组内编号主要表达同一档位下的专长。
这种分解还扩大了可用组合。若每个尺寸只有一个专家,Top-6 基本等于选择 6 个尺寸;若每个尺寸有多个专家,路由器可以在相同总计算预算附近形成大量不同的专长组合。代价是多出一层组门控,但组数只有 8,其打分开销与 FFN GEMM 相比很小。
宽度序列并非随意递增
论文用成对对称关系表达宽度安排:小组与大组的宽度之和围绕一个基准值保持不变。若把组宽度记为 ,可以直观写成:
是这组宽度序列的平均中心。这样做的意义是:把一个小专家和一个大专家放在同一设备时,它们的合计宽度稳定,设备间静态参数量容易做平衡。
论文表 7 给出的实际宽度如下:
| 模型档位 | 标准 MoE 单专家宽度 | MoHGE 的 8 组宽度 | 每组专家数 |
|---|---|---|---|
| 1B | 832 | 256、320、384、512、640、768、832、896 | 4 |
| 3B | 1024 | 384、512、640、768、896、1024、1152、1280 | 8 |
| 14B | 1280 | 640、768、896、1024、1152、1280、1408、1536 | 16 |
以 3B 档为例,首尾两项之和、第二项与倒数第二项之和都等于 1664,因此平均中心 。它低于标准 MoE 的单专家宽度 1024,这不是只把同样参数重新分档,而是连平均专家尺寸也缩小了。64 个 routed experts 的 FFN 参数总量因此约按 缩放,这正是总参数减少接近 20% 的主要结构来源。
这也解释了论文中两个常被混为一谈的数字:总参数下降约 20%,是因为所有专家的平均宽度更小;单 token 激活的专家参数下降约四分之一,则还受到路由器更偏向小组的影响。前者是静态模型结构属性,后者是输入相关的动态结果。
第二层关键机制:分组路由如何工作
两级路由不是先选定某个组、再只在该组内选专家的硬层级分类,而是“候选组剪枝 + 跨候选组全局竞争”。它可以拆成五步。
第一步:组打分
对第 个 token,组路由器为每个组计算一个 Sigmoid 分数:
是当前 token 的隐藏状态, 是第 个组的可学习路由向量, 是 Sigmoid。论文把 称为组的 centroid embedding,它不是组内专家权重的平均值,而是单独学习的门控参数。
这里用 Sigmoid 而不是跨组 Softmax,意味着每个组先独立回答“我是否适合这个 token”。多个组可以同时得到高分,不必为了总概率和等于 1 而互相挤压。之后只保留分数最高的 个组,未入选组在本 token 上全部屏蔽。
第二步:组内专家归一化
对于入选组,专家路由器计算 token 与组内每个专家路由向量的点积,并只在该组内部做 Softmax:
是组 Top- 的集合, 是组内专家编号。组内 Softmax 让同尺寸专家竞争语义专长;它不会直接拿小组的某个专家与大组的某个专家比较,因为两者原始 logit 的标度可能不同。
第三步:把容量偏好与专家专长合并
每个候选专家的组内概率再乘以所属组分数:
这个乘法很关键。若只做组屏蔽而不保留 ,刚刚超过 Top- 门槛的组和高度匹配的组就会拥有同等地位;乘回组分数后,专家的最终竞争力同时取决于“这一容量组是否合适”和“这个专家在组内是否合适”。
第四步:跨组全局 Top-K
将所有候选组中的 个分数摊平,选择全局最高的 个:
这一步没有规定每个组必须贡献几个专家。它比“每个入选组固定取 个”更灵活,也正是 grouped heterogeneous design 能形成丰富组合的原因。另一方面,这也意味着实际负载不能只看组被选中的次数,还要看组内哪些专家进入了最终 Top-。
第五步:全局重新归一化
被选中的专家权重最后归一化:
归一化之后,所有激活 routed experts 的权重之和为 1,便于稳定地加权输出。共享专家是另一条始终开启的路径,不参与这次 Top-K 竞争。
组级损失不是“均匀负载损失”
若只依赖语言建模目标,大专家因容量更强而更容易降低误差,路由器会逐渐把大量 token 推向大组。模型名义上拥有小专家,实际却接近总用大专家。MoHGE 因此增加 Group-Wise Auxiliary Loss,给大组施加很轻的成本压力。
为了突出其含义,可以把论文公式按归一化频率重写为:
是统计窗口内的 token 数; 是组的实际入选频率; 是组的平均软分数; 是相对尺寸; 是很小的系数。论文原式使用了不同的常数缩放,这些常数可以吸收到 中,不改变梯度偏好的方向。
该损失和常规的均衡损失方向不同。常规均衡损失希望所有专家负载接近,MoHGE 的组级损失明确把宽度写进代价:在语言建模收益相近时,选择小组的代价更低;只有大组确实能明显改善预测时,主任务收益才会抵消这项惩罚。因此它并不强制所有 token 都走小专家,而是为路由器引入“计算价格”。
论文的路由统计也支持这一点:加入 后,分布不是完全均匀,而是从偏爱 Group 7、8 转向更多使用 Group 1、2。换言之,目标是成本感知,而不是组间平均主义。
把公式落到一次前向传播
以论文 3B 配置为例,一层有 8 个组、每组 8 个专家。对一个 token,完整候选集合有 64 个 routed experts,但实际路径如下:
- 组路由器计算 8 个点积和 Sigmoid,保留 3 个组;
- 专家路由器仍可一次生成 64 个 logit,但只让候选 3 组的 24 个专家参与后续竞争;
- 在每个候选组内做 8 路 Softmax,再乘组分数;
- 从 24 个加权分数中取全局 Top-6;
- token 被分发到 6 个专家,专家输出按归一化权重相加;
- 加上 2 个共享专家的输出,得到 MoHGE 层结果。
对应的推理伪代码可以写成:
def mohge_forward(x, shared_experts, routed_groups, kg=3, ke=6): group_score = sigmoid(x @ group_gate.T) # [tokens, 8] group_mask = topk_mask(group_score, kg) # 每个 token 选 3 组
expert_logit = x @ expert_gate.T expert_logit = expert_logit.reshape(-1, 8, experts_per_group) local_prob = softmax(expert_logit, dim=-1) # 只在组内归一化
candidate = local_prob * group_score[..., None] candidate = candidate * group_mask[..., None] route_weight, route_mask = global_topk(candidate, ke) route_weight = normalize_selected(route_weight)
routed = dispatch_execute_combine(x, route_weight, route_mask) shared = sum(expert(x) for expert in shared_experts) return routed + shared伪代码省略了 token 排序、All-to-All、容量管理和张量并行,但保留了路由语义。一个重要的工程事实是:组 Top-K 并没有自动减少专家门控矩阵的投影成本。官方实现先执行 self.router.gating(input) 得到全部专家 logit,再把张量 reshape 为“组 × 组内专家”,用组掩码清零。它主要减少的是实际执行的专家集合,而不是第二级 gate 的线性投影。
一个容易误判的例子
假设某 token 的候选组是宽度 512、896、1280 的三个组,最终 Top-6 从它们分别取 3、2、1 个专家。仅 routed FFN 的激活宽度和为:
若标准 3B MoE 固定激活 6 个宽度 1024 的专家,对应宽度和为 6144。忽略共享专家和路由开销,异构组合的 routed FFN 计算量约为标准方案的 。这正好展示了“专家数不变,激活参数量仍可变化”。
但如果 GSM8K 一类输入让路由器更多选择大组,同样的 6 个专家可能得到更高的宽度和,速度优势就会缩小甚至局部反转。MoHGE 的计算量是输入分布的函数,不能只用一个固定的激活专家数预测延迟。
推理系统视角:计算、显存与通信代价
All-size Group-decoupling Allocation
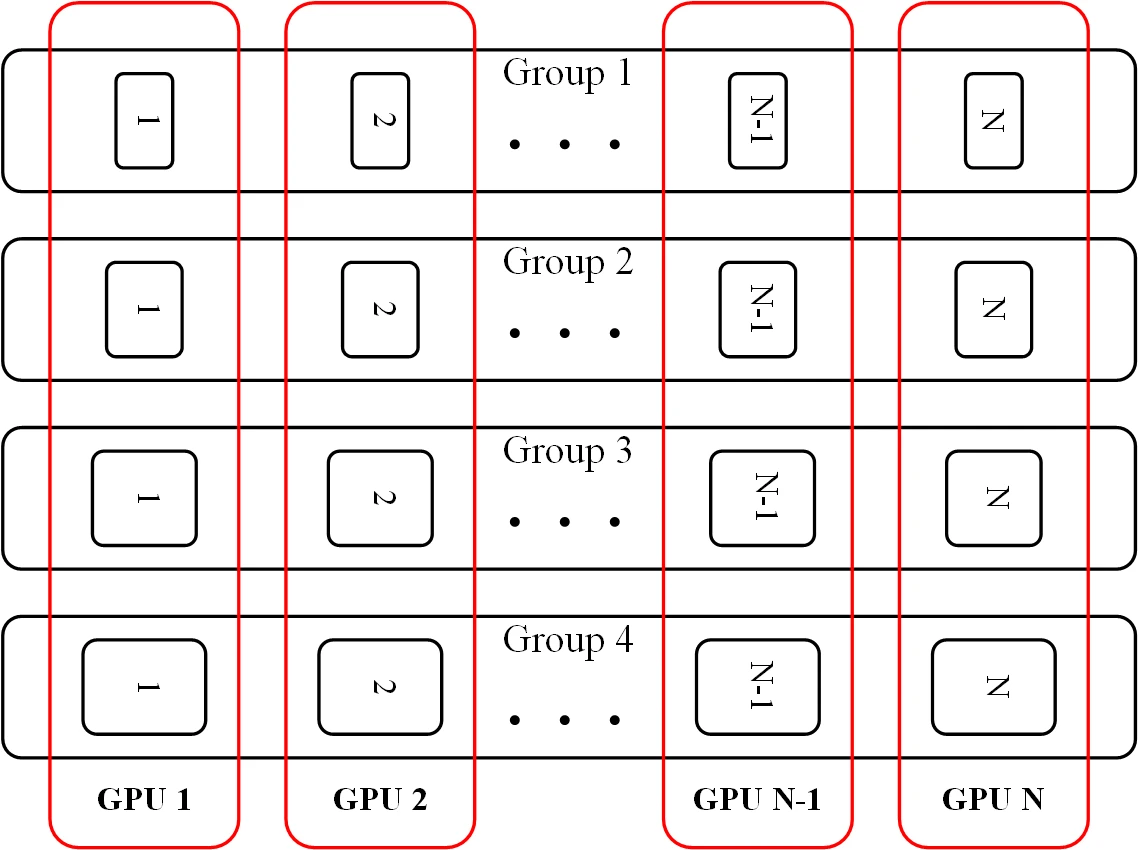
图 2 来自 MoHGE 论文的设备分配示意。横向每一行是同尺寸专家组,纵向每一列是一张 GPU。传统的连续编号放置很可能让 GPU 1 拿到一批小专家、GPU N 拿到一批大专家;MoHGE 则让每张卡都拿到每个组的一个同序号专家,形成一套“全尺寸专家集合”。
设每组有 个专家,恰好使用 张专家并行 GPU,第 张 GPU 放置:
由于每张 GPU 都拥有一份宽度集合 ,其 routed expert 参数量近似相同:
这解决的是静态放置问题:不会有某张卡仅因装了更多大专家而先天占用更多权重显存。当每组专家数多于 GPU 数时,可以让每卡放置每组的相同数量;当两者不能整除时,则需要进一步做组合装箱,论文没有讨论这个一般化场景。
为什么还需要组内均衡损失
静态参数相同不代表运行负载相同。记一个批次中第 张 GPU 上第 组专家收到的 token 数为 ,其 routed FFN 计算量近似为:
若同一组内部的 token 能均匀落到不同设备,即对每个 都有 ,那么无论组间流量怎样变化,各卡的加权和都仍然接近。反过来,即使每卡都有同样的尺寸集合,只要 Group 8 的 token 大量集中到某一张卡,那张卡上的宽专家仍会成为尾部瓶颈。
MoHGE 因而增加 Intra-Group Experts Auxiliary Loss。按归一化形式,它可以理解为:
是专家 在组内的实际选中频率, 是它的平均软路由概率, 是损失系数。频率和概率同时偏高的专家会受到更大惩罚,路由器因而把同组流量摊向其他专家。
这里必须区分两种辅助目标:
- 在组间加入尺寸成本,允许小组比大组更忙;
- 在每个组内部追求均衡,让同尺寸专家在不同设备间分担流量。
如果把所有专家放进一个全局均衡目标,路由器就会被迫让不同尺寸组得到接近的流量,抵消按 token 难度分配算力的初衷。MoHGE 的关键设计是把“容量选择”和“设备均衡”放到两个正交方向上。
通信量不会随专家宽度等比例下降
专家并行的一次典型执行包含 dispatch、expert compute、combine 三段。dispatch 根据路由结果重排 token,通过 All-to-All 把 维隐藏状态送到专家所在设备;combine 再把专家输出发回原设备并加权聚合。
对固定 而言,每个 token 被复制并发送到 6 个 routed experts,通信载荷主要由 token 数、、隐藏维度 和数据类型决定,与专家中间宽度 没有直接线性关系。MoHGE 缩小平均 能明显降低专家 GEMM 的 FLOPs 和权重读取,却不会把 All-to-All 字节数也降低四分之一。因此其端到端加速受计算/通信比例制约:
- 大 batch 或 prefill 阶段,专家 GEMM 更容易形成大矩阵,降低宽度通常能兑现为可见收益;
- 小 batch 的逐 token decode 中,每个专家拿到的 token 很少,通信、路由和 kernel launch 占比上升,理论 FLOPs 降幅可能无法转化为同等延迟降幅;
- 多机专家并行还受网络拓扑影响。若跨节点 All-to-All 已是主瓶颈,减少 FFN 宽度只能优化非主导项。
这也是为什么“激活参数减少 25%”不能直接翻译为“推理快 25%”。论文给出的任务级推理时间确实普遍改善,但幅度大多只有几个百分点到十余个百分点。
异构 GEMM 对 kernel 的新要求
同构 MoE 可以把多个专家拼成 Grouped GEMM:所有专家的矩阵形状一致,只是每个专家的 token 数不同。MoHGE 又增加了 这一维形状差异。若实现简单地为每个专家单独发射 kernel,小专家可能因矩阵太小而无法占满 GPU;若按组分别执行 Grouped GEMM,则最多形成 8 批不同形状的工作,调度和 launch 开销会上升。
高效实现至少要处理四件事:
- 按“专家编号 + 宽度组”对 token 排序,使同形状专家尽量合并执行;
- 为不同 准备合适的 tile 与 workspace,而不是让一个 kernel 配置覆盖所有形状;
- 避免按最大宽度 padding 所有小专家,否则结构上节省的计算会被补零吞掉;
- 在 CUDA Graph 或静态执行图中管理变化的每专家 token 数,必要时按容量桶准备多个图实例。
论文主要证明架构与负载放置可行,并未提供自定义异构 MoE kernel 的微基准。官方仓库依赖 Transformer Engine 与 Megatron 的专家执行路径,说明它更接近可研究、可扩展的系统原型,而不是已经针对所有推理批形状打磨好的服务引擎。
显存收益分成容量与工作集两部分
总参数量减少约 20%,首先降低了模型权重的常驻显存。若采用 BF16,仅看 3B 档论文数字,标准 MoE 的 3.3614B 总参数约需 6.72 GB 权重空间,MoHGE 的 2.821B 约需 5.64 GB,粗略相差 1.08 GB;这未计量化、权重打包、通信缓冲区和框架元数据。
但“本 token 没激活的专家”通常仍常驻 GPU,因此激活参数更少不会自动进一步降低常驻权重显存。它主要降低本步权重读取、计算与中间激活工作集。只有系统引入专家卸载、分层缓存或按需加载时,路由偏向小组才可能进一步减少 HBM 工作集;那又会带来预取命中率和 PCIe/NVLink 传输的新问题。
官方实现中的关键路径
官方 UnicomAI/MoHGE 仓库 基于 Alibaba Pai-Megatron-Patch,核心代码位于 megatron_patch/model/DeepSeek_MoHGE。一次前向传播在 moe/moe_layer.py 中按如下顺序连接:
group_probs, group_routing_map = self.group_router(hidden_states)probs, routing_map = self.router( hidden_states, group_probs, group_routing_map)dispatched_input, tokens_per_expert = \ self.token_dispatcher.token_permutation( hidden_states, probs, routing_map )expert_output, mlp_bias = self.experts( dispatched_input, tokens_per_expert)output, mlp_bias = self.token_dispatcher.token_unpermutation( expert_output, mlp_bias)GroupTopKRouter 负责组打分;TopKRouterForDiffenerentGroup 把 expert logits reshape 为 [tokens, groups, experts_per_group],组内 Softmax 后乘组分数与组 mask,再恢复成扁平专家维度;token dispatcher 支持 allgather、alltoall 和 alltoall_seq 三条路径;专家实现则提供顺序 MLP、Grouped GEMM 和 Transformer Engine GroupedLinear 等选项。
代码中还有一个容易被忽略的重排:全局专家维度先按“组 × 组内编号”计算路由,然后通过 permute 与交错的 rearranged_indices 改成更适合设备放置的次序。专家构造侧使用同一套交错映射决定各本地专家属于哪个宽度组。这不是数学公式的一部分,而是把 All-size 分配落到连续 global expert ID 的桥梁。
当前仓库 README 只给出 3B 示例,并明确要求 Transformer Engine;它没有提供 Hugging Face 权重、预训练 checkpoint、vLLM/SGLang 接入或独立推理 benchmark 脚本。因此代码公开不等于可以直接把现有同构 MoE checkpoint 转成 MoHGE,也不等于主流服务框架已经原生支持其异构专家布局。
还要注意论文与仓库快照的配置差异。论文表 7 的 3B 配置是 ,消融选择 、;截至仓库提交 7ded030,pretrain_deepseek.py 中组 Top-K 为 4、组损失系数为 ,shell 示例中的专家损失系数为 。仓库代码可以验证实现思路,却不能仅凭默认参数复现论文表格。严谨复现需要按论文覆盖这些参数,并核对对应 Megatron-LM 快照。
实验结果应该怎样解读
先看对照是否公平
论文评估 1B、3B、14B 三档模型,所有档位隐藏维度均为 1024,主要通过层数、专家数和 FFN 宽度扩展。MoE baseline 改自 DeepSeek-V2 式结构,并与 MoHGE 使用相同的 routed expert 数、Top-6 激活和 2 个共享专家。实验语料由 DataComp-LM、FineWeb 与 The Pile 合并去重,取 0.58T token;这段设置用于说明模型比较口径,不影响推理机制本身。
Dense baseline 的总参数被设置到接近 MoE 的激活参数,而不是接近 MoE 的总参数。因此三种模型回答的问题不同:Dense 代表“相近单步参数量下,不付稀疏路由代价”;标准 MoE 代表“同构稀疏容量”;MoHGE 代表“更少总参数与动态激活宽度”。不能把三者简单视为等参数模型。
参数节省是真实的,但各档并非都恰好 20%
| 档位 | 标准 MoE 总参数 | MoHGE 总参数 | 总参数降幅 | 标准 MoE 激活专家参数 | MoHGE 激活专家参数 | 激活降幅 |
|---|---|---|---|---|---|---|
| 1B | 1.098B | 0.891B | 18.9% | 0.163B | 0.122B | 25.2% |
| 3B | 3.3614B | 2.821B | 16.1% | 0.376B | 0.295B | 21.5% |
| 14B | 16.760B | 14.122B | 15.7% | 1.191B | 0.843B | 29.2% |
“约 20% 总参数”和“约四分之一激活专家参数”是跨配置概括。逐档看,总参数降幅为 15.7% 到 18.9%,激活专家参数降幅为 21.5% 到 29.2%。这组数字验证了前面的结构分析:静态总参数节省来自较小的平均组宽度,动态激活节省还取决于路由分布。
在准确率方面,MoHGE 在论文表 1 的 3B 与 14B 两档大多数基准上持平或高于标准 MoE。例如 14B 档 MMLU 为 31.62 对 31.18,LAMBADA 为 69.89 对 67.94,MATH 为 9.42 对 7.30。这里更合理的结论是“缩减参数后没有观察到系统性退化”,而不是把绝对分数包装成能力跃迁:模型规模、训练量与这些早期检查点决定了分数整体并不高,且论文没有给出显著性检验。
激活参数下降为何只换来个位数速度收益
论文报告的是完成整个下游评测的总时长,而不是每 token 延迟或 tokens/s。以 3B 档为例:
| 任务 | 标准 MoE | MoHGE | 相对变化 |
|---|---|---|---|
| MMLU | 9.85 h | 9.58 h | 快 2.7% |
| SIQA | 1.29 h | 1.17 h | 快 9.3% |
| LAMBADA | 3.17 h | 3.03 h | 快 4.4% |
| PIQA | 1.20 h | 1.09 h | 快 9.2% |
| TriviaQA | 5.78 h | 5.46 h | 快 5.5% |
| GSM8K | 0.84 h | 0.86 h | 慢 2.4% |
这个结果与系统成本分解相符。FFN 激活参数减少 21.5%,但注意力、共享专家、路由、token permutation、All-to-All 和 kernel launch 都没有同比减少,所以端到端收益显著更小。GSM8K 反而略慢,论文解释为数学推理输入更多选择大专家组;这说明动态计算确实会随工作负载改变,但也意味着服务容量规划不能只拿平均值。
Dense baseline 在若干任务上仍然更快。例如 3B 对应的 0.807B Dense 在 MMLU 上耗时 9.06 h,低于 MoHGE 的 9.58 h。稠密矩阵执行规整、不需要 dispatch/combine,当总参数接近 MoE 激活参数时,这种效率优势并不意外。MoHGE 的卖点是用更多稀疏总容量换取质量,同时缩小相对标准 MoE 的成本,而不是在所有条件下击败等激活规模 Dense。
组级辅助损失确实改变了路由
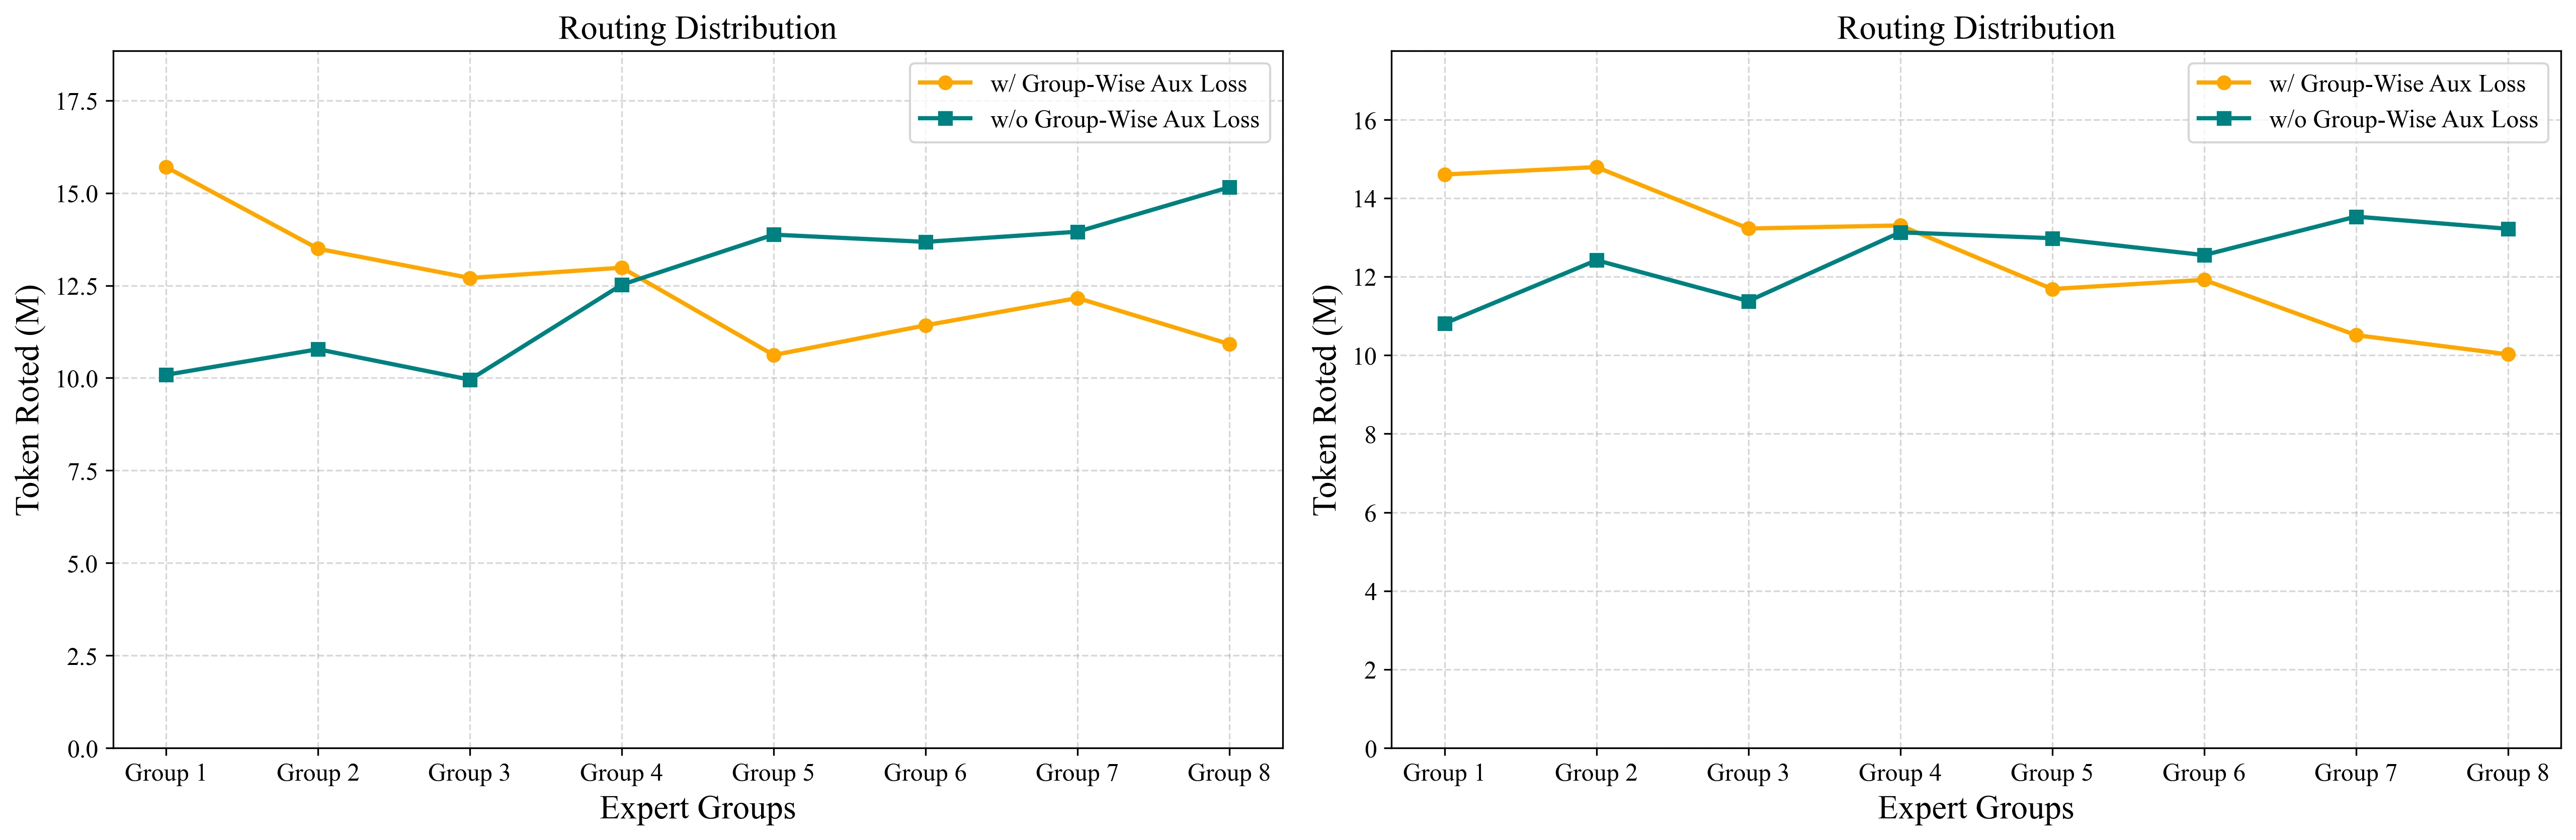
图 3 由论文 Figure 3 的两幅官方图合并,左侧为 3B,右侧为 14B。横轴从 Group 1 到 Group 8,专家宽度逐渐增加;纵轴是对 1 亿次 token 路由的计数。未使用 Group-Wise Auxiliary Loss 时,曲线整体偏向大组;加入损失后,小组流量明显增加,大组流量下降。
消融实验进一步分离了两项损失。在 3B 档,不使用任何辅助损失时激活专家参数为 324M;仅加入 的组内专家损失后降到 307M;再加入 的组级损失后降到 295M,并在多数报告任务上取得该组最好的综合结果。若把系数继续增大,激活参数还能降到 289M,但部分任务分数回落。这符合一个清晰的 Pareto 权衡:成本惩罚过弱,大专家仍占主导;惩罚过强,路由器会为了省参数而放弃有用容量。
论文还用 token 频次排名和困惑度作为难度代理。高频 Top 1K token 被路由到 Group 1 的比例为 16.3%,到 Group 8 为 9.7%;排名超过 10K 的低频 token 则分别为 11.3% 与 13.3%。困惑度不超过 5 的 token 在 Group 1、8 上分别占 14.0%、10.0%,困惑度大于 10 时变为 12.2%、13.2%。趋势符合“容易 token 偏小组、困难 token 偏大组”,但差距并不巨大,而且频次、困惑度都只是难度代理,不能证明路由器学到了可解释的推理复杂度。
“GPU 均衡”证据需要准确表述
14B 实验中,每个组的 token 在 8 张 GPU 上大约各占 12% 到 13%,报告的标准差约为 0.0020 到 0.00304。这很好地证明了组内专家流量被均匀摊到设备,也支持 All-size 放置的前提。
但论文表 3 统计的是 token 路由比例,不是 SM occupancy、HBM 带宽、kernel duration 或端到端每卡利用率时间线;表 6 的 GPU utilization 也只给出 balanced/unbalanced 定性标签。因而最稳妥的结论是“路由计数与静态放置共同预测出均衡的计算负载”,而不是“已经用硬件计数器证明所有 GPU 利用率完全相等”。生产部署仍应测每卡 expert GEMM 时间、All-to-All 等待时间与尾部空泡。
与标准 MoE、共享专家和细粒度专家的边界
MoHGE 容易与几类相关设计混淆,区别可以归纳为下表。
| 方案 | 动态变量 | 路由问题 | 设备放置重点 |
|---|---|---|---|
| 标准同构 Top-K MoE | 专家身份 | 从等宽专家中选固定 个 | 均匀分配专家数即可近似平衡参数 |
| Top-P Dynamic MoE | 激活专家个数 | 置信度不足时继续增加专家 | 每 token 通信副本数也随之变化 |
| MoDSE/HMoE | 专家尺寸与身份 | 在完全或混合异构集合中选专家 | 需要配对或额外策略平衡大、小专家 |
| MoHGE | 容量组 + 组内专家身份 | 先选容量候选,再全局选固定 | 每卡持有全尺寸集合,组内均衡 |
| DeepSeekMoE | 细粒度专长 + 共享知识 | 更多、更窄的同构 routed experts | 重点是专家细分、共享隔离与专家并行 |
Top-P 路由通过改变专家数量来调节计算:简单 token 可能只走少量专家,困难 token 走更多专家。MoHGE 固定专家数量、改变宽度组合。前者会让 dispatch 通信副本数随 token 改变,后者在 固定时通信条目数更稳定,但 GEMM 形状和 FLOPs 动态变化。二者并不互斥,理论上可以同时让专家数量和宽度可变,只是调度空间与负载控制会更复杂。
DeepSeekMoE 的细粒度专家切分也会使用更多小专家与共享专家,但目标是让知识分解得更细,并始终分离公共知识。MoHGE 的组内专家同样承担专长,组间宽度则显式代表容量层级。若需要先理解细粒度 routed experts 与 shared experts 的基本关系,可参考 DeepSeekMoE 完全拆解;MoHGE 论文的 baseline 也正是从 DeepSeek-V2 式 MoE 调整而来。
系统层面,MoHGE 没有消除专家并行的 dispatch/combine。它改变的是专家布局和每卡工作组合,底层仍需要高效的 All-to-All。相关通信路径与低延迟/高吞吐模式可参考 DeepEP 完全拆解。若将 MoHGE 接入服务引擎,通信库、异构 Grouped GEMM 和路由感知调度必须一起优化,只改模型类通常不够。
局限与可部署性判断
这不是现有 MoE 的无损后处理插件
专家宽度、组结构和两级路由都在模型构建时确定,辅助损失又负责塑造路由行为,因此无法把一个训练完成的同构 MoE 仅靠重新排列权重就变成 MoHGE。直接裁剪不同专家的中间维度会破坏已有功能分布;只增加组路由器而不重新学习,也没有可靠的容量选择信号。它是一种模型架构,而不是像 KV Cache 管理那样可独立替换的服务组件。
组宽度与组数仍是人工设计空间
论文固定 8 个组,并手工给出三档宽度序列。8 组是否优于 4 组或 16 组、宽度应该线性还是非线性增长、不同层是否应使用不同序列,都没有系统消融。越多的组提供越细的计算档位,却会减少每组专家数、削弱组内专长多样性,也让 kernel 形状更多;越少的组更容易执行,但动态计算粒度变粗。
一个更完整的设计目标应同时考虑质量、平均 FLOPs、P99 延迟、权重显存、All-to-All 字节数和 kernel 数量,而不只是总参数与基准分数。特别是硬件偏好的对齐宽度可能比均匀数学间隔更重要:中间维度若能与 Tensor Core tile、量化 group size 和内存对齐共同设计,才更可能兑现理论节省。
平均均衡不等于单步无尾部
辅助损失在较长统计窗口上平衡流量,但在线服务每个 decode step 的 token 数有限,短时路由可能仍然倾斜。一个批次里只要某张卡收到较多大专家 token,其他卡就会在同步点等待。论文没有报告不同 batch size 下的负载方差、P95/P99 token latency,也没有分析突发请求或领域漂移后路由分布是否变化。
服务引擎可以进一步使用容量限制、冗余专家、动态 expert replication 或路由感知批处理,但这些机制可能改变模型原始 Top-K,或者增加显存与同步复杂度。官方 MoELayer 的注释明确写着当前只支持 no token dropping,意味着拥塞时优先保持语义正确性,而不是通过丢 token 获得固定容量上界。
推理时间口径还不够支撑生产容量估算
论文说明模型构建使用 16 节点、每节点 8 张 NVIDIA GPU,却没有在推理时间表附近给出 GPU 型号、并行策略、batch size、输入输出长度分布、精度、warm-up 和 kernel 配置。以“完成某个数据集需要多少小时”为指标,能在相同实验环境中比较三个模型,却很难外推到另一套服务环境。
生产评估至少需要补齐:
- prefill 与 decode 分离的 tokens/s、TPOT 和 TTFT;
- 不同并发、上下文长度与输出长度下的 P50/P99;
- 每个宽度组的实际 GEMM 时间与 achieved FLOPs;
- 每张 GPU 的 token 数、加权 FLOPs、HBM 带宽和同步等待;
- NVLink 与跨节点 RDMA 上的 dispatch/combine 字节数和耗时;
- 组路由分布随领域、语言和请求难度的漂移。
在这些数据缺失时,MoHGE 最强的证据是“更少总参数、较少平均激活参数、路由计数均衡且任务总时长略优”,而不是已经证明任意服务栈上都能获得稳定吞吐提升。
官方开源仍缺少完整推理交付物
仓库给出了核心模型代码和 3B 构建示例,这是验证算法路径的重要一步;但没有公开可直接评测的 checkpoint,也没有服务框架适配。仓库还要求外部 Megatron-LM 快照,而 README 未固定具体 commit。再叠加论文参数与示例默认值不同,复现者需要自行锁定依赖并补齐配置。
因此,当前更合适的落地顺序是:先在 Megatron 环境中复现单层路由与参数量;再用合成 token 分布验证每卡加权工作量;随后比较顺序 MLP、同组 Grouped GEMM 和异构融合 kernel;最后才进入完整模型的吞吐与尾延迟评测。若第一阶段就只看模型准确率,很容易漏掉这项工作的系统价值;若跳过准确率只做静态 FLOPs,又会漏掉路由偏向大组时的动态代价。
小结
MoHGE 把异构 MoE 中纠缠的三个问题拆开了:组间宽度负责表达计算档位,组内多个同构专家负责表达语义专长,每张 GPU 的全尺寸专家集合负责静态放置。两级路由先用组门控裁出容量候选,再让候选专家全局竞争固定的 Top-;Group-Wise Auxiliary Loss 为大组加入轻量计算价格,Intra-Group Experts Auxiliary Loss 则只在同尺寸专家内部平衡流量。
从推理角度看,它最重要的结论不是“所有 token 少算同样多”,而是“固定激活专家数也可以拥有输入相关的计算量”。论文三档配置将总参数降低 15.7% 到 18.9%,将 routed experts 的激活参数降低 21.5% 到 29.2%,端到端任务耗时大多获得个位数百分比改善。这个差距同时揭示了架构收益与系统上限:FFN 变窄不会消除注意力、共享专家、All-to-All、路由和 kernel launch。
它也提供了一条清晰的后续工程路线。模型侧要联合搜索组宽度、组数与损失系数;运行时要按形状聚合异构 GEMM;服务侧要用短时负载、通信与尾延迟验证 All-size 放置是否真正均衡。只有这三层共同成立,“按 token 难度购买计算”才会从参数表上的节省变成可持续的在线推理收益。
参考资料
- Mixture of Heterogeneous Grouped Experts for Language Modeling(ACL 2026)
- MoHGE arXiv 论文与 HTML 全文
- UnicomAI/MoHGE 官方代码仓库
- Mixture of Diverse Size Experts(EMNLP 2024 Industry Track)
- HMoE: Heterogeneous Mixture of Experts for Language Modeling
- Harder Tasks Need More Experts: Dynamic Routing in MoE Models(ACL 2024)
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


