


前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU
问题不是“有没有前缀缓存”,而是“满了以后丢谁”
长对话和 Agent 工作流有一个稳定的形状:第 轮请求通常不是一段全新的文本,而是在第 轮完整上下文后追加用户输入、工具结果或模型反馈。前面已经计算过的 token 若再次做 prefill,不仅浪费矩阵乘,还会让首 token 延迟(TTFT)随上下文继续增长。现代推理服务因此把已完成请求的 KV 状态留下来;后续请求只要具有完全相同的 token 前缀,就能直接复用这些 KV,从第一个未命中的位置继续计算。
但“保留所有历史 KV”只在容量无限时成立。单卡 HBM 里的 KV 空间往往只有几十 GiB,跨节点 DRAM/SSD 池虽然可达 TiB,元数据、网络和存储容量仍有边界。当新请求到来、空间不足时,系统必须回答三个问题:
- 淘汰最近最少使用的块,还是淘汰历史访问次数最少的块?
- 每个命中块都算作一次命中是否合理,还是应该优先保护重算代价更高的深层块?
- 淘汰单个 block、前缀树节点,还是整个 session?
哈佛大学 Yiyu Liu、Minlan Yu 与 Juncheng Yang 于 2026 年 9 月发布论文 When Fancy Eviction Fails: Rethinking Cache Replacement For LLM Prefix Reuse,第一次用两家推理服务的生产轨迹系统比较 14 种在线缓存替换算法。最醒目的结论是:ARC、LHD、LeCaR、LRB、3LCache 等复杂算法并没有稳定胜过 LRU,LFU 与 W-TinyLFU 这类频率导向策略甚至明显退化;可预知未来访问的 Belady 离线最优却仍高出一截。
这不是“LRU 已经最优”,而是两个更有价值的判断:
- LLM 前缀缓存的访问结构与 Web CDN、磁盘块缓存不同,直接移植为后两者设计的复杂策略,经常优化错了信号;
- LRU 抓住了最重要的 recency,但没有处理深层 KV 重算更贵、超长 session 占用呈重尾分布等前缀缓存特有问题。
论文最终给出的不是一个到处通吃的新算法,而是一套条件化设计:以 LRU 为底座,只在负载确实需要时加入 one-hit 快速降级、计算感知评分、连续片段淘汰和分层粒度选择。
先把对象说清:前缀树、物理块与两级容量
前缀缓存复用的是什么
对自回归 Transformer,第 个 token 在某层产生的 key 与 value 只依赖它自己及之前的 token。设 token 前缀为 ,模型参数固定且推理时关闭 dropout,则 KV 可以写成确定函数:
只要两个请求的 完全一致,对应 KV 就完全一致。前缀缓存因此是精确复用,不改变模型输出分布;miss 的代价只是重算。它不同于在单个活跃请求内部删掉低价值 KV 的近似压缩方法,后者可能改变注意力结果。前缀缓存的优化对象是跨请求已经完成的计算。
系统通常把 KV 切成固定大小的物理块。论文统一使用每块 16 token:一个 16000-token 的可复用前缀对应 1000 个块。逻辑上,SGLang 可以把这些块组织成基数树,vLLM 可以为“父块哈希 + 当前块 token”计算链式哈希;物理上,它们都需要把可复用块映射到内存页,并在空间不足时选择 victim。逻辑匹配结构和物理驻留策略可以分开:某个深层块仍在缓存时,即使它前面的浅层块已被淘汰,系统也能先重算浅层缺口,再接上仍然有效的深层 KV。
关于最长前缀匹配、节点分裂和引用计数,可先参考站内的 RadixAttention 完全拆解;本文关注它只用一句“LRU 淘汰”带过的下一层问题:LRU 为什么有效,又在哪些负载上不够。
三种状态不能混为一谈
一个 KV block 至少有三种彼此独立的属性:
- 可匹配:哈希表或前缀树里仍能找到它;
- 驻留:它的 KV 张量还在某一级物理内存;
- 在用:当前正在运行的请求持有引用,不能被覆盖。
请求结束后,引用计数可以降到零,但 block 仍可匹配且仍驻留。这正是缓存能够服务未来请求的窗口。新分配需要回收空间时,系统只能从“不在用”的块里选择 victim;淘汰动作会清除其可匹配身份,并把物理页交给新 KV。vLLM V1 的 free queue 就同时承担空闲页队列和 LRU 顺序,具体的 touch、allocate、free 与抢占路径可参考 vLLM 调度器源码拆解。
HBM 与大容量池不是同一种缓存
论文评估两类容量层级:
| 层级 | 容量范围 | 典型作用 | 主要约束 |
|---|---|---|---|
| 单副本 HBM | 24–120 GiB | 直接供注意力 kernel 读取 | 容量紧、block 已是原生管理粒度 |
| 全局 DRAM/SSD 池 | 0.25–12 TiB | 为 GPU 预取或远程拉取可复用 KV | 元数据规模、网络/存储访问、跨副本共享 |
在 HBM 中,少淘汰一个错误 block 可能立刻降低下一次 prefill;在 12 TiB 池中,若仍以 16-token block 管理,就要索引约 840 万个条目。后者可能宁愿把粒度放大到 256–512 token,甚至整 session 管理,换取更低的元数据和控制面成本。这也是为什么同一个“最佳策略”不可能同时适配两层。
生产轨迹与模拟器:这组结论是怎样得到的
缓存算法对 trace 极其敏感。若只用合成 Zipf 分布,容易把“热门对象会被许多独立用户反复访问”当成前缀缓存的默认结构;但 Agent 的主要复用来自同一 session 的连续轮次。论文选用两条生产轨迹,并用 Qwen3-Coder-30B tokenizer 重新切成 16-token block:
| 指标 | FreeInference Trace | Chutes Trace |
|---|---|---|
| 请求数 | 327.5K | 515.8K |
| 多轮 session 中的请求占比 | 34.3% | 26.1% |
| 时间跨度 | 7.0 天 | 130.9 天 |
| 总处理 token | 10.5B | 9.7B |
| 唯一 token | 0.63B | 2.23B |
| 平均请求长度 | 32.0K | 18.7K |
| P99 请求长度 | 219.3K | 98.3K |
FreeInference 以 Agent 流量为主,也含普通 API 请求;Chutes 则混合 Agent、多轮人工对话与单轮 API。序列按 Qwen3-Coder-30B 的 256K 上下文上限截取,超限请求分别跳过 4.3% 与 0.03%。论文还用四条 Qwen Bailian 轨迹和 AgentX 回放验证结论,不把单一生产服务的行为直接推广为普遍定律。
普通 block-cache 模拟器还不够。推理引擎有一个关键的请求级驻留约束:某个请求执行 prefill 时,它本轮所需的全部 block 必须同时有位置,不能因为逐个访问而假装用极小缓存流式扫过。论文基于 libCacheSim 实现 C++ 模拟器,在请求到达时先主动淘汰足够多的 block,为整个输入前缀腾出空间。其 hit ratio 与原生 vLLM 很接近,而评估速度最高达到 vLLM Python 实现的 160 倍。
这里的比较目标也要限定清楚:第 3 节先采用 uniform cost,把每个 block hit 都记作同等价值,以便与传统缓存算法公平比较;后面才把 token 深度导致的非均匀重算成本放进 compute-savings ratio。若一开始把两种目标混在一起,就无法判断差异来自访问预测,还是来自成本模型。
第一个反常识结果:复杂策略为什么赢不了 LRU
论文把 14 种在线算法按主要信号分成六组:
| 类别 | 算法 | 主要假设 |
|---|---|---|
| Recency | LRU | 越久未访问,越不值得保留 |
| Quick demotion | ARC、Sieve、S3-FIFO、S4-FIFO、LIRS | 尽快把只访问一次的对象降级或赶出主缓存 |
| Analytic modeling | LHD | 用概率与成本模型估计 hit density |
| Frequency | LFU、W-TinyLFU | 历史访问越频繁,未来越可能访问 |
| Learned | LeCaR、LRB、3LCache | 学习 recency、frequency 或未来复用之间的组合关系 |
| 前缀缓存专用 | Workload-aware、AsymCache | 利用 LLM workload 或前缀结构设计优先级 |
此外还有 Belady 离线 Oracle:它知道每个 block 下一次何时访问,总是淘汰“未来最晚才会再用”的对象。Belady 不能在线部署,但能回答一个关键问题:当前 trace 里究竟有没有比在线算法更大的提升空间。
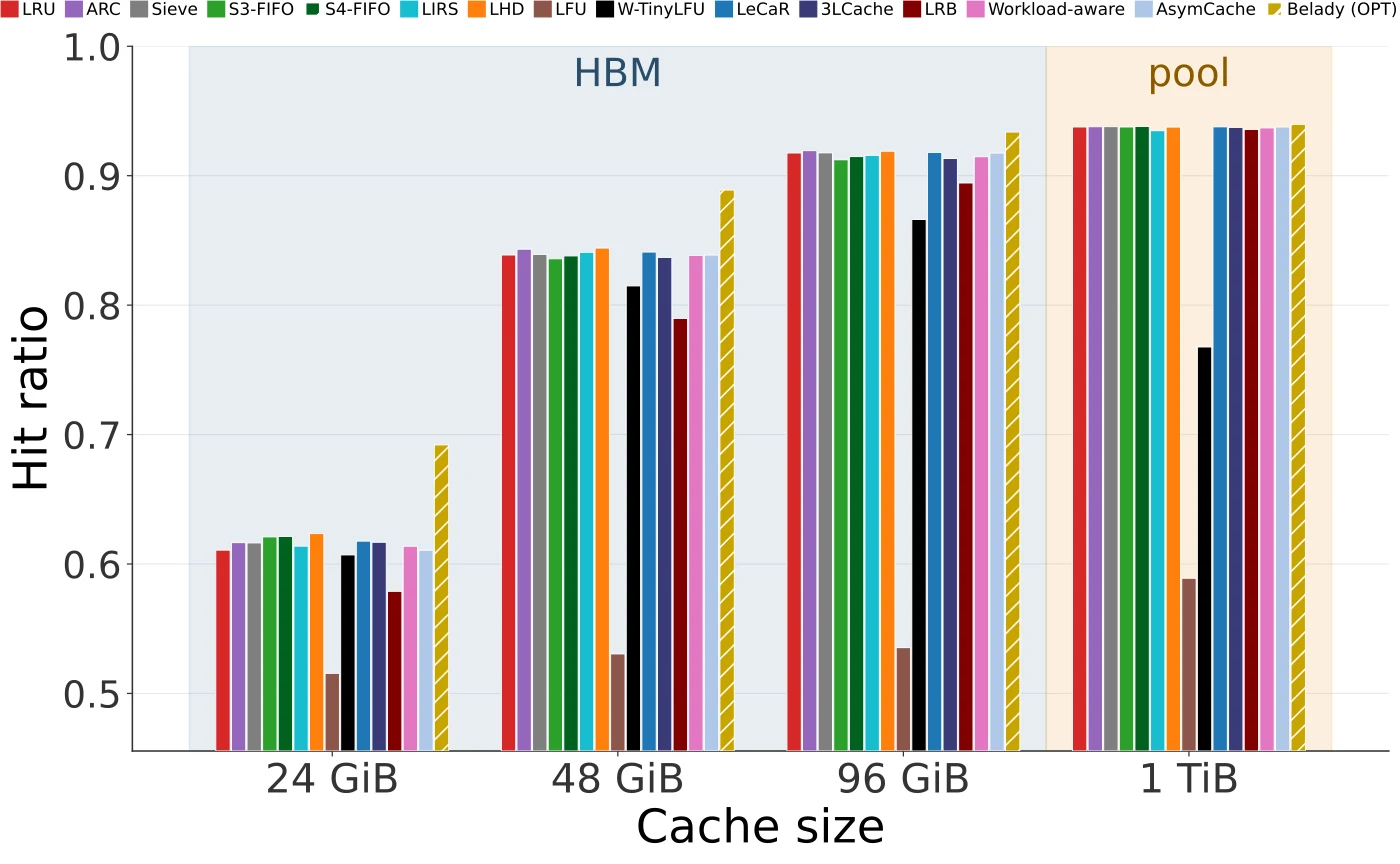
图源:论文 Figure 2(a)。颜色依次对应 LRU、五种 quick-demotion、LHD、两种频率策略、三种学习策略、两种前缀专用策略与 Belady;24/48/96 GiB 属于 HBM 区间,1 TiB 属于大容量池区间。
图中有三组清晰行为。
第一组是“复杂但近似 LRU”:ARC、LHD、LeCaR、3LCache、LRB、Workload-aware 与 AsymCache 大多只和 LRU 持平或略差。它们添加了更多状态和决策,却没有获得比“多久没访问”更强的在线信号。
第二组是“依赖 trace 的快速降级”:S3-FIFO、S4-FIFO、Sieve 与 LIRS 有时略有收益,有时退化数个百分点。它们真正擅长的是阻止 one-hit wonder 污染主缓存;若一次性短 prompt 的总 footprint 不够大,额外过滤不会带来多少空间,反而可能过早丢掉即将进入第二轮的 session。
第三组是“频率崩溃”:LFU 与 W-TinyLFU 明显落后。问题不在实现,而在语义。一个 session 第一轮生成的 block 会被后面每一轮反复读取,所以越靠前的 block 天然频率越高;但整个 session 可能已经结束。累计访问 100 次的旧 block,不一定比 8 秒前刚写入、即将进入下一轮的 block 更有价值。频率记录了“会话走了多远”,却没有回答“下一轮什么时候来”。
最重要的对照是黑色 Belady 柱仍明显更高。这排除了“容量已经足够、所有算法都触顶”的解释。可利用空间确实存在,只是传统算法使用的 frequency、ghost history、learned reuse 等信号没有捕捉到前缀缓存的真正结构。
五个负载性质,以及它们怎样推导出策略
性质一:生命周期被 session 截断
Web 对象来自长期存在的全局集合,热门页面可以连续数天被不同用户访问;磁盘块也可能在长期任务中反复出现。前缀 KV 则是在对话推进时动态生成的,多数 block 的价值随 session 结束而终止。生产轨迹中,多轮 session 的中位持续时间只有 55 秒,P90 为 843 秒,P99 约 4.17 小时;多数被复用的前缀 block 生命周期短于 30 分钟。
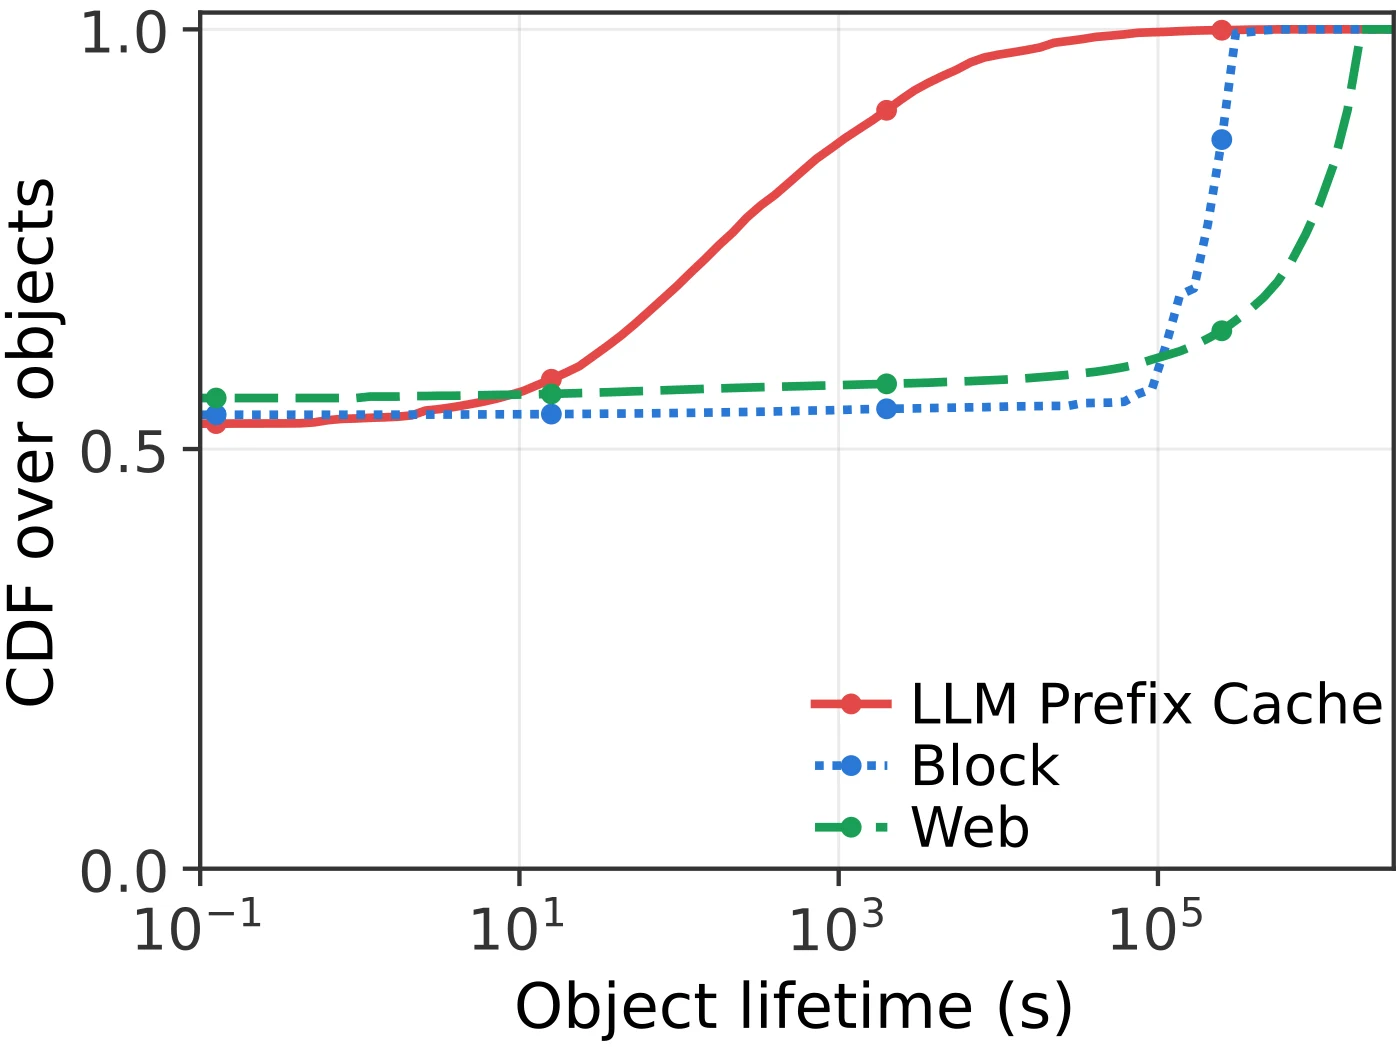
图源:论文 Figure 3(a)。红线代表 LLM 前缀 block;它比传统 Web 与存储对象更早进入 CDF 高位,说明大多数对象更快失去后续价值。
论文进一步把 block 分成三类:
- system prompt 只占唯一 block 的 4.7%,却贡献 18.4% 的访问,可跨 session 共享,中位生命周期 291 秒,P99 约 3.6 天;
- 多轮历史占唯一 block 的 37.6%,贡献 70.2% 的访问,是复用主体,但严格受原 session 约束,中位生命周期 219 秒;
- 单轮 prompt 占唯一 block 的 57.8%,只贡献 11.4% 的访问,其中 84.9% 只访问一次。
这组分解说明“所有前缀都短命”也不准确。system prompt 有跨会话热度,多轮历史有短而密集的 session 内复用,单轮 prompt 则制造大量一次性对象。替换策略需要让 recency 处理前两者的时间局部性,再视 one-hit 流量是否足够大决定要不要加 admission filter。
两个相邻 5 分钟窗口的工作集 Jaccard overlap 超过 30%,但间隔两小时后接近零;Web trace 则长期保留约 5% 的全局热门核心。于是前缀缓存的有效工作集可以粗略估为:
其中 是新 block 到达速率, 是 session 有效生命周期。这个式子不是精确容量规划器,但揭示了主导变量:为了保留几天的全部历史而盲目扩容,通常不如覆盖“当前活跃 session 的产生速率乘存活时间”。FreeInference 上,96 GiB 只容纳不足全部唯一 block 的 0.2%,hit ratio 已经很高,原因正是旧工作集迅速失效。
性质二:复用间隔短而集中
Agent 发出工具调用后,工具结果通常在几秒到几十秒内返回;人工多轮对话也呈轮次连续性。轨迹中 session 内两次请求间隔的中位数为 8.2 秒,P90 为 47 秒,P99 为 409 秒,99.7% 的间隔短于 22 分钟。system prompt 与多轮历史 block 的中位复用间隔分别是 10.0 秒和 11.2 秒。
因此,刚刚用过的 block 很可能属于仍活跃的 session;一个长时间静默的 block 即便历史上很热门,也更可能来自已经结束的工作集。把它为一次长尾复用钉在内存里,会持续挤走许多短间隔对象。LRU 恰好直接编码了这一事实:idle time 越长,优先级越低。
性质三:频率追踪进度,而不是下一次到达
设一个 session 有 轮,第 轮插入的早期 block 理想情况下可能被后续约 轮读取。访问频率因而近似包含两个变量:session 总轮数,以及 block 在 session 中出现的位置。轨迹中的多轮 session 中位轮数为 5,P90 为 30,P99 为 168,最大达到 412;system prompt 和多轮历史 block 的中位访问次数分别为 15 与 12。
但在前缀 trace 里,频率从 1 增到数百时,复用间隔几乎保持水平;在 Web 和磁盘 trace 中,高频对象的间隔通常会缩短。前缀 block 不是被许多并发用户以更高总速率访问,而是跟随一个 session 的稳定节拍。LFU 把“旧 session 已经走了很多轮”误解成“马上还会来一轮”,所以会把过期历史保护得太久。
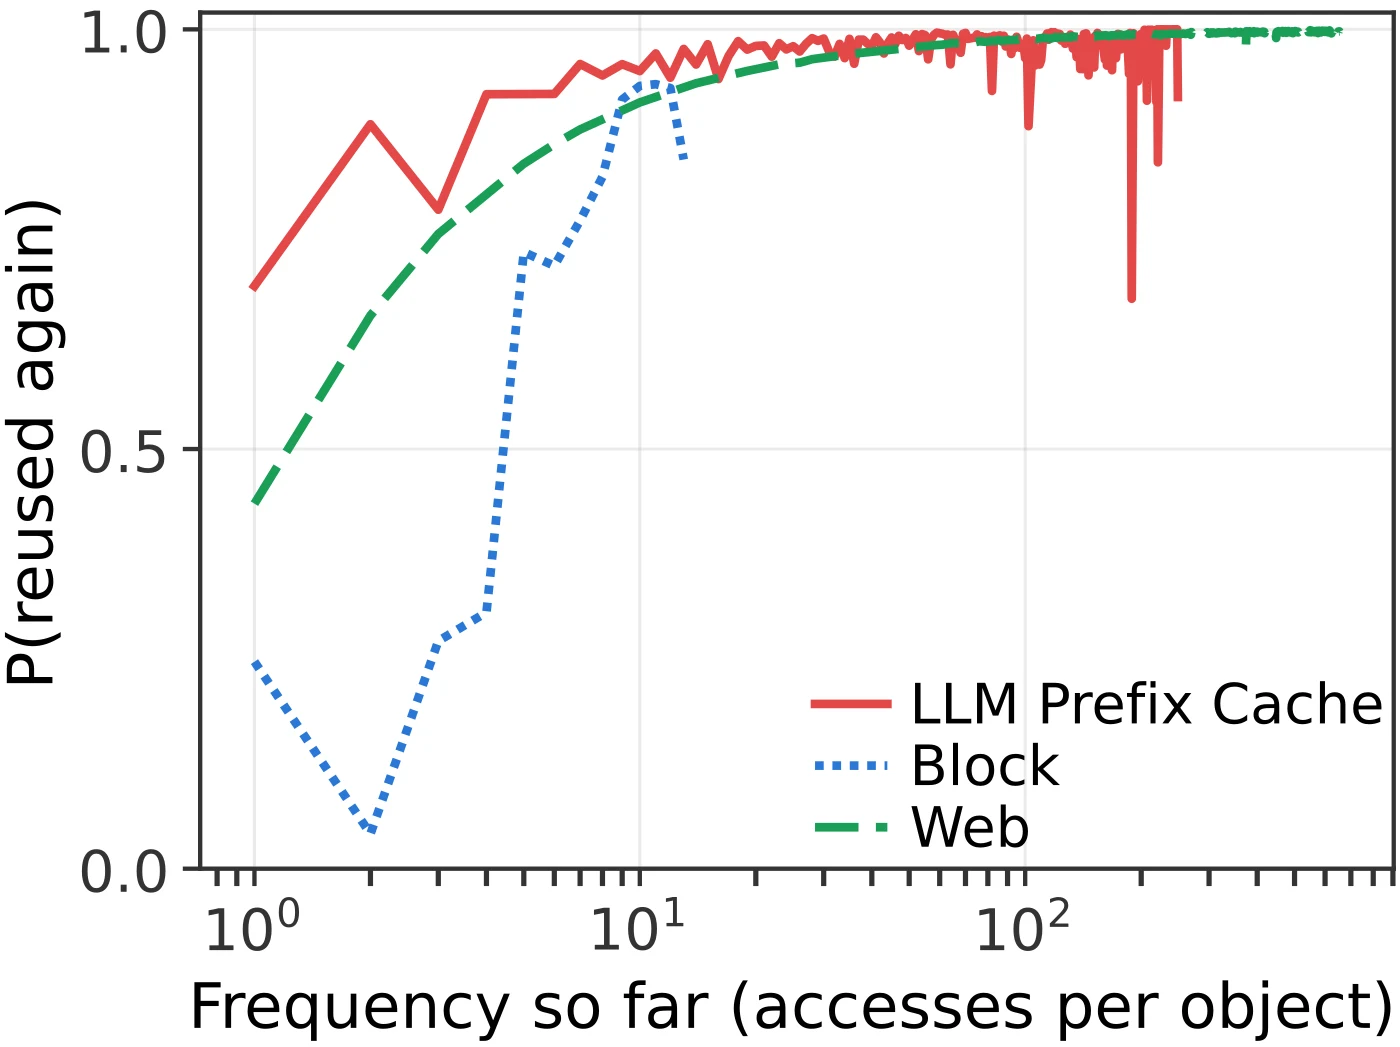
图源:论文 Figure 5(c)。红线表明前缀 block 从第一次访问到第二次访问时,未来再复用概率由 69.4% 跳到 88.7%;再继续累加频率,边际信息迅速减弱。
频率并非完全无用。它适合作为 admission signal:第二次命中能有效区分“一次性 prompt”和“已经建立的多轮 session”。但它不适合作为主缓存中的全局排序键。可以把结论概括为:用早期频率决定“是否晋升”,用 recency 决定“先淘汰谁”。
性质四:同样大小的 block,miss 成本随深度变化
若模型含 full attention,位置 附近的新 token 要与前面约 个 key 做点积。两个 block 都含 16 token、占相同 KV 字节,但重算靠近 64K 位置的 block,注意力 FLOPs 远高于重算开头的 block。论文在单张 NVIDIA H200 上用 Qwen3-Coder-30B 测量:两个请求都需新算 8K token,一个从头算耗时 166 ms、约 71.1 TFLOP;另一个在 64K cached prefix 后计算同样 8K token,耗时 966 ms、约 493.3 TFLOP。
这意味着普通 hit ratio 把价值差异巨大的事件都算作“一个 hit”。若两个候选 block 的复用概率相近,保留深层 block、牺牲浅层 block,可能在 hit 数不变的情况下显著减少实际 prefill 工作。后文的 compute-savings ratio 就为此而设。
性质五:session footprint 呈重尾分布
单个 session 的 KV 占用跨越多个数量级。中位 session 只有 45 个 block,约 0.07 GiB;P99 达到 8.3K block,约 12.2 GiB;最大 session 甚至达到 234 GiB,单独就超过常见 GPU 的可用 KV 空间。Top 10% session 占去 76.2% 的 KV 字节,Top 1% 也占 20.3%。
重尾分布让“整 session 淘汰”在小缓存里变成危险的全有或全无决策:保留一个巨型 session,可能挤走大量正常 session;整个丢掉它,又会毁掉其中仍高价值的深层历史。细粒度 partial eviction 能从巨型 session 回收一部分容量,同时保留其余上下文。到了 TiB 级池,容量压力缓和,整 session 淘汰造成的命中损失接近消失,才值得用粗粒度换取更小的元数据开销。
命中率不等于省算力:Compute-Savings Ratio
从计数目标改成成本目标
把整条 trace 展开为 block 访问事件集合 。事件 是否命中记为 ,传统 block hit ratio 为:
这个指标隐含了“每个 block 的 miss 成本都等于 1”。若事件 对应 block 的重算成本为 ,更贴近服务目标的 compute-savings ratio(CSR)可以写成:
分子是所有命中实际避免的计算量,分母是假设全部 miss 时的总重算量。当 为常数时, 约掉,CSR 就退化为 HR;只要深层 block 比浅层 block 贵,两者就可能给出不同的策略排名。
对 block 大小 、模型宽度 、位置深度 ,一层 full attention 为该 block 做 QK 点积与对 V 加权的主要 FLOPs 可近似写为:
前一个系数 2 来自乘加各计一次 FLOP,QK 与 AV 两次矩阵乘再带来一个系数 2。投影与 MLP 对每个 token 的成本主要不随 增长,因此一个含 个 full-attention 层的简化模型为:
汇总 Q/K/V/O 投影、MLP、归一化等近似位置无关的成本。论文的 Qwen3-Coder-30B 成本模型使用模型实际 FLOPs,而不是直接套这个简式;简式的作用是解释为什么深度差异会存在。若模型大量使用 sliding-window attention, 会被窗口宽度截断;若使用 GQA、MQA、MLA、跨层 KV 共享或 KV 量化,KV 字节数、注意力计算和搬运成本的比例也会变化, 必须重新标定。
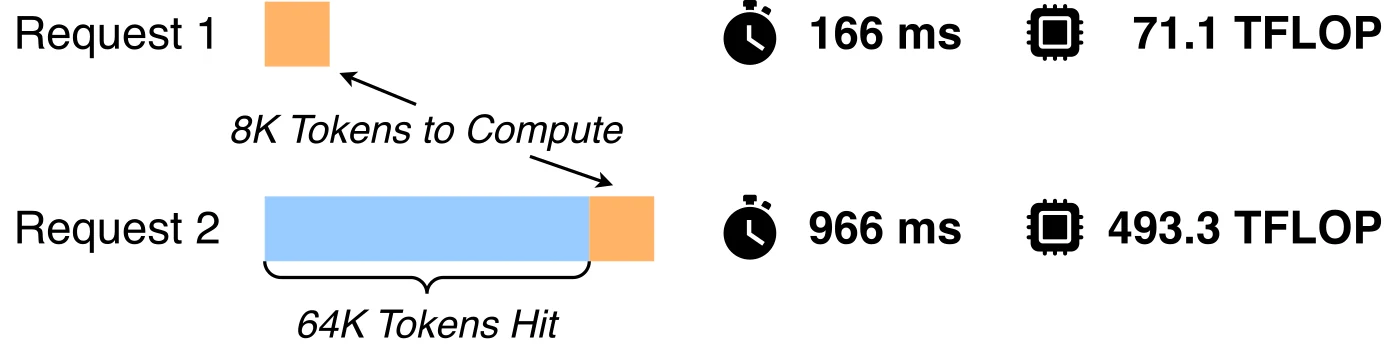
图源:论文 Figure 8,Qwen3-Coder-30B、单张 NVIDIA H200 实测。Request 2 虽然命中了前 64K token,却仍需让后续 8K query 读取并关注这段 KV,因此它“新算 token 数”相同,注意力矩阵却大得多。
这也解释了一个看似矛盾的现象:计算感知策略的 block hit ratio 可能略低,但 TTFT 和总 prefill 吞吐更好。它主动牺牲许多便宜的浅层 hit,换取较少但昂贵的深层 hit。只看命中次数,会把这种交换误判成退化。
两个离线 Oracle:可实现上界究竟在哪里
Belady 只优化命中数
经典 Belady 策略知道未来访问序列,在需要淘汰时选择“下一次访问距离现在最远”的 block。对大小相同、miss 成本相同的对象,它给出最小 miss 数,因此是 hit ratio 的离线最优。
一旦 不相同,Belady 不再是 CSR 最优。举一个极端例子:缓存只能留一个 block,A 在 10 秒后复用、重算成本为 1;B 在 11 秒后复用、重算成本为 100。Belady 会因为 B 的下一次访问更远而淘汰 B,保留一次价值 1 的 hit,却承担价值 100 的 miss。命中数目标没有错,只是它回答的不是“省多少计算”。
ILP Oracle:把每个 reuse interval 当成带价值的占用区间
论文把同一 block 的相邻两次访问之间看作一个 reuse interval。若在整个区间内保留该 block,区间末端就获得一次价值为 的 hit;代价是它在 内持续占用一个缓存槽。用二元变量 表示是否保留区间 ,等大小 block 下可以用下面的示意 ILP 表达:
是缓存可容纳的 block 数;第一个约束表示任意时刻 被选择的驻留区间不能超过容量。真实模拟还要遵守请求级驻留约束,式子主要展示离线问题为何比普通 Belady 多了“价值”维度。ILP 能给出 compute-savings 的精确离线上界,但对数十万请求、数千万 block 的轨迹求解代价很高,不适合在线决策。
BeladyCompute:便宜的离线近似
论文进一步提出 BeladyCompute,以未来复用距离和 block 计算强度构造分数。v1 正文打印的公式为:
并声明淘汰分数最高者。这里需要保留一个严谨边界:若 ComputeIntensity 直接表示 miss FLOPs,按字面相乘再取最大,会让昂贵 block 更容易被淘汰,与后文“保护昂贵 block”的在线评分方向不一致。论文没有在公式附近补充倒数定义,且 v2 仍保留同一写法。因此,这一式子应视为论文报告的实现口径;在代码和轨迹正式公开前,不宜自行把它扩展成未经验证的等价推导。
实验上,BeladyCompute 与 ILP 上界非常接近:在 24、48、96 GiB 下分别只差 1.03、0.41、0.08 个百分点。它的主要价值不是上线,而是做策略诊断:
- hit-optimal Belady 与 cost-optimal ILP/BeladyCompute 差距大,说明“命中谁”比“命中几个”更重要,值得开发 compute-aware 在线策略;
- 两者差距小,说明 hit ratio 已足够代表收益,没有必要给控制面增加成本模型。
FreeInference 在 24 GiB 下,两类 Oracle 的 CSR 相差 12.6 个百分点,计算感知有很大空间;其余五条验证 trace 的差距不超过 1.1 个百分点。这个对照阻止了一个常见工程误区:看到深度成本在理论上不均匀,就默认每个集群都该实现复杂评分。是否值得,要先在自己的 trace 和模型上测 Oracle gap。
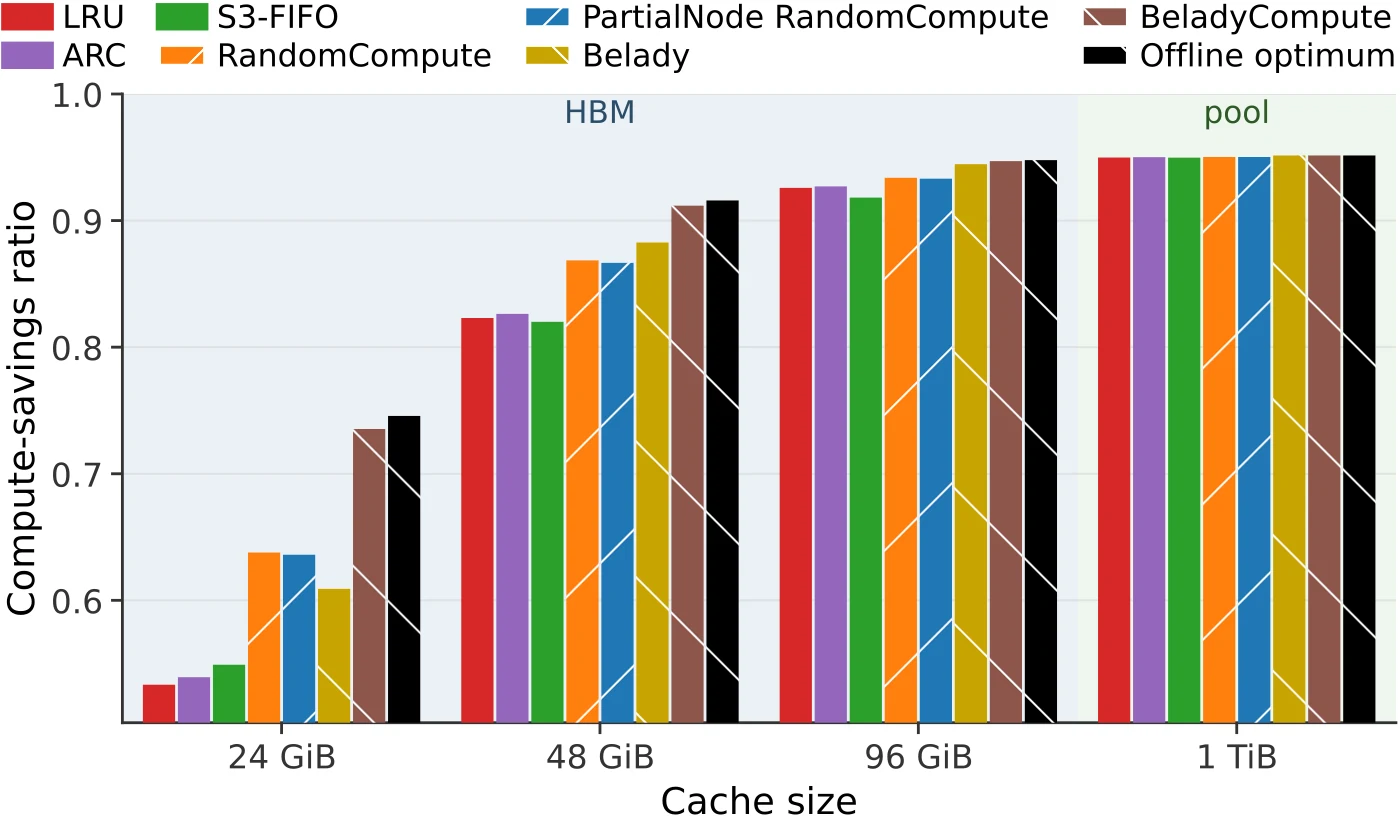
图源:论文 Figure 12。实心柱为在线策略,斜线柱为离线 Oracle;在容量增大到 1 TiB 后,各策略都接近饱和,计算感知带来的边际差距随之缩小。
从分析到工程:四条可落地的替换原则
原则一:LRU 做底座,而不是做最终答案
LRU 的优势不只是 hit ratio 稳健,还在于控制面成本低。每个可淘汰 block 只需最近访问时间或链表位置;命中时 touch,释放时进入队尾,需要空间时从队头取 victim。vLLM 的 Automatic Prefix Caching 设计文档 就把 block pool、free queue、哈希索引与引用计数组合起来,用 O(1) 链表操作维护 LRU。
生产系统首先应实现并测稳这条基线,再根据 trace 暴露的问题添加模块。论文没有支持“把所有高级策略都叠上去”的结论。相反,额外信号只有满足明确触发条件时才值得启用:one-hit footprint 压垮容量时做 quick demotion,长上下文让 miss cost 方差足够大时做 compute-aware,小容量层坚持细粒度,大容量层才考虑 session 粒度。
原则二:Quick demotion 只负责挡住 one-hit 洪水
S3-FIFO 的基本结构是小 probationary FIFO、主 FIFO 与只存元数据的 ghost queue。新对象先进入小队列;若从未得到第二次访问,就很快被降级或淘汰;被证明有复用的对象才进入主队列。它解决的是 admission,不是用累计频率给主缓存排终身座次。
在 Qwen To-B 的 24 GiB 场景,S3-FIFO hit ratio 为 0.491,LRU 只有 0.403,提升 8.8 个百分点。这条 trace 的 compulsory miss 占比高,容量又紧,快速过滤一次性 prompt 确实能保护活跃 session。但 FreeInference 和 Chutes 上,单轮 prompt 虽多,单个 footprint 往往比不断增长的多轮 session 小;它们不一定构成容量主体,quick demotion 便可能没有稳定收益。
部署前应看“one-hit block 数量”之外的两个量:one-hit block 的累计字节占比,以及它们在典型缓存驻留窗口内造成的 eviction 数。只有数量多、总 footprint 也足以污染主缓存时,S3-FIFO 一类过滤器才切中问题。
原则三:RandomCompute 把 recency 与重算成本放进同一个分数
在线环境不知道 TimeUntilNextAccess,只能用上次访问距今多久估计未来复用。论文提出 RandomCompute:从可淘汰 block 中随机采样一小组,对每个候选 计算
并淘汰分数最低者。分子的计算强度越高,block 越受保护;分母的 idle time 越长,分数越低,仍保持 recency 主导。随机采样避免每次淘汰都扫描全缓存,思路与 power-of-k choices 类似:不必找到全局最差,只要样本里有足够差的 victim,就能以很小控制开销逼近更昂贵的排序。
在 FreeInference、24 GiB 和 Qwen3-Coder-30B 成本模型下,RandomCompute 的 CSR 达到 0.638,比 LRU 高 10.4 个百分点,甚至高于以 hit ratio 为目标的 Belady。这里没有违反离线最优:Belady 只对“miss 个数最少”最优,不对“miss FLOPs 最少”最优,两者优化目标不同。
原则四:成本感知必须与连续片段淘汰绑定
若 RandomCompute 直接逐 block 选择 victim,会在一个长前缀里打出很多离散“洞”:例如 block 0–99 中缺 5–7、31、48–51,其余仍驻留。下一次请求必须重算每个缺口,同时接上后面的 cached KV。总重算 block 数可能不多,但 attention kernel 面对许多短而不规则的片段,批处理、矩阵形状与调度效率都会恶化。
论文统计,原始 RandomCompute 平均每个请求留下 9.21 个 hole;P99 达 143 个,最大 281 个。PartialNode RandomCompute 不再逐块散点删除,而是从一个前缀树节点的开头淘汰连续 chunk,并尽量让 chunk 长度对齐系统的 contiguous batching token budget。这样做有三层收益:
- 同样的重算量被压成更少、更长的连续区间;
- 每个 hole 内部能形成规则 prefill,多个互不依赖的 hole 仍可一起批处理;
- 粒度与调度预算对齐后,补洞不会留下大量无法填满一轮预算的小尾巴。
在 24 GiB 轨迹上,partial-node 把平均 hole 数降低 8.7 倍,而 CSR 损失可以忽略。附录的完整分布更能说明问题:两种策略的重算总量分别约 258.0M 与 257.9M block,几乎相同;但平均 hole 长度从 85.5 block 增到 742.6 block,长度不超过 2 block 的碎片占比从 56.6% 降到 0.8%。优化没有“少算”,而是把相同计算整理成 GPU 更能并行执行的形状。
粒度还要匹配内存层级
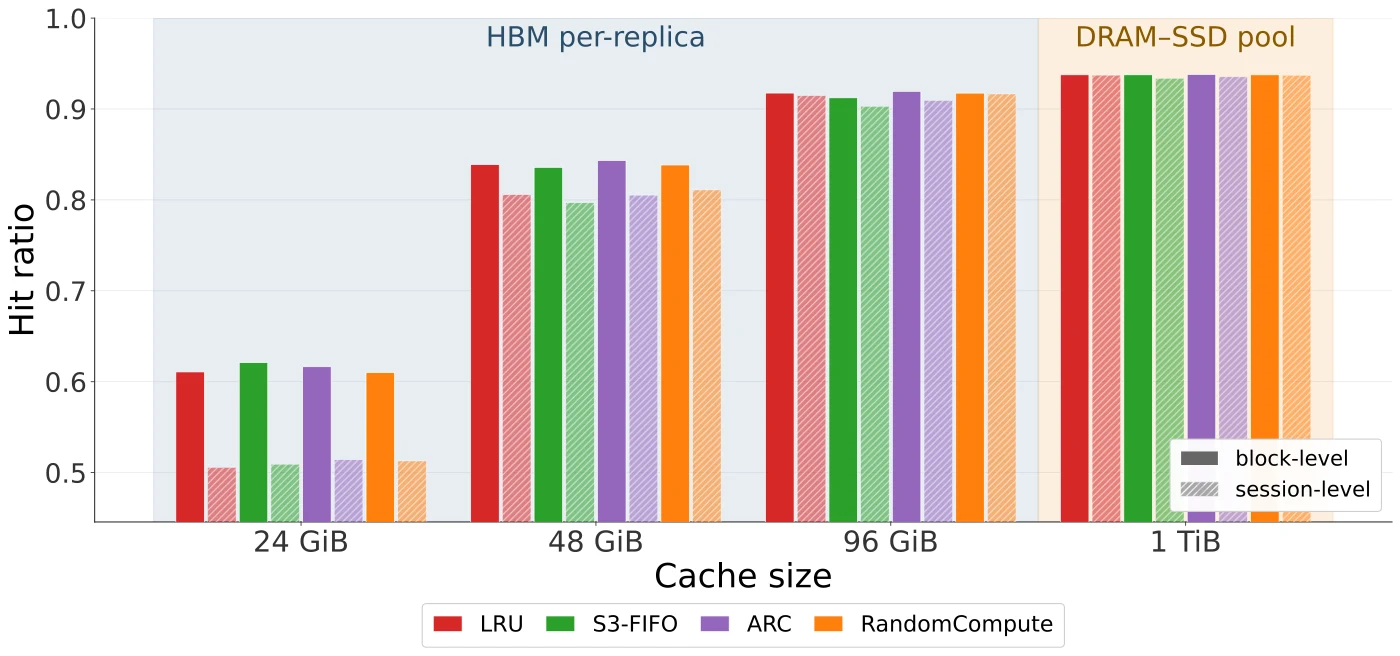
图源:论文 Figure 14(a)。实心柱为 block-level,斜线柱为 session-level;容量越紧,整 session 淘汰的损失越明显。
24 GiB 下,把 LRU 从 block 级改成 session 级会损失 10.5 个 hit-ratio 百分点;RandomCompute 的 CSR 更会损失 18.7 个百分点。48 GiB 下损失缩小,但仍分别有 3.3 和 5.5 个百分点。原因不是 session 语义不好,而是 HBM 中一个重尾巨型 session 无法被局部修剪,只能完整保留或完整牺牲。
进入大容量池后,block 与 session 粒度的性能差距接近不可测。此时 12 TiB 池若按 16-token block 管理,要维护约 840 万条索引;使用 256–512 token chunk 或 session 级元数据能显著减轻控制面开销。仍需单独保护跨 session 共享的 system prompt:把它绑在某一个 session 上整体淘汰,可能误伤其他活跃会话。
把四条原则合在一起,可得到一张条件表:
| 观测到的负载/层级 | 默认动作 | 不应直接做的事 |
|---|---|---|
| 活跃 session 周期短、复用间隔集中 | LRU | 用全局累计频率替代 recency |
| 一次性 prompt 的累计 footprint 冲击容量 | LRU 前增加 quick-demotion admission | 仅因 one-hit 数量多就启用 |
| 长上下文多、深浅 block FLOPs 方差大 | compute-aware score | 只优化 block hit ratio |
| compute-aware 造成离散 hole | partial-node 连续淘汰 | 逐 block 任意打洞 |
| 单副本 HBM 紧张 | block/连续 chunk 粒度 | 整 session 淘汰 |
| TiB 级 DRAM/SSD 池 | 可用粗 chunk 或 session 粒度 | 无条件照搬 HBM 元数据粒度 |
实验结果应该怎样读
端到端验证:策略与 kernel 形状必须一起看
论文在单张 NVIDIA H200 上运行真实 vLLM,模型为 Qwen3-Coder-30B,前缀缓存预算 48 GiB,回放 FreeInference 的 10000 个请求。TTFT 与 prefill throughput 分开测量。
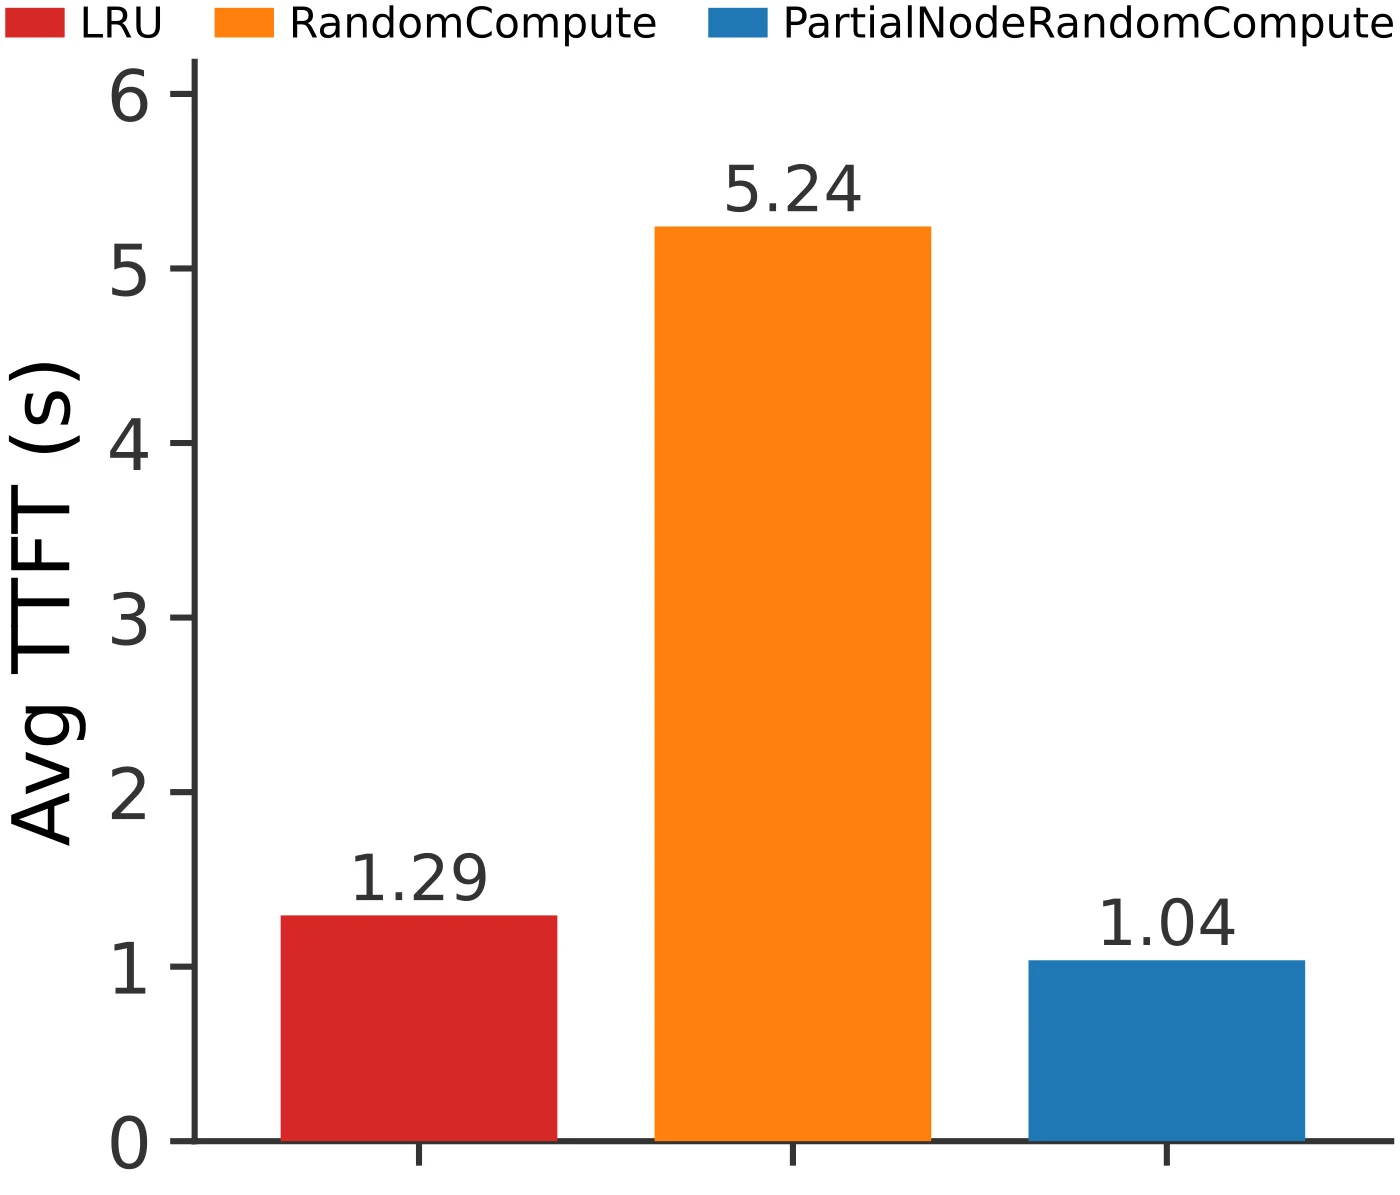
图源:论文 Figure 13(a)。红色为 LRU,橙色为原始 RandomCompute,蓝色为 PartialNode RandomCompute。
PartialNode RandomCompute 相比 LRU:
- 平均 TTFT 从 1.29 秒降到 1.04 秒,下降 19.9%;
- prefill throughput 从 55.2K token/s 提升到 65.6K token/s,提高 18.8%;
- P99 TTFT 从 26.0 秒降到 16.8 秒;
- 但中位 TTFT 从 LRU 的 112 ms 上升到 171 ms。
中位数变差、平均值和 P99 变好并不矛盾。成本感知策略牺牲大量浅层、便宜的小请求,优先保护深层、昂贵的长请求,因此收益集中在尾部。若业务 SLO 强调所有短请求的 P50,策略权重不能只照搬论文;若长 Agent 请求拖累 GPU 总算力并造成严重 P99,它更有吸引力。
原始逐 block RandomCompute 是更重要的反例:其平均 TTFT 达 5.24 秒,约为 LRU 的 4.0 倍;throughput 只有约 14K token/s,比 LRU 低 3.9 倍。trace 模拟里的 CSR 明明更高,真实系统却大幅变慢,说明“保留了哪些 block”不是完整性能模型。连续性、hole 个数、每轮可组成的矩阵形状与 kernel 启动/调度开销,同样属于缓存策略的一部分。
容量越大,简单策略越容易追上
在 Qwen Bailian 与 AgentX 验证 trace 上,1 TiB 时 LRU 与最佳在线算法的差距都不超过 0.4 个百分点;但 24 GiB 时 LRU 并非总是领先。Qwen To-B 上,S3-FIFO 与 ARC 都达到 0.491,LRU 只有 0.403。不同 trace 中 LRU 追上最佳策略所需容量约为 60–462 GiB,而 FreeInference 只需约 37 GiB。
差别与 compulsory miss 和可复用工作集有关。Qwen trace 中 34%–54% 的访问属于必然首次 miss,FreeInference 只有 6.0%,AgentX 更低至 3.75%。当容量小到许多本可复用对象也活不到下一次访问时,admission 与 quick demotion 的价值上升;容量覆盖活跃工作集后,recency 足以工作,复杂策略的边际空间快速消失。
并发度会改变“缓存时间尺度”
同一组 session 若以更高并发交错回放,每个 session 两轮之间会插入更多其他请求。物理时间上的间隔未必改变,但以“中间到达多少 block”衡量的 reuse distance 会变长,固定容量能覆盖的 session 变少。论文附录中,并发 32 时 S3-FIFO hit ratio 达 0.573,LRU 为 0.517;在 1 TiB pool、并发 1024 时,只有 54.1% 的 reuse 仍落在容量可达范围内,S3-FIFO、ARC 与 LIRS 开始占优。
因此,“LRU 在我们的 trace 上很好”必须同时记录 cache capacity、block size、并发度、路由方式和 session affinity。改变其中任何一个量,都可能把一次性对象或暂时不可达对象的占比推过 quick demotion 的收益阈值。
与 RadixAttention、vLLM 和分层缓存的关系
RadixAttention 决定“如何找到”,替换策略决定“留下什么”
RadixAttention 用压缩前缀树表示 token 序列的公共路径,负责最长前缀匹配、节点分裂、引用保护与叶子淘汰。它默认的 leaf-first LRU 很适合 session 的短时间局部性,但树结构本身不要求只能用 LRU。论文的结论可以作为树上 eviction driver 的设计依据:
- 节点的
last_access_time继续提供基础顺序; - probationary 状态区分只出现一次的 prompt 与已建立 session;
- 节点记录 token depth 或模型相关 compute intensity;
- victim 不是任意单页,而是节点内与 batching budget 对齐的连续前段;
- session reference 只能作为软保护,不能让巨型 session 永久 pin 住 HBM。
当前 SGLang 的 Session-Aware Radix Cache 文档 已体现最后一点:活跃 session 的 KV 排在普通缓存之后淘汰,但引用不是不可驱逐的硬锁;空间仍不足时,引用更少、LRU 更旧的 session 数据也会回收。论文则进一步说明,单凭 session 标记还不够,还要处理 session footprint 的重尾和深度成本。
vLLM 的哈希 block 不妨碍更灵活的策略
vLLM 不必先构造显式前缀树。完整 block 的哈希包含父前缀哈希、当前 token 与模型相关附加信息,因此哈希命中仍保证整段前缀一致。请求结束后,零引用 block 按顺序进入 free queue;再次命中时 touch 到队尾,需要新页时从队头覆盖,这就是 block 级 LRU。
加入 compute-aware 不要求推翻 PagedAttention。PagedAttention 解决的是 KV 物理页如何离散分配、block table 如何映射;替换策略解决的是零引用的旧内容里先覆盖谁。需要增加的是:候选抽样、深度成本元数据,以及把若干相邻 block 归成 partial-node/continuous-run 的机制。真正困难处不是评分公式,而是保证 touch → victim selection → hash removal → slot allocation 的并发顺序仍不会让正在执行的 block 被覆盖。
分层缓存要分别设计 admission、eviction 与 transfer
Mooncake 一类 KV-centric 系统把 GPU HBM 之外的 CPU DRAM、SSD 和远端节点组织成全局池。每一级的 miss 代价不同:
是重新 prefill 的算力成本, 是从下一层传输 KV 的网络/存储成本, 是在目标层预留页、登记索引和同步元数据的成本。论文的 CSR 主要建模第一项;真实多级系统应按层级比较三项,而不能简单认为“下一层还有副本就不算 miss”。
短生命周期也重新定义 SSD 的价值。多数前缀工作集在 SSD 大容量发挥作用前已经随 session 消失,把所有 HBM victim 无差别写入 SSD 既消耗带宽,也消耗闪存写寿命。只有具有长尾复用、跨 session 共享或极端容量需求的对象,才适合选择性 admission 到持久层。
路由与替换是上下两层控制
cache-aware router 尽量把同一 session 或共享 system prompt 送到已有前缀的副本,决定请求“落到哪里”;本地 eviction 决定该副本“留下什么”。session footprint 重尾会让 affinity routing 造成热点:某个副本因为接住几个超长 Agent 而提前耗尽 HBM。路由器可以迁移新请求、平衡队列,但请求一旦落到某个副本,session-bounded lifetime、recency 与 depth cost 仍决定本地 victim。
因此监控也应分层:路由层看每副本队列、session footprint 与远程命中;缓存层看 reuse-distance、one-hit 字节、CSR、hole 分布与 eviction 原因。只看集群平均 hit ratio,可能掩盖某个副本已经被巨型 session 压垮。
局限与开放问题
第一,生产 trace 很珍贵,但代表性仍有限。两条主 trace 分别来自 FreeInference 与 Chutes,服务组合、租户行为、路由策略和 prompt 模板都会塑造 reuse。四条 Qwen Bailian 与 AgentX 扩展了验证范围,却不能证明所有企业 Copilot、检索增强应用和长时自治 Agent 都服从相同阈值。论文支持的是“recency 是稳健底座”,不是“LRU 在任意容量都最好”。
第二,轨迹和模拟器在论文 v1 发布时仍标注为“将公开”。缺少代码时,外部读者还不能核对 block identity、并发回放、请求级驻留、成本模型与跳过超长请求的全部实现。尤其 BeladyCompute 的打印公式存在前述方向疑点,复现时应以正式开源实现和测试为准。
第三,FLOPs 不是完整延迟模型。相同 FLOPs 在不同 GPU、batch size、kernel、上下文长度与内存布局下可能对应不同时间;远程 KV 还涉及 NIC 拥塞、序列化、页注册和 NUMA。Partial-node 的实验已经证明形状可以压倒计算量。下一步更合理的 cost 应从单一 扩展为模型、硬件与当前批次共同决定的预测函数,并同时约束控制面开销。
第四,平均 CSR 不等同于 SLO。PartialNode RandomCompute 改善平均与 P99,却让中位 TTFT 变差。多租户服务还要处理优先级、付费等级、公平性和 per-tenant cache pollution。一个只追求全局省算力的策略可能长期牺牲短请求或低流量租户,需要把成本收益与尾延迟、公平约束共同纳入目标。
第五,attention 架构会改变深度成本。full attention 让成本近似随位置增长;sliding-window attention 会封顶;混合模型只在部分层增长;MLA、GQA、MQA、KV 量化与跨层共享又改变每个 token 的 KV 字节和计算/传输比例。访问模式的 session 结论大体仍在,但 compute-aware 的具体权重不能跨模型照搬。关于 MLA 的低秩 KV 与矩阵吸收可参考 MLA 完全拆解。
第六,论文研究的是精确的跨请求 prefix reuse,不等价于单请求内部的 KV 驱逐。后者根据注意力分数、token 位置或量化状态删除历史,可能带来模型质量变化;前者的 block 丢失后可以精确重算。两类技术都叫“KV eviction”,目标、正确性边界与评测指标却不同,不能用同一 hit ratio 直接比较。
第七,物理淘汰与逻辑共享解耦虽带来灵活性,也带来实现复杂度。散点保留深层 block 理论上可行,但需要表示多个 hole、为重算片段建立正确位置编码、拼接已驻留 block,并让 attention kernel 高效消费非连续页。Partial-node 只是把问题压缩到可管理范围,还没有消除 radix node 边界、block 边界与调度 chunk 边界不对齐的工程细节。
小结
这项工作的真正贡献不是宣布“LRU 战胜一切”,而是把前缀缓存替换从算法榜单拉回工作负载结构:
- 前缀 block 的生命通常被 session 截断,reuse interval 短且集中,所以 recency 是最强、最便宜的默认信号;
- frequency 主要记录 session 已进行多少轮,难以预测下一轮何时到来,只适合在 one-hit 洪水下做早期 admission;
- full attention 让深层 block 的重算成本远高于浅层 block,命中率因此不能替代 compute-savings ratio;
- 计算感知若逐 block 任意打洞,会破坏连续 prefill 和 GPU 并行形状,必须与 partial-node 连续淘汰结合;
- session footprint 的重尾要求 HBM 采用细粒度修剪,而 TiB 级池可以用粗粒度换元数据效率。
面向实际系统,合理顺序是先采集 trace,再用 LRU 建立基线,计算 one-hit 字节占比、reuse-distance、Oracle gap、hole 分布与不同层级的 miss cost。只有指标指出明确问题时,才分别启用 quick demotion、compute-aware 与粗粒度管理。前缀缓存不是一道寻找“最聪明替换算法”的孤立题,而是访问预测、计算成本、GPU 执行形状和内存层次共同约束的系统问题。
参考资料
- When Fancy Eviction Fails: Rethinking Cache Replacement For LLM Prefix Reuse(arXiv v1)
- vLLM:Automatic Prefix Caching 设计文档
- SGLang: Efficient Execution of Structured Language Model Programs
- S3-FIFO:FIFO Queues Are All You Need for Cache Eviction
- S3-FIFO 官方实现仓库
- libCacheSim:高性能缓存模拟器
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
- PagedAttention / vLLM 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention
- SGLang:Session-Aware Radix Cache
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


