


Sarathi-Serve 完全拆解:分块 Prefill 与无停顿批处理如何兼顾吞吐和尾延迟
Prefill 为什么会让 Decode 停下来
Sarathi-Serve 由 Georgia Tech 与 Microsoft Research India 的研究者提出,论文《Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve》发表于 OSDI 2024。它要解决的不是某个算子“还不够快”,而是在线服务里一个更隐蔽的矛盾:增大批量能够提高吞吐,却可能让正在流式输出的请求突然停顿数百毫秒甚至数秒。
理解这个矛盾,首先要把一次自回归请求拆成两个阶段:
- Prefill 一次处理整个输入提示,生成每层的 KV Cache,并算出第一个输出 token。输入长度为 时,线性层可以把 个 token 组织成较大的矩阵乘,GPU 通常接近计算受限。
- Decode 每轮只为每个请求处理一个新 token,同时读取模型权重和已有 KV Cache。单请求的矩阵乘很“瘦”,算术强度低,通常更接近显存带宽受限。
在线服务常用三个延迟指标。TTFT(Time To First Token)是请求到达后等待第一个 token 的时间;TBT(Time Between Tokens)是同一请求相邻两个输出 token 的间隔;TPOT(Time Per Output Token)通常是去掉首 token 后的平均每 token 时间。平均 TPOT 很容易掩盖偶发的长停顿,因此 Sarathi-Serve 的主要约束是 P99 TBT,而不只是平均吞吐。
对一个简化的线性层 ,设本轮共有 个 token,输入和输出维度都近似为 ,每个权重元素占 字节。忽略常数项后,计算量与权重读取量近似为:
是乘加计算量, 是至少要从显存层次读取的权重字节数。于是仅考虑权重时的算术强度约为:
关键在于:权重读取成本几乎不随 token 数 增长,而有用计算量与 成正比。Decode 批很小时,GPU 已经付出了搬运整层权重的代价,却没有足够 token 填满 Tensor Core;增加一些 token,单轮时间不会同比增长。Prefill 恰好能提供这些 token。
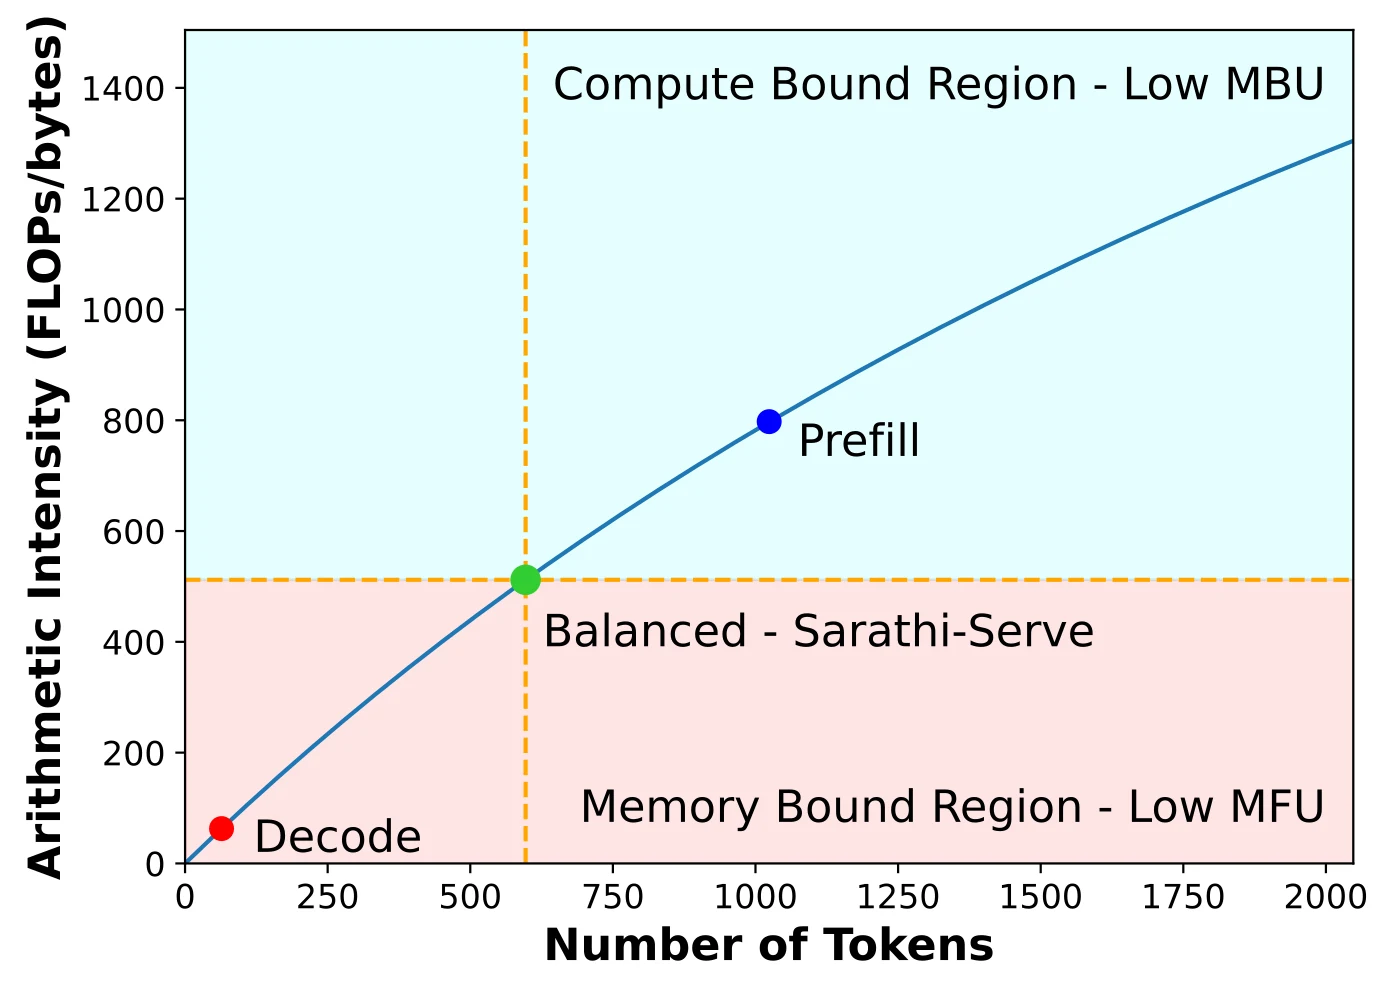
图源:Sarathi-Serve 论文图 5。图中的低 token 区域以显存访问为瓶颈,纯 Decode 批位于这一侧;token 数增大后越过硬件 Roofline 的拐点,执行转为计算受限。Sarathi-Serve 的目标不是无限增大批,而是把 Decode 留下的计算“空槽”用 Prefill token 填到拐点附近。
问题在于,完整 Prefill 可能很长。若调度器把一个 7000-token 的新提示整体插进正在运行的 Decode 批,所有老请求都要等这次 Prefill 结束才能生成下一个 token。论文在两张 A100 上运行 Yi-34B、服务 arXiv 摘要轨迹时,观察到 vLLM 的生成流中出现持续数秒的停顿。对于 Falcon-180B,论文给出的一个更具体例子是:4K token Prefill 约需 1150 ms,而 batch size 32 的纯 Decode 迭代约需 200 ms;若二者在流水并行的不同微批中交错,阶段间可出现约 950 ms 的空泡。
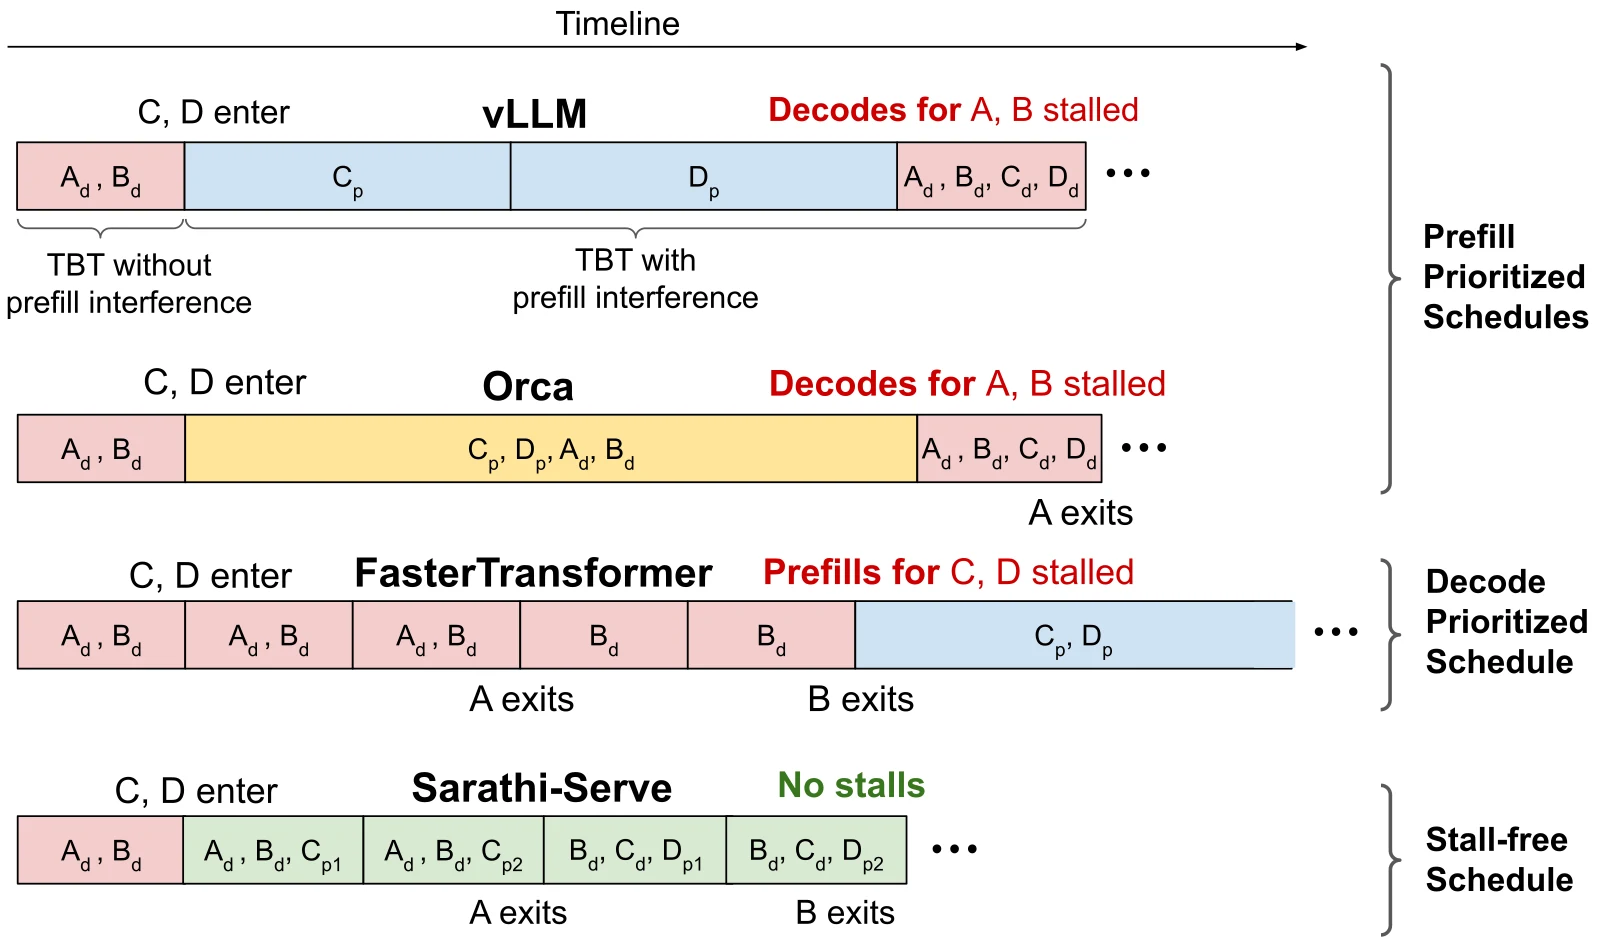
图源:Sarathi-Serve 论文图 7。A、B 已处于 Decode,C、D 后到达。vLLM 风格的 eager prefill 会暂停 A、B;Orca 虽允许混合批,但完整 Prefill 仍然拉长单轮;FasterTransformer 等请求级批处理保护了 A、B,却让 C、D 长时间排队。最下方的 Sarathi-Serve 把 C、D 的 Prefill 切片后与 A、B 的 Decode 同轮执行,使每轮工作量接近固定。
这类停顿的根因不是 KV Cache 分配,也不是连续批处理本身,而是“调度单位”和“计算负载单位”不一致:调度器以一次迭代为单位做决定,完整 Prefill 的工作量却随提示长度剧烈变化。只要完整 Prefill 仍是不可切分的原子任务,吞吐、TTFT 和尾部 TBT 就无法同时稳定。
从连续批处理到无停顿批处理
Orca 在 OSDI 2022 提出迭代级调度:每生成一轮,调度器都可以移除已完成请求、加入新请求。它解决了请求级静态批处理中“短请求陪长请求空等”的问题,也是后来连续批处理的基础。可参考站内的连续批处理完全拆解,其中详细解释了 iteration-level scheduling 与 selective batching。
但是,“每轮都能改批”并不自动等于“每轮工作量可控”。假设 A、B 各有一个 Decode token,新请求 C 有 4096 个 Prefill token:
- Decode 优先:本轮只运行 A、B,C 等待。A、B 的 TBT 很稳,但新请求 TTFT 增大,Decode 批还可能小到无法利用 GPU。
- Prefill 优先:先执行 C 的完整 Prefill,再回到 A、B。C 较快进入系统,后续 Decode 批也变大,但 A、B 遭遇长 TBT 尖峰。
- 朴素混合批:把 A、B 的两个 Decode token 与 C 的 4096 个 Prefill token 放进一次前向。A、B 没有在调度意义上被跳过,但它们的结果仍要等整个巨型批结束,因此物理延迟并没有消失。
Sarathi-Serve 增加两个约束,把问题改写成受预算的装箱:
- Prefill 可被切成多个连续 chunk,不再要求一个迭代完成整个提示。
- 每轮先放入所有正在运行的 Decode token,再用 Prefill chunk 填充剩余 token budget。
若本轮预算为 ,活跃 Decode 请求数为 ,调度给各 Prefill 请求的 chunk 长度为 ,则批组成满足:
因为每个 Decode 请求本轮只贡献一个 token,所以 既是 Decode 请求数,也是 Decode token 数。调度器把这些 token 视作最高优先级;只有 的余量可以给 Prefill。这样,Decode 不会为了接纳新请求而被挤出下一轮,单轮执行时间也由 而不是最长提示长度控制。
论文把这称为 stall-free batching。“无停顿”不是说 TBT 与纯 Decode 完全相同,而是说不会因一个完整长 Prefill 突然插入而产生无界尖峰。混合批仍会增加一些执行时间,只是增量被 token budget 限制,而且通常能利用 Decode 的低算术强度,使这部分增量远小于单独执行 Prefill 再执行 Decode 的时间之和。
这种设计还有一个容易忽略的收益:每轮 token 数更均匀。对流水并行而言,流水线空泡来自不同微批执行时间不一致;把大 Prefill 切成相近大小的块,相当于同时做了时间维度的负载整形。Sarathi-Serve 因而既是单 GPU 的混合批策略,也是多级流水线的微批整形机制。
分块 Prefill 的计算与内存机制
分块不等于截断上下文
设一个提示共有 个 token,被切为 个 chunk,边界满足:
第 个 chunk 包含位置 的 query。对其中位置 ,因果注意力仍必须看到从 0 到 的全部 key 和 value:
、、 分别是位置 的 Query 与位置 的 Key、Value, 是单个注意力头的维度。chunk 只限制本轮新生成哪些 query,不会把可见上下文限制在 chunk 内。因此它不是滑动窗口,也不会改变注意力语义。
处理第 个 chunk 时,系统已经把前 个 chunk 的 K/V 写入分页 KV Cache。本轮先为新 token 计算 Q/K/V,再让新 query 读取“历史页面 + 当前 chunk 页面”,执行带因果掩码的注意力。最后一个 Prefill chunk 完成后,整段提示的 KV Cache 与一次性 Prefill 应当一致,随后才能采样第一个输出 token。
线性层、归一化和逐 token MLP 对序列位置没有跨 token 依赖,天然可以分块;真正需要特殊处理的是注意力与位置元数据。执行引擎必须为每个序列携带:已经处理的提示长度、本轮 chunk 长度、绝对位置、KV block table 以及最后一个页面的有效长度。若绝对位置从零重新计数,RoPE 会错误;若注意力只读取当前 chunk,模型则等价于周期性失忆。
为什么总 FLOPs 近似不变,显存流量却增加
一次性因果 Prefill 的注意力打分数约为三角形面积:
分块后,每个 query 仍与完全相同的历史 key 集合计算点积,所以数学上的注意力乘加数仍为 。分块没有像重复计算整段前缀那样把 FLOPs 变成 倍。
额外成本来自历史 KV 的重复装载。为了看清这一点,先假设 且每个 chunk 都为 。第 轮要读取前面 个 token 的历史 KV,累计历史读取 token 数为:
这并不是额外计算,而是原本一次大注意力 kernel 内可以更好复用的数据,现在跨多个 kernel 边界反复从 HBM 取回。第一个 chunk 的 KV 会在后续 轮被访问,第二个 chunk 会再访问 轮,依此类推。chunk 越小,轮数 越大,重复读取、kernel launch 和元数据准备的固定成本越明显。
但线性层的权重开销呈相反趋势。只要一个混合批的总 token 数足够大,Prefill chunk 与 Decode 可以共同摊销同一套权重读取,使原本带宽受限的 Decode 获得更多有效计算。Sarathi-Serve 的收益正来自两类成本的交换:接受适量的 KV 重读与启动开销,换取更稳定的 TBT、更高的 Decode 批利用率和更均匀的流水微批。
混合批不是把两类注意力强行做成同一个形状
Prefill 和 Decode 虽能共享模型的一次逐层执行,但它们的注意力形状不同:Prefill 请求有多个 query,Decode 请求各有一个 query;每个请求的历史长度也不同。实现通常先把线性层输入在 token 维拼成一个 ragged batch,再通过 offset 数组和 block table 把注意力拆回各自的序列。
以官方开源实现为例,执行器分别构造 Prefill 与 Decode 的 qo_indptr、kv_page_indptr、kv_page_indices 和 kv_last_page_len。qo_indptr 描述每个请求在扁平 Query/Output 张量中的起止位置,KV 元数据则描述其分页缓存。线性层可对拼接后的 token 做大 GEMM,注意力 kernel 仍按请求边界读取正确的 KV 页面。因而“混合”发生在适合共享的算子上,“隔离”保留在必须按序列处理的注意力上。
这也解释了为什么 token budget 只是近似的工作量单位。两个批即使 token 总数相同,若序列历史长度、Prefill/Decode 比例、KV 页面碎片和并行配置不同,注意力成本仍可能不同。固定预算能显著收窄单轮延迟分布,却不能从数学上保证每轮耗时完全相等。
Sarathi-Serve 的调度器如何工作
论文算法可以概括为“先保住正在输出的 token,再续上已经开始的 Prefill,最后接纳新请求”。这三个优先级不能互换。
设等待队列为 ,运行集合为 ,本轮已使用 token 数为 。一次调度大致执行:
输入:token budget τ,运行集合 R,等待队列 Wn_t = 0batch = []
for request in R: if request 已完成 Prefill: 为它分配一个 Decode token n_t += 1 batch.append(request)
for request in R: if request 的 Prefill 尚未完成: c = min(剩余 Prefill 长度, τ - n_t) 若 c > 0,则继续执行该请求的下一个 chunk n_t += c
while W 非空且 n_t < τ: request = W.front() 若 KV Cache 或序列槽位不足则停止接纳 c = min(request 的 Prefill 长度, τ - n_t) 分配 KV 空间并接纳 request n_t += c
执行由 Prefill chunk 与 Decode token 组成的混合批移除已完成请求,进入下一轮第一遍先统计所有已完成 Prefill 的运行请求,每个请求预留一个 Decode token。这样即使等待队列中堆了很多长提示,老请求也不会因“新请求更大、更容易填满 GPU”而被饿死。第二遍优先推进已经开始但尚未完成的 Prefill,避免它们占着 KV Cache 却长期没有进展。第三遍才从等待队列接纳新请求。
官方代码中的 _get_seq_next_num_prefill_tokens 把本轮 chunk 长度计算为:
是提示总长, 是已处理长度, 是剩余预算。最后一个 chunk 可以短于常规 chunk;若预算已被 Decode 用完,,Prefill 留到下一轮。
内存约束与计算预算是两回事。token budget 约束本轮要算多少 token,KV block manager 约束请求整个生命周期能否留在显存。接纳一个新请求前,调度器要确认可以分配其缓存;为 Decode 推进一个 token 前,也要确认能追加 slot。若不能容纳所有运行请求,则需要按策略抢占低优先级请求。可参考PagedAttention 完全拆解理解 block table、物理块分配与抢占之间的关系。
一个 512-token 预算的例子
假设当前有 80 个活跃 Decode 请求,还有两个未完成 Prefill:P 已剩 300 token,Q 已剩 900 token。预算 。
- 先放入 80 个 Decode token,剩余预算 432。
- 若 P 的优先级更高,给 P 分配 300 token,剩余 132。
- Q 本轮只获得 132 token,批总量正好为 512。
- 下一轮仍先放入所有活跃 Decode;P 完成 Prefill 后会转入 Decode,Q 再继续下一个 chunk。
这个例子说明“一个批只放一个 Prefill chunk”是解释机制时常用的简化。论文算法允许在预算内接纳一个或多个 Prefill chunk,官方实现也可把剩余预算依次给多个请求;真正不变的是 Decode 优先和总 token 上限。若把“恰好一个 chunk”当作硬规则,就会误解短提示与最后一个残块的调度行为。
为什么不能只设 max batch size
max batch size 限制的是序列条数,不限制每条序列本轮贡献多少 token。64 个 Decode 请求只产生 64 个 token,而 1 个完整 Prefill 请求可能产生 8000 个 token;两者都只占一个“请求槽”,工作量却相差两个数量级。token budget 直接约束前向中的 token 数,因此比 request count 更接近 GPU 工作量。
它仍不完美:注意力复杂度与上下文长度相关,MoE 路由会改变每个 token 的专家负载,多模态编码器还有独立成本。生产调度器可以在 token budget 之上加入 cost model,但 Sarathi-Serve 的贡献在于先找到一个足够简单、可测量、又能消除最严重 Prefill 尖峰的控制变量。
为什么 Chunk 大小是核心旋钮
Sarathi-Serve 的 chunk_size 同时承担两种角色:它既是单个 Prefill 切片的上限,也是混合批的 token budget。小预算保护 Decode,大预算提高 Prefill 效率。不存在脱离模型、硬件、并行方式和服务等级目标的“最佳 512”。
先从 TBT SLO 反推预算
设离线 profile 得到批执行时间函数 ,其中 是本轮 Prefill token 数, 是 Decode token 数, 概括各请求上下文长度。给定 P99 TBT 目标 ,理想预算应满足:
实际系统很难直接拟合完整高维分布。论文采用一次性 profiling,并借助 Vidur 模拟器,在候选预算中选择不违反 TBT SLO 且容量最大的值。工程上可以先固定模型、精度、TP/PP 拓扑和注意力后端,扫描 max_num_batched_tokens,记录每种 Prefill/Decode 比例下的 P50、P95、P99 迭代时间,再用线上轨迹复核。
只看平均时间会犯两个错误。第一,长上下文 Decode 读取更多 KV,成本高于短上下文 Decode;第二,最后一个 Prefill 残块和多个短 Prefill 拼接会改变 ragged batch 形状。预算应当对目标流量分布做尾部校准,而不是拿单一方阵 GEMM benchmark 代替。
太小的 chunk 为什么会拖慢 Prefill
预算变小时,完整提示需要更多轮才能完成,TTFT 包含更多调度、kernel launch、通信与 KV 元数据准备。前文推导的历史 KV 重读也随 chunk 数增加。论文在 Yi-34B、两张 A100、TP=2 上测得:chunk size 512 相比不切分的 Prefill,最坏约增加 25% 的 Prefill 时间;chunk size 2048 的额外开销则几乎可忽略。
注意,这个 25% 不是通用常数。FlashAttention 版本、Paged KV 布局、GQA 的 KV 头数、上下文长度和 GPU 代际都会改变重读与计算的比例。模型使用 MQA/GQA 时历史 KV 字节数下降,小 chunk 的重读惩罚可能减轻;但若 kernel 对小 query 块支持不好,启动和 tile 利用率又可能主导。
257 为什么可能比 256 慢 32%
GPU GEMM 以 tile 为单位分配 thread block。若 token 维正好是 tile 大小的整数倍,最后一个 block 可以满载;若多出一个 token,就可能再启动一整排 block,其中绝大多数 lane 做无效工作。论文报告的极端例子是 chunk size 257 相比 256 可使 Prefill 时间增加 32%。
因此预算并不是连续可调的光滑旋钮,而是带有性能台阶。候选值应优先从 128、256、512、1024、2048 等与 kernel tile、分页块和 CUDA Graph 捕获尺寸对齐的集合中选择,再通过实测确定。官方仓库的动态 chunk 代码也把候选尺寸对齐到 32 的倍数;这不是模型语义要求,而是硬件执行形状要求。
Decode 数增大时,Prefill 余量会自动缩小
固定 并不意味着每轮都有 个 Prefill token。活跃 Decode 数 上升时,Prefill 可用预算为:
这形成了一种天然反馈:系统输出压力大时优先保持流式生成;Decode 请求少时,空余预算自动转给 Prefill。若 ,仅靠固定预算就无法让所有 Decode 在一轮内推进,调度器必须扩大预算、限制并发序列数、改变 SLO,或在多副本之间重新分流。
更进一步,稳定性要求长期 Prefill 到达工作量不能超过可分配余量。以每秒迭代数 粗略估算,Prefill 服务能力约为:
若到达流量带来的平均 Prefill token 率持续高于 ,等待队列仍会发散,哪怕每个运行请求的 TBT 都很好看。因此 token budget 解决的是批内干扰,不替代准入控制、负载均衡和容量规划。
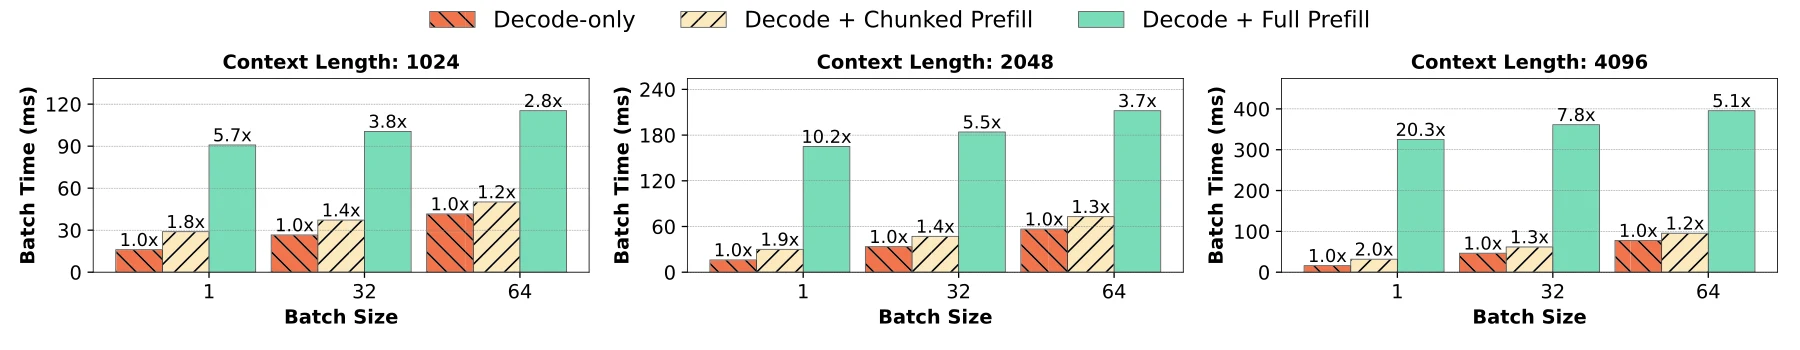
图源:Sarathi-Serve 论文图 9(a)。图中比较纯 Decode、混入完整 Prefill、混入固定预算 Prefill chunk 的相对单轮成本。完整 Prefill 会使小 Decode 批的迭代时间陡增;固定 chunk 把增量限制在较窄范围,而且随着 Decode batch 增大,新增 Prefill 的相对成本下降。
实验结果应该怎样解读
实验口径比最高倍数更重要
论文评测了四种模型与多种拓扑:Mistral-7B 在单张 A100 上,Yi-34B 使用两张 A100 做 TP=2,LLaMA2-70B 使用八张 A40 做 TP=4、PP=2,Falcon-180B 使用两台各四张 A100 的服务器做 TP=4、PP=2,节点间为 100 Gbps Ethernet。工作负载来自两个真实长度分布:
| 数据集 | Prompt 中位数 | Prompt P90 | 输出中位数 | 输出 P90 |
|---|---|---|---|---|
| openchat_sharegpt4 | 1730 | 5696 | 415 | 834 |
| arxiv_summarization | 7059 | 12985 | 208 | 371 |
这组数据揭示了一个重要边界:文章摘要任务的输入明显更长,Prefill 干扰更强,但输出较短。若用“固定 512 输入、固定 128 输出”的合成请求复现,很可能低估分块的价值,也看不到长提示对 P99 TBT 的伤害。
论文定义的 capacity 不是不顾延迟的最大 tokens/s,而是在 P99 TBT SLO 下仍能稳定服务的最大 queries/s,同时要求中位调度延迟不超过 2 秒,避免用无限排队制造虚假的设备利用率。严格/宽松 P99 TBT 目标依模型而异:Mistral-7B 为 0.1/0.5 秒,Yi-34B 为 0.2/1 秒,LLaMA2-70B 与 Falcon-180B 为 1/5 秒。
在严格 SLO、Yi-34B、openchat_sharegpt4 上,Sarathi-Serve 相比 Orca 可承载最高 4.0 倍负载,相比论文当时的 vLLM 可达 3.7 倍。对使用流水并行的大模型,LLaMA2-70B 在同一工作负载下相对 Orca 最高 6.3 倍、相对 vLLM 最高 4.3 倍。这里的“倍数”同时包含尾延迟不再先违规与流水空泡减少,不能解释为某个 kernel 快了 4 倍。
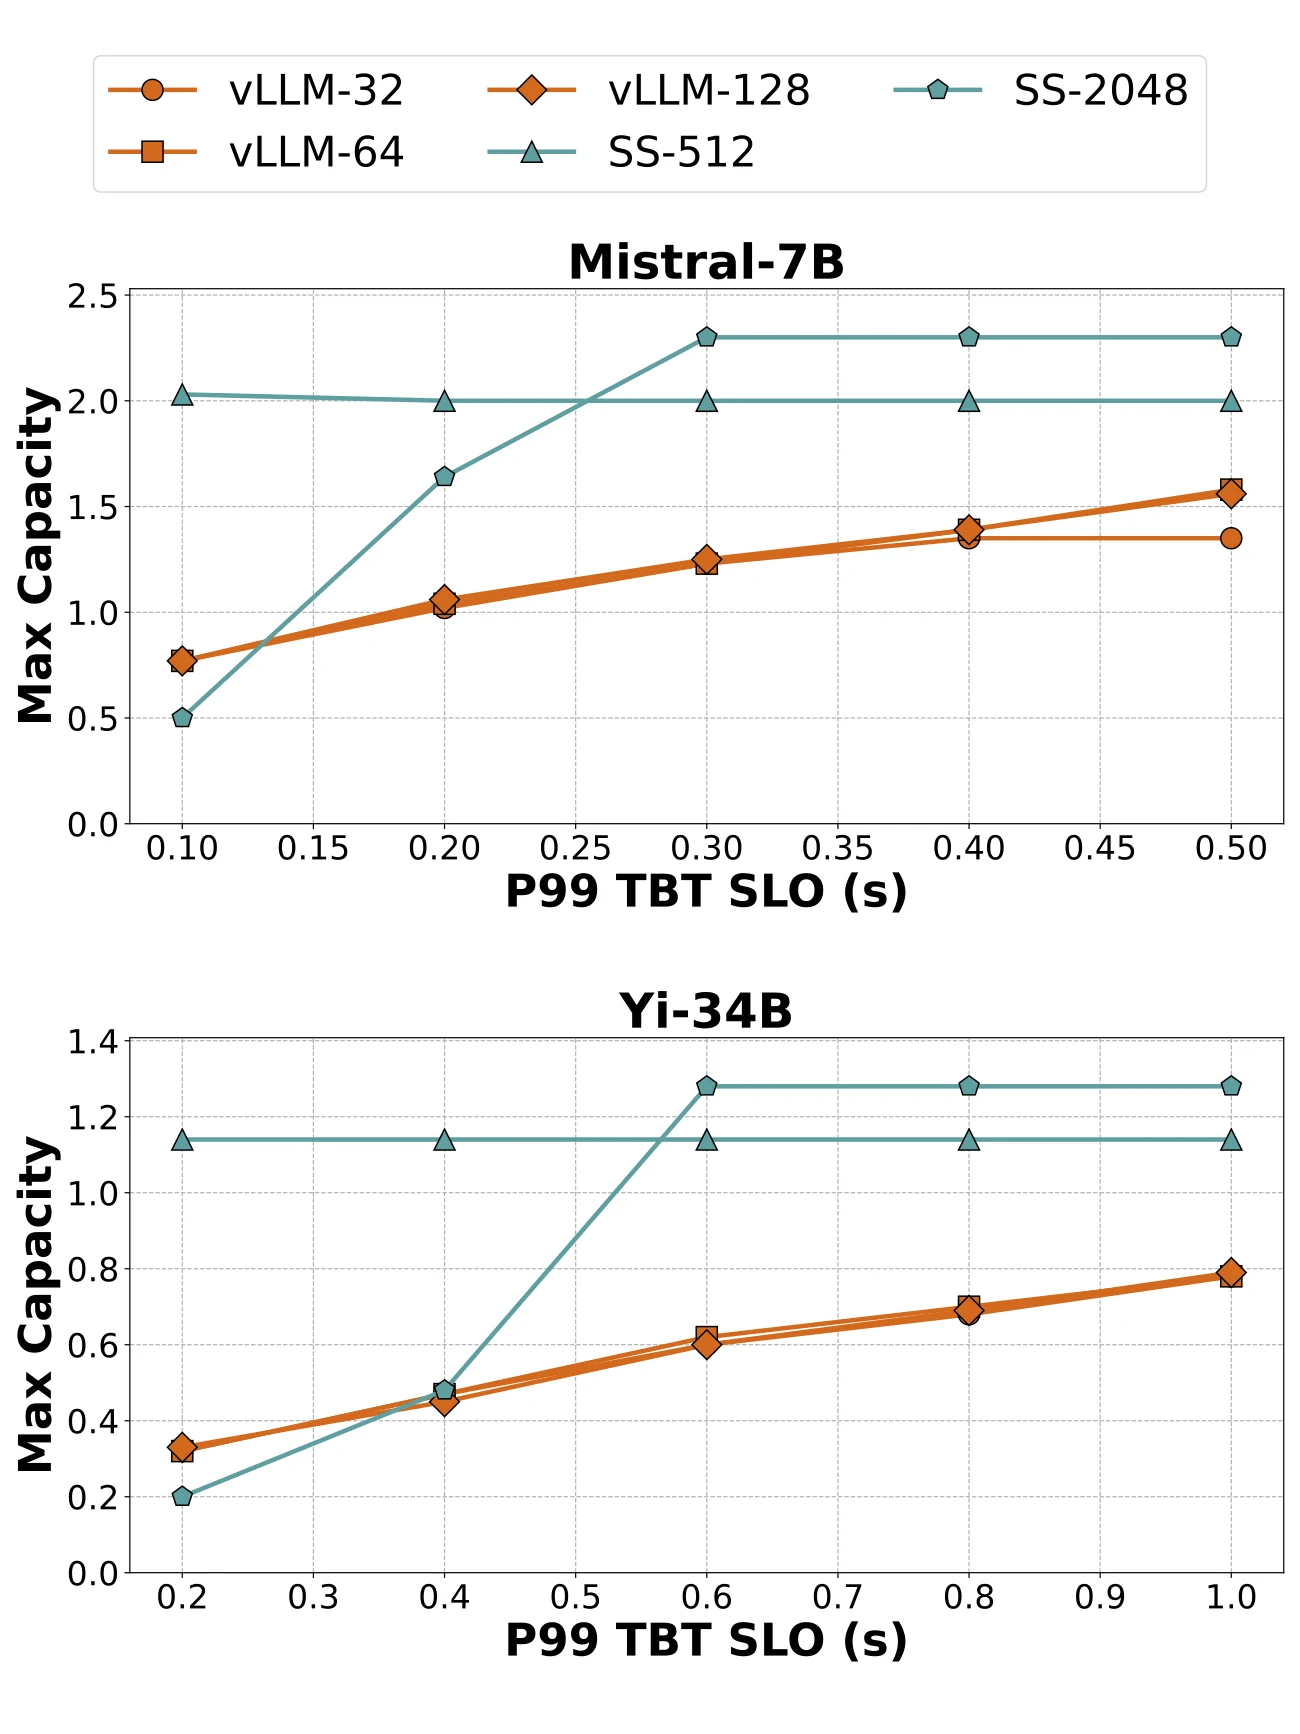
图源:Sarathi-Serve 论文图 12。横向比较时要保持模型和 SLO 相同。Mistral-7B 在 100 ms 严格 SLO 下,512-token 预算的 Sarathi-Serve 相比 vLLM 容量提高 3.5 倍;Yi-34B 在 1 秒宽松 SLO 下,2048-token 预算仍提高 1.65 倍。预算随 SLO 放宽而增大,说明性能来自可控地交换 Prefill 效率与 TBT,而不是一个配置统治所有负载。
消融实验说明两项机制缺一不可
论文在两张 A100 上运行 Yi-34B,用 128 个请求和 1024-token 预算,分别关闭分块或混合批:
| 调度方式 | OpenChat P50 TTFT | OpenChat P99 TBT | arXiv P50 TTFT | arXiv P99 TBT |
|---|---|---|---|---|
| 仅混合批,不分块 | 0.53 s | 0.68 s | 3.78 s | 1.38 s |
| 仅分块,不混合 | 1.04 s | 0.17 s | 5.38 s | 0.20 s |
| 两者结合 | 0.76 s | 0.14 s | 3.90 s | 0.17 s |
仅混合批的 TTFT 较好,因为新请求能快速整体进入,但长 Prefill 仍把 P99 TBT 拉高。仅分块能保护 TBT,却把 Prefill 拆成多轮且没有利用混合批的互补资源,TTFT 明显变差。两者结合后,TTFT 接近仅混合批,P99 TBT 又优于仅分块。这组消融比“容量提高数倍”更能证明设计因果链。
流水并行收益来自方差,不只来自均值
跨节点 TP 每层都需要 AllReduce,慢网络会直接进入 Decode 关键路径;PP 只在 stage 边界传激活,更适合把 TP 限制在单节点内。但 PP 怕微批时长不均:一个 stage 遇到长 Prefill,其他 stage 处理短 Decode,就会出现空泡。
在两节点、8 张 A100、Falcon-180B 的实验中,TP=8 的纯 Decode 中位 TBT 比节点内 TP=4、跨节点 PP=2 高 2 倍以上。换成混合并行后,普通 vLLM 在严格 SLO 下又受 Prefill 方差影响;Sarathi-Serve 通过统一 token budget 把微批时长拉齐,相比 vLLM 的同类混合并行配置,宽松 SLO 下容量提高 1.48 倍,严格 SLO 下提高 3.6 倍。
所以分块 Prefill 对 PP 的价值不是“让每个微批平均更快”,而是降低微批执行时间方差。流水线利用率近似取决于最慢 stage 和微批间不平衡,削掉长尾往往比缩短平均值更重要。
结果不能直接外推到今天的任意框架
论文基线反映 2024 年的 vLLM 与 Orca 实现。今天的 vLLM 已在官方文档中支持 chunked prefill,并允许用 max_num_batched_tokens 调节 TTFT、ITL 与吞吐。因此,“Sarathi-Serve 比 vLLM 高 3.7 倍”不能表述成对当前最新版 vLLM 的普遍结论;更准确的技术遗产是:Sarathi-Serve 系统化证明了分块 Prefill、Decode 优先混合批和 token budget 的价值,这些思想随后进入主流推理引擎。
与 P/D 分离、vLLM 调度的关系
Sarathi-Serve 选择共置,而 P/D 分离选择隔离
Sarathi-Serve 把 Prefill 与 Decode 放在同一模型副本、同一组 GPU 上,通过混合批利用两者的资源互补。DistServe、Splitwise 等 P/D 分离系统则把两个阶段放到不同 GPU 池:Prefill 池针对计算密集型大批量优化,Decode 池针对内存容量、带宽和稳定 TPOT 优化,Prefill 完成后把 KV Cache 传给 Decode 池。
两条路线解决的是同一个干扰问题,但支付不同代价:
| 维度 | 分块 Prefill 共置 | P/D 分离 |
|---|---|---|
| 干扰处理 | 用 token budget 限制同卡干扰 | 用物理资源隔离消除同卡干扰 |
| KV Cache | 原地继续使用,无迁移 | 必须跨进程或跨节点传输 |
| 资源粒度 | 一套副本可动态吸收 P/D 比例变化 | 两个池需分别容量规划 |
| 性能隔离 | 有界但非完全隔离 | 更容易独立控制 TTFT 与 TPOT |
| 部署复杂度 | 较低,适合单机或中等规模集群 | 需要路由、KV 传输与故障处理 |
| 异构硬件 | 同一 GPU 同时兼顾两相 | 两个池可选不同 GPU 或并行策略 |
短提示、请求规模不大或只有一组 GPU 时,P/D 分离的 KV 传输与资源碎片可能得不偿失,共置加分块更直接。超长上下文、高并发、严格的 TTFT/TPOT 双 SLO 或需要独立扩缩容时,物理分离能提供更强隔离。两者也不是互斥的:Prefill 池内部仍可对超长输入分块,Decode 池也需要连续批处理;分离解决池间耦合,分块解决单池内长任务的粒度问题。
P/D 分离的关键成本可以粗略写成:
是该请求已经生成的 KV Cache 大小, 是有效网络带宽,其余项分别对应序列化、排队和在 Decode 端注册缓存。若 接近甚至超过一次 Prefill 干扰造成的延迟,分离不一定有利;若 KV 可经 RDMA 高速传输且两个阶段的资源需求长期失衡,分离更容易提高集群 goodput。
Sarathi-Serve 与今天的 vLLM 是思想继承关系
Sarathi-Serve 官方仓库最初从 vLLM 分叉,补上分块 Prefill、混合调度、流水并行和遥测。它是研究原型,仓库也明确说明功能并不与完整 vLLM 对齐。评估论文时,应把“论文时点的 vLLM 基线”和“当前 vLLM”分开。
当前 vLLM V1 官方文档说明:chunked prefill 在条件允许时默认启用;调度器先放入所有待执行 Decode,再用 max_num_batched_tokens 的剩余预算安排 Prefill,放不下的 Prefill 自动切块。这与 Sarathi-Serve 的核心原则高度一致。官方调优建议同样呈现相同权衡:较小预算改善 ITL,较大预算改善 TTFT 与吞吐。
因此,在现代 vLLM 中应用这篇论文,通常不是部署一个独立的 Sarathi-Serve 服务,而是理解以下配置背后的系统含义:
from vllm import LLM
llm = LLM( model="meta-llama/Llama-3.1-8B-Instruct", max_num_batched_tokens=8192, max_num_seqs=256,)max_num_batched_tokens 控制每轮 token 工作量,max_num_seqs 控制并发序列及 KV Cache 压力。前者太小会增加 Prefill 轮数和 TTFT,太大可能伤害 ITL;后者太大会让 Decode token 本身吃满预算,还可能触发 KV 抢占。二者必须联合扫描,不能只调一个数字。
站内的vLLM Scheduler 源码拆解介绍了 V1 如何在统一 token budget 下处理分块 Prefill、前缀命中与抢占;Sarathi-Serve 提供的是这套调度逻辑背后的性能动机与经典实验证据。
实现边界与工程落地
先验证数值与状态正确性
分块 Prefill 最危险的错误往往不会崩溃,而是悄悄改变输出。实现至少要验证:
- 同一提示在一次性 Prefill 与不同 chunk size 下,第一个 token 的 logits 在允许的浮点误差内一致。
- RoPE 或其他位置编码使用全局绝对位置,不随 chunk 重置。
- 当前 chunk 的因果 mask 正确,既能看到全部历史,又不能看到本 chunk 内的未来位置。
- KV block table 在跨轮追加、抢占、恢复和最后一个非整块页面时保持一致。
- 采样只发生在完整 Prefill 结束后,而不是每个 chunk 末尾。
浮点归约顺序可能因 kernel 形状变化而改变,bitwise 相等通常不是合理目标。应比较 logits 的绝对/相对误差、固定随机种子下的贪心输出,以及长上下文边界位置的结果。若只跑短提示,位置偏移和跨页错误很容易漏掉。
观测四层指标,而不是只盯 GPU 利用率
第一层是用户延迟:P50/P95/P99 TTFT、TBT/ITL、端到端延迟,以及满足双 SLO 的请求比例。第二层是队列稳定性:到达率、排队时间、等待队列长度与被准入拒绝的请求数。第三层是调度器状态:每轮 Prefill/Decode token 数、chunk 分布、活动序列数、抢占和重计算次数。第四层是 GPU 与并行效率:HBM 带宽、SM/Tensor Core 利用率、kernel launch 间隙、NCCL 时间和流水空泡。
“GPU utilization 99%”并不代表服务健康:一个 16K 完整 Prefill 可以让 GPU 满载,同时把所有 Decode 卡住。相反,较小预算可能略降吞吐,却显著提高 SLO 内 goodput。对在线系统,目标函数应写成:
与 分别是 TTFT 和尾部 TBT 目标, 是测量窗口。只有两个约束都满足的请求才计入有效吞吐。
一套可复现的调参顺序
- 固定模型、精度、注意力后端、TP/PP 拓扑和 KV Cache 容量,避免多变量同时变化。
- 用真实 prompt/output 长度联合分布回放流量,而不是只用固定长度合成请求。
- 从与 kernel tile 对齐的预算集合开始扫描,例如 512、1024、2048、4096、8192;同时扫描
max_num_seqs。 - 对每个点逐步提升到达率,直到 P99 TBT、TTFT 或排队稳定性首先违规。
- 画出 goodput—TTFT—TBT Pareto 前沿,并记录 Prefill 分块开销、抢占次数和显存余量。
- 对白天/夜间、聊天/文档摘要等不同流量簇分别验证;若最优点差异很大,再考虑动态预算或分池路由。
预算调优应以服务曲线为单位,而不是一次 microbenchmark 的峰值。Prompt P90 从 2K 变成 20K 后,同一预算的 KV 重读、TTFT 和队列稳定性都会变化;GPU 从 A100 换到 H100/B200 后,计算与带宽比、tile 形状和 kernel 路径也会改变。
不能被固定 token budget 解决的问题
第一,极端 Decode 并发可能占满预算,使 Prefill 饥饿。需要准入控制、优先级老化或为 Prefill 保留最小份额。第二,固定 token 数不能精确代表成本;长历史注意力、MoE 专家不均、多模态 encoder 和投机解码的多 token 验证都会破坏“一 token 一成本”的近似。
第三,共置仍然共享 HBM、L2、SM 和通信链路,不能提供硬隔离。即使总 token 数固定,某些请求的 KV 页面更长或命中率更差,TBT 仍会波动。严格多租户 SLO 可能需要 P/D 分离、优先级队列或独立副本。
第四,Prefix Cache 会改变 Prefill 的实际剩余长度。命中共享前缀后,只应把未命中的 suffix 纳入预算;缓存淘汰又会让相同请求在不同时间具有不同成本。分块调度与前缀缓存是互补机制,但 cost model 必须读取实时命中结果。关于缓存替换的生产轨迹特征,可参考前缀缓存淘汰完全拆解。
第五,较小 chunk 会增加 TTFT,尤其当系统没有足够 Decode 可供“搭车”时。低负载下强行维持很小预算,可能把本可一次完成的 Prefill 拆成许多轮,只得到更差延迟。生产实现应允许在没有活跃 Decode 或 SLO 余量很大时扩大 chunk,而不是把 512 当作永恒常数。
小结
Sarathi-Serve 的核心不是简单地“把 Prefill 切小”,而是重新定义 LLM 服务的一轮工作量:Decode token 先获得不可被挤占的位置,Prefill 只使用 token budget 的剩余部分,长提示因而从一次巨大尖峰变成多次有界增量。
这套设计建立在三条可验证的系统事实之上:小 Decode 批受权重和 KV 读取限制,存在计算余量;中等规模 Prefill chunk 已能有效使用 GPU;流水并行更怕微批时长方差,而不只是平均计算量。分块保持因果注意力语义和总乘加量近似不变,代价是历史 KV 重读、更多 kernel launch 与更长 TTFT。
真正决定效果的是预算选择。它要同时满足 TBT SLO、Prefill 效率、tile 对齐、KV 容量和并行拓扑约束,并用真实流量下的 goodput 验证。现代 vLLM 已吸收 Decode 优先、分块 Prefill 与 token budget 等思想;P/D 分离则在更大集群上以 KV 迁移和资源规划复杂度换取更强隔离。理解这些边界,比记住论文中的某个固定 chunk size 或最高加速倍数更有价值。
参考资料
- USENIX OSDI 2024:Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
- Sarathi-Serve 论文 arXiv HTML 版
- Microsoft Sarathi-Serve 官方开源仓库
- SARATHI:Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills
- USENIX OSDI 2022:Orca 分布式生成模型服务系统
- SOSP 2023:Efficient Memory Management for Large Language Model Serving with PagedAttention
- vLLM 官方文档:Chunked Prefill 与性能调优
- USENIX OSDI 2024:DistServe 的 Prefill/Decode 分离
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


