


CUDA Graph 完全拆解:从逐次 Kernel Launch 到可重放推理执行图
从算力瓶颈到启动瓶颈
大模型推理的热点通常被概括为 GEMM、Attention 和通信,但端到端延迟里还有一段很容易漏掉的时间:CPU 把工作提交给 GPU 的时间。一次 CUDA kernel launch 不是一句 kernel<<<grid, block>>>() 就结束了。框架要先完成 Python 调度、算子分派、形状与步长处理,CUDA Runtime/Driver 再准备参数和 launch descriptor,最后 GPU 前端才接收并调度 grid。每层只有少量大矩阵乘时,这些固定成本不显眼;当 batch 很小、算子融合已经把主要 kernel 压到数微秒,或者张量并行把单卡工作切得更碎时,CPU 可能来不及持续给 GPU 喂任务。
这类瓶颈不是「GPU 算得慢」,而是 GPU 在两个短 kernel 之间等待下一张工单。用 Nsight Systems 观察时,典型信号是:CPU 的 CUDA API 区间连续出现,GPU kernel 却像一串被空白隔开的短条。关于时间线的读法和定位顺序,可结合 GPU 推理性能分析完全指南;这里关心的是诊断之后如何消掉这些空洞。
设一轮推理包含 个 kernel,第 个 kernel 的设备执行时间为 ,逐个提交的平均主机开销为 ,其中能够被前一个 kernel 掩盖的部分为 。不考虑数据传输时,一轮时间可粗略写成:
是有用的设备工作, 是暴露在关键路径上的提交开销。大 kernel 往往满足 ,CPU 能在 GPU 计算期间准备后续工作;小 kernel 密集时则可能出现 ,launch gap 被完全暴露。单纯提高 GPU 算力只会缩短 ,反而可能让后半项占比更高。
CUDA Graph 正是为重复工作流设计的另一种提交模型。NVIDIA 在 CUDA 10 中引入它:程序先把 kernel、内存操作和依赖关系定义成一张图,再将整张图实例化为可执行对象,后续用一次 cudaGraphLaunch 重放。它不把多个 kernel 合并成一个 kernel,也不减少模型的浮点运算;它减少的是每一轮重复穿过框架、Runtime 和 Driver 提交同一批工作的次数。
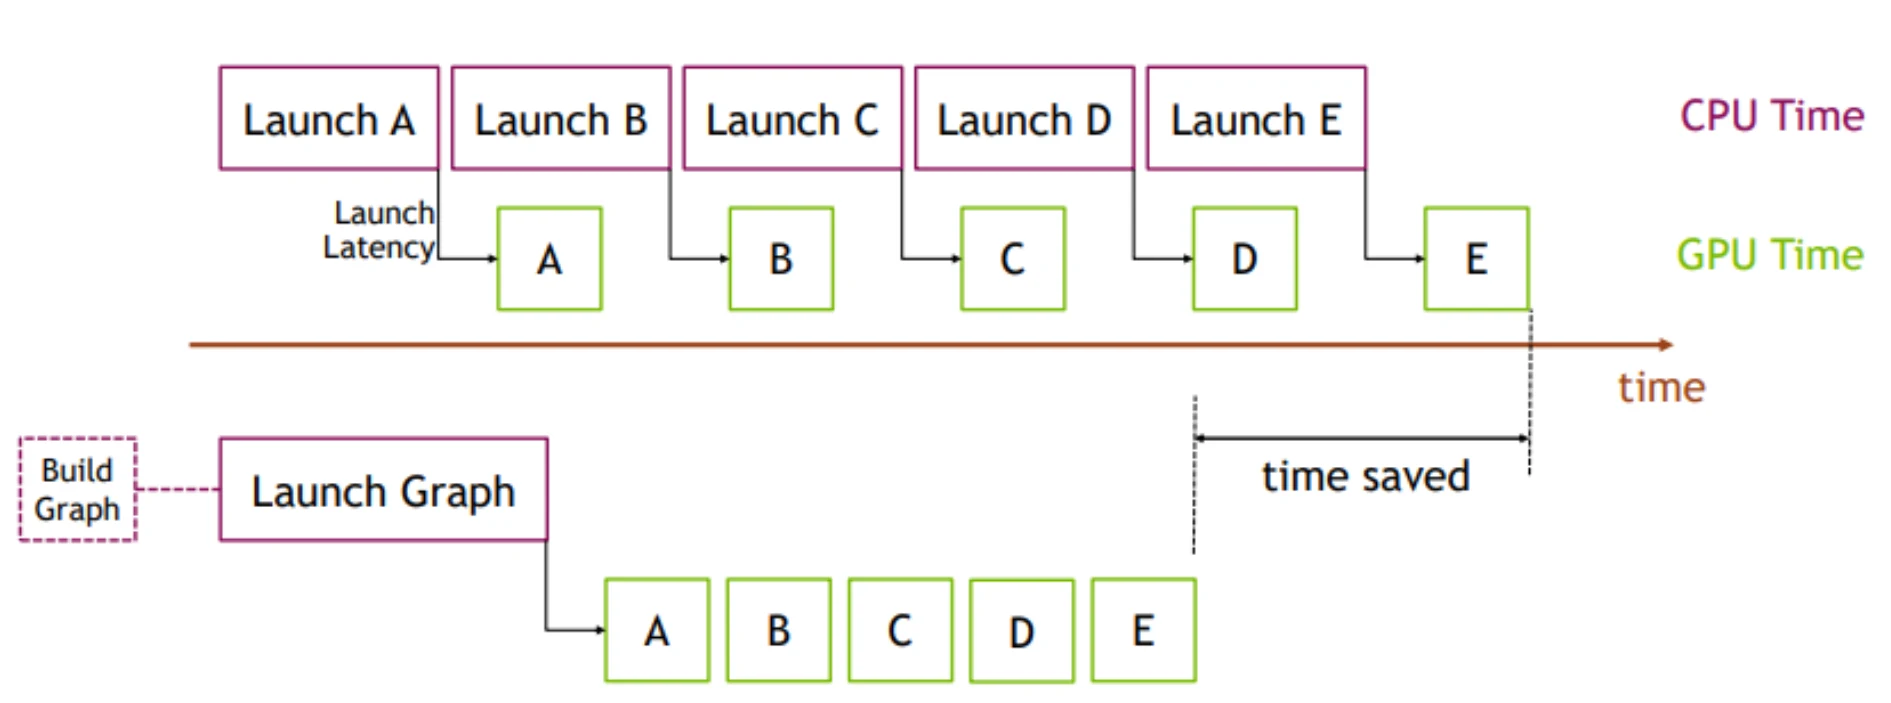
图源:PyTorch 官方 CUDA Graph 介绍。上半部分的五个 GPU 操作由 CPU 分别提交,空隙来自主机侧调度;下半部分先捕获同样的五个操作,重放时只提交一个图实例。图中的 kernel 仍然彼此独立,依赖和执行顺序也没有消失,变化的是提交粒度。
CUDA Graph 最早的官方示例给出了一个很直观的量级:在 Tesla V100 上,单个短 kernel 设备执行约 2.9 微秒;每次都同步时,折算到每个 kernel 为 9.6 微秒;把同步移到一轮末尾后降到 3.8 微秒;捕获 20 个 kernel 并重放图后为 3.4 微秒。这个数字不是所有模型都能复现的加速比,它说明的是同一件事:只有被暴露的 launch 开销足够大,且图被重用足够多次,一次性捕获和实例化成本才值得支付。
CUDA Graph 到底记录了什么
CUDA Graph 是有向无环图。操作是节点,依赖是边;一个节点只有在所有前驱完成后才具备执行资格,具体何时调度由 CUDA 决定。常见节点包括:
- kernel 节点:一次 grid launch;
- memcpy 与 memset 节点:数据搬运和初始化;
- event record / wait 节点:表达跨 stream 依赖;
- host 节点:在主机上执行的回调,但其能力和捕获限制要谨慎处理;
- child graph 节点:把另一张图作为嵌套子图;
- memory allocation / free 节点:以 GPU 顺序语义管理图内存;
- conditional 节点:在设备端表达 IF、WHILE 或 SWITCH 控制流。
因此,「图」不是 Python 计算图、Torch FX 图或编译器 IR 的同义词。三者关注的层级不同:
| 对象 | 主要描述 | 典型优化 | 是否直接负责 GPU 提交 |
|---|---|---|---|
| 模型/算子图 | 张量与算子的数据依赖 | 常量折叠、算子融合、布局变换 | 否 |
| 编译后的 kernel 序列 | 具体 kernel 与参数 | autotune、代码生成、融合 | 通常仍需 Runtime 提交 |
| CUDA Graph | CUDA 操作节点及执行依赖 | 预先准备工作描述、整体重放 | 是 |
算子融合和 CUDA Graph 也不是替代关系。融合把 两个 kernel 变成一个 kernel,可能少一次中间张量的 HBM 读写,也少一次 launch;CUDA Graph 保留两个 kernel,只把重复提交的固定成本前移到实例化阶段。生产系统通常先融合能融合的算子,再对剩余稳定序列做图捕获。
图的收益来自「提前知道」。普通 stream 模式只让 Driver 逐项看到工作,每个 launch 都要准备一次;图实例化能验证拓扑、准备工作描述,并利用全局依赖信息。以一轮图重放开销 、创建与实例化成本 表示,重放 次的平均每轮成本是:
只有当下面的不等式成立,图化才有净收益:
这个式子同时解释了三个工程事实。第一,重复次数 越大,实例化越容易摊薄;第二,单轮 kernel 越碎、数量越多,逐项提交越亏;第三,如果工作本来就是少数长 kernel,左侧接近零,CUDA Graph 不会凭空提升 Tensor Core 吞吐。
三条建图路径:显式 API、Stream Capture 与混合建图
CUDA 提供的不是唯一一种「录制」接口。显式 Graph API 和 Stream Capture 面向不同的改造成本,较新的接口还允许把捕获结果接到已有图上。选错路径不会改变图的理论能力,却会显著影响工程复杂度。
显式 Graph API:自己创建节点和边
显式方式先用 cudaGraphCreate 创建空图,再为 kernel、memcpy 等操作构造节点参数,用依赖节点数组表达边。其优势是节点句柄、拓扑和参数都在应用手中,适合需要精确更新少数节点、拼接子图或生成非线性拓扑的底层库。代价也直接:原本一段清晰的 stream 代码,要改写成繁琐的图构造代码;一旦库调用内部发射多少个 kernel 并不透明,手工复刻几乎不可维护。
较新的 CUDA Programming Guide 推荐统一的多态接口 cudaGraphAddNode(),节点类型由 cudaGraphNodeParams.type 决定;早期为不同节点分别提供的 cudaGraphAddKernelNode()、cudaGraphAddMemcpyNode() 等接口将逐步退居兼容位置。核心逻辑可以抽象为:
cudaGraph_t graph;cudaGraphNode_t load, compute, store;cudaGraphCreate(&graph, 0);
// 省略各节点 cudaGraphNodeParams 的填写。cudaGraphAddNode(&load, graph, nullptr, nullptr, 0, &load_params);cudaGraphAddNode(&compute, graph, &load, nullptr, 1, &compute_params);cudaGraphAddNode(&store, graph, &compute, nullptr, 1, &store_params);这段图表达 load → compute → store,而不是要求 CPU 在每次运行时依次提交三项工作。若两个节点只共享前驱但互不依赖,它们可以在前驱完成后并行。图 launch 所在 stream 只负责图与外部异步工作的顺序,不会把图内部所有节点强制压成单 stream 串行。
Stream Capture:把现有异步代码录成图
Stream Capture 更适合框架和已有 CUDA 程序。cudaStreamBeginCapture 到 cudaStreamEndCapture 之间提交到 stream 的工作不会立刻执行,而是追加到正在构造的图中:
cudaGraph_t graph;cudaGraphExec_t exec;
cudaStreamBeginCapture(stream, cudaStreamCaptureModeGlobal);embedding<<<grid1, block1, 0, stream>>>(...);rmsnorm<<<grid2, block2, 0, stream>>>(...);attention_library_call(stream, ...);cudaStreamEndCapture(stream, &graph);
cudaGraphInstantiate(&exec, graph, 0);for (int step = 0; step < decode_steps; ++step) { cudaGraphLaunch(exec, stream);}attention_library_call 内部即使调用了多个可捕获的 CUDA 库操作,也能被一起录入,因此改造面远小于显式建图。但「录制」这个词容易制造两个误解。第一,捕获期不是执行一遍再记住结果,而是记录未来要执行的 CUDA 操作;第二,图不会记录 CPU 分支背后的所有可能路径,只会得到捕获时实际提交的那条路径。
跨 stream 也能捕获,但必须把 fork–join 完整表达出来。原始 stream 记录 event,其他 stream 等待该 event 后进入同一 capture graph;结束前,分支 stream 再记录 event,并由原始 stream 等待,把所有分支汇合回来。cudaStreamEndCapture 必须在最初调用 begin 的 origin stream 上执行。漏掉 join 会使整个捕获失败。
捕获期间不能对被捕获的 stream 或 event 做同步/状态查询,因为此时它们代表的是尚未排队执行的图节点。某些分配、隐式同步、CPU 读取 GPU 结果以及不支持捕获的第三方库调用,也会破坏捕获。出现非法操作后,capture graph 会进入 invalidated 状态;程序仍应调用 cudaStreamEndCapture 退出捕获,但拿到的是错误和空图。这里最危险的做法是吞掉返回码,直到第一次 replay 才寻找不存在的执行图。
混合建图:捕获现有库,再手工改图
两种方法可以组合。程序先用 cudaStreamBeginCaptureToGraph() 把一段现有库调用接入指定图,再通过显式 API 添加条件节点、额外依赖或可单独更新的节点。这个路径适合中间层:既不想重写 cuBLAS、cuDNN 或框架内部的提交逻辑,又需要拿到某些节点句柄做细粒度控制。
实际选型可压缩为三条:完整掌握底层节点且拓扑需要精确编辑,用显式 API;已有一段成熟的异步 stream 代码,用 capture;大部分流程来自库调用、少数节点需要定制,用混合建图。不要因为显式 API 看起来「更底层」就默认它更快。两条路径最后都会得到 cudaGraph_t,性能差别主要来自最终拓扑、实例化结果和重放方式,而不是图最初如何构造。
从定义到执行:Instantiate、Replay 与 Update
cudaGraph_t 只是可修改的图模板,不能直接运行。CUDA Graph 的完整生命周期有三个阶段:
- definition:创建节点和依赖,得到
cudaGraph_t; - instantiation:验证图并预先完成尽可能多的初始化,生成
cudaGraphExec_t; - execution:把 executable graph 提交到 stream,可重复 launch,不必再次实例化。
实例化不是一次可忽略的类型转换。Driver 要验证拓扑、快照节点参数并准备执行所需的工作描述。第一次 launch 还可能包含把描述上传到设备的成本,所以性能测试必须区分捕获、实例化、首次 launch 和稳定 replay。对首包延迟敏感时,可以显式调用 cudaGraphUpload,把上传成本前移到请求到达之前;上传和 launch 最好使用同一 stream,否则图内存映射等状态可能需要重新处理。
一个重要的并发语义是:同一个 cudaGraphExec_t 不能与自身并发执行,后一次 launch 会排在前一次之后。如果服务端真要让两份同拓扑工作并发,不能只在两个 stream 上反复 launch 同一个 executable graph,而应准备彼此独立的实例,并同时审计输入输出缓冲区是否会冲突。原始 cudaGraph_t 也不是线程安全对象,多线程修改需要应用自行串行化。
参数变了,不一定要重新捕获
图的「静态」不等于所有数值永远相同。CUDA 把变化分成三档:
- 数据内容变化:地址和形状不变,只把新 token、position、slot mapping 等写入静态缓冲区,直接 replay;
- 节点参数变化:拓扑相同,但 kernel 参数或内存地址变化,用 individual node update 或 whole graph update;
- 拓扑/节点类型变化:通常必须重新实例化,必要时重新捕获。
少量已知节点变化时,可用 cudaGraphExecKernelNodeSetParams()、cudaGraphExecMemcpyNodeSetParams() 等接口直接更新 executable graph,跳过无关节点的拓扑比较。大量节点变化或节点来自 opaque library capture 时,可重新得到一张拓扑相同的 cudaGraph_t,再调用 cudaGraphExecUpdate() 更新已有实例。如果更新失败,应用应回退到重新实例化,而不是把失败当成「CUDA 会自动调整」。
更新能力有明确边界。例如,kernel 的函数拥有者不能任意跨 CUDA context 改变;memcpy 的源/目的内存类型和传输类型不能随意替换;conditional node 的主体结构和句柄对应关系也受约束。更新解决的是「同一工作流的参数变化」,不是把一张图原地变成任何另一张图。
这一层区分对推理服务尤其关键。把 batch size 从 8 改成 13,可能同时改变 grid、attention 元数据长度、KV slot 数和某些后端选择,未必是廉价参数更新能覆盖的变化。生产框架更常见的做法不是每轮 update 整张图,而是为一组代表性 shape 建立图缓存,以 shape/batch 描述符查找可重放实例;缓存未命中时选择 padding、捕获新图或回退 eager。
为什么地址、形状和控制流必须稳定
高层框架经常把 CUDA Graph 的限制概括为「静态 shape」,但真正被固定的是重放所需的 kernel 序列、依赖和参数布局。shape 之所以重要,是因为它会间接改变这些东西:矩阵维度影响 grid 和 kernel 选择,token 数影响 attention 元数据,动态输出可能触发新的显存分配,数据相关分支会改变下一批被提交的 kernel。
指针稳定:replay 不会重新做 Python 参数绑定
以 PyTorch 的 raw graph API 为例,捕获时 kernel 参数里记录了输入、输出和临时张量的设备地址。下一次 replay() 不会重新遍历 Python 对象并把一个新 tensor 的地址塞进去。因此正确模式是保留捕获时的长生命周期 static_input,每轮把真实输入复制进这块地址,再重放:
static_input.copy_(real_input)graph.replay()result = static_output.clone() # 仅在结果需要跨下一次 replay 保存时复制把 static_input = real_input 重新绑定成另一个 Python 对象没有作用,图里的 kernel 仍会读取旧地址。类似地,static_output 通常也复用同一地址;若调用方把它长期保存,而下一轮 replay 又覆盖这块内存,就会出现结果悄悄变化的别名 bug。
图内临时分配也必须有稳定语义。PyTorch caching allocator 会在 capture 期间从 graph-private memory pool 满足分配,使 replay 可以复用相同虚拟地址。多个图可以共享私有 pool,但只有在它们的重放顺序与捕获顺序一致、且不会并发时才安全。用一份显存换低 CPU 开销,是 CUDA Graph 在推理框架里的真实成本之一;shape bucket 越多,图实例、静态输入和私有内存池占用越值得监控。
原生 CUDA 的 graph memory node 提供了更底层的机制:allocation node 创建的虚拟地址在图生命周期内固定,物理内存可在生命周期不重叠的 allocation 之间复用;分配与释放按 GPU 执行顺序而不是 CPU API 调用顺序生效。固定虚拟地址正是让其他节点无需每次更新指针的基础,但销毁图不等价于自动释放所有仍存活的 graph allocation,生命周期管理不能省略。
形状稳定:固定的是执行变体,而非业务请求
在线服务的 batch size、prompt 长度和每个请求的解码状态不断变化,看起来与 CUDA Graph 天生冲突。常用解法是 bucket 化。设实际 token 数为 ,已捕获尺寸集合为 ,运行时选不小于 的最小 bucket:
真实数据写入前 个槽位,其余 个槽位用 padding、mask 或空请求占位。这样 graph 看到的是固定 shape,调度器看到的仍是动态流量。代价是 padding 工作量:
bucket 很密, 小,但捕获时间和图缓存显存上升;bucket 很稀,图少了,却让 GPU 计算大量无效槽位。最佳集合不是固定的 ,而应由线上 batch 分布、不同尺寸的 kernel 效率和显存预算共同决定。命中频繁的尺寸可以单独捕获,长尾尺寸则向上取整或回退 eager。
控制流稳定:CPU 不能在 replay 中间重新做决定
如果模型先运行一个 GPU kernel,再把结果同步回 CPU,最后由 Python if 决定执行专家 A 还是专家 B,那么整段无法按传统方式捕获为一张固定图。数据相关控制流的选择发生在 replay 内部,而 CPU 在这次 cudaGraphLaunch 中没有重新参与逐节点调度。
有四类处理办法:
- 把分支改写成 predication 或 mask,固定执行拓扑;
- 只捕获分支两侧稳定的子区间,让动态边界保持 eager;
- 为有限分支分别缓存图,由 CPU 在图外选择;
- 在合适的 CUDA 版本和节点约束下使用 conditional graph node,让设备端条件驱动 IF、WHILE 或 SWITCH 子图。
第四种能力扩展了图能表示的动态性,但不是「任意 Python 控制流自动可捕获」。conditional body 允许的节点类型、设备范围、内存操作和更新方式仍有限制,高层框架也需要显式映射。工程上更稳妥的原则是先划出静态岛,再决定是否值得把动态边界继续下沉。
CUDA Graph 如何落到大模型推理
自回归解码恰好同时具备 CUDA Graph 喜欢和讨厌的特征。喜欢的是重复:每一步都执行近似相同的 decoder 层、KV 读写、采样和通信。讨厌的是动态:请求随时进入和退出,batch 组成变化,序列长度递增,PagedAttention 的 block table 和 slot mapping 每步更新,投机解码还会改变单请求的 query length。
因此,成熟系统捕获的不是「一条请求从头到尾」,而是某类批次的一次 model forward。调度器仍在图外完成请求选择和 KV block 分配,把变化写进地址稳定的元数据缓冲区;图内 kernel 根据这些缓冲区读取本轮的 token、position、block table 和有效槽位。可参考 PagedAttention 完全拆解 理解为什么 KV 物理页可以变化,而传给 kernel 的块表缓冲区地址仍可保持固定。
Prefill 和 decode 为什么要区别对待
Prefill 的 token 数跨度大,attention 计算量高,常由少数持续时间较长的 kernel 主导。此时 launch overhead 占比小,强行 padding 到大 bucket 可能得不偿失。Decode 每个请求通常只新增一个 token,batch 内 query length 更整齐;单步会重复数十层短 kernel,又要执行几百到几千步,是图重放最理想的区域。
P/D 分离部署进一步强化了这一区别:decode 实例可以只准备 uniform-decode 图,避免为复杂 prefill/mixed batch 保存大量图和私有池;prefill 实例则保留 eager 或只图化稳定子段。图优化的边界由工作负载决定,不必追求「全模型、全阶段、全流量」这一种形式。
vLLM 的官方设计把这种取舍显式化为多种运行模式:NONE 完全 eager;PIECEWISE 只捕获兼容区段,不兼容的 attention 等操作留在图外;FULL 捕获整个 forward;FULL_DECODE_ONLY 只为 uniform decode 使用完整图;FULL_AND_PIECEWISE 则按批次在完整图与分段图之间切换。运行时用包含 token 数、请求数、是否 uniform、是否含 LoRA 等信息的 batch descriptor 选择模式和图实例。这个设计的重点不是枚举值本身,而是承认 CUDA Graph 是调度器的一种执行资源,必须和 batch 形态协同。
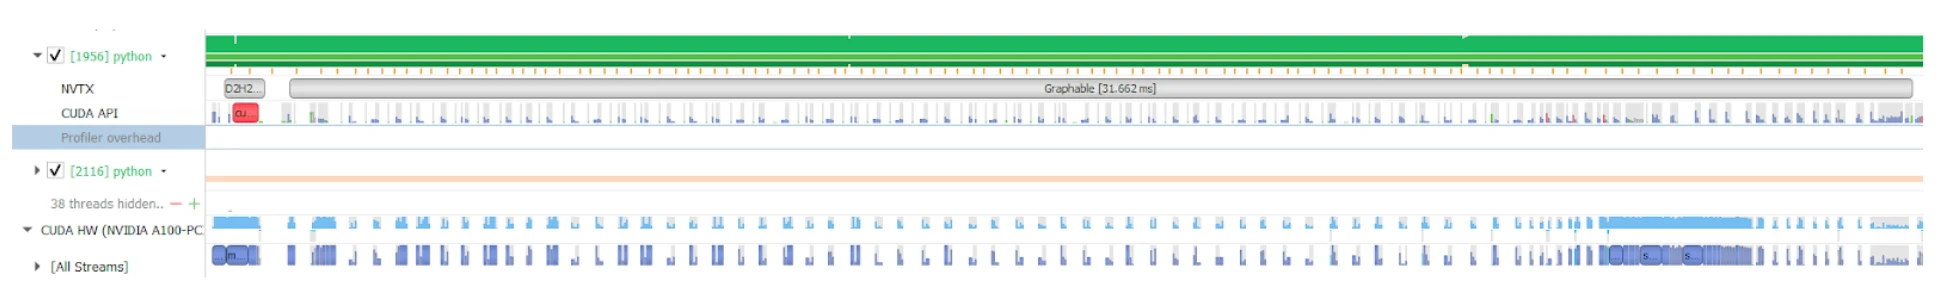
图源:PyTorch 官方 CUDA Graph 文章。绿色 CPU 工作已经占满一侧,蓝色 GPU kernel 之间仍有大段空白,这是典型的 CPU-bound submission。不能只看 GPU kernel 自身 duration;真正影响端到端延迟的是从上一段有用设备工作结束,到下一段开始之间的空洞。
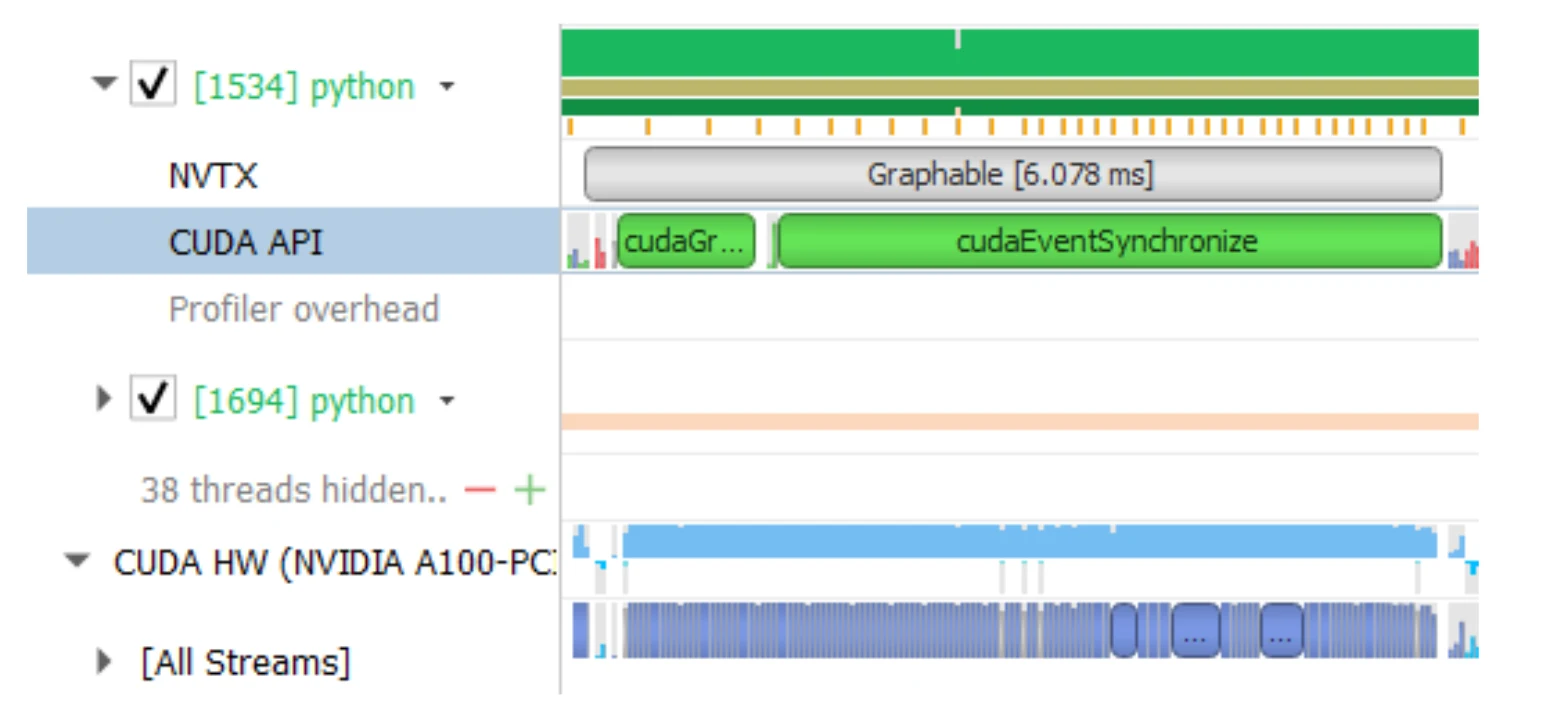
图源同上。图化区间通过一次重放提交后,kernel 在设备时间线上明显紧凑。这个现象不代表每个 kernel 的算法变快,而是 Driver 不再等 CPU 为相同序列逐一准备 launch。PyTorch 官方的 Llama 3 FP8 推理案例也给出过更贴近生成模型的微观数据:其模拟 Llama 3 70B attention 层中,相邻 GEMM 的间隙为 165 微秒,而 matmul 本身约 12 微秒;图重放后间隙降到 6.65 微秒。该实验报告单层相对朴素实现约 6.4 倍加速,但这是刻意暴露 launch overhead 的特定 attention 层,不应外推成完整 LLM 的固定加速比。
与连续批处理、算子融合、persistent kernel 的关系
连续批处理在每个迭代边界重新组合活跃请求,提高 GPU 工作量和 KV 利用率;CUDA Graph 减少组成一个迭代的 kernel 提交成本。二者会发生张力:调度越灵活,batch descriptor 的组合越多,图缓存越复杂。关于迭代级调度的基本机制可参考 连续批处理完全拆解 和 vLLM 调度器源码拆解。
算子融合减少节点数、内存流量和 launch 次数;CUDA Graph 降低剩余节点的批量提交成本。persistent kernel 或 megakernel 则更进一步,把调度器和多个操作常驻到 GPU 内部。三者大致处于不同层级:融合改变 kernel 边界,Graph 改变提交方式,persistent kernel 改变执行组织。Graph 的改造成本通常低于重写 megakernel,也保留了库 kernel 的模块性;但它仍有每次 graph launch、bucket 分派和图内节点调度成本,不等于 GPU 内部常驻 runtime。
PyTorch 实战:捕获一段可重放推理
下面的例子只捕获一个静态 shape 的前向路径,故意保留 warmup、side stream、静态缓冲区和输出生命周期这些容易漏掉的步骤。模型换成 decoder 子模块后,骨架仍然成立。
import torch
torch.set_grad_enabled(False)device = "cuda"
model = torch.nn.Sequential( torch.nn.Linear(4096, 11008, bias=False), torch.nn.SiLU(), torch.nn.Linear(11008, 4096, bias=False),).to(device=device, dtype=torch.float16).eval()
# 捕获和 replay 始终使用这些地址。static_input = torch.empty( (8, 4096), device=device, dtype=torch.float16)
# warmup 必须先触发懒初始化、库句柄创建和 kernel 选择。warmup_stream = torch.cuda.Stream()warmup_stream.wait_stream(torch.cuda.current_stream())with torch.cuda.stream(warmup_stream), torch.inference_mode(): for _ in range(3): static_output = model(static_input)torch.cuda.current_stream().wait_stream(warmup_stream)
graph = torch.cuda.CUDAGraph()with torch.cuda.graph(graph): static_output = model(static_input)
def infer(real_input: torch.Tensor) -> torch.Tensor: if real_input.shape != static_input.shape: raise ValueError("shape 不属于当前 CUDA Graph bucket") static_input.copy_(real_input) graph.replay() # 若消费者会在下一次 replay 后继续持有结果,必须 clone。 return static_output.clone()为什么必须 warmup
第一次运行模型可能触发 cuBLAS/cuDNN 句柄初始化、JIT 编译、autotune、显存池扩展或其他一次性动作。这些工作有的不能被捕获,有的即使能捕获也不应成为每次 replay 的一部分。warmup 的任务是把「只该做一次」的状态建立完,再记录稳定热路径。
warmup 放在 side stream 上,不只是风格偏好。PyTorch 官方 CUDA semantics 要求在用于捕获的上下文之外完成这些准备,并用 stream dependency 保证它结束后才开始 capture。少了前后的 wait_stream,可能出现默认 stream 尚未完成模型初始化,捕获 stream 就开始读写同一资源的竞态。
输入复制为何可以留在图外
上例的 static_input.copy_(real_input) 没有被捕获。这样做保留了请求接入层的灵活性:真实输入对象可以每次不同,只要形状、dtype 和 device 匹配,复制后图内仍读取固定地址。复制本身也是异步 CUDA 操作;它和 graph.replay() 提交到同一当前 stream 时,stream 顺序保证先复制再计算,不需要中间 torch.cuda.synchronize()。
如果 H2D 输入路径也高度稳定,可以把 memcpy 作为图节点捕获;但 host 地址、pinned memory 生命周期和请求并发会变得更难管理。推理服务通常先图化 device-side model runner,把网络接入、tokenization、CPU scheduler 和不规则 H2D 路径留在图外。
多个 shape 怎么管理
生产代码应把单个 graph 扩展为缓存项,每项至少包含:bucket key、CUDAGraph、静态输入、静态输出、额外元数据缓冲区和估算显存。伪代码如下:
class GraphEntry: def __init__(self, graph, inputs, outputs, bucket_size): self.graph = graph self.inputs = inputs self.outputs = outputs self.bucket_size = bucket_size
def run(batch): key = choose_bucket(batch) entry = graph_cache.get(key) if entry is None: return run_eager(batch) # 也可低频捕获,但不要阻塞关键请求
pack_into_static_buffers(batch, entry.inputs) entry.graph.replay() return unpack_valid_rows(entry.outputs, batch.size)缓存淘汰不能只按图对象数量。一个图实例背后可能关联 graph-private pool 和多块静态 tensor,真正约束是总显存、捕获耗时与命中率。若在线临时捕获,首个命中某 bucket 的请求会承担明显延迟尖峰;更可控的方式是在模型加载后根据流量画像预热热点 bucket,长尾保持 eager。
torch.compile(mode="reduce-overhead") 会在适合的区段利用 CUDA Graph 来降低 Python 和 launch overhead,适合不想手工管理 raw graph 的场景;但它仍受 mutation、动态 shape、CPU-GPU 同步和 graph break 影响。自动化封装减少了 API 工作量,不会取消底层约束。遇到性能不符预期,仍要查看实际捕获区间、重编译次数和 eager fallback。
性能模型与测量方法
判断 CUDA Graph 是否值得做,最有用的不是「启用前后 tokens/s」一个数字,而是把一轮延迟拆成四部分:
是框架与 Driver 的主机工作; 是没有被其他工作掩盖、且 GPU 空闲的提交间隙; 是设备有用工作; 是必要或意外的同步。CUDA Graph 主要压缩前两项,不能修复低效 kernel,也不能让必要的请求间依赖消失。
先看时间线,再跑端到端基准
推荐按以下顺序测量:
- 用 Nsight Systems 检查 CPU API 与 GPU kernel 时间线,确认 kernel 间存在可见空洞;
- 把 capture、instantiate、first launch 和 steady replay 分开计时;
- 分别报告 batch、输入长度、输出长度、并发、dtype、量化、GPU、CPU、CUDA 与框架版本;
- 对在线系统同时比较 TTFT、TPOT、P50/P95/P99 和吞吐,不只比较平均值;
- 检查图缓存命中率、padding 比例和额外显存,避免把成本藏在总 tokens/s 外。
图捕获会改变 profiler 的观察方式,profiler 本身也可能给微秒级事件增加扰动。稳态延迟应使用足够多次重复和 CUDA event,端到端延迟则用 CPU wall clock 并在计时边界正确同步。下面是区分首次执行与稳态 replay 的简化测量:
start = torch.cuda.Event(enable_timing=True)end = torch.cuda.Event(enable_timing=True)
# 不把 warmup、capture 和第一次可能的 upload 混入稳态数据。for _ in range(10): graph.replay()torch.cuda.synchronize()
start.record()for _ in range(1000): graph.replay()end.record()end.synchronize()
print("steady replay ms:", start.elapsed_time(end) / 1000)CUDA event 给出 GPU 时间域里的区间,不包含请求在 Python 队列、CPU 调度器和网络栈中的等待。若优化目标是单请求端到端延迟,还需在更外层用 wall clock 测量;若目标是隔离 graph 对设备提交的影响,则应同时保留 event 和 wall clock,两者差距本身就有诊断价值。
计算摊销阈值
设逐项 eager 每轮为 ,稳定 graph replay 每轮为 ,捕获、实例化与预热总成本为 。至少运行多少轮才能回本,可由下式估算:
若 ,分母非正,这段工作没有图化收益;若单轮只省几微秒而捕获要数百毫秒,低频 bucket 可能永远无法回本。反过来,自回归 decode 的热点 bucket 每秒重放大量次数,即使单轮收益不大,累积 CPU 释放和尾延迟稳定性也可能很可观。
NVIDIA 在 CUDA 12.6、RTX 3060 与特定主机平台上的官方微基准显示:Ampere 上含 10 个以上节点的直线 kernel 图,重复 launch 的 CPU 开销约为 微秒再加每节点约 纳秒;同一测试在 CUDA 11.8 上近似为 微秒加每节点 纳秒。这个结果说明新版 Runtime/Driver 已把直线图的重复提交做得接近常数时间,但仅适用于文中测试的拓扑、架构与软件版本。多 root、非 kernel 节点、旧架构和复杂图都有不同曲线,部署决策仍须在目标机器上实测。
常见失败模式与排查顺序
捕获直接报错或返回空图
先检查 cudaStreamEndCapture 的返回码,并定位捕获区间内的同步、legacy default stream、动态分配和不支持 capture 的库调用。捕获中的 stream 并没有真正执行工作,所以对它调用 cudaStreamSynchronize 或查询状态在语义上就不成立。跨 stream 时再检查所有分支是否通过 event 汇回 origin stream。
排查时应从最小区间开始:先捕获一个已知安全的 kernel,确认基础链路;再逐段扩大范围,直到找到破坏 capture 的调用。一次包住整个 model forward 后只看到「capture invalidated」,通常很难直接定位根因。
replay 能跑,但结果错误
优先审计地址和生命周期:是否把新 tensor 重新绑定给变量,却没有复制进静态输入;捕获时使用的临时 tensor 是否已被释放;输出是否在下一次 replay 后仍被外部持有;多个请求或多个 graph instance 是否并发写入同一静态 buffer;padding 区是否被正确初始化和 mask。
第二类错误来自捕获时的 CPU 分支。若 if tensor.item() > 0 在捕获前把 GPU 值同步到 CPU,图里只留下当时选择的分支;后续数据改变不会让 Python 重新选择。解决方式是把分支留在图外、分别缓存分支图,或用真正受支持的设备端条件表达。
replay 正确,却没有变快
先确认瓶颈是否真在 launch。若 GPU 时间线已经被长 GEMM 填满,图能省的只是被完全掩盖的 CPU 工作。然后检查:捕获范围是否太小;每轮是否仍在图前后同步;是否为输出 clone 付出比 launch gap 更大的代价;是否因为 padding 执行了过多无效 token;图缓存是否频繁 miss;是否把捕获或第一次 upload 混进每轮计时。
还要避免把「CPU API 更短」误认为「请求一定更快」。CPU 被释放后可以去做调度、网络和下一批准备,这可能提升系统吞吐或降低抖动;但如果 GPU 本来就是满载计算,单请求设备延迟未必显著下降。优化目标必须在 benchmark 中明确。
显存突然增加
检查捕获尺寸数量、每个图的静态输入输出、graph-private pool、workspace 和并发实例数。多个图共享内存池只在重放顺序固定且不并发时安全;为了省显存错误共享,代价可能是数据破坏。对于部署系统,更合理的是设置图缓存预算,记录每个 bucket 的命中率与增量显存,并淘汰长期不命中的实例。
多线程或多 stream 出现串行化
同一个 executable graph 不能与自身并发,这是常被忽略的串行化来源。即使把它 launch 到不同 stream,CUDA 也会让后一次执行排在前一次之后。并发服务要么让调度器合并请求后用一个实例运行更大 batch,要么维护多个独立 graph exec 和不冲突的缓冲区。图 launch 所在 stream 只规定外部顺序;图内部并行由依赖边决定,不会因为换一个 stream 就重新解释拓扑。
适用边界:何时值得用,何时不该用
CUDA Graph 最适合同时满足四个条件的区间:工作流高频重复;包含许多短 kernel;CPU 提交已成为可见瓶颈;形状、地址和控制流能稳定下来或被有限 bucket 覆盖。小 batch decode、低延迟推荐系统、固定 shape 推理子图和高频通信计算序列都常落在这个区域。
以下场景通常应保持 eager,或只做 piecewise capture:
- 少数长 kernel 已经让 GPU 持续满载,launch gap 被完全掩盖;
- 输入 shape 几乎每次不同,padding 浪费大且 bucket 命中低;
- 每轮都有 CPU 参与的数据相关决策或不支持 capture 的外部调用;
- 工作只运行一两次,实例化与预热无法摊销;
- 显存比 CPU 开销更紧张,图缓存和静态池会挤压 KV Cache;
- 调试阶段仍频繁改变拓扑,eager 的可观测性和灵活性更重要。
决策时可使用一个朴素流程:先用时间线证明存在 launch gap;再选最稳定、重复次数最多的子区间;为真实流量设计少量 bucket;记录捕获成本、稳态收益、缓存命中和显存;最后才扩大捕获范围。完整捕获不是目标,减少关键路径上被暴露的固定成本才是目标。
小结
CUDA Graph 的核心不是「把动态图变静态」这句口号,而是把重复工作流的定义与执行分离。节点、依赖和大部分参数准备在 definition/instantiation 阶段完成,热点路径只做轻量 replay。它因此能跨过 Python、框架和 Driver 的逐 kernel 提交开销,却不会改变 kernel 算法、减少 FLOPs 或自动解决内存带宽瓶颈。
大模型推理落地的关键,是把业务动态性转换成图外调度与图内静态缓冲:请求和 KV 页每轮都可变化,但 model runner 使用固定地址;batch 大小可变化,但落入有限 shape bucket;不规则 prefill 可以 eager,规则 decode 使用完整图;不兼容算子把执行切成静态岛。CUDA Graph 由此不是孤立的 CUDA 技巧,而是调度器、内存管理器、编译器和 kernel 之间的一份执行契约。
最终收益由四个量决定:逐项提交暴露了多少空洞、图能重放多少次、为静态化付出多少 padding 与显存,以及捕获范围外还剩多少同步。把这四项同时量出来,才能判断一次漂亮的 Nsight 时间线是否真的转化成更低 TPOT、更稳尾延迟或更高吞吐。
参考资料
- NVIDIA CUDA Programming Guide:CUDA Graphs
- NVIDIA Technical Blog:Getting Started with CUDA Graphs
- NVIDIA Technical Blog:Constant Time Launch for Straight-Line CUDA Graphs
- NVIDIA Technical Blog:Employing CUDA Graphs in a Dynamic Environment
- PyTorch:Accelerating PyTorch with CUDA Graphs
- PyTorch CUDA semantics:CUDA Graphs
- PyTorch:Accelerating Llama 3 FP8 Inference with Triton Kernels
- vLLM Design Docs:CUDA Graphs
- NVIDIA CUDA Samples
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


