


TileRT 完全拆解:tile 级常驻执行引擎,如何把 671B 到 1T 参数的模型压进毫秒级解码
从「吞吐优先」到「延迟优先」:推理系统的主矛盾正在更换
服务化大模型以来,推理系统的优化主线经历过几次迁移。最初的问题是让超大规模模型能真正跑起来;随后几年,行业把重心放在单位成本下的高吞吐上,更大的 batch、更深的队列、多级 KV Cache 成为主流推理框架的设计核心,这一路线以 vLLM、SGLang 的连续批处理为代表(机制见本站《连续批处理完全拆解》),至今仍是绝大多数生产集群的选择。
但实时 AI 交互正在改变取舍。Agent 长任务、实时代码补全、语音对话、工具调用以及测试时扩展(Test-Time Scaling)的兴起,把推理推向了 latency-first:用户不再只关心系统每分钟能产出多少 token,而开始在意「下一次响应什么时候到」。对 Agent 而言,推理速度直接决定固定延迟预算内的 rollout 次数、搜索深度和自验证能力——系统速度开始反过来决定模型能力的边界。TileRT 官方博客把这条主线概括为「速度是大模型推理的下一个 Scaling Law」。
在这种场景下,单请求延迟(而不是聚合吞吐)成为核心指标。解码侧常用的两个口径是:每秒生成 token 数(tokens/s,TPS)与每输出 token 时间(TPOT,Time Per Output Token),二者互为倒数。若一个请求独占整台服务器,TPS 与「单用户每秒收到的 token 数」同义。
一个令人不安的落差:算力不缺,延迟却下不去
先做一个带宽视角的估算。解码(decode)阶段每生成一个 token,都要把模型的全部激活权重从 HBM 读一遍——在 batch=1 时没有第二份请求来摊薄这份访存量,所以单 token 解码是内存带宽受限的。设 HBM 聚合带宽为 ,单次解码需读出的激活参数量为 ,则生成速率的天花板为:
以 8×B200 的 HGX 服务器为例:单卡 HBM3e 带宽约 8 TB/s,聚合约 64 TB/s;GLM-5 这类 MoE 模型在 NVFP4 精度下每次 decode 只需读出约 21 GB 激活参数。代入:
也就是说,即使不用任何投机解码技巧,纯带宽天花板就有约 3000 tokens/s。换成 8×H200(聚合约 38.4 TB/s)跑 FP8 精度的 GLM-5.1(激活访存量约 42 GB),理论上限也在 1000 tokens/s 附近。
现实却远低于此。TileRT 团队在剖析自己接入前的系统时发现:端到端速度往往只有几十 tokens/s,与理论上限隔着一个数量级;更反直觉的是,此时 GPU 利用率并不低、FLOPS 指标也不差,token 延迟却居高不下。这说明瓶颈不在「算得不够快」,而在别处。
执行缝隙(Execution Gap):被大 kernel 掩盖的固定开销
传统推理框架沿用一套经典执行模型:模型被拆成一串独立的算子(operator),每个算子单独编译成 kernel,host 依次 launch,GPU 依次执行、同步,中间结果反复经由 global memory 往返。可以概括成一条周期:
launch → load → compute → store → synchronize → 下一个 kernel这套抽象在训练时代非常成功:那时一个 kernel 往往要处理巨大 batch,计算量大到可以自然掩盖 launch、同步与 runtime 调度的固定成本。但 decode 改变了时间尺度——batch=1 时单个 kernel 的「净计算」被压缩到微秒级生命周期,过去被摊薄、被掩盖的固定开销全部浮出水面,重新进入关键路径:
- host 端 kernel launch 延迟:一次 CUDA launch 本身就有微秒级开销;
- 跨 kernel 的硬件同步:kernel 边界上的隐式/显式 barrier,迫使执行单元停下来等最慢的 wave;
- global memory 往返:每个算子都要把中间结果写回 HBM、下一个算子再读回来;
- runtime 调度的编排成本:host 上调度器为每个算子做状态切换。
TileRT 团队把这类「基础设施的产物、并非计算本身所需要」的等待统称为 execution gap(执行缝隙)。性能分析中常见的情形是:kernel 还没来得及「热起来」就结束了,GPU 被迫反复重复上面那条周期,每一次算子边界都打断数据流、破坏局部性、迫使执行单元重新同步。真正限制速度的往往不是某个 GEMM 算得慢,而是下一个计算什么时候才能开始。
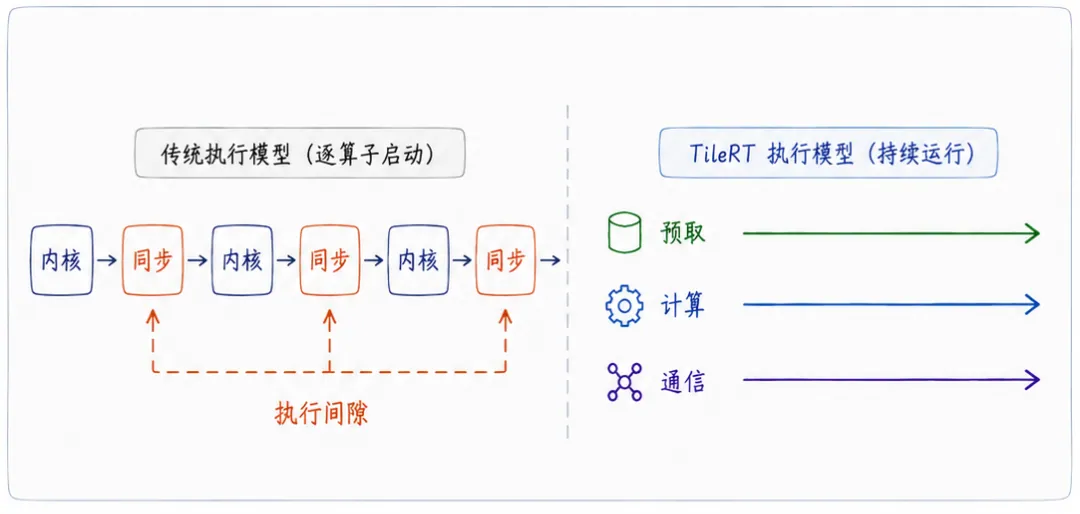
执行缝隙示意:传统执行模型下,执行流被 kernel 启动、同步、访存往返与算子边界反复切碎(图源:TileRT 官方博客)
GPU 硬件侧的另一个深层事实加剧了这个问题:HBM 带宽每代提升 2-3 倍,内存延迟却几乎没有改善。低延迟推理的瓶颈越来越不是「带宽不够」而是「延迟链条上的每一环都慢」。
为什么 CUDA Graphs 救不了这个场景
提到「减少 kernel launch 开销」,很多读者会立刻想到 CUDA Graphs:把一串 kernel launch 与 memcpy 捕获成一个 DAG,之后用一次 cudaGraphLaunch 重放,把成百上千次 launch 压成一次。TileRT 官方与 SemiAnalysis 的评测都专门讨论了它与 CUDA Graphs 的本质区别:
- CUDA Graphs 优化的只是启动方式——DAG 里的 kernel 仍然是彼此独立的 kernel;
- kernel 边界带来的设备侧开销依旧存在(每次边界都有 wave 收敛、依赖等待);
- 片上状态(寄存器、shared memory 里遗留的数据)在每个边界处被清空,无法跨算子延续;
- 图捕获后仍然保持「算子 → 全局内存 → 算子」的数据流。
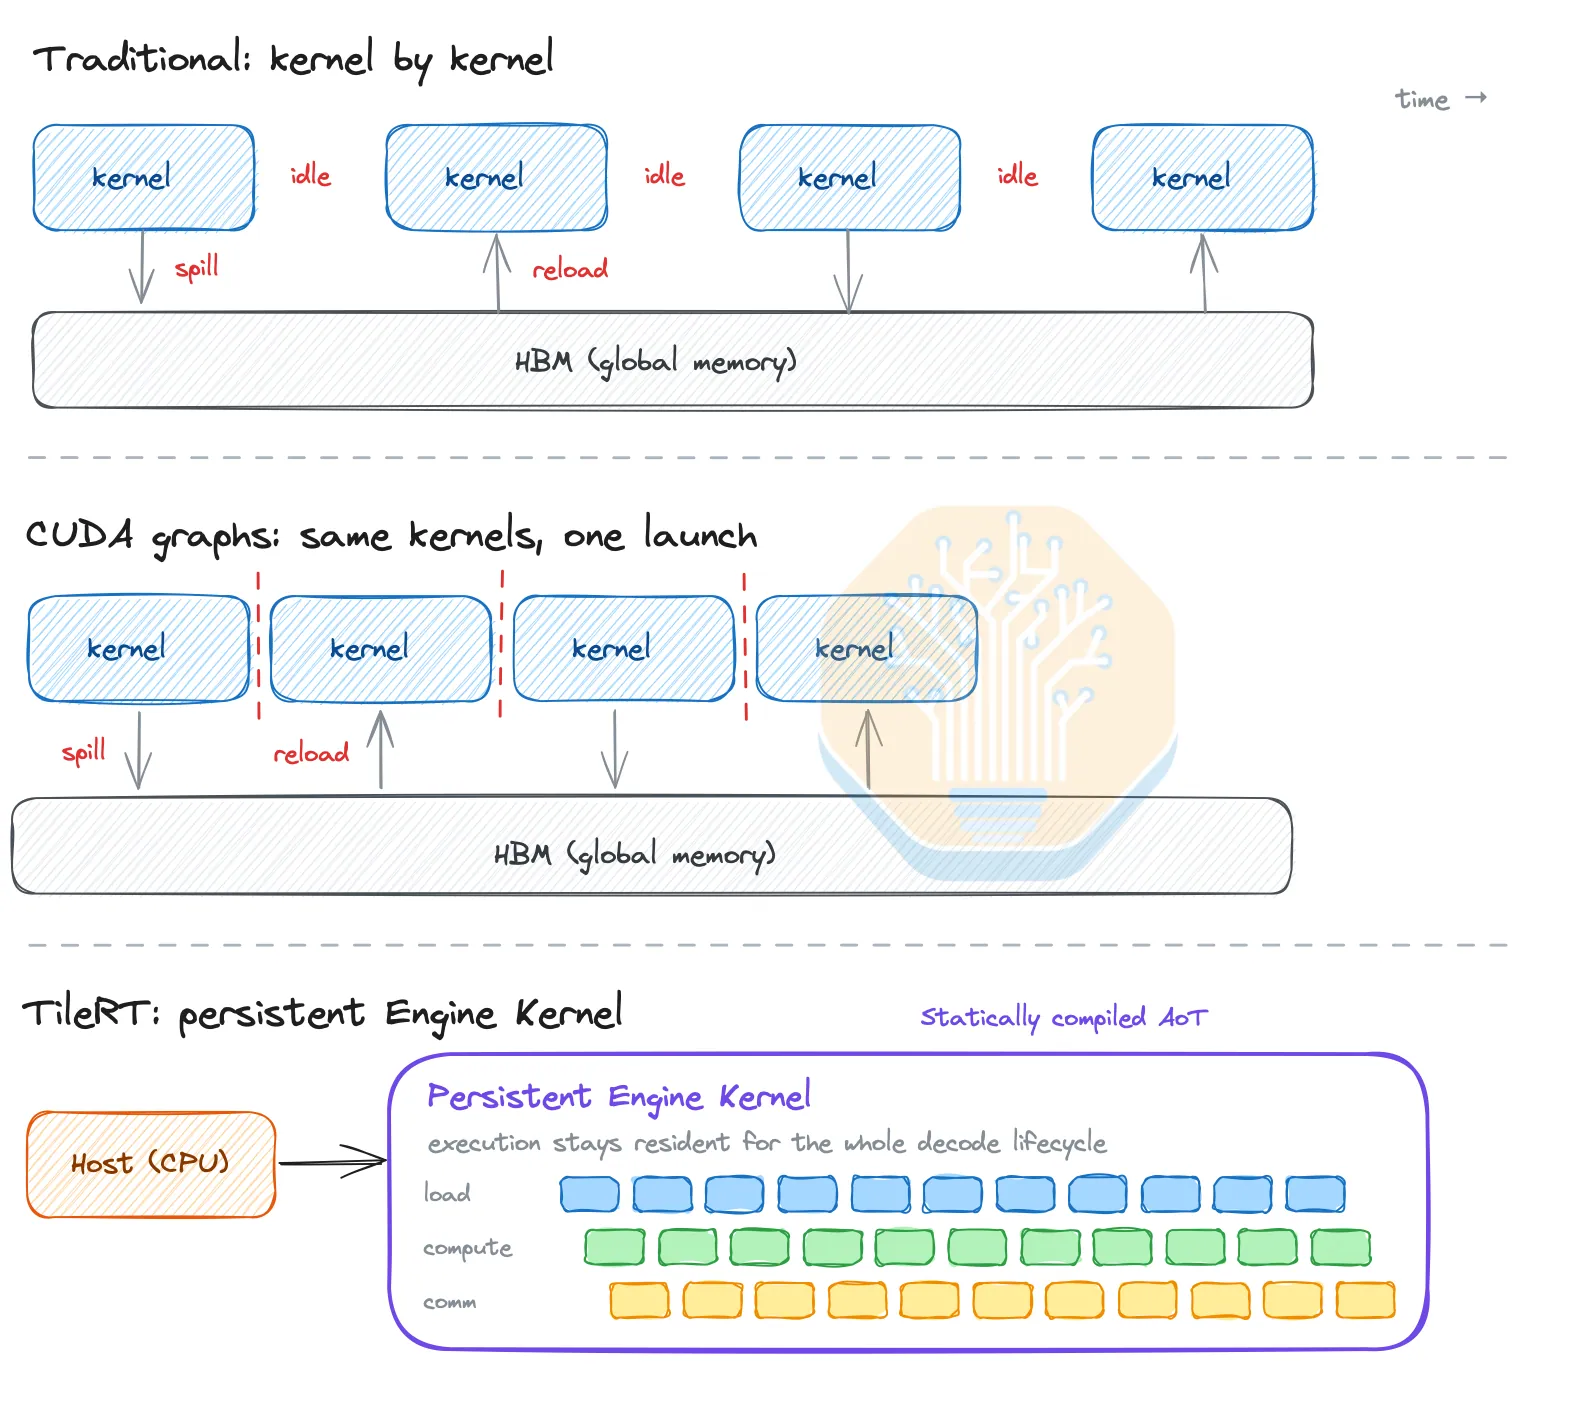
CUDA Graphs 与 TileRT 持久化 Engine Kernel 的对比:前者压缩了 launch 次数但保留 kernel 边界,后者直接取消「kernel 作为执行单元」这一概念(图源:SemiAnalysis / InferenceX)
TileRT 走得更远:它直接取消了「kernel 是执行单元」这一概念,把整个解码计算图变成一个常驻 GPU 的单一执行流水线。
TileRT 是谁:为「响应速度」而生的运行时项目
TileRT(Tile-Based Runtime for Ultra-Low-Latency LLM Inference)由 Tile-AI 社区开发——就是开源 DSL TileLang 背后的同一批人,2025 年 11 月发布首个公开版本。它的目标一句话概括:在不牺牲模型规模与质量的前提下(不做有损量化、不做蒸馏),让几百亿到万亿参数模型的 TPOT 进入毫秒级。与 vLLM/SGLang 这类为高吞吐批处理设计的引擎不同,TileRT 优先优化 batch=1 的单请求响应速度,瞄准的是高频交易、实时交互 AI、实时决策、长时运行 Agent、AI 编程助手这类「单个请求的延迟最重要」的场景。
需要先强调它的定位:TileRT 不是 vLLM 的替代品,官方明确把它设计成 vLLM 体系之外的「速度档位」——高吞吐的 prefill、前缀缓存、调度与 OpenAI 兼容 API 仍由 vLLM 负责,TileRT 只接管对延迟最敏感的解码段(详见后文 PD 分离一节)。项目当前处于 preview 阶段,发布节奏与关键里程碑如下:
| 时间 | 版本 / 事件 | 关键内容 |
|---|---|---|
| 2025-11-20 | v0.1.0-alpha.1 | 首个公开版本,支持 DeepSeek-V3.2-Exp,目标超低延迟推理 |
| 2025-12-23 | v0.1.1 | 端到端 token 生成延迟再降约 35%,相对基线达 3-4 倍加速(8×B200 单机) |
| 2026-01-26 | v0.1.2-alpha.1 | 引入 Multi-Token Prediction(MTP),mtp=3 时合成负载下解码速率最高约 590 tokens/s |
| 2026-02-14 | v0.1.3 | 完整支持 GLM-5,GLM-5-FP8 最高约 500 tokens/s,DeepSeek-V3.2 最高约 600 tokens/s;上线在线 Demo |
| 2026-05-22 | 生产落地 | 智谱 GLM-5.1-highspeed 在 Z.ai 上线,官方文档称输出速度 400 tokens/s,由 TileRT 引擎驱动 |
| 2026-06-01 | v0.1.4 | 两个模型的性能大版本升级(质量不变),引入面向超长上下文的优化 |
| 2026-06-08 | 与小米联合发布 | MiMo-V2.5-Pro-UltraSpeed 在单台 8-GPU 标准节点上把 1T 参数模型推到 1000+ tokens/s |
| 2026-07-14 | v0.1.5 | 引入 PD 分离:vLLM prefill + TileRT decode,OpenAI 兼容端点 |
工程形态上,v0.1.5 的 wheel 是为特定软硬件栈预编译的二进制:硬性要求 8×B200、支持 CUDA 13.2 runtime 的驱动、Linux x86_64、Python 3.12、torch==2.11.0+cu130,官方提供锁好环境的 Docker 镜像。每个受支持模型对应一个独立的后端库(libtilert_dsv32.so、libtilert_glm5.so),运行前用官方权重转换器把 Hugging Face checkpoint 切成 8 份按设备排布的 shard(文件名带 *_dev_{0..7} 后缀)。README 同时说明:底层编译器技术会逐步随 TileLang 与 TileScale 开源——目前开源的是部分模块。
核心思想:把「逐 kernel 启动」换成一条常驻执行流水线
TileRT 的一个核心判断是:当 runtime 的任务编排开始进入延迟关键路径时,继续优化 runtime 已经不够,问题要回到执行模型本身。它的做法在编译期(AOT)完成:
- 在编译期把整个模型的解码计算图静态展开为一个常驻的 Engine Kernel;
- 整个解码生命周期内,host 只 launch 一次,任务执行流持续驻留在 GPU 内部;
- 大量本属于 runtime 的调度决策(算子顺序、依赖关系、资源划分)被前移到编译期确定,运行时只需在设备内部做细粒度推进。
常驻执行带来的第一个直接红利是端到端的连续预取:当某个 tile 正在计算核心(Compute Cores)里执行时,后续数据已经沿着「global memory → shared memory → register」的多级存储层次提前流动起来。传统模型里每一次 kernel 边界都会打断这种预取,而常驻流水线让数据搬运变成一条不间断的传送带。
从更抽象的层面看,这相当于把数据流机(dataflow)加速器(Cerebras、Groq、SambaNova 那类「编译期编排、运行时少调度、中间结果留在片上」的机器)的思想,以软件形式移植到通用 SIMT GPU 上——GPU 依然是动态 warp 调度 + HBM 层次,但 TileRT 用静态展开的持久化 kernel 与手工规划的 warp 分工,让它在执行层面「扮演」一条空间流水线。这也是为什么它能把「几十 TPS 到几百 TPS」的跨越解释为执行模型层面的跃迁,而不是某个 kernel 的局部提速。
Tile 级任务抽象:计算、I/O、通信的统一调度单元
要做到跨算子边界持续重叠,仅靠「一个大 kernel」是不够的——kernel 内部的执行也需要重新组织。TileRT 引入了 tile-level task(tile 级任务)抽象:计算、通信与异步 I/O 被统一拆解为细粒度的 tile 任务,在 GPU 内部持续推进。这里的「tile」不只是更细的矩阵分块,而是一种新的调度单元——矩阵乘法的一个输出分块、一段 KV 的数据搬运、一次跨卡的规约都可以是独立的 tile。
为什么拆到 tile 级有意义?关键在于粒度决定重叠深度:
- 以「整个算子」为调度粒度时,一个 GEMM 内部无法与下一个算子的数据搬运重叠,因为算子边界上要做同步;
- 以「算子内的小块」为粒度时,块与块之间天然互相独立,第一个 tile 算完,其输出就可以开始被消费、被搬运、被通信,流水线在算子内部就开始推进;
- 中间结果不再需要反复写回 global memory,而是在 register、shared memory 与 L2 cache 之间直接向后流动,大幅削减低 batch 下被放大的访存开销。
支撑这套细粒度流水的是 Warp Specialization(线程束专用化):Engine Kernel 内部的不同 warp group 承担不同职责——一部分负责异步数据搬运,一部分负责张量计算,一部分负责通信与归约重叠。传统执行阶段往往以「load → barrier → compute → barrier」的方式串行推进,而在 TileRT 里,数据搬运、张量计算与通信在 tile 粒度上持续重叠,执行节奏从「同步后计算」变成「边算边搬、边算边传」。
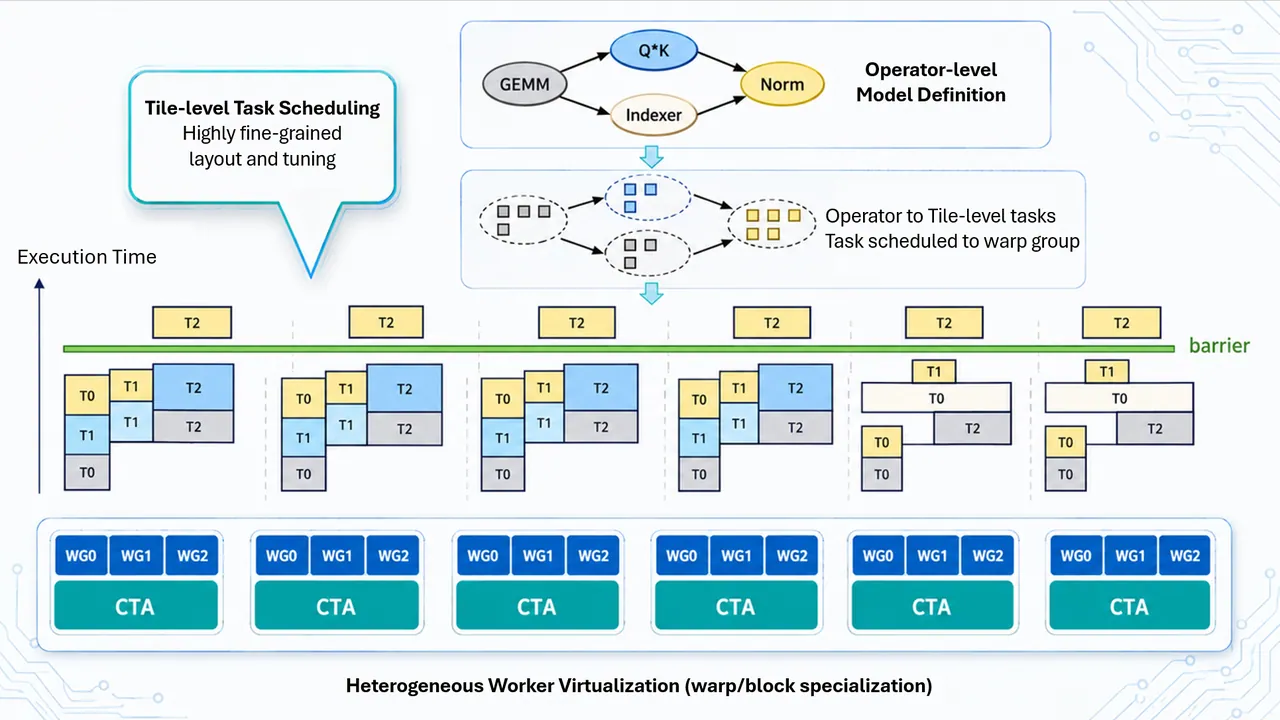
Tile 级任务调度示意:算子被拆解为 tile-level task,调度到 warp group / CTA 上,CTA 通过 warp、block 专用化变成承担不同职责的 heterogeneous worker(图源:TileRT 官方博客)
注意这里的「Warp Specialization」与 FlashAttention-3、DeepGEMM 等单算子 kernel 里的生产者-消费者 warp 分工有本质的尺度差异:后者是在一个算子内部安排几组 warp 分别做 GEMM 与 softmax;TileRT 是把整个模型的成百上千个算子统一压进一条流水线,warp group 的职责划分跨越了传统算子的边界——同一组 warp 可能先为 A 算子的 GEMM 做累加、紧接着为 B 算子的搬运做 DMA。传统 GPU 编程里「一个 CTA 是一块同构 SIMT 计算单元」的假设被打破:每个 CTA 更像一座小型异构工厂,内部有原料搬运工、加工工位和成品输送线。
从单卡到 8 卡:同构张量并行的假设在解码期失效
引擎在单卡内消灭了大量执行缝隙后,扩展到 8×B200 节点时遇到了第二种边界:同构并行假设本身。
绝大多数张量并行(TP)框架默认所有 GPU rank 执行完全相同的逻辑、步调一致地同步推进。这在稠密模型训练时代是自然的选择,但推理把问题带出了这个舒适区:稀疏路由、Top-K 选择、动态索引、长上下文注意力与 MTP 等机制大量进入执行流后,越来越多阶段计算量不大,却高度依赖全局信息(比如注意力索引要看到整条序列的统计才能决定选哪些块)。如果强行让 8 个 rank 都执行同一份逻辑,就必然引入大量重复计算、冗余广播与同步放大——为了一份「只有少数 token 需要」的全局信息,让所有 GPU 都停下来等。
TileRT 团队的关键推演是:既然 warp 可以专用化,GPU 本身为什么不可以?于是他们把专用化从 SM 内部一路外推:
warp specialization → block specialization → GPU specialization不同 GPU 不再被视为完全对称的执行单元,而是根据计算密度、通信成本与数据依赖承担不同角色——Heterogeneous Worker(异构 Worker)本质上就是 Warp Specialization 在更大尺度上的延伸。以 GLM-5.1 的注意力层为例,官方博客披露了真实部署中的拆分方式:GPU 0 作为稀疏索引 Worker,负责 Q/K 索引、稀疏索引打分、Top-K 选择与路由决策这些「依赖全局信息、同步主导」的阶段;GPU 1-7 作为 MLA Worker,执行 RMSNorm、GEMM、Flash Sparse Attention 与 AllReduce 这些「天然适合张量并行、计算密集」的阶段。整个注意力层在 host 侧只对应一次 Engine Kernel launch。
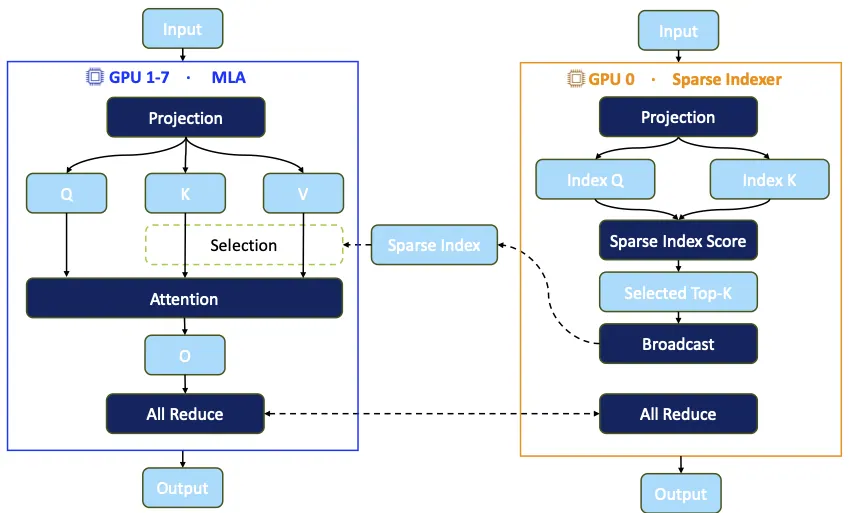
GLM-5.1 中 attention 的异构拆分:GPU 0 专职稀疏索引(Index Q/K、稀疏打分、Top-K、广播),GPU 1-7 执行 MLA 密集计算(Projection、Q/K/V、Selection、Attention、AllReduce)(图源:TileRT 官方博客)
这种拆分的意义不只是「分工」,而是不同阶段获得不同的扩展策略:全局信息主导的阶段集中在一两个 rank 上做,避免全网广播;计算密集的阶段摊到 7 个 rank 上做张量并行。同时,通信不再作为执行流之外的独立阶段存在:广播、归约与同步直接下沉进 tile 级流水线内部,执行模式从「compute → sync → compute」变成持续重叠的「compute ↔ communication ↔ compute」。在超低延迟场景里,通信的尾延迟(tail latency)不再需要整层等待——第一个 tile 的 AllReduce 结果可以在最后一个 tile 还没算完时就喂给下一层。
用 MTP 摊薄顺序解码的深度
顺序自回归是解码延迟的结构性来源:一次前向只出一个 token,而前向又受制于带宽。多 token 预测(MTP)在模型侧提前训练若干「未来 token」预测头,解码时一次前向验证多个候选 token,把顺序步数压缩几倍(MTP 原理与实现已在《MTP 完全拆解》里讲透)。TileRT 从 v0.1.2 起支持 MTP(mtp=3),并在执行层面解决了它带来的新问题——执行流开始变得动态:accept / reject 路径会持续改变流水线的推进方式,draft 与 verify 之间引入新的同步依赖,系统不仅要跑得快,还要在执行路径不断变化时保持流水线不断流。
MTP 的收益可以用一个简单模型刻画:设一次前向(含验证)的步耗时基本不变为 ,平均每次接受 个 token,则有效生成速率近似为:
因验证头与 draft 分支的额外计算而略有上升,所以工程的关键是 的增益与验证成本之间的平衡。TileRT 官方给出的运行统计示例是 Accepted length: mean=2.77, min=1, max=4(mtp=3 时最多接受 4 个:1 个主 token + 3 个草稿);README 基准图注中 GLM-5.1-FP8 在长输入下平均接受长度达 3.2、最好情况下接近 4.0——这意味着同样的带宽条件下,MTP 可以把有效速率再拉高约 3 倍。
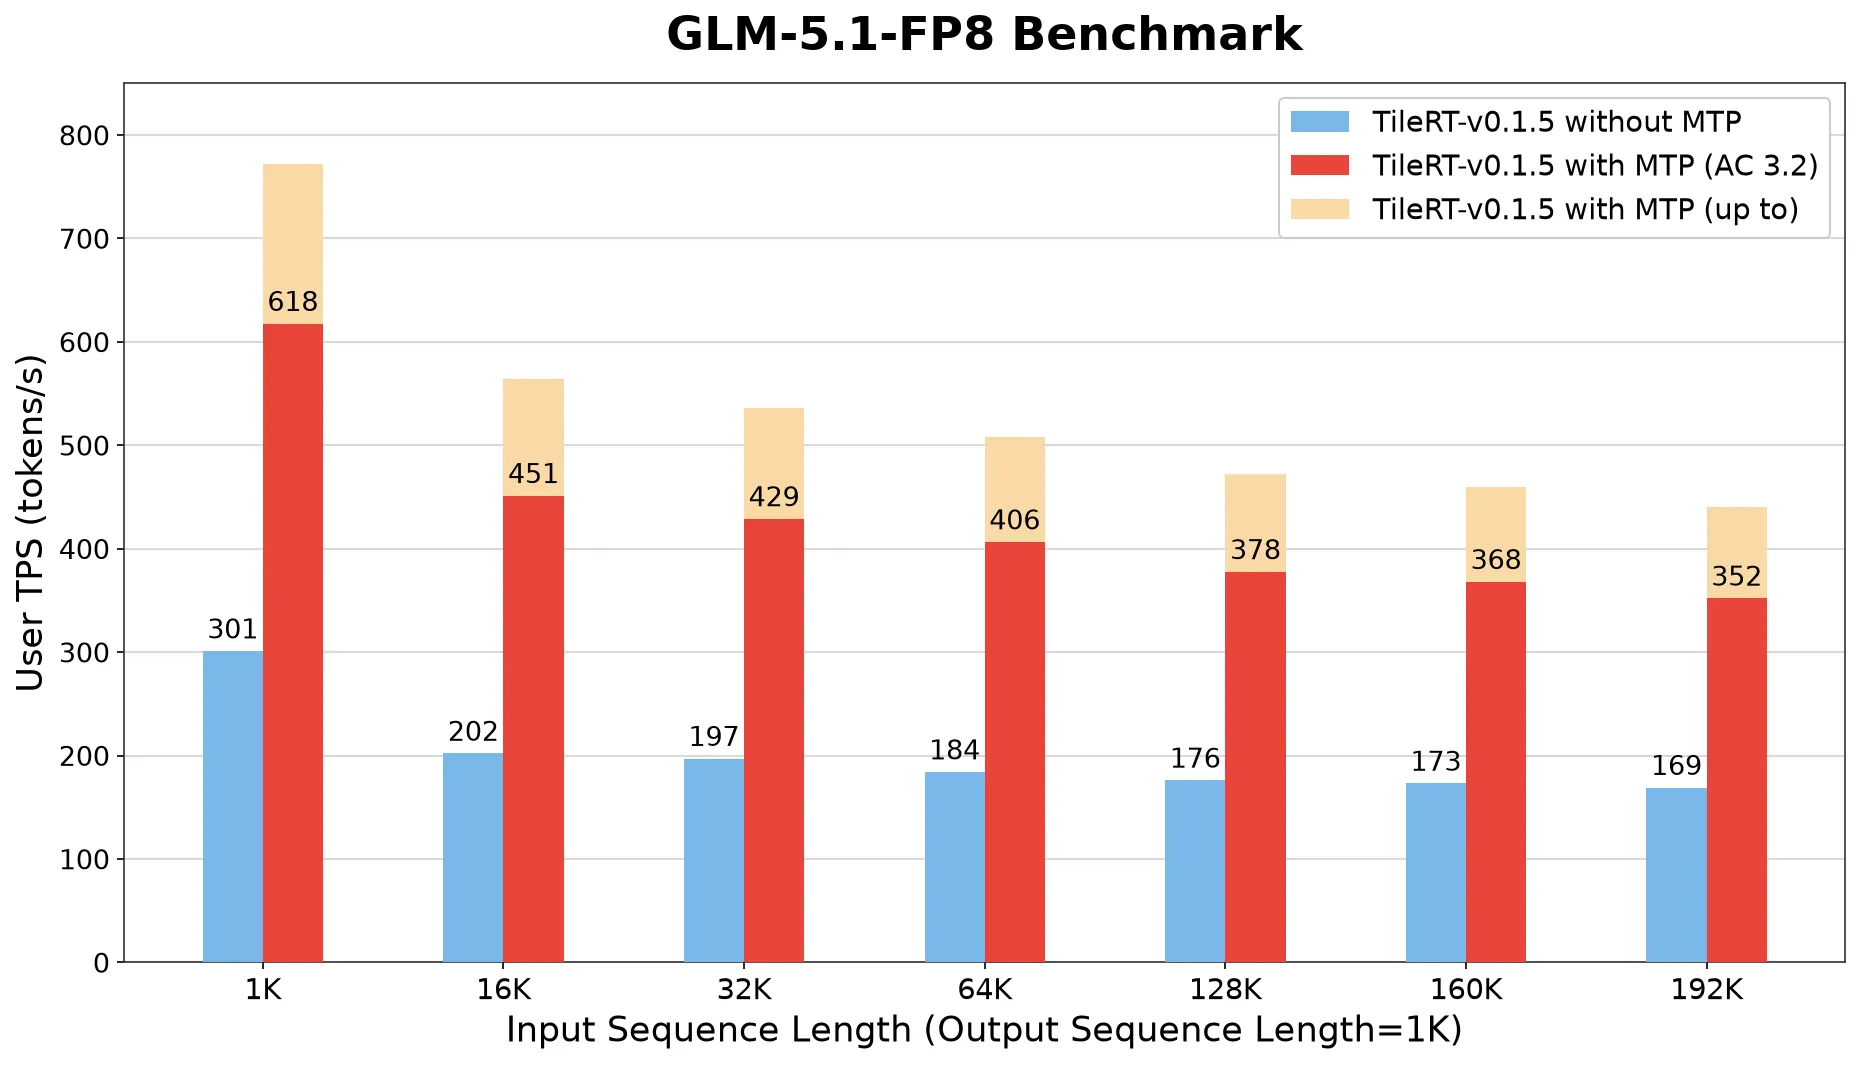
TileRT v0.1.5 官方基准:GLM-5.1-FP8 在 8×B200 上的生成速度,输出 1K、输入 1K-192K;柱状对比不开 MTP、MTP 平均接受长度 3.2 与最好情况接受长度 4.0 三档(图源:TileRT GitHub README)
有意思的是系统视角下的反向观察:在 1000+ tokens/s 的节奏里,MTP 每一层多出来的 LM Head 执行本身就值几十微秒,传统 MTP 架构里每个独立预测头都完整走一遍输出投影,这些「看起来很小」的算子叠加起来足以显著拖慢端到端。这引出了 TileRT 的第二段故事。
两次跃迁:从「执行模型革命」到「模型-系统协同设计」
TileRT 与小米 MiMo 团队把 1T 参数模型推到 1000+ tokens/s 的历程,官方博客总结为两次跃迁,值得分别看:
第一次跃迁:执行模型革命(几十 → 几百 TPS)。 前面几节讲的都是这一跃——用常驻流水线替代逐 kernel 启动,消除算子边界造成的执行缝隙,换来第一个数量级的提升。
第二次跃迁:微秒级瓶颈拆解与硬件-软件协同设计(几百 → 1000+ TPS)。 系统逼近硬件天花板后,瓶颈以全新的方式暴露。在 1000+ TPS 的频率下,单个算子的生命周期被压缩到微秒级,1 微秒的额外开销直接对应端到端几个百分点的抖动。RMSNorm、RoPE、KV Cache 写入、硬件同步、元数据开销这类「FLOP 数可以忽略」的非核心算子,在微秒时钟下反复切碎执行流,聚合成严重的延迟惩罚——在注意力层,最终的限制因素往往不再是注意力 kernel 本身,而是它周围这些碎片化的辅助操作。
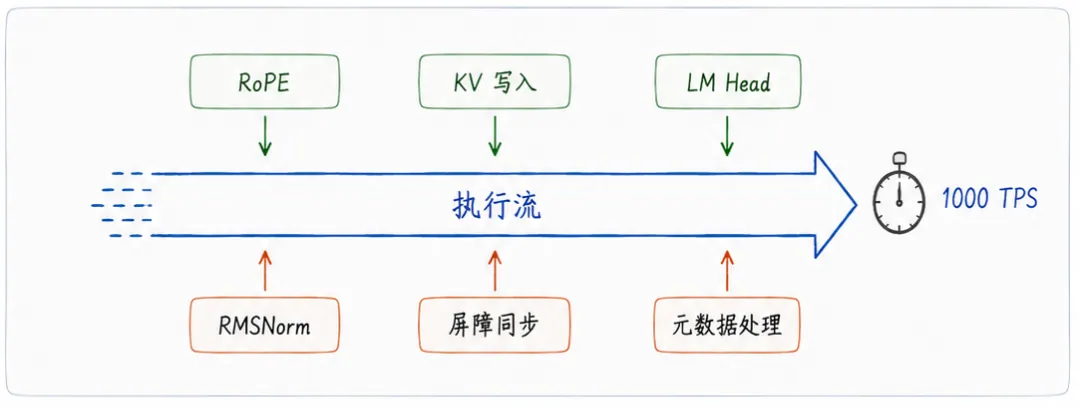
「微秒战争」:当单算子生命周期进入微秒级,RMSNorm、RoPE、KV 写入、同步等低 FLOP 算子的边界碎片化成为主要瓶颈(图源:TileRT 官方博客)
当系统必须以微秒节奏持续运转时,纯 runtime 层面的优化会撞上结构性边界:多级存储层次与模型结构的不匹配、通信拓扑与路由模式(动态稀疏路由)的冲突、KV Cache 增长对数据局部性的破坏——这些问题的共性是它们无法仅靠 runtime 修复,模型结构本身在持续制造执行流碎片。于是双方开始了深度协同设计(官方原文称 hardware-software co-design,实际是 model-system co-design):
- I/O 侧的精度分配:对 100B/1T 参数模型,内存带宽直接决定系统天花板。双方没有全局使用 FP4 或 FP8,而是只对 MoE 专家权重用 FP4、网络其余部分保持 FP8——因为 decode 的访存量几乎全部来自专家权重,把精度红利精准投放在带宽瓶颈上,是基于硬件物理边界算出来的工程权衡(这部分模型由小米开源为 MiMo-V2.5-Pro-FP4-DFlash checkpoint);
- 验证路径的收敛:针对 MTP 每路 LM Head 数十微秒的开销,落地了 DFlash 块扩散解码(本站此前拆解过,论文见小米博客脚注),在维持高接受率的同时收敛 LM Head 侧的计算量;
- 联合调优:滑窗大小、attention sink、接受长度与验证成本等参数由模型侧与系统侧一起平衡到最优工作点。
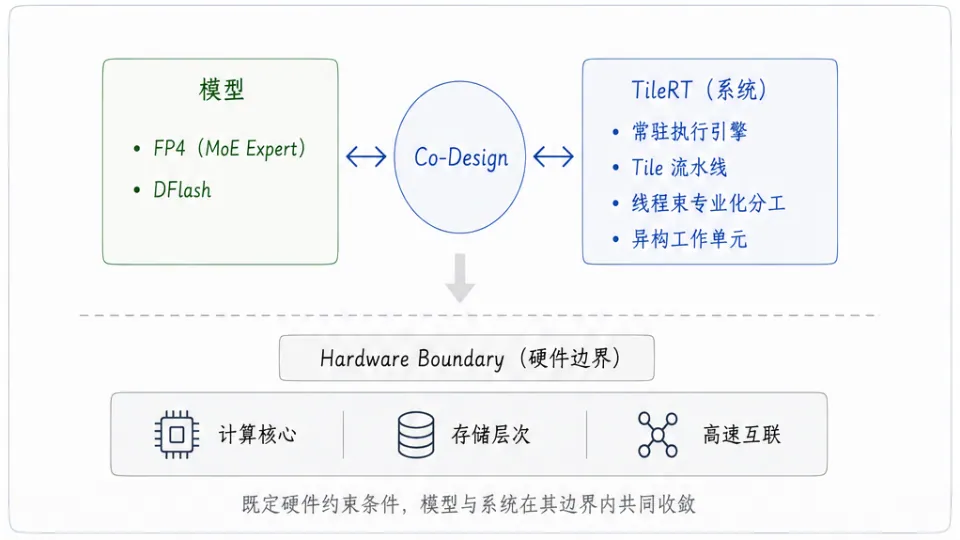
模型 × 系统深度协同:当执行压力逼近物理极限,模型结构(精度、验证头、滑窗)与系统执行流水线必须一起设计(图源:TileRT 官方博客)
结果是 2026-06-08 发布的 MiMo-V2.5-Pro-UltraSpeed:单台 8-GPU 标准节点、1T 参数模型、解码速度突破 1000 tokens/s(小米官方演示图注称最高约 1200 tokens/s)——不依赖任何定制芯片。智谱一侧的 GLM-5.1-highspeed 官方文档则写明,其在推理引擎、调度系统与底层基础设施三个层面做了系统级优化,API 输出速度达 400 tokens/s,率先把旗舰级模型带到生产环境。
生产形态:与 vLLM 组合成异构 PD 分离,而不是取代它
TileRT 的解码虽快,但多数团队早已围绕 vLLM 建好整套服务栈:中央调度、前缀缓存、OpenAI 兼容 API、运维体系。为引入低延迟解码而重写上层服务栈,迁移成本极高。TileRT v0.1.5 因此走了一条「可组合」路线——零修改接入 vLLM 的官方扩展点,构建异构 PD(prefill-decode)分离:
为什么拆开 prefill 与 decode。 两个阶段压的是不同资源:prefill 并行处理长输入,计算密集,追求总吞吐;decode 逐 token 生成、反复访问不断增长的 KV Cache,访存密集,对单步延迟极度敏感。把它们从同一执行窗口里物理拆开,两类负载就不再互相拖累。
零修改的插件机制。 vLLM 自 V1 架构起提供了稳定的扩展点 KVConnectorBase_V1。TileRT 实现了一个 TileRTConnector(扮演 kv_producer 角色),通过标准的 --kv-transfer-config 参数即可在 launch 时动态加载:
{ "kv_connector": "TileRTConnector", "kv_connector_module_path": "tilert.pd_vllm.prefill_connector", "kv_role": "kv_producer", "kv_connector_extra_config": { "tilert_host": "TILERT_DECODE_NODE_IP", "tilert_ctrl_port": 5556, "tilert_model": "glm5", "tilert_max_seq_len": 202752 }}从 vLLM 中央调度器的视角看,这只是一个符合标准生命周期契约的传输插件。另有一个必要的配套设置:decode 侧从第一步起就跑 MTP 投机解码,因此 prefill 侧也必须带上对应的 speculative 配置(num_speculative_tokens: 1)——draft 层的 KV 由 vLLM 在 prefill 时填充,decode 侧的投机从这份状态接着续。
状态传递:异步 RDMA 数据面,前向零阻塞。 prefill 算完后,请求的注意力状态(压缩后的 KV、稀疏注意力的索引缓存、少量元数据)要跨节点搬到 TileRT decode 节点。数据面支持 Mooncake 与 NIXL 两种传输引擎,设计要点有二:
- RDMA 单边写、不碰 host 内存:prefill 侧算完后,状态被直接以 RDMA one-sided WRITE 写进 decode 节点预注册的 GPU 显存——无中间序列化、无 host 中转;握手协议与传输引擎解耦,引擎只负责搬字节;
- 前向窗口零阻塞:在 vLLM 正常的 forward 执行窗口内只做一次快速的状态抽取(在对应 cache block 被回收之前完成),随后立即交给独立的后台异步发送器触发真正的网络传输,forward 本身从不等待网络。因此发往 TileRT 的请求不会拖慢同一 batch 里的其他原生请求。
状态注入活引擎。 状态到达 TileRT 侧后先转换为 TileRT 原生内存布局,再直接注入一个正在运行的引擎实例,注入完成立即开始 decode,MTP 从第一步生效——没有引擎冷启动、没有调度气泡。
路由隔离:多池共存与自适应认领。 生产集群里原生 vLLM decode 池与 TileRT decode 池需要安全共存。实现不碰 vLLM 原生调度器,而是靠一个自适应的认领过滤器:外部路由收到请求后转发给 vLLM 做 prefill,但强制 max_tokens=1(vLLM 只产出第一个 token),并给请求打上透传标记 kv_transfer_params: {"tilert_host": ...};vLLM 内部用官方 MultiConnector 把原生传输插件与 TileRTConnector 并排安装,TileRTConnector 提供静态过滤器 _claim——只认领带 tilert_host 标记的请求,其余请求严格 no-op。两类标记互斥、命名空间不相交,可以在同一 forward batch 里混合运行而不互相干扰。decode 侧,TileRT 池自带门控分发机制做背压,与 vLLM 池的无界队列调度完全隔离,后端积压不会拖累其他流量。
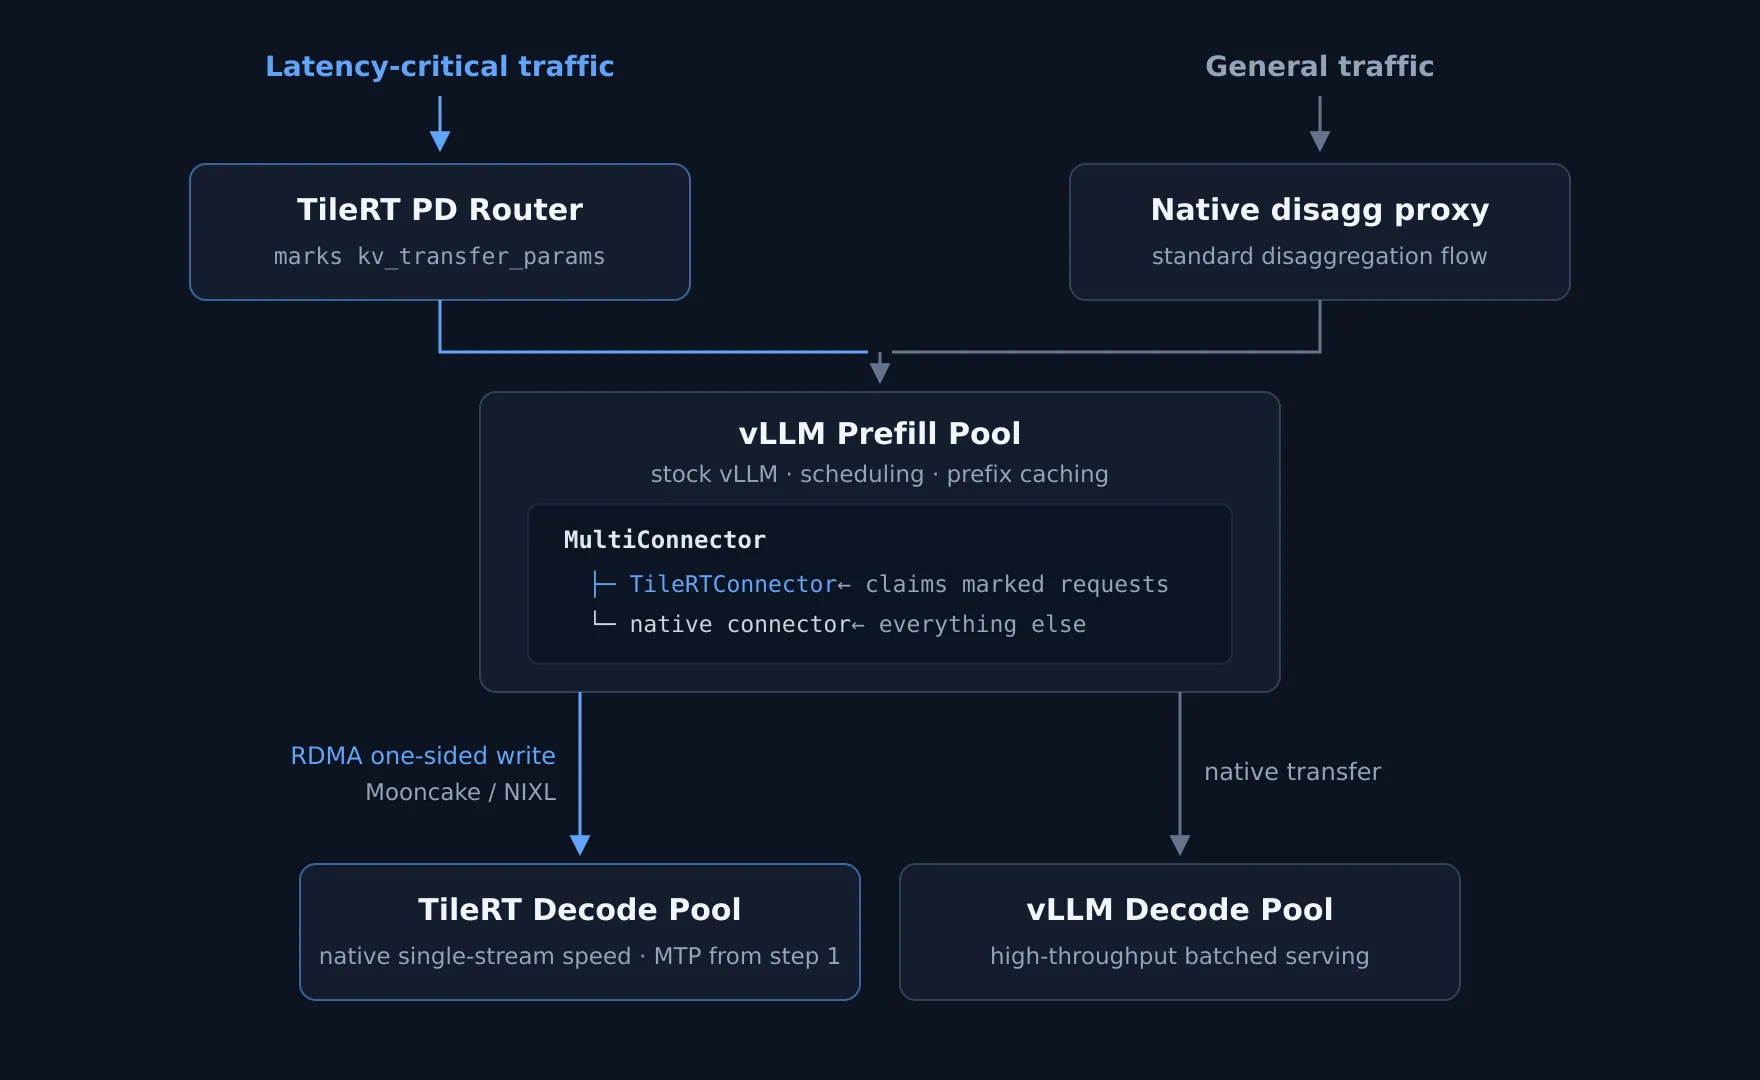
TileRT × vLLM PD 分离整体架构:延迟关键流量与普通流量共享同一个 vLLM prefill 池,由 MultiConnector 按标记分流,decode 分别由 TileRT 池与原生 vLLM 池承担(图源:TileRT 官方博客)
官方博客确认该全链路已在真实模型上验证:状态注入后 decode 侧完整保留 TileRT 原生单流生成速度,MTP 从第一步生效,跨引擎交接无可感知的性能损失。这套方案的意义在于:并发优化、前缀缓存、标准 API 归 vLLM,解码延迟归 TileRT,双方通过开放的接口分工,用户不必在「主流生态」与「极致速度」之间二选一。
独立评测视角:它到底快多少、付出了什么
TileRT 团队的数字由自己发布,难免被质疑口径。SemiAnalysis 的开源评测平台 InferenceX 于 2026-08-10 发布了独立的第三方基准,用统一口径(交互性 = tokens/s/user,即 TPOT 的倒数;吞吐量 = tokens/s/GPU)把 TileRT、传统 GPU 引擎与数据流加速器放在同一张帕累托前沿上比较。先看吞吐与交互性的固有矛盾:在其测量配置中,交互性从约 25 提升到 260 tokens/s/user 时,每 GPU 吞吐从约 5900 掉到 200 tokens/s/GPU——单用户提速约 10 倍的代价是总吞吐下降约 30 倍,批处理与低延迟之间不存在免费午餐。
TileRT 的定位清晰对准高交互性端点。8k/1k(输入 8K、输出 1K)场景:
- TileRT 在 8 卡 B200 节点上达 340 tokens/s/user,此前数据集中最快的 GB300 NVL72(NVFP4 + MTP,Dynamo/TRT-LLM 传统引擎)是 181.4 tokens/s/user——快 1.9 倍;
- 同为 FP8 精度对比更悬殊:B300 + MTP 的 FP8 结果是 113.6 tokens/s/user,TileRT 快约 3.0 倍。TileRT 目前还不支持 FP4,却已胜过对手的 FP4 实现;
- 1k/1k 场景下 TileRT FP8 达 494.2 tokens/s/user,是最佳传统 FP4 结果(256.3)的 1.9 倍、最佳传统 FP8 结果(136.3)的 3.6 倍。
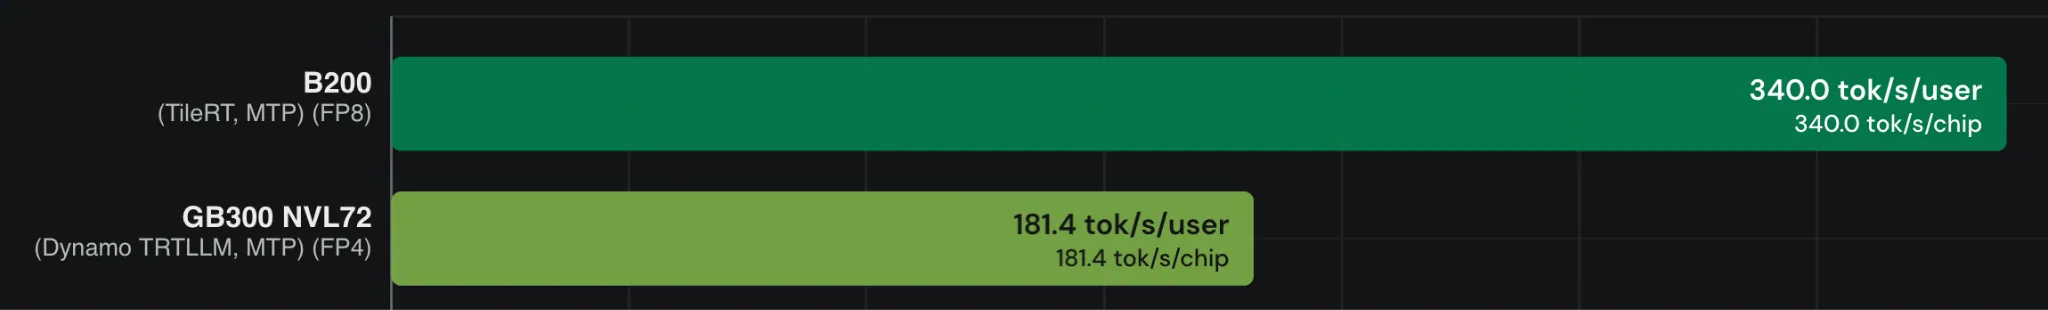
InferenceX 8k/1k 场景对比:B200 上的 TileRT(MTP、FP8)为 340.0 tokens/s/user,GB300 NVL72(Dynamo TRT-LLM、MTP、FP4)为 181.4 tokens/s/user(图源:SemiAnalysis / InferenceX)
值得强调的口径细节:这个对比针对单用户交互性,且 TileRT 来自一个 8 卡 B200 节点,对手是 72 卡 GB200/GB300 NVL72 的 NVLink 纵向扩展域——后者为扩展域付出的工程代价在 batch=1 时对交互性毫无帮助。端到端延迟测量中,TTFT(首 token 时间)TileRT 表现良好但并不突出,决定性优势在解码段:约 3.01 秒,对比此前最佳 NVFP4+MTP 配置的 6.54 秒与 AMD MI355X 的 18.18 秒。
代价同样清晰。TileRT 的交互性优势伴随更低的总吞吐:8k/1k 场景并发 12 时,GB300(FP4+MTP)给出约 240 tokens/s/GPU 的总吞吐并维持 154 tokens/s/user,而 TileRT 是 160.4 tokens/s/GPU、交互性 340 tokens/s/user。截至评测发布时,每个 TileRT decode 节点同一时刻只服务一个在途请求(v0.1.5 状态),路由器负责限流并在节点被占用时施加背压——这是一个刻意专用化的工作点,不是一个通用吞吐配置。SemiAnalysis 的比喻很形象:vLLM 是飞机、汽车、公交与火车,而 TileRT「是一艘只能载一位乘客的私人火箭」;支持更多并发是它明确的下一个目标(对 batch 2/4/8 的帕累托前沿做基准)。
局限与开放性讨论
把 TileRT 放进推理系统的全景里看,它的取舍与争议同样值得展开:
模型目录极窄、扩展代价高。 当前仅支持 GLM-5/5.1 与 DeepSeek-V3.2(v0.1.5 两个独立后端库),MiMo-V2.5-Pro-UltraSpeed 是协同设计合作产物、尚未开源。静态 AOT 编译的持久化 engine kernel 意味着模型被展开为一个常驻程序,必须为每个模型决定 tile 形状、流水线深度、寄存器/共享内存/L2 中的缓冲驻留策略、warp group 在搬运/计算/通信之间的划分、集合通信融合进 tile 流的位点、哪些 GPU 承担专用角色(如 GLM-5.1 的 sparse indexer rank)——换一种注意力机制或路由方案,这套调度的大部分就要重做。这与数据流 ASIC 的弱点同构(好的编译器向来最难造),只是 TileRT 把它带到了通用 GPU 上。
工程约束苛刻。 二进制 wheel 与 CUDA 13.2、Python 3.12、特定 PyTorch ABI 硬绑定;要求整机 8×B200;单体式持久化 kernel 还削弱了传统逐 kernel 剖析手段的效力——性能分析工具按 kernel 粒度给时间线,现在整条解码只有一两个「大块」,自动化反馈闭环变得更难。行业(含 TileRT 生态)正在探索 TileOPs 这类方案:让每个算子用机器可读的 manifest 声明签名、工作负载与 roofline 模型,以硬件上界而非既往实现为基准驱动代码生成与评测。
「软件数据流机」的天花板。 GPU 自带动态 warp 调度器、SIMT 模型与 HBM 层次,TileRT 用巨大的编译器工程量让这套机制「扮演」空间流水线;原生数据流硅片不需要与自己的基底较劲,其 SRAM 屋顶线依然更高——软件可以逼近 HBM 屋顶线,却无法抬高它。SemiAnalysis 因此认为:Cerebras 服务稠密 70B 模型的速度仍是任何 8 卡 GPU 节点调度不出来的。但市场的初步回答是纯粹性可以妥协:小米与智谱都没有采购新芯片,而是从已有集群里划出一个「速度档位」——vLLM 保留 prefill、调度与 API,TileRT 在同一个端点背后接管解码。GPU 池是流动性资源,容量可以按软件调度在角色间逐小时迁移;而专用硅片机队的「速度档位」比例在采购签字那天就被固定了。
学术坐标:常驻 kernel 与 mega-kernel 化的一条推进链
把 TileRT 放进文献坐标里,会发现「消除 kernel 边界」并不是它的独角戏,而是一条分工清晰的推进链,每一环回答的问题不同:ThunderKittens 解决这种 kernel 怎么写,TileLang 解决写出来之后如何编译与跨硬件复用,MPK 尝试把 mega-kernel 化变成编译器的自动行为,Event Tensor 则回答执行流动态变化时 mega-kernel 还怎么成立。先对齐术语:mega-kernel 指把一串彼此同步、中间结果反复往返 HBM 的算子融合成的单个常驻 kernel——TileRT 的 Engine Kernel 正是它的一种极端形态,mega-kernel 化则是把任意张量程序变成这种形态的过程。四篇在正文中此前均未展开,逐一解析如下。
ThunderKittens(ICLR 2025):把「难写」的常驻 kernel 变成「好写」的语言。 论文标题直译即「简单、快速、可爱的 Kernel」,由斯坦福大学 HazyResearch 团队开源,起点是最朴素的抱怨:FlashAttention 这一档的性能人人想要,但「常驻 kernel + warp 专用化 + tile 化编程」这套组合拳向来只有极少数专家打得出来,普通研究员根本写不动。它的做法是把这套打法沉淀成一组极小的语言原语——寄存器驻留的 tile、共享内存与全局内存间的显式搬移、tile 级矩阵乘,以及把持久化 kernel 与 warp 专用化(谁负责搬运、谁负责计算)直接做成语言内置的构造。论文的核心主张是:用远少于手写 CUDA 的代码量,就能写出与专家手工精调相当甚至更快的 kernel,可编程性与性能在「单 kernel」尺度上被同时满足。这对 TileRT 的意义在范式层面:ThunderKittens 证明了「常驻 + 专用化」可以是被封装、被复用的抽象,而不是某个 kernel 的一次性 hack——TileRT 的 tile-level task 与 heterogeneous worker 正是把这套心智模型从单个 kernel 推到整张解码图、再推到跨 GPU 的角色分工(前文「Tile 级任务抽象」一节与 FlashAttention-3 内部生产者-消费者 warp 分工的对比,可以看作这条外推线上的刻度)。区别只在编排者:ThunderKittens 的编排者是写代码的人,TileRT 的编排者是编译器与设备内 runtime。
TileLang(ICLR 2026):TileRT 脚下那层编译器。 TileRT 与 TileLang 的关系前文出现过两次:TileRT 由开源 DSL TileLang 背后的同一批人开发,官方承诺底层编译器技术会随 TileLang 逐步开源。TileLang 论文标题直译为「在现代神经网络 Kernel 中桥接可编程性与性能」,点明了 DSL 的问题域:手写 CUDA 性能最好但几乎不可移植,高层次框架可移植却常常到不了手工性能,语言要在两者之间架桥。它的做法是以 tile 为编程与优化的统一原语——计算、各级存储间的数据移动、流水线阶段都在语言里显式可见——再把分块形状、共享内存预算、warp 分工这类过去靠「手感」确定的参数编码成可搜索的编译决策空间,用自动调优在目标硬件上收敛,使同一份 tile 程序能跨 GPU、跨精度重新编译。它与 TileRT 是上下游关系:Engine Kernel 的静态展开、tile 流水编排与片上驻留策略,本质上是这层编译技术能力的外推;两者问题域的错开也解释了开源边界——TileLang 以算子及小规模融合图内的 tile 优化为中心,而 TileRT 的整图跨算子常驻编排与设备内动态推进远比它复杂,编排层至今未随 DSL 一并开源,或许正是这个落差的体现。
MPK(OSDI 2026):把 mega-kernel 化从手艺变成编译器与运行时。 论文标题直译为「将张量程序 Mega-Kernel 化的编译器与运行时」。它的立论在于:mega-kernel 化不该像 TileRT 那样为每个模型手工雕琢——上一节列过的定制维度(tile 形状、流水线深度、片上驻留策略、集合通信位点)全部要逐模型决定——而应拆成两个可自动化的组件:编译器负责融合规划(哪些算子并入同一个 mega-kernel、跨算子数据放寄存器还是共享内存、常驻线程预算如何在算子间分配),运行时负责设备内推进(任务分发、动态到达的工作、kernel 结束与重配置的时机)。与 TileRT 对照,分野是通用性换极致性:TileRT 把几乎所有调度决策前移到编译期,换来单一模型上的极限速度;MPK 对任意程序自动完成同一件事,代价是编译器不可能在每个层面都先验到极致,一部分同步与兜底检查必须留给运行时。换句话说,MPK 是在为 Engine Kernel 建立「批量生产」的流水线,而 TileRT 目前是「单件定制」的最高水准。这条路线还有一个绕不开的前提:被融合的图在编译期必须确定;一旦执行流出现数据相关的分支,自动 mega-kernel 化就会撞墙——这恰好是下一个工作的起点。
Event Tensor(MLSys 2026):把动态控制流收进统一抽象。 解码是 mega-kernel 真正的试金石:MTP 的 accept/reject 会改变后续执行路径(前文讲过,TileRT 的执行流因此从静态变动态)、稀疏路由的 Top-K 依赖运行期才定型的统计、投机验证的下一步取决于上一步的结果。对自动 mega-kernel 化,这是结构性困难:编译期无法把动态分支展开成静态图,穷举所有路径又会组合爆炸。TileRT 的解法是在引擎运行时里为这些动态路径逐一做专门处理;Event Tensor 论文(标题直译「编译动态 Megakernel 的统一抽象」)则想给出更一般的答案:把 kernel 内部任务间的依赖,从「编译期排定的静态次序」换成显式的事件——某块数据就绪、某个 tile 完成,由产生方在设备内发出事件,消费方等到事件触发才启动;依赖图因此可以在运行期随控制流生长,条件分支在设备内直接决议,不必切回 host 重新 launch。可以把它理解为「CUDA Graphs 的事件语义从 kernel 边界下沉到 tile 粒度」:Graphs 里事件表达的是 kernel 间的依赖,DAG 本身仍是静态的;Event Tensor 里事件成为 kernel 内部动态产生、动态消费的调度令牌。它与 TileRT 的差异依旧是自动化程度——TileRT 靠为特定模型手写的引擎逻辑消化动态性,Event Tensor 想做的是让编译器面对任意动态 megakernel 时,都有一套可推导、可验证的编译路径。
从 Talk 材料里的工程细节看,这条链条还可以再具体一点。ThunderKittens 把 Hopper/Ampere 上的 cp.async、ldmatrix、mma.sync、WGMMA、TMA 与 producer-consumer pipeline 包成 tile 原语,目标是让研究员不用手写所有寄存器排列和 shared memory bank conflict 细节;TileLang 进一步把这些选择变成编译器问题,用 tile shape、memory placement、pipeline stages、warp partitioning 和 register layout 构成候选空间,再用近似 roofline 的静态成本模型选择配置,论文报告在 H100 上相对 Triton 平均约 3 倍加速,FlashAttention 实现从 185 行压到 66 行仍能保持甚至略超性能。MPK 则把图级执行拆成 tGraph:编译器把每个算子的输出区间分成 block-level tile task,分析 producer-consumer 依赖,并用 successor/predecessor set fusion 减少事件数量;运行时把少数 SM 留作 scheduler,其余 SM 作为 worker,由事件驱动任务执行,H100/B200 上对 vLLM、SGLang 的低 batch 负载可拿到约 1.7×/1.5× 加速。Event Tensor 接着补上 MPK 的静态图短板:用符号维度表达 shape dynamism,用运行时事件更新和事件触发表达 data-dependent dynamism,让 MoE routing、变长序列、稀疏选择这类运行期才知道的依赖继续留在 megakernel 内部解决。
把四个工作连起来,TileRT 的另一面会更清楚:上一节批评的「静态 AOT、目录窄、扩展贵」与其说是它的个性缺陷,不如说点中了这条路线在 2026 年的共同水位——单 kernel 尺度的可编程性已被 ThunderKittens 与 TileLang 解决,图级自动 mega-kernel 化由 MPK 起步,动态执行刚被 Event Tensor 提上抽象日程;TileRT 以「单件定制」的姿态跑在整条曲线的最前面,而它身后的自动化工具链每补上一环,常驻 kernel 路线的适用面就再宽一圈。
Talk 中这几项相关工作已经单独整理成补篇:TileRT 技术谱系:ThunderKittens、TileLang、MPK 与 Event Tensor。如果只关心 TileRT 本体,读到这里已经够;如果想理解它背后的常驻 kernel/megakernel 工具链,那篇会逐项展开。
小结
TileRT 的价值不在于又一个更快的 kernel,而在于它对执行模型本身的重新提问:当单请求延迟成为首要指标,逐 kernel 启动的执行模型里那些被大计算掩盖的固定开销(launch、同步、访存往返、runtime 编排)就重新站到了关键路径上。它的回答是一套组合拳——编译期把整张解码图静态展开为常驻 Engine Kernel、以 tile 为粒度把计算/搬运/通信压成持续重叠的流水线、把 warp 专用化一路外推到 GPU 级异构 Worker、用 MTP 摊薄顺序步数,最后在系统与模型之间做深度协同设计(FP4 专家、DFlash 验证路径)。这套「软件数据流机」路线在 8×B200 上拿到了 1k/1k 场景 494 tokens/s/user、1T 模型 1000+ tokens/s 的结果,也以 vLLM 插件的形式进入了生产生态——它未必是通用推理的终局(模型目录、batch=1 工作点与静态编译的扩展成本都是实打实的约束),但「从自己已有的机队里划出一个速度档位」这个思路,正在重新定义低延迟推理的供给方式。
参考资料
- TileRT GitHub 仓库(README、发布说明与基准图)
- TileRT 官方博客:速度:大模型推理的下一个 Scaling Law(2026-05-21)
- TileRT 官方博客:1T 模型通往 1000 Tokens/s 的两次跃迁(2026-06-08)
- TileRT 官方博客:从极致速度到可组合性——TileRT × vLLM 异构 PD 分离(2026-07-13)
- SemiAnalysis / InferenceX:在 NVIDIA GPU 上实现超高交互性?TileRT 登陆 InferenceX(2026-08-10)
- 智谱官方文档:GLM-5.1-HighSpeed 模型介绍
- 小米 MiMo 官方博客:MiMo-V2.5-Pro-UltraSpeed——把 1T 参数模型的生成速度推到 1000 TPS(2026-06-08)
- PyPI:tilert 包页面(各版本发布时间线)
- Hugging Face:Tile-AI/DeepSeek-V3.2-Exp-TileRT 权重
- 知乎专栏:TileRT 的优化技术概览
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


