


HySparse 混合稀疏注意力(二):HySparse2 如何用两级 KV 共享跳过半个 Prefill
从“少读 KV”走到“少跑半个模型”
上一篇拆解了 HySparse 的第一层共享:一个全注意力层既产生精确的块级选择信号,也把自己的全局 KV Cache 交给后续多个稀疏层复用。这个设计同时减少注意力配对和逐层缓存,却留下了一个容易被容量收益遮住的问题:Prefill 仍要让提示词通过全部 Transformer 层。
这不是小开销。设提示长度为 、模型深度为 ,即使大多数层的注意力已经从 降为 ,每层的投影、归一化、残差以及 FFN 或 MoE 仍要处理全部 个 token。长程智能体的工具返回往往远长于模型生成的动作,服务成本于是越来越由输入侧支配。只压缩注意力矩阵,不能消掉“让整段输入穿过后半个模型”的代价。
小米 LLM-Core 团队于 2026 年 9 月发布 HySparse2,把共享范围从一个混合注意力块扩展到两个解码器之间。它保留 HySparse 的块内 KV Reuse,又新增外层 KV Bridging:前半段 self-decoder 产生的隐藏状态,经后半段各全注意力层自己的 K/V 投影,直接构造 cross-decoder 所需缓存。处理历史提示时,运行到 self-decoder 末端便可退出;生成新 token 时,cross-decoder 仍完整执行,用自己的当前 Query 查询这些预先桥接的 KV。
这项变化同时牵动三处设计:
- 块级 TopK 改成 token 级 TopK,把固定预算更精确地花在远程证据上;
- 稀疏层不再维护独立滑窗分支,而是强制把最近 128 个 token 塞进同一次稀疏选择;
- 全局共享形成两级结构:解码器之间共享隐藏状态来源,混合块内部共享已经投影好的 KV 与选择索引。
三个改动并非互不相关。独立滑窗分支一旦存在,cross-decoder 的局部 KV 就依赖它自己逐层产生的隐藏状态,Prefill 便无法真正跳过后半段;删掉这条依赖后,外层桥接才闭合。token 级选择则补偿了失去独立局部分支、并把稀疏预算用在更分散证据上的精度压力。
| 设计维度 | HySparse | HySparse2 | 推理侧影响 |
|---|---|---|---|
| 模型分段 | 单一 decoder 内交替 Full/SA | self-decoder + cross-decoder | 历史 Prefill 可在中间边界退出 |
| 稀疏粒度 | 64-token 块 | 单 token | 检索更精细,访存更离散 |
| 局部路径 | 独立 SWA 分支与局部 KV | 最近 128 token 强制入选 | 删除 cross-decoder 局部缓存依赖 |
| 块内共享 | 索引与全局 KV Reuse | 保留 KV Reuse | 5 个 SA 层复用一个 FA 层 |
| 块外共享 | 无 | Full-only KV Bridging | self 隐藏状态生成 cross KV |
| 论文配置的 KV heads | GQA,4 个 | MQA,1 个 | 降低容量并提高多 Query 复用 |
两级 KV 共享:先看完整数据流
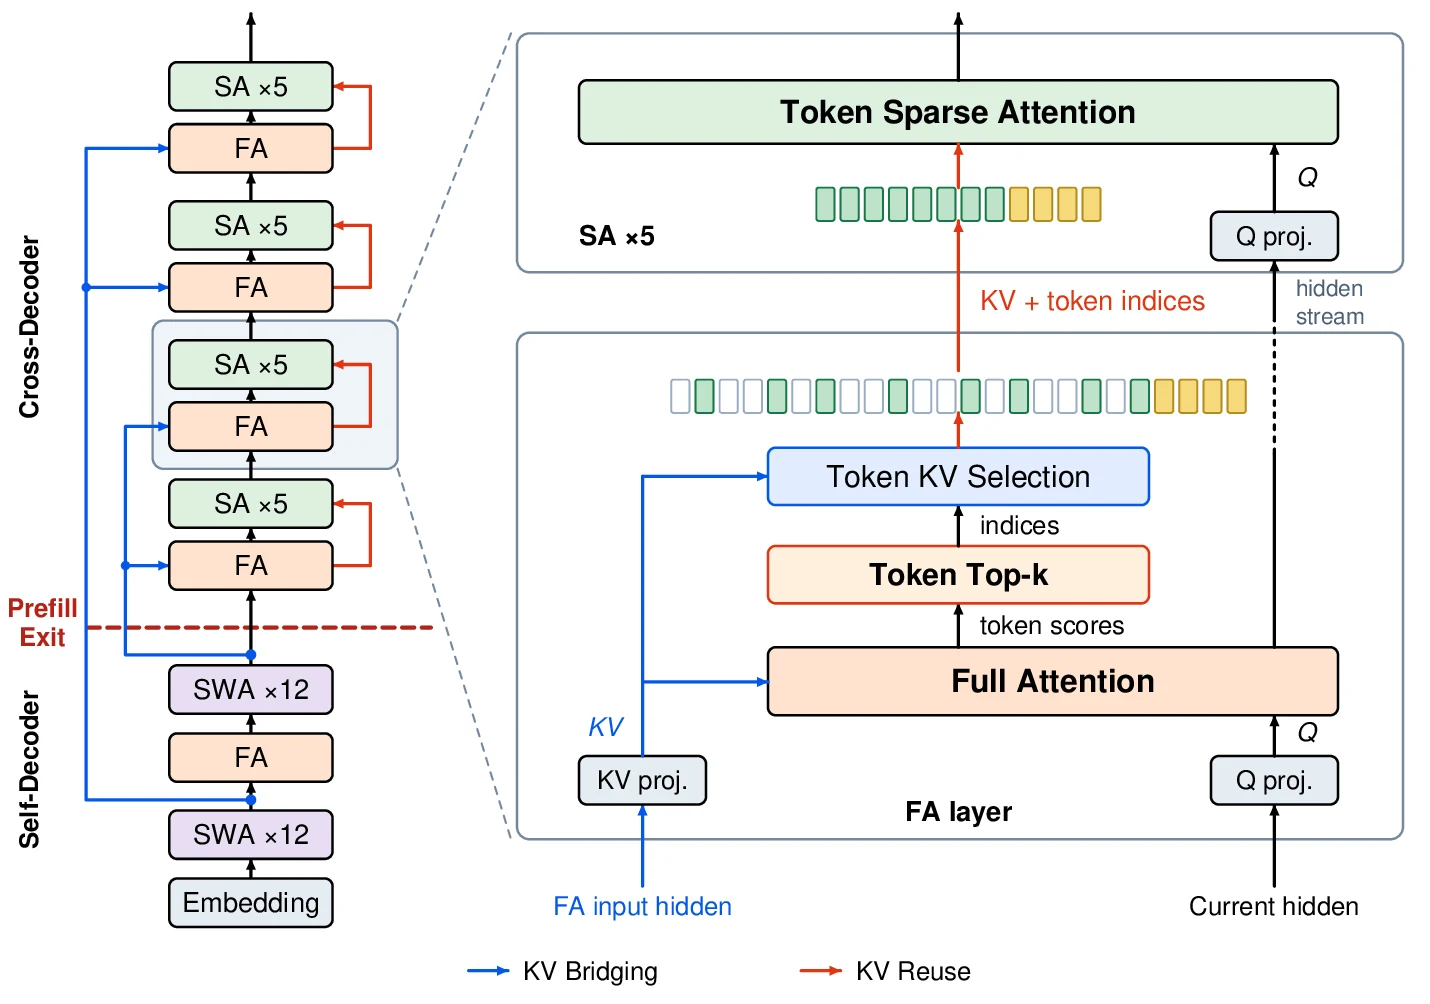
图片来源:HySparse2 论文 Figure 1。蓝线是跨解码器的 KV Bridging,红线是混合块内部的 KV Reuse;虚线 Prefill Exit 表示历史输入不必经过 cross-decoder。
论文的 80B-A3B 配置共有 49 个 Transformer 层。图左侧的 self-decoder 有 25 层:12 个 SWA 层、1 个全注意力层、再接 12 个 SWA 层。cross-decoder 有 24 层,由 4 个“1 个全注意力层 + 5 个稀疏层”混合块组成。全模型仍只有 5 个全注意力层,但 Prefill 构建缓存时真正执行完整全注意力的只有 self-decoder 中那 1 层。
这张图要沿两种时间尺度阅读。
第一种是提示词的 Prefill。整段历史输入依次通过 self-decoder;当运行到承担桥接源的全注意力层时,其输入隐藏状态不仅供本层使用,还送入 cross-decoder 中各目标全注意力层专属的 K/V 投影。于是,后半段每个混合块所需的全长 KV 都能在前半段生成。稀疏层本来就复用这些全注意力 KV,不需要自己的全长缓存;强制局部窗口也从同一缓存取数,不再需要独立局部 KV。至此,cross-decoder 没有任何必须由历史 token 逐层计算才能生成的缓存,Prefill 可以在第 25 层后结束。
第二种是逐 token Decode。新 token 仍从 embedding 开始穿过 49 层。在 cross-decoder 的第 个全注意力层,Query 来自该 token 走到当前深度的隐藏状态;Key 和 Value 则由与之配对的 self-decoder 隐藏状态投影得到,并追加到已有缓存。全注意力产生的精确 token 分数选出全局 TopK,后面 5 个稀疏层复用索引和 KV。因而“Prefill 提前退出”不等于永久删除后半段网络,它只利用 KV Cache 的语义:历史 token 在 Decode 中只需贡献 K/V,不必再次产生最终输出。
可以把两级共享写成两条数据依赖。
外层 KV Bridging 对 self-decoder 第 层与 cross-decoder 第 个全注意力层建立映射:
是桥接源隐藏状态, 是当前 token 在目标层的隐藏状态。最关键的非对称性是:K/V 来自前半段,Q 仍来自后半段。目标层保留自己的 与 ,所以多个目标层即使读取同一份源隐藏状态,也会生成不同的 KV 表示;“共享来源”并不等于“所有全注意力层共用同一份数值缓存”。
内层 KV Reuse 则发生在 cross-decoder 的一个混合块内。若全注意力层产生缓存 与索引集合 ,其后第 个稀疏层只重新生成 Query:
不同稀疏层的 Query 仍随深度变化,因此它们对同一批 KV 会形成不同的注意力权重。外层桥接消掉“历史 token 必须穿过 cross-decoder 才能形成 K/V”的依赖,内层复用消掉“每个稀疏层都要保存自己的全长 K/V”的依赖;两级结构缺一层都无法得到完整的 Prefill 早退。
一条请求怎样穿过这套结构
以长度为 的提示为例,可以把第一次输出前后的状态变化拆成五步。
第一步,Prefill 节点把 批量送入 self-decoder。24 个 SWA 层只在各自窗口内计算,位于中间的全注意力层扫描完整可见前缀。此时得到 self-decoder 自身需要的 KV,以及桥接所需的源隐藏状态。
第二步,同一份源隐藏状态分别经过 4 组目标层专属 K/V 投影,形成 cross-decoder 四个混合块的全长缓存。这个过程按 token 独立做线性投影,不需要先求出 cross-decoder 的历史 Query,也不需要执行后半段 MoE。
第三步,Prefill 节点把 self-decoder 缓存与 4 组桥接缓存传给 Decode 节点。缓存已经是目标层最终要读的形状,Decode 节点不必保留全部提示隐藏状态再做二次投影。
第四步,为得到提示后的第一个 logits,最后一个提示位置的 self-decoder 输出作为当前状态穿过 cross-decoder。每个全注意力层用当前深度的 Q 查询已经构造好的整段 K/V,并产生 token TopK;其后 5 个稀疏层复用该集合。这里只有一个当前 Query 沿后半段前进,不是让 个历史位置重新跑 24 层。
第五步,每生成一个新 token,它照常通过 self-decoder;到达桥接源后,4 组目标 K/V 投影为该 token 生成新缓存项。随后 token 继续经过完整 cross-decoder,并在每个混合块重复“全注意力选索引、5 层稀疏读取”的过程。由此可见,提前退出主要削减长提示的批量 Prefill,不会把逐 token Decode 截成半个模型。
为什么 HySparse2 从块级选择退回 token 级选择
同样读 1024 个 token,信息预算并不相同
HySparse 以 64-token 块为最小选择单元,1024 个全局 token 预算等价于 16 个块。若一个远程工具返回中只有函数名、错误码或某个边界标记真正关键,选中它所在的块便会顺带读取 63 个邻居。连续文本中,这种空间局部性常常有益;多轮智能体轨迹却把系统消息、推理、工具调用和返回结果交错在一起,相关证据可能分散在许多相距很远的位置。块选择的内部浪费会迅速耗尽 16 个槽位。
设完整历史有 个位置,当前全注意力层对位置 的某个 Query head 产生精确概率:
是历史位置, 是头维。HySparse 先把一块内的分数聚合,再选 个块;HySparse2 直接在 token 维上选 个全局位置。对固定注意力预算,块级选择的有效证据数下界可能接近块数 16,而 token 级选择最多可以覆盖 1024 个彼此分散的位置。真实差距由注意力分布的局部聚簇程度决定,不是固定的 64 倍。
论文没有公开多 Query head 归并成共享 token 索引的全部 kernel 细节。因此,不能凭架构图断言它一定采用跨 head 最大值、求和或先分头 TopK 再合并。能够确认的是:分数来自保留的全注意力层的精确注意力,TopK 在 token 粒度上工作,选出的索引与该层 KV 被后续稀疏层共同消费。head 间聚合规则、TopK 是否完全融合以及索引排序方式,仍属于未披露实现边界。
强制局部窗口不是“再加 128 个 token”那么简单
HySparse2 的最终集合由两部分组成。记最近窗口为:
先把 无条件纳入,再从窗口外位置选出分数最高的 个全局 token:
这样一次稀疏注意力实际最多读取 个位置。局部 token 不与远程 token 争抢名额,避免高频近邻把全局预算全部挤掉;同时二者使用同一份全注意力 KV,只需一次 Query 投影、一次 softmax 和一个输出。相比 HySparse 的“全局稀疏输出 + 独立 SWA 输出 + 两个门控”,HySparse2 不再保存每个稀疏层的局部 K/V,也不再维护第二套 K/V 投影。
稀疏层输出可以概括为:
是第 个稀疏层自己的 Query, 来自块首全注意力层, 可包含论文配置中的可学习 attention-sink bias。公式只表达选择后的注意力主体;论文还对稀疏与 SWA 层使用 sigmoid 输出门。与 HySparse 的双分支门控不同,这里只有一个合并后的稀疏输出需要调幅。
从 FlashAttention 统计到 token TopK
上一篇已经说明,HySparse 在 FlashAttention 的 tile 循环中复用行最大值,几乎不额外计算 就能得到块级候选分数。token 级选择更精细,却不能只保存每个 64-token tile 的一个最大值。全注意力 kernel 必须让每个候选 token 的可比较分数进入 TopK 路径,或者在扫描 tile 时维护逐行的局部候选集合,再合并成全局 TopK。
一种不物化完整 概率矩阵的实现思路是分层筛选:每个 KV tile 先在寄存器或共享内存中保留行内前 个 token,完成在线 softmax 扫描后,再把所有 tile 的局部候选归并成最终 个位置。排序只依赖同一 Query 行内的大小关系时,softmax 的单调性允许直接比较 logits;若索引要跨多个 Query heads 共享,则必须处理不同 head 的尺度,不能把未经归一化的 logits 草率混在一起。
for each query tile Qi: initialize online-softmax state (m, l, O) initialize local top-k candidate buffer C for each causal KV tile (Kj, Vj): Aij = Qi @ Kj^T / sqrt(d) update (m, l, O) with Aij and Vj keep promising token positions from Aij in C merge candidates in C force recent-window indices into the final set emit attention output O and token indices I这段伪代码描述的是与论文数据流相容的 kernel 组织,不是作者公开的逐行实现。HySparse2 论文只明确指出 token 级稀疏 kernel 已因 TileLang 等工作而变得可行,没有发布端到端 kernel 延迟、TopK 微基准或源码。因此文章后面的性能分析会把论文给出的 FLOPs 与缓存容量,和实际 tokens/s 严格分开。
Prefill Kernel:把稀疏模式变成规则 Tile
为什么独立 SWA 会破坏提前退出
先看 HySparse 的 cross-decoder 为什么不能直接跳过。假设一个稀疏层有自己的长度 的 SWA 分支。为了给未来 Decode 准备这一层的局部 KV,至少要计算提示词最后 个位置在该层输入处的隐藏状态。可这些状态来自上一层;上一层若也有长度 的局部依赖,要正确生成最后 个输出,就需要再向前扩一段输入。连续经过 个局部层后,严格依赖范围近似扩展为:
是为了精确得到末端一个状态所需回放的后缀长度。若目标不是一个状态,而是为下一层准备完整 项缓存,范围还会继续向前扩。所谓“只回放最后 128 个 token”并不能精确重建深层 SWA 缓存;要么运行越来越长的后缀,要么接受 bounded replay 一类近似。层数多时,这条级联依赖会吞掉 Prefill 早退的意义。
HySparse2 的 forced window 从全注意力层共享缓存中读取,切断了这条递归:
局部与全局只是在索引集合上不同,数据来源完全相同。cross-decoder 的稀疏层不再有任何属于自己的 K/V 状态,提示历史也就不必经过它们。
Prefill 实际还要做哪些工作
“第 25 层退出”不代表后 24 层相关计算全部为零。Prefill 节点仍需完成四类操作:
- 执行 self-decoder 的 25 层,包括 24 个 SWA 层与 1 个全注意力层;
- 保存 self-decoder 自身 Decode 所需的全长与局部 KV;
- 对桥接源隐藏状态执行 cross-decoder 各目标全注意力层专属的 K/V 投影;
- 把得到的 cross-decoder KV 组织成 Decode 节点可直接消费的缓存布局。
它跳过的是 cross-decoder 的 Query 投影、24 层注意力输出、残差路径以及 24 层 FFN/MoE,而不是跳过目标 K/V 投影。设 self-decoder 深度为 ,cross-decoder 深度为 ,桥接目标全注意力层数为 。把单层非注意力主体的每 token 成本记作 ,桥接投影成本记作 ,则两种路径的结构差异可粗略写成:
这里 包括各层注意力, 只包括 self-decoder 中真正执行的注意力。公式故意没有把“省一半层”直接等同于“FLOPs 减半”:MoE 激活专家、投影形状、SWA、全注意力以及桥接投影的成本不同。论文给出的 1M-token 分析中,HySparse2 的 Prefill FLOPs 分别比 HySparse 和 Hybrid SWA 少 与 ,这才是该配置下可引用的量化结果。
若只看注意力配对数量,49 层配置的差异更直观。记 self-decoder 中全注意力层数为 、SWA 层数为 ,cross-decoder 有 个全注意力层和 个稀疏层。HySparse2 的历史缓存构建近似只需:
桥接 K/V 投影是 ,另行计入。若仍让提示穿过 cross-decoder,则还会多出 。HySparse 原版的 49 层配置含 5 个全注意力层和 44 个稀疏层,其注意力主体近似为:
所以 HySparse2 不只是把稀疏层常数变小,而是把 Prefill 路径上的全注意力二次项从 5 份降到 1 份,并移除 24 层 cross-decoder 主体。二次项仍未消失:当 达到百万级时,那一个 self-decoder 全注意力层仍是需要专门并行和分块的重负载。
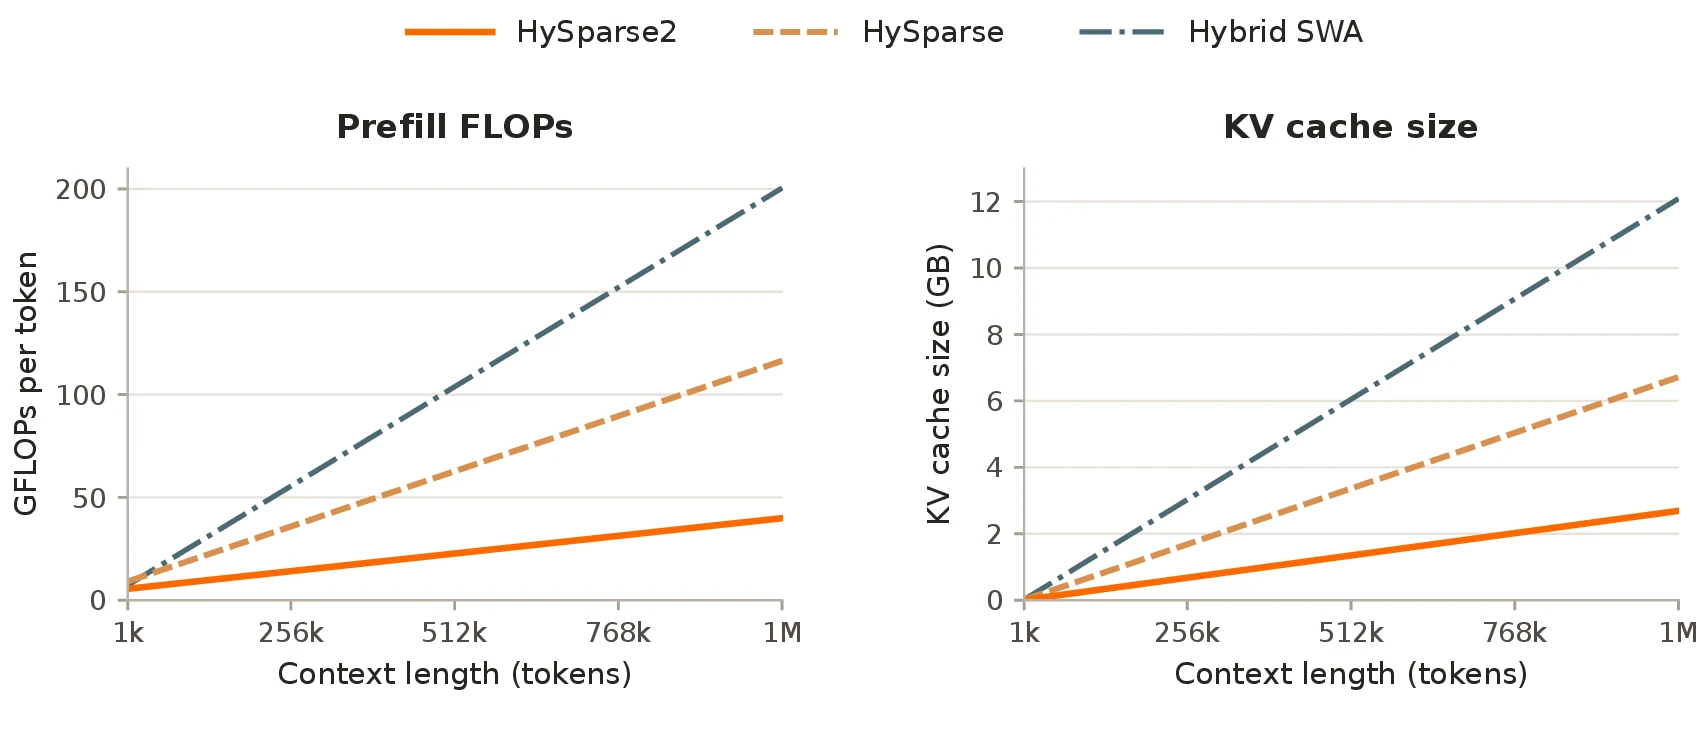
图片来源:HySparse2 论文 Figure 3。左图是理论 Prefill FLOPs,右图按 FP8 KV 统计缓存;二者都是配置分析,不是端到端服务延迟。
图中三条曲线随上下文近似线性上升,是因为纵轴写的是每 token Prefill GFLOPs 与 KV 总容量;横轴扩展时,保留的少数全注意力层仍带来随 增长的单 token 成本。HySparse2 斜率更小来自两件事:只在 self-decoder 运行一次全注意力,以及跳过整个 cross-decoder 的历史 token 前向。曲线没有包含网络传输拥塞、批调度等待或具体 kernel 利用率,不能直接读成 TTFT 比例。
为什么 Prefill 节点只需部署前 25 层
在 Prefill–Decode 分离服务中,普通模型的 Prefill 节点必须持有全模型权重,才能把提示词运行到底。HySparse2 的 Prefill 节点只需 self-decoder 与桥接 K/V 投影;49 层配置中主体权重只部署前 25 层,论文称节点模型内存需求接近减半。生成节点仍需完整 49 层,因为新 token 必须穿过 cross-decoder 获得最终 logits。
桥接缓存适合在 Prefill 侧投影完再传输。若把源隐藏状态传到 Decode 侧,接收端还要执行多组 K/V 投影,并持有相应输入;传已经压缩到 MQA 形状的目标缓存,网络负载与接收侧计算都更可控。工程上还要固定双方约定:层到桥接源的映射、KV dtype、token 顺序、page size、RoPE/NoPE 状态和量化 scale。任一元数据错位都不会触发形状报错,却会让后半段查询错误的历史表示。
Decode Kernel:让 MQA 把一次 KV 搬运供给 64 个 Query heads
相比 HySparse 的 GQA,HySparse2 的论文配置更进一步:它从 64 个 Query heads / 4 个 KV heads 改成 64 个 Query heads / 1 个 KV head 的 MQA。其 QK 与 V 头维也从 HySparse 的 192/128 改为 256/256。
MQA 为什么特别适合 token 稀疏访问
Decode 每一步的 Query 数很少,性能通常由历史 KV 搬运而非矩阵乘吞吐主导。若每个 Query head 都对应不同 KV head 和不同 TopK,kernel 要追踪多套离散地址;若多个 Query heads 共享一套 KV 与索引,则一个 token 的 K/V 读入片上存储后可被多个 Query heads 重用。
以 HySparse2 的 MQA 为例,单个历史 token 的 FP8 KV 负载是:
一次稀疏层若读取 1024 个全局 token 与 128 个局部 token,未计对齐、索引和 scale 的原始数据量约为:
这份数据服务 64 个 Query heads。若换成 4 个相同宽度的 KV heads,负载会按 KV head 数增长;不过论文中 HySparse 的 K/V 头维不同,不能直接用四倍关系比较两个真实配置。
MQA 的代价是所有 Query heads 共享相同 K/V 表示,表达容量更受约束。HySparse2 把头维扩大到 256,并用实验确认总体质量,而不是只做运行时替换。它仍是需要按这种注意力结构得到的模型,不能把已有 GQA checkpoint 的四组 KV 在部署时强行合并成一组。
token 级稀疏把难点从算术转移到地址
块级 HySparse 每次读取 16 段连续的 64-token KV,天然适合向量化加载。HySparse2 最多访问 1024 个分散的全局位置,理论上每个位置都可能落在不同 cache line 或不同物理页。减少无效 token 计算的同时,合并访存更困难。
一个高效 Decode kernel 至少需要处理以下步骤:
- 对固定长度索引做去重,尤其防止 forced window 与全局 TopK 重叠;
- 把逻辑 token 位置翻译为分页 KV 的物理地址;
- 尽量按物理位置排序或分桶,以便相邻线程合并加载;
- 在不把完整稀疏 KV 复制到临时连续缓冲的前提下计算 ;
- 用在线 softmax 合并多个离散 tile 的局部最大值、归一化量与输出;
- 让共享同一 MQA KV 的 Query heads 在 thread block 内复用加载结果。
若先 gather 1152 个位置到连续张量,再调用普通 attention,会多一次 HBM 写入和读取。对于带宽受限的 Decode,这可能抵消很大一部分稀疏收益。更合理的做法是 kernel 直接消费索引与页表:地址解析后立即把 K tile 与 Query tile 做点积,再读取对应 V 累加输出。
对第 个离散 KV tile,在线 softmax 维护运行最大值 、指数和 与未归一化输出 。得到局部 logits 后更新:
最后输出 。 枚举当前离散 tile 内的有效 token。这套递推与 tile 是否连续无关,所以数学上可以精确处理任意 TopK;真正决定速度的是地址形成、加载合并、活跃线程比例和候选排序成本。
论文没有报告上述稀疏 kernel 的微基准,也没有给出 TPOT 或 tokens/s。它引用 TileLang 说明 token 级 kernel 已具备可行性,但“可实现”与“端到端比块稀疏更快”是两个结论。token 级方案首先由检索准确率驱动,系统端还需要在精细选择与访存规则性之间重新找平衡。
Decode 的节省没有 Prefill 那么激进
逐 token Decode 不能使用 cross-decoder 早退,因为每个新 Query 都要形成最终隐藏状态。只按每层访问的历史位置数估算,HySparse2 单步注意力规模约为:
5 个全注意力层仍扫描长度 的历史;self-decoder 的 24 个 SWA 层各读 个位置;cross-decoder 的 20 个稀疏层各读 个位置。HySparse 原版对应近似为:
HySparse2 的 Decode 注意力读取更少,因为前半段的 24 个层只做 SWA,后半段才做全局稀疏读取;但全部 49 层的非注意力主体仍会执行。因而这项架构对 TTFT 的理论改善通常比对 TPOT 更直接。实际差距还会受到 MQA 带宽、token gather 效率、MoE 比例与 batch size 影响,不能只用上式宣称某个固定倍数。
分页 KV、批处理与缓存生命周期
两级共享怎样映射到页表
普通 PagedAttention 的缓存键通常可理解为“请求、层、逻辑块”三元组。HySparse2 增加了生产者与消费者关系:一个 cross-decoder 全注意力层的页面由 self-decoder 隐藏状态投影产生,又会被本混合块内 5 个稀疏层读取。运行时应让多个消费者引用同一组物理页,而不是为每个稀疏层复制页表项背后的数据。
一种清晰的元数据组织是:
request├── self-decoder cache│ ├── full-attention pages│ └── per-layer SWA rings└── cross-decoder shared groups ├── FA group 0: KV pages + token-index buffer -> SA layers 0..4 ├── FA group 1: KV pages + token-index buffer -> SA layers 5..9 ├── FA group 2: KV pages + token-index buffer -> SA layers 10..14 └── FA group 3: KV pages + token-index buffer -> SA layers 15..19这里的索引是每个当前 Query 动态产生的,不应作为整个请求永久附着在每一页上。Decode 第 步,全注意力层计算出 ,随后 5 个稀疏层在该 token 通过混合块期间消费它;离开该块后,这份索引即可释放或复用。长期存在的是全长 KV 页,短期存在的是当前 token 的 TopK 索引缓冲。
若服务支持请求抢占,引用计数单位应是共享组,而非单个消费层。释放某个稀疏层的逻辑状态不能回收其前置全注意力 KV,因为同组其他层以及未来 Decode 步骤仍会访问。若做 prefix cache,共享前缀的粒度也应覆盖桥接产生的所有目标 KV;只共享 self-decoder 页、却在每个请求中重复投影 cross-decoder KV,会损失大量桥接收益。
固定预算对连续批处理很重要
每个 Query 固定 1024 个全局位置和最多 128 个局部位置,使输出形状不随实际相关 token 数变化。固定形状便于 CUDA Graph 捕获、批内 workspace 预分配和 kernel 模板化。短序列 时可以退化为读取所有可见 token,并用有效长度 mask 填充;长序列则保持固定预算。
连续批处理中的请求长度各不相同,TopK 位置也完全不同。不能像块稀疏 Prefill 那样简单把相同稀疏模式的行聚成大矩阵。调度器更适合按 KV dtype、head dimension、page size 和长度区间分组,让一个 kernel 处理多个独立索引表。负载均衡的难点不是 FLOPs 数量——预算已经固定——而是页表命中与物理地址分散程度。
因果性、位置编码和量化元数据
forced window 必须截断到当前可见位置,TopK 也只能在 的历史中选择。Prefill 中若同时处理多个 Query,一个 tile 内既有较早 Query 又有较晚 Query,不能给整块套同一个 token 集合后忘记逐行因果 mask。
论文配置让 self-decoder 的 SWA 使用 64 维 partial RoPE、base 为 10,000,而 full attention 与 sparse attention 使用 NoPE。这样桥接 KV 不需要在长上下文扩展时做 RoPE 重映射。若把架构迁移到使用 RoPE 的全局层,源隐藏状态可以被多个目标层投影,但每个目标层仍必须遵守一致的位置变换;缓存迁移时要明确存的是旋转前还是旋转后的 Key。
FP8 KV 还带有 scale。若按页或按 token 量化,页表必须同时定位 scale 元数据;若不同桥接目标层使用不同 scale,不能因为它们共享源隐藏状态就共享量化参数。稀疏访问只读少量 token,scale 布局若迫使 kernel 为一个值加载整页元数据,也会放大随机访存代价。
缓存容量拆账:2.69 GB 到底省在哪里
论文在 1M-token、FP8 KV 条件下报告:HySparse2、HySparse 与 Hybrid SWA 的缓存分别为 2.69 GB、6.72 GB 和 12.09 GB。要正确理解这组数字,不能只看全注意力层数量,还要把 KV head 数与头维一起算进去。
忽略局部窗口、对齐、scale 与页表,一组全长 KV 的主体容量为:
是上下文长度, 是保存全长 KV 的层数, 是 KV head 数, 是 Key/Value 头维, 是单元素字节数。把论文配置代入 、:
| 架构 | 全注意力层 | Q/KV heads | QK/V 头维 | 全长 KV 主体估算 | 论文总量 |
|---|---|---|---|---|---|
| Hybrid SWA | 9 | 64/4 | 192/128 | 11.52 GB | 12.09 GB |
| HySparse | 5 | 64/4 | 192/128 | 6.40 GB | 6.72 GB |
| HySparse2 | 5 | 64/1 | 256/256 | 2.56 GB | 2.69 GB |
HySparse2 的主体项正好是:
剩余约 0.13 GB 来自 self-decoder 局部窗口、量化或布局元数据等实现项。类似地,HySparse 与 Hybrid SWA 的主体估算也接近论文总量。
这张账表揭示了两个容易误读的事实。
第一,HySparse2 相对 HySparse 的 KV 容量下降,不是因为全长层从 5 层继续减少到更少;两者都是 5 层。主要差别是 GQA 的 4 个 KV heads 变成 MQA 的 1 个 KV head,并调整了头维,同时 cross-decoder 的稀疏层不再保存独立 128-token 局部缓存。
第二,KV Bridging 的最大价值是让 Prefill 跳过 cross-decoder,而不是自动减少最终必须存储的 5 组全长目标 KV。桥接仍为每个目标全注意力层保留独立投影与独立缓存。若仅按容量评估,外层桥接的贡献会被低估;若把 2.69 GB 全归功于桥接,则又会高估它。
四种压缩轴可以彼此叠加:MQA 压 head 轴,token 稀疏压每步读取的 sequence 轴,KV Reuse 压 layer 轴,FP8 压 precision 轴。HySparse2 的数字好看,来自四轴共同作用,而不是某个单一技巧。
实验结果、消融与证据边界
论文的主要对照使用同为 80B-A3B、49 层的 MoE 模型,并尽量保持数据与评测设置一致;这里只讨论能回答架构问题的结果,不展开通用榜单。
token 级选择是否真的比 64-token 块更好
作者在相同骨架、相同 1024-token 全局预算、相同独立 128-token 局部窗口下,只替换选择粒度。与块级选择相比,token 级选择在长上下文任务上的变化如下:
| 指标 | 64-token 块 | token 级 | 差值 |
|---|---|---|---|
| RULER-v2 | 49.56 | 56.13 | +6.57 |
| MRCR-v2,2-needle | 12.94 | 21.08 | +8.14 |
| GraphWalks | 29.38 | 34.92 | +5.54 |
| NoLiMa | 40.27 | 38.43 | -1.84 |
前三项支持“分散证据需要细粒度预算”这一动机,但 NoLiMa 的回落说明 token 级并非对所有长上下文分布都占优。块选择会把关键 token 的邻域一起带入,这种局部冗余有时恰好提供语义上下文;token TopK 则可能选到一组分数高却彼此缺少邻域的孤立位置。精细粒度减少读取浪费,也减少了块内免费上下文,两者是一体两面。
forced window 能否替代独立 SWA 分支
局部机制消融比较三种方案:保留独立 gated SWA、完全移除局部路径、把最近 128 个 token 强制并入稀疏集合。选取与推理数据流最相关的指标:
| 指标 | Gated SWA | No SWA | Forced SWA |
|---|---|---|---|
| RULER | 88.19 | 84.55 | 89.84 |
| RULER-v2 | 53.66 | 54.62 | 55.98 |
| MRCR-v2 | 27.66 | 20.73 | 22.67 |
| GraphWalks | 35.39 | 36.48 | 37.13 |
| LongPPL,越低越好 | 6.8807 | 7.1307 | 6.9838 |
完全删掉局部信息使 MRCR-v2 与 LongPPL 明显变差,说明稀疏 TopK 不能稳定承担所有近邻依赖。Forced SWA 在 RULER、RULER-v2 与 GraphWalks 上最好,却在 MRCR-v2 上比 gated SWA 低 4.99 分,LongPPL 也高约 1.5%。它不是质量上无条件支配,而是用可接受的局部能力折中,换取三个系统收益:删除额外 K/V 投影,删除逐层局部缓存,最重要的是解除阻止 Prefill 早退的级联依赖。
KV Bridging 是否损坏表示能力
在 290B-A8B 消融中,有无 KV Bridging 的 RULER 分别为 96.32 与 96.01,Repo Code PPL 为 1.1351 与 1.1353,差异很小;LongPPL 从 3.6053 改善到 3.4202。另一方面,DROP 从 71.37 降到 68.17,BBH 与 GSM8K 约下降 1 分。证据支持“总体可比、部分指标有取舍”,不支持“桥接在所有能力上无损”。
论文还把只连接全注意力层的 KV Bridging,与前后层反向配对的 U 形 KV Mirror 比较。前者最终 RULER 为 87.65,后者为 81.28。
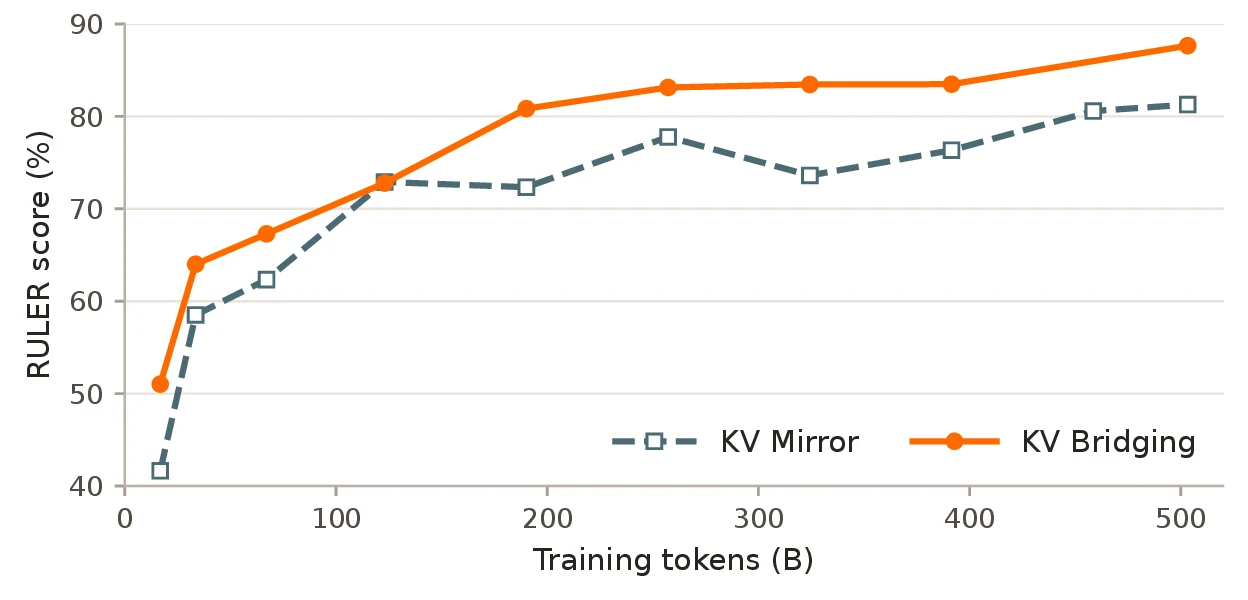
图片来源:HySparse2 论文 Figure 4。作者推测全注意力层的隐藏状态包含更强的全局信息,因此比 SWA 层更适合作为桥接源;曲线支持特定配置下的选择,但没有穷举所有层间映射。
这个结果回答的是“桥接源从哪里取”而不是“是否需要任意跨层连接”。全注意力层直接聚合所有可见位置,其隐藏状态更可能成为多组全局 KV 的稳定源;SWA 层的直接感受野受窗口限制。论文把原因表述为假设,没有提供表示互信息、注意力召回率或所有连接拓扑的系统消融,因此不应把全注意力到全注意力视为已经证明的唯一最优映射。
长上下文曲线说明什么
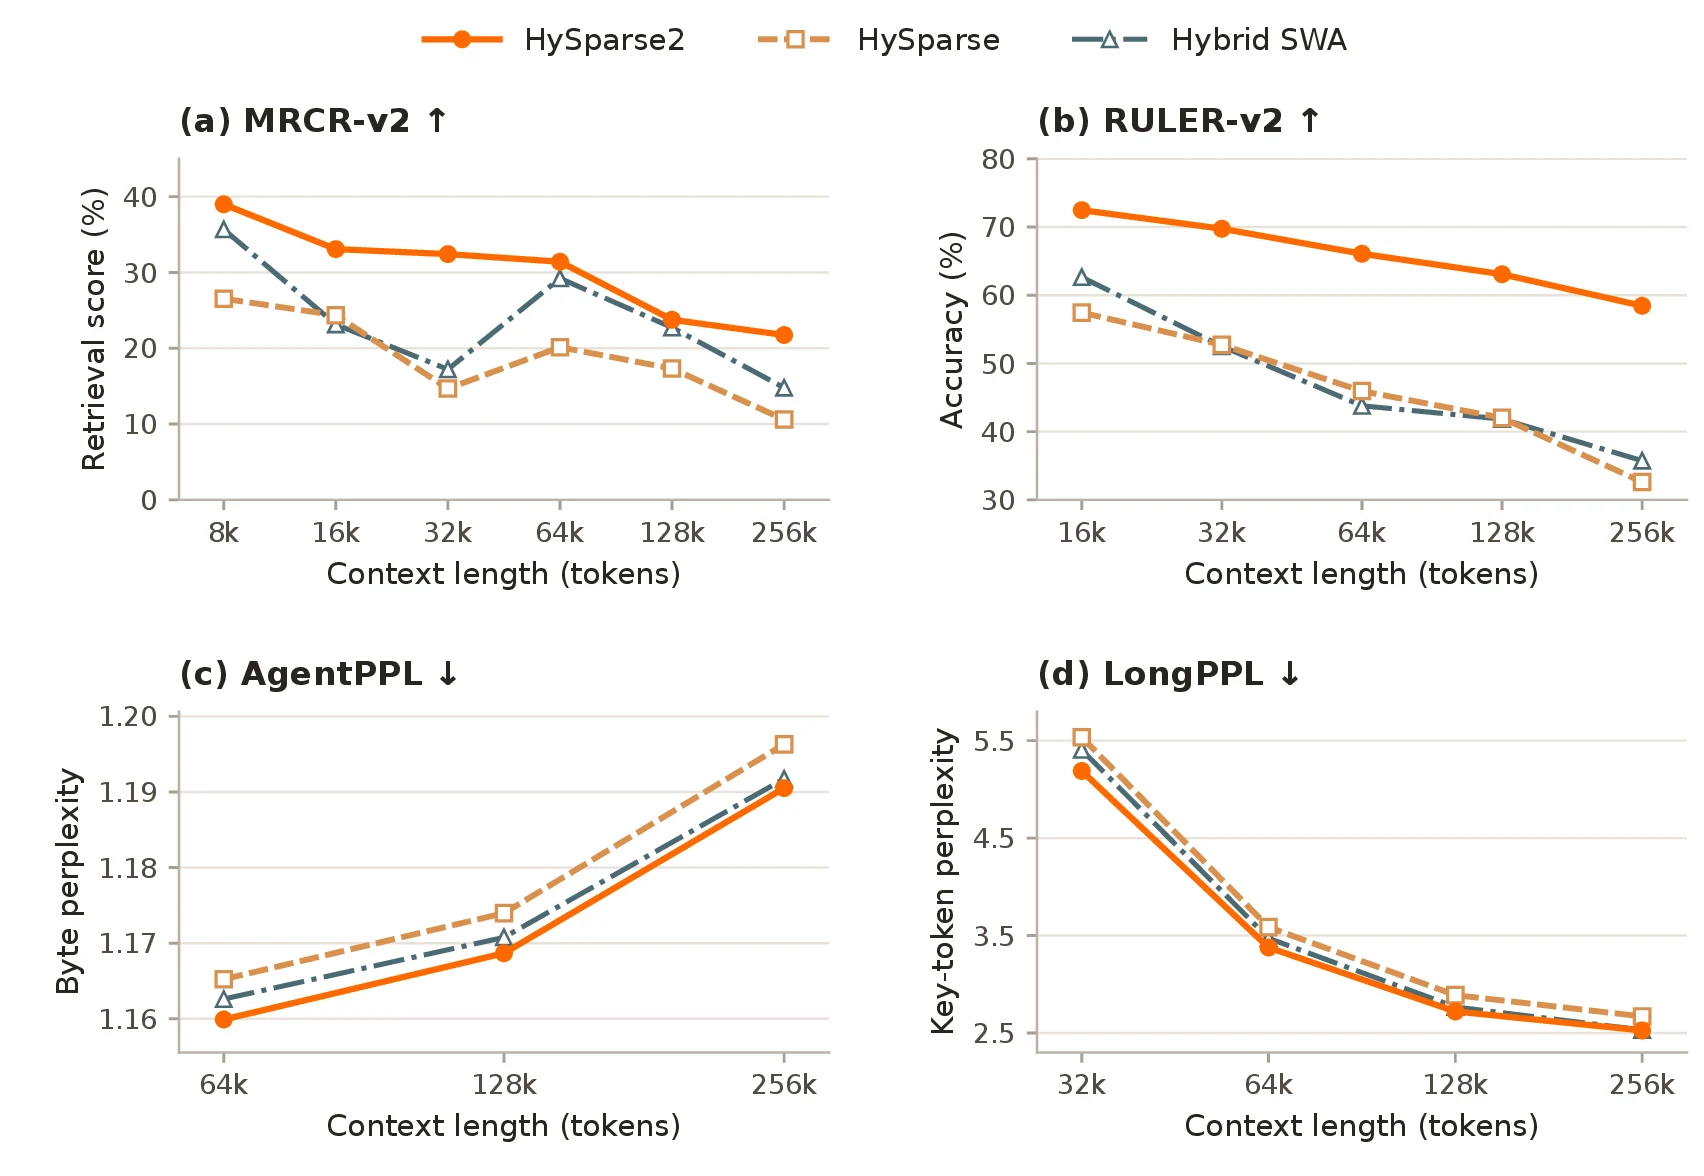
图片来源:HySparse2 论文 Figure 2。上排越高越好,下排越低越好;三个模型使用不同注意力结构,HySparse2 在图示长度范围内保持领先。
在 256k 上下文,HySparse2 的 RULER-v2 为 58.45,HySparse 与 Hybrid SWA 分别为 32.61 和 35.74。跨图示长度取平均,HySparse2 相对 HySparse 的 MRCR-v2 与 RULER-v2 分别提高 11.30 和 19.81 个百分点。AgentPPL 与 LongPPL 也在各评测长度上更低。
这组结果与 token 级选择、外层桥接共同出现,不能把全部差距单独归因于某一个模块。三种模型的 KV head 数、头维与全注意力层布局并不完全相同;结果证明的是整套 HySparse2 配置可行,而非一个严格控制所有变量的 kernel 对比。图中也没有延迟、吞吐、GPU 型号或并发负载,不能据此计算生产服务加速倍数。
什么时候值得采用 HySparse
HySparse2 最适合输入远长于输出、历史会持续增长、又需要精确检索离散证据的负载。多轮工具调用、代码仓库分析、长文档问答和持续状态智能体都符合这一形态:大量新观察进入上下文,模型每轮只生成相对短的动作;Prefill 计算、KV 容量与远程检索准确率同时成为瓶颈。
从系统条件看,采用它至少需要满足以下前提:
- 可以使用原生 HySparse2 架构的模型,而非要求对普通 checkpoint 做无损运行时替换;
- 推理框架能表达跨层 KV 所有权,让多个稀疏层引用一个生产者缓存;
- Prefill 与 Decode 节点可以部署不同的模型子图,并传输带完整层映射的桥接 KV;
- GPU kernel 能直接消费 token 索引与分页地址,不依赖昂贵的 gather 临时张量;
- 调度器能把固定稀疏预算转化为更大 batch 或更多并发,而不只是留下空闲显存。
以下场景未必划算。
短上下文中,TopK、索引生成和桥接元数据的固定成本不易摊薄,普通 FlashAttention 或 Hybrid SWA 更简单。硬件特别擅长连续大矩阵乘、却缺少高效随机 gather 时,64-token 块稀疏可能比 token 稀疏更快。若应用主要依赖连续局部语义而不是分散证据,块内邻域也可能比精细 TopK 更有价值。已有模型若必须保持逐 token 完全一致,则 PagedAttention、KV 量化或分层缓存更现实,因为 HySparse2 会改变模型的数据依赖。
尚未被论文回答的五个部署问题
- token TopK 与全注意力融合后的真实 kernel 开销是多少?论文没有给 TopK、页表解析或稀疏 attention 的微基准。
- 1M-token 配置下的 TTFT、TPOT 与并发吞吐是多少?当前只有 FLOPs 和容量分析。
- Prefill–Decode 分离时,2.69 GB 级 KV 的传输如何与计算重叠?链路带宽可能成为新瓶颈。
- prefix cache 命中后,桥接目标 KV 是直接复用、延迟投影还是独立缓存?三种策略会改变显存与计算折中。
- 选择索引跨 5 个稀疏层复用时,后层真正需要的高权重 token 召回率是多少?最终任务分数无法定位漏选发生在哪一层。
还有一个接口细节需要明确:历史 Prefill 可以在 self-decoder 后退出,但生成第一个 token 仍需要一个 cross-decoder Query 才能得到最终 logits。实现可以把提示末位置的边界计算视为一次单 Query 的 Decode 式前向;它的成本随层数增长,却不再随整段历史 成倍执行。所谓“跳过 cross-decoder”指历史缓存构建路径,不是模型永远不运行后半段。
小结
HySparse2 把 HySparse 的“一个全注意力层服务后续多个稀疏层”,扩展成“前半段隐藏状态服务后半段多个全注意力层”。外层 KV Bridging 让 cross-decoder 的 K/V 可由 self-decoder 直接投影,内层 KV Reuse 再让每组稀疏层共享这些 K/V 与选择索引。两级共享闭合后,历史 token 的 Prefill 可以在 49 层模型的第 25 层后退出。
forced window 是整个闭环里最关键却最容易被忽略的一步。它把最近 128 个 token 与 1024 个全局 token 合并到同一次稀疏注意力中,删除 cross-decoder 逐层独立 SWA 缓存,进而切断局部状态的级联依赖。token 级 TopK 则把预算从 16 个连续块重新分配到离散证据,在多轮检索上明显优于块级选择,但带来更难合并的随机 KV 访问。
1M-token 下 2.69 GB 的 FP8 KV 也必须拆开看:两级共享压缩 layer 轴,MQA 压缩 head 轴,FP8 压缩 precision 轴,稀疏 TopK 压缩每步实际读取的 sequence 轴。HySparse2 相对 HySparse 的容量下降主要来自 4 个 KV heads 变成 1 个,而 Prefill FLOPs 的大幅下降才是 KV Bridging 最直接的收益。
这项工作给出了完整的模型数据流和较有说服力的长上下文结果,却尚未给出服务栈的 wall-clock 性能。下一步真正困难的部分不在公式,而在 token TopK 融合、分页随机读取、P/D 缓存传输和共享页生命周期。只有这些环节不重新物化 KV、不制造新的带宽瓶颈,架构层的“少跑半个 Prefill”才会变成可观测的 TTFT 与吞吐收益。
参考资料
- HySparse2: Hybrid Sparse Attention with Two-Level KV Sharing
- HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing
- You Only Cache Once: Decoder-Decoder Architectures for Language Models
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Fast Transformer Decoding: One Write-Head Is All You Need
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- TileLang: A Composable Tiled Programming Model for AI Systems
- Reducing Transformer Key-Value Cache Size with Cross-Layer Attention
- RULERv2: From Basic Retrieval to Complex Reasoning
- Hidden Decoding at Scale: Latent Computation Scaling for Large Language Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


