


扩散模型从零讲起(十一):三维生成——点云、结构化隐空间与高斯泼溅的扩散路径
写在前面:系列走到三维
前面的十篇把扩散模型的主线铺完了:从 DDPM 的两条高斯链、DDIM 的确定性轨迹、score matching 与 Flow Matching 的连续时间视角,到掩码离散扩散与 dLLM 的推理系统;从潜空间扩散、条件注入与 MMDiT 双流,到视频的时空注意力、采样器的数值误差、少步蒸馏、跨步缓存与 4-bit 量化,最后是主干结构演进与音频扩散。这些内容有一个共同前提:数据躺在一张规则网格上。图像是 的像素阵列,视频是 的立方体,音频是一维采样序列,语言是定长词表上的 token 序列。网格意味着位置是天然的、维度是固定的、相邻关系是明确的,扩散模型只需要在这个网格上定义加噪与去噪。
三维生成打破了这个前提。一个三维资产没有唯一表示:它可以是点云、体素、隐式场、网格、高斯泼溅;每种表示的自由度、拓扑约束、可解码性和渲染方式都不同。更麻烦的是,“生成一个 3D 资产”通常不是一次网络前向就结束——模型先生成一个中间表示(稀疏结构、隐向量集合、隐式场),再由解码器把它变成网格或高斯,最后还要做纹理烘焙、网格提取、格式转换。这条流水线里,扩散模型只占一段,但它的输出空间选择会决定后面所有环节的成本。
本篇沿用系列”从零讲起”的方式,但重点放在三维特有的三个问题上:
- 在什么空间里加噪:点云坐标、隐式场参数、结构化隐空间的局部 latent,三者的扩散行为完全不同;
- 如何把不规则的 3D 数据喂给 transformer:置换不变性、稀疏体素、变长序列、位置编码,每一项都影响注意力的复杂度;
- 一次生成请求的成本落在哪:两段式生成、稀疏注意力、解码器、网格提取与纹理烘焙,各自在延迟与显存里占多大份额。
读完之后,应该能判断一个 3D 生成系统为什么选择某种表征,能算出它的 token 数与注意力开销,也能解释为什么”同样的扩散模型”,在 2D 上 20 步能出图,在 3D 上却要拆成两个模型、再接一串解码器。
三维表征谱系:扩散到底在什么空间里加噪
讨论 3D 扩散之前,必须先把表征讲清楚,因为表征决定了扩散模型的输入维度、输出维度、损失函数和可解码性。这一节按”显式程度”从高到低梳理常见表征,并给每种表征算一笔规模账。
点云:最接近”3D 像素”的表示
点云是 个三维坐标的集合:
它没有连接关系、没有面、没有颜色(除非额外带特征),只有位置。点云的好处是维度固定、生成简单:只要 固定,扩散模型就可以把 个数当作一个向量来加噪,和图像扩散的数学形式完全一致。坏处是它无序:把点的顺序打乱,点云还是同一个点云。这意味着网络必须是置换不变的(permutation-invariant),不能用普通的位置编码来区分第 个点。
点云的规模很小:4096 个点只有 12288 个浮点数,按 FP16 算是 24 KB。这解释了为什么 Point-E 这样的早期系统能在单卡上跑得很快——它的生成对象本身就只有几十 KB。
体素:把 3D 变成规则网格
体素是最直接的”3D 像素”:把空间切成 的格子,每个格子存占用概率、颜色或特征。它的优点是规则、可以用 3D 卷积或 3D transformer;缺点是立方级增长:
| 分辨率 | 体素数 | FP16 特征维度 8 时的显存 |
|---|---|---|
| 32,768 | 0.5 MB | |
| 262,144 | 4 MB | |
| 2,097,152 | 32 MB | |
| 16,777,216 | 256 MB |
看起来 才 4 MB 不算大,但扩散模型不是只存一个体素网格:它要对每个体素做注意力。 有 26 万个 token,全注意力的注意力矩阵是 个元素——即使按 FP16 也要 137 GB,完全不可行。所以体素扩散要么用 3D 卷积(局部感受野),要么必须稀疏化:只在实际有表面的体素上计算。
隐式场:用神经网络表示形状
隐式场(implicit field)把形状表示成一个连续函数:
表面就是 的等值面。NeRF 是它的另一种形式:,输入位置与视角,输出颜色与密度。隐式场的分辨率是”无限”的,参数量由网络宽度决定;但网络权重本身就是高维对象——一个 8 层、每层 256 维的 MLP 有约 50 万个参数,直接对权重做扩散,维度比点云高两个数量级,而且权重空间没有平移/旋转的几何意义。
向量集合与三平面:把 3D 压成 latent token
3DShape2VecSet 的做法是:用一组 latent 向量 表示形状,再用一个交叉注意力解码器把任意查询坐标映射到占用值:
这组 latent 是无序的集合, 通常只有几百到几千,比体素少得多。三平面(triplane)是另一种压缩:把 3D 空间投影到三个正交平面,每个平面是 的特征图,查询时三平面插值后拼接。两者的共同点是把 3D 问题变成”少量 token 的条件生成”,扩散模型只需要生成这组 latent 或三平面特征。
网格:最终资产,但不是好的扩散空间
网格由顶点 与面 组成,拓扑可变、顶点数可变、面数可变。直接对网格做扩散要处理变长、非规则连接、拓扑变化,难度很高。所以绝大多数系统不在网格上扩散,而是生成隐式场或结构化 latent,再用 marching cubes 等算法提取网格。
3D 高斯泼溅:显式、可微、可实时渲染
3D Gaussian Splatting(3DGS)把场景表示成 个各向异性高斯:
其中 是中心, 是 协方差(通常分解为旋转四元数 与缩放 ), 是不透明度, 是球谐系数(三阶球谐有 16 个系数 × 3 通道 = 48 个数)。所以每个高斯约 个浮点数。100 万个高斯就是 5900 万个数,FP32 约 236 MB,FP16 约 118 MB。它比点云重得多,但换来的是可微光栅化与实时渲染——这也是为什么 TRELLIS 这类系统把高斯作为主要输出之一。
结构化隐空间:稀疏体素 + 局部 latent
TRELLIS 提出的 Structured Latents(SLat)把上面几种思路合在一起:
每个 是一个被激活的体素坐标, 是这个体素上的局部 latent。 时网格有 26 万个格子,但实际被激活的只有平均 万个——因为物体表面只占空间的一小部分。这样一来,token 数从 26 万降到 2 万,注意力开销降了一个数量级以上,同时保留了”局部性”:每个 latent 只描述一个体素附近的几何与外观。
这张表把几种表征放在一起比较,后面的所有设计选择都可以回到这张表:
| 表征 | 自由度 | 典型 token/参数数 | 可微渲染 | 直接扩散难度 |
|---|---|---|---|---|
| 点云 | 4096 点 ≈ 12K 数 | 否(需 splatting) | 低(置换不变网络) | |
| 稠密体素 | K | 否 | 高(注意力爆炸) | |
| 隐式场 | 网络权重 | 数十万 | 是(体渲染慢) | 高(权重空间无几何) |
| VecSet | 数百到数千 token | 需解码 | 中(集合扩散) | |
| 网格 | 顶点+面 | 数千到数十万 | 是 | 高(拓扑可变) |
| 3DGS | 个数 | 十万到数百万高斯 | 是(实时) | 中(参数量大) |
| SLat | 约 2 万 token | 需解码 | 中(稀疏结构+latent) |
为什么”表征选择”不是纯学术问题
表征直接决定推理成本。举个具体的账:假设 transformer 的注意力复杂度是 ,,FP16 下每个 token 的 K/V 是 KB。
- 稠密 体素:,K/V 缓存 1 GB,注意力矩阵 个元素,任何单卡都放不下;
- SLat 的 :K/V 缓存 80 MB,注意力矩阵 个元素,约 0.8 GB(FP16),可以分段计算;
- 点云 :,K/V 16 MB,注意力矩阵 1670 万个元素,非常轻。
这就是为什么 3D 扩散的主流方案都绕开了稠密体素:不是体素不好,而是它的 token 数在注意力面前不成立。稀疏化不是优化技巧,而是让问题可解的前提。
第一层:Point-E——把点云当成 的矩阵来扩散
Point-E 由 OpenAI 的 Alex Nichol、Heewoo Jun、Prafulla Dhariwal 等人在 2022 年 12 月发表,是第一批能”文本生成 3D 点云”的系统之一。它的价值不在生成质量,而在证明了一件很基础的事:如果表示选得足够简单,3D 扩散可以几乎原样复用 2D 图像扩散的数学,只需要改网络结构。
表示: 而不是
Point-E 把点云表示成一个 的张量:每个点有 坐标和 颜色,所有分量归一化到 。为什么是 6 而不是 3?因为只生成坐标得到的是无色的”骨架”,下游仍然需要另做颜色估计;把颜色一起扩散,模型输出的就是可直接渲染的彩色点云。颜色和坐标共享同一个归一化区间,损失的尺度也就一致,不需要额外加权。
对 ,前向过程就是普通的高斯扩散,和本系列第一篇的 DDPM 完全相同:
训练目标也是最常见的形式:网络预测噪声 ,同时额外预测方差 (后者继承自 Dhariwal 与 Nichol 的”改进版 DDPM”,用于让采样器选择更合适的噪声日程)。
网络:一个不带位置编码的 transformer
Point-E 的扩散网络是一个标准 transformer,输入上下文由三部分组成:
- 每个点经过一个线性层映射到 维,得到 ;
- 时间步 经过一个小 MLP 得到 维向量,放在最前面;
- 条件图像经过冻结的 CLIP ViT-L/14,取最后一层 的 patch 嵌入,线性投影到 ,也放在前面。
于是输入序列长度是 ,输出取后 个 token 投影回 与 。这里有一个容易被忽略的设计决策:模型不使用任何位置编码。点云是无序集合,如果给第 个点加位置编码,模型就会学习”第 个位置的点应该长在哪”,这既没有意义,也会破坏置换不变性。去掉位置编码后,模型对输入点的顺序不变(输出顺序仍与输入一致)。
这个决策的代价是:模型无法利用任何空间邻近信息。所有点之间都靠自注意力做两两交互, 时注意力矩阵是 ,只有 100 万个元素,成本很低;但如果点数涨到 10 万, 就会爆炸。这也解释了为什么 Point-E 的点数上限不高。
层次化:先粗后细
Point-E 不是一次生成全部点,而是分成三级:
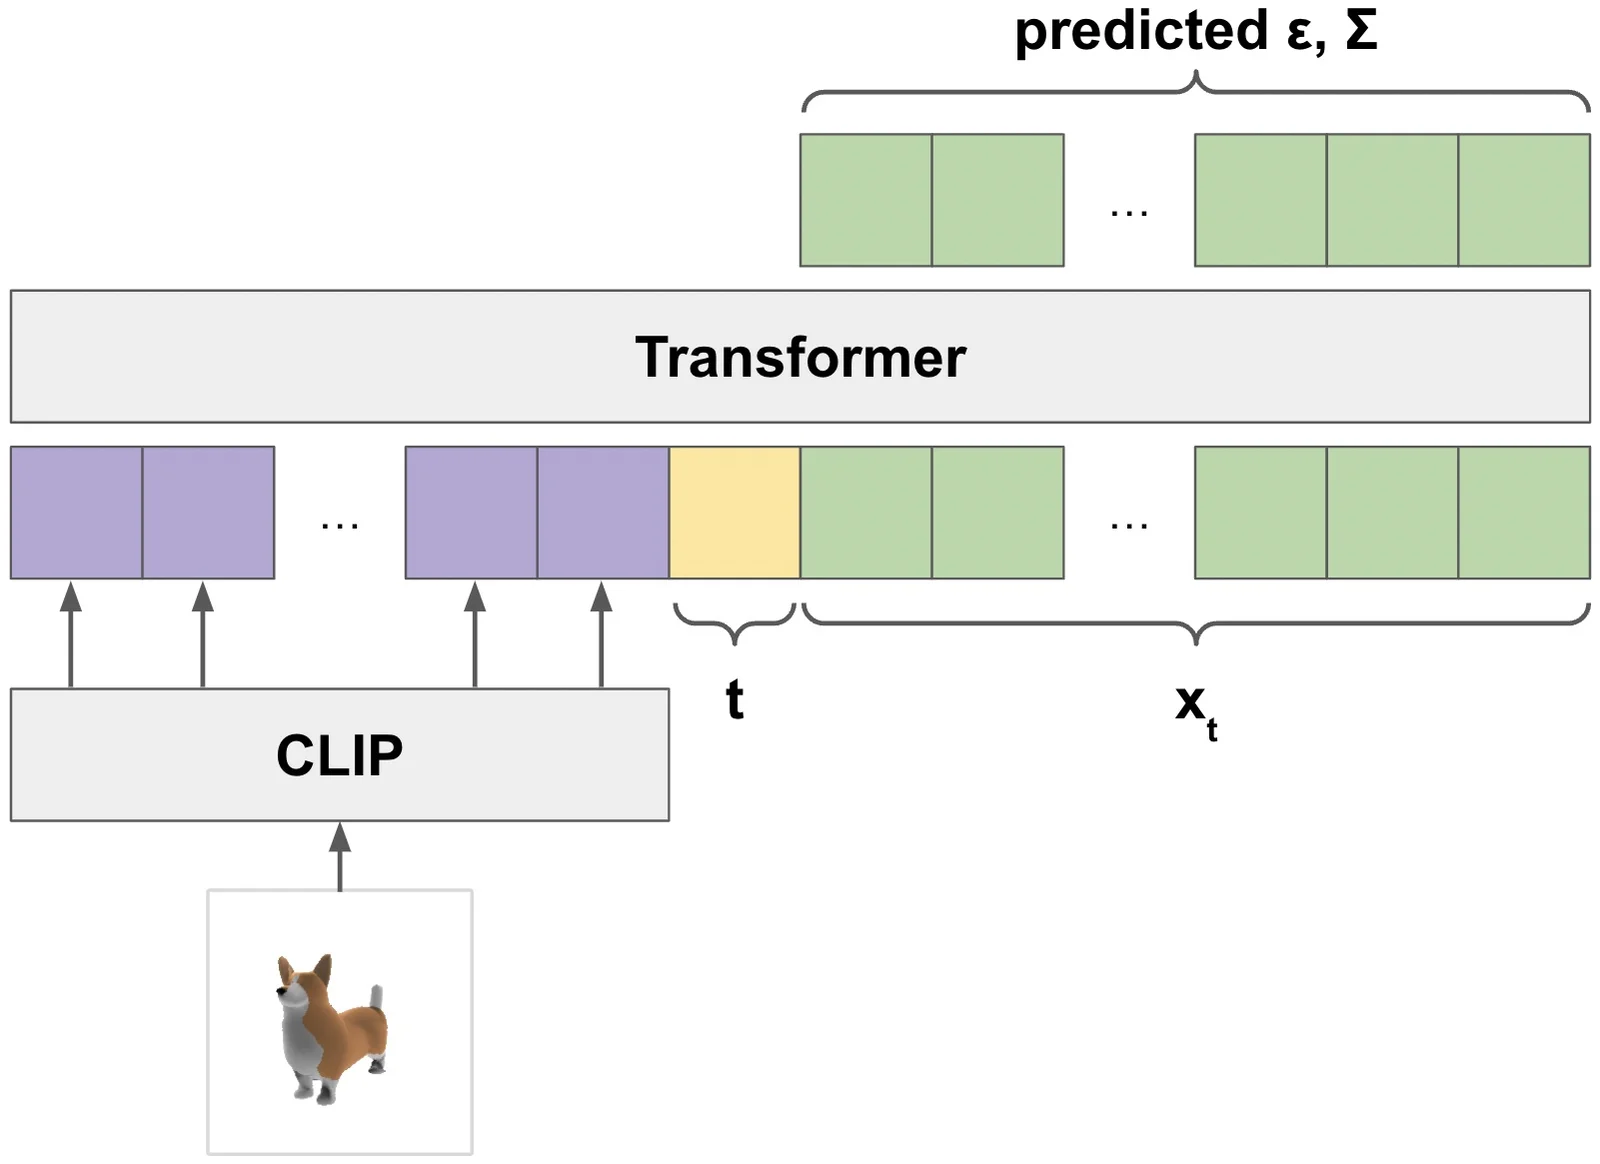
上图是 Point-E 论文的 Figure 3。左侧是冻结的 CLIP 视觉编码器,它把条件图像变成 256 个 token 网格;下方是时间步 与加噪输入 分别作为 token 进入 transformer;右侧输出对应 的部分用于预测 与 。整条路径没有卷积、没有 3D 专用算子,只有”线性投影 + 自注意力”。
具体三级如下:
- 第一级:一个 30 亿参数的 GLIDE 图像扩散模型,以文本为条件生成一张”合成视图”;
- 第二级:一个点云扩散网络,以这张视图为条件,生成 1024 个粗点;
- 第三级:一个点数上采样网络,以 1024 个粗点和视图为条件,生成额外的 3072 个点,补齐到 4096 点。
第三级的设计值得单独讲。上采样网络的结构与基础模型相同,但它把 1024 个条件点通过另一条线性嵌入层处理,然后作为额外的条件 token 放进上下文,而不是与 混在一起。这样处理后,模型能区分”这是已经确定的点”和”这是我正在生成的点”,也就不需要位置编码来配对——这是置换不变网络处理”部分已知条件”的一种通用做法。论文原文的说法是”模型的算力随点数增长”,所以同样规模的模型生成 4096 点要比 1024 点贵出数倍;这也是它把粗点与细点拆成两个网络、而不是一次生成全部点的原因。
采样:二阶采样器与小模型
Point-E 用 Karras 等人的二阶 Heun 采样器(也就是本系列第五、六篇讨论过的 EDM 框架),64 步即 128 次函数评估。它做了一个很有启发性的消融:基础模型在 40M、300M、1B 三档上都训练过,模型变大后质量确实提升,但延迟也随参数线性上升。论文附录给出的 V100 实测时间是:
| 组件 | 参数量 | V100 秒 |
|---|---|---|
| GLIDE 图像模型 | 3B | 46.28 |
| 点云上采样 | 40M | 12.58 |
| 点云基础模型 | 40M | 3.35 |
| 点云基础模型 | 300M | 12.78 |
| 点云基础模型 | 1B | 28.67 |
这组数字是理解 3D 生成成本结构的起点:整条流水线里最贵的其实是 2D 图像模型和最后的上采样,而不是”3D 部分”本身。点云只有 4096 个点,扩散网络再大也贵不到哪去;但 CLIP 编码 256 个 patch、GLIDE 跑 150 步生成一张图,成本已经接近 50 秒。后面所有的 3D 系统都继承了同一结构:先出一个 2D 条件图,再在 3D 空间里”升维”。
Point-E 暴露的问题
Point-E 的输出是点云,没有面、没有拓扑,渲染时需要把点 splat 成小圆片。为了得到网格,它用 marching cubes 在点云上估计的密度场上提取等值面——密度估计不准,网格就会出现破洞和多余面。此外,点云之间没有约束,生成出来的点常常”飘”在表面附近而不是严格贴近表面。
这两个问题指向同一个改进方向:不要在”点”这种松散表示上扩散,而要在能表达形状连续性的表示上扩散。Shap-E 和 3DShape2VecSet 都在 2023 年走了这一步。
第二层:Shap-E 与 3DShape2VecSet——从点云走到隐空间
点云的缺陷不是”点太少”,而是表示本身是离散的:它无法表达”表面在哪里”这种连续信息。2023 年出现了两条互补的路线:Shap-E 直接把隐式函数的参数当作扩散目标,3DShape2VecSet 则设计了专门的向量集合表示,为后续的隐空间扩散打下基础。
Shap-E:扩散一个隐式函数的权重
Shap-E(Heewoo Jun、Alex Nichol 等,OpenAI,2023 年 5 月)的核心做法是两步:
- 训练一个编码器,把 3D 资产确定为隐式函数的参数——也就是一个 transformer 的权重矩阵;
- 训练一个潜扩散模型,以文本或图像为条件生成这些参数。
Encoder 的输入是渲染的多个视角,输出是一个序列化的隐式函数参数。论文把隐式函数的两种形式都支持了:NeRF 渲染(输出颜色与密度)与 STF 渲染(Signed Texture Field,输出 SDF 与颜色),两者用同一个编码器同时训练。
关键的一点在于隐空间的维度与瓶颈。论文里的 latent 是 的矩阵,被拆成 1024 个 token 输入 transformer,每个 token 对应隐式 MLP 权重矩阵的一行。这和图像潜扩散中”把 的特征图切成 patch”在结构上完全同构:都是”一个高维张量 → 一个定长 token 序列”。所以 Shap-E 可以几乎原样复用 Point-E 的 transformer 扩散架构,只是把点云换成 latent token 序列。
但这里存在一个需要解释的设计:隐式函数的参数是”权重空间”中的点,为什么能用扩散模型学?直觉上,权重空间没有几何意义,加噪后得到的”半噪声权重”不必然对应任何合理的形状。Shap-E 的回答是:
- 用确定性编码器(不是 VAE 那样带随机性的)把 3D 资产映射到权重空间,保证同一个资产对应同一个点;
- 不用 KL 正则或向量量化做瓶颈,而是把 latent 钳制到固定数值范围,再加扩散噪声。钳制本身压缩了分布的有效半径,让扩散的噪声档可以覆盖整片权重分布;
- 用 或 重建损失训练编码器与解码器,不使用感知损失或 GAN 目标。
这三点合起来,就是把”没有几何意义的权重空间”变成”一个结构化、可控尺度的向量空间”。从扩散数学的角度看,只要 的分布紧支撑在一个有界区域内,前向高斯链就能定义,后面的推导(闭式后验、训练目标化简)全部沿用 DDPM。
Shap-E 的推理成本结构
Shap-E 论文给出的一组延迟对比很有参考价值(同样的 prompt 集合,在 V100 上测量):
| 方法 | 输出表示 | 延迟 |
|---|---|---|
| DreamFusion | NeRF 参数(逐资产优化) | 约 12 V100 小时 |
| Point-E (300M) | 点云 | 1.2 V100 分钟 |
| Point-E (1B) | 点云 | 1.5 V100 分钟 |
| Shap-E (300M) | 隐式函数参数 | 1.0 V100 分钟 |
DreamFusion 是 2022 年的”SDS 优化”路线:不训练生成模型,而是对每个资产单独做 1–2 小时优化,从 2D 扩散模型里蒸馏梯度。Shap-E 的 1 分钟说明”前馈生成 + 隐空间扩散”在工程上明显更可行。同时也要看到,1 分钟里绝大部分时间花在 1024 步的扩散采样上——Shap-E 使用 DDPM 随机采样,步数远多于图像潜扩散常见的 20–50 步。
这个步数差异不是实现粗糙,而是由输出维度决定的:1024×1024 的 latent 比图像潜空间的 大 64 倍,每个 token 的信息密度低,轨迹误差更容易累积;加上隐式 MLP 参数的分布没有被预训练网络的先验”规整”过,少步采样更不稳。后续系统普遍改用 rectified flow 与更少的步数,这一点在 TRELLIS 一节会看到。
3DShape2VecSet:为扩散设计的形状表示
3DShape2VecSet 由 Biao Zhang 等人在 2023 年 1 月提出(ACM TOG 2023),它不直接研究生成,而是回答一个更前置的问题:什么样的形状表示既紧凑、又适合 transformer 处理?
它的答案是一组 latent 向量 (vector set)。给定任意查询点 ,解码器通过交叉注意力计算 与每个 的相关性,用这些相关性加权聚合 latent 特征,再经一个 MLP 输出占用概率:
这个形式与注意力机制完全一致——查询点是 query,latent 集合是 key/value, 是查询点的位置嵌入。于是”形状表示”和”解码器”被统一成同一个可学习模块。为什么这样设计比网格或体素更好?
- 紧凑: 通常取几百到一千,远小于体素的 ;
- 无序:latent 是一个集合,没有固定的空间网格,可以自由学习哪些 latent 负责哪些区域,避免了”每个格子对应一块空间”的 rigid 约束;
- 适合 transformer:编码器用交叉注意力把点云压成 latent,中间用自注意力在 latent 之间交换信息,解码器再用交叉注意力从 latent 插值出任意位置的场。整条链路都是注意力,没有任何卷积或体素运算。
Hunyuan3D 2.0(2025 年 1 月)的 ShapeVAE 就建立在这个思路上,并做了两个关键改进:
- 重要性采样:只在表面均匀采点会丢掉边缘和转角的信息,因为复杂形状的”信息密度”在棱角处更高。ShapeVAE 额外在网格的边和角上做重要性采样,用一组 query 做最远点采样(FPS),再通过交叉注意力压成 latent;
- 变长 token:不同复杂度的形状用不同数量的 latent,简单物体用更少的 token,省算力。
对推理侧来说,变长 token 是一个重要的设计决策:它意味着扩散模型的序列长度不是固定的,批内不同请求的 token 数可能不同,这会直接影响批处理的效率与内存分配。固定长度的实现通常把短 token 补齐到最长,代价是浪费算力;长度感知的实现则需要处理打包与注意力掩码。
隐空间扩散为什么比直接扩散更便宜
把 Shap-E、3DShape2VecSet、Hunyuan3D 放在一起看,它们的共同点是在 或 上扩散,而不是在 或网格顶点上扩散。这个选择带来的收益可以量化:
| 扩散空间 | 典型 token 数 | 自注意力复杂度() |
|---|---|---|
| 稠密体素 | 262,144 | |
| VecSet(Hunyuan3D ShapeVAE) | 1024 | |
| Shap-E latent | 1024 | |
| SLat(稀疏, 万) | 20,000 |
Shap-E 与 Hunyuan3D 的差异不在 token 数(都是 1024 量级),而在每个 token 承载什么:Shap-E 的 token 是隐式 MLP 的一行权重,解码时要把所有 token 拼回 MLP,再由 MLP 渲染;Hunyuan3D 的 token 是空间中的局部 latent,解码时要用交叉注意力在任意查询点上插值。前者的解码链路要执行完整 MLP(每个查询点一次前向),后者的解码是一个向量化问题(批量查询点一次前向)。这就是为什么后面”解码器成本”会成为 3D 推理的一个独立问题。
这一层解决了什么,又留下了什么
Shap-E 与 3DShape2VecSet 解决了”表示太松散”的问题:扩散输出的是一个能被解码成连续场或网格的紧凑 latent,不再有”点飘在表面外”的毛病。它们也证明了隐空间扩散在 3D 上可行。
但它们留下了一个新的矛盾:latent 与几何的对应关系是隐式的。一个 token 具体负责物体的哪一块,模型不告诉你;如果生成出来的角落有瑕疵,你无法直接定位是哪个 token 出了问题,也无法只重生成那一个 token。TRELLIS 的 SLat 就是针对这一点设计的:让每个 latent 显式地绑定到一个网格坐标。
第三层:TRELLIS 的结构化隐空间——坐标绑定的稀疏 latent
TRELLIS(Structured 3D Latents for Scalable and Versatile 3D Generation)由微软研究院与清华、中科大合作,在 2024 年 12 月发表。它的核心贡献不是新的扩散算法,而是一个新的生成空间:SLat(Structured Latent)。这一节拆解它为什么这样定义、两段式生成如何工作、以及这些设计在推理侧带来什么。
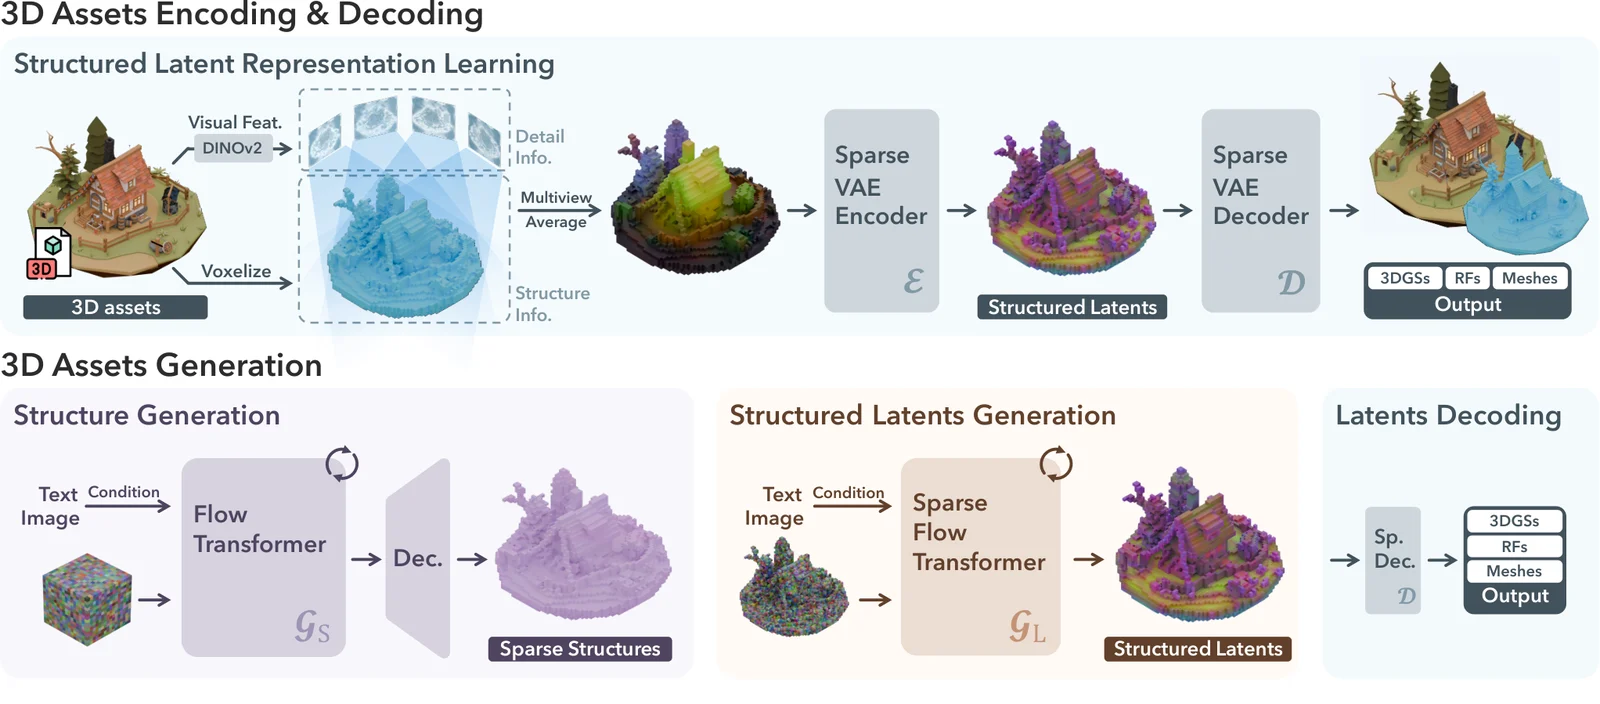
上图是 TRELLIS 论文的 Figure 2(Overview)。左上是编码:从多个随机视角渲染资产,用 DINOv2 提取特征,把每个激活体素投影到特征图取平均,得到稀疏体素特征,再用稀疏 VAE 压成 SLat。中间是生成:先用一个 flow transformer 生成”哪些格子有内容”(稀疏结构),再用另一个 flow transformer 生成”每个有内容格子里的 latent”。右下是解码:同一份 SLat 可以喂给不同的解码器,分别得到 3D 高斯、辐射场与网格。
定义: 比”一组向量”多了什么
SLat 的定义是:
和 3DShape2VecSet 的 相比,它多了一个坐标 。差别看似只是一个附加字段,实质却很大:
- 每个 latent 有明确的空间归属。 只描述 这个体素附近的局部几何与外观,模型可以学”这个角落该怎么画”而不是”整个物体该怎么画”。对 transformer 来说,局部性意味着可以用窗口注意力而不是全局注意力;
- “哪些位置有内容”成为一个独立的生成问题。物体只占空间的一小部分, 时 26 万个格子中平均只有约 2 万个被激活(K)。如果直接在 26 万个格子上扩散,绝大多数格子是”空的”,算力浪费在预测”这里什么都没有”上。把”选格子”和”画格子”拆成两个模型,每个模型只解决自己那一半问题;
- 编辑与变化有了落点。SLat 的论文演示了局部编辑:替换一栋建筑的屋顶,只需要改动屋顶区域的稀疏结构与局部 latent,空间坐标告诉模型改动应该落在哪。
这个设计同时也回答了一个问题:为什么 只取 64,而不是像体素方法那样追求更高的 或 ?因为每个激活体素不再只是一个占用位,而是携带一个 维的视觉 latent。latent 本身承载了细节,64 的分辨率只是”局部块的划分粒度”。TRELLIS 的消融(Table 3)显示:同样 8 通道, 只有 PSNR 31.85, 达到 32.74;而在 下把通道从 16 加到 64 只从 31.64 提升到 31.85。换句话说,增加空间分辨率比增加通道更有效,因为细粒度划分让每个 latent 负责的区域更小、拟合更准。
编码:DINOv2 多视图特征取代专用 3D 编码器
SLat 的编码过程分三步:渲染、采样、平均。
- 在球面上随机采样视角,渲染资产的稠密多视图(同时包含几何与外观信息);
- 用预训练的 DINOv2 编码每张视图,得到特征图;
- 对每个激活体素 ,把它投影到每张特征图上的对应像素,取所有视图的平均,得到 。
为什么选 DINOv2 而不是训练一个专门的 3D 编码器?论文的理由是:DINOv2 的视觉特征已经具备很强的 3D 感知能力,用它做特征提取,可以绕开”为 3D 设计专用网络、再与数据对齐”这一整套昂贵流程;同时多视图平均天然提供了对遮挡的鲁棒性——单个视角看不到的区域,会被其他视角补上。
这一步的代价也很明确:编码阶段要做一次多视图渲染 + 一次 DINOv2 前向。如果用户的输入本来就是一张图(图生 3D),这个编码开销并不存在,因为 SLat 是由生成模型直接产生的;但如果要做”图像编辑后的重生成”或”已有资产的格式转换”,这一步就会进入延迟账。这也是为什么在多数 3D 生成服务的延迟里,“条件图编码”是一个必须单独统计的固定开销。
稀疏 VAE:两个 VAE,各管一段
TRELLIS 有两个 VAE:
稀疏结构 VAE()。它的任务是把 的二值占用网格压成一个 、8 通道的连续 latent,供第一阶段 flow transformer 工作。结构上用的是带残差块和上下采样的 3D U-Net,刻意不使用自注意力——3D 卷积局部性强、显存友好,而结构任务是”判断局部是否有表面”,并不需要全局交互。训练目标被设成二分类问题(占用/未占用),由于占用格子稀疏,正负样本极度不平衡,用 Dice 损失比交叉熵更稳定。
这里有一个工程细节值得注意:把 的二进制网格压到 的连续 latent,相当于把每边缩小 4 倍,每个 latent 对应边长为 4 的一块空间。这个压缩比与图像潜扩散”8 倍下采样”是同一量级。第一阶段 flow transformer 只需要在 个 token 上工作——这是整个 TRELLIS 生成流程里最轻的部分,但它决定了后续 latent 的”空间布局”。
结构化 latent VAE。它把稀疏体素特征 编码成 SLat,并用不同的解码器把 SLat 解码到目标表示。这里的解码器有三个: 输出 3D 高斯、 输出辐射场、 输出网格。其中网格解码器在 SLat 上求解 SDF 网格,再用 marching cubes 提取三角网格。
结构化 latent 的主干:8³ 窗口的 3D 移位窗口注意力
第二阶段 flow transformer 在一个约 2 万 token 的稀疏集合上工作。2 万 token 的全局注意力虽然能算,但开销不小,而且——关键是——局部性本身就是可用的先验:一个体素的 latent 只需要和附近的体素交互,远处的格子对它的影响很小。
TRELLIS 因此把 空间切成 的窗口,每个窗口内部做自注意力,相邻层在窗口划分上做 的偏移,让跨窗口的信息能够传播。这正是 2D 图像里 Swin Transformer 的思想搬到 3D:窗口注意力把复杂度从全局的 降到 ,其中 是窗口内的 token 数。
代价是: 个槽位,但实际激活的 token 数量每个窗口不同,有的窗口只有几十个,有的几百个。变长的窗口注意力无法直接用一个规整的张量核实现——TRELLIS 的解法是用现代注意力实现(FlashAttention、xformers)直接处理变长序列。这个细节对推理实现很重要:你不能把它写成一个普通的 3D 卷积网络,也不能把它写成一个普通的 transformer 批处理,它需要一个”按窗口分组、变长打包”的调度器。
另外两个工程细节:
- QK 归一化:论文提到训练时 query 与 key 的范数会爆炸,所以在注意力前对 Q、K 应用 RMSNorm。这与 SD3 的处理一致,也与本站讨论过的稳定训练技巧同源;
- 稀疏卷积下采样/上采样:网格解码需要更高分辨率的 SDF 网格,结构生成需要更少 token,两者都需要在稀疏张量上改变空间尺寸。稀疏卷积的上下采样只处理激活位置,不会把空区域也铺满。
两段式生成:先结构、后内容
整个生成流程是串行两段:
| 阶段 | 生成对象 | 主干 | token 数 | 步数 | CFG |
|---|---|---|---|---|---|
| 阶段一 | 稀疏结构 | flow transformer ( latent 上) | 4096(稠密网格) | 50 | 3 |
| 阶段二 | 局部 latent | flow transformer (窗口注意力) | 约 2 万 | 50 | 3 |
为什么必须拆成两段? 核心原因是”哪些格子有内容”和”格子里的内容是什么”是两类完全不同的分布。前者是极度稀疏的、接近二值的结构信息;后者是稠密的、多样的细节信息。如果用一个模型同时生成,损失权重需要在这个极端不平衡下折中,训练会很难收敛。拆开后,每个模型只面对干净的分布;代价是两段串行,延迟相加,而且第二阶段的 token 数依赖于第一阶段的结果,调度时无法提前知道。
这也是 3D 生成与图像生成在推理上的一个根本差异:图像生成可以从头到尾只跑一个模型,latency 是”一个模型 × 步数”;TRELLIS 是”阶段一 + 阶段二”,中间的依赖意味着两个模型必须顺序执行,不能并行。如果再加一层,例如 Hunyuan3D 的纹理生成,延迟就会变成三段串行。
TRELLIS 的训练与推理细节:
- 主干规模有 342M(Basic)、1.1B(Large)、2B(X-Large)三档,最大一档用 64 张 40G A100 训练;
- 训练目标从扩散改为 rectified flow;消融(Table 4)显示,在第一阶段 rectified flow 的 CLIP 分数 25.40、FD 113.42,优于扩散的 25.09、132.71;第二阶段同样占优;
- 时间步采样分布从 SD3 的 改为 ,论文说后者更贴合它们的任务;这本质上是在调整训练时”噪声档”的取样偏好,和本系列第六篇讨论的时间步重参数化是同一类操作;
- 推理时 CFG 强度 3、采样步数 50。
这一段在成本上意味着什么
把 TRELLIS 的推理拆成固定开销与可变开销:
- 固定开销:文本或图像条件编码(CLIP 或 DINOv2),一次前向;
- 可变开销一:阶段一 flow transformer,4096 token × 50 步 × 50 步 CFG(CFG 通常把 batch 翻倍)——但它只有 4096 token,每步很轻;
- 可变开销二:阶段二 flow transformer,约 2 万 token × 50 步,窗口注意力让它比全局注意力轻得多;
- 解码开销:不同解码器差别很大。高斯解码器要为每个激活体素预测 32 个高斯,每个高斯约 59 个数,2 万体素就是约 640K 个高斯、约 3800 万个数;网格解码要在更高分辨率的 SDF 网格上做稀疏卷积,再 marching cubes。
这张账揭示了一个容易被忽略的事实:在 TRELLIS 里,“扩散部分”不是最贵的,“解码部分”才是。高斯数以几十万计,网格生成的 SDF 求解对每个网格顶点都要做一次查询。这就是为什么后面会讨论”解码器与网格提取”怎样成为独立的优化对象。
与站内内容的联系:窗口注意力与长序列注意力的取舍,和 NSA 稀疏注意力系列 里讨论的”局部窗口 + 稀疏选择”是同一类结构;而 CFG 的具体机制可以回看 扩散模型从零讲起(四):条件生成与潜空间扩散。
第四层:Hunyuan3D——向量集合、双流主干与纹理的第二条流水线
Hunyuan3D 2.0 由腾讯混元团队在 2025 年 1 月发布,2.1 版本在同年 6 月给出。它在生成空间上选择了与 TRELLIS 不同的路线:向量集合(vecset)而不是带坐标的稀疏 latent。这条路线带来的推理问题也不同——它不是”两段式生成”,而是”形状 + 纹理两条流水线”,并且解码器成为瓶颈。
ShapeVAE:用 1024 个 token 表达一个形状
Hunyuan3D-ShapeVAE 沿用 3DShape2VecSet 的思路,做了几处针对工程质量的改动:
- 输入:从网格表面采样的点云,带 坐标与法向量。法向量很重要——只给坐标,编码器很难判断表面朝哪一边,重建出来的细节会糊;
- 重要性采样:均匀采样在平坦区域浪费了大量点,而棱角、细边才是决定”像不像”的地方。ShapeVAE 额外在网格的边与角上采样,再对两组点分别做最远点采样得到 query,通过一层交叉注意力把点云压成连续的 latent token;
- 变长 token:不同复杂度的物体用不同长度的序列,论文里评测时统一按 1024 个 token 比较,训练时最大序列长可到 3072;
- 解码目标:解码器输出 SDF 值,再用 marching cubes 得到网格。
“输入法向量 + 重要性采样”这两点合起来解决的问题是:VAE 重建的瓶颈不在 token 数,而在输入信息是否完整。同样的 1024 token,如果输入只采了平坦区域,细节就无从重建。这是向量集合方法的一个普遍限制,也是后续工作反复改进的点。
Hunyuan3D-DiT:21 层、双流 + 单流、没有位置编码
生成主干 Hunyuan3D-DiT 借鉴 FLUX 的结构,由 21 层 transformer 组成,分为两类块:
- 双流块:latent token 与图像条件 token 各自使用独立的 QKV 投影与 MLP,只在注意力操作中交互;
- 单流块:两者拼接后一起经过空间注意力与通道注意力并行处理。
这个设计在系列第九篇讨论 MMDiT 时出现过:双流保留模态特有参数、单流促进深度融合。对推理来说,双流块意味着每一层的参数与 KV 缓存都翻倍(两套模态),单流块则合并为一份——层数的分配直接决定显存与算子数量。
最值得注意的设计是:latent 序列不加位置编码。论文给出的理由是,vecset 的每个 token 在序列中的位置并不对应 3D 网格中的固定位置,所以加位置编码反而引入错误先验;空间布局由 token 内容自己决定。对扩散模型来说,这意味着”某个 token 生成在哪个位置”是一个需要模型从全局信息中推断的结果,而不是通过索引直接指定。这和 TRELLIS 用坐标 显式指定位置的路线是两种相反的取舍:
| 维度 | TRELLIS 的 SLat | Hunyuan3D 的 vecset |
|---|---|---|
| token ↔ 空间位置 | 显式坐标 | 隐式,由内容决定 |
| 位置编码 | 有(体素坐标) | 无 |
| 表示能力 | 受 划分粒度限制 | 更自由,可分配 token 给复杂区域 |
| 注意力结构 | 窗口注意力(局部) | 全局注意力(token 只有 1024 量级) |
| 编辑落点 | 可按坐标局部修改 | 难以直接定位区域 |
两张表的差别揭示了一个本质权衡:显式坐标带来可解释性与局部编辑,隐式坐标带来表示效率与更自由的信息分配。两者都无法兼得,所以不同系统按应用场景选择。
条件编码用的是 DINOv2 Giant(输入 518×518),比 TRELLIS 的”DINOv2 多视图平均”更简单:一张图直接进 DINOv2,得到条件 token。训练目标是 Flow Matching,用的是最优传输(OT)路径:
网络预测速度场 ,损失为
推理时用一阶 Euler ODE 求解器从随机起点走到 。这个形式在本系列第五、六篇已经推导过:rectified flow 的直线路径让每步更新直接是”速度 × 步长”,不需要复杂的指数积分。
纹理:第二条扩散流水线
Hunyuan3D 2.0 的流水线是”先形状、后纹理”,图上的结构是 Hunyuan3D-DiT(形状)→ Hunyuan3D-Paint(纹理)。Painter 的机制与形状生成完全不同:
- 输入是一张参考图 + 一个无纹理网格;
- 先做去光照(delighting),把参考图转换成一个与光照无关的”unlit”版本,避免把原图的高光、阴影烘焙进纹理;
- 然后在多视角下用 2D 扩散生成纹理图;
- 生成后用双流图像条件:参考分支的时间步固定为 0,直接把原图特征(无噪声)注入,以保持输入图像的忠实度;同时固定原版 SD2.1 的参考网络权重,充当”软正则”把分布锚定在原模型上;
- 最后把多视角纹理烘焙回网格的 UV 空间,得到高分辨率贴图。
2.1 版本进一步把纹理从 RGB 扩展到 PBR 材质:同时输出 albedo、粗糙度(roughness)与金属度(metallic),依据 BRDF 模型从多个视角联合生成。PBR 的意义在于让生成资产能直接用在真实的渲染管线里,而不是”看起来像”就结束。
对推理侧来说,纹理流水线带来的是又一段串行开销:形状生成没有结束,烘焙就无法开始;烘焙需要网格与 UV 展开,并且图像分辨率越高,烘焙越贵。这使得 3D 资产生成的端到端延迟结构变成:
条件编码 → 形状 DiT(N 步)→ 网格解码(SDF + marching cubes)→ 去光照 → 多视角纹理扩散(N' 步)→ UV 烘焙其中形状 DiT 与纹理扩散是两段独立的扩散采样,步数与 CFG 各自独立。任何”端到端 1 秒”的说法,都必然包含了这两段都做了蒸馏与加速。
解码为什么成了瓶颈
Hunyuan3D 的 ShapeVAE 解码不是图像 VAE 那样的卷积解码,而是向量集合解码:给定一个查询点,用交叉注意力在 latent token 上插值出 SDF 值。要为整个体素网格算 SDF,就要对每个体素做一次交叉注意力。设目标网格分辨率为 ,体素数是 ,每个体素一次注意力(与 个 token 交互),复杂度就是 。
时 ,乘上 是 ——这个规模远超形状 DiT 本身。FlashVDM 论文指出:原 VDM 解码器中 99.9% 的计算集中在最后一层交叉注意力上,且被调用数以千万计。也就是说,“形状生成慢”的直觉是错的:采样步数多固然贵,但解码才是大头。
第五层:3D 高斯泼溅的扩散路径——从显式高斯的参数出发
前面几条路线都以网格或隐式场为目标,再转成高斯。另一条路线是直接生成 3D 高斯泼溅(3DGS)的参数。这条路线的动机很直接:3DGS 是当前最常用的资产表示(渲染快、编辑灵活),如果生成模型能直接输出高斯,就省掉了”网格 → 高斯”的转换与纹理烘焙。
3DGS 的参数结构与规模
一个高斯由中心 、协方差 (分解为旋转 与缩放 )、不透明度 与球谐颜色 组成。其中协方差必须保持半正定,所以通常不直接优化 ,而是优化 与 :
是四元数对应的旋转矩阵。用 参数化而不是用 6 个数直接参数化 ,是为了让梯度下降始终落在合法域内——直接优化协方差很容易产生非半正定矩阵,导致渲染时投影退化。
渲染时,每个高斯在给定相机下被投影成屏幕空间的二维高斯,然后按深度排序做 alpha 混合。排序这一步无法做成可微的反向传播,所以训练与推理都依赖”每帧重新排序”的光栅化器;对生成系统来说,这意味着”生成高斯参数”与”渲染高斯”是两个必须分开部署的组件。
为什么扩散高斯参数比看起来难
对 3DGS 参数做扩散,会遇到三个问题:
- 数量不固定。不同物体用几千到几百万个高斯不等。扩散模型需要固定长度的张量,怎么办?常见做法是固定一个数量上限(如 50 万),把数量作为条件变量;或者学一个”可见性掩码”,把无效高斯的不透明度压到 0;
- 尺度的强耦合。高斯的位置、大小、颜色在空间上是强耦合的——一个高斯位置错了,它的颜色与尺度也跟着错。直接对 59 个参数组成的向量逐维加噪,会把几何与外观混在一起,去噪难度很大;
- 无序性。和高斯泼溅的原始优化不同,生成出来的高斯没有”自然顺序”,但渲染排序需要顺序。生成模型不能依赖顺序,排序必须在渲染时做。
这三点的直接后果是:直接扩散完整 3DGS 参数的系统很少,主流做法是”扩散一个中间表示,再用解码器产生高斯”。TRELLIS 的 就是这条路径的典型:扩散的是 SLat,解码器为每个激活体素预测 32 个高斯,并按照 Mip-Splatting 的做法设置最小尺度 ,防止高斯退化成大而透明的一团。
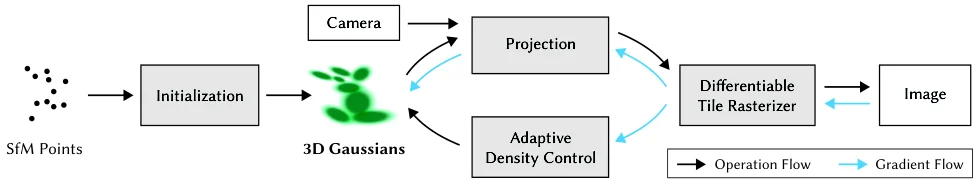
上图是 3D Gaussian Splatting 原始论文(Kerbl 等,2023 年)的 Figure 2。它说明为什么高斯表示被生成系统青睐:从稀疏点云初始化,经过可微优化与自适应密度控制(对重建不足的区域克隆、过度重建的区域分裂),就得到可实时渲染的一组高斯。生成系统希望”跳过优化、直接预测这组高斯”,这就是把高斯作为扩散输出空间的动机。
“直接生成”与”先生成再解码”的账
两种路线在推理成本上的差异可以这样算(以 50 万高斯、每个 59 个 FP16 数为基准):
| 路线 | 扩散空间 | 扩散成本 | 解码成本 |
|---|---|---|---|
| 直接生成高斯参数 | 50 万 × 59 的数 | token 数巨大,注意力不可行,需要固定数量的稠密生成器 | 无 |
| 扩散 SLat 再解码 | 约 2 万 token | 窗口注意力 | 2 万体素 × 32 高斯 = 64 万高斯预测 |
| 扩散 vecset 再解码 | 1024 token | 全局注意力非常轻 | 体素查询 + 高斯化 |
直接生成看起来省了解码,但它的扩散 token 规模根本不可行:把 2950 万个浮点数按 59 维一组当 token,也是 50 万个 token,注意力矩阵是 量级。用中间表示换取”扩散空间小得多、解码可以批量化”,是几乎所有 3D 高斯生成系统的共同选择。代价是解码器必须足够便宜——这就把问题引向了下一层的加速工作。
与站内内容的联系:高斯渲染的”排序不可微”与可微渲染的整体取舍,可以对照 动作条件世界模型完全拆解 里关于视频先验与渲染管线的讨论;而解码器”少算远场、多算近表面”的思路,与 扩散模型从零讲起(八):推理加速工程 的缓存判据一脉相承。
第六层:多视图代理路线——用 2D 先验绕开 3D 数据
原生 3D 扩散需要大量 3D 资产做训练数据,而 2D 图像扩散已经在数十亿图文对上训练过。多视图代理路线正是利用这一点:不训练 3D 生成模型,而是训练一个”给定一张图、生成同一物体其他视角”的 2D 扩散模型,再用这些视图重建 3D。这条路线在 2023 年主导了图像到 3D 的生成,也是理解”为什么后来大家又回到原生 3D”的关键。
Zero-1-to-3:把相对相机位姿变成条件
Zero-1-to-3(Liu 等,2023 年 3 月)微调 Stable Diffusion,让它接收三个额外条件:输入图像、相对方位角 、相对仰角 。训练数据来自 Objaverse 的渲染:同一资产在不同相机下的图像对,相对位姿已知。
它的关键设计是把”视角”表示成相对变换而不是绝对相机参数。这样模型学到的不是”这个物体在某个世界坐标下长什么样”,而是”从当前视角转到另一个视角,图像该怎么变”。这个表示带来很强的零样本泛化:即使输入是绘画或真实照片,模型也能生成合理的背面视图。
但 Zero-1-to-3 输出的是一组互不约束的 2D 图像。每个视角单独采样,视角之间的几何一致性没有保证;把它变成 3D,需要额外的优化过程(SDS):用一个 NeRF 或网格表示,对每个采样视角渲染、计算 2D 扩散的梯度、更新 3D 表示。这又回到了 DreamFusion 的老问题——逐资产优化,慢。
SyncDreamer:把多个视角放进同一个反向过程
SyncDreamer(Liu 等,2023 年 9 月)的核心改进是:不生成一张图,而是一次生成 16 张固定视角的图,并在每一步去噪时让 16 张图互相”看见”。
具体做法是把 16 个视角的噪声潜在变量组成一个批次,在 UNet 的每个分辨率层加入 3D-aware attention:先把每个视角的特征按相机参数投影到同一个 3D 体素空间,在体素空间做注意力,再投影回各视角。同时,所有视角的噪声在每一步都同步(同一时间步、同一噪声水平),这样反向过程建模的是联合分布 ,而不是 16 个边缘分布的乘积。
为什么”同步”重要?如果各视角独立采样,每个视角会各自收敛到一个”看起来合理”的解,但拼起来可能互相矛盾(比如正面是圆的、背面是方的)。同步去噪让它们在每一步都朝同一个共识移动。代价是:一次前向要处理 16 张图,显存与计算量是单视图的 16 倍;而且 16 个视角的注意力需要体素投影与反投影,不能直接用现成的 2D 注意力核。
MVDream:4 视角的轻量方案
MVDream(Shi 等,字节跳动,2023 年 8 月)选择了一个折中:只生成 4 个视角,图像分辨率降到 ,在 UNet 的自注意力层加入跨视角的 3D 注意力。论文明确指出:视角数越多,收敛越难,所以当前模型只用 4 个视角;同时把分辨率降到 256 对多视图一致性帮助很大,因为高分辨率下模型更容易”各画各的”。
MVDream 的定位不是直接输出 3D,而是作为 SDS 的多视图先验:优化 3D 表示时,一次渲染 4 个视角,用多视图扩散模型给出梯度。相比单视图 SDS,多视图先验显著改善了”雅努斯问题”(Janus problem,即模型给物体正面和背面都画上脸)。
DreamGaussian:2 分钟出资产
DreamGaussian(Tang 等,2023 年 9 月)把这条路线推到工程可用:输入一张图,先用 Zero-1-to-3 作为 2D 先验做 SDS,优化一个 3D 高斯表示;再通过高斯到网格的转换与 UV 纹理烘焙,得到带纹理的网格。论文报告:单张图 2 分钟生成带纹理网格,比既有方法快约 10 倍。
它的两阶段结构值得注意:
- 高斯优化阶段:SDS 梯度直接作用于高斯参数,收敛快(高斯是显式的,梯度路径短);
- 网格提取与纹理精修阶段:把高斯转成网格(用密度场 + marching cubes),再做 UV 展开与纹理烘焙。
这个”先高斯、后网格”的顺序,后来被很多系统沿用。它本质上把”几何”和”外观”解耦:高斯阶段只求几何大致正确,纹理阶段再用多视角渲染补齐细节。
多视图路线的成本与局限
| 方法 | 每步视图数 | 分辨率 | 3D 化方式 | 主要成本 |
|---|---|---|---|---|
| Zero-1-to-3 | 1 | 512 | SDS 优化 NeRF/网格 | 每资产分钟级优化 |
| SyncDreamer | 16 | 256 | 多视图重建 | 单步 16 倍显存 |
| MVDream | 4 | 256 | SDS 优化 | 单步 4 倍显存 |
| DreamGaussian | 1(Zero123 先验) | 512 | 3DGS + 网格 | 约 2 分钟/资产 |
局限也很清楚:
- 几何精度受限于 2D 先验。2D 扩散模型没见过真正的 3D 结构,它只能保证”每个视角看起来像”,不能保证”面是闭合的、法线是连续的”;
- SDS 的优化不稳定。SDS 本质是对每个资产做测试时优化,超参数敏感,不同资产的最优步数差别很大;
- 成本不可预测。原生 3D 模型的延迟是”固定步数 × 固定 token 数”,多视图优化是”迭代到收敛”,延迟方差很大——这在服务场景里很难做容量规划。
这三点合起来,解释了为什么 2024 年之后的主流系统(TRELLIS、Hunyuan3D、TripoSG 等)都转向原生 3D 扩散:不是多视图先验不好,而是它不适合做可预测、可批处理的服务。
第七层:解码器——从隐空间到网格的那一段
前几层反复出现一个数字:解码比生成贵。这一节把解码拆开,解释为什么它贵、贵在哪、有哪些加速手段。
网格提取:marching cubes 的复杂度
隐式场生成后,要变成可渲染的网格,最常用的算法是 marching cubes(Lorensen 与 Cline,1987 年):
- 把空间切成 个体素;
- 对每个体素,取 8 个顶点的符号(在表面内/外),得到一个 8 位编码(256 种情况);
- 用预计算的查找表确定这个体素内应该生成哪些三角形;
- 用顶点处的场值做线性插值,确定三角形顶点的精确位置。
复杂度是 :每个体素都要查表。 时是 1677 万个格子, 时是 1.34 亿个格子。对一个要在几百毫秒内返回的生成服务来说,这一步很容易成为 CPU 侧的瓶颈——尤其当实现是单线程或 Python 循环时。
加速手段有三类:
- 稀疏化:只在”表面附近”的体素上跑 marching cubes。FlashVDM 的 hierarchical volume decoding 就是这个思路:先在低分辨率(如 75)上解码 SDF,找出与表面相交的体素,再只在这些体素附近提高分辨率。它把查询数减少了 91.4%;
- 并行化:marching cubes 的每个体素互相独立,天然适合 GPU;但输出三角形的数量不定,需要 prefix sum 与流压缩(stream compaction)来分配输出空间。这是典型的 GPU 编程问题;
- 学习式提取:FlexiCubes 之类的方法把”提取”本身变成可学习的:为每个网格顶点学一个权重,让提取出的网格在保持拓扑的同时更贴合尖锐特征。它不需要在推理时跑传统的 marching cubes 查表,而是直接由网络输出网格,代价是训练阶段需要可微的栅格化。
向量集合解码:为什么 99.9% 的算力在一层注意力上
Hunyuan3D 的 ShapeVAE 解码属于另一类:不是卷积解码,而是对每个查询点做交叉注意力。一个查询点 要输出 SDF 值,需要与 个 latent token 计算注意力权重,再聚合它们的值。单次查询的复杂度是 。
要得到 个格子的 SDF,就是 次查询。FlashVDM 的分析指出:原 VDM 解码器中 99.9% 的计算集中在最后一层交叉注意力,因为这一层被调用了数千万次(每个网格查询一次)。这也解释了为什么 Hunyuan3D-2 的默认形状生成时间高达 34.85 秒——采样只占一小部分,解码占大头。
FlashVDM 的三项优化正好对应三个乘数:
| 优化 | 作用对象 | 效果 |
|---|---|---|
| Hierarchical Volume Decoding | 查询数 | 只在高分辨率解码表面附近,查询数减少 91.4%,解码 22.33s → 2.32s |
| Efficient Decoder | 每次查询的 FLOPs | 固定编码器、只微调解码器,单次查询 FLOPs 降低 76.6%,2.32s → 0.73s |
| Adaptive KV Selection | 每次查询的 | 只选与查询点最近的少量 latent token 做注意力,0.73s → 0.49s |
最终解码从 22.3 秒降到 0.49 秒,约 45 倍;端到端(含采样)从 34.85 秒降到 1.04 秒。这个案例说明:3D 生成的加速不能只盯着扩散步数。把采样从 50 步蒸馏到 5 步只能省 10 倍左右,而解码这一段的优化空间可能更大。
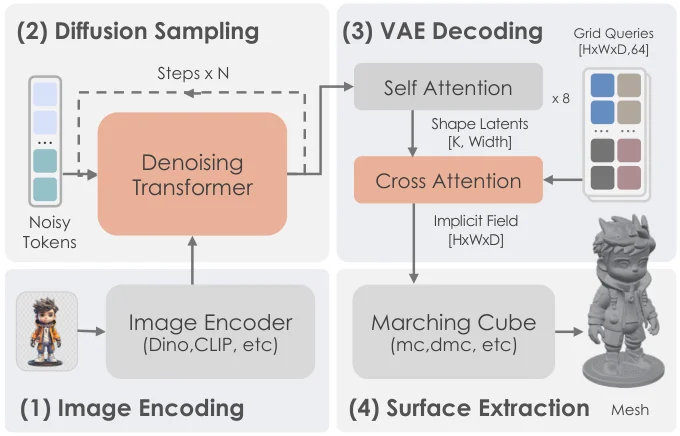
上图是 FlashVDM 论文的 Figure 3(VDM 的四个主要阶段)。它把一次形状生成拆成图像编码、扩散采样、VAE 解码与表面提取四段;解码阶段要对 的网格查询逐个做自注意力与交叉注意力,这正是”99.9% 算力”所在。理解这张图,就能理解为什么后续优化把重点放在解码器而不是采样器上。
Adaptive KV Selection 的依据是局部性:一个查询点的 SDF 只由附近区域的 latent 决定,远处的 token 贡献很小。FlashVDM 统计发现,对每个查询区域,真正有非零注意力的 token 只占少数;于是按空间距离选出最近的 个 token 做注意力,既省算力又几乎不掉精度。这与 LLM 推理里的稀疏注意力、KV 驱逐是同一类思想——只不过这里的”相关性”由 3D 距离直接给出,判据比语言模型更可靠。
学习式少步:FlashVDM 的渐进流蒸馏
FlashVDM 还把采样从 50 步压到 5 步,用的是 Progressive Flow Distillation,分三个阶段:
- Guidance Distillation:先把 CFG 蒸馏进学生模型,让学生在没有双倍 batch 的情况下复现带引导的教师输出;
- Step Distillation:用渐进式的一致性蒸馏,把教师的多个 ODE 步合并成学生的一步;
- Adversarial Finetuning:加一个判别器,用 hinge loss 修正蒸馏带来的”过度平滑”,让形状更锐利。
论文的消融给出两个重要结论:没有 Guidance Distillation 作为预热,蒸馏会失败;不用 EMA,性能会下降。这说明 3D 少步蒸馏比图像侧更脆弱——输出是几何,误差会直接体现为”面塌了”或”角变圆”,不像图像那样可以被纹理掩盖。
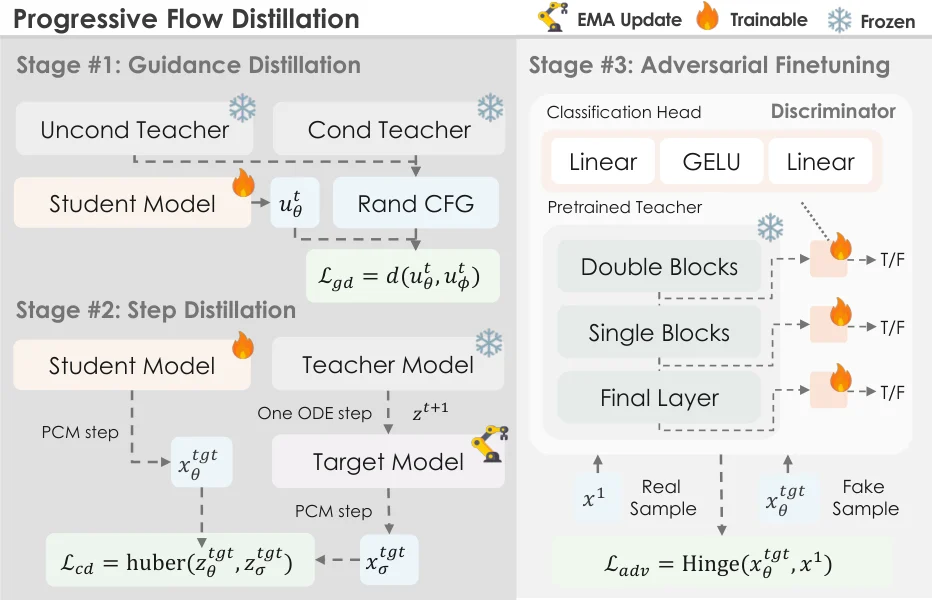
上图是 FlashVDM 论文的蒸馏训练管线(Figure 8)。三个阶段的顺序不能颠倒:先解决 CFG 的双倍开销,再压缩步数,最后用对抗损失修细节。图中同时标出了 EMA 更新与教师/学生的关系——这两点在论文的消融里都是”去掉就掉点”的关键组件。
第八层:一次 3D 生成请求的完整成本账
前面几层分别讲了表示、生成与解码。现在把它们合起来,算一次请求的账。这一节用公开论文里的实测数字搭一张表,再讨论服务层会遇到的调度问题。
公开系统的端到端延迟
不同系统的测量口径不完全一致(有的只算形状、有的含纹理、有的在 V100 有的在 A100),但量级对比仍然有意义:
| 系统 | 输出 | 测量硬件 | 延迟 | 备注 |
|---|---|---|---|---|
| Point-E (40M 基础) | 1024 点 | V100 | 3.35 s | 不含 GLIDE 的 46.28 s |
| Point-E (1B 基础) | 1024 点 | V100 | 28.67 s | 点数越多越贵 |
| Shap-E (300M) | 隐式函数参数 | V100 | 约 60 s | 1024 步 DDPM 采样 |
| DreamGaussian | 纹理网格 | 单卡 | 约 120 s | SDS 优化 + 烘焙 |
| TRELLIS (XL 2B) | SLat → GS/网格 | A100 | 约 7.3 s(2.1 报告的对照实测) | 50 步 × 2 阶段 |
| Hunyuan3D-2 | 裸网格 | A100 | 34.85 s | 含 VAE 解码 |
| Hunyuan3D-2 + FlashVDM | 裸网格 | A100 | 1.04 s | 5 NFE + 解码加速 |
| TripoSR | 网格 | A100 | 0.96 s | 前馈重建路线 |
| SF3D | 网格 | A100 | 0.21 s | 前馈重建路线 |
这张表最值得注意的不是”谁最快”,而是同一代系统内部的差距可以有两个数量级。Hunyuan3D-2 从 34.85 秒到 1.04 秒,靠的不是换模型,而是解码器与蒸馏;TRELLIS 的 7.3 秒已经包含两段 50 步采样,说明它的解码比 Hunyuan3D-2 的原始解码便宜得多。“3D 生成慢”这个判断必须落到具体阶段,否则优化会打错方向。
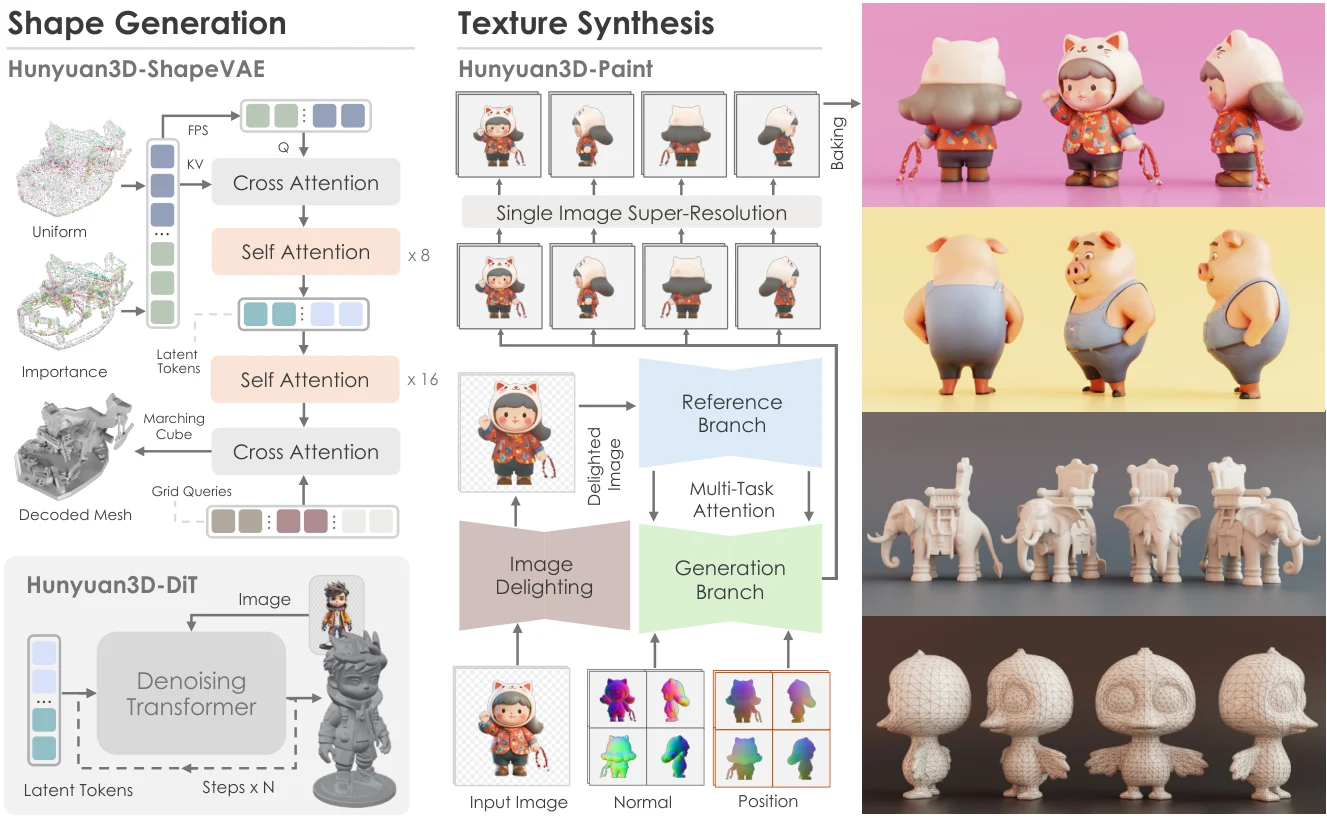
上图是 Hunyuan3D 2.0 论文的 Figure 2。上半部分是形状流水线:图像经 DINOv2 编码,进入 DiT 生成 vecset latent,再由 ShapeVAE 解码成网格。下半部分是纹理流水线:参考图去光照后进入多视图扩散,生成多视角纹理,再烘焙到 UV。两条流水线串行,各自有独立的采样步数——这就是”一次请求三段延迟”的来源。
把延迟拆成四项
对一个 TRELLIS 风格的请求,延迟可以拆成:
其中:
- :文本编码或图像编码。文本侧是 CLIP/T5 的一次前向,几十毫秒;图像侧是 DINOv2 Giant 在 518×518 上的一次前向,通常 100–300 ms;
- :稀疏结构 flow,4096 token × 步数 × CFG 倍数。以 50 步、CFG=3(cond 与 uncond 各一份、再加一份负条件,按 3 份 batch 计)估算,token-step 数是 ;
- :局部 latent flow,约 2 万 token × 50 步 × 3 ≈ token-step,是阶段一的 5 倍;
- :取决于输出格式。高斯解码要为 2 万体素各预测 32 个高斯;网格解码要在高分辨率 SDF 网格上做稀疏卷积与 marching cubes;
- :格式转换、压缩、上传。这部分常被忽略,但对”生成 100 MB 级资产”的服务来说,序列化与网络传输可能占几百毫秒。
用 token-step 数做粗略比较,可以解释为什么阶段二是主要采样成本;但它不能解释端到端延迟——如果解码占 60%,把阶段二砍一半也只省 20%。正确的做法是先测出四项的占比,再决定优化哪一项。FlashVDM 的价值就在于它先测出了”解码占 99.9% 的计算”,然后才动手。
服务层:三段流水线怎么调度
3D 生成服务与 LLM 服务有一个根本差异:请求不是”一个模型跑到底”,而是”多个模型按依赖顺序跑”。这带来三个调度问题。
第一,阶段之间无法并行,但不同请求之间可以。 请求 A 在阶段二时,请求 B 可以在阶段一做条件编码,请求 C 可以在解码。这就是流水线并行(pipeline parallelism)的思路:把不同请求放在不同阶段,填满每个阶段的算力。代价是显存要同时容纳多个阶段的模型——文本编码器、两个 flow transformer、VAE 解码器、纹理模型,全都常驻或频繁换入换出。
第二,阶段二的 token 数依赖阶段一的结果,无法提前分配。 稀疏结构生成完后才知道有多少激活体素,进而才知道阶段二的序列长度。调度器必须在阶段一结束时做一次”动态批处理”:把 token 数相近的请求打包,避免长短请求互相拖累。这与 LLM 的 continuous batching 思路相同,但打包点发生在流水线中间,而不是请求入口。
第三,解码是异构的。 高斯解码是 GPU 上的向量化计算;marching cubes 可能在 CPU 上跑;网格提取后的格式转换又是 CPU。一个请求在 GPU 与 CPU 之间来回切换,延迟里会出现”气泡”。好的实现会把解码尽量做成 GPU 端可微/可向量化的形式,或者把 CPU 段与下一请求的 GPU 段重叠。
一个具体的容量规划例子:假设单卡上阶段一耗时 100 ms、阶段二 400 ms、解码 300 ms,三个阶段各占一张卡(或同一张卡的时间片),那么流水线稳态吞吐约为 请求/秒/卡;但单请求延迟仍是 800 ms。吞吐由最慢阶段决定,延迟由所有阶段之和决定——这是 3D 生成服务与 LLM 服务共享的排队论结论,只是阶段数更多、依赖更硬。
少步与量化在 3D 上的特殊性
系列第七、八篇讲的少步蒸馏与 4-bit 量化,在 3D 上要重新评估:
- 少步蒸馏:FlashVDM 证明 5 步可行,但它的消融显示”没有引导蒸馏预热会失败”、“没有 EMA 会掉点”。3D 的几何误差没有纹理掩盖,少步更容易出现”面塌陷”。所以 3D 少步模型的上线评估必须包含几何指标(Chamfer、法线一致性),不能只看渲染图的 CLIP 分数;
- 量化:LLM 的 4-bit 量化主要影响语言质量,3D 的量化会直接影响坐标精度。高斯的中心坐标、网格顶点的位置对量化误差非常敏感——把坐标量化到 8-bit,物体表面会出现阶梯状抖动。安全的做法是对坐标与尺度保留更高精度,只对颜色/球谐系数做低比特量化;
- 缓存:视频扩散的跨步缓存依赖”相邻时间步特征相似”,3D flow 的时间步语义不同(从噪声到结构,中间会发生拓扑变化),缓存判据不能直接照搬。TRELLIS 的窗口注意力与阶段划分,本身就是比”缓存复用”更结构化的省算力方式。
第九层:评估——为什么 3D 的指标不能直接信
3D 生成的评估比 2D 难,原因不是指标少,而是指标与”资产能不能用”之间隔着一条鸿沟。
常用指标各自测什么
| 指标 | 测什么 | 盲区 |
|---|---|---|
| CLIP score | 渲染图与文本的语义匹配 | 不测几何,纹理好看就能刷高 |
| FD / FID(多视图) | 渲染图分布与真实分布的距离 | 依赖渲染设置与视角选择 |
| Chamfer Distance | 生成表面与参考表面的点距离 | 对拓扑错误不敏感,破洞可能得高分 |
| Volumetric IoU | 体积占用的一致性 | 需要水密网格,非水密资产无法计算 |
| LPIPS / PSNR | 重建视图的感知/像素误差 | 只测外观,不测可编辑性 |
| 法线一致性 | 表面朝向是否连续 | 对薄壁、非流形结构不友好 |
| 用户研究 | 人眼偏好 | 样本小、问题设计影响大 |
这些指标的组合能回答”看起来像不像”,但回答不了下面这些问题:
- 网格是水密的吗? 物理仿真、3D 打印、碰撞检测都要求水密。一个 Chamfer 分数很高的模型,可能输出大量非流形边;
- UV 是合法的吗? 纹理烘焙需要无重叠的 UV 展开。生成模型如果直接输出带纹理的网格,UV 可能是乱的;
- 尺度是真实的吗? 生成一个”杯子”,它到底是 8 cm 还是 8 m?多数模型不做绝对尺度回归,下游需要人工缩放;
- 能不能做碰撞体? 机器人规划需要凸分解。原始生成网格通常有几十万面,直接做凸分解非常慢。
资产可用性:一个被指标掩盖的维度
2026 年 10 月的 I2CD 工作把这个问题量化了。它冻结 Hunyuan3D-2 的图像条件 DiT 与形状解码器,只训练一个 3800 万参数的交叉注意力头,让模型直接输出 个凸多面体的半平面参数。结果是:
- 单个资产约 0.5 秒得到”物理引擎可直接加载”的凸分解,而”先生成网格、再做修复/简化/凸分解”的流水线要慢 6–37 倍;
- 在一个 20 个物体的杂乱场景里,I2CD 用 11 秒产出规划器可用的几何,最强基线要 328 秒;
- 在真实 xArm7 抓取任务上,成功率 85/100,基线 90/100——略低,但快了近 30 倍。
这个案例说明:3D 生成的”最后一公里”不是生成更漂亮的网格,而是生成下游能直接消费的表示。对具身智能、仿真、游戏来说,碰撞体、骨骼、PBR 材质、LOD 层级,每一项都可能需要独立的模型或后处理。评估体系如果不覆盖这些,就会系统性高估系统的可用性。
数据:3D 的稀缺是结构性的
2D 扩散能成功,靠的是数十亿图文对。3D 资产的最大公开数据集 Objaverse 约 80 万件,ShapeNet 约 5 万件、55 个类别;即使加上 Objaverse-XL 与合成数据,规模仍比图像小三个数量级。这带来两个后果:
- 模型必须大量依赖 2D 先验。TRELLIS 用 DINOv2 多视图特征、Hunyuan3D 用 DINOv2 Giant 条件编码,本质都是在”借用”2D 预训练模型的视觉知识;
- 长尾类别表现差。训练集中罕见的类别(精细机械结构、软体、透明物体)生成质量明显下降,而评估集往往以常见类别为主,指标会高估真实场景的表现。
这也解释了为什么”多视图代理路线”在 2023 年能成立:它绕开了 3D 数据不足的问题,直接用 2D 扩散的先验。而 2024 年之后原生 3D 路线回归,是因为 3D 数据规模与 2D 特征提取技术同时进步,让”在 3D 隐空间上扩散”变得可行。
局限与未解决的问题
三维扩散仍有几个没有收敛的方向:
一是拓扑与细节的权衡。 隐空间方法(vecset、SLat)擅长整体形状,但对薄壁、镂空、细小连接结构的重建仍不稳定。提高分辨率会增加 token 数,降低分辨率会丢细节;目前没有一种表示能同时满足”高保真、低 token、可编辑”。
二是材质与光照的解耦。 PBR 生成(Hunyuan3D 2.1)已经能输出 albedo/roughness/metallic,但生成结果与真实光照条件下的渲染仍有差距;去光照(delighting)本身是一个不适定问题,参考图里的阴影会被错误地当成材质。
三是动态与关节。 现有系统几乎都生成静态资产。带关节的物体(门、抽屉、机器人)需要”部件分割 + 关节轴预测 + 运动学约束”,这几步目前主要靠独立的模型或人工,端到端方案尚未成熟。
四是评估。 前面列的指标都无法覆盖”可仿真、可绑定、可编辑”,而这三项恰恰是 3D 资产在工业管线里的核心要求。建立一个覆盖资产可用性的基准,比再刷高 0.5 个 Chamfer 更有价值。
五是服务化。 多阶段流水线的调度、显存复用、跨阶段批处理,目前各家用各自的后端实现,没有像 vLLM 之于 LLM 那样的通用引擎。3D 生成的”推理框架”层仍是空白。
小结
把这一篇的机制压成几条判断:
- 3D 扩散的第一个决策是表征,不是模型。 点云、体素、隐式场、vecset、SLat、3DGS 的自由度与 token 数差几个数量级;表征决定了注意力能不能算、解码贵不贵、资产能不能编辑。
- 点云扩散证明了 3D 可以复用 2D 的数学。 Point-E 把点云当成 矩阵、去掉位置编码、用 CLIP 图像 token 做条件;它的成本大头其实在 2D 条件模型与上采样,而不是”3D 部分”。
- 隐空间扩散是 3D 的必经之路。 Shap-E 扩散隐式函数参数、3DShape2VecSet 用向量集合表示形状、Hunyuan3D 用 1024 token 的 vecset——它们都把 的体素问题压成 的 token 问题。
- 结构化隐空间把”位置”重新引入。 TRELLIS 的 SLat 用 让每个 latent 绑定一个体素坐标;两段式生成(先结构、后内容)+ 窗口注意力,把 2 万 token 的生成变得可算,也换来了局部编辑能力。
- 3D 的延迟结构是”多段串行”。 条件编码 → 结构生成 → 内容生成 → 解码 → 后处理,每一段都可能是瓶颈;Hunyuan3D-2 的 34.85 秒里解码占大头,FlashVDM 把解码从 22.3 秒降到 0.49 秒,端到端才到 1 秒级。
- 解码器是 3D 推理最被低估的一段。 vecset 解码的 99.9% 算力在一层交叉注意力上;marching cubes 是 ;高斯解码要为每个体素预测几十个高斯。优化顺序应该是”先测占比,再选手段”。
- 多视图代理是 2D 先验的借用,不是 3D 理解的替代。 Zero-1-to-3、SyncDreamer、MVDream、DreamGaussian 用 2D 扩散 + SDS 绕开 3D 数据不足,但延迟不可预测、几何一致性有限,不适合做可批处理的服务。
- 3D 评估的盲区是”资产可用性”。 CLIP/Chamfer/IoU 测不出水密性、UV 合法性、碰撞体可用性;I2CD 的例子说明,下游消费格式(凸分解)本身可以成为独立的生成目标。
- 这一层的工程判断:先确定输出格式(网格/高斯/GS + PBR),再倒推需要的表征与解码器;先测四段延迟占比,再决定蒸馏、量化、缓存用在哪;不要把 LLM 的 continuous batching 直接套到多阶段 3D 流水线上。
三维生成把扩散模型从”规则网格”带到了”任意表示”,也让推理优化从”一个模型”变成了”一条流水线”。下一篇会把镜头再拉近一层,讨论资产生成之后的事:纹理与 PBR 的烘焙成本、网格修复与简化、碰撞体与骨骼的生成,以及一条 3D 生成流水线如何真正交付成下游可直接使用的资产。
参考资料
- Point-E: A System for Generating 3D Point Clouds from Complex Prompts
- Shap-E: Generating Conditional 3D Implicit Functions
- 3DShape2VecSet: A 3D Shape Representation for Neural Fields and Generative Diffusion Models
- TRELLIS: Structured 3D Latents for Scalable and Versatile 3D Generation
- TRELLIS 项目主页(含交互演示与代码)
- Hunyuan3D 2.0: Scaling Diffusion Models for High Resolution Textured 3D Assets Generation
- Hunyuan3D 2.1: From Images to High-Fidelity 3D Assets with Production-Ready PBR Material
- Unleashing Vecset Diffusion Model for Fast Shape Generation(FlashVDM)
- FlashVDM 官方仓库
- 3D Gaussian Splatting for Real-Time Radiance Field Rendering
- Zero-1-to-3: Zero-shot One Image to 3D Object
- SyncDreamer: Generating Multiview-consistent Images from a Single-view Image
- MVDream: Multi-view Diffusion for 3D Generation
- DreamGaussian: Generative Gaussian Splatting for Efficient 3D Content Creation
- I2CD: Direct Image-to-Convex Decomposition for Simulation-Ready Collision Geometry
- Marching Cubes: A High Resolution 3D Surface Construction Algorithm(Lorensen 与 Cline,1987)
- Flexible Isosurface Extraction for Gradient-Based Mesh Optimization(FlexiCubes)
- Objaverse: A Universe of Annotated 3D Objects
- Objaverse-XL: A Universe of 10M+ 3D Objects
- FLUX.1 官方仓库(双流 + 单流 transformer 结构)
- Diffusers 库(Hunyuan3D pipeline 与 schedulers 实现)
图片来源:Point-E 模型结构图取自 Point-E 论文 Figure 3;TRELLIS 流程总览取自 TRELLIS 论文 Figure 2;3D Gaussian Splatting 概览取自 Kerbl 等人的原论文 Figure 2;Hunyuan3D 2.0 架构取自 Hunyuan3D 2.0 论文 Figure 2;VDM 四阶段图与渐进流蒸馏管线取自 FlashVDM 论文 Figure 3 与 Figure 8。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



