


扩散模型从零讲起(七):少步蒸馏——一致性模型、对抗蒸馏与轨迹蒸馏
写在前面:为什么采样步数是扩散推理最贵的那一维
前面几篇分别把扩散的生成链路拆成了几块:第一篇从 DDPM 的前向/反向过程讲到 DDIM、score matching、Flow Matching,第二篇把连续扩散搬到离散的掩码状态空间,第三篇从系统角度讨论 dLLM 的缓存与调度,第四篇讲潜空间扩散与条件注入,第五篇讲视频扩散时空注意力的结构与成本,第六篇则把”为什么 20 步就够”这件事落到采样器的数值细节上。
第六篇的结论可以浓缩成一句话:在一次纯扩散推理请求里,主干网络的前向次数(NFE,number of function evaluations)几乎是唯一的可调预算,步数减半,采样阶段的算力就减半。
这句话也同时指出了扩散推理最贵的那一维——时间轴上的重复调用。自回归模型生成 个 token 需要 次前向,扩散模型生成一张图需要 次(开启 classifier-free guidance 还要乘以 2,部分实现甚至乘以更多)。第六篇已经解释了为什么在 10–20 步区间里二阶采样器的边际收益会迅速衰减——那是”在固定模型上换求解器”能给的全部空间。如果还要继续往下压,就必须动模型本身:让一个模型不再沿轨迹一步步走,而是一步(或几步)直接落脚到终点附近。
这就是少步蒸馏(few-step distillation)要解决的问题。本篇按”动机 → 数学基础 → 各类方法 → 工程落地 → 局限”的顺序展开:
- 为什么换求解器的路走到 10–20 步就基本到头了,误差的下限在哪里;
- 一致性模型(Consistency Models)与它的连续时间、少步、潜空间变体,以及”不需要教师”的一致性训练;
- 分布匹配蒸馏(DMD/DMD2),它把蒸馏从”逼近轨迹”换成”逼近分布”;
- 对抗蒸馏(ADD、SDXL-Lightning)以及它的判别器设计;
- 轨迹蒸馏(Rectified Flow 的 reflow 与 InstaFlow)、多步蒸馏(Progressive Distillation);
- 蒸馏与 CFG、量化、部署形态的关系,以及一个请求延迟的实际账。
第零层:求解器的天花板在哪里
步数继续往下压时,误差从什么量级开始抬头
第六篇已经给出各采样器的局部误差阶:DDIM 是一阶(局部误差 ,全局 ),DPM-Solver 二阶/三阶分别对应局部 、。朴素地读这张表,会得出”三阶采样器在 5 步时应该仍然很准”的推论——局部误差阶数在形式上确实支持这一点。实际结果却远差于阶数预测,原因有三层。
第一层是轨迹本身不够直。DPM-Solver 的高阶项来自对半线性 ODE 的 Taylor 展开,误差常数里含有速度场的高阶导数。在噪声较大、模型预测不稳定的区段(例如 接近最大噪声的时间步),速度场相对于 -SNR 的变化非常剧烈。步长足够细时,这些剧烈变化被光滑化掉;步长一旦放大到覆盖这个区段,Taylor 展开的余项就不再小,阶数带来的优势会被巨大的常数吃掉。
第二层是网络本身的误差地板。即便求解器把 ODE 解得完全精确,它也只是在解”模型所定义的那条 ODE”。模型在训练时只见过有限噪声水平的样本,它的去噪输出与真实数据分布之间始终有一段差距。步数缩到 5 以下时,每一步要跨过很大的噪声差,网络在高噪声处一次预测就要承担相当于多次小步累积的信息量——它的预测误差会被直接放大成最终图像的偏差。第六篇”步数上限在哪里”一节已经讨论过这个地板:降步数只能逼近这个地板,不能穿过它。
第三层是guidance 的放大作用。CFG 的输出是 ,当 guidance scale 取 5–8 时,网络误差被放大 倍或更多。训练时在高噪声区学到的一点点偏差,在推理时会被 CFG 推成结构性的色块、过饱和和细节坍塌。这也是少步扩散最早出现的现象:步数一少,结果不是”模糊”,而是”崩坏”。
结论:降步数必须改模型,而不是改积分器
把上面三层合成一句话:在 10–20 步以下,瓶颈不再是数值积分精度,而是”模型是否被训练成能在一步之内跨越大噪声差”。
这句话定义了少步蒸馏的核心问题:给定一个已经在全部噪声水平上训练好的扩散模型(教师),如何得到一个新模型 (学生),使得从纯噪声出发只用 1–4 次 调用就得到与教师多步采样接近的样本。
后面每一类方法,差异都在这一个问题里有不同的”正确答案”:
- 一致性模型:让 在任何 上都输出同一条轨迹的终点 ,于是从任意噪声出发一步到位;
- Progressive Distillation:把 2 步教师变成 1 步学生,再反复套用,每次把步数减半;
- 轨迹蒸馏:让学生的轨迹尽可能”直”,直轨迹用大步长 Euler 就能近似;
- DMD:不去匹配轨迹的点,而是匹配每一步输出的分布;
- 对抗蒸馏:让判别器来定义”像不像真样本”,让学生的少步输出分布去骗过判别器,而不必逐点对齐教师。
下面逐一展开。
第一层:一致性模型——让任何时刻的点直达终点
出发点是概率流 ODE 的”流”
第一篇与第六篇已经把采样写成一条概率流 ODE(PF-ODE)。在 EDM 的记号里(第六篇第一部分讲过 EDM 的重参数化),它写成
其中 是网络给出的”去噪后的数据估计”, 是 EDM 的噪声水平参数(越大越糊), 是最大噪声水平。这条 ODE 从噪声 出发向前积到 0,就得到样本。
一致性模型(Consistency Models,Song 等人,2023 年,Consistency Models)的出发点是把这条 ODE 的所有轨迹看成一族曲线:给定一个初始噪声 ,ODE 唯一地确定了整条轨迹 。轨迹的终点是数据样本 。
一致性模型要学的函数是 ,它接收轨迹上任意一点,输出这条轨迹的起点:
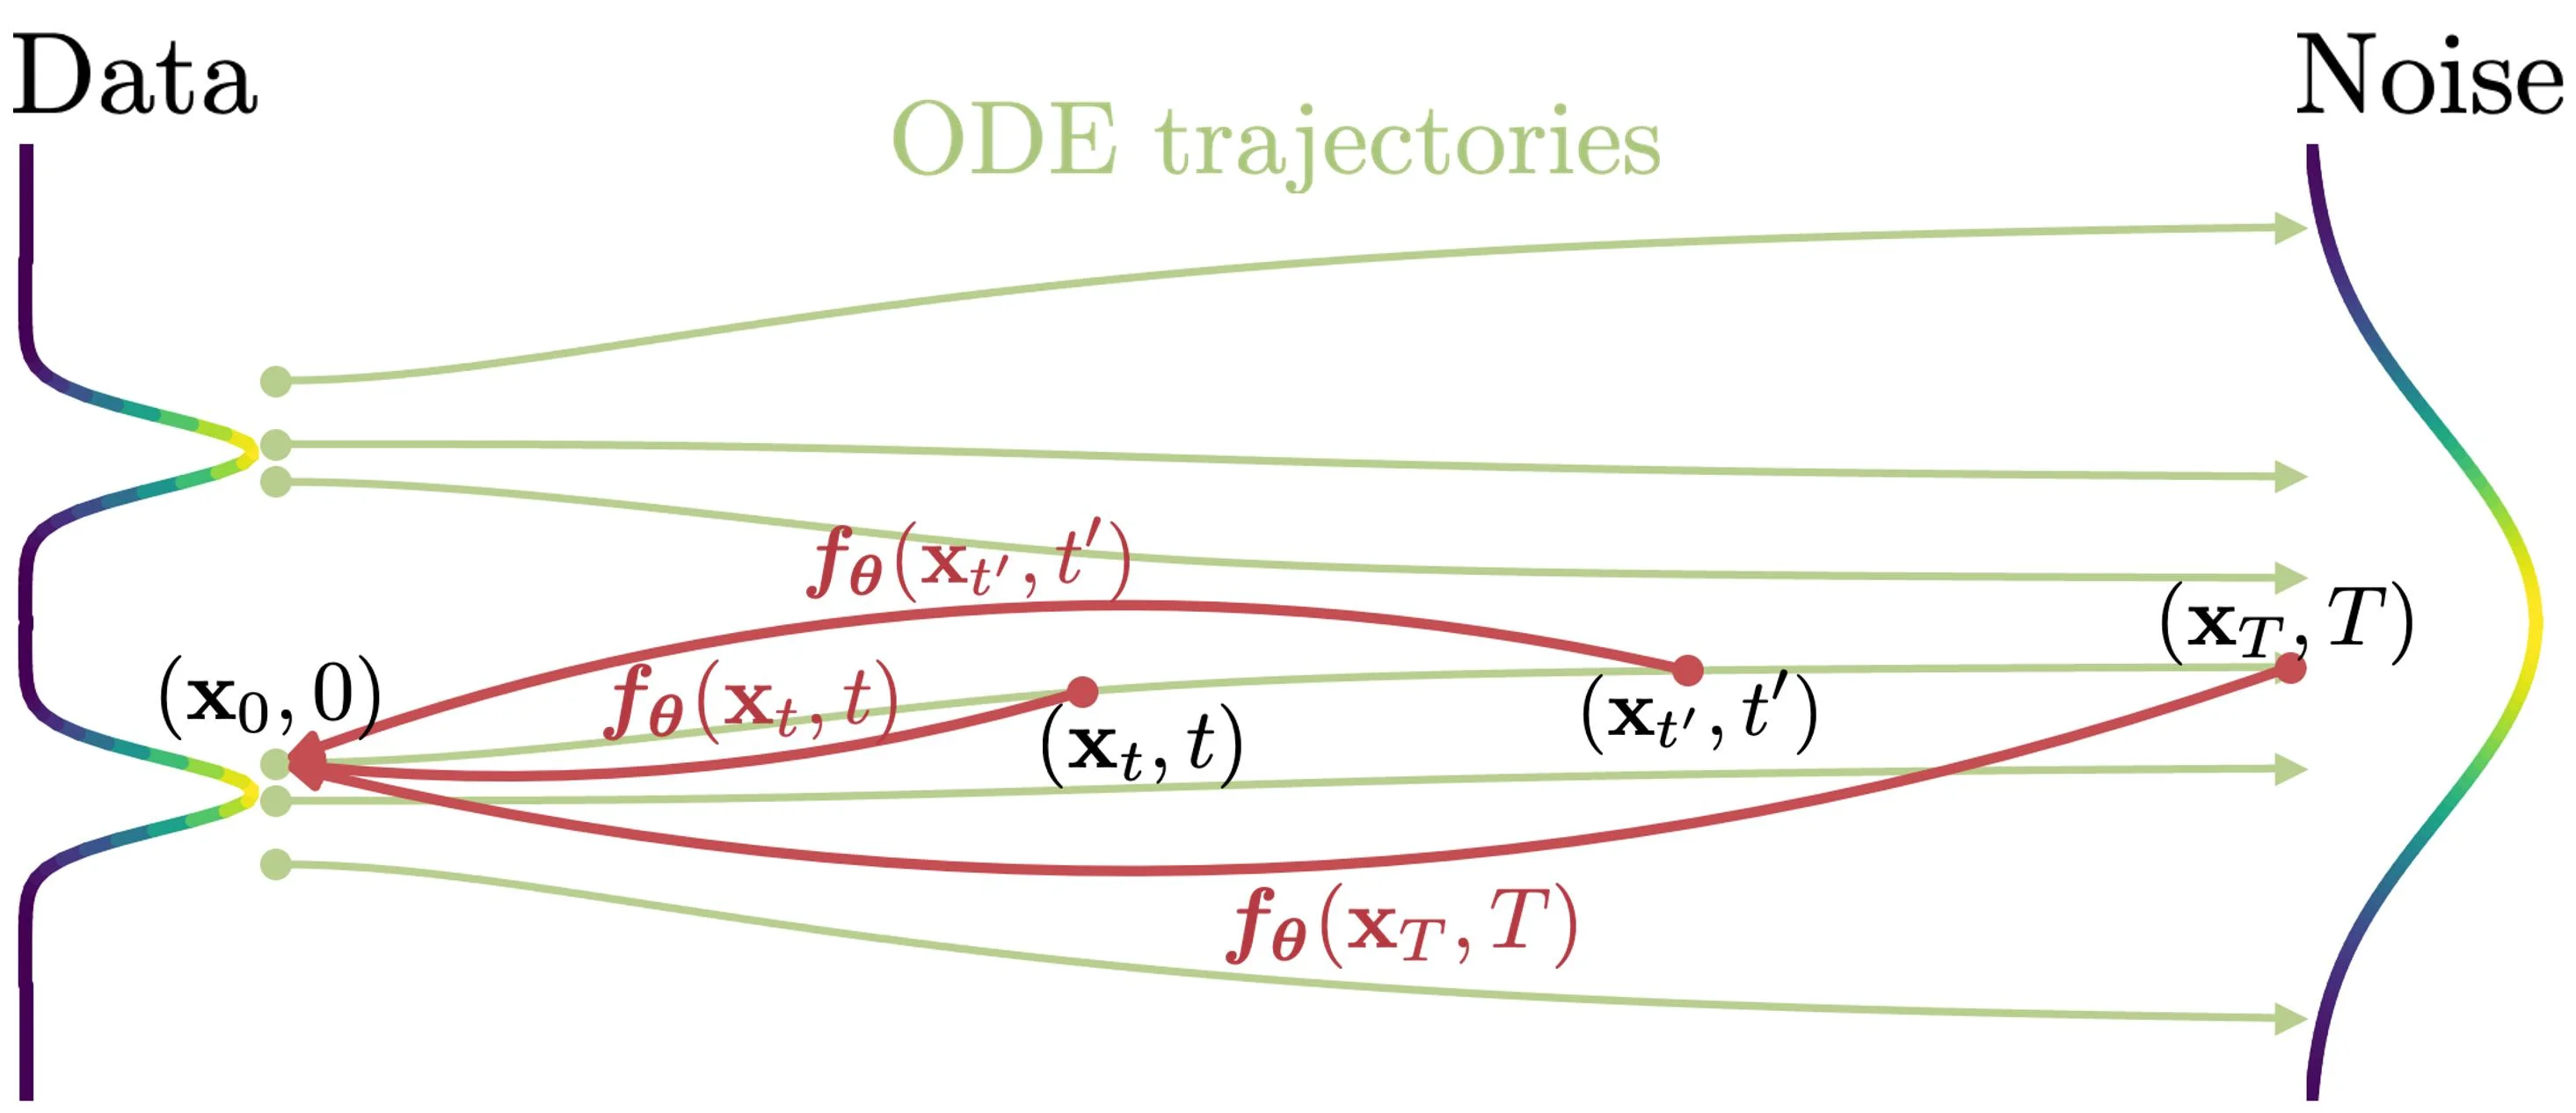
图出自 Consistency Models 论文 Figure 2。左侧是 ODE 从数据到噪声的若干条轨迹;右侧展示同一个训练好的 把 、、 三个时刻的点(以及一个新噪声 )都映射到各自的起点。注意右下角那条陌生噪声也能被映射——这正是”从纯噪声一步出图”的能力来源。
如果 精确满足这个条件,推理就极其简单:取 ,一次调用 就得到样本。一步采样。这就是一致性模型”1-NFE”的含义。
边界条件与自一致性:训练目标怎么来的
问题变成:怎么训练 而不需要知道”每个点属于哪条轨迹”?答案是两条约束。
第一条是边界条件:
在 时轨迹点就是数据本身,映射必须是恒等(EDM 实现里 常取 0.002,下文为了简洁写作 0)。实现上最常见的方式是参数化
其中 、, 是任意神经网络。这样 自动成立,无需额外约束。这与第六篇读到的 EDM 参数化是同一个套路——用系数把边界条件”焊死”进结构里,网络只学中间的残差。
第二条是自一致性(self-consistency):同一轨迹上相邻的两个点,映射出来的终点必须相同。离散时间版本对相邻时间步 定义
其中:
- 是任意一个噪声样本(从数据加噪得到,或直接取初值噪声);
- 是从 出发,用教师模型求解 PF-ODE 一步得到的下一点,即 ;
- 是 的 EMA 副本(与自回归模型里目标网络的做法同源),目标是冻结的;
- 是距离度量,常见取 。
中的 CD 是 consistency distillation。直觉是:如果 在两点都输出终点,那么它在这两点输出必须一致;而 由教师 ODE 步给出,所以学生实际上被锚定在教师的轨迹上。这里”EMA 目标 + 同一轨迹相邻点”的结构与自回归里的”学生-目标”蒸馏形似,区别是不再有”逐 token 交叉熵”而是”整幅图的终点一致”。
连续时间极限:为什么”切线”是核心
离散版本有一个内在缺陷: 总是通过数值求解器得到,步长 越大,它与真实轨迹的偏差越大。当步长很小时,可以用一个恒等式把一致性损失写成连续形式。Song 等人在原论文 Remark 10 里指出:取 、令 , 对 的梯度趋近于
其中 是目标函数沿 ODE 轨迹的全导数:
这里 是对输入求雅可比、 是对时间求偏导、 就是 PF-ODE 的速度场。这一项正是 沿轨迹方向的切线导数——它衡量的是”沿着 ODE 走一小步,映射输出会怎么变”。自一致性要求这个变化量为零(两点映射到同一点),所以损失推动 抵消这个切线变化。
sCM(Simplifying, Stabilizing and Scaling Continuous-Time Consistency Models,Lu 与 Song,2024 年)把这一点说得更明确:连续时间一致性模型不需要任何 ODE 求解器,因为它直接沿轨迹的切线方向做无穷小步,从而避免了离散化误差。代价是切线项本身需要计算雅可比-向量积(Jacobian-vector product,JVP)。
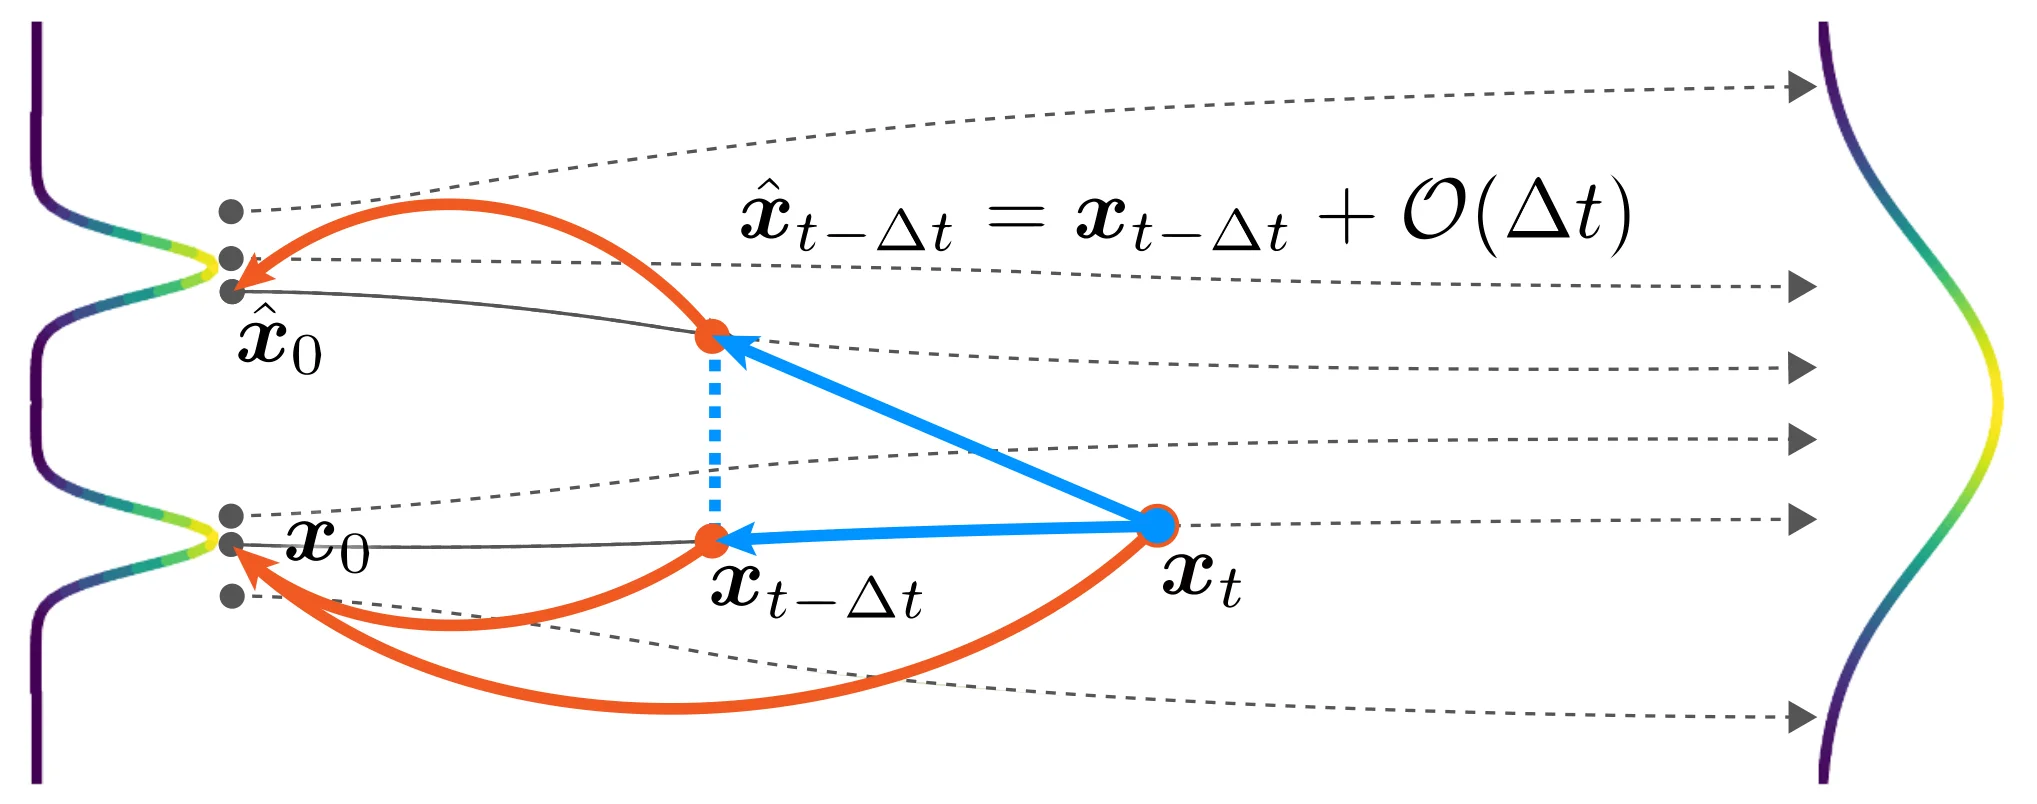
上图是 sCM 论文的 Figure 3:上半部分离散时间 CM 需要调用数值 ODE 求解器从 逐步走到 ,误差随步长累积;下半部分连续时间 CM 用 与 之间的切线公式直接构造训练信号(方向取决于把 ODE 写成”噪声到数据”还是反过来,写成 与 等价), 时成为精确的无穷小步。图里的公式 "" 表示的正是离散化误差随步长一阶消失。
图中的公式用文字复述一遍:连续时间版本的核心是一个”切线恒等式”——把 沿 ODE 的一阶展开与”零自一致性”联立,就能在不知道终点的情况下构造训练目标。sCM 论文把它整理为 的稳定化形式,并改写权重与参数化以避免训练发散。
sCM 把连续时间训练”修”成了可用
连续时间一致性模型在 Song 2023 年提出时只是理论上的极限,实践中训练极不稳定。sCM 的贡献集中在三处,每一处都对应一个具体的数值问题:
其一,参数化统一(TrigFlow)。 sCM 引入 TrigFlow 框架,用角度变量 表示噪声水平,令 、,前向过程是
这就是第一篇讲的”旋转坐标”视角:数据与噪声被投影到单位圆上, 从 0(纯数据)走到 (纯噪声)。在这个坐标系下,EDM、Flow Matching、速度预测三种参数化都可以等效变换到同一形式——sCM 论文附录 B 给出的推导正是第六篇里”换一套参数化、公式几乎不变”的再确认。TrigFlow 的好处是边界条件 与切线公式的形式都变得更对称,雅可比项的结构更规整。
其二,JVP 重排与数值精度。 切线项 需要对网络输出做关于 (输入, 时间) 的 JVP。直接对整条网络做 JVP 在 FP16/BF16 下会被误差放大——sCM 论文报告了 JVP 重排与注意力计算精度的问题,并给出了内存高效的实现方式(把 JVP 分解到注意力层,保留稳定的计算顺序)。这与第五篇里”8-bit 注意力比 8-bit GEMM 难得多”是同一类问题:对输入做求导的算子对低精度更敏感。
其三,稳定化训练目标。 原文指出,直接使用连续时间 CM 的目标会出现训练发散;sCM 通过重新加权 、调整梯度缩放,并证明这些修正后训练目标在噪声水平上的尺度是可控的。sCM 实验的结论是:在 ImageNet 512×512 上,用 sCD(一致性蒸馏)得到的 2 步模型在相同有效采样算力下与教师多步采样的 FID 可比;而 sCT(一致性训练,不依赖教师)能从头训练出 2 步生成模型。这里要分清两个概念:
- sCD / consistency distillation:有教师(预训练扩散模型),用教师 ODE 构造训练信号;
- sCT / consistency training:没有教师,用”从数据加噪”构造训练样本,模型是独立的生成器。
后者的价值在于不依赖教师模型、可以独立从头训练,但它收敛通常更慢,且原文也报告了 sCT 在潜空间上的效果弱于 sCD(图例里”is less effective than sCD in latent spaces”)。原因不难理解:潜空间里 VAE 编码器已经把数据分布变得偏离高斯很远,没有教师提供的”真实轨迹”时,训练信号只能靠有限样本的统计。
LCM:把一致性模型做进潜空间
一致性模型一开始在像素空间上训练(CIFAR-10、ImageNet 64×64)。真正进入工业场景的是潜空间版本——潜一致性模型(Latent Consistency Models,LCM,Luo 等人,2023 年)。第四篇讲过潜空间扩散的结构:VAE 负责压缩,扩散在 latent 上进行。LCM 的改动正是把一致性蒸馏架在这个结构上。
LCM 的关键观察是:CFG 引导下的采样过程可以看成一条增广的概率流 ODE——把条件与无条件两条支路合并成一个增广状态,ODE 的速度场由 定义。LCM 直接在这条增广 ODE 上做一致性蒸馏,于是学生模型在 2–4 步内就包含 guidance 效果,推理时不再需要每步跑两次前向。这解释了为什么 LCM 系列模型常常在 4 步就能生成可用图像,而不是 8 步:一次 NFE 已经等于”带 guidance 的一次 NFE”。
LCM 论文报告的口径值得记住:从预训练 CFG 扩散模型蒸馏出一个 768×768 的 2–4 步 LCM,训练只需要 32 个 A100 GPU 小时。这个数字说明了少步蒸馏在工程上的”轻”——与从头训练一个图像模型相比,蒸馏的算力开销很小,主要成本在数据与训练稳定性调参,而不是规模。
对部署最有影响的变体是 LCM-LoRA(Luo 等人,2023 年末)。LCM-LoRA 把一致性蒸馏的参数做成低秩适配器(LoRA),可以插在任何 SD 系列主干上,不改变原模型权重;插上后把步数压到 4–8 步。第五篇视频蒸馏一节也提到过:图像侧常见 LCM-LoRA 这种可插拔形态,视频侧则多是全量蒸馏权重,因为视频模型对步数更敏感、对质量退化也更敏感。原因在于:low-rank 适配器能改变的”轨迹映射”幅度有限,图像侧从 20+ 步压到 4 步时剩余误差能被结构容忍,视频侧多帧一致性对小误差更敏感。
多步一致性:一步质量不够时可以”用两步换质量”
一致性模型有个内在的灵活性:它不仅仅是”一步采样器”,也可以当”多步少步采样器”用。做法是把区间 切成 个点,从 出发先用 得到轨迹起点 ,再重新加噪到 ,继续……每一步都是一次一致性映射。这样每多一步就能减少一部分跨大噪声差的误差。
实践上,1 步 LCM 往往有细节缺失、纹理偏软;2–4 步质量显著提升,这与 ADD 论文的观测是同一个现象(ADD 论文图 4 展示了同模型 1、2、4 步的明显质量变化)。因此工业部署中常见的形态是”蒸馏到 4 步 + 保持 CFG 蒸馏后的 guidance 不变”,而不是激进地 1 步。
第二层:Progressive Distillation——每次把步数减半
一致性模型走的是”绕开轨迹”的路线。更早、也更直观的一条路线是多步蒸馏(Progressive Distillation,Salimans 与 Ho,2022 年,Progressive Distillation for Fast Sampling of Diffusion Models):既然教师用 步能到达终点,那就训练一个学生,让它用 步到达同一个终点;再把这个学生当作教师,重复一遍得到 步;如此反复,直到 1–4 步。
一步蒸馏的构造
核心是一个局部问题:把教师的两小步合并成学生的一大步。
设教师的一步更新为一次 DDIM 式更新,把 映射到 的两次调用构成一个函数 。学生用大步长 从 直接到 。训练损失是
其中 是真值,不需要梯度——它就是教师从 出发走一步的结果。学生的一次前向要预测两步累积的信息量,因此它是”在同一个噪声水平上被要求预测更远的下一站”。
与普通扩散训练的区别非常清晰:普通扩散模型在任意 上预测”往 走一步的噪声/速度”,而蒸馏学生被要求在 加倍的情况下预测同一个终点。一旦训练完成,旧网格上的两步变成新网格上的一步,时间网格整体减半,然后进入下一轮。
为什么它需要”重新参数化”才稳
Progressive Distillation 论文的另一个贡献是新的参数化。原文指出,当步数很少时,标准的噪声预测参数化(-prediction)会出现不稳定:在 接近 0 的几步里,网络预测的噪声对最终样本的贡献被 的比值放大,少量误差就能把像素推到饱和区。
论文给出的替代参数化之一是 -prediction:
其中 、 是前向过程的系数(第一篇里 )。 同时包含”噪声方向”与”数据方向”,在噪声水平的两端都不会退化。直观上:
- 高噪声端():,它主要携带”数据往哪走”的信息,比噪声预测在此处更稳定;
- 低噪声端():,退化为噪声预测。
-prediction 后来在 SD 2.x 与许多蒸馏工作里成为默认选择,原因就在于它对”少步 + 大跨步”更耐受——大步长的更新里, 的误差不会像 那样在低噪声端被放大成颜色偏移。
渐进式的代价与收益
渐进式蒸馏的代价是训练要串行:必须先得到 步学生才能训练 步学生,每一轮都需要一个教师模型的 ODE 轨迹作为标签。论文报告的是从数百步(CIFAR-10/ImageNet 等)逐步降到 1 步;在 Stable Diffusion 上则从 50 步降到 4 步,在 4 步范围内质量下降可控。
收益在于过程完全可解释、可复现,而且每一步的误差来源都很清楚——每次减半都是”用一次前向替代两次前向”,学生只会累积这一级的误差。它不涉及判别器、分布匹配这类训练稳定性的难题,因此适合”已经有充足教师轨迹标签”的场景。
它的局限也很直接:串行带来的多轮训练开销,以及最后一轮(从 2 步到 1 步)误差最难消解——因为最后一步要跨越的噪声差最大,而教师在 2 步时的轨迹本身并不”直”,学生一步之内没有办法完全复刻它。这解释了为什么后续方法(DMD、ADD)都选择直接在 1 步上训练,而不是从多步往下逐级削减。
第三层:轨迹蒸馏——先把轨迹拉直再压缩
Rectified Flow 的 reflow
第一篇的 Flow Matching 部分讲过:流模型的条件速度场是 ,沿此速度走的轨迹是从 到 的直线(在配对好的 上)。问题在于边际速度场:训练时我们用随机的 配对,学到的边际速度沿着每个点的期望方向,实际采样轨迹并不直——它弯曲的程度取决于噪声与数据之间的耦合。
Rectified Flow(Liu 等人,2022 年)的 reflow 步骤给出一个朴素而有效的修法:用已经训练好的模型自己的确定性采样轨迹重新配对。
具体地:
- 用当前模型(教师)从 出发,以 Deterministic Euler 多步采样得到 ;
- 把这对 存下来,作为新的训练配对;
- 用这对新配对重新训练一个流模型,它的边际速度场就是”沿着旧模型轨迹的方向”。
第 2 步之后,旧轨迹上每个中间点的速度方向被”直线化”了: 被强制配对成一条直线上的两个端点,训练时模型学到了这条路。这就是”直”的来源。
数学上,reflow 的思想可以这样看:第一轮模型里,点 的速度是”所有可能的 配对在 上的条件期望”,这个期望会因为配对不唯一而偏离”点到端点连线”的方向;reflow 把配对唯一化之后,条件期望就向连线方向靠拢。重复多次(reflow 2、3)会让轨迹进一步变直,但收益递减。
InstaFlow:把 reflow 用在文生图上
InstaFlow(Liu 等人,2023 年,InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image Generation)把这一路线放到 Stable Diffusion 上:先对 SDXL/SD1.5 做 reflow(用教师的轨迹重新配对训练),让轨迹变直;再直接用 Euler 一步采样。由于轨迹已经接近直线,一步 Euler 就能近似整条路径。
InstaFlow 的核心难点在于文本条件。图像侧的 reflow 比较简单:配对是 ;文生图里每个噪声都被一个 prompt 条件化,必须保证 reflow 的配对保持文本条件一致——否则学生会把”鸟”的 prompt 配到”车”的轨迹上。它的解法是把配对过程写成”给定 prompt 的确定性采样”:让教师按 prompt 生成轨迹,噪声、轨迹终点与 prompt 三者作为一个三元组一起进入 reflow 训练,配对因此是条件一致的。
InstaFlow 的结论与后文对抗类方法对照很有意思:它证明”1 步能生成有结构的图像”是可达的,但纹理细节需要额外手段。这也是后续 DMD、ADD 都要加判别器或分布项的原因。
第四层:分布匹配蒸馏——不追轨迹,只追分布
DMD 的核心:把蒸馏变成 KL 最小化
DMD(Distribution Matching Distillation,Yin 等人,2023 年)改变的是优化目标本身。一致性模型与渐进式蒸馏都在要求”学生输出接近教师的某个点”,DMD 不要点的对应,只要输出分布一致:
其中 是学生生成的数据经前向扩散到时间 后的分布, 是教师数据经前向扩散到时间 后的分布, 是时间权重。直接算 KL 不行(两个分布都没有闭式),但 KL 对生成参数的梯度可以写成两个 score 函数之差。DMD2 论文把它写成( 表示”学生从噪声 生成样本后、再前向扩散到 ”):
注意 KL 的方向是 (学生分布在前),梯度前有一个负号。这决定了实际更新的方向:若某点处真实 score 比 fake score 更”指向高概率区”,梯度下降就会把学生样本往该方向拉动,使 fake 分布向 real 分布靠拢。
score 与去噪预测之间的关系是第一篇”score matching”一节的直接对照。DMD2 论文给出的恒等式是
其中 、 是前向过程的系数, 是教师网络在该点的去噪估计(预测”原图是什么”)。fake score 用同样的公式、把教师换成一个在线训练的辅助模型。这一形式正是 sCM 论文里提到的 VSD(variational score distillation)思想的复用。各符号的含义:
- 是教师模型在每个扩散时间步的 score(等价于教师的去噪预测);
- 是一个用学生当前生成样本在线训练的辅助扩散模型,用来估计学生分布 的 score;
- 通过学生生成器的反向传播得到。
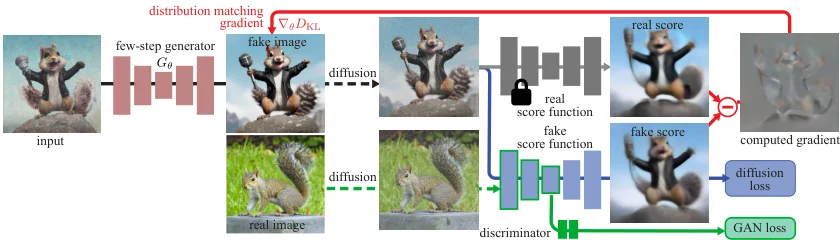
上图是 DMD2 论文 Figure 3 的简化管线:左侧是一个”一步生成器” (灰色块是初始噪声,红色块是教师模型),它从噪声出图;中间的”分布匹配梯度”由 real score function(教师)与 fake score function(在线训练的辅助扩散模型)之差算出;下侧分支是 GAN 损失,用真实图像与生成图像训练判别器;右上角的 diffusion loss 用于维持辅助扩散模型对新生成样本的建模能力。
读这张图要抓住三个要点:
其一,DMD 的”教师”其实在每一步都参与了梯度计算。 辅助的 fake 扩散模型只负责估计学生分布,教师才是”真分布”的锚点。因此一次训练迭代要算两个扩散模型的前向(教师与 fake),再加判别器,训练成本虽然远低于从头训练教师,但比一致性蒸馏更重。
其二,GAN 损失的加入。 原始 DMD 只用 KL,结果容易出现模式覆盖问题——学生学会了”生成平均样本”,但对多样性的分布尾部覆盖不足。DMD2 加入判别器损失(右下角)来补足分布尾部:判别器迫使生成样本与真实图像在判别器的高频特征上一致,而 KL 项负责让整体分布匹配。这相当于把”逐像素逼近教师轨迹”换成”逐判别器特征逼近真实图像”。
其三,DMD2 去掉了回归损失。 DMD 论文为了稳定训练,额外加了一项”学生输出与教师多步采样结果逐点回归”的损失,需要预先生成大量噪声-图像对。DMD2 的改进是把这项去掉,靠两阶段训练、GAN 引导与更细致的 fake 模型更新节奏来替代。去回归损失的好处是学生不再被”教师轨迹”绑死——它可以把训练质量重点放在”分布匹配”而不是”路径匹配”上。
DMD 与一致性模型的本质差异
| 维度 | 一致性模型 | DMD |
|---|---|---|
| 优化目标 | 同一轨迹相邻点的映射一致 | 学生分布与教师分布的 KL |
| 需要教师轨迹标签吗 | 需要(ODE 步) | 不需要(只要教师的 score) |
| 是否需要判别器 | 否 | DMD2 需要 |
| 每步训练成本 | 教师前向 + JVP(连续时间) | 教师 + fake 模型双重前向 |
| 一步质量 | 中等(纹理偏软) | 高(DMD2 视觉质量接近教师) |
两种方法没有谁绝对更优。一致性模型在”训练成本低、可插拔”上有优势(LCM-LoRA 就是明证),DMD 在”一步质量的极限”上有优势。
MeanFlow:一个”没教师”的新方向
MeanFlow(Geng 等人,2025 年,Mean Flows for One-step Generative Modeling)值得单独提一句,因为它说明少步蒸馏已经不再是”必须先有教师”的路线。MeanFlow 把流匹配从”瞬时速度”扩展到”平均速度”:
即从时间 积分到 的平均速度(论文用 表示轨迹上的点, 是目标时刻,取 就是”平均到终点”)。若能直接学到这个平均速度,从 一步沿它走到 就精确了。
MeanFlow 的关键是推导出一个恒等式。对定义式关于 求导,由微积分基本定理
再对左边逐项展开( 的分子是积分、分母是 ,求导用到乘积法则),整理后得到论文的式 (6):
论文称之为 MeanFlow 恒等式。它说的是:平均速度等于瞬时速度减去一段时间乘以平均速度的时间导数。当 时右边退化为瞬时速度,当区间变宽时修正项变大。
训练目标是让网络预测的 满足这个由自身定义的恒等式——网络的输出同时出现在等式两边,右边的时间导数通过对网络做 JVP 得到(与 sCM 的切线项是同一类数值操作)。于是不再需要教师、也不需要轨迹标签,可以从头训练一步模型。论文报告在 ImageNet 256×256 上 1-NFE 的 FID 为 3.43。
MeanFlow 论文还指出,之前的一些一步流模型只约束”网络输出沿时间移动时如何变化”,缺少对”真实平均速度场”的明确定义,导致训练不稳定、需要精心设计的”离散化课程”逐步约束时间域;MeanFlow 恒等式给平均速度场下了一个可验证的定义,这正是它能从头训练的根基。
MeanFlow 的恒等式在形式上与一致性模型”切线”很接近:都在用”沿轨迹的导数”构造自洽约束。区别是:一致性模型学”起点映射”,MeanFlow 学”平均速度”,前者约束的是终点一致,后者约束的是积分一致。这条路线对推理侧的意义在于,它把”少步”的收益从蒸馏范式推广到了训练范式——一个从头训练的模型就能是 1 步的。
第五层:对抗蒸馏——用判别器补上”真实感”
ADD 的两个损失项
对抗扩散蒸馏(Adversarial Diffusion Distillation,ADD,Sauer 等人,2023 年,Stability AI)把少步生成的配方写成两项相加:
其中 是标准对抗损失(判别器区分生成样本与真实图像), 是来自教师的分数蒸馏损失, 是平衡系数。
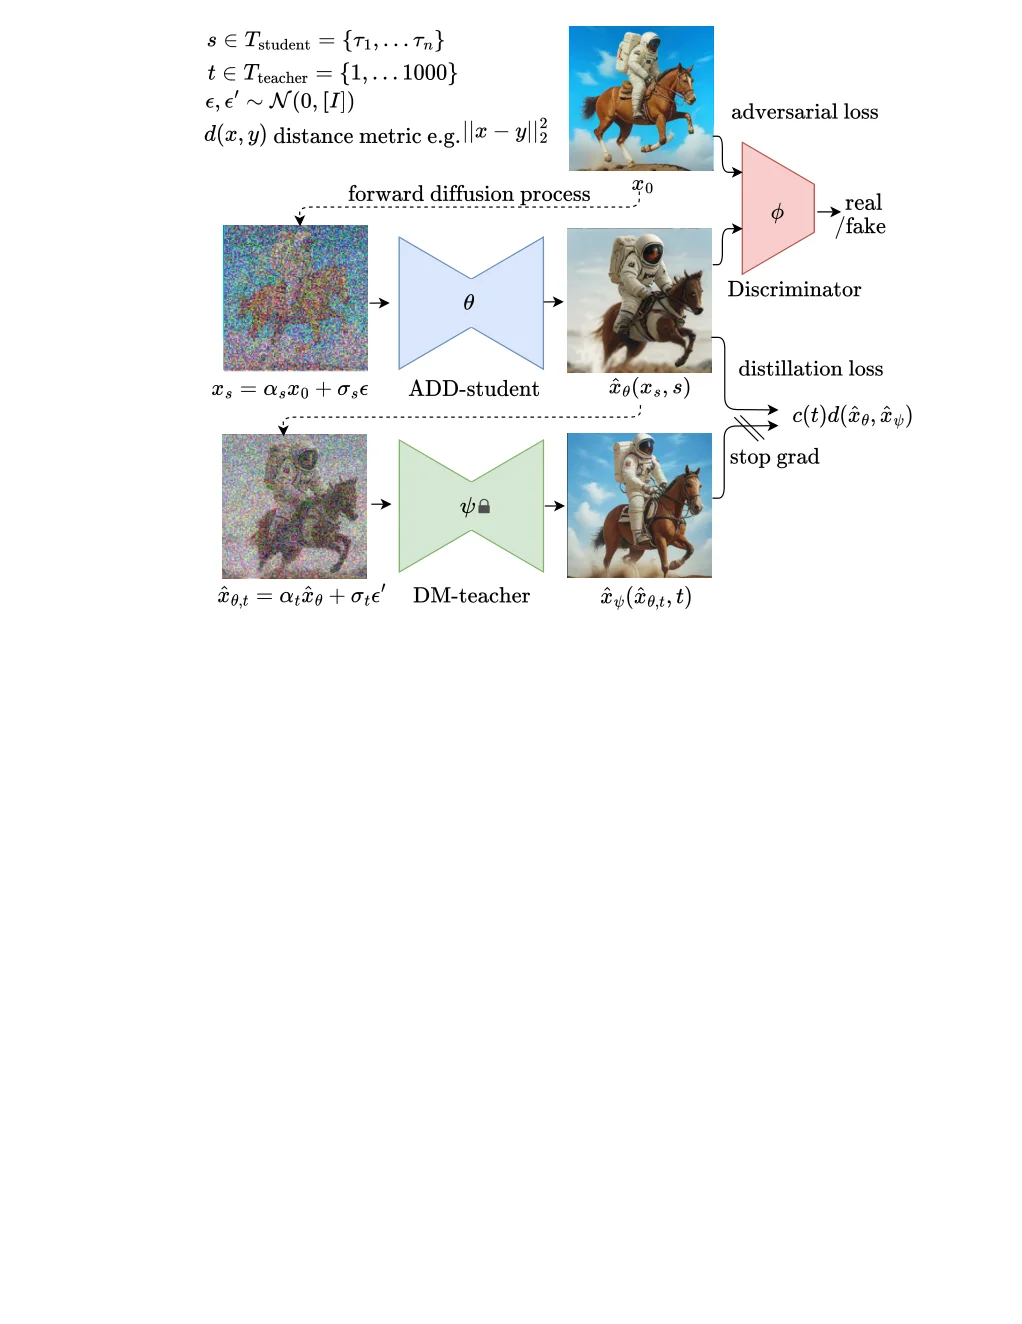
上图是 ADD 论文 Figure 2:ADD-student 被训练成一个”去噪器”,接收噪声水平 下的带噪图像 与条件,输出 。图里两条训练路径分别对应:a) 对抗损失——生成样本 送进判别器,与真实图像 对比;b) 蒸馏损失——把学生输出重新加噪到教师可接受的噪声水平,再与冻结教师 的去噪目标比较。
这里有一个容易被忽略的细节:学生的输出必须先重新加噪,才能送进教师。原因在于教师是在”带噪输入”上训练的,直接喂干净的 属于分布外(out-of-distribution)输入,教师的输出会失准。图中 这一步( 是新采样的噪声)就是为此存在的。
蒸馏损失的形式是
其中 是权重(ADD 论文比较了指数权重 与 SDS 权重两种选择), 取 , 是教师的去噪目标。当 且权重取 SDS 形式时,这一项等价于 Score Distillation Sampling(SDS)目标——SDS 原本用于从二维扩散模型蒸馏三维表示,ADD 把它搬到了”从教师蒸馏学生”的场景。
为什么光靠蒸馏在 1 步会崩
ADD 论文的消融实验给出一组很有说服力的数字(COCO zero-shot FID-5k,单步):
- 只用对抗损失 :FID 20.8;
- 只用蒸馏损失 :FID 315.6;
- 两者合用:FID 20.3–20.6。
分数蒸馏单独训练一步模型时几乎完全失败。原因并不神秘:分数蒸馏损失是”在教师指定的噪声水平上比较去噪目标”,它衡量的是”学生输出与教师输出在逐样本意义上有多接近”。1 步学生要一次跨过大噪声差,它的输出不可能逐样本近似教师路径上的那个点;此时梯度方向会被大量互相矛盾的样本平均掉,学生只能学到”模糊的平均图像”。判别器则不同:它只要求”看起来像真的”,不要求”与教师的某一步对齐”。这两项的作用正好互补——判别器负责局部真实感与高频细节,蒸馏项负责全局结构与文本对齐。
ADD 的另一个关键设计是判别器特征网络。它不做成从零训练的卷积判别器,而是取一个预训练视觉主干(论文默认用 DINOv2 ViT-S),只在其上接一个轻量可训练的头。消融里对比了 DINOv1、DINOv2、CLIP 以及 ViT-S/ViT-L 不同规模,ViT-S DINOv2 的组合最好。用预训练特征的理由和 GAN 训练的经典经验一致:从零训练判别器在大规模文生图上不稳定,而预训练特征已经含有语义与纹理的强先验,判别器只需学习”在哪些特征上区分真假”。
ADD 的初始化也很重要。消融中”随机初始化”的 FID 是 293.6,“预训练学生权重”是 20.6——学生必须从教师权重出发。这印证了第零层的结论:蒸馏不是”重新训练一个快模型”,而是”把已有的轨迹能力压缩到更少的调用次数里”。随机初始化的学生没有可压缩的能力。
SDXL-Lightning:渐进 + 对抗
SDXL-Lightning(Lin 等人,2024 年)把两条路线组合起来:先用渐进式蒸馏把步数逐级压下来,再用对抗蒸馏在低步数区间精修。它同时开源了 LoRA 与完整 UNet 两种形态。
这个组合的动机正好对应两种方法的短板:
- 渐进式蒸馏的优点是模式覆盖好(它逐点对齐教师轨迹,不会丢样本模式),缺点是低步数处模糊、纹理不足;
- 对抗蒸馏的优点是真实感强,缺点是模式覆盖容易收缩(判别器只奖励”看起来真”的样本,学生可能放弃长尾模式)。
先渐进、后对抗,等于先用前者保住分布覆盖,再用后者补细节。SDXL-Lightning 论文明确把这一点写成”在质量与模式覆盖之间取平衡”。
第六层:五条路线的横向对比
把前面的方法放在同一张表里,差异会更清楚。表中的”1 步可用”指”1 次前向就能出可接受图像”,不是”1 步质量等于教师”。
| 方法 | 优化目标 | 需要教师轨迹 | 额外网络 | 典型步数 | 主要短板 |
|---|---|---|---|---|---|
| 一致性模型 / LCM | 轨迹相邻点映射一致 | 是(ODE 步) | 无(EMA 副本) | 1–4 | 1 步纹理软、细节少 |
| Progressive Distillation | 两点合一步的逐点回归 | 是(多轮) | 无 | 1–8 | 需串行多轮;末级误差难消 |
| Reflow / InstaFlow | 拉直轨迹后大步 Euler | 是(重新配对) | 无 | 1–2 | 文本条件配对复杂;细节仍弱 |
| DMD / DMD2 | 分布 KL + GAN | 否(只要 score) | fake 扩散模型 + 判别器 | 1–4 | 训练重、需要调 fake 模型节奏 |
| ADD / SDXL-Lightning | 对抗 + 分数蒸馏 | 是(教师去噪目标) | 判别器 | 1–4 | 模式覆盖收缩、需教师初始化 |
几条选择经验:
如果目标是把已有模型快速变成 4 步可用,LCM/LCM-LoRA 是成本最低的路径:32 A100 小时的量级、可插拔的 LoRA、不需要判别器。代价是 1 步质量不行,必须保留 2–4 步。
如果目标是 1 步、且能接受更重的训练,DMD2 与 ADD 是当前公开方法里质量最高的两条。DMD2 的优势是分布匹配的理论更干净、且不需要教师轨迹标签;ADD 的优势是训练管线更简单、已有官方权重可参考。
如果只是想让采样器在 8–15 步更好,其实不需要蒸馏——第六篇的 DPM-Solver++ 与合适的 sigma schedule 就够了。蒸馏的收益要到 4 步以下才明显。
如果要从头训练一步模型、且没有教师,MeanFlow 与一致性训练(sCT)是两条可选路线。它们的意义更多在研究与”模型天生就是少步”的形态,工业上目前还是以蒸馏为主。
第七层:蒸馏之后,推理管线发生了什么
这一节是整篇里最贴近部署的部分。少步蒸馏不只是”步数变小”,它会改变推理管线的多个环节,而且这些环节如果不同步修改,蒸馏带来的收益会被抵消甚至变成负收益。
变化一:CFG 消失,批大小与显存跟着减半
标准扩散推理每一步要跑两次前向(条件 + 无条件),把结果按 guidance scale 线性组合。蒸馏模型(LCM、ADD、SDXL-Lightning、DMD2 的学生)在训练时已经把 guidance 烘进权重,推理时只需一次前向。
对服务的直接影响有三层:
- 单步延迟减半。这不是”优化”,而是”需求消失”——不需要第二次前向,也不需要保存两份激活。
- 批大小可以翻倍。同样的显存预算下,原来放 4 条请求的 batch 现在可以放 8 条,吞吐进一步提升。
- kernel 调用次数减少。CFG 的两路前向在实现上通常是拼成一个 batch 一起跑的(等价于把 batch 翻倍),所以它并不额外增加 launch 次数,但会占满显存带宽。去掉后,单请求的显存带宽压力明显下降。
代价是自由度:guidance scale 被固定在蒸馏时的取值。需要更强引导(更”听话”、更饱和)或更弱引导(更自然、更多样)时,只能:
- 用标准 CFG 回退(如果学生仍保留无条件分支);
- 重新蒸馏一版;
- 用 prompt 侧的补偿(更强/更弱的提示词)近似。
这也是为什么很多蒸馏模型在发布时会注明”建议 guidance=1.0/0.0”——不是建议,而是模型只在这个取值上被训练过。
变化二:调度器与时间步表必须匹配
少步模型对时间步网格非常敏感。以 LCM 为例,它的训练使用了特定的噪声日程与跳步(skip-step)设计,推理时必须使用配套的 LCMScheduler(或在 diffusers 里显式指定 timesteps),否则即使步数正确,质量也会明显下降。
原因在前面的推导里:一致性模型的训练目标建立在”相邻时间步的相对间距”上。训练时用的是某个特定的 序列(例如 这类跳步),推理时如果换成均匀的 4 步网格,学生看到的时间点分布与训练不一致,映射就会偏。
工程上的做法是:蒸馏模型应当与它的调度器、时间步表、sigma 变换一起被当作一个整体发布。只发布权重而不发布配套调度器,是复现失败最常见的原因。
变化三:分辨率变化会破坏蒸馏
多数蒸馏在固定分辨率(或固定 latent 尺寸)上完成。改变分辨率时,latent token 数量变化,网络的注意力模式与噪声日程的”有效 SNR”都会偏移。第六篇讲 DPM-Solver 时提到的 sigma shift 也是同一个问题:分辨率变了,需要重新调整噪声日程。
对蒸馏模型,这个问题更严重——学生的”一步映射”是在特定 token 数下学的,换成另一分辨率时,它没有机会用多步来修正。实际部署里常见的做法是:
- 保持训练分辨率推理,超分交给专门的上采样模型;
- 或为不同分辨率分别蒸馏(视频模型尤其如此,第五篇提到视频侧的分辨率/帧数组合通常各有蒸馏权重);
- 或在推理时用 “sigma shift” 参数做补偿,但这只能缓解,不能完全恢复。
变化四:量化与蒸馏的顺序
量化和蒸馏都会改变权重,叠加时顺序很重要。经验上:
- 先蒸馏、后量化:学生在教师的轨迹上学到的是”稠密”的映射,量化误差可以被蒸馏阶段的鲁棒性吸收一部分;但量化到 4-bit 时,一步模型对权重量化误差非常敏感,因为误差没有多步累积来平均。
- 先量化、后蒸馏:蒸馏直接在量化后的教师上做,学生会适配量化误差,质量通常更稳;代价是教师本身已经掉了一点质量,蒸馏的上限被压低。
对 1 步模型,更稳的顺序是”先量化教师、再蒸馏”,因为 1 步没有迭代纠错的机会;对 4 步以上模型,两种顺序差别不大。
变化五:缓存与稀疏注意力还能不能叠加
第五篇与站内其他文章讨论过扩散推理的缓存(跨步复用注意力/特征)与稀疏注意力。这两类优化与少步蒸馏的叠加有一个反直觉的结论:步数越少,缓存的收益越小。
原因很简单:缓存的价值来自”相邻步之间的特征高度相似”,可以跳过重复计算。步数从 50 降到 4 后,相邻两步之间的噪声差变大,特征相似度下降,能安全复用的比例减少。如果缓存策略仍按 50 步的相似度阈值设计,4 步模型上会引入明显误差。
同理,稀疏注意力的掩码统计是在多步轨迹上估计的;少步模型的注意力模式更集中(因为每步要处理更多信息),稀疏化的容错空间更小。第五篇提到 HunyuanVideo 1.5 把稀疏注意力的训练放在蒸馏阶段,正是为了让掩码适配蒸馏后的注意力分布。
第八层:一次请求的延迟账
把上面的变化代进延迟公式,可以看到蒸馏的收益到底落在哪一段。
扩散请求的端到端延迟可以拆成
其中:
- 是文本编码器(CLIP/T5)的前向,与步数无关;
- 包括 latent 初始化、调度器时间步表构建、可能的 prompt 嵌入拼接;
- 是主干前向次数(含 CFG 的倍数);
- 是单次主干前向的耗时,由模型规模、分辨率、批大小决定;
- 是 VAE 解码,与步数无关,但在高分辨率下占比不小;
- 是框架调度、内存搬运、kernel launch 的固定开销。
对一个 1024×1024 的 UNet 类模型,量级大致是:单步主干前向几十毫秒,VAE 解码几十毫秒,文本编码十几毫秒。于是:
- 25 步 + CFG: 量级,端到端 2–3 秒;
- 4 步蒸馏 + 无 CFG:,端到端几百毫秒;
- 1 步蒸馏:,此时 与 的占比迅速上升,甚至成为主要项。
这张账说明了两件事。
第一,蒸馏之后瓶颈会转移。 步数从 50 降到 4,采样阶段省了 90% 以上;但端到端不会同比例下降——文本编码和 VAE 解码没变。第六篇”CUDA Graph 与固定 NFE 绑定”一节提到的固定开销,在少步模型上会变成主要优化对象。这也解释了为什么 1 步模型的工程重点会从”采样器”转向”VAE 解码、文本编码缓存、图捕获”。
第二,对 DiT 类主干,蒸馏的收益更大。 DiT 的单步成本随 token 数线性增长(注意力项还随 token 数平方增长),而 1 步模型把 token 数的成本只付一次。以 12B 级 DiT 在 1024²(4096 token)为例,单步前向的算力在数十 TFLOPs 量级,20 步 + CFG 就是数百 TFLOPs 到 PFLOPs 量级;压到 4 步后,采样算力降一个数量级以上。
不过,训练成本必须计入总账。LCM 的 32 A100 小时是针对 SD 级别的模型;DMD2 与 ADD 在 SDXL 级别需要数百到上千 GPU 小时,视频模型还要更多。如果只是偶尔生成几张图,蒸馏不划算;如果是要支撑高 QPS 的在线服务,蒸馏的成本在很短时间内就能被推理节省摊平。
第九层:扩散之外——同一套思路的迁移
少步蒸馏的机制并不绑定在图像扩散上。它依赖的是”一个需要多步迭代的生成过程”,所以凡是迭代生成,都能套用同一套思路。这一节列几个已经落地的迁移,目的是让”一致性/对抗/分布匹配”这三个概念有更宽的适用面。
视频:对抗式后训练的 1-NFE 形态
视频扩散的成本结构(第五篇)比图像更极端:每一帧都要完整走一遍主干,50 步 → 4 步直接省掉 90% 以上的算力。把 ADD 的思路搬到视频上的代表工作是自回归对抗式后训练(AAPT,2025 年):在预训练好的潜空间视频扩散模型上做对抗损失 + 分数蒸馏的后训练,让学生每帧只做 1 次前向,并把生成结果流式输出——每生成一个潜空间帧就立即解码推给用户,而不等整段视频完成。
这里有一个图像蒸馏里不存在的约束:帧间一致性。单帧的对抗损失无法约束相邻帧的运动连贯,所以视频蒸馏通常要在判别器里加入时间维度的特征(例如 3D 判别器或用多帧堆叠的判别器输入),否则学生会生成”每帧都很真实、连起来很跳”的结果。
视频的 1-NFE 自回归化
AAPT 的形态是”1 NFE 生成一帧、自回归滚动生成视频”:每帧用一次前向生成一个潜空间帧,然后把它追加到上下文里生成下一帧。这里的”自回归”与第一篇讲的自回归文本生成本质相同——只是 token 变成了潜空间帧,而”下一帧”的条件由教师蒸馏出来。除了少步,这类工作还要解决”长上下文”问题:随着帧数增加,历史帧的潜空间表示与 KV 缓存都在膨胀,必须做滑窗或压缩,否则延迟会随视频长度线性增长。
这个形态的推理意义在于:它把视频生成从”一次性算完整段”变成”流式”——首帧延迟由 1 次前向决定,后续帧的延迟由单帧前向决定,可以边生成边播放,也可以随时中断。第五篇讲”长视频分块自回归与流式生成”时讨论过类似的形态,区别是那里分块是为了控制显存,这里 1-NFE 是为了控制延迟。
3D 与场景:少步是必要的
文本到 3D、场景重建这类任务里,一次优化要覆盖几十个视角,每个视角都是一次采样。如果用 50 步扩散,单场景需要数万次前向;蒸馏到 4 步后,同样的视角数只需数千次。更重要的是,3D 生成往往在优化循环里反复调用扩散模型(作为 score 函数或先验),“每步 2 次前向”的 CFG 会直接让循环慢一倍。因此在这些场景里,LCM 类与对抗类蒸馏几乎是默认选项。
离散扩散:dLLM 的”步数”是块内轮数
第二篇与第三篇讲过 dLLM 的块并行解码:一个块内的 token 通过多轮”掩码-预测”逐步确定,轮数越少,每轮的并行度越高但质量越差。这与图像扩散的”步数”结构完全同构——都是”用更少的迭代换取延迟”。
所以少步蒸馏的思路可以搬过来:训练一个”多轮教师”的”少轮学生”,或让学生模型在 1–2 轮内就提交整块。区别在于离散空间的优化目标不是 ,而是交叉熵或分布 KL;而对抗损失在离散 token 上的判别器设计也比图像更难(需要处理变长序列与词表嵌入)。这也是为什么 dLLM 的蒸馏研究目前更多停留在加速多轮调度,而没有像图像侧那样出现成熟的 1-轮蒸馏模型。
与投机解码的结构相似性
站内已经写过投机解码(DFlash、DFlow 等)。投机解码与少步扩散蒸馏有一点形式上相似:都是”用一个更便宜的过程产生候选,再由一个更昂贵的过程验证”。区别是:
- 投机解码的草稿模型与验证模型保持同一模型结构,验证是无损的(验证概率可以精确计算);
- 少步蒸馏的学生与教师结构相同,但验证不可能无损——学生的一次前向输出的信息量上限就是”教师 50 步轨迹的压缩”,不存在可精确计算的接受概率。
这个区别决定了工程上的不同:投机解码可以随时回退到全量验证保证质量,少步蒸馏的”质量”完全由训练决定,部署时没有回退路径。这就是为什么蒸馏模型通常需要配套的评测(FID、人工偏好)而不是像投机解码那样有理论保证。
第十层:质量评估——为什么蒸馏模型的榜单数字不能全信
少步蒸馏的论文都会给出 FID、CLIP score 与人工偏好三类指标。这三类指标测的东西不同,混用会导致错误的部署决策。
FID 测的是分布距离,但样本量会改变结论
FID 的做法是把真实图像与生成图像分别送进 Inception 网络,取特征的高斯分布,计算两个高斯之间的 Fréchet 距离:
其中 是真实图像特征的均值与协方差, 是生成图像的对应量。这个指标同时惩罚”均值偏移”和”协方差结构差异”,所以它对模糊、模式缺失、颜色偏移都敏感。
但它的估计是有偏的:协方差的估计在样本数少时不准,导致 FID 会随样本量系统性变化。不同论文用 5k、10k、30k、50k 样本时,数字不可直接比较。ADD 论文用的是 COCO zero-shot FID-5k,很多其他论文用 FID-50k;把两者放在一张表里排序是常见的误读。
还有一条更隐蔽的偏差:FID 的参考分布是真实数据,不是教师。学生可能在某类样本上比教师更好(例如对抗损失让纹理更锐利),同时在某些长尾概念上更差;FID 作为总体距离,会把这两种效应混在一起。一个蒸馏模型 FID 低于教师,不代表它在所有 prompt 上都更好。
CLIP score 测的是文本对齐,对细节不敏感
CLIP score 用 CLIP 的图像-文本相似度衡量”图和 prompt 有多配”。它的问题是对空间关系、数量、文字渲染这类细粒度信息不敏感:一张”两只猫”的图和”一只猫”的图,CLIP score 可能只差一点点。少步模型最常见的退化恰恰出现在这些地方——物体数量错、文字糊、空间关系乱。所以 CLIP score 持平的模型,实际可用性可能差很多。
人工偏好与 Elo
ADD 论文用的是人工偏好评估:让标注者比较两个模型的输出,再折算 Elo。这类评估对”真实感、细节、美观”敏感,但成本高、难以复现,且容易受展示分辨率与选择偏差影响。
三种指标的关系可以概括为:
| 指标 | 敏感的东西 | 不敏感的东西 | 适合回答 |
|---|---|---|---|
| FID | 分布整体、模糊、模式缺失 | 文本对齐、局部结构 | 学生是否覆盖了教师的主要分布 |
| CLIP score | prompt 语义对齐 | 数量、空间、文字 | 学生是否还”听话” |
| 人工/Elo | 真实感、细节、美观 | 长尾概念、可复现性 | 用户是否愿意用 |
一步模型的典型失效模式
少步模型的退化不是随机的,而是有稳定的几种形态。识别它们比看指标更有用:
其一,纹理”塑料感”。 1 步模型在高频区域(毛发、织物、皮肤)容易生成过度平滑或过度锐利的结果。前者是逐点回归(一致性、渐进式)的典型症状,后者是对抗损失的典型症状。DMD2 加 GAN 项正是为了修正前者。
其二,模式覆盖收缩。 对抗类蒸馏最典型的问题:同一个 prompt 多次采样,构图与色彩趋同。判别器只奖励”看起来真”的区域,学生会放弃少见的构图。诊断方法是固定 prompt、变化随机种子采样 20 张,看构图/色彩的多样性;或者统计生成分布的 pairwise 距离。
其三,文本渲染与计数退化。 需要精确字形或精确数量的 prompt 上,学生更容易错。原因很直接:这些信息在教师的多步轨迹里是逐步”雕刻”出来的,学生一步之内没有足够的迭代次数去修正。
其四,guidance 固定导致的”过饱和”。 CFG 蒸馏后的学生相当于把 guidance 固定在某个值;prompt 越复杂,这个固定值越可能不合适,表现为色彩过饱和、对比过强、细节过锐。
其五,时间步错配。 用了不匹配的调度器时,模型不是”质量下降”,而是直接出现结构性崩坏(大面积色块、重复纹理)。这类错误通常一测就能发现,不需要复杂指标。
一个实用的验收流程
对一个新拿到的蒸馏权重,按这个顺序检查:
- 先确认配套:调度器类名、时间步表、guidance 取值、训练分辨率。四项任一不匹配,先修配置再看质量。
- 再看单请求延迟:用固定 prompt、固定种子测端到端时间,确认与预期的 NFE 对得上。如果延迟没有下降,说明管线里还有隐藏的第二次前向(例如代码仍开着 CFG)。
- 再看多样性:同一 prompt 换 8–16 个种子,肉眼确认构图不塌缩。
- 最后看指标:在相同样本量、相同参考集下与教师对比 FID;单独看 CLIP score 没有意义,要与 FID、人工观感一起判断。
工程排查清单:蒸馏模型上线前先看这几处
下面这份清单按”最常出错”排序,可以直接当上线检查表用。
1. guidance 是否被重复施加。 蒸馏模型通常要求 guidance_scale=1.0(或等价的不启用 CFG)。如果代码里仍传 7.5,等于对已经含 guidance 的输出再放大一次,结果是过饱和与崩坏。
2. 调度器是否与权重匹配。 LCM 权重必须配 LCMScheduler;ADD/Turbo 类权重配 EulerAncestralDiscreteScheduler 或官方指定的调度器;DMD2 学生配它自己训练时用的 sigma 表。混用会直接毁掉输出。
3. 时间步表是否覆盖了训练区间。 少步模型的训练集中在若干特定噪声水平;推理时必须显式给出与训练一致的时间步,而不是均匀切分。
4. 是否仍在跑无条件分支。 有些框架即使 guidance=1.0 也会跑两次前向;要确认计算图里没有多余的 uncond 分支,否则延迟收益只剩一半。
5. 分辨率与 latent 尺寸。 确认推理分辨率与训练一致;不一致时先试 sigma shift 补偿,再看是否需要专门的蒸馏权重。
6. dtype 与 kernel。 蒸馏学生的权重对低精度更敏感(尤其 1 步模型)。BF16 通常安全,FP8/INT8 要单独验证;不要假设”教师能跑 FP8,学生也能跑”。
7. 文本编码器是否被换掉。 学生与教师必须共用同一个文本编码器与同一个 embedding 维度;换编码器等于换了条件分布。
8. 缓存与稀疏注意力是否按少步重调。 若沿用多步配置,先关掉这两项跑基线,再逐项打开确认收益与质量。
与站内其他扩散工作的衔接
这个系列已经用六篇把扩散的数学与系统拆开,本篇补的是”时间轴的压缩”。几篇文章之间的关系可以这样看:
- 第一篇给出 DDPM、DDIM、score matching、Flow Matching 与 DiT 的骨架,本篇的一致性函数、平均速度都建立在这套记号上;
- 扩散模型从零讲起(二):掩码离散扩散 讲的是离散侧的”步数”,本例的少步思想在 dLLM 上对应”块内轮数”;
- 扩散模型从零讲起(三):dLLM 推理系统 从服务角度讨论缓存与调度,本篇的第七、八层是同一套记账方式在图像侧的版本;
- 扩散模型从零讲起(四):潜空间扩散与条件生成 的 VAE、cross-attention、MMDiT 与 CFG 是 LCM/ADD/DMD2 的工作前提——没有潜空间压缩与条件注入,就没有”少步文生图”这件事;
- 扩散模型从零讲起(五):视频扩散 已经讨论过视频侧蒸馏的形态,本篇第九层补上了对抗式后训练的细节;
- 扩散模型从零讲起(六):采样器完全拆解 给出”为什么 20 步就够”的数值解释,本篇则回答”为什么 4 步以下必须改模型”。
站内还有几篇从推理优化角度拆解扩散/块并行的文章,可以作为延伸:
- DFlash 块扩散解码 用扩散做草稿生成,属于”扩散 + 投机”的组合,与本篇的”减少 NFE”是两条不同的加速轴;
- TEAM 完全拆解 讨论 MoE 扩散的专家激活,与本篇的”步数压缩”可以叠加:少步减少时间维度,MoE 稀疏减少每次前向的算力;
- Epoch 完全拆解 把扩散块编译成服务单元,属于第三篇服务视角的延续。
小结
- 换求解器能把步数压到 10–20 步,再往下就受三条限制:轨迹不直、网络误差地板、CFG 放大误差。降步数必须改模型。
- 一致性模型把 PF-ODE 轨迹上的任意点映射到轨迹起点;边界条件由 参数化焊死,训练靠”相邻点映射一致 + EMA 目标”;连续时间极限把目标变成沿轨迹的切线导数为零,需要 JVP;sCM 用 TrigFlow 参数化、JVP 重排与自适应权重把它训稳。
- LCM 把一致性蒸馏搬到潜空间,并把 guidance scale 作为条件输入,从而把 CFG 烘进学生;LCM-LoRA 把它做成可插拔低秩模块,训练成本约 32 A100 小时量级。
- Progressive Distillation 每轮把步数减半,需要教师轨迹与串行训练;-prediction 是它在低步数下稳定的关键。
- Reflow/InstaFlow 先把轨迹拉直再一步 Euler;文本条件的配对一致性是它的工程难点。
- DMD/DMD2 直接最小化学生分布与教师分布的 KL,梯度是两个 score 之差(带负号,KL 方向是 fake‖real);DMD2 去掉回归项、加 GAN 项、用两时间尺度更新 fake 模型。
- ADD 把对抗损失与分数蒸馏相加,只用分数蒸馏在 1 步会崩(消融 FID 315.6),对抗项负责真实感,预训练特征判别器与教师初始化是两个必要条件。
- MeanFlow 用平均速度与”MeanFlow 恒等式”给出不依赖教师的一步训练路线,1-NFE FID 3.43(ImageNet 256)。
- 蒸馏改变的不只是步数:CFG 消失让批次与显存减半,但 guidance 自由度被固定;调度器、时间步表、分辨率必须与权重一起当作整体;量化顺序与缓存策略也要重调。
- 延迟账上,采样阶段能省 90%,但文本编码与 VAE 解码不变;1 步模型的瓶颈会转移到非采样阶段。
- 评估上,FID 有样本量与参考集偏差,CLIP score 对数量/空间/文字不敏感,人工偏好成本高;一步模型的典型退化是纹理塑料感、模式收缩、文本渲染退化、过饱和与调度器错配。
参考资料
- Consistency Models(Song 等,2023)
- Consistency Models(HTML 全文,含 Remark 10 与算法)
- Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference
- LCM-LoRA: A Universal Stable-Diffusion Acceleration Module
- Simplifying, Stabilizing and Scaling Continuous-Time Consistency Models(sCM)
- sCM(HTML 全文,含 TrigFlow 推导与连续时间目标)
- Progressive Distillation for Fast Sampling of Diffusion Models
- Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
- InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image Generation
- One-step Diffusion with Distribution Matching Distillation(DMD)
- Improved Distribution Matching Distillation for Fast Image Synthesis(DMD2)
- DMD2(HTML 全文,含 score 恒等式与训练管线)
- Adversarial Diffusion Distillation(ADD)
- ADD(HTML 全文,含消融表与判别器设计)
- SDXL-Lightning: Progressive Adversarial Diffusion Distillation
- Mean Flows for One-step Generative Modeling
- Autoregressive Adversarial Post-Training for Real-Time Interactive Video Generation
- Diffusers
LCMScheduler源码 - Diffusers
DPMSolverMultistepScheduler源码 - Stability AI
generative-models仓库(ADD/SDXL-Turbo 实现)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



