


扩散模型从零讲起(六):采样器完全拆解——DDIM、Heun 与 DPM-Solver,为什么 20 步就够
写在前面:这一篇在系列里的位置
前面几篇把扩散模型的”生成过程本身”讲清楚了:
- 第一篇从 DDPM 的两条高斯链出发,给出闭式前向边缘与闭式后验,指出训练等价于回归噪声;随后把随机反向链改成确定性轨迹(DDIM),把去噪与分数场联系起来,再引入 Flow Matching 的直线路径与 DiT 主干。
- 第二篇把状态空间换成词表,讲吸收态掩码扩散与块并行解码。
- 第三篇进入系统层,讨论 dLLM 的缓存、调度与硬件特征。
- 第四篇拆解潜空间扩散:VAE 压缩、文本条件的三条注入通路、MMDiT 双流,以及 Flux 的双流—单流结构。
- 第五篇讲视频扩散的时空注意力、3D VAE 与少步蒸馏。
这几篇反复出现同一个词——步数。图像生成从 1000 步降到 20 步,视频从 50 步降到 8 步,一致性模型甚至做到 1 步。第一篇给过”20–30 步 Euler 就够”的实践结论,但没有回答一个核心问题:同一条扩散轨迹,为什么换一个采样器积分,所需的前向评估次数(NFE,number of function evaluations)能差出一个数量级? 答案在数值分析里一套相当经典的工具:把扩散采样看成 ODE 初值问题,然后用专门为这类半线性方程设计的指数积分器去解它。
这一篇从”扩散采样到底是什么方程”开始,依次推导 DDIM 的误差结构、Heun 这类通用 RK 方法为什么对扩散”贵且不划算”、DPM-Solver 的坐标变换与指数积分公式、二阶多步的 DPM-Solver++、自适应步长的代价,最后讨论这些结论如何落到图像、视频与蒸馏模型的服务配置上。只讨论”网络训练好之后,如何用最少的前向把轨迹积分出来”,不涉及训练配方。
第零层:把采样写成一个 ODE
概率流 ODE
第一篇讲过,score matching 视角下每一时刻的加噪分布 都有一个对应的概率流 ODE(probability flow ODE),它和”前向加噪 SDE + 反向去噪 SDE”共享相同的边缘分布,但在实现上完全确定、没有随机采样。Score SDE 论文(Song 等人,2020 年,Score-Based Generative Modeling through Stochastic Differential Equations)用下面这张图把三类对象摆在一起:
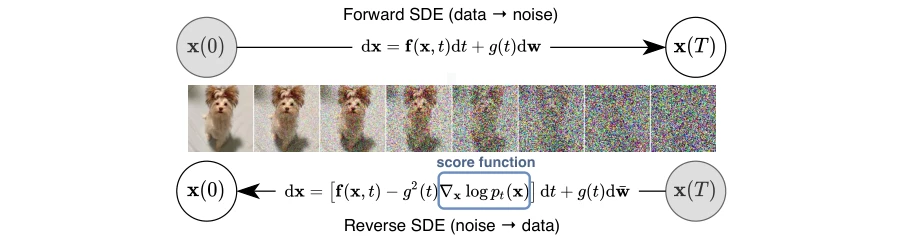
图中从左到右依次是:前向 SDE 把数据逐步加噪成标准高斯;反向 SDE 用分数 驱动采样从噪声回到数据;中间那条概率流 ODE 则是”同样的分数场、但去掉了随机项”的确定性版本。三条路径在每一时刻 的边缘分布完全一致,区别只在于轨迹是否随机。采样器要积分的,正是中间这条确定性轨迹——因为它每一步都只依赖网络输出,步数可以远小于 SDE 离散化所需的步数。
设前向 SDE 为
其中 是时间反向的维纳过程, 是漂移系数, 是扩散系数。对应的确定性 ODE 是
后一项是分数。网络预测的噪声 与分数只差一个噪声标准差:
是 时刻的噪声标准差。代入后 ODE 的右侧完全由一次网络前向决定,这就是采样器的输入函数。
Score SDE 论文的下图把”分数场如何同时定义 SDE 与 ODE”画得更细:虚线是前向 SDE 对应的加噪轨迹,实线是反向 SDE,而 ODE 轨迹是同一时刻边缘分布的”确定性代表”——它不含随机项,但每一步都沿分数场指向数据。
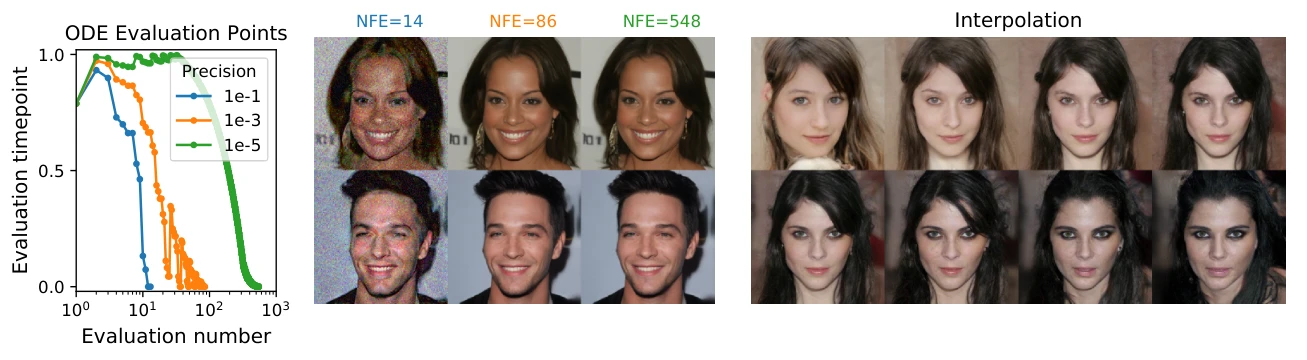
读图时注意中间一栏:ODE 轨迹在每一个噪声水平上都落在反向 SDE 的分布中心附近,而不是任意的随机点。这是”同一条轨迹、不同采样器积分”能比较质量的前提——只要采样器把这条轨迹积分得够准,各种积分方式应该收敛到同一个终点;残差正是采样器阶数、步长与权重近似造成的差别。
VP 型前向的系数
DDPM 属于 VP(variance preserving)型扩散。本篇沿用 DPM-Solver 论文的符号: 表示幅度而不是方差,满足
它与第一篇里 DDPM 的 、 一一对应:本篇的 就是第一篇的 , 就是 。之所以改用幅度符号,是因为 log-SNR 与指数积分的公式在幅度下标写最短。条件分布因此写成
这个”缩放后的高斯”是后面所有推导的出发点: 可以看作 被缩放 后再叠加 的噪声。DDIM 与 DPM-Solver 的差别,很大一部分就来自它们对这个结构的不同利用方式——前者把 当作区间内的常量做线性插值,后者把线性缩放精确解出来、只对网络输出做积分。
第一层:DDIM 的更新形式与误差阶
DDIM 的更新式
第一篇给出过 DDIM 的更新,用 重写:从 走到 (,无随机项),
其中
是网络对 的估计。把 代回并整理,可以得到 DPM-Solver 论文式 (4.1) 的写法:
这里有两个可以”读出来”的性质:网络只通过 这一个量进入更新, 的”缩放到 时刻”由显式系数完成;而 恰好是 log-SNR 的负指数(见第三层)。DPM-Solver 论文 Section 4.1 证明了 DDIM 的更新与一阶指数积分器完全一致——DDIM 就是积分器家族里的 特例,只是它的推导来自”预测 后按比例重缩放”,而不是”解 ODE”。
局部误差是一阶
把 DDIM 看作概率流 ODE 的一种离散化,它的局部误差是步长的平方阶、全局误差是步长的一阶。做一次 Taylor 展开就能看清:设区间长度为 ,精确解 与 DDIM 从 一步跳到 的输出之差,在 时是 ;累积到全局就是 。这与显式 Euler 方法同阶——DDIM 用”区间内 近似不变、按 比例线性插值”做了近似,本质上就是把变化率取成区间起点值。
一阶误差的直接后果是步数-质量曲线很”慢”。DPM-Solver 论文的 Figure 1 把这件事画出来了:
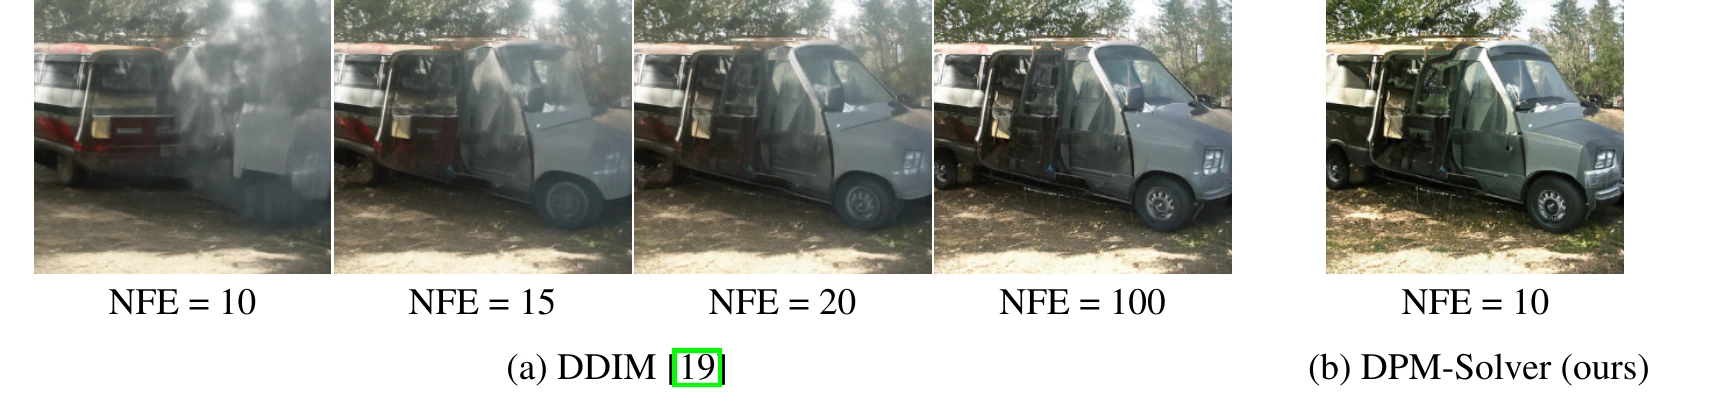
(a) 组是 DDIM 用 10、15、20、100 次前向的采样,(b) 组是 DPM-Solver 只用 10 次前向的结果。读图时看两件事:DDIM 在 10–15 NFE 时画面发糊、结构没定型,要到 100 NFE 才接近收敛;DPM-Solver 在 10 NFE 就已经和 DDIM 的 100 NFE 视觉上接近。DPM-Solver 论文报告,在 CIFAR-10 连续时间模型上它达到 FID 4.70@10 NFE、3.24@15 NFE、2.87@20 NFE,而前代的训练无关快速采样器要 50 次以上前向才能接近收敛。
DDIM 仍然是最便宜的基线
DDIM 并不因此失去价值。它每步只需要一次网络前向(“一阶、单评估”是所有采样器里最省的结构),实现只要一个 估计、一组系数、一次加减。对任何已有扩散模型的推理管线,它就是最合理的保底采样器;后面所有高阶方法的收益,都是在这条基线上把”NFE → 质量的映射”往前推。
第二层:显式 Euler 与 Heun——通用 RK 方法为什么对扩散不够好
Euler 与 Heun 的形状
把扩散 ODE 写成 ,最简单的显式 Euler 是
二阶的 Heun(改进 Euler / 梯形法)每步两次评估——先用 Euler 走一步得到预测点,再在预测点算一次,取平均:
数学上很干净:二阶方法局部误差 、全局 ,理论上用一半步数就能达到 Euler 的精度。EDM 论文(Karras 等人,2022 年,Elucidating the Design Space of Diffusion-Based Generative Models)的 Algorithm 1 就是 Heun:先按 的导数算出 ,做一次 Euler 步,再在预测点评估一次、用梯形平均做校正;论文明确提到,最后一步 时无法求导(分母为零),要退回 Euler,实现上直接跳过校正步。
为什么通用 RK 在扩散上吃亏
传统 RK 方法把 整个当作黑盒,用区间中间若干次评估的组合去逼近积分
但扩散 ODE 的右侧是半线性的: 是精确已知的线性项,只有 那部分是非线性的。RK 方法同时逼近两项,而线性项精确解里含指数因子(EDM 论文指出,VP 型 ODE 的解在大 端趋于水平线,VE 型则在数据附近剧烈弯曲),用多项式插值去逼近指数曲线,步长稍大误差就会指数放大。DPM-Solver 论文直接引用了这一经验:显式 RK 用在半线性 ODE 上,大步长时容易出现数值不稳。
Heun 的第二个问题是 NFE 翻倍。一次 Heun 步等于两次网络前向,DDIM 一次前向走一步。在 DiT 这类大主干上,每一次前向都是全序列注意力 + FFN 的完整开销,远高于”多写几行积分代码”。工程上真正的比较单位是 NFE 而不是步数:DPM-Solver 用 10 NFE 达到 DDIM 100 NFE 的效果,等于把主干成本压缩一个数量级;Heun 用 20 NFE(10 步 × 2)换来的只是二阶精度。
EDM 的 Heun 在”像素空间图像模型 + 非均匀噪声日程”这个组合下仍然非常好用,但它的收益依赖两件事同时做对:换一个 呈几何级数分布的噪声日程,以及 Heun 的梯形校正。EDM 论文 Figure 2 把这几项改进拆开做了归因:每条曲线是一个采样器配置,横轴是 NFE(对数轴),纵轴是 FID。
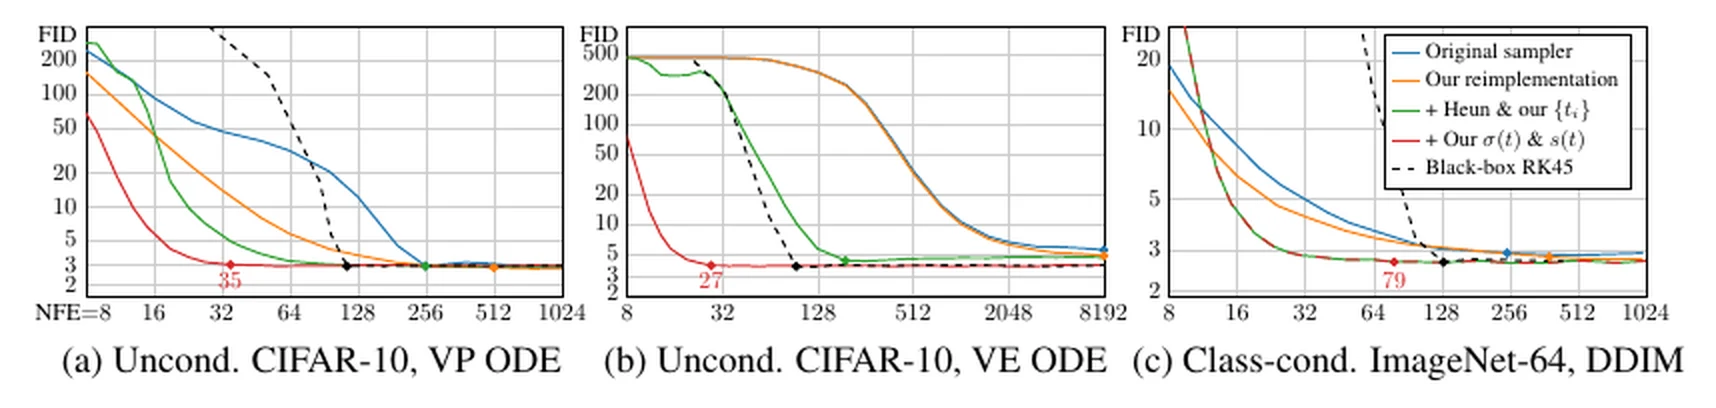
图上三组子图分别是 VP ODE 的 CIFAR-10、VE ODE 的 CIFAR-10、以及 DDIM 风格的 ImageNet-64。灰线是原论文采样器,黑线是把原采样器搬进统一框架后的重实现,然后依次叠加 Heun 与自定义步长、再叠加作者设计的 与 。图里最值得看的是”黑色实线与虚线的间距”:只换 Heun 和时间步网格,VE 模型就从几百 NFE 掉到几十;再换噪声日程,VE 的改进累计到论文所说的 300 倍。这说明采样器的收益不是单一旋钮,而是”积分器阶数 × 步长分布 × 噪声日程”三项的乘积;DPM-Solver 要解决的是更”即插即用”的问题:给定任意已有预训练模型和任意噪声日程,不重训也能把步数压下来。
第三层:DPM-Solver 的坐标变换—— 不是好变量
换到 log-SNR 坐标
DDPM 的 并不是数学上最自然的参数。DPM-Solver 论文选择以对数信噪比(log-SNR)的一半作为新变量:
接近 0 时 ,; 接近 时 ,。这个变换把 铺成整个实轴,并让”噪声与信号之比”变成一条直线。采样从噪声侧 走向数据侧 , 是递增的,因此步长记为
从 走到 ,log-SNR 增加 。论文里的 正是按同样方式定义的(,),符号统一后下面的公式不需要再换方向。
两个关键恒等式
论文从 VP 前向的定义直接推出两个恒等式。第一,扩散系数与 log-SNR 的关系(式 3.2):
第二,漂移系数 恰好是缩放率的对数导数。这两条放在一起,让”变分常数法”下的精确解(式 3.1)
化简成(式 3.3 的形式;这里改写成”起点 更噪、终点 更干净”的采样方向)
这个形式非常关键:线性项被精确解成 ,只剩一个对网络输出的指数加权积分需要数值近似。推导时用到 与 ;积分方向从 走向 (沿采样方向 递增,),被积函数是 与网络输出的乘积,积分值为正。这就是”指数积分器”名字的来源:指数权重是解析的,网络输出是慢变的,两者相乘后在 轴上用多项式近似。
第四层:一阶 DPM-Solver——与 DDIM 等价,但用指数代替线性
一阶近似
最朴素的一阶近似是把区间内 当作常量,积分只剩
于是从 走到 ()的精确解近似为
由 与 ,可以把上式整理成论文式 (3.6) 的形式:
括号里的 正是 log-SNR 步长的指数。推导只用到” 在区间内近似不变”,剩余误差项是 ( 为 轴上的步长)——这就是一阶。值得强调的是, 这一项是解析的指数,而不是它的线性截断;这正是 DDIM 与显式 Euler 的差别所在,后文会给出一致的形式。
与 DDIM 的等价性
把 DDIM 的更新式也写成 log-SNR 形式。由 ,DDIM 的更新是
最后一步用到 与 。两式完全一致。注意 不是 的线性近似,而是完整的指数——所以 DDIM 在步长大时比显式 Euler(其线性项用 近似)更稳,这正是论文说的”DDIM 充分利用了半线性结构,因此优于传统 Euler 方法”。一阶 DPM-Solver 在实现上可以认为”就等于 DDIM”,DPM-Solver 的增量全部从二阶、三阶开始。
一阶仍然不够
一阶近似的问题在噪声日程的两端。(纯噪声端)时 很小, 变化极快; 时 很小、 膨胀得很快。此时” 近似常量”的误差被指数权重放大,一阶方法的少步收益有限。阶数才是下一个台阶。
第五层:二阶与三阶——让误差项顺着轨迹走
二阶:中点评估
DPM-Solver-2(论文 Algorithm 1)的逻辑比”二阶 RK”简单得多:在 log-SNR 中点做一次额外评估,用两个评估点的差去修正积分。设本步从 到 ,步长 ,中点 定义为 对应的时刻。
第一步,用起点评估 走到中点(一阶 DPM-Solver 形式,步长为 ):
第二步,在中点再评估一次 ,然后直接把它当作终点处的评估值走完整个区间:
是”如果网络输出在全程等于 时轨迹会经过的中点”, 上的评估值 比 处的评估值更接近整段区间的代表值。局部误差从 降到 ,代价是中点那次额外评估——因此 DPM-Solver-2 每步 2 次 NFE。
论文 Theorem 3.2 的收敛保证是:终点误差 ,其中 是最大 log-SNR 步长。注意这个误差界里的 是 轴上的步长,而不是时间 的长——这也是后面”步长应该在 轴上等距”的依据。
三阶:两个中点, 变量累积
DPM-Solver-3(论文 Algorithm 2)取 轴上的 、 两个中间点,每步三次评估。它引入了两个”差分变量” :
以及在第一个中点处评估得到的 上,再做一项带权修正(论文 Algorithm 2 第 7 行):
最后一步用第二个中点的差分 做同样的带权修正,得到终点值。这两个修正项的形式————看起来古怪,含义是”用一阶近似与真实积分之间的差,把中间点的预测拉回指数积分应有的曲线上”。参数 的选取保证在三阶精度下各项展开正好抵消。
三阶的 NFE 账:为什么 NFE 不能被 3 整除时要”补一步”
论文 Appendix C 提到一个实现细节:少步采样时要把 NFE 用满。当总 NFE 不能被阶数整除时,先尽量用高阶步,剩下的 1 或 2 次用低阶补齐。例如设 NFE=10:三次三阶步用掉 9 次,最后 1 次用一阶收尾;NFE=11 则是三次三阶步加一次二阶。这个细节在自研采样器里最容易漏:单纯”总 NFE 除以阶数取整”会让最后一段区间用超大步长走完,画面上表现为边缘细节缺失或构图偏移。
对服务端还有一个对账问题:名义 NFE 与实际前向次数不一定相等。阶梯补齐、CFG 在部分步跳过、缓存复用都会改变实际次数,统计延迟最好以实际 kernel 调用次数为准,而不是用”步数 × 阶数 × CFG 倍率”估算。
阶数的收益为什么集中在少步区间
DPM-Solver-3 的中间点按 等距选取,而不是按时间 等距。如果按 等距,在两端会出现”采样点极度不均”——一端与相邻点距离过近,评估贡献被浪费; 等距则让每一段的指数权重变化幅度相近。
论文 Table 6 扫描了一到三阶在 10–20 NFE 下的 FID,趋势是:10–12 NFE 区间三阶的收益最明显,20 步以后一阶与三阶的差距显著收窄。原因在 NFE 的账本里:三阶每步 3 次评估,固定 NFE 下只能走 1/3 的步数,当步数本来就多时,高阶的额外评估反而被摊薄。所以”选阶数”实际上是”给定 NFE 预算时,把评估分配到更多步(低阶)还是更少的步(高阶)“。
一阶、二阶、三阶放在同一张 NFE 表里
| 方法 | 每步 NFE | 局部误差 | 最适用的 NFE 区间 |
|---|---|---|---|
| DDIM | 1 | 50+,保底方案 | |
| DPM-Solver-1 | 1 | 与 DDIM 等价 | |
| DPM-Solver-2 | 2 | 12–25 | |
| DPM-Solver-3 | 3 | 10–15 | |
| Heun(EDM) | 2 | 论文日程下约 35 NFE | |
| 自适应 DPM-Solver-12/23 | 不定 | 混合 | 精度优先、批小 |
这张表的关键读法:当 NFE 固定在 10 左右时,DPM-Solver-3 的 3 步 × 3 阶结构比 DPM-Solver-1 的 10 步 × 1 阶更好;当 NFE 在 20 以上时,二阶的 10 步 × 2 阶已经够用,三阶的额外评估赚不回成本。
第六层:自适应步长——为什么论文有、工程里少用
Algorithm 6/7 的结构
DPM-Solver 论文的 Algorithm 6(DPM-Solver-12)与 Algorithm 7(DPM-Solver-23)是自适应步长版本。以 12 为例:
- 在每一步里,先用 DPM-Solver-1 与 DPM-Solver-2 对同一个区间各算一次(二者共享起点评估,故额外开销为 1 次);
- 把两者之差当作局部误差估计 ,其中容差 ;
- 若误差低于阈值就用一阶结果扩大步长,若高于阈值就用二阶结果缩小步长。论文给的默认参数是 、、初始步长 、安全系数 ——后者是经典自适应 ODE 求解器的通行做法。
两个工程代价
代价之一是NFE 不可预测。图像服务的显存预算、批大小、CUDA Graph 的桶形、KV 缓存都是按固定步数规划的;自适应步长让每一步的前向次数取决于样本本身,调度就难以预先算清。批内样本的误差最大值决定整批步长,一个”难样本”会拖慢整批。
代价之二是它和多步方法、缓存复用冲突。自适应允许”某些步只走一阶、某些步走二阶”,如果采样器同时在用前几步的评估值(多步方法),一旦某步被跳成不同阶,缓存的评估值就对不上了。
因此生产系统里的常见选择是固定步数 + 二阶多步采样器,把”自适应”放到”选哪些步做完整前向”(视频侧的跨步缓存)上,而不是”每步多大”。这与 EDM 对步长日程的结论一致:论文经过分析认为步长只要随 减小而单调减小即可,不需要逐样本变化,一个全局的 日程足以。
第七层:DPM-Solver++——从噪声预测换到数据预测
大 guidance scale 下的高阶不稳定
DPM-Solver++(Lu 等人,2023 年,arXiv 2211.01095)的出发点不是”更高阶”,而是”高阶在引导采样下不稳”。它是 DPM-Solver 同一第一作者的后续工作,论文标题就写明了目标场景:Fast Solver for Guided Sampling of Diffusion Probabilistic Models。论文 Section 3 指出两个问题:
- 大引导系数放大导数。 这类强 CFG 会同时放大 的输出与其导数,而 ODE 求解器的收敛半径取决于导数大小;导数被放大后,高阶方法需要小得多的步长才能收敛,于是阶数越高反而越差,论文报告高引导下 15 NFE 的高阶结果甚至不如一阶 DDIM。
- 训练-测试不匹配。图像数据落在有界区间(如 ),强引导把条件噪声预测推离真实噪声,使收敛解 跑出边界,生成画面饱和、不自然。
论文 Figure 1 的视觉对比很直观:同一预训练的 ImageNet 256×256 模型、同一分类器引导系数 、同样 15 NFE,不同的采样器与阶数依次排列。
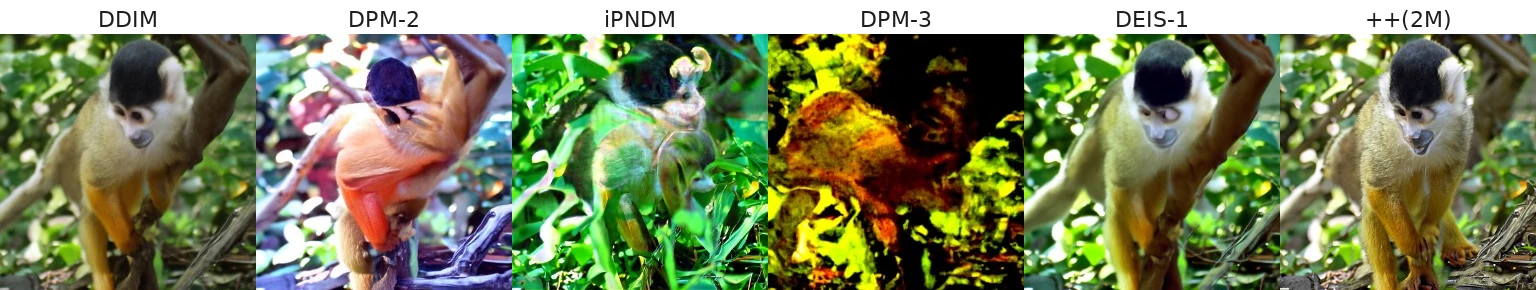
从 DDIM 到 DPM-2、iPNDM、DPM-3,再到 DEIS-1,这些基于噪声预测的高阶解法在强引导下普遍出现饱和色块与结构崩坏,阶数越高越明显;最右一格换成 预测的 DPM-Solver++(2M) 后才回到可用区间。这组样本不是”哪个采样器更漂亮”,而是”同一条 ODE 的不同参数化,在强引导下数值稳定性完全不同”——论文的解释是:强引导同时放大网络输出及其导数,高阶方法的收敛半径随阶数收窄,导数被放大后需要小得多的步长;而 参数化的解本身有界,再配合阈值钳制,误差不会指数放大。
数据预测形式与常数变易
DPM-Solver++ 的解法是:不再对噪声 ODE 求高阶,而是对等价的 预测 ODE 求解。两者数学完全等价,但设计出的求解器不同。论文 Proposition 4.1 给出 形式下的精确解(沿用本步骤号:起点 更噪、终点 更干净):
对比噪声版本:噪声 ODE 精确解算的是 ,被积函数是 ; 版本精确解算的是 ,被积函数是 。这带来两个实用效果:
- 形式与阈值截断(thresholding)天然兼容—— 可以把每步预测直接裁到数据边界内,缓解训练-测试不匹配;
- 形式与 SD 系列模型输出(或 Flow Matching 模型的 相互换算)更接近,现代管线里少一层缩放。
DPM-Solver++(2M):多步二阶
单步二阶(DPM-Solver++(2S))每步内部两次评估,中间的 用一次就丢。论文 4.2 节提出多步二阶(DPM-Solver++(2M)),利用上一步与上上步的评估值插值,每步只需 1 次新评估。Algorithm 2 的结构:
是两次相邻评估的线性外推:(步长均匀)时就是 ,即 Adams-Bashforth 二阶外推。论文给出的关键比较是:同样 N 个总评估,多步方法可以走 N 步,k 阶单步方法只能走 N/k 步,所以多步方法的步长 约是单步的 ,局部截断误差 也相应更小。
这一条把 20 步配置的成本账彻底改写:diffusers 里的 DPMSolverMultistepScheduler 默认就是 2M 多步结构,每步 1 次前向,20 步 = 20 NFE;论文在 SD 上报告它能用 15–20 步达到官方 PNDM 50 步相近的 latent 收敛误差,像素空间的对比中则明显优于同 NFE 的 DDIM。这也是 SD/SDXL 生态里”20 步为什么够”的主要来源。Flux 这类 flow 模型不使用这个 scheduler,它们的 20–28 步对应的是 flow 侧的 Euler 采样器,机制在第八层讨论。
潜在空间上的收敛速度
论文 7.2 节在 Stable Diffusion 上验证了这一点:官方管线默认 PNDM 50 步,DPM-Solver++(2M) 15–20 步即可达到相近的 latent 收敛误差。这里有一个容易被误读的细节:latent 空间上各求解器的 FID 都很接近(10 步内都在 15–16 附近),因为 VAE 解码器能”修饰”未完全收敛的 latent;所以论文用 latent 的 L2 收敛误差 来区分求解器质量,而不是 FID。对推理服务来说,这意味着在潜空间扩散里,采样器质量的差别体现在”更少步数是否仍然稳定”,而不是 FID 榜单。
第八层:Flow Matching 与 rectified flow——把轨迹拉直换大步长
换一套参数化,公式几乎不变
第一篇讲过 Flow Matching 的训练目标:构造一条从噪声到数据的条件路径,回归路径上的速度场。推理时解的是
最常用的线性插值路径(rectified flow 的写法)是
对 求导得到条件速度 ,训练目标就是让网络回归它。推理从 的纯噪声出发,沿速度场积分到 。
这套符号与扩散的差别只是”时间轴怎么定义”:把扩散的幅度系数写成 、,立刻有 ,和前面的 log-SNR 完全同构。所以前面所有关于阶数、误差、步长的结论都可以直接搬过来:Euler 是一阶、每步 1 NFE;Heun 是二阶、每步 2 NFE。diffusers 里的 FlowMatchEulerDiscreteScheduler 就是这套符号下的 Euler,而各类 flow 多步采样器则是把 DPM-Solver++ 的 形式换到 flow 时间轴后的版本。
轨迹越直,步长越大
rectified flow 论文的核心论点可以用一句话概括:Euler 离散化的误差与轨迹的曲率成正比。如果速度场在整条路径上近似常量,一步就能从噪声走到数据;轨迹弯折越多,同样的步长误差越大。
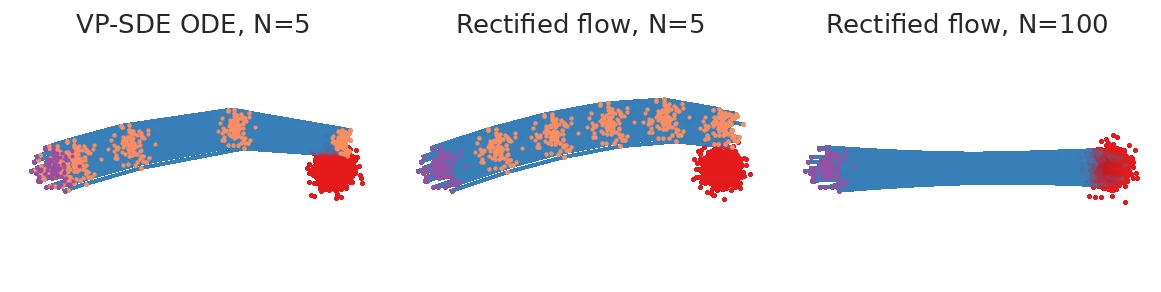
三张子图从左到右是:VP-SDE ODE 只走 5 步、rectified flow(经一次 reflow 迭代拉直后)走 5 步、rectified flow 走 100 步。第二张与第三张几乎一致,说明 5 步已经足够;第一张的轨迹在两端明显弯折,5 步的中间点偏离了目标分布。原因不是”rectified flow 的采样器更高级”,而是训练时就把轨迹拉直了——论文用 reflow 迭代降低曲率,并用”straightness”指标定量衡量。这是”模型结构与采样器协同设计”的典型例子:采样步数的上限,在训练目标选定时就大致决定了。
实践中的 flow 采样配置
SD3 与 Flux 这一代模型普遍采用 rectified flow / flow matching 目标,配套的采样器配置有三个常见选择:
- Euler:每步 1 NFE,20–30 步是常见区间;Flux.1-dev 的社区配置常用 20–28 步;
- Heun:每步 2 NFE,用于对轨迹曲率敏感、需要更高精度的场景;
- 二阶多步(flow 侧):把 形式的二阶多步结构搬到 flow 时间轴,目标是在 15–20 步区间拉开与 Euler 的差距。这套实现比扩散侧年轻,不同管线之间的默认步长与 shift 不完全统一,配置时要按模型实测收敛而不是照搬。
这里有一个容易踩的坑:flow 的”时间”与扩散的”时间”不是同一个参数。flow 用 表示纯噪声、 表示数据,扩散的 DDPM 下标则用 表示噪声、 表示数据;如果照抄扩散采样器的代码,时间步的取值方向、 与 的对应关系都会反过来,表现为”越采样越噪”而不是收敛。工程上的判断方法很直接:跑一步看 latent 的范数应该向数据尺度靠拢,而不是发散;再看 处的输出是否落在 VAE 的输入范围(而不是被 clip 到边界)。
第九层:随机采样、EDM 的 churn 与确定性轨迹的取舍
一条 ODE 为什么能”倒着走”
反向积分能成立,依赖概率流 ODE 的一个性质:它在时刻 的映射 是从数据分布到 的可逆变换(在 的支撑上),而且逆映射同样由同一个分数场定义。把真实图像编码回 latent(inversion)、或者对一张图做”加噪到中间再重采样”(SDEdit 类编辑),都是在用同一个网络沿轨迹反向前进。
这种”可逆性”要求积分器是确定性的:每一步的更新是 的确定函数,没有随机数。DDIM 与 DPM-Solver 满足这一点;DDPM 的随机反向链不满足(同一步在不同随机数下走向不同点),EDM 的 churn 类采样器也不严格满足(每步注入新噪声后,“反向前进”需要知道注入的噪声)。所以图像编辑类工作普遍绑定 DDIM/DPMSolver 采样器,而在同一模型上换成随机采样器,同一张图的 inversion 结果会明显漂移。
随机性带来什么
EDM 论文把 SDE 写成概率流 ODE 加一项 Langevin 扩散与噪声注入的组合:
其中 表达”旧噪声被新噪声替换的相对速率”。EDM 的解读是:Langevin 项把样本往当前时刻的边缘分布推,主动修正前面步数累积的误差,所以随机采样通常质量更好;但用 SDE 离散化来近似这一项本身又引入误差。EDM 的随机采样器就是在确定性二阶积分器上加入”加噪声—积分—去噪声”的 churn,让噪声量级每步先升后降、在 轴上做小范围往返。
对服务系统的意义
- 随机采样在相同步数下质量更好,但同一 prompt + seed 每次结果不同,可复现性差;
- 确定性采样(DDIM / DPM-Solver)可以反向积分,把真实图像编码回 latent(图像编辑、SDEdit 类工作依赖这一能力);
- 对于需要批内一致、可缓存、可 CUDA Graph 捕获的服务,确定性采样器是更好的选择——每一步是纯计算、没有随机数依赖,kernel 形状完全固定。
这就是为什么生产图像服务普遍以 DDIM/Euler/DPM-Solver++ 为主,随机采样更多用于”质量优先、延迟不敏感”的离线生成。
第十层:采样器如何接进推理服务
调度器:把”步数”翻译成”时间步序列”
采样器负责”怎么走一步”,调度器(scheduler)负责”在哪些时刻走”。这两件事在论文里经常一起出现,在代码里是两个对象。一个调度器要决定四件事:
- 训练时间步网格:离散模型在 个训练噪声水平上训练(如 1000 步),推理步数 时需要从网格里挑 个;
- 挑选方式:
leading(从前向后取)、trailing(从后向前取)、还是按 log-SNR/ 重采样; - 的分布:DDIM 常用均匀或二次方步长;Karras 等人提出 的几何式分布, 是 EDM 的默认值,让低噪声端步长更密;
- 预测类型:模型输出是噪声、速度还是 ,决定采样器要做的换算。
diffusers 的 scheduler.config 里 prediction_type、timestep_spacing、use_karras_sigmas 三个字段就是这四件事的开关。同一个模型换 scheduler 后效果差异大,往往不是模型变了,而是第 2、3 项把”20 步覆盖了哪些噪声水平”改了——这正是”同样 20 步,质量却不一样”的常见原因。
一次 20 步请求的账怎么算
把一次图像生成的成本拆开,可以写成
其中每步主干 FLOPs 大致是 ( 是主干参数量, 是 latent token 数,系数 2 来自乘加),注意力部分另按 计。对 1024×1024、latent 下采样 8 倍、patch size 2 的 DiT,;20 步就是 20 次全序列前向。采样器自身的开销是多少?每一步只做十几次标量乘加与一次 的向量更新, 是 latent 维度(如 ),大约百万级浮点运算——相对主干的百亿级 FLOPs 完全可忽略。
这条账带来两个直接结论:
- 优化采样器代码没有意义,优化的对象只能是 NFE;
- CFG 是 NFE 的乘数:无蒸馏模型每步要算条件与无条件两次前向,20 步配置实际是 40 次主干前向。把 CFG 蒸馏掉(或少步蒸馏),等价于把 NFE 减半,比换采样器更划算。
结论一:NFE 是硬预算
一次图像生成的延迟 ≈ 单步主干耗时 × NFE × CFG 倍率。CFG 最贵(直接 ×2),步数次之(线性),采样器阶数是”在同样 NFE 下把质量推高”的旋钮。DPM-Solver 论文 Table 7 给出的单批运行时间随 NFE 近乎线性增长——运行时基本由前向次数决定,采样器本身的 CPU 开销可以忽略。一个服务的优选顺序是:先把 CFG 蒸馏掉(第四篇讨论过),再把 NFE 压到二阶多步的区间,而不是先降分辨率。
结论二:视频侧采样器与缓存必须联动
第五篇讲过视频侧的跨步缓存(DiTFastAttn、FasterCache、Wan 的 attention cache)。缓存的基本假设是”相邻步输出相似”,而这恰恰也是二阶/多步采样器把相邻步评估做插值时的假设。两者叠加不是简单加速:缓存失效的时刻,往往就是插值开始失真的时刻。工程上更稳的做法是把缓存触发条件从”固定隔几步”改成”看相邻评估的差量”,这与 DPM-Solver 局部误差估计的思路同源。
结论三:少步蒸馏模型里一阶反而更稳
一致性模型、DMD 这类 1–8 步模型把”采样器收敛到轨迹”的前提弱化了——它直接输出终点。此时一阶与二阶的差别变小,但一阶的稳定性更重要:极少步数下二阶的中间点评估可能落在网络没训练过的位置,画面会崩。所以少步模型常见一阶 DPM-Solver / Euler,二阶通常只在 8 步以上配置里使用。
结论四:分辨率变化要改 shift,采样器的不变性要一起看
第四篇讨论过 SD3 的 timestep shifting。采样器系数全部依赖 的解析形式;Flow Matching 模型换了时间步网格或用了 resolution shift 之后,log-SNR 轴上的”等距步长”对应的实际噪声日程会变。如果沿用旧配置,“同样 20 步”在不同分辨率下的有效覆盖区间不同,质量会出现莫名劣化。服务端把分辨率、shift、采样器阶数三者一起调,是稳定产出的前提。
结论五:CUDA Graph 与固定 NFE 绑定
采样器每一步的输入形状是”当前 latent + 时间步标量”,在固定分辨率、固定批大小、固定步数下,每次前向的 kernel 形状完全一致,可以整段捕获成 CUDA Graph。这是扩散服务与 LLM 解码一个很重要的差别:LLM 的 KV 长度每步增长,需要分桶;扩散的 token 数从头到尾不变,只要步数固定、CFG 开关固定,整个采样循环就是一张静态图。一旦引入自适应步长或动态 guidance interval,图就要按分支重捕获,收益立刻消失。这是”论文里的自适应步长在工程里少用”的另一个原因。
结论六:guidance interval 能把 NFE 再砍一截
不少管线只在中间一段噪声区间启用 CFG,前期与后期用单次条件前向。理由与 CFG 的机制有关:高噪声端 CFG 主要影响构图与语义,低噪声端主要影响纹理;在两端跳过无条件分支,视觉损失有限,但能省下 20%–40% 的前向。它与采样器阶数是正交的旋钮,但要注意:跳过 CFG 的步会改变 ODE 本身,采样器的局部误差估计不能直接套用,配置要按模型实测。
第十一层:步数上限在哪里——离散误差与模型误差的地板
采样器的误差可以拆成两项:
第一项随步数增加按 下降,第二项与步数无关。这解释了一个常见的经验现象:从 200 步降到 50 步,质量几乎不变;从 50 步降到 20 步,多数模型仍可用;从 20 步降到 10 步,开始看采样器;降到 5 步以下,必须靠蒸馏。
原因是当 足够小时, 已经小于 ,继续加步数只是在逼近”网络定义的这条 ODE 的精确解”,而这个精确解本身就带着网络近似误差与引导偏差。换句话说,采样器只能让你”更准确地到达网络想去的地方”,不能修正网络想去错地方。
这给服务配置一个很实际的判据:先用一个高步数配置(如 100 步 DPM-Solver-2)作为参考轨迹,再逐步降步数;当输出与参考轨迹的 latent L2 误差开始明显上升时,就是该模型在该采样器下的”步数地板”。DPM-Solver++ 论文在 SD 上正是用这个口径比较求解器:用 999 步 DDIM 的结果作为 ,比较各采样器的收敛误差,而不是只看 FID——因为 FID 会被 VAE 解码器”美化”,掩盖 latent 上的真实偏差。
一个可直接照抄的采样循环
把上面的机制落成代码,DPM-Solver-2 的主循环只有十几行。下面用伪代码给出结构,重点是”中点按 取、终点用中点评估”这两个细节:
import torch
def dpm_solver_2_step(model, x, t, s, alpha, sigma, lam): """从时间 t(噪)走到 s(净),h = lam(s) - lam(t) > 0。""" h = lam(s) - lam(t) eps_t = model(x, t) # 第 1 次 NFE
# 1) 在 log-SNR 中点 t_mid = lam^{-1}(lam(t) + h/2) 做预测 lam_mid = lam(t) + 0.5 * h t_mid = invert_lambda(lam_mid) u = (alpha(t_mid) / alpha(t)) * x - sigma(t_mid) * (torch.exp(0.5 * h) - 1.0) * eps_t
# 2) 中点处的评估直接用于终点更新 eps_mid = model(u, t_mid) # 第 2 次 NFE return (alpha(s) / alpha(t)) * x - sigma(s) * (torch.exp(h) - 1.0) * eps_mid这段代码里有两个容易写错的地方。第一,invert_lambda 必须用训练时的噪声日程反解,不能用均匀时间网格代替——否则中点会落在错误的噪声水平上,二阶精度退化为”看起来像二阶、实际是一阶”。第二,终点的系数用的是 exp(h) - 1 而不是 h;换成线性近似就等于退回 DDIM,二阶评估白做。
在 diffusers 里不需要自己写循环:DPMSolverMultistepScheduler 已实现 2M 多步版本,切换采样器只需替换 scheduler 对象并传入模型输出的预测类型(epsilon、v_prediction 或 sample):
from diffusers import DPMSolverMultistepScheduler
pipe.scheduler = DPMSolverMultistepScheduler.from_config( pipe.scheduler.config, algorithm_type="dpmsolver++", # x0 预测形式 solver_order=2, # 二阶多步 use_karras_sigmas=True, # 配合 Karras 噪声日程)image = pipe(prompt, num_inference_steps=20, guidance_scale=7.5).images[0]solver_order=2 时每步 1 次 NFE;algorithm_type 若误设为 "sde-dpmsolver++" 会引入随机项,同一 seed 的结果不再可复现。这类配置差异在”换一个 scheduler 出图风格就变了”的现象里占了很大比例。
局限与未解决的问题
- 自适应步长与批处理、缓存冲突:前文已述,DPM-Solver-12/23 在批内步数不一致时会破坏多步评估缓存,生产很少直接使用;
- 对噪声日程的强依赖:DPM-Solver 的系数推导依赖 的解析形式;对 cosine、flow 自定义日程需要额外校正,否则”精确线性项”的推导退化;
- 多分辨率与视频的密度偏差:视频、高分辨率图像的每像素噪声水平不同,按固定 log-SNR 步长积分会对高分辨率样本产生偏置,需要 shift 补偿;
- 无条件的收敛保证有限:Theorem 3.2 的误差界依赖网络输出满足正则性条件,实际蒸馏模型(尤其是被裁剪或量化过的)不一定满足;
- 二阶以上的收益需要”平滑网络”:FP8/INT8 量化推理会让网络输出带有较大抖动,评估点之间的差被噪声放大,高阶插值未必比一阶更准;量化扩散模型里常用”一阶 + 小步数”,而不是二阶。
工程排查清单:采样配置出问题时先看这五处
采样器本身只有十几行公式,但”出图不对”的现场问题很少真的是公式写错。按出现频率从高到低,可以先查这五处:
- 时间步方向。DDPM 用整数下标, 表示数据、 表示噪声;flow 用浮点 ,同样是 数据、 噪声,但时间轴尺度与训练时的采样方式不同。把 DDPM 的整数下标直接喂给 flow 采样器、或者把 flow 的 当 DDPM 下标用,表现是”前几步看起来还行、后面越来越糊或越来越噪”;
- 与 的定义。有的实现里 存的是方差 、有的是幅度 ;latent 还要额外乘 VAE 的 scaling factor(Stable Diffusion 是 0.18215,Flux 不同)。系数乘错一次,图像会整体偏色或对比度异常,但结构还在;
- 预测类型。模型输出是 、 还是 ,三者可互相换算,但换算需要正确的 。scheduler 的
prediction_type与模型训练配置不一致时,最简单的表现是”20 步出的图和 50 步出的图都糊”,因为每步的更新方向本身就偏了; - CFG 的批次排列。CFG 把条件和无条件样本拼成一个 batch 跑一次前向,索引排反(无条件在前、条件在后)会让引导系数作用在错误方向上,效果是”负面词起作用、正常词不起作用”或整体过饱和;
- VAE 的 latent 范围。扩散在缩放后的 latent 空间做,采样终点如果落在未缩放空间,解码后画面整体偏灰或偏亮。SD 系列的 scaling factor 是 0.18215,Flux 用不同的换算,换模型时必须跟着换。
这五处的共同点是:它们都不会让循环报错,只会让输出”不像”。所以排查时不要从采样器公式开始,而是先用已知正确的参考实现(diffusers 对应 scheduler)在同一模型上跑,对比 latent 的统计量(均值、方差、范数)是否逐点一致;一旦第一、二步的 latent 就发散,问题一定在系数或方向,而不是阶数。
与站内其他扩散工作如何衔接
- 第二、三篇讨论的离散扩散语言模型不依赖这条连续 ODE,但”步数即成本、块内并行改变成本结构”的思路与本篇的 NFE 账同源;
- 第四篇的潜空间扩散正是本篇”每步主干的 token 数 从哪来”的来源,VAE 下采样因子直接决定 ;
- 第五篇的视频扩散里,Distillation 与跨步缓存是在采样器之外的另外两个旋钮,与本篇的”阶数/步长”正交;
- 站内讨论块扩散投机解码的 DFlash 块扩散解码:以并行扩散替代自回归草稿,实现无损 6 倍推理加速 把”块扩散去噪”当作草稿生成器,它内部的去噪步数同样受本篇误差-步数关系的约束。
小结
- 扩散采样可以写成概率流 ODE;DDIM 是这条方程的一阶指数积分器,每步一次前向、误差 ,与 DPM-Solver-1 形式等价。
- 通用 RK(Euler、Heun)对半线性 ODE 的线性项处理不理想,线性项解含指数因子、大步长误差会指数放大;Heun 每步两次评估、二阶精度,在少步区间不划算。
- DPM-Solver 的核心是”线性项精确积分、只对网络输出做近似”的指数积分器:换到 log-SNR 后,精确解是 减去 的加权积分;一阶、二阶、三阶分别用常数、中点、两个中点的近似,局部误差 、、。
- 阶数的收益集中在 10–15 NFE;NFE 预算变大后,二阶多步是更划算的选择。
- DPM-Solver++ 把积分变量换成 ,数值更稳、可配阈值截断,2M 多步版本每步 1 次前向、成为
diffusers多步采样器的默认实现;SD 官方 PNDM 50 步可压到 15–20 步。 - 自适应步长(Algorithm 6/7)有理论价值,但 NFE 不可预测、与批处理与缓存冲突,生产多用固定步数 + 二阶多步。
- 随机采样(EDM 的 churn 类)质量更好但可复现性差;确定性采样更适合可缓存、可图捕获的服务管线。
这个系列从 DDPM 的数学主线走到离散扩散系统、潜空间与视频结构,再落到本篇的采样器数值细节。前面所有”多少步就够”的结论,本篇给出了背后的数值机制;如果要继续往下展,最有价值的方向是采样器与调度器的联合设计——把 NFE 预算、缓存刷新、批内一致性放进同一个积分规划里。
参考资料
- DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps
- DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps(HTML 全文,含全部算法与表格)
- DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models
- DPM-Solver++(HTML 全文,含 Proposition 4.1 与 Algorithm 2)
- Elucidating the Design Space of Diffusion-Based Generative Models(EDM)
- Denoising Diffusion Implicit Models(DDIM)
- Score-Based Generative Modeling through Stochastic Differential Equations
- Flow Matching for Generative Modeling
- Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
- Diffusers
DPMSolverMultistepScheduler源码 - Diffusers
FlowMatchEulerDiscreteScheduler源码 - Denoising Diffusion Probabilistic Models(DDPM)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



