


视频到视频编辑架构入门:从逐帧风格化到 TokenFlow 的时空 token 传播
先说清楚 V2V 要解决什么
视频到视频(Video-to-Video,V2V)的任务形式很朴素:给一段输入视频,再给一个条件——一句文本、一张风格参考图、一段深度或边缘序列,输出一段每一帧都被改写、但时间上仍然连贯的视频。它和文生视频(Text-to-Video,T2V)、图生视频(Image-to-Video,I2V)的区别不在模型大小,而在约束的来源:T2V 只需要从噪声里生成一个合理的世界,I2V 只需要让这个世界从给定首帧开始演化,而 V2V 的每一帧都已经被输入视频钉死了构图、运动、遮挡关系和物体身份。模型不能重新想象一个世界,只能在这个世界的骨架上换掉外观、材质、风格或局部内容。
这件事在工业上比 T2V 更常见。影视后期要把实拍素材转成动画风格,广告要把白天街道改成夜景,老片修复要逐帧去噪与上色,短视频工具要把人物抠出来换背景。它们的共同点是:输入视频的结构必须保留,输出视频的帧与帧之间不能闪。也正因为如此,V2V 的核心难题不是“画得好不好看”,而是“相邻两帧画的是不是同一个东西”。
早期 V2V 用条件 GAN 解决这个问题。NVIDIA 的 vid2vid(Wang 等,NeurIPS 2018)把语义分割图序列翻译成街景视频,生成器是逐帧的,但训练时加入了光流 warping 损失:把上一帧生成结果按估计的光流 warp 到当前帧,要求它与当前帧生成结果一致。这个思路奠定了之后所有 V2V 系统的共同骨架——先生成,再把生成结果沿运动轨迹对齐。扩散模型接棒之后,逐帧生成的质量大幅提升,但“沿运动轨迹对齐”这一步反而变得更难,因为扩散采样本身是随机的,同一个模型对两帧相似但不相同的输入可能落到不同的外观模式上。
本文按“时间一致性靠什么传递”把主流 V2V 架构分成几条路线:靠像素传播的经典关键帧方法,靠注意力传播的跨帧注意力方法,靠 token 身份传播的 TokenFlow,靠内容场传播的 CoDeF,以及靠结构条件约束的 ControlNet 路线。每条路线都会讲到它的机制、成立条件、失效边界和推理成本。
逐帧编辑为什么会闪
要理解各种 V2V 架构,先要看清一个反例:把输入视频的每一帧单独送进一个文生图模型,用同一句提示词编辑,再把结果拼回视频。单看任何一帧都可能是好图,连起来却会明显闪烁。原因有四层,而且一层比一层难修。
第一层是初始噪声独立。 扩散采样从高斯噪声开始,即使固定随机种子,每一帧的噪声张量也不同。对于内容不同的帧,这不会造成问题;但对于运动很小的相邻帧,不同的噪声会把采样推向不同的局部模式。更麻烦的是,文生图模型对同一提示词存在多个同样合理的解,比如“油画风格”可以对应厚涂、薄涂、点彩,帧与帧可能各自选中不同的解。
第二层是条件本身的微小差异被放大。 相邻帧的像素差异可能只有几个像素的位移,但经过 VAE 编码后,潜变量的差异会被非线性放大;去噪网络在每一步都对这个差异做一次非线性映射,几十步之后,两条轨迹可能已经分叉。这不是训练不足,而是扩散采样作为动力系统的敏感性。
第三层是运动与遮挡。 物体转动时,原本被遮住的表面会露出来;镜头推进时,画面边缘会出现新区域。这些像素在上一帧没有对应物,任何“把上一帧结果搬过来”的方法都无从搬运,只能让模型重新生成。重新生成就回到了第一层的问题。
第四层是编解码漂移。 如果管线是“解码到像素→逐帧编辑→再编码”,每次 VAE 往返都会引入细微色偏和纹理变化;这些变化在单帧里看不出来,在 24 fps 下会变成持续的亮度呼吸。
因此,V2V 的所有架构本质上都在回答同一个问题:如何让不同帧的生成过程共享足够多的信息,使它们落在同一个外观模式里,同时又不把运动锁死。 共享得太少会闪,共享得太多会把视频变成一张静止图的重复。
衡量闪烁需要一个可计算的指标。最常用的是基于光流的 warping error:设 是第 帧输出, 是从第 帧到第 帧的估计光流, 表示按光流做双线性采样,则
这个量越小,说明相邻帧在运动补偿之后越像。它有一个明显的缺陷:如果输出视频整体模糊或静止,warping error 也会很小,所以实际评测还要配合 LPIPS、CLIP 分数和人工主观评分。遮挡区域会天然产生大误差,通常要用前后向光流一致性筛出有效像素,只在非遮挡区域统计。理解这个指标很重要,因为后文每条架构的收益,最终都要落到这个量上。
前置基石:扩散模型如何在潜空间里改图
后面的各条路线都假设读者知道扩散模型采样一次的基本结构。这里用最小篇幅把与 V2V 直接相关的部分讲清楚,重点不是推导,而是看清“哪些环节可以被跨帧共享”。
潜空间压缩。 文生图模型不是直接在像素上去噪的。一个自编码器把 的图像压成 的潜变量,空间上缩小 8 倍。扩散在潜变量上运行,最后再解码回像素。这个压缩对 V2V 有三个含义:光流在像素空间算,warp 出来的结果要编码回潜空间才能继续去噪;潜变量每个位置对应 8×8 像素块,所以 token 级的一致性只在 8 像素的粒度上成立;VAE 编解码本身不是完美无损的,反复往返会累积色偏。
以 Stable Diffusion 的 U-Net 主干为例(Rombach 等,CVPR 2022),它由若干“下采样块 → 中间块 → 上采样块”组成,每个块里交替放卷积和 Transformer 块。自注意力只出现在低分辨率层(常见是 64×64、32×32、16×16 三档)。这意味着:跨帧共享越适合放在低分辨率层——那里每个 token 代表更大的图像区域,注意力便宜,而且语义更抽象,受纹理噪声干扰小。TokenFlow 的对应关系就是在这些层上算的。
采样与引导。 一个基础的采样循环是:从纯噪声 出发,对步 重复调用去噪网络预测噪声,按调度器更新 。分类器无关引导(CFG)把条件分支的无条件预测与条件预测做加权:
其中 是文本条件, 是空条件, 是引导系数。 越大越贴提示词,但画面对比度、颜色饱和度会过冲,帧与帧之间的过冲方向又不一致,所以 V2V 系统常把 压低,用跨帧机制来补一致性,而不是靠强引导。
为什么采样对初始条件敏感。 去噪网络在每一步都是非线性的, 的一个小扰动经过几十步会按雅可比矩阵的特征方向放大。设两条轨迹的初始差为 ,经过 步后差约为 量级的放大。这就是逐帧编辑闪烁的数学根源:即便相邻帧的输入几乎一样,不同的初始噪声也会把两条轨迹推到不同的吸引区。反过来,这个敏感性也为 V2V 提供了抓手:只要让不同帧共享初始条件或共享中间特征,它们就会被拉回同一个吸引区。
反演把真实视频变回噪声。 V2V 常用 DDIM 反演:沿确定性 ODE 的正向时间积分,把真实帧 映射到 。这个 不再是高斯噪声,而是“编码了这张图结构的噪声”。从它出发用新提示词去噪,输出会保留原图结构。反演的精度取决于步数与引导强度:CFG 引导越强,反演越不精确(因为反向过程不是正向过程的严格逆),于是有了 null-text inversion 一类方法,为每一步单独优化空条件嵌入来补偿误差。
一致性约束怎么落进采样。 有了上面这些,V2V 的一致性机制可以归成三个可插入的位置:
- 初始条件:让不同帧的 相关(关键帧传播的 warp、运动动力学)。
- 中间特征:在去噪的某几步,让不同帧的注意力或特征互相交换(跨帧注意力、token 轨迹)。
- 输出端:在解码后的像素上做光流混合(背景平滑、关键帧补帧)。
一个系统用哪几个位置,决定了它的成本与失效模式。下文的几条路线,基本是按“主用哪个位置”来区分的。
架构地图:时间一致性靠什么传递
把已有系统按“跨帧共享什么”排一遍,会得到一张很清晰的地图。共享的媒介不同,架构的复杂度、可编辑范围和失效模式也不同。
| 传递媒介 | 代表工作 | 跨帧共享的东西 | 主要代价 | 最适合的编辑 |
|---|---|---|---|---|
| 像素与光流 | EbSynth、Rerender A Video | 关键帧的 stylized 像素、光流对应 | 光流误差、遮挡 | 风格化、上色、老片修复 |
| 注意力 | Tune-A-Video、Text2Video-Zero | 参考帧的 K/V | 每帧多一次注意力、参考帧漂移 | 短片段、外观改写 |
| token 对应关系 | TokenFlow | 语义对应的 token 轨迹 | 对应搜索、特征存储 | 主体一致的风格/材质编辑 |
| 规范内容场 | CoDeF | 一张规范图 + 形变场 | 每段视频单独优化 | 长视频、重复运动 |
| 结构条件 | ControlNet 类 V2V、Gen-1 | 深度/边缘/姿态 | 结构估计误差、条件冲突 | 保留几何的换风格 |
这张表里没有“最好”的一列。选择取决于两件事:编辑要不要保留输入的结构,以及视频有多长。风格化、上色、去噪这类编辑几乎完全保留结构,关键帧传播最划算;把“白天改成夜景”“夏天改成冬天”这类全局外观改写,跨帧注意力更直接;把“把猫换成狗”这类主体替换,token 对应关系更合适;超过几十秒的长视频,则必须考虑分段与误差累积。
第一条路线:关键帧加光流传播
最经典也最便宜的做法,是只对少量关键帧跑生成模型,其余帧靠光流把关键帧的结果搬运过去。EbSynth 是这条路线最纯粹的代表:它甚至不是神经网络,而是一个基于样例的纹理合成器。给定一张手工或模型生成的风格化关键帧,EbSynth 用光流建立关键帧与目标帧的像素对应,再把关键帧的局部纹理块迁移到目标帧上,同时用多尺度 patch 匹配修复搬运带来的裂缝。
这条路线为什么有效?因为它把“生成”与“传播”解耦了。生成模型只负责回答“这一帧应该长什么样”,而且只在关键帧上回答;传播算法负责回答“其他帧如何沿用这个答案”。生成模型不需要理解时间,光流负责时间。于是显存和计算量都只与关键帧数量成正比,而不是与总帧数成正比。一段 10 秒、24 fps 的视频有 240 帧,如果每 12 帧取一个关键帧,只需要 20 次扩散前向,其余 220 帧都是光流和 patch 合成。
代价也来自这个解耦:传播只能搬运已经存在的像素。关键帧里没有的东西,光流搬不出来。物体转身时露出的背面、镜头拉远时出现的新区域、被前景遮住后又露出的背景,都属于“关键帧里没有”的内容,只能靠 patch 匹配去猜,猜错就变成糊块或重影。光流本身在大位移、无纹理区域、快速运动下也会失准,误差会沿着帧序列累积:第 5 帧的小偏差传到第 30 帧可能已经变成明显的漂移。EbSynth 的工程质量很高,但它无法突破这条信息论上的上限。
Rerender A Video:把关键帧传播做成一套可递归的系统
Rerender A Video(Yang 等,SIGGRAPH Asia 2023)把关键帧思路搬到了扩散模型时代,并补上了两个关键机制:递归关键帧选择与分层跨帧约束。它的流程可以概括为四步。
- 用光流估计整段视频的运动量,按累计运动幅度递归地选出关键帧。运动越大、越容易出现新内容的地方,关键帧越密。
- 每个关键帧用“文生图模型 + ControlNet 深度条件”渲染。深度图来自输入视频,保证关键帧的构图与实拍一致;文本提示决定风格。
- 关键帧之间用光流做像素级传播,把已渲染的关键帧 warp 到中间帧,作为中间帧的初始 latent。
- 对中间帧做少量去噪,并在去噪过程中加入跨帧注意力与 latent 融合,把传播带来的模糊、错位修正回来。
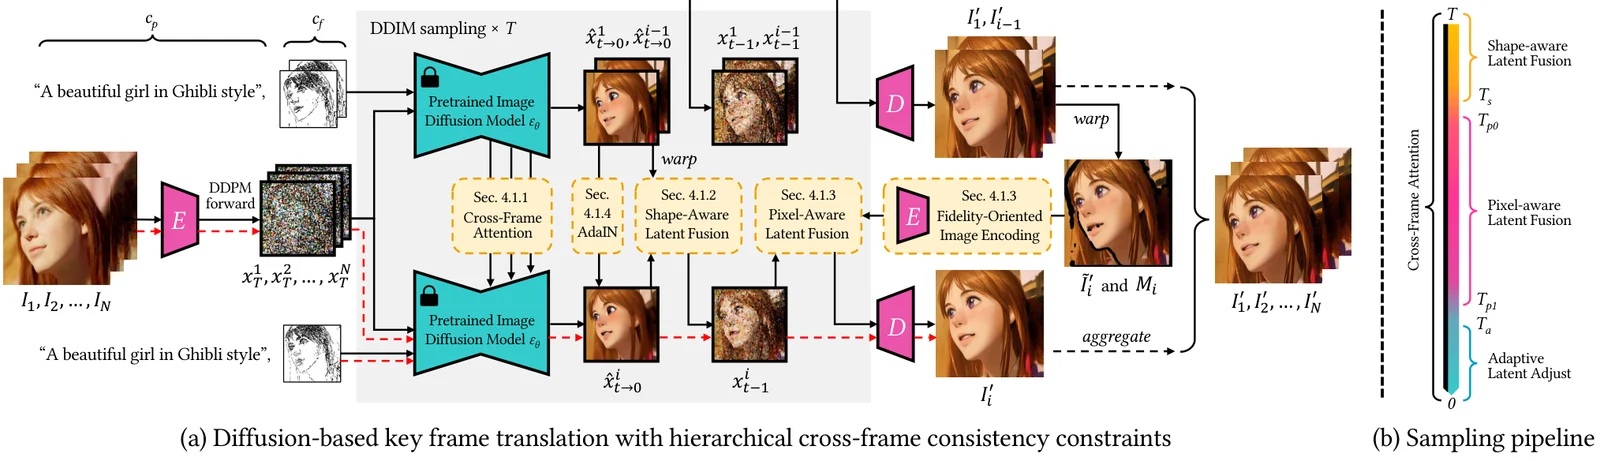
上图是 Rerender A Video 的管线。左侧是关键帧的扩散采样:文本提示加深度条件生成关键帧;右侧是中间帧的传播与修正:光流 warp 给出初始 latent,跨帧注意力从关键帧取 K/V,像素级与形状级两种 latent 融合负责把传播结果和模型先验拼在一起。图里出现的 shape-aware 与 pixel-aware 两条融合通路,分别处理“整体形状对不对”和“局部像素像不像”,这是它比朴素光流传播稳的原因。
这套设计的聪明之处在于把昂贵的扩散计算集中在信息量最大的帧上。关键帧承担“决定外观”的责任,中间帧只承担“把外观插值到正确位置”的责任。它不需要对整段视频做联合注意力,因此可以处理比 Tune-A-Video 长得多的视频;同时因为每个关键帧都有深度条件,结构保真度比纯文本驱动的逐帧编辑高得多。
它的局限同样清晰。关键帧选择依赖光流,光流在快速运动或遮挡处失准时,关键帧可能选错位置;中间帧的修正能力受限于“少量去噪步数”,如果传播初始值错得太离谱,模型没有足够步数把它拉回来;文本编辑如果要求改变结构(比如把桌子变成沙发),深度条件会强烈阻碍这种改变,因为 ControlNet 会把输入的几何硬压到输出上。
第二条路线:跨帧注意力
不让像素在帧间搬运,而是让注意力在帧间共享,是另一条更“模型内生”的路线。它的出发点很直接:扩散模型的自注意力层里,K/V 编码了当前帧的外观与语义。如果让第 帧的 query 去查第 1 帧的 K/V,第 帧就会倾向于生成与第 1 帧相同的外观。Tune-A-Video 与 Text2Video-Zero 都建立在这个观察上,区别在于一个要微调,一个完全不训练。
Tune-A-Video:把 2D 文生图网络“充气”成视频网络
Tune-A-Video(Wu 等,ICCV 2023)的做法是拿一个预训练的 Stable Diffusion,把它的 2D 结构改造成能看多帧的结构,然后在单段视频上做一次轻量微调。改造有两处。
第一处是把 2D 卷积换成伪 3D 卷积:卷积核从 变成 ,时间维核长固定为 1。这意味着卷积层不在时间上混合信息,只负责逐帧的空间特征。这样做是为了尽量保留预训练权重的作用——如果直接在时间维做 3×3 卷积,预训练的空间滤波器会被破坏,微调需要更多步数才能恢复。
第二处是把自注意力换成时空注意力(ST-Attention)。设第 帧的 query 为 ,Tune-A-Video 不让它查所有帧的 K/V,而是只查第一帧与前一帧:
其中 来自第一帧, 来自前一帧, 是每个头的维度。第一帧提供“全局外观锚点”,前一帧提供“局部运动连续性”。这个设计把注意力的 key/value 数量从 降到 ( 为每帧 token 数),计算量从 降到 ,代价是模型看不到更早的历史帧。
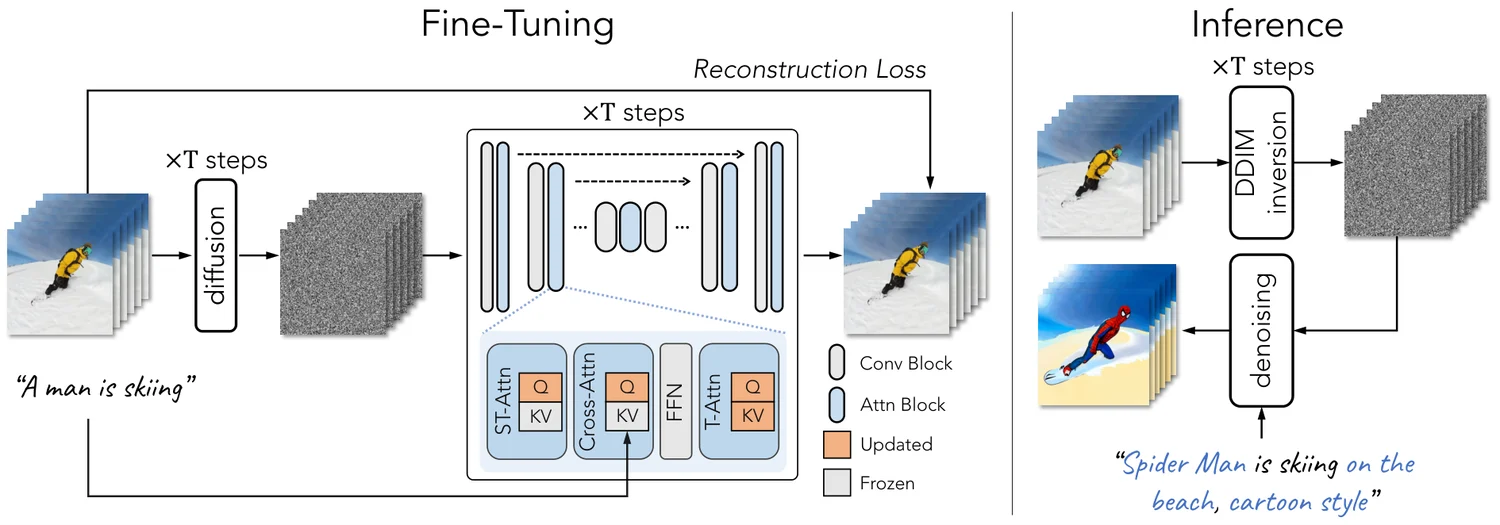
上图左边是微调阶段:输入视频加文本提示,网络在重建损失下更新;右边是推理阶段:先对输入视频做 DDIM 反演得到噪声序列,再用编辑后的提示词去噪。中间标注的 Conv Block 与 Attn Block 分别对应伪 3D 卷积和 ST-Attention。图中输入提示词“A man is skiing”被改写为“Spider Man is skiing on the frozen beach, cartoon style”,两者共用同一段输入视频,说明编辑发生在提示词层面,视频结构由反演噪声保留。
Tune-A-Video 的推理流程里,DDIM 反演是关键。反演把真实视频的每一帧映射回噪声空间,得到一个仍然携带原始构图与运动的噪声序列;然后用新提示词从这些噪声出发去噪。因为起点已经包含了原视频的结构,输出不会跑偏;因为去噪过程用了跨帧注意力,输出不会闪。反演本身有误差累积问题:步数越多、引导越强,反演越容易偏离,所以实际系统常配合 null-text inversion 一类的修正方法。
这条路线的问题是“一次微调只服务一段视频”。Tune-A-Video 需要对每段输入视频单独优化几百步,虽然比从头训练便宜得多,但在线服务场景下仍然太慢。它更适合离线制作,而不是“用户上传视频、几秒后出结果”的产品形态。另一个问题是它只看第一帧和前一帧,长视频里第一帧的锚点会逐渐失效,外观还是会漂。
Text2Video-Zero:完全免训练的跨帧注意力
Text2Video-Zero(Khachatryan 等,ICCV 2023)把“免训练”推到了极致:不改任何权重,只改采样过程。它由两个机制组成。
机制一:运动动力学(motion dynamics)。 先为第一帧采样一个 latent ,然后对后续每一帧,按预设的全局平移 和局部对象仿射变换,把第一帧的 latent 变形为第 帧的初始 latent:
其中 是按变换 做的可微 warp。这样所有帧从同一个噪声场出发,只是位置和尺度不同,采样结果的“底子”就接近。这个做法很粗糙,但它用几乎零成本给了视频一个全局一致的初始条件。
机制二:跨帧注意力。 在去噪的每个自注意力层,第 帧的 query 除了查自己的 K/V,还查第一帧的 K/V:
第一帧在这里扮演“外观参考帧”。因为整段视频的第一帧是由同一提示词生成的,后续帧都向它对齐,颜色、材质、风格就保持一致。
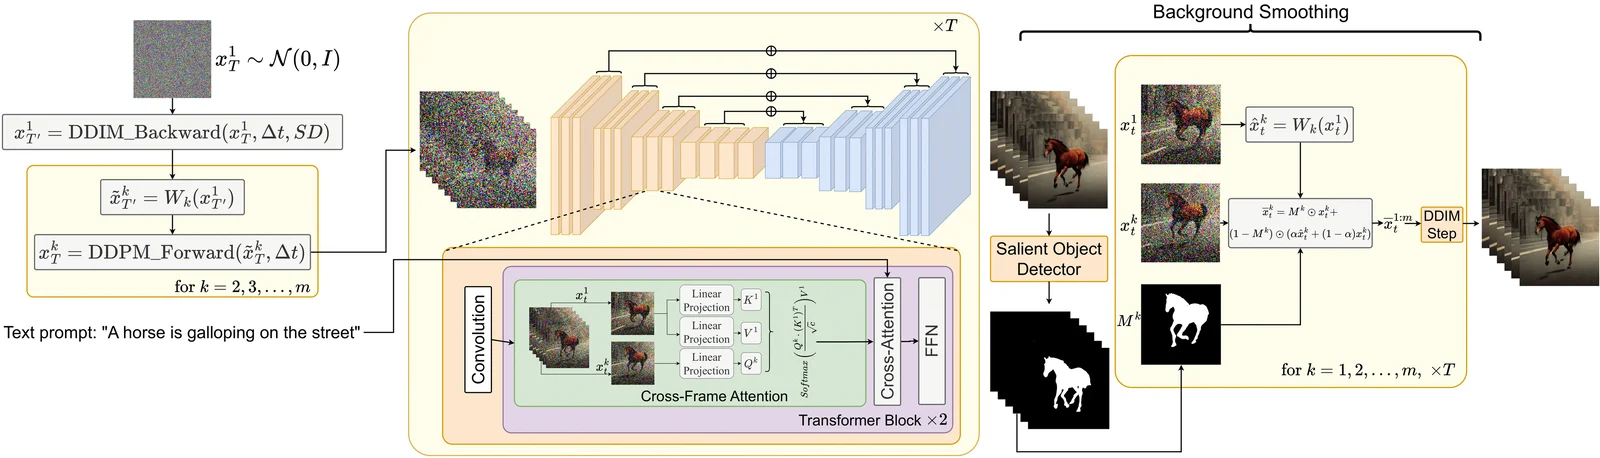
上图展示了 Text2Video-Zero 的三段式采样:第一帧正常生成,后续帧的 latent 由第一帧按运动场变形得到,然后在每个 Transformer block 里用跨帧注意力把当前帧与第一帧绑定;长视频还会加一个背景平滑步骤,用 warp 后的前一帧输出和当前帧做掩码混合,压制背景闪烁。图下方的 ControlNet 分支说明它也能做视频到视频:深度或边缘条件从输入视频提取,保证结构不丢。
Text2Video-Zero 的最大优点是零训练、即插即用,任何 Stable Diffusion 权重都能直接用;最大缺点也来自“只看第一帧”。当视频很长、镜头运动很大时,第一帧与当前帧的语义对应关系已经很弱,跨帧注意力会把不相关的区域强行对齐,产生鬼影。它的运动动力学是手工设计的,无法从数据里学习真实运动,快速转身、遮挡、非刚性形变都处理不好。背景平滑能缓解闪烁,但不能修复错误的内容。
第三条路线:TokenFlow——把对应关系变成注意力掩码
跨帧注意力解决了“外观向谁对齐”,但没有解决“对齐到哪个位置”。第一帧里的猫鼻子,应该对齐到第 10 帧里猫鼻子的位置,而不是画面同一坐标。TokenFlow(Geyer 等,ICCV 2023)的核心贡献,就是用扩散模型自己的特征算出这个对应关系,再让注意力只沿对应关系传播。
从“全图对齐”到“token 轨迹”
TokenFlow 的观察是:文生图扩散模型在中间层产生的特征,本身就带有很强的语义对应能力。同一只猫的鼻子,在不同帧的 feature map 上,余弦距离很近;猫鼻子与背景树叶的距离则很远。于是可以构造一张跨帧的最近邻表:对第 1 帧的每个 token ,在第 帧的所有 token 里找特征最接近的 ,记作 。这些对应关系连起来,就是一条 token 轨迹。
有了轨迹,注意力就可以改写。标准自注意力让每个 token 查本帧所有 token;TokenFlow 的“共享注意力”让每个 token 只查轨迹上的对应 token:
这样,猫鼻子的 query 只会看到各帧猫鼻子的 K/V,不会被背景干扰;同时因为所有帧的猫鼻子共享同一组注意力,它们被推向一致的外观。计算量从全时空注意力的 降到 ——每帧每个 token 只看 个对应 token,而不是 个。
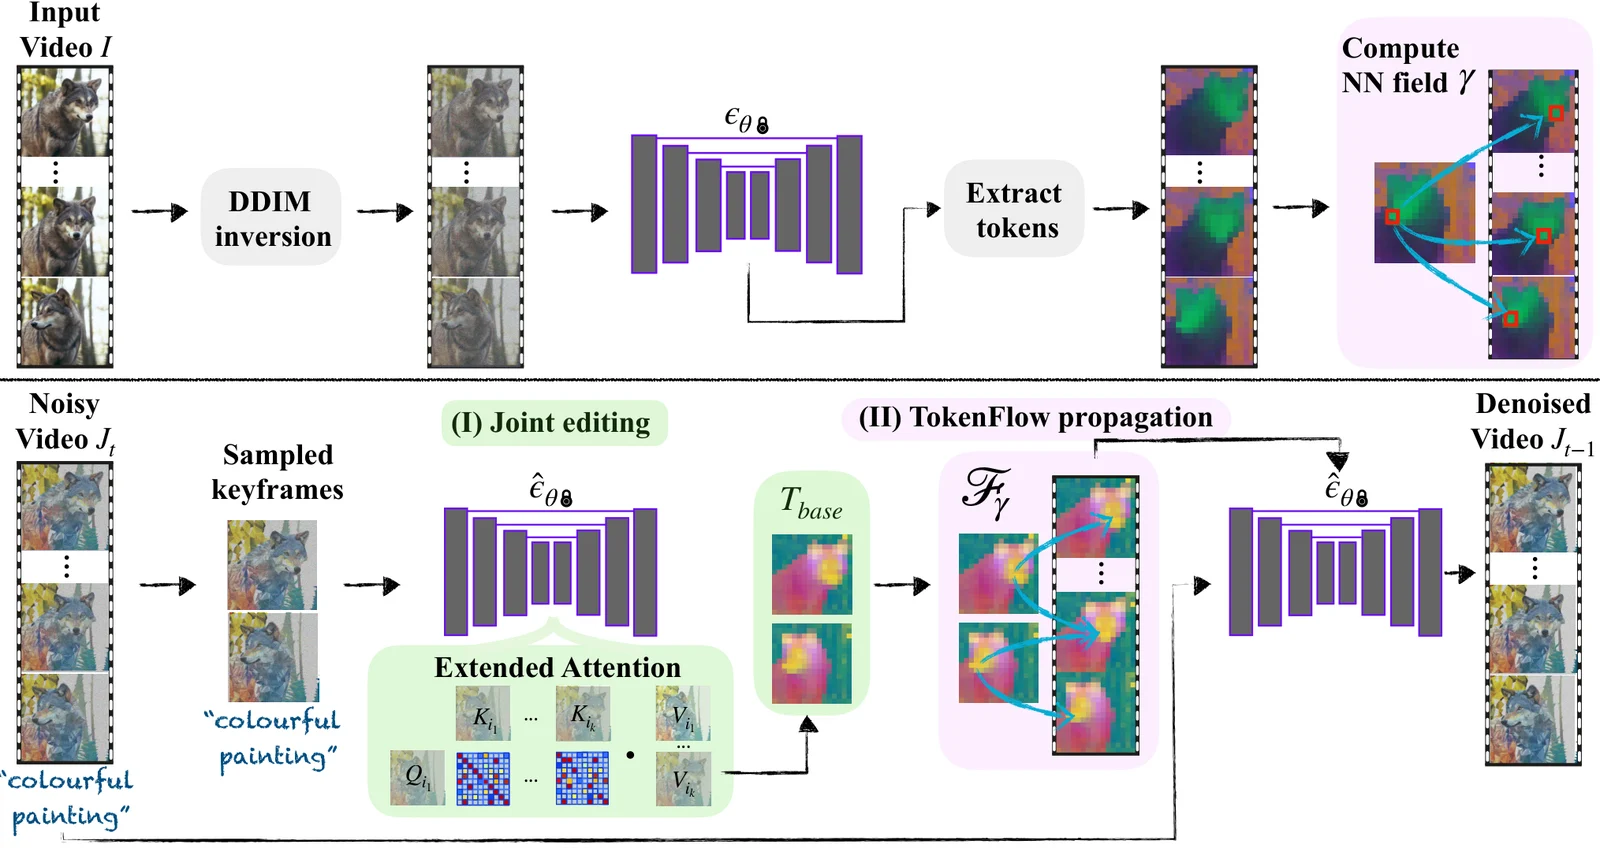
上图是 TokenFlow 的完整管线。输入视频先做 DDIM 反演,得到携带结构的噪声;然后跑一次逐帧编辑,得到粗结果,同时从 U-Net 中间层抽出 token 特征;用这些特征计算跨帧最近邻,得到 token 对应关系;最后在联合去噪时,把注意力限制在对应 token 上。图中标注的 Extended Attention 就是共享注意力的实现位置。注意它没有训练任何新网络,所有信息都来自预训练扩散模型内部。
这里有一个工程上很关键的细节:对应关系不是一次算完就不变。去噪过程中,特征会随噪声水平变化,早期步的对应更偏语义,后期步的对应更偏纹理。TokenFlow 会在若干步后重新计算最近邻,用新的特征刷新轨迹。刷新太频繁会让对应关系抖动,刷新太少则后期纹理对不上。论文里对刷新间隔做了消融,结论是适度刷新比固定一次更好。
TokenFlow 为什么能保住主体
逐帧编辑最怕的是“第 3 帧的猫还是猫,第 8 帧的猫变成了狗”。TokenFlow 从两个方面抑制这种漂移。第一,所有帧共享同一条 token 轨迹,轨迹上的 K/V 被混合,单帧的语义偏移会被其他帧拉回。第二,DDIM 反演保留了输入视频的结构,编辑方向被限制在“外观改变、几何不变”的子空间里。两者叠加,主体身份就稳了。
它的失效边界也很明确。最近邻对应在大运动、遮挡、重复纹理下会错。比如一片草地,每个 token 的特征都差不多,最近邻可能把第 1 帧的草对到第 10 帧完全不同的位置,导致纹理被拉花。物体被遮挡时,被遮住的 token 在第 1 帧不存在,轨迹断裂,模型只能退回自注意力,外观一致性在这一块失效。场景切换更严重:前后两个镜头的 token 本来就不该有对应关系,强行共享注意力会把两个场景混在一起。
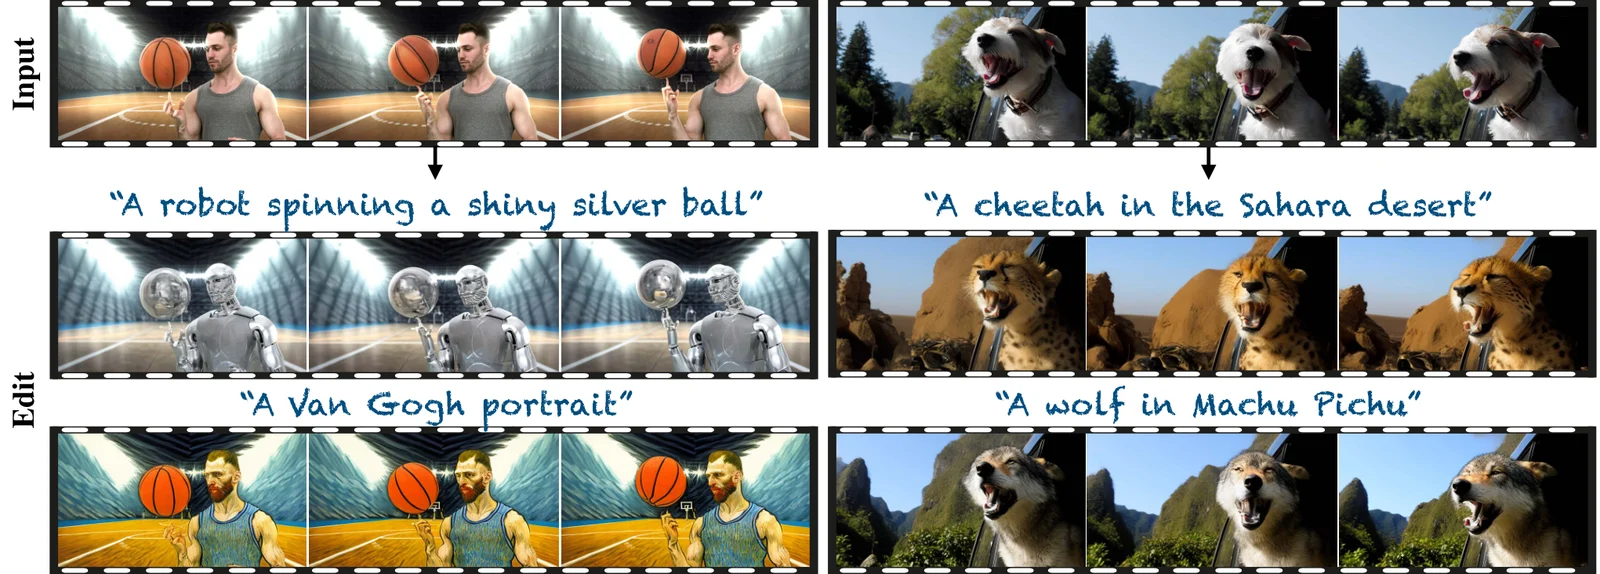
上图是 TokenFlow 的结果展示:同一段输入视频被改写成梵高风格、沙漠中的猎豹、机器人转球等不同内容,帧与帧之间的主体保持一致。这些例子说明 token 轨迹在主体明确、运动可控的场景里非常有效;但它们也都是相对短的片段,长视频与复杂遮挡并不在图示范围内。
第四条路线:CoDeF 的内容变形场
前三路线都在“帧”这个维度上想办法:关键帧传播、跨帧注意力、token 轨迹,都是让帧与帧之间共享信息。CoDeF(Ouyang 等,CVPR 2024)换了一个视角:能不能不要帧,把整段视频压缩成一张“规范图”加一个随时间变化的形变场?
规范内容场与时间形变场
CoDeF 把目标视频分解成两部分:
是一张与时间无关的规范图(canonical image),记录了视频里所有出现过的内容,而且按语义组织——比如一只跳舞的人,规范图里是人的完整外观,头部、躯干、四肢各就各位; 是形变场,对每个时间 给出从规范图坐标到该帧坐标的映射,参数是 。渲染第 帧就是:对每个像素坐标 ,找到它对应到规范图的位置 ,采样规范图:
形变场本身用哈希编码加一个小型 MLP 表示,类似 NeRF 的做法;规范图是一张可学习的特征图。整段视频只需要优化这两个对象,不需要任何大规模扩散模型。
这个分解为什么能提高一致性?因为外观只有一个来源。无论第几分钟,人的头发都是规范图上的同一块像素;形变场只决定这块像素出现在画面的哪个位置。逐帧方法里每帧都要重新决定头发的颜色,CoDeF 里头发颜色被规范图钉死,闪烁在原理上就被消除了。
规范图怎么编辑
CoDeF 的编辑流程是“编辑规范图、再渲染”。先用一个图像编辑模型(比如文生图加 ControlNet,或者干脆是 Photoshop)对规范图做修改,比如把人的衣服改成汉服、把背景改成赛博朋克城市;然后把修改后的规范图放回去,用原来的形变场重新渲染整段视频。因为形变场没变,运动完全保留;因为外观来自同一个规范图,风格完全统一。
这其实是把 V2V 问题降维成了图像编辑问题。图像编辑是成熟得多的领域:指令编辑、局部修复、多参考图风格迁移,都有现成工具。CoDeF 的价值在于提供了一张“能代表整段视频的图”,让这些工具直接可用。
局限:每段视频都要单独优化
CoDeF 的最大问题是优化成本。规范图与形变场是用视频本身做重建优化出来的,一段 30 秒的视频通常需要几分钟到十几分钟的优化,远慢于一次扩散前向。它是“一段视频一个模型”,不能泛化到没见过的视频。形变场对大运动、镜头切换、非刚性形变也不友好:镜头一切,规范图坐标与画面坐标的对应关系就断了;人突然跳起来,形变场需要极高的表达能力才能跟上。
因此 CoDeF 更适合离线、长视频、重复性运动的场景:舞蹈、循环动画、延时摄影。它不太适合短视频平台的在线处理。
CoDeF 的“跟踪一切”版本 Tracking Anything with Decoupled Video Segmentation 与它的规范场思路一脉相承,都尝试用一张规范表示代替逐帧的独立表示。这也是 V2V 里通向“长视频一致性”的一条有潜力的路线,只不过成本还没有降下来。
第五条路线:结构条件约束
前面几条路线都在“让生成结果互相对齐”,还有一类系统在“让生成结果与输入对齐”:把输入视频的几何结构(深度、边缘、姿态、分割)提取出来,作为条件喂给扩散模型,模型在条件约束下生成新外观。
为什么结构条件能稳住视频
结构条件的作用是把自由度压缩到外观维度。给定深度图,模型知道每块区域离镜头多远、轮廓在哪里;给定姿态骨架,模型知道人物关节的位置。这些信息在两帧之间是稳定的,因为输入视频的真实几何本来连续。于是模型每帧只需要决定“这块深度对应的区域该是什么颜色”,而不需要重新决定“这块区域在画面哪里”。几何被条件锁住,闪烁就主要来自外观层面的随机性,而外观层面的随机性又可以被跨帧注意力或 token 轨迹进一步压制。
ControlNet(Zhang 等,ICCV 2023)是这条路线最常用的接口。它把预训练扩散模型的编码器复制一份,称为“副编码器”,用零卷积(zero convolution)连接到主模型的冻结解码器。零卷积的权重初始化为 0,初始输出为 0,因此接入 ControlNet 的最初一刻,主模型输出与原模型完全相同;训练时零卷积逐渐学出非零权重,条件信息才慢慢注入。这种设计的好处是不破坏预训练权重,只增加一个可以按条件类型切换的“插件”。
在 V2V 里,深度条件几乎是最稳的一种。原因有三:深度图对纹理变化不敏感,光照、材质改变不会影响深度;深度图对遮挡有天然处理,前景深度值本来就与背景不同;深度图可以用单目深度估计模型实时得到,不需要额外传感器。边缘条件更轻,但容易丢细节;姿态条件只适用于人物,且骨架估计错误时会把错误传给生成。
Gen-1:把结构条件放进商用 V2V
Runway 的 Gen-1 是这条路线第一次以产品形式落地。它用结构引导(structure guidance)与内容引导(content guidance)两个条件:结构引导来自输入视频的深度或边缘,内容引导来自一张参考图或文本提示。用户上传一段实拍,给一张风格参考,Gen-1 输出风格化后的视频。产品的形态反过来印证了这条路线适合“结构不变、外观全换”的编辑:宣传片换风格、广告换材质、旧素材换年代感。
条件冲突是这条路线的主要失效模式
结构条件很强,强到有时会阻碍用户真正想要的编辑。如果用户想把“一个坐着的人”改成“一个在奔跑的人”,姿态条件是矛盾的:输入骨架是坐姿,模型要么忽略条件去生成奔跑,要么被条件锁死在坐姿。常见的缓解办法是让条件强度随编辑类型变化:风格化用强条件,结构编辑用弱条件甚至去掉条件,交给文本描述。
另一个问题是条件本身的误差。深度估计模型在有反光的玻璃、透明物体、细密纹理(如铁丝网)上常常失准;错误深度会被 ControlNet 忠实执行,生成出扭曲的几何。实践中要么手动修正条件,要么选择对误差更鲁棒的条件类型(比如同时给深度和边缘,让模型在两路条件不一致时有依据可循)。
长视频:分段、误差累积与分层处理
分段处理与误差累积
超过 10 秒以上的视频,没有任何一条路线能一次性处理完。显存放不下整段视频的全部 token 特征,注意力也承担不了 量级的 K/V。工程上的通用做法是分段 + 段间对齐,而这一步是误差的主要来源。
分段的直接做法是按固定帧数切,每段独立走后文所述的某条路线,段首帧用上一段的末帧或一张参考图做初始化。这个做法的缺陷是段与段的接缝处会跳变:第 90 帧与第 91 帧来自两次不同的采样过程,外观模式不一定相同。缓解方式有三种:
- 重叠窗口:每段多生成前后若干帧作为上下文,只取中间部分拼接,接缝处用多帧结果加权混合。重叠越多越平滑,但计算量按重叠比例线性增加。
- 首帧条件:下一段的第一帧以上一段末帧的输出作为强条件,类似于 I2V。这能保证接缝连续,但会把上一段的误差当作“正确”继续传播。
- 锚点校验:保留若干全局锚帧(比如第 1、30、60、90 帧),每段都与最近的锚帧对齐;锚帧本身用更高的步数、更强的条件生成,作为“参考版本”。
误差累积的数学形态也值得看清楚。设每段引入的漂移服从一个带偏置的随机过程,,其中 是系统性偏差(比如风格逐渐变淡), 是零均值抖动。 段之后,累积误差为 ,标准差按 增长,而偏置按 线性增长。这解释了一个常见现象:长视频里抖动的增长是有限的,但风格偏移会越来越明显。锚点校验同时压住 与 ,重叠窗口只压住 。
视频编辑的分层扩散
把编辑拆成“低频”和“高频”两层,是工程上另一个通用手段,尤其适合结构改动较大的任务。以 Video-P2P(Liu 等,CVPR 2023)为例,它先对视频做 DDIM 反演,再用一个解耦的交叉注意力控制注入文本指令:把 self-attention 换成解耦的 self-attention,把 cross-attention 换成解耦的 cross-attention,分别控制“保留原视频结构”和“执行新文本指令”。这解决的是 Tune-A-Video 的一个实际痛点:Tune-A-Video 的 ST-Attention 会让新文本与原视频结构互相打架,改了物体颜色结构也跟着变,而解耦注意力让两种控制各走各的通道。
分层扩散则从频域思路出发:在扩散过程的早期步(高噪声、低频信息主导),允许较大的结构变化;在后期步(低噪声、高频细节),退回原始视频对应的噪声轨迹,让细节与原视频一致。这样生成的视频“大体上像编辑后的,细节上像原视频的”。商用视频编辑系统中的“结构保留强度”一类参数,本质上就是在时间步的两端之间调权重:越偏向保留,后期步越贴原始轨迹。
这两种方法的共同点是承认一次性处理整段视频不可行,于是把问题沿时间或频段拆开,在拆开的维度上加约束。它们不能完全消除长视频的漂移,但能把漂移从“肉眼可见的跳变”压到“需要逐帧比对才看得出”。
推理成本:V2V 在服务器上到底花多少
V2V 系统的架构差异,最终都要落到推理账上。下面按一段 5 秒、24 fps、共 120 帧的 512×512 视频估算,只看与架构相关的部分,不计 VAE 编解码和文本编码。
| 架构 | 主要计算 | 逐帧扩散前向次数 | 额外开销 | 相对 T2I 单帧的成本倍数 |
|---|---|---|---|---|
| 逐帧编辑 | 每帧独立去噪 | 无 | ||
| 关键帧传播(Rerender) | 每 帧一次完整去噪,中间帧少量步数 | 光流估计、warp | 显著低于逐帧 | |
| Tune-A-Video | 单段视频微调 + 整段采样 | (带跨帧注意力) | 每段视频离线微调 | 高于逐帧(离线侧) |
| Text2Video-Zero | 整段采样 + 每步跨帧注意力 | 跨帧注意力增加 K/V | 略高于逐帧 | |
| TokenFlow | 逐帧粗编辑 + 联合去噪 + 最近邻搜索 | + 联合阶段 | token 特征存储、最近邻 | 高于逐帧 |
| CoDeF | 每段视频单独优化 | 与帧数无关 | 优化数百到数千步 | 离线为主 |
表里的倍数是量级估计,具体数字随步数、分辨率、模型大小变化。它想说明的是:逐帧编辑是成本基线,所有一致性机制都是在基线之上加账。关键帧传播之所以在工业上长期存在,就是因为它把最贵的一次生成压缩到少数帧上;跨帧注意力和 token 轨迹之所以更贵,是因为它们让每一帧的注意力都要多看一眼别的帧。
跨帧注意力的额外成本可以算清楚。标准自注意力每头每 token 的 key/value 长度是 ,Tune-A-Video 变成 ,Text2Video-Zero 也是 ,TokenFlow 变成 (每帧取一个对应 token)。前者把注意力计算量提高约一倍,后者把 降到 ,反而比原注意力更省——但额外要算最近邻,最近邻的规模是 的特征比较,在 token 数很大时要靠 FAISS 或 GPU 分块距离计算,这笔开销不能忽略。
显存是另一个约束。TokenFlow 需要保存每一帧每一层的 token 特征来计算对应关系,、、特征维度 256、单精度,单层就要约 126 MB;多层叠加,显存很容易上到十几 GB,这也是它通常只在较短视频上运行的原因。关键帧传播的显存只与关键帧数量有关,这也是它在显存受限时更受欢迎的原因。
站内相关技术的位置
V2V 不是孤立的技术,它和站内已经讲过的几块内容直接相连。
视频扩散的时空结构决定了跨帧注意力能放在哪一层。可参考 扩散模型从零讲起(五):视频扩散——时空注意力、3D VAE 与蒸馏后的少步生成,那里推导了时空注意力的计算量和 3D VAE 的时间压缩方式;V2V 的跨帧注意力本质上是把时空注意力的 key/value 集合限制在参考帧上。
图生视频和 V2V 是同一套时序机制的两个方向。I2V 从一张首帧图出发,V2V 从整段视频出发;两者都要解决“图像条件如何穿过时间轴”。可参考 图文生视频模型架构入门:一张首帧图如何被「时间化」。
视频 DiT 的稀疏注意力与 TokenFlow 的共享注意力在“只看一部分 K/V”这件事上同源。可参考 视频扩散模型的稀疏注意力:SVG、SVG2、Radial Attention 与 Re-ttention 如何把 3D 全注意力压到可服务的成本,那里按头级模板、语义置换、能量衰减与统计重标定拆解了四类稀疏结构;V2V 的 token 轨迹可以看作按“跨帧语义对应”组织的稀疏模式。
结构条件与指令编辑在同一套条件注入路线上。可参考 扩散模型从零讲起(十五):可控生成——ControlNet、T2I-Adapter 与 IP-Adapter 如何把结构条件注入去噪网络 与 指令式图像编辑模型架构入门,前者讲条件通道的机制,后者讲图像层面的指令编辑;Video Instruct-Pix2Pix 一类工作就是把后者的思路搬到视频上,再加时序层。
一致性评测与视频生成的评测共享指标。可参考 扩散模型从零讲起(十八):生成质量怎么量——FID、CLIPScore 与感知指标的失效边界,那里讨论了为什么单帧指标的均值不能代表视频质量,这与本文开头的 warping error 局限是同一类问题。
小结
回到文章开头的那个问题:V2V 的核心难题是“相邻两帧画的是不是同一个东西”。本文拆解的几条路线,是对这个问题的几种回答方式。
关键帧加光流传播把问题拆成“少量帧生成”和“大量帧传播”,便宜、可解释,但受制于关键帧的信息量上限;跨帧注意力让每一帧都向参考帧对齐,几乎不增加架构复杂度,但参考帧的锚点会漂;TokenFlow 把“对齐到哪个位置”交给特征最近邻,用 token 轨迹代替全图对齐,在主体明确的短视频上效果最好;CoDeF 把整段视频压缩成一张规范图加形变场,从根上消除了外观闪烁,但优化成本高;结构条件路线把几何锁住、只放开外观,适合结构不变的编辑,却难以做结构编辑。
选择路线时,先问两个问题:编辑是否要保留输入结构,以及视频有多长、是否在线处理。结构不变、在线处理,关键帧传播最稳;结构不变、离线处理且长视频,CoDeF 值得考虑;外观全换、短视频,跨帧注意力与 TokenFlow 更直接;结构需要局部改动,则要降低结构条件强度,回到跨帧一致性机制上。
还没解决的问题也很清楚。长视频的误差累积没有任何一条路线彻底解决:关键帧会越传越糊,跨帧注意力的参考帧会失效,token 轨迹在场景切换处断裂。遮挡与新露出区域的内容生成依然是硬骨头,任何“搬运”都搬不出不存在的像素。分段处理加段间对齐、用更强的视频时序模型做参考帧、在 token 层面显式建模遮挡,都是正在探索的方向。
参考资料
- TokenFlow: Consistent Diffusion Features for Consistent Video Editing(arXiv:2307.10373)
- TokenFlow 项目主页
- Tune-A-Video: One-Shot Tuning of Image Diffusion Models for Text-to-Video Generation(arXiv:2212.11565)
- Tune-A-Video 项目主页
- Rerender A Video: Zero-Shot Text-Guided Video-to-Video Translation(arXiv:2306.07954)
- Rerender A Video 项目主页
- Text2Video-Zero: Text-to-Image Diffusion Models are Zero-Shot Video Generators(arXiv:2303.13439)
- CoDeF: Content Deformation Fields for Temporally Consistent Video Processing(arXiv:2308.07926)
- Adding Conditional Control to Text-to-Image Diffusion Models(arXiv:2302.05543)
- Video-to-Video Synthesis(arXiv:1808.06601)
- EbSynth 官方主页
- Video-P2P: Video Editing with Cross-attention Control(arXiv:2303.04761)
- Runway Gen-1
- High-Resolution Image Synthesis with Latent Diffusion Models(arXiv:2112.10752)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



