


视听联合建模基础架构:画面和声音如何互相指认——五种把两种模态放进同一个目标函数的做法
一段视频里同时存在两种信号
一段普通的视频包含两条时间轴:画面帧和音轨。它们在采集时就被同步记录,播放时又被同步呈现。人看一段敲击桌面的视频,听到的「咚」和看到的「手落下」并不是两条独立的信息,而是同一个事件在两个感官通道里的投影——手落下决定声音的大小和节奏,敲击的材质决定声音的音色,反过来,声音也能提示画面里哪一块区域正在动作。
机器长期把这两条信号分开处理。视频理解读取帧序列,语音识别读取音轨,两条流水线各自训练、各自调优,中间只靠人工设计的时间戳对齐连起来。这种分工在各自任务上很成熟,却丢掉了视频自带的一个关键性质:画面和声音是同一事件的两种观测,彼此可以互相解释、互相约束。利用这种约束来学习表示、分离声源或改善识别,就是视听联合建模(audio-visual joint modeling)要解决的问题。
本文只讲最基础的内容:图像和音频这两种最常见模态,如何被编码成网络能处理的张量,以及在这个基础上发展出的五种基本架构——判断画面与声音是否对应的二分类网络、让视频「教」声音模型的教师-学生蒸馏、在像素级别把声音拆成独立声源、用画面检测到的脸把混合语音分离成每人一路、用掩码预测同时处理两种模态的自监督模型。每条路线都代表一种不同的「怎么把两个模态放进同一个目标函数」的思路,理解了这五条,再看其他视听模型就都能找到它们的位置。
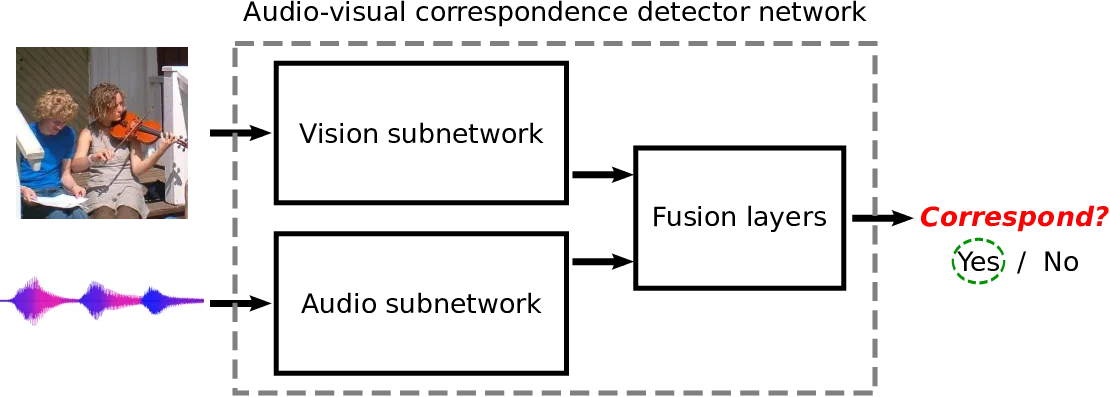
上图是视听联合建模最基础的任务形式——视听对应(audio-visual correspondence,AVC):给定一帧画面和一小段音频,判断它们是不是来自同一段视频的同一时刻。正样本来自同一视频,负样本来自不同视频。看似简单,但它把「画面和声音是否描述同一件事」变成了一个可以用分类器直接优化的目标,后面几条路线都可以看作在这个目标附近的变体或延伸。
两种模态怎么变成网络输入
画面:从像素到一帧张量
视频的每一帧是一张 RGB 图像。在绝大多数视觉主干里,一帧先被缩放到固定分辨率(例如 224×224),再经过一层归一化,得到形状为 的浮点张量。时间维度另算:视频模型通常一次取 帧,得到 的五维张量,或者把时间当作通道与空间合并。
视觉编码器的选择决定了后续架构能读到什么粒度的信息。用 ResNet 一类的卷积主干,输出可以是一张空间特征图(保留「哪里」),也可以是全局池化后的一个向量(只剩「是什么」)。这两者对后续模块的影响极大:需要定位时(例如分离画面某一区域的声音),必须保留空间维;只需要判断内容时(例如判断视听对是否对应的分类接口),全局向量就够了。路线一的视觉子网络就属于后一种。
音频:从波形到 log 频谱
声音的原始形式是采样点序列。16 kHz 采样率下,1 秒音频有 16000 个采样点。采样点级建模代价极高,所以几乎所有的视听联合模型都先把波形转换成时频表示——最常用的是短时傅里叶变换(short-time Fourier transform,STFT):用长度 25 ms 左右的窗、10 ms 左右的步长把波形切成重叠的帧,每帧做一次傅里叶变换;几十毫秒的窗就能覆盖语音里大多数音素的长度,因此频谱图在时间轴上的分辨率与音素对齐。
频谱图取幅度、再做对数压缩,就得到 log 幅度谱。对于 1 秒的音频,常见的设置是 64 ms 窗、16 ms 步长,得到约 63 个时间帧,每帧 257 个频点( 时 )。把频点当纵轴、时间帧当横轴,log 幅度谱就是一张二维图像,这张图像是灰度的:每个像素只有强度一个值,没有颜色通道。这一结论对理解后面的网络结构很重要——音频子网络与视觉子网络的结构可以几乎完全一样,唯一的系统性差别是输入像素的通道数。
| 画面 | log 频谱 | |
|---|---|---|
| 原始形式 | RGB 三通道空间网格 | 单通道时频网格 |
| 采样密度 | 空间 224×224,可隔帧取 | 时间约 60~100 帧/秒,频率 257 点 |
| 局部相关性 | 空间上强相关(相邻像素) | 时间与频率上都强相关(相邻频点、相邻帧) |
| 语义单元 | 物体、动作、场景 | 音素、音色、事件节奏 |
两类张量在形状上高度相似,都是「两个维度 + 通道」的网格,卷积核可以直接复用,迁移学习也天然成立。但语义结构不同:声音的「时间轴」是音素序列,画面的「时间轴」是动作的阶段;声音的「频率轴」是音高与音色,画面的「空间轴」是物体位置。接下来的五条路线,本质都是在设计「用哪种方式让这两张语义不同但形状相似的网格发生关联」。
路线一:视听对应分类——用一个二分类器学会双向指认
任务与结构
视听对应任务由 Arandjelović 与 Zisserman 在 2017 年提出,论文《Look, Listen and Learn》发表在 ICCV 2017,arXiv 编号 1705.08168。它的目标函数极为朴素:给定 对,输出「是否对应」的二分类概率。正样本取自同一视频的同一时间窗口,负样本是画面来自视频 A、音频来自视频 B 的随机拼接。
网络分为三个部分:视觉子网络、音频子网络、融合网络。视觉子网络把单帧画面编码成一个 512 维向量;音频子网络把 1 秒音频的 log 频谱(257×199)当作灰度图像,用结构几乎相同的卷积主干编码成另一个 512 维向量。两个向量拼成 1024 维,再经过两层全连接(中间 ReLU)输出两路 softmax,判断对应与否。
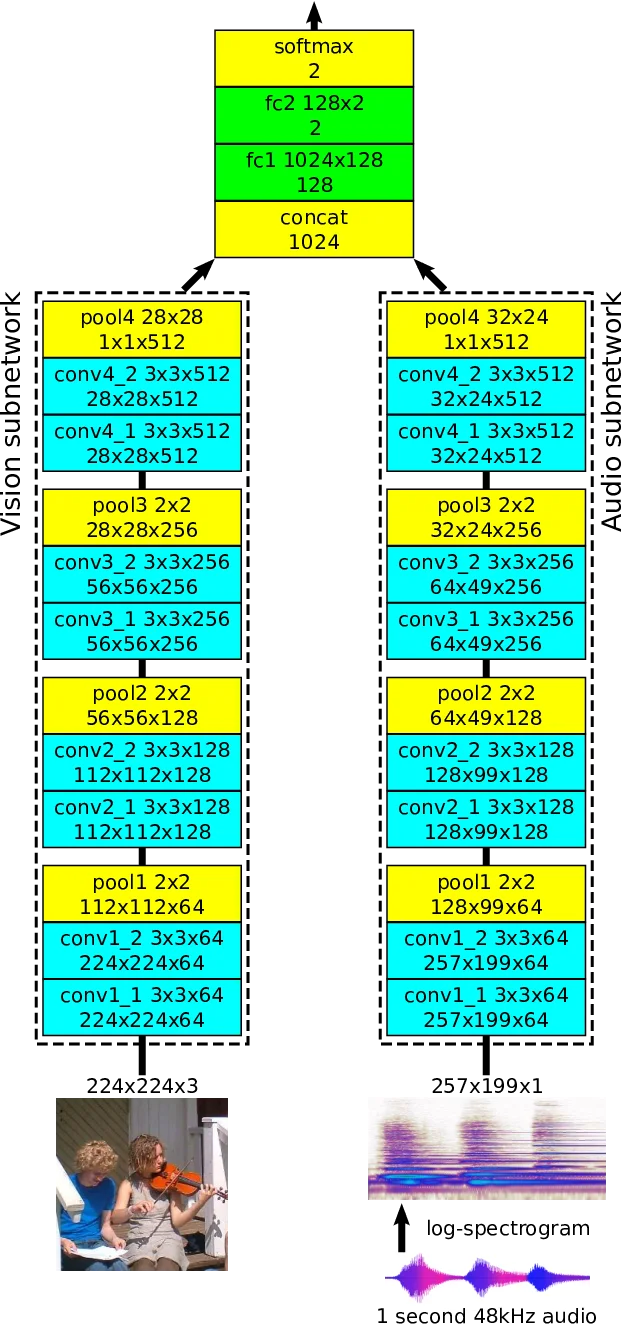
上图是 L3-Net 的完整网络。两侧子网络采用相同的卷积块设计:每个块由两层卷积加一次池化组成,块内卷积核数量相同,块之间依次翻倍(64、128、256、512),每个卷积后接批归一化和 ReLU;最后在空间上做全局最大池化,得到单个 512 维特征向量。音频侧的 conv1_1 因为输入只有单通道,滤波器尺寸可以小一些。两侧输出拼成 1024 维后,经过两层全连接完成二分类。
为什么这个目标能学到语义
二分类本身信息量很低——只有一个比特。但要让网络在大量随机负对上把这个比特分对,它必须同时找到画面和声音各自的语义概念。负样本是随机拼的,比如「弹吉他」的画面配上「切菜」的声音。网络能分对「对应」与「不对应」,只有在两路特征都捕捉到了足以区分事件的语义时才可能做到。论文中展示了一个印证:视觉侧 pool4 的某些通道会对特定动作类别强烈响应(如弹吉他、吹萨克斯、切菜),而音频侧的同一批通道则会对该动作对应的频谱模式强烈响应——两侧学到的概念在同一语义空间里「对上号」。
这个过程的精妙之处在于:网络从未被告诉「弹吉他的声音是什么样的」。它只被告诉「这一帧和这一段声音来自同一个视频」,然后在负样本的对比下被迫自己推导出「吉他的画面特征应该和吉他的频谱特征相似」。这就是为什么这条路线被看作弱监督:标签不是人工的语义类别,而是视频自带的同步性。
推理端的成本与限制
这条路线的推理结构非常简单:两路卷积 + 一个线性二分类头。它的主要代价不在计算量,而在对输入的处理上——音频必须切到固定长度的窗口,画面必须选好采样时刻,否则「同步」这个标签就失真。当需要检测任意一段长视频中哪些时刻存在「声音与画面不一致」时,必须滑动窗口多次前向,且要权衡窗口长度(越长,语义越完整,但漏检细小不一致的概率越高)与步长(越密,时间分辨率越高,计算量越大)。
这个结构还留下了一个明显的空缺:网络只回答「对应/不对应」,不回答「画面中的哪些区域产生了声音」,也不回答「这段音频由哪几个事件混合而成」。后面两条路线正是拆开这两个空缺。
路线二:用视图「教」声音——教师-学生蒸馏
从对应分类到跨模态蒸馏
对应分类网络的特征通常作为预训练初始化使用:拿训练好的视觉子网络或音频子网络,冻结或微调到下游任务。但如果某一天要在没有声音的环境里部署一个声音模型,就会撞上一个尴尬的问题:被用作教师的视觉模型可以接受一帧画面,被用作学生的音频模型却只接受频谱图,而它真正需要的监督信息——「这张频谱对应的语义是什么」——来自视觉教师。
视听蒸馏(audio-visual distillation)把这个问题变成了一个训练流程:先训练一个视觉模型,再用它去指导音频模型的学习。学生在训练时同时看到两路输入,把视觉教师对画面的输出分布作为音频分支的目标;推理时学生只输入音频,输出的是教师视角下的语义分布。
这一路线的核心问题是跨模态特征的对齐方式。两种常见做法是:
- 关系蒸馏:不要求音频特征逐元素逼近视觉特征,只要求「样本之间的关系」保持一致。如果两张画面被视觉教师判为相似,音频学生也应当把它们对应的两段声音判为相似。这个约束对特征维度和幅值规模不敏感,适合两路编码器结构不同的场合。
- 软标签蒸馏:教师输出的完整概率分布(不只是 argmax)携带了类别之间「多相似」的信息,学生用这组分布作为目标。软标签比硬标签提供了更多梯度方向,尤其在音频监督稀少的类别上效果明显。
无论哪种,推理时的结构都是「只剩音频分支 + 一个分类头」。这是这条路线的特点:教师只在训练期存在,推理期完全不参与。对部署而言,它的意义是让一个只在画面数据上被充分训练的模型,能够把语义能力「迁移」给另一条只能读声音的流水线。
这条路线的部署形态很明确:训练期存在两个模型,推理期只存在一个。代价在于监督信息的传递效率——教师看到的是「画面」,学生学到的是「声音里的语义」,两者之间隔着一次特征对齐;如果音频侧的分布与视觉侧的分布差异很大(例如环境噪声、非语音事件),蒸馏的效果会明显受限。第三条路线不再借助一个外部教师,而是直接把画面本身当作分离音频的「线索」,由网络自己学会用视觉特征解释声音。
路线三:像素级声音分离——回答「画面的哪个区域在发声」
PixelPlayer 的核心设计
视听对应分类只给出「对应/不对应」的一个比特,它无法回答一个更细的问题:一帧画面里同时有吉他手和鼓手,能不能把声音拆成「吉他在哪、鼓在哪,各自发出什么」?PixelPlayer 由 Hang Zhao、Chuang Gan 等人在 2018 年提出,论文《The Sound of Pixels》发表在 ECCV 2018,arXiv 编号 1804.03160。它给出的答案是:把「声源分离」与「视觉定位」合成同一个问题,在像素级别同时完成这两件事。
具体形式是:给定一帧画面 与整段音频的混合信号,模型输出每个像素位置 的音频通道,把所有像素的音频加起来就应当还原混合信号;每个像素通道的频谱幅度又自动给出了该像素在发声的强度,即声源定位的答案。
系统结构
系统由三个模块组成:视觉分析网络、音频分析网络与音频合成器。
- 视觉分析网络把一帧画面编码成像素级的视觉特征图:先经过一个空洞卷积(dilated ResNet)主干,然后在时间维度(此处为片段内的多帧)上做最大池化,让每个像素位置得到一个融合了时间上下文的多通道特征向量。时间上池化是为了让「发声与否」对单帧抖动不敏感——乐器可能在某一帧被手遮挡,但整体片段里它一直在发声。
- 音频分析网络把混合音频的 log 频谱经过 U-Net,输出若干音频声道特征图。U-Net 的跳连让高层的语义声道与低层的频谱细节同时保留;每个声道对应一种「音色模式」。
- 音频合成器把视觉特征图与音频声道特征图在空间上做卷积组合,得到每个像素位置在若干声道上的权重,再与声道特征相乘求和,得到该像素的音频频谱输出。所有像素的输出加起来即为混合音频——这个「逐像素求和等于混合」的约束在训练目标中直接体现,它迫使模型把能量在像素之间做正确分配。
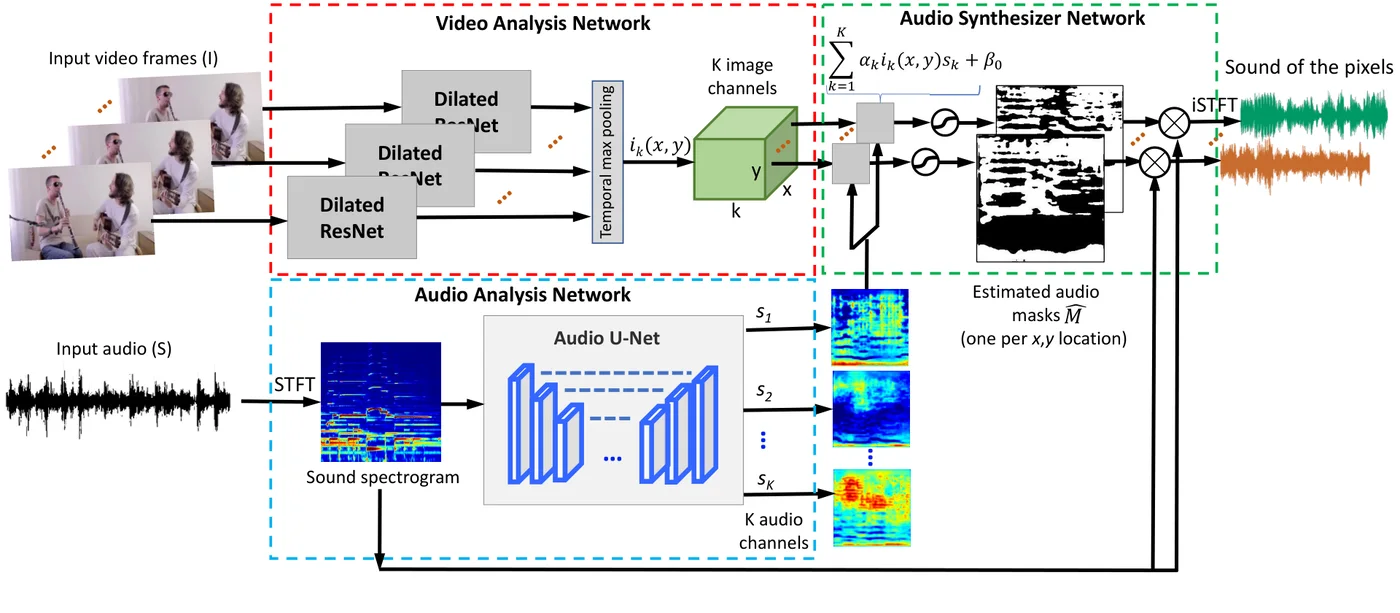
上图把这个合成过程单独画了出来:左侧是一帧画面的像素级视觉特征,右侧是音频 U-Net 解出的若干声道,中间通过一组空间权重把两者组合,得到每个像素位置的音频频谱。图中每一个像素都有自己的输出频谱,把整张图的输出叠加起来就是原始混合音频。这种「用视觉特征去解释声音」的做法与跨模态蒸馏的逻辑同源,区别是这里视觉侧提供的不再是一个全局语义向量,而是保留空间位置的特征图。
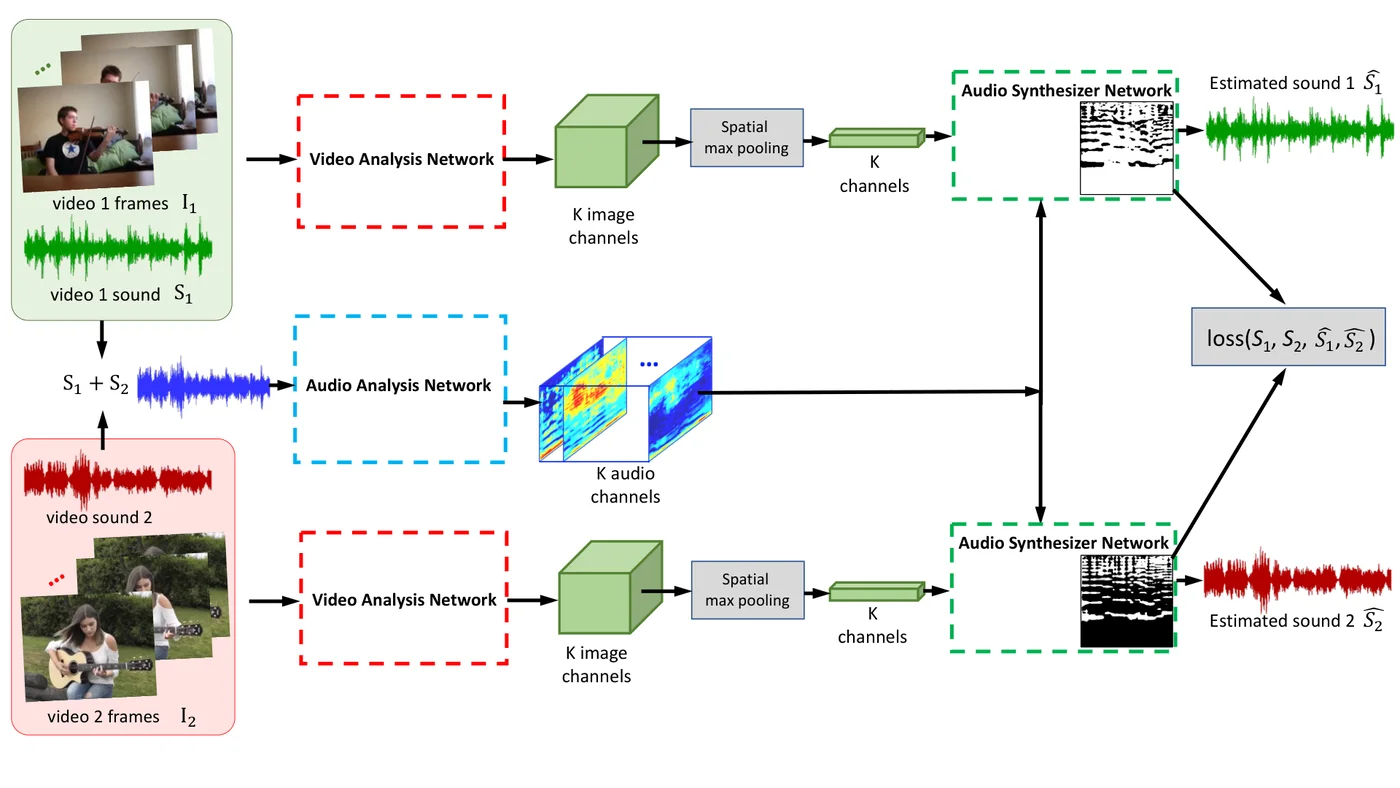
上图是 PixelPlayer 的训练流程(Mix-and-Separate)。关键在于训练数据的构造方式:并没有任何标注告诉网络「吉他在这一帧的哪个位置、发出什么声音」。做法是把若干段乐器的单人视频的音频加起来,构造一个混合音频;画面用其中一段视频的帧作为输入;训练目标要求网络把混合音频分成每个像素的音频成分,使得各个像素的音频加起来近似等于混合音频,并且每个视频对应的「源」像素区域能输出与原始单人音频一致的声音。整个过程在数据层面完成拼接,不需要人工标注声源位置或声源类别。
推理与计算账本
像素级输出的成本结构值得单独看。视觉网络对每帧只前向一次;音频网络对每一段混合音频只前向一次;合成器对每一帧分别执行。这意味着处理一段 帧的视频,视觉与音频主干的计算量是 级别的累计,但合成器本身是逐像素的卷积,代价与帧数直接成正比。当视频帧率很高、或者需要输出到像素级时,合成器会迅速成为瓶颈——这也是后来的工作会加入「空间特征下采样」或「一次性处理多帧并插值」的原因。
PixelPlayer 的局限同样清楚:它只处理「声音能量集中在画面可见区域」的情形;画面外的声源(旁白、背景音乐、画外音)无法被定位到像素,会被网络摊到某个区域或摊平;当画面与声音发生显著延迟(如远距离回声)时,逐像素匹配的精确对齐会失效。这些边界标出了后续模型的空间:需要处理画外声源时,就要引入与像素无关的残差通道;需要处理延迟时,就要在跨模态对齐里加入时间偏移搜索。第四条路线正是在这个空间里换了一个更贴近真实录音的定位粒度。
路线四:视觉辅助语音分离——用画面里的脸把混合语音拆开
一个比声源定位更常见的问题
PixelPlayer 处理的是「声音来自画面里哪个像素」,但真实录音里最常见的情形不是乐器独奏被拆开,而是多个说话人的声音混在一起。单人说话的音频在会议室、车内、街道上都会被同场的其他人、背景音乐和环境噪声叠加,形成一段混合信号。要在这种信号里只保留「画面中正在说话的那个人」,纯音频方法必须解决一个前置问题:目标说话人是谁。传统做法是事先录一段该说话人的声音、提取说话人嵌入(speaker embedding),或者为每个目标说话人单独训练一个模型——这些都是说话人相关(speaker-dependent)的方案,换一个人就要重新注册或重训。
画面提供了一条绕开这个前置问题的路径。视频里每个人脸的位置是已知的,唇部的开合节奏又直接对应这个人是否在说话、说的是哪几个音节。把「脸是谁」和「嘴在什么时候动」作为条件,分离网络就不需要事先知道目标说话人,也能在混合音频里挑出对应的那一路。这条路线最具代表性的系统是 Looking to Listen,由 Ephrat、Mosseri 等人在 2018 年提出,论文发表在 SIGGRAPH 2018,arXiv 编号 1804.03619。
AVSpeech:用公开讲座视频构造训练集
训练这套模型首先需要大量「单说话人、语音干净、人脸可见」的视频片段。论文从公开的讲座、演讲类视频里收集了约 29 万段视频,再用三步筛选:检测并跟踪人脸,丢弃人脸模糊或不够正面的帧;估计语音信噪比,丢弃噪声过高的片段;确认片段内的语音只属于画面中可见的单个说话人。处理后的数据集体量约 4700 小时,被命名为 AVSpeech。
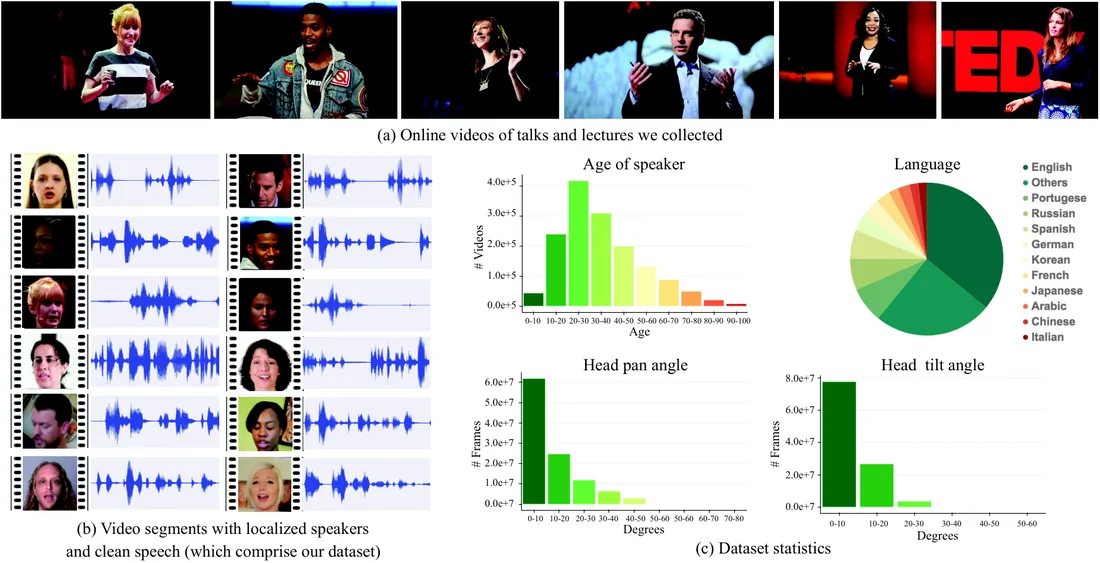
上图是 AVSpeech 的构造流程:从大量公开演讲视频出发,经过人脸检测与跟踪、语音质量筛选,得到说话人可见且语音干净的片段。这套数据的价值在于「画面与声音的对应关系是自然存在的」——不需要人工标注哪张脸对应哪段语音,筛选过程本身就保证了这种对应。训练混合语音时,再把若干段单人语音的音频相加,构造出「合成的鸡尾酒会」,画面仍取其中一段视频的帧,于是网络可以学到「从混合音频里挑出与画面中这张脸对应的语音」。
多流结构:音频一路,脸各一路
Looking to Listen 的网络是一个多流结构:音频流只有一条,视觉流按检测到的人脸数量各开一条。
- 音频流:对 3 秒的混合音频做 STFT,保留每个时频点的实部与虚部,再做幂律压缩,避免响度大的声音压制弱声音。压缩后的频谱送入一个由空洞卷积堆叠的音频编码器,输出与频谱同时间分辨率的音频特征图。
- 视觉流:每张脸在每一帧上裁出一个缩略图(3 秒、25 fps 约 75 张),先经过一个预训练的人脸识别模型提取逐帧的人脸嵌入(face embedding),再经过一个结构类似音频侧的空洞卷积网络,得到视觉特征序列。视觉特征的时间分辨率与频谱不同,需要用最近邻插值在时间轴上拉伸到与频谱一致的 100 Hz。
- 融合:把音频特征图与每一路视觉特征图在通道维拼接,送进双向 LSTM(BLSTM),再接三个全连接层,输出该说话人对应的复数频谱掩码(complex spectrogram mask)。
- 输出:把掩码与混合频谱做复数乘法,得到该说话人的干净频谱,再经逆 STFT 还原成波形。有几张脸就有几路掩码,每路对应一个说话人。
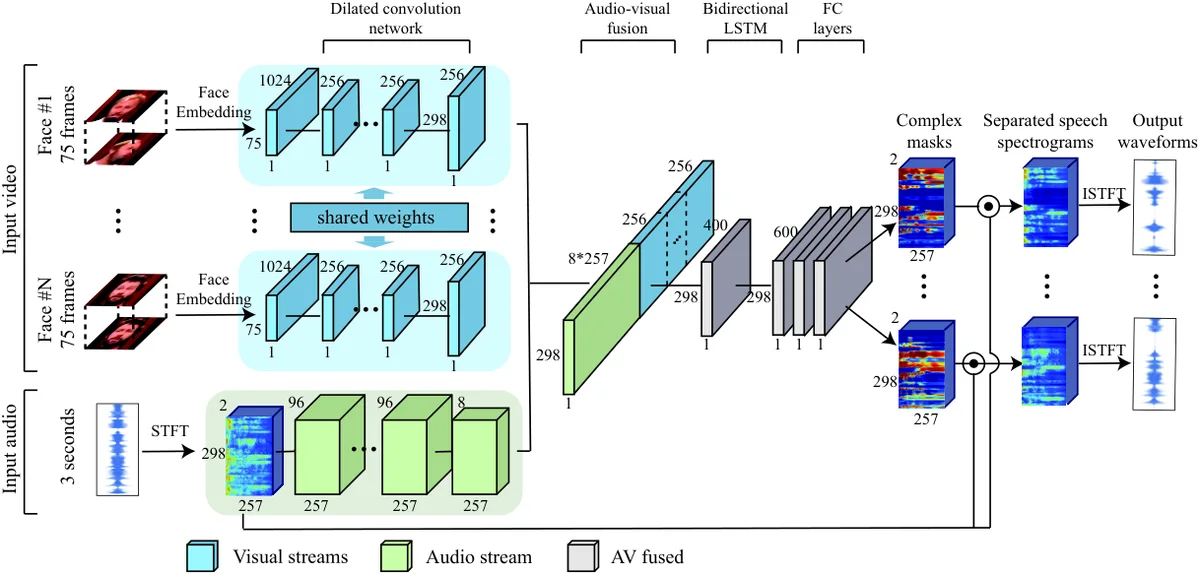
上图是这套多流架构的总览。音频流只有一条,视觉流按人脸数量复制;每条视觉流独立提取人脸嵌入、独立与同一份音频特征融合、独立输出掩码。这个设计的直接后果是计算量随画面中说话人数线性增长,但也带来了一个重要的能力:同一个模型可以同时分离出画面里的多个说话人,而不需要为每个人单独训练。这就是论文强调的说话人无关(speaker-independent)性质——训练一次,对任意说话人可用。
掩码融合为什么比直接拼接波形更稳
复数掩码的物理含义是「在每一个时频点上,这个说话人的声音占混合信号的多大比例、相位如何偏移」。相比直接回归干净波形,掩码目标有两个好处。第一,它天然有界(幅度掩码通常在 0 到 1 之间),网络不容易输出超出混合信号能量的结果,训练更稳定。第二,它逐时频点独立作用,允许不同频率上做不同程度的抑制——低频的背景嗡鸣和高频的齿音可以被分别压掉,而不是整段音频统一缩放。
视觉信息在这里的作用不是「生成声音」,而是提供「谁在说、什么时候说」的先验:人脸嵌入负责身份,唇部运动负责活动区间。两者与音频特征拼接后,BLSTM 在时间轴上把前后文整合起来,输出逐帧的掩码。视觉流的有效性也因此有条件——检测不到人脸、人脸被遮挡、或者说话人不在画面里时,这条路线就退化回音频分离的水平,甚至因为条件错位而变差。
推理端:延迟与人数
这条路线的推理成本有三个来源:人脸检测与跟踪(每帧一次)、人脸嵌入提取(每帧每人一次)、音频与视觉编码器(3 秒窗口一次)。在实时场景里,人脸检测和人脸嵌入通常是主要开销,因为它们的输入分辨率远高于频谱;音频编码器反而相对轻。视觉特征插值到 100 Hz 会带来额外的内存带宽开销,尤其在多人场景下,每一路视觉特征都要保留完整的 3 秒序列。
工程上常见的折中是降低视觉采样率:人脸不需要 25 fps 逐帧处理,5 到 10 fps 足以捕捉唇部活动的包络,缺失的帧用插值补齐。另一种折中是只在检测到「有人在说话」的片段启动视觉分支,其余时间退回音频分离,从而把视觉开销限制在真正需要的窗口内。这些取舍不影响架构本身,只影响它在延迟与算力之间的位置。
路线五:音视频掩码建模——把两个模态放进同一个预训练目标
AV-HuBERT 的基本思路
前四条路线解决的是「一个具体任务」,第五条路线改变的是「预训练范式」。隐单元 BERT(Hidden-unit BERT,HuBERT)在语音上的成功带来一个想法:不直接预测频谱,而是预测「聚成组的离散单元」。那么,如果输入同时有唇部画面与音轨这两路流,能否把「预测这些单元」做成一个跨模态的自监督任务?
AV-HuBERT 由 Shi、Hsu 等人在 2022 年提出,论文《Learning Audio-Visual Speech Representation by Masked Multimodal Cluster Prediction》发表在 ICLR 2022,arXiv 编号 2201.02184。它沿用了 HuBERT 的迭代预测范式(先用信号处理特征聚类出初始单元,再用模型迭代细化),把两路输入一起送进同一个编码器,并要求模型在「只看到部分帧、部分模态」的条件下预测这些单元。
输入编码与融合
两路输入的编码是轻量的、特定于模态的:
- 画面:每一帧裁剪出说话人嘴部区域,经过一个 ResNet 得到一个视觉特征序列 。
- 音频:经过一个线性层得到音频特征序列 。论文有意让音频编码器只有一层线性,以降低音频分支的表达能力。
两路特征序列在特征维上拼接,然后送进同一个 Transformer 主干。这里的拼接意味着两路信息共享同一个注意力上下文:视觉特征和音频特征在同一序列的同一时间位置,彼此互为上下文。
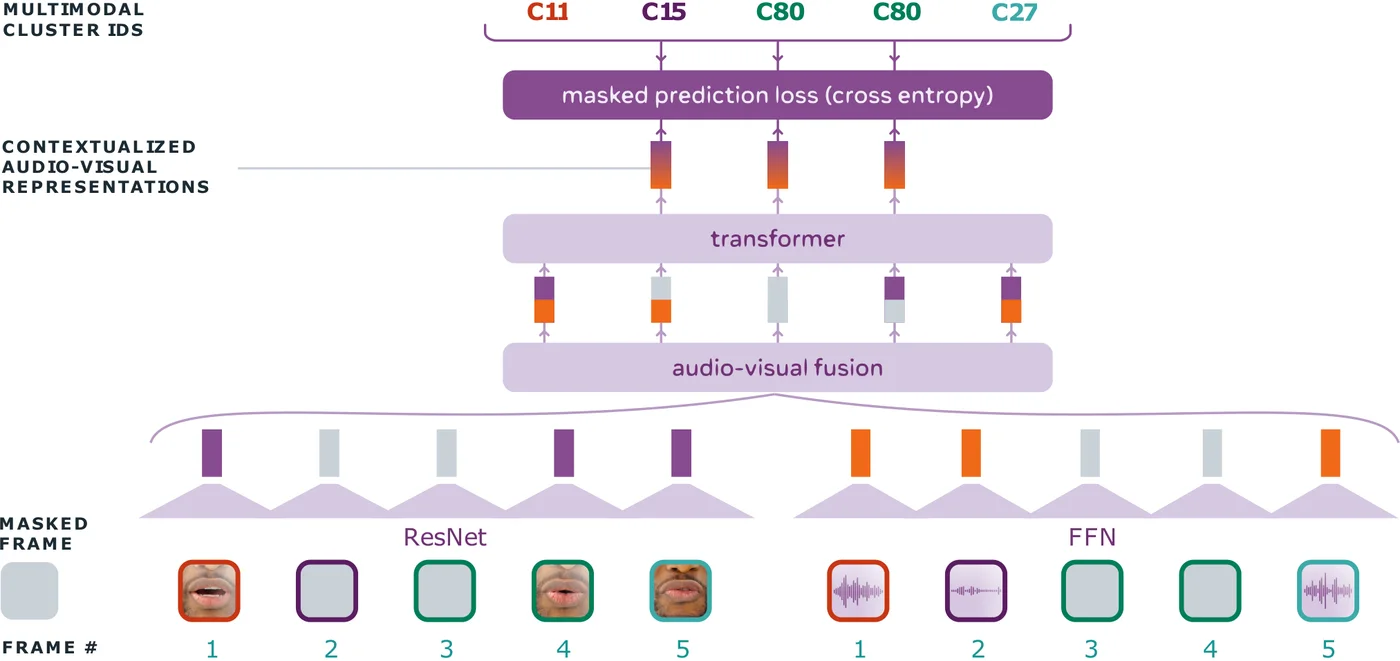
上图是 AV-HuBERT 的完整流程。注意损失只在「两路之中至少一路被掩码」的那几帧上计算——如果没有掩码,模型可以直接复制输入,学不到任何东西;如果掩码只发生在某一路,模型就必须借助另一路的信息以及被掩码序列的上下文来推测。这个约束是让「跨模态信息互补」真正被利用的关键。
掩码与模态丢弃
AV-HuBERT 的掩码策略分两个层面:
- 帧级掩码:在时间序列上按 HuBERT 的做法(例如连续一段帧整体掩掉),被掩码的帧用可学习的掩码嵌入替换。
- 模态丢弃(modality dropout):在序列层面把某一路整段特征置零。具体地,两路都保留的概率是 ,只有音频保留的概率是 ,只有视觉保留的概率是 ,三种情况互斥。
模态丢弃有两个目的。第一,它使模型在预训练时就能适应「只有画面」或「只有声音」的输入配置,这样在下游微调到唇读任务时,直接把音频输入丢掉即可,不需要额外改结构。第二,音频输入对语言的预测能力天然强于唇部输入(唇形到音素的映射多对一),如果不加约束,模型会完全退化到只看音频;而目标单元初始又来自音频聚类,这会让训练形成「音频主导」的自证循环。模态丢弃切断了这条捷径。
迭代式目标单元
初始的离散单元来自音频侧的频域特征(例如 MFCC 或类似特征的 k-means 聚类)。这样做是因为音频信号的「内在音素单元」比画面容易提取。之后的训练在「特征聚类」与「掩码预测」之间交替:用当前编码器的中间层特征重新聚类,得到更贴近语义的新单元,再用新单元作为目标重训。由于训练时两路输入共享同一个 Transformer,音频侧的上下文信息会被融合进视觉特征,从而让聚类出的单元带上「画面可推断」的性质——这正是唇读能够用同一套编码器的原因。
推理:一个编码器两个任务
训练完成后的编码器可以直接用于两种下游任务:
- 自动语音识别(在音频上):输入音频序列(视觉特征置零),微调一个字符级或子词级输出层。
- 唇读(在画面上):输入视觉序列(音频特征置零),同样的微调方式。
同一个预训练编码器在两种输入下都能工作,这正是模态丢弃的直接收益。从推理计算账本的视角看,它的好处是两条下游流水线共用一套主干权重——部署上只需要一份编码器,按下游任务决定输入哪一路(或者两路都用,做音视频联合识别)。
唇读的输入预处理值得单独说明。整帧画面里绝大部分区域与语音无关,直接编码整帧会浪费容量,也会把背景场景的语义混进表示里。更常见的做法是把每一帧中的说话人嘴部区域裁出来,按时间步排成一个缩略图序列:视觉序列因此在时间上与音频逐帧对齐,画面尺寸也被限定在「嘴唇与下巴」这一小块。AV-HuBERT、AVSpeech 以及后来几乎所有的音视频掩码模型都采用这种「裁剪 + 时间序列化」的预处理,它相当于用检测器把视觉输入预先对齐到了语音的语义粒度。
五条路线的关系
把五条路线放在一张图里,可以看到它们是对「画面与声音的同步性」这一唯一弱信号的五种不同用法:
| 路线 | 代表工作 | 监督信号 | 解决什么 | 推理端特征 |
|---|---|---|---|---|
| 对应分类 | L3-Net(ICCV 2017) | 同视频同时间 = 正,不同视频 = 负 | 让两路编码器学到可对齐的语义概念 | 两路编码器 + 线性分类头;可取出单路特征 |
| 跨模态蒸馏 | 视听蒸馏系列 | 视觉教师的输出分布 | 把视觉语义迁移到音频模型 | 只部署学生(音频)模型 |
| 像素级分离 | PixelPlayer(ECCV 2018) | 混合音频需由逐像素输出重建 | 同时回答「哪些像素在发声、发什么声」 | 视觉 + 音频 + 合成器,按帧计 |
| 人脸引导的语音分离 | Looking to Listen(SIGGRAPH 2018) | 单一说话人的干净语音 | 把混合语音拆成画面里每张脸对应的一路 | 每张脸一路视觉流,随人数线性增长 |
| 掩码建模 | AV-HuBERT(arXiv 2022) | 跨模态与模态内上下文 | 预训练一个两种输入都能用的通用编码器 | 一份主干,按任务选输入通道 |
从演进来看,路线一给出了「同步性可作为弱监督」的核心观察;路线二解决「只需要一种模态时的部署形态」;路线三沿着同步性往下钻到空间粒度,回答位置与音色;路线四把粒度从像素换成了「人」——用画面中可见的人脸与唇动去分离混合语音,这是同步性在真实录音场景里最有实用价值的形态;路线五把前四条积累的现象(两路特征可对齐、可互相推测、可按人/位置分组)抽象成一个通用预训练目标。它们并不是互斥的模块,一条完整的视听系统可能同时使用第五条的预训练编码器、第四条或第三条的分离头,以及第一条的对应分类头,视任务而定。
落地时的三条基本边界
同步性本身就是假设。 这五条路线都依赖「画面与声音在时间上对齐」。真实视频里存在延迟(回声、后期混音、网络传输抖动)、遮挡与剪辑,任何一条都会削弱这个假设。工程上的对策通常是:在输入端估计一个时间偏移,在训练时加入随机的微小偏移扰动,让模型对对齐误差不敏感。
可见声源与不可见声源。 路线三、路线四都默认「要分离的声音来自画面中可见的东西」。旁白、背景音乐、画外音这类声源不满足这个前提:像素级方法会把它们摊到某个区域或均衡输出,按人脸分离的方法则根本没有对应的视觉流,这些声音会留在混合信号里、无法被指派给某个人。处理这类内容的视听模型,必须在架构里显式加入「无视觉条件的残差通道」,而不是期望分离头自然覆盖。
两种模态的算力不对称。 画面通常需要较大的视觉主干(卷积或 ViT),而音频的频谱图在分辨率上小于高分辨率图像,用更轻的主干就可以取得相当的表现。在部署阶段,这意味着两路的延迟贡献不均衡;对时序约束强的场景(如听障辅助显示、实时字幕),瓶颈几乎总在视觉侧的帧采样与裁剪,而不是音频侧的特征提取。
结语
视听联合建模的基本问题只有一句话:如何把画面和声音放进同一个目标函数,使得一条信号能约束另一条信号的学习。对应分类用「同一时刻来自同一视频」这个二分类目标回答它;跨模态蒸馏用「视觉模型输出分布」回答它;像素级分离用「逐像素输出之和必须重建混合信号」回答它;人脸引导的分离用「混合频谱乘上掩码必须还原单说话人频谱」回答它;掩码建模用「被掩掉的帧必须从上下文和另一模态推测出来」回答它。
这五条路线的共同底层结构是「两种编码 + 一个融合或约束」,差别在于约束施加在哪一层、以什么形式表达:对应分类把约束放在两个全局向量之间;蒸馏把它放在两路输出分布之间;像素级分离把它放在「所有像素合成一个混合信号」的求和上;人脸分离把它放在时频点的掩码乘法上;掩码建模把它放在被掩帧的预测上。理解了这一层,再看后续基于视频的图文对齐、音频驱动的视频生成、以及多模态语音识别等工作,就可以把它们分别归入这五条框架的扩展:有些是在编码器上做得更大更深,有些是在约束上引入更强的空间、时间或身份先验。至于生成方向的视听模型(让模型根据画面生成声音、或根据声音生成对应画面),它们在这个基础框架之上把「解码」也纳入了目标,这部分留待后续再展开。
参考资料
- Arandjelović R., Zisserman A. Look, Listen and Learn. ICCV 2017. arXiv:1705.08168. https://arxiv.org/abs/1705.08168
- Zhao H., Gan C., Rouditchenko A., Vondrick C., McDermott J., Torralba A. The Sound of Pixels. ECCV 2018. arXiv:1804.03160. https://arxiv.org/abs/1804.03160
- Ephrat A., Mosseri I., Lang O., et al. Looking to Listen at the Cocktail Party: A Speaker-Independent Audio-Visual Model for Speech Separation. SIGGRAPH 2018. arXiv:1804.03619. https://arxiv.org/abs/1804.03619
- Shi B., Hsu W.-N., Lakhotia K., Mohamed A. Learning Audio-Visual Speech Representation by Masked Multimodal Cluster Prediction. ICLR 2022. arXiv:2201.02184. https://arxiv.org/abs/2201.02184
- Hsu W.-N., Bolte B., Tsai Y.-H. H., et al. HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units. IEEE/ACM TASLP 2021. arXiv:2106.07447. https://arxiv.org/abs/2106.07447
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



