


声纹识别与语音克隆基础架构:从 d-vector 到 x-vector、ECAPA-TDNN,再到零样本克隆如何把几秒钟的声音装进模型
两类问题,同一把钥匙
语音合成系统可以把一句话读得字正腔圆,却几乎总是读出同一个人的声音;而人类只要听一段陌生来电,就能同时判断”他在说什么”和”他是谁”。这两件事在语音里由两个不同的信号承载:内容(说了哪些字、用什么语调)和说话人身份(音色、共鸣腔、发音习惯)。前者变化快、以音节为单位,后者在整段语音里几乎是恒定的。
围绕这两个信号,工业界长期在做两类看似相反的任务:
- 说话人识别(speaker verification / identification,即声纹识别):给定两段语音,判断是不是同一个人。它只需要一个向量来表示”这是谁”——说话人嵌入(speaker embedding)。
- 语音克隆(voice cloning),更准确地说个性化语音合成:给定目标说话人几秒钟的参考语音,合成任意文本,要求听起来就是这个人。它需要在生成过程中注入说话人信息。
把这两件事放进同一篇文章,是因为现代零样本克隆系统的第一步往往就是调用一个说话人编码器,而它和声纹识别模型在结构、训练目标上几乎同源。理解”如何把一段声音压成一个向量”,是理解”如何把这段声音再放出来”的前提。
本文按时间顺序拆解说话人嵌入主干的四次演进——d-vector、x-vector、ECAPA-TDNN 与更晚的 ResNet 式主干——再转向克隆侧:从需要逐人训练的 SV2TTS,到把语音离散成 token 的 VALL-E,最后到抛弃时长预测、纯整流流去噪的 F5-TTS。每一节的落点都放在架构为什么这样设计、推理时要付什么代价,而不是榜单分数。
先统一口径:声纹系统怎样被评估
在进入网络结构之前,需要先把评估方式说清楚,后面的设计动机才有参照物。
声纹识别有两种基本形态。验证(verification)是 1:1 比对,输入一个断言”这两段语音来自同一人”,输出接受或拒绝;开集识别(open-set identification)是 1
度量用的是余弦相似度。若两段语音的嵌入分别为 :
之所以用余弦而不是欧氏距离,是因为嵌入训练目标通常本身就在角度空间上施加约束(见后文 AAM-Softmax),模长不携带身份信息,归一化后丢掉即可。当嵌入预先做了 L2 归一化时,余弦相似度就等于内积,检索库里所有注册向量可以预先归一化后放进一个矩阵,一次矩阵乘法得到全部候选分数。
系统性能通常报两个指标:
- EER(Equal Error Rate,等错误率):把阈值从低扫到高,虚警率(false accept)与漏检率(false reject)随阈值此消彼长,二者相等时的错误率就是 EER。它用一个数概括了整条 DET 曲线的工作点。
- minDCF(minimum Detection Cost Function):给定虚警与漏检的代价权重(通常漏检更贵)和目标先验概率,求所有阈值下加权错误代价的最小值。它比 EER 更贴近实际部署,因为真实系统很少工作在等错误点上。
一个细节值得记下:声纹嵌入的质量几乎完全由注册语音的长度和信道条件决定。同一人在手机录音和会议室远场麦克风下的嵌入可能差得很远,这就是所谓”信道失配”。后面每一次主干升级,动机大多可以归结为”让嵌入在信道扰动、短语音、强噪声下更稳”。
d-vector:把说话人建模当成分类任务
最早的深度学习声纹方案之一是 Google 于 2014 年提出的 d-vector。它的思路极其朴素:训练一个区分训练集里所有人的分类网络,每帧语音经由若干层 DNN 得到激活值,把一整段语音的所有帧激活取平均,得到的定长向量就是嵌入。训练损失是标准的 softmax 交叉熵,只要求模型能分辨训练集里的几百到上千人。
这种做法的直觉是:如果网络为每一帧输出”这一帧听起来像谁”的分布,那么对一段属于某人的语音,各帧激活的平均值就浓缩了此人的统计特征。d-vector 在当年的文本相关说话人验证上取得了明显优于 i-vector 的效果,但它有两个硬伤:
- 训练和测试目标不一致。训练时网络只需在封闭集合上分类,没有任何机制鼓励”同一个人的两段不同语音映射到相近的点”,也没有机制强迫”不同人的点分开”。这个约束是事后由平均池化和余弦相似度隐式带来的,非常弱。
- 逐帧平均丢掉了时序结构。音色信息并不均匀分布在每一帧上——清音段、静音段几乎不含说话人信息,把它们与元音段等权平均会稀释信号。
第二个问题的修法很直接:把平均换成统计量。x-vector 正是这样做的。
x-vector:TDNN、统计池化与端到端度量损失
x-vector 于 2018 年由 David Snyder 等人在 ICASSP 上提出。它把主干从普通 DNN 换成时延神经网络(time-delay neural network, TDNN),并为变长语音设计了一个结构化池化层。
TDNN 为什么要替代普通全连接
TDNN 本质上是一维卷积:每个时间步的输出只依赖前后若干个时间步的输入,参数在各时间步间共享。对语音而言这很自然——同一类音素无论出现在句子哪个位置,都应该触发同一组特征检测器。TDNN 的每一层配置成(核宽 、膨胀 、通道数):
- 前几层只感受局部(),逐层扩大感受野;
- 最后一个局部层把上下文聚成逐帧的 维表示,其中 通常为 512 或 1536;
- 再接若干全连接层把帧表示映射到嵌入维度(常见 512)。
输入通常是 24 维左右的 MFCC 或 40 维滤波器组特征,取 25 ms 窗、10 ms 帧移。之所以用这种短时谱特征而不是原始波形,在于 MFCC 已经做过倒谱变换,把声道形状(决定音色)与激励(决定音高)在一定程度上解耦,音高变化对声纹识别是干扰而非身份信号。
统计池化:把变长换成定长
x-vector 的关键替换是统计池化(statistical pooling)。设池化层输入为 的帧级表示 ,输出由每个通道的时间均值与标准差拼接而成:
池化后的向量维度为 。标准差这一项的作用常被低估:均值刻画了”平均而言此人听起来是什么样”,标准差刻画了”此人说话时的变化幅度”,对区分发音习惯差异很大的说话人很有效。此后接两层全连接,最后输出 的 x-vector。
训练目标为何要从 softmax 改成度量学习
Snyder 的方案在训练阶段使用了一个更接近测试目标的结构:一个端到端的小网络,把一批语音各变成一个嵌入,再配一个”比对头”(comparison layer)——把嵌入按说话人聚合、求均值和方差,并按余弦相似度构造”这些是同一个人 / 这些不是”的 softmax 分类问题。这个比对头只存在于训练过程中,推理时完全不需要。它的意义在于让嵌入之间的距离本身成为优化对象,而不是分类概率。
但即便如此,基于分类的 softmax 有一个隐式目标”类间分开”,却没有显式目标”类内紧凑”。于是后续工作引入了两类显式约束:中心损失(center loss)把每个人拉向其类中心,AAM-Softmax(Additive Angular Margin Softmax)则在角度空间上加一个间隔 ,强迫同类样本在角度上更紧凑。ECAPA-TDNN 就采用 、预缩放 的 AAM-Softmax。
AAM-Softmax 的完整形式为:
其中 为批内样本数, 是样本 的真实说话人, 是嵌入与第 个类权重向量之间的夹角。 放大 logits,使 logits 尺度与普通分类器可比; 把真实类的角度向外推,相当于要求样本与自己的类中心之间留出间隔。这种改法的代价是训练更不稳定,通常需要先以较小 margin 预热。
ECAPA-TDNN:把 TDNN 主干改成可听多尺度的残差网络
ECAPA-TDNN(Emphasized Channel Attention, Propagation and Aggregation in TDNN)由 Brecht Desplanques 等人在 Interspeech 2020 发表,是 x-vector 之后在 VoxCeleb 上被广泛采用的主干之一。它的名字已经概括了三个核心改动:强调信道注意力(SE)、改进传播结构(残差)、聚合多层特征(multi-layer aggregation)。
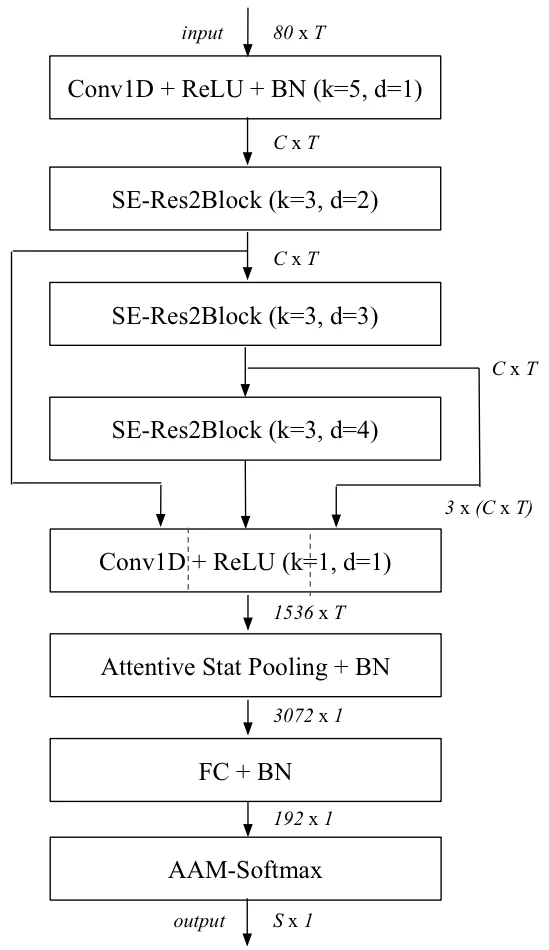
上图是论文给出的整条前向路径,可以按箭头逐段读:
- 输入:80 维 MFCC,25 ms 窗、10 ms 帧移,随机截取 2 秒做倒谱均值归一化。不做 VAD,因为论文认为池化层本身能学会忽略静音段。
- 起始 Conv1D + ReLU + BN(,512 通道):把帧级特征压成一个基础表示 ,维度 ,此处 。
- 三个 SE-Res2Block,核宽均为 3,膨胀分别为 2、3、4。每个块内部先做 squeeze-and-excitation,再做多尺度 Res2Net 处理,最后残差加回输入。
- 多层特征聚合:把三个块的输出与 在通道维拼接(),再用一个 的 Conv1D 压到 1536 通道。
- 注意力统计池化:输出 3072 维(均值与标准差拼接)。
- FC + BN 到 维,再接 AAM-Softmax 分类层进行训练,推理时取 192 维 FC 输出作为嵌入。
设计动机逐条拆开
为什么要加 SE 块。 Squeeze-and-Excitation 模块先做全局平均(squeeze)得到一个通道描述向量,再经两层小 MLP(reduction 维度 128)算出每个通道的权重(excitation),最后逐通道缩放。对 ECAPA 而言,这意味着网络可以按上下文动态调整各通道的重要性:在含噪帧上压制噪声道,在元音帧上突出共振结构较强的通道。论文强调 SE 还能”扩大时域上下文”,因为 squeeze 是对整段做时间平均,权重是对全局上下文计算出来的,后续每个时间步都能用上这段全局统计。
为什么用 1-D Res2Net 而不是单纯的膨胀卷积。 标准 Res2Net 把通道切成 组(论文取 ),第 2 组之后每组都以前一组的输出为输入,形成层级式的多尺度残差连接。放在一维语音上,效果是同一层内同时存在多个感受野:第 1 组几乎只看局部,第 8 组感受野最大。传统做法是靠不同膨胀率的并行分支(如 2、3、4 各一个块)获得多尺度,而 Res2Net 把多尺度塞进一个块内部,参数更省——论文报告 的 ECAPA-TDNN 只有 6.2M 参数,却优于 20.4M 参数的 E-TDNN(large)。
为什么要聚合三层输出。 TDNN 系列的惯例是只取最后一层做池化,但网络越深,浅层中精细的音素细节被抽象得越多,而这些细节对音色有贡献。多层聚合相当于把”低层细节 + 中层结构 + 高层抽象”一起送进池化,代价只是拼接后多一个 卷积。
注意力统计池化。 把 x-vector 的等权均值换成加权均值。设帧级表示 ,注意力权重为:
加权均值为 ,加权二阶中心矩为 ,拼接得到池化输出。这就是”无 VAD 也能工作”的原因:静音帧的注意力权重会被自动压低。
相对 x-vector 的工程含义
在同一套 VoxCeleb2 训练条件下,论文报告 ECAPA-TDNN()在 VoxCeleb1 上的 EER 为 0.87%,而 E-TDNN 基准为 1.49%,EER 几乎减半,参数量 14.7M 相对基准的 6.8M 并不算大。更重要的是,ECAPA-TDNN 的 版本只有 6.2M 参数,可以塞进移动端或嵌入式设备做离线注册,这是声纹在工业界大规模落地时非常看重的一点。
还有一个推理层面的细节:ECAPA-TDNN 的整个主干都是时间卷积 + 全局池化,不含任何循环结构,因此对一段固定长度输入只需一次前向;对实时流式场景,卷积部分可以按块缓存尾部上下文增量计算,但注意力池化的权重依赖整段,真正的流式嵌入需要把池化改成移动统计量或分段聚合。
更晚的主干:为什么在长录音上 ResNet 反而更稳
当注册语音延长到数秒乃至数十秒,TDNN 类主干的感受野增长有限,深层的帧表示仍然偏局部。2021 年前后,SRE 竞赛的强系统大量改用 ResNet 主干加统计池化(通常称 r-vector 路线),再接 AAM-Softmax。ECAPA 的同一篇论文里 ResNet34 的 EER 已经接近 ECAPA(2.46% vs. 2.32% 在 VoxCeleb1-H 上),而随着数据规模增长,ResNet 在更长、更嘈杂的试音上优势明显。到 ECAPA-TDNN 的后续改进(如针对跨域评测的 SE-ResNet 变体),主流思路是把二者的长处合起来:残差主干负责局部纹理,SE 负责信道自适应。
这条演进对下游克隆系统有一个直接影响:开源克隆工具链里用作”音色提取器”的模型,大多来自这条线。例如开源的 Resemblyzer 直接复现了 SV2TTS 的 GE2E 说话人编码器(3 层 LSTM、256 维嵌入),而更近的克隆项目普遍换成了 ECAPA-TDNN 或 WavLM 系的自监督表示——因为它们生成的嵌入更稳、更像”身份指纹”。
SV2TTS:第一次把”几秒钟样本”变成可用的克隆系统
把上面这套说话人嵌入落到合成上,最早的系统性工作是 SV2TTS(Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis),2018 年由 Ye Jia 等人在 NeurIPS 提出,同年也由 Google 以 “Tacotron 2 + Speaker Encoder” 的形式开放演示。
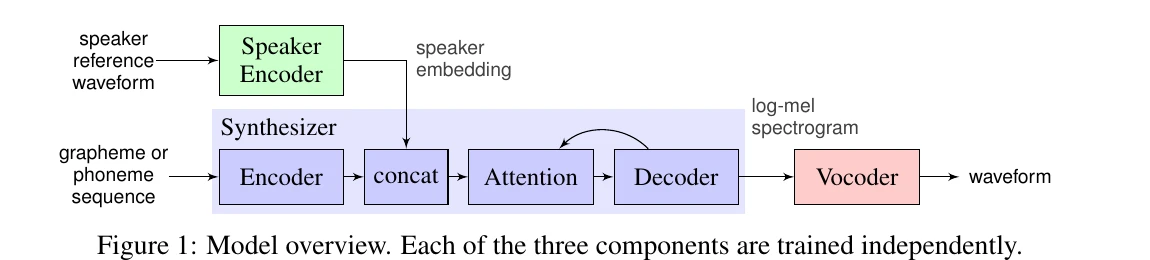
SV2TTS 的结构如图所示,分为三个独立训练的网络:
- 说话人编码器:输入 40 通道 log-mel,3 层 LSTM、每层 768 单元、每层后接投影到 256 维,取最后一帧输出做 L2 归一化得到 256 维嵌入。训练数据切成 1.6 秒片段,使用说话人身份标签做 GE2E 损失(Generalized End-to-End Loss),完全不需要转写文本。
- Tacotron 2 风格的合成器:从字符或音素预测 mel 频谱。说话人嵌入被加到字符编码器的每个时间步输出上,再进入注意力解码。这里嵌入不是作为注意力上下文,而是作为”偏置”注入文本侧——这种注入方式一直被后续的零样本 TTS 沿用,因为它不破坏原有的字符对齐。
- WaveNet 声码器:自回归地把 mel 转成波形。
三个网络拆开训练是关键设计。训练多说话人 TTS 要求成对的(文本、语音),而说话人编码器只需要(语音、说话人标签),后者可以拿到远多于前者的数据、且允许含噪和有声学回声。更重要的,二者可以在不重叠的说话人集合上训练,实验证明这一拆分依然能泛化到训练集之外的说话人。
推理时,给出目标说话人几秒参考语音得到嵌入,后续合成就用这个嵌入。这本质上是一个”条件变量替换”式的零样本:模型从未见过这个人,但嵌入空间对所有说话人统一编码。
这条路线的问题也自此暴露:
- WaveNet 声码器太慢。自回归逐样本生成,一段几秒语音需要数万次前向。后来的 Parallel WaveGAN、HiFi-GAN 类 GAN 声码器在推理速度上提升了两个数量级,从频谱到波形的 GAN 声码器一篇对这条替代路线有完整拆解。
- 嵌入与合成是两段独立训练的系统,误差无法互相纠错。说话人编码器学的是”判断是不是同一人”,合成器学的是”在有嵌入的条件下读文本”,二者共享的只有嵌入的数值语义。一旦嵌入落在训练分布之外(极端口音、强噪声),合成器只能按最近邻的语义去理解,音色或韵律走样无法被内部机制纠正。后面的零样本系统试图用”提示延续”替换掉这种显式条件。
- 声学模型本身用确定性注意力。Tacotron 2 的对齐是学习出来的,在未见过说话人上出现漏读、重复的概率不低。
从”条件变量”到”提示延续”:说话人信息进入语言模型
SV2TTS 把说话人信息当成一个显式条件,VALL-E 的思路则完全不同:不提取嵌入,直接把参考语音的离散 token 当成一段”前缀”,让模型顺着这段前缀继续生成。这是 2023 年微软的 VALL-E 采用的方案。
把语音离散成多层 token
VALL-E 使用 EnCodec 神经编解码器。EnCodec 的编码器在 24 kHz 波形上工作,先产生 75 Hz 的连续隐表示(相对采样率压缩 320 倍),再用 残差向量量化(residual vector quantization, RVQ)把它量化为多层离散码。VALL-E 的配置是 8 层量化器、每层 1024 个编码本。
RVQ 的结构决定了”层”的含义。第一层量化器给出一个粗重建 ,残差 再送入第二层,依此类推:
层数越靠后,携带的能量越小、信息越细。因此一个 10 秒的语音在 VALL-E 看来是 的码矩阵,并且每一层的序列都以第一层为锚——后续层只修正”细粒度音色与纹理”。
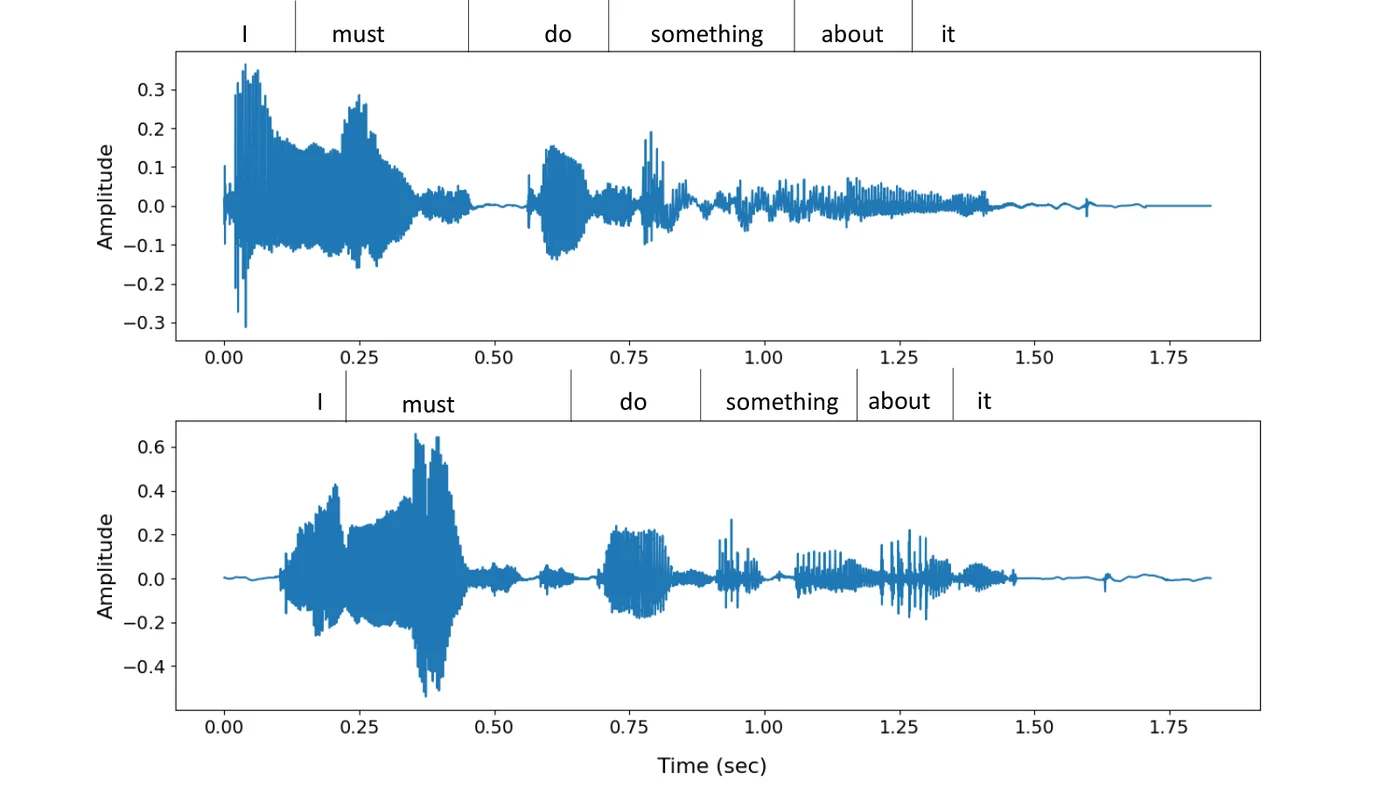
上图展示论文给出的量化示意:同一段语音在波形视图中是连续曲线,在码层视图中则变成了几组有明显结构的阶梯序列。可以看到低层码在时间上变化相对平缓、高层码更”跳跃”,这与 RVQ 逐层细化残差的结构相吻合。
两层建模:AR 管第一层,NAR 管其余层
VALL-E 的生成被拆成两个 Transformer:
- 自回归模型(AR)只在第一层码上运行,以音素序列和参考语音第一层码为前缀,逐位预测 ;
- 非自回归模型(NAR)对第 2 至第 8 层并行运行,以音素、参考语音的全部码层,以及第一层码的新生成结果为条件,逐层输出。
两个模型结构一致:12 层 Transformer、16 个注意力头、嵌入维 1024、FFN 维 4096。训练数据为 LibriLight 60K 小时。
这种分层建模的动机可以用一句话概括:把最需要全局一致性的层留给自回归,把细粒度补充交给并行。第一层码决定”大骨架”,需要跨时间长依赖与文本对齐,必须顺序生成;第 2–8 层主要是纹理与细节,给定第一层后彼此相对独立,论文把它们放在一个 NAR 模型里逐层调用(实践中调用 7 次),把总的前向次数从码层数乘以序列长度压到约 次自回归解码加 7 次 NAR 前向。
提示延续如何携带音色
VALL-E 的”参考语音”与”待合成文本”被拼接成一维序列输入:
[音素序列 x] [参考语音第 1 层码 ã_1 ... ã_T1] → 预测新语音的第 1 层码也就是说,说话人身份不是通过一个单独的嵌入注入,而是以在上下文中的前几个 token 的形式,和文本一起被模型读到。论文把它称为上下文学习(in-context learning)。好处是没有显式设计——不需要为音色定义损失,也不需要对齐嵌入与文本,只要模型学过”读一段语音后接着读同一种声音”这种模式。
这条路线有两个继承自早期实验的推论:其一,参考语音的长度和质量直接决定克隆效果,论文用的参考约 3 秒;其二,模型对参考语音的情感和录制环境也会一并延续,这在某些场景是优点(如保留语气),在另一些场景是缺陷(参考中有回声,合成也会有回声)。
这条路线在推理侧的真实代价
- AR 与 NAR 的串行依赖:NAR 必须等 AR 全部生成完毕,导致流水线无法深度交叉;
- 码本数量大:8 层各 1024 个码,每步 AR 都需要在 1024 维 logits 上采样,解码开销不低;
- 采样与对齐的脆弱性:音素与音频码长度完全依赖模型学到的时间缩放,在罕见的、语速异常或大量重复音节的情况下会出现漏字。论文中报告了为缓解对齐问题而引入的”连续性训练”变体。
同一时期另一条支线是 AR + flow matching 的混合系统,如 CosyVoice 2:用 LLM 主干做自回归建模,再以 flow matching 把 token 映射到 mel,并设计成双向流式以保证首包延迟。对这条语音 token 序列的推理链路,CosyVoice 2 架构拆解一篇有逐层说明;而 RVQ 与 codec 语言模型的一般形态,可参考音频生成的离散 token 路线。
F5-TTS:抛弃时长预测与音素对齐的非自回归克隆
VALL-E 之后,零样本 TTS 的演进方向分成两支:一支继续在语言模型上堆叠(逐步把 NAR 变成并行解码、把 codec 换成更强的一层),另一支则彻底离开离散 token 和自回归框架,回到整流流匹配 + DiT的连续去噪。第三支的早期代表是 2024 年提出的 E2 TTS,它展示了最激进的做法:文本补齐填充 token 后直接与语音拼在一起,由一个非自回归模型做语音填充。F5-TTS(2024 年 10 月发布,作者来自上海交通大学、剑桥、Origin Lab 等)在此基础上改进了输入表示与采样。
核心思想:把克隆变成”掩码语音填充”
假设要合成”Hello! I’m fine!”这句话,目标时长约 3 秒。F5-TTS 的处理顺序是:
- 把参考语音(3 秒)和其转写(“Are you OK?”)作为前半段;
- 把待合成文本转成字符序列,用填充 token(filler token)补齐到与目标语音等长的长度;
- 把两段拼接成一条序列送入 DiT,在流匹配目标下预测含噪语音段的速度场;
- 推理时从高斯噪声出发,用 Euler ODE 求解器沿时间步积分预测速度场得到 mel,再经声码器(官方权重用 Vocos)输出波形。
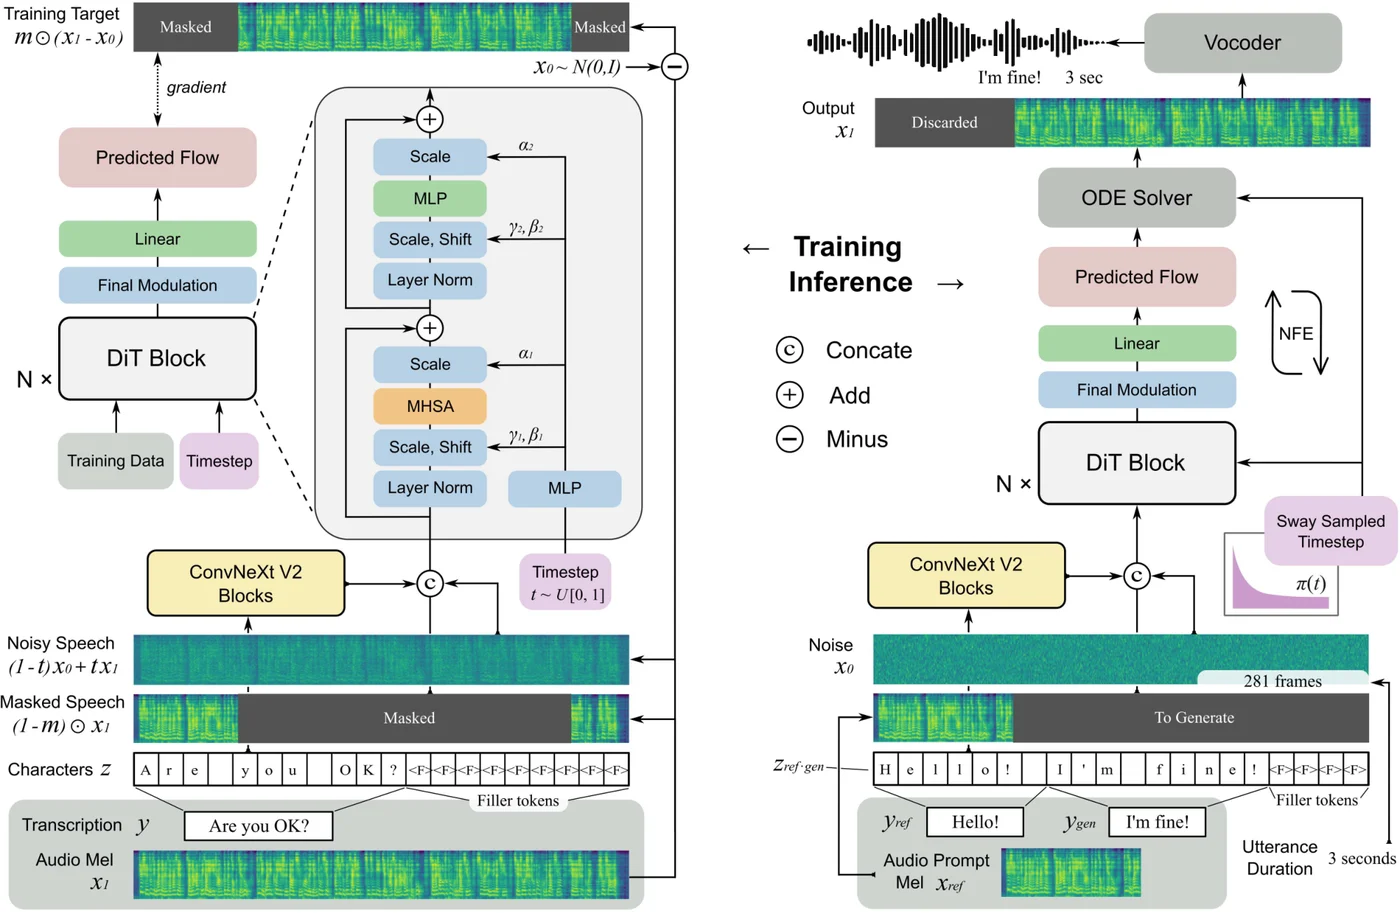
上图中左右两栏分别是训练与推理。左侧可以看到关键拼接:字符嵌入经 ConvNeXt V2 块精炼后才与语音嵌入拼接,而右侧推理路径从高斯噪声开始,经 ODE 求解器迭代得到预测速度场,再积分成纯净语音。
这套设计的”为什么”值得细说,它解释了为什么现代零样本 TTS 可以不要时长模型、不要音素对齐、不要单独的说话人编码器:
为什么不需要时长预测器。 传统 TTS(如 FastSpeech 2)必须先预测每个音素持续多少毫秒,再把文本”拉伸”到目标长度,这个时长预测器是误差的主要来源之一。F5-TTS 换了一种表示:既然待合成文本的长度未知,就直接用 filler token 把文本塞到一个候选长度——推理时可以按参考语音的语速估计目标帧数。模型学到的是”在给定长度的位置上填什么声音”,时长信息隐含在填充策略里,无需显式预测。
为什么不需要显式对齐。 因为没有音素级位置标签。参考语音与参考转写、待合成文本与待填充语音段都只是被拼接在一起,模型通过注意力自行学习”哪个字符对应哪段声音”。这与 SpeechT5、Whisper 所依赖的序列到序列对齐完全不同,反而更接近 VALL-E 的上下文延续——区别在于 VALL-E 在 token 上延续,F5-TTS 在连续的潜表示上延续。
为什么音色注入不需要额外模块。 参考语音的 mel 直接出现在序列里,说话人信息以”上文”的形式提供给 DiT。这和 SV2TTS 显式 256 维嵌入形成鲜明对比:嵌入是压缩过的、信息有损的、需要额外一个编码器训练;上下文化的 mel 是原始信号,模型可以直接从中提取音色、语速、录音环境等复合特征。代价是每次推理都要多处理一段参考语音的 token。
DiT + ConvNeXt V2:文本侧为何还要先”精炼”
F5-TTS 的主干是 DiT 块(adaLN-Zero 调制),而输入侧的文本嵌入先过一个小的 ConvNeXt V2 块。论文对这一设计的解释是:字符级嵌入缺少上下文,而需要与语音做联合注意力时,如果直接使用原始字符向量,模型难以在早期把文本结构”整理”成和语音对齐的形式。ConvNeXt V2 提供一维局部卷积上下文,把字符嵌入”预对齐”到语音侧,缓解了 E2 TTS 中训练收敛慢与鲁棒性差的问题。论文把这一改动归因于收敛速度与鲁棒性的改善:字符嵌入本身缺少上下文,直接与语音拼接时模型难以在早期建立稳定对齐。
DiT 块本身使用 adaLN-Zero 调制:时间步 的嵌入经 MLP 产生 scale、shift、gate 三个向量,对 LayerNorm 输出做仿射,并在残差分支上乘 gate(初始化为零)。门控初始为零意味着训练开始时每个 DiT 块等于恒等映射,这对深层网络稳定训练很关键。图中标注的”Final Modulation”就是最后一次 adaLN 调制。
整流流匹配:为什么比扩散更适合语音
训练目标是条件流匹配(conditional flow matching, CFM):
这里 是真实 mel, 是高斯噪声, 沿着一条直线路径插值。目标速度场 要拟合的正是这条直线方向 。与 DDPM 相比,CFM 的路径是直线,因此 ODE 求解所需的步数可以很少;论文报告中 F5-TTS 用 16 步即达到自然的工作点,在 RTX 3090 上 10 秒语音的 RTF 约为 0.15。
值得注意的是,这条训练目标里没有单独的音色项。说话人相似度完全由条件输入(参考语音段)通过注意力提供。这是 F5-TTS 与 SV2TTS 最本质的区别——前者把音色当作”上下文”,后者把音色当作”条件向量”。
Sway Sampling:推理调度也可以和训练不同
一个易被忽略但很有用的技巧是推理侧的非均匀时间步调度。训练时 ,但流模型的”难度”并不均匀分布在整个区间:靠近 的早期步从纯噪声起步,负责勾勒语音的整体轮廓;靠近 的末段已接近数据,负责补充细粒度细节。F5-TTS 的推理用一个单调映射 改变采样:
先均匀采样 ,再令实际求解时间步 。系数 控制偏移方向与幅度: 退化为均匀采样, 时采样向右侧偏移, 时向左侧偏移。论文的关键观察是,语音与文本的对齐在最初几步就基本定型——早期的生成结果决定了后面的内容走向,因此把更多步数分配到早期阶段比均匀分配更有价值。F5-TTS 默认取 。
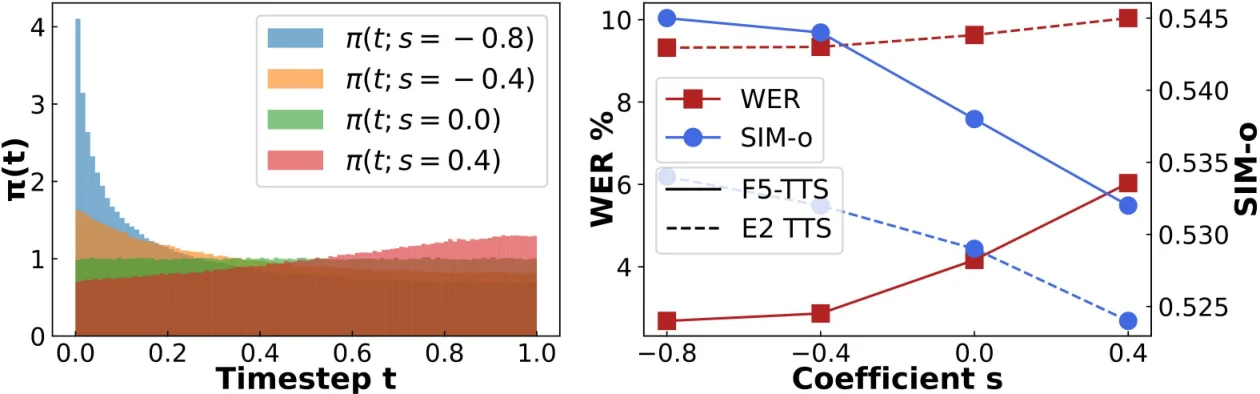
上图左侧是不同系数 下时间步 的概率密度函数: 是一条平坦的均匀分布, 越负,密度越向 一侧堆积;右侧对应的小模型评测显示,WER 随 变负而下降,而音色相似度 SIM-o 的变化相对平缓——受益最多的是”内容对齐”,而非”音色”。论文还用一个”泄漏与覆盖”实验说明这一点:先放开对末段结果的约束、再比较质量变化,结果同样指向早期步的重要性。
这一技巧的关键在于它不需要重新训练——同一个模型配上不同的调度就能获得不同质量。对推理系统设计而言,这意味着求解时间表本身就是一个可调旋钮:延迟预算紧张时可以调步数与步位置,而不必改动模型权重。
F5-TTS 的推理账本
以 10 秒目标语音为例,一次零样本合成的计算大致由以下四块构成:
| 环节 | 输入规模 | 主要开销 | 可优化点 |
|---|---|---|---|
| 参考语音 mel 提取 | 参考音频 3–10 秒 | STFT + mel | 可缓存,与待合成文本无关 |
| 文本精炼 | 字符数 + filler 补齐 | ConvNeXt V2 + 字符嵌入 | 可与参考侧并行 |
| DiT 去噪 | 拼接序列长度 ≈ 参考帧 + 目标帧;16 步 | 全注意力 O(L²),每步一次前向 | 少步蒸馏、缓存、Sway 采样 |
| 声码器 | mel 帧数 | 卷积/GAN 声码器 | 通常是最小开销项 |
这其中的最大项是 DiT 的注意力。当参考语音很长(例如 30 秒),拼接后的序列长度接近训练时的上界,注意力成本按平方增长,且参考段每一步都要参与计算——这正是社区里”参考语音不宜过长”的经验来源,和 VALL-E 里”前缀越长、AR 成本越高”是同一个机制。
三种范式的对照
把上面三条路线放到一张表里比较,可以更清楚地看到音色是如何进入系统的:
| 维度 | SV2TTS(2018) | VALL-E(2023) | F5-TTS(2024) |
|---|---|---|---|
| 声学表示 | 连续 mel | EnCodec RVQ 8 层离散码 | 连续 log-mel |
| 建模框架 | Tacotron 2 自回归注意力 | AR(第 1 层码)+ NAR(2–8 层) | 整流流匹配 + DiT,全非自回归 |
| 音色注入 | 显式 256 维嵌入加到字符编码器 | 参考语音 token 作为上文前缀 | 参考语音 mel 作为上文拼接 |
| 时长预测 | 注意力自行学习 | AR 隐式决定长度 | filler 填充,无显式预测器 |
| 声码器 | 自回归 WaveNet | EnCodec 解码器 | 非自回归声码器 |
| 参考长度敏感性 | 低(被压缩成嵌入) | 高(前缀越长 AR 成本越大) | 中高(注意力平方增长) |
| 参考环境/情绪是否被继承 | 部分(仅嵌入所保留的信息) | 明显 | 明显 |
表中最后一列的问题可以推广成一条判断:音色注入越”原始”,克隆越像,但上下文成本越高。SV2TTS 用一个高度压缩的 256 维向量换来低成本的推理,却丢失了参考语音中的细节;VALL-E 和 F5-TTS 把参考语音原样塞进上下文,相似度显著提升,但必须为这段参考支付注意力代价。工程上常见的折中是:对参考语音做低分辨率或低帧率编码后再作为上下文,既保留较多细节又控制长度——这与 KV 缓存压缩的思路同源。
把步数再压一半:训练无关的步采样剪枝
Sway Sampling 改的是”步点落在哪里”,不改步数。对生产环境来说,真正决定延迟的是前向次数(NFE, number of function evaluations)——DiT 每多一步就多一次全序列注意力。围绕这一点,2025 年的 Fast F5-TTS 提出了另一种思路:经验步采样剪枝(Empirically Pruned Step Sampling, EPSS)。
它的做法是先在若干条参考语音上记录 F5-TTS 的完整采样轨迹(每一步的 与预测速度),观察哪些区间里轨迹的变化极小——这些步对最终结果的贡献接近于零。把步点从这些区间挪走、集中到轨迹曲率大的区间,就得到一组非均匀的离散时间步。因为只是替换求解器的时间表,不需要重新训练、不需要改模型权重,与 Sway Sampling 属于同一类”训练无关加速”。
论文报告的结果是:7 步生成在 RTX 3090 上把 10 秒语音的 RTF 压到 0.030,相对原版 F5-TTS 约 4 倍加速,论文报告其表现与原版可比。这个数字值得单独看一眼:原版 16 步的 RTF 是 0.15,按步数比例线性外推(7/16 ≈ 0.44)应得到约 0.066,实测却只有 0.030。两者的差异说明 RTF 并不只由 NFE 决定,实现层面的融合、内存访问与固定开销都会叠加进来;但把两个数字放在一起仍能确认一条工程结论:NFE 是流式 TTS 延迟的第一主导项,减少步数带来的收益远大于同一层面的其他优化。
把两种调度放在一起对比,可以更清楚它们的分工:
| 策略 | 改变什么 | 是否需要重训 | 典型收益 | 风险 |
|---|---|---|---|---|
| Sway Sampling | 步点在 内的分布 | 否 | 相同步数下质量更好 | 系数越负,质量持续变好但边际收益递减 |
| EPSS | 步点的具体位置与数量 | 否 | 7 步接近 16 步质量,RTF 降约 4 倍 | 剪枝过度会丢细节,尤其在高频段 |
| 少步蒸馏 | 模型本身的输出 | 是(需教师模型) | 1–4 步可用 | 训练成本高,泛化受教师约束 |
这三种手段并不互斥:蒸馏得到少步学生模型后,仍可叠加 Sway 或 EPSS 的调度;反过来,调度只能压到”质量悬崖”之前,再往下就必须改模型。上一段提到 RTF 从 0.15 到 0.030 的跃迁,恰好说明在实际服务里,求解器配置与模型结构的优化空间是同一量级,而前者几乎没有训练成本。
对批处理系统,NFE 的减少还有一个二阶效应:去噪迭代中的中间激活只保留一步所需的规模,批内样本共享同一套步表即可同步推进,因此减少步数同时提高了批内同步的效率。这与 LLM 推理中减少解码步数的收益结构类似——只是这里的”步”不是 token,而是去噪迭代。
克隆系统在推理服务中的位置
最后把视角拉到部署层面。一个零样本克隆服务通常由三个可独立伸缩的环节组成:
- 音色预处理(可离线、可缓存):参考语音转 mel、降噪、VAD、说话人嵌入提取。这部分与待合成文本无关,同一说话人的多次请求可以完全复用结果,是缓存收益最高的一段。
- 生成主干:DiT 或 AR 主干,决定延迟与吞吐,也是批处理最有效的一段——拼接序列里参考段共享的部分并不天然可批处理,但目标段的去噪步可以按相同步数批量调度,形成类似推理服务调度中的批处理效应。
- 声码器:通常非自回归,可以按帧批处理,延迟稳定。
需要特别注意的安全与合规问题在这里不能一笔带过。语音克隆的滥用风险远高于其他生成任务,因此工业系统往往在服务入口加入声纹验证(用上面介绍的嵌入技术判断”这段参考语音是不是用户本人的”)、合成水印(如 Google 的 SynthID 类方案)、以及请求限流。这几项和本文讲的嵌入主干共享同一套技术栈:验证侧使用的正是 EER / minDCF 那一套评估口径,只不过部署时的阈值是按业务代价重新调整的,而不是直接取 EER 点。
一个常被混淆的分工:谁负责”像”,谁负责”清”
读完三条克隆路线,会浮现一个问题:相似度和可懂度到底由谁提供?在 SV2TTS 里答案很明确——声学模型负责内容与韵律,声码器负责自然度,音色由嵌入强加;而在 F5-TTS 与 VALL-E 里,这三件事被搅在一起,由同一个主干同时承担。这种耦合并不意味着分工消失了,而是分工从模块层面下沉到了表示层面。
可以用一个常见的消融视角验证这一点。把同一段生成的 mel 换不同的声码器(例如 Vocos 与 HiFi-GAN),音色听起来基本不变、清音与辅音的锐度会变;反过来,把同一份 DiT 权重配上不同的参考语音,音色变化明显、发音内容不变。这说明:
- 声码器只影响”清”:它把 mel 翻成波形的能力决定了齿音、气声与高频纹理,但 mel 本身已经携带音色信息;
- 主干决定”像”:参考语音经注意力进入主干,音色特征在生成过程的早期几步就已确定(这也解释了 Sway Sampling 为什么把步点集中到早期),声码器无法弥补一个错误的音色起点;
- 文本条件决定”对”:音色相似而内容读错的合成,问题总出在文本与语音的对齐段。
工程上的推论是:声码器可以按设备性能自由替换,而生成主干与参考语音的配对必须固定。很多开源克隆项目允许替换声码器,正是因为这一层与音色无关;反过来,把一个为 24 kHz mel(频带上限 12 kHz)训练的主干配上只覆盖到 8 kHz 的 16 kHz 后端,高频共振衰减,音色会立刻”变薄”——问题不在声码器的网络结构,而在频带被截断了。
对 VALL-E 这类离散 token 路线,分工又不同:codec 解码器承担”清”,而第 1 层码承担”像”的主要部分、第 2–8 层补细节。这解释了为什么 VALL-E 的 AR 与 NAR 必须共享同一 codec 权重——一旦换 codec,所有层的码语义一起改变,AR 层学到的”骨架”便不再对应同一种音色。
小结
说话人嵌入主干的演进可以归纳为一条主线:从分类目标到底层度量目标,从等权统计到注意力统计,从局部卷积到多尺度残差。
- d-vector 用分类网络 + 逐帧平均给出最早的深度嵌入,问题是没有显式的”同人相近”约束;
- x-vector 用 TDNN 替代全连接、用均值方差统计池化替代平均,并引入端到端度量损失,奠定了此后十年声纹主干的基本形状;
- ECAPA-TDNN 在 x-vector 之上加入 SE 通道注意力、1-D Res2Net 多尺度块与注意力统计池化,以更少的参数获得显著更低的 EER,成为开源克隆工具链里最常用的音色提取器之一;
- ResNet 式主干在长录音与跨域场景下进一步提升,和 ECAPA 的设计要素逐渐合并。
在克隆侧,三条路线体现了音色注入方式的三种取法:
- SV2TTS 把音色压成一个嵌入,以显式条件注入合成器,训练拆分、推理轻量;
- VALL-E 把参考语音离散成 RVQ 多层码,以”前缀延续”的方式由 AR+NAR 生成,代价是 AR/NAR 串行与码本采样;
- F5-TTS 把参考 mel 直接拼进序列,借助整流流匹配与 DiT 做非自回归填充,用 Sway Sampling 调整推理调度,把”能否克隆得像”交给上下文注意力解决。
对本站此前讲过的语音合成、音频 token 与声码器三块,本文给出的视角是:它们分别对应了”生成主干""声学表示”与”波形后端”这三个可独立演进的层,而说话人信息始终是横跨三层的条件变量。理解如何表示与注入这个变量,比记住任何一个具体模型都更接近问题的本质。
参考资料
- Generalized End-to-End Loss for Speaker Verification
- Deep Speaker: an End-to-End Neural Speaker Embedding System
- X-Vectors: Robust DNN Embeddings for Speaker Recognition
- ECAPA-TDNN: Emphasized Channel Attention, Propagation and Aggregation in TDNN Based Speaker Verification
- Transfer Learning from Speaker Verification to Multispeaker Text-To-Speech Synthesis
- Tacotron 2 的说话人适应演示页(SV2TTS 合成样例)
- Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers(VALL-E)
- High Fidelity Neural Audio Compression(EnCodec)
- E2 TTS: Embarrassingly Easy Fully Non-Autoregressive Zero-Shot TTS
- F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching
- Accelerating Flow-Matching-Based Text-to-Speech via Empirically Pruned Step Sampling(Fast F5-TTS)
- CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



