


音频驱动的说话头基础架构:从 Wav2Lip 的像素口型同步到潜空间扩散数字人
一段音频和一张人脸照片,输出一段这个人正在说这段话的视频。这件事在影视配音、虚拟主播、在线课程、游戏 NPC 和无障碍播报里都有真实需求。它看起来像“让照片动起来”的简单滤镜,实际却是一个跨模态生成问题:输入是时间轴上一维的声学信号,输出是时间轴加上两个空间轴的像素序列,两个模态之间唯一的共同结构是“说话时的口型和表情”。
本文只讲基础架构。具体说,要回答四个问题:音频里哪些信息决定了嘴型,视频一侧用什么表示人脸,生成网络在哪个空间里做修改,以及训练时靠什么信号让嘴型和声音对上。围绕这四个问题,产业界形成了四条有代表性的路线,分别以 Wav2Lip、SadTalker、LivePortrait 和 MuseTalk/EchoMimic 这类工作为节点。每条路线都是一套不同的折中,而不是同一个模型的版本迭代。
问题定义:音频到人脸视频到底难在哪
两个模态之间没有天然的逐帧对齐
语音识别可以把波形压到每秒 100 帧左右的特征再映射到文字,因为文字和语音在时间上有大致对应关系。说话头更麻烦:输出视频每秒 25 到 30 帧,每一帧要决定整张脸上每个像素的颜色,而音频只提供“当前发了什么音”这一条线索。
音素(phoneme)和视素(viseme)之间不是一一映射。汉语里“b/p/m”三个音素对应的口型几乎一样,都是双唇闭合;英语里“f/v”都表现为上齿咬下唇。反过来,同一个音素在不同上下文里口型也不同。这意味着模型不能只学“这一帧是什么音”,还要从上下文推断嘴应该张多大、圆唇还是扁唇。更麻烦的是协同发音(coarticulation):人说话时嘴型会提前为下一个音做准备,一个音的口型峰值往往出现在它的声学中心之前或之后。音频帧和视频帧之间因此存在几十毫秒的错位,强行逐帧对齐会让口型看起来“慢半拍”。
身份、姿态、表情三个变量纠缠在一起
如果只要求“嘴动起来”,最简单的做法是把嘴部区域替换成另一段视频的嘴。但观众立刻会发现脸不像本人、头在诡异地晃动、牙齿和下颌边缘穿帮。说话头模型必须同时满足:
- 身份保持:眼睛、鼻子、脸型、肤色、发型不能变,否则一眼假。
- 姿态与表情自然:说话时头会轻微点头、侧转、眨眼、挑眉。完全冻结头部会像面具。
- 时序一致:相邻帧之间不能闪烁、抖动,牙齿不能忽隐忽现。
- 口型准确:唇音同步误差要小到人眼察觉不到,通常要求音视频偏移在 80 毫秒以内。
这四个目标互相拉扯。让生成器自由发挥可以提高自然度,但身份会漂移;严格约束身份又会压制表情,让脸变僵。四条技术路线的差异,本质上就是把这四个约束分别放在哪个空间里解决。
同步误差的容忍阈值从哪里来
“听起来同步”和“看起来同步”不是同一件事。人耳对声音超前于画面比较敏感,对声音滞后于画面相对宽容,这种不对称来自视听整合的心理物理特性。ITU-R BT.1359 给出了一个常被引用的可察觉阈值:声音超前画面约 45 ms 时开始能被察觉,声音滞后画面约 125 ms 时开始能被察觉。超出这个区间,观众会明确感到“配音没对上”。
把这两个数字换算到视频帧上:25 fps 时一帧是 40 ms,30 fps 时一帧是 33 ms。也就是说,音频超前超过一帧左右就可能被察觉,滞后超过三到四帧才明显。这给模型设计定了两条约束:一是生成帧与音频的对齐精度至少要到半帧量级,二是训练与推理时的音视频偏移校正比“尽量精确”更重要——一个系统性偏移 60 ms 的模型,即使每一帧的嘴型都正确,观感依然会很差。
为什么不能直接套用文生视频模型
2024 年之后的视频扩散模型已经能生成逼真的人脸说话视频,但它们解决的是“从文本生成一个不存在的人”,而不是“让这张特定的脸说这段话”。直接拿文生视频模型做说话头有三个具体障碍:
- 身份无法精确控制。文本提示词只能描述“一个年轻女性”,不能锁定某一张脸。
- 口型与给定音频的同步没有机制保证。文生视频模型没有音频输入接口。
- 推理成本高。一段 10 秒、512×512、25 fps 的视频是 250 帧,扩散模型逐帧去噪的代价远超实时需求。
所以说话头系统通常不是“一个大模型端到端生成整段视频”,而是把任务拆成几个可控的子问题:音频特征提取、人脸表示、口型区域生成、身份与姿态保持、后处理拼接。下面四条路线就是对这些子问题的不同拆法。
共同前端:音频特征与视频表示
音频侧:从波形到每秒 50 帧的语义特征
几乎所有说话头模型都不直接吃原始波形。通用的前端是 mel 频谱:以 16 kHz 采样、25 ms 窗长、10 ms 帧移做短时傅里叶变换,再经过 80 个 mel 滤波器,得到每秒 100 帧、每帧 80 维的矩阵。Wav2Lip 用的是 80 维 mel,并把相邻帧堆叠成短窗输入生成器;SadTalker 的 ExpNet 也用 mel 作为输入。
mel 频谱保留了音色和音高信息,但冗余很大:决定口型的主要是共振峰(formant)和能量包络,说话人的音高、音色、录音设备都会混进来。于是后来的工作转向自监督语音特征,例如 wav2vec 2.0、HuBERT 或 Whisper 编码器的中间层。这些特征在大量语音上预训练过,对音素内容更敏感、对说话人更不敏感,跨身份泛化更好。代价是前端多了一个几百 MB 的编码器,推理链路变长。
这里有一个工程上的取舍值得说明:mel 前端是纯信号处理,CPU 上几乎零成本,而且帧率固定;自监督编码器需要 GPU,特征帧率取决于模型(HuBERT 是 20 ms 一帧,Whisper 是 10 ms 一帧再降采样)。如果目标是实时数字人,mel 加轻量卷积往往比大编码器更划算;如果目标是离线高质量渲染,自监督特征通常能换到更准的口型。
还有一个容易忽略的细节:mel 帧率(100 fps)通常高于视频帧率(25 或 30 fps),两者之间要做时间重采样。最简单的做法是按时间戳把每帧视频对应的 mel 帧取出来,堆叠成固定长度的窗口。窗口长度的选择有讲究:太短(比如只取 ±1 帧)看不到协同发音的上下文,嘴型会一顿一顿;太长(比如 ±25 帧)会把不相关的音素混进来,生成器难以决定当前该发哪个音。Wav2Lip 的生成器取的是与当前帧对齐的一小段 mel,而它的同步判别器 SyncNet 用连续 5 帧画面配对应音频片段,这个 5 帧(约 200 ms)的窗口是这类系统常用的经验尺度。
Whisper 的特征还有一个特殊之处:它的编码器输出是 50 Hz(10 ms 一帧、两次卷积各下采样一次后的结果),且感受野覆盖整段 30 秒音频。MuseTalk 直接把 Whisper 编码器的中间特征作为音频条件,这意味着每个输出帧看到的音频上下文远大于 mel 窗口,对长音素和连续语音的建模更稳。代价是音频编码器必须一次处理完整段音频,流式场景下要按块切分并处理块边界。
视频侧:四种人脸表示
同一张参考图,可以被表示成四种东西,对应四条路线:
| 表示 | 内容 | 谁在用 | 优点 | 代价 |
|---|---|---|---|---|
| 像素 | RGB 图像本身 | Wav2Lip | 无需 3D 模型,保真度高 | 身份与姿态耦合在像素里,难解耦 |
| 3DMM 系数 | 身份、表情、姿态的低维参数 | SadTalker | 可解释、可重定向、跨身份泛化 | 依赖 3D 重建质量,细节丢失 |
| 隐式关键点 | 学习到的 个二维关键点与局部变换 | LivePortrait、FOMM | 无需 3D 标注,运动解耦好 | 关键点语义不明确,难手工编辑 |
| 潜空间 latent | VAE 编码后的低分辨率特征图 | MuseTalk、EchoMimic | 扩散模型友好,计算量小 | 需要额外的 VAE 与解码器,细节靠后处理补 |
这张表是理解后面所有架构的索引。每条路线的生成器、损失函数和失败模式,都可以从它选择的人脸表示推出来。
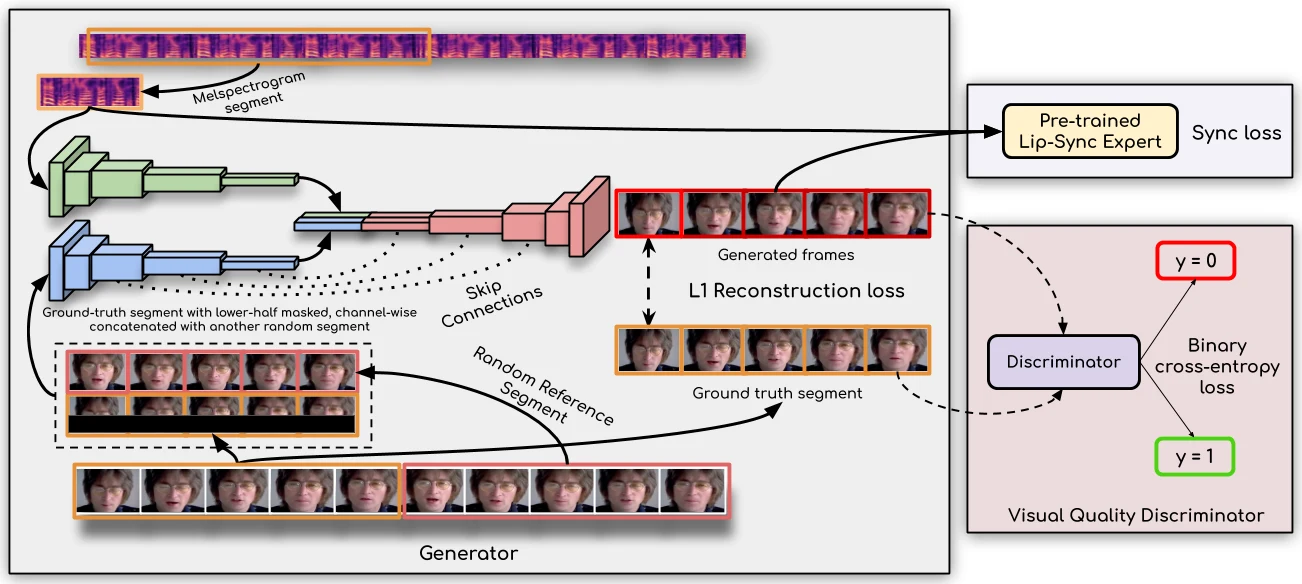
上图是 Wav2Lip 论文给出的整体架构。左侧是数据流:从一段视频里取参考帧,遮住下半张脸,与音频的 mel 片段一起送入生成器;上方是生成出的帧序列,与真实片段计算 L1 重建损失;下方是视觉质量判别器,用二分类交叉熵判断生成画面与真实画面。这张图里没有出现同步判别器——SyncNet 在论文中是单独一张图,承担的是另一项职责。这张架构图值得先记住,因为后面三条路线都能看作对其中某个模块的替换:换掉人脸表示、换掉生成器、换掉判别信号。
路线一:Wav2Lip 的像素级口型同步
核心思路
Wav2Lip 由印度 IIIT Hyderabad 与英国巴斯大学(University of Bath)的研究者合作完成,2020 年发表在 ACM Multimedia。此前基于 GAN 的口型同步工作(如 Li 等人的任意说话人生成、Chen 等人的像素级迁移)大多在训练集里出现过的人脸或静态图像上有效,一旦换成没见过的身份、视频里又有头部运动和大角度侧脸,口型就会明显脱节。它的目标非常窄:给定一段视频和一段音频,把视频里人物的嘴改成与音频同步,其他区域尽量不动。它不生成头部姿态,不换脸,也不做表情迁移。
做法是把问题化成条件图像修复:把参考帧的下半张脸(从鼻子以下到下巴)用灰色矩形遮住,让生成器根据“上半张脸 + 音频”把遮住的部分补出来。由于上半张脸保留了眼睛、鼻子和脸型,身份约束天然存在;由于只补嘴部,生成器不需要学习整张脸的结构,模型可以做得比较小。
生成器结构
生成器是一个 U-Net 风格的编码器-解码器。输入是 6 通道:前 3 通道是遮住下半脸的目标帧,后 3 通道是从同一段视频里另取的一帧参考帧,提供说话人的身份与姿态先验。音频侧把 mel 频谱按时间对齐后,经过若干层卷积与转置卷积,上采样到与图像特征图相同的空间尺寸,然后在 U-Net 的中间层与图像特征做通道拼接。
设音频特征为 ,图像特征为 。对齐的做法是把 在时间轴上插值到与目标帧数一致,再在空间轴上复制到 ,得到 ,然后拼接:
这个设计很朴素,但它暴露了一个本质问题:音频是全局的、一维的,图像是局部的、二维的。简单复制意味着每个空间位置都看到同一段音频,生成器必须自己学会“嘴部区域应该响应音频,眼睛区域不应该”。Wav2Lip 没有显式的位置先验,全靠数据学出来。这也是它在侧脸、遮挡、胡须等情况下容易出错的原因之一。
判别器:同步判别是关键
只有重建损失(L1)时,生成器会输出模糊的平均嘴型,因为 L1 倾向于把所有可能的嘴型平均掉。Wav2Lip 的解决办法不是普通的图像 GAN 判别器,而是引入一个唇音同步判别器(SyncNet)。
SyncNet 的结构是双流:视频流用 3D 卷积处理连续 5 帧嘴部区域,音频流用 1D 卷积处理对应的 mel 片段,两路各自池化成一个 512 维向量,然后计算余弦相似度。训练时构造正样本(真实同步的音视频对)和负样本(把音频偏移若干帧,或换成别人的音频),用二分类损失让同步对相似度高、错位对相似度低。
把 SyncNet 作为判别器接进 GAN 后,生成器的对抗损失变成:
其中 是生成的嘴部帧序列, 是对应音频,两个向量都做了 L2 归一化,点积即余弦相似度。这一项直接奖励“生成的画面与音频在 SyncNet 的表示空间里接近”,比像素级损失更贴近人眼对同步的感知。
完整的训练目标由三部分组成:
是生成区域与真实帧的 L1 损失, 是普通图像判别器的对抗损失, 控制权重。论文的经验是同步项权重不能太小,否则口型会糊;也不能太大,否则画质下降。
推理流程与工程细节
推理时,系统对目标视频逐帧处理:取当前帧,遮住下半脸,取音频中与当前帧时间对齐的 mel 窗口,送入生成器,得到一张完整的人脸裁剪图;再只取它的下半区,与目标帧的上半脸拼接。因为实际使用的只有下半区,拼接边界需要羽化(feathering)或泊松融合,否则鼻翼和脸颊会出现明显的接缝。
Wav2Lip 的一个重要工程优势是模型小、速度快:生成器只有几百万参数,在单张 V100 上处理速度可以超过实时。它因此被大量数字人产品当作“口型后处理”模块:先用别的模型生成头部运动,再用 Wav2Lip 修嘴。
但它的局限也很明确。第一,分辨率低,论文主要在 96×96 的人脸裁剪图上训练,高清场景需要额外的人脸修复网络。第二,它不生成姿态,头完全不动或只沿用原视频的运动,遇到大角度侧脸会崩。第三,它对参考帧的质量敏感,牙齿、胡须、手部遮挡都会让生成器产生伪影。第四,因为只改下半脸,表情变化被限制在嘴部,眼神和眉毛是死的。
路线二:SadTalker 的 3DMM 参数化中间表示
为什么要插入一个 3D 中间层
Wav2Lip 的问题可以概括为:像素空间里,身份、姿态、表情、口型全部耦合在一起,模型只能靠遮罩强行隔离。SadTalker 的思路是先把人脸拆成可控的低维参数,在参数空间里根据音频预测运动,再把参数渲染回图像。
SadTalker 由中国西安交通大学与腾讯 AI Lab 等团队完成,2023 年发表在 CVPR。它采用 3D 形变模型(3D Morphable Model,3DMM)作为中间表示。3DMM 用一个统计模型描述人脸:
其中 是三维人脸顶点坐标, 是平均脸, 是身份基, 是表情基, 和 是对应的系数向量。再加上一个姿态参数(旋转 、平移 、缩放 ),就能描述一张脸在某一帧的状态。常见的 3DMM 实现(如 Basel Face Model、FLAME)身份系数约 80 到 300 维,表情系数约 50 到 100 维。
的维度是顶点数乘 3(例如 35709 个顶点对应 107127 个数),而 加 只有一两百维。这个巨大的降维正是 3DMM 的价值所在:一张脸的全部几何变化被压缩到了几百个可解释的系数上,于是“让这张脸说这段话”的问题变成“预测一串几百维的系数”。系数之间的插值、缩放、迁移都有清晰的几何含义,而这些操作在像素空间里是不可控的。
这个表示的好处是把“这是谁”和“现在做什么表情”分开了: 只由参考图决定, 由音频决定,姿态由单独的模块预测。三者可以独立修改,也可以迁移到别人脸上。
三段式流程
SadTalker 的流程分三段:音频到系数、系数到三维渲染、渲染到真实图像。
第一段:ExpNet 预测表情系数。 输入是 mel 频谱片段,输出是每一帧的 3DMM 表情系数 。ExpNet 是一个一维卷积网络加全连接层,训练时用真实视频的 3DMM 拟合结果作为监督。这里有个鸡生蛋问题:训练需要“音频对应的真实表情系数”,而真实系数要靠 3DMM 拟合器从视频里逐帧估计。SadTalker 用现成的 3D 人脸重建工具(如 Deep3DFaceRecon)离线处理训练视频,得到带噪声的伪标签,再让 ExpNet 去拟合。噪声通过时间平滑和大量数据被平均掉。
第二段:PoseVAE 预测头部姿态。 完全由音频预测姿态是不可靠的,因为音频里没有“头往哪转”的信息。SadTalker 的做法是从参考图出发,预测一个相对于参考姿态的偏移序列,并且用参考图的姿态作为条件。具体实现是一个条件变分自编码器(conditional VAE):编码器把真实的姿态序列压成隐变量,解码器在“音频特征 + 参考姿态”的条件下重建它。训练完成后,推理时从先验分布采样一个隐变量再解码,得到一段有随机性的自然头部运动。
这里为什么用 VAE 而不是直接回归,值得说明。如果用一个确定性网络做 L1 回归,模型会输出所有可能姿态的均值;在说话场景里,这个均值就是“几乎不动”。观众看到的就是一张僵脸在念稿。VAE 保留了运动的多样性:同一段音频每次采样得到的点头、侧转幅度略有不同,但都符合训练数据里的运动分布。这个思路与语音合成里用 VAE 建模韵律停顿是同一种动机——回归会抹平变化,采样才能保留变化。
论文还引入了一个可选的“姿态风格迁移”:从一段驱动视频里提取姿态序列,迁移到目标人脸上。风格迁移的用途是让数字人模仿某个真人的说话习惯,比如有的人说话爱点头,有的人爱歪头。
第三段:三维感知渲染与 GAN 精修。 把预测出的 3DMM 系数和参考图的身份系数结合,得到每帧的三维人脸网格,用可微分渲染器渲染出粗糙的二维图像。这个渲染结果保留了正确的几何和遮挡关系,但纹理是平均脸纹理,不像真人。于是再接一个 GAN 精修网络(face renderer),把渲染图、参考图和遮挡掩码作为输入,生成最终图像。
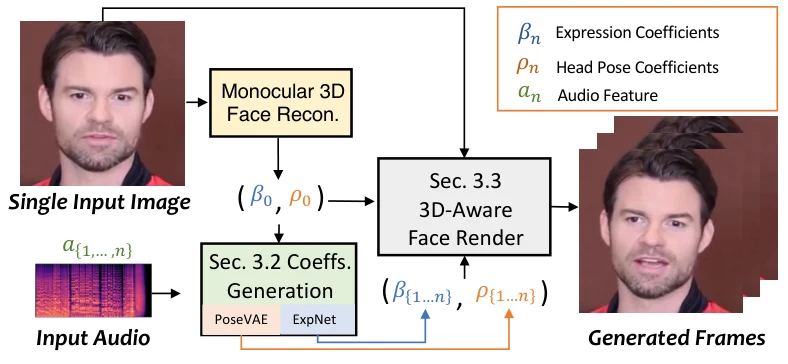
上图把三段流程画在了一起。可以看到音频只进入 ExpNet 和 PoseVAE 两个小网络,真正生成像素的是后面的渲染器与精修网络。这种“小网络预测参数、大网络负责渲染”的分工,是参数化路线的典型结构:可控性强,但渲染质量上限受限于 3DMM 的表达能力。
为什么 3DMM 路线更适合跨身份
Wav2Lip 训练时见过的人脸,其身份特征隐含在像素里,换一个没见过的脸,模型要靠上半脸的上下文临时适应。SadTalker 则显式地把身份系数从参考图里估计出来,表情系数由音频预测,两者在三维空间里组合。这意味着模型学到的是“表情如何改变人脸几何”,而不是“某张脸的嘴应该长什么样”,跨身份泛化更好。
代价是细节损失。3DMM 的表情基主要描述大尺度肌肉运动,对牙齿、舌头、口腔内部、法令纹的细微变化建模不足。渲染器必须靠 GAN 从参考图里“借”纹理,遇到参考图里没有的口腔状态(比如从未张嘴的照片),就只能生成一个平均的、模糊的口腔。这也是为什么 SadTalker 在张嘴幅度大、露牙多的句子上容易显得不自然。
训练损失
SadTalker 的训练分阶段:ExpNet 用系数 L1 与渲染图感知损失训练,PoseVAE 用条件 VAE 的重建目标训练,渲染与精修网络最后单独训练。精修网络的目标包括:
是 VGG 特征空间的感知损失,保证纹理自然; 提升清晰度; 用身份编码器约束生成脸与参考脸相似; 仍然是唇音同步项,通常用预训练的 SyncNet 特征距离而不是对抗形式。
ExpNet 的训练也有自己的损失设计。论文强调它同时蒸馏两种监督:一种是 3DMM 系数本身的 L1 损失,另一种是“由系数渲染出的三维人脸图”与真实渲染图之间的感知损失。后一项看起来绕,作用是让 ExpNet 学到的系数不仅在数值上接近,而且在视觉意义上准确——两个系数向量数值差得远,渲染出来可能几乎一样;反之亦然。用渲染结果做监督,等于把监督信号搬到了与最终观感一致的表示上。
整个系统还有一个隐性的对齐问题:3DMM 拟合器估计的表情系数本身带噪声,不同帧的拟合误差不一致,如果直接拿来做监督,ExpNet 会学到拟合器的抖动而不是真实表情。常见做法是对系数序列做时间平滑,或者只对拟合置信度高的帧计算损失,在训练与推理之间保持一个稳定的“伪标注”分布。
路线三:LivePortrait 的隐式关键点与重演
从 3DMM 到隐式关键点
3DMM 需要三维重建,流程重、依赖拟合器,而且表情基是固定的,表达范围受统计模型限制。另一条路线放弃显式三维结构,改用隐式关键点:让网络自己学出一组二维关键点,以及每个关键点周围的局部仿射变换,用这些变换把参考图“扭曲”成目标表情。
这类方法的代表是第一阶运动模型(First Order Motion Model,FOMM)和后来的 Face-vid2vid。LivePortrait 是快手团队 2024 年发布的系统,它把这条路线工程化到了很高完成度,支持视频驱动、图像驱动、风格化人脸,还能做表情迁移与眼睛、嘴巴的精细重定向。
外观特征体与形变场
LivePortrait 的第一阶段是外观与运动解耦。编码器把参考图编码成一个外观特征体(appearance feature volume),同时一个运动编码器从驱动图(或从音频预测的关键点)得到一组隐式关键点 和局部变换 。解码器对每个关键点做局部仿射变换,再把变换后的特征加权融合:
其中 是第 个关键点在位置 的融合权重,由关键点位置的高斯核或学习到的注意力给出。这个公式的含义是:每个关键点负责脸上一小块区域,先按自己的变换把那块区域搬过来,再平滑拼接。 通常取 10 到 20 个关键点,覆盖嘴角、眼角、眉毛、鼻翼等运动区域。
局部变换 的来源值得展开。第一阶运动模型(FOMM)把“从驱动图到源图的运动场”在每个关键点附近做一阶泰勒展开:
其中 是第 个关键点在驱动图上的位置, 是该点的位移, 是运动场在该点的雅可比矩阵。一阶展开的含义是:在小邻域内,任何平滑运动都可以近似成“平移 + 线性形变”,而这个线性形变恰好能表达缩放、旋转、剪切,足以描述嘴角上扬、眼皮闭合这类局部动作。
把所有关键点的局部近似加权组合,就得到完整的运动场:
权重 通常取高斯核 并在 上归一化。靠近某个关键点时,该关键点的局部变换占主导;远离所有关键点时,权重趋于均匀,形变退化为各关键点位移的加权平均。这个性质也解释了为什么背景区域有时会跟着轻微移动——它没有自己的关键点,只能跟着平均运动走。这个结构的好处是:网络只需要预测 个关键点的位置与 的雅可比矩阵,总共约 个标量,而不是一整张稠密光流。对 来说,运动表示只有 60 个数,模型很小,推理很快。
这个“一阶近似”也解释了一类典型失败:当驱动运动在关键点邻域内不再是平滑的线性变化时——比如大笑到嘴角裂到脸颊、眼皮快速颤动、下巴大幅张开——局部线性近似就撑不住。LivePortrait 用更大规模的训练数据、更精细的形变目标以及额外的小模块来缓解这一类问题,但结构上仍受“局部线性”和“关键点稀疏”的约束。
第一阶段管线总览
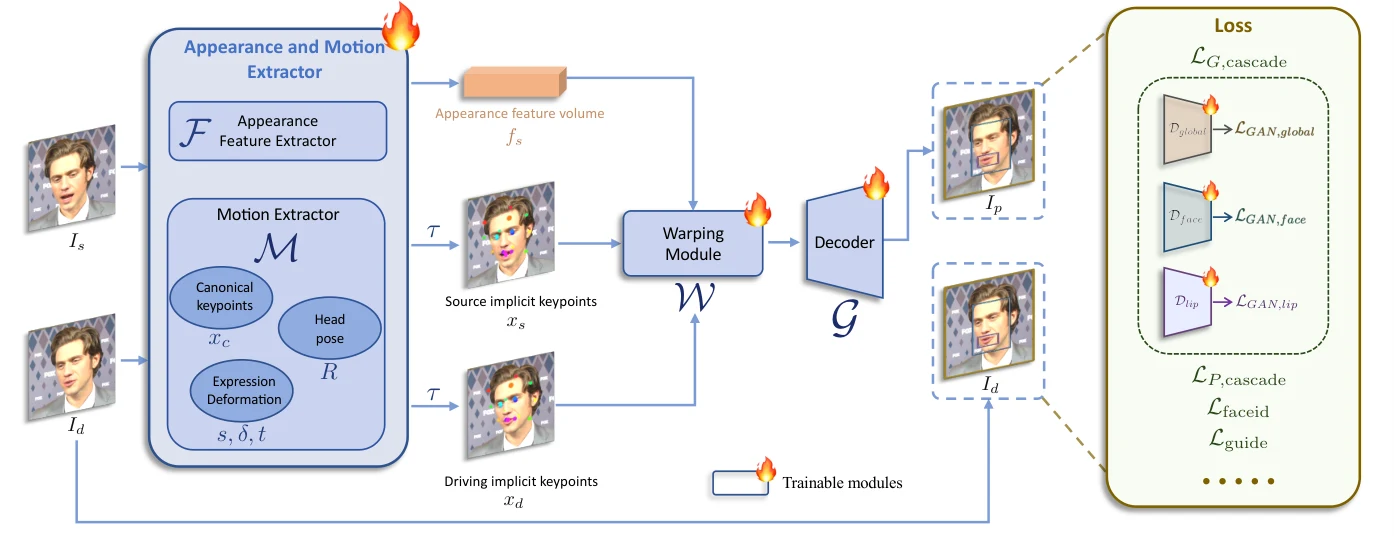
上图是 LivePortrait 第一阶段的管线:外观与运动提取器。左边源图(source)经外观提取器得到外观特征体,同时经运动提取器得到源隐式关键点;右边驱动图(driving)经运动提取器得到驱动隐式关键点;中间用两组关键点计算隐式形变,作用到外观特征体上,再解码出重演结果。图下方标注了各类损失:外观损失、关键点级联损失、形变与关键点引导损失以及蒸馏损失。注意它没有三维网格,也没有显式表情系数,运动完全由关键点位置与隐式形变承载。
拼接与重定向模块
LivePortrait 相比早期隐式关键点方法的改进主要有两点。第一是缝合模块(stitching module):隐式关键点方法在脸与非脸区域(头发、脖子、背景)的边界容易产生撕裂,LivePortrait 训练一个小网络,把重演区域与参考图的非重演区域做条件融合,消除接缝。第二是重定向模块(retargeting module):把驱动视频里的眼睛闭合、嘴角上扬等运动,按目标人的解剖结构做缩放与偏移,避免“小眼睛的人被驱动成大眼睛”时比例失真。
这两个模块看起来是工程细节,实际决定了产品可用性。数字人场景里,驱动视频和目标人往往不是同一个人,直接搬运关键点位移会让表情幅度严重失配。
音频驱动怎么接进来
LivePortrait 本身是图像/视频驱动的重演系统,不直接吃音频。要把它变成说话头,需要外挂一个音频到关键点的预测器:用一段配对数据训练一个模型,从 mel 或 HuBERT 特征回归出每帧的关键点位移,尤其是嘴部关键点。这类组合在开源社区很常见:音频预测嘴部运动,LivePortrait 负责把它渲染成逼真的人脸。
这种“音频→运动参数→重演”的分层结构有一个明显好处:运动参数可以被手工编辑、被其他信号覆盖(比如同时驱动表情和头部姿态),也方便做实时优化,因为重演网络本身是前馈的,不需要扩散采样。
路线四:潜空间扩散——MuseTalk 与 EchoMimic
把口型生成放进 latent 里做修复
扩散模型进入说话头领域后,主流做法不是直接生成整段视频,而是把 Wav2Lip 的“遮罩修复”搬到潜空间。MuseTalk 是腾讯音乐 2024 年发布的实时视频配音工作,它的核心是一个在冻结的 VAE 潜空间里做口型修复的扩散模型。
流程是:参考帧经 VAE 编码得到 latent ,把嘴部区域的 latent 遮掉,音频特征经编码后作为条件,扩散模型在遮罩区域去噪,最后 VAE 解码回像素。因为只在嘴部 latent 上做扩散,计算量远小于生成整帧,可以做到实时(论文报告在 V100 上 30 fps 以上)。
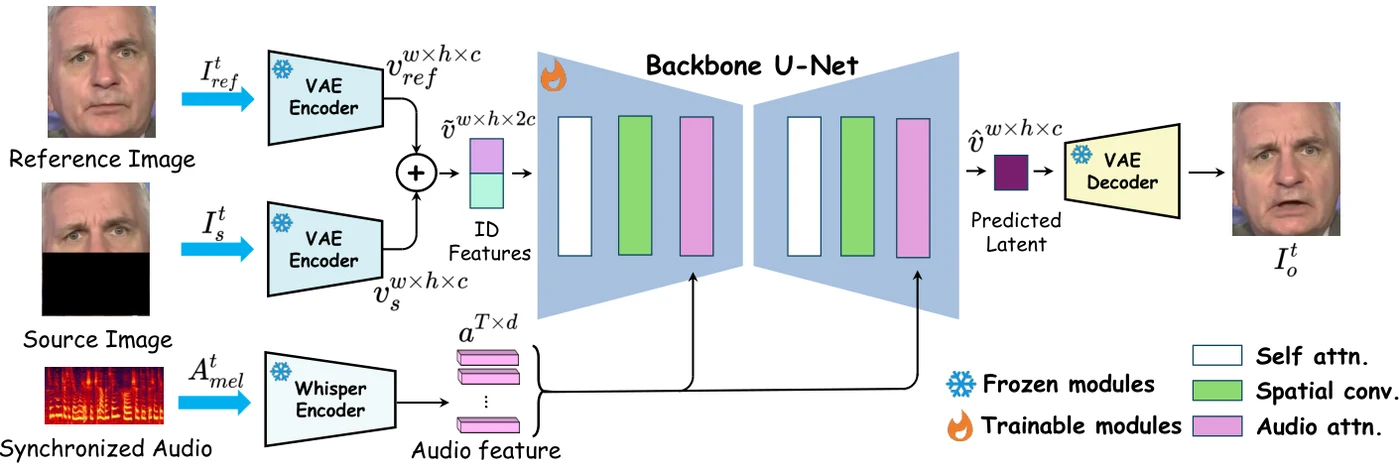
上图是 MuseTalk 论文给出的网络结构。左侧是参考图与源图,经冻结的 VAE 编码成 latent ;音频先取 mel,再经 Whisper 编码器得到特征序列;中间是冻结骨干 U-Net,内部同时有空间卷积、自注意力与音频注意力(audio attn.),把音频特征注入图像 latent;右侧输出预测的 latent,再由 VAE 解码回像素。图中把模块分成冻结与可训练两组:VAE 与 U-Net 骨干冻结,只训练与音频融合相关的部分,这让模型能在较小的配对数据上微调,而不破坏基础生成能力。
MuseTalk 论文里的两阶段指的是训练阶段,不是推理阶段:第一阶段做面部抽象预训练(Facial Abstract Pretraining),用“信息帧采样”把参考图与源图的姿态对齐,减少冗余特征干扰;第二阶段做唇音同步对抗微调(Lip-Sync Adversarial Finetuning),用“动态边距采样”在空间上挑出最能推动嘴部运动的区域,在同步精度与牙齿细节之间取得平衡。
两阶段分开的原因是目标不同:预训练先建立“身份 + 姿态 + 音频”到嘴部内容的稳定映射,对抗微调再集中优化唇音同步与牙齿细节。若把两类目标混在一起训练,判别器的梯度会干扰身份与姿态的表征学习,嘴部容易在“清晰”和“同步”之间来回摆动。
条件注入方式
扩散网络里音频条件的注入有两种常见结构:
- cross-attention:把音频特征序列作为 key/value,图像 latent 作为 query,让每个空间位置自己选择关注哪段音频。这种方式灵活,但注意力图不一定对齐到嘴部。
- 音频注意力(audio attention)与空间对齐:把音频特征按帧投影到与 latent 相同的空间网格,再做逐位置的注意力或拼接。MuseTalk 的图里展示的正是这种“空间卷积 + 自注意力 + 音频注意力”的组合,音频特征通过注意力而不是简单广播进入每一层。
EchoMimic:半身与姿态的扩散
EchoMimic 是蚂蚁集团 2024 年发布的工作,目标是音频驱动半身人像,不只是嘴部。它把条件分成两类:音频条件和视觉条件(参考图、面部关键点)。生成器是一个视频扩散模型,音频经音频编码器后通过音频注意力注入,面部关键点经关键点编码器后作为视觉条件参与去噪。训练时用“音频+关键点”和“仅音频”两种条件交替,推理时可以只用音频,也可以叠加关键点做更精确的控制。
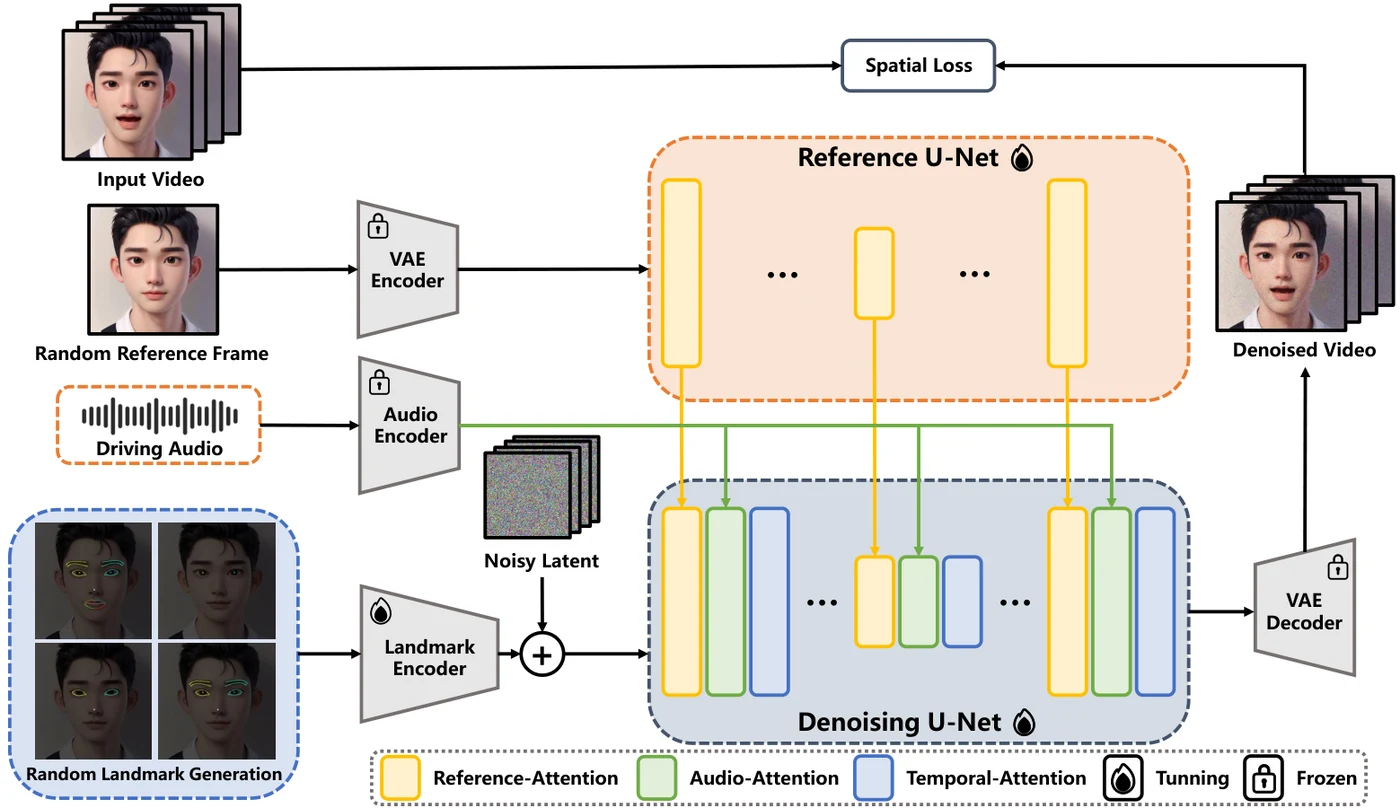
上图是 EchoMimic 论文给出的整体管线。参考帧经 VAE 编码后与噪声 latent 一起进入去噪 U-Net;音频编码器提供内容条件,关键点编码器提供姿态条件。去噪 U-Net 沿用 Stable Diffusion 1.5 的骨干,但在每个 Transformer 块里放了三种注意力:Reference-Attention 建模当前帧与参考图的关系,Audio-Attention 在空间维度上对齐视觉与音频,Temporal-Attention 做时间维的自注意力以维持帧间一致。训练时关键点可以是随机生成的、也可以来自真实视频,让模型既学会“只凭音频生成”,也学会“按给定关键点精确控制”。
这条路线代表了说话头的另一个方向:从“修嘴”走向“生成整个人的上半身”,包括手势、肩部、头部姿态。代价是身份保持更难,模型更大,实时性更差。EchoMimic 的公开实现需要多步扩散,通常做不到 MuseTalk 那样的实时帧率。
EchoMimic 对关键点条件的处理值得单独说明。真实场景里,用户给出的关键点常常只有部分区域——可能只标了嘴,没标眼睛;也可能某几帧检测失败。论文提出随机关键点选择(Random Landmark Selection,RLS):把人脸拆成眉毛、眼睛、瞳孔、鼻子、嘴几个部分,训练时随机丢掉其中一个或几个部分,强迫模型学会用不完整的关键点生成完整人脸。这个做法的作用类似 dropout,但丢的是输入模态的一部分,让同一个网络既能处理“全关键点”,也能处理“只有嘴部关键点”或“完全没有关键点、只靠音频”的情况。
训练信号:怎么让嘴型和声音对上
四条路线的生成器不同,但让口型同步的训练信号高度相似,可以归纳成四类损失。
重建损失
像素级 L1 或 L2 损失,约束生成区域与真实帧接近。它提供稳定的梯度,但单独使用会得到模糊结果,因为模型倾向于输出条件分布的中位数。
感知与对抗损失
感知损失在 VGG 或 CLIP 特征空间比较生成图与真实图,对抗损失用判别器逼出高频细节。这两项决定“看起来像不像真人”,但对同步几乎没有贡献。
同步损失
这是说话头特有的项。三种实现方式:
- SyncNet 特征距离:把生成的嘴部帧序列与音频送进预训练 SyncNet,最大化余弦相似度,或最小化与真实对的差距。
- SyncNet 对抗:把 SyncNet 当判别器,让生成结果在同步表示空间里骗过它。
- 音素级监督:如果有音素对齐标注,可以直接监督每个音素对应的嘴部关键点位置。标注成本高,公开数据少,实际使用不多。
身份与时间一致性损失
身份损失用 FaceNet、ArcFace 或 CLIP 图像编码器约束生成帧与参考图的嵌入距离。时间一致性损失比较相邻帧的光流或特征差,抑制闪烁。有些工作还会加嘴部区域的光流监督,强制嘴部运动连续。
一个容易被忽略的细节是数据配对的偏移。训练数据里音频和视频往往不是严格同步录制的,存在几十毫秒的偏移。如果直接按文件时间戳对齐,SyncNet 学到的“同步”本身就是错的。工程做法是在训练前用 SyncNet 或互相关估计每段数据的偏移,做全局校正;有的工作还会在训练时随机抖动几帧,让模型对小幅错位鲁棒。
训练数据:配对、规模与噪声
说话头训练需要“音频 + 同一段人脸视频”的配对数据。公开数据集各有侧重:LRS2、LRS3 来自 BBC 新闻与 TED 演讲,音质干净、说话人数量有限、人脸姿态偏正面;VoxCeleb2 是从访谈类视频里自动爬取的大规模数据,说话人多、口音杂,但画质与对齐质量参差不齐;HDTF、CelebV-HQ 侧重高清人脸与多样风格,适合训练高分辨率模型。
这些数据的共同问题是“非专业演播室录制”:光照变化、手势遮挡、镜头切换、压缩噪声都存在。模型如果只在干净数据上训练,遇到真实用户上传的手机视频就会明显退化。所以工程上的常见做法是做强数据增广:随机裁剪、色彩抖动、模糊、压缩伪影、随机遮挡下半脸、加入背景噪声与混响。增广的目的不是提高上限,而是把训练分布覆盖到真实输入的退化范围内。
规模也很重要。LivePortrait 的论文提到训练数据扩大到约 6900 万帧高质量画面,并采用图像与视频混合训练;这个量级比早期隐式关键点方法大了两个数量级,直接换来了跨身份与跨风格泛化能力的提升。对扩散路线,配对数据还要额外经过 VAE 编码,数据管线的吞吐往往是训练瓶颈之一。
推理链路与工程账
各路线的一次请求都算什么
一个生产系统的完整链路通常比论文里的模型多出好几步。以“上传一张照片 + 一段音频,输出数字人视频”为例,实际要经过:
- 音频预处理:解码、重采样到 16 kHz、去噪、按静音切句。切句很重要,长句中间的长停顿会让模型生成静止的口型。
- 人脸检测与对齐:用 RetinaFace 或 SCRFD 找到人脸框和五点关键点,按姿态做仿射对齐,裁出固定尺寸的人脸区域。
- 身份与运动提取:如果是 3DMM 路线,跑一次三维重建得到身份系数;如果是关键点路线,提取参考图的关键点与外观特征体。
- 驱动信号生成:音频经前端得到特征,再由 ExpNet、音频到关键点网络或扩散条件编码器变成逐帧的运动参数。
- 逐帧生成或分段扩散:渲染、形变或去噪,输出人脸区域。
- 融合回原图:按蒙版把生成区域贴回,羽化边界,必要时做色彩匹配。
- 后处理:人脸上采样、锐化、去闪烁,编码成 H.264/H.265。
- 音视频封装:把音频与视频按时间轴对齐,处理帧率转换与容器封装。
这条链路里最容易被低估的是第 2 步与第 6 步。人脸检测与对齐决定了生成区域与参考图的几何一致性,一旦对齐框抖动,输出就会“脸在框里漂”。融合决定接缝,尤其是在头发遮挡脸侧、手挡嘴、戴眼镜的场景。很多公开 demo 看起来很好,是因为输入是正面、无遮挡、光照均匀的高清照片;产品里真实输入往往不是这样。
把四条路线放在同一张账本上比较,可以看出它们适合的场景完全不同。
| 路线 | 每帧计算 | 主要开销 | 典型帧率 | 分辨率 | 身份保持 |
|---|---|---|---|---|---|
| Wav2Lip | 一次 U-Net 前向 | 卷积,与音频长度无关 | 实时以上 | 96×96 人脸裁剪 | 中,靠上半脸上下文 |
| SadTalker | 系数回归 + 渲染 + GAN | 3D 感知渲染 + GAN 精修 | 低于实时(数 fps) | 256×256 | 高,显式身份系数 |
| LivePortrait | 编码 + 形变 + 解码 | 特征体形变 | 实时以上 | 512×512 | 高,参考图特征体 |
| MuseTalk | VAE 编码 + 少步扩散 + 解码 | 扩散采样 | 实时附近 | 256×256 | 高,latent 修复 |
| EchoMimic | 多步视频扩散 | 时空注意力 | 离线 | 512×512 | 中高,需参考条件 |
这张表里的帧率是各论文在 V100/A100 级 GPU 上报告的量级,实际产品还要算上人脸检测、对齐、音频前端、后处理与网络传输。一个常见的误区是只看生成器帧率:人脸检测与关键点提取在 CPU 上可能就要几毫秒一帧,音频前端与重采样也有开销,端到端延迟往往是生成器耗时的两到三倍。
流式与分段
说话头产品通常要求“边说边出画面”,这就需要流式推理。流式的难点不在单帧生成,而在上下文:口型依赖前后音素,视频帧之间需要时间一致性。Wav2Lip 和 MuseTalk 这类逐帧模型可以通过滑动窗口解决:每次取当前帧前后各若干帧音频,生成当前帧,窗口向前滑动。窗口太短会丢失协同发音上下文,太长则增加延迟。
SadTalker 和 EchoMimic 这类需要全局姿态或视频扩散的模型,流式化更困难。常见折中是分段生成:每 2 到 4 秒为一段,段内做完整生成,段间做重叠融合。段边界容易出现姿态跳变,需要用运动插值或重叠帧平滑。
显存与批处理
扩散路线的显存开销主要来自 VAE 解码与注意力。256×256、16 帧的 latent 视频扩散,在 fp16 下大约需要 8 到 12 GB 显存;如果加到 512×512、32 帧,很容易超过 24 GB。工程上常用三种手段:把 VAE 解码分块、用少步蒸馏模型(4 步或 8 步)、把时间维度的注意力限制在局部窗口。这些手段与视频扩散的通用优化相同,站内 扩散模型从零讲起(五):视频扩散 有更细的时空注意力与 3D VAE 讨论。
评测:同步、画质与身份怎么量
唇音同步
最常用的指标是 LSE-C 与 LSE-D(Lip Sync Error - Confidence / Distance),由 SyncNet 计算。LSE-D 是生成视频与音频在 SyncNet 表示空间里的平均距离,越低越好;LSE-C 是同步置信度,越高越好。这两个指标的问题是对嘴部遮挡、侧脸、低分辨率不敏感,数值好看不代表观感自然。
更严格的评测会用人工标注:让标注者判断音视频是否同步,统计可察觉偏移的分布。人眼对“音频超前于口型”和“口型超前于音频”的敏感度不对称,前者更容易被察觉。
画质与身份
画质用 FID、FVD 衡量生成帧与真实帧的分布距离,或用 LPIPS 衡量感知差异。身份保持用 FaceNet/ArcFace 嵌入的余弦相似度,比较生成帧与参考图。这些指标同样有边界:FID 对少量帧的估计方差很大,身份相似度高也不代表表情自然。
时序稳定性
一个常被忽略的指标是帧间抖动。可以用光流的一致性、嘴部关键点的轨迹平滑度,或简单地看相邻帧差分的方差。产品里更直接的做法是让真人看一段连续视频,抖动在静止片段里最明显。
局限、风险与边界
技术局限
四条路线各有硬边界。像素路线受限于分辨率与姿态;3DMM 路线受限于表情基的表达能力与三维重建质量;隐式关键点路线在极端表情、遮挡、非正面人脸时容易撕裂;扩散路线画质好但慢,且可能在嘴部生成“合理但不对”的内容——比如音频是“o”,生成了一个看起来自然但口型偏“e”的嘴。
牙齿与口腔内部是所有路线的共同弱点。训练数据里张嘴露牙的帧比例低,模型见到的口腔状态有限;3DMM 不建模牙齿,像素与 latent 路线则容易把牙齿生成成一片白色。
滥用风险
说话头是 deepfake 的核心组件之一。一个人脸照片加一段任意音频,就能合成名人说任意话的视频。工业界的应对包括:生成内容加水印与元数据、平台侧检测、法律与授权流程。技术文章不展开合规细节,但需要明确:这类模型的默认能力就是“让不在场的人说没说过的话”,产品设计必须把授权与标识当作一等公民。
小结
音频驱动说话头可以按“人脸表示”分成四条基础路线:
- Wav2Lip 在像素空间做遮罩修复,用 SyncNet 判别器保证唇音同步,简单、快、适合做口型后处理,但姿态与表情能力弱。
- SadTalker 用 3DMM 把身份、表情、姿态拆成低维参数,在参数空间里由音频预测运动,跨身份泛化好、可控性强,但细节受表情基限制。
- LivePortrait 用隐式关键点与局部仿射变换做重演,配合缝合与重定向模块,画质与实时性都好,音频需要外挂预测器接进来。
- MuseTalk 与 EchoMimic 把口型生成搬进潜空间扩散,前者做嘴部 latent 修复以求实时,后者做半身视频生成以求表现力,共同代价是采样成本与身份控制难度。
四条路线不是替代关系,而是产品里可以组合的模块:用参数化或关键点模型生成头部运动,用扩散模型提升画质,用像素级同步模块修嘴。理解每种表示的能力边界,比记住某个模型的榜单分数更有用。
参考资料
- Wav2Lip: A Lip Sync Expert Is All You Need for Speech to Lip Generation In the Wild
- SadTalker: Learning Realistic 3D Motion Coefficients for Stylized Audio-Driven Single Image Talking Face Animation
- LivePortrait: Efficient Portrait Animation with Stitching and Retargeting Control
- MuseTalk: Real-Time High-Fidelity Video Dubbing via Spatio-Temporal Sampling
- EchoMimic: Lifelike Audio-Driven Portrait Animations through Editable Landmark Conditions
- First Order Motion Model for Image Animation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



