


DeepInfer 源码拆解(二十六):多 token 的账本——变长验证的扁平行布局与 RequestOutput 对象池
到目前为止,这个系列已经沿着 DeepInfer 的装配线走过了调度、KV、EPLB、投机解码、CUDA Graph 和上下文并行。前面这些篇章有一个共同的叙述方式:站在模块边界上,看数据如何从上一层交给下一层。调度器交出一份计划,Worker 把它变成一次 GPU 前向,模型层交出 logits,采样层交出 token——每一层都像一个独立的车间。
但真正上过线的推理系统里,最难的往往不是车间里的算法,而是车间之间的交接单。尤其是开启投机解码之后,一次 decode step 交出来的不再是一条请求一个 token,而是「若干条请求、每条不定长的一串 token」。这串 token 里有草稿、有被接受的草稿、有被拒绝后补采的修正 token,也有请求恰好在本步结束、后面的 token 不该再计入输出的情况。它们最终要被拆成一条条可流式返回的 RequestOutput,而且每一条只包含属于对应的那一个请求的 token。
本文就盯住这张交接单。它由三段代码共同完成:
- Python 侧
deepinfer/model_executor/layers/sampler.py与tilelang_ops/sampler.py:把变长验证行压平成[total_q],生成first_token_positions、接受前缀与每条请求的最终行; - C++ 侧
csrc/engine/scheduler.hpp::process_outputs:把接受的前缀追加回Sequence,决定本步每条请求究竟「落地」了几个 token; - C++ 侧
csrc/engine/outputs.hpp::build_request_outputs:把落地结果打包成RequestOutput,并从固定的对象池里取内存。
这三段之间有两套完全不同的「索引语言」:前一段用「扁平行号」,后一段用「请求下标」。理解它们如何互相换算、哪些字段是借用视图、哪些哨兵值是协议的一部分,比理解某一个 kernel 的循环更能解释清楚:为什么 DeepInfer 能在不引入每 token Python 对象的前提下,把投机解码的收益稳定地送到用户手里。
先定位:一次 decode step 里,输出到底经过了哪些手
把镜头拉远一点。DeepInfer 的一步 decode 在开启 MTP(Multi-Token Prediction,多 token 预测)之后,大致是下面这条链路:
Scheduler.schedule() ├─ 选批、分配 KV 块与状态槽 ├─ 为每条请求算出本步要验证的草稿数 seqlens_q[i] = 1 + draft_i └─ 产出 SchedulerOutputs(borrowed view) │ ▼GPU:主模型前向 + 采样/验证融合内核 ├─ logits 形状 [total_q, vocab_size],total_q = Σ seqlens_q[i] ├─ 每行属于哪条请求、是草稿行还是最终行,由 first_token_positions 决定 └─ 输出 SampledInfo:token_ids[req_cnt]、verified_token_ids[total_q](-1 为哨兵) │ ▼scheduler.process_outputs() ← C++,提交本步账本 ├─ 对每条请求:把「接受前缀 + 主 token」追加到 Sequence ├─ 遇到停止条件就停,记下本步实际追加了几个 token └─ pushed_tokens_before_finish[req_cnt] │ ▼build_request_outputs() ← C++,构造用户可见对象 ├─ 每条请求可能产出 1~nextn 个 RequestOutput ├─ 只有最后一个输出带 finish_reason └─ RequestOutputPool:固定 10000 槽的对象池 │ ▼Python:entrypoint 克隆、解码、流式返回这张链路图里最容易被忽略的是中间那一步的「压平」。在普通自回归解码里,seqlen_q 恒等于 1,total_q == req_cnt,行号与请求号一一对应,很多实现干脆不区分这两个概念。一旦开启变长验证,这个等式就被打破了:一条请求可能占 1 行(没有草稿或全部被拒后只验证主 token),也可能占 2 到 6 行(验证 1 到 5 个草稿加一个主 token)。于是「第 37 行 logits 属于谁」变成一个必须显式回答的问题。
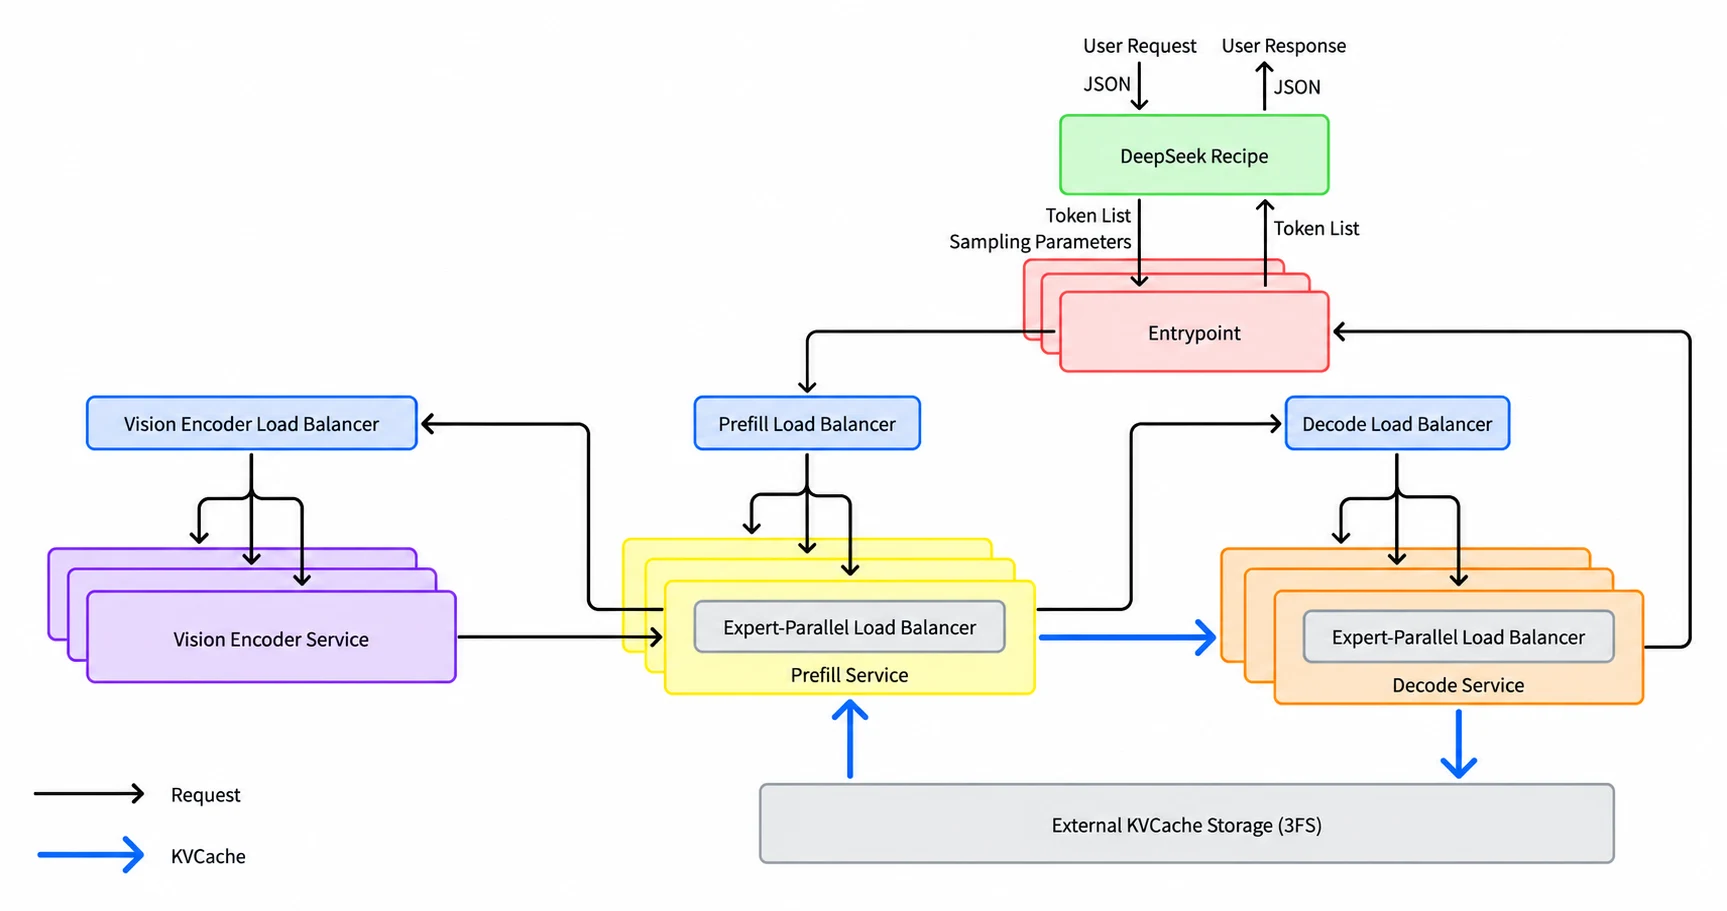
(图源:DeepSeek V4.1 Flash 推理部署 Q&A,见 DeepInfer 仓库 doc/images/architecture_overview.png)
图中 Decode 实例内部那条投机解码支路,就是本篇要拆的部分。需要先说明一个边界:本篇不重复讲 DSpark 的置信度调度与拒绝采样数学,那部分已经在投机解码一篇里拆过;本篇只讨论「一旦验证长度可变,系统如何把结果算清楚、记清楚、发出去」。
一行 logits 属于谁:三张索引表与一个哨兵
为什么需要 first_token_positions
先看一个具体例子。假设本步调度了三条请求:
- 请求 A:调度器决定验证 3 个草稿,另有 1 个主 token 行,共
seqlen_q = 4; - 请求 B:验证 1 个草稿,共 2 行;
- 请求 C:没有可用草稿,只验证主 token,共 1 行。
那么 total_q = 4 + 2 + 1 = 7,logits 是一个 [7, vocab_size] 的张量。GPU 内核只认识行号 0 到 6,它不知道什么叫「请求 A」。要把行号翻译成请求语义,DeepInfer 使用三张长度都为 total_q 的表,外加一张长度 req_cnt 的偏移表:
def prepare_verification_metadata_ref(ftp, seqlen_q, total_q): row_to_req = torch.repeat_interleave( torch.arange(ftp.shape[0], dtype=ftp.dtype, device=ftp.device), seqlen_q, output_size=total_q, ) local_step = torch.arange(total_q, dtype=ftp.dtype, device=ftp.device) - ftp[row_to_req.long()] is_verify = local_step != seqlen_q[row_to_req.long()] - 1 return row_to_req, local_step, is_verify这五行代码值得逐行解释,因为后面所有账本都建立在它们之上:
ftp(first token positions) 是每条请求的第一行在扁平张量里的偏移。对上面的例子,ftp = [0, 4, 6]。它满足两个约束:ftp[0] == 0;ftp[i+1] == ftp[i] + seqlen_q[i]。换句话说,ftp 就是 seqlen_q 的前缀和(exclusive prefix sum)。源码在测试里正是用 ftp[1:] = seqlen_q.cumsum(0)[:-1] 构造它。
row_to_req 把每个行号映射回请求号。repeat_interleave 的语义是「把第 i 个元素重复 seqlen_q[i] 次」,所以 row_to_req[0..3] = 0、row_to_req[4..5] = 1、row_to_req[6] = 2。这就是行号到请求号的换算表。
local_step 是行在它所属请求内部的偏移:请求 A 的 4 行是 0、1、2、3,请求 B 的 2 行是 0、1,请求 C 是 0。它由「全局行号减去该请求的 ftp」得到。
is_verify 标记这一行是不是「验证行」。每个请求的最后一行是主 token 行(local_step == seqlen_q - 1),其余行都是草稿验证行。因此 is_verify = local_step != seqlen_q - 1。这个布尔量在下游至少有两个用途:融合采样内核据此决定这一行是做拒绝采样的验证,还是做一次普通采样;最终打包时据此把「被接受的草稿」和「主 token」分开统计。
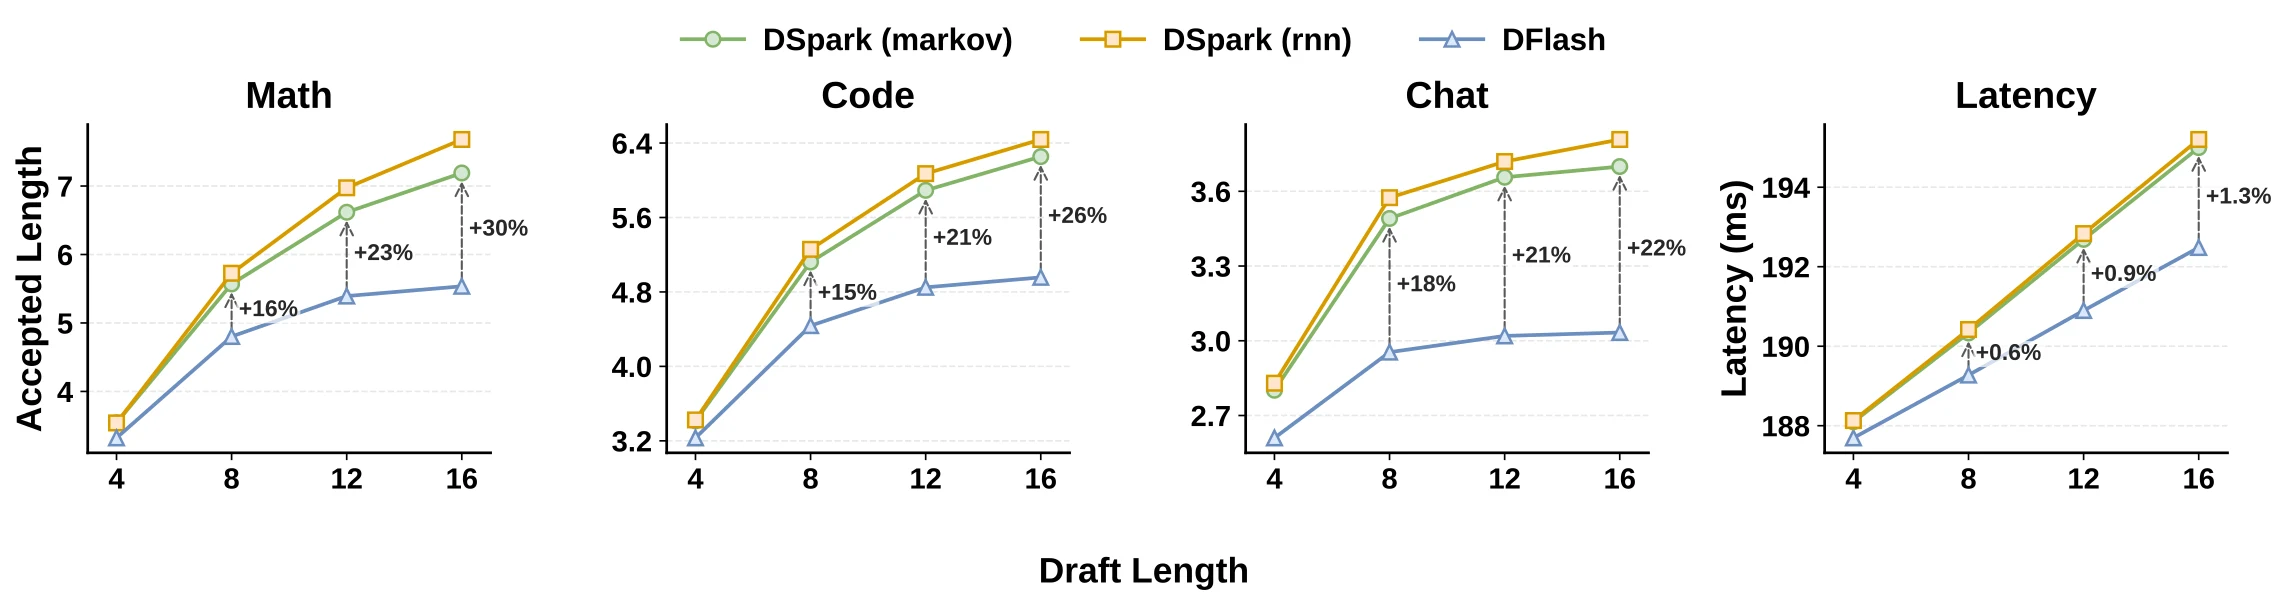
(图源:DSpark 图 4,Qwen3-4B 目标模型;左三栏分别为 Math、Code、Chat 三个领域,右栏为顺序头的额外延迟)
这张图解释了一个前提:草稿块可以很长,但真正进入验证的前缀长度由调度器逐请求决定。DSpark 的硬件感知前缀调度器会根据置信度与当前吞吐曲线,把每条请求的验证长度压到不同的值;落到引擎里,就是 seqlens_q[i] 在 batch 内取 1、2、…、nextn+1 等不同值。如果没有一张按行组织的索引表,GPU 内核和后面的 C++ 收账都无从知道「第几行是谁的」。
一张图看清扁平布局
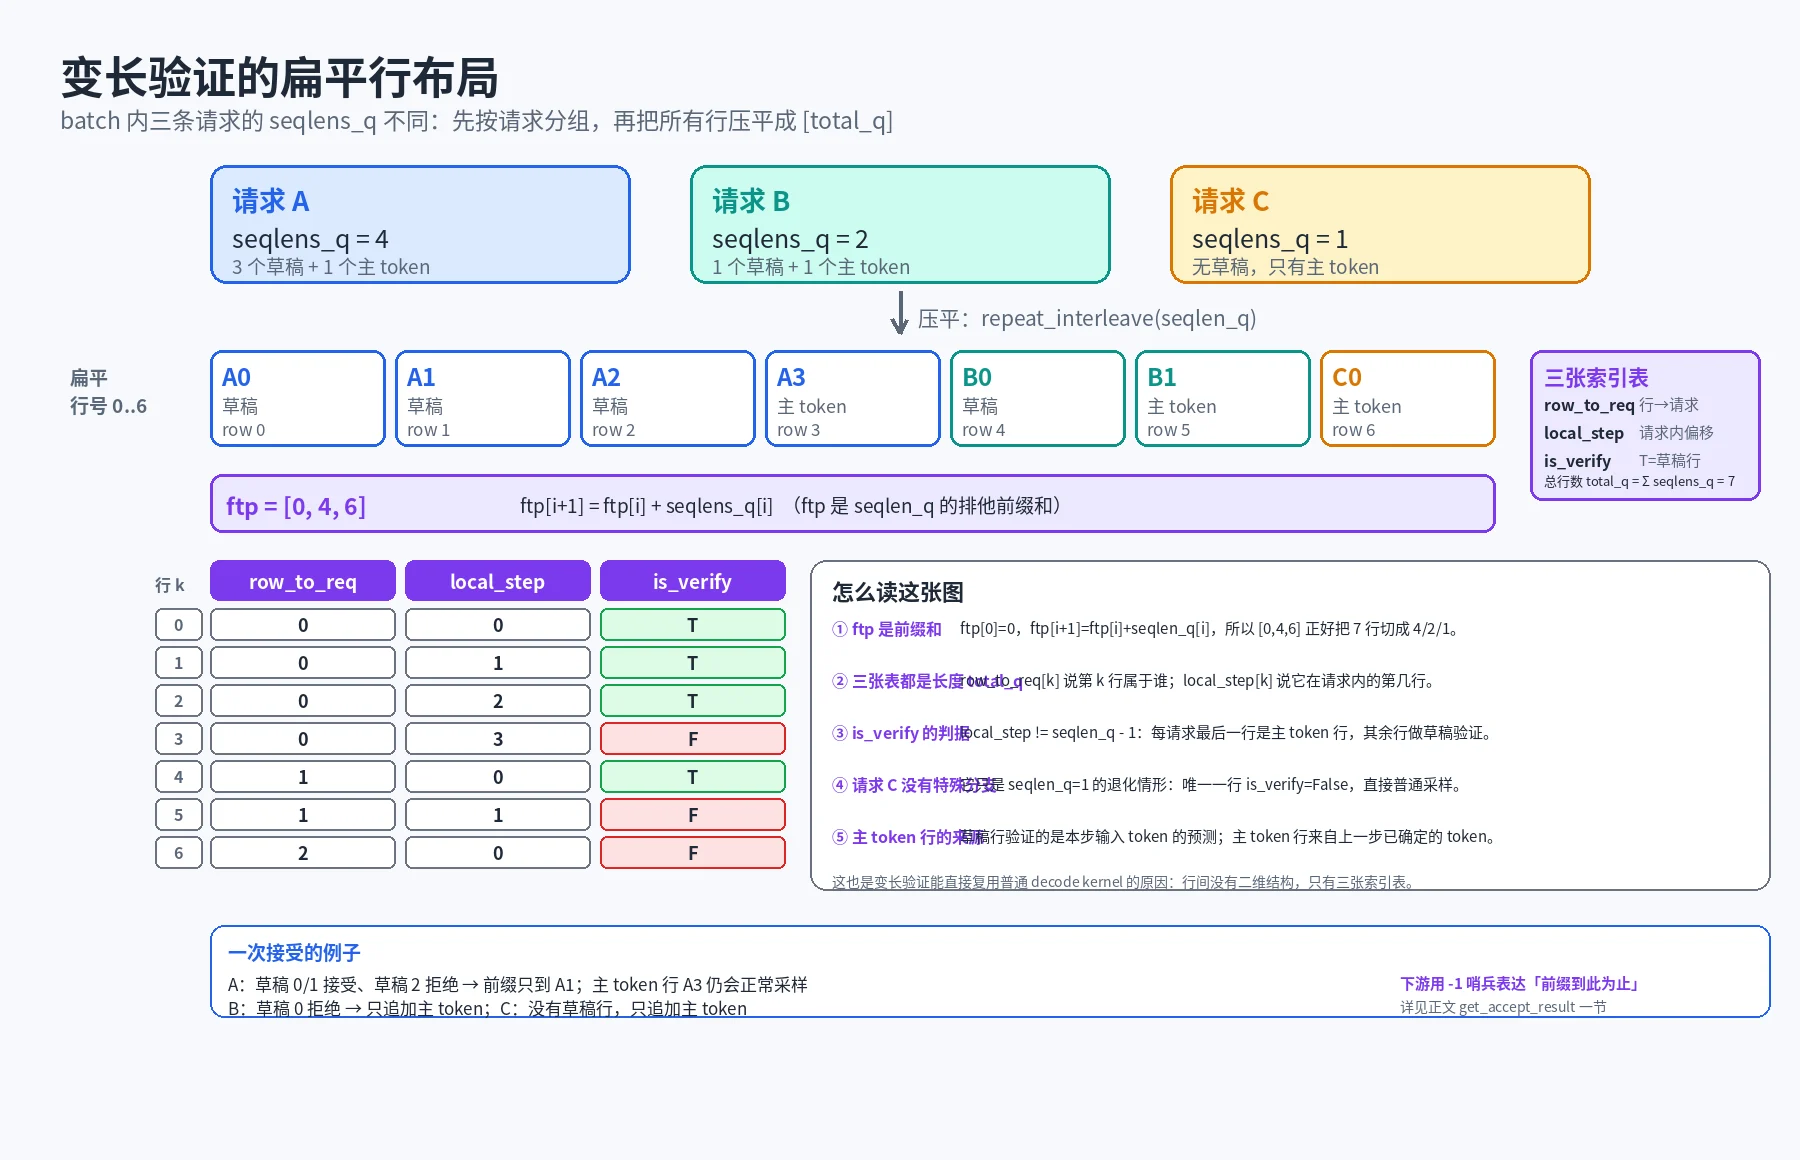
(本站自制图,依据 tilelang_ops/sampler.py 中 prepare_verification_metadata_ref 与 fused_sample 的行布局绘制)
这张图对应上面的例子。左边是三条请求各自的验证长度,中间是压平后的 7 行,右边三列是 row_to_req、local_step、is_verify 的取值。注意最右边请求 C 只有一行,local_step = 0,而 seqlen_q - 1 = 0,所以 is_verify = False——它直接走普通采样,不参与拒绝采样。这个细节很重要:「没有草稿」不是特殊分支,而是「seqlen_q = 1 的退化情形」。同一套内核、同一套索引表就能处理,不需要为「纯 decode」另写一条路径。
为什么不用二维张量
一个自然的疑问是:既然每条请求的验证长度不同,为什么不直接用一个 [req_cnt, max_nextn + 1] 的二维张量,短的行用 padding 补齐?这在很多推理框架里确实是常规做法,但 DeepInfer 选择扁平化,原因有三层:
- kernel 的负载均衡。变长验证的
seqlens_q分布很不均匀:有的请求验证 5 个草稿,有的只验证 1 个。二维布局会让同一列的行承载完全不同的计算量,而扁平布局把所有行当成独立元素,GPU 的线程块可以均匀地按行分片,不会因为某一列大量 padding 而空转。DSpark 论文在部署部分也明确写了这一点:把不同请求的 token 全部压平、当成独立元素处理,序列内依赖通过稀疏注意力里的 marker 张量表达,而不是靠二维 mask。 - 与 CUDA Graph 的形状契约一致。DeepInfer 的 decode 走分档 CUDA Graph,图按
graph_size(总行数)选择,而不是按req_cnt × 固定列数。扁平化让「图的形状」只依赖一个整数,捕获与重放的档位管理简单得多。这一点在CUDA Graph 捕获与重放里已经讲过。 - 跨语言的接口更窄。C++ 调度器只需要接收一个
[total_q]的接受结果张量和一个[req_cnt]的first_token_positions,就能还原每条请求的接受前缀;不需要在 C++ 侧再实现一套二维索引逻辑。接口越窄,跨语言边界上能出的错越少。
代价是索引表必须由生产方和消费方共同遵守。first_token_positions 不是可选提示,而是协议:build_request_outputs 在收到 accepted_token_ids 时,如果没有同时收到 first_token_positions,会直接 TORCH_CHECK 失败。这类显式失败比「悄悄按错误偏移读」要好得多。
接受前缀怎么落回每条请求
扁平布局解决的是「行属于谁」。下一步要解决的是「哪些行算数」。投机解码的接受规则是前缀接受:从第一条草稿开始逐条判断,遇到第一个拒绝就停止,后面的草稿即使单独看也可能被接受,也不能再算。这个规则在投机解码里已经从概率角度解释过,这里只看它在扁平张量上的实现。
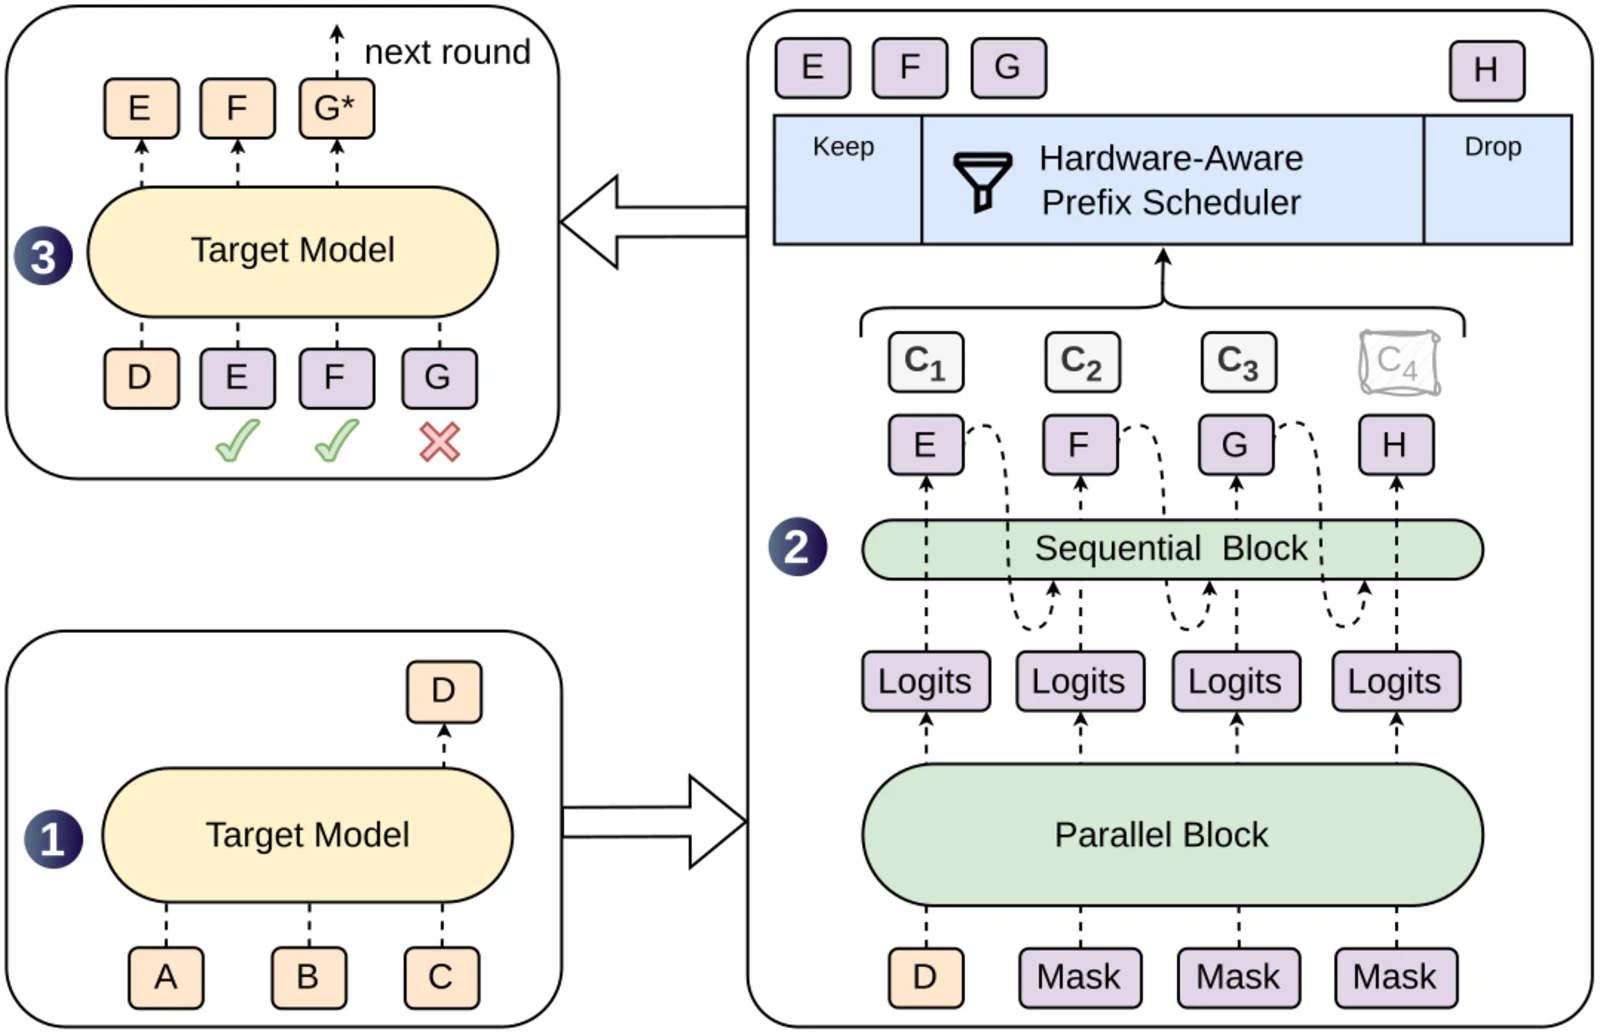
(图源:DSpark 图 1)
图中最关键的是最后一步:E、F 接受、G 拒绝后,H 即使本身可能被接受也不再检查——这就是「前缀接受」。下面这段代码要解决的,正是如何把这种逐请求的前缀语义,用一次全局 cumsum 同时算完。
用一次前缀和表达「前缀存活」
def get_accept_result_ref(raw_accept, golden, draft_token_ids, candidate_token_ids, is_verify, ftp, row_to_req): accept = raw_accept tokens = candidate_token_ids if golden is not None: use_golden = golden != -1 accept = torch.where(use_golden, golden == draft_token_ids, accept) tokens = torch.where(use_golden, golden, tokens) blocked = ~(is_verify & accept) prefix = torch.cat([blocked.new_zeros(1, dtype=torch.int32), blocked.cumsum(0, dtype=torch.int32)]) alive = prefix[:-1] == prefix[ftp[row_to_req.long()].long()] effective_accept = alive & is_verify & accept is_final = alive & blocked return tokens, effective_accept, is_final这段代码的妙处在于,它没有对每条请求写循环,而是用一次全局 cumsum 同时处理所有请求。理解它的关键是 blocked 的定义:「不是验证行」或者「验证了但没接受」都算 blocked。于是每条请求内部,blocked 的第一个位置就是「该请求的接受前缀到此为止」的位置:
- 如果请求 A 的三条草稿全部接受,那么前三行的
blocked = False,第四行是主 token 行(is_verify = False),blocked = True; - 如果请求 A 的第二条草稿被拒,那么第二行
blocked = True,第三行虽然可能accept = True,但它已经在前缀之外。
cumsum 之后,prefix[k] 表示「第 0 到 k-1 行里有多少个 blocked」。对请求 i,prefix[ftp[i]] 是它开始之前的全局 blocked 计数。某一行 k 属于请求 i 时,如果 prefix[k] == prefix[ftp[i]],说明从请求起点到这一行之前没有任何 blocked——也就是这一行仍在「存活前缀」内。alive 就是这个判断。
于是:
effective_accept = alive & is_verify & accept:真正被接受的草稿行;is_final = alive & blocked:每条请求的「第一处断点」,它可能是第一个被拒的草稿行,也可能是永远存在的主 token 行。
is_final 是后面所有计数的锚点。finalize_verification_ref 用它一次性算出每条请求的最终行、接受数量与输出位置:
rows = torch.arange(q, dtype=ftp.dtype, device=ftp.device)final_row = rows[is_final]last_valid_offset = final_row - ftp # 每条请求的最终行相对起点的偏移...num_generated_tokens.scatter_add_(0, step_index, accepted_mask.to(torch.int32))num_verified_tokens.scatter_add_(0, step_index, is_verify.to(torch.int32))last_valid_offset 的语义是「本步这条请求的最后一个有效 token 位于它自己的第几行」。对上面的例子:请求 A 若接受 2 条草稿,最终行是第 2 行(主 token),last_valid_offset = 2;请求 B 若第一条草稿就被拒,最终行是第 1 行,last_valid_offset = 1。这个值随后会被传给草稿头,作为下一轮生成草稿的起点。
-1 哨兵:被拒绝的行怎么表达
finalize_verification_ref 里还有一行不起眼但很关键的代码:
verified_token_ids=torch.where(scalar_mask, effective_token_ids, -1).to(torch.int32),被接受的草稿行写入真实 token id,没被接受(包括前缀之外的草稿行)写入 -1。为什么不用 0?因为 0 是合法的 token id(DeepSeek 的词表里 0 是 BOS)。用一个不可能出现在正常输出里的负数作哨兵,下游就能用「遇到 -1 就停」来表达前缀语义,而不需要再读一次 effective_accept 布尔张量。
这个哨兵在 C++ 侧被消费了两次:
if (accepted_token_ids_base_ptr[flat_idx] != -1) num_accepted++;else break;第一次是在统计 accept_tok 时;第二次是在真正追加 token 时:
if (token_id == -1) break;appended_tokens++;两处都是「遇到 -1 立刻停」,而不是「跳过 -1 继续读」。这正是前缀语义在数据层面的表达:哨兵不是过滤条件,而是终止符。如果哪天有人把它改成 continue,错误会非常隐蔽——被拒绝的草稿后面如果碰巧有被接受的草稿,就会被错误地追加进序列,而前缀约束已经被破坏。
为什么 verified_token_ids 是 [total_q] 而不是 [req_cnt, nextn]
这与扁平布局是同一个设计选择的一体两面。[req_cnt, nextn] 需要每条请求都补齐到最大草稿数,而实际接受的草稿数可能从 0 到 5 不等。补齐会带来两个问题:一是下游必须知道「哪些位置是 padding」,二是 MTP 的草稿池本身已经按 slot 存了定长 nextn 行,再在输出侧补一次会造成两套长度语义。扁平加哨兵则只有一种长度语义:读到 -1 为止。
跨步的草稿槽:MTPInfoPool 的读写下标
输出账本不只涉及「本步的结果」,还涉及「下一步要验证的草稿」。在变长验证里,这一步的草稿是上一步的草稿头生成的,而上一步的采样结果又要等到这一步才能被验证——这就形成了一个跨 step 的写后读依赖。DeepInfer 用一块 GPU 常驻的 MTPInfoPool 来承载它。
池的形状与 slot 0
MTPInfoPool 的文档字符串把布局写得很清楚:
Stable GPU storage for MTP proposals indexed by scheduler slots.Each slot owns nextn rows. Slot 0 is reserved for padding; all otherslots store one row per MTP proposal.pool_rows = (max_num_seqs + 1) * nextn也就是说,池子按「请求槽位」组织,每个槽位固定 nextn 行;槽位 0 永远不用,留给 padding。调度器为每条进入运行队列的请求分配一个槽位:
void allocate_mtp_info_slot(Sequence &seq) { if (nextn == 0 || seq.mtp.info_slot != 0) return; TORCH_CHECK(!free_mtp_info_slots.empty(), "No free MTP info slot for request ", seq.request.request_id); seq.mtp.info_slot = free_mtp_info_slots.back(); free_mtp_info_slots.pop_back();}槽位号从 1 开始,随请求的生命周期分配与释放。请求结束时 release_mtp_info_slot 把槽位还回 free list,并清空 Sequence 里的记录。这个设计的直接好处是:草稿的位置与请求的物理槽位绑定,而不是与 batch 内的临时下标绑定。即使下一步请求的排列顺序变了、batch 组成变了,只要请求还活着,它的草稿就还在原来的槽位里。
写一步、读一步
草稿头在本步生成下一轮的草稿后,把结果写进池子:
def store(self, write_slots, prediction, logprobs, logprobs_index): store_mtp_info( write_slots, prediction.token_ids, logprobs, logprobs_index, prediction.confidence_rates, self.token_ids, self.logprobs, self.logprobs_index, self.confidence, )write_slots 是 [req_cnt] 的槽位号;store_mtp_info 的内核把每条请求的 nextn 行写到 slot * nextn + j。写到槽位 0 的请求会被跳过,从而保留槽位 0 的 padding 内容。下一步验证时,Sampler._verification 用 mtp_info_read_rows 把池子里的对应行读回来:
logprobs, ... = process_sampling( logits, driver_inputs.kernel, self.force_topk, row_to_req=row_to_req, local_step=local_step, is_verify=is_verify, last_nextn_token_logprobs=mtp_info_pool.logprobs if speculative_inputs is not None else None, ... mtp_info_read_rows=speculative_inputs.mtp_info_read_rows if speculative_inputs is not None else None,)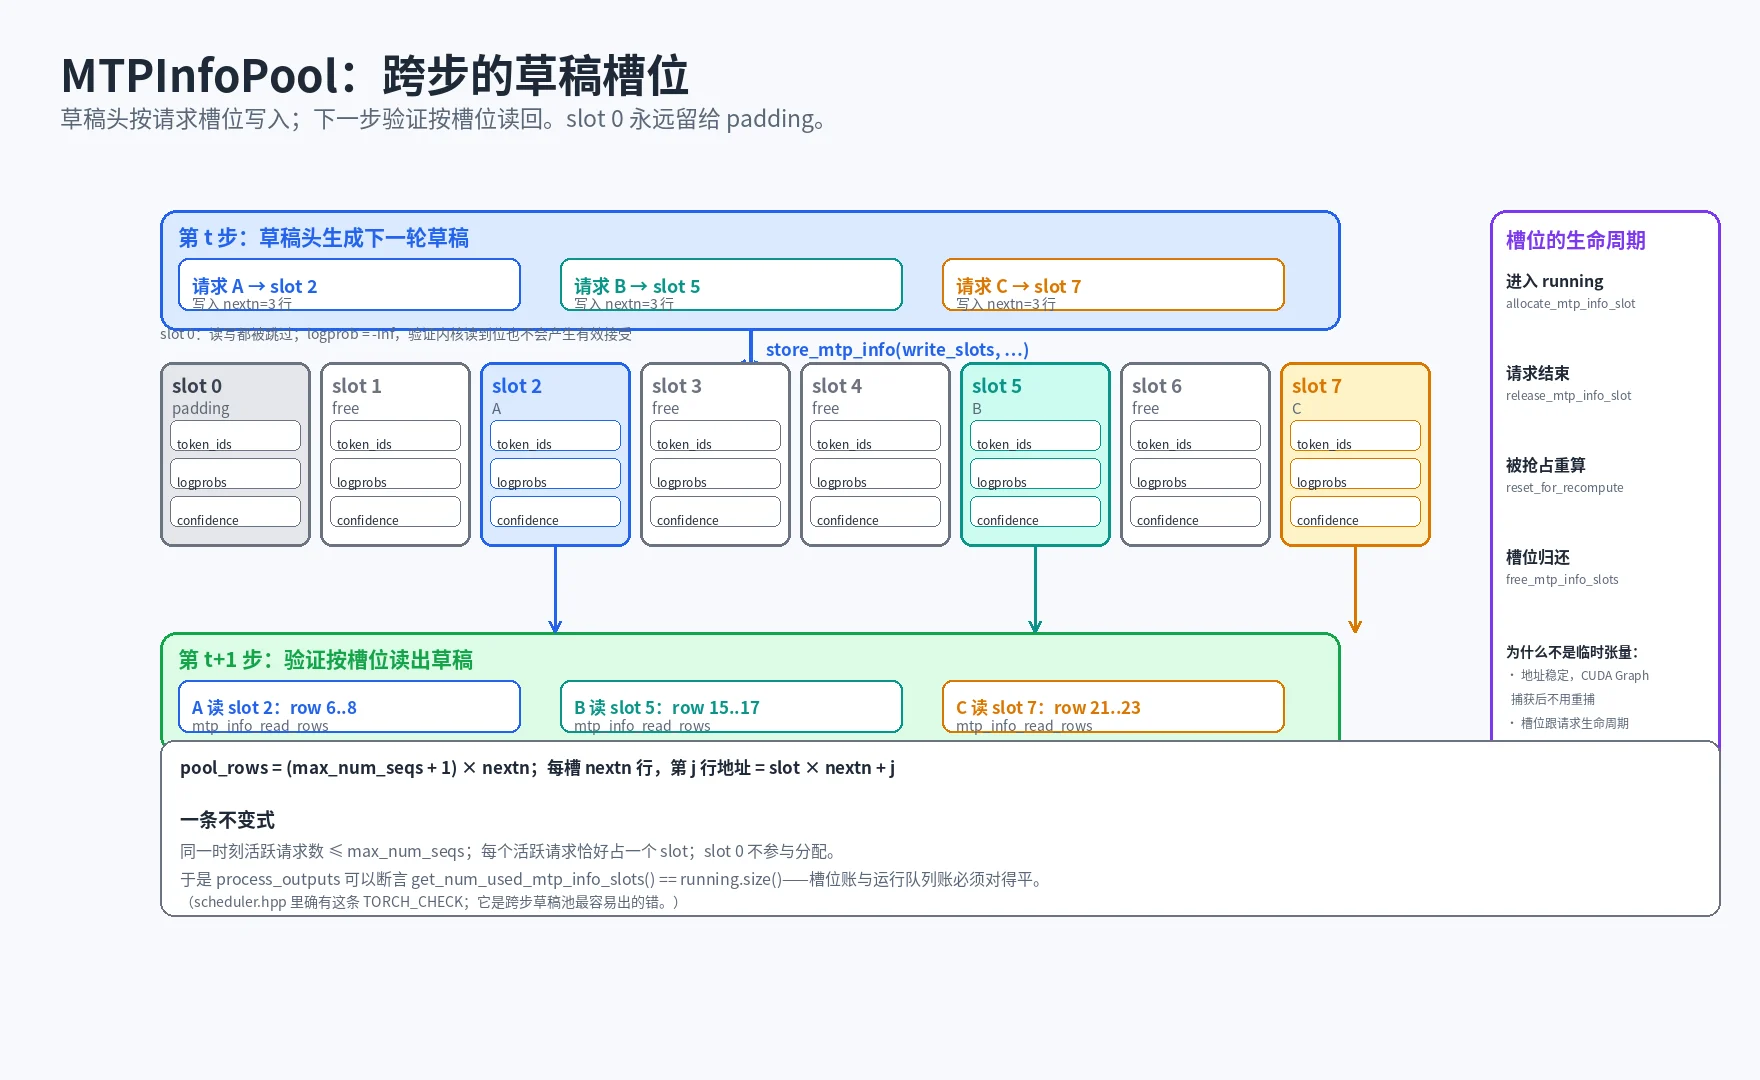
(本站自制图,依据 mtp_info_pool.py 与 scheduler.hpp::allocate_mtp_info_slot 绘制)
这张图把三件事画在一起:左侧是本步的草稿生成,中间是常驻 GPU 的槽位池,右侧是下一步的验证读取。注意图中标注的「槽位 0」:它不是某条请求,而是所有「本步没有草稿」请求的公共替身。写入时跳过它,读取时它的 logprobs 是 -inf(除 padding token),这样验证内核即使读到它也不会产生有效的接受判定。
为什么不能直接返回张量
一个自然的替代方案是:草稿头把本步生成的 token_ids、logprobs 直接作为 SamplerOutput 的一部分返回,下一步再传回来。DeepInfer 没有这么做,原因有三点:
- ZOS 的延迟消费。在零开销调度下,本步的输出要到下一步才被消费;如果草稿张量是临时分配,生命周期会跨 step,Python 侧必须持有引用并保证不被回收,这会把内存管理复杂度从「一块常驻池」扩散到「每个 step 的临时对象」。
- CUDA Graph 的地址稳定性。草稿头的图在捕获时绑定了池子的地址;如果每步换一块新张量,图就必须重新捕获,或者退化成 eager 路径。常驻池让地址在捕获前后保持不变。
- 槽位与请求生命周期对齐。请求被抢占、重算、恢复时,槽位可以跟着
Sequence一起保存/释放;如果草稿是随 step 返回的临时张量,重算时就得额外决定「上一轮的草稿是否还属于这条请求」。MtpState里的reset_for_recompute()、take_draft_info_slot()正是为这种生命周期准备的。
C++ 收账:process_outputs 如何追加 token
现在把镜头切到 C++。Python 侧已经准备好三样东西:每条请求的接受前缀([total_q],-1 终止)、本步的主 token([num_output_tokens])、以及结构化输出的状态。Scheduler::process_outputs 负责把它们写回 Sequence。
一、“golden” 这个状态名
读 process_outputs 之前,先看 Sequence 里一个容易让人困惑的成员:MtpState::last_output_token。它保存的是「上一步输出的最后一个 token」,源码里的做法是:
seq.mtp.last_output_token = output_token_ids_data[i];而注释直接称它为「本轮的 golden token」。为什么叫 golden?因为目标模型在本步验证草稿时,第一条主 token 行的输入恰恰就是这个 token:上一轮已经确定的输出,构成了这一轮第一个位置的确定性输入。草稿头的「串行头」也以它为起点继续生成下一轮的草稿——所谓 anchor(锚点)。
理解了这一点,sampled_token_ids_gpu、predict_token_ids_gpu 这些字段为什么是「GPU 常驻副本」就清楚了:ZOS 下,下一步的输入里 target 位置用的是上一步采样结果,draft 位置用的是上一步草稿池。这两份数据都在 GPU 上,下一步的前向直接做 D2D 拷贝,不需要经 CPU 绕一圈。
乐观推进与提交
先看账面。调度时,调度器已经按 seqlens_q 乐观地推进了 KV 账本:
seq.cache.advance_optimistically(scheduler_outputs.seqlens_q[i]);advance_optimistically 会把 previous_num_tokens 记成推进前的值,把 num_tokens 加上 seqlen_q。这样做的原因是:KV 块在调度阶段就要按最坏情况分配,不能等采样结果回来再决定;否则显存可能不够。采样结果回来之后,真正被接受的 token 数可能小于 seqlen_q(草稿被拒),于是要「回填」:
// decode:把 cache.num_tokens 从乐观推进值回填为实际接受数(未被接受的 draft 不占 KV)seq.cache.commit_processed_tokens(token_cnt);commit_processed_tokens 的实现只有一行:
void commit_processed_tokens(int token_count) { num_tokens = previous_num_tokens + token_count; }这行代码是整本账的收口:先按上限记账,再按实际用量结算。previous_num_tokens 是推进前的稳定基线,token_cnt 是本步真正追加的 token 数。中间那个「多算的部分」就是被拒绝的草稿——它们曾经占用过 KV 块的形状预算,但没有被写进序列,所以在提交时被扣掉。
追加循环与停止条件
真正写 token 的循环如下(省略了日志与分支):
token_ids = accepted_token_ids_vec;seq.mtp.last_output_token = output_token_ids_data[i];token_ids.push_back(seq.mtp.last_output_token);
int token_cnt = 0;for (auto token_id : token_ids) { seq.append_token_id(token_id); seq.append_compressed_token_id(map_engram(token_id)); token_cnt++; _check_stop(seq); if (seq.is_finished()) break;}if (seq.is_finished()) release_mtp_info_slot(seq);pushed_tokens_before_finish.push_back(token_cnt);这段代码回答了一个很实际的问题:如果一条请求在接受的前缀中途就触发了停止条件,后面的 token 怎么办? 答案是不追加。_check_stop 在每次追加后检查(EOS、max_tokens、结构化输出失败等),一旦命中就 break,token_cnt 停在命中位置。于是 token_cnt 可能小于「接受前缀 + 1」,这正是 pushed_tokens_before_finish 名字的由来:它是「结束之前实际被 push 进去的 token 数」。
这个值随后被 build_request_outputs 用来决定本步要发出几个 RequestOutput、哪一个带 finish_reason。如果没有它,输出构造就只能假设「接受多少就发多少」,于是用户会看到 EOS 之后的 token——一个非常典型、也非常难在离线测试里发现的 bug。
被抢占与已中止的请求
process_outputs 还有两个提前返回的分支:
// seq is already abortedif (seq.is_finished()) { release_mtp_info_slot(seq); pushed_tokens_before_finish.push_back(0); ... continue;}
// ZOS 异步:本步尚在途时就被 _preempt 抢占重算的 seqif (!scheduler_outputs.prompt_run && seq.schedule.status == SequenceStatus::WAITING) { pushed_tokens_before_finish.push_back(0); ... continue;}两个分支都写入 0,含义是「本步这条请求没有任何 token 可以发给用户」。前一个是请求已经结束(比如被 abort),后一个是请求在本步前向还在飞的时候就被抢占、放回等待队列,本步结果作废。后者是 ZOS 特有的竞态:采样结果回来时,Sequence 的状态可能已经变了。pushed_tokens_before_finish = 0 就是一个显式的「本步无输出」标记,避免把作废的 token 追加进去造成重复输出。
从 Sequence 到 RequestOutput:一次请求多个输出
现在进入最后一层。build_request_outputs 的输入是一堆扁平张量和一个对象池指针,输出是一个 uint64 指针数组,每个指针指向池子里的一个 RequestOutput。这一节按「一条请求」的视角走一遍。
接受草稿先发,主 token 后发
对每条请求,函数先处理被接受的草稿,再处理主 token:
if (has_accepted_tokens) { for (int j = 0; j < num_draft_i; j++) { int flat_idx = ftp_i + j; int token_id = accepted_token_ids_base_ptr[flat_idx]; if (token_id == -1) break; appended_tokens++; if (appended_tokens > pushed_tokens) break; ... bool is_finished = appended_tokens < pushed_tokens ? 0 : seq->is_finished(); int num_output_tokens = seq->get_output_len() - pushed_tokens + appended_tokens; request_outputs.emplace_back(request_output_pool->allocate(...)); golden_output = ...; }}if (appended_tokens < pushed_tokens) { appended_tokens++; // 主 token 的 RequestOutput}这里有三个不变量:
appended_tokens从 1 开始计,且最多到pushed_tokens。草稿循环里每发一个就加一,发到pushed_tokens为止;主 token 只在appended_tokens < pushed_tokens时才发。这保证了「发出去的 token 数」严格等于「实际追加进序列的 token 数」。finish_reason只落在本步最后一个输出上。is_finished = appended_tokens < pushed_tokens ? 0 : seq->is_finished():前面的草稿输出即使发生在「将要结束」的请求上,也不带结束标记;只有最后一个才带。否则客户端会在收到第一个草稿 token 时就把流关掉。num_output_tokens是「累计口径」而不是「本步增量」。get_output_len() - pushed_tokens + appended_tokens表示「本步开始前的输出长度 + 本步已经发出的数量」。这个字段用于usage统计和客户端判断进度,不是增量。
golden_output 是一个很有意思的变量:它指向本步这条请求最后发出的那个 RequestOutput,然后被写入 draft_tok、accept_tok 与 confidence_score:
golden_output->draft_tok = draft_tok_val;golden_output->accept_tok = accept_tok_val;if (seq->mtp.prev_confidence_raw.size() > 0) { golden_output->confidence_score = seq->mtp.prev_confidence_raw;}为什么统计信息只挂在最后一个输出上?因为对客户端来说,一条请求的「本步结果」是一个整体:它想知道这一步验证了几个草稿、接受了几个、置信度误差多大,而不是在收到每个草稿 token 时都重复一遍。把这些字段集中到最后一个输出,既减少重复,也避免了「中间输出被提前消费」时的语义歧义。
-9999 钳位:为什么不是 -inf
输出构造里有大量这样的代码:
float token_logprob = std::max(token_logprobs_ptr[i], -9999.0f);logprobs 在数学上可以取到 -inf:被 top-p 剪掉的 token、词表外的图像 token、强制 top-k 模式下未入选的位置,都会得到负无穷。但 -inf 一旦进入 JSON 序列化,就会变成 null 或直接解析失败;进入某些客户端的浮点显示,又会变成 -Infinity 这种非标准字面量。-9999 是一个「足够小、但仍然是有限数」的钳位值,保证协议层永远拿到合法的 JSON 数字。
这个细节和输出账本的主题看似无关,其实是同一类问题:内部表示可以为了计算方便而使用哨兵/无穷,跨出引擎边界时必须换成协议安全的表示。-1 在内部是接受前缀的终止符,但在 RequestOutput 里不会出现;-inf 在内部是合法的 logprob,但到了输出层会被钳成 -9999。
被忽略的请求:ignored_seqs
还有一类请求不走主循环:ignored_seqs。它们通常是因为 prompt 长度超过限制而被拒绝的请求,本步没有进入前向,也没有采样结果。但客户端仍然需要一个明确的结束原因:
for (auto &seq : scheduler_outputs.ignored_seqs) { request_outputs.emplace_back(request_output_pool->allocate( seq->request.request_id, seq->get_prompt_len(), seq->get_last_token_id(), get_finished_reason(seq->schedule.status), seq->is_finished(), ..., seq->get_output_len() + 1, PromptLogprobs()));}注意它的 token_id 是 get_last_token_id()(prompt 的最后一个 token),num_output_tokens 是 get_output_len() + 1(保证至少为 1),logprobs 用无效值 1.0 / -1.0 填充。这是一条「没有生成、但必须告诉客户端为什么结束」的输出。get_finished_reason 会把 FINISHED_IGNORED 映射成 "prompt_length_exceeded",客户端据此显示错误,而不是一直等待一个永远不会到来的 token。
ZOS 下,输出是上一拍的账单
前面的叙述默认「本步采样、本步收账、本步发输出」。在零开销调度下,这个默认不成立:第 N 拍的采样结果,是在第 N+1 拍的前向执行期间才被收账并构造成 RequestOutput 的。回到 LLMEngine.step() 的注释——process_output 这个虚函数在不同模式下语义不同:
- ZOS=False:处理当前 step 的输出;
- ZOS=True:处理上一个 step 输出的 token。
这句注释是整个输出账本的时序注脚。它意味着:
- 账本永远是「延后一拍」的。调度器在第 N+1 拍算
seqlens_q时,用的Sequence长度是第 N 拍采样之前的长度;第 N 拍的接受结果要到后处理时才提交进Sequence。因此 ZOS 下的 KV 账和序列长度会短暂地「落后一步」。第 N+1 拍在schedule()里看到的是第 N 拍提交之前的长度,它按这个长度加上本拍seqlens_q做准入;而process_outputs里的乐观推进(advance_optimistically)是在第 N 拍的后处理中把第 N 拍已调度行占用的 KV 提前记到Sequence上,供第 N+2 拍的准入使用。两边合起来,才是「一拍的账在下一拍结算、但永远不欠账」的完整时序。 - 输出的所有权与 GPU 的生命周期绑在一起。
RequestOutputPool的槽位在下一步step()开始前不能被复用,因为它们的字段仍然在流式发送线程手里;这就是DeferredRelease统一管理的request_outputs_to_release存在的理由。池子不在process_outputs里释放,而在下一次pre_sampler_sync里释放。 - flush 是特殊路径。当调度器认为所有请求都已结束时,最后一拍的在途输出还没被收账。
flush_inflight_reqs()会强制触发 Worker 侧的后处理,然后调用process_output把最后一批RequestOutput构造出来。这段代码在第十七篇已经讲透,这里不再重复,只强调一点:如果没有 flush,用户看到的最后 1 到 nextn 个 token 会悄悄消失,而且这种缺失在单请求测试里几乎无法发现——它只在「请求恰好在最后一拍结束时」出现。
对象池:为什么输出不是普通 Python 对象
固定 10000 槽的池子
RequestOutput 不是 Python 类,而是一个 C++ 结构体,里面有 std::string、std::vector、c10::optional。如果每个 step 都为每条输出 new 一个对象,再交给 Python 持有,那么在高并发下会产生大量小对象分配与析构,且 Python GC 的时机不可控。DeepInfer 的做法是预先分配一整块内存,用 placement new 在上面构造:
class RequestOutputPool { RequestOutput *pool_{nullptr}; std::vector<RequestOutput *> free_;public: static constexpr size_t max_size = 10000;
RequestOutputPool() { pool_ = reinterpret_cast<RequestOutput *>( aligned_alloc(alignof(RequestOutput), sizeof(RequestOutput) * max_size)); ... }
template <typename... Args> uint64_t allocate(Args &&...args) { TORCH_CHECK(!free_.empty(), "RequestOutputPool exhausted (max_size=", max_size, "); outputs are not being released"); auto p = free_.back(); free_.pop_back(); new (p) RequestOutput(std::forward<Args>(args)...); return reinterpret_cast<uint64_t>(p); }
void release(py::array_t<uint64_t> ptrs_py) { const uint64_t *ptrs = ptrs_py.data(); int size = ptrs_py.size(); for (int i = 0; i < size; ++i) { auto p = reinterpret_cast<RequestOutput *>(ptrs[i]); std::destroy_at(p); free_.push_back(p); } }};几个设计点值得拆开:
max_size = 10000是硬上限。池子耗尽时直接TORCH_CHECK失败,而不是退化成new。这是一种「宁可显式失败,不要静默降级」的选择:如果输出没有被及时释放,说明调用方的生命周期管理有问题,继续分配只会把问题拖到更晚、更难定位的地方。- 返回的是裸指针的整数值。
allocate返回uint64_t,build_request_outputs把一批指针塞进py::array_t<uint64_t>。Python 侧看到的是一串整数,只有需要字段时才通过_C的绑定解码成对象。这避免了每个输出一次的 Python 对象构造,也避免了跨语言拷贝。 release接受指针数组。释放不是逐个调用,而是一次性把一批指针还回 free list。这让「释放本步所有输出」变成一次批量操作,和DeferredRelease的批量回收天然对齐。
clone 与 release:谁拥有这些对象
池子的所有权模型可以用一句话概括:池子拥有内存,调用方拥有「本步的租约」。step() 返回的指针在本步有效;下一步 step() 会回收上一批输出。如果调用方要把输出保留到下一步之后(例如异步流式发送),必须显式 clone:
for raw_output in step_outputs: output = RequestOutput.clone(raw_output) ...clone 的实现是一行 std::make_unique<RequestOutput>(*raw)——它并不占用池子的槽位,而是在堆上新建一个独立的 RequestOutput,拷贝构造全部字段(包括 std::string 与 std::vector)。这样原始输出可以在下一步被回收,而副本由 Python 持有引用、随引用计数回收。也正因为它不占池子,大量克隆的输出只受 Python 堆的管理;而池子侧要防的,只是「本步产出的输出没有被 DeferredRelease 回收」。
为什么必须 gil_scoped_release
build_request_outputs 在构造循环开始前有一行:
py::gil_scoped_release release;然后在返回前重新获取:
py::gil_scoped_acquire acquire;return py::array_t<uint64_t>(request_outputs.size(), request_outputs.data());这看起来只是性能优化,实际上和 ZOS 的正确性有关:输出构造发生在引擎侧的后处理阶段,这段时间 GPU 正在执行下一拍的前向。如果持有 GIL,Python 侧的其他线程(例如结构化输出的编译线程、流式发送线程)就会被阻塞,CPU 后处理的时间会被拉长,最终把 GPU 拖空。释放 GIL 让构造循环真正并行于其他 Python 工作,也是「把 CPU 工作藏进 GPU 阴影里」这一整套设计的组成部分。
一个完整的走账例子
把上面的机制串起来,用一个具体例子走一遍。假设本步有三条请求:
| 请求 | seqlen_q | 草稿数 | 实际接受 | 本步追加 token 数 token_cnt |
|---|---|---|---|---|
| A | 4 | 3 | 2 | 3(草稿 2 + 主 1) |
| B | 2 | 1 | 0 | 1(主 1) |
| C | 1 | 0 | — | 1(主 1) |
并且假设请求 A 的输出长度正好在追加第三个 token 时达到 max_tokens(在追加循环之前的累计输出长度是 max_tokens - 1),请求 B、C 正常继续。
第一步,扁平布局。 ftp = [0, 4, 6],total_q = 7。请求 A 占行 0..3,B 占 4..5,C 占 6。is_verify 对 A 是 [T, T, T, F],对 B 是 [T, F],对 C 是 [F]。
第二步,接受判定。 A 的草稿行为 [接受, 接受, 拒绝],接受前缀长度 2,last_valid_offset = 2,verified_token_ids 在 A 的 4 行上是 [t1, t2, -1, -1](主 token 行不算 verified,用 -1 填充);B 的草稿被拒,verified_token_ids 是 [-1, -1];C 没有验证行,全是 -1。主 token 另行通过 token_ids[req_cnt] 传出。
第三步,C++ 收账。 A 的 token_ids 向量是 [t1, t2, main_A];追加时 _check_stop 在每个 token 后比较 seq.get_output_len() == max_tokens,追加第三个后命中,token_cnt = 3,状态变为 FINISHED_LENGTH_CAPPED。B 的向量是 [main_B],token_cnt = 1;C 同理 token_cnt = 1。pushed_tokens_before_finish = [3, 1, 1]。KV 账本:A 从乐观推进的 4 回填为 3,B 从 2 回填为 1,C 保持 1。
第四步,输出构造。 A 发出 3 个 RequestOutput:t1、t2、main_A;前两个 finished = false,第三个 finished = true,finish_reason = "length"。draft_tok = 4、accept_tok = 3 挂在第三个上。B 发出 1 个 main_B,finished = false。C 发出 1 个 main_C,finished = false。数组里一共 5 个指针,顺序是 A 的 3 个、B 的 1 个、C 的 1 个。
第五步,Python 消费。 _run_engine 逐个 clone,解码 token,按 request_id 分组发给各自的流。A 的客户端收到 3 个 token 后看到 finish_reason = "length",关闭流;B、C 继续等待下一步。
这个例子解释了两件事。第一,「一次请求多个输出」不是可选的优化,而是变长验证的必然结果:A 本步产生了 3 个 token,必须按顺序发出,否则客户端会看到一个「跳跃」的 token 序列。第二,pushed_tokens_before_finish 是输出数量与序列账本之间的桥:没有它,A 会发出 4 个输出(3 个草稿 + 主 token),但实际只追加了 3 个,多出来的那个既不在序列里、也没有对应的 KV,属于纯粹的幻影输出。
这套账本的边界与常见坑
把机制讲完之后,值得列出几类在真实调试中容易踩的坑。它们都不是「代码写错了」那种显式 bug,而是协议不变量被绕过之后产生的静默错误。
第一,first_token_positions 与 seqlen_q 必须同源。 两者一个来自调度器的切分,一个来自采样元数据;如果其中一个被下游修改(例如为了对齐 CUDA Graph 而补了 padding 行),另一个没有同步,row_to_req 就会指错请求。源码在 build_request_outputs 里要求「提供 accepted tokens 就必须提供 ftp」,但这条检查只能保证存在性,保证不了一致性。调试时应当把两者一起打印,检查 ftp[i+1] - ftp[i] == seqlen_q[i] 是否处处成立。
第二,-1 哨兵的语义是「终止」而不是「无效」。 在 verified_token_ids 里,被拒绝的草稿和主 token 行都是 -1;但主 token 行本来就不参与 verified 前缀,它的 -1 不是「拒绝」,而是「不属于这个数组的语义范围」。下游如果用 != -1 过滤而不是 break,就会把主 token 行后面的(不存在的)行也读进来。正确的读法是「读到第一个 -1 为止」,这一点在 process_outputs 和 build_request_outputs 里都是一致的。
第三,pushed_tokens_before_finish 的「0」有两种含义。 对正常请求,0 表示「本步没有可发 token」;对已中止或被抢占的请求,0 也表示同样的事,但原因不同。输出侧不需要区分原因,只需要知道「不要发」;但统计侧(例如吞吐、接受率)应当把这两种 0 分开,否则 abort 率会被混进「本步无输出」的比例里。源码里 pushed_tokens_before_finish 只是一个 int 数组,没有附带原因;原因在 SequenceStatus 里,调试时需要回到 Sequence 查。
第四,池耗尽是生命周期 bug,不是容量不够。 RequestOutputPool 的 10000 个槽位对应的是「同一时刻未被释放的输出数」。正常路径下,每步结束都会回收上一批;如果池子耗尽,几乎一定是某条路径 clone 之后没有 release,或者把 step() 的返回值缓存了下来。把 max_size 调大只会把崩溃推迟,不能修复问题。
第五,-9999 是协议值,不是数学值。 如果下游把它当成真实 logprob 参与计算(例如重新归一化、算 perplexity),会得到明显错误的结果。它只应该出现在展示与序列化层;任何需要数学运算的地方,都应当使用原始的 -inf 或重新计算。
怎么确认账本是对的:四个检查点
账本类代码的 bug 往往是「不报错但悄悄错」,所以实际排查时最好按下面四个点逐层核对。它们都能在现有源码里找到对应的变量,不需要改代码。
检查点一:行布局自洽。 对调度输出里的每条请求,ftp[i+1] - ftp[i] 必须等于 seqlens_q[i],且 ftp[0] == 0、ftp[-1] + seqlen_q[-1] == total_q。只要这一条不成立,row_to_req 就会把行指向错误的请求,而内核不会报错,只会算出一组看似合理的 token。
检查点二:接受前缀是连续的。 对每条请求,verified_token_ids[ftp[i] : ftp[i]+seqlen_q[i]-1] 必须形如 t1, t2, …, tk, -1, -1, …——前面是连续的接受 token,后面全是 -1。一旦出现「-1 后面又有非 -1」,说明有人把哨兵当成了过滤器而不是终止符。
检查点三:落地数不超过接受数加一。 pushed_tokens_before_finish[i] <= 接受草稿数 + 1,且只有在停止条件命中时才严格小于。如果大于,说明主 token 被重复追加;如果小于却没有结束,说明某个 token 被静默丢弃。
检查点四:槽位账与运行队列账对平。 调度器在 decode 步之后的 schedule() 里会做一次断言:get_num_used_mtp_info_slots() == running.size()。它不是给生产代码用的,而是给开发时用的「账本对账器」——如果一条请求被抢占后槽位没有归还,或重算时槽位被重复分配,这个断言会最先炸出来。
这四个检查点分别对应本篇的四个小节:扁平行布局、接受前缀、C++ 收账、草稿槽位。把任何一个单独拿出来看都像「实现细节」,但它们串起来就是 DeepInfer 在变长验证下仍然能对账的完整理由。
与站内其他框架的对照
把 DeepInfer 的输出账本和站内已经拆过的几个框架放在一起,可以看到三种不同的取舍:
| 维度 | DeepInfer | vLLM V1 | SGLang |
|---|---|---|---|
| 多 token 输出 | 扁平 [total_q] + ftp + -1 哨兵,一次 C++ 构造多条 RequestOutput | 单个 C++ 侧 SamplerOutput,经 Python 输出处理器逐条构造 | 单条输出对象承载整个 batch,经 detokenize 与管理器拆分 |
| 输出对象生命周期 | 固定 10000 槽对象池,裸指针数组,显式 clone/release | 由引擎内部生命周期管理,前端只消费 | 异步 detokenize 队列,前端消费已解码结果 |
| 结束判定位置 | C++ _check_stop 在追加循环内,pushed_tokens_before_finish 精确到 token | 停止条件在输出处理器(Python)里逐条判断 | 停止条件与语法约束在调度/采样批次管理中判断 |
| 与 ZOS 的关系 | 输出构造与下一拍前向重叠,对象池延迟释放 | 同步 step,输出即用即走 | overlap scheduler 下输出经队列传递 |
这张表不是为了评判优劣,而是说明一个事实:「输出」在推理框架里从来不是一个简单的数据结构,而是调度、KV、采样、流式协议四者的交汇点。DeepInfer 选择把交汇点压进 C++ 和固定池,换取确定性的延迟与零 Python 对象分配;vLLM 选择把交汇点留在 Python,换取可扩展性与调试便利;SGLang 选择把 detokenize 挪到独立进程,换取前端吞吐。三者都能工作,区别在于复杂度被放在了哪一侧。
站内相关阅读:vLLM 源码完全拆解(九):Sampler、SGLang 源码完全拆解(十一):投机解码、TensorRT-LLM 源码完全拆解(十七):Sampler。
小结
本篇沿着一条 decode step 的输出路径,拆了三段代码和两套索引语言:
- 扁平布局解决了「一行 logits 属于谁」。
first_token_positions是seqlen_q的前缀和,row_to_req/local_step/is_verify三张表把行号翻译成请求语义;扁平化让变长验证的负载在 GPU 上均匀分布,也让跨语言接口只剩一个整数数组。 - 接受前缀用一次全局
cumsum表达「每条请求从起点到当前行之间有没有断点」。is_final标出每条请求的最终行,last_valid_offset给出下一轮草稿的起点,-1哨兵把「前缀到此为止」编码进数据本身。 - 输出账本由
process_outputs的追加循环和build_request_outputs的打包循环共同完成。前者用pushed_tokens_before_finish记录「结束前实际落地了几个 token」,后者据此决定发几个RequestOutput、哪一个带结束标记;固定对象池则把「每步成千上万个小对象」变成「一块预分配内存 + 一批裸指针」。
如果要用一句话概括这套设计:DeepInfer 把「变长」限制在最小的范围内——变长只存在于 GPU 的行布局与接受前缀里,一旦跨出采样层,所有东西都重新变成「每条请求一个定长小账本」。这正是它能在投机解码、ZOS、CUDA Graph 三者叠加时仍然保持账目清晰的原因。
下一篇会继续沿着 DeepInfer 的源码往外走,讨论推理引擎与外部 KV 存储系统之间的接口:块缓存的键怎么构造、命中之后如何跳过重复的 prefill、以及在 SWA 有界重放的约束下,「命中重算」为什么是一种必要的妥协。
参考资料
- DeepInfer 仓库(deepseek-ai/DeepInfer)
- DeepInfer
sampler.py(采样层与验证入口) - DeepInfer
tilelang_ops/sampler.py(扁平验证元数据与接受前缀) - DeepInfer
mtp_info_pool.py(草稿槽位池) - DeepInfer
scheduler.hpp(process_outputs与 MTP 槽位分配) - DeepInfer
outputs.hpp(RequestOutput与对象池) - DeepInfer
sequence.py(SamplerOutput与SampledInfo) - DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation(arXiv:2607.05147)
- DeepSeek V4.1 Flash 推理部署 Q&A
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



