


TensorRT-LLM 源码完全拆解(三十):HF checkpoint 的装载管线——分片发现、懒加载切片、并行读盘与可消费权重字典
为什么装载层值得单独一篇
前面的文章里,权重从模型层到内核的路径已经拆得比较细:模型注册表决定了「哪个 HF 架构对应哪个 PyTorch 模型类」,DecoderModelForCausalLM.load_weights() 决定了「一个模块名该去找 checkpoint 里的哪些张量」,LinearMethodBase 决定了「张量读进内存之后怎么量化、怎么排布」,而 BufferManager 决定了「KV 池和 workspace 怎么分显存」。这些文章都从一个前提出发:桌面上已经摆着一份 dict[str, Tensor]。
真实部署里,摆上桌面的代价不小。一个 671B 级别的模型 checkpoint、以 BF16 存盘,光是文件就有上百个 *.safetensors 分片。急切装载路径下,每个 rank 都会把全量分片读进主机内存,再由模型层按 mapping 切出自己那一份——TP=8 的八张卡,存储系统就要被同一份 checkpoint 拉八遍。如果再多机部署,流量按 rank 数线性放大。这不是实现偷懒,而是因为「哪些张量归哪个 rank」的切分逻辑住在模块里,装载器提前不知道;但代价是真实的,懒加载与 rank-striped 预读都是为了把这笔代价压下来。
本文沿 tensorrt_llm/_torch/models/checkpoints/ 与 modeling_utils.py 的源码,把这层拆成五段:
- 分片发现与目录编目:文件名列表如何变成一个可查询的「键名 → 文件 + 偏移」目录;
- 懒加载切片:为什么这里返回的不是张量,而是
PySafeSlice,以及v[:]何时才真正把字节读进来; - 可消费权重字典:
ConsumableWeightsDict如何让「模块装载完就释放」成为可能,前缀查找为什么必须用有序索引; - 并行读盘:多线程装载、worker 数量上限、以及为什么读盘并发和模块装载并发要分开控制;
- 与模型层的交接:
load_weights()两套实现(mapper 路径与兼容路径)怎样把字典里的张量和模块名对上,mark_consumed何时才允许整个子树的释放。
前一篇讲模型注册表时已经交代过:TensorRT-LLM 的 PyTorch 后端会按 HF 配置里的 architectures[0] 找到模型类,再由 get_checkpoint_weight_loader() 找到对应的 checkpoint 装载器类。本文从那个装载器类被实例化的地方开始。
装载层在整条推理栈中的位置
HF checkpoint 与 TensorRT-LLM 运行时之间隔着一组「形状约定」,理解这些约定才能读懂装载代码。
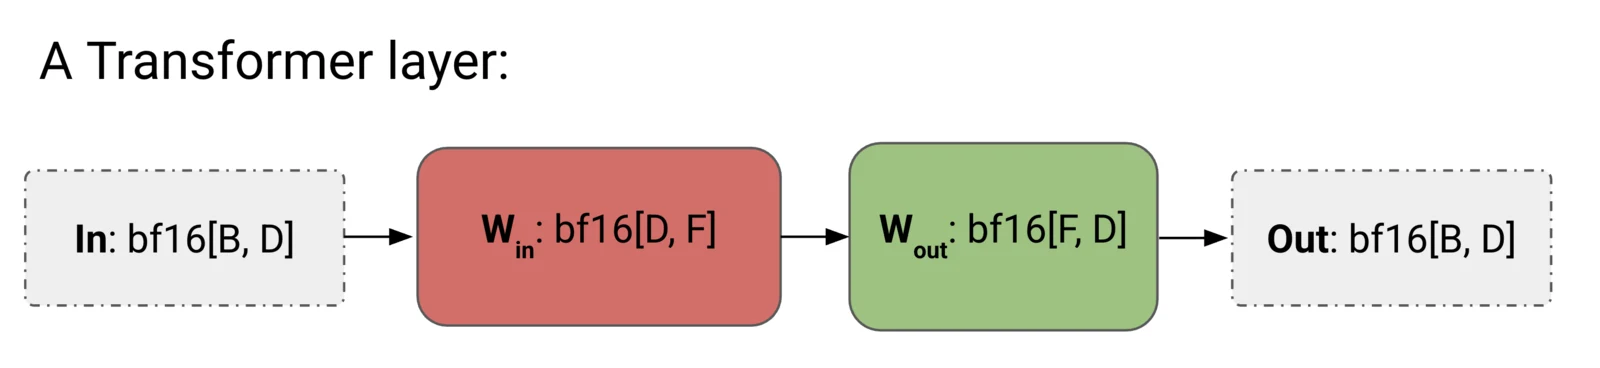
图中一个 Transformer 层的注意力和 MLP 两条残差支路,在 HF checkpoint 里对应的是分立、未融合的张量:注意力的 q_proj、k_proj、v_proj、o_proj,MLP 的 gate_proj、up_proj、down_proj。而 TensorRT-LLM 运行时追求的是「一次 kernel 完成两个投影、共享同一份量化激活」,于是在模型层把 q/k/v 融合成 qkv_proj、把 gate/up 融合成 gate_up_proj。装载层的任务因此分成两半:把磁盘上的分立张量映射到正确的模块名,以及在模块自身的 load_weights 里完成拼接、切分与重排。前者是本文的核心,后者在前面的量化与张量并行文章里已经拆过。(图源:JAX Scaling Book,How to Scale Your Model)
起点:装载器类与 BaseWeightLoader 契约
HF checkpoint 装载器继承自 BaseWeightLoader,它只有一个抽象方法:
class BaseWeightLoader(ABC):
@abstractmethod def load_weights(self, checkpoint_dir: str, mapping: Mapping, **kwargs) -> Union[Dict[str, Any], ConsumableWeightsDict]: """Returns a dict where keys are tensor names and values are the tensors."""接口签名里有两个信息值得注意。第一,mapping 参数——也就是 TensorRT-LLM 的 Mapping 对象,携带 tp_size、rank、ep_size、pp_size、dp_size 等并行拓扑——被直接传进来。这意味着装载器自己就知道当前 rank 处于什么并行拓扑中,可以据此做「只读本 rank 需要的切片」这类优化。第二,返回类型是 Union[Dict, ConsumableWeightsDict]:契约允许装载器返回普通字典,但「可消费」的字典才是能压住峰值内存的实现。
HfWeightLoader 是这个基类的实现。它支持的磁盘格式包括 *.safetensors 分片、consolidated 式的单个整合 safetensors,以及旧式 *.bin / *.pth。这一层不关心「模型长什么样」,只负责「把磁盘上的字节变成一张键名到张量的映射」。它最值得讲的设计全部围绕两个目标:不能把整个 checkpoint 同时读进内存,以及键名匹配要快。
一、分片发现与目录编目
分片文件名列表
HF 的分片命名是约定俗成的:model-00001-of-00100.safetensors。装载器用 sorted(glob.glob(f"{checkpoint_dir}/*.safetensors")) 把所有分片列出来,找不到任何分片就直接报错:
weight_files = sorted(glob.glob(f"{checkpoint_dir}/*.safetensors"))if not weight_files: raise RuntimeError(f"No safetensors files in {checkpoint_dir}.")sorted 不是随手加的。后面所有并发任务(读盘、预取、编目)都以文件为单位切分,执行顺序需要可复现,否则「哪几个文件先被读进内存」在不同 rank、不同运行之间就会不同,调试时看到的内存峰值曲线就无法对齐。
为什么要「编目」
safetensors 格式的特点是:文件头部有一段 JSON,记录每个张量的名字、dtype、形状和字节区间;数据区按偏移平铺存放。因此「某个张量在哪个文件、什么位置」可以直接从头部读出来,不需要读数据本身。
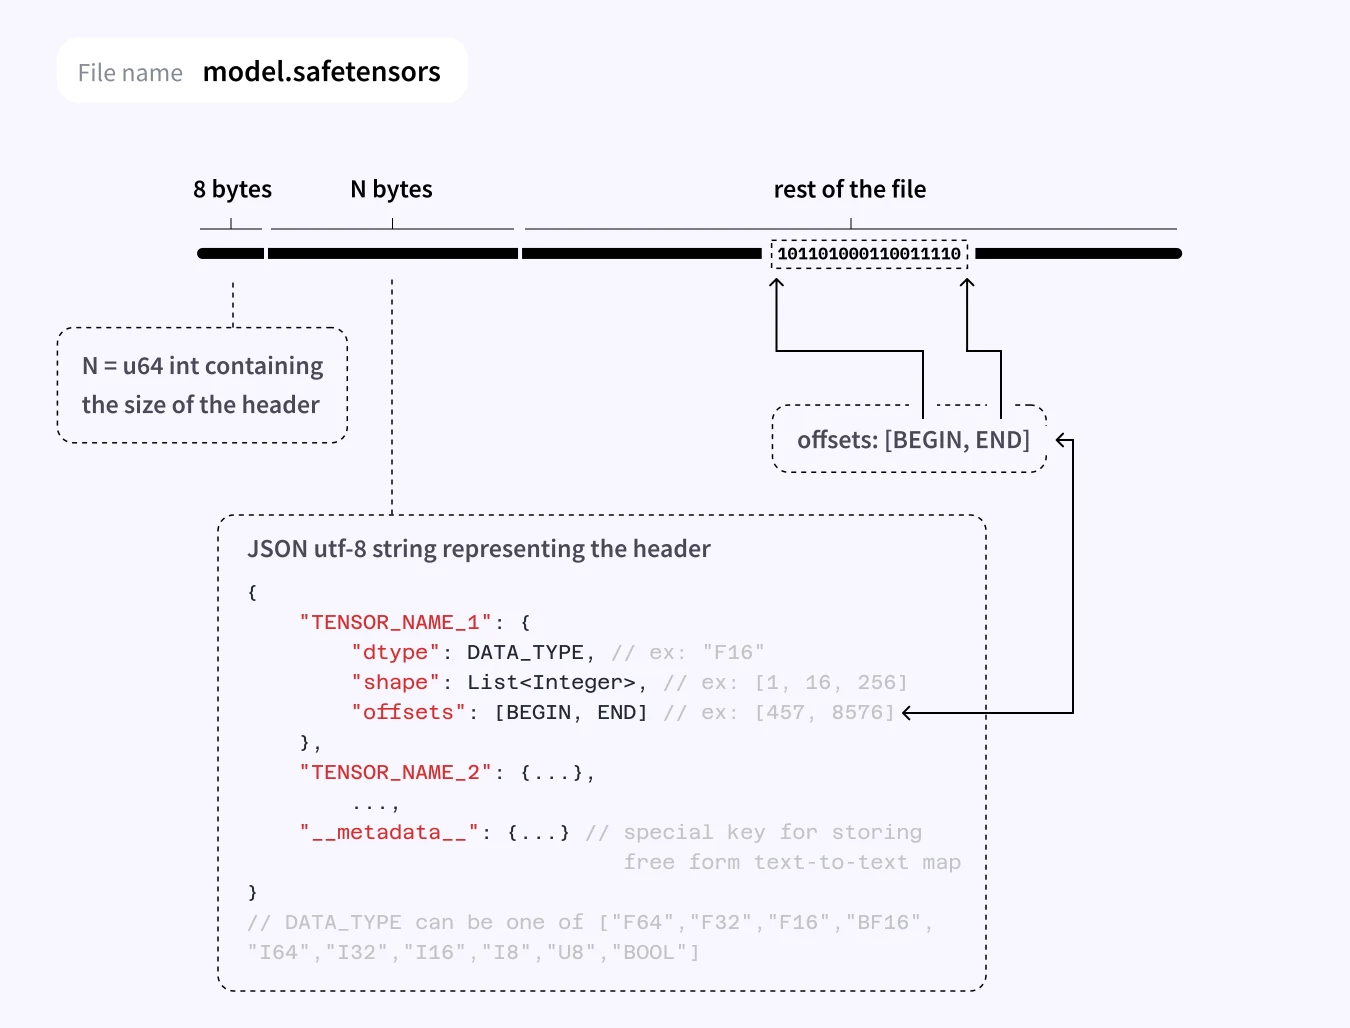
图中左侧是文件头部的元数据区,每个张量条目记录名字、dtype、形状与起止偏移;右侧是按偏移连续存放的数据区。装载层只打开文件、读头部,就能建出「键名 → 文件 + 偏移」的映射;懒切片 v[:] 也只是按偏移截取一段字节。这正是「编目」与「懒加载」共用同一份头部信息的格式基础。(图源:Hugging Face safetensors 官方文档)
safetensors 库的 safe_open() 打开文件后返回一个句柄,handle.keys() 给出全部键名,handle.get_slice(name) 给出一个绑定到该张量的切片对象。要回答「model.layers.17.self_attn.q_proj.weight 在不在这个 checkpoint 里、在哪个文件里」,朴素做法是逐个文件打开、逐个键名比对——O(分片数 × 每分片键数)。
build_safetensors_checkpoint_catalog() 扫描一遍所有分片的头部,把每个键名连同它所在的文件、偏移、形状与 dtype 记录成一份目录。这份目录不是每次装载的必经路径:普通装载直接走 load_file 或懒切片,目录服务于「不读数据也要回答键名问题」的场景。DecoderModelForCausalLM._checkpoint_has_lm_head_scale() 就是一个例子:它只查头部里有没有 lm_head.weight_scale,不物化任何权重,而这个判断决定 lm_head 要不要按量化配置构造,必须在真正装载之前完成。影子装载计划(后文展开)也靠目录来核对「计划需要的张量,磁盘上到底有没有」。
构造目录要付出一遍头部扫描的代价;换来的是把之后多次「键名是否存在、在哪个分片」的线性扫描变成一次构造加 O(log N) 查询。只有当查询次数足够多、或必须在不物化数据的前提下回答时才划算——这也是它没有成为默认路径的原因。至于装载过程中每个模块的前缀过滤,用的是另一套结构:ConsumableWeightsDict 自己的有序键索引,下一节展开。
懒加载的触发条件
装载器里有一个开关函数 _requires_lazy_safetensors(checkpoint_dir),它的语义是「这个 checkpoint 是否必须保持 mmap、不能整体读入」。它的判断依据不是文件大小,而是 config.json 里的 model_type:
_LAZY_SAFETENSORS_MODEL_TYPES = ("kimi_k3", "kimi_linear", "glm5_next", "glm5_next_text", "muse_spark")源码注释给出的理由很具体:这几类模型的 checkpoint 从数百 GiB 到 1.5 TB,而且模型自己的 load_weights 会从懒句柄里按 rank 流式读取局部切片(例如 Kimi K3 按专家并行范围只读本 rank 的专家)。如果在这条路径上先整体物化,主机内存直接不够,后续的 rank-local 流式读取也失去意义。一旦判定为需要懒加载,装载路径就走 _load_lazy_safetensors(),而不是一次性 safetensors.torch.load_file()。
这里有一个分布式正确性细节:函数注释强调不能吞掉 config.json 的读/解析异常。因为每个 rank 必须走同一分支——急切路径里会 enqueue 集合通信,如果某个 rank 因为本地瞬时错误走进了另一条分支,集合通信的参与者数量就对不上,整个作业会死锁。把异常向上抛,让所有 rank 同时失败,比让一个 rank 悄悄换路要安全。
懒加载路径返回的字典长这样(简化):
def _load_lazy_safetensors(self, checkpoint_dir, use_consolidated): weight_files = sorted(glob.glob(f"{checkpoint_dir}/*.safetensors")) weights = {} handles = [] for file_name in weight_files: handle = safetensors.safe_open(file_name, framework="pt", device="cpu") handles.append(handle) for name in handle.keys(): weights[name] = handle.get_slice(name) return _LazySafetensorsWeights(weights, handles)这里有两个要讲清楚的点。
其一,值不是张量,而是 PySafeSlice。 PySafeSlice 只记录了「哪个文件、什么偏移、什么 dtype、什么形状」,真正取数发生在 slice[:](或任意索引)的时候,并且只 mmap 该张量覆盖的那段字节。于是「字典里有 15 万个键」与「15 万份张量数据都在内存里」彻底脱钩:字典只多出与键数成正比的元数据。某个模块装载时只对它的几个键做 slice[:],读进来的是几十 MB 到几百 MB,而不是全部权重。
其二,句柄的生命周期要跟着字典走。 safe_open() 返回的句柄持有文件描述符与 mmap 映射,句柄一旦被回收,切片对象就会失效。_LazySafetensorsWeights 因此把句柄列表挂在自己身上:
class _LazySafetensorsWeights(ConsumableWeightsDict): def __init__(self, weights: dict[str, Any], handles: list[Any]) -> None: super().__init__(weights) self._handles = handles
def clear(self) -> None: super().clear() self._handles.clear()clear() 里先清权重字典、再清句柄列表,顺序是有意义的:装载结束调用 clear() 时,字典里残留的切片对象先被丢掉,此时再放掉句柄才不会让仍有引用的切片指向一个已解映射的文件。若反过来做,先释放句柄,字典里那些切片就成了悬空引用。
_load_lazy_safetensors() 还会在返回的容器上挂一个 checkpoint_dir 属性。注释说明了原因:懒切片对象本身不携带它来自哪个文件,而像 Kimi K3 这样「按分片文件流式读取 rank-local 专家」的模型需要自己重新打开分片;同时 transformers 已不再给 PretrainedConfig 设置 _name_or_path,模型层没有别的可靠途径拿到目录。于是目录信息就跟着容器一起传给模型层。
此外 _load_lazy_safetensors() 与急切路径共用同一套分片筛选规则:当目录里同时存在普通分片与 consolidated 整合文件时,只保留调用方指定的那一种,避免同一套权重被加载两遍、并在 mark_consumed 时因为键名重复而出现难以排查的残缺。
二、可消费权重字典:ConsumableWeightsDict
峰值的来源
即使用了懒切片,如果所有切片都在字典里挂着直到装载结束,它们引用的字节仍然可能被逐张量地访问过、并在页缓存里占着。更根本的问题是:真正被物化的张量(slice[:] 的结果)一旦在字典里保留到结束,就构成全量常驻。一个 671B 模型 BF16 全量约 1.3 TB,显然不能在单机 rank 上常驻。
ConsumableWeightsDict 的核心设计是:字典里的键可以在「被消费」后删除,模块把张量拷进自己的参数之后,立刻把源键从字典里删掉,源张量随即失去引用、被释放(若是 slice[:] 物化出的新张量,则直接释放;若是 lazy 切片,则只是释放该切片)。装载从「先全读入、再逐个拷」变成了「边读、边拷、边释放」,峰值内存的量级从「整个 checkpoint」降到「最大单模块 + 装载并发数 × 单模块」。
前缀查找:有序索引 + 二分
删键带来一个新问题:前缀查询。filter_weights(prefix, weights) 要给某个模块挑出 name.* 下所有键;mark_consumed(prefix) 要在模块消费完之后删掉 prefix. 下所有键。如果每次都线性扫全字典,装载时间与「模块数 × 键数」成正比。
ConsumableWeightsDict 的答案是维护一份排序后的键名列表并在其上二分:
def _keys_with_prefix_locked(self, prefix: str) -> list[str]: if self._key_index is None: self._key_index = sorted(self._weights) begin = bisect_left(self._key_index, prefix) upper_bound = prefix[:-1] + chr(ord(prefix[-1]) + 1) end = bisect_left(self._key_index, upper_bound, begin) return [key for key in self._key_index[begin:end] if key in self._weights]upper_bound 的算法是经典技巧:所有以 prefix 开头的键在字典序上一定小于「把前缀最后一个字符加一」得到的串。例如前缀 model.layers.17,上界是 model.layers.18。于是区间 [begin, end) 恰好覆盖所有以前缀开头的有效键,复杂度为 O(log N + 命中数),而不是 O(N)。
删除为什么不重建索引
有一个细节容易忽略:代码注释特意说明,删除键时故意不使索引失效:
Deletions deliberately do not invalidate the index: a stale index isalways a superset of the live keys, so filtering on membership keepsevery reader correct while each lookup stays proportional to the keysit matched rather than to the size of the checkpoint.索引是「删键之前的快照」。它只会比实际存在的键多,不会少,所以二分划出的区间里可能包含已删掉的键,但遍历时用 if key in self._weights 过滤即可。因此删键是 O(1) 的,不需要每删一次就重新 sorted。如果选择删键即重建,装载过程中数千次 mark_consumed 会各自付出一次全量排序;不重建则把成本全部压到了「首次查找时一次性排序」上。
这个设计里还有一个隐含约束:新增键会重置索引。__setitem__ 与 update 都会把 _key_index 设成 None,因为这会让已排序列表的成员关系改变。装载路径中一般不再加键,所以索引在首次构建后基本稳定;但流式权重更新(allow_partial_loading 等场景)会出现增量键,此时索引会回退到下一次重建。
线程安全与快照迭代
装载是多线程的(下一节展开),而字典会被并发读写。为此 ConsumableWeightsDict 内部持有一把 threading.Lock,并且所有迭代接口都返回快照副本:
def __iter__(self): with self._lock: return iter(list(self._weights.keys()))
def keys(self): with self._lock: return list(self._weights.keys())用快照而不是直接返回视图,原因是 Python 字典在迭代过程中被其他线程删除键会抛 RuntimeError: dictionary changed size during iteration。快照换来的是「迭代期间有人删键也不会崩」。代价是每次 keys() 都要复制一份键列表,但一次装载中 keys() 的调用次数有限(主要在编目、探测、日志里),可以接受。
take_ownership:让派生字典成为唯一持有者
装载过程中会出现「派生字典」:rename_weights_with_regex() 按正则重命名键、filter_weights() 按前缀筛出子集、convert_compressed_tensors_nvfp4_weights() 按格式转换张量。这些操作生成的新字典与原字典共享同一批张量对象(没有拷贝数据)。只要原字典还活着,张量就至少有两个引用,消费掉派生字典里的键什么都不会释放。
ConsumableWeightsDict.take_ownership() 就是解决这个问题的:
@classmethoddef take_ownership(cls, source, derived): if not isinstance(source, cls): return derived source.clear() return cls(derived)调用它的前提是:derived 里已经包含了 source 里仍然需要的所有张量。清空 source 之后,derived 成为最后一个持有者,后续 mark_consumed(prefix) 才能真的把内存还回去。注释里特别提醒「调用后不得再使用 source」——source 被清空,它的键索引也置空,任何基于它的查询都会返回空。
真正调用它的地方是那些「重写整份字典」的操作:BaseWeightMapper.rename_by_params_map() 用正则改键名、HfWeightMapper 做 compressed-tensors 格式转换、以及 DeepSeek-V4 系列模型自己的权重重映射。它们的共同点是:新字典里的值要么是原张量本身(改名),要么是从原张量算出来的新张量(转换),后者不再引用原数据,但只要旧字典还握着旧张量,它们就占着内存。take_ownership 在这些地方统一收口,让「替换整份字典」这个动作自带释放语义。
同样地,clear() 方法自身的注释也有一个易错点:
Use once a downstream dict owns the tensors: a derived dict aliases thesource tensors it did not rewrite, so consuming it frees nothing whilethis dict still holds them.读到这里就能理解整个设计链:派生 → 清空源 → 消费派生。三者少一步,释放都不会发生。
filter_prefix:为装载循环准备的分块视图
装载循环里每个模块都需要 prefix -> {去掉前缀的局部键: 切片} 的视图,filter_prefix() 做的正是这件事,同时去掉了前缀:
def filter_prefix(self, prefix: str) -> Dict[str, Any]: start = len(prefix) + 1 return { key[start:]: self._weights[key] for key in self._keys_with_prefix_locked(prefix) }「去掉前缀」这一步很关键:模块的 load_weights(weights=[module_weights]) 期望看到的是相对于该模块的键名(weight、bias、q_proj.weight……),而不是完整路径。前缀去掉的位置是 len(prefix) + 1,跳过的是分隔符 .。
三、并行读盘:多线程、上限与环境变量
并发装载需要知道并行拓扑
BaseWeightLoader.load_weights() 的签名里带着 mapping,装载器一旦拿到它就能知道本 rank 在多少个维度上被切过:tp_size 决定同一个线性层的权重是否要被拦腰切一刀,pp_size 决定这个 rank 只该装哪几层,dp_size 与 ep_size 决定哪些专家副本归自己。
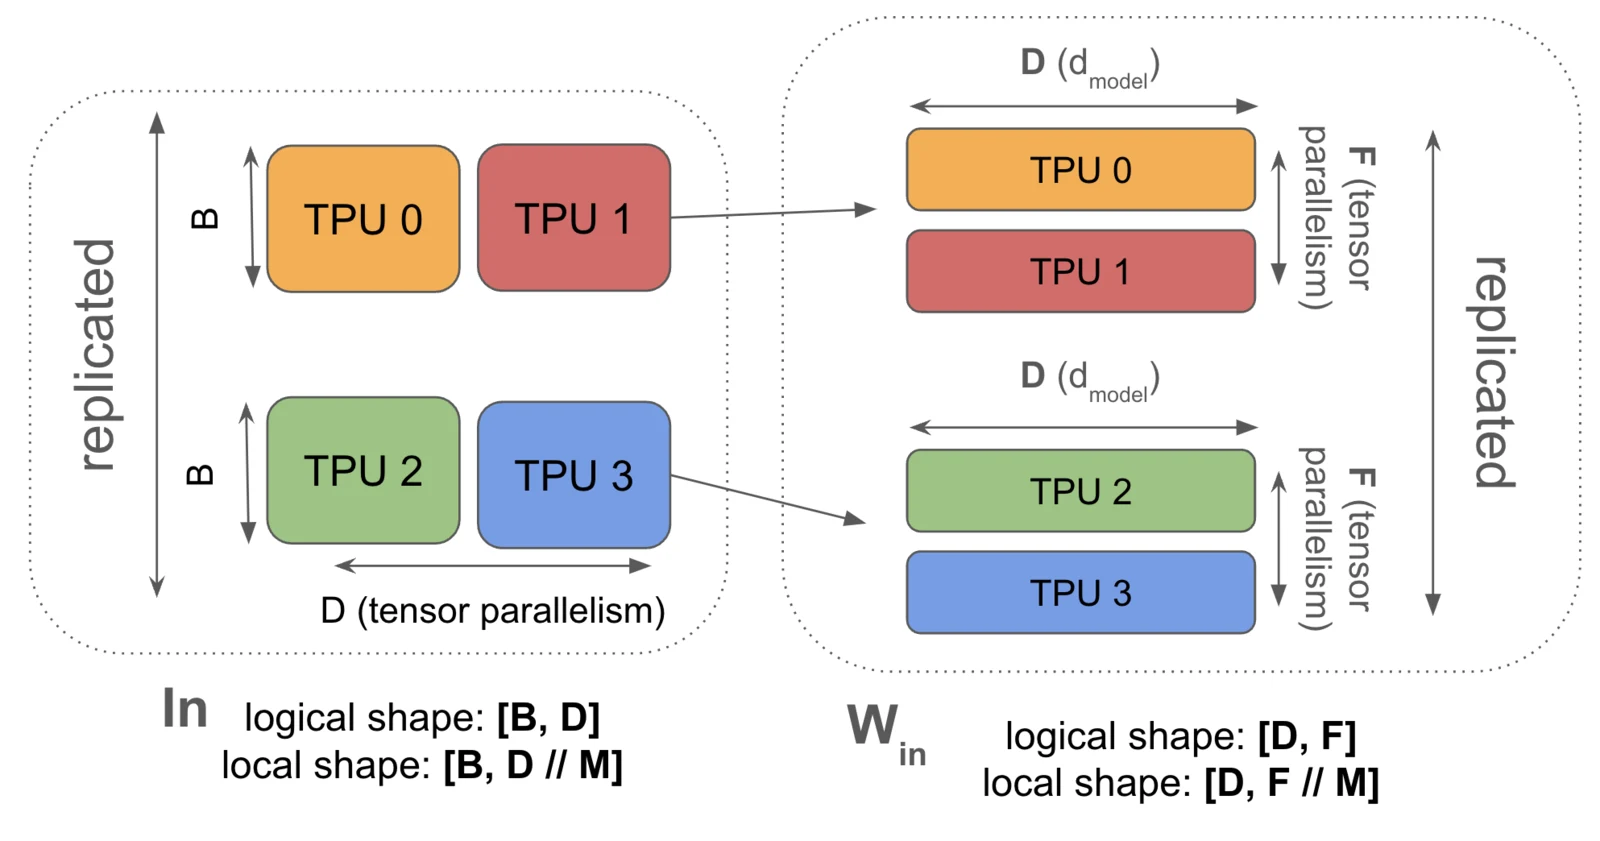
图中列并行切出 [N, K/p]、每个 rank 算出部分输出、无需通信;行并行切出 [N/p, K]、每个 rank 算出部分和、必须 AllReduce。装载层对两种模式的处理不同:列并行(qkv_proj、gate_up_proj)的切分边界落在输出维度上,行并行(o_proj、down_proj)落在输入维度上。两种模式在 checkpoint 里长一样,差别全部体现在 Linear 构造时传入的 shard_dim 与 mapping 上。因此在装载层里,mapping.tp_size == 1 与 mapping.tp_size == 8 走的是同一条代码路径,只是最后 load_shard() 切出来的片段大小不同。(图源:JAX Scaling Book,How to Scale Your Model)
注意力模块为什么要先复制 KV 头
GQA 模型的 k_proj、v_proj 输出宽度只有 q_proj 的 1/n(n 为分组数)。如果按「输出维度除以 tp_size」切分而不做处理,当 tp_size 大于 KV 头数时,某些 rank 会分不到任何 KV 头。
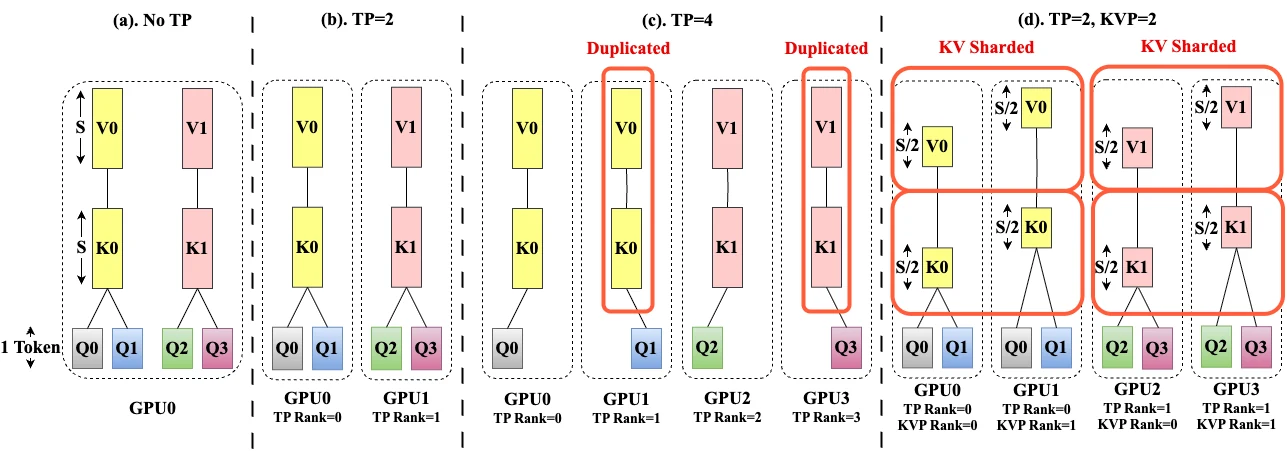
图中展示的是注意力头上「谁持有哪几个 head」的分片关系。兼容装载路径里 duplicate_kv_weight() 的作用就是在装载前把 K/V 权重沿 head 维度复制到与 Q 头数一致,这样「按 Q 头数切 tp_size 份」的规则对三个投影都成立:每个 rank 恰好持有相同数量的 Q/K/V 头,不需要在切分逻辑里为 GQA 开特例。代价是每个 rank 存储的 K/V 权重比严格意义上所需的更多,换来的是切分规则与注意力 kernel 头布局的一致——这条取舍在张量并行文章里讨论过的 head 复制策略是同一种思路。(图源:TensorRT-LLM 官方技术博客 Helix Parallelism 的分片示意)
多线程装载 safetensors 分片
一个 checkpoint 有上百个分片时,串行 load_file 会把启动时间拖得很长。HfWeightLoader 用线程池并发装载分片:
def _load_safetensors_file(file: str) -> dict[str, torch.Tensor]: return safetensors.torch.load_file(file)
def _load_weights_in_parallel(self, weight_files, load_func, desc): ...为什么是线程而不是多进程?safetensors 读盘是「mmap + 逐张量拷贝」,耗时主要在 I/O 与内核态拷贝上,Python 线程足以重叠这段等待,而多进程会把每个进程的张量另起一份内存、跨进程传回又得序列化,得不偿失。
预取:把页缓存提前焐热
prefetch_files() 在并行装载之前做一次「只读不物化」的预取:对每个分片执行 mmap 并触发 madvise(MADV_POPULATE_READ) 一类提示,让操作系统提前把文件页读进页缓存。这样后续真正的 load_file 命中页缓存,而不是等磁盘。
_read_file_in_chunks() 的回退路径特意用固定 64 MiB 的复用缓冲区分块读,而不是一次 read() 整个文件。注释给出的理由很实际:整文件读会把整个文件钉在匿名内存里直到读完;如果每个本地 rank 同时有最多 16 个多 GB 文件在读,慢存储会让这些缓冲区累积到几百 GB,直接把主机 OOM。分块读对页缓存的预热效果一样,但每个线程的常驻足迹是常数。还有一个细节:当文件已经被页缓存完整覆盖(offset 已到文件尾)时,函数在分配缓冲区之前就返回——否则 16 个 worker 各分配 64 MiB,会在读 EOF 时瞬时浪费约 1 GiB。
这类思考在数据并行下尤其重要:如果每个 rank 都预取全量,N 个 rank 会同时把 N 份 checkpoint 从存储系统拉进各自的页缓存,对共享存储形成风暴。
这里要分清三个不同的「并发度」,它们属于不同层、互不相干:
| 并发层 | 线程池 | 单位 | 可调 |
|---|---|---|---|
| 分片读盘 | run_concurrently() 的 ThreadPoolExecutor | 每个分片文件 | 默认由线程池默认值决定,可传 num_workers |
| 模块装载 | 同上 run_concurrently() | 每个持参模块 | TLLM_LOAD_WEIGHTS_NUM_WORKERS,或 TRT_LLM_DISABLE_LOAD_WEIGHTS_IN_PARALLEL 关闭 |
| rank-striped 预读 | RankStripedReadAheadSession 的线程池 | 节点内每个 extent 块 | 由 distribute_worker_budget() 分配 |
第一、二两层共用同一个工具函数,但控制的是不同的东西:读盘线程池控制「同时有几个文件在读」,模块装载线程池控制「同时有几个模块在做 slice[:] 和 copy_」。之所以要分开,是因为它们的瓶颈不同——读盘线程多,会加快 I/O 并行、但不会增加物化后的常驻张量数;模块装载线程多,会同时物化更多模块的权重,直接抬高峰值内存。把两者混成一个参数,就失去了「只加 I/O 并行、不抬内存」的调节能力。
装载模块的并发度是可调的,_get_load_weights_num_workers() 对应环境变量 TLLM_LOAD_WEIGHTS_NUM_WORKERS:
env_name = "TLLM_LOAD_WEIGHTS_NUM_WORKERS"...if num_workers <= 0: raise ValueError(f"{env_name} must be a positive integer, got {value!r}")源码里的注释交代得很直白:设置的正整数会换来装载并行度,但会占用主机内存;变量必须严格校验,因为「写错了不该看起来像生效了」。另外还有 TRT_LLM_DISABLE_LOAD_WEIGHTS_IN_PARALLEL 这个「完全关闭并行」的开关,优先级高于 worker 上限,一般用于排查竞态。注释建议在多个 rank 共享受限 cgroup 时调低该值,并按节点 memory.peak(看不到共享页缓存)而非单进程 RSS 来校准。
谁来调用装载器:ModelLoader 的 session 与分档
装载器不是被直接调用的。ModelEngine 在 load_model() 里把装配工作交给 ModelLoader,后者通过一个上下文管理器包住整个「装载 + 物化」过程:
with _timed_checkpoint_weight_session(checkpoint_loader, checkpoint_dir, ...) as weights: weights_preloaded = checkpoint_loader.is_weights_preloaded() self.weight_mapper = checkpoint_loader.get_initialized_weight_mapper(model, config) ... self._call_load_weights(model.load_weights, weights, self.weight_mapper)_timed_checkpoint_weight_session() 在 __enter__ 时打开 session、在 __exit__ 时关闭,并把「准备」与「收尾」两段时间分别记进指标。这个设计解决了两件事:一是 rank-striped 预读线程必须活过物化阶段(前文已述);二是让「惰性句柄、预读 fd、节点级通信组」有一个明确的关闭点。_open_checkpoint_weight_session() 还做了一层鸭子类型兼容:如果装载器类没有 open_weight_session,就退回一个「只 yield load_weights() 结果」的 legacy session,保证旧格式装载器不被这套接口拖死。
load_weights_kwargs 里除了目录与 mapping,还会按需带上 model_config、load_config 与其它格式参数;get_initialized_weight_mapper(model, config) 则拿到与「模型类 + checkpoint 格式」匹配的 mapper,再交给 _call_load_weights()——它用 inspect检查模型load_weights的签名里有没有weight_mapper` 参数,有才传。这正是前文「有 mapper 就走 v2、没有就走兼容」分支的上游来源。
同一套 session 机制也用于投机解码的草稿模型:_materialize_draft_checkpoint_weights() 对 speculative_model 再走一遍,草稿模型没有独立配置时直接复用目标模型的 mapper 与权重。
影子装载计划:先验证、再启用
load_weights 上面还有一层可选的影子计划(TRTLLM_SHADOW_WEIGHT_LOAD_PLAN=1)。_inspect_shadow_weight_load_plan() 会构造 checkpoint 目录(build_checkpoint_catalog),再让 mapper 基于目录生成一份 WeightLoadPlan,并做 plan.validate_against(catalog) 的一致性校验,把 coverage(需要哪些张量、由谁供)、ordering(读取顺序)与张量总数打进日志。它的默认行为是只观察:校验失败只打 warning,绝不会让原本成功的装载变成启动失败。
这是一个值得借鉴的工程模式:新一版的装载计划在真正接管之前,先在旧路径旁边「演练」一遍,用日志比对「计划认为需要的」与「磁盘上实际有的」。等计划稳定后,再把执行权切过去。
权重缓存
HfWeightLoader 还有一层进程内权重缓存:用「分片列表 + 指纹」作缓存键,装载完成的一组权重可以在后续重复装载中直接复用。_tensor_sig() 给出的指纹是「形状 + dtype + 跨步采样至多 1024 个元素的 float 求和」:对未修改的内存重算求和是确定性的,所以它能检测出原位修改,而采样让每个张量只花微秒级时间。
命中时的校验更值得看。缓存的张量跨次装载共享,若某个 mapper 或预处理在原位改了张量,污染会被带到之后所有装载里。_get_cached_weights() 因此在返回前重算一遍指纹,发现被改就点名打印前五个键、删掉条目、从磁盘重新装载。把「契约被破坏」变成「检测到并自愈」,比静默复用稳得多。返回时还会重新包一层 ConsumableWeightsDict(dict(weights))——装载方会调用 mark_consumed,删的是这次包装的键,而不是缓存里的条目。
缓存条目数默认是 1,由 TRTLLM_HF_WEIGHT_CACHE_MAX_ENTRIES 调整;源码注释提醒:每个条目会把一份完整原始权重钉在 CPU 内存里,所以默认值刻意保守(启用开关本身是 TRTLLM_HF_WEIGHT_CACHE)。对单次装载没有影响,但在 router 或多模型服务中能省一轮完整读盘。
不过缓存与懒加载存在冲突,前文那张清单里的一个条件正说明了这一点:分片筛选完成后,缓存一旦启用,_load_weights_in_parallel() 返回的是真正的张量字典,而不是懒切片字典——缓存需要「可复用、可比较指纹的张量」,而不是「绑定到文件句柄的切片」。
并行装载的合并方式
无论急切还是懒加载,分片都是逐文件在 run_concurrently() 里完成的:每个文件交给 load_func 得到一份局部字典,再由 reduce_func=weights.update 合并进同一个全局字典,进度条按文件计数。合并发生在主线程,装载线程只做「读文件 → 返回局部字典」。
这个合并模型有两个前提。第一,各分片之间的键名不重叠——HF 的分片划分保证每个张量只出现在一个文件里,否则后到达的覆盖先到达的,结果取决于线程完成顺序,无法复现。第二,局部字典在合并后可以被丢弃,因为全局字典持有同一批张量,引用计数不会归零。合并完成后再用 ConsumableWeightsDict 包一层,后续模块装载时的 mark_consumed 才有对象可删。
.bin / .pth 单文件格式走同一个并行函数,只是加载器换成 torch.load(..., weights_only=True, map_location="cpu", mmap=True),并在 mmap=True 失败时回退到普通读取——旧式 pytorch 文件是 pickle 格式,张量之间夹着对象结构,不一定支持整文件的 mmap 加载。weights_only=True 则把反序列化限制在张量等安全对象上,避免加载来源不明的 checkpoint 时执行任意 pickle 代码。
分片级预取与 rank-striped 预读
safe_open() 是懒的,load_file() 也只是把映射建立起来;如果每个张量第一次被访问时才去碰磁盘,装载线程会在读页上串行等待。prefetch_files() 在并行装载之前,用「mmap + madvise(MADV_POPULATE_READ)」把所有分片的页提前读进页缓存,不支持 madvise 的平台退回「每文件一个固定大小缓冲区、按块 read」的方式。两条路径都按固定窗口推进,并给出固定节奏的进度日志。
预取的触发有一个明确的启发式:checkpoint 总大小小于可用主机内存的 90% 才预取,超过就不预取,避免把页缓存挤爆后在装载时又连续触发缺页、来回抖动。另外,如果设置了 TLLM_OVERRIDE_LAYER_NUM(只装载部分层),也不预取——因为大部分文件根本不需要。判断「可用内存」在数据并行下要走本地通信组,取各 rank 的最小值,避免一个内存紧张的 rank 被其他 rank 带着一起预取。
这段代码里还埋着一个分布式死锁的教训,注释写得非常直接:enable_prefetch 依赖 psutil.virtual_memory().available,这是一个每个 rank 各自读取、会波动的值,不同 rank 可能选出不同分支;如果把同步屏障(barrier)放在 if enable_prefetch 分支里面,预取的 rank 和跳过的 rank 就会在屏障两边互相等待。正确做法是无条件屏障,跳过的 rank 直接到达屏障、预取的 rank 完成后再到达。
rank-striped 预读:切块轮转、缺页计数与准入
checkpoint_io_policy 有两种取值:native 与 rank_striped_read_ahead。后者是上述预取的升级版,专门解决「多个 rank 同机、共享页缓存」的问题:同一节点上的 N 个 rank 如果各自预取全量 checkpoint,页缓存会被塞进 N 倍数据,最终大部分仍要回落到磁盘;而如果都不预取,装载又被缺页拖慢。
切块与分配:build_local_plan() 把每个文件按固定块大小(_CHUNK_SIZE)切成若干 extent,然后按节点内 local rank 轮转分配:
local_extents = tuple(extents[issuer_index :: len(issuer_ranks)])节点内每个 rank 只负责自己的那一份 extent,合起来恰好覆盖整个 checkpoint 且互不重叠。每个 rank 的读线程数由 distribute_worker_budget() 分配,总量是「每组加载者线程上限」与「每 rank 线程上限 × local_size」取小,再尽量均匀地分给各 rank。
读法:session 用 os.open 拿到只读 fd,然后 os.pread(fd, read_size, offset) 循环读完全部 extent。pread 不带文件偏移状态,多个线程对同一 fd 并发读也不会互相干扰——这是选择 pread 而不是 read 的直接原因。
是否被挤掉:读完一轮并不意味着页还在。_refresh_dropped_pages() 周期性读取节点级 major page fault 计数:如果某个时间窗内节点上的大缺页数超过阈值,说明页缓存已经被别的东西挤掉,所有 rank 一起再读一遍自己的 extent。刷新有递增冷却时间,避免一次抖动触发反复全量读;每次刷新前也重新做一次内存准入检查。
准入与一致性:启动前要对每个 rank 做「文件大小/设备号/inode/修改时间」签名与可用内存的 allgather。签名不一致说明某些 rank 解析到了不同的文件(例如挂载差异),直接报错;任一 rank 判定 eligibility_reason 非空(懒加载类型、缓存启用、部分层装载、内存不足等),整组回退到 native 策略——所有 rank 必须选同一条路径,否则后面的集合通信就对不上。
生命周期:session 依赖 open_weight_session() 这个上下文管理器存活。因为预读线程要在「模型物化」期间持续刷新页,若按普通 load_weights() 同步返回,session 没法跨越物化阶段。注释也说明:在没有 session 的情况下请求 rank-striped,会记录一次 fallback 原因并走 native 路径。
最后,_CheckpointIOStatus 把「请求的策略、实际策略、是否激活、回退原因」记成一条可观测的记录,供启动日志打印。这类「请求值 vs 实际生效值」的分离开销很小,但在排查「为什么我以为开了预读却没效果」时没有它就得抓瞎。
四、交给模型层:两套 load_weights 实现
量化 checkpoint 的命名差异
装载器还要面对「同一份模型,不同量化工具写出的 checkpoint 名字不同」这件事。compressed-tensors 把 NVFP4 权重存成 weight_packed、weight_scale、weight_global_scale、input_global_scale,而 TensorRT-LLM 的 NVFP4 Linear 期望 weight、weight_scale、weight_scale_2、input_scale,并且 global scale 的语义方向相反:前者存的是除数 (FP8_MAX × FP4_MAX) / amax,后者存的是乘数 amax / (FP8_MAX × FP4_MAX)。convert_compressed_tensors_nvfp4_weights() 在装载前完成重命名与求倒数,同时把 0 值 scale 显式映射成 0 而不是 Inf。
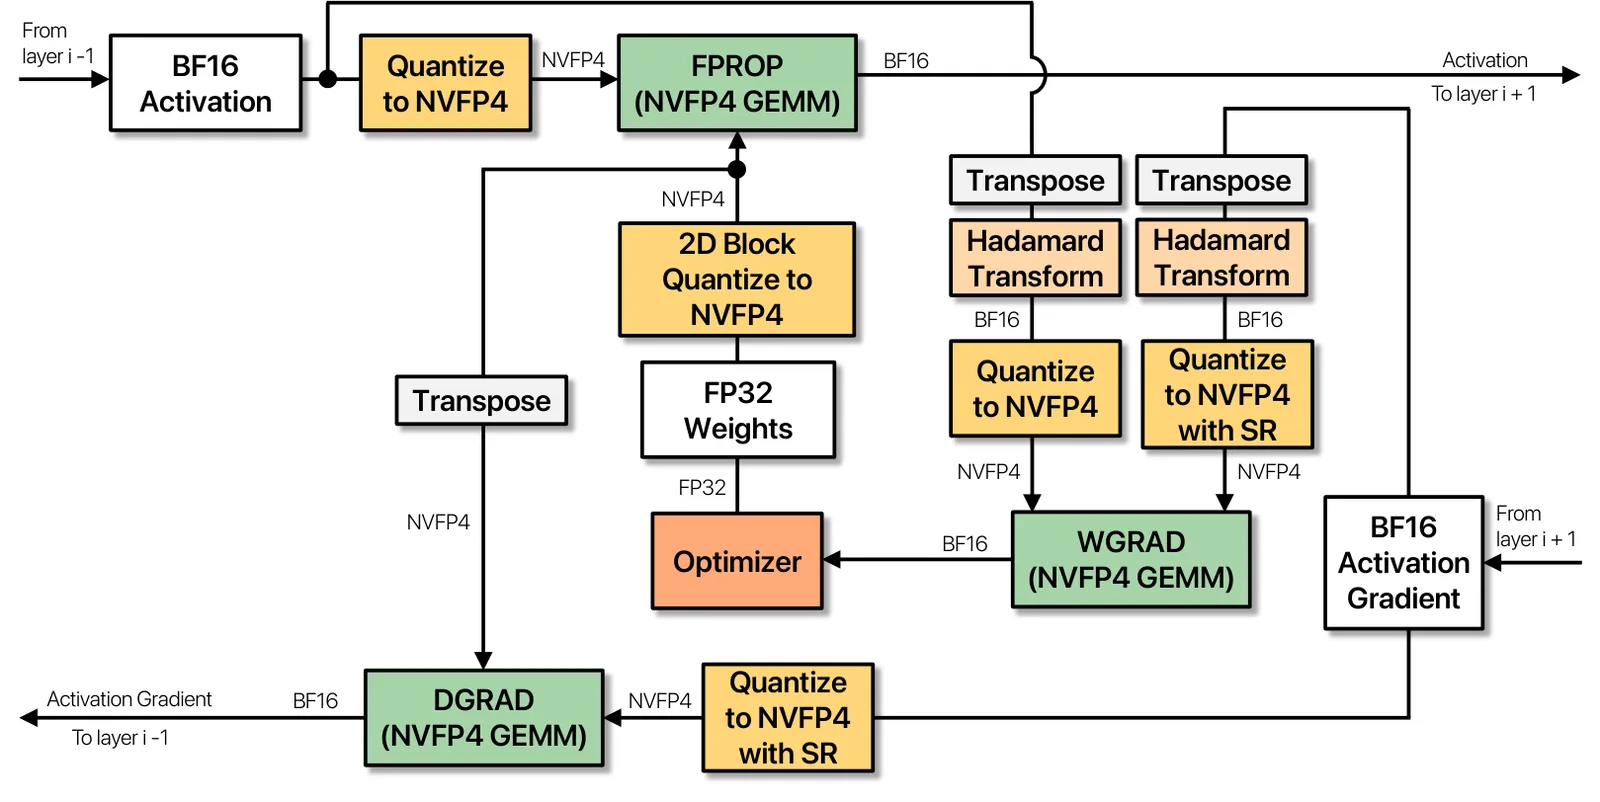
图中权重与激活各自按 16 元素块量化,GEMM 之后乘回两层 scale。装载层只负责把 checkpoint 里的 weight_packed 与各级 scale 按正确名字、正确方向搬进来;真正的布局交错(weight_scale 的 interleave)发生在线性层自己的加载函数里。这张图也解释了为什么转换函数不能简单「改名了事」:global scale 的方向一旦反了,GEMM 结果会整体缩放一个常数倍,数值上看不出异常,只有对照输出才能发现。(图源:NVIDIA《Pretraining LLMs with NVFP4》arXiv:2509.25149)
装载器返回字典之后,工作交给 DecoderModelForCausalLM.load_weights()。它根据是否传入了 weight_mapper 选择两套实现:mapper 路径(_load_weights_impl_v2)与兼容路径(_load_weights_impl)。
if weight_mapper is None: _load_weights_impl(self, weights, skip_modules, params_map=params_map, ...)else: _load_weights_impl_v2(self, weights, weight_mapper, skip_modules, ...)共同的骨架
两套实现共享同一个骨架:
- 可选的
params_map(正则重命名)先对字典做一次改写; - 用
model.named_modules(remove_duplicate=False)拿到模块名到模块的映射; - 对每个直接持有参数的模块(
len(module._parameters) > 0)执行装载; - 能并发就并发,并支持一组
preload_weight_modules串行优先装载(用于 min-latency 的 llama4 类模型,装载顺序影响正确性); - 每个模块装载完后,调用
mark_consumed/mark_consumed_keys释放源键。
remove_duplicate=False 这个参数看起来不起眼,注释里写明原因:next_layer_layernorm 这类模块与相邻层共享参数对象,默认的 named_modules() 会去重、丢掉后者。对装载而言,共享参数并不需要重复装载(p.data.copy_ 会写同一块),但按名字调用模块自己的 load_weights 时,去重会导致某些模块完全不被处理。
mapper 路径:规则收进对象
mapper 路径把「哪些模块要特殊处理、按什么表拆分、拆出来的 K/V 要不要复制」全部收进 HfWeightMapper 这个对象。构造函数里挂了一份回调列表,目前只有一项 _duplicate_kv_weights:
class HfWeightMapper(BaseWeightMapper):
def __init__(self): super().__init__() self._callbacks = [self._duplicate_kv_weights]
def map_weights(self) -> None: self.mapping.update({ 'qkv_proj': ['q_proj', 'k_proj', 'v_proj'], 'gate_up_proj': ['gate_proj', 'up_proj'] })注意融合表 mapping 与兼容路径的 FUSED_MODULE_COMPONENTS 内容一模一样。源码注释也说明了这一点:那张表是唯一事实来源,两条路径都必须从它读,不能各写一份。区别在行为:mapper 路径通过 does_require_special_handling(module_name) 判断当前模块是否在表里,若在则先跑 apply_callbacks()(K/V 头复制就在这里发生),再调用模块的 load_weights;兼容路径则把同样的复制内联在循环里。也就是说,_duplicate_kv_weights 从「代码里的一段特判」变成了「回调列表里的一项」,今后再需要「装载前先做点变换」的模块,只需往回调列表里加一项,不必改循环本身。
跳过规则同样被收进 should_skip_module():tie embedding 时的 lm_head、LoRA 自定义的 embed/lm_head、next_layer_layernorm 都在这里返回 True,最后再调用基类判断。两条路径的跳过集合因此完全一致,只是执行时机不同——mapper 路径在 load_single_module 开头查询,兼容路径在 load_single_module 内部逐条 if 判断。
兼容路径:硬编码融合表
没有 mapper 时,兼容循环里的融合判断直接查 FUSED_MODULE_COMPONENTS:
FUSED_MODULE_COMPONENTS = { 'qkv_proj': ['q_proj', 'k_proj', 'v_proj'], 'gate_up_proj': ['gate_proj', 'up_proj'],}checkpoint 里 q/k/v 是三个独立张量,而模型树里是一个融合 qkv_proj 模块。装载循环看到模块名末段命中这张表,就为每个分量做 filter_weights(),再交给模块自己的 load_weights 去拼接。拼接发生在模块内部,这是 TensorRT-LLM 的通行做法——每一层都把「怎么把多个 HF 张量拼成一个融合布局」封装在自己身上,而不是让通用装载器去猜。
这条路径里还有一个容易被忽视的 GQA 处理:当 K/V 投影要按 TP 切分而 KV 头数少于 Q 头数时,duplicate_kv_weight() 会先把 K/V 权重在头维度上复制到与 Q 头匹配,再交给模块切分。这样列并行的切分逻辑对所有投影一视同仁,不必为 GQA 写特殊分支。
特殊模块名:MoE 的 .backend
模型重构之后,ConfigurableMoE 多了一个 backend 子模块,而 checkpoint 里的 MoE 权重名并不带 .backend。装载循环因此有一个特例:
if names[-1] == "backend" and is_moe_weight_owner(module): name = '.'.join(names[:-1]) names = name.split('.')把模块名末段的 .backend 去掉,退回父模块名去匹配 checkpoint 键。这是典型的「运行时结构比 checkpoint 结构新」的兼容处理——代价是通用装载循环里多了一个针对特定类家族的判断。
消费粒度:为什么不能“反正载完了就整树删”
这是一个容易写错的地方。一个模块的 load_weights 如果接收的是「整个 name.* 子树」,它可以整树消费,因为子树下所有键都由它负责。但如果模块只是走 named_parameters(recurse=False) 直接拷贝自己的参数,它只消费了 name 这一层的少数键,此时不能用 mark_consumed(name) 删整个子树——named_modules() 是前序遍历,子模块尚未处理,子树里它们的键会被提前删除,然后静默地保持未初始化。
源码注释把这一点写得很清楚:
Only a module handed the full `name.*` subtree may consume it wholesale.Otherwise just its own `recurse=False` params were loaded, and since`named_modules()` is pre-order, consuming the subtree would drop weightsits descendants have not loaded yet -- they would silently keepuninitialized weights.因此两套实现都在最后区分两种情况:loaded_own_params is None(模块自己处理了子树)→ mark_consumed(name);否则 → 只 mark_consumed_keys 已装载的 name.param。这条规则直接决定了并发装载是否安全:并发线程之间只要都遵守「只消费自己真正拿走的键」,就不会互相删到对方待用的张量。
跳过的模块
循环里还有几处跳过逻辑,每一处都对应一个具体约束:
skip_modules:投机解码等模块稍后由别的函数装载,这里跳过;tie_word_embeddings且模块名以lm_head开头:lm_head 与 embed_tokens 共享权重,不需要单独装载;- LoRA 启用了自定义 embed/lm_head(
has_custom_embed_tokens/has_custom_lm_head):不覆盖它们; next_layer_layernorm:与下一层共享参数,装载路径跳过。
模型自带的装载器:DeepSeek 系列
并非所有模型都走通用循环。DeepSeek 系列在 DeepseekV3ForCausalLM.load_weights() 里只做一件事——交给自己的 DeepseekV3WeightLoader:
def load_weights(self, weights: ConsumableWeightsDict): weight_loader = DeepseekV3WeightLoader(self) weight_loader.load_weights(weights)注意签名里没有 weight_mapper 与 allow_partial_loading。ModelLoader._call_load_weights() 用 inspect 检查签名后只会传 weights,其它参数一概不传;allow_partial_loading=True 在这种模型上会直接断言失败。这就是「通用装载器的灵活性」与「模型专属装载的精准性」之间的边界。
DeepSeek 装载器为什么要自定义,看 kv_b_proj 这一支就明白了。MLA 的 kv_b_proj 在 checkpoint 里是被拆成两个方向的:一个「把 latent 投到 K_no-pe」和「把 latent 投到 V」拼接而成的矩阵,外加一个转置分量 k_b_proj_trans。自定义装载器做完这些拼接与转置之后,还要:
- 从拼好的
kv_b_proj里切出v_b_proj,再_bind_v_b_proj_weight()绑定到注意力模块的视图上; - 如果模块带
weight_scale,就用同一套切分逻辑处理 scale(scale 沿 head 维度的长度要按 128 个元素一个块折算,即qk_nope_head_dim // 128,否则切出来的 scale 与权重对不上); - 在 TP 与 CP 同时存在时,按
local_num_heads // cp_size再切一次 head。
这一连串操作里有形状算术、有视图绑定、有量化元数据,任何一步出错都不会报错,只会算出错误的注意力。让通用循环去猜这些,不如让模型自己写清楚。
另一个细节:共享 MTP 层不能消费。 当用户要求 max_draft_len 大于 checkpoint 自带的 MTP 层数时,ModelLoader 会把 num_nextn_predict_layers 撑大,多个模型 MTP 层实例通过取模映射到同一个 checkpoint 层。这时如果照常 mark_consumed,第一个实例装完后就会删掉键,后面的实例读不到权重、静默地保持未初始化。DeepseekV3WeightLoader 里的 detect_shared_mtp_weights() 与 is_shared_mtp_layer 判断正是为此:共享层的 mark_consumed 一律关闭,宁可多占一份内存,也绝不能删到别人还要用的键。这和前文「消费粒度」规则是同一种风险的两面。
torch.compile 包装器
如果模型被 torch.compile 包裹过(refit 场景),模块路径里会多出一段 _orig_mod,而 checkpoint 键名没有这段。strip_torch_compile_wrapper(name) 在装载前把它去掉,让键名对得上。
五、一次 HF checkpoint 装载的完整时序
把以上各段串起来,一个 rank 的启动期装载大致是:
1. 模型类解析 architectures[0] → 拿到 DecoderModelForCausalLM 子类2. get_checkpoint_weight_loader(name) → 拿到 HfWeightLoader(或子类)3. 分片发现:glob *.safetensors → sorted4. 判断 _requires_lazy_safetensors: 是 → 逐文件 safe_open,构造 {name: PySafeSlice},句柄挂在 _LazySafetensorsWeights 上 否 → 线程池并发 load_file,拼成一个平铺字典5. (可选) prefetch_files:mmap + 页缓存预热6. (可选) 压缩格式转换(如 compressed-tensors NVFP4 → TRT-LLM 命名),派生字典 take_ownership7. (可选) params_map 正则重命名8. named_modules(remove_duplicate=False)9. 并发(或先串行 preload 再并发)对每个持参模块: a. 按模块名过滤出子字典(filter_prefix / weight_mapper.filter_weights) b. 融合分量或特殊模块逻辑 c. module.load_weights(...) 或 p.data.copy_(...) d. mark_consumed / mark_consumed_keys 释放源键10. 装载完毕:clear() 剩下的键与句柄11. post_load_weights:setup_aliases → transform_weights → cache_derived_state第 11 步值得单独提一句。post_load_weights() 是「装载后」三段式钩子:别名设置(比如让某些模块共享同一份参数的 view)、权重变换(如 MLA 的矩阵吸收、FP8 scale 的布局转换、QKV 的交织重排)、派生状态缓存(如把做好的 RoPE 表、转置后的权重视图挂上去)。这些步骤都发生在「所有张量都已经落到模块参数里」之后,属于模型层的职责,装载器不参与。
工程上的几个坑
坑一:派生字典没有 take_ownership,内存峰值不降。 如果自定义了一个转换函数生成了新字典,但没有清空源字典,那么源字典里每个张量仍被持有,消费派生字典时释放不掉任何东西。代码里 convert_compressed_tensors_nvfp4_weights() 的注释也提醒「其他键原样透传,调用方之后不得再用 weights」。
坑二:并发装载与共享参数。 两个模块共享同一个 Parameter(如 tie embedding)时,两个线程分别 p.data.copy_ 会写同一块内存;内容一致就无害,不一致则结果取决于谁先完成。装载器的跳过规则(tie embedding 跳过 lm_head)正是为了避免这种冲突。
坑三:compressed-tensors 的 global scale 为 0。 NVFP4 转换时,全局 scale 以「除数」形式存储。若原 scale 为 0(表示该专家从未被校准),直接取倒数会得到 Inf。_invert_compressed_tensors_global_scale() 的处理是把 0 显式映射为 0,并注释说明:MoE 层内按专家做 max 归约时,Inf 会赢下所有专家、污染整层的 input scale;而 0 只会让这个死专家的输出为零,无害。
坑四:lm_head 是否被量化。 这不能靠猜,只能读 checkpoint 头部。_checkpoint_has_lm_head_scale() 只读 safetensors 头、不物化张量,就是为了在装载前解决「lm_head 要不要按量化配置构造」的问题。如果误判,会出现「权重里多了一层 scale、模块里少了一个量化层」或者反之。
坑五:跨 rank 分支不一致。 本文出现了三处「每个 rank 必须走同一分支」的地方:_requires_lazy_safetensors() 的解析异常必须向上抛;预取判定依赖各 rank 不同的可用内存,所以屏障必须无条件;rank-striped 的 eligibility 用 allgather 汇总,任一 rank 不合格就整组回退。它们的共同根源是:只要某个分支里含集合通信,或者后续步骤依赖「参与者数量一致」,就不能容忍 rank 间的选择差异。排查加载期 hang 时,先 grep 这些「分支里是否有集合通信」,往往比盯着集合通信库本身更有效。
坑六:inspect 判定签名。 _call_load_weights() 只在签名里明明有 weight_mapper 时才传该参数,而像 DeepseekV3ForCausalLM 这样自带装载器的模型接收的是 ConsumableWeightsDict。这意味着给这类模型打开 allow_partial_loading 会直接断言失败,而不是被忽略。写自定义装载路径时,签名本身就是一份契约声明,比在函数体里用 **kwargs 兜底更不容易被误用。
坑七:惰性字典 + 多线程。 PySafeSlice 本身是「单次物化」的轻量对象,多次物化同一键会各自拷一份数据。装载器在字典层没有做「切片结果的去重缓存」,去重是在模块层完成的——每个模块的键只被物化一次(或被融合后合并)。如果某个通用工具函数对同一个键调用了多次 slice[:],就会浪费一份内存带宽与内存,但不会导致错误。
小结
从磁盘上的分片目录到模块参数,TensorRT-LLM 的 HF 装载层用的是几个朴素但配合紧密的机制:有序目录让「键名是否存在、在哪个分片」变成 O(log N) 查询;懒切片让字典里的值变成「可物化的指针」而非数据;可消费字典配合 前缀索引二分,让边装边删成为现实;派生字典 take_ownership 保证释放不落空;并发读盘 + 消费粒度规则 则让多线程装载既快又不会互相误删。模型层接过去之后,post_load_weights 的三段钩子才真正把「张量」变成「推理时可直接调用的布局」。
下一阶段回到 SGLang 与 vLLM 侧的横向对照:同样一份 HF checkpoint,它们的装载器在分片定位、命名映射与 TP 落位上有不同取舍,可以拿这里的机制作为参照。
参考资料
站点延伸阅读
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



