


FlatCake 数据面工程拆解:GDS 直达、NVMe 布局与 64 位统一地址
写在前面:从机制图再往下走一层
FlatCake 的架构动机与 FC-GVA、FC-MAS、FC-CIO 三个组件的职责划分,可参考 FlatCake 完全拆解:把 DRAM 与 SSD 拉平成同一层 KV 存储。那篇回答的是「为什么要把主机 DRAM 与 NVMe SSD 当作对等介质」,以及三个组件各自在控制面上解决什么问题。
沿同一条数据路径再往下走,会碰到另一层问题:一个块键从基数树里被查到之后,究竟怎样变成一次 cuFileBatchIOSubmit,NVMe 设备收到的是什么形状的请求,数据又怎样落进 GPU 上一块固定的暂存窗口;64 位全局虚拟地址(Global Virtual Address,GVA)除了「省一次查表」之外,还改变了哪些工程约束;以及当这套结构真的部署到一台机器上时,PCIe 拓扑、文件系统 extent、SSD 垃圾回收和引用计数会以什么方式反噬设计。
论文(arXiv:2610.38355,2026 年 10 月 28 日提交)在实现章节只用了四段话描述这些细节。这四段话背后是 Linux I/O 栈、NVIDIA GPUDirect Storage、NVMe 协议与 CUDA 流语义的组合,值得单独展开。
一次 SSD 恢复的完整调用链
把「SSD 命中」这个词拆开,实际上是一串跨进程、跨内核、跨总线的动作。下面这条链路对应论文 Figure 5(c)(iii) 的第三条恢复路径,也就是 FlatCake 在重负载下真正走的那条。
- 前缀匹配。请求进入 SGLang 的调度器后,基数树(radix tree)按页粒度匹配已有前缀。DeepSeek-V4-Flash 的页大小是 256 token,因此一次匹配返回的是一串页号,而不是一段连续 token。匹配在第一个缺失页处停止——这一点后面会反复用到:前缀命中天然是连续的一段,中间不会出现「跳过一页继续命中」的情况。
- 块键翻译。每个页号连同会话 ID、层号组成块键,送进 FC-GVA 的一级索引。索引是一张驻留主机 DRAM 的开放寻址哈希表,一次 64 位原子比较交换(compare-and-swap,CAS)读就能拿到不可变的 64 位 GVA。调度线程在这条路径上不加锁。
- 按介质分类。FC-MAS 取这串 GVA 的最大值:小于 说明全部落在主机 DRAM,请求进 DRAM-Ready 队列立即派发;只要有一个大于等于 ,请求进 SSD-Preparing 队列。混合请求(共享系统提示词在 DRAM、会话历史在 SSD)按最慢介质归类。
- 描述符合并。FC-CIO 拿到的是几百到几万个块描述符,每个描述符包含
gpu_file_id、文件内偏移、字节数和目标 KV 槽号。它先按(gpu_file_id, offset)排序,再线性扫描合并相邻区间,把小于 64 KiB 的空洞桥接掉。合并后的描述符按轮转分给工作线程。 - 提交 GDS 读。每个工作线程持有私有的
CUfileHandle_t、CUDA stream 和 batch 句柄,调用cuFileBatchIOSubmit把一批读请求交给 libcufile。这一步是异步的:提交线程不等待数据落地。 - 内核与设备。
nvidia-fs内核模块把请求翻译成对 NVMe 设备的 DMA;在完整 GDS 模式下,数据从 SSD 直接写进 GPU 的 BAR1 映射窗口,不经过主机内存。I/O 完成状态由cuFileBatchIOGetStatus轮询或由完成线程回收。 - 散射进分页槽位。合并读落进的是连续的暂存窗口,而 SGLang 的 KV 池页在 HBM 上并不连续。一个轻量 CUDA scatter 内核按 256 token 页把数据从暂存窗口拷进目标槽位,再用
cudaEventRecord与cudaStreamWaitEvent和计算流对齐。 - 重新准入。所有层的前缀都到位后,请求按原始到达时间戳插回 DRAM-Ready 队列,而不是排到队尾。
这条链路上每一段的耗时量级完全不同,值得列成一张表:
| 阶段 | 执行位置 | 典型量级 | 是否与上下文长度成正比 |
|---|---|---|---|
| 基数树匹配 | CPU,调度线程 | 微秒到毫秒 | 是,按页数增长 |
| 块键到 GVA | CPU,哈希表读 | 亚微秒每块 | 是,按块数增长 |
| 排序合并 | CPU,提交线程 | 毫秒 | 是, |
cuFileBatchIOSubmit | 用户态到内核 | 每次提交数微秒 | 是,按批次数增长 |
| NVMe DMA | 设备与 PCIe | 由字节数和队列深度决定 | 是 |
| scatter 内核 | GPU | 数十微秒每层 | 是,按层内字节数 |
| 事件同步 | GPU 流 | 微秒 | 否 |
把这条链路写成式子,一次恢复的墙钟时间是:
其中 又可以写成:
是这次恢复的字节数, 是该请求实际分到的有效带宽, 是 NVMe 读命令数, 是每条命令的固定开销。FlatCake 的两个布局设计分别作用在这两项上:层优先布局把 从 压到 ,有界窗口与双队列则让 不会因为队头阻塞掉到接近零。
用论文的数据代入,可以看到一个容易被忽略的事实。DeepSeek-V4-Flash 每个 rank 每 token 的 KV 是 7.5 KiB,生产轨迹里单请求历史 KV 的中位数是 0.52 GiB、均值 0.80 GiB。若把 5 GB/s 当作这条恢复路径可独占的带宽,0.80 GiB 只需要约 0.17 s。但论文在 1.0 QPS 时测到的平均 SSD 预取延迟是 1.64 s。差了近十倍,说明恢复延迟根本不是「字节数除以带宽」:5 GB/s 要在多个 rank、多个在途恢复之间分摊,再叠加排队、窗口等待和长尾会话,单个请求能拿到的有效带宽远低于设备侧观测值。只盯着 SSD 顺序读带宽做优化,会错过真正的大头。
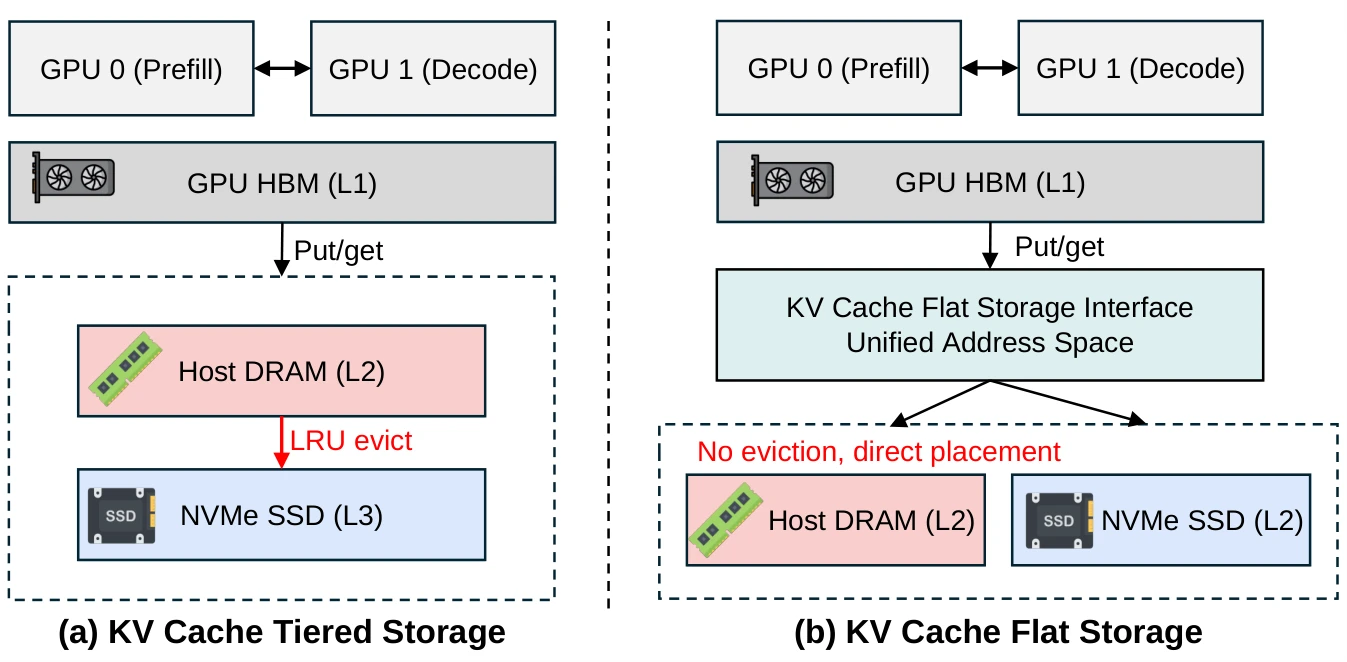
图源:FlatCake 论文(arXiv:2610.38355),Figure 1。左侧是分层结构:块先进入主机 DRAM,只有在 LRU 淘汰时才到达 SSD;右侧是扁平结构:块在创建时直接写入目标介质,之后不再迁移。两者服务同一组 prefill/decode GPU,区别只在「谁决定块的长期归属」以及「这个决定发生在什么时候」。
这张图值得从数据面的角度重读一遍。分层结构里,SSD 上的字节布局是淘汰顺序的副产品:哪个块先被挤出 DRAM,哪个块就先落盘。扁平结构里,SSD 上的字节布局是消费顺序的直接映射:prefill 先消费第 0 层,写入时就先把第 0 层放好。前者产生随机小读,后者产生顺序大读。传输原语相同,结果相差数倍,原因全在写入时的那一次布局决策。
GPUDirect Storage 省掉的两次拷贝
理解 FlatCake 为什么能在 SSD 上跑出 5 GB/s,需要先理解 GPUDirect Storage(GDS)到底改了什么。它并不是一个新的存储协议,而是把「谁来做 DMA」这个问题换了个答案。
普通文件读的三段路
在没有 GDS 的系统里,一次「SSD 到 GPU」的传输,数据至少要经过三段:
SSD ──DMA──▶ 主机内存(页缓存 / 用户缓冲)──CPU 或 cudaMemcpy──▶ GPU HBM第一次搬运用的是存储设备的 DMA 引擎,目标是主机内存;第二次搬运用的是 GPU 的 DMA 引擎(由 CPU 编程的拷贝引擎),源是主机内存。两次之间,数据必须落在主机内存里,因为 GPU 的 DMA 引擎只能寻址主机内存和自己的显存,无法直接寻址 NVMe 设备背后的介质。NVIDIA 的 GDS 设计文档把这层中间缓冲称为 bounce buffer,并明确指出这是 GPU 拷贝引擎的固有限制。
这带来两个后果。第一是带宽被主机内存链路夹住:单块 PCIe 4.0 NVMe 的顺序读约 7 GB/s,八块 RAID-0 的聚合带宽已超过 50 GB/s,而主机到 GPU 的 H2D 单跳实测只有 25–32 GB/s。分层路径把 SSD 读与 H2D 串成两跳,恢复带宽的上限就被压到 H2D 一侧,中间还要额外占用主机内存。第二是占用主机内存——这正是 FlatCake 要彻底去掉的东西,因为在途暂存的需求是 。
GDS 把 DMA 引擎换成「离存储近的那个」
GDS 的思路是:既然 GPU 的 BAR1 窗口(显存映射到 PCIe 地址空间的那一段)可以被别的 DMA 引擎寻址,那么让离存储更近的 DMA 引擎直接写显存即可。NVIDIA 文档描述得直白:NVMe 盘、网卡、RAID 卡都有自己的 DMA 引擎,只要允许它们对 GPU 显存发起 DMA,就无需经过主机内存。
但文件系统这一层挡在中间:操作系统不支持把一个 GPU 虚拟地址直接传进文件系统调用。GDS 的解法是引入 nvidia-fs 内核模块作为「GPU 地址与文件映射之间」的翻译层。用户态通过 libcufile 发起请求,nvidia-fs 把文件偏移翻译成设备 LBA,并把 GPU 显存缓冲区登记为 DMA 目标;NVMe 驱动拿到的是「目标地址在 GPU 上」的描述符。
这条路径省掉的是拷贝,但没有省掉 CPU 提交。每一次 GDS 调用的发起仍然在 CPU 上:组装 I/O 参数、陷入内核、由 nvidia-fs 翻译。所以 GDS 解决的是数据搬运的效率,而批量 API 与多线程提交解决的是提交路径的效率。两者不能互相替代——这解释了为什么 FlatCake 同时需要 GDS 和排序合并。
两种执行模式与 align 约束
libcufile 内部有两条路径,选哪条取决于注册缓冲是否满足对齐与大小要求:
- 完整 GDS 模式:数据由存储侧的 DMA 引擎直接写入已注册的 GPU 缓冲。
- 兼容模式:无法满足条件时(例如文件偏移或缓冲未按 4 KiB 对齐,或者批量 I/O 的尺寸超过 libcufile 的 bounce buffer(
properties.per_buffer_cache_size_kb)),数据退回经由主机内存中转。
兼容模式不会报错,只会悄悄变慢。这是 FlatCake 在实现章节里反复强调对齐的原因:GPU File 内的所有逻辑块偏移、GPU 暂存缓冲的每一个切片,都对齐到 4 KiB 边界。以 DeepSeek-V4-Flash 为例,SGLang 的页是 256 token,单个 token 在 43 层上的 KV 合计 7.5 KiB,所以一个页跨全部层是 ,恰好是 4 KiB 的整数倍。但层优先布局会把这个页按层切开:一层只有约 44.7 KiB,并不是 4 KiB 的整数倍。这意味着实现必须显式地把每层的块区间向上取整到 4 KiB,而不能假设「页大小对齐就万事大吉」。只要有一层的切片没有补齐,那次写入就会退回兼容模式。一个看似无关的页大小与 KV 格式,会通过单层切片的对齐性决定存储路径走完整模式还是兼容模式,这是跨层设计里很典型的一类耦合。
batch API 的真实语义
libcufile 的批量接口有三个关键调用,理解它们的语义就能理解 FC-CIO 为什么按 worker 线程组织:
/* 1. 建立 batch 句柄,声明最大条目数 */CUfileError_t cuFileBatchIOSetUp(CUfileBatchHandle_t *batch_idp, int max_nr);
/* 2. 异步提交一组 I/O:每个条目有各自的文件、文件偏移、GPU 指针与字节数 */CUfileError_t cuFileBatchIOSubmit(CUfileBatchHandle_t batch_idp, unsigned nr, CUfileIOParams_t *iocbp, unsigned int flags);
/* 3. 轮询完成状态,拿回每个条目的字节数与错误码 */CUfileError_t cuFileBatchIOGetStatus(CUfileBatchHandle_t batch_idp, unsigned int min_nr, unsigned int *nr_events, CUfileIOEvents_t *events, struct timespec *timeout);有两点需要说清楚。第一,cuFileBatchIOSubmit 本身是异步的——它只是把请求排进 nvidia-fs,返回时数据尚未落地;真正的完成状态要靠 GetStatus 回收或事件通知。第二,max_nr 受驱动属性 properties.io_batch_size 约束,不是可以无限开大的。因此 FC-CIO 选择「每个 worker 一个私有 batch 句柄」:与其所有线程共享一个巨型 batch(完成事件回收会串行化),不如让各线程各自提交、各自回收,用轮转方式平衡负载。
论文里 cuFileHandle、cuFileBatchIOSubmit 的写法就是这个结构的简化描述:每个工作线程持有自己的 CUfileHandle_t、CUDA stream 和 batch 句柄,彼此之间没有锁。
为什么 GDS 单独打开不够
论文在 Llama-3.1-70B 的跨模型实验里放了对照组 Mooncake-GDS:保留分层的淘汰顺序落盘,只把 SSD 读路径换成 GDS。在 16K 上下文时两者几乎持平(2.31 s 对 2.32 s);到 64K 时 Mooncake-GDS 退化到 6.60 s,比 FlatCake 的 3.74 s 慢 1.8 倍。
这组对照把「传输原语」与「磁盘布局」两个变量分开了:
| 变量 | 只换 GDS | FlatCake |
|---|---|---|
| 传输原语 | 存储侧 DMA 直达显存 | 存储侧 DMA 直达显存 |
| 磁盘布局 | LRU 淘汰序,碎片化 | 会话连续、层优先 |
| 命令数 | ||
| 主机内存占用 | 仍有分层缓冲 | 无 |
GDS 的 scatter-gather 列表只能把数据分散到不连续的 GPU 页,前提是源字节位于一段连续的 LBA 上。这句话是理解整篇的关键约束:GPU 侧可以碎,SSD 侧必须整。分层结构恰好把 SSD 侧写碎了,于是 GDS 再好也只能发一堆小读,每条小读都要一次提交、一次 DMA 描述符、一次完成事件。上下文越长,命令数越多,固定开销占比越大。
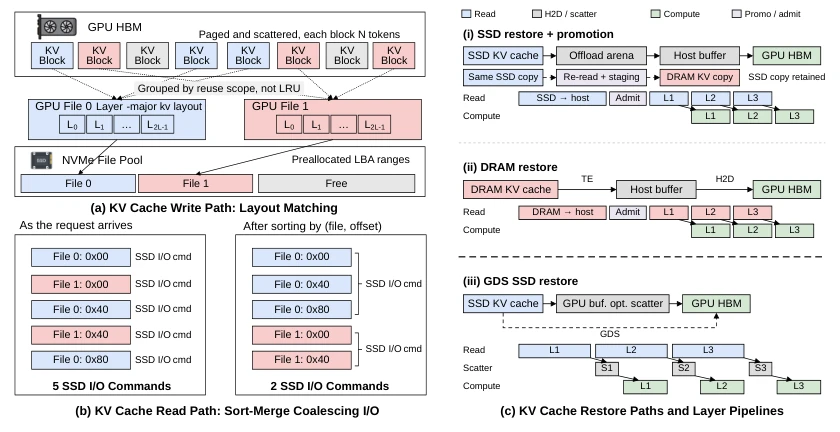
图源:FlatCake 论文(arXiv:2610.38355),Figure 5。(a) 写时的层优先会话布局:同一会话的块在一个 GPU File 内按层排列,映射到 NVMe File Pool 中预分配的单 extent 文件;(b) 读时的排序—合并:五个块描述符按文件与偏移排序后合并成两条 I/O 命令;(c) 三条恢复路径——(i) 带晋升的分层 SSD 恢复,(ii) 经主机缓冲的 DRAM 恢复,(iii) 层流水线的 GDS 恢复,数据流进有界的 GPU HBM 窗口,然后可选散射或直接旁路。
有界 GPU 窗口与回压
FlatCake 把「暂存」从主机内存挪到了 GPU 显存,但并没有取消暂存。区别在于,GPU 上的这块临时区是固定大小、启动时分配一次、所有请求共用的,而不是每个在途请求各占一份。
窗口尺寸的推导
论文给出的尺寸是「每个活跃流两层」,即双缓冲:
其中 是一层在 SSD 上的合并区间字节数, 是活跃的恢复流数量。 由页大小、每 token 每层 KV 字节数与最大可恢复前缀长度共同决定:
以 DeepSeek-V4-Flash 为例:每 token 每 rank 的 KV 是 7.5 KiB,分摊到 43 层后每层约 字节; token。一个 128K token 的前缀在一层上有 512 页,单层区间约 。双缓冲即约 46.8 MB 每流;8 条恢复流合计约 357 MiB,相对 180 GB 的 HBM 仍然只占约 0.2%。
对比分层结构的 :在同一条生产轨迹里,单请求历史 KV 的均值是 0.80 GiB 每 rank,八卡合计的 P90 足迹达 16.0 GiB。只要两条长会话的恢复同时在途,分层结构就需要在主机上预留多个 GiB 的暂存池。这就是论文观察到的瓶颈一的成因。
为什么是两层而不是一层
如果只有一层缓冲,流水线就会退化成串行:
因为计算流必须等 I/O 流把这一层写完、scatter 完,才能开始这一层的注意力;而 I/O 流又要等上一层 scatter 完成才能复用缓冲。双缓冲后,第 层的计算与第 层的 I/O 重叠:
两层的选择是最小可用深度:再深会增加显存占用与 scatter kernel 的调度压力,而收益在 I/O 已经完全被计算掩盖之后就不再增长。论文没有给出窗口深度敏感性实验,但从量纲上看,只要 不大于 ,两层足够。
这里有一组决定流水线含义的比例关系。对一个 128K 前缀做恢复时,单层区间约 23.4 MB,在该请求分到的带宽下需要数毫秒;同一层的注意力与 FFN 计算在 B200 上量级是几十到几百微秒。也就是说 I/O 依然慢于计算,流水线能掩盖的只是启动和散射开销,整体恢复时间仍近似等于 SSD 传输时间。扁平化做的是让这个传输时间接近顺序带宽,而不是让传输消失。
回压:等待而非撤销
窗口固定,意味着并发恢复一旦超过窗口容量就必须排队。FlatCake 的选择是在 CUDA 流事件上等待,而不是撤销在途预取去重算。按论文的交付口径,这个选择直接反映在高负载下的命中率上。
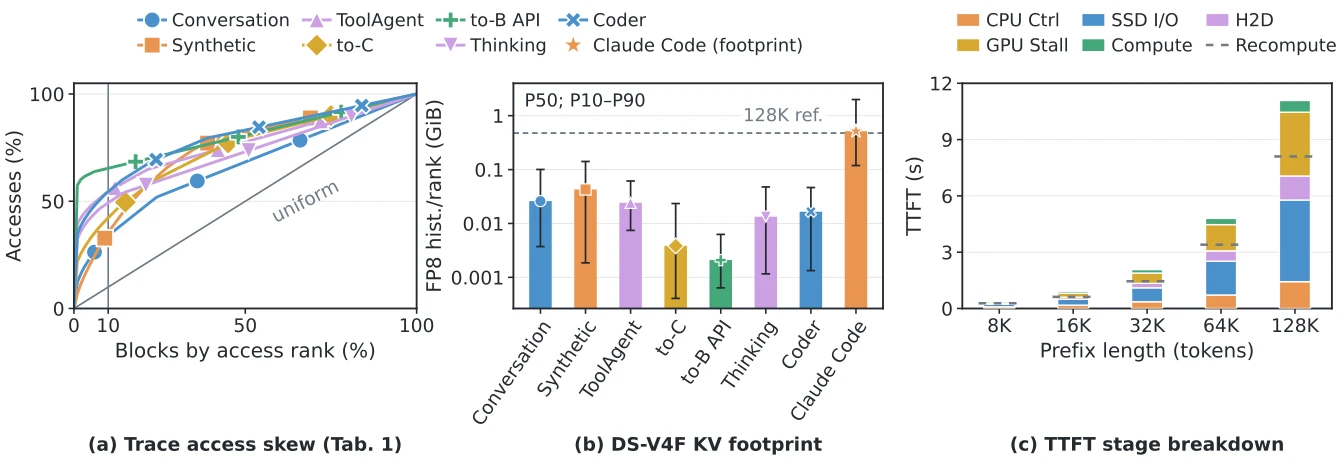
图源:FlatCake 论文(arXiv:2610.38355),Figure 2。(a) 七条非 Agent 轨迹的块访问累计分布,前 10% 的块承担 34–65% 的访问;(b) DeepSeek-V4-Flash 上各轨迹单请求历史 KV 在单个 GPU rank 上的足迹,中位数 0.52 GiB、均值 0.80 GiB,P90 达 16.0 GiB;(c) 分层 SSD 恢复与全量重算的 TTFT 阶段拆解,横跨 8K–128K 上下文。
其中 (b) 和 (c) 解释了回压策略的必要性。足迹图说明单请求就可能吃掉数 GiB 主机内存,暂存池几乎必然不够;阶段拆解图说明一旦 SSD I/O 与 H2D 在 TTFT 中占到大头,任何「撤销后重算」都会把 IO 成本换成计算成本,而且这个计算成本随上下文长度增长得更快——64K 以后重算的代价已经超过了从 SSD 恢复。
用公式表达这两种处理方式的期望代价。设恢复一个块序列的 I/O 时间为 ,在 GPU 上重算同一序列的时间为 。
- 撤销策略:付出的代价是 ,且命中的 KV 块被作废;
- 等待策略:付出的代价是在流水线内的排队时间 ,但命中被保住了。
当 时,等待严格占优。论文的实验正是这个区间:64K 时 Mooncake-GDS 的 TTFT 是 6.60 s,而它本可以靠已经算好的 KV 更快完成。另一侧的代价是尾延迟——等待会让某些请求多等一会儿,因此 FC-MAS 才需要双队列把不需要等待的 DRAM 命中分离出去。两条机制是配套的:窗口提供回压,双队列保证回压只落在该等的请求上。
NVMe 上的布局数学
FC-CIO 的布局设计可以完全用命令数来量化,不需要复杂的模型。这一节把「层优先布局为什么能把读命令从 降到 」算清楚,并进一步说明实际合并率为什么达不到理论上限。
记号
- :模型层数。DeepSeek-V4-Flash 为 43 层。
- :前缀在 SSD 上的块数,按写入时的块粒度计。
- :页大小(token 数),256。
- :前缀的 token 数,, 是页数。
- :每 token 在全模型所有层上的 KV 字节数,7.5 KiB;每层为 ,约 178 字节。
碎片情形:
先看分层结构。写入时按 LRU 淘汰顺序落盘,同一会话的块被拆散到不同 LBA 区间。读命令来自两条约束的叠加:
- NVMe 读命令只能覆盖一段连续的 LBA;
- 每个 KV 页在 SSD 上是分块存储的,块与块之间可能不相邻。
如果按块粒度发命令,命令数为
如果按页粒度发命令(每页在一层上是 KiB,属于同一个块,因此可以直接覆盖整页),命令数为
两个数在 时等价。以 43 层、128K token(512 页)为例:
这还只是一个请求、一个前缀的命令数,而且这里假设每页在每层上恰好落入一个块——对 256 token 的页这是理想的、最宽松的情形。论文在 motivation 部分写的 就是这个量级。每条命令都有固定的提交与描述符开销;即便 NVMe 深度足够,CPU 侧的提交也会成为瓶颈。这也是论文引用的实测现象:SSD 带宽大幅提升后,吞吐只得到远小于线性比例的收益——因为限制不在设备,而在提交路径和碎片化。
理想情形:
层优先布局把同一会话、同一层的所有块安排成一段连续 LBA。于是每一层只需要一条读命令:
同样 43 层、128K token 的前缀,命令数从 22,016 降到 43,约 512 倍。这不是带宽提升了 512 倍,而是每条命令覆盖的字节数从约 44.7 KiB(一页在一层上的字节数)变成整层约 23.4 MB。设备侧看到的是一次大顺序读,队列深度对单个请求已不重要;重要的是多条请求之间的公平。
合并率:理想值与现实的差
理论上限的前提是「所有请求的前缀恰好是整页对齐、无洞、同会话」。现实中 FC-CIO 面对的是排序后合并的描述符集合,合并率定义为
其中 是输入描述符数, 是成功拼接的次数。合并只在两个条件同时成立时发生:
- 两个描述符属于同一个 GPU File(即同一会话作用域);
- 后者的文件偏移恰好等于前者的偏移加字节数(或差距小于 )。
设两个物理相邻的描述符之间存在空洞的概率为 ,则每层的期望命令数为
是超过桥接阈值的那部分空洞概率。 KiB 的作用就是把这个概率压低:只要空洞不超过 64 KiB,多读一小段顺序字节即可,命令不拆。
这个式子揭示了一个反直觉的结论:合并率对 并不单调。增大阈值会让更多空洞被桥接,减少命令数;但多读的字节会增加 SSD 流量,而多读的字节在 SSD 上通常不是「免费」的——它消耗带宽、可能触发读放大。论文没有做这个阈值的敏感性扫描,从量纲上看,64 KiB 大致相当于「一条 NVMe 命令传输 64 KiB 数据所需时间的数十分之一倍」,是一个保守的中间值。
写时的单 extent 为什么重要
层优先布局能够物理成立,依赖一个容易被忽略的文件系统条件:连续的逻辑偏移必须映射到连续的物理 LBA。在 XFS 上,这等价于文件是单 extent 的:一个文件的全部数据占据一段连续的分配。
如果文件被多次 write 追加,文件系统可能把它分到多个 extent,中间夹着别的文件;此时即使逻辑偏移连续,cuFileBatchIOSubmit 拿到的 LBA 也不再连续,合并会退化成多次设备命令。FlatCake 的做法是启动时用 fallocate 在 XFS/RAID-0 阵列上预分配一组固定大小的单 extent 文件,再以 O_DIRECT 打开。这样就排除了运行期的元数据分配与 extent 碎片。
还有一个副作用来自 RAID-0 的条带大小。若条带为 128 KiB,而一层的区间跨越多个条带,设备看到的就是对多块盘的并行读——这是好事;但如果区间小于条带,就会退化成只读一到两块盘,单请求带宽下降。因此层区间的字节数最好显著大于条带尺寸。上面算出的 128K 前缀每层约 23.4 MB,远大于条带,这个条件满足。
另一个设备侧的因素是 SSD 的垃圾回收(garbage collection,GC)。写时直放意味着每个块只写一次、只读多次,一个会话的 extent 一旦写入就不再改动,对 GC 非常友好:GC 只需要搬运低频更新的空闲空间。相反,分层结构的 FIFO 桶回收会反复改写桶,加剧 GC 写放大。论文报的写放大 (FlatCake)对 Mooncake 在保留缓存状态下的 –,差值的量级不大,但对闪存寿命和后台 GC 抖动有实际意义。
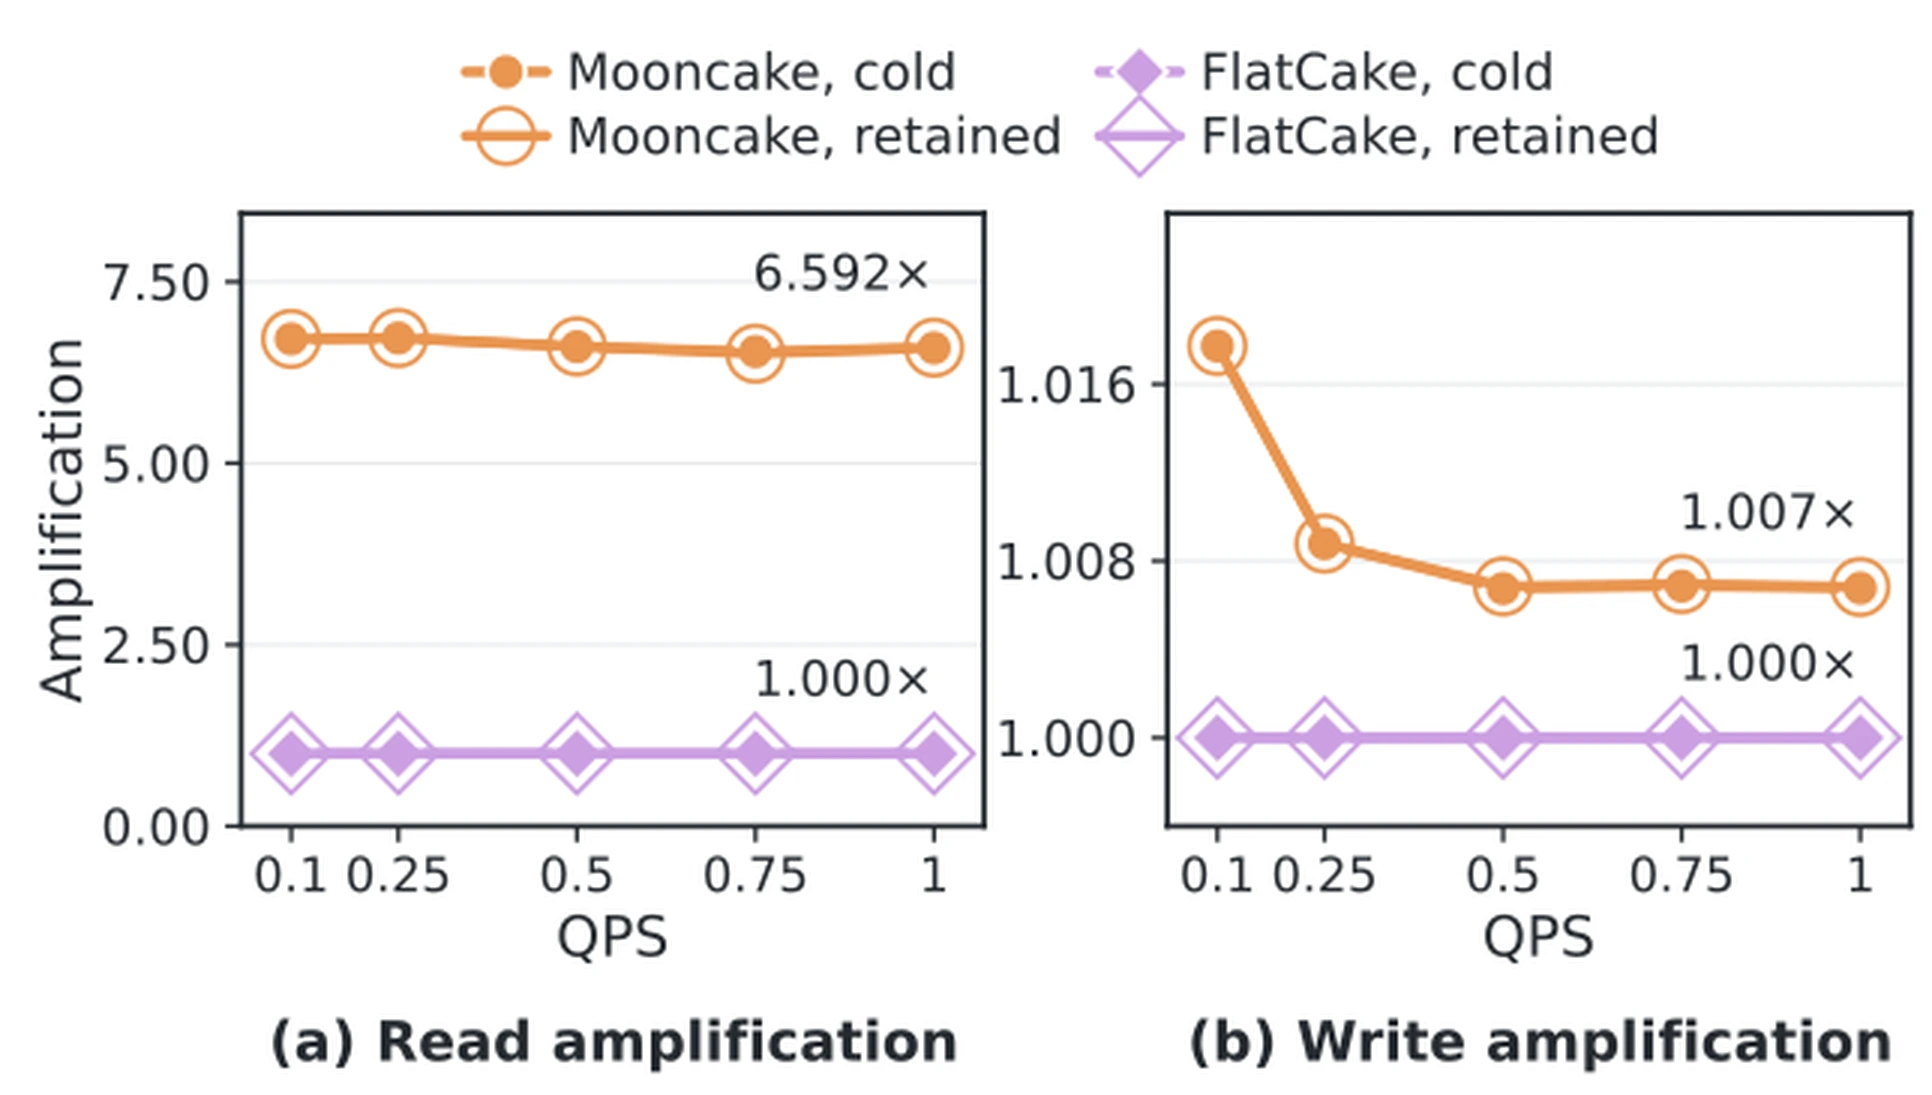
图源:FlatCake 论文(arXiv:2610.38355),Figure 9。(a) 各到达率下的归一化 SSD 读放大;(b) 对应的写放大。两者都以 FlatCake 在冷启动与保留缓存两种状态下的值为 1.0 做归一。分层方案的读放大是 FlatCake 的 6.51–6.72 倍,来源是被淘汰打碎的块、后台晋升流量以及被撤销后又重试的预取——这些读流量消耗了设备带宽,却没有把完成的恢复交付给 GPU。写放大的绝对差距很小,但它反映的是桶回收反复改写同一批页,对 GC 不友好。
布局与「只读一次」的关系
KV 块的生命周期是「写一次 → 读多次 → 整会话回收」。这带来一个分层结构没有的性质:同一个块只需要被写入到一个位置,且这个位置永远不变。因此:
- 布局可以在写入时按未来读取顺序决定,而不需要任何迁移或搬迁;
- 回收可以按会话整段进行,不需要逐块删除——这使回收是 的元数据操作,而不是逐页 unlink。
换句话说,FlatCake 在存储层做的事情,本质上是把 KV 当成日志结构来写:写一次、按消费顺序追加、按作用域整体回收。这一点和 Mooncake 的「桶分配 + FIFO 回收」形成对照:后者的回收粒度与复用粒度不匹配,前者把两者统一到了会话作用域。
64 位 GVA:把路由折叠进地址
FlatCake 的 64 位全局虚拟地址常被一句话带过:「介质 4 位、节点 12 位、偏移 48 位」。但这套位域设计的意义不在编码本身,而在于它把三个不同层面的决策——介质选择、节点路由、设备内偏移——压进了一个不可变句柄。理解这一点,才能理解为什么它能省掉逐层页表和 LRU 链。
位域与可表示的容量
| 字段 | 位宽 | 位置 | 含义 | 容量 |
|---|---|---|---|---|
| MediaType | 4 | [63:60] | 0=DRAM,1=SSD,其余保留 | 16 种介质 |
| NodeID | 12 | [59:48] | 集群节点编号 | 4,096 个节点 |
| Offset | 48 | [47:0] | 节点内字节偏移 | 每节点 256 TiB |
先做一个容量核算。单个介质类型下,12 位节点与 48 位偏移组合出的可寻址空间是
16 种介质类型合计 B,正好用满 64 位地址空间。这个数字不是巧合:设计者把地址空间按介质切成 16 个 1 EiB 的区段,节点再在区段内切成 4,096 个 256 TiB 的子区段。当前任何单集群都用不到 1 EiB,但这个上界保证了「地址不会在可预见的未来耗尽」,从而可以把它当成一个永久句柄。
为什么介质位放在最高位
把 MediaType 放在 [63:60] 带来一个直接好处:DRAM 与 SSD 的地址落在互不相交的数值区间:
于是 FC-MAS 的「这个请求是否需要 SSD」判断退化成一次整数比较,不需要查介质表、不需要读元数据。请求的 GVA 集合是有序的,取最大值即可分类:
/* 请求的每个块都有一个 GVA;按最慢介质归类 */static inline bool needs_ssd(const std::vector<uint64_t>& gvas) { uint64_t max_gva = 0; for (uint64_t g : gvas) max_gva = std::max(max_gva, g); return max_gva >= (1ULL << 60); /* MediaType >= 1 */}这段代码之所以成立,依赖两个前提:介质编号单调对应「慢」,且介质位在最高位。如果未来加入 CXL 内存(比 SSD 快、比 DRAM 慢),直接沿用这段比较就会失效——介质编号 2 同样满足 ,会被误判为 SSD。可行的做法是给每个介质记录一个「快慢等级」字段并比较等级,或者重新编号并修改这段热路径代码。这是位域编码的隐性代价:它把「介质快慢序」固化进了地址布局。
路由表:四种后端与一次位运算
拿到 GVA 后,运行时按 (MediaType, NodeID) 选择传输后端:
| MediaType | NodeID | 后端 | 典型延迟 |
|---|---|---|---|
| 0 | 本地 | cudaMemcpyAsync(H2D) | 微秒级 |
| 0 | 远端 | RDMA READ | 十微秒到毫秒 |
| 1 | 本地 | GDS cuFile | 百微秒到毫秒 |
| 1 | 远端 | NVMe-oF | 毫秒级 |
这张表是理解「地址即路由」的关键。传统分层系统要走到 SSD,需要:查块表 → 查层号 → 查页表 → 查设备号 → 构造 I/O。FlatCake 把这些折叠成一次位掩码提取和一次表跳转。省掉的不是某一个数据结构,而是整条翻译链。
需要澄清一个容易误解的点:GVA 不是 MMU 意义上的虚拟地址。它没有页表、没有 TLB、不会触发缺页异常,CPU 或 GPU 不能直接解引用它。它更像一个 capability 句柄:携带了「去哪取、取哪一段」的全部信息,但取数据仍要显式调用对应的传输后端。把它叫「全局虚拟地址」是借用了地址空间的语言,实际语义更接近「带标签的远程指针」。
与 CXL、DAX 的对照
这套设计与硬件定义的内存语义形成有趣对照:
- CXL 用硬件解码器把主机物理地址映射到设备内存,访问对 CPU 透明,但容量与拓扑由硬件枚举决定;
- DAX 把持久内存映射进进程地址空间,CPU 可直接 load/store,但要求介质具备字节寻址能力;
- FlatCake GVA 完全由软件定义,介质可以是不可字节寻址的 NVMe,访问必须经过运行时。
代价是软件必须自己维护地址分配与回收;收益是它可以把「SSD 的一段文件偏移」和「主机 DRAM 的一段缓冲区」放进同一个编号体系,从而用统一接口调度两种介质。这也是为什么论文说它把「两种介质拉平成同一层」——不是物理上拉平,而是在寻址语义上拉平。
不变性与发布协议
GVA 一旦分配就永不改变,这个性质支撑了无锁读。但「分配」和「可见」是两件事,FlatCake 把它们分开:
- 写入前先分配 GVA(确定介质、节点、偏移);
- 发起 DMA 或 GDS 写;
- 写完成回调触发后,才把
块键 → GVA条目发布进一级索引; - 读线程看到条目时,数据一定已经落位。
用内存序的语言描述:发布是一次 release store,查询是一次 acquire load;数据写入(GDS/DMA 回调)发生在 release 之前,读线程的 acquire 读保证能看到这次写入的数据。因为条目一旦发布就不再修改,读路径不需要任何锁;多个写线程并发插入时,用 64 位 CAS 解决哈希冲突即可。
/* 简化后的发布路径:先写数据,后发布索引 */uint64_t gva = alloc_gva(scope, bytes);submit_dma_write(gva, src, bytes, [=] { index_.insert_release(block_key, gva); /* 仅在此刻可见 */});这个协议还带来一个失败语义上的好处:如果 DMA 失败,索引里根本不会出现该条目,读线程最多看到「未命中」,不会看到半写的数据。对 KV 缓存这种可重建的派生数据来说,这已经足够——不需要 WAL,不需要 fsync,不需要崩溃恢复。论文没有展开这一点,但它是这套设计能做得如此轻量的前提。
地址空间不是免费的
位域编码也有代价。最直接的是分配粒度:48 位偏移以字节为单位,但实际分配必须以页或块为单位,否则相邻块会重叠。FC-GVA 在写入时按会话作用域整段分配,避免了细粒度碎片,但这也意味着分配器要维护「每个会话一段连续偏移」的约束——当会话增长时,新增段必须追加到同一 GPU File 的末尾,而不能插空。这是用地址连续性换布局连续性,两者在这里是同一件事。
第二个代价是节点容量的硬上限:单节点 256 TiB。对当前的 NVMe 阵列(论文用 8 块 3.84 TB,约 30 TB)绰绰有余,但如果未来单节点挂载更大规模的闪存池,48 位偏移会成为约束。届时要么扩展位域(破坏兼容),要么在节点内引入二级偏移(重新引入一次查表)。
并发、一致性与回收
一个 KV 存储层要接入推理引擎,最难的部分不是传输,而是在多个线程之间维持一个正确的所有关系。SGLang 的调度器、前缀匹配器、I/O 工作线程和 GPU 计算流对同一批块的认知必须一致:不能有块在传输途中就被回收,也不能有块在被读取时还未落盘。FlatCake 的解法集中在引用计数与作用域回收两件事上。
引用计数的三个层次
存储层里至少有三个「读者」可能同时关心一个块:
- 调度器:正在为某个请求解析前缀,需要这块的 GVA;
- I/O 工作线程:正在提交或回收该块的 GDS 读;
- 回收线程:在 SSD 高水位时寻找可以释放的会话。
FlatCake 用会话作用域级的原子引用计数统一管理,而不是逐块计数。理由与分页 KV 的设计一致:一个会话的块在回收时必须整段释放(否则破坏层优先的连续布局),所以计数的粒度天然是「会话」而非「块」。这与 PagedAttention 中按逻辑块引用计数、写时复制的思路形成对比——后者关心的是块级共享与分叉,前者关心的是会话级的整段生命周期。
回收的条件是:
是 SSD 利用率, 是高水位(论文没有给出具体数值)。三个条件同时成立才回收最老的会话。注意第三项:只有当容量紧张时才回收,这使得稳态下已热的前缀不会被无谓清除——这也是扁平结构能维持 94% 左右交付命中的原因之一。
为什么不需要「传输中」状态
很多存储系统需要为每个块维护 fetching / ready / evicting 这样的状态机。FlatCake 的设计里缺省地省掉了 fetching 状态,代价是需要一个协议来保证「读到的块一定完整」。
它的做法是:GVA 的发布协议本身就是完整性证明。一级索引里出现 块键 → GVA,意味着写已完成;GC 会保证条目在被删除前,不会有读者拿着旧 GVA 去读。这里的关键是回收只发生在会话引用计数为零时,而引用计数由调度器在解析前缀时递增。因此读线程只要在取得引用之后才访问 GDS,就不会读到正在被回收的块:
/* 解析前缀:在一个作用域内一次性递增整个会话的引用 */ScopeGuard guard = scope_ref_.acquire(session_id);for (auto& key : prefix_keys) { uint64_t gva = index_.lookup(key); /* 可能是未命中 */ if (gva) plan.push_back(gva);}/* guard 析构时递减;回收线程只有在 refcount==0 时才动这部分 extent */这种「先取得会话级引用、再查块」的顺序与引用计数式资源管理(如文件系统的 open/close)在结构上是同一类:只要还有一个持有者,底层资源就不会被释放。区别在于这里的资源单位不是单个文件,而是一整个会话作用域——回收时整段释放,不做逐块删除。
跨节点的一致性
论文提到一个轻量协调器在多节点间跟踪 DRAM 与 SSD 的聚合容量,并在写入时分配 GVA。这里有几个值得追问的点:
- 读路径无协调。因为 GVA 已经烘焙了 MediaType 与 NodeID,读线程不需要问协调器「这个块在哪」,直接按位域路由。协调器只在写入分配时参与,而 KV 流量是读多写少,所以它不在关键路径上。
- 一致性模型是「发布后只读」。块发布后不可修改,因此不存在多写冲突;只有「发布」与「回收」两种状态转换,而回收需要在所有节点都撤销引用。论文没有详细描述跨节点的引用计数如何维护,从设计推断,最可能是在作用域级别做分布式引用计数,代价是回收路径上多一次往返——但回收不在关键路径上。
- 故障域。若某节点在写入后、发布前崩溃,该块就不会进入索引,其他节点最多看到未命中并重算。若在发布后崩溃,则该块在索引里但数据可能丢失,需要在读返回后校验或依赖上层容错。
这套设计把存储层定位成可重建的缓存,而不是有状态的存储。这个定位决定了它可以放弃事务、放弃持久化语义,只保留「正确或未命中」两种结果。
回压与回收的耦合
回压和回收看似无关,实际上耦合在一个资源上:GPU 暂存窗口。当窗口被在途恢复占满时,新请求等待;如果这些请求长时间等待,它们持有的会话引用也就长时间不释放,回收随之推迟。因此窗口尺寸实际上也决定了 SSD 容量的回收节奏。窗口太小会形成正反馈:等待延长 → 引用不释放 → 回收推迟 → 命中率下降 → 更多请求需要恢复 → 窗口更紧张。反过来,窗口过大又浪费 HBM。论文没有量化这个耦合,但它意味着窗口大小不能只看流水线需求,还要看负载的并发度。
接进推理框架:HiCacheStorage 的契约
FlatCake 的实现规模是约 8.8K 行 C++17/CUDA 加 7.1K 行 Python,挂在 SGLang 的 HiCacheStorage 接口后面,不改模型 runner,也不改注意力 kernel。这个「不改计算侧」的定位,决定了存储层必须遵守一套很具体的契约。把契约写清楚,比复述架构图更有工程价值。
三个原语与它们的隐含语义
HiCacheStorage 的核心接口只有三个:
class HiCacheStorage {public: virtual bool exists(const BlockKey& key) = 0; virtual bool get(const BlockKey& key, void* dst, size_t bytes) = 0; virtual bool put(const BlockKey& key, const void* src, size_t bytes) = 0;};接口简单,但每条都有隐含要求:
exists必须便宜。它被调度器在准入阶段高频调用,不能触发 I/O。FlatCake 的实现只查一级 GVA 索引,命中与否是内存哈希表的读,不触碰 SSD。get的dst是 GPU 指针,且必须是已注册缓冲区。这直接对应前面说的cuFileBufRegister。如果把每请求的 KV 槽位当成dst直接传给cuFileRead,就会强制逐请求注册——一次毫秒级开销,足以吃掉整个传输的收益。FlatCake 的做法是get只负责把数据弄进固定的暂存窗口,再由 scatter 内核分发。put的src也是 GPU 指针,且写入必须幂等。同一个块键可能因为重试被写入多次;由于 GVA 不可变,重试要么复用已分配的 GVA(未发布时可覆盖),要么分配新 GVA 并让旧条目失效。前者要求写入方保证「未发布的块不会被读」,后者要求索引支持原子替换。论文没有说明重试路径,但从「写一次」的语义看,更可能是前者。
这里有一个容易被忽略的接口不匹配:HiCacheStorage 以块为粒度,而 FC-CIO 以层区间为粒度做合并。也就是说,存储层收到的是「这些块要读」,但它真正提交给 GDS 的是「这些 LBA 区间」。两者之间的转换(排序、合并、补洞)必须发生在 get 内部,而不能暴露给调用方。这是 FC-CIO 被设计成一个独立组件、而不是散落在调度器里的原因。
调度器需要配合改什么
「不改模型 runner」不等于「不改调度器」。要让扁平存储发挥作用,调度器至少要在四个地方配合:
| 调度器职责 | 分层系统的做法 | FlatCake 需要的做法 |
|---|---|---|
| 准入分类 | 统一 FCFS | 按 GVA 最大介质分双队列 |
| 预取完成 | 完成后追加到队尾 | 按原始到达时间重新插入 |
| 预取取消 | 暂存池满时撤销 | 窗口满时等待,不撤销 |
| 前缀驻留 | 晋升进 DRAM 层 | 不晋升,命中直接由 SSD 服务 |
这四项里,前三项是控制面改动,第四项是策略改动。它们共同说明:扁平化不是「把 GDS 接上」就结束,它要求调度器接受「SSD 命中是常态」这个前提。如果调度器仍然假设「命中应该来自 DRAM」,那么它会在 SSD 命中时做出错误的准入与取消决策。
一个最小接入骨架
下面的骨架把关键点串起来。它省略了错误处理与并发细节,但保留了 exists / get / put 与暂存窗口、scatter 的关系:
class FlatCakeStorage final : public HiCacheStorage {public: bool exists(const BlockKey& k) override { return index_.lookup(k) != kInvalidGva; /* 仅内存查表 */ }
bool get(const BlockKey& k, void* dst, size_t bytes) override { uint64_t gva = index_.lookup(k); if (gva == kInvalidGva) return false; if (is_dram(gva)) { return h2d_async(dst, gva, bytes, stream_); /* 亚毫秒 */ } /* SSD:先流进固定窗口,再 scatter 到 dst */ StageSlot* slot = window_.acquire(stream_); /* 可能阻塞等待 */ if (!slot) return false; io_worker_.enqueue(CoalescedRead{gva, bytes, slot->ptr}); return true; /* 完成由事件通知 */ }
bool put(const BlockKey& k, const void* src, size_t bytes) override { uint64_t gva = alloc_.reserve(k, bytes); /* 写时定址 */ write_worker_.enqueue({gva, src, bytes, [this, k, gva] { index_.publish(k, gva); /* 完成后再发布 */ }}); return true; }};这段代码里有两处刻意的设计。第一,get 在 SSD 路径上返回 true 时数据还没有到位,完成要靠事件;调用方必须理解这是异步语义,否则会在数据落地前就启动注意力。第二,put 先 reserve 再异步写、写完才 publish,这正是前面说的发布协议。把这两点写错,系统会出现「读到半写块」或「读到未落盘块」的隐蔽 bug。
与现有 SGLang 分页 KV 的衔接
SGLang 的 KV 池以 256 token 页为单位分配,页在 HBM 上不连续。这带来两个衔接问题:
- 源连续、目的不连续。GDS 只能写连续的目标区间,因此不能直接写进分页槽位;必须经过暂存窗口 + scatter。这是 FC-CIO 存在的根本原因。
- 层号与页号的映射。前缀块键里含层号,但 HBM 槽位按「页 → 层」组织。scatter 内核需要知道每个页在每个层的目标地址;这要求存储侧在描述符里携带目标槽号,而不能只带文件偏移。
如果未来 SGLang 支持更大的页(例如 512 token),全模型页宽 仍是 4 KiB 的倍数,但单层切片变成约 89.3 KiB,同样需要向上补齐;暂存窗口也要相应放大,scatter 的粒度也要改。这说明接口契约里隐含了页大小的假设,跨版本升级时需要重新核算。
可观测性
这套系统上线后,最容易被误读的指标是缓存命中率。论文的指标口径只统计在 prefill 开始前已经传输到 GPU HBM 的块,也就是交付命中率,而不是「块是否还在缓存里」的名义命中率:
分层系统在低负载时名义命中可以很高,但交付命中会因为暂存池耗尽而崩塌。FlatCake 的 94.16%–94.57% 是交付口径,所以能和源轨迹 94.72% 的上界直接比较。工程上应当把交付命中率与另外几个指标放在一起看:按介质拆分的命中构成、SSD 预取延迟、每 worker 的 SSD 读带宽、以及读放大倍数。只报一个「命中率」会掩盖真正的问题——分层方案在低负载下名义命中不低,却在交付环节丢掉了大半。
容量与收益怎么估
前面几节讲的是机制,这一节讲怎么判断「这套东西在我的负载上值不值得」。FlatCake 的论文给了两组模型、一条轨迹和若干硬件参数,足够反推出几个可复算的判据。
先估工作集,再谈介质
设活跃会话数为 ,单个会话的 KV 足迹为 ,则活跃工作集是
只有 显著小于主机 DRAM 容量时,分层结构的「DRAM 当过滤器」才成立。用论文的数字做一个粗糙估算:单请求历史 KV 均值 0.80 GiB/rank、八卡合计 6.4 GiB;轨迹里共有 393 个多轮会话。若用一个请求的均值代表一个会话,且这些会话在时间上重叠,工作集是
而系统只配置了 1 TiB 主机 DRAM。即便按均摊计算,全部会话历史也装不进 DRAM;若这些会话在时间上高度重叠,缺口会更大。这解释了为什么仅用 L2 Host DRAM 的交付命中率停在 53.30%——不是缓存算法不好,而是容量本身差了一个量级(这条轨迹上总量相差约 2.5 倍,并发重叠时更甚)。
一个粗略的容量判据是:
达不到时,SSD 必然在关键路径上。此时要做的不是换淘汰算法,而是接受「SSD 命中是常态」,并按这个前提设计数据面——这正是 FlatCake 的出发点。
SSD 容量该配多大
SSD 要装下「所有可能被复用的会话历史」加上一次性块的短期周转。一个保守的估法是:
是安全水位(通常 0.2–0.3), 是一次性块与在途写入的周转空间。论文的 4 TiB(约 4.4 TB)对 2.46 TB 的会话总量,,留得相当宽。这个宽裕度不是浪费:它让回收可以等到高水位才发生,从而避免为了腾空间而误伤活跃前缀。
反过来,如果 SSD 容量只按「平均工作集」配,系统会频繁触发回收,而回收粒度是会话——一次误回收可能作废整个几 GB 的会话前缀,代价远高于多买几块盘。按会话粒度回收的系统,容量水位应该比按页回收的系统更保守,因为回收的粒度更粗。
带宽够不够:一个容易算错的量
恢复带宽的需求不是「总 KV 字节除以时间」,而是按到达率与命中字节估计:
其中 是请求到达率, 是命中中由 SSD 服务的比例, 是单次恢复的字节数。用论文峰值代入: QPS,, GiB/rank,得到
这个均值远低于设备侧观测到的 5 GB/s 量级。按均值看,带宽并不紧张。但 P90 的会话足迹是 16 GiB(八卡合计),单 rank 约 2 GiB;若几条长会话同时恢复,瞬时需求会跳到 6–10 GB/s,超过单 worker 的 5.5–6.5 GB/s。这就解释了为什么平均预取延迟是 1.64 s 而不是 0.17 s:瓶颈是瞬时并发与排队,不是平均带宽。
用 Little 定律可以更直接地看到这一点:
1 QPS、1.64 s 的平均恢复时间意味着平均只有约 1.6 条恢复在途。但长尾请求的恢复时间可能是均值的数倍,瞬时在途数会高得多;窗口与队列就是为这些尖峰准备的。
恢复 vs 重算:一条几乎总是成立的判据
很多人凭直觉认为「从 SSD 读 KV 比重新算便宜」,但很少有人把它量化。设模型参数量为 ,单 token 每 rank 的 KV 字节数为 ,GPU 有效算力为 (FLOP/s),则对一个长度为 的前缀:
恢复更快的条件是
以 Llama-3.1-70B、TP4、FP16 KV 为例: KiB/token/rank(每层 1 KiB,80 层),, FLOP/s(4×A100 的有效算力,按 30% MFU 估)。代入得
也就是说,只要 SSD 的有效带宽超过约 100 MB/s,恢复就比重算快。这个门槛低得惊人,因为 prefill 的算术强度很高:每个 token 要做 次浮点运算,却只产生 字节的 KV。现代 NVMe 阵列轻松超过这个门槛,单盘都不止。
这条判据解释了一个表面矛盾:论文的 Figure 2(c) 显示,分层恢复在长上下文下反而慢于全量重算;而它的设备侧带宽并不低——Figure 8 里 Mooncake 的 SSD 读带宽为 2.69 GB/s。原因是那个对比里的「重算」并不只是 FLOPs,还包括调度、批处理与 GPU 利用率;而分层的恢复路径把大量时间花在暂存争用、命令拆分与撤销重试上,有效带宽远低于设备带宽。所以优化存储路径的目标不是提高峰值带宽,而是消除那些把有效带宽打到 100 MB/s 以下的系统开销。
一个可复算的 TTFT 预算表
把上面的量拼起来,可以为自己的负载列一张预算表。以 64K 上下文、Llama-3.1-70B、TP4 为例:
| 项目 | 估算 | 说明 |
|---|---|---|
| KV 字节/rank | GiB | GQA,8 KV 头,FP16,TP4 后每 rank 2 头 |
| 顺序恢复时间 | s | 假设该请求可独占 5 GB/s |
| 重算 FLOPs | 稠密模型 | |
| 重算时间 | s | 30% MFU |
| 论文实测 TTFT(FlatCake) | 3.74 s | 含调度、注意力与首 token |
| 论文实测 TTFT(Mooncake-GDS) | 6.60 s | 布局碎片导致有效带宽下降 |
这张表的价值在于给「3.74 s」一个可解释的拆分:按独占带宽估算约 1 s 是传输,剩余是调度、scatter、注意力与解码启动。它也说明为什么 Mooncake-GDS 的 6.60 s 不是设备慢——同样的 GDS 原语,只因为磁盘布局不同,有效带宽就掉了一半以上。
闪存寿命:别忽略写入量
KV 缓存是写一次、读多次,但仍然有写入。按轨迹估算:21.6B 输入 token,交付命中约 94%,需要新写入的 token 约
每 token 每 rank 7.5 KiB,八卡合计约
这条轨迹按 1 QPS 重放约需 27 小时,折合约 71 TB/天。对 8 块 3.84 TB、1 DWPD 的盘(合计约 30 TB/天额定写入),这个量已经超过额定值两倍以上。论文没有报告持续写入压力,实际生产中的写入量取决于命中率与 token 增长;但这提醒我们:KV 卸载不是零成本的,SSD 的每日写入量要纳入容量规划。写时直放至少保证了每个块只写一次,避免了分层结构里因撤销重算导致的重复写。
复现与踩坑清单
FlatCake 的实现虽然挂在一个标准接口后面,但数据面依赖一整套底层特性。如果要复现或在相似架构上借鉴,下面这些点最值得优先排查。
硬件与驱动
- GPU 的 BAR1 窗口要够大。 GDS 依赖把显存的一段映射进 PCIe 地址空间供对端 DMA。如果 BIOS 里 BAR1 被压缩,暂存窗口可能注册失败。部署前用
nvidia-smi -q确认 BAR1 的Total与Used。 nvidia-fs与 libcufile 版本要匹配。 论文用 GDS 1.16.1 配 CUDA 13.1。版本错配时cuFileHandleRegister往往不报错,而是悄悄退回兼容模式——表现为「能跑,但只有一两 GB/s」。验证方法是跑gdscheck或观察cuFileGetDriverProperties返回的驱动能力位。- PCIe 拓扑要确认 GPU 与 NVMe 在同一主机桥下。 如果 NVMe 挂在远端 NUMA 节点、跨了 CPU 间的互连链路,P2P DMA 可能被降级或直接不支持。用
nvidia-smi topo -m查 GPU 之间的 P2P 矩阵,用lspci -t确认 GPU 与 NVMe 是否挂在同一个根复合体下。 - IOMMU 模式要核对。
iommu=pt(passthrough)通常性能更好,但需要确认 GPU 与 NVMe 的 P2P 权限没有被分组隔离掉。
文件系统与存储
- XFS 的 extent 行为。 预分配大文件后,可以用
xfs_bmap -vp <file>确认只有一个 extent。如果看到多个startblock,说明分配被碎片化了,需要重新预分配或调整阵列。 O_DIRECT与对齐。 所有读写偏移、长度、用户缓冲地址都要满足设备逻辑块大小与 4 KiB 的对齐要求。SGLang 的默认页大小(256 token)与常见 KV 格式恰好满足,但换成 128 token 页或 3 字节格式就会破掉。- RAID 条带与层区间的关系。 若层区间小于条带,单请求只触及少数盘,带宽下降。在论文的配置里这条不成立,但在小模型、短前缀场景下需要重新算。
- SSD 的耐久与后台 GC。 持续的大写入量会触发 GC 与写放大。监控
nvme smart-log的percentage_used与media_errors;若写入量接近 DWPD 额定值,应缩短会话保留时长或降低缓存容量。
软件与接口
- 暂存窗口只能注册一次。 对每个请求缓冲调用
cuFileBufRegister会带来毫秒级 BAR1 与 IOMMU 映射开销,必须复用固定窗口。 - 异步完成语义。
cuFileBatchIOSubmit返回成功只代表「已入队」。如果在cuFileBatchIOGetStatus确认完成之前就启动依赖该数据的 kernel,会读到旧数据。正确做法是用 CUDA event 在 I/O 流与计算流之间建依赖。 - 批大小上限。
cuFileBatchIOSetUp的max_nr受properties.io_batch_size约束。按 worker 拆分 batch,比所有线程共享一个大 batch 更稳定。 - 发布顺序。 一级索引的插入必须发生在写完成之后。若为了省一次回调而提前插入,读路径会存在读到半写块的时间窗。
一个最小的验证脚本
在写完整系统前,建议先用一个脚本把「GDS 在本机上能否走完整模式」验证掉:
# 1. 确认驱动与能力grep -i nvidia_fs /proc/modules || echo "nvidia-fs 未加载"
# 2. 建立测试文件并确认单 extentfallocate -l 1G /mnt/nvme/test.binxfs_bmap -vp /mnt/nvme/test.bin
# 3. 查看 GPU 与存储的拓扑关系nvidia-smi topo -m | head -20如果工具链提供的 gdscheck 显示 only compatible mode,那么后面所有的布局优化都不会有预期收益。先确认传输原语,再谈布局。
局限
从数据面视角看,论文有几处没有展开、但会直接影响工程落地的地方。
窗口大小的敏感性缺失。 论文把暂存窗口定为「每流两层」,但没有给出窗口深度与并发恢复数的扫描。从前面回收与回压的耦合分析看,窗口过小会让等待与回收形成正反馈,窗口过大则浪费 HBM。这个参数应当有一个基于到达率与 P90 足迹的选取公式,论文没有提供。
的取值没有实验支撑。 64 KiB 是一个经验值。它在 NVMe 上大致是「一条命令传输时间的量级」,但对不同 PCIe 代际、不同条带、不同队列深度未必最优。更合理的做法是做一个小的参数扫描,把读放大与命令数画成两条曲线取交点。
跨节点部分语焉不详。 论文只提到「轻量协调器跟踪聚合容量」,没有说明跨节点的引用计数如何同步、回收如何做到全局一致、故障时如何恢复。对单机部署这不影响结论,但若要做集群级 KV 池,这就是必须补齐的部分。
基准面偏窄。 主实验是一条 Claude Code 轨迹配一个 MoE 混合 MLA 模型;跨模型实验只到 Llama-3.1-70B 的稠密 GQA。对稀疏注意力(例如 DSA 的索引器缓存)、线性注意力(循环状态而非 KV)这类结构,SSD 上的布局假设需要重新推导。站内关于 Kimi Delta Attention 的讨论说明固定循环状态的模型根本不需要 KV 层,这类模型自然不适用。
没有报告能耗与成本。 SSD 带宽提升与主机内存节省,最终都要折算成每 token 的成本。论文给出了延迟与吞吐,但没有给出功耗与机架密度层面的权衡。对采购决策而言,这部分与延迟数字同样重要。
对上层语义的强假设。 整套设计建立在「KV 块写一次、不可变、按会话整体复用」之上。这个前提对标准注意力成立,但对需要原地修改 KV 的机制(例如某些缓存压缩/重放方案需要回收并重写块)不成立。站内 KV Cache 卸载 一文讨论的分层放置策略也隐含了类似的假设,说明这是整条路线共同的前提。
小结
把这篇拆解收束到数据面上,FlatCake 做的事情可以概括为三句:
- 传输原语换成存储侧 DMA。 GPUDirect Storage 让 NVMe 设备直接把数据写进 GPU 的 BAR1 窗口,省掉主机内存中间缓冲的两跳,代价是必须满足 4 KiB 对齐与已注册缓冲的约束。
- 磁盘布局按消费顺序写。 因为 KV 块写一次、不可变、按会话复用,写入时就能按「层优先、会话连续」排好;读时只需排序—合并,把 条小读变成 条大读。这一点比 GDS 原语更关键——Mooncake-GDS 的对照实验证明了这一点。
- 暂存改在有界 GPU 窗口里做,回压选择等待而非撤销。 窗口把暂存内存从 压到常数级,回压策略保证命中率不因并发升高而崩塌;双队列则确保等待只落在真正需要等的请求上。
64 位 GVA 是把这三件事粘起来的骨架:介质位最高、节点居中、偏移最低,让「去哪取」退化成一次位掩码;不可变的句柄配合「写完才发布」的协议,让读路径可以无锁,也让存储层可以作为可重建缓存而不需要事务。
如果要给出一条可复用的判据,那就是前面推出来的那条:恢复比重算快,仅要求 SSD 有效带宽超过约 ,对 70B 级模型只要 100 MB/s 量级。现实中大量系统达不到这个门槛,问题几乎总是出在有效带宽被碎片布局、暂存争用和撤销重试吃掉,而不是设备本身。所以性能工作的重点应当是让顺序读保持顺序,而不是单纯追求更高的峰值带宽。
参考资料
- FlatCake: A Flat KVCache Storage Architecture for LLM Serving,Xin Huang 等,arXiv:2610.38355,2026。
- FlatCake 论文 HTML 全文(含全部图表),arXiv HTML 版。
- GPUDirect Storage Design Guide,NVIDIA 官方文档,含数据路径与 bounce buffer 说明。
- GDS cuFile API Reference,NVIDIA 官方文档,含
cuFileBatchIOSubmit与cuFileBatchIOGetStatus签名。 - GPUDirect Storage Overview Guide,NVIDIA 官方文档,简介 GDS 的作用与适用文件系统。
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving,Qin 等,arXiv:2407.00079,2024。
- Efficient Memory Management for Large Language Model Serving with PagedAttention,Kwon 等,SOSP 2023。
- SGLang: Efficient Execution of Structured Language Model Programs,Zheng 等,arXiv:2312.07104,2023。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



