


llama.cpp 源码完全拆解(二十六):router 的模型账本——按需加载、LRU 淘汰与显存配额如何把多个模型装进一个端口
一个端口背后,为什么要有多份模型
前面二十五篇沿着 llama.cpp 的 tools/server 拆完了单模型服务的整条链路:HTTP 入口、任务队列、slot 状态机、连续批处理、KV 缓存与 prompt cache、投机解码、多模态输入、采样与结构化输出。这些机制的共同前提是:一个 llama-server 进程只加载一个模型,所有请求都在这个模型的 context 上排队。
现实中的本地推理服务经常不是这样。一个开发者可能同时想在 7B 的通用模型、32B 的代码模型、一个重排模型和一个视觉模型之间切换;一台 24 GB 显存的机器显然装不下全部权重,更装不下它们各自的 KV 池和计算缓冲。传统做法是给每个模型单独起一个进程、各占一个端口,外面再套一个反向代理和一套启停脚本。llama.cpp 在后续版本里把这一层做进了 llama-server 自身:不指定模型启动时,进程进入 router 模式,对外仍然只暴露一个 OpenAI 兼容端点,内部按请求里的 model 字段按需拉起、路由、淘汰子实例。
这一篇要回答的不是“怎么用 router”,而是它的源码账本是怎么记的:
- router 进程自己为什么完全不碰 GPU,模型由谁加载;
- 模型列表从 Hugging Face 缓存、
--models-dir、.inipreset 三个来源如何合并,冲突时谁覆盖谁; - 一条请求如何在
POST的 JSON body 与GET的 query 参数里找到模型名,未加载时又由谁负责等待; - 多个请求同时要同一个模型时,队列为什么按“模型”而不是按“请求”合并;
--models-max与--models-memory-margin两本账分别怎么算,LRU 受害者如何挑,为什么正在服务的实例永远不会被卸;- 显存测量子进程为什么要跑两遍模型元数据,
min/max/effective三个数各自代表什么; - 加载、就绪、睡眠、卸载、崩溃这五个状态在父子进程之间如何传递。
这一篇的代码依据是当前 master 分支的 tools/server/server.cpp、server-models.cpp、server-models-sched.cpp 与 server-context.cpp。router 这一层仍在快速迭代,函数名和字段可能随版本变化,阅读时以源码为准。
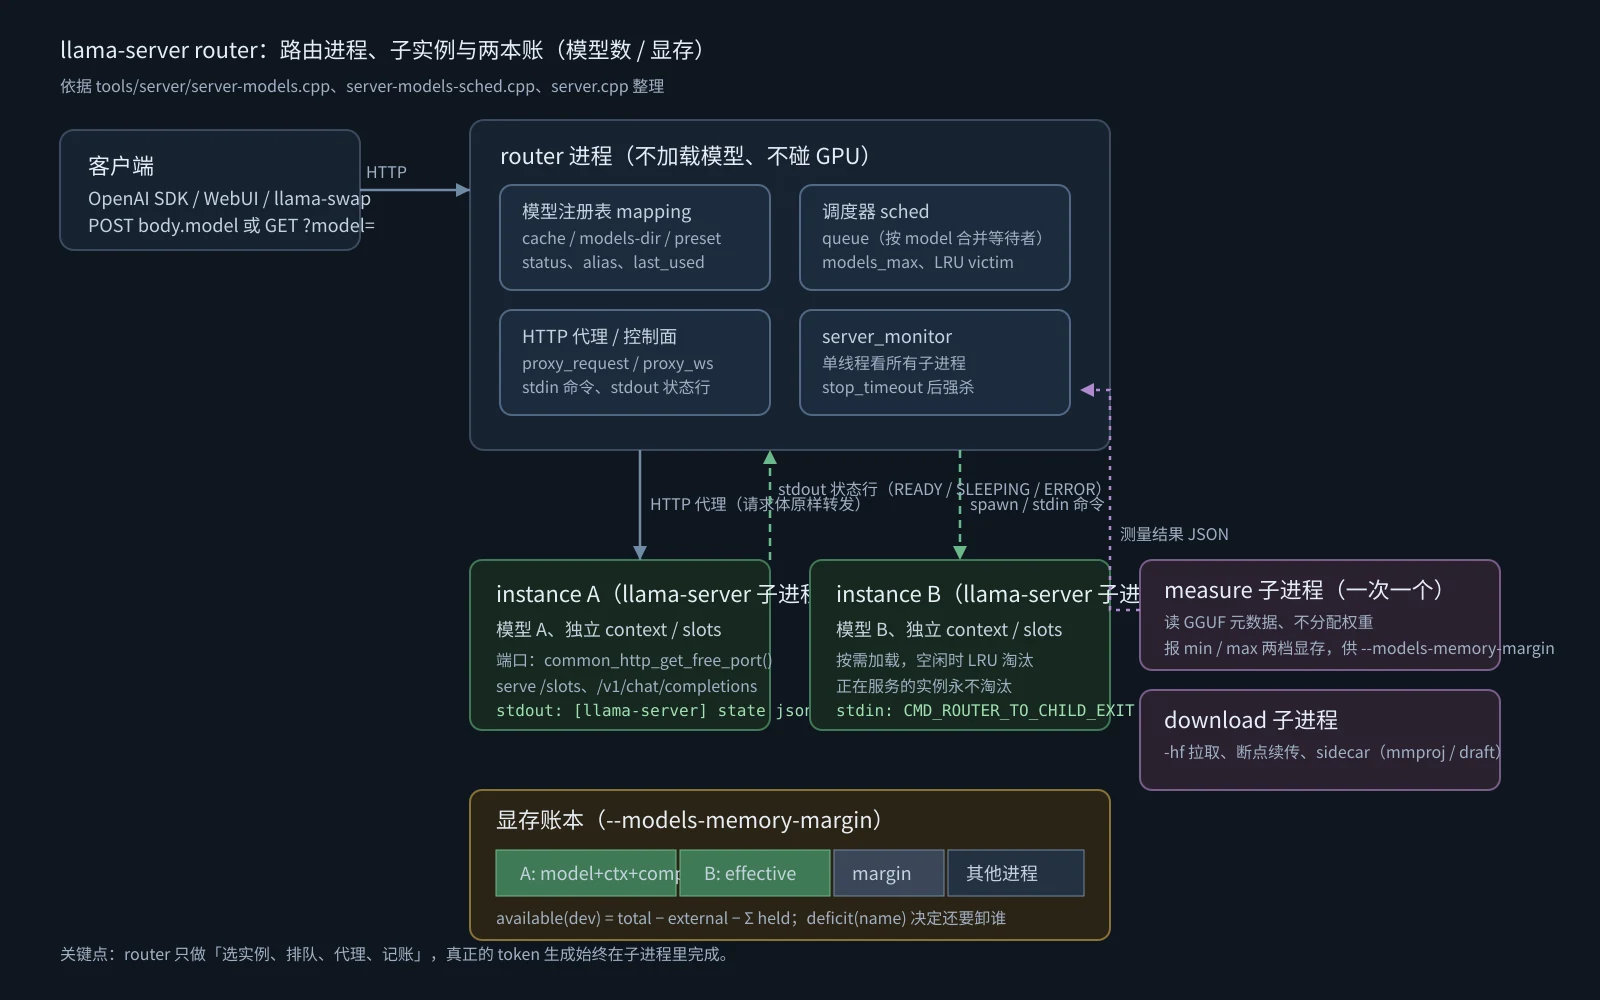
进程拓扑:router 是一个不加载模型的控制面
从“有没有模型”决定角色
server.cpp 里的角色判定非常直接:
// a server given no model is a routerconst bool has_model = !params.model.path.empty() || !params.model.hf_repo.empty() || !params.model.docker_repo.empty();return has_model ? SERVER_ROLE_INSTANCE : SERVER_ROLE_ROUTER;同一个二进制、同一套参数解析,只因为命令行里有没有 -m / -hf / --docker-repo,就分成了两种进程。SERVER_ROLE_INSTANCE 是前面二十五篇一直在讲的那种进程;SERVER_ROLE_ROUTER 则是本篇的主角。
这个设计带来一个很实用的性质:router 与实例共用完全相同的 HTTP API。server_register_routes() 注册路由时不会因为角色而改变路径,router 只是在注册之前把 server_routes 里的函数指针换成代理:
routes.post_completions = models_routes->proxy_post;routes.post_chat_completions = models_routes->proxy_post;routes.post_control = models_routes->proxy_post;routes.post_embeddings = models_routes->proxy_post;routes.post_rerank = models_routes->proxy_post;// ... 其余推理端点同理server_register_routes(ctx_http, routes);所以客户端不需要知道“我现在连的是 router 还是实例”。/v1/models、/v1/chat/completions、/props 的 URL 与请求体格式完全不变,差异只发生在 handler 被调用之后:router 先解析模型名,再选一个已经加载或可以加载的子实例,把整个 HTTP 请求原样转发过去。
router 进程里没有 llama_context
router 自己不创建 llama_model,也不创建 llama_context。它持有的是三样东西:
- 模型注册表:
server_models里的mapping,记录每个模型的名字、来源、preset、状态、子进程句柄、端口、最后一次使用时间、请求计数、显存测量结果。 - 准入调度器:
server_models_sched,维护一个按模型合并的等待队列,负责models_max的容量判断、LRU 受害者选择和显存配额计算。 - 子进程监视器:
server_monitor,一个单线程的事件循环,同时盯住所有子进程的 stdout、stderr、stdin 与退出状态。
真正的 token 生成发生在子进程里。每个子实例是一个独立的 llama-server 进程,带自己的模型、context、slot 池和 KV 缓存;router 通过 127.0.0.1 上的临时端口把 HTTP 请求代理过去。这个边界很重要:router 的崩溃不会带走已经生成的 token,子进程的崩溃也不会让 router 失去对整个模型列表的控制,两者通过进程边界隔离。
三种子进程角色
router 拉起的子进程不只有“模型实例”一种。server_role_type 一共四个值:
enum server_role_type { SERVER_ROLE_ROUTER, // 没有模型:列模型、按需拉起实例、代理请求 SERVER_ROLE_INSTANCE, // 服务一个模型,单独运行或作为 router 的子进程 SERVER_ROLE_DOWNLOAD, // router 的子进程:下载模型、报告进度、退出 SERVER_ROLE_MEASURE, // router 的子进程:不加载权重,只测量模型需要多少显存,退出};角色通过环境变量传给子进程:
LLAMA_SERVER_ROUTER_PORT:只要存在,子进程就知道自己是被 router 管理的,不再自己监听对外端口,而是把命令通道切到保留的 stdout。LLAMA_SERVER_CHILD_ROLE:instance/download/measure,未设置时默认是instance。
server_role 的构造函数会在检测到 LLAMA_SERVER_ROUTER_PORT 时调用 server_reserve_stdout(),把 stdout 保留给父子协议,日志全部走 stderr。协议只有两种消息:
cmd_router_to_child:exit // router -> child,走 child 的 stdincmd_child_to_router:state:{json} // child -> router,走 child 的保留 stdout状态消息里的 JSON 长这样:
{"state":"ready","payload":{"..." : "..."}}状态枚举只有五个值:downloading、measuring、loading、ready、sleeping。router 的 handle_child_state() 解析这些行,更新注册表,再通过 /models/sse 把状态变化广播给前端。
还有一个容易被忽略的细节:子进程的 server_role::setup() 会起一个线程读 stdin。读到 cmd_router_to_child:exit 就正常退出;读到 EOF 也退出——EOF 意味着 router 进程已经消失,子进程不应该变成孤儿继续占着显存。这个设计让“杀掉 router”等价于“回收所有子实例”,不需要额外的进程组管理。
monitor:一个线程看所有子进程
server_monitor 用 poll() 同时等待所有子进程的管道,而不是每个子进程开一个线程。它维护三类命令:
WATCH:登记一个新的子进程,附带名字、角色、端口和可选的强杀截止时间;STOP:请求停止某个名字最新的实例,附带stop_timeout和是否发送exit命令;QUIT:监视线程退出。
停止流程分两步:先向子进程 stdin 写 cmd_router_to_child:exit,让它在自己的调度循环里完成收尾;如果超过 stop_timeout(preset 里的 stop-timeout,默认 10 秒)仍未退出,monitor 直接 terminate() 强杀。强杀是必要的兜底:一个卡在 CUDA 同步或大模型析构上的进程,可能永远等不到优雅退出。
模型从哪来:三路扫描与 preset 的覆盖顺序
三个来源
router 启动时不做任何模型加载,只做一次“盘点”。server_models::load_models() 分三个阶段读取配置:
// 1. Hugging Face 缓存里的模型common_presets cached_models = ctx_preset.load_from_cache();
// 2. --models-dir 指向的本地目录common_presets local_models;if (!base_params.models_dir.empty()) { local_models = ctx_preset.load_from_models_dir(base_params.models_dir);}
// 3. --models-preset 指向的 .inicommon_preset global = {};common_presets custom_presets = {};if (!base_params.models_preset.empty()) { custom_presets = ctx_preset.load_from_ini(base_params.models_preset, global);}三种来源对应三种使用场景:
- 缓存:之前用
llama-server -hf user/model:quant下载过的 GGUF,文件已经在LLAMA_CACHE里;router 直接扫描缓存目录,不需要联网。 - 本地目录:
--models-dir ./models,适合把 GGUF 放在固定磁盘位置。多文件模型(多分片、带mmproj的多模态)要放在子目录里,mmproj文件名必须以mmproj开头。 - preset:
.ini文件,除了模型路径,还能给每个模型单独指定上下文长度、GPU 层数、聊天模板、草稿模型、stop-timeout、是否随服务启动等参数。
合并顺序:后读到的覆盖先读到的
三个来源不是简单的并集,而是有明确的优先级:
// 缓存先放入for (const auto & [name, preset] : cached_models) { final_presets[name] = preset; source_map[name] = SERVER_MODEL_SOURCE_CACHE;}// 本地目录覆盖同名缓存for (const auto & [name, preset] : local_models) { final_presets[name] = preset; source_map[name] = SERVER_MODEL_SOURCE_MODELS_DIR;}// preset 再覆盖;如果同名已存在,是 merge 而不是整体替换for (const auto & [name, custom] : custom_presets) { if (final_presets.find(name) != final_presets.end()) { final_presets[name].merge(custom); } else { final_presets[name] = custom; } source_map[name] = SERVER_MODEL_SOURCE_PRESET;}这段代码有三层含义:
- 本地目录优先于缓存。同一个模型名如果在缓存和
--models-dir里都出现,本地文件胜出。这对离线部署很重要:缓存里的文件可能是旧的量化版本,本地目录才是运维真正想用的那一份。 - preset 是“打补丁”,不是“换文件”。同名时调用
merge(),只覆盖 preset 里显式写出的键,其余参数保留缓存或本地扫描得到的默认值。这样用户可以在.ini里只写n-gpu-layers = 99,而不必重复模型路径。 [*]全局段先级联,再合并命令行。ctx_preset.cascade(global, ...)把[*]里的公共参数铺到每个模型上;随后preset.merge(base_preset)把 router 命令行里的参数再铺一遍。优先级从低到高是:模型默认 <[*]全局段 < 单模型段 < router 命令行。
这个顺序解释了一个常见疑问:为什么 llama-server -c 8192 在 router 模式下对所有子实例都生效。因为 router 自己的 -c 被合进了每个 preset,子进程启动时看到的就是 8192。
dedup-cache-models:同一个文件,两个名字
缓存扫描会把同一个 GGUF 的所有名字都列出来,而 preset 可能又给这个文件起了一个业务别名。结果就是 /models 里出现两条指向同一份权重的记录,用户不知道该选哪个。
dedup-cache-models 的处理方式是:收集所有 preset 解析后的实际文件路径,再看缓存模型解析出的路径是否已经被某个 preset 占用;如果是,就把缓存那条标记为 hidden,只保留 preset 那条。GET /models 遍历时会跳过 hidden 的条目,但内部注册表仍然保留它,避免路径解析和下载逻辑出现两套。
状态机与启动加载
注册表里每个模型有一个 server_model_status,核心值包括:
UNLOADED:没有子进程,权重不在显存里;LOADING:子进程已经拉起,但还没报告ready;LOADED:可以接请求;SLEEPING:子进程还活着,但模型和 context 已经卸载(--sleep-idle-seconds),收到请求会被唤醒;DOWNLOADING/DOWNLOADED:下载子进程的状态,不参与推理调度。
load-on-startup = true 的模型会在 load_models() 的末尾被逐个加载。注意这个选项只在启动时生效:如果之后通过 GET /models?reload=1 重新扫描 preset,新加进来的模型只会出现在列表里,不会自动加载。这个限制是刻意的——热重载配置不应该突然触发一次几十 GB 的权重加载。
请求如何找到模型:body、query 与别名
三种端点,三种取模型名的方式
router 的代理层要解决一个很实际的问题:不同 HTTP 方法的参数位置不同。server_models_routes::init_routes() 里对应三种取法:
// POST:模型名在 JSON body 的 "model" 字段this->proxy_post = [this](const server_http_req & req) { json body = json::parse(req.body); std::string name = json_value(body, "model", std::string()); // ...};
// GET:模型名在 URL query 的 ?model=this->proxy_get = [this](const server_http_req & req) { std::string name = req.get_param("model"); // ...};
// WebSocket:同样走 querythis->proxy_ws = [this](const server_http_req & req, server_http_context::ws_conn & conn) { std::string name = req.get_param("model"); // ...};这与 OpenAI SDK 的习惯一致:POST /v1/chat/completions 在 body 里带 "model": "...";GET /props?model=...、GET /metrics?model=... 则在 query 里带模型名。WebSocket 的 /v1/realtime 无法在握手后再读 body,所以也只能用 query。
校验:别名解析与 autoload
拿到名字后,router_validate_model() 做三件事:
static bool router_validate_model(std::string & name, server_models & models, bool models_autoload, std::unique_ptr<server_http_res> & res) { if (name.empty()) { res_err(res, format_error_response("model name is missing from the request", ...)); return false; } auto meta = models.get_meta(name); if (!meta.has_value()) { res_err(res, format_error_response(string_format("model '%s' not found", ...), ...)); return false; } // resolve alias to canonical model name name = meta->name; if (!models_autoload && !meta->is_running()) { res_err(res, format_error_response("model is not loaded", ...)); return false; } return true;}第一,空模型名直接拒绝。router 不会猜“默认模型”,因为多模型场景下猜错代价很高。
第二,get_meta() 支持别名。模型可能有多个 alias(比如 qwen3-8b 和 Qwen/Qwen3-8B-GGUF:Q4_K_M),返回值里的 name 是注册表的规范名,后续所有查找都用它,避免同一个模型出现两个调度条目。
第三,--no-models-autoload 时,未加载的模型直接返回 400,不进入等待。默认是 autoload 开启,此时 ensure_model_ready() 会把请求挂起,直到模型就绪或加载失败。
单次请求还可以用 ?autoload=true|false 覆盖全局设置,is_autoload() 先读 query,没有才回落到 params.models_autoload。
会话请求:记住模型,还要能取消
普通请求在模型加载期间可以随时断开,但对话类请求不行。一个 conversation_id 可能对应一个长会话,客户端在模型加载的几十秒里刷新页面、掉线重连都很正常;如果 socket 一断就取消加载,会话就永远起不来。
router 的处理是给会话请求做一层登记:
std::string conv_id = server_stream_conv_id_from_headers(req.headers);uint64_t ticket = models.conv_models.remember(conv_id, name);// 普通请求用 socket 的 should_stop;会话请求只在显式 stop 时取消auto should_stop = ticket == 0 ? req.should_stop : nullptr;bool waited = autoload && models.ensure_model_ready(name, should_stop);if (ticket != 0 && !models.conv_models.alive(conv_id, ticket)) { // 加载期间被显式 stop,返回取消错误 return error;}conv_models 是一个 conversation_id -> model 的映射,带一个单调递增的 ticket。它的作用有两个:
- 后续的流式读取(
/v1/responses的 stream、WebSocket 的会话)可以通过conversation_id直接找到当初处理这条会话的子实例,不需要轮询模型列表,也不需要解析 conversation id 的内部格式。 - 加载期间如果收到 stop,删除映射并把 ticket 标记为失效,正在等待的请求就能区分“客户端掉线”和“用户主动取消”。前者不应该杀掉一次可能已经排队很久的加载,后者应该立刻退出。
如果请求确实等待了加载,proxy_request() 的 detached 参数会被置为 true:代理不再把客户端的 socket 断开当作停止信号,生成结果会先进入会话缓冲区,等客户端重连后再续传。这是多模型 router 比“外部反向代理 + 按需 spawn”更难做对的一块,因为加载延迟把“请求生命周期”和“模型生命周期”解耦了。
代理本身很薄
真正转发时,proxy_request() 只做四件事:
auto meta = get_meta(name);if (!meta->is_running()) throw std::invalid_argument("model is not running");
{ std::unique_lock<std::mutex> lk(mutex); if (update_last_used) mapping[name].meta.last_used = ggml_time_ms(); mapping[name].req_count++;}
auto proxy = std::make_unique<server_http_proxy>( method, "http", CHILD_ADDR, meta->port, proxy_path, req.headers, req.body, req.files, detached ? [] { return false; } : req.should_stop, base_params.timeout_read, base_params.timeout_write);
proxy->cleanup = [this, name]() { // req_count--;减到 0 时调用 sched->tick()};req_count 和 last_used 是两本账的输入:req_count 决定一个模型“是否正在服务”,last_used 决定 LRU 的顺序。清理回调里减到 0 时调用 tick(),是因为一个忙碌的模型刚刚空出来,队列里可能正有等待者需要它腾位置。
HTTP 代理会原样转发方法、路径、query、headers、body 和上传文件,只把目标地址换成 127.0.0.1:<child_port>。流式响应通过 should_stop 回调感知客户端断开;detached 模式下则忽略 socket 状态,交给会话缓冲。WebSocket 走另一条路径:router 建立一个到子实例的 WebSocketClient,然后开两个方向相反的泵,一条读客户端写上游,一条读上游写客户端,关闭时两边一起收尾。
准入:队列按模型合并,加载者只能有一个
为什么队列条目是“模型”而不是“请求”
想象三个用户几乎同时请求同一个未加载的模型。最朴素的做法是三个请求各自触发一次 load(),结果三个子进程抢同一份权重、同一块显存,最后一个成功,前两个失败或者把显存吃光。router 的调度器把这个问题从源头消掉:等待队列的条目是模型,不是请求。
server_models_sched::entry_t 只有三个字段:
struct entry_t { std::string model_id; int n_waiters; // 有多少请求在等这个模型 bool loading; // 其中一个等待者正在执行加载};join() 的逻辑是:队列里已经有这个模型,就把 n_waiters++;没有才新建条目。leave() 反之,最后一个等待者离开时删除条目。这样,三个请求只会产生一个队列条目,也只会触发一次加载。
这个设计还解决了另一个问题:排队顺序按模型首次到达的时间,而不是按每个请求的时间。如果 A、B 两个模型都在排队,A 的第一个请求先到,那么 A 的后续请求会排进 A 已有的条目,不会插到 B 前面,也不会被 B 的请求挤开。队列的公平性以模型为单位,而不是以请求为单位。
ensure_model_ready:谁负责真正加载
ensure_model_ready() 是请求线程进入等待的地方。它的骨架是一个带 try_claim() 的循环:
bool server_models::ensure_model_ready(const std::string & name, const std::function<bool()> & should_stop) { auto meta = get_meta(name); if (!meta) throw std::runtime_error("model name=" + name + " is not found");
if (meta->is_ready()) return false; // 已就绪,无需等待 if (meta->status == SERVER_MODEL_STATUS_SLEEPING) return false; // 睡着,但请求会唤醒它
bool queued = false; { std::unique_lock<std::mutex> lk(mutex); auto it = mapping.find(name); if (it != mapping.end() && it->second.meta.status == SERVER_MODEL_STATUS_UNLOADED) { sched->join(lk, name); sched->tick(lk); queued = true; } }
std::unique_lock<std::mutex> lk(mutex); while (true) { // ... 读取 status,处理 LOADING / DOWNLOADING / UNLOADED ... if (status == SERVER_MODEL_STATUS_UNLOADED && sched->try_claim(lk, name)) { lk.unlock(); bool ok = true; try { load(name); // 真正 spawn 子进程 did_load = true; } catch (...) { ok = false; } lk.lock(); sched->claim_done(lk, name, ok); sched->tick(lk); continue; } cv.wait_for(lk, std::chrono::milliseconds(200)); }}这里有几个值得展开的点。
第一,try_claim() 只允许队首加载。 它先检查 queue.front().model_id == model_id,再检查 queue.front().loading 是否为 false,最后检查容量和显存。也就是说,即使一个模型已经轮到队首,同一时刻也只能有一个线程把它置为 loading = true 并执行 load()。其余等待者看到 loading 为真,继续睡。
第二,加载失败会把 loading 复位,但不改变队列位置。 claim_done(name, ok=false) 只把 loading 置回 false,条目仍在队首;下一次循环会重新尝试。如果失败是“容量被其他线程抢走了”这种瞬态原因,重试是对的;如果是模型文件损坏,load() 里会走到错误路径,最终由状态机把模型标成失败,等待者被唤醒并收到错误。
第三,等待循环用 200 ms 的 wait_for(),而不是无限期 wait()。 因为状态变化可能来自多个地方:load() 自己、monitor 线程、另一个请求线程、卸载流程。用超时轮询加条件变量,既能在正常路径上被 cv.notify_all() 立刻唤醒,也能在漏掉一次通知时最多 200 ms 后自愈。
第四,should_stop 在每个循环里检查。 普通请求在客户端断开后,should_stop() 返回 true,等待者抛出“request cancelled while waiting for model”,然后 leave_queue() 和 tick() 把腾出的位置让给下一个等待者。会话请求传入的是 nullptr,只有显式 stop 才会走取消路径。
队列条目的第二重作用:防淘汰
join() 除了合并等待者,还有一个副作用:只要队列里还有这个模型的条目,pick_victim() 就不会把它选为淘汰对象。源码里的条件是:
if (models.stopping_models.count(m.first) || find(m.first)) { continue;}find(m.first) 就是在等待队列里找同名条目。这意味着一个“已经被请求、正在排队等加载”的模型不会被另一个模型的加载流程顺手卸掉。否则会出现这样的死锁:A 在排队等容量,B 的加载为了腾容量把 A 的目录项卸了,A 的等待者永远等不到 UNLOADED -> LOADING 的转换。
tick():容量账本的实时修正
tick() 是调度器的“对账”函数,在多个位置被调用:请求清理、状态变化、ensure_model_ready() 的每次循环、load() 前后。它只做一件事:当等待队列需要的实例数超过可用槽位时,按 LRU 逐个请求卸载。
int n_running = 0; // 正在运行的实例int n_stopping = 0; // 已经在停止流程里的实例int n_needed = 0; // 队列里还没 claim 的条目数int n_claimed = 0; // 已 claim 但还没 spawn 出来的条目数
int n_free = models_max - n_running + n_stopping - n_claimed;while (n_free < n_needed) { std::string victim = pick_victim(lk); if (victim.empty()) return; // 剩下的都在忙,只能等 models.request_stop(victim); n_free++;}这个公式把三种“正在进行中”的状态都算了进去:
n_running包含所有已经 spawn 的实例,不管它是加载中、就绪还是睡眠;n_stopping是已经在停止流程里的实例,它们仍然占着n_running的名额,但马上会释放,所以加回去;n_claimed是已经拿到队首权、但load()还没把子进程放进mapping的条目,它们马上会占用一个新名额,所以减掉。
如果只按 n_running 算,两个线程可能同时看到“还有一个空位”,然后都去加载,最后超出 models_max。n_claimed 就是为了堵住这个窗口。load() 里在持有锁的情况下又检查了一次 limits_exceeded(),是第二道保险。
淘汰:models_max 与 LRU 的受害者选择
pick_victim 的四道过滤
std::string server_models_sched::pick_victim(std::unique_lock<std::mutex> & lk) { std::string victim; int64_t victim_last_used = 0; for (const auto & m : models.mapping) { // 正在服务请求的,跳过 if (m.second.req_count != 0 || !m.second.meta.is_ready_or_sleep()) continue; // 已经在停止流程,或队列里有人等它的,跳过 if (models.stopping_models.count(m.first) || find(m.first)) continue;
if (victim.empty() || m.second.meta.last_used < victim_last_used) { victim = m.first; victim_last_used = m.second.meta.last_used; } } return victim;}四道过滤对应四种“不能动”的情况:
req_count != 0:有请求正在代理到这个实例,可能是长流式生成,也可能是 WebSocket 会话。卸掉它等于把用户正在读的 token 流掐断。!is_ready_or_sleep():加载中、下载中、正在停止的实例都不适合作为受害者。加载中的实例还没有可用的服务能力,卸掉它只会让等待者更晚拿到模型;正在停止的实例已经有人处理,重复请求停止没有意义。stopping_models:已经在停止流程里,再选一次会重复发exit命令。find(m.first):队列里有等待者,见上一节。
剩下的实例里,按 last_used 取最小值。last_used 在三种时机更新:load() 成功时设为当前时间、proxy_request() 的 update_last_used=true 分支、WebSocket 代理开始时。GET 代理传的是 false,因为一次 /props 或 /metrics 查询不应该让一个模型在 LRU 里“变年轻”;只有真正接推理请求的 POST 和 WebSocket 才算使用。
一个具体的容量推演
假设 --models-max 2,当前有三个模型 A、B、C,状态如下:
| 模型 | 状态 | req_count | last_used | 在队列里 |
|---|---|---|---|---|
| A | LOADED | 1 | t=100 | 否 |
| B | LOADED | 0 | t=90 | 否 |
| C | UNLOADED | 0 | t=0 | 是(1 个等待者) |
请求 C 时,tick() 看到 n_running=2、n_stopping=0、n_needed=1、n_claimed=0,n_free = 2 - 2 + 0 - 0 = 0 < 1,需要淘汰一个。pick_victim() 跳过 A(req_count=1),选中 B(last_used=90)。request_stop(B) 把 B 放进 stopping_models,n_free 变成 1,循环结束。
B 的子进程收到 exit,析构 context、释放显存,monitor 检测到退出,update_status(B, UNLOADED) 把 B 从 stopping_models 移除并调用 tick()。这一次 n_running=1、n_stopping=0、n_needed=1、n_claimed=0,n_free=1,不再需要淘汰。C 的等待者在下一次循环里 try_claim() 成功,load(C) 启动。
如果 A 也是空闲的(req_count=0),而 B 的 last_used 更近,那么受害者会是 A。LRU 的“使用”只认推理请求,不认管理接口,这一点在多租户环境下很重要:监控系统高频轮询 /metrics?model=A 不会把 A 保住在显存里。
没有抢占,只有等待
这套调度器最值得注意的设计取向是:它不做请求级抢占。一个忙碌的模型永远不会被卸载,哪怕队列里有一个更高优先级的模型在等容量。等待者只能等当前请求自然结束,req_count 减到 0 后 tick() 才有机会选它当受害者。
这和 vLLM 的调度器形成鲜明对比。vLLM 在 KV 块不足时会抢占运行中的序列(recompute 或 swap),因为它的调度单位是 token 和块,抢占的代价可以量化成“重算多少 token”。router 的调度单位是“整个模型实例”,抢占意味着杀掉一个可能正在流式输出的 HTTP 连接,代价无法用 token 数衡量,所以它选择不抢占。
代价是尾延迟:一个长对话可能让另一个模型的冷启动等上几分钟。收益是语义简单:只要请求返回了 200,它的模型就不会在中途被卸掉。对于本地多模型服务,这个取舍通常是合理的;对于多租户 SaaS,就需要在上层做配额和超时。
显存账本:为什么不能只看权重文件大小
两本账的分工
--models-max 只数实例个数,不理解显存。一个 70B Q4 模型和一个 0.6B Q4 模型都算“一个实例”,但前者可能占 40 GB,后者不到 1 GB。只按个数限制,要么浪费显存,要么在加载大模型时 OOM。
--models-memory-margin N 打开第二本账:router 跟踪每个设备上的总显存、外部占用、已加载实例的占用,并在加载新模型前按需卸载空闲实例,保证加载后每个设备至少还剩 N MiB。它的目标不是“精确预测”,而是“在加载前做出一个不会立刻 OOM 的决定”。
测量子进程:min / max / effective
router 自己不解码模型,也就不可能知道一个 GGUF 需要多少显存。它的办法是拉一个测量子进程:SERVER_ROLE_MEASURE 的 llama-server,读取模型元数据,按 --fit 的规则算出两档显存需求,报告给 router,然后退出。
server_model_memory 里有三个关键数字:
min:模型在--fit可能选择的最小上下文下的显存占用。默认--fit-ctx是 4096,乘以序列数;如果 preset 用-c钉死了上下文,或者--fit off,min就是那个固定上下文下的占用。max:模型在“当前设备空闲显存允许的最大上下文”下的占用。它是一个快照:其他模型加载或卸载后,这个数会变。effective:实例真正启动后报告的“我实际分配了多少”。开了--fit时,实例通常会吃到接近max的上下文,所以effective往往比min大得多。
测量只跑元数据,不分配权重。它的 free 读数不包含自己,所以 calibrate() 里对测量子进程的 self 取 0;对真实实例则取 d.self()(model + context + compute)。
外部占用怎么算
calibrate() 是账本的核心:
for (const auto & d : mem.devices) { if (!d.is_device() || d.total == 0) continue;
int64_t tracked = 0; for (const auto & [name, devs] : held) { if (name == reporter) continue; auto h = devs.find(d.name); if (h != devs.end()) tracked += (int64_t) h->second; }
const int64_t self = reporter.empty() ? 0 : (int64_t) d.self(); auto & dm = device_memory[d.name]; dm.total = (int64_t) d.total; dm.external = std::max<int64_t>(0, dm.total - (int64_t) d.free - self - tracked);}这段代码在解决一个跨后端的差异:
- CUDA 的
free是“整机剩余”,已经把其他进程(包括 router 的其他子实例)算进去了; - Metal 的
free更接近“本进程视角”,不一定包含其他进程。
所以不能直接用 total - free 当作“别人占的”。正确做法是:从 total - free 里减掉“本实例自己”和“账本里已经跟踪的其他实例”,剩下的才是真正的外部占用。否则每加载一个实例,external 就会被重复计算一次,可用显存越来越少,最后 router 会变得过度保守。
held 是“已加载实例在每台设备上的占用”,由 reserve() 写入。reserve() 优先用 effective,没有才退回 min:
const auto & mem = info.effective ? info.effective : info.min;for (const auto & d : mem->devices) { if (d.is_device() && d.total > 0) { devs[d.name] = d.self(); }}sleeping 和 unloaded 时调用 release() 把条目从 held 里删掉,因为 --sleep-idle-seconds 会把模型和 context 真正卸载,显存已经还回去了。
available 与 deficit
int64_t server_models_sched::available(const std::string & dev) const { auto dm = device_memory.find(dev); if (dm == device_memory.end()) return INT64_MAX; // 没报告过,不限制
int64_t n_held = 0; for (const auto & [name, devs] : held) { auto h = devs.find(dev); if (h != devs.end()) n_held += (int64_t) h->second; } return dm->second.total - dm->second.external - n_held;}available 的语义是“如果现在要加载一个新模型,最多能动用多少”。它没有减 margin,margin 在 deficit() 里减:
const int64_t margin = (int64_t) models_memory_margin * 1024 * 1024;for (const auto & d : info.min->devices) { if (!d.is_device() || d.total == 0) continue; if (device_memory.find(d.name) == device_memory.end()) continue;
const int64_t avail = available(d.name) - margin; if ((int64_t) d.self() > avail) { res[d.name] = (size_t) ((int64_t) d.self() - avail); }}deficit 返回的是“每台设备还差多少字节”。如果 map 为空,说明 min 已经能装下;否则 router 需要卸载一些空闲实例,直到每台设备的缺口都补上。
注意这里比较的是 min,不是 max。这是刻意的保守选择:router 只保证“模型至少能以最小上下文加载”,加载后 --fit 会在剩余空间里尽量放大上下文。如果按 max 比较,一个本来可以以 4096 上下文跑起来的模型会被拒绝,因为它想要 128K。
make_room:先测量,再卸 LRU,直到装得下
void server_models_sched::make_room(const std::string & name) { if (memory_enabled()) { std::unique_lock<std::mutex> lk(models.mutex); enqueue_measure(name, /* front */ true);
auto measured = [this, &name]() { auto it = models.mapping.find(name); return it == models.mapping.end() || it->second.meta.memory.is_settled(); }; if (!measured()) { models.cv.wait(lk, measured); } }
while (true) { std::unique_lock<std::mutex> lk(models.mutex); if (!limits_exceeded(lk, name)) return;
std::string lru = pick_victim(lk); if (lru.empty()) return; // 全在忙,交给 load() 报错
models.unload(lru); models.cv.wait(lk, [&] { return models.mapping[lru].meta.status == SERVER_MODEL_STATUS_UNLOADED; }); }}这段代码的时序值得逐行读:
- 测量优先。 如果这个模型还没测量过,把它插到测量队列队首,然后等
memory.is_settled()(measured或failed)。一个从没下载过的模型会测量失败,此时is_settled()为真,不会死等。 - 循环判断缺口。
limits_exceeded()里先查models_max,再查deficit。如果缺口为空,直接返回。 - 挑一个 LRU 受害者并同步等待它卸载完成。
models.unload(lru)只是发起停止,真正的释放发生在子进程退出后;cv.wait()等到状态变成UNLOADED才进入下一轮。这个同步等待很关键:如果异步地连续卸多个,可能在第一个还没释放时又基于旧账本算出新的缺口。 - 没有受害者就返回。 所有模型都在忙,
make_room不会强行卸载,而是让load()继续走,由limits_exceeded()在真正的加载点报“model limit reached”。
一个容易误读的分支:没有实例时“超了也照载”
limits_exceeded() 里有一段:
bool any_running = false;for (const auto & m : models.mapping) { if (m.second.meta.is_running()) { any_running = true; break; }}for (const auto & [dev, bytes] : missing) { if (any_running) { SRV_DBG("model name=%s is short by %zu MiB on %s\n", ...); } else { SRV_WRN("model name=%s is projected to be short by %zu MiB on %s " "with nothing else loaded, loading anyway\n", ...); }}return any_running;如果机器上什么都没加载,而测量结果仍然说 min 装不下,router 选择不阻止加载,只打一条警告。原因是 min 本身是偏保守的估算(按最小上下文和 preset 的设备放置算),真正的 --fit 在实例启动时还有机会选一个更小的上下文或者把部分层放到 CPU。反过来,如果有其他实例在跑,卸载它们是有意义的,所以 limits_exceeded() 返回 true,make_room() 会继续卸。
这也解释了为什么“显存不够”时 router 有时会先尝试加载再失败,而不是提前拒绝。它把最终裁决权交给了子进程的 --fit,router 只负责在能腾空间时腾空间。
边界与已知缺口
测量账本不是万能的,源码和文档都明确列出了边界:
mmproj不计入测量。 多模态模型的视觉编码器会额外占显存,min报的数偏低。文档建议给这类模型留更多 margin。- host 内存视为无限。 和
--fit的假设一致;在纯 CPU 构建或没有 GPU 的机器上,显存限制没有效果。 - 测量失败的模型不做显存检查。 比如 GGUF 损坏、
-hf模型还没下载,memory.status = failed,加载时跳过deficit;等模型成功加载后会重试测量。 - 测量结果是一个快照。 其他模型加载/卸载会改变设备空闲量,
max尤其明显。router 在每次加载前等测量完成,但使用的仍是当时的值,所以它只能保证“按这一刻的账本不会超”,不能保证加载过程中外部进程不抢显存。 --models-max 0表示不限个数。 此时has_capacity()恒为 true,只有显存账本还在工作;如果连--models-memory-margin也没开,router 就完全不限制实例数量。
加载与卸载:父子进程之间的五个状态
load():从注册表条目到子进程
server_models::load() 是 router 里最长的一个函数,但它的阶段很清晰:
void server_models::load(const std::string & name, const load_options & opts) { if (!opts.custom_meta.has_value()) { if (!has_model(name)) throw std::runtime_error("model name=" + name + " is not found"); if (opts.role == SERVER_ROLE_INSTANCE) sched->make_room(name); }
std::unique_lock<std::mutex> lk(mutex); cv.wait(lk, [this] { return !is_reloading; });
auto meta = opts.custom_meta.has_value() ? *opts.custom_meta : mapping[name].meta; if (meta.status != SERVER_MODEL_STATUS_UNLOADED) return;
if (opts.role == SERVER_ROLE_INSTANCE && sched->limits_exceeded(lk, name, false)) { throw std::runtime_error("model limit reached, try again later"); }
instance_t inst; inst.meta = meta; inst.meta.port = common_http_get_free_port(); inst.meta.status = SERVER_MODEL_STATUS_LOADING; inst.meta.last_used = ggml_time_ms();
inst.subproc = std::make_shared<server_subproc>(); inst.meta.update_args(ctx_preset, bin_path); // 把 preset 渲染成命令行 std::vector<std::string> child_args = inst.meta.args; std::vector<std::string> child_env = base_env; child_env.push_back(SERVER_ENV_ROUTER_PORT + "=" + std::to_string(base_params.port)); // 按角色追加 LLAMA_SERVER_CHILD_ROLE / -hf 参数 / sidecar 开关
inst.subproc->sproc.create(child_args, options, child_env); mapping[name] = std::move(inst); sched->on_spawned(lk, name); monitor->watch(name, proc, opts.role, port); cv.notify_all();}按顺序拆开:
- 先等一次重载结束。
is_reloading保护的是 preset 列表重载与加载之间的竞争。如果GET /models?reload=1正在重建注册表,load()会阻塞到重载完成,避免拿着旧的 preset 去 spawn。 make_room()在锁外执行。 它要等测量子进程、等卸载完成,可能持续数秒;如果抱着models.mutex做这些,整个 router 的所有状态查询都会被卡住。所以make_room()自己内部加锁、放锁,load()只在它返回后才进入临界区。- 锁内复核容量。 两个线程可能同时通过
make_room(),都认为“现在装得下”。limits_exceeded()在锁内再算一次,第二个线程会看到第一个线程已经on_spawned()的预留,从而被拒绝并重新排队。 - 分配端口。
common_http_get_free_port()在127.0.0.1上找一个空闲端口。端口是动态的,不是 preset 里写死的,所以同一个模型卸载后再加载,端口可能变化;router 的代理总是从meta.port读当前值。 - 渲染命令行。
update_args()把 preset 转成实际的argv,并把 router 的 host、port、alias 等保留参数剥掉或覆盖,防止子进程监听对外地址。 spawn并登记。 子进程创建成功后,先写mapping[name],再sched->on_spawned()把显存账本按min预留,最后monitor->watch()。顺序很重要:monitor 可能在子进程启动的瞬间就收到 stdout 的ready,如果那时mapping还没有条目,状态更新会找不到对象。cv.notify_all()唤醒等待者。 等待者会看到LOADING,继续等READY或失败。
子进程上报:loading -> ready
子进程启动后,common_init_from_params() 加载权重、创建 context,然后通过 notify_to_router("loading", {...}) 和 notify_to_router("ready", {...}) 上报。ready 的 payload 里除了模型架构、模态信息,还有 实际显存占用 和 实际上下文长度。
router 的 handle_child_state() 把 ready 映射成 SERVER_MODEL_STATUS_LOADED,调用 update_status()。update_status() 在锁内做四件事:
- 更新
meta.status、exit_code、loaded_info、progress; - 如果状态是
LOADED,调用sched->on_ready():把effective写进账本,重新reserve(),并用这次真实读数calibrate()设备总量与外部占用; - 如果是
SLEEPING或UNLOADED,调用对应的on_sleeping()/on_unloaded()释放账本; - 调
tick(),因为一个模型从“加载中”变成“就绪”,或者从“运行”变成“卸载”,都会改变队列可用的槽位数。
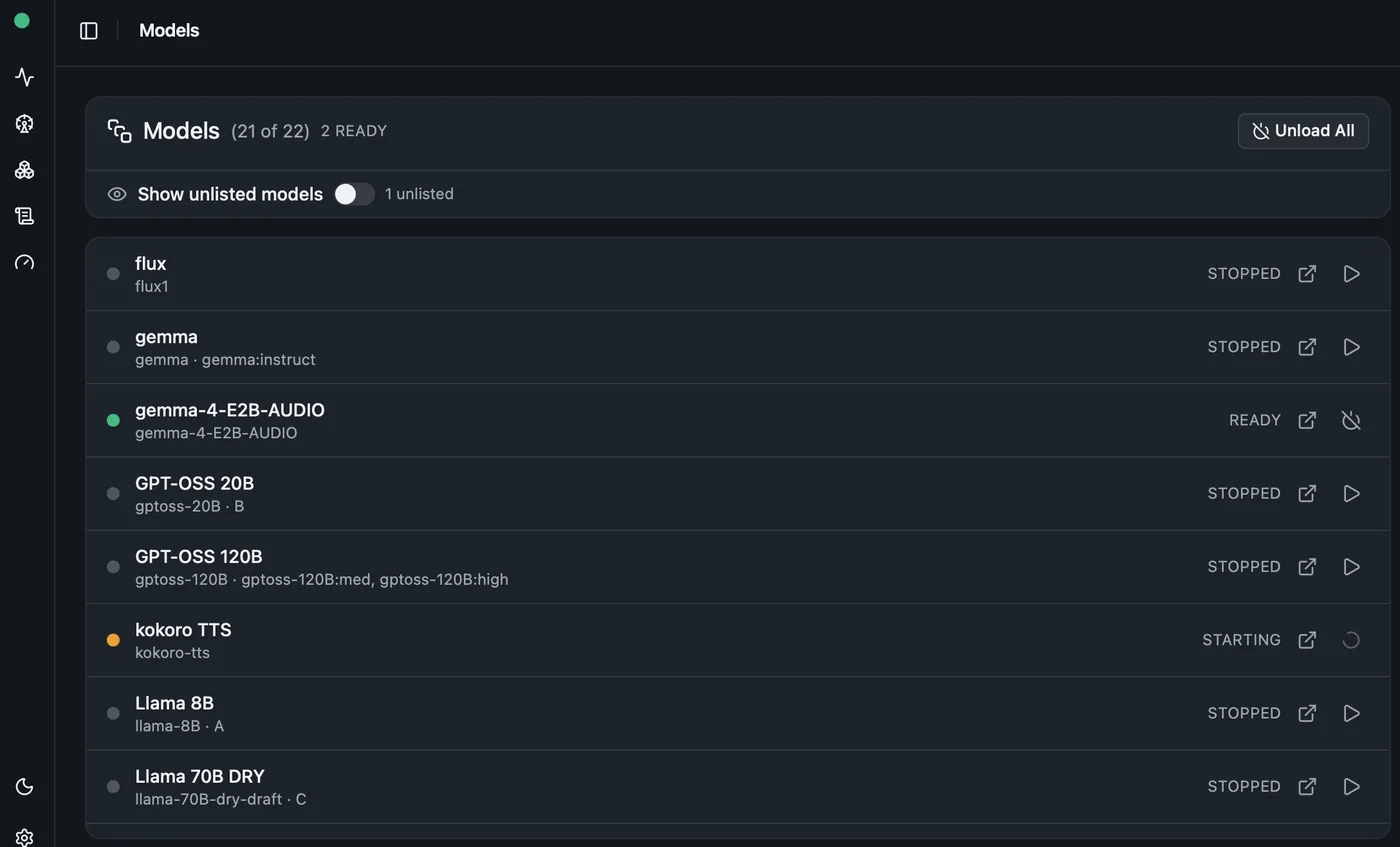
最后通过 /models/sse 发一条 status_change 事件,payload 里带 status、info、progress、memory。前端的模型卡片就是靠这条 SSE 流实时更新的,不需要轮询。
睡眠:子进程还在,显存已经还了
--sleep-idle-seconds 不是 router 层的功能,而是子实例自己的空闲检测。子进程在空闲超时后 unloading 模型和 context,把自己的状态改成 sleeping,但进程本身不退出。router 收到 sleeping 后:
- 把模型从
held账本里移除(on_sleeping -> release); - 但
meta.status仍是SLEEPING,is_running()仍为 true,proxy_request()仍然可以找到它的端口; - 下一次请求代理到这个子进程时,子进程自己会先唤醒(重新加载权重),再处理请求。
这个设计把“进程生命周期”和“模型生命周期”分开了。睡眠状态的好处是省掉了进程启动、参数解析、端口分配的开销;坏处是唤醒延迟仍然存在,而且 router 的显存账本在睡眠期间是“空的”,可能把空间让给别的模型,唤醒时又要抢回来。ensure_model_ready() 对 SLEEPING 直接返回 false(不等待),就是把这个冲突留给子进程的唤醒路径去处理。
卸载:先礼后兵
unload() 分三种情况:
- 下载中的模型:写
exit命令,然后等状态离开DOWNLOADING。下载子进程会在收到命令后清理未完成的分片。 - 加载中的模型:直接
terminate()强杀。加载可能卡在磁盘 I/O 或 CUDA 初始化,优雅退出的路径还没建立起来,等stop_timeout没有意义。 - 已加载/睡眠的模型:
request_stop(name, send_exit=true),由 monitor 发exit并等stop_timeout。
request_stop() 先检查 stopping_models,避免重复停止;然后把名字插进集合,调用 monitor->stop()。monitor 找到这个名字最新的、非 measure 角色的子进程,写 exit,设置 deadline;子进程退出后,on_child_exit() 把状态改成 UNLOADED,清掉 stopping_models,唤醒所有等在 cv 上的线程。
unload_all() 用于进程退出:遍历所有实例,发停止命令,然后等所有实例都变成 UNLOADED 或下载状态消失。它还会取消测量队列,避免 shutdown 时还有一个 measure 子进程在跑。
崩溃:状态回到 UNLOADED,但不是“正常卸载”
子进程可能因为 OOM、CUDA 错误、段错误直接死掉,不会发 ready 或 sleeping。monitor 的 poll() 会看到管道 EOF,waitpid 拿到退出码,调用 on_child_exit():
update_status(name, { SERVER_MODEL_STATUS_UNLOADED, exit_code });update_status() 把 exit_code 写进 meta,并通过 SSE 的 status_change 事件带出去。等待中的请求会被 cv.notify_all() 唤醒,看到 UNLOADED 且 is_failed() 为真,抛出“model failed to load”。
崩溃和正常卸载在状态机上都落到 UNLOADED,区别在 exit_code 和 memory.effective 的处理:on_unloaded() 会 release() 账本并清空 effective,所以崩溃后不会留下“幽灵占用”。这一点很关键:如果崩溃的实例仍被算在 held 里,router 会以为显存还被占着,后续所有加载都会被保守地拒绝。
下载:router 也会拉起“非推理”子进程
POST /models 可以从 Hugging Face 下载新模型。router 的处理不是自己写 HTTP 下载器,而是再 spawn 一个 SERVER_ROLE_DOWNLOAD 的 llama-server 子进程,环境变量里带 LLAMA_ARG_HF_REPO 和 sidecar 列表(mmproj、草稿模型)。下载子进程复用 common_models_handler 的下载逻辑,把进度通过 downloading 状态行报给 router,完成后退出。
unfinished_downloads 记录每个模型的分片文件路径和 sidecar 类型,写在磁盘上。router 重启后能恢复“哪些下载没完成”,并阻止两个下载任务写同一批 partial 文件:
if (d.model == name || other == mapping.end() || other->second.meta.status != SERVER_MODEL_STATUS_DOWNLOADING) continue;
for (const auto & p : unfinished_downloads.get_all()) { for (const auto & q : opts.partials) { if (q.path == p.path) { throw std::invalid_argument("model '" + name + "' shares files with " "the download of '" + d.model + "' on its way"); } }}这段检查不是“防重复下载”那么简单:两个不同模型可能共享同一个 tokenizer 文件或 mmproj,如果同时写同一个 partial,字节会交错,最后两个文件都损坏。router 选择直接拒绝第二个下载,让调用方等第一个完成。
失败路径:这套账本在哪里会出错
模型没下载、文件损坏、测量失败
这三种情况在 measure 阶段就会被发现。memory.status 变成 FAILED,is_settled() 为真,make_room() 不会死等。加载时 limits_exceeded() 看到 memory.min 为空,直接跳过显存检查;子进程在 common_init_from_params() 里失败后退出,monitor 通过退出码把状态置回 UNLOADED,等待者收到“model failed to load”。
文档里还有一个细节:测量失败的模型在成功加载后会重试测量(最多两次)。原因是 -hf 模型可能在测量时还没下载完,测量子进程读不到文件;等主实例加载成功后,文件已经在了,再测一次就能得到正确结果。
端口竞争与加载竞态
common_http_get_free_port() 是“找一个当前空闲的端口”,不是“预留一个端口”。从找到端口到子进程 bind() 之间有一个窗口,另一个进程可能抢占同一个端口。子进程绑定失败会退出,router 收到错误状态,等待者失败。
这个窗口无法完全消除,除非 router 自己持有 socket 再传给子进程(SO_REUSEPORT 或 fd 传递),但当前实现选择了简单路径。实际影响不大:端口范围很大,同一台机器上同时启动多个实例的概率低;即使撞上,重试一次即可。
并发加载的容量窗口
前面提过 n_claimed,这里补充为什么光有它还不够。tick() 里的 n_free 计算发生在锁内,但 request_stop() 只是“发起停止”,子进程还没退出;n_stopping 把这些实例加回去,表示“它们马上会释放”。如果两个线程同时 tick(),都看到“有一个 stopping 实例”,都可能认为有一个空位。真正的串行化在 try_claim():只有队首能把 loading 置真。load() 里的 limits_exceeded() 复核是第三道闸。
这三层保护不是冗余,而是分别对应不同时刻:tick() 负责“提前腾空间”,try_claim() 负责“同一时刻只放一个加载者”,load() 负责“进入临界区前再确认一次”。任何一层单独使用,都会在并发下出现超卖。
请求取消与“加载到一半没人要”
如果所有等待者在加载期间都取消(客户端断开、显式 stop),队列条目会被 leave() 删除,但加载本身不会停。router 没有“最后一个等待者离开就取消加载”的逻辑,因为加载可能已经进行到一半,取消的代价(杀掉子进程、清理 partial 状态)未必比让它完成更低。
结果是可能出现“加载完成后没有请求使用它”的实例。它会在 LRU 里排到最前,下一次需要腾空间时被优先卸载;如果没有新的加载请求,它就安静地占着显存,直到 --sleep-idle-seconds 生效或者手动 unload。这个行为在容量紧张时不够理想,但实现简单,也不会破坏正确性。
显存测量的三个盲区
再强调一次三个已知盲区,因为它们直接影响线上稳定性:
mmproj不计入min。 一个带视觉编码器的模型,实际占用可能是测量值的 1.2 到 1.5 倍。给这类模型设置 margin 时要把视觉部分算进去。max是快照。 它按测量时刻的设备空闲量计算,其他模型加载后会失效。router 只用min做准入,就是不想依赖这个会变的数。- host 内存不设限。 如果模型大量层被
--fit放到 CPU,min里的 host 部分不会阻止加载,实际可能把系统内存吃满。这是--fit的既有假设,不是 router 引入的。
与外部多模型方案的对照
llama-swap:把“启停”放在进程外
llama-swap 是社区里最常见的 llama.cpp 多模型方案。它的形态是一个独立的 Go 代理进程,读 YAML 配置,按请求里的模型名启动或停止 llama-server 子进程,再把 HTTP 流量转发过去。它提供 Web UI、模型手动加载/卸载、日志流和 token 指标。
两者的核心差异在“控制面放在哪”:
| 维度 | llama.cpp router | llama-swap |
|---|---|---|
| 控制面位置 | llama-server 二进制内部 | 独立代理进程 |
| 模型配置 | cache / --models-dir / .ini preset | YAML |
| 子进程管理 | 内建 server_monitor、stdin/stdout 协议 | 外部进程管理 |
| 显存配额 | 内建测量子进程与 --models-memory-margin | 主要靠配置和外部脚本 |
| 异构参数 | preset 按模型覆盖 | YAML 按模型覆盖 |
| 额外能力 | 与 llama.cpp 版本同步,无额外依赖 | 更成熟的 UI、日志、指标 |
llama.cpp router 的优势是“零额外依赖”和“版本同步”:它和 llama-server 是同一个二进制,子进程协议、状态枚举、preset 语义都随 llama.cpp 一起演进。llama-swap 的优势是“控制面独立”:它可以管理不同版本的 llama-server、不同后端(甚至非 llama.cpp 的 OpenAI 兼容服务),UI 和可观测性也更完整。
选择哪一个,取决于你要的是“一个二进制解决多模型”,还是“一个统一网关管理多种后端”。
vLLM Production Stack:另一种分层
vLLM 的生产栈走的是另一条路:每个模型一个独立的 vLLM 实例(通常一个 Pod),前面放一个 router 做请求分发,Kubernetes 负责调度、扩缩容和故障恢复。它的“多模型”是集群级的多模型,不是单机显存里的多模型。
| 维度 | llama.cpp router | vLLM Production Stack |
|---|---|---|
| 部署单位 | 单机进程 | Kubernetes / 多节点 |
| 模型切换 | 同机 spawn / unload | 不同实例、不同 Pod |
| 显存管理 | router 测量 + LRU 卸载 | K8s 资源配额 + 每实例固定显存 |
| 调度粒度 | 模型实例 | 请求 / 副本 |
| 故障隔离 | 进程级 | Pod 级 |
| 适用场景 | 本地、单机多模型 | 集群、多租户、弹性扩缩 |
vLLM 的 router 不需要“卸载模型腾显存”,因为每个实例的显存是静态分配的,扩缩容由编排层负责。llama.cpp router 不需要 Kubernetes,因为它把“编排”压缩成了同机进程管理。两者解决的问题看起来相似,约束条件完全不同。
这也解释了为什么 llama.cpp router 的显存账本要自己测量:在没有编排层、没有容器资源限制的单机环境里,router 是唯一知道“这台机器上还有多少显存”的角色。它必须自己补上这层信息,否则 --models-max 只是一个拍脑袋的数字。
与 vLLM / SGLang 单实例调度的关系
router 的调度器不是 vLLM Scheduler 的替代品。vLLM 的调度器在一个模型实例内部决定哪些序列进 batch、分配多少 KV 块、是否需要抢占;llama.cpp router 的调度器在多个模型实例之间决定哪个模型可以加载、哪个可以卸载。两层调度的粒度和目标都不一样:
- 实例内调度追求 GPU 利用率和 token 吞吐;
- 实例间调度追求显存不超卖、请求不中断、冷启动可控。
把两层混在一起,会得到一套既不能做 token 级抢占、又不能做跨模型内存复用的系统。llama.cpp 选择把它们分开:子进程继续用前面二十五篇讲的 slot 调度,router 只做准入和生命周期管理。
小结
这一篇拆的是 llama.cpp 多模型服务里最容易被当成“运维脚本”的那一层。把它收束成六条判断:
第一,router 是控制面,不是推理面。 它不创建 llama_model、不碰 llama_context,只维护注册表、队列和子进程监视器。真正的 token 生成全部发生在子进程里,进程边界同时提供了故障隔离和“杀掉 router 即回收全部实例”的语义。
第二,模型来源有三路,优先级是缓存 < 本地目录 < preset < 命令行。 preset 对同名模型是 merge() 而不是替换,[*] 全局段先级联,router 命令行最后覆盖。dedup-cache-models 解决同一文件多名字的展示问题。
第三,请求的模型名按方法取:POST 读 body,GET/WebSocket 读 query。 别名会解析成规范名;--no-models-autoload 时未加载模型直接 400;会话请求用 conversation_id 登记,加载期间掉线不取消,显式 stop 才取消。
第四,准入队列按模型合并,加载者只能有一个。 join/leave 维护 n_waiters,try_claim 只放行队首,claim_done 失败复位,tick 用 n_running - n_stopping + n_claimed 的公式提前腾容量。队列条目同时保护模型不被别的加载流程淘汰。
第五,淘汰是 LRU,但不抢占。 pick_victim 跳过忙碌、未就绪、正在停止、队列有等待者的实例;正在服务的模型永远不会被卸,等待者只能等它自然结束。这个取舍换来了简单的请求语义,代价是尾延迟。
第六,显存账本靠测量,不靠文件大小。 measure 子进程报告 min / max,实例启动后报告 effective;calibrate 扣掉自身和已跟踪实例,算出 external;available = total - external - held,deficit 再减 margin 得到每台设备的缺口;make_room 先测量、再逐个卸 LRU,直到缺口消失。
这层代码最值得借鉴的不是某个函数,而是它对“边界”的处理:router 知道自己不知道模型要多少显存,所以拉一个测量子进程;知道自己不能抢占正在生成的请求,所以选择等待;知道子进程可能崩溃,所以把 UNLOADED 和 exit_code 一起记进状态机。多模型服务最难的部分从来不是“把请求转发过去”,而是在资源不足、进程崩溃、请求取消这些异常路径上,仍然让每一笔账对得上。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



