


稀疏注意力的新瓶颈:从 DSA 到 Indexer 加速与 KV 卸载的完整实战路线
当上下文长度从 8K 推到 128K、1M 甚至更长时,标准因果注意力(dense attention)的二次复杂度会同时以两种方式惩罚推理系统:每个 query 要和所有历史 key 做点积,计算量随长度平方增长;每生成一个 token 都要保存一层 KV,显存占用随长度线性增长。稀疏注意力是过去两年最被倚重的解法,但它把问题从一个地方搬到了另一个地方。本文沿着这条演化路线,完整讲清稀疏注意力如何从”淘汰 KV”走到”原生可训练的索引器”,以及当索引器本身成为新瓶颈之后,学术界和工业界分别用什么办法把它加速,最后再讨论一个常被忽略的事实:稀疏注意力降低的是计算,不是存储。
背景:长上下文注意力为什么成为瓶颈
先把这个问题的”量级”算清楚,后面的所有设计都绕不开它。
对一个长度为 的序列、 个 query head、 个 key/value head、head 维度为 的注意力层,因果注意力的计算量为
因子 来自因果掩码,只有一半的 query-key 对需要计算;每个 pair 需要一次 QK 点积( 次浮点运算)和一次 PV 加权( 次)。 从 8K 增到 1M 时, 增长约 1.6 万倍——这已经是推理延迟中不可忽略的部分。
存储则随 线性增长。以 MLA(Multi-head Latent Attention)为例,每层每个 token 只保存一个低秩 latent 以及一个 RoPE 小向量,单 token 单层的 KV 字节数记为 ,总 KV 占用为
其中 是在飞的并发请求数。 在几十到几百字节之间(不同模型差异很大),但只要 拉到百万级、 拉到大几十,这就是几百 GB 的级别,远超单卡 HBM。
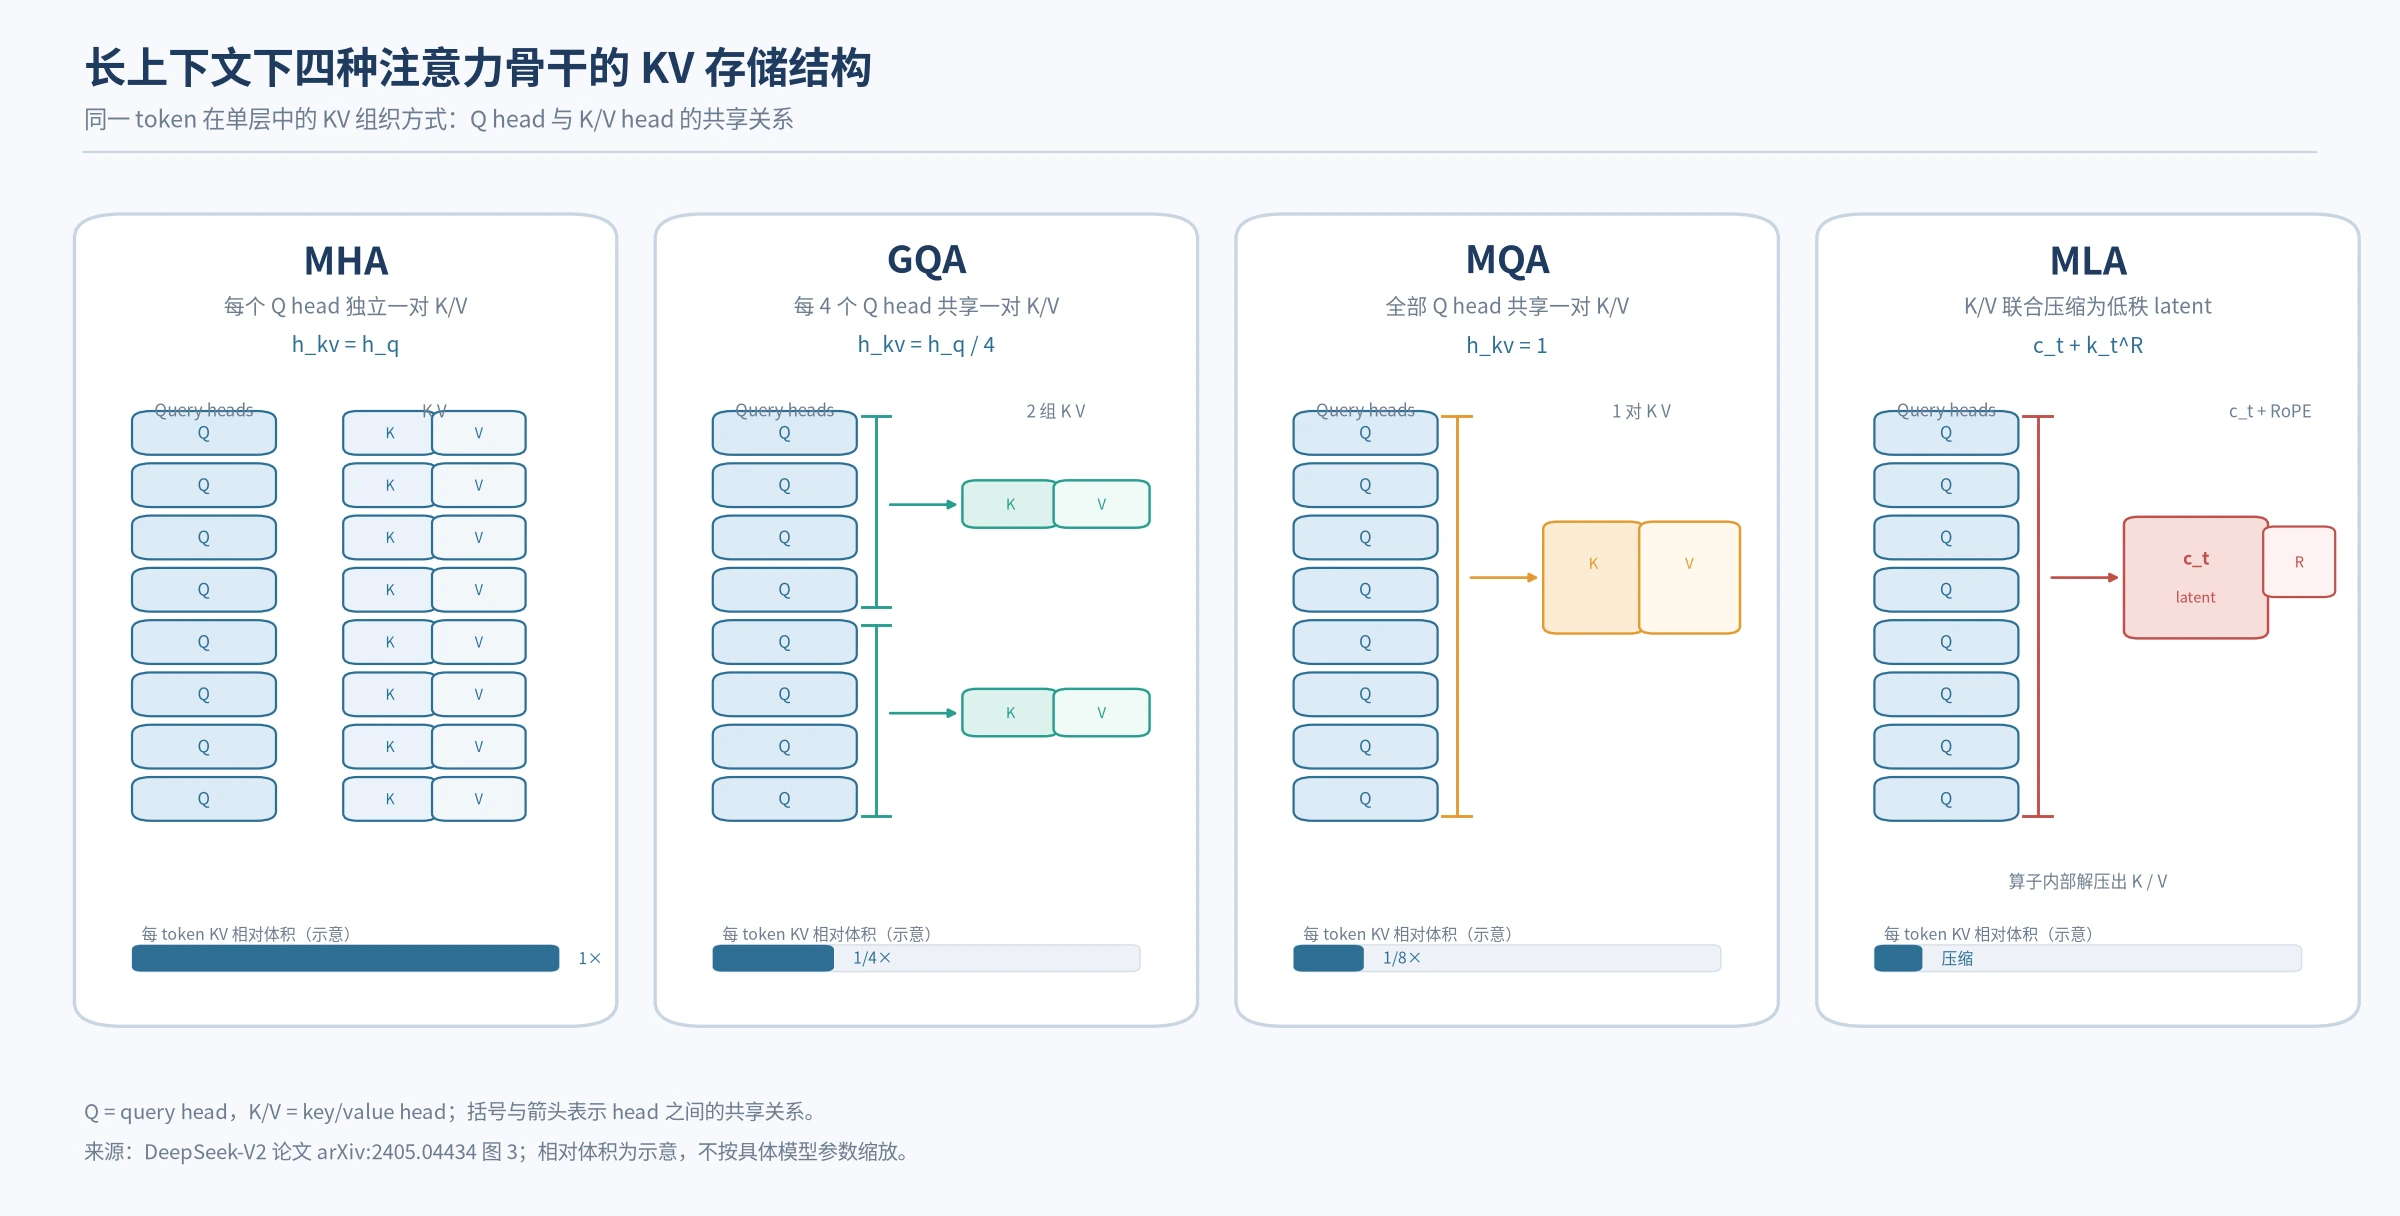
图:MHA / GQA / MQA / MLA 四种注意力骨干的 KV 存储结构。从左到右每 token 的 KV 体积依次缩小,MLA 把 K 和 V 联合压缩到一个低秩 latent 再在算子内部解压。(来源:DeepSeek-V2 论文 arXiv:2405.04434 图 3)
注意这里有两件事被混淆了:计算 O(L²) 和 存储 O(L)。稀疏注意力主要针对前者;后者需要另一套机制处理,这也是本文后半部分的主题。
稀疏注意力的基本范式:Index → Select → Attend
几乎所有现代稀疏注意力——无论训练无关还是原生可训练——都可以写成同一条三阶段流水线:
- Index(索引):用一个轻量的”索引器”(indexer)给每个候选历史位置打分。打分通常是 indexer query 与 indexer key 的内积,输出一个相关性分数。
- Select(选择):按分数选 Top- 个位置或 block。
- Attend(注意力):主注意力只在选中的位置上计算,并且仍然使用原始(或压缩后的)KV。
主注意力从 降到 (),这就是稀疏注意力的核心收益。但注意流水线的第一步:如果 indexer 对全部历史 个位置都打分,那么 indexer 仍然是 的——它变成了新的总瓶颈。这一点决定了后面所有加速工作的动机。
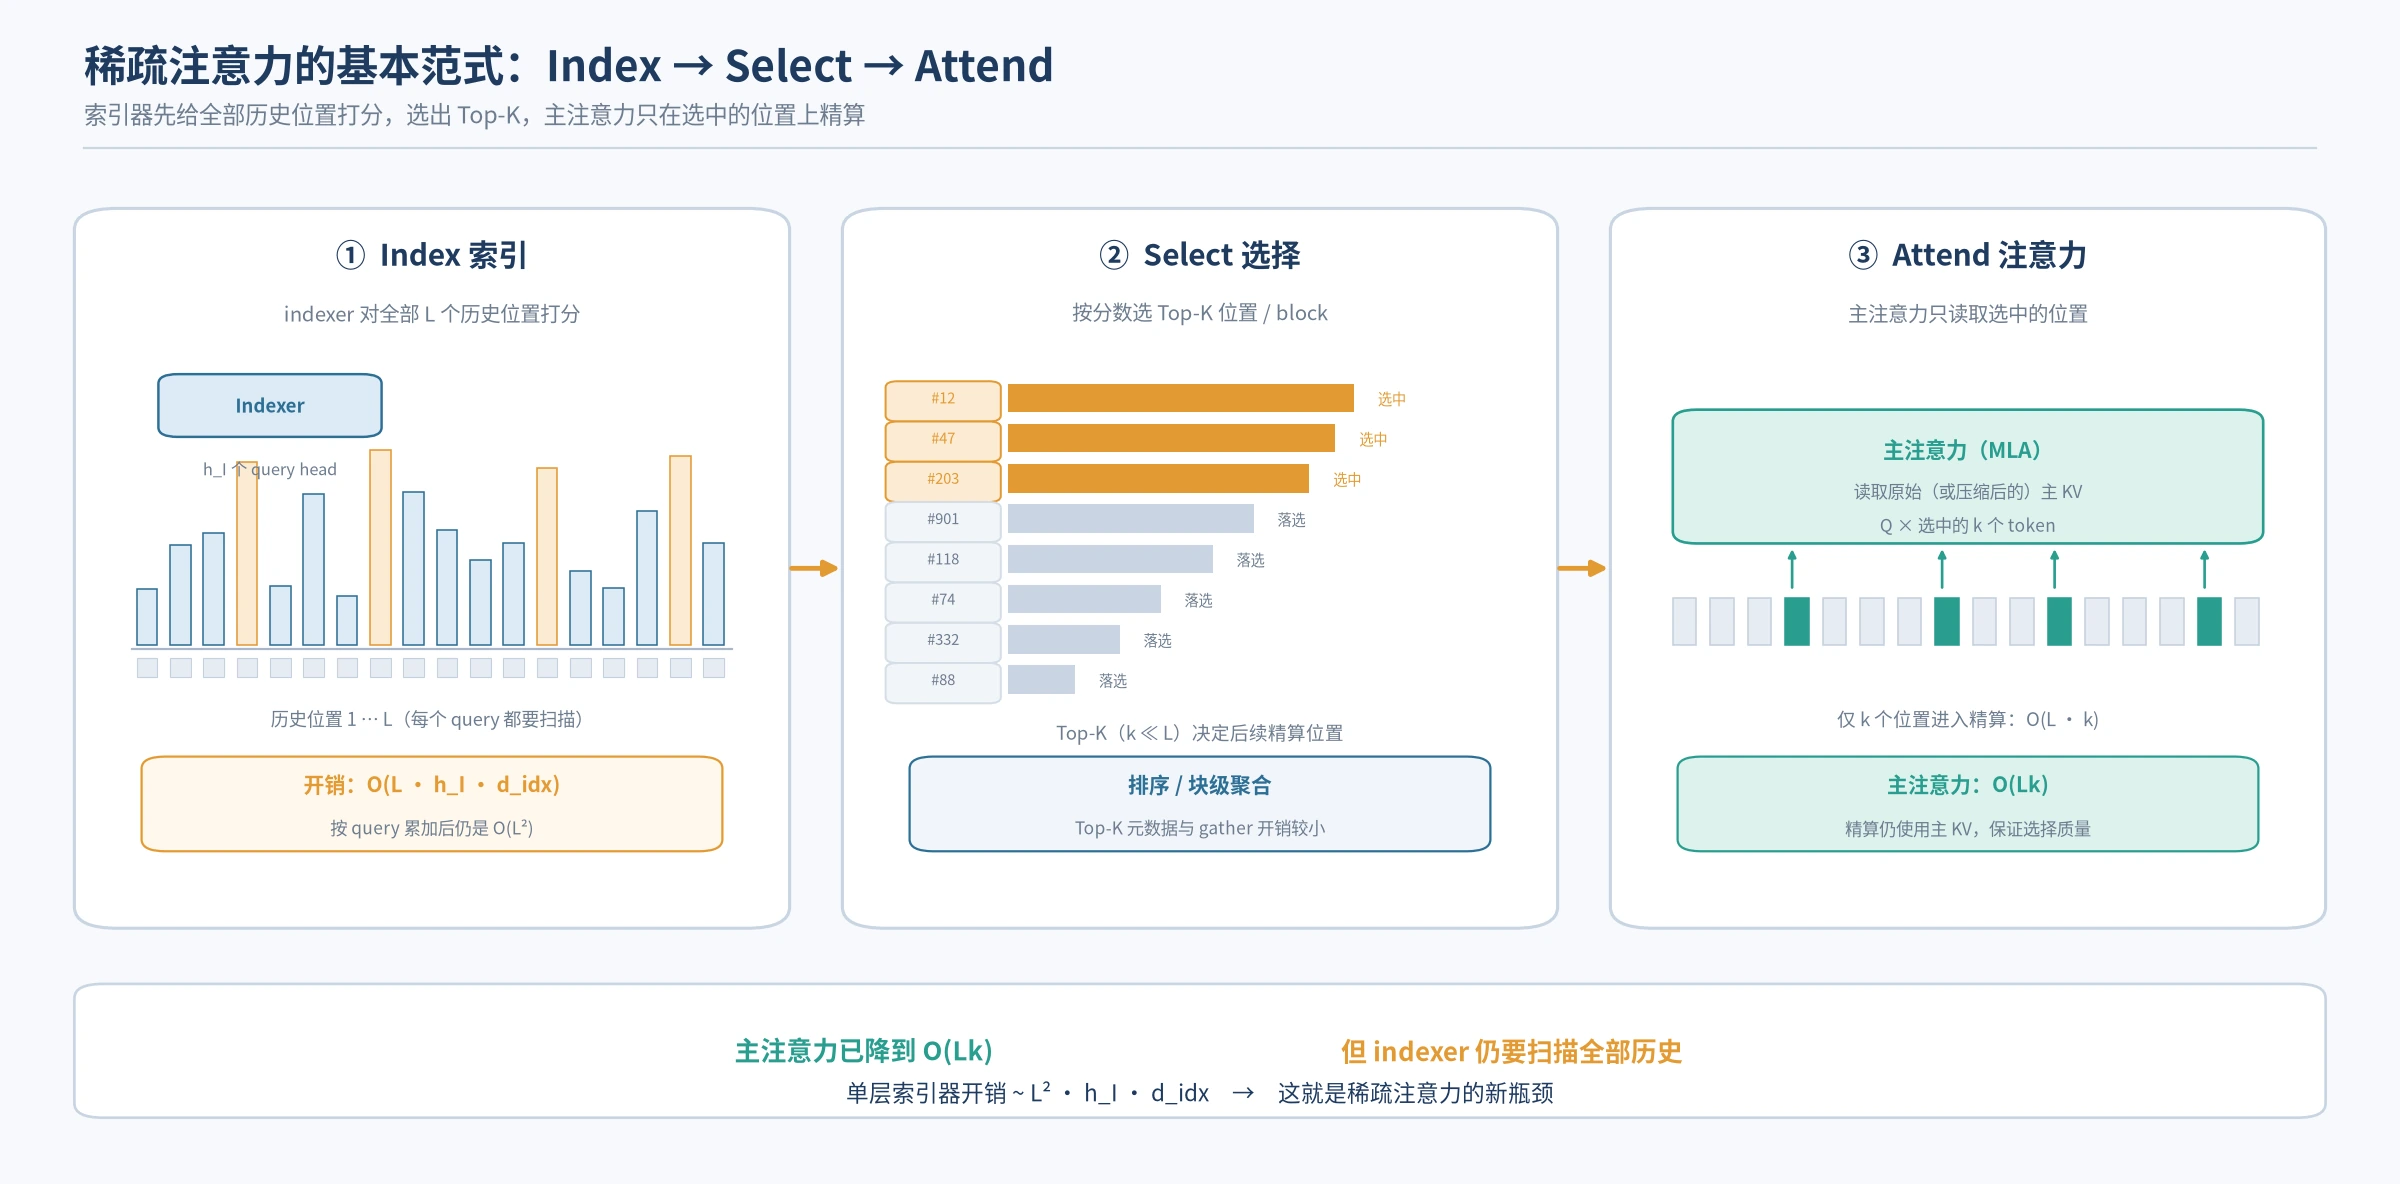
图:稀疏注意力的基本范式。索引器对全量历史打分,选出 Top-K 位置,再在主注意力中精算。(根据汤子瑜《Sparse Attn》讲解整理的自绘图)
索引器的几个设计维度
在设计或对比方案时,有几个独立维度需要分别讨论,否则很容易把不同层面的设计混为一谈:
- Attn 骨干:主注意力是标准 GQA、GQA + 线性注意力(如 Gated DeltaNet、KDA)的混合,还是 MLA。骨干决定了主 KV 的存储格式与解压开销。
- 选择粒度:是 token 级还是 block 级。token 级更精确,但 Top-K 的元数据与 gather 更散;block 级访存连续,但可能把无关 token 带进来。
- 是否有独立索引器:独立索引器可以学习、可以有自己的一套投影;不独立索引器则复用主注意力的 query 直接给 block 打分(无参数路由)。
- Indexer Q 与 Attn Q 的关系:两者是否相同、是否共享底层 latent。MLA 骨干天然只暴露一个低秩 latent query,索引器需要从这个 latent 独立投影出自己的一组 Q。
- Indexer K 的序列压缩:是否对相邻 token 做 pooling(如 4:1 池化)来缩短索引器 key 序列。
- Indexer K 的 head 共享:多个 indexer query head 是否共享同一个 indexer key head。
- 主 KV 是否压缩:是否在存储层面真正压缩主 KV,而不只是选择。
下面这张表把当前主流的几个生产级和学术级方案放在同一框架下:
| 方案 / 模型 | Attn 骨干 | 选择粒度 | 独立 Indexer | 独立 Q_indexer | Indexer K 序列压缩 | Indexer K Head 共享 | 主 KV 压缩 | 跨层复用 |
|---|---|---|---|---|---|---|---|---|
| DeepSeek V3.2 DSA | MLA | Token | √ | √ | × | √ | × | × |
| Moonshot MoBA | 标准注意力 | Block | × | × | √(块均值 K) | — | × | × |
| MiniMax M3 MSA | GQA | Block | √ | √ | ×(逐 token 打分后按块汇聚) | √ | × | × |
| Qwen QSA | GQA + GDN | 4-token block | √ | √ | √(4:1 pooling) | √ | × | × |
| GLM-5.3-Flash KPool-DSA | MLA + KDA | 4-token block | √ | √ | √(4:1 pooling) | √ | × | × |
| DeepSeek V4 CSA / HCA / SWA | 混合稀疏注意力 | 压缩 entry + 局部窗口 | 部分 | 部分 | √ | — | √ | × |
| GLM-5.x IndexShare | MLA | Token | √ | √ | × | 部分 | × | √ |
把表中”DSA 行”展开看:主注意力是 MLA,选择粒度是 token 级,有一个从 latent 独立投影出来的索引器,索引器有 64 个 query head 但只共享 1 个 key head,因此索引器 key 的存储非常小(每 token 只需一个 维向量),但索引器的计算量是”64 个 query head × 全量历史 K”。这就是后续 Indexer 加速的全部出发点。
稀疏注意力方案的演化
从”淘汰 KV”到”原生可训练索引器”,中间有几级台阶,每一级都在解决上一级的某个具体问题。
第一级:固定模式淘汰 KV(H2O、StreamingLLM)
最早的稀疏化思路非常直接:不训练任何索引器,用固定规则决定哪些 KV 保留、哪些丢弃。
H2O(Heavy-Hitter Oracle)给每个 KV 维护一个累积注意力权重(heavy hitter score),在缓存满时淘汰分数最低的 KV。它把缓存压缩成”少数热门 token + 最近一段”。StreamingLLM 则观察到:只要保留最开始几个位置的 attention sink,加上最近若干个 token 的滑动窗口,模型就能在远超训练长度的上下文上稳定工作,而不需要真正”理解”整段历史。
这类方案最大的优点是简单、无训练成本、与任何模型兼容。问题也很明显:淘汰是有损且不可逆的。被淘汰的 KV 一旦与后续 query 相关,就再也找不回来。固定模式(滑动窗口)假设”重要信息就在近处”或”就在开头几个 sink 附近”,这个假设在真实任务上经常不成立——一句话出现在 50K 之前,但恰好被当前 query 问到,滑动窗口就完全看不见它。
第二级:用部分 Q 或低维 Q 筛 KV(SnapKV、Loki 一类)
既然固定模式太粗暴,第二级思路是:用当前查询去和 KV 做一次便宜的预筛,选出候选 KV。
代表性做法是拿最后若干个 query(decode 阶段当前要生成的位置往往就在序列末尾)做一次注意力扫描,得到每个位置被关注的分数上界,再从 KV 缓存中保留分数最高的部分。这类方法的关键假设是”最近几个 query 的注意力分布能覆盖未来若干个 query 的注意力分布”,因为相邻 query 关注的 token 集合往往高度重叠。
这一级的收益在于它仍然训练无关、可以插到任何模型上。代价是:预筛用的 query 与真正要算的 query 不一致,存在近似误差;而且这种预筛在每一个 decode step 中都要跑一次完整扫描,随着 增长,预筛本身的 开销也不可忽视。
第三级:把索引器写进模型结构(DeepSeek DSA)
真正改变问题性质的是 DeepSeek-V3.2 的 DeepSeek Sparse Attention(DSA)。它不再”事后淘汰”,而是在主注意力前面装一个可训练的轻量索引器:
- 索引器从 MLA 的 latent query 独立投影出 个 query head(V3.2 中 )。
- 索引器 key 由历史 token 的 hidden state 经一个很低的维度投影得到,并且 64 个 query head 共享 1 个 key head。
- 每个 query 对全量历史计算 indexer score,选 Top-(V3.2 中 )。
- 主注意力(MLA)只在选中的 token 上做,并且读取的是原始的 MLA 主 KV。
这里有两个设计细节值得展开:
为什么索引器 key 只用一个 head。 主注意力的 KV 存储是稀缺资源,索引器的 K 如果也按 64 个 head 存,存储会翻 64 倍,抵消掉主 KV 不变的好处(索引器本来就是低维的,但乘上 head 数之后就未必了)。在训练中让索引器学习把多个 query head 的信息压缩进一个共享的 key head,相当于强制索引器在”跨 head 共识”上做选择,也顺带让索引器的 K 可以常驻 GPU。
为什么必须原生训练。 事后接入的近似索引器(第二级)只能复用现有的注意力分布,无法保证”被选中的 Top-K 恰好是主注意力真正需要的”。把索引器写进模型结构、与主注意力联合训练,才能让索引器输出的 top- 与主注意力真正依赖的位置对齐。这正是原生稀疏注意力(Native Sparse Attention)的核心主张。
关于 DSA 在生产引擎中的算子实现、Top-K 选择与稀疏 MLA 的内核细节,可以参考本站的 DSA 稀疏注意力完全拆解;关于 NSA 三个分支(压缩、选择、滑动窗口)的架构原理,可参考 NSA 原生稀疏注意力(一)。DeepSeek-V3.2 技术报告中 DSA 的成本账与双模实现,已在 DeepSeek-V3.2 技术报告精读 中逐条拆解。
第四级:继续压缩、复用(CSA、KPool、跨层共享)
一旦索引器写进模型,下一步问题就是:索引器本身还能不能更便宜?
DeepSeek V4 的 CSA / HCA / SWA 混合路线做了更激进的事情:不仅压缩索引器 K,而且真正压缩主 KV 表示。CSA(Compressed Sparse Attention)用压缩后的 entry 而不是原始 token 作为选择与 attention 的对象;HCA(Heavily Compressed Attention)在更高倍率上做全压缩;SWA(Sliding Window Attention)保留一个局部窗口以弥补压缩带来的细节丢失。这已经从”选择”进阶到”真正压缩主 KV”,也就是说它不再依赖一个完整的全量 KV 存储,而是以更低成本的表示承担历史信息。
GLM-5.3-Flash 的 KPool-DSA 走的是另一条路:在 MLA + KDA 混合骨干上,把 indexer K 先做 4:1 pooling,把索引器要扫描的序列长度直接缩短为 ;同时选择粒度从 token 级变到 4-token block 级。4:1 池化意味着索引器分数只需要对 个 block 计算,但为了保证 token 级精度,选中 block 之后再在 block 内做 token 级精修。
GLM-5.x 的 IndexShare 则盯上了另一个冗余:相邻层的 Top-K 集合高度重叠。相邻若干层共享索引器的选择结果,只有少数层真正跑完整的索引器。这一点和后面要讲的 IndexCache 是同一思路的不同工程实现。
MoBA(Moonshot) 和 MiniMax MSA 在结构上有一个有意思的差异:MoBA 没有独立索引器,直接用主注意力的 query 对 block 均值 K 做无参数路由;MSA 有独立索引器,但它是逐 token 打分后按 block 汇聚成块级选择,属于 GQA 骨干上的块稀疏注意力。前者在设计上更轻量(不需要额外参数),后者更精细(保留了 token 级信息后再 block 化)。
第五级:真正压缩主 KV 表示(V4 类的混合稀疏注意力)
从前面的表格可以清楚看到,绝大多数方案的”主 KV 压缩”一栏都是”ד。也就是说:它们在计算上只读取 Top-K 个位置的 KV,但在存储上仍然保留全部历史 KV。这一点会在后文”存储瓶颈”一节被反复提到,因为它决定了很长上下文场景下稀疏注意力能带来多少系统级收益。
只有像 V4 的 CSA / HCA / SWA 这类方案在存储层面也做了实质性的压缩,部分 token 的历史被替换成了压缩 entry,而 SWA 局部窗口保留原始细节。这种”混合稀疏”的设计是当前最激进的路线之一——本站已用一篇文章完整拆解过其机制,见 DeepSeek-V4 混合注意力完全拆解。
索引器成为新瓶颈
DSA 把主注意力从 降到 ,但索引器的代价没有随之下降。以 DSA 的索引器为例:每个 query 要和全部 个历史位置计算 indexer score,索引器有 个 query head,索引器 key 共享一个 head:
其中 是索引器 key 的维度(比主 head 维度小很多)。主注意力的代价是
如果 ,,索引器的扫描量仍然和全量成正比。随着上下文变长,主注意力的 已经很小,而索引器的 在 很大时逐渐成为主导项。Indexer Is the New Bottleneck 不是一句口号,而是复杂度账算出来的直接结论。
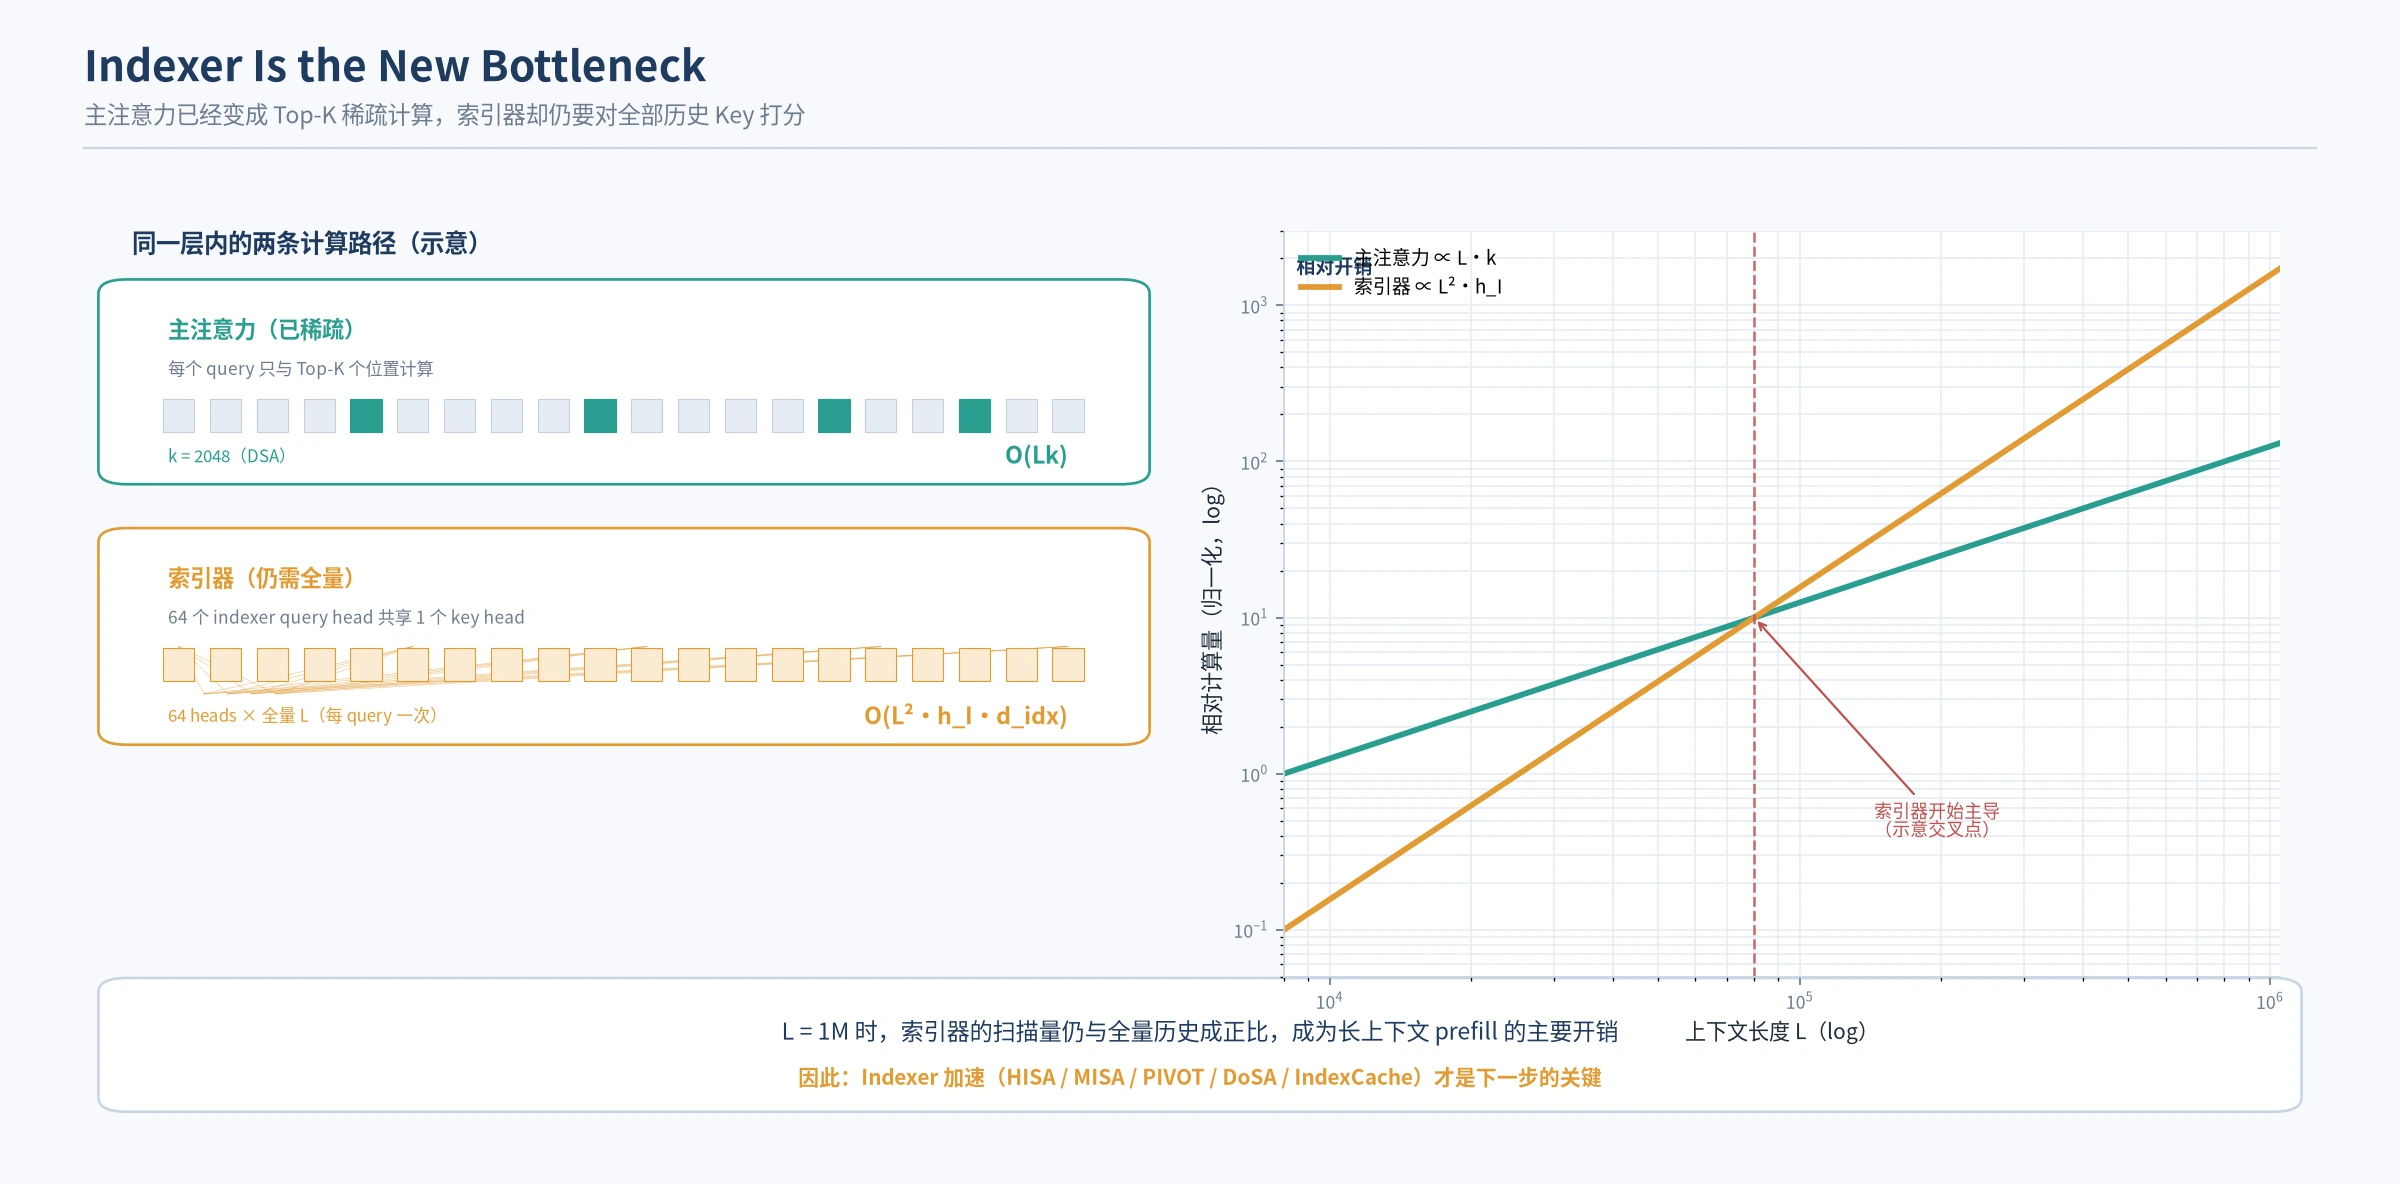
图:主注意力已经从 Dense 计算变成 Top-K 稀疏计算,但索引器仍需扫描大量历史 Key;长上下文下索引器逐渐成为主要开销。(根据汤子瑜《Sparse Attn》整理的自绘图)
既然主注意力已经受益于 Top-K 选择,为什么索引器不能同样”只扫描一部分”?因为 Top-K 选择本身就需要知道哪些候选足够相关,而不知道全量分数就无法确定哪些是 Top-K。这里的困难可以形式化为:
对于长度为 的候选集 ,选择 Top- 的精确结果,标准做法是计算全部 个分数并排序。我们是否可以只计算其中一小部分,并且仍然保证选出的 Top- 与全量计算结果完全一致?
有三种回答方式,它们构成后面几节的主体:
- 改变扫描对象(HISA、MISA):不再扫描原始的全量 KV,而是扫描一个”摘要”(block 级均值、选中的 head 子集)。
- 改变查询对象(PIVOT):不再为每个 query 扫描一次,而是用一个代表 query 扫描一次,服务一组 query。
- 跳过不可能入选的候选(DoSA):用便宜的上/下界剪枝,只对”可能入选”的候选计算完整分数。
此外,还有第四条路线不关注”是否无损”:
- 跨层复用(IndexCache):如果相邻层选出的 Top-K 高度重叠,就跳过部分层的索引器。
下面逐节展开这四条路线,其中 HISA、MISA、PIVOT、IndexCache、DoSA 在 arXiv 上均有原始论文可以追溯;每条路线的设计动机都可以回到”减少 Query × Head × Key × Layer 的冗余计算”这一个统一视角。
路线一:HISA——把 Key 搜索从扁平变层级
HISA(Hierarchical Indexed Sparse Attention,arXiv:2603.28458)试图回答:在 token 级 Top-K 之前,能否先在 block 级把大部分”不可能入选”的 Key 区域整体淘汰掉?
观察:重要 Token 在局部连续区域聚集
索引器打出来的分数有一个很强的空间结构:重要的 token 往往集中在局部连续的序列区域里,而不是完全随机地散布在整个序列。这个现象在长文档里很直观——当一段话提到”上海”,与”上海”相关的一组 token 往往排在一起;被问到一个地名时,模型真正需要的位置是那个连续段落,而不是零散在全文的若干孤立 token。
这个结构可以用 block-sparse 利用,但直接 use block sparse 的问题在于粗粒度选择会遗漏重要 token:一个 block 里只有少数几个 token 真正重要,而这个 block 因为均值不够高被整体丢弃,最终 token 级 Top-K 就不完整了。反过来,如果放宽 block 选择阈值,又会把大量无关 block 带回来,主注意力计算量回升。
设计:Block 粗筛 + Token 精修
HISA 的答案是两级索引:
- Block 粗筛:把索引器 K 按 个 token 分块,对每块做 mean pooling 得到 block K,再用同一套 indexer query 与 block K 做内积,得到 block 级分数。从 block 级分数中选出 Top-64 个 block。
- Token 精修:只对选中 block 内的 token 执行原始的 DSA 索引器。64 个 block × 128 token = 8192 个 token 参与精算,最终得到 token 级 Top-。
这里的关键参数:、Top-64 blocks、8192 候选。为什么这么设计?如果 太小,block 数变多,粗筛本身的代价就接近全量扫描;如果 太大,粗筛的粒度太粗,精修阶段要处理的候选太多(每个 block 带入的无关 token 比例增加)。 是经验上的折中:在 1M 上下文时,block 数是 8192;选中 64 个 block 后,候选是 8192 个 token,仍然足够多,能够容纳真正的分散热点;但相对于 1M 的全量扫描,粗筛的 block 级扫描量是 8192 个点积,精修只有 8192 个 token——总扫描量大约是原来的 。
注意 HISA 的粗筛阶段仍然对全部 block 打分,它降低的不是”扫描的点数”(block 级扫描也是全量扫描),而是”每个点的维度与每 token 的开销”。更准确地说,它把每 token 一次高维 indexer score 换成了每 128 token 一次低维 block score,随后再对少量候选做高维精算。
效果与代价
HISA 的收益在 LongBench 上最直接:它作为 DSA 索引器的即插即用替换,在保持下游任务质量的前提下把索引器开销降低了一个数量级。从机制上讲,它对下游主注意力的输入是完全一致的——主注意力拿到的仍然是 token 级 Top- 集合,只是这个集合是通过”粗筛 + 精修”得到的近似。
代价有两块:块均值假设和近似选择。
- 块均值会把 block 内的信息混在一起,如果某个 block 里只有一个位置极其重要、其余位置都无关,块均值分数会偏低,可能整块被丢。HISA 的 Top-64 选择通过放宽 block 数量(而不是只选几个)来降低这一风险,但它并非无损。
- 精修阶段的 token 级 Top- 是在”选中 block 内”选择的。如果真正需要的位置所在 block 被粗筛遗漏,那么无论如何精修都无法挽回。因此 HISA 在”block 级选择质量”上非常依赖块均值分数与 token 级分数的一致性。
路线二:MISA——把 Indexer Head 当 Mixture-of-Experts
MISA(Mixture of Indexer Sparse Attention,arXiv:2605.07363)沿着另一条轴的观察出发:DSA 的索引器有 64 个 query head,但这些 head 真的每次都需要跑吗?
观察:每个 Query 只需要少数几个 Indexer Head
MISA 的核心观察是:对单个 query,并不是所有 indexer head 都同等重要;需要的 head 集合随 query 改变。 索引器 64 个 query head 的投影矩阵在训练后各自负责一种”视角”,有的更偏好句法层面的邻近性,有的更偏好语义层面的话题一致性。当当前 query 是一个数字问题时,可能只有与之相关的少数几个 head 真正”投出了有效票”,其余 60 多个 head 的分数被淹没在平均里或几乎随机。
这与 MoE(Mixture-of-Experts)的思想非常契合:专家池里有很多专家,但每次只激活少数几个。索引器的 64 个 query head 就像 64 个专家,每个 query 只需要被少数几个 expert 打分。
设计:轻量 Router + Top-8 Head
MISA 的结构可以拆成三步:
- Router:把历史 Indexer K 按 分块,做 pooling 得到 block K。用 query 与 pooled K 计算相关性,得到每个 head 的”重要性”(importance)。这里的 router 是轻量的,因为它只在 block 级上计算。
- 选 Top-8 Head:每个 query 从 64 个 head 中动态选出 Top-8。
- 只在这些 Head 上精算:仅使用选中的 8 个 head,对全部历史 token 打分,得到最终的 token 级 Top-。
这里可以清楚看到它的设计逻辑:MISA 没有缩短要扫描的历史 Key( 不变),而是缩短了每个 query 的”head 维度”(64 → 8)。这个设计对 GPU kernel 非常友好,因为 head 维度压缩可以带来规整的并行度。
Hierarchical MISA(MISA†) 进一步把 HISA 的层级思想叠加进来:先用 8 个 head 做初筛,得到 Top-8192 token 候选;再用全部 64 个 head 在这些候选内筛选 Top-2048。这相当于在 MISA 之上再叠了一层”粗筛 + 精修”:粗筛用少量 head,精修用全部 head 但只对少量候选。
效果与代价
MISA 的收益:索引器成本从”64 个 head × 全量 token”降到”8 个 head × 全量 token + router 开销”,理论上是约 8 倍的计算压缩。Router 的成本取决于 block 级扫描,但 block 数远小于 token 数,所以 router 本身很小。
代价在于 Router 的准确性:如果 router 选错了 head 子集,最终 Top- 的质量就会下降;而且选错的 head 往往恰好是”少数派专家”,这些 head 在某些特定查询上可能最重要,而 router 基于 block 级统计的廉价信号不一定能识别它们。这是所有 MoE 式路由的共性问题,MISA 也不例外。
路线三:PIVOT——用一个 Proxy Query 服务一组 Query
PIVOT(Proxy Indexing Via One full-prefix Traversal,arXiv:2607.24593)观察到一个非常朴素的事实:相邻 query 的 Top-K token 集合高度重叠,直接相邻时的重合比例约为 80%–90%。
为什么相邻 Query 的 Top-K 会高度重叠
从注意力分布的角度看,这是”长尾 + 局部平滑”的自然结果。相邻两个 query 在语义上是同一段话的延续,关注的上下文段落基本一致。在 decode 阶段,这两个 query 只是相邻的生成 step,每步只多了一个 token,query 本身的语义漂移非常缓慢。所以它们用 indexer 打出来的分数分布高度相关,Top-K 集合自然大量重合。
DSA 对每个 query 独立执行完整的历史 Key 扫描,这在数学上并没有错误,但在工程上是巨大的冗余:为了得到几乎相同的结果,重复计算了 80%–90% 的分数。
设计:Proxy Query + 一次共享全量扫描
PIVOT 的答案是为一个 query 组选一个 proxy query,共享一次完整的前缀扫描:
- 聚合:把多个相邻 query 聚合为一个 proxy query(例如对它们的 query 向量做平均,或取组内某个中心 query)。
- 一次全量扫描:用 proxy query 与全量历史 Indexer K 做扫描,得到一个候选集(通常是比 略大的 )。
- 组内各自 Top-K:每个原始 query 在候选集内做一次较轻的选择,得到自己的 Top-。
关键设计在于第二步的候选集大小 与第三步的验证方式。如果候选集只等于 ,那么所有组内 query 将共享同一个 Top-,重叠比例会非常高,但会丢失组内差异;如果候选集过大,第三步的开销又回来了。PIVOT 的折中是在候选集上做精确 Top-,允许不同 query 从同一个候选池里选出不同结果。
这个设计本质上是用”query 组的语义相近”换取”扫描次数的衰减”。假设组大小为 ,则全量扫描次数从每个 query 一次降为每 个 query 一次,扫描开销降低 倍,而每 query 额外多出的是在候选集上的小规模选择开销。
效果与代价
PIVOT 的收益在 decode 阶段最大,因为 decode 阶段每步只有一个(或极少数)query,并且相邻 step 的相似度最高。训练无关、即插即用也是它的一大优势——它不需要重训索引器,可以直接替换 DSA 引擎中的索引器调用。
代价是:当组内 query 的语义差异超过预期时,proxy query 的候选集会偏斜,导致某些 query 的正确 Top- 不在候选集中。这就是 PIVOT 论文强调 “long-tailed along the key axis” 的原因——索引器分数沿 key 轴的分布是长尾的,因此候选集只需略微放大 ,就能以大概率覆盖真实 Top-。
路线四:IndexCache——跨层复用 Top-K 选择
IndexCache(arXiv:2603.12201)换了一个轴:不压缩 head、不压缩 key、不共享 query,而是压缩 layer。
观察:相邻层的 Top-K 高度重合
DSA 的每个 Transformer layer 都需要独立执行索引器。IndexCache 的两个观察很明确:
- 观察一:相邻 Layer 的 Top-K Token 集合高度重合,Overlap Ratio 达到 70%–100%。
- 观察二:不同 Layer 对 Indexer 的依赖程度不同,部分 Layer 完全可以复用前面 Layer 的 Top-K。
为什么相邻层不独立?因为相邻层的 hidden state 在语义上是高度相关的(残差流在层间平滑变化),query 也是从同一残差流投影而来,所以相邻层索引器看到的 query 向量变化不大,历史 token 的 indexer key 也变化不大,Top-K 集合自然重合。
设计:Full Layers 与 Shared Layers
IndexCache 把 layer 划分为两类:
- Full Layer(F):独立执行完整索引器。
- Shared Layer(S):复用最近的 Full Layer 的 Top-K。
问题是:哪些层应该是 F,哪些层应该是 S?这里给出了两种确定方式:
Training-Free IndexCache:贪心搜索。 对每一层,逐步尝试移除其索引器(把它变成 Shared Layer),测量对 calibration loss 的影响;选择影响最小的层持续变为 S,直到性能下降达到阈值。这个过程是一个经典的贪心搜索——它利用的是”层间冗余”这一结构性质:当某个层的索引器被移除后,其对最终输出的贡献主要由它前面 Full Layer 的 Top-K 代表,所以能承受。
Training-Aware IndexCache:多层蒸馏。 让 Full Layer 的索引器学习”服务的多个 Layer 的 attention distribution”,也就是让 Full Layer 的索引器不只为自己的层选择 Top-K,而是兼顾它后面那些 Shared Layer 的需求。这相当于把”多个层的索引需求”蒸馏到少量索引器里。
从机制上讲,IndexCache 最具有”系统级”特征:它是一个训练无关的 drop-in 替换,在现有模型上直接生效;同时它也提供了训练感知版本,让模型设计者可以在训练时把”哪些层需要索引器”作为结构选择。
在真实推理框架中的对应
跨层复用索引选择在推理引擎中其实已经有对应实现。GLM-5.3 的 SGLang 推理链路的分析发现:DSA 索引器缓存只由 21 层写入、另 57 层不写缓存只复用 Top-K——这正是 IndexCache 式跨层复用在生产引擎里的工程化形态,只是它的 F/S 划分来自模型设计本身。详见 GLM-5.3 推理全链路(十一):索引器缓存的跨层读写。
路线五:DoSA——无损加速,用上/下界剪枝
前面四条路线都在某处做近似——粗筛、选 head、共享 query、复用跨层选择。DoSA(Dots Sparse Attention,arXiv:2610.13990)走的是最”硬核”的一条:近似筛选性能有损,能不能在不改变最终 Top-K 的前提下加速索引器?
核心 Insight:Top-K 只需要”拒绝的证据”
要回答”哪些候选不可能入选 Top-”,只需要证明这些候选的分数低于第 大的分数。这里有一个关键的不等式直觉:Top-K 选择与完整分数的排序只关心截断位置,不需要精确比较所有候选之间的顺序。只要我们有一个下界(第 大的分数至少是多少)和每个候选的上界(它的完整分数最多是多少),那么任何上界低于下界的候选就都不可能入选。
这是可证明的剪枝条件。它不需要近似,只需要一个可靠的分数上界。
分数上/下界如何构造
DSA 的 indexer score 是多个 head 的内积之和:
其中 是第 个 indexer query head, 是第 个位置的 indexer key(DSA 中共享一个 key head)。注意这里用的是 DSA 的共享 key head设定——所有 query head 对同一个 key 向量打分。
DoSA 的分数分解与有界化分三步:
- Seed Set 得下界:选择少量(至少 个)候选,在所有 head 上完整计算分数,取 Top-K 得到一个第 k 大分数下界。这些就是 seed set——一个”至少不会更差的参考集”。
- 部分 Head 上界:对每个非 seed 候选,只完整计算一部分 head 的分数。利用已算出的那些 head(比如负贡献的 head 可以被激活范围界定),用不等式放缩得到剩余 head 的分数上界。
- 剪枝 + 精确过滤:上界低于下界的候选直接跳过;上界高于下界的候选,可能入选,才去计算剩余 head 的精确分数。
这里的关键设计是”H 个 head 之间的分数分解”——如果 head 的贡献可以被非负或非正的界约束,那么部分 head 的和配合这些界的放缩就能给出完整和的上界。DoSA 的论文给出的具体形式包括:非负 Head 投影为正向 contributions 提供上界,联合残差界给出整体上界,activation-informed aggregation 给出负向 head 的幅值下界。这组技术名词背后的共性是:用便宜的、可以预先计算的量,把”未知的那些 head”的贡献限制在一个区间里。
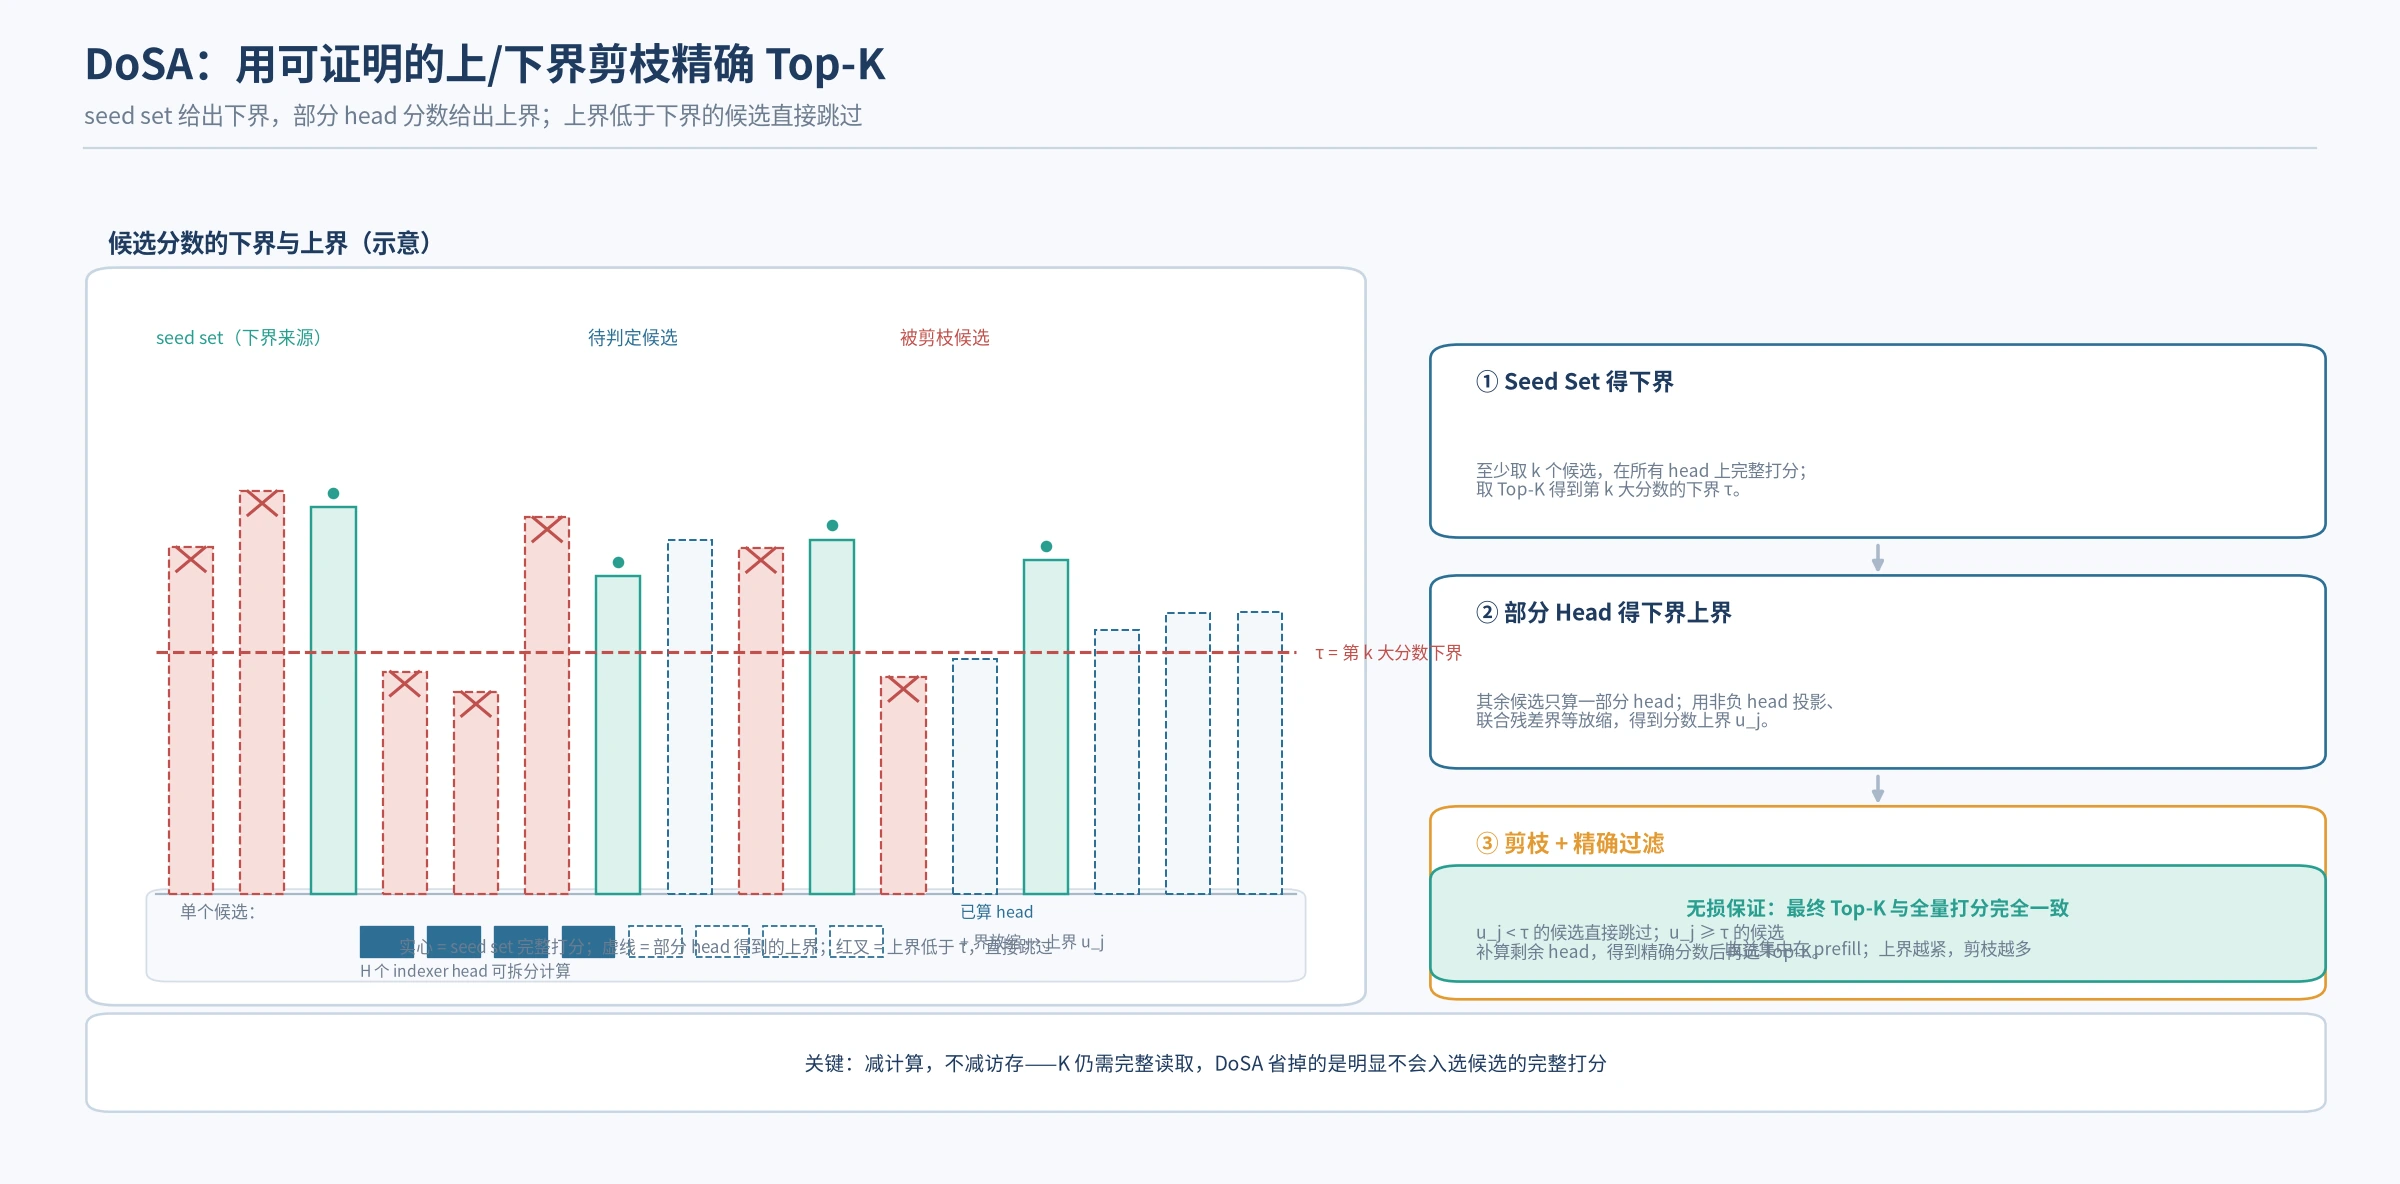
图:DoSA 用 seed set 得到 Top-K 下界,再用部分 head 的分数与放缩得到上界;上界低于下界的候选直接跳过,从而在不改变最终结果的前提下减少完整打分。(arXiv:2610.13990)
效果与权衡
DoSA 的论文表明它在保持精确 Top-K 选择的前提下减少打分计算。这里有一个非常重要的工程含义:减计算,不减访存。因为 DoSA 需要知道每个候选的部分 head 分数,它仍然要把全量 QK 读取(K 的读取是完整的),只是把那些”明显不会入选”的候选从完整打分与写回/选择中省掉。
这一点在 prefill 阶段效果最好,因为 prefill 的 query 数很多,Top-K 的候选多,剪枝空间大;而在 decode 阶段,query 很少,剪枝的收益相对小。DoSA 的论文在实验结果部分也有同样的描述:prefill 收益更明显。
代价是:DoSA 需要额外的 seed set 计算和可能的分块扫描,并且依赖于”上界紧不紧”。如果上界过于松(放缩太保守),剪枝效果会大幅下降;论文中分析了”几何与选择间隔”如何决定这个方法的有效性——当 Top-K 的分数间隔拉开时,下界与候选真实分数之间的差距就更大,剪枝更有效。
站内已有文章
DoSA 的内核设计、seed set 构造与 GPU 实现,本站已有更详细的拆解,见 DoSA 完全拆解:用可证明的提前拒绝加速精确稀疏注意力索引。
四条路线的统一视角
把 HISA、MISA、PIVOT、IndexCache、DoSA 放在一起,可以归纳出一个统一框架:索引器加速本质上是在减少”Query × Head × Key × Layer”这四个维度的冗余计算。
| 路线 | 缩减的维度 | 代表方法 | 是否无损 |
|---|---|---|---|
| 层级索引 | Key(先缩到 block,再对少量 block 精算) | HISA | 近似 |
| MoE 式 head 路由 | Head(只算被路由到的少数 head) | MISA | 近似 |
| Query 共享 | Query(用一个 proxy query 服务一组 query) | PIVOT | 近似 |
| 跨层复用 | Layer(少量 Full Layer 算,其余复用) | IndexCache | 近似 |
| 上/下界剪枝 | 计算(跳过不可能入选的候选) | DoSA | 无损 |
这张表本身就是一个很好的检验清单:当看到一个新的”Indexer 加速”工作,先问它缩减了哪一维、是否无损、代价落在哪里。绝大多数工作都在某一维上做近似,而 DoSA 是唯一在计算维度上做了精确剪枝的工作。这里也不是说无损一定更好——无损的剪枝依赖上界质量,如果上界松,收益会打折;有损的方法如果把误差压在可接受范围内,收益更直接。两条路线是互补的,不是替代关系。
工程落地:这些加速如何进入推理引擎
要把这些方法和推理引擎的实际调度对齐,需要先理解引擎中索引器的执行方式。
典型的 DSA 推理流程(以 vLLM / SGLang 的 DSA 实现为例)大致分为:
- 主注意力层前的 indexer score 计算:indexer Q 与全量 indexer K 做点积,得到每个 query 的分数向量。
- Top-K 选择:对每个 query 的分数做 Top-,得到位置索引。
- 稀疏 MLA/主注意力:按位置索引从主 KV 中 gather 出选中位置,做注意力。
其中第 1 步和第 2 步就是本文讨论的”索引器”,第 3 步是”主注意力”。HISA、MISA、DoSA 替换的是第 1 步的算法;PIVOT 改变第 1 步的执行上下文(服务多个 query);IndexCache 减少第 1 步被调用的次数(跨层复用)。
从调度角度看,最有可能的落地方式是:
- HISA / MISA / DoSA 作为替换 kernel 的即插即用组件:引擎调度层不变,只把索引器 kernel 换掉。
- PIVOT 需要在调度层感知 query group:引擎需要把相邻生成的 query 聚合起来,这对 decode 阶段的连续生成比较自然,但对 prefill 阶段的分块调度有额外复杂度。
- IndexCache 需要在模型层定义 F/S pattern:它既可以是训练无关的推理时选择,也可以是训练时确定的结构。
- 模型设计层面的方案(KPool、IndexShare 等)需要模型训练与引擎双方对齐:索引器 K 的池化比例、块的粒度、跨层共享的模式都由模型定义,引擎只是跟随模型的稀疏结构。
推理引擎在这些方案上的实现细节,可以参考本站 GLM-5.3 推理全链路系列,例如 GLM-5.3 在 SGLang 中的一个请求 和 GLM-5.3 在 vLLM 中的算子融合与索引器复用。这些文章都展示了索引器与其它算子同处一个长链路的实际情况,以及索引器算法一旦改变,链路中其它环节(如调度、CUDA graph、KV 分配)会如何受影响。
多卡与通信:稀疏注意力并不天然”省通信”
稀疏注意力在多 GPU 上的一个常被忽略的事实是:卡间通信占比可能并不像计算那样减少。
在 DSA 等稀疏注意力下,每个 DP(数据并行)worker 计算各自的 sparse attention,而主注意力的 MoE 部分可能跨 DP 通信。如果仔细拆开,一次请求的通信账本里,主注意力的 Q/KV 通信相对于 MoE 的 all-to-all 占比其实很小——即使主注意力计算从 降到 ,它原本占的通信比例也没那么高。Sparse Attention 多卡计算如 TP(张量并行)和 CP(上下文并行)时,卡间 Query、KV 等通信占比较少,真正成为瓶颈的是 MoE 的专家通信和调度开销。
这一点在实际系统设计里非常重要:不要因为稀疏注意力把 attention 计算降下来,就认为”多卡通信的比例也会同比例下降”。稀疏注意力减少了 attention 的计算与 KV 读取,但 KV 存储、调度、MoE 通信这些维度并不会因为稀疏化而变小。
存储瓶颈:稀疏注意力并不真正淘汰 KV
到这里必须把这一点讲透:以 DSA 为代表的稀疏注意力不会真正 evict KV,因此计算虽然减少,存储需求不变。
原因很直接:Top-K 选择是每个 query 独立选择的。当前 query 选的 Top-K 是这 2048 个,下一个 query 选的可能是另外 2048 个(尽管重合比例高,但不完全一致)。如果系统真的淘汰”没被选中”的 KV,那么当后续 query 恰好需要它时,就无法找回,等于变成有损稀疏化。为了保证模型质量不变,系统必须保留全部历史 KV。
因此,稀疏注意力对 HBM 容量压力的缓解非常有限:
- 计算上:每个 query 只读 个位置,读取量 。
- 存储上:全量 个位置的 KV 仍然在 HBM 中(或者某个更低级的存储中),。
于是出现了一个明显的矛盾:稀疏注意力计算稀疏、读取稀疏,但存储不稀疏,HBM 容量仍然是限制。
一个非常具体的例子可以说明问题的量级:在 8×H20 上,DeepSeek-V3.2 每个 Attention DP worker 只能容纳约 380K tokens 的 KV。稀疏 FlashMLA kernel 由于不连续访存,需要更大的 batch size 才能充分利用 GPU 计算吞吐;但更大的 batch 意味着更小的单请求可用 HBM——HBM 容量因此成为吞吐的瓶颈。
这说明:稀疏注意力降低了计算,但它也需要更大的 batch 才能摊销非连续访存的开销;而 batch 增大又受限于 HBM 容量。 这两者形成闭环瓶颈,是 ECHO、Janus 等存储侧工作的直接动机。
ECHO:把不常用的 KV 放到主机内存
ECHO(Efficient KV Cache Offloading with Lossless Prefetching for Serving Native Sparse Attention LLMs)针对的是上节描述的”HBM 容量瓶颈”。它的核心思路是:把 KV Cache 卸载到主机 DRAM,利用 GPU HBM 缓存热点 KV,从而支撑更高的并发。
分层 KV 存储
ECHO 的分层存储策略非常明确:
- Indexer K 常驻 GPU:索引器需要扫描全部历史 indexer K,如果这部分不在 GPU,每次扫描都要走 PCIe,开销不可接受。因此索引器 K 虽然体积小(因为 DSA 的 indexer K 共享 head、维度低),但它必须常驻 HBM。
- 完整 MLA KV 存储于 Host DRAM:主 KV 是整个存储里最大的部分。把它放到主机内存是 ECHO 的核心选择。
- GPU 只缓存热点 KV:根据访问热度,把一部分主 KV 保留在 HBM。
这个分层的依据是”访问频率”:每个 indexer 都对全量索引器 K 打分,所以索引器 K 是热数据;主 KV 的访问则是按 Top-K 选中的位置,只有近期高频出现的位置才是热的。
CUDA Graph 友好的缓存管理器
一个分层缓存系统在推理引擎中非常容易碰到的问题:稀疏注意力的各 Layer 选择不同的 KV,动态 Allocation / Eviction / Recall 造成 CUDA Graph Break。
CUDA Graph 是推理引擎把固定形状的一串 GPU kernel 打包成一个图并一次性提交的技术,它能消除 launch 开销。CUDA Graph 的关键约束是图在编译后形状与内存地址固定不变。如果一个 kernel 需要动态分配、动态驱逐、动态召回 KV,那它的地址和形状会变,CUDA graph 就会 break,引擎退回普通 launch,loss 大幅回升。
ECHO 提出的 Graph-Friendly Cache Manager 正是为了在不破坏 CUDA graph 的前提下完成动态 KV 管理:
- Metadata 使用固定长度 GPU Tensor:维护 Free Bitmap、Eviction Priority、GPU ↔ Host Mapping,这些元数据以固定长度的 GPU tensor 形式存在,不随 KV 变化而变化,从而无需重新 capture 图。
- 在 GPU 内完成所有操作:Atomic Allocate、Priority-based Free、Parallel Recall,全程在 GPU 内执行,避免 CPU-GPU 同步。
- Per-Layer 缓存分配:每个 layer 有自己的 cache,独立管理。
这里的关键是”数据和图分离”:CUDA graph 需要固定的内存布局,而 KV 的分配是动态的。ECHO 用固定长度的元数据 tensor 来描述动态分配,实际数据位置由元数据指向,从而让分配/驱逐/召回操作不改变图的形状。
Lossless Prefetching:提前取 KV 但不影响结果
ECHO 的第三个组件是 lossless prefetching,它利用了相邻 decode step 之间的一个统计性质:相邻 Decode Step 的第 k 大 Indexer Score 具有较强的数值可预测性。
这意味着你可以用一个轻量的预测来估计”本步第 k 大的 indexer score 大概在什么水平”,从而推算出本步可能入选的阈值。在 indexer score 计算期间(这段时间 GPU 正在打全量分数),可以提前 Fetch 超过阈值的 KV——等 indexer 算完,需要 fetch 的 KV 已经有一半在路上了。
关键在于”lossless”:最终仍然执行 Exact TopK,并通过 Recall 补取遗漏的 KV。预测只是提前把”很可能被选中”的 KV 搬上来,它不影响最终的选择结果——如果预测正确,这一步 KV 已经在 GPU 上;如果预测遗漏,最终补取(Recall)即可,结果与不预取时完全一致。
这一点和投机解码里的”草稿 + 验证”思路是同构的:草稿(预测)先做,验证(Exact TopK)后做,验证保证结果不变。
实验与收益归因
ECHO 的实验设置是 8×H20(96GB HBM)、PCIe Gen5、DeepSeek-V3.2 W4 AWQ、Attention DP8 + MoE TP8、InfiniteBench 长上下文。在这套设置下,ECHO 观察到:
- 收益主要来自 Host mem 提升了 Batch size。这是最重要的一点——ECHO 不是通过”让 attention 更快”来加速,而是通过把 KV 放到主机内存来腾出 HBM,从而允许更大的 batch,用更大 batch 的吞吐来获得整体收益。
- 多数 Layer 的 GPU Cache Hit Rate 为 97%–99%,说明在真实的访问模式下,热点 KV 的命中率极高,HBM 中保留的小容量已经足够覆盖绝大部分访问。
- Prefetching 其实作用不大。因为 hit rate 已经 97%–99%,预取能提前命中的部分本来就寥寥无几。这是一个很有价值的结论:在 hit rate 极高时,预取机制本身的边际收益很低;真正的收益来自”把容量挪到主机内存后能开更大的 batch”。
ECHO 的结论直接提示了系统设计者的一个原则:在做 KV 分层时,先检查命中率,再考虑预取。如果命中率已经 97%+,瓶颈就不在预取,而在容量与 batch 大小的权衡。
Janus:在 Agentic Serving 下从 SSD 装载稀疏 KV
如果说 ECHO 处理的是”主机内存”层级,Janus(Efficient Agentic LLM Serving over SSD-based Sparse KV Storage,arXiv:2609.36938)处理的是更便宜但也更慢的”SSD”层级。它面对的场景与普通长上下文不太一样:Agentic workload。
问题特征:多轮工具调用 + 长历史 + 短追加
Agentic 场景里的请求特征是:
- 多轮工具调用带来 Long History + Short Append:一个对话会话会经历多轮,每轮 append 一小段内容(工具输出、推理步骤),历史不断累积。
- 历史 KV 需要跨 Round 持续复用:如果每轮都重算历史,代价不可接受。因此历史 KV 必须跨 round 保留,从外存读取。
Janus 的两个观察:
- 观察一:Append Prefill 的多个 Q 访问大量历史 KV;后续 Decode 所需的历史 KV 约 99% 已在 Append Prefill 中加载。这意味着,如果能在 append prefill 时把历史 KV 装入一个稍大的缓存,后续 decode 几乎全部命中。
- 观察二:多轮复用使累计 KV Read Volume 达到 Write Volume 的 3.9–23.5 倍。读远大于写,说明这套场景是 读主导 的,优化重点应放在读路径。
核心挑战:I/O 落在关键路径上
Janus 的核心挑战不在容量,而在延迟时序:
稀疏 KV Selection 依赖当前 Layer 的 Hidden States,只有 Indexer 完成后才能确定 SSD Read 的位置,导致 I/O 落在 Critical Path。
这是所有存储在”关键路径”上的系统的经典问题。对于 SSD 层级,延迟比 DRAM 大一个数量级以上,把 SSD 读放在关键路径上会让延迟失控。于是 Janus 的核心问题是:能不能在 indexer 完成之前就预测到需要读哪些 KV?
Cross-Layer Lookahead KV Prefetch
Janus 的答案是:Lookahead Prediction——在 Layer 使用较早的 Hidden States,提前运行 Layer 的 Indexer,预测其 KV Selection。
这里利用的是层间 hidden state 的相似性:较早层的 hidden state 与较晚层的 hidden state 在语义上相近,用较早层的 hidden state 提前预测较后层的 Top-K,可以在真正执行到 Layer 之前就把 KV 从 SSD 拉上来。
关键设计是 Corrective Read:真正执行到 Layer 时,重新计算 Exact TopK,只补取预测遗漏的 KV,从而保持模型输出不变。和 ECHO 的 lossless prefetching 一样,预测只负责提前搬运,正确性由事后精确选择保证。
Sync Free:预测阶段不需要算出完整 TopK,也无需多卡同步。这一点对多卡效率非常重要——如果预测阶段需要完整 TopK 与跨卡同步,那可能比直接做一次精确选择更贵。Janus 因此把预测保持为”低成本、无同步”的阶段。
SSD 感知的 I/O 优化
除了 lookahead 预测,Janus 还针对 SSD 的物理特性做了三项 I/O 优化:
- Best-effort Read Packing:合并物理连续的选中 SSD Blocks,减少小粒度 NVMe Commands。SSD 对小粒度随机读的吞吐远低于大粒度连续读,因此把”物理连续”的选中 block 合并成一次大读,能大幅降低命令数。
- CPU-assisted Write Packing:在 CPU Staging Buffer 中重排零散 KV,避免 GPU Packing 与模型计算争抢 SM 资源。把写路径上的 packing 放到 CPU 上,GPU 不为此消耗 SM。
- Phase-aware Write Capping:限制后台 SSD 写带宽,减少 Read–Write Interference。SSD 的读和写共享内部带宽,如果后台写占用了太多,前台读延迟就会上升。在关键读阶段,限制写带宽是稳态设计。
这三项优化体现了一个原则:SSD 层级的稀疏 KV 存储,优化点不在”选得准”而在于”把读变成大块、把写移出关键路径、减少读写干扰”。
存储侧的几条系统设计法则
从 ECHO 和 Janus 两条路线,可以抽出几条通用法则:
- 索引器数据的层级选择由访问频率决定。 索引器 K 被全量扫描,常驻高速存储;主 KV 只被少量 Top-K 访问,可放到低速存储。
- 无损预取的关键是”验证在最后”。 预测只是提前搬运,不改变最终结果;最终 Top-K 精确计算,遗漏用 Recall 补。
- CUDA graph 是推理引擎的硬约束。 任何动态管理(分配、驱逐、召回)都必须做到”元数据固定、数据可变”,否则 graph break。
- 收益归因不可混淆。 ECHO 的收益主要不是预取,而是 batch size;Janus 的收益不是预测本身,而是把 I/O 挪出关键路径。判断一个系统的收益来源,要看它改变了哪个约束。
- SSD 层级的瓶颈是命令粒度与读写干扰,不是容量与选择精度。 read packing、write capping 这些”物理层”优化比算法层的 Top-K 更直接。
小结与展望
把这个主题压缩成几句话:
- 长上下文下,主注意力从 Dense 变成 Top-K 稀疏;但索引器仍是 ,逐渐成为新瓶颈。 Index → Select → Attend 的范式里,瓶颈从左端(Attend)转移到了第一个箭头(Index)。
- Indexer 加速的本质是减少”Query × Head × Key × Layer”四维冗余。 HISA 缩 Key(层级索引),MISA 缩 Head(MoE 路由),PIVOT 缩 Query(proxy query 共享),IndexCache 缩 Layer(跨层复用)。DoSA 换了个思路:用上/下界剪枝,无损地跳过”不可能入选”的计算。
- 稀疏注意力减少了计算与 KV 读取,但不减少 KV 存储。 以 DSA 为代表的稀疏注意力不会真正淘汰 KV,HBM 容量仍然是限制。这直接催生了把 KV 放到主机内存(ECHO)和 SSD(Janus)的工作。
- 目前的工作较局限于减计算量。 访存、通信等维度同样值得考虑:稀疏注意力的读取是稀疏的,但存储与通信并不稀疏;多卡场景中 attention 的通信占比本来就小,真正的瓶颈在 MoE 通信、调度与容量。
- 模型层面的压缩是更彻底的解决方案。 V4 的 CSA / HCA / SWA 已经把压缩延伸到了主 KV 表示,KPool、IndexShare 这类模型设计也在从结构上减少索引器本身要覆盖的范围。索引器的加速最终会与”主 KV 是否压缩”耦合在一起——如果主 KV 已经被压缩到足够小,存储侧问题会小很多;如果主 KV 仍然全量,那 ECHO / Janus 这类分层存储永远有存在的必要。
最后要提醒的是:索引器加速不是”越无损越好”的单目标问题。DoSA 证明了无损剪枝可行,但它依赖上界质量;HISA、MISA、PIVOT、IndexCache 做了近似但带来了更直接的收益。选择哪条路线,取决于下游对 Top-K 精度的容忍度,以及引擎目前的瓶颈落在计算还是存储。
参考资料
- DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention
- HISA: Efficient Hierarchical Indexing for Fine-Grained Sparse Attention
- MISA: Mixture of Indexer Sparse Attention for Long-Context LLM Inference
- PIVOT: Efficient Query-Group Indexing for Token-Level Sparse Attention
- IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse
- DoSA: Dots Sparse Attention
- Efficient Agentic LLM Serving over SSD-based Sparse KV Storage
- ESS: An Offload-Centric Latent-Cache Management Architecture for DeepSeek-V3.2-Exp
- AVSG: Accelerated Vectorized Sparse Gather for Efficient KV Cache Offload in Sparse-Attention LLM Serving
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- Moonshot AI MoBA: Mixture of Block Attention
- DeepSeek-V3.2 技术报告精读:DSA 的成本账、双模实现与稀疏注意力的质量验证
- DSA 稀疏注意力完全拆解:从 DeepSeek-V3.2 的闪电索引器到 vLLM 的算子实现
- DeepSeek-V4 混合注意力完全拆解:CSA + HCA + 滑窗,百万上下文如何便宜 10 倍
- DoSA 完全拆解:用可证明的提前拒绝加速精确稀疏注意力索引
- KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存
- GLM-5.3 推理全链路(十一):索引器缓存的跨层读写
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



