


Kimi K3.1 Pro 架构完全拆解:69 层 KDA、24 层 Gated DSA 与 896 选 16 的 LatentMoE
Kimi K3.1 Pro 是 Moonshot AI 在 2026 年 10 月底发布、11 月初开放权重的模型,总参数 2.8 万亿、每 token 激活 1040 亿、上下文长度 100 万 token,并且原生支持图像输入。它并不是一次从零开始的预训练,而是从 Kimi K3 出发、经过更大规模联合强化学习得到的后训练版本。真正值得推理侧关心的是它保留并改写了哪些结构:93 层主干里有 69 层 Kimi Delta Attention(KDA)和 24 层全局注意力;K3 原本的 24 层 Gated MLA 在 K3.1 Pro 中被替换成 Gated DeepSeek Sparse Attention(Gated DSA);每层注意力后面都接一个从 896 个路由专家中选 16 个的 Stable LatentMoE;层与层之间用 Attention Residuals 做深度方向的检索。
这篇文章围绕模型结构与推理路径展开。训练配方只作为理解结构动机的背景,不展开预训练数据、强化学习流程或优化器细节。文中所有结构数字来自 Kimi K3 技术报告、Kimi K3.1 Pro 的公开模型卡与 config.json,成本估算会明确标注为按公开参数推导的估算值,而不是厂商实测。
一、K3.1 Pro 在 K3 上改了什么
先把两代模型的骨架摆在一起。K3 的总参数是 2.78 万亿,激活 1042 亿,93 层,其中 69 层 KDA 加 24 层 Gated MLA。K3.1 Pro 的总参数、激活参数、层数、隐藏维度都没有变化,结构上唯一明确的改动是把 24 层 Gated MLA 换成 24 层 Gated DSA。模型卡对此的说明很直接:相比 K3,替换全注意力的 Gated MLA 层,是为了让长上下文建模更高效。
这个改动的位置很关键。K3 的混合注意力采用 3:1 的比例:每个四层块里,前三层是 KDA,第四层是全局注意力;主干末尾再额外放一层全局注意力,保证最后一层一定能看到完整上下文。93 层正好拆成 23 个四层块(92 层)加 1 层收尾全局层,于是 69 层 KDA 与 24 层全局注意力相加为 93。K3.1 Pro 没有动这个排布,只是把每个四层块里的那一层全局注意力从 MLA 换成了 DSA。
| 项目 | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| 总参数 / 激活参数 | 2.78T / 104.2B | 2.8T / 104B |
| 层数 | 93(1 层 dense + 92 层 MoE) | 93(1 层 dense + 92 层 MoE) |
| 注意力层构成 | 69 KDA + 24 Gated MLA | 69 KDA + 24 Gated DSA |
| 隐藏维度 / 注意力头数 | 7168 / 96 | 7168 / 96 |
| 全局注意力 KV 压缩 | MLA,latent 512 + RoPE 64 | MLA 式 latent,NoPE |
| 路由专家 / 每 token 激活 | 896 / 16,2 个共享专家 | 896 / 16,2 个共享专家 |
| LatentMoE 维度 / 专家隐维 | 3584 / 3072 | 3584 / 3072 |
| 上下文长度 | 1M | 1M |
| 视觉编码器 | MoonViT-V2,401M | MoonViT-V2,401M |
| 权重 / 激活精度 | MXFP4 / MXFP8(QAT) | MXFP4 / MXFP8(QAT) |
表中的“MLA 式 latent”需要解释。DSA 本身只规定“先算索引分数、再对 top-k 个 key-value 条目做注意力”,它并不规定 key-value 条目长什么样。DeepSeek 在 V3.2 里把 DSA 实例化在 MLA 的 MQA 模式上:每个 token 仍然只缓存一份低秩 latent 向量,所有查询头共享这份条目。K3.1 Pro 的 config.json 保留了 kv_lora_rank: 512、qk_rope_head_dim: 64、v_head_dim: 128 这些 MLA 字段,同时增加了 dsa_config,说明它走的是同一条路线:全局注意力层仍然用压缩后的 latent KV 存储,只是读取时不再扫描全部 token,而是先由索引器挑出 2048 个。
这里就能看出 K3.1 Pro 的两条互补路线。KDA 解决的是“每层都要存不断增长的 KV”这个问题,用固定大小的循环状态换掉逐 token 的 KV;DSA 解决的是“全局层仍然要读完整上下文”这个问题,用一次轻量索引扫描换掉全量注意力。两者叠加,才使 100 万 token 的推理在容量和带宽上都变得可承受。
二、93 层主干的排布逻辑
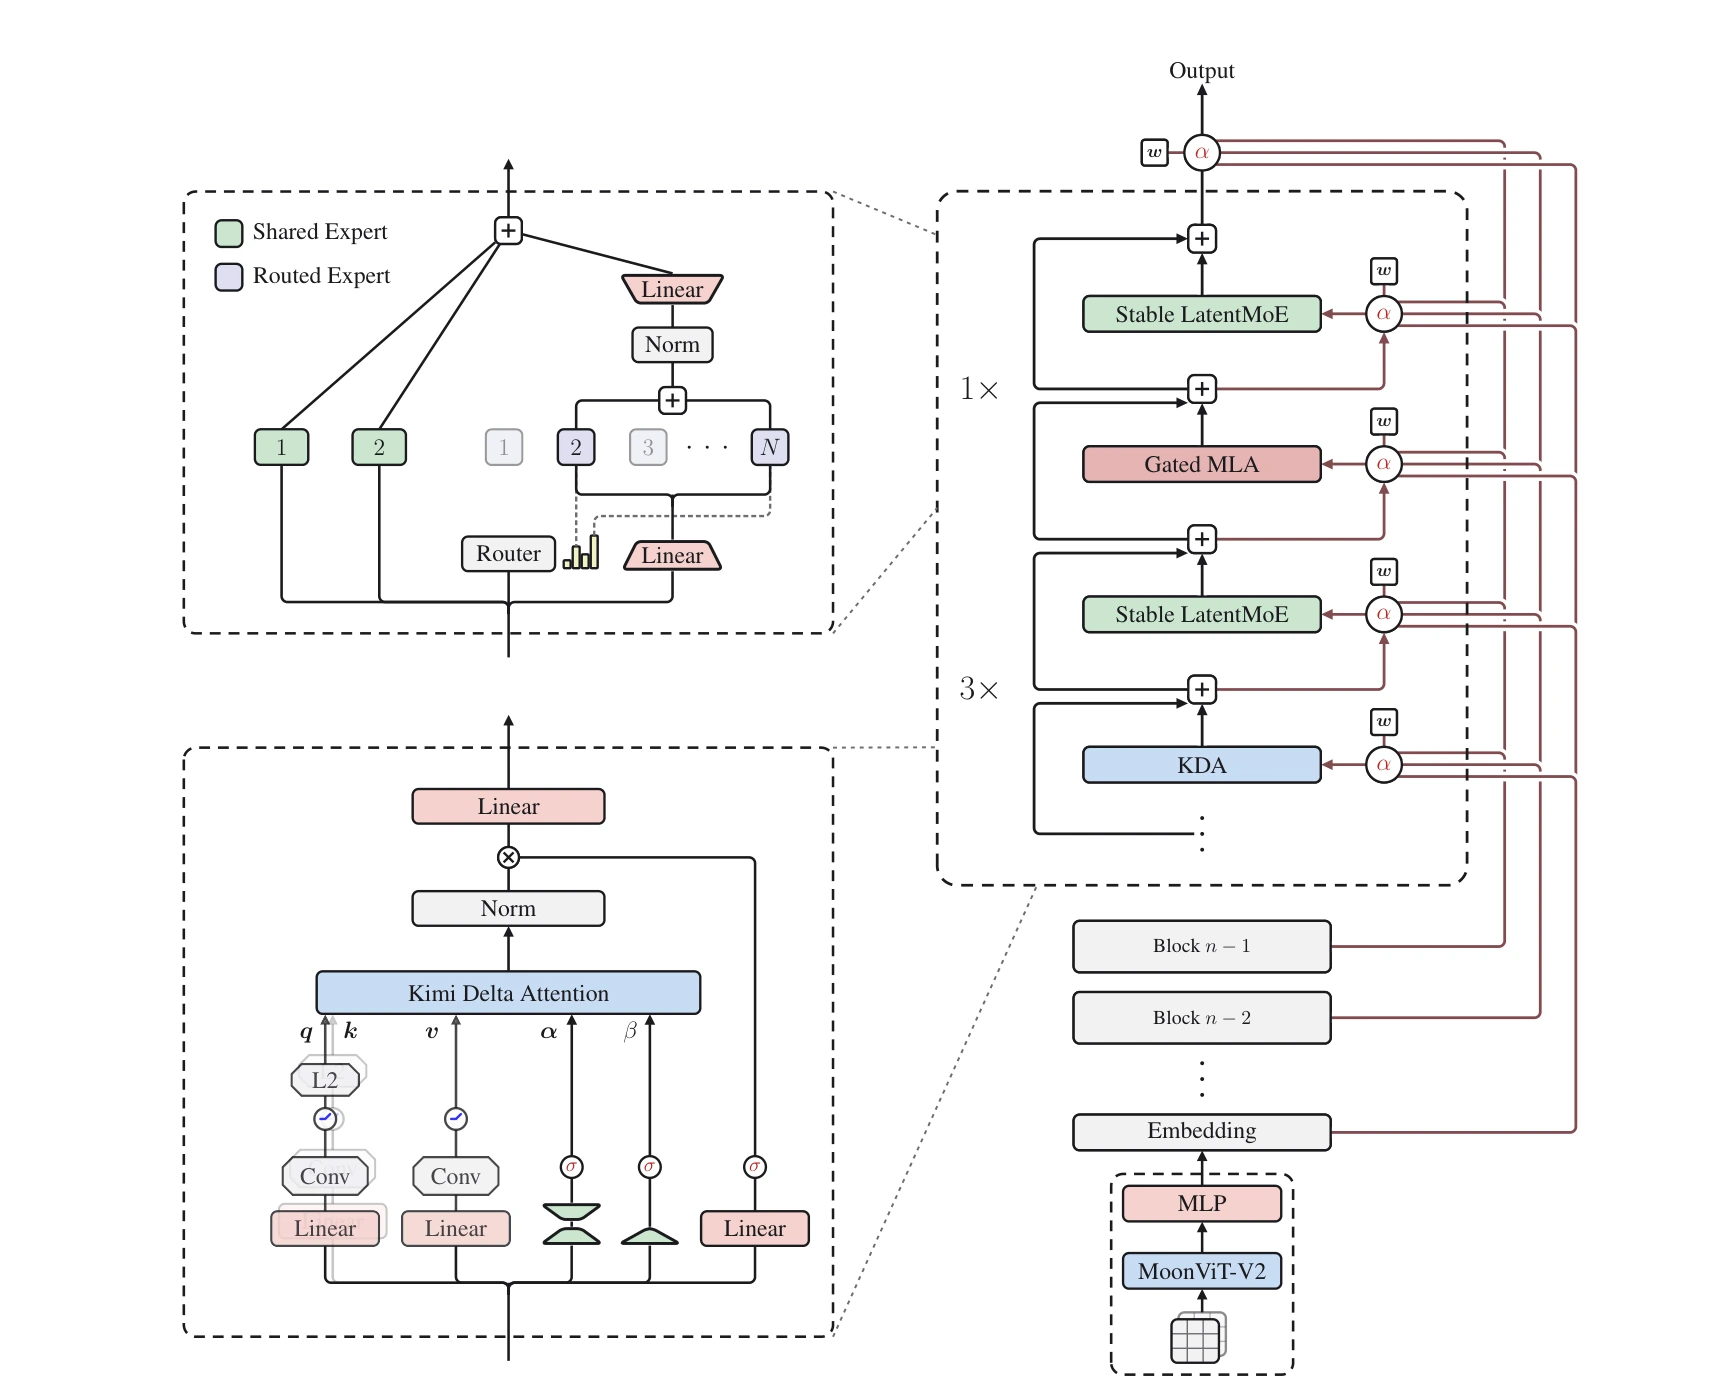
图 1:Kimi K3 技术报告 Figure 2 原图。右侧数据流自下向上,展示 3 层 KDA 配 1 层 Gated MLA 的交错结构;左侧展开专家与 KDA 内部模块,红色连线是深度方向的 Attention Residuals。K3.1 Pro 将图中的全局 Gated MLA 层替换为 Gated DSA,原图仍保留 K3 的命名。来源:官方技术报告。
2.1 为什么是 3 层线性加 1 层全局
纯线性注意力或纯循环模型的每 token 计算量与状态大小都是常数,但状态容量有限,精确召回长距离细节的能力弱于全注意力。纯全注意力的表达能力最强,代价是 KV 随序列长度线性增长,解码时每个 token 都要读完整缓存。混合架构把两者按层交替:大多数层用便宜的状态更新维持全局信息流,少数层用高容量的全注意力做精确检索。
3:1 的比例来自 Kimi Linear 的混合比例消融:三层 KDA 加一层全注意力能在质量与缓存规模之间取得平衡,线性层比例再高会削弱精确检索能力,再低则缓存与计算收益不足。K3 则在这个比例上把模型做深:层数从 K2 的 61 层增加到 93 层,全局注意力层变为 24 层,整个网络按同一个四层模式重复。
末尾那层额外的全局注意力是一个容易忽略的设计。如果主干最后一层是 KDA,那么模型进入输出头之前看到的是循环状态,而不是对最后若干 token 的精确注意力。补一层全局注意力,等于在生成前的最后时刻再做一次全上下文检索,代价只是一层 KV,却能让输出层拿到未被状态压缩的信息。
2.2 全局层为什么不再用 RoPE
K3 的所有 MLA 层都采用 No Position Encoding(NoPE):查询和键上不加旋转位置编码。位置信息由穿插其间的 KDA 层提供。KDA 的衰减因子随 token 位置逐通道累积,天然带有“越久远的信息衰减越多”的归纳偏置;同时短卷积和门控也提供局部顺序线索。全局层只负责内容寻址,不再负责位置。
这样做有两个直接好处。第一,扩展上下文时不需要重调 RoPE 的基频,也不需要 YaRN 之类的插值;K3 从 8K 预训练一路扩到 64K,再在冷却阶段从 256K 扩到 1M,位置外推不依赖任何位置编码参数。第二,MLA 的 KV 里不需要再存 64 维的 RoPE 键,只存内容 latent;不过 K3.1 Pro 的配置仍保留 qk_rope_head_dim: 64 字段,实际是否使用要看加载代码的分支,不能只凭字段名判断。
2.3 96 个头与 7168 维
隐藏维度 7168、96 个注意力头、每头 128 维,这组数字在 K3 与 K3.1 Pro 上完全一致。96 个头不是为了增加参数量,而是为了在张量并行下保持切分粒度:96 可以被 8、16、24、32、48 整除,常见 TP 度数都能均匀分头,不会出现某些 rank 多一个头、某些 rank 少一个头的情况。对 2.8T 参数的模型来说,部署时通常要用几十张卡,头数能否被 TP 度整除会直接影响负载均衡。
KDA 同样使用 96 个头、每头 128 维。它的状态是每个头一个 的矩阵,而不是每头一组键值向量。这个尺寸选择让状态既能容纳足够的通道信息,又能在片上寄存器或共享内存里完成一次更新。如果再大,单头状态就无法在解码 kernel 里常驻;如果再小,状态容量不足,需要更多层来补偿。
三、KDA:用固定状态替代增长的 KV
KDA 的全称是 Kimi Delta Attention,它继承 DeltaNet 的 delta rule,并加入逐通道的遗忘门。站内已经有一篇 Kimi Delta Attention 完全拆解 从 Delta Rule 讲到硬件感知 kernel,这里不重复那篇的推导,而是聚焦 K3/K3.1 Pro 这一代对 KDA 做的三处改动,以及这些改动对推理的影响。
3.1 单头递推公式
对单个注意力头,设第 个 token 的查询、键、值分别为 、,循环状态为 。KDA 的更新写成:
其中 控制写入强度, 是逐通道的一步保留率。这个式子包含两个动作。 先把旧状态按通道衰减,模拟“遗忘”; 是一个秩一投影,它把旧状态中与当前键方向重合的分量减掉,再把新的 写进去。减掉旧分量再写新分量,就是 delta rule 与普通线性注意力的区别:普通线性注意力只做加法累积,同一个键出现多次会不断叠加;delta rule 用当前键做一次“覆盖写”,让状态更像一个可更新的关联记忆。
这个设计对推理的直接意义是状态大小固定。无论上下文是 8K 还是 1M,每个头始终只维护 的矩阵。K3.1 Pro 有 69 层 KDA,每层 96 个头,按 BF16 存储:
也就是单个序列的 KDA 状态约 207 MiB,与序列长度无关。对比同样 69 层如果存 MLA latent KV:每 token 每层 B,69 层就是 79.5 KiB/token;207 MiB 只相当于约 2730 个 token 的 KV。换句话说,序列超过约 2.7K token 后,KDA 在容量上就开始占优;到 1M token 时,差距是三百多倍。
3.2 chunkwise 并行:训练与预填充的基本盘
递推式在时间维度上是串行的,直接按 token 循环会让 GPU 的 SM 大量空转。KDA 采用 chunkwise 形式:块内并行、块间串行。设块大小为 , 是第 个块内堆叠的查询、键、值矩阵, 是进入该块的初始状态。定义块内逐通道累积衰减:
把 按行堆成 ,再用 UT transform 得到 与 ,定义伪值项 。于是块内所有输出可以一次算完:
第一项把进入块的状态带到当前块,第二项处理块内 token 之间的因果交互。 保留下三角(含对角线),因为每个输出要读到当前 token 更新之后的状态。
工程上的难点在于数值范围。 是许多小于 1 的衰减因子连乘,块越长乘积越小;公式里又要除以 做重标定,倒数会迅速变大。Kimi Linear 的做法是在对数空间算相对衰减,并把块再切成 16 token 的小瓦片;非对角瓦片可以走 Tensor Core 的稠密矩阵乘,对角瓦片仍要逐位置对计算,成为块内主要瓶颈。
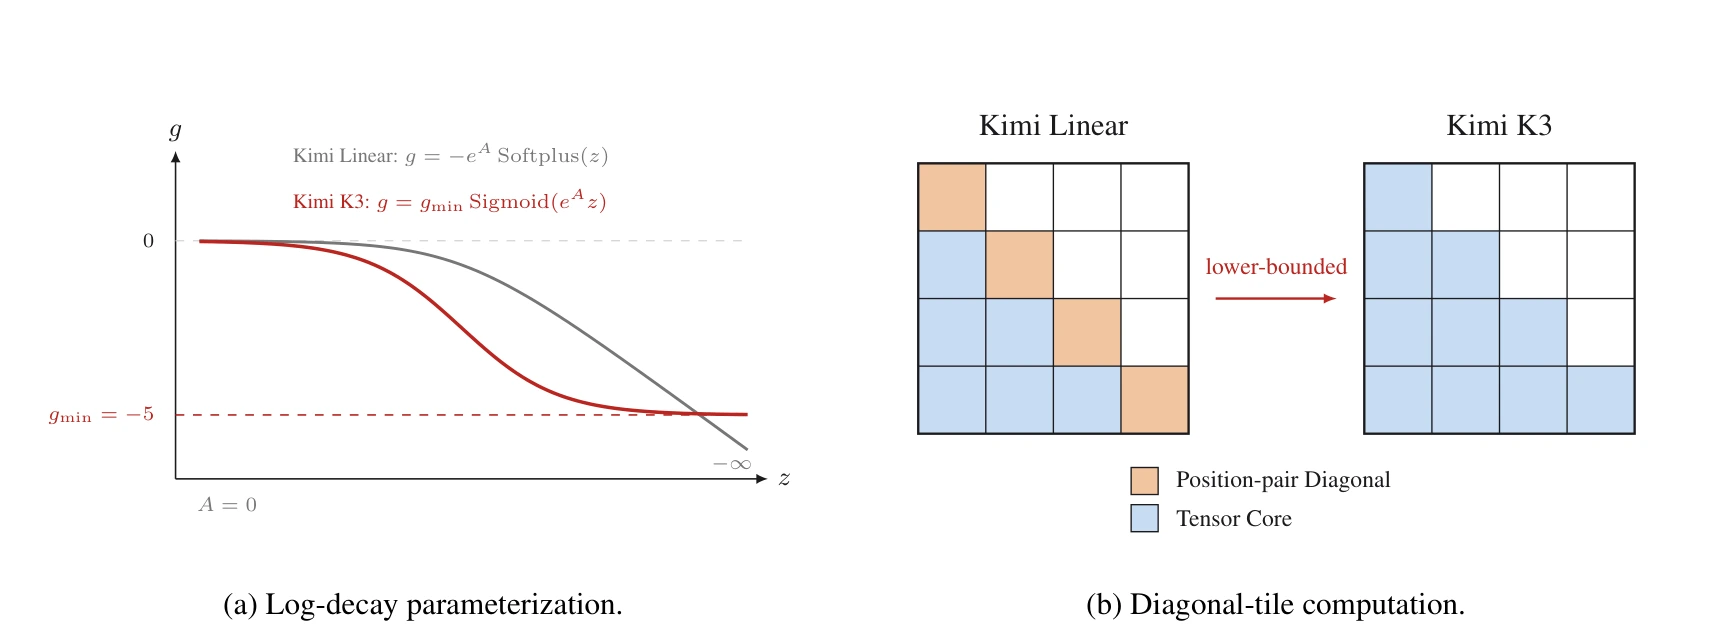
图 2:Kimi K3 技术报告 Figure 3 原图。左侧对比对数衰减参数化,红线具有有限下界;右侧展示对角瓦片从逐位置对计算转为 Tensor Core 计算。图中的 是对数衰减量,不应将其下界直接当作衰减因子本身的取值范围。来源:官方技术报告。
K3 的改动是把衰减的对数形式从负 Softplus 换成有下界的缩放 Sigmoid:
其中 是每个头可学习的对数尺度, 固定。负 Softplus 的值域是 ,衰减可以无限接近 0,导致倒数没有上界;缩放 Sigmoid 把对数衰减压在 ,每个保留率至少为 。16 token 瓦片的累积对数衰减落在 ,重标定因子的上界是 ,仍在 BF16 的动态范围内。数值有界之后,对角瓦片不必再做逐位置对计算,可以和非对角瓦片一样走稠密矩阵乘,块内计算的形状变得更规整。
这个改动的收益不在模型质量,而在 kernel 形状。推理预填充阶段,KDA 层要处理长序列的块内矩阵;对角瓦片原来是标量路径,Tensor Core 利用率低,现在整块都是矩阵乘,预填充吞吐随之提高。K3 技术报告给出的说法是,FlashKDA 在这个形式下明显快于 Triton 参考实现,并被自动分派为 flash-linear-attention 的后端。
3.3 满秩输出门
Kimi Linear 的 KDA 输出门是低秩参数化;K3 改成输入相关的满秩投影。对循环输出先做 head-wise RMSNorm,再逐通道门控:
与 都是满秩矩阵,门控向量与输出同维。低秩门控只能在一个低维子空间里调制通道,满秩门控可以让每个 token 独立决定哪些通道通过。代价是每层多一个 的投影,但在 7168 维、96 头的规模下,这部分计算相对于 KDA 的状态更新仍然很小。
3.4 解码阶段的真正难题:状态回滚
KDA 的解码和预填充是两种完全不同的负载。预填充可以用 chunkwise 并行把长序列摊开;解码时每个请求只前进一个(或几个)token,状态必须原地更新,瓶颈从“找并行度”变成“怎样低成本地读写状态”。
更麻烦的是投机解码。如果草稿模型一次提出 个 token,验证后只接受前 个,那么 KDA 的状态已经越过了第 个 token,多更新了被拒绝的部分。全注意力模型可以丢掉被拒绝 token 的 KV 条目,因为 KV 是按 token 追加的;KDA 的状态是累积矩阵,不能简单截断。为每个草稿位置保存一份状态快照当然可以回滚,但状态本身是 207 MiB 量级,按草稿长度复制会让状态流量成倍增长,在大 batch 下不可接受。
K3 推理栈采用的办法是只缓存投影后的输入,而不是缓存状态。任一对被接受 token 前缀的状态,完全由这些 token 的投影输入决定;投影输入的体积远小于状态。验证完成后,在片上重放被接受 token 的递推,重建状态,再把已验证 token 与 bonus token 的状态写回。重放、bonus token 和下一个草稿窗口共享同一个融合 kernel,短卷积、输入归一化、门控、KDA 递推与输出归一化都在里面完成。这个思路与并行的 ReplaySSM 工作一致。它把“状态快照”换成了“输入重放”,用少量重复计算换掉了大量状态搬运。
顺带一个公开配置里的细节:K3.1 Pro 的 config.json 中 num_nextn_predict_layers 为 0,而 K3 报告给出的结构表中有 1 层多 token 预测(MTP)。公开配置里没有附带 MTP 头,报告提到的投机解码路径需要加载额外的 MTP 模块才成立,不能默认这份 checkpoint 自带。模型卡同时列出 Kimi K3.1 Pro Highspeed,称其速度是标准版的 2 到 3 倍;公开材料没有说明它采用哪种加速手段,因此不应把它直接归因于上文的重放机制或投机解码。
四、Gated DSA:全局层的稀疏检索
4.1 普通 MLA 层在长上下文解码时要读多少
先把问题量化。MLA 每 token 每层缓存的是 512 维 latent 加 64 维 RoPE 键,按 BF16 每 token 每层 B。K3.1 Pro 有 24 层全局注意力,一个 100 万 token 的会话,全局层的 KV 缓存就是:
这已经接近四张 H100 的显存总量,而且只是 KV,不含权重与激活。更糟的是解码带宽:每生成一个 token,24 层都要从显存读一遍自己的整段缓存,一次读取 27.6 GB。即使用带宽最高的 HBM3e,单卡约 8 TB/s、八卡 H100 约 64 TB/s 聚合带宽,仅读 KV 的下限也在 0.43 ms 左右,还没算权重读取、MoE 通信与 kernel 启动开销。序列越长,这个数字按比例上升。
DSA 的思路是:解码时绝大多数过去的 token 对当前查询没有贡献,没必要把它们全部读进显存带宽。先用一个便宜的索引器给每个过去 token 打分,只对分数最高的 2048 个条目做真正的注意力。于是全局层每次读取的条目数从序列长度变成常数 2048。
4.2 闪电索引器
DSA 由两部分组成:闪电索引器(lightning indexer)与细粒度 token 选择。索引器计算查询 token 与过去 token 之间的索引分数:
其中 是索引头数,、 是专门的索引查询与索引键, 是查询侧为每个索引头计算出的权重。然后按分数取前 个:
就是 MLA 的 latent KV 条目。注意这里有两个“头”的概念容易混淆: 是索引头数,真正做注意力的主注意力头数与它无关。DeepSeek-V3.2 的索引器是 64 个索引头,每头 128 维;K3.1 Pro 的 dsa_config 是 32 个索引头、每头 128 维、top-k 为 2048。索引器用 ReLU 而不是 GELU 或 SwiGLU,DeepSeek 给出的理由是吞吐考虑:ReLU 不需要额外的非线性查表,且索引器能以 FP8 实现,计算开销很小。
索引头的数量决定了索引器的“分辨率”。每个索引头相当于一个独立的检索视角,多个视角的加权和让索引分数能同时捕捉不同语义的相似性。32 个头对于 2048 的 top-k 已经足够;如果索引头太少,不同语义信号会被挤在少数维度里,选择质量下降。
4.3 DSA 如何实例化在 MLA 上
DSA 在 DeepSeek-V3.2 中被实例化在 MLA 的 MQA 模式上,原因是 kernel 效率:每个 key-value 条目要在同一个 token 的所有查询头之间共享,才能让一次显存读取服务多个查询头。如果把 DSA 建在 MHA 模式上,每个头都要自己挑选 top-k,读放的条目不再共享,带宽收益就没了。
K3.1 Pro 的每个全局层沿着同样的思路:查询侧仍然有 96 个主注意力头,但被读取的条目是每个 token 一份 512 维 latent。索引器针对这份 latent 打分。这样一来,稀疏选择与压缩存储是正交的两个减少量:MLA 把每个条目的字节数从“每头一组键值”压到 512 维 latent,DSA 把读取的条目数从“全部 token”压到 2048。两者叠乘,全局层解码读取量从 B 变为 B。
由此也可以算出 DSA 在 K3.1 Pro 里真正省下的是哪一部分。对 100 万 token 的序列,24 层全局层的解码读取量:
再加上索引器自己的扫描。索引分数是查询与全部过去 token 的索引键的点积,因此索引器仍然要读全部 token 的索引键。按 DSA 的原始定义,索引键每个 token 只有一份 128 维向量、被多个索引头共享;若按这个口径并以 FP8 存储,每层每 token 128 B,24 层合计 3 KiB/token,100 万 token 约 3 GB。索引器的计算量是每缓存 token 每层 次乘加,24 层、100 万 token 约 197 GFLOP/生成 token。作为对照,如果这 24 层都对全部 token 做 MLA 注意力,按每缓存 token 每层 96 头 ×(192 维 QK + 128 维 PV)× 2 计算,约 1.47 TFLOP/生成 token。按公开参数做算术下限估算,DSA 把全局层的读取量从 27.6 GB 降到约 3 GB 索引扫描加 56.6 MB 选中 KV,计算量降到约七分之一。这只是算术估算,不含 kernel 效率、批处理与索引器实现差异,不能当作实测加速比。
4.4 Gated DSA 与 K3.1 Pro 的额外门控
DeepSeek 原版的 DSA 没有输出门控。K3.1 Pro 称为 Gated DSA,在 MLA 输出上加一个输入相关的逐通道满秩门:
这和 3.3 节 KDA 的满秩输出门结构一致。配置中 mla_use_output_gate: true,use_full_rank_gate: true。门控的意义有两层。结构上,KDA 层与全局层的输出分布不同,满秩门让全局层也能按 token 调制哪些通道写入残差。训练上,稀疏选择会带来选择噪声:某些 token 的 top-k 集合可能不理想,输出门可以抑制这些 token 上不稳定的全局层输出。
4.5 稀疏层的位置为什么隔四层一个
dsa_config 里的 dsa_layers 是 [4, 8, 12, ..., 92, 93],也就是每四层里的最后一层,加上主干末尾的第 93 层。这个位置与 K3 的全局注意力层完全重合,说明 K3.1 Pro 是把同一位置的 MLA 逐层替换,而不是重排网络。
这种“稀疏检索层夹在循环层之间”的排布对推理调度很重要。调度器可以把请求按层切分成两段不同的计算:KDA 层只更新固定状态,不碰分页 KV;DSA 层需要读取分页 KV 并做 top-k 选择。如果两类层是交替更细的粒度,kernel 启动和状态管理会频繁切换;每隔四层切一次,可以在 KDA 层段里连续发射融合 kernel,在 DSA 层单独走分页注意力路径,分段调度更简单。
4.6 DSA 的代价与边界
稀疏选择不是免费的。第一,存在漏选风险:如果真正需要的信息没有进入 top-k,模型就看不到它。DeepSeek 用继续预训练让主注意力适配“只看 top-k”的输入分布;K3.1 Pro 继承了 K3 的训练,然后通过后训练进一步适配新的稀疏层。第二,索引器需要额外维护索引键。按上面的口径(每 token 128 B、24 层),100 万 token 约 3 GB;如果实现里让 32 个索引头各自存一份 128 维键,则放大到每 token 4 KiB、约 98 GB。K3.1 Pro 的 config.json 同时给出了 index_head_dim: 128 与 index_num_heads: 32,公开材料没有说明索引键在缓存里是头间共享还是每头独立,这个差距决定了索引缓存的量级,实际部署前需要按实现核对。
第三,top-k 是逐 token 的查询自己的选择,同一个请求内不同 token 的 top-k 集合不共享,解码时每个 token 都要重新做一次 top-k。这限制了跨 token 的批处理优化,也让“选择哪些条目”成为解码 kernel 的一个组成部分。站内 DSA 索引器 kernel 拆解 与 GLM-5.3 的 DSA 推理实践 讨论过索引器在 vLLM 中的实现方式,可以对照看。
五、Stable LatentMoE:896 选 16
5.1 LatentMoE 的基本结构
K3.1 Pro 每层有两个共享专家和 896 个路由专家,每 token 激活 16 个路由专家。稀疏度是 ,相比 Kimi K2 的 进一步扩大。对输入 (),共享专家直接处理原宽度的 ;路由路径先把 下投影到隐空间 (,正好是隐藏维的一半),把 分发给选中的专家,再把加权聚合结果上投影回 维:
其中 是选中的 个路由专家,、 分别是两类专家的前馈网络, 是路由权重,。
LatentMoE 的核心收益是把“专家宽度”与“模型宽度”解耦。传统 MoE 里每个被选中的专家都吃完整 7168 维向量,专家数增加的代价主要来自通信量与专家权重的读取;LatentMoE 让路由专家只在 3584 维空间工作,专家权重的输入维度减半,专家见到的输入也减半,通信量随之下降。这让专家池能从 384 扩到 896,同时每 token 的专家数从 8 增加到 16,激活参数从 32.6B 上升到 104B。
共享专家保留原宽度,保证公共变换(比如通用的语言知识、格式处理)不经过任何瓶颈压缩。K2 只有 1 个共享专家,K3 固定为 2 个,配置里 num_shared_experts: 2;报告没有给出这一改动的单独消融,从结构上看它给公共变换留出了更多容量。
5.2 为什么稀疏度扩大后要“稳定化”
K3 技术报告点出极端稀疏放大了传统 MoE 设计的两个失败模式。第一,路由路径是 、多分支门控专家前馈、 三段的串联,中间夹着接近四次连续矩阵乘。这种结构在 2.8T 规模下容易出现内部激活爆炸:某个批次的激活值在连续线性变换中逐层放大,最终超出 BF16 的范围或使注意力层输入失真。第二,896 个专家、每 token 选 16 个,每个专家在训练批次里分到的 token 数变少,负载均衡的难度远超传统 MoE。
针对这两个问题,Stable LatentMoE 引入三个部件。
第一,上投影前加 RMSNorm:
聚合后的 的尺度取决于选中的专家和它们的路由权重,变化范围很大。先归一化再上投影,把路由分支的尺度固定在可控范围,再与全宽度的共享分支相加。K3 报告称这个 RMSNorm 除了稳定训练,还一致地改善验证损失与下游指标。配置里 latent_moe_use_norm: true 对应这一设计。
5.3 SiTU-GLU:有界的门控
第二,把 SwiGLU 换成 SiTU-GLU。先看 SwiGLU 的形式:
即门分支是 ,上分支是线性的。问题在于两个乘数都无界:门分支在大正值时近似线性增长,上分支也线性增长,两者相乘在激活值很大时增长极快,容易在低精度计算里溢出。原始 GLU 的门是纯 Sigmoid,有界但损失了 Swish 在正值区的近似线性行为。
SiTU-GLU(Sigmoid Tanh Unit GLU)同时给两个分支加平滑截断:
K3.1 Pro 取 (门分支)、(上分支)。 在原点是斜率为 1 的直线,大幅值时被压到 ,所以它近似保留了 SwiGLU 在原点的响应,同时把输出限制在 与 ,整个 SiTU-GLU 的输出上界是 。
三种门控分支的定义、作用范围与输出上界对比如下。 在原点是斜率为 1 的直线,大幅值时被压到 ;因此 SiTU-GLU 只在需要的地方截断,而不是整体压缩响应。
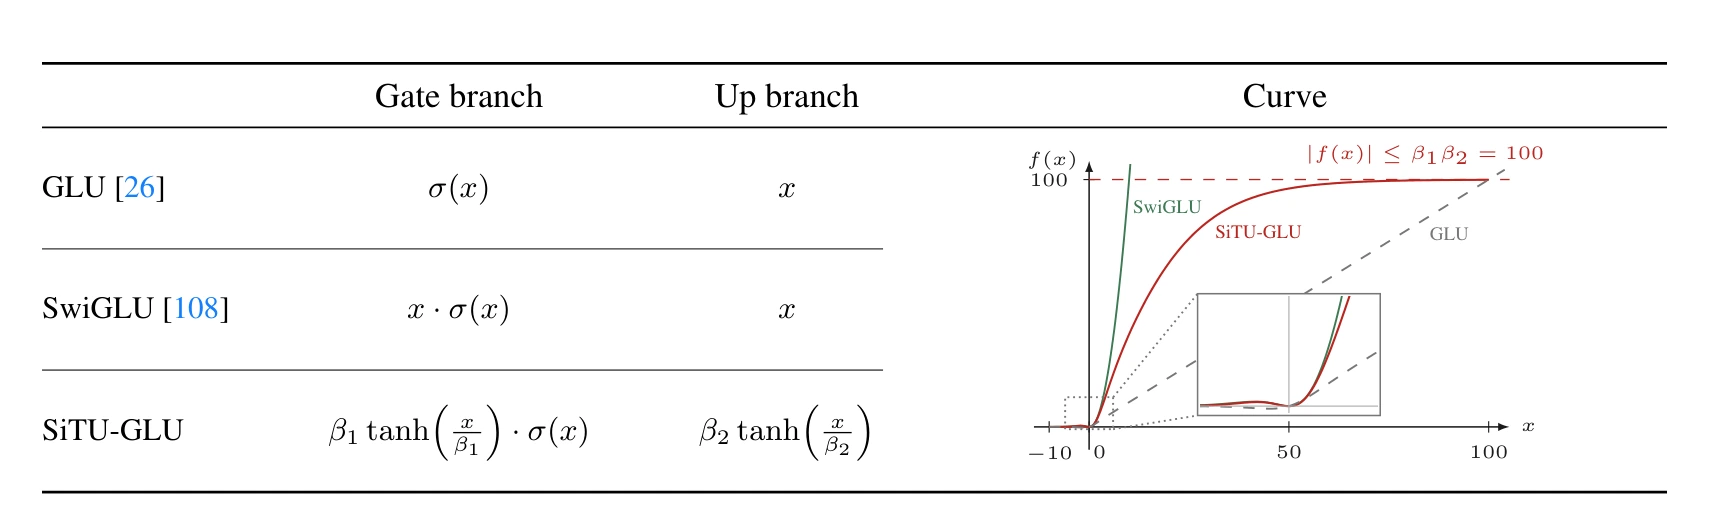
图 3:Kimi K3 技术报告 Figure 4 原图,保留门分支、上分支公式与右侧输出曲线。K3.1 Pro 实际取 与 ,乘积 100 是这一门控单元的输出上界。来源:官方技术报告。
为什么上界重要,要结合推理侧的量化配置。K3.1 Pro 用 MXFP4 存权重、MXFP8 存激活,而且是在训练阶段就做了量化感知训练(config 中 quantization_config 的 format: mxfp4-pack-quantized,group size 32,忽略项覆盖注意力、共享专家、门控与 lm_head)。MXFP8 的动态范围比 BF16 窄。如果激活在路由分支内部出现大离群值,即使训练时用高精度,推理改低精度后也会出现截断或精度损失。SiTU-GLU 把整个前馈输出的上界压在 100,使激活分布更窄,低精度推理更容易保住数值稳定。这是“结构设计与推理精度协同”的一个典型例子。
5.4 Quantile Balancing:让 896 个专家都分到活
第三个部件是负载均衡。K3 沿用无辅助损失的偏置路由:路由分数为
选择时使用带偏置的分数:
注意偏置 只出现在选择里,不出现在权重 的分子分母中,因此它调节的是“哪些专家被选中”,而不改变组合权重本身。原来的固定步长规则是 ,用步长 在“适应慢”与“负载震荡”之间折中。896 个路由专家时,固定步长很难同时做到快速收敛和稳定。
K3 的 Quantile Balancing(QB)换了一个角度:每个专家的偏置应该设在哪,才能让它恰好收到目标负载。设一个训练批次有 个 token、 个专家、每 token 选 个,则每个专家的目标负载为 。做法是用 top- 路由拿到每个 token 的截断分数 (第 名的偏置分数),那么专家 在候选偏置 下被选中的 token 数为:
这个计数随阈值 单调递减。令它等于 ,则 就是所有边际 的第 大值,即 分位数。于是:
第二行减去所有偏置的均值,因为给所有专家同时加同一个常数不改变 argtop-k 的结果,这一步只是把偏置定在一个统一尺度上。更新在下一个训练步生效,保证一个批次不用自己推导出的偏置来路由自己。
下面用报告里的最小例子走一遍流程:8 个 token、4 个专家、每 token 选 1 个,于是目标负载 。
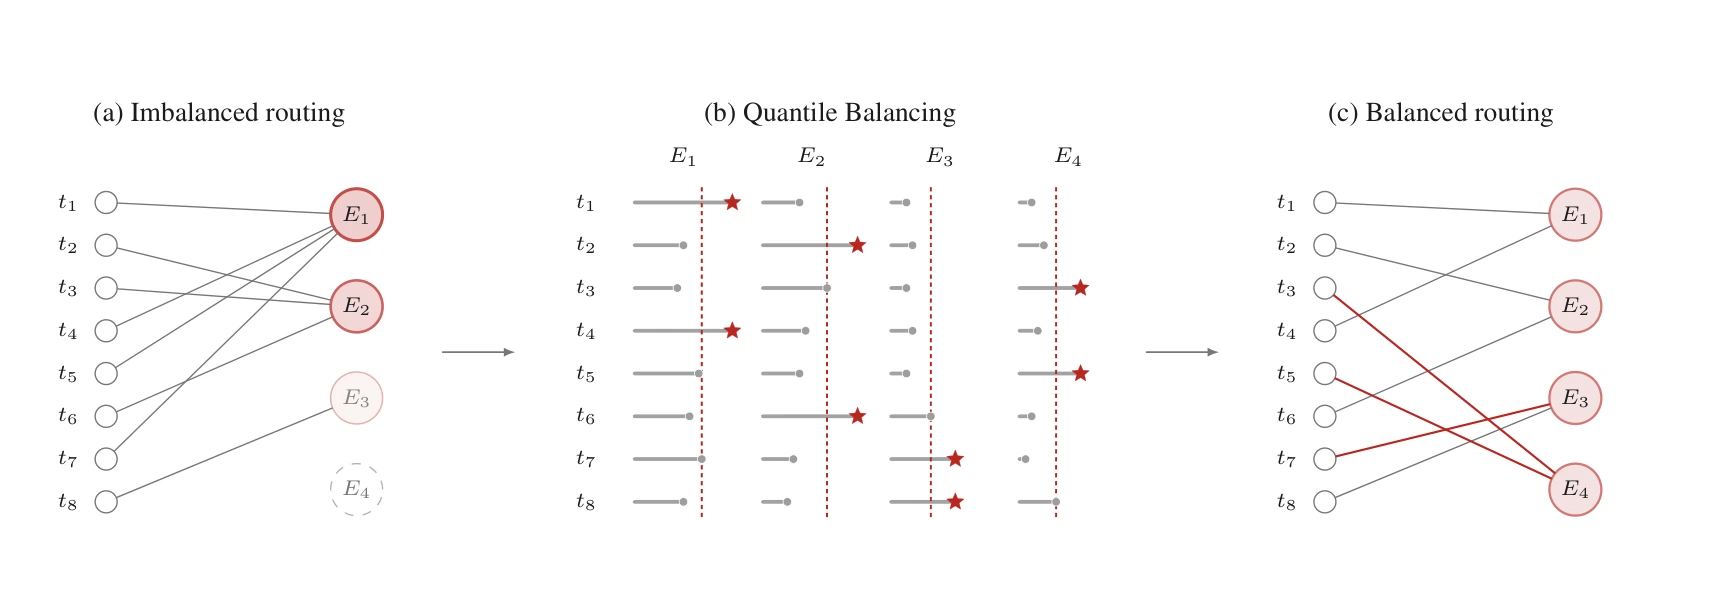
图 4:Kimi K3 技术报告 Figure 5 原图。左侧路由集中到少数专家,中间按每个专家的边际分布计算分位数,右侧达到每个专家 2 个 token 的平衡分配。中间一步的意义在于:偏置不是用固定步长试探出来的,而是让每个专家的分位数对应目标负载。来源:官方技术报告。
大规模训练时精确分位数不可行:边际数量在百万级,且分散在不同 rank 与累积步上。K3 用直方图估计:每个专家维护一份边际分布的直方图,一次 all-reduce 汇总各 rank 的桶计数,再从汇总计数里读出分位数。计数可加,所以直方图代表的是全局批次的分位数,误差只来自桶宽,通信量也只是每个专家几百个桶。推理时偏置冻结,不再更新。
QB 对推理的直接意义在负载形状。均衡之后,每个专家在典型批次中收到的 token 数相近,路由专家 GEMM 的分组大小更均匀,避免了少数“热专家”拖慢整个 MoE 层的情况。对 896 个专家这样的大池子,负载不均不仅影响训练,还会让推理时某些 rank 的 expert-parallel 通信严重倾斜。
六、Attention Residuals:深度方向也做注意力
6.1 残差流为什么成了瓶颈
标准残差连接把每一层的输出加到同一个残差流上:。对深网络来说,这个设计把所有历史信息压进一个 维向量,第 层想读取第 3 层产生的某种特定表示,只能依赖残差流里恰好保留了它。层数越多,早期层的信息越容易被后续层的更新“稀释”,这类似于 RNN 在时间维度上的瓶颈。
Transformer 在序列维度上的解决方案是注意力:每个位置用数据相关的权重选择性地读取所有历史位置,而不是简单累加。Attention Residuals(AttnRes)把这个思路搬到深度维度:每一层用可学习的伪查询,对所有先前层输出做一次加权求和。
6.2 完整版 AttnRes
对第 层,定义层专属的可学习伪查询 ,键和值都是各层的输出:
其中 是 token 嵌入, 是第 层的输出。注意力权重使用带 RMSNorm 的 softmax 核:
键里加 RMSNorm 是关键细节。不同层的输出数值尺度可能相差很大,如果不归一化,输出范数大的层会几乎独占 softmax 权重,伪查询就失去了“按内容选择”的能力。归一化之后,权重由方向相似度决定,而不是由范数决定。
完整版的算术量是 ,93 层的模型也完全可承受( 量级的乘加对 GPU 而言很小)。真正的成本在内存:每一层的输出都必须保留到后面所有层用完。在流水线并行下,这意味着跨 stage 传递所有层的输出,通信量是 。
6.3 分块版 AttnRes
K3 采用的是分块版本。把 93 层分成 8 个块,每块 12 层(最后一块不满 12 层),再加上 token 嵌入算作第 9 个源。块内各层输出先求和压缩成一个块表示:
表示块 内前 层的部分和。跨块注意力只作用在这 个块表示上。对块 的第 层,值矩阵为:
其中 保证 token 嵌入始终是一个可被选中的源。第一层只能看到之前各块的完整表示;后续层还能把自己块内的部分和作为额外源,让块内信息在后续层之间流动。最后一层汇总全部 8 个块的表示。
分块把内存与通信从 降到 ,93 层只需常驻 9 个 维向量。K3 报告给出的经验值是 就能恢复大部分收益,所以选了每块 12 层、共 8 块的配置;config.json 中的 attn_res_block_size: 12 对应这一点。
6.4 对推理的影响
AttnRes 在推理时增加了一类新的状态:块表示。它在预填充阶段随 token 一起计算;解码阶段每个新的 token 都要维护 9 个 维向量,并逐层更新当前块的部分和。对每个活跃 token,这份块表示的体积是 KiB,比 KDA 状态小得多,但比普通残差流多出 8 个向量。
K3 推理栈对分块 AttnRes 做了两阶段调度:先对跨块表示做一次批处理的注意力,再让每一层把自己的块内部分和通过在线 softmax 合并进来。在线 softmax 是 FlashAttention 里的技巧:不预先知道全部权重的归一化因子,边读边维护当前最大值与归一化累积,最后一次性归一化。这个结构正好适配“跨块结果可以先并行算出、块内部分和再顺序合并”的推理顺序。
预填充阶段,若在每个张量并行 rank 上都物化全部块表示,会造成大量重复显存。K3 推理栈把 TP 的 all-reduce 拆成 reduce-scatter 与 all-gather,中间插入块内 kernel,只让每个 token 的块表示在恰好一个 rank 上物化。解码阶段则把跨块 kernel 放到辅助流上与主计算重叠,并把块内合并、部分和更新与 RMSNorm 融进前一次 all-reduce,省掉独立的 kernel。这些是推理侧对 AttnRes 的直接优化,结构本身决定的额外状态量则是无法回避的成本。
七、原生视觉:MoonViT-V2
7.1 从零训练的视觉塔
K3 的视觉编码器 MoonViT-V2 有约 4.01 亿参数、27 层、patch 大小 14、12 个注意力头,输出 1024 维特征,经轻量 MLP 投影到 7168 维后与文本嵌入进入同一个主干。与 K2.5 不同,MoonViT-V2 不是从 SigLIP 之类的对比学习模型初始化,而是用下一个 token 预测从头训练。
K3 报告给出的主要理由是训练稳定性:把对比学习预训练的编码器接到语言模型上联合优化时,梯度范数持续偏高并频繁出现尖峰;从零训练、只用语言建模目标优化的编码器,梯度范数更低也更平稳。此外,语言建模目标会直接塑造编码器的表示,让视觉特征偏向对下游文本有用的细粒度线索,而不是对比学习偏好的全局语义。
配置里也能看出稳定化的细节:视觉塔全部去掉线性层和注意力投影的偏置,归一化用 RMSNorm。这两项都减少了参数的平移自由度,降低从零训练时发散的风险。
7.2 视频与 token 压缩
图像与视频共享同一套参数。注意力在帧内做空间注意力、帧间做时间注意力;时间维度再做一次池化压缩。进入投影前,像素重排(pixel shuffle)做 下采样,把视觉 token 数量降到四分之一。这些设计保证最大 3584 × 3584 像素的输入在 100 万 token 上下文里仍然可承受。
对推理侧,视觉 token 的成本与文本 token 一样走主干:KDA 层更新状态、DSA 层做稀疏检索、MoE 层做路由。一张高分辨率图片经下采样后仍然可能有数千个视觉 token,这直接影响首 token 延迟。多模态推理的显存规划里,视觉 token 占据的状态与文本 token 同量级,不能被忽略。
八、推理时的内存组织:两套缓存的联合管理
8.1 两份性质不同的缓存
K3.1 Pro 的每个四层块里,3 层 KDA 每层维护一份固定大小的循环状态(每序列一份,不随长度增长),1 层 DSA 维护一份随长度增长的分页 latent KV,外加索引器需要的索引键。两份缓存的增长规律完全不同,却必须在同一个请求里被一起管理。
K3 推理栈的做法是把 KDA 状态打包进与 MLA KV 相同的分页块池。页大小统一,KDA 状态占据自己的一份页,和 KV 页共享同一套分配、引用计数与回收逻辑。页内按头连续存储,每个头的字节流自成一体,可以作为跨节点传输的最小单位。
这个设计有一个不易察觉的好处:KDA 状态页与 KV 页的数据布局完全不同,如果程序把两者搞混,读出来的不是“看起来像数据的垃圾”,而往往是明显异常的数值,等于给分页布局提供了一个零开销的健全性检查。
8.2 前缀缓存为什么在混合架构上变难
块哈希前缀缓存是推理服务里的常见优化:把 KV 按时长切块,每块算一个哈希,缓存命中的前缀直接复用,跳过预填充。对纯全注意力模型,这很简单,因为缓存只有 KV。
混合架构的难点在于:一个前缀只有在“KV 与 KDA 状态都能在同一个边界恢复”时才能复用。KDA 状态是每序列一份的大矩阵,不可能在每个 token 边界都存快照,否则存储会爆。所以 KDA 检查点只能在稀疏的边界保存,这反过来约束了哈希块的粒度。
K3 推理栈把这个耦合拆开:哈希在 MLA 页内部按细粒度(例如 512 token)的哈希块进行,物理页仍然是粗粒度的分配单位(4096 到 6144 token);KDA 检查点只保存在 MLA 哈希块的某些端点,这些端点是查询可能引用的唯一位置。查找分两阶段:先在 MLA 层找完整命中的物理块,在第一个缺失块处回退到其内部的哈希端点;再到 KDA 层检查候选边界是否在每个 KDA 缓存组都有检查点。最终命中点是两阶段都满足的最长边界,它永远是哈希块的整数倍,但不一定是物理页的整数倍。
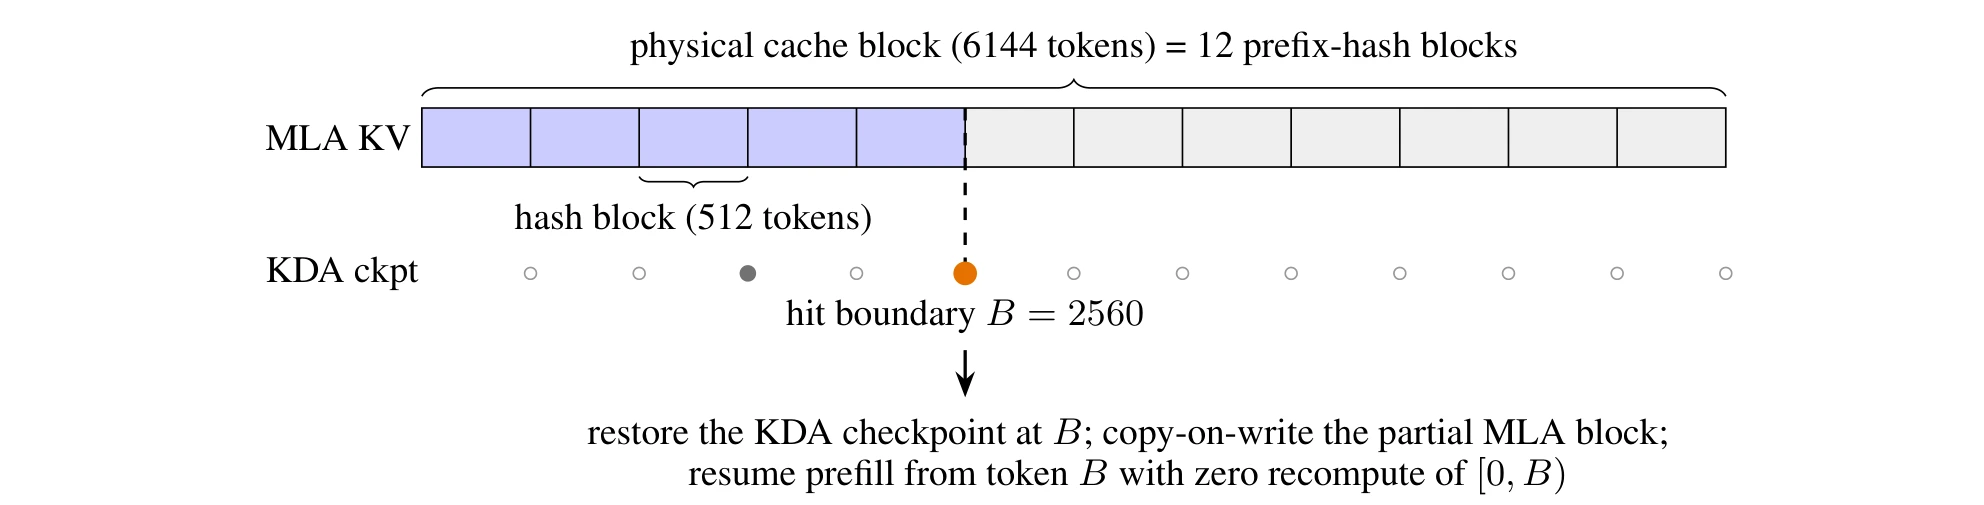
图 5:Kimi K3 技术报告 Figure 12 原图。物理块是分配单位,哈希块是查找单位,KDA 检查点只落在部分哈希边界;图中 6144、512 与 2560 都是说明这一解耦的示例值。来源:官方技术报告。
图中展示的正是这种解耦:一个请求的前 2800 个 token 与缓存前缀匹配,但第一个可恢复的边界是 2560(第 5 个 512 token 哈希块的端点),那里恰好有一个 KDA 检查点。请求就从这个点恢复,部分填充的 MLA 页以写时复制方式复制给请求私用,预填充从 2560 继续,前面 2560 个 token 零重算。如果没有这种解耦,按物理页粒度做哈希,第一个可复用边界会是 6144,对这个请求来说等于完全未命中。
8.3 并发调度下的三个一致性约束
混合缓存共享一个空闲页池,调度时会遇到几个具体的一致性问题,K3 推理栈的处理方式可以作为设计参考:
第一,块分配可能驱逐另一个缓存组刚命中的页。所以所有命中的页在分配任何新页之前,必须先在全部缓存组中钉住。
第二,复制到私有页的操作在 GPU 上紧挨着前向执行,如果某个页在当前调度步内刚被分配或登记,读取方可能拿到上一个持有者的旧字节。所以这类页要等复制完成后才参与匹配。
第三,KDA 检查点只有在每个 KDA 组都存在时才可恢复,因此驱逐一个组里的检查点必须原子地使其兄弟组失效。一个检查点要么在全部组可命中,要么全部不可命中。
三条约束合起来,保证了登记的状态始终精确对应它声明的 token 前缀,使混合架构的前缀缓存能达到与全注意力模型同等的通用性。
九、服务层的两个调度问题
9.1 缓存亲和路由
100 万 token 上下文的智能体请求有一个典型形状:输入前缀可能有 40 万 token,但每次调用新增的预填充只有几千 token。前缀缓存命中时只需预填充增量,未命中时要重新处理 40 万 token,两者相差两个数量级以上。
因此请求应该路由到持有其前缀缓存的集群。跨集群搬运缓存不现实:集群间链路带宽远低于集群内互连。但把每个会话绑定到一个集群,又意味着该集群故障时会话全部中断。K3 推理栈用一致性哈希把每个会话钉到两个集群:主集群服务流量,预分配的备集群在主集群故障时接管。备集群没有该会话的前缀缓存,故障转移时要重新预填充;一致性哈希让不同会话的备集群均匀分布,把重新预填充的负载摊到整个集群,而不是集中到一个。
站内 SGLang Model Gateway 完全拆解 讨论过缓存感知路由与近似基数树,两者要解决的约束是同一个。
9.2 预算式准入控制
生产流量里短请求可能不到 2K token,超长请求能到 100 万 token,单请求成本相差约三个数量级。基于“平均请求”的容量规划、排队模型和限流配额在这种方差下全部失效。典型故障模式是一批长上下文请求占满算力,之后到达的短请求排不进调度,所有流量的首 token 延迟一起恶化。
预算式准入控制给不同请求类别分配独立的资源预算:长上下文的突发流量最多用掉自己那份容量,不能拖垮其他类别的端到端 SLO。这个思路本身不依赖模型结构,但在混合稀疏架构上更必要:KDA 状态与 KV 页的分配都通过同一个池子,长请求一旦占满池子,短请求连恢复状态的空间都拿不到。
十、结构上的权衡与遗留问题
把 K3.1 Pro 的结构逐层看完,可以看到几个明确的权衡点。
KDA 与 DSA 的分工是容量与带宽的分工。KDA 解决了状态随长度增长的问题,但它把信息压缩进一个固定矩阵,精确细节的召回靠 24 层全局注意力补足。这个分工的代价是两类状态并存:每序列约 207 MiB 的 KDA 状态,加上随长度增长的分页 KV,二者的分配、回收、前缀复用都必须在同一个系统里协调。
DSA 的稀疏选择引入了一个“选错”的风险。top-k 只保证索引器认为最相关的 2048 个条目被看到,如果索引器本身学得不够好,真正关键的信息可能落在 top-k 之外。索引器是独立训练的小网络,与主注意力的表示不共享,因此选择质量成为系统性能的一个独立变量,需要单独的监控与调优。
896 选 16 的极端稀疏给了大的表达能力,代价是路由与专家并行通信更密集。每 token 16 个专家意味着更长的 dispatch 列表、更细的专家分组,专家并行下 all-to-all 的条目数更高。LatentMoE 用一半宽度的隐空间缓解了这个问题,但没有消除它。
AttnRes 把深度方向的瓶颈部分打开了,但 9 个块表示在每个 token 上的维护仍然是一项额外状态。它与 KDA 状态、分页 KV 共同构成推理时的第三类内存负担,在前缀缓存与分页管理里都需要被考虑。
最后是数值层面。整个模型用 MXFP4 权重、MXFP8 激活做量化感知训练,SiTU-GLU 的截断、KDA 衰减的下界、AttnRes 里键的 RMSNorm,都可以看作让激活与状态落在低精度可表示范围内的结构手段。这些设计在训练侧的作用是稳定,在推理侧的作用是让低精度部署不出现数值异常。理解这一点,比记住每个公式更重要。
参考资料
- Kimi K3: Open Frontier Intelligence
- Kimi K3.1 Pro 模型卡(含 config.json 与结构表)
- Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence
- Kimi Linear: An Expressive, Efficient Attention Architecture
- Attention Residuals
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- MoonEP: 完美负载均衡的专家并行方案
- Multi-layer Indexer: Overlapping Selection and Attention in DeepSeek Sparse Attention
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



