


vLLM 源码完全拆解(三十一):编译期的融合 pass——FX 图上的一次模式匹配,如何把 RMSNorm、SiLU 与量化缝成一个算子
从一次多余的显存往返说起
解码阶段的一条 Transformer 层里,权重矩阵乘(GEMM)之外还有大量“小算子”:RMSNorm、残差相加、SiLU 与逐元素乘(SiLU-and-Mul)、RoPE、写 KV Cache、以及量化时的缩放与类型转换。它们的 FLOPs 少得可以忽略,却每一个都要把上一步的输出从显存读进来、算完再写回去。以 BF16 为例,一个形状为 的激活张量,每多做一次逐元素 kernel,就要多付出 字节的读写——读一遍、写一遍,每个元素 2 字节。当 只有几十、 是 7168 时,这些字节数加起来完全可以和一次小 GEMM 的权重读取相提并论。
手工写融合 kernel 是传统解法:把 RMSNorm、量化、写 KV 塞进同一个 kernel(本站拆解过的 DeepInfer fused_transform 就是典型)。但推理框架要支持几十种模型结构、十几种量化方案、多种硬件后端,靠人手写融合 kernel 既写不完也维护不动。vLLM 选择了另一条路:让 torch.compile 先把模型前向编译成一张 FX 图,然后在图上跑一组模式匹配(pattern matching)融合 pass——用“子图模式 + 替换子图”的声明式写法,自动把 RMSNorm → FP8 量化 这样的相邻小算子替换成一个预先写好的融合自定义算子。
本文拆的就是这一层:vllm/compilation/passes/ 下的融合 pass 框架,以及 RMSNorm + 量化、SiLU-and-Mul + 量化、AllReduce + RMSNorm、QK-Norm + RoPE + 写 KV 这四类最常用的融合是怎么被“匹配”出来的。它回答的问题不是“融合能快多少”,而是:一张已经和模型代码脱钩的 FX 图,凭什么能被认出一段语义?替换之后的新算子如何保持图的可函数化性质?为什么同一类融合要注册几十个模式?
这一层在 vLLM 的编译栈里处于什么位置
先把位置钉死,否则很容易和本站已经拆过的 piecewise 编译、CUDA Graph 混在一起。
vLLM 的编译链路大致是:
模型 forward (Python) │ torch.compile(dynamic=True, backend=...) ▼TorchDynamo 捕获 → FX Graph(aten 级算子,带 dynamic shape 符号) │ ▼vLLM 的 PostGradPassManager(本文主角) │ ├─ NoOpEliminationPass │ ├─ AllReduceFusionPass │ ├─ RMSNormQuantFusionPass │ ├─ ActivationQuantFusionPass │ ├─ RopeKVCacheFusionPass / QkNormRopeKvCacheFusionPass ... │ ├─ PostCleanupPass │ ├─ VllmIRLoweringPass │ ├─ UnsafeCloneEliminationPass │ ├─ PostCleanupPass(第二次) │ └─ FixFunctionalizationPass ▼Inductor 后端:调度、代码生成、产生 Triton/C++ kernel │ ▼CUDA Graph 捕获(另一层,本站 vLLM(十二)已拆)三个层次要分清楚:
- piecewise 编译决定的是“图在哪里断开”。vLLM 把 attention 等算子列进
splitting_ops,让它们成为图边界,从而每个 piece 可以独立编译、独立捕获 CUDA Graph。 - 融合 pass 决定的是“在没断开的那一段图里,哪些相邻算子合并成一个”。它发生在 Inductor 代码生成之前,操作对象是
torch.fx.Graph。 - CUDA Graph 决定的是“编译好的 kernel 序列怎么一次性发射”。它发生在所有编译产物确定之后。
所以融合 pass 的收益和 CUDA Graph 的收益是两回事:前者减少的是 kernel 数量与显存往返,后者减少的是 CPU 发射开销。两者叠加,但互不替代。
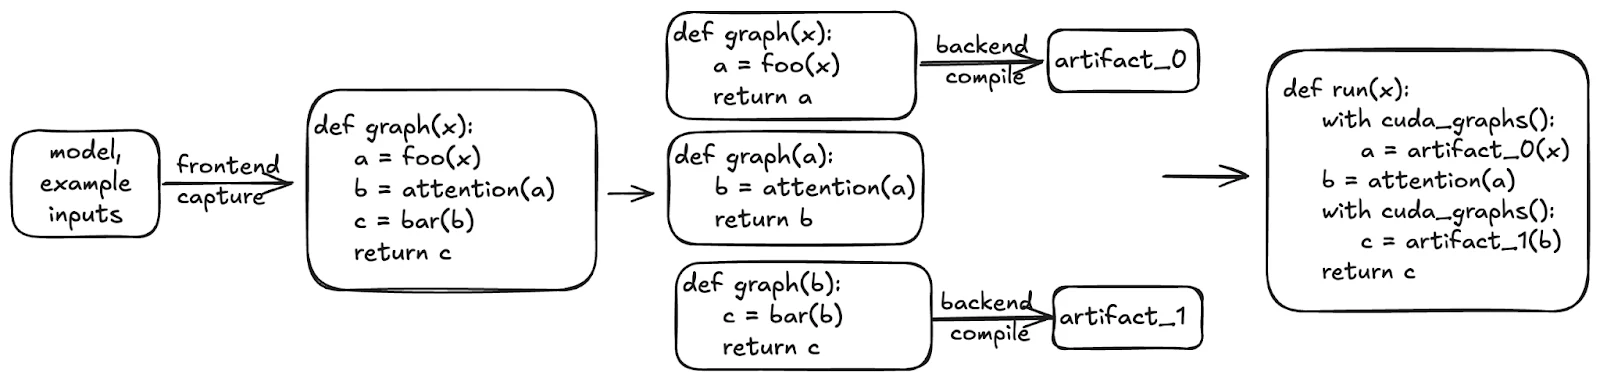
上图来自 vLLM 官方博客对 torch.compile 与 vLLM 协作方式的介绍(2025 年)。图的上半部分是 TorchDynamo 与 TorchInductor 的标准编译流程,下半部分左侧是 vLLM 额外插入的 piecewise CUDA Graph 切分,右侧是本文讨论的自定义融合 pass。图中刻意把“图在哪里断”和“断完之后的图怎么优化”画成了并列的两条线,而不是一条串行流水线——这正是理解这三层关系的关键。
先弄懂四件基础设施
融合 pass 的代码看起来到处是 pm.register_replacement、auto_functionalized、vllm.ir.ops,如果不知道这些是什么,读源码基本就是在读咒语。先把它们讲清楚。
1. FX 图与 post-grad pass
torch.fx 用 torch.fx.Graph 表示一个前向计算:图里的 Node 是算子调用(torch.ops.aten.linear、torch.ops._C.rms_norm),边是张量数据流。TorchDynamo 捕获 Python 的 forward 之后会产出这样一张图;torch.compile 的编译后端里,“post-grad”阶段指的是自动微分阶段之后的图优化——推理场景下模型以 torch.no_grad 运行,图里本来就没有反向节点,所以“post-grad”其实就是整张前向图本身。
Inductor 在拿到这张图并生成 Triton/C++ kernel 之前,会调用一批自定义 pass。PostGradPassManager 就是这批 pass 的容器,它本身实现 CustomGraphPass 接口,被 Inductor 当作 post_grad_custom_post_pass 调用,也就是说:vLLM 的融合发生在 Inductor 调度之前,图还是 aten 级、带 dynamic shape 符号的形态。
这张图有两个非常重要的性质:
- 算子已经是“函数式”的形态。
make_fx会做 functionalization:原本就地修改输入的算子(例如fused_add_rms_norm会原地更新残差)会被改写成“返回新张量”的版本。这是后面“在图里插入新算子”能成立的前提。 - 形状是符号化的。解码阶段 batch 大小是动态的,图里可能出现
s0这样的 SymInt。模式匹配必须在符号形状下也能匹配成功,这也是get_inputs()里要提供示例张量的原因。
2. PatternMatcherPass:子图模式 + 替换子图
torch._inductor.pattern_matcher.PatternMatcherPass(下文简称 PM)是 PyTorch 自带的子图替换工具。它的工作方式是:
- 用
register_replacement(pattern, replacement, example_inputs, trace_fn, pass_)注册一对函数:pattern描绘要寻找的子图,replacement描绘要替换成的子图,example_inputs是用于把两个函数都 trace 成 FX 图的示例张量。 - 在一张目标图上运行时,PM 遍历所有算子节点,尝试把每个节点当作模式的“输出节点”,向上回溯输入链路,看是否能与模式图同构(shape 能对上、dtype 能对上、非张量参数能对上)。
- 匹配成功后,把替换图内联(inline)进目标图,删除旧的子图节点。
PM 的一个关键行为是:它会对 pattern 和 replacement 各 trace 一次,并对 replacement 施加 fwd_only(只保留前向节点的 graph)。所以 replacement 里写的代码必须是能被 make_fx 追出 FX 图的:普通 Python 控制流(if x > 0 之类)会在 trace 阶段被“烧掉”成常量。vLLM 大量使用闭包而不是带 self 的方法(rms_quant_fusion.py 里的注释“Cannot use methods, as the self argument affects tracing”正是这个原因)。
3. auto_functionalized:让带副作用的算子进入图
融合后的新算子很多是“多输出 + 原地写入”的自定义算子的形态,例如 fused_add_rms_norm_static_fp8_quant(residual, x, weight, scale, eps)——它要同时产出 (normalized, new_residual),并且语义上是在原地写 residual。在 FX 图里,它不能直接被当作普通函数调用,否则后面的 functionalization 分析会出错。
torch._higher_order_ops.auto_functionalized 的做法是:把一个带 Schema() 和 mutates_args 描述的自定义算子包装成一个“纯函数”高阶算子,它的返回值是一个 tuple,第 0 位是 None(占位,对应算子自身如果没有返回值),之后依次是“每个张量输出”和“每个被就地修改的输入”的新版本。
看一个 vLLM 里的真实用法(来自 rms_quant_fusion.py 的 RMSNormStaticQuantPattern):
at = auto_functionalized( self.FUSED_OP, # torch.ops._C.rms_norm_static_fp8_quant result=result, # 预先分配的输出张量 input=input, weight=weight, scale=scale, epsilon=self.epsilon,)return at[1] # 0 是占位,1 才是 output因为 FUSED_OP 没有返回值(C++ 侧签名 void rms_norm_static_fp8_quant(Tensor! out, Tensor input, Tensor weight, Tensor scale, float eps)),所以 at[1] 是唯一的输出。换成带残差的 block 量化版本 fused_add_rms_norm_per_block_quant 就复杂得多:它既写 residual(就地输入),又产出 scale(输出),源码里对应的替换端写的是
# result, residual, scalereturn at[1], at[3], at[2]也就是说 at[1] 是 result、at[2] 是 scale、at[3] 是被就地更新的 residual。索引顺序并不按“视觉上的参数顺序”排列,而是先列算子声明的输出、再列 mutates_args 中的就地输入;读这类代码必须对着算子签名数一遍,不能凭直觉猜。allreduce_rms_fusion.py 里 return allreduce[3], allreduce[1] 这类看似古怪的索引,来源完全相同。
4. vllm.ir.ops:稳定下来的算子语义
一个容易被忽略的问题:模型代码里调用的 RMSNorm 到底是哪个算子? 在不同版本、不同后端下可能是 torch.ops._C.rms_norm、torch.ops._C.fused_add_rms_norm,也可能是别的后端实现。如果模式直接写死 torch.ops._C.rms_norm,一旦模型走的是“原生实现”路径,模式就匹配不上。
vLLM 的解法是引入一层 IR:vllm.ir.ops.rms_norm、vllm.ir.ops.fused_add_rms_norm。模式里统一引用这层 IR 算子,等融合 pass 全部跑完,再由 VllmIRLoweringPass 把 IR 算子 lowering 到具体后端算子(_C.rms_norm 或 fla 等)。这就是 PostGradPassManager.__call__ 里“先跑所有融合 pass,再 ir_lowering,再 post_cleanup”的顺序来源:
passes(融合:IR 层面) ↓post_cleanup # 清理融合过程留下的死节点/冗余 reshape ↓ir_lowering # vllm.ir.ops.* → 后端具体算子 ↓clone_elimination ↓post_cleanup # 再清一次(lowering 后可能有新冗余) ↓fix_functionalization # 保证图对 functionalization 合法注意 post_cleanup 出现了两次,注释写得很直白:第一次 cleanup 放在 IR lowering 之前,为的是先清理融合过程留下的产物,保证不会有已经死掉的 IR 算子被 lowering。融合过程中会产生一些临时节点(比如为匹配模式而构造的 reshape、permute),如果不在 lowering 前清掉,lowering pass 就会为这些永远用不到的节点生成代码,白花编译时间、甚至直接报错。第二次 cleanup 则处理 lowering 之后才暴露出的冗余。
fix_functionalization 永远最后跑,因为 auto_functionalized 引入的高阶算子和 vLLM 自定义算子的 mutation schema 并不总能被 PyTorch 原生 functionalization 正确处理,需要这一 pass 兜底。
PostGradPassManager 的装配:谁在决定跑哪些 pass
configure() 里的开关从哪里来
PostGradPassManager.configure() 读的是 config.compilation_config.pass_config,一个 PassConfig 对象。这些开关一部分由用户显式指定(-O3 之类的编译级别会打开一组默认开关),另一部分由 vLLM 在“模型上线”阶段根据硬件自动探测——例如只有 CUDA 平台且 C++ 扩展里存在 silu_and_mul_nvfp4_quant 时,NVFP4 相关融合才注册。
装配逻辑里有一处顺序值得细看:
# Run the more specific RMSNorm+router-pad fusion before# AR+RMS, since both consume fused_add_rms_norm.if self.pass_config.fuse_act_padding and (...): self.passes += [RocmAiterTritonAddRMSNormPadFusionPass(config)]
if self.pass_config.fuse_allreduce_rms: ... self.passes += [AllReduceFusionPass(config)]
if enable_transformers_norm_canonicalization: # Let AR+RMS match before moving output reshapes ahead of the # remaining RMSNorms, exposing them to RMS+Quant fusion. self.passes += [RMSNormReshapeFusionPass(config)]
if self.pass_config.fuse_norm_quant: ... self.passes += [RMSNormQuantFusionPass(config)]这里体现了一个通用规律:pattern matcher pass 的顺序是有语义的。AR+RMS 融合要匹配 fused_add_rms_norm,而 RMS+Quant 融合同样要匹配 fused_add_rms_norm 后面跟量化。如果先把 RMS+Quant 跑了,AR+RMS 的模式就要和已经被替换过的图去匹配,自然失败;反之先让 AR+RMS 吃掉,再让 RMSNormReshapeFusionPass 把 output reshape 挪到剩余 RMSNorm 之前,剩下的 RMSNorm 才有机会和量化拼上。注释里那句“exposing them to RMS+Quant fusion”说的就是这件事。
为什么 pass 可以“只对某个形状范围生效”
__call__ 里有一个 compile_range:
compile_range = get_pass_context().compile_rangefor pass_ in self.passes: if pass_.is_applicable_for_range(compile_range): pass_(graph) VllmInductorPass.dump_prefix += 1 else: logger.debug("Skipping %s with compile range %s", pass_, compile_range)原因是 piecewise 编译会按不同 token 数区间分别编译同一段图。某些融合(例如 AllReduce+RMSNorm)的收益依赖 FlashInfer 的通信-归一化重叠实现,而这个实现在 batch 很小时可能反而更慢(通信量太小时,单 kernel 融合无法填满 SM)。is_applicable_for_range 让 pass 只在用户配置的编译区间内生效;区间本身被写进 uuid():
state["compile_range"] = str(get_pass_context().compile_range)这一点后面讲缓存时会再回来。
dump:把每一 pass 前后的图落成文件
VllmInductorPass.time_and_log 装饰器在每次 __call__ 前后自动计时并 dump_graph:
def dump_graph(self, graph: torch.fx.Graph, stage: str) -> None: i = VllmInductorPass.dump_prefix i_str = "" if i is None else f".{i}" lazy_format_graph_code( f"post_grad{i_str}.{self.pass_name}.{stage}", graph.owning_module )dump_prefix 由 PostGradPassManager.__call__ 每跑一个 pass 递增一次,所以看 VLLM_COMPILE_DUMP_PATH 目录下的文件名排序,就是 pass 的执行顺序:
post_grad.0.NoOpEliminationPass.beforepost_grad.0.NoOpEliminationPass.afterpost_grad.1.AllReduceFusionPass.beforepost_grad.1.AllReduceFusionPass.after...配合 dump_patterns()——它把注册的每个 pattern 用 PatternPrettyPrinter 反打印成一段看起来像合法 Python 的代码——就能回答“这个 pass 到底想找什么、实际找到了什么”:
# Patterns for op: <OpOverload(op='vllm_ir.rms_norm', overload='default')>def pattern_0(): ... = auto_functionalized(torch.ops._C.static_scaled_fp8_quant, ...) return ...这一点在融合“应该匹配却没匹配”时极其有用:先看 pattern 文件,确认注册的模式长什么样;再看 before/after 图,确认目标图里的算子形态是 vllm_ir.rms_norm 还是 aten 原生形状——两者对不上,就是 IR lowering 或模型实现路径的问题,而不是 pattern 本身写错。
第一类融合:RMSNorm + 量化
模式到底长什么样
先看最简单的“静态 per-tensor FP8 量化”版本(RMSNormStaticQuantPattern):
def pattern(input, weight, scale): result_rms = vllm.ir.ops.rms_norm(input, weight, self.epsilon) return self.quant_matcher(result_rms, scale)[0]
def replacement(input, weight, scale): result = torch.empty(input.shape, device=input.device, dtype=self.quant_dtype) at = auto_functionalized( self.FUSED_OP, result=result, input=input, weight=weight, scale=scale, epsilon=self.epsilon, ) return at[1]模式是“归一化 → 量化 → 取 quantized 结果”,替换是把两者合并成 rms_norm_static_fp8_quant。两个细节:
第一,quant_matcher 本身是可切换的。 MatcherCustomOp.__init__ 会根据 enabled 选择 forward_custom 还是 forward_native:
self.forward = self.forward_custom if enabled else self.forward_nativeforward_custom 调的是 torch.ops._C.static_scaled_fp8_quant 这类自定义算子;forward_native 走的是纯 PyTorch 实现的 QuantFP8。为什么要这么设计?因为 pattern matcher 必须在目标图里实际出现的算子形态上匹配。如果当前 vLLM 版本或硬件下量化走的是原生实现(例如某些 CPU/XPU 后端),图里就没有 static_scaled_fp8_quant 节点,用 custom 形态的 pattern 去匹配必然落空;反过来用 native 形态,则能在图里找到对应子图,再做替换。同一个融合 pass 的“可匹配性”因此取决于运行环境,而不是源码写死。
第二,量化键(QuantKey)携带的全部信息。看 FusedRMSQuantKey:
class FusedRMSQuantKey(NamedTuple): quant: QuantKey fused_add: boolquant 里有四类字段:
| 字段 | 取值示例 | 对模式的影响 |
|---|---|---|
dtype | FP8 / NVFP4 | 决定图里量化的目标 dtype |
scale.static | True / False | 决定是否有 scale 输入节点 |
scale.group_shape | PER_TENSOR / PER_TOKEN / PER_GROUP(128/64) | 决定有哪些 scale/输出 scale 节点 |
scale.symmetric | True / False | 决定是否需要 scale_ub 之类的额外参数 |
而 fused_add=True/False 区分的是“前面有没有残差相加”。这就是组合爆炸的来源:
- 归一化形态:
rms_norm、fused_add_rms_norm(2 种) - 量化形态:静态 per-tensor FP8、动态 per-token FP8、FP8 block-128、FP8 block-64、NVFP4(至少 5 种)
- 每种 block 量化还要区分 scale 布局:普通行主 / 列主(
col_major_scales)、ue8m0缩放 / 普通 float32 缩放、是否 TMA 对齐
RMSNormQuantFusionPass.__init__ 里就是在这个笛卡尔积上循环注册:
for quant_key, is_scale_transposed, is_e8m0, is_tma_aligned in itertools.product(...): ... .register(self.patterns)为什么 scale 布局也要区分? 因为 scale 在目标图里的“形状和排列方式”是不同的子图:列主 scale 和行主 scale 在图里经过的 reshape/transpose 链不一样,如果不分模式,pattern 要么匹配不到,要么匹配到一个形状其实对不上的子图——后者更危险,因为 PM 会按 shape 检查,但对“语义上等价、实际数据布局不同”的情况无法自动判断。用不同的 pattern 加上 MatcherQuantFP8(has_col_major_scales=True, ...) 让 pattern 端的 make_scale 生成正确布局的示例 scale 张量,才能在 trace 阶段把布局差异体现在图结构上。
一个真正理解这一点的方法是反过来想:如果只写一个“通用 RMSNorm+FP8 量化”模式,会发生什么? 在 block-128 与 block-64 两种量化下,图里的量化算子都是 per_token_group_fp8_quant——同一个算子、不同常量参数。PM 会比对非张量参数(group_size=128 vs 64),所以理论上能区分;但 scale 形状不同、输出数量不同(block 量化输出 (q, scale),per-tensor 只输出 q),所以模式必须分别写。
extra_check:匹配上了还要再做一次检查
pm.register_replacement 还有一个 extra_check 参数,RMSNormQuantFusionPass 给它传的是 _rms_input_weight_dtype_match(定义在 fusion/rms_quant_fusion.py)。这个检查并不只是比对 dtype,源码里它还会确认 rms_norm 与 fused_add_rms_norm 两类 IR 算子的输入宽度是否成对(QK-Norm 那种 qkv 拼接张量属于特例),从而把“形状看起来对、但语义上不是同一个子图”的候选排除掉。它的用途是排除那些 shape/dtype 对得上、但语义上不该融合的匹配。典型场景:某些模型权重用 FP32 存储(例如 Gemma 系列的一些变体),归一化的输入是 BF16、weight 是 FP32,融合 kernel 的签名可能只支持两者同 dtype,或者反过来“只在二者 dtype 相同时才存在对应的融合 kernel”。这种约束在 pattern 层面很难表达(pattern 里的示例输入都是固定 dtype),所以在匹配后做一次检查,不通过就放弃这次匹配、让原图保持原样。
PM 的 apply() 会对每个候选匹配调用 extra_check,只有返回 True 才做替换。这是 vLLM 在不改动 PyTorch PM 的前提下加上的“语义过滤钩子”。
没有残差版和带残差版为什么索引不同
FusedAddRMSNormStaticQuantPattern 的模式是:
def pattern(input, residual, weight, scale): rms, residual = vllm.ir.ops.fused_add_rms_norm(input, residual, weight, eps) return self.quant_matcher(rms, scale)[0], residual注意它同时返回归一化输出和新的残差。原因是即使后续只看量化结果,残差仍然要传给下一层(Transformer 的残差流),所以模式里必须保留这两个输出的使用者关系;返回 residual 是为了让 PM 在匹配时把“残差流”也纳入子图,否则会出现“残差在子图外被用、融合算子却不能正确更新残差”的语义错误。
替换端则必须返回相同数量的输出,并且含义一一对应:
旧图: (quantized, new_residual)新图: auto_functionalized(fused_add_rms_norm_static_fp8_quant, ...)[1:3]这种“输入输出一一对应”是 PM 内联替换的基本约束,也是读融合代码时最容易出错的地方——替换端一旦少返回或多返回一个值,内联到目标图后,原来使用该结果的节点就会接上错误的张量,最终表现为数值错误而不是编译错误。
静态 vs 动态量化的融合差异
静态 per-tensor FP8:scale 是常量(模型上线时标定好的),作为普通张量输入出现在图里;融合算子 rms_norm_static_fp8_quant(out, input, weight, scale, eps) 只需要一个输出。
动态 per-token FP8:scale 必须在运行时根据每个 token 的绝对值最大值算出来,因此融合算子必须自己分配一个 scale 输出,并把 scale 当作可写输出、而不是输入。模式的量化端也是“返回 (q, scale)”两项:
per-token: quant_matcher(rms) -> (q, scale)融合算子: rms_norm_dynamic_per_token_quant(...) -> (q, new_scale, ...)所以同一个 RMSNormQuantFusionPass 里,静态和动态两套 pattern 的注册代码长度完全不同,但骨架一样:定义模式图、定义替换图、给出示例输入。理解融合代码的捷径是看“替换端的输出顺序和模式端的输出顺序是否一致”,剩下的都是机械的枚举。
第二类融合:SiLU-and-Mul + 量化
为什么 MLP 里第一个被盯上的是这里
一个标准的 gated MLP 层是这样的:
x ──► gate_proj ─┐ ├──► silu(gate) * up ──► down_proj └─► up_proj ──┘silu(gate) * up 在很多实现里是两个 kernel:先 silu(或者先乘 gate 再 silu),再逐元素乘;更常见的是 vLLM 已经把它实现成一个融合自定义算子 silu_and_mul(输入形状 [..., 2H],前 H 个是 gate、后 H 个是 up,输出 [..., H])。所以在图里这一步往往已经是一个算子。
那么剩下的可融合空间就在 silu_and_mul 和它后面的量化之间:如果 down_proj 使用 FP8 权重,其输入必须先量化成 FP8,于是 silu_and_mul → quant 就会连续出现。ActivationQuantFusionPass 的目标就是这两个。
SILU_MUL_OP = torch.ops._C.silu_and_mul.default注意它没有用 vllm.ir.ops,而是直接用 _C.silu_and_mul。这是因为 vLLM 的模型实现里,激活函数在 BF16 路径上就是直接调 _C.silu_and_mul,在 IR 化之前就已经是自定义算子了;RMSNorm 则因为存在 Transformers backend 等多条实现路径,才需要 IR 统一。
模式:两层“匹配器”的嵌套
SiluMulFp8StaticQuantPattern 的模式:
def pattern(input, scale): result_silu_mul = self.silu_and_mul_matcher(input) result_quant = self.quant_matcher(result_silu_mul, scale) return result_quant[0]其中 silu_and_mul_matcher 是一个 MatcherSiluAndMul,它本身也区分 custom/native 两条路径。所以这里是两级 matcher 的嵌套:外层决定整个融合的形状,内层分别决定激活和量化在图里的具体算子形态。当 vLLM 启用“原生激活实现”(例如某些后端不支持 _C.silu_and_mul)时,MatcherSiluAndMul.forward_native 会 trace 出 silu(gate) * up 两个 aten 结点,于是 pattern 就自动变成“两算子 + 量化”的三算子模式。
这一点很值得记住:pattern matcher 的“模式”不是写死的子图,而是由一组可切换的 matcher 在注册时动态 trace 出来的。 这解释了为什么 vLLM 的融合代码读起来像“配置”,而不像“算法”——算法是 PyTorch PM 实现的,vLLM 提供的是匹配规则。
替换:输出形状是怎么算出来的
替换端最关键的一行是形状计算:
d = input.shape[-1] // 2output_shape = input.shape[:-1] + (d,)silu_and_mul 的输出宽度是输入的一半,量化不改变形状,所以融合算子的输出形状就是 input.shape[:-1] + (d,)。在符号形状下,input.shape[-1] // 2 能得到正确的 SymInt 表达式——这也是为什么示例输入的形状必须是偶数宽度(empty_bf16(5, 64) 之类),否则 trace 会出问题。
NVFP4 版本:输出有两个
NVFP4 量化的输出是 (packed_fp4, scale_block),两者的形状和 dtype 都不同:
result = self.empty_quant(5, 32) # uint8 打包的 FP4output_scale = empty_i32(128, 4) # 缩放因子块模式里通过 auto_functionalized(self.QUANT_OP, ...) 显式拿到 at[1], at[2] 两个输出;替换端则传入同形的输出缓冲区,由融合算子原地写入:
at = auto_functionalized( self.FUSED_OP, result=result, result_block_scale=output_scale, input=input, input_global_scale=scale,)return at[1], at[2]这里 input_global_scale 和 RMSNorm 静态量化里的 scale 是同一个东西:NVFP4 是“块内 scale + 全局 scale”的两级缩放,全局 scale 来自模型上线时标定,块内 scale 在运行时按 16 个元素一块动态算。融合之后,SiLU 计算、块内 scale 的最大值搜索、FP4 打包在一次 GPU 读里做完,省掉了中间 silu_and_mul 输出的 BF16 往返和单独的 scale 归约 kernel。
block-128 / block-64 的 scale 布局参数
SiluMulBlockQuantPattern 的构造参数最复杂:
def __init__(self, quant_key, is_scale_transposed=False, is_e8m0=False, is_tma_aligned=False, match_aiter=False):is_scale_transposed 决定 scale 存在 [N/group, M] 还是 [M, N/group];is_e8m0 决定 scale 存储格式是不是 MX 风格的“纯指数”;is_tma_aligned 决定 scale 是否需要按 TMA 要求对齐。这三个参数在 vLLM 里不是由用户选的,而是由 quant_method(权重量化方案)的元数据决定:
- DeepSeek-V3 系 FP8 block-128 的 scale 默认列主,且用
float32; - 新一代 MXFP8/NVFP4 路线用
ue8m0作为块 scale; - 需要 TMA 加载 scale 的 GEMM 实现(例如 CUTLASS 的 grouped GEMM)要求 scale 按特殊方式对齐。
这些差异最终会反映到融合算子的参数列表里(比如 rms_norm_per_block_quant 多一个 is_scale_transposed 参数),也会反映到替换端的输出缓冲区形状和 permute 上:
if self.is_scale_transposed: scale = torch.empty( (d // self.group_size, input.shape[0]), device=..., dtype=torch.float32, ).permute(-1, -2)permute 在这里不是多余操作:融合 kernel 按行主视图写入 scale,但下游 grouped GEMM 期望列主布局;用 permute 构造一个非连续视图交给 kernel,既满足了 kernel 对“最后一个维度连续”的要求(permute 后第一个维度才是连续的那一份),又让下游直接吃到期望布局。读这一段时如果先看 MatcherQuantFP8.is_tma_aligned 分支里“for tma_aligned, the scale must be passed to forward_custom / tma_aligned fusion then matches by custom op arguments”的注释,就更容易把两边对上。
融合的收益与代价:一组可以量化的估算
在继续拆第四类融合之前,先把“融合到底值多少”算清楚,因为后面所有的设计取舍都建立在这个账上。
单层注意力里的字节账
设 batch 中有 个 token 正在解码(每 token 一行),隐藏维 ,BF16 每元素 2 字节。一段由 个逐元素算子组成的链,如果不融合,需要 次读 + 次写:
融合成一个 kernel 后,只需读一次输入、写一次输出(中间值留在寄存器或共享内存):
节省比例是 。三个算子融合能省掉 2/3 的字节,五个算子能省掉 4/5。代入 、:每层每段链的未融合字节数约为 MB(),融合后降到约 0.92 MB。以 H100 的 3.35 TB/s HBM 带宽计算,这 1.8 MB 的差额约等于 。一层里有 3–4 段这样的链(QKV 段、MLP 激活段、每段前后各一次 RMSNorm+量化),乘以 60–80 层,单步解码可以省下几十到上百微秒——在 decode 的单步时间以毫秒计的背景下,这是个位数百分比量级,与官方博客给出的“量化开销约占 8%”是同一个数量级。
但 kernel 数量减少不等于时间线性减少
上面的账只算了带宽。真实的收益还要扣除三件事:
- 融合 kernel 的并行度可能变差。把 3 个各自能开满 SM 的 elementwise kernel 合成为一个,SM 数不变,但每个线程要串行做更多工作,如果原 kernel 已经受限于指令吞吐而非带宽,融合后并不会更快。
- 寄存器压力上升。融合算子要同时持有输入块、中间结果、输出块,还要为量化维护 scale 归约的临时值;寄存器一超标,occupancy 下降,带宽利用率反而掉。
- 融合算子的实现质量。手写 C++/CUDA 的融合 kernel 未必要比 Inductor 自动生成的 Triton 更好;这也是为什么 vLLM 只在“确实有对应高质量实现”的组合上注册融合(源码里成片的
assert quant_key in FUSED_OPS就是这条纪律的体现)。
所以“模式匹配融合”正确的定位是:在不动算法、不换实现的前提下,去掉可以去掉的中间张量。它不能把一个带宽受限的 kernel 变成计算受限,也不能替代真正的手写优化 kernel。
编译期成本的另一面
融合 pass 在模型上线时执行,pattern 数量越多,匹配越慢。以一个 80 层的模型为例,每层有若干 RMSNorm、若干激活、若干 AllReduce 位置,每个位置都要对几十个模式做一次同构检查。注册的模式数量是“量化键 × scale 布局 × 残差有无 × 其它变体”的乘积,量级在几十到上百。这就是为什么:
PostGradPassManager只在编译一次时跑这些 pass,绝不在每个请求上跑;uuid()要把 pass 类集合纳入缓存键,避免“改了 pattern 但复用了旧编译产物”;- 调试时要先看
match_table(每个 pass 命中了几次),而不是盲目增加模式——命中数为 0 的模式不仅没用,还在每次编译时白白消耗匹配时间。
一个实用的经验:如果某个 pass 的 match_table 在生产模型上长期为 0,要么是模型代码形态变了(模式需要更新),要么是这个 pass 对该模型根本不适用(应该在装配阶段的条件里排除掉)。
第三类融合:AllReduce + RMSNorm
为什么这里要融合通信
张量并行(TP)下每一层末尾都要做一次 AllReduce。以本系列拆过的 GLM 系模型为例,每层至少两次 collective,加上 RMSNorm 就形成 AllReduce → (fused_add_)rms_norm 这种固定序列。通信本身走 NVLink/RDMA,但通信完成之后,每个 rank 都要把整个输出张量从显存读出来做归一化——也就是说,通信 kernel 已经把张量过了一遍手,RMSNorm 又要过一遍。把两者融合成一个 kernel,可以让归一化直接在通信 kernel 的收尾阶段计算,避免一次额外的全量读写。
这类融合不是 vLLM 自己写的:allreduce_rms_fusion.py 调用的是 FlashInfer 的 flashinfer_trtllm_fused_allreduce_norm。vLLM 的角色是在图上识别出这个序列并调用它。
模式:IR 层 + 一个“反直觉”的返回值
AllReduceRMSNormPattern 的模式:
def pattern(input, weight): allreduce_output = tensor_model_parallel_all_reduce(input) rms = vllm.ir.ops.rms_norm(allreduce_output, weight, self.epsilon) return rms, allreduce_output它返回两个值:归一化结果,以及 AllReduce 的输出。为什么 AllReduce 的输出也要返回?因为在第一层 Transformer block 里,AllReduce 的输出(也就是 layer 的输入 x)后面还会被用于残差流(第一层没有前置残差,x 本身就是 residual 的起点)。如果模式只关心 rms,PM 匹配成功并替换后,目标图里那个仍然使用 allreduce_output 的节点就会失去它的生产者。
所以模式必须把“所有被融合子图的生产者”都写进返回值——即便替换端不一定全部用上。替换端:
def replacement(input, weight): residual = torch.zeros_like(input) rms_result = torch.empty_like(input) allreduce = auto_functionalized( flashinfer_trtllm_fused_allreduce_norm, allreduce_in=input, residual=residual, # 没有真实残差,传一个全零占位 norm_out=rms_result, quant_out=None, scale_out=None, rms_gamma=weight, rms_eps=self.epsilon, pattern_code=flashinfer_comm.AllReduceFusionPattern.kARResidualRMSNorm, ..., ) return allreduce[3], allreduce[1]这里有两个设计点:
- 传给 FlashInfer 的
residual是torch.zeros_like(input)。FlashInfer 的融合算子统一按“AllReduce → 加残差 → 归一化”的语义实现(这样可以覆盖带残差的场景),当没有残差时,就用零张量让它退化成纯 AllReduce+RMSNorm。零张量可以用torch.zeros_like在替换图里直接生成——这个节点会被 Inductor 识别为常量零并做特殊处理,不会真的产生一次显存清零的内存开销。 - 返回值顺序由 FlashInfer 算子的签名决定。
allreduce_in是被就地修改的输入,residual也是被就地修改的输入,所以在auto_functionalized输出里,[1]是allreduce_in的新版本、[2]是residual的新版本(如果传入)、[3]是norm_out。注释“# rms_result, allreduce_in”就是为了提醒自己这一点。这类索引写错在测试时不一定能立刻发现(如果返回的两个值形状一致),但会直接造成数值错误。
extra_check 与 Gemma gamma
AllReduceFusedAddRMSNormPattern 的注释:
# extra_check routes a Gemma fp32 gamma to AllReduceFusedAddGemmaRMSNormPattern.Gemma 的 RMSNorm 使用 gamma + 1 的形式(而不是直接乘 gamma),并且 gamma 以 FP32 存储。FlashInfer 融合算子有单独的 Gemma 变体。这里 extra_check 起到“在两种候选模式之间分派”的作用:先尝试普通模式,匹配后检查 weight dtype 是否是 FP32 且存在 Gemma 变体,是则交给 Gemma 模式,否则用普通模式。
“只返回第一个”的变体
注释“Same pattern, but only return the output and not residual / (helpful for end of graph where residual is not used again)”揭示了一个模式注册中的小技巧:
first_return_only = lambda fn: lambda a, b, c: fn(a, b, c)[0]pm.register_replacement( first_return_only(pattern), first_return_only(replacement), ...)因为同一个模式可以注册多次,但每个模式的所有输出都必须能在目标图里找到对应的锚点,用 lambda (...) [0] 包一层,就能把“三输入三输出”的模式变成“三输入一输出”的模式。为什么需要这样?如果目标图里 residual 这个输出在融合点之后已经没有任何使用者(例如最后一层 block 的残差流在这里终止),DCE 或图构造阶段很可能根本不会保留这个节点;此时严格的三输出模式会去找一个在目标图里不存在的锚点,匹配失败。把模式改成“只产出第一个输出”,就能匹配这种“残差已死”的图形态。
这一点是理解 pattern matcher 行为的关键:PM 是“锚点 + 数据流同构匹配”,而不是“子图包含匹配”。模式里声明的每一个输出节点,都要在目标图中找到一个结构对应的节点作为锚点(Match.output_nodes() 返回的就是这些锚点,替换阶段会用它们逐一对接替换图的输出);目标图里多出来的使用者不影响匹配,但模式里多出来的、目标图中不存在的节点会让匹配失败。所以同一种融合往往要按“输出被用了几项”注册多个变体。vLLM 在 AllReduce 融合里显式处理了这类情况,其它 pass 也有类似做法(例如 Rope + KV Cache 融合里对“只有一个使用者”和“有多个使用者”分别注册)。
第四类融合:QK-Norm、RoPE 与写 KV Cache 的三合一
前三类融合都只缝合两个算子。真正能说明模式匹配能力上限的,是 qk_norm_rope_kvcache_fusion.py 里的 QkNormRopeKvCachePattern:它一次跨过五六个算子、两次 reshape、一次 split,最后落在写 KV Cache 上。
未融合的序列长什么样
QkNormRopeKvCachePattern 的类注释把要匹配的序列写得很清楚:
q, k, v = split(qkv, [q_size, k_size, v_size], dim=-1)q = rms_norm(q.view(heads), q_weight).view(flat) # QK-Normk = rms_norm(k.view(heads), k_weight).view(flat)q, k = rotary_embedding(positions, q, k, cos_sin_cache) # RoPEq = q.view(num_heads, head_dim)k = k.view(num_kv_heads, head_dim)v = v.view(num_kv_heads, head_dim)dummy = unified_kv_cache_update(k, v, layer_name) # 写 KV这是 Qwen3 一类模型每层注意力的前半段:QKV 投影产出一个拼接张量,按 [q_size, k_size, v_size] 切成三份;Q 和 K 各自做一次 RMSNorm(按 head 视图);然后做 RoPE;最后把 K、V 写进分页 KV Cache。中间至少产生 4 次 kernel 启动、6 次张量读写,且全部是访存主导的窄算子。
替换后的形态
替换端没有逐段重写,而是把整个“从 qkv 到写缓存”的过程交给一个自定义算子:
_, _, v = qkv.split([self.q_size, self.k_size, self.v_size], dim=-1)v = v.view(qkv.shape[0], self.num_kv_heads, self.head_size_v)results = auto_functionalized( self.FUSED_OP, # fused_qk_norm_rope_and_unified_kv_cache_update q_out=q_out, k_out=k_out, qkv=qkv, positions=positions, q_weight=q_weight, k_weight=k_weight, rms_norm_eps=self.eps, cos_sin_cache=cos_sin_cache, is_neox=self.is_neox, layer_name=self._get_layer_name(layer_name),)return results[0], results[1], results[2], v注意三个细节:
- 融合算子接收的是原始
qkv,不是切好的 q/k/v。 也就是说,split 本身被吞进了 kernel:kernel 内部按偏移量分别读 Q/K/V 段,省掉了“先切出一个连续张量再读”的这一跳。V 仍然在图里被切出来并 view,因为后续 attention 需要它作为独立张量;但 K 不再需要单独存在,它被直接写进了 KV Cache。 q_out/k_out是预先分配的输出缓冲区,results[0]、results[1]是融合后的 Q、K(注意 K 只是为了让下游 attention 有张量可用,真正的 K 已经落在缓存里)。layer_name是编译期常量。KV Cache 的写入必须知道“写哪一层的槽位”,而层名在编译时已确定,所以它作为字符串参数进入模式。源码里_USE_LAYERNAME这个模块级开关决定了到底把layer_name作为显式参数传入,还是用torch.ops.vllm.unified_kv_cache_update的隐式约定——于是register()里出现了quant_query × _USE_LAYERNAME的四套闭包,逻辑完全相同,只是参数表不同。
为什么这个模式需要特殊的 trace 处理
普通的 pm.register_replacement 会把 pattern 再 trace 一次并转成内部模式图。但这一段的输入里有 positions(int64)、head_size/num_heads 这类整型常量,还有动态形状的 T。PatternMatcherPass 默认会把 int 当成需要精确匹配的常量——T=5 的示例输入会让模式只匹配 batch 为 5 的图,动态解码时永远匹配不上。
源码的处理是显式构造模式:
search_gm = trace_fn(pattern, inputs)search_fn_pattern = pm.fx_to_pattern( search_gm, ignore_types=(int, torch.SymInt), argnames=argnames,)pm.register_replacement(..., search_fn_pattern=search_fn_pattern)ignore_types=(int, torch.SymInt) 把整型和符号形状都当作通配符,argnames 保证内联时参数顺序正确。这一段是理解“为什么同一个 pattern 在静态 shape 下能匹配、动态 shape 下匹配不到”的关键:不是 pattern 写错了,而是 trace 时把示例形状固化进了模式。前面几类融合的示例输入形状恰好都是常量(如 5, 16),而它们的目标图也只在固定 token 区间内匹配,所以问题不明显;到了 QKV 这种 batch 维完全动态的场景,就必须显式放宽。
一个模式能跨多远
这段融合的边界很值得注意:它没有把 qkv_proj(GEMM)一起吞进去,也没有把 attention 吞进去。
- 不吞 GEMM:GEMM 的输出布局、量化方式、并行切分都由权重决定,把 GEMM 和后续元素级算子放进同一个模式,意味着模式要同时理解权重形状与量化方案,注册数量会再乘一个维度;而且 GEMM 本身的算术强度足够高,融合带来的收益远小于维护成本。
- 不吞 attention:attention 是 vLLM 的
splitting_ops边界,piecewise 编译本来就在这里断图,模式不可能跨过图边界。
所以这类融合的实际上限是“一段连续的、shape 规则、全部访存主导的元素级算子链”。源码里还有一个很现实的约束:
SUPPORTED_FUSED_QK_NORM_ROPE_KVCACHE_HEAD_DIMS: tuple[int, ...] = (64, 128, 256)# Head sizes the fused kernel ... supports. Other sizes hard-abort, so skip those layers.融合 kernel 只支持 64/128/256 三种 head_dim,其他尺寸直接 abort。也就是说,模式的注册必须由模型结构驱动:PostGradPassManager 在装配时遍历模型的 attention 层,只给支持的层注册对应模式。这解释了为什么融合 pass 的构造函数往往需要拿到 layer: Attention 这样的对象——它不是为了“通用”,而是为了针对每一层生成精确的示例输入和参数。
真实世界里模式匹配会怎样失效
上面的“读法”假设模型代码老老实实写成了标准形态。工程实践中,失效往往来自一些不显眼的地方,列出几个高频场景:
- 中间多了一次 dtype 转换。例如作者为了让数值更稳定,在 RMSNorm 之后写了
x.float(),再量化。模式里没有这个节点,匹配直接失败;而这通常是静默失败,只表现为“这段融合没生效”,不会报错。排查办法是看 dump 出来的before/after图:after与before完全相同,说明一条都没匹配上。 - 算子被替换成了等价写法。
F.rms_norm(x, (H,), w, eps)与RMSNorm模块的forward在 eager 下等价,但 trace 出的节点可能不同(一个是aten.rms_norm,一个是_C.rms_norm或 IR 算子)。这正是vllm.ir.ops存在的理由:把模型侧写法收敛到一层 IR,模式匹配 IR,而不是匹配各自 trace 出的原始节点。 - reshape 链多了或少了一层。
q.view(-1, heads, head_dim)与q.reshape(...)在图中都可能出现,甚至view().transpose().view()这种“看似冗余但语义必要”的组合。vllm_inductor_pass.py里的_fx_view_to_reshape、_remove_noop_permutes、fold_consecutive_reshapes就是为了在 trace 前把这些差异抹平,让模式只关心真正的计算链。 - 融合算子在该硬件上不可用。模式注册时用的是
if current_platform.is_cuda()之类的守卫,在非 CUDA 平台上这个模式根本不存在;这属于预期内的退化,排查时要先确认平台分支。 - batch 维出现了符号形状,而模式把它当常量。就是上一节
ignore_types讨论的问题。典型症状是“静态测试能匹配、线上动态批不匹配”。
把这几种情况记住之后,调试流程其实非常固定:先看 match_table 是否 > 0 → 若为 0,看 dump 出的 before 图里目标算子的形态是否与 pattern 一致 → 若形态一致仍不匹配,检查 extra_check、形状常量、ignore_types → 若都不对,说明 trace 出的模式本身有问题(示例输入失败或形状不合法)。
读模式之前:编译缓存与数值不变量
fuse_inductor_pass 的 uuid 机制
推理服务最怕的事之一:模型第一次请求时触发编译,编译花了 20 秒,但换一台机器或换一次模型配置,又得重编一次。vLLM 解决了这点——InductorPass 有 uuid() 方法,Inductor 用它作为缓存键的一部分;PostGradPassManager.uuid() 把所有子 pass 的 uuid 和配置的 hash 串起来:
state = {"pass_config": self.pass_config.compute_hash()}passes = []for pass_ in self.passes: passes.append(pass_.uuid())passes.append(self.post_cleanup.uuid())passes.append(self.ir_lowering.uuid())passes.append(self.clone_elimination.uuid())passes.append(self.post_cleanup.uuid())passes.append(self.fix_functionalization.uuid())state["compile_range"] = str(get_pass_context().compile_range)state["passes"] = passesreturn InductorPass.hash_dict(state)而每个 pattern matcher pass 的 uuid 来自:
def uuid(self) -> str: return VllmInductorPass.hash_source( type(self), *[type(pr) for pr in self._pattern_replacements], )也就是说,缓存键只取决于 pass 的类和注册的 pattern 类,不包括这些类内部具体实例的参数(epsilon、group_size 等)。这是有意为之:那些参数会影响“示例输入的形状”,但不会改变生成的 kernel 代码——kernel 代码只由目标图决定。因此把 uuid 简化成“类名集合”,既安全(不同类必然不同),又避免每次 tweak 示例输入就造成全量重编译。
compile_range 被显式写进 uuid 的原因不同:不同 token 区间的图会被分别编译,但同一段代码可能对不同区间有不同决策(例如是否跳过某个 pass),缓存键必须能区分,否则从区间 A 复用的缓存会被错用到区间 B。
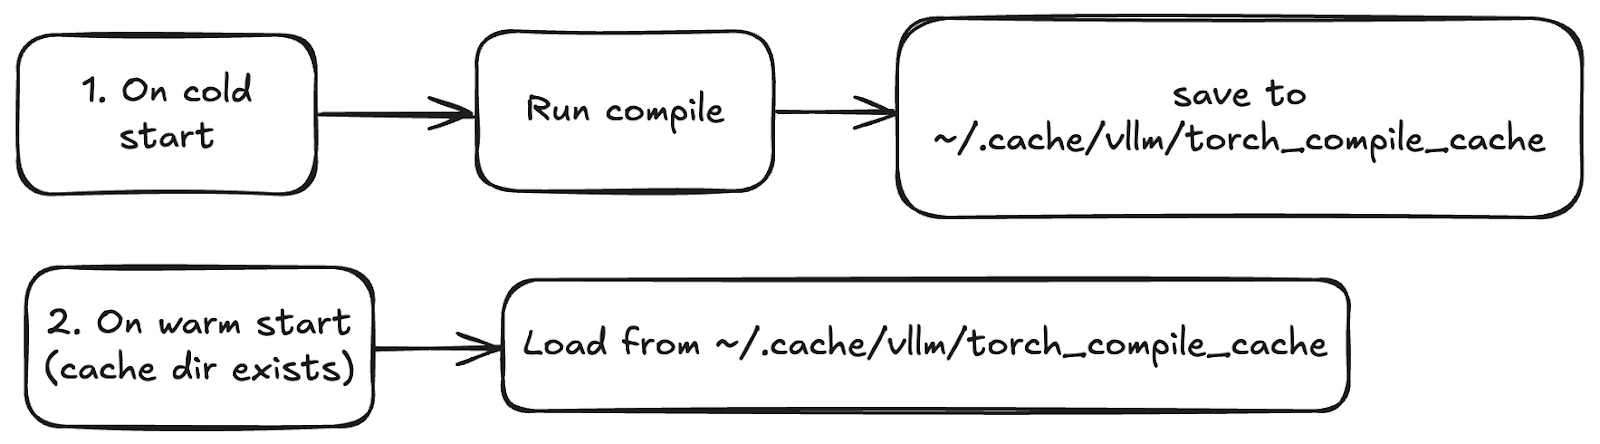
上图(vLLM 官方博客)画的是更外层的缓存:Inductor 生成的 kernel 与编译后的图落在磁盘上,机器重启或换机器时可以复用。把它和 uuid() 放在一起看,层次就清楚了——uuid() 决定的是“这份缓存是否适用于当前这组 pass”,外层的磁盘缓存决定的是“这份缓存是否适用于当前这台机器、这个模型配置”。两者任何一层的键不一致,都会触发重新编译;而融合 pass 的源码一旦改动(哪怕是新增一个 pattern 类),hash_source 就会产出新的 uuid,旧的编译缓存自动失效,不需要手动清理。
和“不变量”的关系
一个和本系列前面的 vLLM(三十)显存预算、(十二)piecewise 编译相关的点:融合 pass 不改变数值语义,只改变“计算的组织方式”。这也是它能对编译后图做模式替换的前提——如果一个融合会改变数值结果(例如改变舍入顺序),那么编译出来的模型就与 eager 路径产生了偏差,而 vLLM 的 batch-invariant 等机制正是为了避免这种偏差。融合实现(例如 rms_norm_static_fp8_quant 的 C++ 实现)在数值上要精确等价于“先做 RMSNorm 得到 BF16,再做静态量化”的序列——这通常是最难写对的地方(scale 乘在哪一步、平方根用 rsqrt 近似还是精确、归约树如何切分),但它是融合能成立的底线。
读懂一个融合 pass 的通用方法
总结成一套可以复用的阅读步骤:
- 先看
register()里的pattern和replacement两个闭包,以及它们的返回值元组。 这是唯一不可省略的部分;get_inputs()只是“让 pattern 和 replacement 能成功 trace 一次”的示例张量。 - 在模式上画出“生产者链”。 每个被返回的张量,它的生产者都必须能被模式完整覆盖;被目标图使用而未被返回的张量,就要找到对应的“剪裁版”模式。
- 核对
replacement的每个输出。 输出数量必须和 pattern 一致,顺序必须和auto_functionalized的mutates_args顺序一致。 - 确认示例张量的形状是对的。
silu_and_mul的示例输入宽度必须是偶数;NVFP4 块量化的示例输入宽度必须是 16 的倍数(每 16 个元素一块);block-128 量化的示例列宽必须是 128 的倍数;is_tma_aligned的 scale 示例形状要符合对齐要求。任何一条不满足,register_replacement会在 trace 阶段报错,而报错信息通常很不直观(会指向auto_functionalized内部)。 - 看
extra_check。 它往往承载“语义层”的判断(dtype 组合、是否有对应 Backend 实现),也是“同一模式多分派”的地方。
官方实测:融合省下来的吞吐
前面讲的全是“怎么融合”,还有一个问题没有回答:一张图上的这几处缝合,到底能不能在端到端吞吐上被看见?vLLM 官方博客(2025 年 Introduction to torch.compile and How It Works with vLLM)给出了一个可以直接拿来拆读的对照。
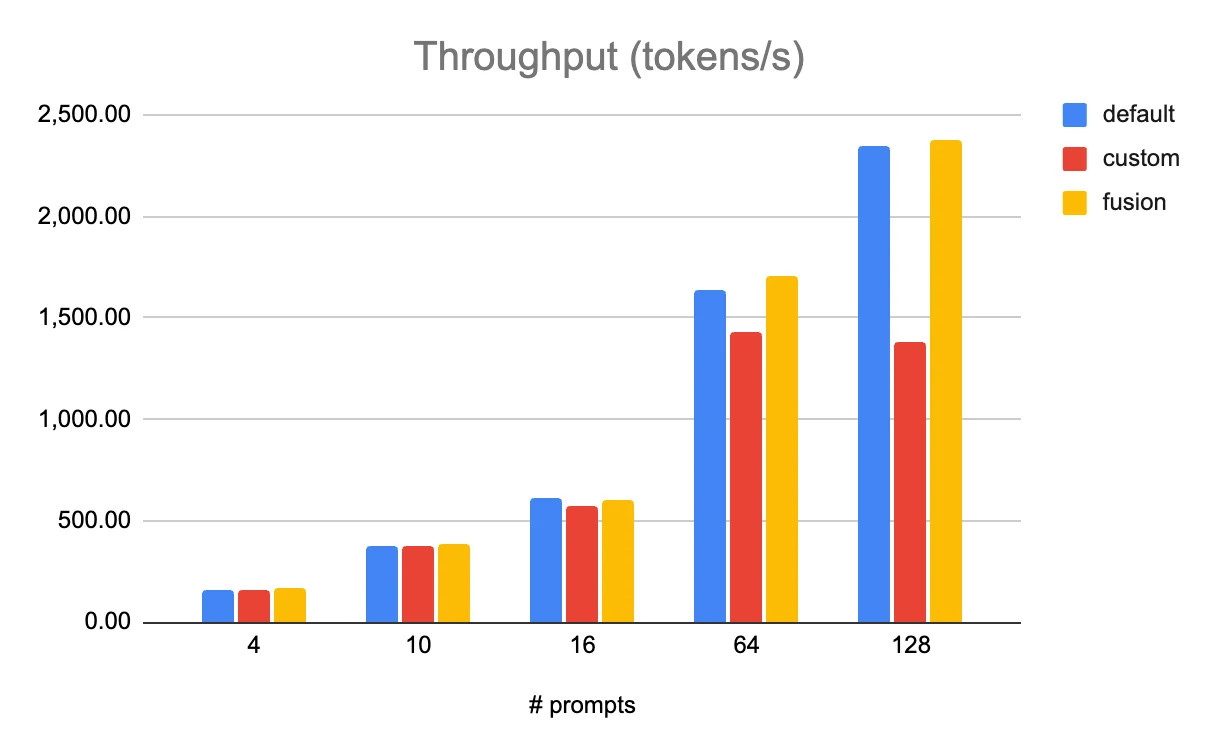
实验条件是 Llama 3.1 405B 量化为 FP8、8 张 MI300 做张量并行;图中按不同输出长度的解码场景分组比较三种配置的吞吐。读这张图不需要记住具体的倍数,只需要抓住三件事:
第一,fusion 与 default 之间的差距,对应的正是本文拆的那几类融合。default 配置下 RMSNorm 和 SiLU 走的是 torch 的 aten 算子,量化走单独的 static_scaled_fp8_quant / per_token_group_fp8_quant;fusion 则是把这三段(在 block 量化下是三段合成一段)用 pattern matcher 缝成 rms_norm_static_fp8_quant、silu_and_mul_nvfp4_quant 这类融合算子。也就是说,图里两条线之间的空隙,就是“多出来的那几次显存往返”在真实负载下的价格。
第二,custom 与 fusion 的对比说明了模式匹配相对手工融合的价值不在性能上限,而在覆盖面。custom 是手工注册的未融合自定义 kernel,性能通常介于两者之间:每个小算子都换成了更高效的实现,但 kernel 之间的中间张量仍然要落在显存里。融合只是把中间张量省掉,并没有发明新的算法,所以 fusion 的上限是“把所有中间读写都消掉”。
第三,图中给出的另一组信息解释了为什么这项工作的收益看起来不大却在生产中被反复优化:博客同时指出,在该实验里“所有量化开销”约占吞吐的 8%,如果完全通过融合消掉,理论上限就是 8% 左右,而部分场景确实摸到了这个上限。这个数字同时也划定了前面那段字节数估算的边界——融合能省的是访存,不是 FLOPs,所以当 GEMM 已经把 SM 占满时(长输出、大批量解码),融合的收益会被 GEMM 的耗时掩盖,只有在“计算不饱和、访存占比高”的场景(短输出、小批量、量化路径长)里才最容易显现。
这也解释了为什么 PostGradPassManager 要给每个 pass 配 is_applicable_for_range:同一套融合在不同 token 区间里的边际收益完全不同,是否需要为某个区间单独关掉某类融合,是一个可以配置的工程决策,而不是“有融合就一定要用”。
局限与代价
编译期融合不是没有代价:
- 编译时间与缓存体积。每个模型第一次上线要跑完所有融合 pass,并且每段图、每个 token 区间都跑一遍。
RMSNormQuantFusionPass注册的模式数量是几十个,匹配时每个算子节点都要尝试几十个模式,图越大代价越明显。vLLM 用 uuid 缓存能部分缓解,但第一次冷启动仍然有开销。 - 对图形态的强依赖。融合能匹配上,必须假设模型在前向里确实写成了
rms_norm → quant这种相邻序列。模型作者如果在两步之间插了一个调试用print、一次 dtype 转换(to(fp32))、或者写法不同(F.rms_normvs 自定义RMSNorm类),模式就匹配不上——而匹配不上不会报错,只是静默地退化成未融合,性能下降在端到端测试里往往被淹没。 - 后端耦合。AllReduce 融合直接依赖 FlashInfer 的存在和版本;某些融合只在 CUDA 上注册。跨平台的统一性靠的是“没有对应实现就不注册”,而不是“一个实现覆盖全部硬件”。
- 数值正确性验证的难度。融合 kernel 与原序列的数值等价性需要单元测试覆盖每个量化键,而 vLLM 的模式数量意味着测试矩阵极大。这也是为什么源码里到处是
assert quant_key in FUSED_OPS——一旦某个组合没有实现,直接 fail-fast,而不是悄悄用错误的算子。
小结
vLLM 编译期的融合 pass 本质上是“把 PyTorch 的 PatternMatcherPass 包装成一套针对推理模型常见小算子序列的声明式规则”:
- 图在 Inductor 代码生成之前被处理,所以融合改变的是 kernel 的数量与形状,而不是 CUDA Graph 结构;
vllm.ir.ops提供了与后端无关的稳定算子层,融合在 IR 上做,lowering 在后头;auto_functionalized让带副作用的融合算子以纯函数形态进入图,返回值的顺序决定了替换端的索引;- 模式的数量由量化键、scale 布局、是否有残差、是否 Gemma-variant、是否带
layer_name这些“维度”组合出来; - 跨算子越多,模式对 trace 细节越敏感(动态形状要
ignore_types、head_dim 要预先过滤),所以融合的边界停在“元素级窄算子链”,而不是把 GEMM 与 attention 也吞进来; - 匹配不上时的调试路径是
dump_patterns+dump_graph:先看模式,再看目标图的算子形态。
下一篇会讨论这一层和运行时“形状分档 + 编译缓存”的衔接:同一段图在解码区间和预填充区间如何被分别编译、编译结果如何在不重启的情况下被复用,以及形状不匹配时 vLLM 在编译缓存上如何退化。相关的前置内容可以参考本系列的 vLLM 源码完全拆解(十二):piecewise compilation 与 CUDA Graph、GPU GEMM 优化完全拆解(三):Tensor Core、MMA/wgmma 指令与异步流水线、浮点数与数值稳定性:从 IEEE 754 到 FP8 的 LLM 精度世界 与 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图。
参考资料
- vLLM 源码:vllm/compilation/passes/pass_manager.py
- vLLM 源码:vllm/compilation/passes/fusion/rms_quant_fusion.py
- vLLM 源码:vllm/compilation/passes/fusion/act_quant_fusion.py
- vLLM 源码:vllm/compilation/passes/fusion/allreduce_rms_fusion.py
- PyTorch 文档:torch.fx Graph and GraphModule
- PyTorch 源码:torch/_inductor/pattern_matcher.py
- flashinfer 仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



