


Lookahead Decoding 完全拆解:Jacobi 迭代与 N-gram 池,不靠草稿模型的投机解码
投机解码类方法有一个绕不开的前提:需要草稿模型。无论是经典 Speculative Decoding、特征级的 EAGLE 系列,还是多头候选的 Medusa,都要额外准备一个能与目标模型对齐的小模型或者额外微调的头。草稿模型不好选、难以在多个模型族之间复用,还要在显存里多占一份权重。Lookahead Decoding 的切入点是:能不能完全不引入任何辅助模型和数据存储,直接让目标 LLM 自己”边生成边投机”。
答案是肯定的。2024 年 2 月,UCSD 的 Yichao Fu 与 LMSYS/UC Berkeley 的 Peter Bailis、Ion Stoica、Hao Zhang 等人发表了《Break the Sequential Dependency of LLM Inference Using Lookahead Decoding》(ICML 2024),并提出一种精确的并行解码算法:把自回归解码看成一个非线性方程组,用 Jacobi 不动点迭代并行求解,再从迭代轨迹里收集 n-gram 候选,交给一个验证分支去并行验证。它不需要草稿模型、不需要数据存储、不改变输出分布,在 MT-Bench 上把 LLaMA-2-Chat-7B 的解码加速到 1.8 倍,多卡强扩展下在代码补全任务上做到 4 倍。
这篇拆解会沿着论文的逻辑走:先从非线性方程组的角度理解 Jacobi 解码,再看它与 Lookahead Decoding 的本质区别,然后详细拆解 lookahead 分支、验证分支、三者的合并执行、以及 LP 并行方案,最后分析缩放定律、实验数据与局限。
背景与问题定义
自回归解码本身是串行的
现代 LLM 推理在解码阶段是内存带宽受限的:每生成一个 token,都要把整份模型权重从 HBM 里读一遍,再乘上一个只增加一个行向量的激活。这带来两个直接后果:
- 每步只产出一个 token。总生成时间与解码步数成正比,无法用并行摊薄。
- 每步算力利用率极低。解码阶段的算术强度很低,GPU 的算力空转。
更本质的约束来自因果注意力:第 个位置的输出 只能由 的 计算得到:
配合下三角因果掩码后,每一步的输入依赖上一步的输出。LLM 除了注意力层都是 token-wise 的逐位置变换(MLP、RMSNorm),所以这种”输出依赖输入本身”的结构贯穿整条序列。想打破串行,就必须让”下一 token 的输入”在生成之前就被猜出来。
猜测-验证范式:绕不开草稿模型
Speculative Decoding(ICML 2023)的经典做法是:小草稿模型每步自回归地猜 个后续 token,目标 LLM 一步并行验证,接受前缀里命中的部分。这个范式成立的条件是存在一个与目标模型分布足够接近、又足够便宜的草稿来源。站里已有文章详细拆解过各类草稿来源:MTP 模块的自投机、EAGLE 的特征级草稿、Medusa 的多头候选、以及 REST 的检索式草稿。
这些方法有一个共同的成本项:草稿来源本身要维护。要么额外占显存,要么对每个模型族重新训练/蒸馏,要么只对”有大量重复文字”的场景有效,通用性有限。Lookahead Decoding 用的是第四条路:不引入任何外部猜测器,从模型自身的迭代轨迹里”挖掘”候选。
核心思想:从方程组视角看解码
把自回归解码写成非线性方程组
记 prompt 为 ,LLM 要生成 个 token。在贪心采样下,自回归解码等价于逐个求解以下方程(论文式 (1)):
这里 是 LLM 给出的下一个 token 的分布, 对应贪心解码。这个方程组的麻烦之处在于: 的右边出现 、 的右边出现 ……这是一个三角结构的非线性方程组——解出 才能解 ,天然串行。
定义 ,上式可改写为一个标准形式(论文式 (3)):
这一步是纯形式变换:所谓”解码”就是求这个方程组的不动点。一旦换了这个视角,串行不串行就不再取决于方程组本身,而取决于求解方法。Jacobi 迭代正是解非线性方程组的一种并行格式。
Jacobi 迭代:解码的”并行格式”
高斯-赛德尔迭代是”解出一个变量就立刻用最新值解下一个”,对应自回归;Jacobi 迭代则是在每一轮对所有变量同时用上一轮的旧值更新:
- 给定第 轮的完整序列估计 ;
- 把 整个喂给 LLM,一次性并行算出每个位置上的下一 token 分布;
- 得到第 轮的估计 ;
- 不断重复,直到收敛到不动点。
在 Jacobi 迭代中,相邻两轮的序列 与 之间天然存在一个差分关系: 的第 个元素是将 的前 个元素喂给模型得到的 。论文给出了两个关键观察:
观察一:迭代一定收敛到正确答案。 因为 的第一个元素只依赖 prompt,而 prompt 是已知输入,因此 与贪心自回归的第一步完全一致;后续同理。所以最坏情况下,Jacobi 迭代最多 轮就收敛到与自回归完全相同的 个 token——精度无损。
观察二:轨迹里藏着 2-gram。 是由 生成而来,因此任意相邻两轮的 token 序列之间天然满足”前一轮的后缀是后一轮的前缀”的关系,可以构成有意义的 2-gram。
只可惜这两点还不够。论文作者实测发现,Jacobi 解码虽然一步能产出多个 token,但几乎不带 wall-clock 加速:这些 token 经常放错位置,即便放对位置,也可能在后续轮次中被重新计算出来的其他值覆盖,“正确”的 token 没法稳定留在序列里。要把它变成工程上可用的加速手段,必须解决两个问题:一是从轨迹里挖出高置信度的候选,二是为这些候选补上严格的接受/拒绝机制。
一次具体的迭代走读
用一个极简例子把迭代过程走一遍。设 prompt 为「法国的首都是」,贪心自回归会依次产出「巴黎」「,」「它……」三个 token。Jacobi 解码则先对这三个待求位置填任意初值,比如 :
- 第 1 轮:把整条 (连同 prompt)喂给模型,并行求三个位置。位置 1 只依赖 prompt,输出「巴黎」;位置 2、3 的前缀是错的,输出无意义(记为 X、Y)。此时第一个生成 token 已经锁定为「巴黎」。
- 第 2 轮:前缀里多了一个正确的「巴黎」,位置 2 的输入条件改善,输出开始有意义(例如「,」);位置 3 仍错。
- 第 3 轮:位置 2 正确后,位置 3 也收敛。
三个观察值得写下来。其一,错位是常态:初值 把无意义 token 放在了所有位置上,模型必须在后续轮次里逐个”挤掉”它们,这正是”正确 token 会被覆盖”的微观机制。其二,收敛有单调性下界:位置 1 的条件永远是完整正确的,所以每轮至少把一个新位置从”错”变”对”,最多 轮收敛的结论由此而来。其三,轨迹本身就是免费的草稿:第 1 轮的「巴黎」与第 2 轮的「,」在同一相对位置上首尾相接,构成的 2-gram(巴黎,,)正是模型对「巴黎」之后最可能出现的延续——下一节将看到,把这些轨迹 n-gram 系统性地收集起来验证,就构成了加速的来源。
原理详解:从 Jacobi 轨迹到多分支并行
Lookahead Decoding 的整体工作流如图 1(论文图 1)所示:每一步解码里,系统同时执行三件事——lookahead 分支并行生成候选 token、验证分支并行验证 n-gram、n-gram 池接受新的候选。
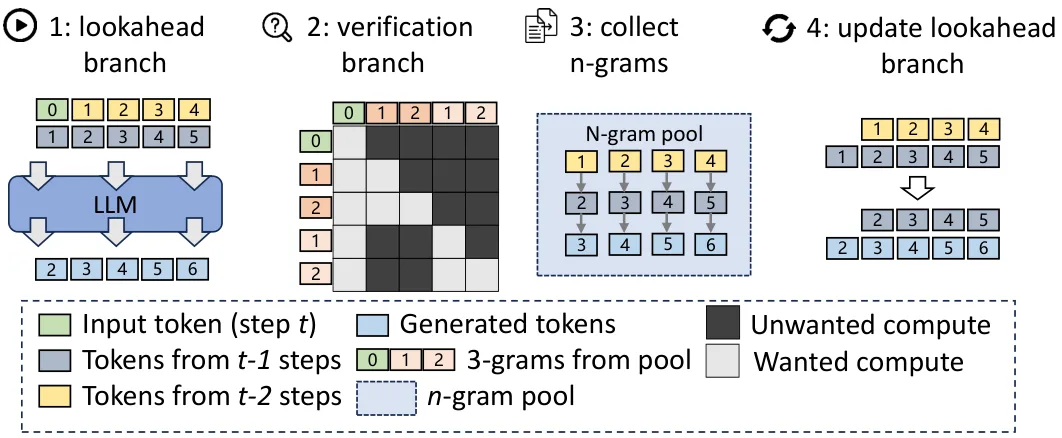
Lookahead 分支:用 2D 窗口制造 n-gram
纯 Jacobi 解码只用上一轮的历史,只能产出 2-gram。Lookahead Decoding 的第一个关键设计是把历史”拉长”:用 Jacobi 迭代轨迹上的过去 轮(论文里用 表示 n-gram 长度)一起参与这轮的并行生成,从而并行制造大量长度为 的 n-gram。
这个机制用一个固定的 2D 窗口来描述,窗口沿着两个维度滚动:
- 序列维(W):往未来”看”多少个 token 位置,每轮并行填充这 个位置;
- 时间维(N):从 Jacobi 轨迹里往回看 轮,把近 轮同一相对位置上的 token 串成一条 n-gram。
论文图 2(b) 给出了 的例子:当前轮(蓝色,标 0)作为输入,橙色、绿色、红色 token 分别是 轮的产物。每个 token 上的数字表示它与当前输入的相对位置。这一轮做一次改进版 Jacobi 迭代,为全部 5 个位置并行生成新 token;随后把「橙色位置 1 → 绿色位置 2 → 红色位置 3 → 新生成的 token」这样一条沿时间轴串起来的链收进 n-gram 池。
窗口每步滚动、保持固定大小:把两个维度上最旧的 token 淘汰(例如上轮的橙色、绿色中位置 1 的那几个),把本轮新生成的 token 补进窗口。这套滚动窗口机制让 Lookahead Decoding 每一步都能产出 个长度为 的全新候选 n-gram——与纯 Jacobi 只产生若干 2-gram 相比,候选数量与质量同时提升。
N-gram 池与身份判定
Lookahead Decoding 引入一个池来缓存沿轨迹收集到的 n-gram 候选。不是所有候选都值得验证,论文采用一个极简而重要的判定条件:只有首 token 与当前序列最后一个生成 token 完全一致的 n-gram 才进入验证。这一条件有两个好处:
- 过滤掉大多数无效候选,避免把验证开销耗在毫无希望的候选上;
- 保证候选与当前上下文首尾相接,即这条 n-gram 的前缀就是已生成序列的尾部,可以直接拼上去做验证。
这与 Prompt Lookup Decoding 一类的纯查表方法在机制上等价,但查的表不一样:查表法在 prompt 里找匹配,Lookahead 查的是”模型自身迭代轨迹”攒出来的表。站里已有多篇文章讨论 KV 缓存的复用与淘汰策略,如 RadixAttention、前缀缓存淘汰,读者可对照体会”缓存什么、以什么粒度查缓存”在设计空间中的位置。
验证分支:输出分布不变性
Lookahead 分支产出的候选是不连续的(disjoint)n-gram(不同分支之间没有 token 级依赖),不是 SpecInfer 那种树状结构,没法直接套树验证。Lookahead Decoding 的做法是:把所有通过首 token 过滤的候选 n-gram 拼接到当前序列上,并行执行一次前向,然后逐个位置与候选逐一比对。
以贪心解码为例,验证的判定逻辑与 Speculative Decoding 一致:候选 n-gram 的第 个 token 必须与当前序列拼上该 n-gram 后、在位置 上 LLM 给出的 完全一致。多个候选里最长的命中前缀胜出,其 n-gram 中被命中的部分连同其后的一个”奖励” token 一起并入已生成序列;所有没被采纳的 n-gram 继续留在池中等待下一轮。论文证明了这套机制下 LLM 的输出分布保持不变(附录 B 给出了不连续 n-gram 验证的分布不变性证明)。
采样模式的验证
采样模式下情况更微妙:经典投机解码在拒绝候选时,需要用到”草稿 token 被采样时的原始分布”来做拒绝后的重采样修正。但 n-gram 池是持久缓存,如果每个 token 都要存一份词表大小的分布,内存开销无法接受。
论文的解法非常聪明:验证只关心候选被接受与否,不关心候选当初是怎么被采出来的——不同的草稿侧采样方式只影响接受率,不影响目标分布的正确性。因此可以让 lookahead 分支在产生候选时强制用贪心采样,此时分布退化为 one-hot,只需要记住”选了哪个 token”;验证侧则按 Algorithm 4 的机制做完整的采样式验证。这一设计把草稿侧的候选存储从”每 token 一份词表分布”压缩到”每 token 一个整型 id”,代价只是接受率略降。论文在 CNN/Daily Mail 与 XSum 上实测确认了质量无损:温度 1.0 下 ROUGE 与自回归基线的差异在 0.05 个点以内,同时拿到 1.46 至 1.5 倍加速(表 2)。
Decode、Predict、Verify 一步完成
Lookahead 分支与验证分支合在同一次前向里:lookahead 分支的 token 与验证分支的 n-gram 各自拼接、互相不可见,但都完整参与同一次模型 forward。之所以可行,是因为这整套结构本质上仍是一个带自定义掩码的因果注意力。
论文图 2 对比了两种掩码。图 2(a) 是常规解码器的下三角因果掩码;图 2(b) 是 Lookahead Decoding 的掩码():
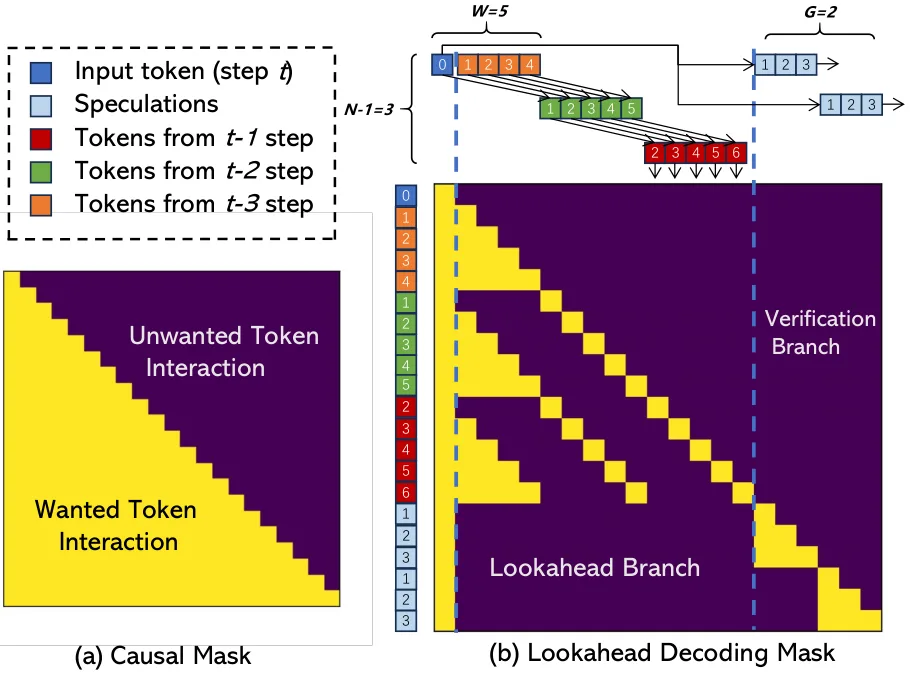
掩码的派生规则只有一条:每个 token 可以看到所有”相对位置编号比自己大”的 token。图 2(b) 中,红色 token 6 可以看到绿色 token 5 与全部橙色 token,但看不到蓝色与绿色中编号更小的。lookahead 分支与验证分支的 token 互相不可见,以保证验证分支”拿到的候选”在验证时不会被 lookahead 分支尚未定型的内容污染。这个掩码就是 Lookahead Decoding 的全部”算法”——机制上它只是一个带自定义掩码的一次前向。
与 FlashAttention 的集成
FlashAttention 强化了 IO 效率,但默认假定下三角因果掩码,与 Lookahead Decoding 的自定义掩码不兼容。论文把 Lookahead Decoding 的 attention 模式(由 决定)硬编码进 FlashAttention,实测这带来约 20% 的端到端加速(相比直接在 PyTorch 上实现的朴素版本)。这一集成思路与站内已拆解过的 FlashAttention 系列 一脉相承:先在机制上理解清楚每一步产生什么样的掩码,再去谈 kernel 层面的融合与加速。
Lookahead Parallelism:多卡并行的新维度
Lookahead 分支里有大量互不依赖的分支链,验证分支里多个候选 n-gram 的验证也彼此独立——这些独立性可以换算成多卡并行度:
- lookahead 分支:把互不交互的分支链放到不同 GPU 上,各卡独立前向,不需要通信;
- 验证分支:把候选 n-gram 的验证分给不同卡,候选之间独立,同样零通信。
论文图 3 展示了把图 2(b) 的工作负载切给 4 张 GPU 的方案:
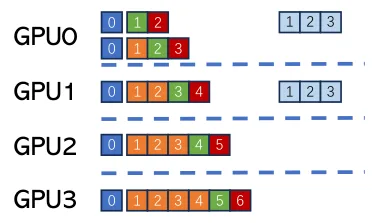
代价是:部分 token(如橙色 0,1,2,3 与输入 token 0)会在多卡上冗余计算,好处是每次前向的通信量几乎为零,只需在每次前向结束后同步各卡产出的 token。论文把这称为 lookahead parallelism(LP):它不做权重分片,每卡持有一份完整权重(显存开销更大),换取逐步通信量近似为零,这与 TP/PP 形成了鲜明对比——后两者把通信放在每步解码的关键路径上。
缩放定律:FLOPs 换解码步数
投机解码的收益上限
投机解码的收益有一个经典上界。设草稿 token 平均接受率为 ,每步草稿猜 个 token,则期望接受数为(Leviathan et al. 2023,论文式 (4)):
直觉理解:接受 0 个 token 的概率是 ,接受 个 的概率是 ……这个几何级数有明确的收敛上界 。即使 ,接受的 token 期望不超过 ;同时 增大,草稿成本也在涨。投机解码的接受侧收益封顶了,只能靠增加草稿序列数 突破:
当 时退化为上面的几何级数形式。注意 会随 指数衰减,所以长草稿的价值快速饱和,增加 (多猜几条)才是长草稿时代的主要杠杆。
Lookahead Decoding 的步数压缩比
Lookahead Decoding 定义步数压缩比 :
它表示”每一步 Lookahead Decoding 摊到几个自回归步”。与投机解码不同,Lookahead Decoding 的候选质量是非平稳的:有时 n-gram 池里有极好的候选,一步接受多个 token;有时池子里没有可用的候选,退化为纯自回归步。论文用一个”平均每 步出现一次好候选”的抽象来桥接两者:(f-1) 步退化为 1 token、1 步平均接受 个 token,得到论文式 (7):
论文用 、 的设定拟合 MT-Bench 上的实验曲线:
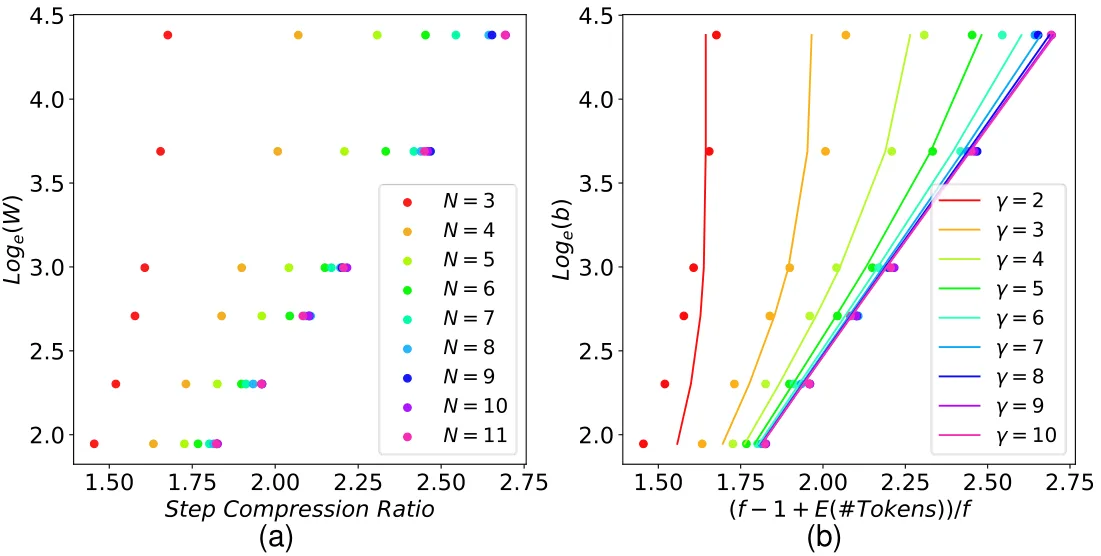
拟合的趋势揭示了这个方法最本质的性质:在 足够大的前提下,解码步数随每步 FLOPs 的对数线性下降。原因在于每步 FLOPs 大约正比于每步输入 token 数,即 ;而收益()随 线性增长(见式 (5), 在求和项里以指数形式抑制失败概率)。这就是论文标题里”用每步 换解码步数”的含义——相比投机解码的”接受侧饱和”,LP 下的 Lookahead Decoding 没有这条饱和界,可以继续用 FLOPs 换收敛步数,多卡强扩展也由此成立。
实验:数字、参数与消融
实验设置
论文用 LLaMA-2(7B/13B/70B)与 CodeLlama(7B/13B/34B)两族模型,全部 FP16、batch size 1。两套测试平台:
- S1:单卡 A100-80GB(7B/13B/34B 单卡,70B 用 Accelerate 跑 2 卡流水线并行);
- S2:DGX 8 卡 A100-40GB,NVLink 互联,用来看 LP 并行表现。
数据集覆盖对话(MT-Bench)、数学(GSM8K 前 1k)、代码补全(HumanEval)、指令生成代码(MBPP)、类级代码生成(ClassEval),采样验证用 CNN/Daily Mail 与 XSum 摘要任务。基线是 HuggingFace 的贪心搜索实现,以及 FlashAttention 版自回归;分布式基线为 DeepSpeed 的 TP 与 Accelerate 的 PP。
端到端性能
单卡(S1,无 FlashAttention):相比 HF 贪心搜索,Lookahead Decoding 在各数据集上取得 1.5x–2.3x 加速。两个明显规律:
- 代码任务收益最高(如 HumanEval 2.3x):代码里有大量重复片段,n-gram 池的命中率显著更高;
- 小模型收益更高:大模型每步 FLOPs 更大,同样 设定下更容易撞上算力上限,「FLOPs 换步数」的杠杆就变小了。
LP + FlashAttention(S2,7B/13B):FlashAttention 集成让 PyTorch 参考实现再快 20%;对比开启 FlashAttention 的自回归(1.07x),单卡 Lookahead Decoding 在 MT-Bench 达 1.9x、论文摘要中的 1.8x 即接近此口径。强扩展场景下,TP/PP 在 batch=1 下反而变慢(0.75x–0.82x),而 LP 把 4 卡算力换成了步数压缩,在 ClassEval 上拿到 4x 加速。
质量与采样验证
表 2 的摘要任务结果显示:温度 0.0 与 1.0 下,ROUGE-1/2/L 与自回归基线几乎完全一致(差异在 ±0.05 个点内),同时拿到 1.46x–1.60x 加速、压缩比 达 1.64x–1.77x。这验证了两件事:贪心与采样模式的验证机制都保持了输出分布;采样模式的接受率下降使加速比贪心模式略低,与投机解码领域的既有结论一致。
消融:两个分支哪个都不能少
表 3 的消融实验(MT-Bench、A100、开启 FlashAttention)把 的作用拆得很清楚:
| 配置 | (N, W, G) | 用 prompt 建池 | 加速比 | 压缩比 S |
|---|---|---|---|---|
| ① | 自回归 | ✗ | 1.00x | 1.00 |
| ② | Prompt Lookup | ✓ | 1.44x | 1.55 |
| ③ | (10, 1, 3) | ✓ | 1.36x | 1.45 |
| ④ | (5, 1, 10) | ✓ | 1.36x | 1.51 |
| ⑤ | (5, 1, 30) | ✗ | 1.04x | 1.12 |
| ⑥ | (5, 1, 30) | ✓ | 1.46x | 1.59 |
| ⑦ | (5, 30, 1) | ✗ | 1.61x | 1.79 |
| ⑧ | (5, 15, 15) | ✗ | 1.78x | 1.96 |
| ⑨ | (5, 15, 15) | ✓ | 1.88x | 2.05 |
三个关键结论:
- 纯验证分支不够(③④⑥,):只靠 prompt/池查找而 lookahead 萎缩成单点,加速比卡在 1.36x–1.46x;无 prompt 建池时甚至只有 1.04x。这说明 n-gram 池的候选需要 lookahead 分支的持续补给,否则快耗尽。
- 纯 lookahead 分支也不够(⑦,):大 没有验证分支配合,候选接受量不足,1.61x 低于均衡配置。
- 均衡配置最好(⑧⑨): 的对称设定拿到最高加速,且用 prompt 建 n-gram 池还能再涨(1.78x → 1.88x)。论文已经把这个增强集成进官方实现。
参数怎么选
论文给出的 A100 上 batch=1 的近优配置为():
| 模型 | Window Size W | N-gram size N |
|---|---|---|
| 7B | 15 | 5 |
| 13B | 10 | 5 |
| 34B | 7 | 5 |
规律很直观:模型越大, 越要调小。7B 模型 时每步的输入 token 数为 ,相当于比自回归多 120 倍 FLOPs;13B、34B 分别是 80 倍与 56 倍。这些”浪费”的 FLOPs 只有在算力过剩时才是免费的,模型越大算力越紧张,就要把窗口收小,让额外计算落在 GPU 算力上限以内。
工程实现:从算法到可用的库
论文配套的官方实现以 lade 为包名发布在 hao-ai-lab/LookaheadDecoding,接口刻意做了最小侵入:pip install lade 后,在调用 config_lade 时设置三个核心参数即可。参数命名与论文记号的对应关系为:
# 论文里的 (N, W, G) 在 lade 里分别对应:lade.config_lade( LEVEL=5, # N:n-gram 长度,即回看轨迹的深度 WINDOW_SIZE=7, # W:lookahead 窗口宽度 GUESS_SET_SIZE=7, # G:验证分支并行验证的候选上限 DEBUG=0,)有三个实现细节能直接回答”为什么它落地没遇到想象中的阻力”。其一,lookahead 分支的重排 token 延续了 Jacobi 迭代里”未来位置填充猜测”的语义,KV Cache 不需要任何特殊结构——每个位置就是一条正常的键值对,窗口滚动只是淘汰旧键值对、写入新键值对,与站内拆解过的 PagedAttention 分块管理天然兼容。其二,transformers 的 generate() 被整体接管,用户代码几乎不用改。其三,它的自定义 FlashAttention kernel 需要对每个模型单独适配,官方文档明确说「lookahead decoding requires an adaptation for each specific model」,这是把自定义掩码塞进生产级 attention kernel 的代价,也是它当时只首发支持 LLaMA 系列的原因。
局限与工程边界
额外计算是核心代价
Lookahead Decoding 的本质是「用 FLOPs 换解码步数」,只适合算力过剩的场景:
- 单请求解码是它的主场——解码阶段的算力利用率极低,大量 FLOPs 闲置,把它们换成步数压缩是”免费午餐”;
- 大 batch 服务是它的雷区——batch 增大后 GPU 逐渐进入 compute-bound 区,再加 倍的 FLOPs 只会让每步变慢,加速变负;
- 低算力硬件同样吃亏:论文在 RTX 3090 上的实测显示,同样的 配置下加速明显低于 A100;不过在算力紧张时小步收缩窗口仍能拿到 30%–50% 的免费加速。
收益递减
从缩放定律看,步数压缩是 的:每翻一倍 FLOPs,只能换来恒定增量的步数减少。 的配置在 A100 上已接近收益曲线的平缓段,继续加大窗口性价比迅速下降。
与 KV Cache 优化的叠加问题
Lookahead Decoding 每步要处理 个输入 token,KV Cache 的写入量与读取量都相应放大。它与 MLA、KV Cache 量化、分页管理等”压缩 KV”路线处于不同的优化轴上,一个压 KV 容量与带宽,一个用闲置算力换步数,理论上可以叠加,但叠加后的掩码与 FlashAttention kernel 的工程整合并不平凡。这也解释了论文为何要”硬编码”自己的注意力模式进 FlashAttention。
小结
Lookahead Decoding 的核心贡献是三条:
- 视角转变:把自回归解码写成非线性方程组,用 Jacobi 不动点迭代并行求解,串行性不再来自问题的结构而来自求解方法的选择;
- 候选挖掘:从 Jacobi 迭代轨迹的 2D 滚动窗口中持续产出 n-gram 候选,配合一个按”首 token 匹配”过滤的池与严格验证分支,做到了不改变输出分布的无损加速;
- 缩放定律:解码步数随每步 FLOPs 的对数线性下降,且在 lookahead parallelism 下能扩展到多卡,绕过了经典投机解码”接受侧收益封顶”的边界。
它的适用边界同样清晰:算力过剩的单请求解码是主场,大 batch 服务会负优化。这与站内多篇文章形成互补:EAGLE 系列与 Medusa 用额外参数换更高的接受率、适合 batch 服务;Lookahead Decoding 用闲置算力换步数、适合低延迟场景;而 SGLang 源码系列的调度与内存管理层,正是这类解码算法落地时必须协同的底座。下一篇若继续这个方向,可以拆解 Jacobi 迭代在连续批处理与推理服务引擎(如 vLLM/SGLang)中的调度适配问题。
参考资料
- Break the Sequential Dependency of LLM Inference Using Lookahead Decoding(arXiv:2402.02057,ICML 2024)
- Lookahead Decoding 官方代码仓库(hao-ai-lab/LookaheadDecoding)
- LMSYS 官方博客:Break the Sequential Dependency of LLM Inference Using Lookahead Decoding
- Fast Inference from Transformers via Speculative Decoding(arXiv:2211.17192,ICML 2023)
- Accelerating Transformer Inference for Translation via Parallel Decoding(Jacobi 解码,arXiv:2305.10427)
- Accelerating Feedforward Computation via Parallel Nonlinear Equation Solving(Jacobi 迭代解并行的先驱,ICLR 2021)
- SpecInfer: Accelerating Generative Large Language Model Serving with Tree-based Speculative Inference and Verification(arXiv:2305.09781)
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads(arXiv:2401.10774)
- REST: Retrieval-Based Speculative Decoding(arXiv:2311.08252)
- Prompt Lookup Decoding(GitHub 仓库)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



