


HeteroReason 完全拆解:草稿模型搬上 FPGA,推理步骤级投机解码如何把回溯损失补回来
推理模型(Large Reasoning Model,LRM)把一道题拆成几十个甚至上百个中间步骤,逐步往下写,回答才慢慢浮出来。相比普通对话模型,它的输出长度天然更长,解码步数更多,而且每一步都依赖上一步——这种串行结构是延迟的来源,也是所有投机类加速方法在推理模型上遇到的第一道墙。
步骤级投机推理(speculative reasoning)是这条线上进展最快的一类方案:用一个小草稿模型抢先写出下一步,再让过程奖励模型(Process Reward Model,PRM)给这一步打分,分数够高就接受,不够高就换成大目标模型重写。它把”验证”从逐 token 概率匹配放宽到了”语义上大概对就行”,在推理任务上的收益很可观。
但这条路有一个默认前提:草稿、验证、精修都在同一块 GPU 上按顺序执行。2026 年 9 月,Zehuan Zhang、Quan Deng、Zibo Ren 等作者在 arXiv 上发表了 HeteroReason(arXiv:2609.28717),把这一前提拆开了:草稿模型放到 FPGA 上跑,PRM 和目标模型留在 GPU 上,同时在算法上加入了”回溯”能力。它不是单纯做一次硬件移植,而是把算法层的健壮性问题和硬件层的利用率问题放在同一个设计空间里去解。
本文沿着论文的动机、算法、工作流、调度和 FPGA 内部结构逐层展开,重点讲清楚三个问题:为什么草稿模型适合搬到 FPGA、回溯为什么必须靠硬件同步机制才划算、提前一步调度到底把哪一段空闲时间吃掉了。
一、背景:步骤级投机推理到底在做什么
1.1 推理模型的解码瓶颈
推理模型和有明确结构输出的普通 LLM 在推理流程上并没有本质区别:都还是自回归逐 token 生成,都受 KV 缓存长度增长带来的解码延迟影响。区别在于,推理模型的思维链(Chain-of-Thought,CoT)动辄上千 token,而这些 token 是串行生成的,每一步的注意力都要读完整的历史 KV。解码阶段本身是显存带宽受限的——每生成一个 token,都要把全部权重和 KV 缓存读一遍——因此输出越长,总延迟的线性增长越明显。
对这种”长输出、串行依赖”的工作负载,业界已经有一类成熟的做法:token 级投机解码。小模型先草拟 k 个 token,大模型一次并行验证,接受率高的部分直接采用。HeteroReason 论文所依赖的 RSD(Reward-Guided Speculative Decoding,Liao 等人 2025 年,arXiv:2501.19324)把这一思路搬到了步骤粒度上。
1.2 从 token 级到步骤级的语义
投机解码对验证的要求严格:草稿 token 必须和目标的采样分布一致,否则要通过拒绝采样修正。步骤级投机推理则放松了这个要求。推理模型的中间步骤本质上是一段推理过程,只要能推导出同样的结论,措辞不同并不影响最终答案。SpecReason(R. Pan 等人 2025 年,arXiv:2504.07891)和 RSD 都利用了这种语义容差:草稿模型写出一个候选步骤,PRM 只需要给出一个表示”这一步过得去”的奖励分数,而不是逐 token 比对。
RSD 的流程可以用一个记号化算法描述。设题目为 ,第 步的候选为 ,PRM 给出的奖励为 ,其中上下文 。如果 超过阈值 ,候选被接受;否则调用目标模型重写这一步。整个过程严格单向前进。
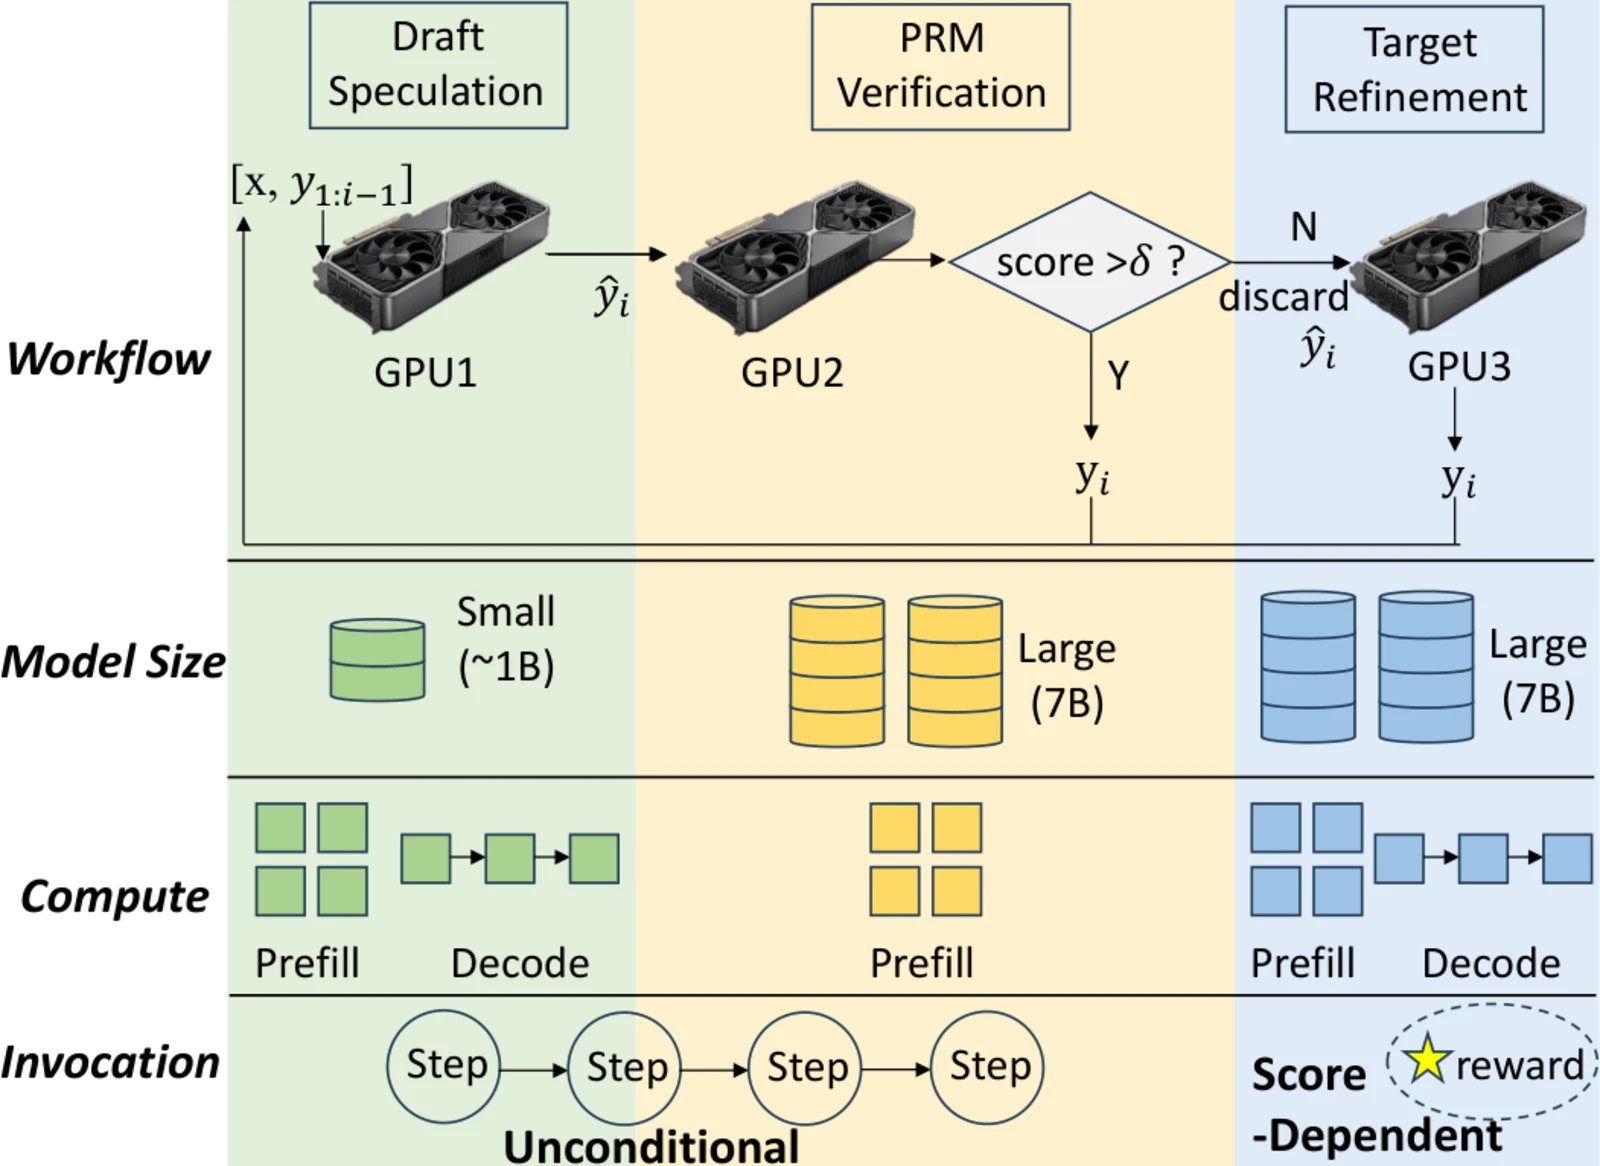
上图是论文图 2:左侧画的是 RSD 的串行流程——草稿模型写一步,PRM 打分,必要时目标模型精修,然后进入下一步;右侧是把单步延迟拆到三个模型上的占比统计。可以看到草稿模型(参数规模只有约 1B)并不是成本大头,却占了 34.6%–55.4% 的单步延迟,原因是它每一步都要被无条件调用,而且每次调用既要预填充(把新上下文 z_i 编入 KV)又要自回归解码。PRM 只占 16.1%–22.2%,因为它只需要一次并行前向就能给整段候选打分。目标模型是否调用取决于奖励分数,但一旦调用,它的参数体量和预填充成本就使得延迟占比达到 22.4%–47.5%。
这个延迟分布是 HeteroReason 全部设计动机的源头:草稿端调用最频繁、单次计算最轻,却是延迟大户;验证端计算最重但并行度最高;精修端调用频率低但单次最贵。三者的计算模式完全不同,把它们压在同一个硬件平台上,必然有人闲着。
1.3 RSD 的默认硬件假设
RSD 和 SpecReason 的实验配置通常是多 GPU:草稿模型占一张卡,PRM 占一张卡,目标模型占一张卡。这种”一模型一卡”的分配在吞吐上没问题,但在单请求、batch size 为 1 的交互场景下,三张卡都不是满负荷:草稿模型解码时 GPU 的算力单元大量空闲,只受显存带宽约束;PRM 验证时只做一次前向,紧接着就要等待草稿模型下一步的产出;目标模型则大部分时间处在空闲状态,等着 PRM 的判决。
论文把这种状态概括为两个层面的不匹配:
- 负载不对称:草稿端是内存密集的串行解码,验证端是计算密集的并行前向,精修端是低频但高参数量的大模型前向。“一张卡同时扛三种负载”意味着每种负载都要按峰值资源来配,利用率必然低。
- 设备间空闲:串行流程下,GPU 等待 FPGA(或另一张 GPU)产出草稿,草稿端又等待 GPU 回传判决,两边的 bubble 加在一起就是每步总延迟。
二、核心动机:为什么草稿模型能放到 FPGA
异构设计的第一步是确定谁搬到哪。HeteroReason 的选择是草稿模型上 FPGA、PRM 和目标模型留 GPU。这个选择背后有三条支撑理由,论文在 II-C 节逐条展开,值得单独拆开讲,因为它决定了整套系统能不能成立。
2.1 草稿模型是内存瓶颈型负载
草稿模型只有 0.5B–1B 级别的参数量(论文实验中用的是 Qwen2.5-Math-Instruct 0.5B 系列),解码时每生成一个 token 都要把全部权重读一遍。以 W8A8 量化计,1B 参数约为 1 GB,权重加动态 KV 缓存可以完整装进 FPGA 的板载 HBM(U280 有 8 GB HBM2,V80 有 32 GB HBM2e)。这意味着解码不需要访问主机内存,也不需要为权重反复换入换出。
FPGA 的峰值算力(U280 约 8 TFLOPS 量级 FP32)远低于 3090 的 35.6 TFLOPS,但解码负载根本不看峰值算力,看的是”能不能把权重持续不断地从 HBM 喂进计算单元”。一个全流式结构、不为中间激活分配额外缓存的自定义数据流,恰好能把每条访存的延迟隐藏起来,而 GPU 的 SIMT 执行模型在这种极低并行度(batch=1,每步只生成一个 token)的解码上反而很难占满计算单元。
2.2 验证负载必须留在 GPU
PRM 验证一段候选步骤,本质上是一次长度等于候选步骤 token 数的并行前向:所有位置同时计算,算力利用率高。这类负载是 GPU 的主场。目标模型精修同理,而且它的调用频率低,对延迟不如草稿端敏感,放在 GPU 上可以和其他请求共享资源。
异构分工因此可以写成一句话:把最”不并行”的负载搬到最擅长隐藏访存延迟、功耗最低的平台上,把最”并行”的负载留给算力最强的平台。
2.3 步骤粒度让通信成本可以忽略
异构系统最容易被人质疑的一点是 PCIe 通信开销:每一步都要在 FPGA 和 GPU 之间交换数据,会不会得不偿失?
论文给出的论据是粒度问题。如果一个系统按 token 粒度同步,每个 token 都要走一趟 PCIe,那么上千 token 的推理会产生上千次往返,通信开销会吃掉大部分收益。但步骤级投机推理每次交换的是一个完整步骤的 token 序列——典型配置下每步不到 200 个 token——而且交换的是 token 而不是整个 KV 缓存。以 PCIe 带宽折算,单步 token 序列的传输延迟在微秒级。
论文的实测也印证了这一点:在所有配置和数据集上,最大通信延迟只占端到端延迟的 0.0123%。这个数字非常关键,它说明异构拆分在这个工作负载上不是”用通信换算力”的赌博,而是几乎零成本的资源重分配。
三、算法层:回溯机制与”单向前进”的健壮性问题
3.1 单向前进的失效模式

论文图 3 揭示的问题很直接:步骤级投机推理只在 PRM 分数过低时才调用目标模型,但如果目标模型精修后的步骤分数仍然过低呢?原始 RSD 流程没有第三种选择——它只能把这个低质量步骤强行写入推理链,然后继续往下走。
推理步骤之间存在强依赖:第 5 步的结论会成为第 6 步的前提。一个低质量步骤一旦被写入上下文,后续每一步都在错误的逻辑基础上展开,错误会沿推理链传播,最终答案大概率错误。草稿模型本身参数小、又经过量化近似,本来就难以在所有难度上保证输出质量;当它和容量有限的目标模型同时”失手”时,单向前进没有任何止损手段。
论文特别指出,这种失效模式在目标模型较小时更严重。实验配置 2 用 1.5B 的目标模型,容量不足以可靠修正草稿模型的错误,单向前进下”被迫接受精修失败结果”的概率明显更高。后文精度实验的结果和这个判断完全对应。
3.2 回溯的设计:锚点、窗口与尝试上限
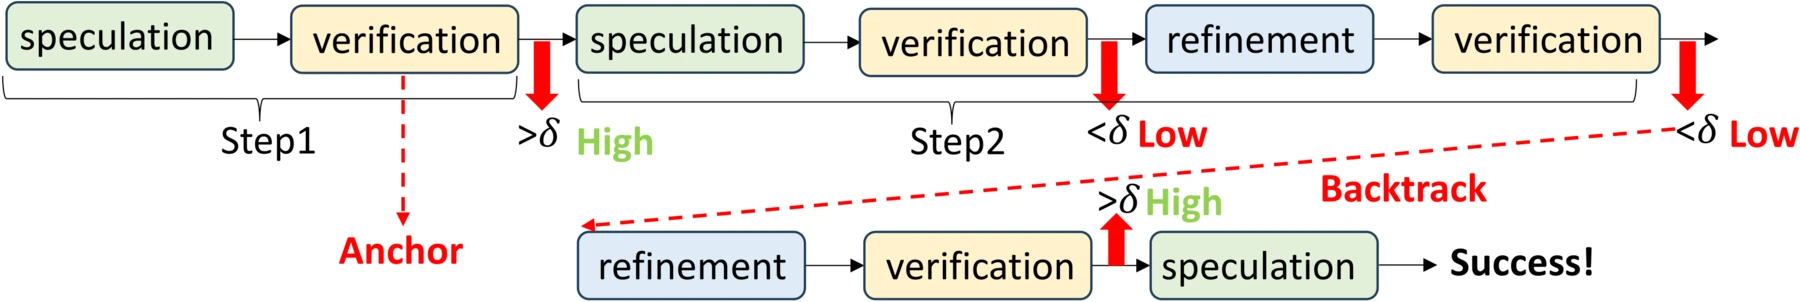
回溯机制(Backtracking-Enhanced Reasoning,论文中简称 BRSD)要解决的就是”低质量步骤已经被写进上下文”的问题。它的思路不是继续修当前这一步,而是退回更早的某个位置,从那里重新展开推理。
三个设计点值得逐一说清:
触发条件:回溯只在草稿模型和目标模型同时产出低奖励步骤时激活。这个门槛保证了回溯不会在日常路径上频繁触发——只有在当前上下文被判定为”根本性有问题”时才付出回溯的代价。
锚点选择:回溯不是随便退一步。系统沿推理历史向前遍历,只接受”当时由草稿模型投机产出且未经目标模型介入就被 PRM 接受”的步骤作为锚点。这类步骤代表了 PRM 认为高质量、草稿端能独立产出的状态,从这些位置重新展开最有可能走出新的推理路径。如果退回到一个曾经被目标模型修过的位置,很可能只是重复同一条失败轨迹。
回溯窗口与次数上限:锚点在失败步骤之前的 步范围内查找(论文举例 、)。如果失败的步骤是 ,选中的锚点是 ,那么从 开始重新生成,整个从 到 的上下文都被丢弃。每次问题的回溯尝试总数被限制在 5 次,在”搜索空间”和”推理延迟”之间权衡。
用一句话概括:回溯把一个只能前进的搜索过程变成了带记忆的有限深度优先搜索,而锚点筛选保证每次回溯都是一次真正不同的尝试。
3.3 为什么回溯在纯 GPU 上是负收益
这里有一个容易被忽略的细节。论文的消融和对比实验显示,3-GPU 基线上加入回溯之后,延迟变成了 RSD 的 0.73×–0.93×(配置 1)和 0.68×–0.93×(配置 2)——变慢了。精度提升了 2 到 5 个百分点,但速度掉下来,这在延迟敏感场景里是不能接受的。
原因在于回溯会额外增加一段上下文重写:草稿模型需要重新预填充回退后的上下文,目标模型需要重新写后续步骤,被丢弃的步骤所对应的计算全部作废。纯 GPU 上每个模型都串行地处理自己的重算,这些开销没有地方可以并行化。
HeteroReason 的立场很清楚:如果想让回溯这种”算法上更健壮但计算更贵”的机制变成本可接受的选项,必须同时在硬件和调度层解耦,让回溯引入的额外计算被隐藏在其他设备的空闲时间里。这就是后文两级设计——影子同步与提前一步调度——的出发点。
四、系统层:预填充-解码解聚与影子同步
4.1 三段式工作流
论文把异构系统的工作流拆成三个相位,在系统总览图(图 5)中可以看到 FPGA 与 GPU 之间通过 PCIe 交换”初始状态、投机序列和反馈”。
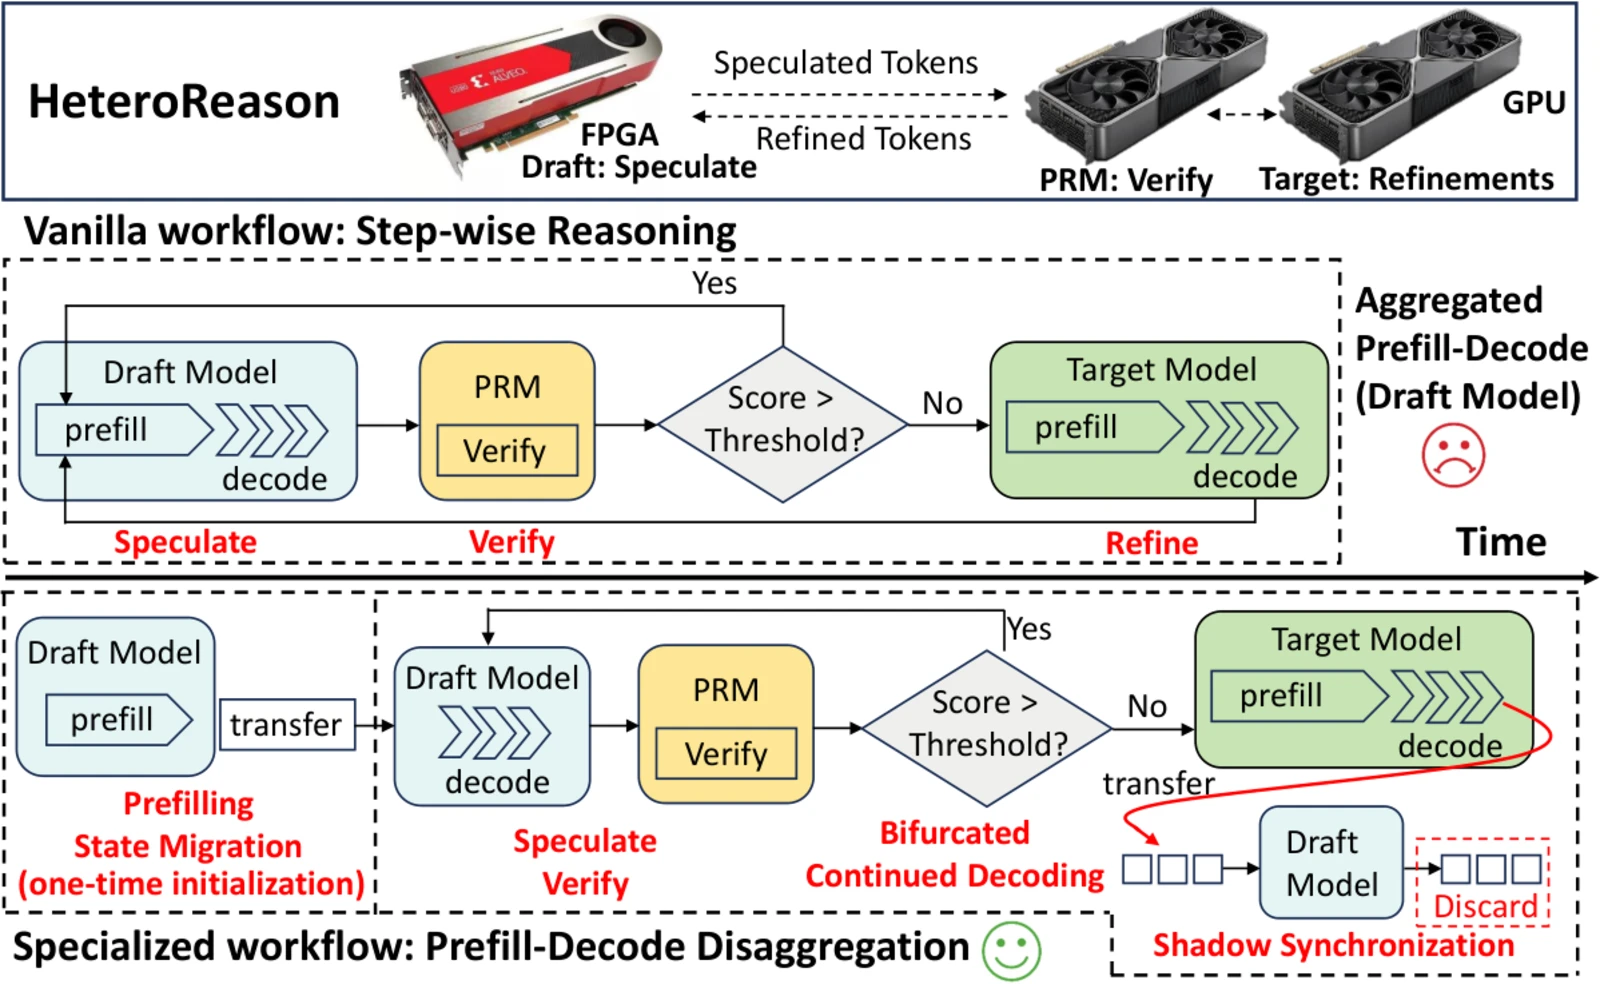
相位一:预填充与状态迁移。 题目的预填充在 GPU 上完成,输出第一个预测 token 和对应的 KV 缓存。接着,草稿模型在 FPGA 侧的初始 KV 缓存从主机内存经 PCIe 传到 FPGA 的 HBM。这一步只为每个推理任务执行一次,相对整个生成过程的数千 token 来说可以忽略。
相位二:投机与验证。 FPGA 用定制数据流持续解码,直到当前一步写完,把投机序列交给 GPU 上的 PRM 做单步并行验证。这一步的核心是:FPGA 只做解码,不做任何预填充。
相位三:分流后的继续解码。 根据 PRM 的判决走两条路:
- 接受路径:FPGA 的 KV 缓存里已经保存了上下文 和新接受 token 的隐状态,可以直接从原位继续下一步 。不需要对已确认前缀重新预填充。这一点是整个系统的关键收益。
- 拒绝路径:投机 token 作废,目标模型在 GPU 上用已确认的上下文 做精修。此时 FPGA 不能直接继续——其 KV 缓存里包含被拒绝 token 对应的无效状态。
如果不加处理,拒绝路径的原始做法是让 FPGA 自己对 做一次本地预填充来刷新 KV。这会重新引入”预填充与解码交织”的问题:FPGA 上的预填充是计算密集的大块计算,和它精心优化过的流式解码完全不同,定制数据流的优势会被抵消。
4.2 影子同步:用 GPU 的精修时间掩护 FPGA 的状态更新
影子同步(shadow synchronization)是这一段的解耦手段,名字来自一个形象的类比:FPGA 的状态更新像影子一样紧贴着 GPU 的精修过程,在不打扰它的前提下完成。
具体做法分三步:
- FPGA 收到拒绝信号后,立即在 KV 缓存管理单元里执行一次指针回滚,把状态退回到最后一个被验证的 token。
- 目标模型在 GPU 上开始自回归生成精修 token,每产出一个 token 就通过 PCIe 流式回传 FPGA。
- FPGA 一边接收这些 token,一边做纯前向计算来更新自己的 KV 缓存,丢弃输出 logits。
第三步之所以能掩盖延迟,是因为草稿模型的前向延迟远低于目标模型。目标模型每生成一个 token 要读几十 GB 的权重,而草稿模型只要读约 1 GB;同一个 token 上,FPGA 的”吸收”速度快得多。只要草稿模型的前向速度高于目标模型的生成速度,GPU 精修完这一步时,FPGA 的状态更新就已经完成,可以立刻进入下一次投机。
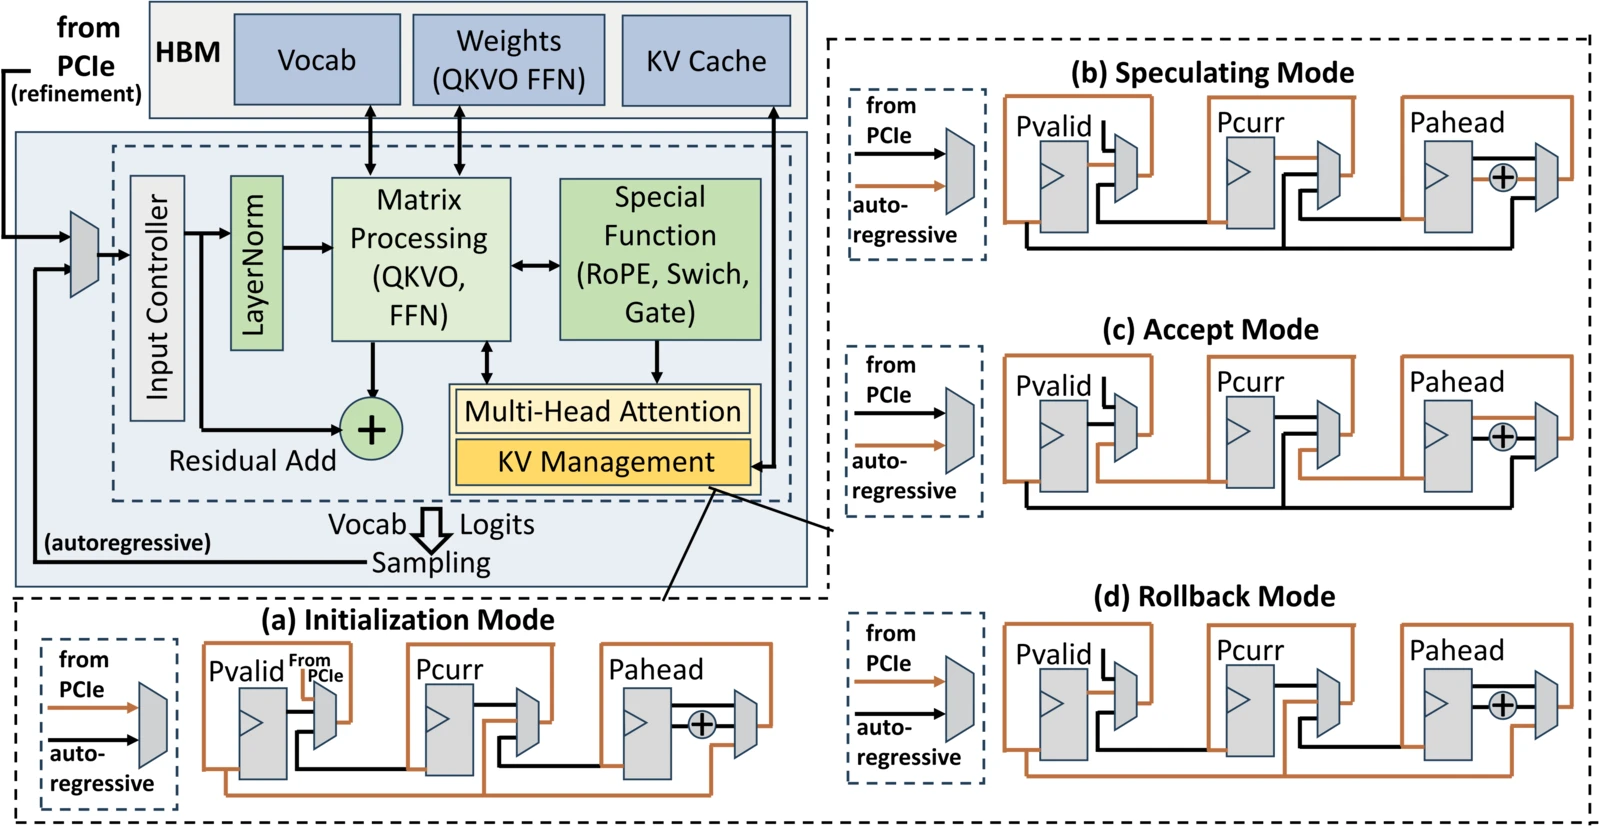
论文图 7 把 FPGA 侧的这一机制画得很完整:加速器是 TAPA 编写的全流式架构,权重和 KV 都在板载 HBM 中,中间激活不需要写回片外内存;KV 缓存管理单元(Key-Value Cache Management Unit,KVMU)用三组指针寄存器跟踪状态:
- 已确认指针():最后一个被 PRM 或目标模型验证过的上下文边界。
- 当前指针():当前正在被验证的步骤的起点。
- 提前指针():提前一步投机所生成的 token 前沿。
KVMU 的四种模式直接对应调度阶段(后文会详细展开):
| 模式 | 触发时机 | 指针变化 |
|---|---|---|
| 初始化 | 系统启动或回溯触发 | 三组指针重置到题目起点或回退位置 |
| 投机 | 正常解码 | 只推进 ,另两组保持不动 |
| 接受 | 收到 Accept 信号 | ,同时 |
| 回滚 | 收到 Reject 信号 | 同时写入 与 |
这四组动作都是单周期级别的状态切换,配合输入多路选择器:投机与接受模式下输入取自本地采样单元,形成内部反馈闭环,不需要经过主机;初始化与回滚模式下输入切到 PCIe 接口,接收目标模型的高质量 token。也就是说,FPGA 从一个错误的投机路径切换到精修路径,只需要改变输入源并回退指针,不需要重启数据流。
4.3 预填充-解码解聚的含义
“预填充-解码解聚”(Prefill-Decode Disaggregation)在注意力优化领域通常指把两类计算模式放到不同的硬件或实例上。HeteroReason 把它用在了草稿模型内部:FPGA 只负责解码阶段,所有预填充工作——无论是初始题目还是拒绝后的上下文吸收——都”外包”给 GPU 或与 GPU 精修重叠。这样 FPGA 的数据流结构可以被专门优化为”每周期读权重、算一个 token”,而不必兼容预填充时的大块矩阵乘。
这也是它与现有 FPGA 投机解码工作的本质差别。论文对比表把 DFVG(Lu 等人 2026 年,ASPLOS)归入”FPGA-GPU、draft-on-FPGA、verify-on-GPU”一类,面向的是 token 级投机解码,其草稿端仍要承担步骤级的本地预填充,两套计算模式压在同一条数据流上,且不感知回溯。HeteroReason 的路线是:FPGA 一侧只保留解码数据流,预填充被交给 GPU 或与 GPU 精修重叠,同时让 KVMU 去承接回溯带来的状态回退。
五、调度层:提前一步投机与精修
5.1 串行依赖还剩多少
影子同步解决了”拒绝后如何恢复”,但没有解决”每一步内仍然要等验证结果”。即使 FPGA 的投机状态更新被隐藏,整个流程仍然是:FPGA 写完一步 → 交给 PRM → 等判决 → 继续下一步。GPU 在等 FPGA,FPGA 在等 GPU,这种互相等待就是 II-D3 节所说的 bubble。
HeteroReason 的第二个机制——提前一步投机与精修(step-ahead speculation and refinement)——把空闲时间利用起来。核心思想是:在 PRM 验证当前步骤的同时,FPGA 和目标模型各自开始为下一步做准备。
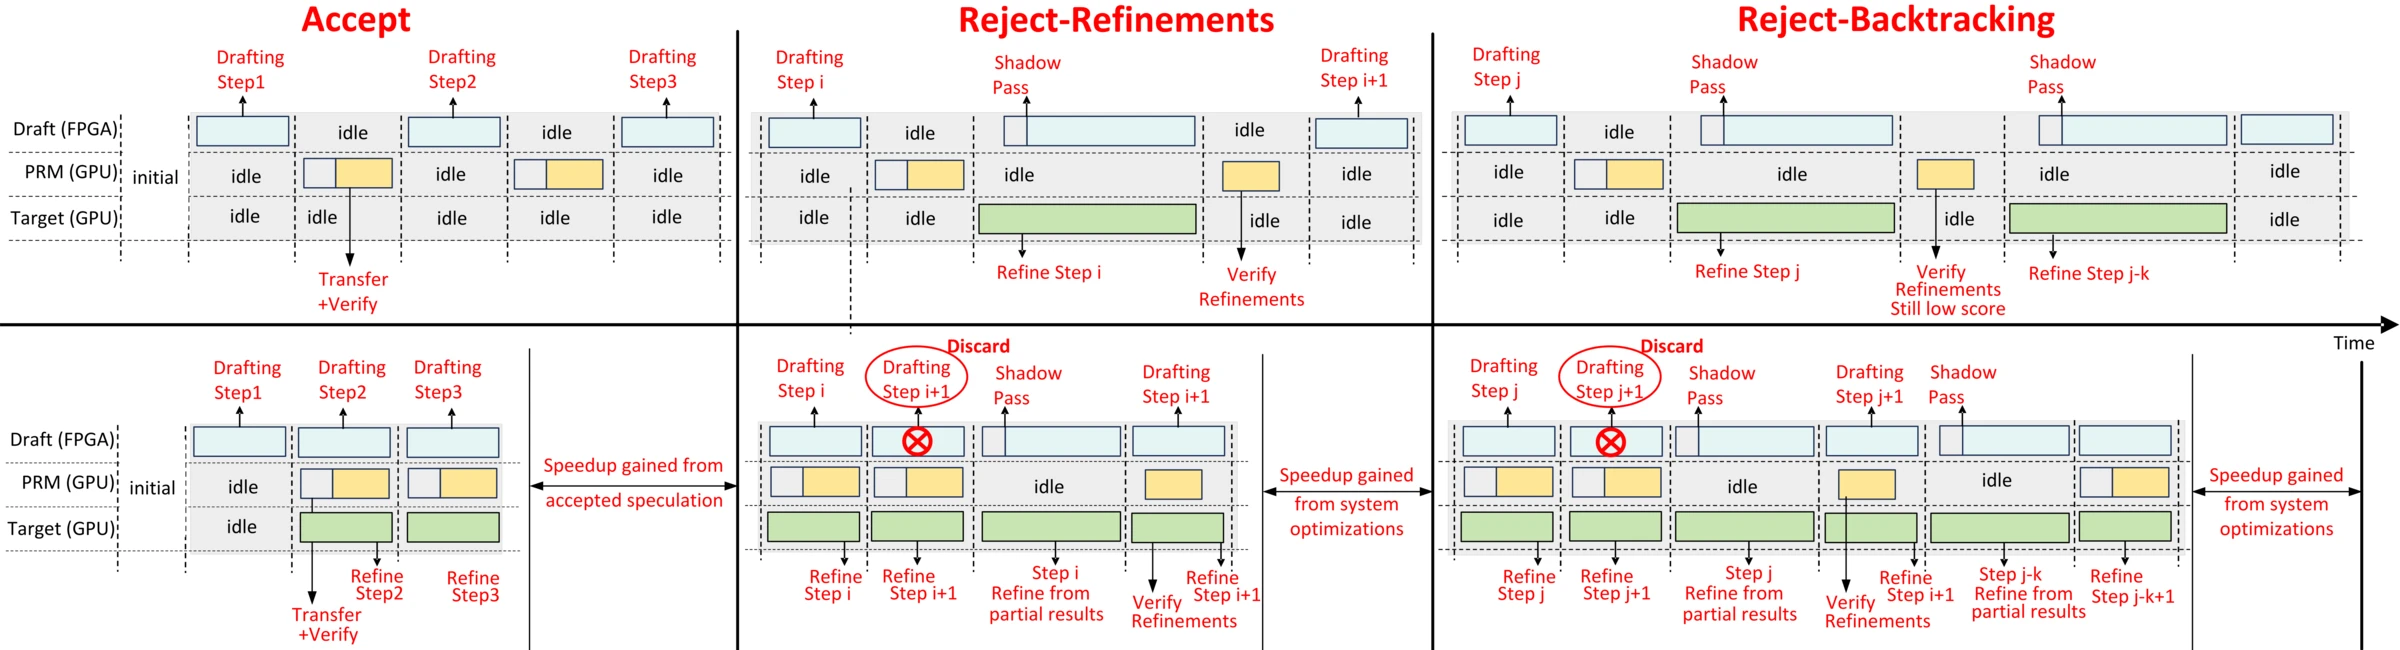
图 6 展示了这条流水线。当前步骤的投机序列交给 PRM 后,FPGA 不待结果返回就继续解码下一步;GPU 上的目标模型也不等判决,直接开始生成下一步的候选精修结果。三个设备的执行在同一时间窗内重叠。
5.2 异步目标预取与缓存
目标模型提前生成有个前提问题:它比草稿模型慢得多,一次完整的精修需要的时间可能超过 PRM 验证加上下一个投机步骤的时间。因此提前执行通常只能生成一部分 token。
这引出了目标端的”异步预取与缓存”策略:目标模型在当前步骤完成后立即启动下一步的生成,而不是等待验证结果。如果提前执行因为当前步骤被接受而中断,已经产出的部分 token(不带 KV 缓存)会被缓存下来。真正的精修或回溯被触发时,如果当前上下文和缓存序列共享公共前缀,系统就复用已经计算过的部分,只从分叉处开始算。
这一步的意义在于让回溯和精修变便宜。前面提到纯 GPU 回溯会让延迟掉到 0.7 倍左右;在 HeteroReason 中,精修路径往往能直接命中预取缓存,回溯后的重写也只从锚点之后的步骤算起。论文的消融结果表明,提前一步调度带来的加速在配置 1 中是 1.25×–1.33×,配置 2 中是 1.35×–1.40×,而且论文强调这一优化”适用于不同平台”,不依赖 FPGA。
5.3 三种判决场景下的流水行为
调度的收益要看它在 PRM 所有可能判决下的表现。论文分了三种场景:
接受场景。 PRM 给出的分数达标。提前一步的投机继续进行,直到下一步投机完成;GPU 上的提前精修也在继续。此时每一步的延迟由”投机时间”和”验证时间”中较长者加通信开销决定——流水线被填满,两个设备同时忙。
拒绝-精修场景。 PRM 给出低分。提前一步产出的投机 token 立即作废,GPU 继续产出精修 token 作为替代,FPGA 则在影子同步下用目标模型的 token 更新 KV。由于草稿模型延迟远低于目标模型,影子同步可以被完全隐藏,FPGA 在下一次迭代前就已经准备就绪。缓存命中让精修本身变快。
拒绝-回溯场景。 精修后的步骤也达不到阈值。回溯机制被激活,退回到之前的锚点;目标模型更新历史状态,FPGA 同步内部 KV。这里同样复用预取缓存,和精修场景一样获得加速。
论文的总结是:这套调度把所有可能的判决分支都用”提前一步”填充了空闲周期,因此不管走哪条路,延迟都有下降。
5.4 代价:多出来的那部分投机计算怎么办
提前一步必然引入”浪费”:当前步骤被拒绝时,提前一步为下一步产出的投机结果要作废,这部分计算白做。论文专门量化了这个”作废 token 的能量开销”。
在配置 1 的 3-GPU 基线上,提前一步预取带来的加速是 1.25×–1.33×,而多出来的能量消耗只有 0.480%–0.719%。论文解释了两点原因:第一,浪费只发生在被拒绝的验证路径上,而这些轨迹的拒绝概率通常低于 30%,大多数预取 token 最终都会被有效推理轨迹复用;第二,预取是可中断的——一旦收到拒绝信号,系统就停止无效的提前执行,避免在推理状态已失效的情况下继续往下生成。
这个数据的意义在于:提前一步调度的经济账是正的。它把大量空闲硬件周期换成了实质性的延迟下降,而代价只是几个百分点的能量。
六、实验:精度、延迟与能耗
6.1 设置
硬件方面使用 AMD U280(16 nm、8 GB HBM2、约 8 TFLOPS FP32、460 GB/s)和 V80(7 nm、32 GB HBM2e、约 58 TFLOPS FP32、820 GB/s)两块 FPGA,GPU 侧是 NVIDIA RTX 3090。FPGA 设计基于 TAPA 框架、W8A8 量化,Vitis HLS 2022.2 综合。
模型使用 Qwen2.5-Math-Instruct 系列,两种配置:0.5B 草稿 + 7B PRM + 7B 目标,以及 0.5B 草稿 + 7B PRM + 1.5B 目标。基线是多 GPU 方案,推理引擎用 vLLM 0.9.2,草稿模型替换为 FPGA 实现。所有实验 batch size 为 1,对应交互场景。PRM 接受阈值和回溯触发阈值都取 0.7,回溯次数上限 5。
评测数据集覆盖难度梯度:Math500、GSM8K、Gaokao2023EN、OlympiadBench。
有一个实现细节需要说明。作者在 U280 上跑 200 MHz 完成了板载测量,并把带宽、延迟等指标推演到 300 MHz 的时钟频率(V80 也用同一方法估算),端到端评估使用的 trace-driven 模拟器同时依据 FPGA 板载实测交叉校验的性能模型和 GPU 侧的真实推理延迟。论文在局限性一栏也明确写了:部分结果来自仿真与板载测量的组合,未来的工作会把它们做成完整的端到端演示系统。读到本文的量化结论时,应当知道这一点。
6.2 精度:回溯的收益在弱目标模型上更明显
| 方法 | Gaokao | GSM8K | MATH500 | Olympiad | 平均 | Δ |
|---|---|---|---|---|---|---|
| 配置 1(0.5B 草稿、7B PRM、7B 目标) | ||||||
| RSD 基线 | 56.9 | 87.3 | 64.8 | 26.5 | 58.8 | – |
| BRSD(加回溯) | 58.4 | 89.5 | 67.0 | 28.6 | 60.8 | +2.0 |
| BRSD + 系统优化 | 57.9 | 89.3 | 67.2 | 27.9 | 60.5 | +1.7 |
| 配置 2(0.5B 草稿、7B PRM、1.5B 目标) | ||||||
| RSD 基线 | 42.9 | 71.3 | 50.2 | 17.0 | 45.3 | – |
| BRSD | 46.0 | 78.0 | 56.8 | 20.7 | 50.3 | +5.0 |
| BRSD + 系统优化 | 45.2 | 78.6 | 54.8 | 19.7 | 49.5 | +4.2 |
配置 1 中,回溯本身带来 +2.0,加上系统级优化后仍有 +1.7——说明异步预取和缓存带来的调度变化只损失了 0.8% 以内的精度。配置 2 中回溯带来 +5.0,完整系统仍保留 +4.2。论文对差距的解释正是第三节的分析:目标模型容量有限时,单向前进被迫接受低质量精修的概率更高,回溯的止损价值更大。换句话说,目标模型的容量越小,回溯机制越是不可替代的,这也让”FPGA + 小目标模型”这种追求低成本部署的组合更可行。
另外注意差异最大的数据集:配置 2 上 MATH500 从 50.2 提升到 54.8,OlympiadBench 从 17.0 提升到 19.7。难度越高,单向前进的错误传播越致命。
6.3 延迟、goodput 与能效
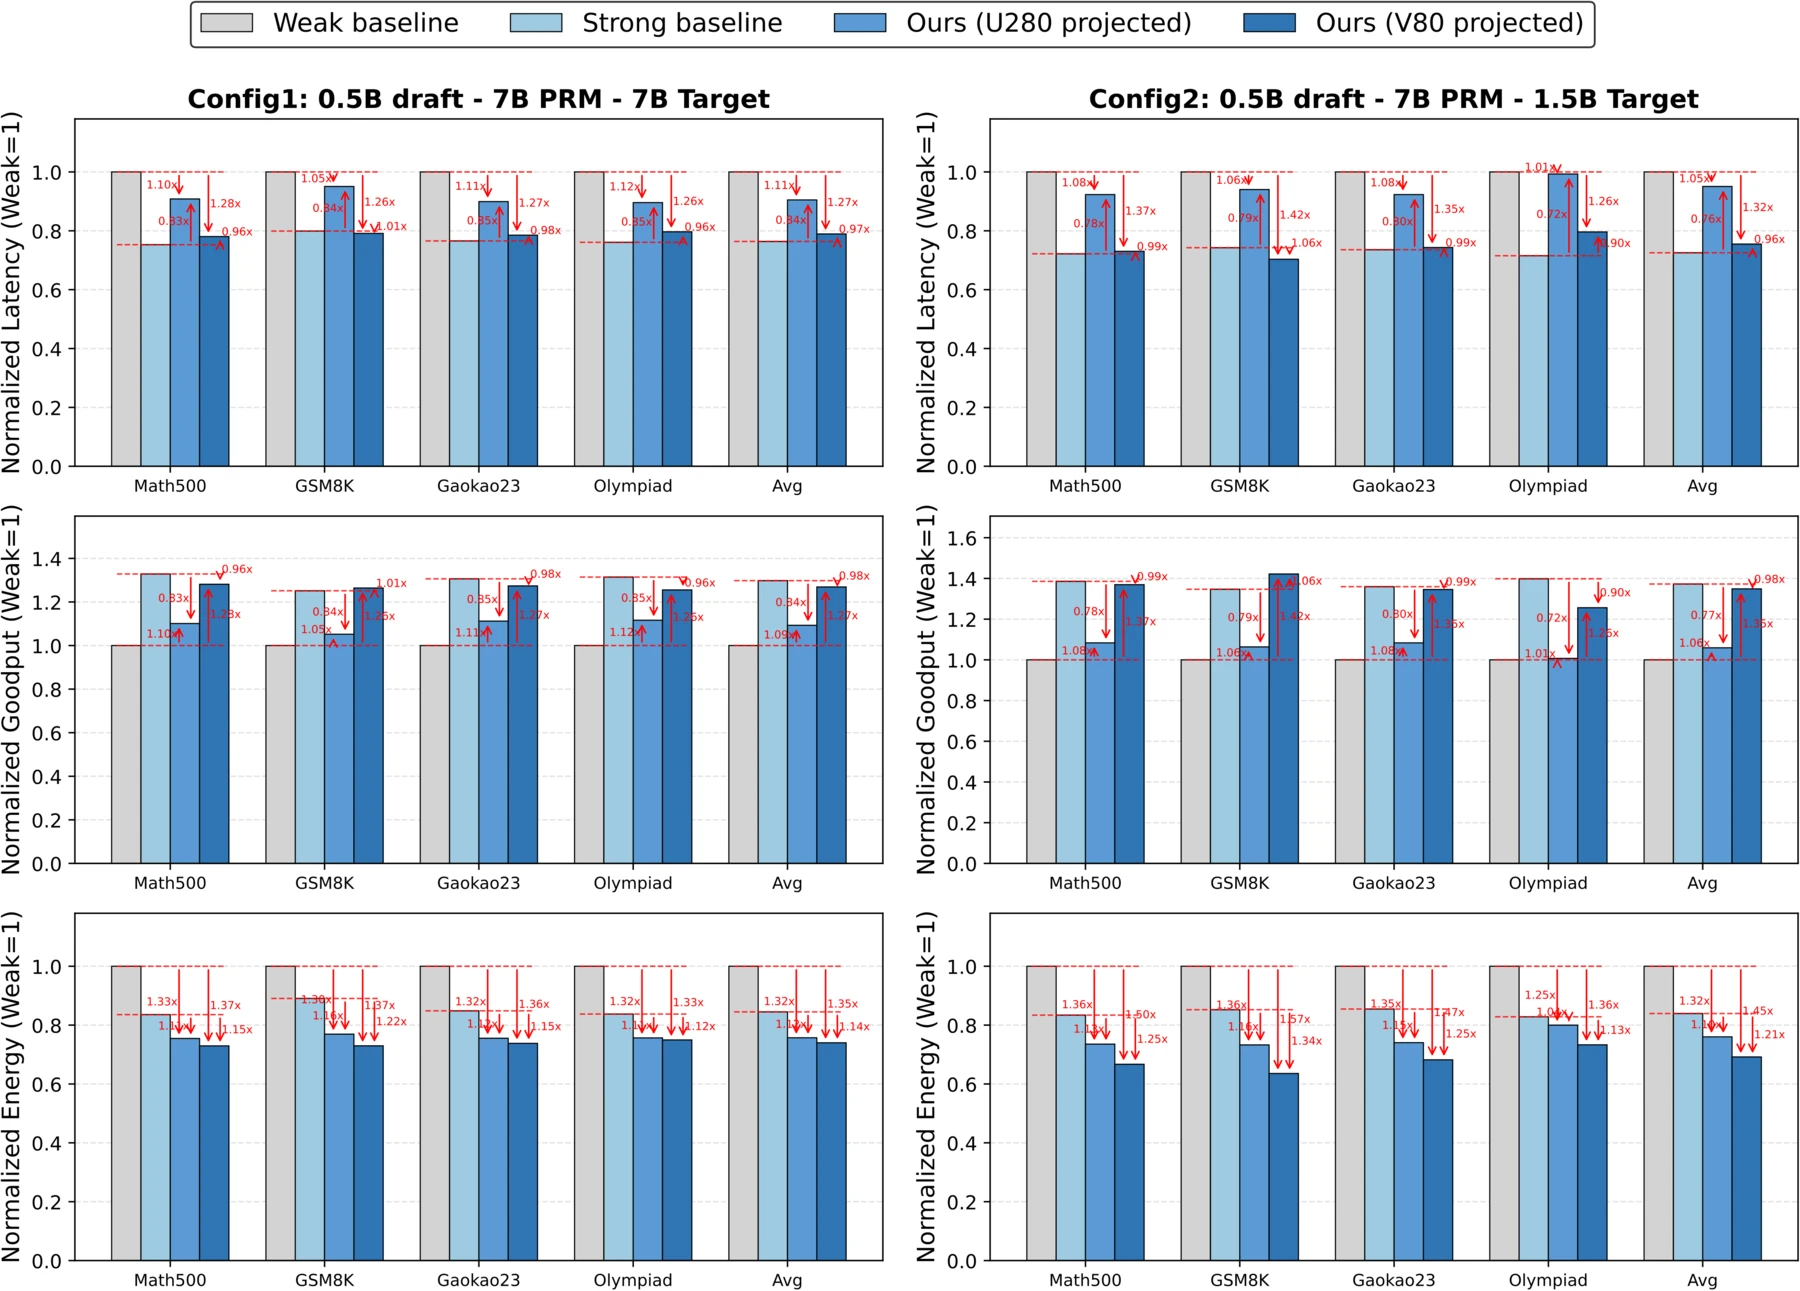
图 8 给出四个数据集上与两类基线的对比。弱基线是加了回溯的原始工作流,强基线在此基础上再加提前一步调度。
- U280 系统相对弱基线延迟降低 1.01×–1.12×,goodput 提升 1.01×–1.12×。
- V80 系统延迟降低 1.26×–1.42×,goodput 提升 1.25×–1.42×,同时端到端延迟与强基线相当。
- 能效方面,HeteroReason 的每 token 能耗比弱基线和强基线分别好约 1.3× 和 1.1×。论文把原因归于 FPGA 的工作功耗显著低于 GPU。
V80 的优势来自它 7 nm 工艺、高得多的 HBM2e 带宽和更大的板载容量,说明草稿端的解码速度直接由板载内存带宽和流式结构决定。V80 上”延迟与强 GPU 基线持平、能效明显更好”的组合很有说服力:异构方案不是拿速度换功耗,而是两头都占。
6.4 消融与通信
论文的消融把优化拆成两层。T2(提前一步调度)单独带来 1.25×–1.33×(配置 1)和 1.35×–1.40×(配置 2)的加速。叠加 T1(FPGA 预填充-解码解聚)之后加速略有下降,但能耗优势仍然存在——这符合预期:把草稿端搬到 FPGA 会损失一点原始速度,换来的是功耗的大幅下降。
通信方面的数据前面已经提过:最大通信延迟只占端到端延迟的 0.0123%。论文同时报告了”投机停顿比例”:FPGA 提前一步投机完成、等待 GPU 验证结果期间的停顿时间占全部步骤的 4.95%–26.57%,平均 17.50%。这个数字说明了调度优化的边界——草稿端越快,越是会先一步完成并停下来等验证,因此相对停顿比例会升高,但端到端延迟仍在下降。
6.5 关于边缘 GPU 与 ASIC 的讨论
论文在 VI-G 节讨论了草稿模型的替代平台,这部分对理解”为什么选 FPGA”很重要。
在 NVIDIA Jetson Orin Nano 上跑 W8A8 草稿模型(Jetson 优化版 PyTorch、源码编译的 vLLM、FlashInfer 注意力后端),解码速度稳定在约 17 token/s,而且不随预填充长度变化。原因是解码本身受显存访问而非算力约束,边 GPU 的 SIMT 并行度和串行 token 生成方式之间存在根本性错配。这个速度甚至低于 RTX 3090 上运行的 7B 目标模型,因此用边 GPU 替换 FPGA 草稿端会使整体系统慢约 5–6 倍。边 GPU 能降低功耗,但不能改善解码阶段的算力利用率。
ASIC 在理论上更合适,但流片成本和周期使得算法-硬件协同设计的迭代无法进行。FPGA 提供了同等程度的硬件定制能力,同时保留可重构性:调整算法往往只需重新生成一个比特流。HeteroReason 因此把自己定位为”面向未来 ASIC 的 FPGA 原型”。
七、工程视角:哪些结论可以直接带走
抛开论文本身的组合方式,这套系统里有几项设计是可以被单独借鉴的。
第一,步骤粒度是异构拆分的甜点。 token 级同步会让 PCIe 成为瓶颈,步骤级同步则让通信几乎免费。任何打算把异构硬件引入投机类推理的方案,都应当先在粒度上做算术:每步交换多少数据、PCIe 带宽多少、单步计算多久。
第二,预填充-解码解聚不只适用于大模型集群。 这里解聚的是”设备内的两种计算模式”,FPGA 只保留解码数据流,让 GPU 或影子同步承担预填充。任何只面向解码优化的加速器都可以考虑同样的思路:不要为了兼容预填充而让自己的数据流变复杂。
第三,算法层引入的额外计算需要调度层去吸收。 回溯在纯 GPU 上是负收益,在异构系统里却变成可接受甚至正收益,靠的是影子同步和预取缓存。算法的健壮性机制和系统的调度机制需要一起设计,单独看任何一层都会得出错误的结论。
第四,指针化 KV 管理是代价极低的状态同步机制。 KVMU 的三组指针和四种模式把”KV 缓存该退到哪里、该信到哪里”变成了几个寄存器的赋值,单周期完成。相比重建缓存或重新预填充,这种轻量级状态管理是投机推理系统里值得推广的模式。
八、局限与仍待回答的问题
论文自己也列出了几点局限。当前实现有一部分实验结果是仿真与板载评估的组合,完整的端到端系统演示是后续工作。方法目前只在数学推理模型上验证,线性注意力模型(如 Mamba 系列)和扩散语言模型上的适用性还没有测试——后者的推理图构建与自回归解码差异很大,提前一步调度的前提(下一步的草稿依赖于当前步骤的上下文但可以提前开始)是否成立需要重新推导。
此外还有一些论文没有展开的工程问题:回溯阈值取 0.7、尝试上限取 5 是沿用 RSD 的设定,没有针对不同数据集调参;单请求、batch size 为 1 的评测场景下 17.50% 的投机停顿比例说明 FPGA 的”快”在有些步骤上反而成为等待来源,若要支持多请求并发,FPGA 的批处理能力、KVMU 的多序列指针管理都需要重新设计;目标模型预取缓存在多请求争用 GPU 时会增加显存占用,缓存淘汰策略没有讨论。
九、小结
HeteroReason 的核心不是”把草稿模型搬到 FPGA”这一单一动作,而是三个层面的联合设计:
- 算法层:回溯机制把严格的单向前进改造成带锚点记忆的有限次重试,在目标模型容量有限时把精度拉回 4–5 个百分点;
- 系统层:FPGA 只做解码、GPU 承担预填充,影子同步让 FPGA 的 KV 状态更新完全隐藏在 GPU 精修过程中;
- 调度层:提前一步投机与精修把串行依赖展开成流水线,用不到 1% 的能量代价换来 25–40% 的延迟下降。
三者相互依赖:没有回溯,异构拆分只是把同样的流程换个设备;没有影子同步,回溯引入的重写会让 FPGA 端停顿;没有提前一步调度,两端的相互等待仍然存在。这套协同设计最终给出的是 1.01×–1.42× 的延迟降低、1.25×–1.57× 的能效提升,并且是在精度不降反升的前提下实现的。
对推理优化和异构系统感兴趣的读者,可以把这篇工作放在两条脉络里看:一条是投机推理从 token 级到步骤级的演进(可参考站内对 EAGLE 特征级草稿 和 Medusa 多头候选 的剖析,理解验证机制的不同形态);另一条是 FPGA 加速 LLM 推理的路线(站内的 FPGA 加速 LLM 推理前沿技术 对 FlightLLM 等映射做了完整拆解)。HeteroReason 正好是两条线交叉的位置:它既有投机解码的验证流水,也有 FPGA 上的定制数据流和 KV 管理。
参考资料
- HeteroReason: Heterogeneous FPGA-GPU Acceleration for Disaggregated Speculative Reasoning(Z. Zhang, Q. Deng, Z. Ren 等,2026)
- Reward-Guided Speculative Decoding for Efficient LLM Reasoning(RSD)(B. Liao 等,2025)
- SpecReason: Fast and Accurate Inference-Time Compute via Speculative Reasoning(R. Pan 等,2025)
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(J. Wei 等,2022)
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning(DeepSeek-AI,2025)
- TAPA: A Scalable Task-Parallel Dataflow Programming Framework for Modern FPGAs(L. Guo 等,2023)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



