


Star Attention 完全拆解(一):锚点块、分块上下文编码与两阶段全局注意力
一个看起来「太简单」的分布式注意力
2024 年 11 月,NVIDIA 的 Shantanu Acharya、Fei Jia 与 Boris Ginsburg 在 arXiv 上首次公开了 Star Attention,该工作后来被 ICML 2025 接收。它的题目很朴素:Star Attention: Efficient LLM Inference over Long Sequences。
绝大多数长上下文分布式方案都在做同一件事:把序列切开,让每块算局部注意力,再想办法把「远处」的信息传过来。Ring Attention 的做法是让每个设备依次接收其他设备传来的 KV,绕环一圈,实现精确的全局注意力,代价是上下文编码阶段要搬运整份 KV。DeepSeek-V3/R1 推理系统 那类专家并行系统则是另一个极端:规模靠 TP/EP 堆,注意力本身仍然是密集全局的。
Star Attention 走了一条更激进的近似路线:上下文阶段完全不通信。每台机器只处理自己那一段上下文,和谁都不交换 KV,也不交换注意力分数。到了查询阶段,才发起一次通信,而且每台机器只需要交出「每个 token 位置一个向量加一个标量」。论文报告的数字是最高 11 倍推理加速,同时保留 97%–100% 的精度。
这听起来简单得有些可疑。分块注意力在长文档任务上的失效方式是众所周知的:块与块之间老死不相往来,模型在块内建立了自己的「开场白」,注意力分布和全局注意力差得很远。真正支撑 Star Attention 的并不是「分块」这个动作,而是分块时额外塞进每一块前面的那一小段「锚点块」。整篇论文最有信息量的部分,恰恰是锚点块这个设计的消融实验——它说明注意力机制对「序列开头」的依赖有多强,以及这种依赖可以被怎样利用。
这篇文章先讲清楚第一阶段和第二阶段各自的机制、公式与实现细节,包括仓库里真实的代码路径与线上实现之间的差距;实验、精度分布与锚点块的消融留到下一篇。
长上下文推理到底贵在哪里
在讲 Star Attention 之前,先把账单列清楚。
Transformer 自注意力在长度为 的序列上是 的计算量,其中 是单头维度。FLOPs 每翻一倍序列长度就要涨四倍,这只是计算;真正先撞墙的是显存与带宽。
解码阶段模型每一步都要读取全部历史 token 的 KV 缓存。以 Llama-3.1 8B 为例:32 层、8 个 KV 头(GQA)、head_dim 128、bf16。每个 token 的 KV 大小是
128K token 就是 16 GB。这还只是单条序列。论文附录里记录了一个很能说明问题的现象:在 8 张 A100(80GB)上跑 Llama-3.1-8B 的原生自回归生成,序列超过 64K 就开始 OOM,128K 根本跑不起来。
分块预填充 + 分页 KV 这类手段能缓解显存压力,但计算量的二次增长无法回避:128K 长度下,一次 prefill 的注意力部分需要算 128K × 128K 的分数矩阵,哪怕用 FlashAttention 的 IO 感知分块,也只是把中间矩阵藏在 SRAM 里,乘法和软硬件访存的总量不变。
于是分布式长上下文有两条主流路径:
- 计算切分,KV 绕环。每台机器持有一段 KV,算出本地部分结果后,把 KV(或其压缩形式)传给下一台。Ring Attention(Liu 等,2024)是代表,RingAttention 的原始论文 通过把 KV 分块与计算重叠,让序列长度随设备数线性扩展。
- 信息压缩,丢弃远端。滑窗注意力、StreamingLLM 的 sink + 窗口、H2O 之类只保留一小部分 KV,读得少、算得少,但信息真的丢了。
Star Attention 不属于这两类中的任何一类。它在上下文阶段丢信息(块之间不可见),在查询阶段又恢复了信息(对全部块做全局注意力)。它既不是精确的全局注意力,也不是简单的稀疏注意力,而是一种 「输入阶段稀疏、输出阶段稠密」的两阶段近似。这个结构决定了它的收益来源与失效边界,后面的所有设计都在为这个结构服务。
时序回顾:一次请求里的两段
在开始拆算法之前,需要把 LLM 推理的两个阶段和 Star Attention 的两个阶段对齐——它们是四件不同的事,容易混淆。
| 维度 | 预填充(prefill) | 解码(decode) |
|---|---|---|
| 计算特征 | 矩阵乘主导,计算密集 | 逐 token 生成,带宽密集 |
| KV 状态 | 一次写入全部 prompt KV | 每个 token 追加一行 |
| 延迟指标 | TTFT(首 token 延迟) | TPOT(每 token 延迟) |
Star Attention 的两个阶段分别是:
- Phase 1:上下文编码(Context Encoding)。对应长 prompt 的 prefill,但被切成块并行执行,且块间无通信。
- Phase 2:查询编码与 token 生成。查询与后续生成的每个 token 都对全局做注意力,这一阶段同时承担首 token 的 prefill 与后续的 decode。
论文明确针对的是「长上下文 + 短查询 + 短答案」这一类负载:输入是一大段文档/代码库/邮件,查询是末尾的一两句问题,输出最多几十上百个 token。这是检索增强、多文档摘要、仓库级代码问答的典型形状。Star Attention 的 Phase 1 规模由上下文长度决定,Phase 2 的规模由查询和生成长度决定;在这类任务里,Phase 1 吞掉了绝大部分工作量,Phase 2 只处理末尾的一小段。
这个负载假设需要被记住:如果查询本身也很长、答案也很长(比如让模型对整篇文档逐段改写),Phase 2 的全局 attention 会重新变贵,两阶段的收益结构会改变。论文没有覆盖这种负载,这一点我们后面还会回到。
问题定义与记号
论文的记号如下:
- 完整的输入序列由上下文 和查询 拼接而成,记作输入 ;
- 上下文被切成 个连续块:,每块 个 token;
- 第一块 被赋予特殊角色,称为锚点块(anchor block);
- 系统有 台主机(host),每台主机持有一段或多段上下文块的 KV;
- 其中一台被指定为查询主机 。
为什么叫 Star Attention?每个上下文块的 KV 都在自己的主机上,而查询像一个中心节点一样与所有主机各连一条边,拓扑形状像星型。这不是一个特别严谨的命名,但它道出了通信模式的关键:只存在查询主机到各上下文主机的星型通信,不存在主机之间的通信。
Phase 1:带锚点块的局部上下文编码
被增广的上下文
Phase 1 要做的第一件事并不是分块,而是构造一个被增广的上下文序列:
从第二块开始,每一块 前面都拼上第一块 的副本,形成长度为 的增广块 (首块本身即 ,长度 )。位置编号的做法是:锚点部分保持它在原序列中的位置编号 ,当前块保持它自己的位置编号 。
也就是说,第 块的增广块在位置维度上「跳」了一次:锚点块用的是序列真正开头的位置,而当前块保持原位。这个设计在论文的消融实验中证明是合适的——锚点内容的语义比它被放在什么位置更重要,详见下一篇。
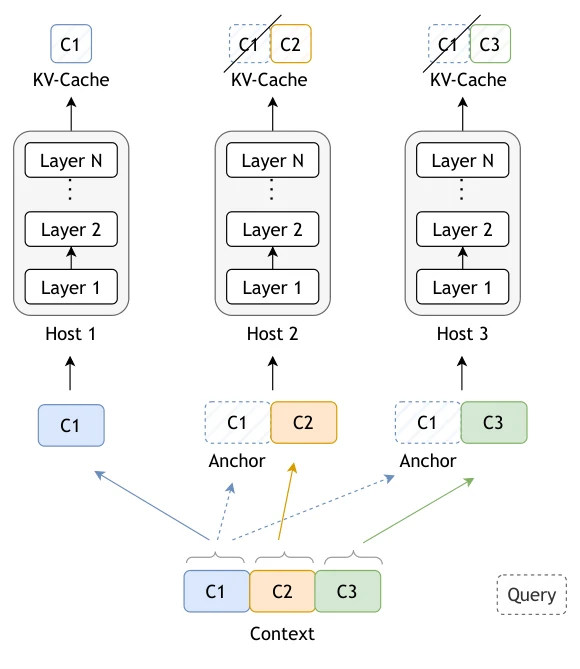
图 1:Star Attention Phase 1 的数据划分。锚点块在每台主机(除持有第一块的主机外)前面重复出现;主机之间没有「环」通信。来源:NVIDIA Star Attention 论文 Figure 1(a)。
图中值得注意的几个细节:
- 第一块也会作为锚点被复制到其他主机,因此 在这台集群上被计算了 次。这是 Phase 1 额外开销的来源,也是它避免通信的代价——用重复计算换取数据不动。
- 每台主机可能持有多个块。论文默认让块大小等于「序列长度 / 主机数」,此时每台恰好一块;如果把块大小设得更小(比如长序列时为了速度把块冻结在 32K),主机数不变的情况下每台就要串行处理多个块。
- 主机之间没有任何通信箭头,这正是与 Ring Attention 图最大的差别。
局部注意力与 KV 丢弃
每台主机对自己持有的每个增广块计算注意力和前向,得到长度 的当前块 KV。然后再做一件看似不起眼、实则关键的事:
把锚点部分产生的 KV 全部丢弃,只保留当前块 的 KV。
由此,每台主机上的 KV 总量是它所持有块的总长,而不是「每块 2b 的累积」。如果每台持有一个块,主机内存里的 KV 长度就是 ,加上查询与后续生成部分的 KV 空间。
这个「算完就丢」的规则让 Phase 1 的 KV 内存与真实上下文长度线性相关,而不是 2 倍。锚点块对模型的贡献仅限于:在计算当前块 KV 时影响注意力分布,一旦 KV 算完,锚点块本身不再存在。
复杂度分析
设每台主机处理一个长度为 的增广块(除首块为 )。Phase 1 的注意力计算量大约是每块 ,共 块,即 ,其中 是上下文长度。
- 对 block size 固定、上下文长度 增长的场景:计算量对 线性。
- 对 (块随长度与主机数缩放、每台一块)的场景:计算量对 仍线性,而且从全局的 降到了 ,设备数直接买来算力。
这就是「把二次复杂度变成线性」这句话的真正含义:不是算法本身线性了,而是计算被分摊到了 台主机上,单台看到的序列长度是 。上下文长度之所以能跟着主机数线性增长,是因为主机数本身在增长。
同时,Phase 1 的通信开销为零。论文在 Introduction 中直接点出了与 Ring Attention 的对比:Ring Attention 的上下文编码阶段要把 KV 绕环传一圈,每台主机的通信量与主机数大致成正比,而 Star Attention 在这里一次通信都不做。
为什么块内注意力会跑偏:attention sink 的复制
如果只是「切开各自跑」,结果会很糟。论文给的实测例子很干脆:在 RULER-NIAH 64K 任务上,去掉锚点块、单纯分块编码,精度从全局注意力的 99.50% 掉到 60.11%;128K 上从 98.49% 掉到 73.75%。也就是说,只是把块切开、各自编码,精度会从近乎全对掉到六七成的水平。
论文把原因归到注意力汇聚(attention sink)上。StreamingLLM 的观察是:经过大量自回归预训练的模型,会把相当一部分注意力分数固定地分配到序列最前面的若干 token 上,不管它们有没有语义作用。这种现象被用来解释「为什么删掉开头几个 token 会让流式推理崩掉」。
在分块场景下,每个块被单独送进模型时,它自己的第一个 token 就成了这段「序列」的开头,于是每个块都在自己开头的几十个 token 上堆出一个 sink。全局注意力中只有一个序列开头的 sink,现在变成了 个分散的 sink。模型对「哪里是值得关注的」的判断被这些假 sink 污染。
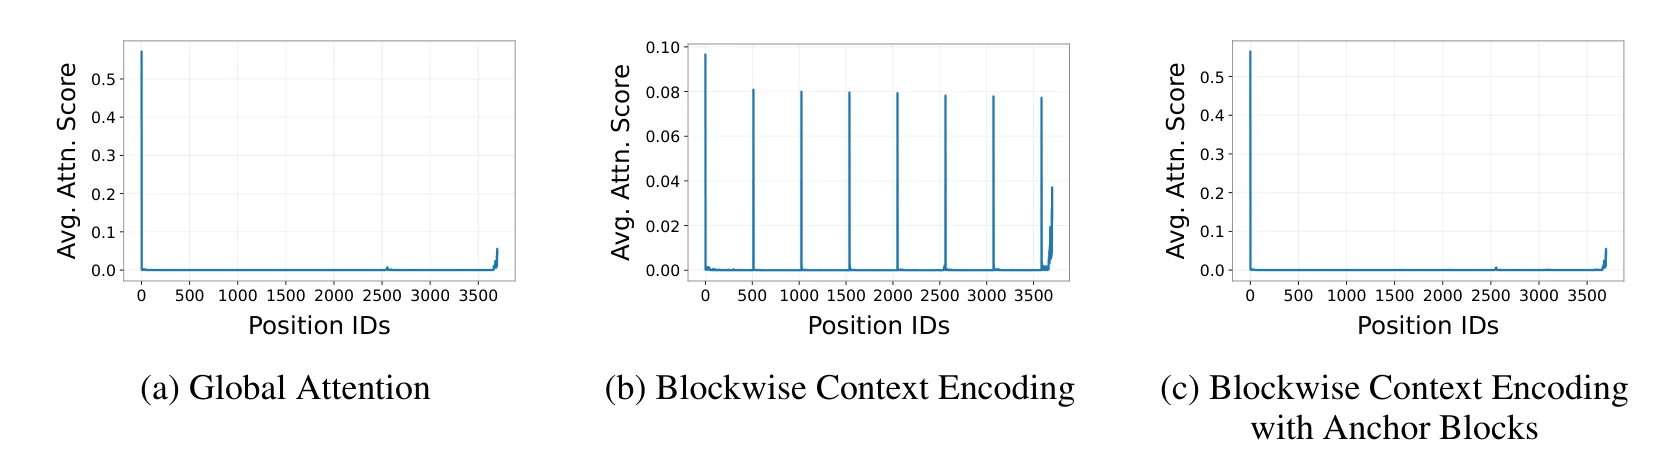
图 2:4K 序列切成 512-token 块后,三种编码策略的平均注意力分布。来源:NVIDIA Star Attention 论文 Figure 3。
三张子图的读法是:
- 全局注意力 (a):序列最开头有一个尖锐的注意力尖峰,之后注意力水平回落到平稳的基线——典型的 sink + 平铺分布。
- 无锚点的分块编码 (b):序列上出现了等间距排列的一串尖峰,位置恰好是每个 512-token 块的开头。注意纵轴量级变了:尖峰高度从约 0.5 降到了 0.1,说明注意力被摊薄到多个假 sink 上,原本用于关注真实内容的那部分也随之减少。
- 带锚点块 (c):尖峰出现在锚点块所在的位置,并且因为锚点是同一个 的副本,所有尖峰落在同一段位置区间上,整体分布更接近 (a)。
锚点的作用不只是「加一段前缀」,而是人为地把每块的 sink 引到同一段语义内容上。所有块都以同样的 开场,因此每个块的注意力开头都「指向」同一份真实内容,而不是各自当前块的前几十个 token。随后丢弃锚点的 KV,这些被引偏的注意力就不再影响后续计算。
论文的原话是:分块编码后的注意力分布与全局注意力之间的差异,「必须被校正,以确保 Phase 2 的注意力分布近似全局注意力」。这句话的直觉是:Phase 2 里查询看到的 KV 是各段局部编码结果拼起来的,模型在读到这一段拼接序列时,依然会把「序列开头」当成 sink;如果 Phase 1 的块内分布也把注意力集中在与开头对应的那段内容上,两段之间的分布就是一致的;否则块内算出的 hidden state 本身就已经带着「当前块开头才是重点」的偏差,这个偏差在 Phase 2 无法被纠正,只能原样传下去。
仓库里的真实实现
论文的实现同时提供 HuggingFace Transformers 版本与 TensorRT-LLM 版本,开源仓库 NVIDIA/Star-Attention 给出 HF 版本的完整推理脚本。读一下 model.py 中的 _process_blockwise_context,可以看到上面公式在代码里的样子(节选自仓库):
for idx in range(len(ctx_ids_blocks[self.rank])): ctx_block = ctx_ids_blocks[self.rank][idx] position_block = position_ids_blocks[self.rank][idx]
# 从第二块开始,在前面拼接锚点块 if self.rank != 0 or idx > 0: ctx_block = torch.cat( (ctx_ids_blocks[0][0][:, : self.anchor_block_size], ctx_block), dim=-1 ) position_block = torch.cat( (position_ids_blocks[0][0][:, : self.anchor_block_size], position_block), dim=-1 )
kv_block = self.model( ctx_block, position_ids=position_block, past_key_values=None, use_cache=True, num_ring_steps=0, # 关闭 ring attention,走纯块内注意力 ).past_key_values
# 丢弃锚点部分的 KV,只保留当前块 if self.rank != 0 or idx > 0: kv_block = [ [x[0][:, :, self.anchor_block_size :], x[1][:, :, self.anchor_block_size :]] for x in kv_block ]几个观察:
- 锚点大小可与块大小不同(
anchor_block_size是独立参数);论文默认取整个首块作为锚点,附录实验中 128K 序列、32K 块时锚点也是 32K。 - 每块独立调用一次前向,
past_key_values=None,所以块与块之间不共享任何状态。首块在持有它的主机上只跑一次,其他主机各自跑一份副本。 - 位置编号直接拼接:锚点用首块的位置编号,当前块用原本的位置编号,这在 RoPE 下是合法的——RoPE 只要求任意两个 token 之间的位置差保持正确,不要求单调递增。锚点 token 之间的相对位置仍然是真实的;当前块内 token 之间的相对位置也是真实的;唯一「不真实」的是跨锚点/当前块边界的相对距离,而这正是近似所在。
modeling_llama.py 中还有一处细节值得注意:Star Attention 模式下,只有最后一台主机(RANK == WORLD_SIZE - 1)在 Phase 2 真正更新 KV 缓存,其余主机保留的是 Phase 1 的局部 KV,不做更新。这个约定在下一节会解释原因。
Phase 2:全局注意力与分布式 softmax
局部注意力与本地统计量
Phase 2 开始时,查询 先被分词,位置编号接在上下文之后(),然后广播到所有主机。
每台主机用自己 Phase 1 留下的 KV(对应一部分 )计算局部注意力和,并额外保留本地 softmax 分母。对某一层、某个查询 token,主机 持有一段长度 的 KV:
这里 是「只看本地 KV 时的注意力输出」, 是本地 softmax 的分母(指数的和)。它们的乘积关系是:
也就是说,每台主机算出的实际上是局部未归一化的注意力加权和。这正是分布式 softmax 需要的量。
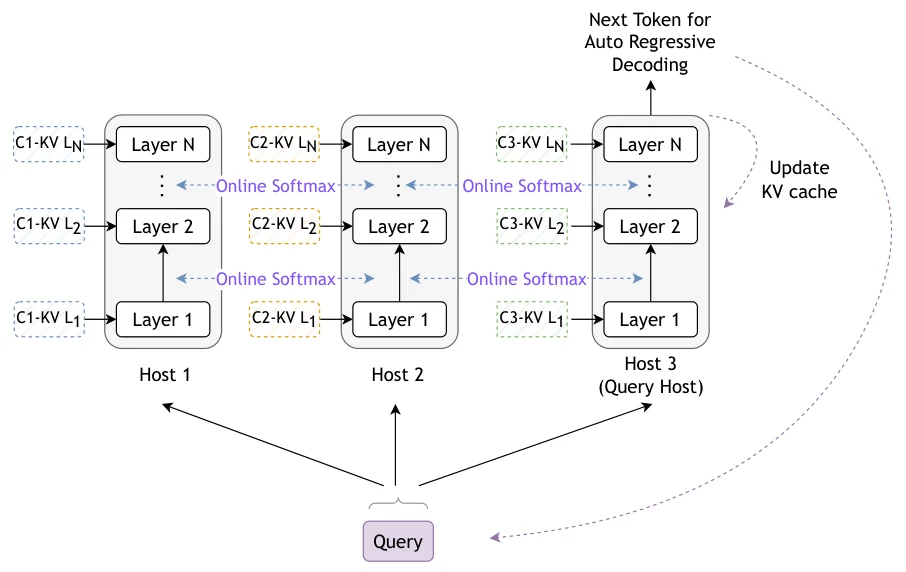
图 3:Phase 2 的通信形态。每台主机只回传本地注意力输出与 log-sum-exp 统计量,KV 不跨机移动。来源:NVIDIA Star Attention 论文 Figure 1(b)。
组装全局结果
查询主机 从所有主机收集 和 ,然后:
为什么这个式子是对的?把 的定义代进去:
这就是对全部 KV(所有块的 KV 拼起来)的精确 softmax 注意力。分母被拆成了各块之和,分子被拆成了各块之和,归一化放在全局一次做完。只要各主机的 KV 拼起来就是完整的上下文 KV,这个组合就是精确的;近似只存在于 Phase 1,不在 Phase 2。
换句话说,Phase 2 的全局 softmax 本身没有任何近似,是类似 Ring Attention 和 FlashAttention 的在线 softmax 的组合;Star Attention 的近似全部集中在「块与块之间在 Phase 1 看不到彼此」。
通信量:每层每 token 一个标量加一个向量
论文对 Phase 2 通信量的描述很值得一提:每台主机每 token 需要发送「一个标量 + 一个向量」,向量长度是注意力头的输出维度 。这是对每个注意力层、每个查询 token 而言的。
设层数 ,查询加生成长度 ,单头维度 ,头数 ,元素字节数 2(bf16):
以 Llama-3.1-8B(32 层、32 头、、bf16)为例,每台主机对每层每个 token 发送 字节,32 层走完后即 KiB。假设查询长度为 256 个 token、主机数为 8:
注意这是把所有头的输出都发回去,且没有压缩、没有量化;也没有包括 KV 本身不移动这一前提下的任何隐式拷贝(比如 all_gather 内部的集合通信实现可能带来额外的拷贝)。作为对照,8 张卡上 128K 长度的 Llama-3.1-8B 完整 KV 共 16 GB;Ring Attention 在上下文阶段以块为单位轮转 KV,每台设备都要把其余 7 台的 KV 各接收一次,总量约为这份 KV 的 7/8。两者量级相近,但 Star Attention 的这部分通信只发生在查询阶段,并且随查询与生成长度增长而不是随上下文长度增长——上下文越长、查询越短,这笔账就越划算。
这个数字也暴露了 Star Attention Phase 2 的一个工程弱点:通信是 per-layer、per-token 的往返。在 HF 实现中,star_flash_attn.py 的 _star_flash_attn_forward 是这样的:
block_out, _, _, _, _, block_lse, _, _ = _flash_attn_forward(q, k, v, ...)
out_gather = [torch.zeros_like(block_out) for _ in range(dist.get_world_size())]lse_gather = [torch.zeros_like(block_lse) for _ in range(dist.get_world_size())]dist.all_gather(out_gather, block_out, async_op=False)dist.all_gather(lse_gather, block_lse, async_op=False)dist.barrier()
out, lse = None, Nonefor i in range(len(out_gather)): out, lse = update_out_and_lse(out, lse, out_gather[i], lse_gather[i])每层的注意力直接调用一次 all_gather,同步等待(async_op=False),再加一次 barrier。它既没有和上一层的计算重叠,也没有做异步流水。对论文里「最大加速比」的结果来说,这一点并不致命,因为在他们的长上下文实验里,Phase 1 占绝对主导;但对一个想在生产里使用的实现来说,这显然是最先要被改掉的地方。
仓库实现里的一个有趣事实:逻辑全在 Query 主机上
读源码会发现,HF 版实现里并没有我们预想的那样「所有主机各自算全局注意力」,而是:
- 只有最后一台主机(
RANK == WORLD_SIZE - 1)在 Phase 2 更新 KV 缓存,其他主机不更新; modeling_llama.py中非最后一台主机在enable_star_attn=True时,直接用 Phase 1 留下的past_key_value[self.layer_idx]作为 K/V 参与注意力,即不追加新 token 的 KV;star_flash_attn的all_gather之后,每台主机都会算出同一个全局结果(所有主机收到的 out/lse 集合是相同的),因此 query 主机和其他主机的输出一致。
这个设计有个副作用:其余主机在 Phase 2 每生成一个 token,都要重新跑完整的 MLP 与除注意力以外的所有层计算,但它们产出的 KV 被丢弃。对论文测试的短答案任务(几十个 token)来说,这只是一份可以忽略的重复计算;对长答案任务,它就是灾难。
它也解释了为什么「最后一台主机持有更新后的 KV」是必要的:Phase 1 时 KV 分散在各主机上,Phase 2 的新 token 需要被某个地方统一持有,否则下一次迭代时每台主机都会有一份自己的「新 KV 副本」。至于为什么是最后一台而不是第一台,是仓库实现的选择(_generate_output 里直接写了 if self.rank == self.world_size - 1),不影响算法正确性。
数值稳定性:为什么实际实现用的是 log-sum-exp
论文正文给出的公式(上一节 、、 的组合)是概念层面的说明;论文在 2.2 节末尾明确说明,实际实现使用 FlashAttention 与在线 softmax 的 log-sum-exp 技巧。
原因很好理解。 这种写法在 bf16 或 fp16 下会溢出:点积的绝对值一旦超过几十, 就超出表示范围。FlashAttention 内部从来不显式算分母,而是保存 log-sum-exp(LSE):
其中 是当前块内的最大分数。LSE 的取值范围与点积同量级,不会溢出。两个块的 LSE 合并方式(仓库 star_flash_attn/utils.py 中的 update_out_and_lse):
注意第一式的形式: 是两段 LSE 的差, 在 时趋近于 0(新块贡献可忽略),在 时按 线性增长,因此第二式中的 与 之和恒为 1——这实际上就是按新旧两块「谁占主导」在两个局部输出之间做插值。仓库实现直接用 lse + torch.log(1 + torch.exp(block_lse - lse)),当 很大时 exp 会溢出,返回 inf;因此生产实现通常改用 logaddexp、或加上「先取最大值再减」的保护。对 Star Attention 来说,由于各主机的 LSE 来自同一组查询对长度相近的 KV 段的注意力, 通常不会极端到溢出;但当某一段全部被屏蔽(例如 padding 块)时,LSE 可能变成 或 ,这在多块拼接时需要显式过滤。
代码里还有一个细节:block_out 和 block_lse 都先被转成 torch.float32 再参与合并,最后再把 out 转回 q.dtype。合并后的结果再进入下一层时,是注意力输出而不是 KV,所以不存在把 fp32 中间态传下去的问题——只是每层合并一次的精度提升。
落到 vLLM:chunked_local_attention 后端的形态
论文以 HF 与 TensorRT-LLM 两种实现为主。在 vLLM 这一侧,与之最直接相关的是 chunked_local_attention 注意力层(vllm/model_executor/layers/attention/chunked_local_attention.py)及其后端构造,值得单独读一读,因为它展示了一种与论文完全不同的「划分注意力」思路。
论文的 Phase 1 划分方式是在数据层面:把输入切成块,每块拼上锚点,逐块调用模型。vLLM 的做法是在注意力后端层面:模型前向仍然是一次完整的、跨全部上下文的调用,注意力层内部把这次注意力「假装成」很多个独立的虚拟请求。
具体地说,chunked_local_attention.py 并不自己实现内核,而是把当前后端(FlashAttention、FlashInfer 等)包装一层:
class ChunkedLocalAttentionBuilder(underlying_builder): def build(self, common_prefix_len, common_attn_metadata, fast_build=False): cm, make_virtual_batches_block_table = make_local_attention_virtual_batches( attention_chunk_size, common_attn_metadata, self.kv_cache_spec.block_size, ) metadata = super().build(common_prefix_len, cm, fast_build) metadata.make_virtual_batches_block_table = make_virtual_batches_block_table return metadatamake_local_attention_virtual_batches(位于 vllm/v1/attention/backends/utils.py)做的事情是把每个请求的 query 按 attention_chunk_size 切成段:每个非首段只看到「当前段之前的一个完整 chunk」的 KV 加上自己这一段,首段只看到从 0 开始到当前段末尾。它的注释里给出了一个具体例子:attn_chunk_size = 4、q_seqlens = [4, 10, 5]、k_seqlens = [6, 17, 9] 时,会被拆成 8 个虚拟请求,每段的 seqlens_k_local 为 [4, 2, 4, 4, 4, 1, 4, 1]。块表也要按同样的切分重排,update_block_table 里通过 make_virtual_batches_block_table 完成。
这个形态与 Star Attention 的关系可以这样理解:
- 相同点:每个块只看到局部窗口,块内的第一个 token 都会成为这段「局部序列」的开头,因而各自产生一个 attention sink——这正是 Star Attention Phase 1 里需要锚点块来解决的问题。
- 不同点:
chunked_local_attention的窗口是「上一个 chunk + 当前 chunk」,每个块的「开头」落在不同的紧邻前缀上;而 Star Attention 的锚点固定为整段上下文的第一块,所有块的 sink 都被引到同一段内容上。前者更接近滑窗注意力,后者更接近「所有块共享同一个开头」。论文的消融实验恰好比较过这两种选择:用「上一块」作为锚点时,64K 的 NIAH 精度从 97.61% 降到 94.20%,128K 时从 97.54% 降到 96.13%——都不如固定用第一块。 - 工程意义:vLLM 这种「在注意力后端里伪造虚拟请求」的做法不需要修改模型代码,也不需要为每个块单独跑一次完整前向,因此能自然复用分页 KV、CUDA Graph 的静态形状约束与批处理。代价是注意力层以下的全部计算(MLP、MoE、归一化)仍然在完整上下文长度上执行,Phase 1 省下的只是注意力部分的乘法与访存,而不是整个前向。
从源码角度,这里有一条很实用的学习路径:先读 make_local_attention_virtual_batches 搞清楚虚拟请求的 Q/K 长度与块表是怎么切出来的,再回到本站的 vLLM Attention Backend 一文,看 AttentionMetadata 如何被不同后端消费。理解了「元数据可以在一层里被重写成另一种形状的注意力」,就理解了 Star Attention 这类算法在生产框架中被「降维」成后端的通用手法。
需要说明的是:vLLM 的 chunked_local_attention 本身并没有实现论文的锚点块拼接,也没有实现 Phase 2 的分布式 softmax 合并。它是 Star Attention 在框架层面落地时最接近 Phase 1 的那一块拼图;完整的 Star Attention 服务形态还需要一层负责「构造锚点、划分上下文、在查询阶段合并各段 KV」的调度逻辑,论文 HF 实现里的 model.py 就是这个逻辑的最简版本。
与相邻方案的边界
Star Attention 常被拿去和三类东西比较,边界需要讲清楚。
和 Ring Attention
两者都是分布式长上下文,但近似性质完全不同:
| 维度 | Star Attention | Ring Attention |
|---|---|---|
| 上下文阶段通信 | 无 | KV 绕环传一圈 |
| 注意力是否精确 | 否,块内不可见 | 是,精确全局 |
| 单机算力需求 | 低(只看本地块) | 高(密集全局,靠分块 IO 优化) |
| 内存 | 线性于本地块 | 线性于本地块 + 环内缓冲 |
| 结果 | 近似 | 精确 |
一个容易忽略的事实是:在 Phase 1,Star Attention 的单机计算比 Ring Attention 便宜得多,因为 Ring Attention 虽然每台设备也只「持有一块 KV」,但它要在整个序列长度上做全局注意力,单机要做完整长度上的乘法;Star Attention 每台只看 。论文 Table 6 中 128K 序列时 Ring 为 53 秒/样本、Star 为 20 秒/样本,差距主要来自这里。论文 Table 1 给出了不同配置下的相对加速:Llama-3.1-8B-Instruct 在 128K、块 32K 时为 2.7 倍(精度下降 1.90 个百分点),Llama-3.1-70B-Instruct 在 64K、块 16K 时为 4.7 倍(下降 1.44 个百分点);把块冻结在 32K、序列拉到 1M 时,加速比达到 16.9 倍,精度下降 5.32 个百分点。加速比随模型变大、序列变长而增长,本质上是「每台设备要处理的局部长度相对全局长度越来越小」的体现。
和稀疏注意力
StreamingLLM、MInference 这类方法减少的是「查询能看到多少 token」。Star Attention 减少的是「上下文阶段多少 token 需要彼此可见」,而 Phase 2 的查询仍能看到全部。它的稀疏性只发生在「输入被编码」这一步,编码结果(KV)依然是完整的。
这个区别直接决定了二者在精度上的表现差异:从论文 Table 2 看,RULER 上 128K 时 Full Attention 76.31、MInference 58.17、StreamingLLM 30.77、Star Attention 74.41;InfiniteBench 的 PassKey 任务上 Full 99.15、Star 93.22、MInference 56.78、StreamingLLM 2.71。原因是 Star 的 KV 是完整的,只是各段 KV 是在「少看了别的段」的情况下算出来的,误差是缓和的;稀疏注意力则直接在查询时把内容丢掉了。
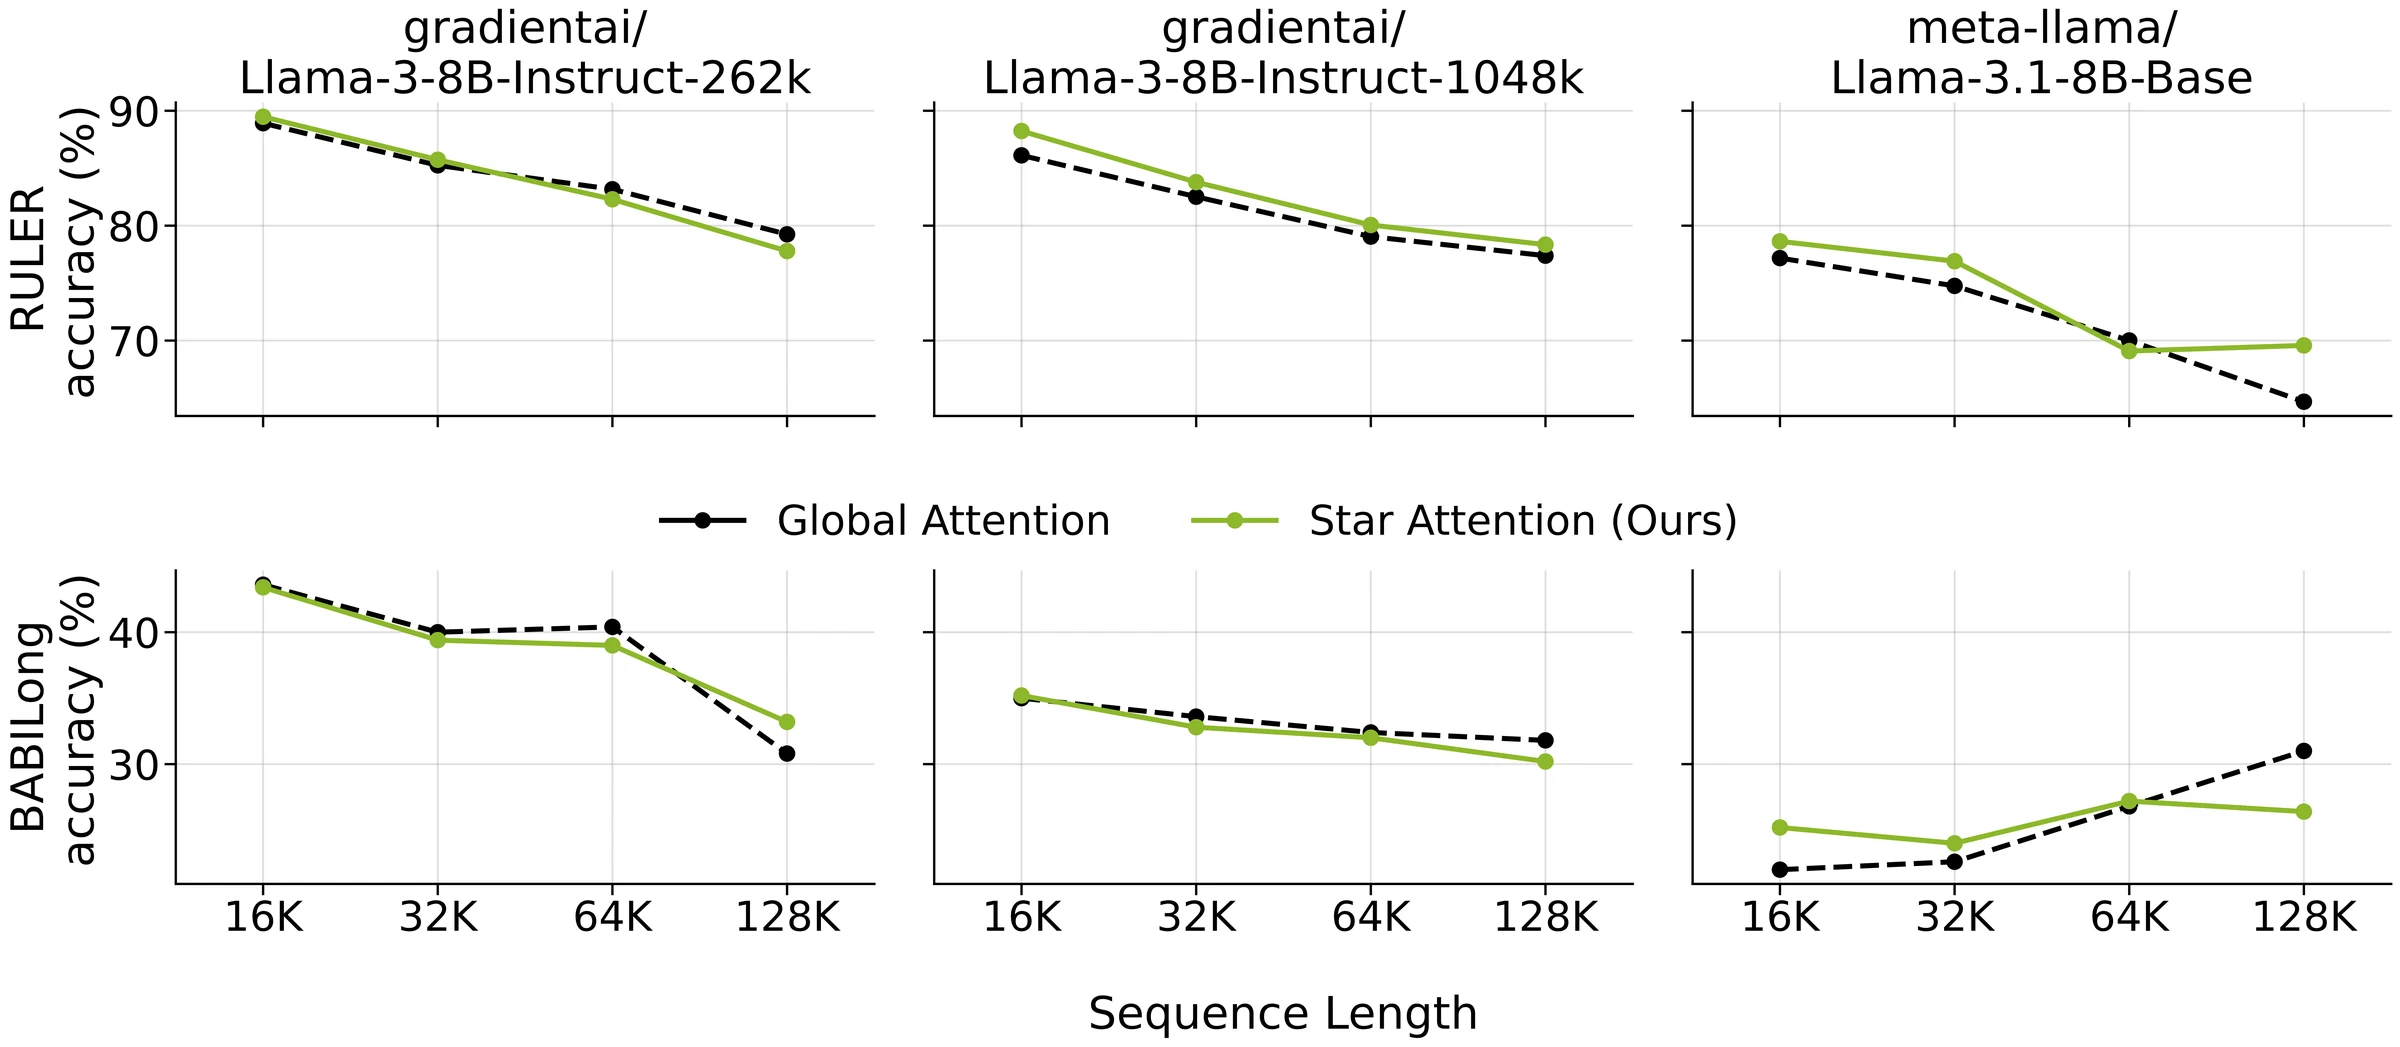
图 4:16K–128K 长度下 Star Attention 与全局注意力的精度对比(Llama-3.1-8B/70B 等)。块与锚点块均取序列长度的四分之一。来源:NVIDIA 官方仓库中的 RULER/BABILong 评测图。
和 NSA、DSA 这类「原生稀疏」
原生稀疏需要模型在预训练/后训练阶段适配,其稀疏模式是「学出来的」。Star Attention 是免训练的:它不改变模型权重,不改训练数据,只改变推理时输入的组织方式。代价是它依赖模型对「锚点」的统计行为——这一点如果模型换了、位置编码方式换了(比如 ALiBi、或者非 RoPE 的有界位置编码),锚点设计的有效性需要重新验证。
对于 RoPE 模型,锚点位置编号的做法尤其自然:RoPE 下两个 token 的注意力只依赖位置差,只要锚点内部的相对位置与当前块内部的相对位置保持真实,模型就能用得上。论文的消融实验也印证了这一点:锚点位置编号怎么取影响很小,内容影响很大。
适用边界与工程注意点
Star Attention 的收益结构可以概括成三句话:
- 上下文越长、查询越短,收益越大。Phase 1 分块编码覆盖了几乎全部工作量;当上下文只有 16K 时,FlashAttention 的全局实现本来就够快,Star Attention 的额外开销(锚点重复计算)让它并不占优。
- 主机数决定可扩展长度。Phase 1 每台主机处理 长度的块,上下文要跟着主机数线性扩展。
- 精度取决于任务类型。检索、聚合类任务几乎无损,甚至可能更好;跨块多跳、需要块间信息传递的任务会下降,下一篇会给出具体的分类数据。
对实现者来说,还有几个值得提前知道的坑:
- 锚点的 KV 丢弃要彻底。如果只是「不写回到 cache」,但 KV 仍占着显存,Phase 1 的内存优势就没了。仓库实现是在 Python 层做切片后重新拼装,实际工程中应该在注意力后端内部支持「前缀只读、不落 KV」。
- 位置编号的非单调是故意的。锚点保持首块的原位置、当前块保持原位,整体看位置编号不是单调递增的,并且相邻两个块之间的位置差比真实距离大——块边界附近因此会失去「紧邻上下文」。论文消融显示锚点的位置编号怎么取影响有限(随机采自前缀区间仍有接近精度),但把锚点位置重置为 0 会丢失锚点 token 之间真实的相对位置,这在 RoPE 下等同于换了一份内容。
- Phase 2 的 KV 只由一台主机更新,意味着其余主机的计算有一部分是纯浪费。对长答案任务,应该让每台主机在 Phase 2 也能「认领」生成 token 的某些层或某些头,而不是全部重算。
- 查询长度本身也要计入预算。Phase 2 的通信按查询 token 数线性增长,如果查询是几百 token 的多轮对话上下文,那么它就在吃 Phase 1 省下来的通信预算。
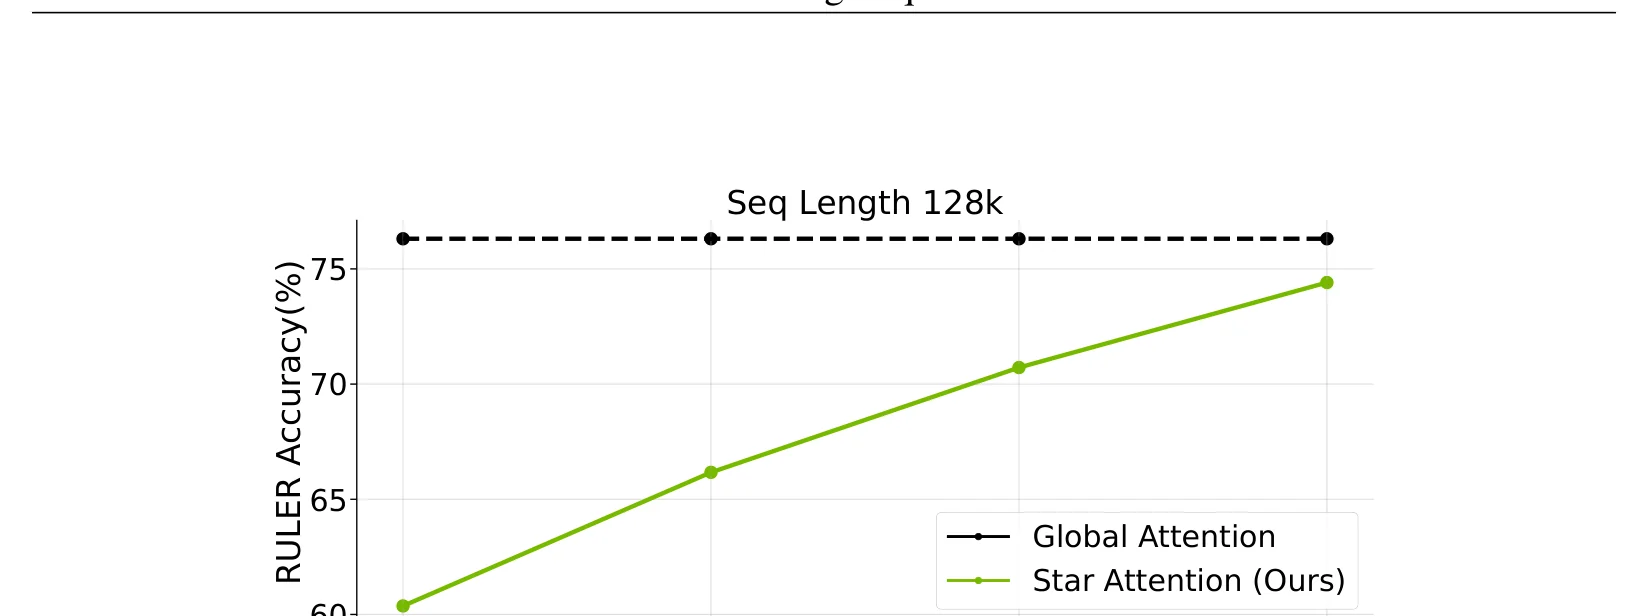
图 5:128K 序列下块大小对 RULER 精度的影响。块从 4K 增到 32K,精度单调上升并逐渐逼近全局注意力。来源:NVIDIA Star Attention 论文 Figure 5(a)。
图 5 给出了一个关键观察:块越大,精度越高。直觉是块内的「可见范围」越大,块内编码越接近全局注意力,块边界处的信息断裂就越少。这直接导致 Star Attention 的推荐配置——块大小取序列长度的约四分之一——在大模型上、128K 之上会把块冻结在 32K。块大小与精度的权衡、以及为什么锚点必须和块一样大,是下一篇的主要议题。
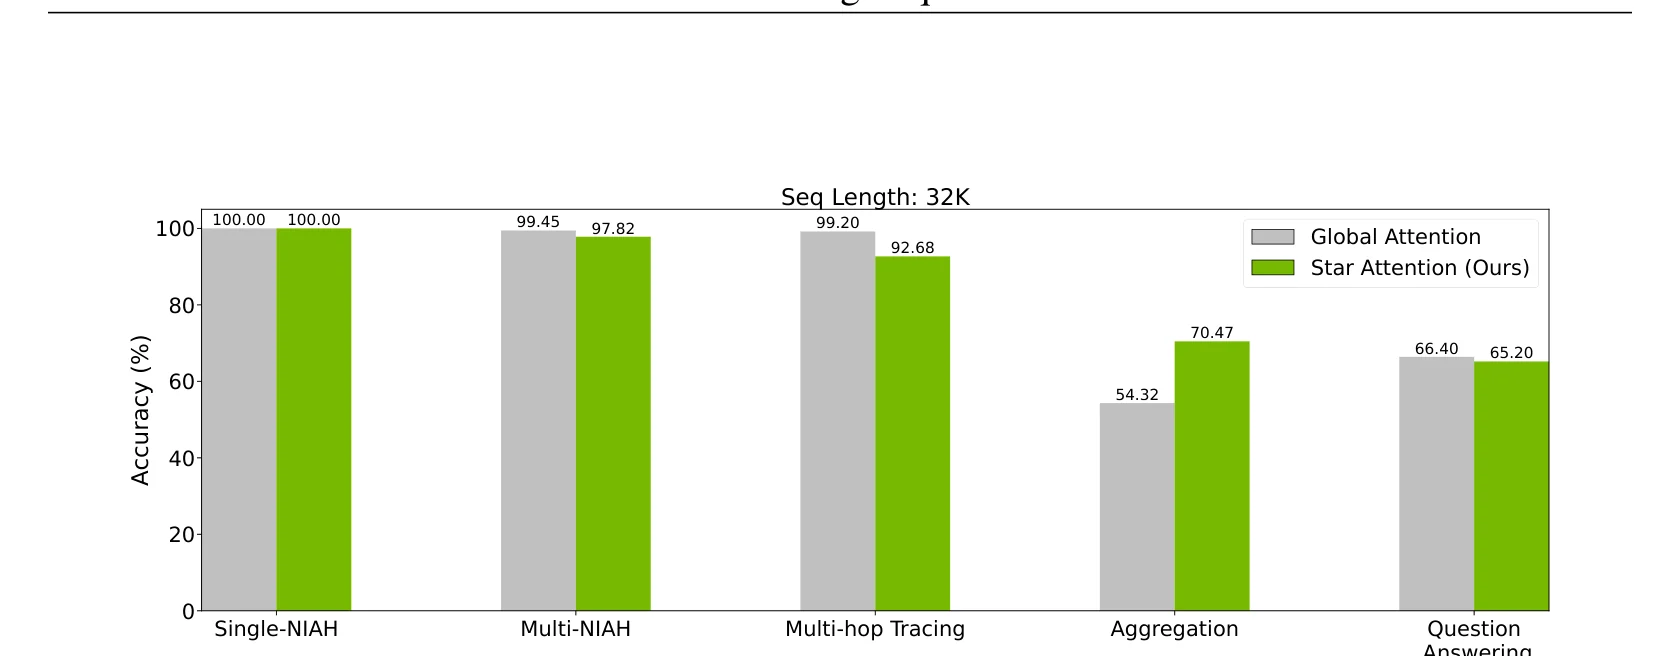
图 6:块大小固定为 32K,序列长度从 128K 增到 1M 时 Star Attention 的精度-速度权衡。来源:NVIDIA Star Attention 论文 Figure 6。
小结
Star Attention 的结构可以浓缩成三个要点:
- Phase 1:上下文切成 块并分配到 台主机,每块(除首块外)前置同一份锚点块 ,块内计算后丢弃锚点 KV,主机间零通信;
- Phase 2:查询广播,各主机用本地 KV 计算局部注意力和本地 softmax 分母,查询主机用全局归一化合成精确的全局注意力;每层每 token 通信「一个标量 + 一个向量」;
- 近似只在 Phase 1,Phase 2 的合成在数学上是精确的。
锚点块是这个设计里最不直观、也最有信息量的部分。下一篇将拆开它的消融实验:位置与内容的分离实验说明了什么、为什么锚点大小必须与块大小相当、以及论文在各任务类别上的精度分布——特别是多跳追踪任务为什么必然下降、聚合类任务为什么会反超全局注意力。
参考资料
- Star Attention: Efficient LLM Inference over Long Sequences(arXiv:2411.17116,ICML 2025)
- NVIDIA/Star-Attention 官方仓库(HF 实现与基准脚本)
- Ring Attention with Blockwise Transformers for Near-Infinite Context(arXiv:2310.01889)
- World Model on Million-Length Video and Language with Blockwise RingAttention(arXiv:2402.08268)
- Efficient Streaming Language Models with Attention Sinks(StreamingLLM,arXiv:2309.17453)
- MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention(arXiv:2407.02490)
- vLLM 源码:chunked_local_attention 注意力层
- vLLM 源码:make_local_attention_virtual_batches(虚拟请求切分)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



