


Hyper-Connections 完全拆解:字节跳动如何把残差流拆成 n 条可学习车道
一篇被后续工作遮住光芒的原始论文
过去一年,讨论超连接(Hyper-Connections,HC)时,很多文章会直接从 DeepSeek 的 mHC 讲起:把残差混合矩阵投影到双随机流形上,恢复跨层恒等映射,让宽残差流稳定堆到 61 层。那篇工作确实把 HC 从”实验室里的结构技巧”推进到了”可以在超大模型上稳定使用”的工程阶段,站内也有对应的完整拆解(mHC 完全拆解:流形约束超连接)。
但 mHC 的所有讨论都建立在一个更早的基础上:2024 年 9 月 29 日,字节跳动 Seed-Foundation-Model Team 的 Defa Zhu、Hongzhi Huang、Zihao Huang、Yutao Zeng、Yunyao Mao、Banggu Wu 等人挂在 arXiv 上的原始《Hyper-Connections》(arXiv:2409.19606,2025 年 3 月更新到 v3)。原始论文第一次把残差连接从”一条固定强度的加法支路”改写成一个可学习的 连接矩阵,并提出了深度连接、宽度连接、静态 HC 与动态 HC 这一整套概念。mHC 后来做的,是在这个矩阵上再加一条流形约束;如果不先理解原始矩阵每一项在控制什么,mHC 的约束为什么必要、为什么只约束残差混合矩阵,都会变成没有上下文的结论。
这篇文章只聚焦原始 HC。它要回答四个问题:残差连接到底被什么限制住了;HC 如何用 条隐藏流同时表达多种跨层连接;顺序排列与并行排列为什么是同一个连接矩阵的两种特例;以及在推理侧,这套结构究竟要多花多少参数、多少 FLOPs、多少显存。
残差连接的真正瓶颈:一条固定强度的单车道
从 ResNet 的恒等映射说起
ResNet 由何恺明等人于 2015 年提出(CVPR 2016 的 “Deep Residual Learning for Image Recognition”),它给单层网络写下的式子是
其中 是第 层输入, 是隐藏维度, 是这一层真正执行的计算(在 Transformer 里就是 Attention 或 FFN), 是该层权重。把式子逐层展开:
浅层信号以系数恰好为 1 的通路直达深层,深层只是在这条通路上不断叠加增量。反向传播时,
括号里的单位矩阵 是恒等通路的梯度镜像。即使后面那串雅可比累加项全部趋近于零,梯度仍然可以沿着 原样回传到浅层。何恺明 2016 年的后续工作 “Identity Mappings in Deep Residual Networks” 把这一点讲得更清楚:让极深网络可训练的关键,不是”残差”这个名字,而是主干必须保持恒等、残差分支不修改主干这个结构约束。
Pre-Norm 与 Post-Norm 的跷跷板
Transformer 里最常见的两种残差变体,把归一化放在了不同位置。
Pre-Norm 在进入每个子层之前做归一化:
归一化被放进子层内部,主干上的加法始终保持一条干净的恒等通路,所以梯度不容易消失。代价是深层隐藏特征会越来越相似:每一层都在同一个归一化后的表示上做增量,层数增加后新增层对最终表示的贡献被稀释,论文把这种现象称为表示坍缩(representation collapse)。Liu 等人 2020 年的 “On the Variance of the Hessian Spectrum” 一类分析也指出,Pre-Norm 深层的特征相似度会系统性地升高。
Post-Norm 则在子层输出与残差相加之后再做归一化:
归一化压缩了每个隐藏状态对后续层的影响,表示坍缩得到缓解;但主干上的恒等通路被归一化打断,梯度在深层容易消失,早期 Post-Norm Transformer 需要 warmup 才能训练起来。
两者像跷跷板的两端:Pre-Norm 偏向梯度稳定,Post-Norm 偏向表示多样,但二者都无法同时把两端压下去。更根本的问题在于,残差连接的强度是预先写死的。无论是 Pre-Norm 还是 Post-Norm,输入与输出之间的系数都由结构决定,网络没有权限根据当前层的输入、当前 token 或当前深度去调整”这一层应该保留多少旧信息、写入多少新信息”。
表示坍缩在推理侧意味着什么
表示坍缩不只是训练指标问题。对推理系统来说,如果相邻层的隐藏状态高度相似,那么这些层对最终输出的边际贡献很低,但它们的矩阵乘法、注意力和 KV Cache 读取仍然要完整执行。层数越深,单位 FLOPs 换来的表示变化越小,这是”名义深度”和”有效计算深度”之间的差距。站内文章就用统一公式和层级诊断讨论过不同残差设计如何影响有效计算深度(DepthBench 完全拆解)。HC 的出发点,正是把这个”固定强度”改成可学习、甚至可随 token 变化的连接矩阵。
HC 的基本对象:超隐藏矩阵与超连接矩阵
把一条隐藏向量复制成 条流
标准 Transformer 在第 层的输入是一个 维向量。HC 先把它复制 份,组成一个超隐藏矩阵(hyper hidden matrix):
这里 是隐藏维度(论文用 表示 Transformer 的 hidden size), 称为扩展率(expansion rate)。每一行是一条独立的隐藏流,初始时 条流完全相同。第 层的输入是上一层的 ,而不是一个 维向量。
在网络的最后一层之后,把最后那个超隐藏矩阵按行求和,得到一个 维向量,再送入最终的归一化层与 unembedding 层。也就是说, 条流在进入网络时是同一份信息,在离开网络时被重新聚合成一份输出;中间每一层都可以让它们走不同的路径。
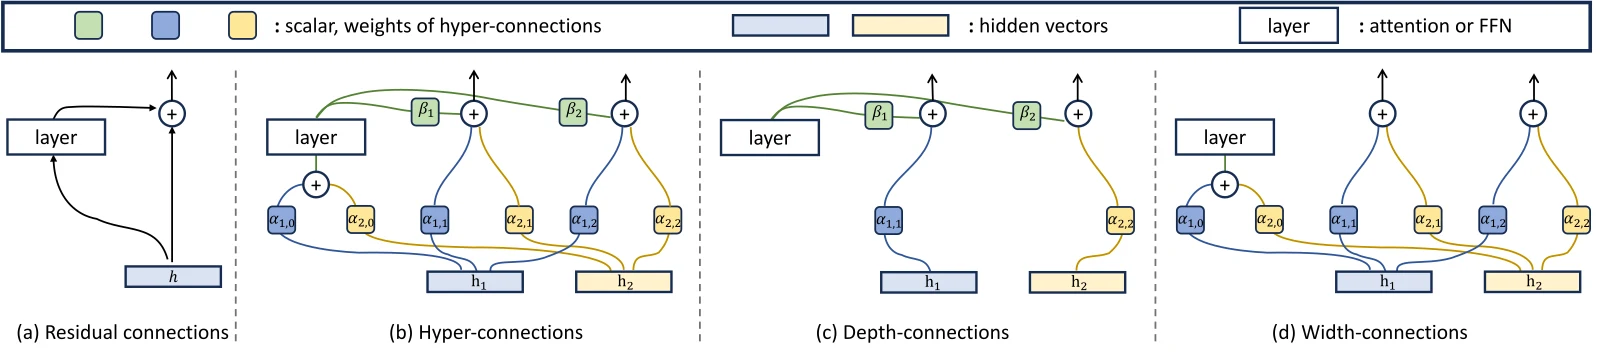
上图是论文 Figure 2 的结构示意,扩展率取 。左侧是标准残差连接:一条 维主干,一条旁路把层函数 的输出加回主干;右侧是 HC:主干被拆成两条流,层函数从两条流中按权重读出输入,输出再按权重写回两条流,同时两条流之间还存在横向混合。图中的 控制写回, 控制读出与流间混合。把这些系数排成一个矩阵,就是 HC 的核心对象。
的连接矩阵
HC 用一个矩阵 描述”当前层的输入、当前层的输出、下一层的 条流”之间的关系:
其中 是写回权重, 是读出权重, 是流间混合矩阵。左上角的 是一个占位项,表示当前层的输出不会直接连回自己;真正参与运算的是其余 个系数。
给定一个层函数 (在 Transformer 里就是 Attention 或 FFN 子层)和输入 ,HC 的输出写成
这个式子看起来抽象,拆开就是三步。
第一步是读出:
的形状是 ,转置后得到 的行向量,也就是 维的层输入 。 的 个系数决定从 条流中各取多少,聚合成一条 维向量。层函数 只看到这一条 维向量,所以 Attention 和 FFN 的计算量与标准 Transformer 完全一样,不会因为 条流而变成 倍。
第二步是残差混合:
是 ,作用在流的维度上,把 条旧流混合成 条新流。它相当于把标准残差里的”原样加回去”换成了一个可学习的线性组合。
第三步是写回:
是一个 维列向量;转置成 后,左乘 ,得到 的矩阵。 的 个系数决定把这一层的输出分别写回每条流多少。最后加上残差混合的结果,得到下一层的超隐藏矩阵。
把三步连起来看,HC 的每一层仍然只有一个 Attention/FFN 子层,计算量没有乘 ;被加宽的只有”流的数量”和”流之间的线性混合”。这就是论文反复强调的”看起来宽了 倍,实际计算量几乎不变”。
为什么读出和写回必须是两个不同的映射
如果只用一个 维向量同时控制读出和写回,那么”从哪条流读”和”往哪条流写”就被绑死,网络无法表达”从流 1 读、把结果写回流 2”这种跨流路由。HC 把读出 和写回 分开,才让每条流可以保留不同的历史模式:一条流可能主要保存浅层特征,另一条流可能主要保存最近几层的增量,层函数可以从前者读出、把结果写入后者。
则负责在层与层之间重新分配这些历史。它不经过层函数,直接作用在流维度上,相当于一条”流级别的残差通路”。三者合起来,才构成一个完整的 连接矩阵。
深度连接与宽度连接:把残差拆成两个可学习的问题
论文把 HC 矩阵拆成两个部分来看,这两个部分对应两种不同的连接。
深度连接:广义的残差
把 中与”当前层输出”和”下一层输入”相关的行抽出来,得到深度连接矩阵:
第一行 是当前层输出写回各条流的权重;第二行是 的对角线,表示每条流保留自身历史的比例。标准残差连接可以看成这个 矩阵在 时的特例:只有一个 和一个 ,且两者都固定为 1。HC 把这两个标量扩展成两行 列的矩阵,让每条流拥有自己的”保留多少旧信息、写入多少新信息”。
宽度连接:流与流之间的交换
把 和 拼起来,得到宽度连接矩阵:
是读出, 是流间混合。宽度连接让同一层里的 条流可以互相交换信息,而不必等到下一层。它解决的是”多条流各自为政、信息不互通”的问题:如果只有深度连接, 条流只是 条平行的残差通路,彼此之间没有耦合,网络仍然只能表达 个独立的单流残差,无法把不同流的历史组合起来。
为什么 不够, 才出现新结构
论文明确论证过 的退化情形。当 时,HC 矩阵退化成 :
它仍然可以学习”保留多少旧信息、写入多少新信息”,也就是可以调整残差强度,但只有一条流,无法同时保留两种不同的跨层模式。论文的消融显示, 的 DHC 性能不如基线;连接矩阵可视化里, 模型甚至出现某一层完全浪费、与后续层没有任何连接的情况。原因很直接:单流上的 只能把所有历史压缩成一个标量系数,无法表达”浅层特征走一条路、深层增量走另一条路”。
当 时, 是一个真正的 矩阵,可以把不同历史成分分配到不同流上; 和 又允许层函数从指定流读写。此时网络不仅能调整残差强度,还能重新排列层的顺序:顺序排列和并行排列都可以写成特定的 HC 矩阵,这一点在下一节展开。
从参数和计算量看, 的代价很小。以 OLMo-1B 为例,动态 HC 在 时只增加约 39.4 万个参数,占总参数量的 0.033%;前向 FLOPs 只增加约 0.0049 G,占总量的 0.2%。静态 HC 的参数和 FLOPs 更小。换句话说,HC 用不到千分之几的额外计算,换来了一个可以重新布线整个网络的自由度。
静态 HC:初始化即 Pre-Norm
静态矩阵的初始化
HC 的第一种形态是静态 HC(Static Hyper-Connections,SHC):连接矩阵的系数是可学习的,但不依赖输入,训练完成后固定。论文给出的初始化是
其中 是层编号, 是第 个位置为 1、其余为 0 的 列向量, 是 单位矩阵, 是全 1 的行向量。
这个初始化看起来有点绕,但它的含义很清楚:
- :每条流原样保留自己的历史,不做混合;
- :当前层的输出平均写回所有流;
- :第 层只从第 条流读出输入。
把这三条合起来,第 层的行为就是:从一条流读出 维输入,经过层函数,把输出写到所有流上,同时所有流保留旧值。因为写入是”复制到所有流”,而读出是”循环选择一条流”,整个网络在初始化时等价于标准 Pre-Norm 残差连接:每一层的输出都会进入主干,主干的和在最后统一聚合。
循环缓冲区的解释
可以把 条流看成一个长度为 的循环缓冲区。第 层从第 个槽位读取当前表示,计算完把结果写入所有槽位。这样每个槽位保存的是”最近一次被选中作为层输入的那份表示”,不同槽位之间相差若干层的延迟。最后把所有槽位求和,等于把每一层的输出都加回主干——这正是 Pre-Norm 残差在展开后的形式。
这个解释也说明了为什么初始化必须让 、:如果初始化时就让流之间强烈混合,网络一开始就不是一个已知的稳定结构,训练早期的梯度尺度会失控。HC 的做法是先把初始化锚定在 Pre-Norm 上,再让训练慢慢把矩阵推离这个锚点。论文还按 缩放输出模块(FFN 的第二层线性层、Attention 的输出投影)的初始化标准差,保证最后按行求和后的输出尺度与标准 Transformer 一致。这两点合起来,使 HC 在训练开始时与基线完全等价,不会因为”多了 条流”而凭空改变初始 loss。
静态 HC 的参数与计算
静态 HC 的可学习参数只有连接矩阵本身。每个 HC 模块的矩阵有 个位置,左上角固定为 0,所以是 个参数;每个 Transformer 层有两个 HC 模块(Attention 前一个、FFN 前一个),总参数量是 。论文 Table 7 给出的实测值是:OLMo-1B-SHC×2 增加约 2600 个参数(+0.00002%),SHC×4 增加约 7700 个参数(+0.00007%),都不到总参数量的万分之一。这个量级意味着静态 HC 几乎不增加模型存储,也不会改变推理时的权重加载瓶颈。
前向计算的主要开销在 和 这两步,复杂度是 ;相比之下 FFN 是 ,Attention 的投影部分是 。因为 通常取 2 到 4,而 是数千, 比 小两三个数量级,所以 HC 的额外 FLOPs 可以忽略。
动态 HC:让连接权重随 token 改变
从固定矩阵到输入相关的矩阵
静态 HC 的矩阵在训练后固定,所有 token 共享同一套连接强度。动态 HC(Dynamic Hyper-Connections,DHC)把矩阵的每一项变成输入 的函数:
其中
符号逐个解释:
- 是超隐藏矩阵在最后一维上做归一化的结果。 是 ,归一化对每一行的 个特征独立进行;在 OLMo 里这个归一化没有可学习参数。
- 、、 是三个线性投影。 的形状是 ,转置后变成 ,正好对上 ; 是 ,对上 。
- 把动态部分压到 ,防止某个 token 把连接权重推到极端值。
- 、 是可学习的缩放因子,初始化为很小的值(论文附录取 量级)。这样训练开始时动态项接近 0,DHC 退化成静态 HC,再慢慢学会利用输入相关的路由。
- 、、 是静态偏置,也就是不依赖输入的那一部分。动态 HC 实际上是”静态矩阵 + 输入相关的残差”。
动态项的参数量
三个投影的参数分别是 、、,加上偏置和缩放因子,每个 HC 模块约 个参数。以 、 为例,每个模块约 万参数;16 层、每层两个模块,总共约 39.4 万参数,与论文表格中 OLMo-1B-DHC×4 的 0.000394B 完全对得上。这个数字只占总参数量的 0.033%。
动态 HC 在推理时到底多做了什么
在推理时,DHC 的每一步需要先对当前超隐藏矩阵做一次归一化,再算三个小矩阵乘法: 乘 (两次)和 乘 (一次)。以 、 为例,最后一次是 乘 ,只有 3.3 万次乘加;相比之下,一层 7B 模型的 FFN 是 量级,几千万次乘加。动态 HC 的计算量占比与论文给出的 0.2% 总 FLOPs 增量一致。
真正需要留意的是动态矩阵不能跨 token 共享。静态 HC 可以把整个矩阵预先算好、折叠进权重或 kernel 常量;动态 HC 的 每个 token 都不同,batch 内不同序列、不同位置的 token 各自有一套 矩阵。服务端实现时,这会变成一次 batched 小 GEMM,或者在一个融合 kernel 里对每个 token 单独算 系数。它的绝对计算量很小,但会打断”整个 batch 共用同一个残差结构”的假设,增加一点 kernel 启动和访存开销。对延迟极其敏感的场景,静态 HC 更容易做深度优化;对质量优先的场景,动态 HC 的额外自由度更有价值。
为什么 HC 能改写网络拓扑:残差是它的一个特例
Pre-Norm 与 Post-Norm 都是不可训练的 HC
论文在 §3.1 给出了一个很重要的视角:Pre-Norm 和 Post-Norm 都可以写成扩展率 的 HC 矩阵,只是矩阵元素不可训练。
Pre-Norm 的等价矩阵是
第一行 表示当前层输出以权重 1 写回唯一的流;第二行 表示读出权重为 1、残差保留权重为 1。这正是 。
Post-Norm 的等价矩阵则依赖输入与输出的方差、协方差:
其中 、 分别是输入和输出的标准差, 是二者的协方差。Post-Norm 在相加之后做归一化,等价于把”输出写回”和”残差保留”同时乘上一个由当前输入/输出统计量决定的缩放系数。这个系数不是学出来的,而是由归一化算子即时算出来的。
这两个特例说明:残差连接并不是 HC 的对立面,而是 HC 在 、矩阵元素被结构写死时的一个点。HC 把矩阵从 扩展到 ,把元素从固定值变成可学习、甚至输入相关,因此网络可以在 Pre-Norm 和 Post-Norm 之间连续滑动,而不是二选一。
顺序-并行二象性
HC 最反直觉的性质是顺序-并行二象性(sequential-parallel duality):一串按顺序执行的层,和一组并行执行的层,可以写成同一个 HC 矩阵的不同取值。
论文以 为例。如果 HC 矩阵取
网络就按顺序排列:每一层从流 1 读出,输出写回流 1 和流 2,流 2 保留历史;下一层再从流 1 读出。这等价于标准残差串联。
如果把奇数层和偶数层的矩阵分别取成
那么相邻两层就会形成并行结构:奇数层的输出不再作为偶数层的唯一输入,偶数层可以从另一条流读出,两层的结果在后续层汇合。论文证明,通过归纳法可以把这种局部矩阵展开成”每两层并行”的排列;更一般地,任意混合顺序/并行的排列都可以由某个 HC 矩阵表示。
这解释了一个常见的误解:并行 Transformer 块(Parallel Transformer Block,PTB)并不是一个独立的架构技巧,而是 HC 连接矩阵的一个特例。标准 Transformer 只能预先选择”全顺序”或”全并行”,HC 则让网络自己学出一个混合排列。静态 HC 学到的排列在训练后固定;动态 HC 可以按 token 改变排列,让不同的 token 走不同的层间路径。
连接矩阵展开:从局部权重看全局布线
为了分析 HC 到底学到了什么,论文把递推式展开。第 层的输入可以写成之前所有层输出的加权和:
其中 是第 层的输出, 描述第 层对第 层输入的贡献。把所有 排成一个矩阵,就得到一张”跨层连接图”。这张图把 HC 的局部 矩阵展开成全局的稠密连接模式,可以直接看出网络把哪些层的输出保留到了后面。
论文的可视化给出了几个稳定现象:
- 基线 Pre-Norm 的连接矩阵是一个下三角矩阵,对角线被抹掉,因为每层都等权地把输出加回主干;
- 并行 Transformer 块的矩阵呈锯齿状,因为 FFN 的输入不依赖上一层的 Attention 输出;
- Post-Norm 的矩阵只有相邻层有较强连接,越往下的层权重衰减越快;
- 两跳残差(two-hop residual)的矩阵出现竖直条纹,因为 Attention 输出只贡献给下一层 FFN,不进入主残差。
HC 学到的矩阵则同时出现两种模式:一种是”长期衰减”,层更倾向于依赖少数相邻层的输出,这是 Post-Norm 风格;另一种是”底层被频繁访问”,浅层输出在大多数后续层中都有贡献,这是 Pre-Norm 风格。两种模式叠在一起,形成论文所说的 形连接模式。换句话说,HC 不是在做二选一,而是在同一个网络里同时保留 Pre-Norm 的直达通路和 Post-Norm 的局部衰减。
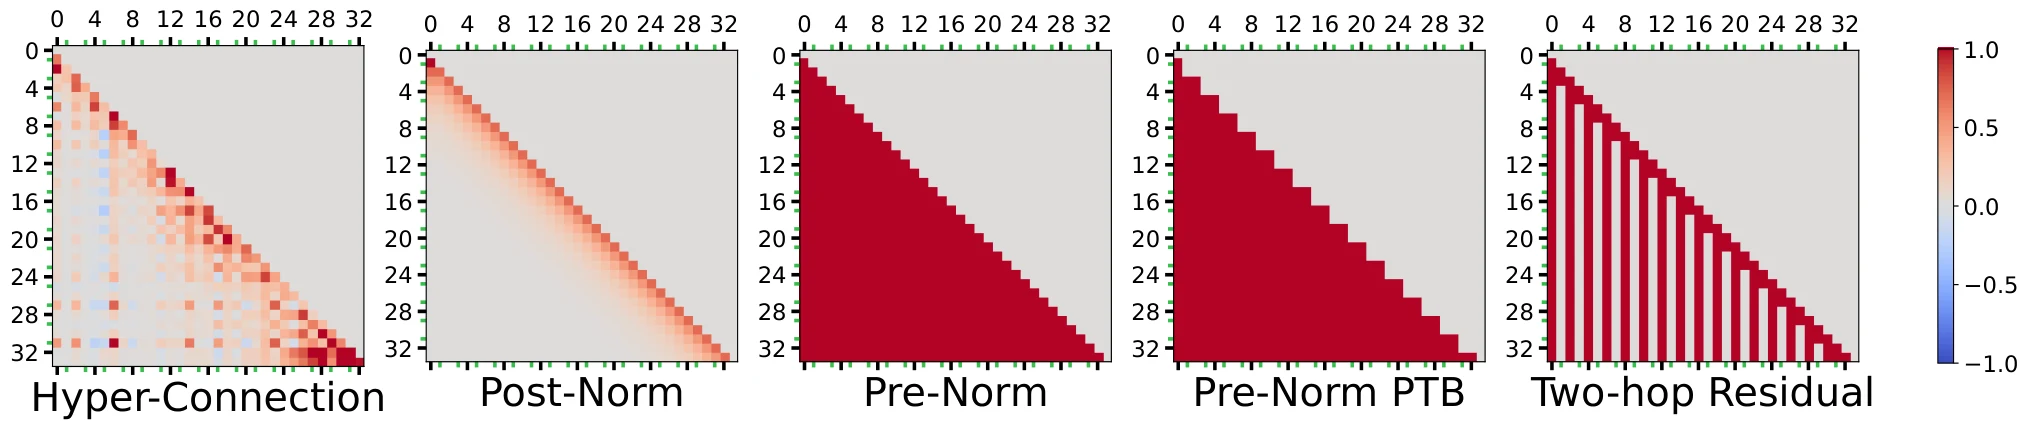
上图来自论文 Figure 7,把 HC 与 Pre-Norm、Post-Norm、并行块、两跳残差等基线的连接矩阵并排展示。横轴是目标层,纵轴是源层,颜色越深表示源层输出对目标层输入的贡献越大。可以看到 Pre-Norm 的均匀下三角、Post-Norm 的窄带、并行块的锯齿,以及 HC 的”底层亮、近邻亮”的复合结构。这个对比是理解 HC 为什么能同时缓解梯度消失和表示坍缩的最直接证据。
展开后的四个细节:HC 究竟把信息放在哪里
论文附录 F 对 OLMo-1B-DHC×4 在 500B token 检查点上的连接矩阵做了更细的拆解,有几个细节值得单独讲。
输入词嵌入被排除在最终输出之外
连接矩阵的第一列对应输入词嵌入。可视化显示,输入词嵌入对大多数层都有贡献,唯独对最后一层几乎没有贡献。最后一层的输出直接进入 unembedding 做下一 token 预测;如果输入词嵌入的成分大量残留在最终表示里,会干扰预测,尤其在 OLMo-1B 使用 tied embedding 的情况下更明显。HC 学到的矩阵自动把这一列在最后一层压掉,说明它确实在按”哪一层该保留什么”做路由,而不是简单地均匀加和。
并行块模式是学出来的
论文在 HC 的连接矩阵里观察到局部锯齿:某些相邻层之间的贡献很弱,意味着这两层可以并行执行。例如第 11 层对第 12 层输入的贡献很小,二者就形成了一个类似 PTB 的局部结构。这个现象不是人工设计的,而是 HC 在训练中自己学出来的。它验证了顺序-并行二象性不只是数学上的等价,而是网络会实际利用的自由度。
Attention 的长期连接少于 FFN
连接矩阵显示,底层的 Attention 输出几乎没有长期贡献,这个趋势一直持续到第 17 层左右;相比之下,FFN 的输出在后续层中保留得更多、幅度也更大。这个模式接近两跳残差的设计:Attention 的输出主要贡献给紧邻的 FFN,不进入主残差通路。HC 没有显式规定这一点,但它在优化中发现了”Attention 输出更适合局部使用、FFN 输出更适合长期保留”的结构。
的失败方式
论文对比了 DHC×1、DHC×2、DHC×4 的连接矩阵。DHC×1 的矩阵里,第 17 层完全没有连接到后续层,等于这一层被浪费;同时早期层到最终层的连接也没有形成 形模式。原因是 时 只是一个标量,无法同时表达”保留早期特征”和”衰减近期特征”两种模式,网络只能在两者之间折中。缺少从浅层到深层的直达连接,梯度回传就像 Post-Norm 一样容易消失,性能自然下降。
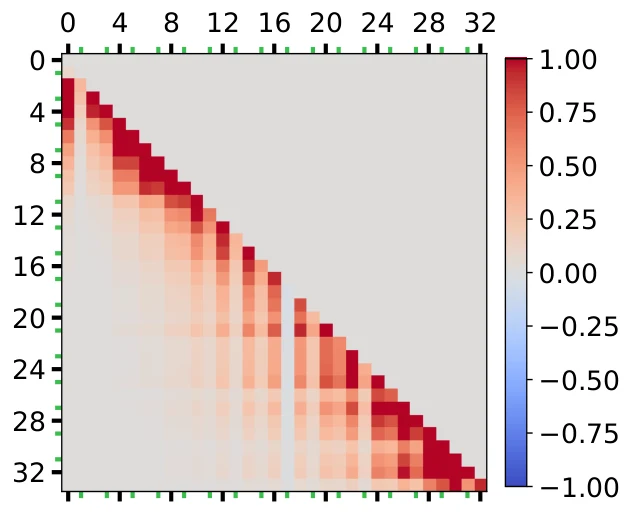
上图是论文附录 Figure 14(a) 的 DHC×1 连接矩阵。可以看到第 17 层对应的行/列出现明显的空白,这一层没有向后续层传递任何信息;这正是 退化成单流后无法维持多模式连接的直观表现。作为对照,下面是 DHC×4 在同一个检查点上的连接矩阵:
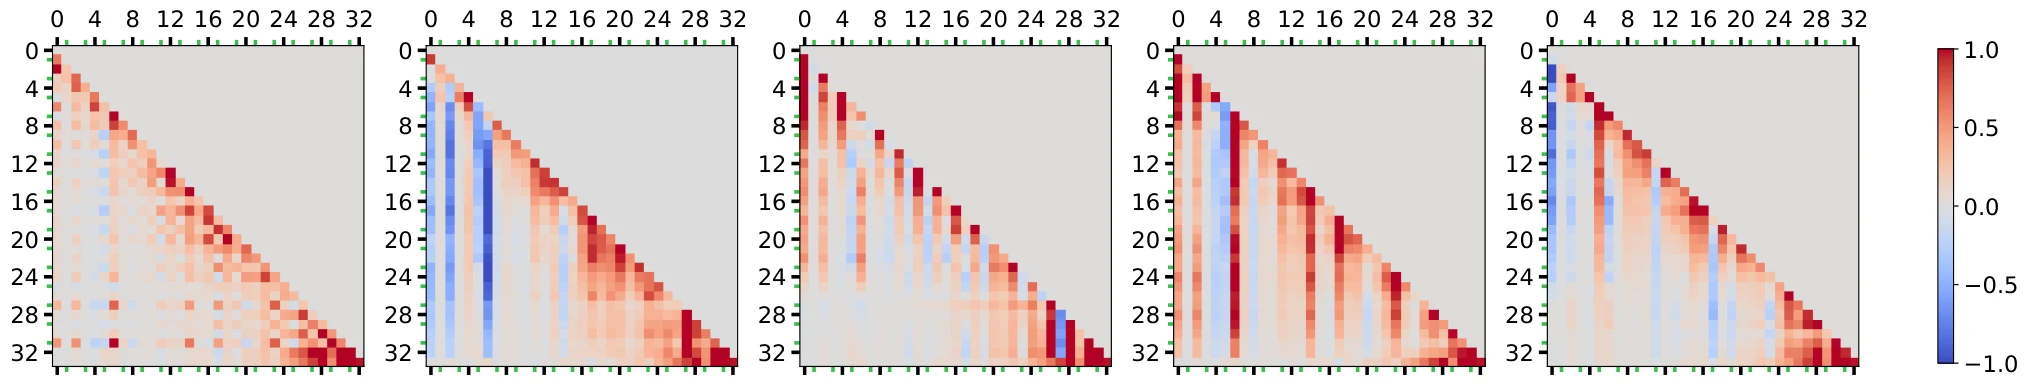
DHC×4 的矩阵明显更”满”:底层列持续发亮,近邻对角线也保持较强的贡献,二者叠成 形。浅层到深层的通路没有断,深层的局部增量也没有被均匀抹平。这就是 带来的结构差异,而不是简单的”参数更多所以更好”。
初始化、稳定性与训练动态
HC 的初始化策略值得单独说明,因为它决定了这套结构能不能在标准 Transformer 的训练配方下直接替换残差连接。
第一,动态投影权重 、、 初始化为 0,缩放因子 、 取很小的初值(论文附录取 量级)。因此训练第一步里 项和门控项都接近 0,DHC 几乎退化成静态 HC(SHC)。静态矩阵再按式 (14) 初始化。这样网络不会在初始化时就被随机的 token 路由打乱。
第二,静态矩阵按上一节的循环缓冲区方式初始化,使整个网络在初始化时等价于 Pre-Norm。这个等价性不是”近似”,而是逐层展开后成立的;两者至多相差一个由 决定的常数倍,而网络末端的归一化会吸收这个常数尺度。它保证了替换残差连接后初始 loss、初始梯度尺度都与基线一致。
第三,输出模块的初始化标准差也按扩展率做了缩放。最后要把 条流按行求和,如果完全不调整,求和结果的尺度会随 变化;论文用与 相关的因子把初始输出尺度拉回与基线一致,保证替换残差连接后初始 loss 不因流的数量而漂移。
在这三条初始化之下,论文报告 HC 在 1B 和 7B 模型上训练 500B token 没有出现 loss spike,而基线反而有若干次尖峰。这个稳定性不是来自某个正则项,而是来自”初始化锚定在已知稳定结构上,再逐步放开自由度”的设计。对推理系统来说,这意味着 HC 不是一个需要特殊训练技巧才能用的结构;它可以直接替换现有 Transformer 的残差连接,而不改变优化器和学习率配方。
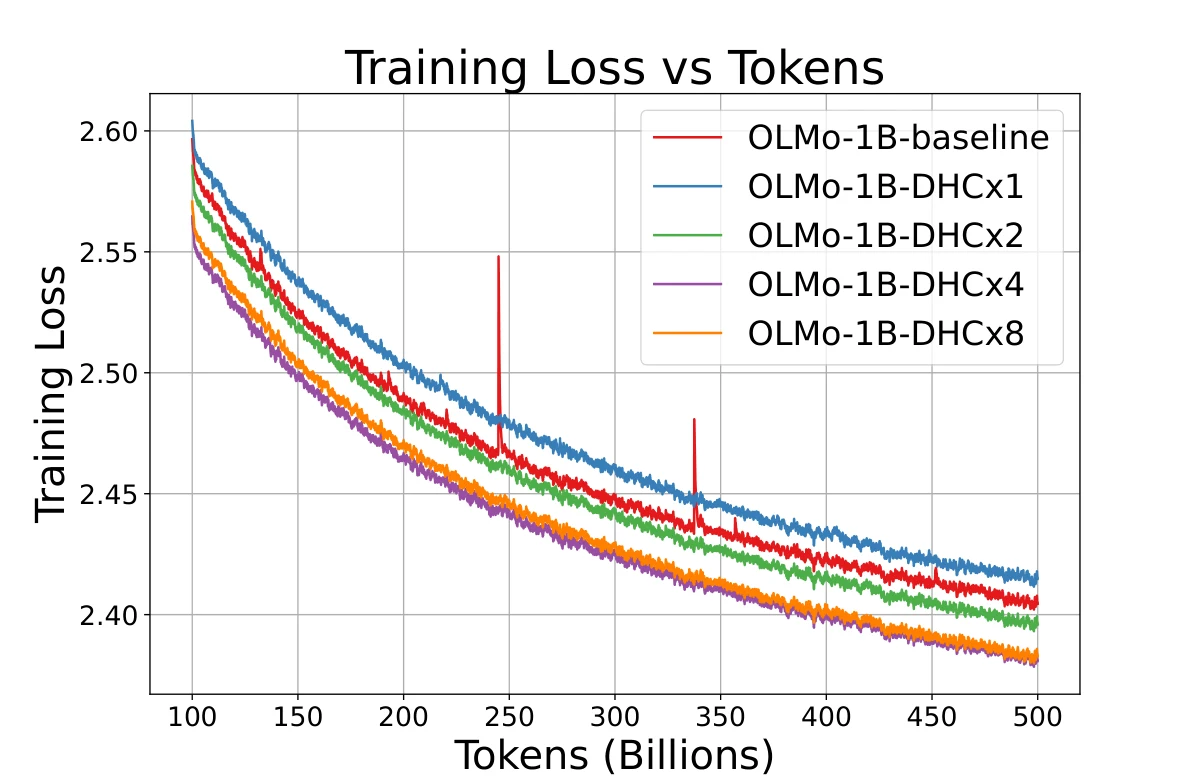
上图是论文 Figure 5 的损失曲线。左图比较不同扩展率的 DHC,右图比较带 tanh 与不带 tanh 的动态形式。曲线本身不是本文重点,重要的是它对应的机制: 的曲线明显高于基线, 开始超过基线, 与 的差距很小。这说明 HC 的收益主要来自”从单流变成多流”这一步,而不是无限制地加宽流; 已经覆盖了大部分可用的连接模式。
这里顺便纠正一个常见的误读:HC 的扩展率 不是”模型宽度乘以 “。层函数的输入仍然是 维,Attention 的 Q/K/V 投影、FFN 的中间维度都没有变;变宽的只有残差流的存储和流间混合。因此 HC 不会像单纯加宽 hidden size 那样把注意力计算量乘 ,也不会增加 KV Cache 的头数或层数。
与 Altup、ResiDual 的区别
HC 不是第一个试图”加宽残差通路但不增加太多计算”的工作。论文在同一套 OLMo 配置下复现了两个相关方法:Altup 和 ResiDual。
Altup 的做法是把隐藏状态扩成多份,但每层只把其中一部分送入 Transformer 块,其余部分通过预测/校正机制保留。它的目标是”用低计算成本加宽 hidden dimension”,本质上是把宽度维度切开分时使用。ResiDual 则用两条流分别承载 Pre-Norm 和 Post-Norm 的表示,试图同时保留两种归一化的优点;它把 hidden size 扩成两倍,但两条流之间没有 HC 那样的完整 混合矩阵。
HC 与它们的区别在于:HC 的 条流不是”把 hidden 切片”,而是”把残差历史分成多条车道”;每条流都保留完整的 维表示,流之间通过 做可学习的线性混合,层函数通过 从所有流中读出。HC 的连接矩阵是 的完整矩阵,包含了读出、写回、流间混合和跨层残差四个部分;Altup 和 ResiDual 的连接模式则更受限。论文的实验显示,这两种方法在训练早期有增益,但随后会被基线追上;HC 的增益则能持续到 500B token。这个差异的根源不是参数多少,而是连接矩阵的自由度是否足以表达”底层直达 + 近邻衰减”的复合模式。
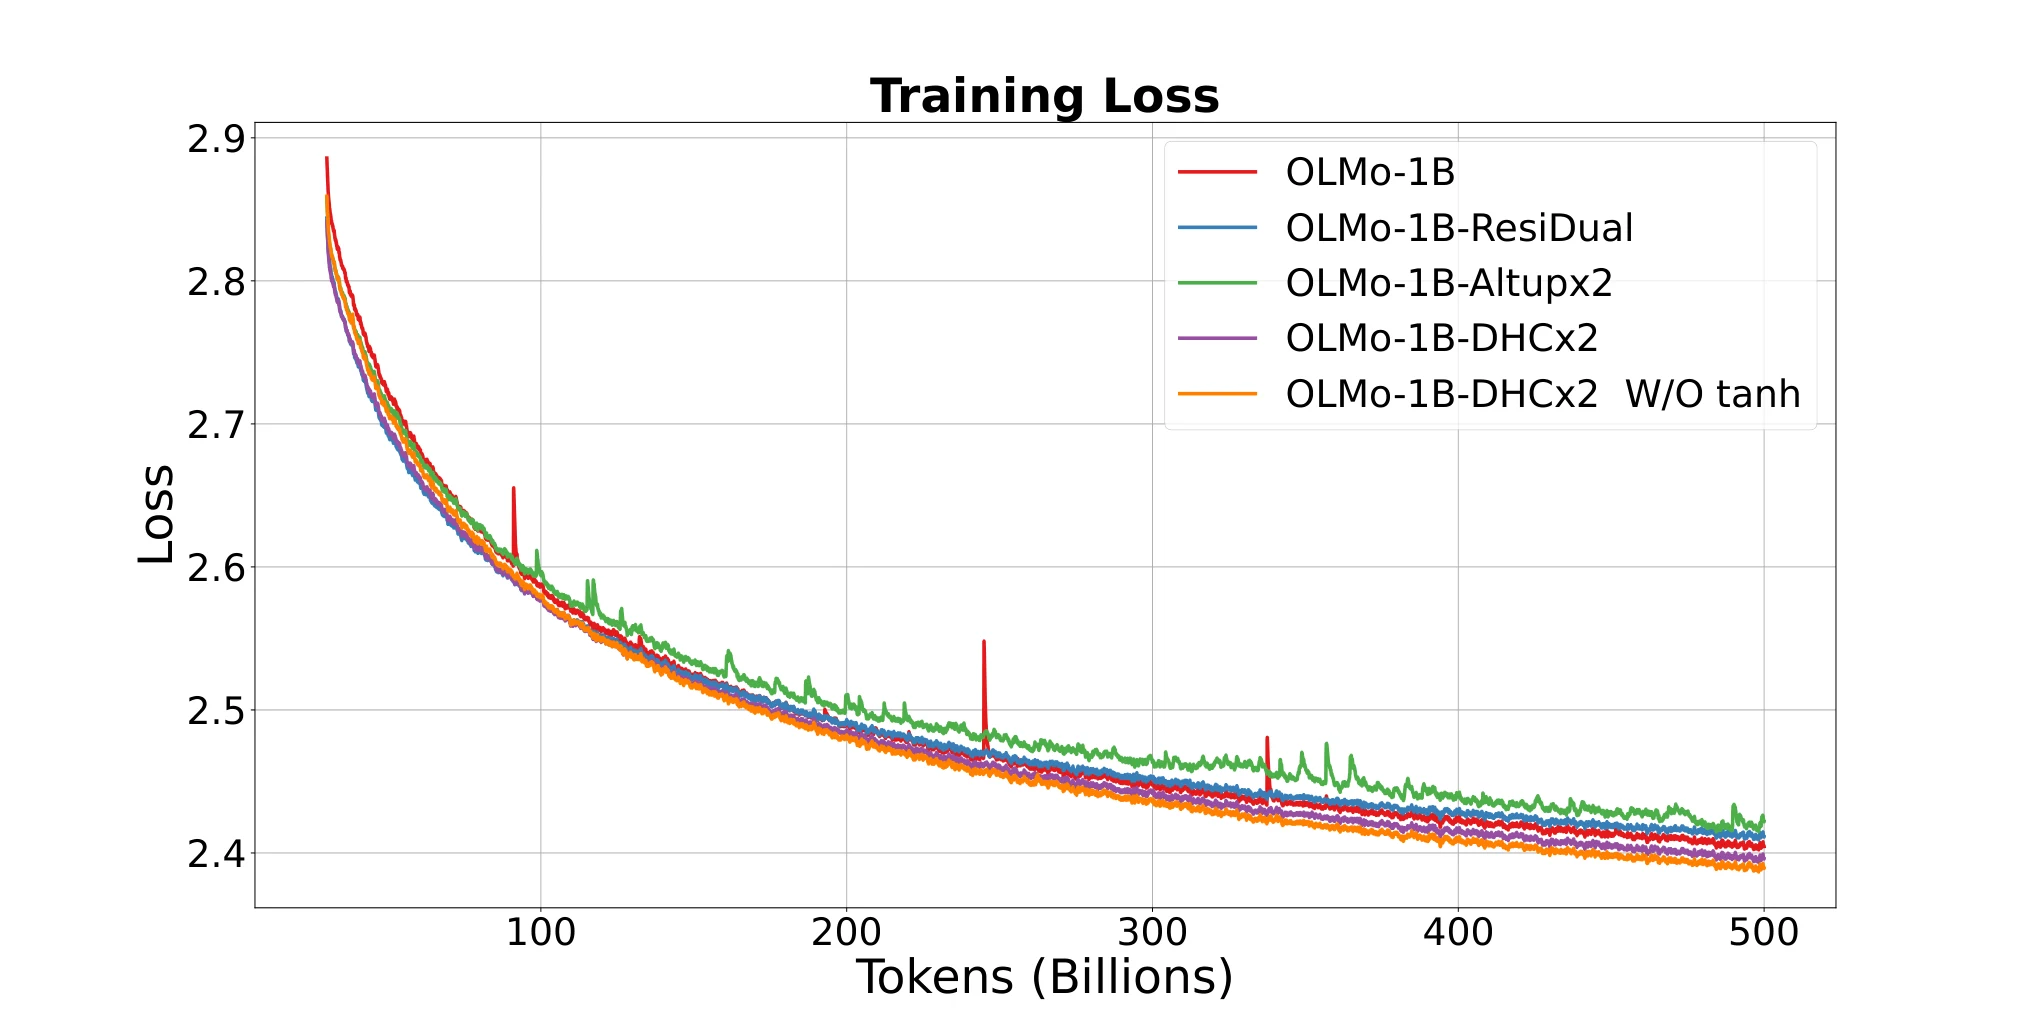
上图是论文 Figure 15 的相关方法对比曲线。可以看到 Altup 和 ResiDual 在早期一段区间内低于基线,但随着训练推进逐渐被基线反超;HC 的曲线则保持更低的损失。这个现象说明”加宽残差流”本身不够,关键是连接矩阵能否学到跨层的长程结构。
推理侧到底付出什么:显存、算力与 KV Cache
这一节从服务端视角把 HC 的代价拆开。很多架构论文只报告训练损失,推理工程师更关心的是:权重多占多少显存、每 token 多多少 FLOPs、KV Cache 会不会膨胀、batch 内能不能共享。
权重与 FLOPs
以 OLMo-1B 为例,DHC×4 的额外参数约 39.4 万,占总参数 0.033%;前向 FLOPs 增加约 0.0049 G,占 0.2%。对 7B 模型,DHC×4 的额外参数约 131 万,占 0.023%;FLOPs 增加约 0.0197 G,占 0.147%。这些数字说明 HC 不属于”用算力换质量”的重型结构,它的开销更接近一个常数项,而不是随模型规模增长的乘性项。
从 kernel 角度看,HC 的额外计算主要是:
- 读出:,一个 乘 的向量-矩阵乘,输出 维;
- 写回:,一个 乘 的外积,输出 ;
- 流间混合:,一个 乘 的小矩阵乘;
- 动态 HC 额外还有归一化和三个 乘 的小投影。
这些都是 elementwise/reduction 级别的操作,可以和前置的 RMSNorm、残差加法、量化反量化融合进同一个 kernel。真正需要新写的不是大 GEMM,而是”多流布局”下的读写:hidden state 从 变成 ,Attention/FFN 仍然按 维计算,所以需要在进入子层前做一次 gather/readout,在离开子层后做一次 scatter/writeback。这两步的带宽开销与 成正比,但只作用于激活值,不作用于权重。
KV Cache 不受影响
HC 不改变 Attention 的 Q/K/V 头数、头维度和层数,也不改变每层缓存多少 token。KV Cache 的大小仍然由 决定,与 无关。 条流只影响进入 Attention 前的隐藏状态布局,不影响 Attention 内部缓存的内容。这一点对长上下文服务很关键:HC 不会像增加层数或头数那样线性放大 KV Cache 压力。
激活显存与逐层释放
训练时,HC 会让每层的激活从 维变成 维,激活显存增加的比例大约是 倍中的一部分。论文给出的估算显示, 时额外激活显存占总量的比例很小,因为 Transformer 的激活大头是 Attention 的中间矩阵和 FFN 的中间维度,而不是残差流本身。推理时更简单:只需要保留当前层的超隐藏矩阵,进入下一层后前一层的 激活就可以释放;不像训练那样需要为反向传播保存所有层的激活。论文也指出,HC 的隐藏状态可以在前向结束后丢弃、反向时重算,进一步降低训练显存。
张量并行与通信
在张量并行(TP)下, 维被切分到多个 rank,每个 rank 持有 的流片段。 作用在流维度上,不跨 维,所以它是 rank 本地的,不需要额外 all-reduce; 是在每条流的本地 片段上求和,也不需要跨 rank 通信。换句话说,HC 的流间混合不会引入新的集合通信。这一点和”把 hidden size 加宽 倍”不同:后者会改变 TP 切分和通信量,HC 不会。
对调度的影响
静态 HC 的连接矩阵固定,可以把 、、 预先折叠进相邻的线性层或 norm kernel,推理图与标准 Transformer 几乎一样,只是多了一次 维的读写。动态 HC 需要每个 token 单独算矩阵,batch 内不能共享;但它的小 GEMM 可以按 token 并行,代价是额外的 kernel 启动和中间张量。对于 continuous batching 的服务,建议把动态 HC 的三次投影融合进一个 kernel,并把 的构造与后续的流混合合并,避免为每个 token 物化一个 矩阵。
HC 的局限与 mHC 的修正
原始 HC 的自由度既是优点也是风险。 是一个无约束的 矩阵,多层连乘后,流间的放大/衰减会累积:
如果 的特征值长期大于 1,深层激活会爆炸;如果长期小于 1,浅层信号会被压扁。原始论文在 1B/7B 的 500B token 训练中没有出现尖峰,但这不等于任意规模、任意扩展率下都稳定。DeepSeek 的 mHC 后来指出,在更宽、更深的设置里,无约束的残差混合会破坏跨层恒等映射,训练到一定步数后 loss 会失稳;解决方案是把 投影到双随机矩阵流形(非负、行和列和都为 1),让连乘的谱半径被约束在 1 附近,同时保留流间混合的表达能力。
这不是说原始 HC 的设计错了,而是说它的”完全自由”需要额外的约束才能扩展到更大规模。原始 HC 的价值在于把问题定义清楚:残差连接是一个 连接矩阵的特例,深度连接、宽度连接、顺序-并行排列都可以在这个矩阵里统一表达。mHC 是在这个定义之上加约束,而不是另起一套结构。
另一个局限是动态 HC 的 per-token 路由。它让不同 token 走不同的层间路径,理论上更灵活,但在服务端会带来 batch 内矩阵不一致的问题;同时,动态路由的收益是否抵得上额外的 kernel 开销,取决于具体模型和负载。静态 HC 的矩阵固定,更容易做编译期优化和并行重排,对推理系统更友好。
总结:HC 真正改变了什么
回到最初的问题:残差连接的瓶颈不是”加法”本身,而是加法的系数被结构写死。Pre-Norm 和 Post-Norm 各自选择跷跷板的一端,却都无法让网络自己决定每一层应该保留多少历史、写入多少新信息。HC 的做法是把这条单车道拆成 条流,用一个 矩阵同时控制读出、写回、流间混合和跨层残差;残差连接、Pre-Norm、Post-Norm 都成为这个矩阵在 时的不可训练特例。
这套结构带来三个新自由度:
- 深度连接:每条流可以有不同的残差强度,网络可以同时保留”底层直达”和”近邻衰减”两种模式;
- 宽度连接: 条流之间可以线性混合,层函数可以从一条流读出、把结果写到另一条流;
- 顺序-并行二象性:顺序排列和并行排列是同一个矩阵的不同取值,网络可以学出混合排列,甚至按 token 动态改变排列。
代价则小得出乎意料: 时参数增加不到千分之一,FLOPs 增加约 0.2%,KV Cache 完全不变;额外的激活显存和读写带宽与 成正比,但只作用于隐藏状态,不作用于权重。对推理系统来说,HC 更像一次”残差流的重新布局”,而不是一次”模型宽度的膨胀”。
如果要继续往下读,mHC 是这条线最自然的下一站:它保留了原始 HC 的矩阵形式,只对残差混合矩阵加了双随机约束,解决了无约束连乘的稳定性问题。站内的 mHC 完全拆解 已经从流形约束、Sinkhorn 投影和 61 层堆叠的角度把后续故事讲完;把这篇原始 HC 当作它的前置阅读,会更容易理解”为什么只约束 、为什么初始化必须等价于 Pre-Norm、为什么 不够”这些设计取舍。
参考资料
- Defa Zhu, Hongzhi Huang, Zihao Huang, Yutao Zeng, Yunyao Mao, Banggu Wu, Qiyang Min, Xun Zhou. Hyper-Connections. arXiv:2409.19606, 2024; v3 2025. https://arxiv.org/abs/2409.19606
- Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun. Deep Residual Learning for Image Recognition. CVPR 2016. https://arxiv.org/abs/1512.03385
- Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun. Identity Mappings in Deep Residual Networks. ECCV 2016. https://arxiv.org/abs/1603.05027
- Dirk Groeneveld, et al. OLMo: Accelerating the Science of Language Models. arXiv:2402.00838. https://arxiv.org/abs/2402.00838
- Niklas Muennighoff, et al. OLMoE: Open Mixture-of-Experts Language Models. arXiv:2409.02060. https://arxiv.org/abs/2409.02060
- Cenk Baykal, et al. Alternating Updates for Efficient Transformers. arXiv:2301.13310. https://arxiv.org/abs/2301.13310
- Shufang Xie, et al. ResiDual: Transformer with Dual Residual Connections. arXiv:2304.14802. https://arxiv.org/abs/2304.14802
- DeepSeek-AI. mHC: Manifold-Constrained Hyper-Connections. arXiv:2512.24880. https://arxiv.org/abs/2512.24880
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



