


deepseek-recipe 源码拆解(一):三种 API 协议如何统一成会话,再变成 DeepSeek 的 token
这份代码在推理栈里的位置
一个推理服务从外部看只有两件事:收下一段对话,吐出一段回答。但这两件事之间隔着一条很长、很容易被低估的转换链:HTTP 上的 JSON 是协议,模型吃进去的是一串 token,模型吐出来的又是另一串 token,而用户要的仍是 JSON。中间每一次转换都可能出错,而且错误的形态各不相同——prompt 少一个换行,模型行为就会变;特殊 token 被当成普通文本编码,工具调用就解析不出来;流式输出中的一个多字节字符被切在两块之间,前端就会看到乱码。
DeepSeek 官方开源的 deepseek-recipe 把这条转换链单独抽成了一个库。README 的第一句话就把边界写得很清楚:它把不同格式的 API 请求统一转换成 Conversation 结构,渲染成 DeepSeek 模型的 prompt,借助附带的分词器编码成 token ID,再把模型输出转换回对应协议的响应;模型推理、工具执行与 HTTP 传输由调用方提供。换句话说,它是一层”协议与表示”的基础设施,不是推理引擎,也不是 Web 服务器。
这个定位非常重要,因为它决定了很多设计。推理引擎关心的是 KV Cache、调度、批处理;recipe 关心的是同一段对话在不同 API 协议、不同模型版本、不同输入模态下,应该变成哪一个 token 序列,以及模型输出的 token 序列应该如何被还原成协议对象。前者是计算问题,后者是表示问题。表示层做错,计算层再快也没有意义。
本站已经拆过 DeepInfer 的 Python 前端如何把 LLM.generate 接到引擎(DeepInfer 源码拆解(二十七):Python 前端与 token 策略),也拆过 vLLM 的入口与引擎(vLLM 源码完全拆解(一):整体架构与模块全景)。那些文章关注的是”请求进入引擎之后”;本篇关注的是”请求进入引擎之前”和”输出离开引擎之后”。把这两段接起来,才是一条完整的服务链路:
HTTP JSON(Chat Completions / Responses / Messages) │ 协议适配 ▼Conversation(统一中间表示) │ 模板渲染 ▼RenderedPrompt(文本 + 特殊 token 区间 + 图像源) │ 分词 ▼token IDs ──► 推理引擎 ──► 输出 token IDs │ 流式解码 + 输出解析 ▼ 协议响应 JSON / SSE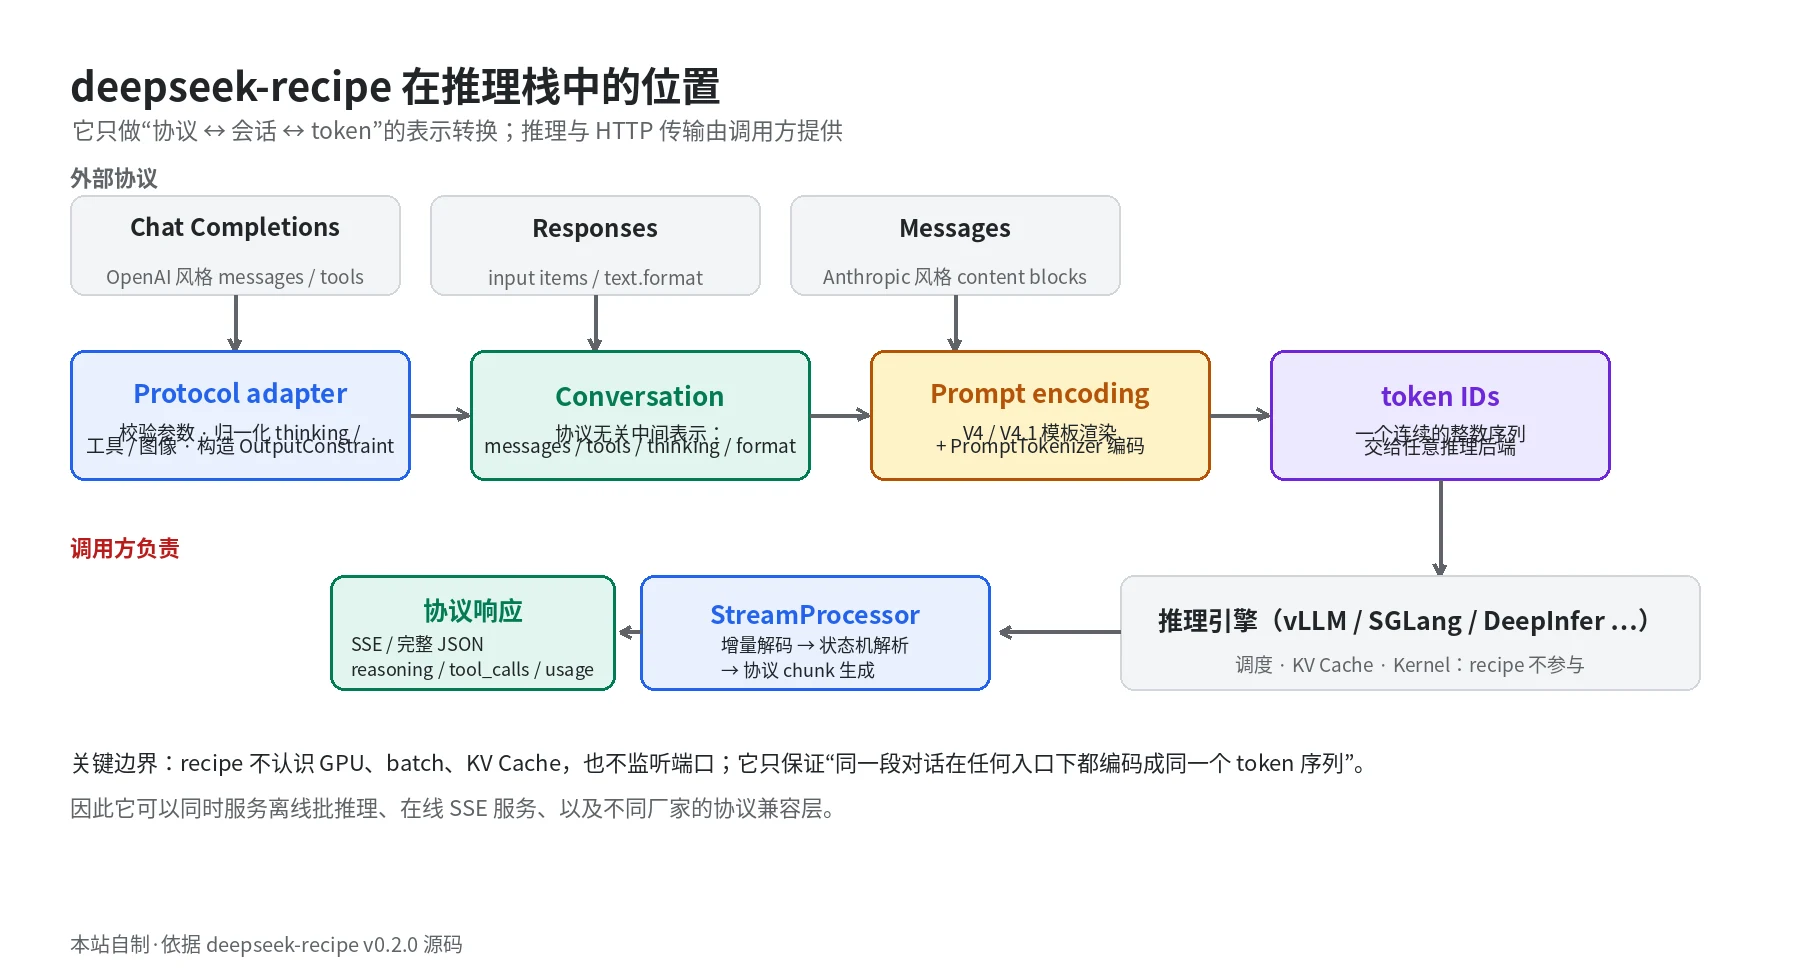
(图源:本站自制,依据 deepseek-recipe v0.2.0 源码的模块边界绘制。)
这张图里有一条容易被忽略的边界:recipe 不认识 GPU、batch、KV Cache,也不监听端口。它不关心后端是 vLLM、SGLang、TensorRT-LLM 还是 DeepSeek 自家的 DeepInfer;只要调用方把 token ID 交给后端,再把后端返回的 token ID 交回来,它就能工作。正因如此,它可以同时服务离线批推理、在线 SSE 服务,以及不同厂家的协议兼容层。代价是它必须把”协议差异”和”模型差异”都吃进自己的表示层,而这正是源码里最值得读的部分。
仓库地形:六个 crate 的职责边界
deepseek-recipe 不是一个单体工程,而是一组按职责切开的 Rust crate,外加一个 Python 绑定。理解目录结构,比逐行读代码更能先建立正确的心智模型。
| crate | 职责 | 关键类型 |
|---|---|---|
deepseek-recipe-core | 与协议、模型都无关的共享类型 | Conversation、InputMessage、Prompt、SpecialToken、ImageSource |
deepseek-recipe-encoding | V4/V4.1 的 prompt 渲染与 token 编码 | DeepseekV4Encoding、DeepseekV41Encoding、RenderedPrompt、PromptTokenizer |
deepseek-recipe | 协议转换、流式输出解析、响应生成 | ProtocolRequest、ConversationRequest、StreamProcessor、OutputParser |
deepseek-recipe-image | 图像下载、校验与预处理 | ReqwestImageFetcher、DestinationFilter |
deepseek-recipe-macros | 渲染模板用的 prompt! 宏 | PromptFragment、Special |
deepseek-recipe-python | PyO3 绑定 | deepseek_recipe Python 包 |
依赖方向是单向的:core 不依赖任何东西,encoding 依赖 core,主 crate 依赖 core 与 encoding,Python 绑定再包一层。这个方向决定了三件事:
第一,协议适配与模型渲染彼此解耦。Chat Completions、Responses、Messages 三个适配器只需要把各自的 JSON 变成 Conversation,不需要知道 V4.1 的模板长什么样;反过来,V4.1 编码器只认 Conversation,不关心请求是从哪个协议来的。新增一个协议,只需要写一个 ProtocolRequest 实现;新增一个模型版本,只需要写一个 PromptEncoding 实现。
第二,“渲染”和”编码”被拆成两个阶段。渲染输出的是 RenderedPrompt:一段字符串、一组特殊 token 的字节区间、以及按占位符顺序排列的图像源。编码则拿着这三样东西去调分词器。拆开的好处是:模板可以单独测试(直接断言渲染出的字符串),分词器可以被替换(测试里用真实 tokenizer,生产里也可以换成别的实现),而调试时能直接看到”模型到底收到了什么文本”。
第三,图像处理是可选依赖。deepseek-recipe-image 单独成 crate,主库只定义 ImageSource 与 ImageInfo,不强制把 reqwest、OpenCV 拉进依赖树。这在小服务里很实用:只做文本推理的调用方可以完全不带图像栈。
值得单独说一句的是 deepseek-recipe 主 crate 里的 protocol/ 目录。它按协议分成 openai/chat_completion、openai/responses、anthropic/messages 三套,每套都包含 request schema、request convert、response schema、chunk generator。三套适配器共享 protocol/reasoning.rs、protocol/validation.rs、protocol/output_constraint.rs 等公共逻辑。读源码时先看这三份公共文件,再看具体适配器,会省很多时间。
三种协议如何统一:Conversation 是唯一的中间表示
1. ProtocolRequest 的契约
三个协议的请求类型都实现同一个 trait:
pub trait ProtocolRequest: 'static + Send + Sync { type Response: ProtocolResponse;
fn convert(self, options: ConversionOptions) -> Result<ConversationRequest, ConversionError>;
fn chunk_generator( request: &ConversationRequest, response_id: String, model: String, ) -> <Self::Response as ProtocolResponse>::ChunkGenerator;}这个 trait 只有两个方法,却把整条链路切得很干净:convert 负责”进来”,chunk_generator 负责”出去”。convert 的返回值 ConversationRequest 是整条链路的核心结构:
pub struct ConversationRequest { pub conversation: Conversation, pub inference_options: InferenceOptions, pub parsing_options: ParsingOptions, pub model_version: ModelVersion, pub stream: bool, pub response_options: ResponseOptions,}这六个字段几乎对应了后面所有模块的输入:
conversation交给编码器渲染;inference_options交给调用方去构造采样参数与约束解码;parsing_options交给StreamProcessor,决定输出怎么解析;model_version决定用 V4 还是 V4.1 的编码器;stream决定生成 SSE 还是完整响应;response_options记录协议特有的回显、工具命名、usage 等设置。
注意这里没有”HTTP 请求”或”引擎句柄”。整个结构是纯数据,可以序列化、可以跨线程传递、也可以在没有网络的环境里单测。这是它和 vLLM 的 OpenAIServingChat 那一层最本质的区别:后者与引擎对象、tokenizer、LoRA 管理器深度绑定,recipe 则刻意保持无状态。
2. InputMessage:把三种消息模型压成五种角色
Conversation 本体非常简单:
pub struct Conversation { pub messages: Vec<InputMessage>, pub thinking_mode: bool, pub tools: Vec<ToolDefinition>, pub tool_choice: ToolChoice, pub reasoning_effort: Option<ReasoningEffort>, pub response_format: ResponseFormat,}复杂度都在 InputMessage 上。它只有五种变体,却要覆盖三个协议的差异:
pub enum InputMessage { System { content: Prompt, image_sources: Vec<ImageSource>, tools: Option<Vec<ToolDefinition>> }, User { content: Prompt, image_sources: Vec<ImageSource> }, Assistant { content: String, reasoning_content: Option<String>, tool_calls: Option<Vec<ToolCall>>, prefix: bool, }, Tool { content: Prompt, image_sources: Vec<ImageSource>, tool_call_id: Option<String> }, LatestReminder { content: String },}几处设计值得展开:
- System、User、Tool 的内容是
Prompt,Assistant 的内容是String。 这不是随意的类型不一致。System/User/Tool 的内容可能包含图像占位符,占位符必须作为特殊 token 保留;而 Assistant 的历史内容只需要识别少量 grounding 标记(<|ref|>、<|box|>等),其余按普通文本处理。用一个专门的Prompt类型来携带”特殊区间”,比在字符串里塞标记更可靠。 Assistant显式保存reasoning_content与prefix。 前者让 thinking 模式下的历史推理可以按模板决定是否渲染;后者支持 Chat Completions 的 prefix 续写——最后一条 assistant 消息不是”新的一轮”,而是”接着写”。Tool的tool_call_id是可选的。 不同协议对工具结果的关联方式不同:Chat Completions 有tool_call_id,Messages 用tool_use_id,Responses 用call_id。统一后保留为Option<String>,缺失时由渲染器按位置处理。LatestReminder是 DeepSeek 模板特有的角色。 它对应<|latest_reminder|>,用于在对话中插入”最新提醒”这类系统级提示。三个协议都没有这个角色,适配器只在特定字段(例如某些系统注入)里构造它。
ToolCall 也很克制:
pub struct ToolCall { pub id: String, pub name: String, pub arguments: String,}arguments 保持原始 JSON 字符串,不在中间表示层解析成结构化对象。原因是不同协议对参数的要求不同:Chat Completions 允许任意字符串,Messages 的 input 是对象,Responses 的 arguments 也是字符串。保持字符串可以让渲染器在需要时再解析,并在解析失败时走降级路径,而不是在协议转换阶段就把请求拒掉。
3. 协议差异在哪里被吸收
三个适配器的职责不是”把 JSON 字段改个名”,而是把各自的语义差异吸收掉。几个典型例子:
模型版本解析。 请求里的 model 字段通过 ConversionOptions::model_versions_by_name 映射到 ModelVersion。默认只接受 DeepSeek-V4-Pro 和 DeepSeek-V4.1-Flash;其他名字直接报错,并在错误信息里列出全部可接受的名字。这个设计把”模型别名”变成配置而不是硬编码,服务方可以用 with_model_alias 注册自己的对外模型名。
能力差异。 ModelVersion 提供 supports_image() 与 supports_mid_conversation_system()。V4 不支持图像,适配器会把每个图像块替换成文本 [Unsupported Image],而不是报错;V4.1 则生成图像占位符。这个选择很务实:同一个客户端可能同时打两个模型,静默降级比 400 更容易排查。
工具命名差异。 Responses 的 namespace 工具在 V4.1 里命名为 {namespace}::{name},在 V4 里是 {namespace}__{name}(如果 namespace 以 _ 结尾或 name 以 _ 开头,则直接拼接)。这类规则看起来琐碎,但一旦写错,模型看到的工具名和客户端声明的工具名就对不上,工具调用必然失败。
thinking 与 effort 的归一化。 三个协议对”思考”的表达各不相同:Chat Completions 有 thinking.type 与 reasoning_effort,Responses 有 reasoning.effort,Messages 有 thinking blocks。公共的 resolve_thinking_mode 把它们压成两个值:thinking_mode: bool 与 reasoning_effort: Option<ReasoningEffort>。映射规则是:
| 请求里的 effort | 归一化结果 |
|---|---|
none | 关闭 thinking |
minimal、low | Low |
medium、high | High |
xhigh | Xhigh |
ultra、max | Max |
显式的 thinking.type 优先于 effort:enabled 强制开启,disabled 强制关闭。都没有时走 default_thinking_mode,默认是开启。thinking 开启但没有声明 effort 时按 High 处理。这个”三优先级”的设计(thinking type > effort > 默认值)在三个适配器里是同一份代码,避免了三处各写一遍、三处各错一遍。
采样参数的模型相关默认值。 这部分很容易被忽略,但直接影响输出稳定性:
temperature在 thinking 模式下恒为 1.0;非 thinking 模式下取请求值,缺省 1.0。top_p在 thinking 模式下,V4.1 取max(requested, 0.95);V4 在带工具时固定 0.95,不带工具时固定 1.0。非 thinking 模式下,V4.1 固定 1.0,V4 取请求值。max_tokens的缺省值按模式分三档:非 thinking 8192,thinking 65536,thinking 且 effort 为max时 131072。
这三条不是”约定俗成”,而是模型侧的训练/对齐口径。把它们写进转换层,等于把”调用方不需要知道这些”变成一条保证。代价是 recipe 必须跟着模型版本升级;ConversionOptions 里的 model_versions_by_name、两个 max_tokens 上界、default_thinking_mode 都是为此准备的旋钮。
参数校验。 RawInferenceOptions::into_inference_options 按固定顺序检查:n 只能是 1;presence_penalty 与 frequency_penalty 在 [-2, 2];temperature 在 [0, 2];top_p 在 (0, 1];top_logprobs 必须在 logprobs=true 时使用且不超过 20;max_tokens 在 [1, upper_bound];seed 小于 2^63。顺序固定意味着错误信息也是确定的,客户端可以用同一套断言做回归。
4. Conversation 的规范化发生在渲染阶段,而不是转换阶段
一个容易误解的点:convert 返回的 Conversation 并不是”最终形态”。真正的规范化在 render_conversation 里做,具体包括:
- 连续 user 消息用空行合并;
- 连续
LatestReminder只保留第一条(后一条被丢弃); - 带
tool_call_id的 tool 结果,按前一条 assistant 消息里 tool call 的顺序重排; - 首条不是 system 且需要渲染工具提示或响应格式时,插入一条空 system 消息。
为什么不在转换阶段做?因为”是否需要工具提示”取决于 tool_choice 与 tools 的组合,而”是否需要响应格式”取决于 response_format;这些是模型模板的语义,不是协议语义。把它们放在编码器里,协议适配器就只需要忠实搬运,不用理解模板。这个分层在新增协议时尤其重要:新适配器不用重复实现排序、合并、插入 system 这些规则。
渲染:V4.1 的 prompt 到底是什么样
1. 先看整体形状
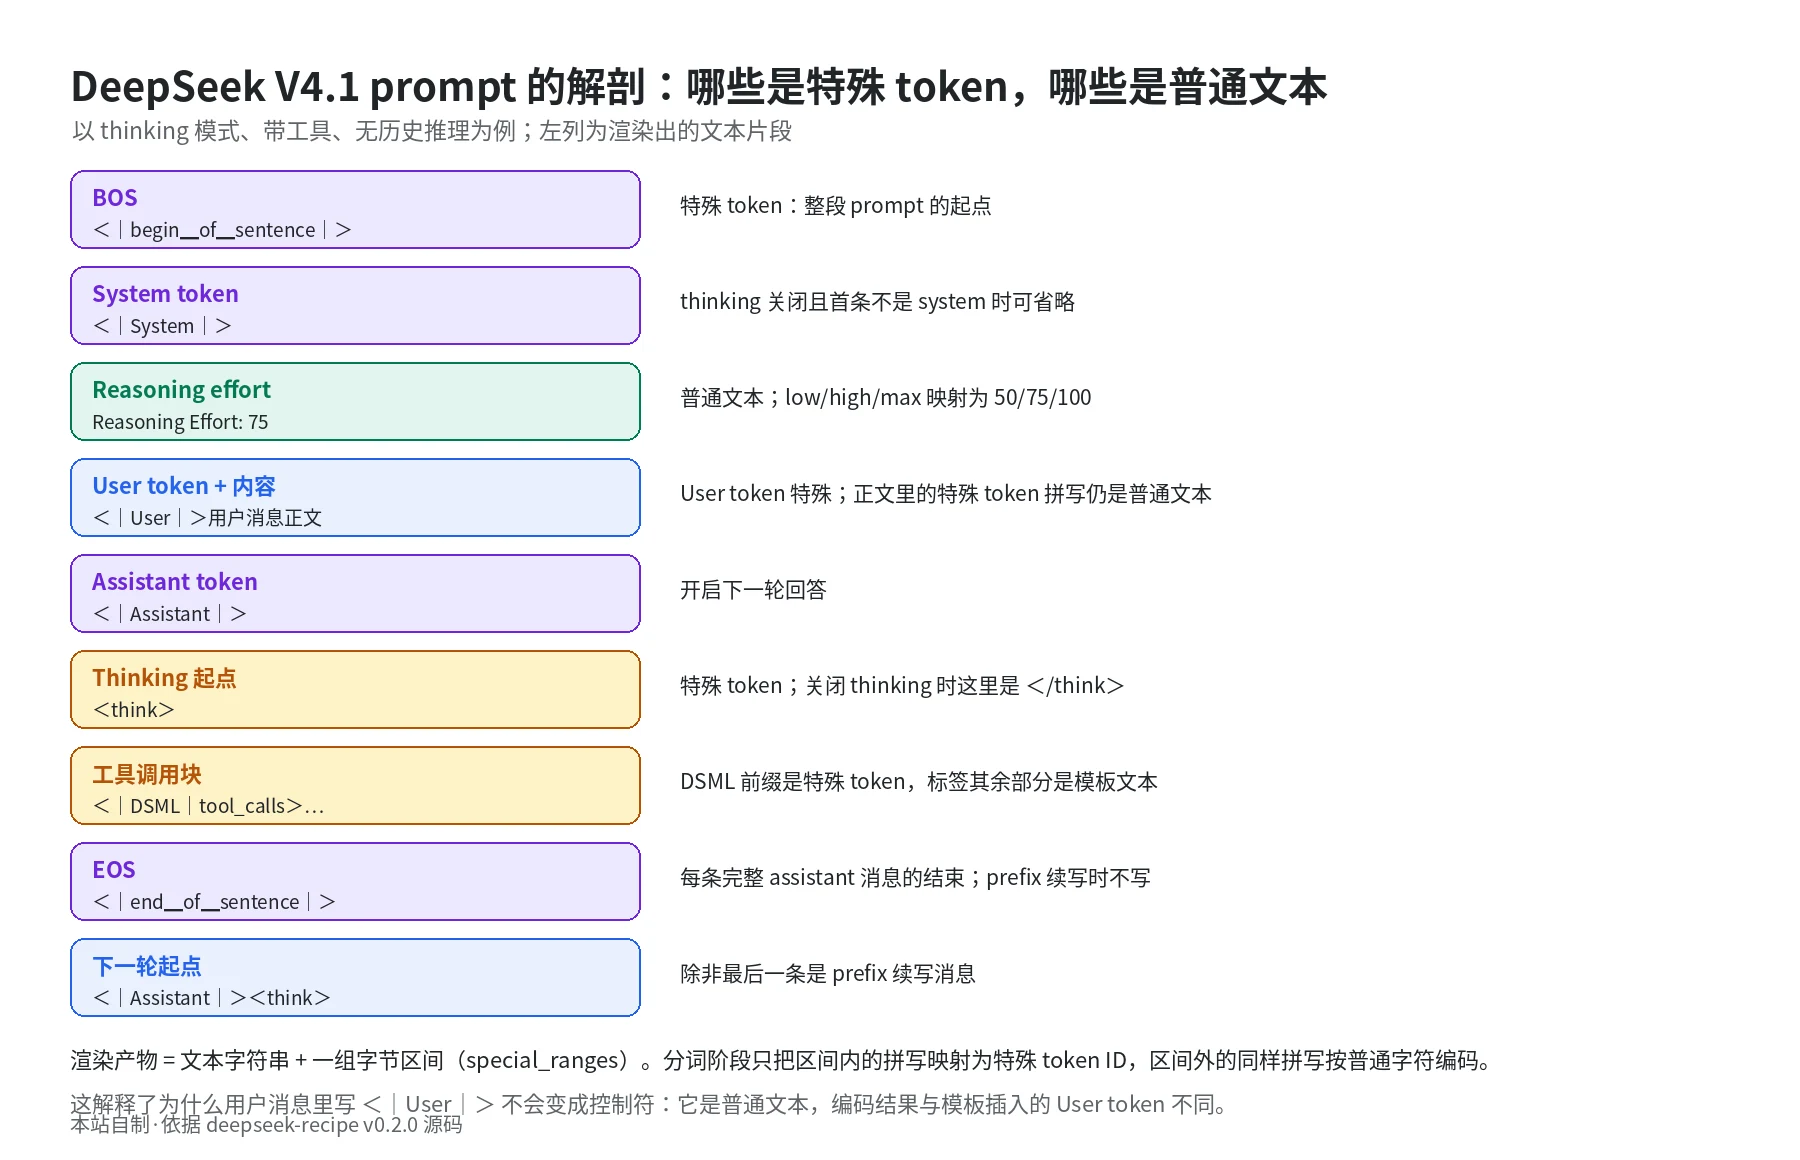
(图源:本站自制,依据 deepseek-recipe-encoding/src/v4/dsv41.rs 与 deepseek-recipe-core/src/special_tokens.rs 绘制。)
一个 thinking 模式、带工具、没有历史推理的请求,渲染结果大致是:
<|begin▁of▁sentence|><|System|>Reasoning Effort: 75 (range 1-100, the higher the value, the more thorough the reasoning)
<|User|>用户消息正文<|Assistant|><think>如果带工具,system 内容后面会追加一大段工具说明与 JSON schema;如果 tool_choice=required,结尾还会追加 |DSML|tool_calls 块的开头。tool_choice=auto 时,结尾就是 <|Assistant|><think>,由模型自己决定是否调用工具。
这里有两个细节值得强调:
第一,Reasoning Effort 不是特殊的元数据字段,而是实打实写进 prompt 的普通文本。 数值映射很直接:low 对应 50,high/未指定/xhigh 对应 75,max 对应 100。文本是 Reasoning Effort: {score} (range 1-100, the higher the value, the more thorough the reasoning)\n\n。这也解释了为什么 recipe 要把 effort 归一化成枚举:模板只认这四个档位。
第二,<think> 与 </think> 是特殊 token,不是普通字符串。 渲染时它们通过 Special 片段写入 Prompt,记录在 special_ranges 里;分词时会被映射为词表里的单个 token ID。模型在训练时见到的也是这些特殊 token,所以推理时必须严格对齐。
2. normalize_messages:三条容易被忽略的规则
render_conversation 的第一步不是渲染,而是 normalize_messages。它做三件事:
合并连续 user 消息。 两个相邻的 InputMessage::User 会被合并成一条,内容之间插入两个换行,图像源按顺序拼接。原因是模板里 <|User|> 是”一轮用户输入”的边界;如果连续出现两个 <|User|>,模型会把它理解成两轮,而不是一轮里的两段。Chat Completions 允许连续 user 消息,Messages 也允许,但 DeepSeek 模板要求合并。
丢弃连续的 LatestReminder。 只保留第一条。这个角色的语义是”最新提醒”,连续多条没有意义,保留第一条可以避免重复注入。
按 tool call 顺序重排 tool 结果。 这个规则最细。它只在”前一条 assistant 消息带 tool calls”且”后面紧跟一段 user/tool 消息”时生效:把这段里所有带 tool_call_id 的 Tool 消息取出来,按前一条 assistant 的 call 顺序排序,再放回原来的槽位;不带 id 的 tool 结果保持原位。匹配不到任何 call 的 id 排在最前。这样做的原因是:模板按顺序渲染 tool 结果,模型在训练时看到的顺序与 call 顺序一致;如果客户端乱序返回,模型可能把结果对应到错误的调用上。
3. system 消息的插入与工具提示
V4.1 的规则是:工具提示与响应格式都追加到第一条 system 消息的内容后面;如果第一条不是 system,就先插入一条空 system。
if renders_tool_prompt || response_format.is_some() { if !matches!(messages.first(), Some(InputMessage::System { .. })) { messages.insert(0, InputMessage::System { content: Prompt::new(), image_sources: Vec::new(), tools: None, }); } // 追加工具提示与 response format}renders_tool_prompt 的条件是 tool_choice != None && !tools.is_empty()。注意 tool_choice=None 时即使声明了工具也不渲染提示——这符合 OpenAI 的语义:none 表示”本轮不许调用工具”,模型不需要看到工具定义。
工具提示本身是一段模板文本,包含:
## Tools标题;- 一段 DSML 调用格式说明,含
<|DSML|tool_calls>、<|DSML|invoke name="...">、<|DSML|parameter name="..." string="true|false">的示例; string="true"与string="false"的语义说明;- thinking 模式下”先输出完整推理,再输出工具调用或最终回答”的约束;
### Available Tool Schemas与逐个工具的 JSON schema。
tool_definition_json 只保留三个字段:name、description、parameters。description 缺省为空字符串。这里没有把 strict 写进 prompt,因为 strict 是给约束解码用的,不是给模型看的。
历史 assistant 消息里的 tool calls 则由 render_tool_calls 渲染成 DSML 块:
|DSML|tool_calls|DSML|invoke name="get_weather"|DSML|parameter name="city" string="true">北京</|DSML|parameter>|DSML|invoke|DSML|tool_calls参数解析走 parse_tool_call_arguments:如果 arguments 是合法 JSON 对象,就按 key-value 逐个渲染;如果不是,就退化成单个 arguments 字符串参数,并打一条 warning。这个降级很重要:历史上可能有客户端传了非 JSON 的参数,直接报错会让整段对话不可用;退化成字符串至少能让模型看到原始内容。
4. thinking、历史推理与 prefix 续写
V4.1 对 assistant 消息的渲染规则比 V4 复杂,核心是三个布尔量:
thinking_mode:下一轮是否开启 thinking;renders_reasoning:这条历史 assistant 消息是否渲染它的 reasoning content;prefix:这条消息是否是”续写”,而不是完整的一轮。
renders_reasoning 的条件是 thinking_mode && index > 0 && (!drop_thinking || prefix)。drop_thinking 的定义是 !renders_tool_prompt:只有在渲染工具提示时,才保留历史 assistant 的 reasoning content;没有工具时,历史推理被丢弃。
为什么?工具调用场景下,模型需要看到”上一轮为什么调用这个工具、参数是怎么来的”,否则它无法正确续接多步工具链;普通对话场景下,历史推理对下一轮帮助不大,保留反而会增加 token 与干扰。这个取舍不是拍脑袋,而是 DeepSeek 模型训练时的数据组织方式决定的。
prefix 的处理更细:
- 如果最后一条 assistant 消息带
prefix=true,渲染时不写 EOS,也不追加下一轮的<|Assistant|><think>; - 如果 reasoning 为空、content 为空、也没有 tool calls,reasoning 块不写
<think>的闭合标记,让模型从推理中间继续写; - 如果 reasoning 为空但有 content 或 tool calls,正常闭合 reasoning 块,再写 content / tool calls。
这对应 Chat Completions 的 prefix 续写语义:客户端把”已经生成了一半的 assistant 消息”传回来,要求模型接着写。模板必须让 prompt 恰好停在”半句话”的位置,不能多一个 EOS,也不能多一个 assistant 起始标记。
5. 响应格式与结构化输出
ResponseFormat 有四种:Text、JsonObject、JsonSchema、Regex。渲染规则是:
Text与Regex不写进 prompt;JsonObject写入{"type": "json_object"};JsonSchema写入原始 schema。
写法是追加到第一条 system 内容后面:
## Response Format:
You MUST strictly adhere to the following schema to reply:{schema}这里有一个值得注意的分工:schema 写进 prompt 是”告诉模型”,不是”强制模型”。真正的强制由调用方的约束解码完成。recipe 在 InferenceOptions::output_constraint 里给出 Json { schema }、Regex、ToolCalls { tools, required } 三种约束描述,但是否执行、怎么执行,由后端决定。这个边界在 docs 与源码注释里反复出现,是理解整个库设计的关键。
6. V4 与 V4.1 的模板差异
V4 不是 V4.1 的简单子集。dsv4.rs 里有几处结构性差异:
- V4 不写
<|System|>,system 消息会被”提升”到开头并按空行拼接; - V4 不渲染 reasoning effort;
- V4 的历史 tool calls 与 tool 结果按
id排序,而不是按 call 顺序; - V4 不支持图像,图像块被替换为
[Unsupported Image]; - V4 不渲染 mid-conversation system,system 消息会被搬到最前面。
这些差异说明”一个模板打天下”是不成立的。recipe 把 V4 与 V4.1 分成两个编码器,共享 EncodingComponents 与部分辅助函数,但模板主体各自实现。这个选择会增加代码量,却换来一个好处:模板可以逐版本冻结,升级模型时不会意外改变旧模型的 prompt。
编码:special_ranges 为什么必须存在
1. 一个反例:如果直接把整段 prompt 丢给分词器
假设渲染结果是:
<|begin▁of▁sentence|><|User|>你好,请解释 <|User|> 这个标记用户的正文里也写了 <|User|>。如果直接用带 added vocabulary 的分词器编码整段字符串,两个 <|User|> 都会被识别为控制 token,模型会以为这里出现了两轮用户消息。实际语义是:第一个是控制符,第二个是用户文本。
这不是假设。任何允许用户输入任意文本的 API 都会遇到这个问题:用户可能讨论特殊 token、可能粘贴模型输出、可能在 prompt 里注入控制符。如果编码层不区分”模板插入的特殊 token”与”用户文本里的同样拼写”,就会产生 prompt injection 式的语义错位。
2. Prompt 的表示:文本 + 区间
Prompt 的定义非常直接:
pub struct Prompt { text: String, special_ranges: Vec<Range<usize>>,}push_special 追加一段文本并把它的字节区间记下来;push_plain 只追加文本。所有渲染操作最终都在维护这两个字段。prompt! 宏让模板写法接近格式化字符串,但每个片段会按类型分派:str 与 String 走 push_plain,Special 走 push_special,嵌套的 Prompt 会把自己的区间整体平移后合并进来。
Prompt::split_off 还有一个不常见的语义:如果切点落在一个特殊 token 的区间内部,这个特殊 token 会在两半里都退化成普通文本。这个函数目前主要用于把 prompt 切成前缀/后缀的场景;它明确选择了”宁可失去特殊语义,也不产生半个 token 区间”。
3. PromptTokenizer:两份词表
PromptTokenizer::new 做了一件关键的事:克隆一份 tokenizer,然后把 added vocabulary 清空。于是它持有两份东西:
pub struct PromptTokenizer { plain_tokenizer: Tokenizer, // 没有 added vocabulary added_vocabulary: HashMap<String, u32>, // 特殊 token 拼写 → ID}编码时:
- 按
special_ranges把文本切成”普通区间”与”特殊区间”; - 所有普通区间合成一个 batch,用
plain_tokenizer.encode_batch_fast一次性编码(tokenizers库可以并行); - 每个特殊区间直接用
added_vocabulary查 ID; - 按原顺序把普通 token ID 与特殊 ID 拼接起来。
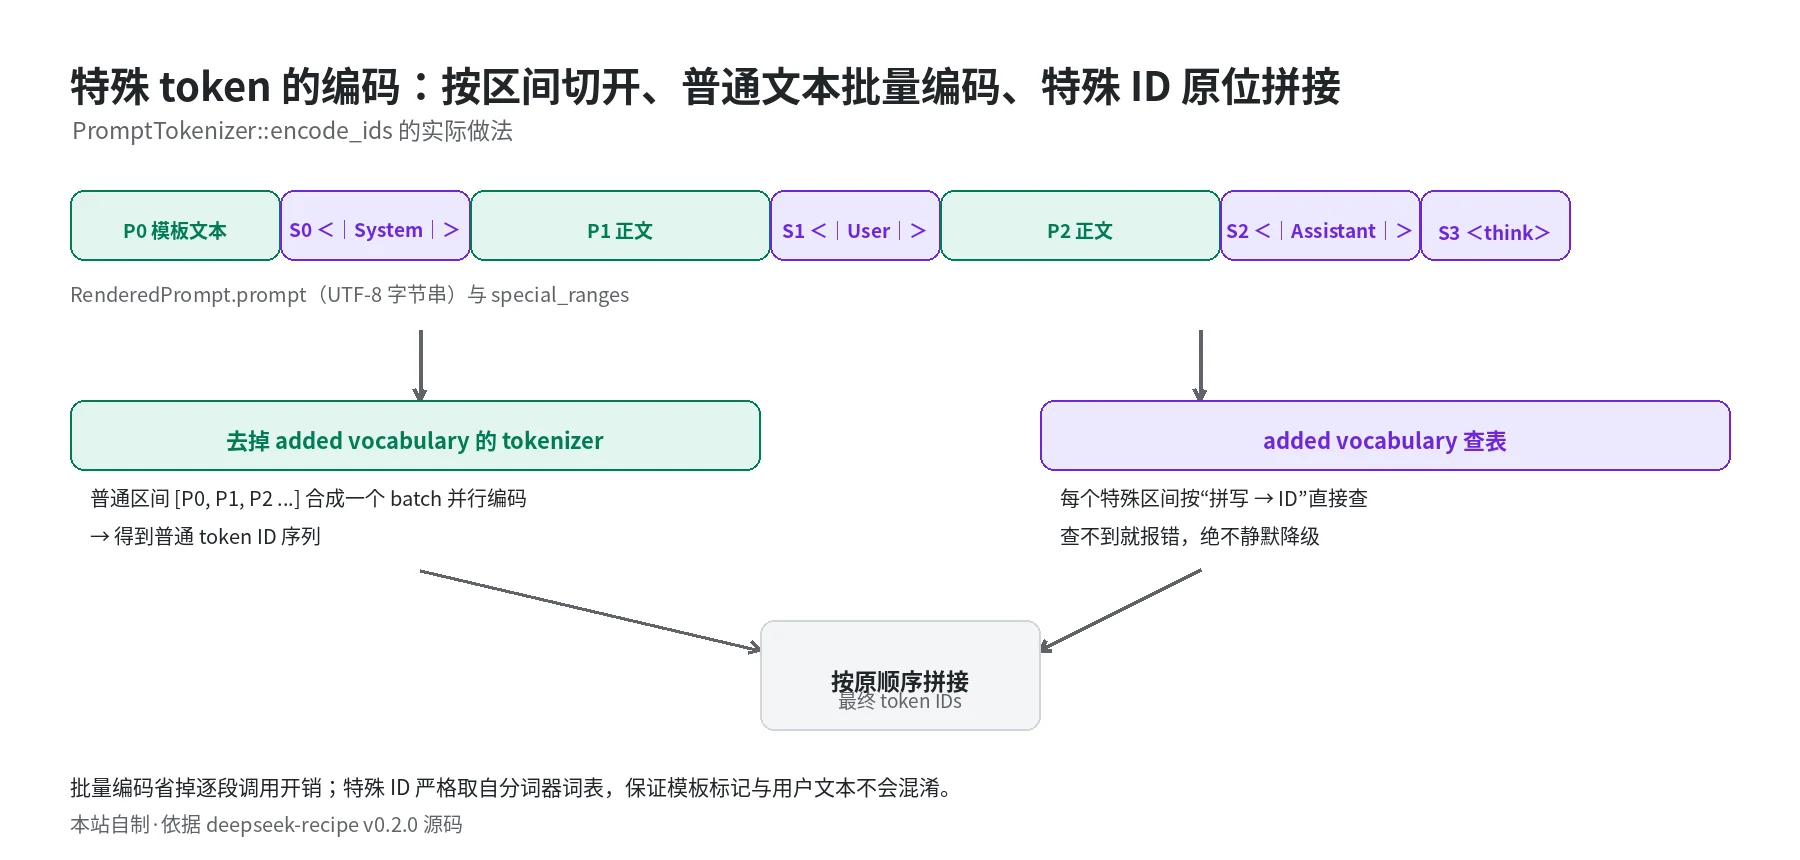
(图源:本站自制,依据 deepseek-recipe-encoding/src/tokenizer.rs 绘制。)
这个实现有几个值得注意的工程点:
- 普通区间批量编码,而不是逐段调用。
encode_batch_fast会把多段文本一起送进 tokenizer 的并行路径;对于长 prompt,这比逐段encode快得多。代价是内存里要同时持有所有区间的编码结果,但相对推理耗时可以忽略。 - 特殊区间查表失败必须报错。 如果模板写了一个 tokenizer 词表里没有的特殊 token,
special_token_id返回EncodingError::Encode,而不是静默降级。原因是模板与 tokenizer 必须严格配套;静默降级会让模型收到错误的控制符,后果比直接失败更难排查。 - 不额外加 BOS。 文档明确要求
TokenizerEncoder不得添加 BOS 等额外 token,除非文本本身编码出它们。BOS 已经由模板写入<|begin▁of▁sentence|>,分词器再加一个就会重复。 - tokenizer 不能配置 padding。 如果 tokenizer 带 padding,
encode_batch_fast会在短区间后面补 pad token,拼接后的序列就错了。这是一个隐含契约,源码注释里写得很清楚。
4. 图像占位符与 token 数修正
多模态请求的编码有一个容易被低估的细节:prompt 里每个图像只占一个占位符 token,但模型实际消耗的图像 token 数远不止 1。
MultiModalData::image_token_adjustment 计算的是”实际图像 token 数减去占位符数”的总和。V4.1 的图像规格是:
- patch 大小 14 像素;
- 空间下采样倍率 3;
- 单图最多 1024 个 token;
- 面积小于
544 × 544的图像会先上采样。
resolve_max_tokens 在计算上下文余量时,用的是”编码后的 token 数 + 图像修正值”,而不是直接用编码长度。否则一张 1024 token 的图会被当成 1 个 token,max_tokens 会被高估,最终请求可能超出上下文。
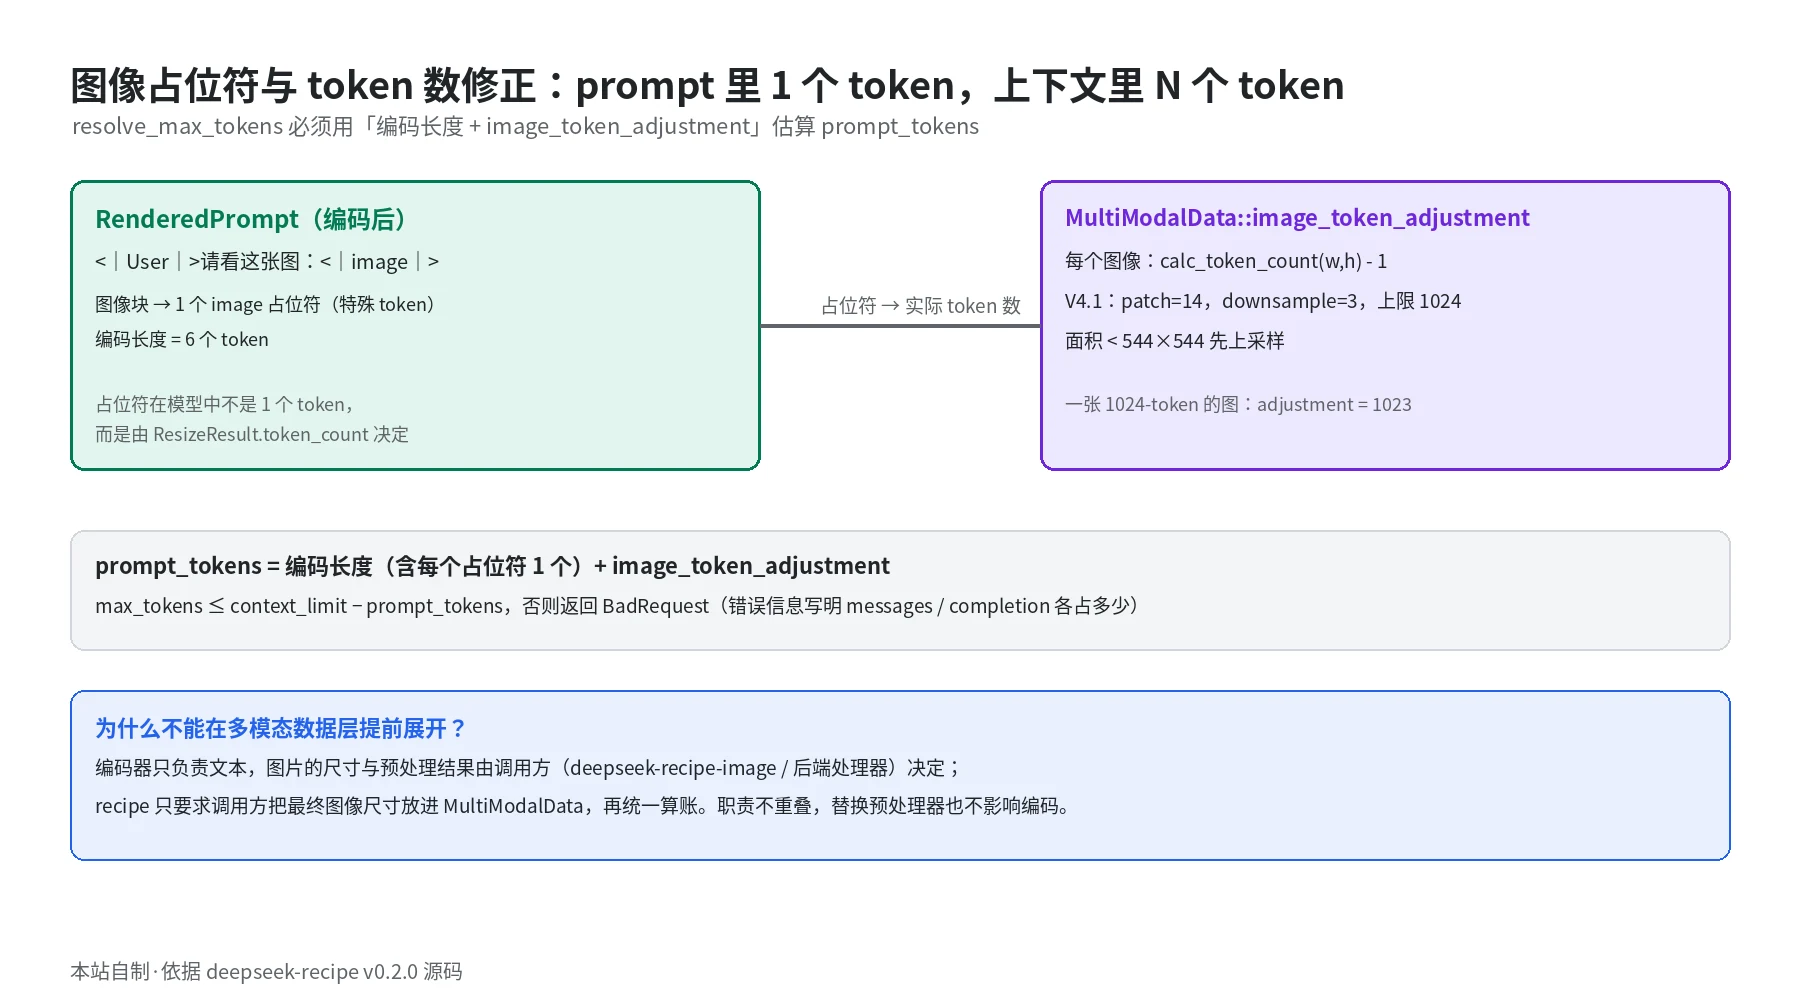
(图源:本站自制,依据 deepseek-recipe-core/src/multimodal/mod.rs 与 deepseek-recipe-core/src/multimodal/token_spec.rs 绘制。)
max_tokens 的解析规则可以写成:
其中 default 按模式取 8192 / 65536 / 131072,最后还要 max(1)。如果 prompt_tokens + requested 已经超过上下文,直接返回 BadRequest,错误信息里会带上 prompt 与 completion 各自占了多少 token。这个错误信息是 OpenAI 兼容层的标准格式,客户端可以直接展示。
输出侧:从 token ID 回到协议对象
1. 为什么输出解析比输入渲染更难
输入侧是”确定性的模板拼接”:给定 Conversation,渲染结果是唯一的。输出侧则要处理三类不确定性:
- 模型可能输出任何东西:正常回答、带 reasoning 的回答、工具调用、JSON、格式错误的半截工具调用、重复的
</think>、在 content 里写出特殊 token 的字面拼写; - 流式输出按 token 到达:一个多字节字符可能被切在两个 chunk 之间,一个标记可能被切在三个 chunk 之间;
- 协议对输出的形状有要求:Chat Completions 要
delta.content/delta.reasoning_content/delta.tool_calls,Responses 要 typed events,Messages 要 content blocks。
StreamProcessor 与 OutputParser 就是为这三件事设计的。前者负责”解码与缓冲”,后者负责”状态机与动作”。
2. StreamTokenizer 的四条契约
StreamProcessor 不直接依赖 tokenizers::Tokenizer,而是依赖一个更小的 trait:
pub trait StreamTokenizer: Send { fn decode_ids(&self, ids: &[u32], skip_special_tokens: bool) -> Result<String, String>; fn id_to_token(&self, _id: u32) -> Option<String> { None } fn count_tokens(&self, _text: &str) -> Option<usize> { None } fn is_special_token(&self, _id: u32) -> bool { false }}这四条方法的契约写得很细,值得逐条读:
decode_ids必须把不完整的 UTF-8 序列解码成 U+FFFD。 这样StreamDecoder才能通过”结尾是否是替换字符”判断字符是否完整;不完整的 token 会留在缓冲区,等下一个 chunk 补齐。skip_special_tokens=false时必须保留特殊 token 文本。 输出解析要靠这些文本识别</think>与 DSML 标签;如果解码时把它们丢掉,解析器就看不到标记。id_to_token返回 byte-level 词表字符串(例如Ġhi),供 logprobs 还原 token 的原始字节。is_special_token必须对 added vocabulary 里的所有 ID 返回 true。 这是”标记只在 token 边界生效”的基础。
3. StreamDecoder:按 token 边界切 pieces
decode_incrementally 的核心逻辑是:
for &id in token_ids { if self.tokenizer.is_special_token(id) { self.flush(true, false, &mut pieces)?; // 先把前面的普通 token 冲刷出来 self.push_id(id, logprob); self.flush(true, true, &mut pieces)?; // 特殊 token 单独成一个 piece } else { self.push_id(id, logprob); }}self.flush(false, false, &mut pieces)?;flush 的规则是:
- 如果缓冲区为空,直接返回;
- 解码缓冲区;如果结果为空,继续缓冲;
- 如果不是
force且结果以 U+FFFD 结尾,继续缓冲(说明一个多字节字符还没拼完); - 否则把这段文本作为一个
DecodedText输出,带上 token 数、logprobs、以及is_special_token标记。
特殊 token 之前先 flush(true, false) 是为了处理”普通 token 的最后一个字符还没拼完,但后面紧跟特殊 token”的情况:此时必须强制冲刷,哪怕结尾是 U+FFFD,否则特殊 token 会被永远卡在缓冲区后面。这个细节在测试 an_incomplete_character_before_a_special_token_is_flushed 里有覆盖。
4. OutputParser:用 KMP 匹配”带特殊标记的模板文本”
OutputParser 的状态机有九个 stage:
Content → Json → AfterJsonContent → ToolCalls → ToolName → ToolCallArguments → ToolCallArgumentName → ToolCallArgumentStringAttribute → ToolCallArgumentValueReasoning → ContentFinished每个 stage 有一组”匹配分支”和一个”未匹配时的动作”。匹配分支不是简单的字符串前缀匹配,而是带特殊标记的 pattern:
type Pattern = Vec<(u8, bool)>; // (字节, 是否属于特殊 token 段)例如 </think> 这个标记由两部分组成:普通文本 </ 与特殊 token think>?实际情况是 ThinkingEnd 整个拼写 <|/think|> 被当作一个特殊段;工具调用块的开头是普通 < + 特殊 |DSML|。匹配时,ChunkKind::SpecialToken 只能匹配 pattern 里 is_special=true 的字节,ChunkKind::PlainTokens 只能匹配 is_special=false 的字节,ChunkKind::Text 则两者都匹配(因为没有 token 边界信息)。
匹配算法是逐分支的 KMP。每个分支维护自己的 matched_len 与失败表;每来一个字节,依次尝试所有分支,第一个匹配成功的分支获胜(分支按优先级注册)。如果匹配长度小于已缓冲长度,说明前面有一段未匹配的文本,按当前 stage 的 action_on_unmatched 输出;匹配部分按 action_on_matched 输出;然后重置状态机到 next_stage。
这个设计的精妙之处在于部分匹配的保留:如果输入是 <|/thi,没有任何分支完全匹配,但 </think> 分支的 matched_len 可能是 5;这段字节不能被当成 content 输出,必须留在缓冲区等下一个 chunk。buffered_len 与 matching_len 的差值就是”可以安全输出”的部分。
5. 从 DSML 到 JSON arguments
输出侧最复杂的转换是工具调用。模型输出的是:
|DSML|tool_calls|DSML|invoke name="get_weather"|DSML|parameter name="city" string="true">北京</parameter></invoke></|DSML| calls>协议要的是:
{"get_weather": {"city": "北京"}}OutputParser 在 ToolCallArguments stage 里维护 is_first_argument,通过 ArgumentsLabel 逐个写出 JSON 标点:
- 第一个参数前写
{(ObjectOpen); - 后续参数前写
,(ArgumentSeparator); - 参数名与值之间写
:(KeyValueSeparator); string="true"的值前后各写一个"(StringOpen/StringClose);string="false"的值原样写出;- 空参数时写
{},非空时写}。
这里有一个很细的坑:StringOpen 与 StringClose 写出的文本都是 ",但它们是不同的 ArgumentsLabel 变体。原因是 PendingOutput 会合并相邻且 action 相同的 segment,并在每个 segment 的第一个 piece 上写 label;如果两个引号用同一个 action,中间的空字符串值会导致两个引号被合并成一个。源码里专门注释了这一点:
The variants that write equal text,
StringOpenandStringClose, remain distinct actions. The stream processor merges adjacent segments with equal actions and writes a label once per segment, so an empty string value needs two distinct actions to produce both of its quotes.
这类”看起来多余、实际必须”的设计,只有把流式输出与增量 JSON 拼接放在一起看才能理解。
PendingOutput::take_piece 还负责把转义后的参数值写进 JSON。字符串参数走 escape_json_string,处理引号、反斜杠、控制字符;非字符串参数原样输出,由客户端自己保证它是合法 JSON 值。如果模型输出了非法 JSON(例如 string="false" 但值不是合法 JSON),这里不会报错,而是把原始文本直接拼进去;最终 JSON 解析失败由客户端承担。这是一个明确的取舍:流式解析器不负责 JSON 语法校验,只负责结构转换。
6. stop sequence、finish reason 与 usage
ParsingOptions::stop_sequences 是一组字符串。解析器在 Content 与 Json stage 注册每个 stop sequence 为字面量分支,命中后进入 Finished,并记录匹配到的文本。之后的所有输出都被 SkipInvalid { kind: ContentAfterFinished } 跳过。
finish reason 的判定顺序是:
- 如果命中 stop sequence,
StopSequence; - 否则看后端返回的 finish reason:
Stop且已经出现过 tool calls,判ToolCalls;Stop判Stop;Length判Length;ContentFilter判ContentFilter; - 后端没有返回 finish reason,判
EndOfStream。
注意第 2 步的 had_tool_calls_at_finish:它在后端 Finish 到达时记录”此刻是否已经有工具调用”,而不是在最终 flush 之后判断。原因是 flush 可能把最后一段缓冲解析成工具调用,如果用它来判断,会把一个本该是 Stop 的响应误判成 ToolCalls。源码注释把这个顺序写得很清楚。
usage 的计算有两个容易忽略的点:
- completion_tokens 按 piece 的 token 数累加,而不是按 chunk 数。 一个
Tokenschunk 可能被切成多个 piece(普通段 + 特殊 token),每个 piece 带自己的 token 数。 - reasoning_tokens 需要重新编码 reasoning 内容才能得到。 因为输出侧只有文本,没有”这段文本对应多少 token”的直接信息;
StreamTokenizer::count_tokens会把已输出的 reasoning content 重新编码计数。没有 tokenizer 时,Chat Completions 的 usage 省略completion_tokens_details,Responses 报 0。
7. 输出侧的”同一串字符,不同语义”
回头看标题里的那句话:token 边界决定”标记”还是”内容”。这在输出侧有一个非常直观的例子:
- 模型真的输出了特殊 token
</think>,解码器把它作为ChunkKind::SpecialToken交给解析器,解析器识别为”推理结束”,切换 stage; - 模型输出了普通 token 拼成的
</think>文本(例如用户在 content 里要求它复述这个标记),解码器把它作为ChunkKind::PlainTokens,pattern 匹配时is_special=true的字节不匹配,于是它作为 content 原样输出。
同一串字符,因为 token 边界不同,语义完全不同。这就是为什么 StreamTokenizer::is_special_token 的契约要求”added vocabulary 里的所有 ID 都返回 true”,也是为什么 OutputParser 要用 (字节, 是否特殊) 的 pattern 而不是普通字符串。
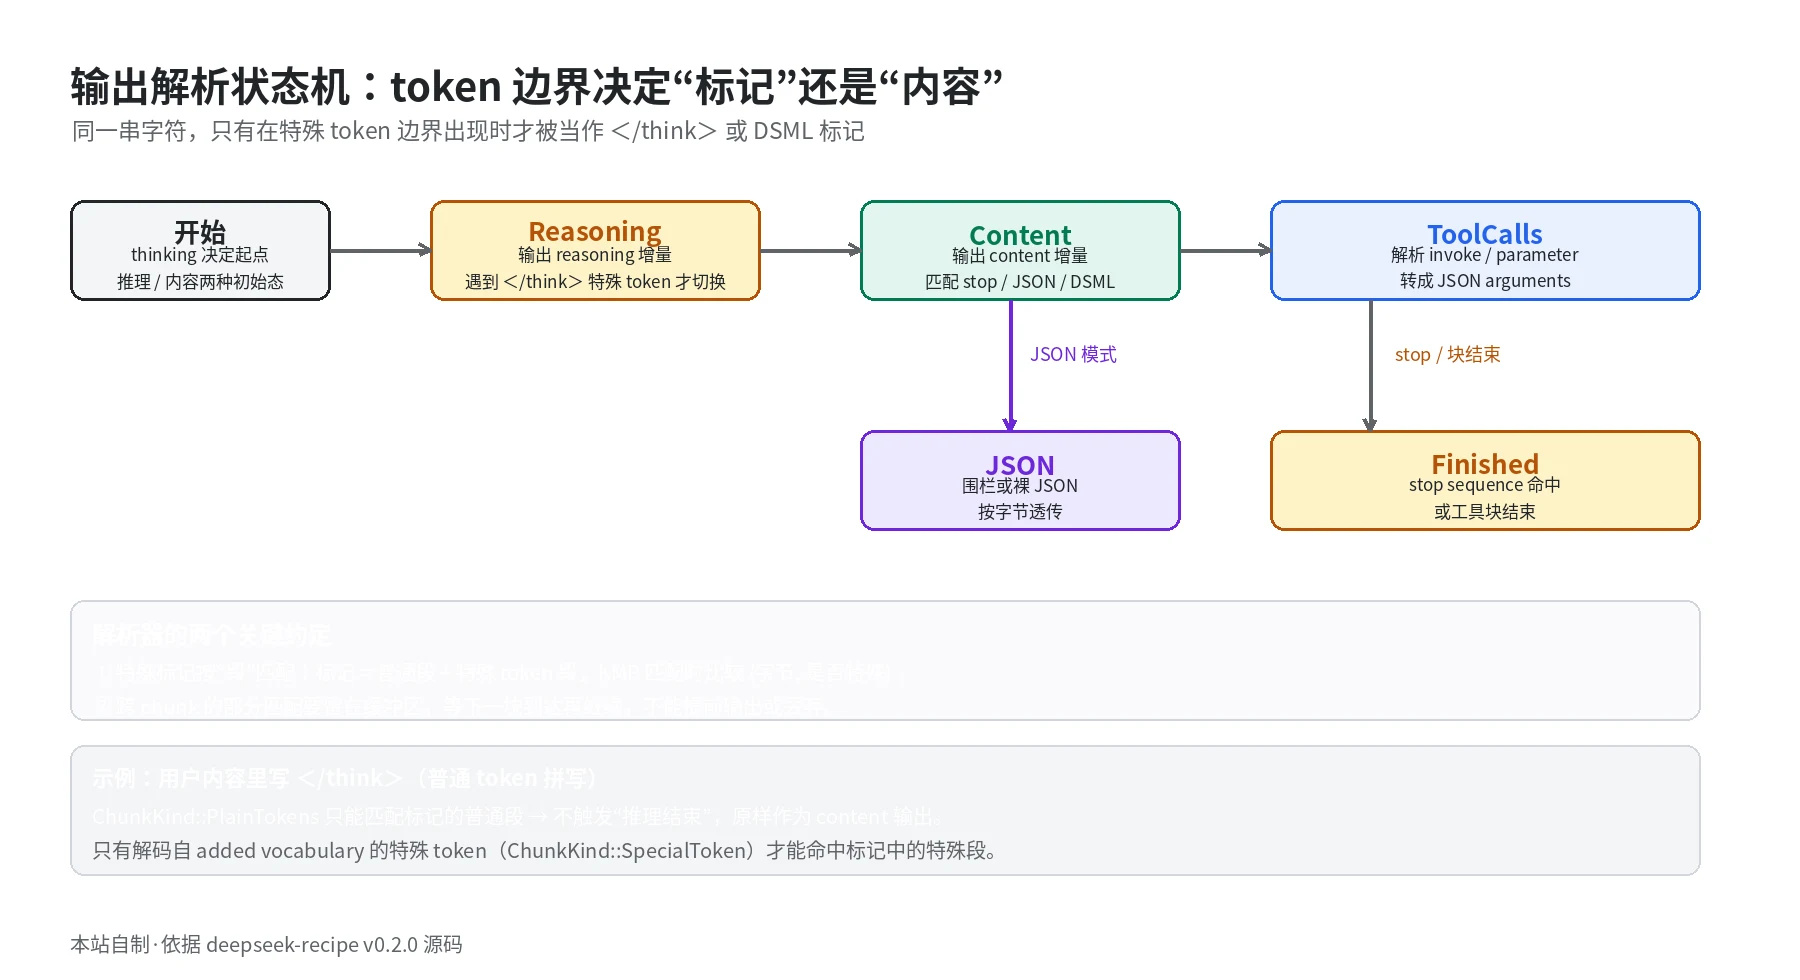
(图源:本站自制,依据 deepseek-recipe/src/stream/output_parser.rs 与 processor.rs 绘制。)
结构化输出:库只负责”描述约束”,不负责”执行约束”
1. OutputConstraint 的三种形态
InferenceOptions::output_constraint 是一个 Option<OutputConstraint>:
pub enum OutputConstraint { Json { schema: Option<serde_json::Value> }, Regex(String), ToolCalls { tools: Vec<ToolDefinition>, required: bool },}选择规则在 resolve_output_constraint 里:
- 有工具且
tool_choice != None:约束是ToolCalls;required为 true 表示至少一次调用;如果工具里混用了 strict 与非 strict,直接报错;如果全部 strict 且同时指定了response_format,也报错。 - 否则按
response_format:JsonObject→Json { schema: None };JsonSchema→Json { schema: Some(...) };Regex→Regex;Text→None。
这里的”strict 工具”指的是 OpenAI 的 strict: true。strict 工具要求 schema 满足更严格的约束:每个 object 的所有属性都必须在 required 里,additionalProperties 必须是 false。normalize_strict_schema 会做规范化:
- 把每个 object 的
required补成全部属性; - 把
additionalProperties设为false; - 拒绝
additionalProperties: true; - 拒绝
required里出现未知或重复属性; - 拒绝
required列表遗漏属性; - 对空 object 做特殊处理(允许无属性)。
这些规则的目的是让 schema 可以被约束解码器直接编译成状态机。约束解码(例如 xgrammar)需要一个确定的、无歧义的 JSON 语法;如果 schema 里有可选属性或额外属性,编译出的自动机会爆炸,或者无法保证”只输出合法前缀”。recipe 把规范化放在转换层,等于把”什么样的 schema 可以约束解码”这件事标准化了。
2. schema 进 prompt 与约束解码是两条路
同一份 JsonSchema 会走两条路:
- 原始 schema 写进 prompt,告诉模型”应该输出什么”;
- 规范化后的 schema 放进
OutputConstraint,交给后端做约束解码。
为什么要两份?因为约束解码可能改变输出分布,而 prompt 里的 schema 是模型理解任务的主要依据。只给约束不给 prompt,模型可能在 token 级别被”逼”出合法 JSON,但字段语义完全不对;只给 prompt 不给约束,模型可能输出带 markdown 围栏、带解释文字的”近似 JSON”。两条路一起走,才是稳定的结构化输出。
ResponseFormat::Regex 则只进约束,不进 prompt。源码注释写得很明确:rendering does not write it into the prompt。正则表达式的语义不适合用自然语言描述,写进 prompt 反而会让模型困惑;交给约束解码器执行更合适。
3. 流式 JSON 解析:识别,不校验
当 parse_json_output=true(Chat Completions 的 json_object 模式)时,OutputParser 会在 Content stage 注册两类 JSON 开头:
- 围栏:
```json\n或```\n; - 裸 JSON:
{或[。
命中后进入 Json stage,按字节透传,直到遇到 \n```` 进入 AfterJson。裸 JSON 的开头字符会作为 Label` 输出,因为它是内容的一部分。
注意这里只做”边界识别”,不做语法校验。原因还是流式:JSON 可能分几十个 chunk 到达,任何时刻都只是一个前缀,无法判断整体合法性。真正的校验应该由客户端在流结束后做,或者由约束解码在生成时保证。recipe 的职责是”把 JSON 部分准确地切出来”,不是”保证它是合法 JSON”。
和四个推理框架的前端是什么关系
把 recipe 放回推理框架的版图里,会看得更清楚:
| 框架 | 协议转换在哪里 | 模板/分词在哪里 | 结构化输出在哪里 |
|---|---|---|---|
| vLLM | vllm/entrypoints/openai/ | transformers tokenizer + chat template | guided_decoding + xgrammar/outlines |
| SGLang | sglang/srt/entrypoints/ | tokenizer + chat template | constrained_decoding |
| TensorRT-LLM | tensorrt_llm/serve/ | tokenizer + chat template | guided decoding + sampler |
| llama.cpp | tools/server/ | GGUF tokenizer + chat template | GBNF grammar |
| DeepInfer | Python 前端 + recipe | recipe 编码器 + tokenizer | recipe 约束描述 + 引擎执行 |
区别在于耦合方向。vLLM/SGLang/TensorRT-LLM 的协议层通常与引擎对象绑定:它们要拿 tokenizer、要查 LoRA、要访问调度器、要注册 metrics;recipe 则把这些都推到调用方,自己只做纯函数式的转换。这个设计让它可以被任意引擎复用,但也意味着调用方要自己完成”tokenizer 加载、模板选择、约束解码接入”这些粘合工作。
DeepInfer 的例子最能说明这种分工。DeepInfer 的 Python 前端负责 LLM.generate 到引擎的调用,tokenizer 与 chat template 的处理可以由 recipe 承担;引擎只认 token ID,不认 OpenAI 的 JSON。这样一来,同一个引擎可以同时服务 Chat Completions、Responses、Messages 三种入口,而不需要在引擎里写三套适配器。站内拆过的 DeepInfer 源码拆解(六):结构化输出与确定性 讲的是引擎侧如何执行语法约束;recipe 讲的是”约束从哪里来、长什么样”。两者正好接上。
同样的接法也适用于 vLLM 的 Guided Decoding 或 SGLang 的 采样与语法约束。recipe 不依赖任何一家引擎的 API,这是它最大的复用价值。
工程边界与代价
1. 无状态带来的三个好处与两个代价
好处很直接:
- 可测试:不需要起引擎、不需要 GPU、不需要网络,给定 JSON 就能断言渲染出的 prompt 与 token ID;
- 可移植:同一份转换逻辑可以放在网关、Sidecar、批处理脚本、甚至浏览器 WASM 里;
- 可组合:调用方可以只使用编码器、只使用解析器、或只使用协议转换,不必整套引入。
代价也很明确:
- 粘合工作交给调用方:tokenizer 要自己加载,图像要自己下载(或使用
deepseek-recipe-image),约束解码要自己接,HTTP 要自己写; - 模型版本要自己维护:每新增一个模型名,就要在
model_versions_by_name里注册;每换一个 tokenizer,就要确认 added vocabulary 里有模板用到的全部特殊 token。
这不是缺陷,而是定位。一个”什么都能做”的库,最终会变成另一个推理框架;recipe 选择只做表示层,把计算层留给引擎。
2. 模板与 tokenizer 的强耦合
PromptTokenizer 的两份词表设计,隐含了一个强耦合:模板里的特殊 token 拼写必须与 tokenizer 的 added vocabulary 完全一致。 如果模型升级后 tokenizer 改了特殊 token 的拼写,旧模板会直接报 EncodingError::Encode。这个失败是”响亮的”,比静默生成错误 prompt 好,但也要求升级流程里必须同时更新编码器与 tokenizer。
IMAGE_SPECIAL_TOKEN_ID = 129264 是另一个硬编码点。源码注释写得很清楚:覆盖 SpecialToken::Image 只改变拼写,不改变这个 ID;使用这个常量的调用方必须使用”把 image token 分配到同一 ID”的 tokenizer。这类常量在跨模型版本时最容易出问题,读源码时要特别留意。
3. 测试策略:把 prompt 当成 golden output
deepseek-recipe-encoding/src/v4/mod.rs 里的测试非常值得一读。它们不是”跑通就行”,而是直接断言渲染出的完整字符串:
assert_eq!( render(&conversation), "<|begin▁of▁sentence|><|System|>\n\n## Response Format:\n\nYou MUST strictly adhere...");这些 golden test 覆盖了:自定义 system token、V4 不写 system token、历史推理只在工具提示下渲染、连续 reminder 保留第一条、JSON schema 写进 system、regex 不渲染、V4 提升 system 消息、V4 按 id 排序 tool calls、prefix 续写、特殊区间只覆盖显式特殊 token、用户文本里的特殊 token 拼写按普通文本编码。
这种测试方式的价值在于:prompt 是模型的输入,任何一字节的变化都可能改变模型行为;只测”编码不报错”没有意义,必须测”编码成了什么”。升级模板时,golden test 会逼你逐条确认差异,而不是靠肉眼 review。
4. 已知的边界
- 不执行工具:recipe 只把工具调用解析成 JSON,工具执行与结果回填由调用方完成;
- 不校验 JSON:流式 JSON 只做边界识别,不保证语法合法;
- 不做 HTTP:SSE 的 chunk 格式、错误码、重试都由调用方处理;
- 不做训练侧:没有 loss、没有数据组织、没有 RL;
- 图像下载的 SSRF 风险:
ReqwestImageFetcher默认可以连接任意地址;从不可信请求里抓 URL 的服务必须装DestinationFilter,检查 host、解析出的每个地址、以及每次重定向的目标。
最后一条在源码的 README 与 changelog 里都单独强调过。它提醒我们:即使是”只做表示层”的库,只要碰了外部输入(URL),就仍然有安全边界。
小结
deepseek-recipe 的价值不在于它实现了某个复杂的算法,而在于它把一条容易被做错的链路拆成了可验证的几段:
- 协议适配:三种 API 的语义差异在
convert里被吸收,统一成Conversation;模型版本、thinking、effort、采样默认值、参数校验都在这一层完成。 - 模板渲染:V4 与 V4.1 各自维护模板,
Prompt用”文本 + 特殊区间”表示渲染结果,normalize_messages处理合并、排序、system 插入。 - 分词编码:
PromptTokenizer把普通区间批量编码、特殊区间查表拼接,保证用户文本里的特殊 token 拼写不会被误认为控制符;图像 token 数在max_tokens解析时被修正。 - 输出解析:
StreamDecoder按 token 边界切 pieces,OutputParser用带特殊标记的 KMP 匹配识别 reasoning、JSON、工具调用与 stop sequence;同一串字符是否成为标记,取决于它的 token 边界。 - 约束描述:schema 既写进 prompt,也规范化成
OutputConstraint交给后端;库只描述约束,不执行约束。
这五段里,任何一段做错,都会以”模型行为不对”的形式表现出来,而不是以”程序崩溃”的形式表现出来。这也是表示层最难调试的地方。recipe 用 golden test、明确的错误类型、以及”渲染产物可检查”的设计,把这种隐性错误尽量变成显性错误。
下一篇会继续读 StreamProcessor 与三个协议 chunk generator 的细节:同一份 OutputChunk 如何被翻译成 Chat Completions 的 delta、Responses 的 typed event、Messages 的 content block,以及 usage、logprobs、tool call 增量在三种协议里的不同形状。
参考资料
- deepseek-recipe 官方仓库
- deepseek-recipe crate 文档
- Use with tokenizer:RenderedPrompt、special_ranges 与 PromptTokenizer
- Streaming response:StreamProcessor 与协议 chunk 生成
- deepseek-recipe CHANGELOG 0.2.0:模型版本、结构化输出、prefix 续写与显式特殊 token
- vLLM 官方仓库
- SGLang 官方仓库
- TensorRT-LLM 官方仓库
- llama.cpp 官方仓库
- DeepInfer 官方仓库
- JSON Schema 2020-12 Core
- xgrammar:语法引导的解码库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



