


DeepInfer 源码拆解(二十二):InputMetadata 的构造——调度元数据如何变成 GPU 输入张量
从第二十一篇接上
第二十一篇拆的是 CP 组的对象广播:driver rank 把非张量字段塞进共享内存环,把张量字段交给 NCCL,跟随 rank 按路径回填。那篇文章停在元数据“已经准备好、正要发给其他 rank”的时刻。但元数据本身是怎么来的?调度器手里只有每条序列的 seqlen_q、seqlen_k、block table 和 state id,GPU 上的注意力 kernel 却需要 cu_seqlens、slot_mapping、block_tables、klen、kv_ca_index_offset_len、SWA 窗口 pivots 等十几种形状各异的张量。中间这层翻译就是 InputMetadata 的构造。
这一篇按“上游输入 → 公共底座 → 压缩 KV → SWA → prompt 的 key 区间 → YoCo 截断 → decode 的三条路径 → 与 CUDA Graph 的接口”的顺序走一遍,重点回答四个问题:
- 哪些字段必须在 CPU 上逐 token 算,哪些可以搬到 GPU kernel,分界线由什么决定?
- 压缩 KV 的
positions_c/slot_mapping_store_ca如何把“序列位置”映射成“压缩块里的槽位”? - prompt 的
ks/ke与kv_swa_full_index_pivots这两套索引,为什么一个按 query 行给区间、另一个给四元组让 kernel 展开? - ZOS decode 路径的“原地填充”与 eager 路径的“重新分配”如何在同一个函数里共存,又为什么必须靠
get_or_create和行视图来维持 CUDA Graph 的零拷贝?
先看 DeepInfer 官方仓库给出的整体架构,本文讨论的构造层位于调度器与模型执行器之间。
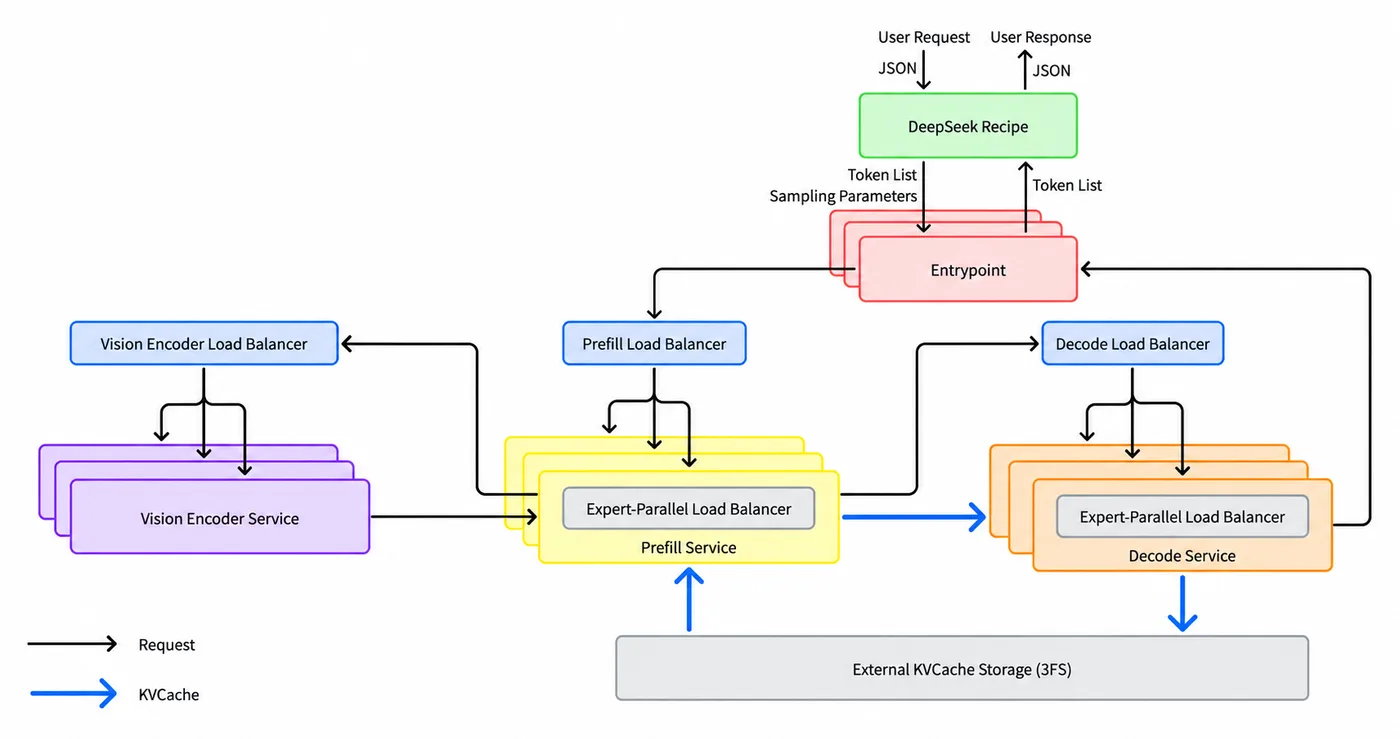
图片来源:DeepSeek 官方仓库 deepseek-ai/DeepInfer 的 doc/images/architecture_overview.png。
三个构造时刻
DeepInfer 的输入元数据不是在一个函数里统一生成的,而是按执行路径分成三条:
| 路径 | 入口 | 在哪里算 | 主要特点 |
|---|---|---|---|
| prompt | prepare_prompt_v4(C++) | CPU,pinned 内存 | 逐 token 展开 ks/ke、SWA pivots、load segments |
| decode eager | prepare_decode_v4(C++) | CPU,pinned 内存 | 每步重建,字段以 query token 为行 |
| decode ZOS | prepare_decode_v4_zos(Python)+ prepare_v4_decode_metadata(TileLang) | 行提取在 CPU,主体在 GPU | 原地填充 CUDA Graph 的输入缓冲区 |
三条路径共享同一个 Python 数据类 InputMetadataV4,共享同一套字段语义,也共享同一个“有 args.out 就原地填充、没有就新分配”的约定。理解这三条路径的差异,比记住字段名更重要。
为什么 prompt 不也做成一个 GPU kernel?prompt 的输出长度是数据相关的:每个压缩倍率产生的压缩 token 数 n_cq 取决于每条序列的 seqlen_k 与 seqlen_q,ks/ke 的基准又取决于前面所有序列的压缩长度。要在 GPU 上直接写,就得先做一次前缀和、再分配精确大小的缓冲,或者在最大尺寸上写再压缩;前者多一次 kernel 与前缀和同步,后者浪费显存且下游要额外处理未写区域。prefill 每步只构造一次,CPU 顺序算这些长度并把结果直接作为 torch::empty 的尺寸,反而更简单、更省显存。decode 不同:total_q 小、字段多、每步都要构造,CPU 循环的固定开销占比高,才值得搬到 GPU。
先把另一个容易混淆的点说清楚:这里的“CPU 构造”不是指 Python 循环,而是指 C++ 扩展里的逐 token 循环。prepare_prompt_base、prepare_decode_base、prepare_prompt_v4 都编译在 deepinfer._C.engine 里,通过 pybind11 暴露。之所以放在 C++,是因为每个 token 都要写几个 int32 字段,Python 层逐 token 赋值会把 GIL 和解释器开销放大到不可接受。C++ 侧分配的是 pinned memory(torch::TensorOptions(dtype).pinned_memory(true)),这样后续 tensor.cuda(non_blocking=True) 可以走异步拷贝:页锁定的主机内存能被 DMA 直接读取,不需要先拷到驱动内部的暂存区。
get_or_create_tensor 是三条路径共同的入口约定:
torch::Tensor get_or_create_tensor( const py::dict &dict, bool has_out, const py::str &name, const torch::IntArrayRef &size, const torch::ScalarType &dtype) { torch::Tensor ret; if (has_out) { ret = dict[name].cast<torch::Tensor>(); TORCH_CHECK(ret.sizes() == size, ...); TORCH_CHECK(ret.scalar_type() == dtype); } else { ret = torch::empty(size, pinned(dtype)); dict[name] = ret; } return ret;}has_out 来自 args.out.has_value()。CUDA Graph 捕获时,out 是一份预分配的字典,形状按捕获档位的 max_batch 固定;回放时同一档位的 total_q 更小,但缓冲区仍是捕获时那块,所以只校验形状并原地写前缀。eager 路径没有 out,每次按真实 total_q 新分配。这个二分支贯穿全文,后文不再重复。
上游只给了四类原料
所有字段都从 SequenceMetadata 推导。它由 C++ 调度器在每步结束时构造,核心字段只有四类:
- 长度:
seqlen_q(本步要算的 query 数)、seqlen_k(算完后的总 key 数,含本步 query)。prompt 阶段seqlen_q可能是一大段 chunk,decode 阶段通常是 1,开投机解码后是nextn + 1。 - 块表:
block_table,逻辑块号到物理块号的映射;KV 块大小block_size由CacheConfig决定。 - 状态槽:
state_id,SWA ring 与压缩状态在 state cache 里的槽号。 - 附加语义:
is_placeholder(DP 空步占位)、swa_valid_start(zero-state 重放的有效下界)、mtp.draft_tokens(投机草稿 token)、seq_data(原始 token 序列与压缩序列)。
is_placeholder 值得单独说。DP Attention 下每个 DP rank 是独立引擎,某一步可能只有部分 rank 有请求;没有请求的 rank 也要参与集合通信,于是用一个占位序列凑齐批形状。占位序列的 seqlen_q 通常为 1,但它的 token 不参与采样,也不写 KV。元数据层用两个哨兵表达这件事:valid_token_mask=false,以及 query_indices=998244353。
公共底座:positions、input_ids 与四张辅助表
在进入逐字段讲解之前,先交代一个贯穿全篇的读者可能不熟悉的概念:varlen 布局。推理引擎不会把不同长度的序列零散地放进各自张量,而是把本步所有序列的 query token 按序列顺序首尾相接成一个一维张量,再用 cu_seqlens(前缀和)划分每条序列的边界。好处是 attention kernel 只看到一块连续的 [total_q, head_dim],不需要为变长批写循环;代价是所有“按序列”的信息(属于哪条序列、序列从哪个绝对位置开始)必须通过元数据里的附加字段恢复。本文反复提到的“query 行”“行下标”都是这个含义:一维张量里的第 行对应某条序列的某个 token。理解了这一点,后面 i_q 的递增、query_indices 的取值、ks/ke 的按行展开就都能对上。
prepare_common_base 是 prompt 与 decode 共用的第一层。它按序列顺序把所有 query token 摊平成一维,依次填四个字段:gate_force_random、positions、input_ids 与 ngram_token_ids。
positions:绝对位置
for (int32_t j = p_seq->seqlen_k - p_seq->seqlen_q; j < p_seq->seqlen_k; ++j, ++i_q) p_positions[i_q] = j;对第 个 query token,它的绝对位置是
其中 是该 token 在本次 query 段内的局部下标。prompt 的 chunked prefill 下,seqlen_k - seqlen_q 就是这段 chunk 的起点;decode 下它等于上一步结束时的长度。RoPE、SWA ring 槽位、压缩 token 的边界判断全都以这个绝对位置为准,所以它是所有派生字段的锚点。
input_ids:prompt 取整段,decode 取一个加草稿
prompt 的 query 段就是原始 token 序列的尾部:
memcpy(p_input_ids + i_q, token_ids.data() + p_seq->seqlen_k - p_seq->seqlen_q, seqlen_q_golden * sizeof(int32_t));decode 只取最后一个已确认 token,后面接投机草稿:
p_input_ids[i_q] = token_ids[seqlen_k - seqlen_q];for (int j = 0; j < seqlen_q_draft; ++j) p_input_ids[i_q + 1 + j] = p_seq->mtp.draft_tokens[j];这里有一个容易读错的地方:decode 的 seqlen_q 是 1 + 草稿数,而 seqlen_k 是 token_ids.size() - 1 + seqlen_q。也就是说,草稿 token 还没有进入 token_ids,但已经计入本步的 key 长度。验证分支会用 seqlen_q_golden = 1 单独检查主 token,再检查草稿数量。
gate_force_random:负载均衡的旁路开关
p_gate_force_random[i] = args.force_load_balance;这是一个布尔张量,整批同值。它为真时,MoE gate 会用随机 logits 替换真实 logits,把路由强行摊平。它的用途不是推理正确性,而是压测与 EPLB 统计:当需要在不改变输入分布的前提下观察最坏情况下的专家负载时,打开它可以让每个专家都收到接近均等的 token。它逐 token 复制成 [total_q],是因为下游 kernel 按 token 读取,不想在 kernel 里再传一个标量分支。
ngram_token_ids:Engram 的回看窗口
开启 Engram(max_ngram_size > 0)时,每个 query token 需要 max_ngram_size 个压缩后的历史 token。fill_engram_row 逐行填充:
for (int r = 0; r < max_ngram_size; ++r) { int s = pos - r; // 往回看 r 步 if (s < 0) v = pad_token; // 序列头,补 pad else if (s < L) v = compressed[s]; // 已压缩部分 else v = lookup_table[last_next_n_token[s - L]]; // 本步新 token,现场压缩} 是 compressed_seq_data 的长度。回看窗口跨越“已压缩历史”和“本步/上步未压缩 token”两个区段,后者要通过压缩词表的 lookup_table 现场映射。遇到图像哨兵 token 时,从该位置起全部填 pad,避免 N-gram 跨模态边界。这个字段的形状是 [total_q, max_ngram_size],是公共底座里唯一一个二维字段;其余都是一维。
valid_token_mask 与 query_indices:占位序列的两种标记
decode base 填 valid_token_mask:
bool is_valid = !p_seq->is_placeholder;for (int j = 0; j < p_seq->seqlen_q; ++j) p_valid_token_mask[i_q++] = is_valid;query_indices 则给每个 token 标记它属于哪条序列:
int indices = !p_seq->is_placeholder ? i_seq : 998244353;正常序列用批内下标 i_seq;占位序列用一个远大于任何真实批大小的哨兵。为什么不用 -1?因为下游的 index-attention 与 core-attention 会拿它做 block_table[query_indices[i]] 一类的间接寻址,-1 在 C++ 里是合法下标,会读到错误位置;998244353 在 int32 范围内足够大,任何数组访问都会越界并被 CUDA 的非法地址检查捕获,属于“快速失败”的设计。
prompt 路径的 valid_token_mask 不是在这里填的,而是在 CP mirror 之后由 mirror_cp_index != -1 生成,原因在 CP 一节说明。
压缩 KV:把序列位置换算成压缩块槽位
V4.1-Flash 的注意力不是单一倍率。配置里同时存在 dense_compress_ratios 与 sparse_compress_ratios,前者走全量压缩 KV 的 core attention,后者走 top-k 稀疏索引。两类倍率的并集记为 ca_ratios,元数据按倍率分桶:positions_c、slot_mapping_store_ca 都是 dict[str, Tensor],键是倍率的十进制字符串。
update_common_v4 对每个倍率 做两件事:算出本步新产生的压缩 token 的绝对位置,以及它们在压缩 KV 池里的写入槽位。
prompt:一段 query 产生多少个压缩 token
n_cq += std::max(1, seqlen_k / n - (seqlen_k - seqlen_q) / n);设 query 段为 ,压缩粒度为 。这段区间覆盖的完整压缩块数是
也就是“结尾处的压缩块数减去起点处的压缩块数”。但 code 外面套了 max(1, ...):如果这段 query 太短、没有跨过任何压缩边界,仍然要分配一行。这一行不是有效压缩 token,而是占位行:positions_c 写 0,slot_mapping_store_ca 写 -1。下游的压缩器按行数启动,零行会导致 grid 为 0,某些 kernel 与 CUDA Graph 都不喜欢零长度;补一行并把 slot 标成 -1,既保持形状稳定,又让写入操作被跳过。
对每个有效压缩 token,位置与槽位分别是
其中 是压缩 token 的全局压缩下标, 是每个物理块能放多少个压缩 token。第一项把压缩下标还原成原序列的绝对位置(压缩 token 代表从 开始的 个原始 token),第二项把压缩下标映射进物理块。这里用的是按最小压缩倍率计长的块表:fill_decode_block_tables 用 min_compress_ratio 数每条序列占了多少块;块本身的大小 block_size 对所有倍率相同,倍率更大的层只是每块能容纳的压缩 token 更少。
decode:只在跨过压缩边界的那一步写
decode 的 seqlen_q 很小,绝大多数 query token 不会产生新的压缩 token。判断条件是:
if ((orig_pos + 1) % n == 0) { p_pos[i_q] = (orig_pos / n) * n; p_slot[i_q] = block_table[compressed_idx / b_c] * b_c + compressed_idx % b_c;} else { p_pos[i_q] = 0; p_slot[i_q] = -1;} 时, 说明第 个 token 正好是第 个压缩块的最后一个原始 token;此时压缩下标是 ,它代表的压缩 token 位置是 。其余行写 slot=-1,表示“本步不写压缩缓存”。这里 positions_c 写 0 而不是 -1,是因为位置字段只被写路径读取,而写路径先看 slot 是否非负;写 0 可以让未初始化内存不进入 kernel。
一个共享的坑:block table 的右侧未初始化
fill_decode_block_tables 把每条序列的块表复制到 [total_q, max_num_blocks] 的每一行:
int32_t tokens_per_block = block_size / compress_ratio;num_blocks = (seqlen_k / compress_ratio + tokens_per_block - 1) / tokens_per_block;std::copy(block_table.begin(), block_table.begin() + num_blocks, p_block_tables + i_q * max_num_blocks);右侧 max_num_blocks - num_blocks 列不初始化。这不是疏忽:下游 kernel 的有效长度来自 klen / offset_len,不会读越界列;而把整行清零反而要多一次写。若调试时看到块表右侧是垃圾值,先确认读取方是否用了 num_blocks 而不是 max_num_blocks 做循环上界。
SWA:ring 槽位与块粒度装载计划
SWA(sliding window attention)的历史 KV 不放在分页 KV 池里,而是放在每个序列独占的 StateBlock 中。StateBlock 的 ring 大小是 swa_block_size,通常比 window_size 略大,留出投机回退的余量。元数据要回答两个问题:本步的 query token 往 ring 的哪个槽写,以及本步 attention 要从 ring 的哪些块读。
写:只写窗口内的最后一段
if (p_seq->seqlen_q - j <= swa_block_size) p_slot_mapping_store_swa[i_q] = p_seq->state_id * swa_block_size + (p_seq->seqlen_k - p_seq->seqlen_q + j) % swa_block_size;else p_slot_mapping_store_swa[i_q] = -1;条件 seqlen_q - j <= swa_block_size 表示这个 query token 位于本段 query 的最后 swa_block_size 个之内。更早的 token 不会留在 ring 里(会被后续 token 覆盖),所以不写。槽位公式是
前一项定位到序列自己的 state 槽,后一项是 ring 内的偏移。state_id 在 prompt 阶段是每条序列一个(state_block_idx 形状 [n_seq]),在 decode 阶段展开成每个 query token 一个(形状 [total_q]),因为 decode kernel 按 token 取行。
读:把 ring 区间翻译成块粒度描述符
make_swa_block_load_plan 不生成逐 token 的索引,而是生成“装载段”:
history_end = seqlen_k - seqlen_q;history_begin = history_end - window_size;padding_len = clamp(swa_valid_start - history_begin, 0, window_size);valid_begin = history_begin + padding_len;builder.append_zero_fill(padding_len);builder.append_ring_range(state_id, valid_begin, history_end);输出是 [num_segments, 4] 的 int32 张量,每行 [src_block_id, src_begin, src_end, dst_offset],其中 src_block_id=-1 表示零填充。为什么要块粒度?因为 SWA kernel 的输入布局是 [n_seq * window_size, ...] 的连续缓冲:每条序列固定占 window_size 行,历史不足 window_size 的部分要补零。装载计划把“从哪个 state 槽的哪段 ring 搬到目标缓冲的哪个偏移”描述成若干段,一次 kernel 就能完成全部序列的搬运,而不需要 CPU 逐 token 计算。
total_k_swa 恒等于 n_seq * window_size,即使真实历史更短。补零段就是为此存在。swa_valid_start 则处理 zero-state 重放:当 SWA 状态被清零后,[0, valid_start) 的槽不可信,装载计划把这段也补零,attention 的可见下界在后续 pivots 里同步 clamp 到 valid_start。两处必须一致,否则 kernel 会读到清零后的垃圾值。
混合层型意味着两套池子
V4.1-Flash 的层不是同一种注意力:一部分是全量压缩 KV,一部分是 SWA,还有 YoCo 的 consumer 层。不同层型的 KV 生命周期不同——全量 KV 要长期保留、可落盘复用;SWA ring 只保留一个窗口,且一部分层在重放时要重算。元数据因此天然分成两套池子的描述符:
- 分页池:
block_table、slot_mapping_store_ca、klen、kv_ca_index_offset_len; - 状态池:
state_block_idx、slot_mapping_store_swa、kv_swa_index_offset_len、load_segments_swa。
两套池子的“块”含义也不同:分页池的块由调度器统一分配,可以跨请求复用;状态池的槽按序列独占,生命周期跟随请求。把它们混在一张块表里,会让前缀复用与 SWA 重放都变复杂。vLLM 在混合注意力模型上采用“分组”的方式处理同类问题:不同层型各自成组,组内共享块池,组间独立核算。
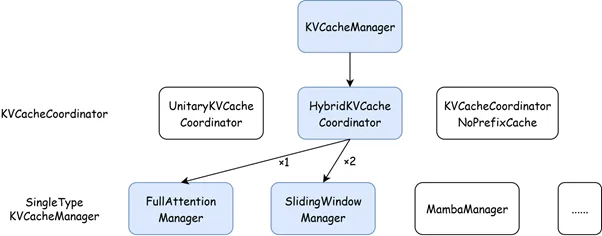
图片来源:vLLM 官方文档 docs/assets/design/hybrid_kv_cache_manager/overview.png。DeepInfer 没有直接照搬这套分组,但“全量层与 SWA 层分开记账”的原则是一致的;差别在于 DeepInfer 的 SWA 历史放在 StateBlock 里,而不是分页池的一个组。
压缩 KV 的装载计划
prompt 阶段还要把压缩 KV 历史从分页池搬进连续缓冲,make_paged_block_load_plan 复用同一个 BlockLoadPlanBuilder:
for (auto p_seq : seq_metadata_list) { num_tokens = p_seq->seqlen_k / compress_ratio; if (num_tokens == 0) builder.append_zero_fill(1); else builder.append_paged_range(p_seq->block_table, 0, num_tokens);}每段按物理块切分,total_k_compressed 记录搬完后的总长度。append_zero_fill(1) 同样是为了避免零长度序列:一条空序列也要在缓冲里占一行,保持 cu_seqlens 单调。
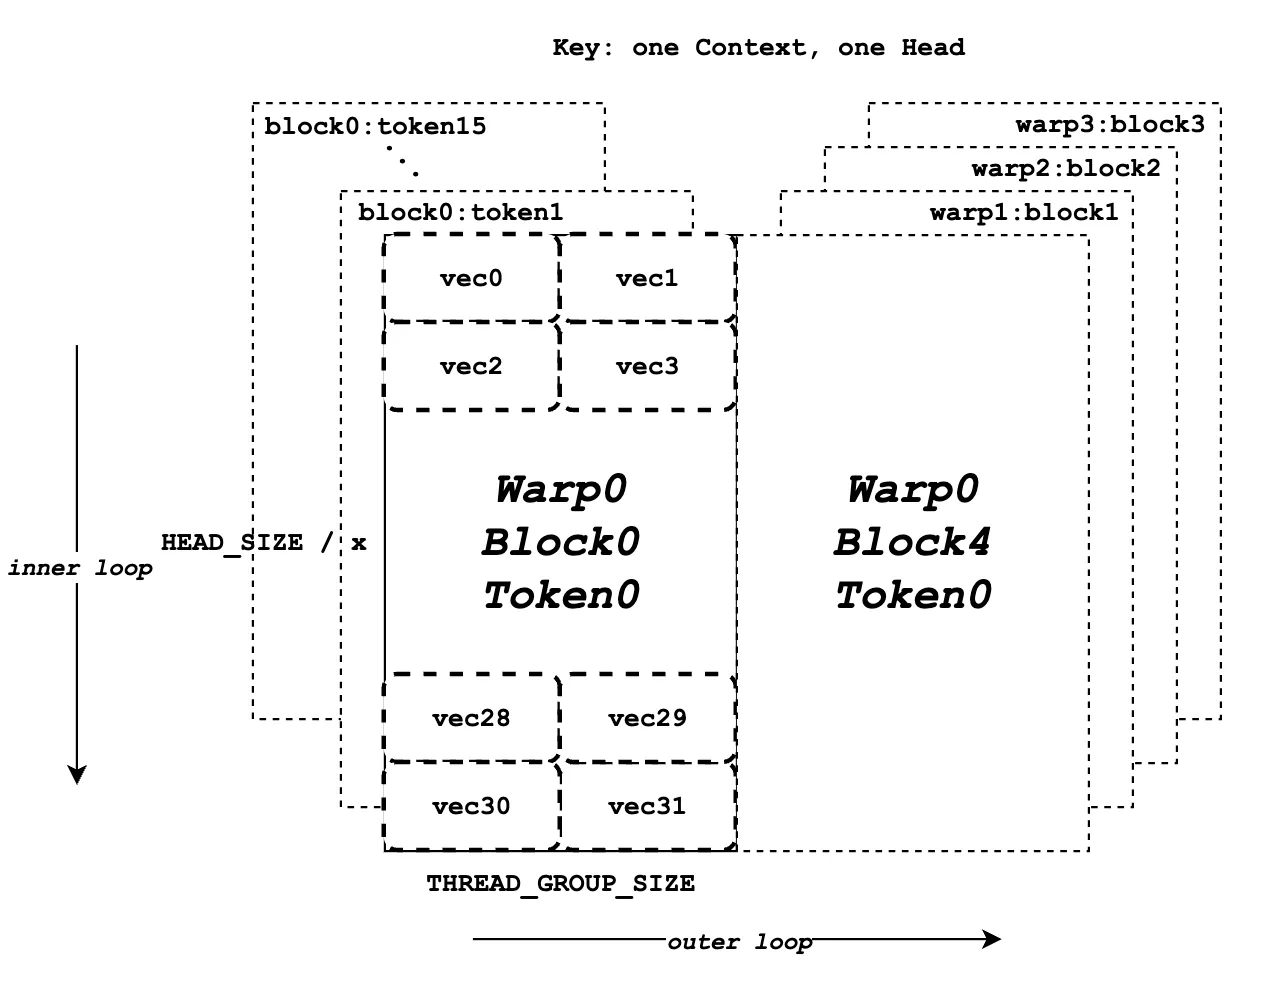
图片来源:vLLM 官方文档 docs/assets/design/paged_attention/key.png。DeepInfer 的 block_table 与 slot_mapping 沿用同一套“逻辑位置 → 物理块 → 块内偏移”的三级映射,只是额外叠加了压缩倍率与 SWA ring。
CP mirror:prompt 元数据的重排
上下文并行在 V4.1-Flash 的生产部署里默认关闭,但 prefill 路径上的代码是完整可用的,元数据层也必须为它准备好布局。CP 的核心是 prepare_for_mirror_cp:把元数据从“全局 varlen 布局”切成“本 rank 的 mirror 布局”。
zigzag 的 token 归属
一条长度为 的序列被切成 块( 是 CP 大小),rank 拿第 块和第 块:
每个 rank 的 token 数与 cp_mirror_len 由 C++ 侧直接算出:
cp_mirror_len += (seqlen_q + cp_size * 2 - 1) / (cp_size * 2);cp_mirror_len *= 2;(sq + 2p - 1) / (2p) 是每块的向上取整长度,乘以 2 是两块。注意这里的 sq 是 chunk 长度,不是整条序列:chunked prefill 下,镜像切分按本次 chunk进行,而不是按历史长度,因为本 rank 只处理本次 chunk 的一部分。
重排哪些字段、保留哪些字段
prepare_for_mirror_cp 的规则是“query-aligned 的字段重排,跨边界的字段保留”:
| 字段 | 处理 | 原因 |
|---|---|---|
positions | gather(positions, mirror_cp_index) | 每行 query 的绝对位置,随行移动 |
ngram_token_ids | 按行 gather | 每行一个回看窗口 |
gate_force_random | 保留原名,另存 _cp 版本 | 后续压缩视图还要按全局下标 gather |
input_ids | 不重排 | 只在层循环前的 embedding 消费 |
valid_token_mask | 由 mirror_cp_index != -1 重新生成 | 重排后 -1 处即为 pad |
positions_c / ks/ke | 由 prepare_cp_mirror 一并产出 | 压缩边界按整条序列算,必须重算 |
cu_seqlens_q / cu_seqlens_k | 不重排 | 描述全局序列边界,供压缩与装载使用 |
有一处细节很值得注意:代码先判断 hasattr(self, "positions_cp") 再赋值。
if hasattr(self, "positions_cp"): self.positions_cp = self.positionsself.positions = gather(self.positions, self.mirror_cp_index)positions_cp 保存的是重排前的原值。为什么压缩 KV 需要原位置?在 CP 下,压缩是对整条序列做的:每个 rank 只算自己的 query,但压缩 token 的边界(哪个原始位置产生一个压缩 token)取决于全局位置,不能随 mirror 重排而变。所以压缩相关的 gather 用 positions_cp,而 attention 的 query 位置用重排后的 positions。同理,prepare_cp_mirror 直接吃原始的 cu_seqlens_q/cu_seqlens_k,输出每个 mirror 行的 ks/ke。
InputMetadataV4VL 覆写了一件事:图像掩码 images_seq_mask 在重排前另存为 images_seq_mask_full。YoCo compact 视图需要按全局下标 gather 图像掩码,而已经重排过的版本无法反推全局位置。这是“跨边界字段必须保留原件”原则的一个具体例子。
mirror 与 YoCo 的叠加顺序
当两种机制同时开启时,顺序不能反:
- 先在 full 布局上算截断(
fill_yoco_truncation_metadata); - 再在 compact 布局上做一次 mirror(
get_consumer_view里的prepare_cp_mirror)。
代码注释把这称为“先 compact 再 CP”。反过来的话,mirror 后的行已经打乱,无法按连续的保留区间计算 clip_prefix。Compact 之后重新 mirror 的长度由 fill_yoco_consumer_cp_scalars 预先算出:
cp_mirror_len_c += 2 * ((keep_len + 2 * cp - 1) / (2 * cp));它的另一项输出 yoco_consumer_cp_contrib_pad_len 是“每个 rank 对 compact 结果的贡献最大值”:对 rank ,只数那些落在保留区间内的块:
lo = max(ps * b, clip); hi = min(ps * (b + 1), q_len);kept_per_rank[r] += max(hi - lo, 0);取所有 rank 的最大值,作为 all-gather 后每个 rank 的连续缓冲长度。为什么取 max 而不是和?因为每个 rank 只把自己的贡献发给汇聚点,汇聚后的总长等于所有贡献之和,但单 rank 的发送缓冲只需要放下自己那一份;取最大值保证每个 rank 用同一块大小的缓冲,避免在 CUDA Graph 里出现按 rank 变化的形状。
prompt 的 key 区间:ks/ke 与四元组 pivots
prompt 阶段有两个注意力分支要读历史 KV:压缩 KV 的 core attention(稠密层),以及 SWA(滑动窗口层)。它们对“本行 query 能看哪些 key”的表达方式不同,这不是风格差异,而是由 kernel 的消费方式决定的。
ks/ke:一个 query 行给一个连续区间
对每个稀疏倍率 ,prompt 的 ks/ke 按序列顺序累加:
int curr_ks = 0;for (int j = seqlen_k - seqlen_q; j < seqlen_k; ++j) { p_ks[i_q] = curr_ks; p_ke[i_q] = curr_ks + (j + 1) / r;}curr_ks += std::max(1, seqlen_k / r);这里的下标不是全局压缩下标,而是搬进连续缓冲之后的下标:前面序列的压缩 key 先占位,本序列的 key 从 curr_ks 开始。第 个位置的因果注意力只能看到位置 的 key,其中压缩 key 的数量是
于是区间是 。为什么 curr_ks 要加 max(1, seqlen_k / r) 而不是直接用 seqlen_k / r?因为装载计划里空序列会补一行,这里的步进必须与装载后的实际长度一致,否则下一序列的起点会错位。两处都出现了同一个 max(1, ...),它们必须成对修改。
ks/ke 的形状是 [total_q],每个 query 行两个 int32。稀疏索引层拿它做什么?top-k 选出来的压缩 key 只给出一组“候选位置”,真正的注意力计算仍然需要知道每个 query 行的候选在缓冲里的绝对区间;ks/ke 就是这个区间的左闭右开边界。与 index_attn.py 里的索引器实现相配合,这一节只讨论元数据侧的输入。更早讨论压缩 KV 与索引器跨层共享的文章见 DeepInfer 源码拆解(十一):注意力族与压缩 KV。
pivots:一个 query 行给两段
SWA 的可见 key 来源是两段:ring 里的历史(section 1)和本步 chunk 里新算的 key(section 2)。它们不在同一块内存里,无法用一个连续区间表达。DeepInfer 的做法是让 CPU 只写四元组,让 kernel 展开:
其中 是该 query 行最终的 kv_swa_full_index(长度 window_size), 是窗口大小, 为 mask。四元组的产生:
abs_lo = max(pos - window_size + 1, valid_start); // 可见下界(绝对位置)if (abs_lo < 0) abs_lo = 0;
sec1_lo_abs = min(abs_lo, q_start);start_slot = sec1_lo_abs - (q_start - window_size);P0 = sec1_start + start_slot; // section1 起点(缓冲下标)P1 = window_size - start_slot; // section1 长度
k_lo = max(0, abs_lo - q_start);P2 = sec2_start + k_lo; // section2 起点P3 = j - k_lo + 1; // section2 长度逐步解释:
- 可见下界。因果注意力 + 滑窗:位置 的 query 只能看 。再与
valid_start取 max,保证不读被清零的槽。 - section 1 的偏移。
sec1_start = i_seq * window_size是这条序列在历史缓冲里的行起点。历史缓冲里每个序列占window_size行,对应绝对位置 。所以绝对位置 在 section 1 内的偏移是 ,即start_slot。若历史不足一整窗,start_slot会接近 ,表示前部是补零或不存在。 - section 2 的起点。section 2 存放本 chunk 新算的 KV,从
sec2_start开始,长度等于已处理的 query 数。局部位置 对应绝对位置 ,所以起点是sec2_start + k_lo。 - 长度。section 2 的长度是“当前局部下标 减去起点 再加 1”,包含自身。
四元组的好处是 CPU 只写 4 个 int32,而展开成 列的稠密索引交给 GPU 上的 expand_swa_index kernel。 通常是 128–1024 量级,若在 CPU 展开,每行要写 个值,prompt 的 total_q 动辄数万,会直接拖慢每步准备时间。compute_attn_info 在 forward 开头调用 _expand_kv_swa_full_index 展开;展开结果走 _cp_gather,在 CP 开启时同时按 mirror 索引重排。
kv_ca_index_offset_len 用的是同样的“给区间、让 kernel 展开”思路,区别是展开结果指向分页池而不是连续缓冲。dense 层每行的公式在 InputMetadataV4.compute_attn_info 里写成注释:
kv_ca_index[i_q, :len] = offset[i_q] + arange(len)decode 时的展开还要走 block table:
pos = offset[i_q] + arange(len[i_q])kv_ca_index[i_q, :len] = block_tables[pos // tpb] * tpb + pos % tpbtpb = block_size // n。这与压缩槽位公式是同一条映射的两种写法:一个在写侧算 slot,一个在读侧把 slot 展开成稠密索引。展开宽度必须是 128 的整数倍((max_model_len // n + 127) // 128 * 128),因为稀疏注意力 kernel 的索引布局按 128 对齐。
为什么不在 CPU 上直接展开
可以把这看作一次“元数据的分层”:CPU 层只承担 的工作(每行常数个值),GPU 层承担 的展开。展开是纯数据并行,没有依赖,适合放在 kernel 里。更深一层的原因是 CPU 时间必须落在关键路径之外:CP 广播在 driver 上先发对象再发张量,跟随 rank 的空闲窗口由 driver 的 CPU 时间决定;每多一次逐 token 的 Python/C++ 循环,重叠窗口就少一点。第二篇讨论过的 ZOS 把 CPU 后处理移出关键路径,这里的设计与它是同一个思路:能在 GPU 上并行做的,就不要让 CPU 顺序做。
decode 的三条路径
decode 是最热的一段:每生成一个 token 就走一次。元数据构造在 DeepInfer 里有两条实现——eager 的 C++ 路径和 ZOS 的“CPU 行提取 + GPU kernel”路径,两者要产生相同的字段语义。
eager:prepare_decode_v4
在 prepare_decode_base 与 update_common_v4 之后,eager 路径补齐三组字段:
context_lens:每个 query token 的上下文长度(含自身):
投机解码时 seqlen_q > 1,同一序列的草稿 token 共享前缀,但每个草稿位置看到的 key 数依次增加,所以是逐 token 的。
klen:稀疏层每个 query token 要看的压缩 key 数,。它与 prompt 的 ke-ks 同构,只是不带偏移。
kv_swa_index_offset_len:decode 的 SWA 读窗口。与 prompt 不同,decode 的 query token 本身也已经写进了 ring(slot_mapping_store_swa 先写后读),所以窗口就是 ring 本身的一个环形区间:
real_window_size = min(current_offset + 1, window_size);offset = state_id * swa_block_size + (current_offset - real_window_size + 1) % swa_block_size;current_offset = seqlen_k - seqlen_q + j 是 query 的绝对位置。窗口起点 (current_offset - W + 1) % swa_block_size 落在 ring 里,长度不超过 。这里出现一个 subtle 的点:decode 的 ring 大小 swa_block_size 可能略大于 window_size(留投机回退余量),但读窗口只取 个,所以环上“多出来”的槽不会被读到。
ZOS:先讲清单,再让 kernel 算
ZOS 路径的入口在 Python 侧 prepare_decode_v4_zos。它分三个阶段:
prepare_decode_zos_inputs(C++):把每条序列的 CPU 标量抽出来,装进一个MetadataZOS结构。抽出的东西是每序列的,不是每 token 的:seqlens_q、seqlens_k、cu_seqlens_q(前缀和)、block_tables_in(紧凑一维)、block_tables_offsets、state_block_idx、is_placeholder、input_ids_cpu、ngram_token_ids_cpu等。prepare_common_decode_buffers_zos:按total_q分配或复用positions、valid_token_mask、gate_force_random、context_lens、query_indices、block_tables六个公共缓冲区。prepare_v4_decode_metadata(TileLang kernel):一个 CTA 处理一条序列,把上面所有每 token 的字段一次性算完;block_tables_out由第二个 kernel 展开。
为什么要把逐 token 的工作交给 kernel?对比一下工作量:一个典型的 decode 步 条序列、 个 query 行(含投机),每行要写 positions、valid_token_mask、context_lens、query_indices、block_tables(max_num_blocks 列)、每个压缩倍率的 positions_c 与 slot_mapping_store_ca。在 CPU 上,block_tables 这一项就是 次写;在 GPU 上,同一个 kernel 用 个 CTA 并行完成,并且与 driver 的其余准备工作重叠。
MetadataZOS 里有一个在调度论文里反复出现的字段——remap。它描述“上一步的请求在本步批里去了哪里”,用于把上一步的采样结果、草稿 token、已接受数量搬运到本步正确的位置。prepare_token_ids_zos 就是消费者:
gather_input_ids_zos(fresh_input_ids, prev_sampled_token_ids, prev_predict_token_ids, remap, seqlens_q, cu_seqlens_q, input_ids, max_seqlen_q=nextn + 1)有新请求(fresh)时,token 在 CPU 现成;延续的请求(prev)的 token 在 GPU 上由上一步产生,通过 remap 做设备端 gather。两条路分在一处,是因为“本步的 input_ids”必须是一块连续缓冲给 embedding 用,而它的来源是异构的。这个设计的背景在 DeepInfer 源码完全拆解(二):异步调度与零开销调度 ZOS 里讨论过;本篇只关心它对元数据布局的影响。
分桶栈与零拷贝行视图
ZOS 路径里最容易被忽略的是 get_or_create_stacked。按倍率分桶的字段(klen、positions_c、slot_mapping_store_ca、kv_ca_index_offset_len)在 CUDA Graph 里不能是“每倍率一块独立张量”再加 Python 循环去填,因为 kernel 想在一次启动里写完所有倍率。做法是把它们 stack 成 [n_ratio, q_stride, ...] 的一块缓冲,kernel 按倍率与序列二维展开时,一次启动就能写完所有桶。
stacked = torch.empty([n, *size], ...) # eager:新分配return stacked, {k: stacked[i] for i, k in enumerate(keys)}返回的 dict 是 stacked 的行视图。CUDA Graph 捕获时按 max_batch 捕获,回放时 total_q 更小,不能换 buffer,只能按捕获时的行间距切前缀:
q_stride = stride_elems // rest_numelkernel_out = rows[0].as_strided([n, q_stride, *size[1:]], [stride_elems, *rows[0].stride()])所以 kernel 写入的是一块 [n, q_stride, ...]、隔着 stride 写每行前 size[0] 个位置的视图。dict 里的值是 _cut 之后每行的前缀切片,与 kernel 的写入地址是同一块存储。代码里有一条很长的断言,检查所有行“同一 storage、等间距、连续”,失败就说明捕获流程被改动,零拷贝前提被破坏。
这个设计还有一个隐式收益:当 dense_ratios 与 sparse_ratios 不同时(比如稀疏层 4、稠密层 1),ca_ratios 是并集,同一个 token 可能出现在多个倍率的桶里。stack 让 kernel 的 grid 维度自然对应倍率,而不需要为每个倍率单独启动。
YoCo 截断:同一份元数据的两种视图
YoCo 的 prefill 截断在第三篇里从缓存与等价性角度讲过:保留最近 keep_tokens 个 token 参与计算,更早的部分丢弃,但推理结果必须与不截断时逐位对齐。第三篇关注的是 KV 被搬到哪里,这一篇关注的是 元数据如何描述“保留区间”。两者是同一件事的两面。
截断的几何定义是一条矩形:
其中 data_len 是已经写入的序列长度(不含本次 chunk 的 query), 是 yoco_prefill_keep_tokens。chunk 开头落在矩形之外的 token 会被裁掉:
clip_prefix = compact ? std::clamp(data_len - keep_tokens - q_start, 0, q_len - 1) : 0;clamp 的上界是 q_len - 1,意思是“至少保留 chunk 的最后一个 token”。为什么?如果整个 chunk 都在矩形之前,理论上可以全部丢掉,但保留一个 token 可以让后续的 cu_seqlens 不出现零长度序列,也让消费者层的 MoE gate 至少有一行可算。这是形状稳定性优先于极限压缩的一个取舍。
截断后每行 query 的可见区间由 yoco_swa_visibility 计算:
abs_lo = clamp(max(pos - window_size + 1, rect_lo, valid_start), 0, pos + 1);sec1_lo_abs = min(abs_lo, q_start);start_slot = sec1_lo_abs - (q_start - window_size);k_lo = max(abs_lo - q_start, 0);new_len = j - k_lo + 1;与不截断的 pivots 相比,只多了一个下界 rect_lo = data_len - keep_tokens,其余公式完全同构。这正是 mask 模式与 compact 模式能够共享 yoco_swa_visibility 的原因:两种模式的可见域定义相同,差别只在保留的 query 行是否被物理搬走。
mask 模式不裁行:
clip_prefix = 0,所有 query 行照常计算;- 只产出
yoco_mask_swa_index_pivots,形状与 full 布局相同; get_mask_view()做一次浅拷贝,把kv_swa_full_index_pivots换成 mask 版 pivots,并把已展开的kv_swa_full_index置空。
结果是计算量没有下降,但 attention 的可见域被收窄,数值上等价于截断。适合调试与对拍,因为行布局不变,容易逐行比较。
compact 模式真裁行:
- 每序列保留
q_len - clip_prefix行,cu_seqlens_q与total_q都变小; - 产出
yoco_consumer_query_indices(保留行在全局 full 布局里的下标)、yoco_consumer_positions、yoco_consumer_slot_mapping_store_swa、yoco_consumer_ks/ke、yoco_consumer_kv_ca_index_offset_len; ks/ke的基准按max(1, seqlen_k / r)累加,但只对保留行发号;ke = base + (q_start+j+1)/r;- SWA 写入槽位只给矩形内且位于最后
swa_block_size的 token 发 slot,其余 -1。
get_consumer_view() 把这些字段换进浅拷贝,同时清空 kv_ca_index、kv_ca_index_len、klen、kv_swa_full_index,让 compute_attn_info 按 compact 布局重新展开。这里有一条重要的约束:未重写的字段与原对象共享 tensor,禁止原地修改。浅拷贝不是深拷贝,input_ids 仍指向完整序列,因为 embedding 在层循环之前就已经消费完;mm_token_type 也不重排,因为它只在 aligner 阶段使用。
CP 打开时,compact 视图还要再做一次 zigzag 切分:
mirror_cp_index_c, mirror_cp_reverse_index_c, ks_all, ke_all = prepare_cp_mirror( self.yoco_consumer_cu_seqlens_q, self.cu_seqlens_k, cp_group.size(), cp_group.rank(), kernel_ratios, self.yoco_consumer_total_q, self.yoco_consumer_cp_mirror_len)注意第二个参数仍然是原始 cu_seqlens_k。这是紧凑布局的关键:prepare_cp_mirror 内部用 seqlen_k - seqlen_q 推每个 query 行的绝对起点,如果传 compact 的 cu_seqlens_q 又传 compact 的 cu_seqlens_k,起点会被算成 0;保留原始 key 长度,才能让 compact 行仍然指向它在原序列中的绝对位置。代码注释把这条推导写得很清楚,并注明它由端到端等价性脚本覆盖,而不是单元测试。yoco_cp_contrib_index 与 yoco_cp_boundary_index 则是给 decoder 层边界分支用的重分布索引:把本 rank 在 full-mirror 布局里保留的行,经过 all-gather 后映射到 compact-mirror 布局。
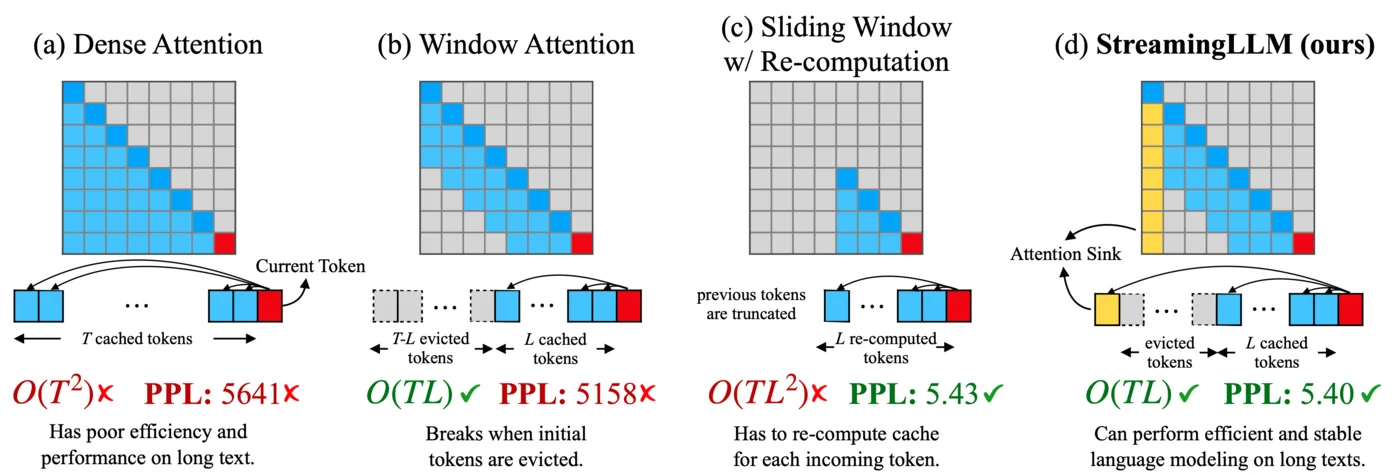
图片来源:MIT HAN Lab 的 StreamingLLM 项目图 figures/schemes.png。SWA 只保留最近窗口,YoCo 截断则在此基础上再裁掉矩形外的 query 行;两者都要在元数据里精确表达“哪些位置可见”。
与广播、CUDA Graph 的接口
元数据构造完成后,接下来是第二十一篇讲的广播。两篇的交界处有三个接口,值得单独说明。
to_flatten_dict:只展开一层
for k, v in self.__dict__.items(): if isinstance(v, dict) and v: for sub_k, sub_v in v.items(): flat[f"{k}.{sub_k}"] = sub_v else: flat[k] = v按倍率分桶的字段被展开成 klen.4、positions_c.2 这样的键。为什么不递归展开?注释给了答案:broadcast_tensor_dict 只处理一层嵌套,更深的结构在接收侧无法按路径回填。把“结构深度”限制在一层,是广播协议与数据类之间的契约。from_flatten_dict 是它的逆操作:按第一个 . 切分,把子键折回 dict。
broadcast:按路径收集非张量字段
InputMetadata.broadcast 遍历对象,把张量收进 tensor_list,把非张量按 a.b.c 路径收进 non_tensor_values;用 id(obj) 去重,防止同一个 tensor 被环形引用重复收集。接收侧按路径逐级 getattr / [key] 回填:
*parents, last = path.split(".")obj = selffor part in parents: obj = obj[part] if isinstance(obj, dict) else getattr(obj, part)这条路径式回填的好处是接收侧的 InputMetadata 对象结构可以独立构造,不需要发送侧序列化整个对象图。第二十一篇详细讲了共享内存环与 NCCL 两条通道,这里只强调一个易错点:空 dict 被当成非张量广播,因为“没有键”本身是信息;如果接收侧把空 dict 丢掉,compute_attn_info 会以为该倍率不需要展开,直接跳过。
recursive_copy_:把一份元数据搬进另一份
除了广播,InputMetadata 还提供了 recursive_copy_(other):逐字段、逐字典值做 copy_,张量用 non_blocking=True。它解决的是“对象换了、缓冲区不变”的场景:当一份元数据的张量地址需要与另一份保持一致时(例如图捕获时为固定档位准备好的输入缓冲),重新构造对象会让 tensor 地址变化,依赖旧地址的图就会失效;recursive_copy_ 保持接收侧地址不变,只搬运内容。它与 get_or_create 的原地填充是同一目标的两条实现路径:前者用于“已有完整对象、只换值”,后者用于“字段不全、按名补齐”。
需要留意的是,recursive_copy_ 只处理 tensor 与一层 dict,标量字段被跳过。这与广播的“非张量走对象通道”互补:标量(num_reqs、total_q、is_prompt)在捕获时固定,回放时由调用方单独更新;张量则按块拷贝。若误以为标量也会被复制,图回放会用到捕获时的 num_reqs,在某些 kernel 里表现为“少算了后几个请求”。
图内图外:get_clean_list 与 compute_attn_info
InputMetadataV4.get_clean_list() 返回五个字段:
["kv_ca_index_len", "kv_swa_index", "kv_ca_index", "mlp_relu_schedule_metadata", "flash_mla_sched_meta_dict"]它们都是展开结果或 kernel 调度缓存,不是调度器给出的原始信息。复用 CUDA Graph 时先把它们置 None,等 forward 开头再由 compute_attn_info 重建。为什么必须清空?因为图回放时的 total_q、block_tables、positions 都换成了本步的值,上一轮展开的索引若残留,就会指向旧位置。清空加重建把“派生字段”与“原始字段”明确分开,避免在图复用路径上出现难以排查的脏读。
compute_attn_info 还把 kv_ca_index_offset_len 展开成 kv_ca_index,把 kv_swa_index_offset_len 展开成 [total_q, window_size] 的 kv_swa_index,并为每个压缩倍率维护 klen。它的调用点有两个:普通 forward 开头,以及图回放前的清理之后。函数本身是幂等的(if self.kv_ca_index is None 才展开),所以重复调用不会重复分配。
mlp_relu_schedule_metadata 与 flash_mla_sched_meta_dict 是另一类:它们是 FlashMLA 与 DeepGEMM 的调度元数据缓存,由第一个消费该配置的层创建,后续同配置层复用。键里包含 ratio、是否 packed KV、是否用 SWA、topk 大小;这些参数相同的层可以共享同一份调度决策。把这类缓存放进 get_clean_list,说明它们也依赖本步形状,不能跨 step 复用。
一条 decode 步的时序:元数据在关键路径上的位置
把第二篇的调度时序与这一篇的构造时序合起来看,一次 decode 步大致是:
Scheduler.step (C++) ├─ 选出本步序列,更新 seqlen_k / block_table / state_id ├─ 构造 SequenceMetadata 列表 └─ 返回给 LLMEngineLLMEngine.step (Python driver) ├─ prepare_decode_v4_zos(args, metadata_zos) │ ├─ C++ 行提取(pinned)→ H2D │ ├─ get_or_create 公共缓冲 │ ├─ compute_attn_info 的惰性展开(首次访问时) │ └─ TileLang 元数据 kernel ├─ InputMetadata.broadcast(CP) ├─ Worker.execute_model_step │ ├─ embedding / Engram gather │ ├─ 40 层 attention + MoE │ └─ sampler └─ post_process:输出 token 写回 Sequence注意 prepare_decode_v4_zos 与 execute_model_step 的相对位置。ZOS 的目标是让 CPU 的元数据准备与 GPU 上的前一步计算重叠:调度器在 GPU 跑上一步时就准备好下一步的 SequenceMetadata,元数据 kernel 也尽可能早地发出去。元数据构造本身是轻量的,但它决定了 GPU 何时能开始下一步;把 CPU 循环压到 、把展开放到 GPU,正是为了缩短这段串行窗口。
compute_attn_info 的惰性展开在这个时序里有一个微妙的位置:它需要 block_size 与 max_model_len,这两个值在引擎初始化时确定;但展开结果依赖本步的 block_tables 与 positions,所以只能在每步构造之后做。把它放在 forward 开头而不是构造函数的末尾,是为了让“构造”只负责调度器给出的原始信息,“展开”由模型执行器在真正需要时完成——这也让 CUDA Graph 的 get_clean_list 能有一个明确的切分点。
从元数据到一次前向:谁在消费哪个字段
字段不是孤立存在的,按前向顺序走一遍,可以看到每个字段的消费者:
- embedding:
input_ids查词表,positions供 RoPE;ngram_token_ids交给 Engram 的哈希查表。输入侧只关心“本步有哪些 token、在哪”,不关心 KV。 - MoE gate:
gate_force_random决定是否旁路真实 logits;images_seq_mask(VL)决定图像 token 的路由。query_indices在部分 kernel 里用于按序列聚合。 - 注意力层:
cu_seqlens划分 varlen 边界;block_tables+klen/kv_ca_index_offset_len定位压缩 KV;kv_swa_index_offset_len定位 SWA ring;positions_c与slot_mapping_store_ca在写路径上告诉压缩器“本步新产生的压缩 token 写哪”。YoCo 的 consumer 层换成 compact 视图后,消费的是另一套同名字段。 - 采样与输出:
valid_token_mask屏蔽占位行,query_indices把 token 行映射回请求,context_lens用于长度相关的停止判定。投机解码下seqlens_q还会决定每个草稿位置是否参与采样。
这张消费清单解释了一个设计选择:为什么 InputMetadata 是一个大结构体而不是按层拆成多个对象。一次前向的几十层里,绝大多数层需要的是同一份元数据的不同子集;如果按层拆对象,要么每层重复构造,要么在层间传递一个“字段包”。集中成一个结构体,配合 to_flatten_dict 与 broadcast,让跨 rank 传递只需一次遍历,代价是结构体越来越大——这也是为什么字段注释必须写成规格说明,否则读代码的人无法判断某个字段是否还有消费者。
这笔账:为什么每条路径这样分工
把三条路径的工作量摊开,可以看出分工不是随意的。
以一次 decode 步、64 条序列、每条 1 个 query token、max_model_len = 128K、block_size = 128 为例。块表是 1024 列,block_tables 一块就是 。如果 block_tables 在 CPU 上逐 token 复制,C++ 侧要写 65536 个 int32;ZOS 路径把这个复制交给第二个 TileLang kernel,CPU 只提取 65 个偏移量。
更大的开销在 kv_ca_index。dense 倍率 时,展开宽度按 128 对齐到 131072,。这还只是一个倍率、一步的量。若在 CPU 上展开并 H2D,PCIe 会成为瓶颈;放在 GPU 上展开,虽然仍要写 32 MiB 显存,但写入是并行的、与计算重叠的,而且 kv_ca_index_offset_len 只需要每行 2 个 int32,H2D 只有 512 B。这就是“CPU 只写区间,GPU 展开索引”的经济学解释。
SWA pivots 是同一个逻辑的另一个例子。若在 CPU 展开 [total_q, window_size], 行并不大;但 prompt 的 total_q 可能是 32768,,且要在 prefill 的关键路径上逐行写。四元组把 CPU 写入量压到 ,展开交给 expand_swa_index,并且可以按 CP mirror 再重排。
反过来说,哪些工作留在 CPU 是合理的?
- 每序列的行提取:,N 是批内序列数,通常几十到几百。
prepare_decode_zos_inputs要读SequenceMetadata的 C++ 对象,GPU 无法直接访问主机内存里的结构体,提取必然是 CPU 工作。 - 小张量的填充:
input_ids的 fresh 部分来自 tokenizer,本来就在主机;valid_token_mask、gate_force_random每 token 一个字节,H2D 成本可以忽略。 - 一次性构造:prompt 的元数据每个 chunk 构造一次,chunk 的计算量远大于元数据构造,CPU 时间可以被 prefill 的计算掩盖。
还有一个经常被忽略的成本:launch 次数。ZOS 路径把十几个字段塞进一个 TileLang kernel,而不是每个字段一个 kernel。每多一次 kernel launch,就多一次几微秒的驱动开销;decode 步的预算常以百微秒计,十几次 launch 就是可观的固定成本。prepare_v4_decode_metadata 的“one CTA per sequence”设计,把按 token 展开与按倍率分桶都收进同一个 grid,正是为了压 launch 数。
读这份代码时容易踩的坑
cu_seqlens 的两个约定
prompt 的 cu_seqlens_q 是从 0 开始的前缀和:cu[0]=0,cu[i+1]=cu[i]+seqlen_q[i],长度 n_seq+1,这是 FlashAttention 系列 varlen 接口的标准约定。
ZOS decode 的 cu_seqlens_q 在 prepare_v4_decode_metadata 的签名里写的是 inclusive cumsum:每个序列的结束位置,不含前导 0,长度 n_seq。prepare_decode_inputs_zos 里的 torch.cumsum(seqlens_q, dim=0, out=cu_seqlens_q) 也印证了这一点。两者同名不同义,跨路径复用代码时最容易错。判断方法很简单:看形状是 n_seq+1 还是 n_seq。
零长度与至少一行
代码里反复出现 max(1, ...) 和 append_zero_fill(1):
- 压缩 token 数为 0 时补一行,
slot=-1; - 空序列在装载计划里补一行零;
curr_ks的步进用max(1, seqlen_k / r);InputMetadataV4的注释明确写“零长度张量补到长度 1”。
这些不是防御性编程的装饰,而是形状契约:下游 kernel 的 grid、cu_seqlens 的单调性、按倍率 stack 的行数都假设“至少一行”。删掉任何一个 max(1, ...),都可能让某个空序列在真实负载里触发越界或除零。
int32 的边界
kv_ca_index_offset_len 的 offset 是 i_q * max_num_blocks * (block_size // n)。当 、total_q 很大、块表很长时,这个乘积可能超过 。ZOS kernel 的 Python 包装里显式检查:
max_offset = total_q * max_num_blocks * (block_size // min(dense_ratios))assert max_offset <= torch.iinfo(torch.int32).maxC++ 侧也有对应的 TORCH_CHECK_LE。这不是理论风险:128K 上下文、128 块大小、 时每行 offset 步进就是 131072,total_q 超过 16384 就会溢出。看到这条断言失败,应该先检查是不是把 dense 倍率配成了 1 而上下文又极长,而不是简单改成 int64——改成 int64 会让整个索引张量的带宽翻倍。
压缩边界与 max(1, ...) 的三次出现
max(1, seqlen_k / r) 在元数据里至少出现三次,每次的语义都不同:
cu_compressed_seqlens_q:给压缩器的行数定界,保证每条序列至少一行;ks/ke的curr_ks步进:保证下一序列在连续缓冲里的起点与装载结果一致;kv_ca_index_offset_len的kv_ca_offset步进:同样是连续缓冲的起点。
这三处必须严格同源。想象一条序列的 seqlen_k < r:它只产生 0 个完整压缩块,但装载计划会补一行零,压缩器也要处理一行,ks/ke 的下一序列起点要跳过这一行。如果只改了其中一处——比如为了省内存把装载计划的补零去掉——偏移量就会错位,attention 会读到上一序列的压缩 KV,表现为“偶发的首 token 错误”。修这类问题的正确做法不是加边界检查,而是找到三处并检查它们是否仍然用同一个公式;代码里三处都用 std::max(1, ...) 而不是各写各的,就是为了让这一点肉眼可查。
投机解码下 seqlens_q 的级联
开启投机后 seqlen_q = nextn + 1,元数据里有三处会随之变化:
positions每行是q_start + j,草稿位置的绝对位置可以大于已确认长度;input_ids的后nextn行来自mtp.draft_tokens,它们还没有进入token_ids;slot_mapping_store_swa只给最后swa_block_size个 token 发槽位,草稿不会触发额外的写。
还有一个隐藏约束:prepare_decode_inputs_zos 里,当 DEEPINFER_ENABLE_MTP_VARLEN 打开时,cu_seqlens_q 由上一步的 metadata_zos.seqlens_q 现场 cumsum 得到,而不是从 C++ 重取:
torch.cumsum(metadata_zos.seqlens_q, dim=0, dtype=torch.int32, out=cu_seqlens_q)原因是可变长投机下,每条序列本步实际要验证的草稿数取决于上一步接受了多少;这个数字只有上一轮采样后才知道,所以 seqlens_q 被“滞后一拍”地写进 MetadataZOS,下一轮元数据构造时再消费。元数据构造因此有一个回看着上一步结果的成分,这也是为什么 MetadataZOS 里同时存着 prev_sampled_token_ids、prev_predict_token_ids 与 prev_num_accepted_tokens。
空 ks 的 fallback
prepare_for_mirror_cp 里有一段:
kernel_ratios = tuple(sparse_ratios) or (1,)纯 dense 模型的 ks 是空 dict,但 prepare_cp_mirror 的 kernel 至少需要一个倍率来算 ks/ke 输出。传 (1,) 让 kernel 有合法的 grid,输出随后被丢弃(if has_ks 才写回)。这类“给 kernel 一个 dummy 参数”的写法在 CP 路径上还有几处,读的时候不要误以为模型真的有一个倍率为 1 的稀疏层。
block table 的构建倍率
fill_decode_block_tables 用 min_compress_ratio 建表,而不是每个倍率各建一张。原因是块表描述的是物理块到逻辑块的映射,物理块大小固定;压缩倍率只改变“一个块能装多少个压缩 token”。因此所有倍率共享同一张表,读取时用 block_size // n 换算块内偏移。若某天有人按倍率各建一张表,kv_ca_index 的展开公式必须同步改成按倍率取表,否则会读到错误的物理块。
与其他框架的对照
三家主流框架都有类似的一层,但抽象边界不同。
vLLM 的 InputBatch 维护每条请求的 token、块表与 slot_mapping,decode 时把 slot_mapping 传给 paged attention kernel。它的 slot_mapping 与 DeepInfer 的 slot_mapping_store_ca/swa 是同一个概念:逻辑位置到物理槽的映射。差别在于 vLLM 的默认模型没有多倍率压缩 KV、SWA ring 与 YoCo 截断,所以元数据层不需要按倍率分桶,也不需要四元组 pivots。vLLM 的设计文档对块表与 slot 的解释见参考资料。
SGLang 的 ForwardBatch 把请求池里的字段聚合成批,配合 RadixAttention 的前缀树做复用。它的元数据更多是“把请求对象摊平”,派生索引的计算分散在 attention backend 里。DeepInfer 把派生索引集中到 InputMetadata 与 compute_attn_info,好处是 backend 只消费统一字段,坏处是这个类变成了一个很大的结构体——这也是为什么字段注释写得像规格说明。
TensorRT-LLM 的执行器在 C++ 侧准备输入,Python 侧做编排,思路与 DeepInfer 的 C++ prepare_* 更接近;它的 plugin 与 attention 元数据耦合更紧。DeepInfer 把元数据做成独立数据类,便于 CP 广播与 CUDA Graph 复用,这是它作为“自研引擎”而不是“通用框架”的一个结构性选择。
站内已经拆过这几家的实现,可以对照阅读:DeepInfer 源码完全拆解(一):整体架构与模块全景 给出了模块地图,(三):KV 内存与 SWA 有界重放 讲了块账与截断的缓存侧,(二十一):CP 组对象广播 讲了这份元数据如何跨 rank 传递。
小结与全系列收尾
InputMetadata 的构造可以概括成四句话:
- 调度器只给长度、块表、状态槽与语义标记,其余字段都是派生量;派生的核心是把“序列绝对位置”翻译成“缓冲下标”或“物理槽位”。
- CPU 只写常数级信息,GPU 展开线性信息。
ks/ke、kv_ca_index_offset_len、SWA pivots 都是“给区间”,展开交给 kernel;这是为了把每步 CPU 时间压到与批大小无关的量级。 - 三条路径共享字段语义,不共享实现。prompt 用 C++ 一次构造;decode eager 用 C++ 每步重建;decode ZOS 用“每序列行提取 + 一个 TileLang kernel + 分桶栈”完成原地填充。
- 两套视图描述同一份截断。YoCo 的 mask 模式只换 pivots,compact 模式换行布局并重算
ks/ke,两者由同一个yoco_swa_visibility保证可见域一致。
把这层看懂之后,再回头看注意力 kernel 的入参,就不会被十几个形状各异的张量淹没:每个张量都能追溯到调度器的一个字段,以及一个“为什么必须这样布局”的答案。
从第一篇到这一篇,DeepInfer 系列已经走过二十二个模块:整体架构、ZOS、KV 与 YoCo、EPLB、投机解码、结构化输出、TileLang 算子、采样、视觉编码器、模型层、注意力族、CUDA Graph、并行拓扑、权重装载、基础线性层、C++ 调度器、引擎握手、Engram、MFU、启动显存、CP 广播,以及本篇的输入元数据。剩下的主要是偏外围的部分——tokenizer 与 detokenizer、OpenAI 兼容接口、基准测试脚本与部署配置,它们更多是工程胶水而非推理内核。核心路径(调度 → 元数据 → 前向 → 采样 → 输出)到这里已经闭合。后续若要继续深挖,更有价值的方向是把 DeepInfer 与 vLLM、SGLang、TensorRT-LLM 在同一个模块上做横向对读,本站对此已有若干篇可以衔接。
参考资料
- DeepSeek 官方推理引擎 DeepInfer
- DeepInfer 推理部署问答(SWA、KV Cache 与 P/D 分离口径)
- DeepInfer prepare_tensor_input_v4.cpp(prompt/decode 的 V4 元数据构造)
- DeepInfer prepare_tensor_input_base.cpp(公共底座与块表填充)
- DeepInfer input_metadata.py(InputMetadataV4 字段与 compute_attn_info)
- DeepInfer prepare_tensor_input_zos.py(ZOS 输入构造与分桶栈)
- DeepInfer yoco.py(YoCo mask/compact 两种元数据视图)
- DeepInfer prepare_v4_decode_metadata.py(decode 元数据的 TileLang kernel) 8a. DeepInfer parallel_state.py(CP 组与 gloo 控制通道) 8b. DeepInfer parallel_utils/communication_op.py(cp_broadcast 与张量字典广播)
- vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention
- vLLM 设计文档:Paged Attention
- StreamingLLM: Efficient Streaming Language Models with Attention Sinks
- StreamingLLM 官方代码仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



