


DeepInfer 源码拆解(十五):Linear、RMSNorm 与 RoPE——解码层里最不起眼的三块部件如何被改造成引擎的形状
写在开头:从「参数容器」走到「运行时部件」
前面几篇已经把 DeepInfer 的骨架搭起来了:第一篇讲整体架构与模块全景,第十篇讲 v4_modules 的参数容器族与 mHC 主干,第十一篇讲注意力族如何把压缩 KV、稀疏索引和 MLA 拼在一起,第十三篇讲 DP Attention 与 Wide-EP 的四轴并行拓扑,第十四篇讲权重如何按 EP rank 物化到每张卡上。
到这一步,模型参数已经落在正确的显存位置、正确的分片形状里。但一次前向真正跑起来时,每层的计算由另一批类承担:deepinfer/model_executor/layers/ 下的运行时部件。这一篇只挑其中最小、最不起眼、却每层每步都要调用好几次的三块来讲:
ReplicatedLinear:所有线性投影的公共实现,也是 FP8/FP4 权重的 GEMM 入口;RMSNorm:融合了残差相加、归一化和(可选)FP8 cast 的一体化算子;RotaryEmbedding:预计算 cos/sin 表,按 token 位置行切片查表。
之所以单开一篇,是因为这三块和注意力、MoE 这些大块头不同:它们没有复杂的调度逻辑,但恰恰是它们决定了解码路径上每一次 kernel 启动的上下文能不能被复用、每一次很小的访存是不是多余、每一次微小的数值偏差会不会让确定性承诺失效。把它们看懂,再回看注意力后端和 CUDA Graph 那几篇,会发现那些设计很多都是围绕这三块部件的接口约定展开的。
前置概念如果还不熟,可以看本站的 RoPE 完全拆解(旋转位置编码的数学与长度外推)、MLA 完全拆解(低秩压缩 KV 与 RoPE 解耦),以及 RMSNorm 论文(LayerNorm 的简化变体)。
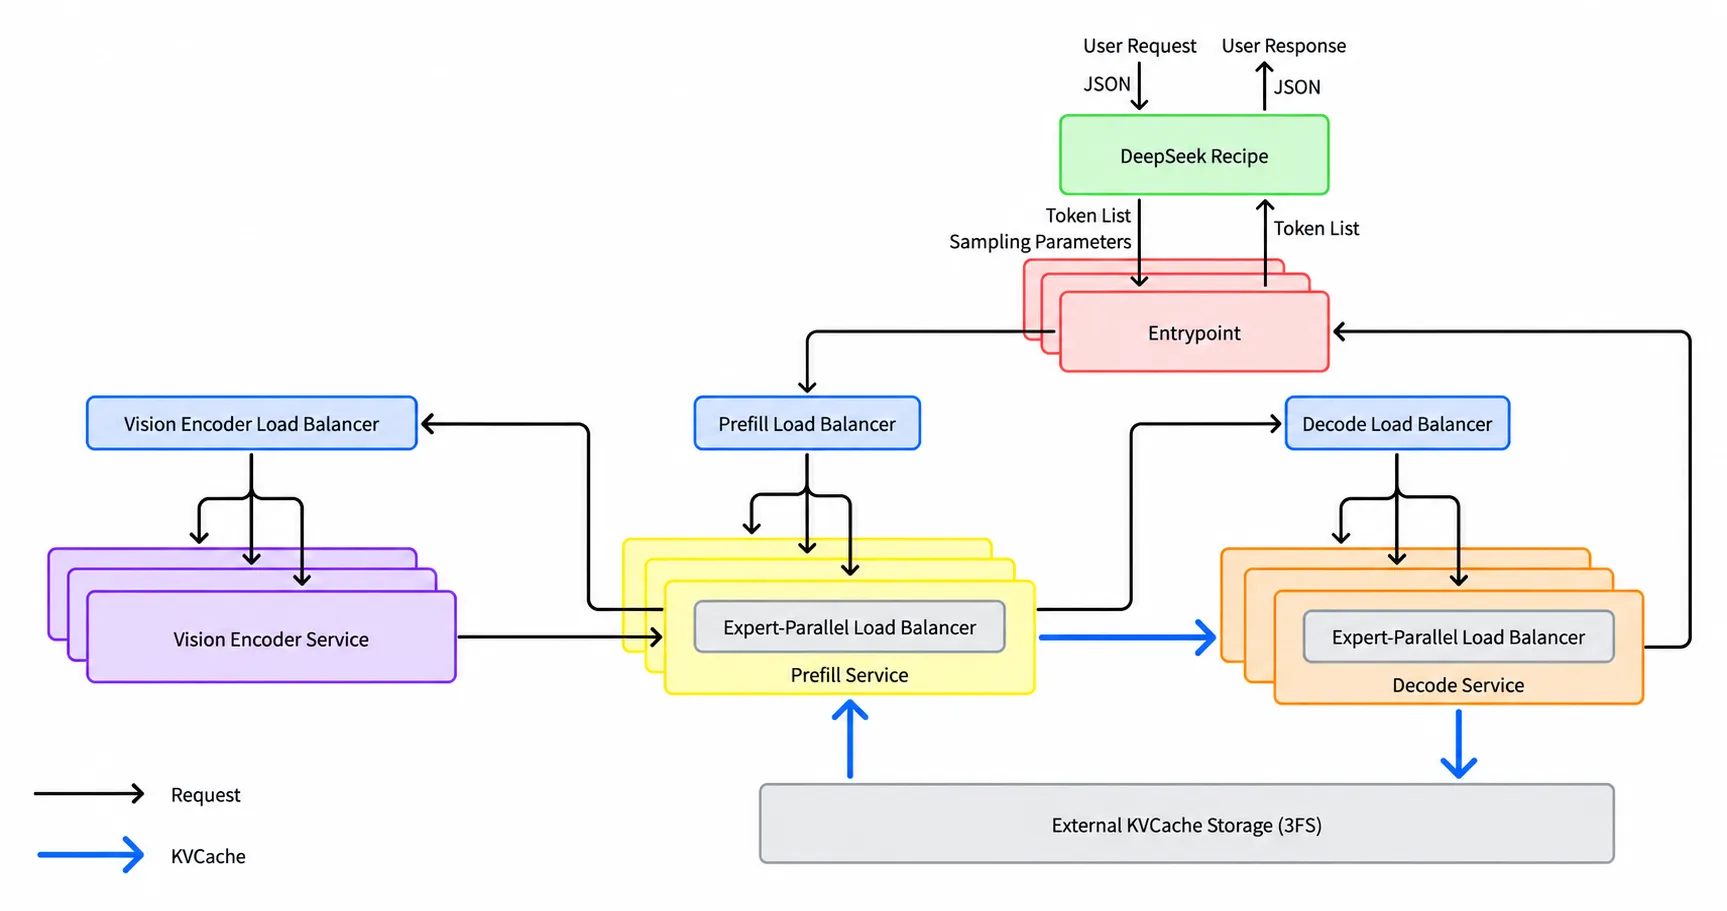
图:DeepInfer 仓库提供的架构总览。本篇关注的
layers/linear.py、layers/layernorm.py、layers/rotary_embedding.py对应图中每个 Transformer block 内的前向主线;注意力侧的 KV 写入则经fused_norm_rope_hadamard_cast_store_kvcache直接落到 page 池。来源:deepseek-ai/DeepInfer。
下面分三部分展开:先讲 Linear,再讲 RMSNorm,最后讲 RoPE,并在每一部分末尾回答一个”为什么这么写”的问题——这三个答案合起来,就是这一篇的主线。
一、Linear:为什么每层的输出都要按 32 字节对齐
打开 deepinfer/model_executor/layers/linear.py,第一眼看到的不是 GEMM 本身,而是几行常量:
_OUTPUT_ALIGNMENT_BYTES = 32
def get_fp8_casting_granularity() -> int: return 32
def get_fp8_cast_params() -> dict[str, Any]: return { "fmt": "e4m3", "num_per_channels": get_fp8_casting_granularity(), "round_sf": True, "use_packed_ue8m0": True, "use_tma_aligned_col_major_sf": True, }ReplicatedLinear 的类注释只有一句话:Replicated linear layer——权重的每一行都完整复制在每个 rank 上,不做张量并行切分。DeepInfer 的并行拓扑是 DP Attention + Wide-EP(见第十三篇),注意力和 MLP 的矩阵都不做 TP 切分,所以这里的 ReplicatedLinear 是真正意义上的”每卡一份完整权重”。这一点和 vLLM 的 RowParallelLinear / ColumnParallelLinear 体系完全不同:没有 TP 通信,也没有 world_size 相关的归约,代码因此短了很多。
1.0 两个同名类:参数容器与运行时 GEMM 的分工
在 v4_modules/linear.py 里还有一个同名的 ReplicatedLinear,它只有几十行,继承 nn.Linear:
class ReplicatedLinear(nn.Linear): """Complete linear weights, optionally prepared as FP8 on meta.""" def __init__(self, in_features, out_features, *, bias=False, use_fp8_gemm=False): super().__init__(in_features, out_features, bias=bias) self.use_fp8_gemm = use_fp8_gemm这个类不参与前向。它的作用是让 HF 参数树按原始名字、原始形状分配权重:q_proj.weight、o_proj.weight 这些名字必须与 checkpoint 一一对应,否则权重加载器找不到。use_fp8_gemm 也只是给加载器看的元数据——它说明”这一层的权重在 checkpoint 里是不是 FP8/FP4 物化的”,而不是运行时分支的开关。
运行时类 layers/linear.py::ReplicatedLinear 则相反:它在 __init__ 里接收已经物化好的 weight(以及可选的 bias),断言 weight.shape == (output_size, input_size),然后用 reconstruct_param(weight) 包一层:
def reconstruct_param(param): p = torch.nn.Parameter(param.data, requires_grad=False) if hasattr(param, "sf"): p.sf = param.sf return p注释里说得很直白:重新构造 nn.Parameter 是为了隔离模型之间的参数生命周期,避免释放一个模型时把另一个模型的参数存储一起清空。这个细节和”两个同名类”是同一个设计意图的两面——容器负责长得像 HF,运行时负责算得像引擎。use_fp8_gemm 与运行时实际走哪条 GEMM 路径无关:运行时只看 weight.dtype 和 weight.element_size(),所以即使容器标了 use_fp8_gemm=False,只要加载进来的权重是 FP8,运行时仍会走 apply_weight_fp8。两边的唯一契约是”权重形状与 sf 属性”。
1.1 输出对齐:32 字节、一次空分配、一个切片视图
真正有意思的代码在 _allocate_output 和 _align_output:
def _allocate_output(self, shape, dtype, device): assert len(shape) >= 2 and shape[-1] == self.output_size itemsize = dtype.itemsize outputs_per_alignment = _OUTPUT_ALIGNMENT_BYTES // itemsize physical_output_size = (self.output_size + outputs_per_alignment - 1) \ // outputs_per_alignment * outputs_per_alignment storage = torch.empty((*shape[:-1], physical_output_size), dtype=dtype, device=device) return storage[..., : self.output_size]
def _has_aligned_output_stride(self, output): assert output.stride(-1) == 1 return output.stride(-2) * output.element_size() % _OUTPUT_ALIGNMENT_BYTES == 0这两段代码把”输出最后一维必须对齐到 32 字节”变成了一条硬约束:
- 分配端:按
(M, N)视图调 GEMM 时,out的实际底层 buffer 行宽会被向上取整到 32 字节的整数倍,然后返回一个storage[..., :N]的切片视图。于是out.shape[-1] == N,但out.stride(-2) * itemsize至少是ceil(N * itemsize, 32)。 - 校验端:
_has_aligned_output_stride只检查行间跨距,不检查形状,所以切片视图能通过。
为什么要做这件事?因为 DeepInfer 的 GEMM 走 deep_gemm 提供的 bf16_gemm_nt / fp8_fp4_gemm_nt 接口,这些接口内部的 TMA(Tensor Memory Accelerator,Hopper 起的异步批量搬运单元)访问要求输出矩阵的行首地址按 32 字节或 128 字节对齐。如果直接分配 torch.empty(M, N),当 N * itemsize 不是 32 的倍数时,第 i 行的起始地址 i * N * itemsize 就可能落在不对齐的位置,TMA 会拒绝或者退化成低效路径。
那为什么不干脆让所有层的 N 都是 32 的倍数?因为 DeepInfer 的线性层横跨从 hidden_size(数千)到各类小输出维度的场景。比如 heads.py 里的 MarkovGPTHead 有一层 markov_w2 = ReplicatedLinear(self.markov_rank, cfg.vocab_size, ...),它的输入维度只有 markov_rank;又如 AcceptRatePredictor 的输出维度是 1。这些都不保证是整齐的倍数。把所有 N 强制对齐意味着要在模型结构里做”补零”——这会牵动权重加载、shape 校验、采样输出 shape 一堆地方。与其在模型层处理,不如在 linear 这一层兜底:输出行宽永远向上对齐,对外 shape 永远等于用户期望。这是一种接口层吸收硬件约束的典型手法。
1.2 行主序输出和列主序 SF:为什么 cast 参数里有两个”对齐”开关
再往下看 FP8 路径:
def apply_weight_fp8(self, x, bias=None, out_acc=None): assert bias is None if isinstance(x, torch.Tensor): x = tile_kernels.quant.per_token_cast(x, **get_fp8_cast_params()) weight = (self.weight, self.weight.sf) ... deep_gemm.fp8_fp4_gemm_nt(x, weight, out, out_acc, recipe=(1, 1, 32)) return out这里有两个与对齐有关的选择:
use_packed_ue8m0=True:E8M0 是 FP8 的 8 位指数型 scale 格式,它没有符号位和尾数位,值只有 这一个自由维度。因为 E8M0 只占 1 字节,四个连续的 scale 可以塞进一个int32里——这就是 packed 的含义。packing 后每 4 个 scale 共用 1 个 4 字节槽位,scale 向量每 4 个一组刚好对齐到一个 4 字节事务,这也是为什么在tilelang_ops/norm.py的_alloc_fp8_sf里会看到pack_factor = pack_dtype.itemsize和d_scale % pack_factor == 0这类断言。use_tma_aligned_col_major_sf=True:SF 矩阵(每个 token 每 32 个元素一组 scale)排成列主序,并且每一列补齐到 4 行对齐(代码里m_pad = (seqlen + 3) // 4 * 4)。这是 DeepGEMM 对 TMA 搬运 SF 的要求——SF 矩阵被当成一个独立的、每列 4 行一组的张量喂给 GEMM。
而在 linear 里,权重 SF 的布局是在构造时一次性处理掉的:
if self.weight.element_size() == 1: self.weight.sf = weight.sf if self.weight.sf.dtype != PLATFORM.fp8_sf_type: self.weight.sf = deep_gemm.transform_sf_into_required_layout( self.weight.sf, self.weight.size(0), self.weight.size(1), recipe=(1, 32, 32), is_sfa=False, )注意这里的 is_sfa=False。DeepGEMM 的 SF 有两种角色:sfa 是激活(左操作数 A)的 scale,随 batch 变化、运行时 cast;sfb 是权重(右操作数 B)的 scale,在权重就绪时一次性排好。transform_sf_into_required_layout 做的就是”把任意布局的权重 scale 重排成 TMA 列主序”这一步,它只跑一次,所以放在 __init__ 里。反观激活 SF,则是每次前向时 per_token_cast 现算、现排,因此 cast 参数里必须带 use_tma_aligned_col_major_sf=True。
这就解释了为什么 get_fp8_cast_params() 和权重初始化要各自调一次布局转换:两者都是 TMA 列主序,但生命周期完全不同——权重常驻,激活一次性的。
1.3 out_acc:一个让 GEMM 变成累加器的参数
第三个值得讲的参数是 out_acc。所有 apply_weight_* 都带着它:
def apply_weight_bf16(self, x, bias=None, out_acc=None): ... bf16_gemm_nt(x.view(m, k), weight, self._flatten_output(out), out_acc) if bias is not None: out += bias return out在 GEMM 的经典数据流里,一次乘法通常有两种写法:D = A @ B(输出为结果)和 D = A @ B + D(输出是累加)。out_acc 走的是后者——如果传入一个与输出形状相同的 out_acc,GEMM 在该 buffer 上做累加,而不是覆盖写。
这个参数在 DeepInfer 里最常见的两个调用点,恰好都在本篇的外围:
v4_modules/mlp.py里的DeepseekMoE.shared_forward:return self.shared_down_proj(down_in_hidden, out_acc=out_acc)。注释里说得很清楚——如果fuse_shared没启用,共享专家那一路的shared_down_proj会累加到 mega MoE 已经算好的out上。也就是说,在部分层里,路由专家和共享专家的输出是两次独立 GEMM,然后通过out_acc合并到同一块 buffer 里。models/mtp/dflash.py里的 Markov 修正:logits = self.markov_w2(w1, out_acc=logits)。DFlash 的每个草稿步都要在基础 logits 上加一个一阶 Markov 修正项,这个修正项也是一个线性层。直接走out_acc就免去了”分配临时 logits、做加法、再覆盖回原 buffer”这套多余的访存。
这两个用例把 out_acc 的意义写得很清楚:它不是”加速”的参数,而是”合并”的参数——让若干个形状相同的 GEMM 共享同一块输出,从而把”分配 + 加法”这两步从热点路径上消掉。
但这里有一个隐藏的约束:out_acc 必须满足 _has_aligned_output_stride。代码里对传入的 out 也做了同样的判断:
assert out.shape == (*m_shape, n)assert self._has_aligned_output_stride(out)也就是说,调用方传进来的 out_acc 自己也要对齐。实践中它通常就是从另一个 ReplicatedLinear 的输出来的,那个输出本来就是对齐的切片视图,因此这条断言几乎不会失败。真正失败的情况是调用方自己 torch.empty 一块不规则形状的 buffer 当累加器——这种情况会在断言处显式报错,而不是悄悄地丢掉性能。
1.4 为什么要让 _flatten_output 如此挑剔
_flatten_output 做的事情只有一件:把 (..., N) 的 N 维视图折叠成 (M, N) 的二维视图,喂给 GEMM。但它带着一长串断言:
assert all(output.stride(i) == output.stride(i + 1) * output.shape[i + 1] for i in range(output.ndim - 2))这条断言要求外层各维严格是连续的。为什么这么严格?因为 out 可能来自 _allocate_output 的切片视图——它的最后一维已经连续,但行间跨距被向上取整了,所以在折叠时不能让行间跨距被”压平”。折叠公式 (output.stride(-2), 1) 正好保留了这个被对齐后的跨距;如果外层不是连续的,折叠出来的二维视图就会错位。
这也解释了一个小细节:_allocate_output 只有在输出”外层连续”的情况下才能返回切片视图。如果调用方传入一个本身就不连续的 out(例如从别的算子里拆出来的一段),_align_output 会退化成”分配一块对齐的新内存再 copy_”,代价多一次拷贝。所以对齐不是免费的:它要求所有上游都尽量返回连续输出,而这在 DeepInfer 里是做得到的——因为大部分算子的输出都是自己分配的。
1.5 这条线通到哪里:融合算子的对齐检查
Linear 这一节的对齐讨论看起来只是数学层面的,但它在下一部分会派上用场:layers/tilelang_ops/fused_transform.py 里的融合算子也要做对齐检查:
assert x.dtype == torch.bfloat16 and x.ndim in (2, 3) and x.stride(-1) == 1...assert x.stride(1) % 16 == 0assert x.stride(0) % 16 == 0n, num_heads, head_dim = x.shapex 的形状是 [num_tokens, num_heads, head_dim],这里的检查要求 token 维和 head 维的步长都按 16 个元素对齐。这个约束和 Linear 里”输出行宽按 32 字节对齐”的思路一致——只有上游输出按行对齐,下游按”行”或”头”访问的算子才能用向量化指令直接读,而不必先 contiguous() 一次。两个模块从不同角度把同一个物理约束写进了接口。
二、RMSNorm:为什么一个归一化要吃掉 residual 和 FP8 cast
RMSNorm 本身只有一行公式:
是隐藏维度(DeepSeek 系模型常见 7168), 是长度为 的可学习权重, 是防除零的小常数。RMSNorm 的论文指出,相比 LayerNorm,去掉均值中心化和偏置后效果几乎不变,但少了一次归约和一次向量减法。
但如果只按这个公式实现,解码路径上每层都会浪费:前一层子层的输出要先和残差相加,再做归一化,再转 FP8 喂给下一个 GEMM。这是三个独立算子、三次 kernel 启动、三轮读和两轮写。DeepInfer 的 layers/layernorm.py 把这三件事一口气做完:
def forward(self, x, residual=None, out=None, return_bf16=False, fp8_cast_params=None, extra_sf_layout=None, extra_sf_out=None, extra_sf_block_m=0): if fp8_cast_params is None: fp8_cast_params = get_fp8_cast_params() if self.use_fp8 else {} return norm(x, self.weight, residual=residual, eps=self.variance_epsilon, out=out, **fp8_cast_params, extra_sf_layout=extra_sf_layout, extra_sf_out=extra_sf_out, extra_sf_block_m=extra_sf_block_m, return_bf16=return_bf16, out_scale=self.out_scale)类本身只有 60 多行,真正的实现全在 layers/tilelang_ops/norm.py 的 norm() 函数里,而它用 TileLang 写了一整套 kernel 分支。这一节按”融合了什么”、“返回了什么”、“边界在哪里”三段来讲。
2.1 融合了什么:加法、归约、归一化、cast、scale 排布
norm() 的签名已经泄露了全部融合信息:
residual:先做x + residual,再做统计。注意顺序——文档字符串写的是”先以 x.dtype 相加,再转 float32 做 norm 统计”,也就是加法在 BF16 中完成,只有统计才升到 FP32。这样做省下了把 residual 转 FP32 的带宽,也避免了x + residual这一步因为精度差异和参考实现分叉。out/return_bf16:如果fmt非空(即要 cast 成 FP8),out的 dtype 是float8_e4m3fn,同时如果return_bf16=True,kernel 还会额外写一份 BF16 结果。为什么要同时保留 BF16?因为下一层的 GEMM 可能用 FP8(use_fp8=True),但也可能因为 MoE 路由、门控打分等需要高精度而用 BF16;两份结果一份喂 FFN 或注意力,一份喂 router 或 mHC 的 mix 计算。out_scale:把归一化结果的幅度缩放一个常数。RMSNorm的构造函数默认out_scale=1.0,但models/v4_modules/mla_attn.py里 kv_lora 的 norm 会传入kv_lora_norm_out_scale——这个参数在attn.py里被 assert 等于 1,但在 checkpoint 中确实存在。于是引擎把这个常数融合进归一化,而不是在归一化后再做一次逐元素乘法。extra_sf_layout / extra_sf_out / extra_sf_block_m:把一份额外排布的 scale 直接写进调用方预分配好的 buffer。这是给 mega MoE(共享专家的融合 kernel)准备的shared_l1_acts_sf——这个 SF 的转置规则很特殊:块内行号按m → (m//128)*128 + (m%32)*4 + (m%128)//32重排,这是统一通信里 128×4 分块的排布方式。如果不在 norm 里顺手写出来,调用方还得再起一个 kernel 做转置,成本等于白算一次。is_exp_norm:checkpoint 里 norm 权重有时以对数形式存放,容器的DropoutAddRMSNorm.get_weight()在is_exp_norm=True时返回self.weight.exp(),运行时RMSNorm拿到的已经是有效权重。引擎不需要知道这个约定,只在装配时展开一次。
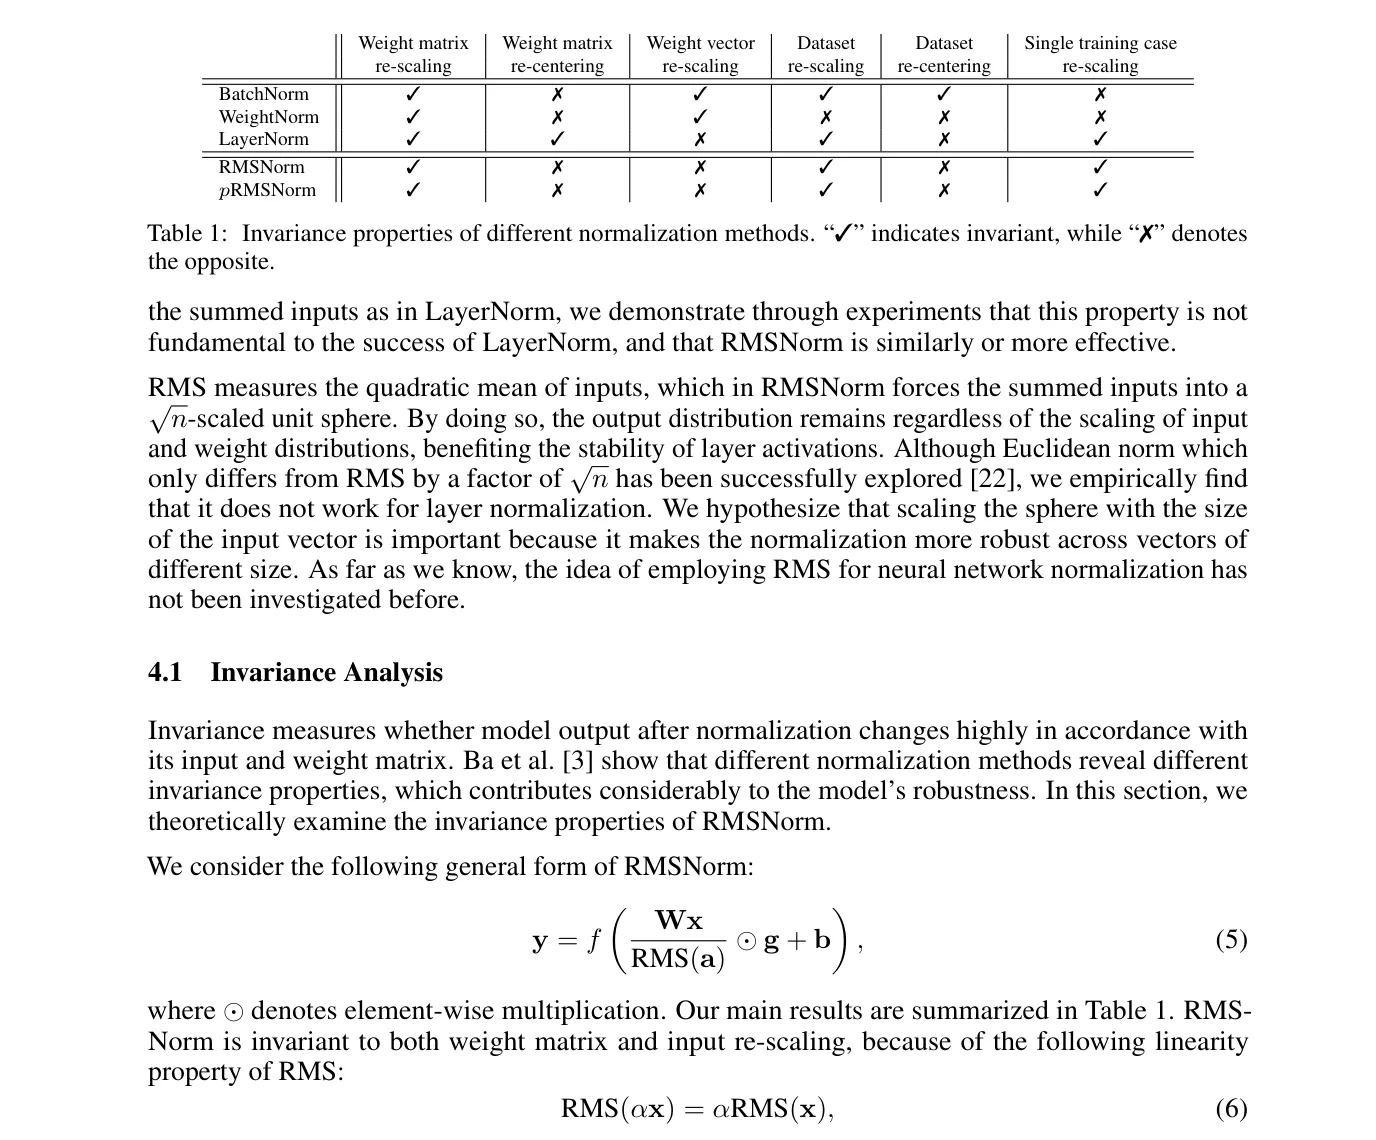
图:RMSNorm 论文表 1 的截取。
√表示该归一化方法对对应变换保持不变,×表示会受影响。可以看到 RMSNorm 对权重与输入的 re-scaling 都不变(因为只除以均方根、不做去中心化),这正是它能安全融合out_scale、并在不同 FP8 scale 布局下保持数值稳定的原因;代价是它对 re-centering 不再不变,这也是它不能单独替代 LayerNorm 的场合。来源:Biao Zhang、Rico Sennrich,Root Mean Square Layer Normalization 表 1。
2.2 返回什么:(out, sf) / (out, out_bf16) / (out, residual_out) 由外到内层层套
norm() 的返回值不是单一 tensor,而是根据开关组合出的嵌套结构。代码末尾的封装顺序是:
result = (out, sf) if do_fp8_cast else outif return_bf16: result = (result, out_bf16)if residual is not None: result = (result, residual_out)return result于是调用方的解包是固定模式的:
hidden_states, residual = self.attn_layernorm(hidden_states, residual, return_bf16=True)hidden_states, hidden_states_bf16 = hidden_states第一行拿到的是 ((out, bf16), residual_out);第二行再把 (out, bf16) 拆开。这个解包顺序在 v4_modules/hc.py 的 attn_norm_forward 里、ffn_norm_forward 里和 decoder_layer.py 里都用到了。
这种”按需嵌套”的返回值有好处也有代价:
- 好处是同一个 kernel、同一份内部 BF16 缓冲区,可以同时服务 FFN 的 FP8 GEMM(
out)、mHC 的 FP32 mix GEMM(bf16)和残差链(residual_out),一次读写三处使用。 - 代价是调用方必须记住解包顺序,而且
residual is not None时residual_out被放在最外层——如果哪层忘记传return_bf16,hidden_states_bf16就会拿错对象。这是这类”融合函数返回嵌套元组”的通病,DeepInfer 把它控制在少数几个调用点上,避免了问题扩散。
residual_out 本身是 x + residual 的结果,不带归一化;下一层用的正是它——这就是 Pre-LN 里”残差链”的语义:每层只存一份未经归一化的残差流,norm 输入是这一份,norm 输出喂给子层,子层输出再和这一份相加。在融合 kernel 里,residual_out 和 out 的读地址相同但写内容不同,所以必须是两份 buffer。
2.3 边界的实现:为什么 kernel 的实参列表里塞了一堆用不到的张量
norm() 在调 TileLang kernel 时有一段很典型的防御:
kernel = ops.norm_tl( N, dtype, out_dtype, "float", residual is not None, eps, out_scale, do_fp8_cast, num_per_channels, use_tma_aligned_col_major_sf, round_sf, use_packed_ue8m0, out_origin is not None, 2 if B == 1 else 3, extra_sf_block_m, x_stride_s=..., y_stride_s=..., residual_stride_s=..., ...)kernel( x, out, weight, residual if residual is not None else x, residual_out if residual_out is not None else x, sf_kernel_arg if sf_kernel_arg is not None else x, extra_sf_kernel_arg if extra_sf_kernel_arg is not None else x, out_origin if out_origin is not None else x,)四个”未启用则传 x 占位”的实参,是 TileLang 这类 DSL 的固有约束:kernel 的参数列表在编译期固定,运行时没法”少传一个”。但把一个形状完全不对的占位张量传进去也有风险——如果 kernel 里某条分支不小心读了它,就会越界。DeepInfer 的做法是把”是否启用”也从编译期参数里传进去(residual is not None、do_fp8_cast 等),让 TileLang 在生成代码时直接消掉不用的分支。这是用编译期特化换取运行时零分支:每个 (dtype, 是否 residual, 是否 cast, 粒度, SF 布局) 组合编译出一个独立 kernel,命中率由运行时路径有限决定,编译产物数量可控。
这也解释了为什么 x.ndim 只能是 2 或 3,为什么 x.stride(1) 和 out.stride(1) 要作为动态参数传入(x_stride_s=...):这些 stride 决定矢量化访存的粒度,而且它们会随调用点不同(例如 mHC 的 [n, hc_mult, hidden] 三维张量)而变化,无法作为常数烘焙进去。
2.4 mHC 层里的调用:一个 norm 被推迟使用
v4_modules/hc.py 的 attn_norm_forward 和 ffn_norm_forward 在 hc_enabled=True 时都走 _hc_fused_post_pre,最后在 _hc_pre 里才真正调用 hc_modules.layer_norm(...):
def _hc_pre(self, residual, hc_modules, prev_pre_layer_mix, cast_kwargs=None): residual = residual.unsqueeze(0) if not self.hc_shifted: post_layer_mix, comb_res_mix, layer_input = mhc_pre_big_fuse( residual, hc_modules.fn, hc_modules.scale, hc_modules.base, self.hc_norm_eps, self.hc_pre_eps, self.hc_sinkhorn_eps, self.hc_post_mult_value, self.hc_sinkhorn_repeat, ) else: ... normalized_input_fp8, normalized_input_bf16 = hc_modules.layer_norm( layer_input.squeeze(0), return_bf16=True, **(cast_kwargs or {}), )在 mHC 模型里,进入 norm 的不是”单路残差”,而是由 mhc_pre_big_fuse 混合出的一路 layer_input。norm 本身没变,但它输入的计算过程变了——所以 norm 的 residual 参数这里没有传:residual 已经参与了混合,混合后再单独归一化。这正是”融合 residual 的 norm”与”不融合 residual 的 norm”在接口上的区分:融合是一种便利,而不是默认。mHC 需要自己接管残差混合时就直接调用不带 residual 的分支。
2.5 三种 SF 布局:同一个 kernel 怎么服务三类 GEMM
norm() 的 fp8 分支最终由 _alloc_fp8_sf 决定 scale 的物理布局。代码里有三条互斥的分支,对应三类下游:
| 布局 | 形状 / 步长 | 主要消费者 | 选择开关 |
|---|---|---|---|
| row-major fp32 | (B, M, d_scale) 连续 | 参考实现、部分非 TMA 路径 | use_tma_aligned_col_major_sf=False |
| row-major packed ue8m0 | (B, M, d_scale/pack_factor),每元素打包 4 个 1 字节 scale | mega MoE 的 x_sf | use_packed_ue8m0=True |
| col-major packed ue8m0 | 底层 (B, packs, m_pad),对外 mT[:, :M],每列补齐 4 行 | DeepGEMM 的 TMA 读取 | 两个开关都为 True(默认) |
第三种的 m_pad 不是随便取的:m_pad = (seqlen + 3) // 4 * 4 保证每列起始地址按 4 个元素对齐,storage.view(uint8).as_strided((B, M, packs, pack_factor), (packs*m_pad*pack_factor, pack_factor, m_pad*pack_factor, 1)) 把同一块 buffer 同时解释成”对外视图”和”kernel 实参视图”。这就是为什么 norm() 返回的 sf 对象有 shape、stride、dtype 三重约束——它不只是数据,还是 TMA 描述符的一部分。
第四种是 extra_sf_out:形状 (M, d/128) 的 int32 张量,步长 (1, rows),每个块内行号按 UTCCP 的 128×4 分块转置。它只服务于 mega MoE 的共享专家,要求 num_per_channels=32 且 round_sf=True。代码里对 rows 的断言是:
assert (M + extra_sf_block_m - 1) // extra_sf_block_m * aligned_block_m <= rows意思是:按 extra_sf_block_m 分块后,每块补齐到 128 行,总行数不能超过底层 buffer。这个断言把”块内转置 + 块间 padding”的布局规则写死在了接口上,调用方只要按契约分配 buffer,kernel 就能直接写。
三、RoPE:cos/sin 表为什么要按行预计算、按行读取
RoPE 的核心是一个简单的几何事实:把每一对相邻维度 当成复数 ,乘上 ,其中 是 token 位置, 是每一对维度对应的旋转频率。因为旋转不改变模长, 只依赖相对位置 。详细推导可以看站内 RoPE 完全拆解。
在推理引擎里,这个旋转的常见实现是:预先计算每个位置 的 和 ,存成一张 [max_position, rotary_dim] 的表,运行时按 token 的 position 去表里取对应行。DeepInfer 的 layers/rotary_embedding.py 正是这种写法,但它在三个地方做了和标准实现不同的选择。
3.1 表的形状:为什么是 (cos, sin) 拼在一行,而不是两张表
def _build_cos_sin_cache(t, inv_freq, mscale=1.0): freqs = torch.outer(t, inv_freq) freqs_cis = torch.polar(torch.ones_like(freqs), freqs) cos = freqs_cis.real.cuda() * mscale sin = freqs_cis.imag.cuda() * mscale return torch.cat((cos, sin), dim=-1)注意 dim=-1:cos 和 sin 是沿旋转维拼接成一行。表的总宽就是 rotary_dim(cos 占一半,sin 占一半)。这样一行的布局是:
[ cos(θ_0) ... cos(θ_{d/2-1}) | sin(θ_0) ... sin(θ_{d/2-1}) ]为什么要拼在一起?因为 apply_rotary 拿到一个位置后,只需要 一次按行加载,就能同时得到 cos 和 sin 两个向量,然后一次算完这两个旋转后维度。如果拆成两张表,就要两次按行加载;如果和常规做法一样把表扩成 (x, y) 交错排(每对维度两列),那么 cosine 与 sine 会被穿插到同一行的不同偏移,旋转时仍需两路读取并重新配对,而按行连续读、整行参与计算的向量化方式就会被破坏。
torch.polar 这一步是为了保证 cos/sin 的数值来源一致——先用极坐标 一次性得到实部和虚部,再乘法缩放 mscale。在 YaRN 扩展里,mscale 会对所有频率的幅度做一个统一缩放以补偿长度外推带来的注意力分布偏移,见后文。用极坐标而不是分别取 cos(freqs) / sin(freqs),也顺手避免了”大角度下 cos 和 sin 分开算导致模长不为 1”的数值偏差。
3.2 YaRN 的 inv_freq:插值 / 外推怎么混、表为什么可以更窄
在 RotaryEmbedding 的基类里,inv_freq 是标准的:
inv_freq = 1.0 / (self.base ** (torch.arange(0, self.rotary_dim, 2, dtype=torch.float) / self.rotary_dim))到了 YaRNScalingRotaryEmbedding,_compute_inv_freq 做了三件事:
- 插值 / 外推分段混合:按照
beta_fast和beta_slow给出的旋转圈数阈值,把维度分成”高频(保持外推)“和”低频(改为插值缩放)“两段,中间用一个线性斜坡做平滑过渡:
其中 是原始频率, 是缩放因子(factor,也就是把位置压回的倍数), 是维度 的混合权重, 由 _yarn_linear_ramp_mask(low, high, ...) 在 上做线性截断得到。这段逻辑和 vLLM 的 YaRN 实现完全一致(注释里也引用了 jquesnelle/yarn 的工作)。
为什么需要一个”斜坡”而不是直接二分?因为不同维度的周期相差很大:高频维度在长文本下每转一圈的误差会累积,低频维度在短文本下几乎不旋转。二分切在某个维度上会让相邻维度在两段之间突变,进而破坏相对位置衰减的平滑性。beta_fast 和 beta_slow 给出的正是”在该位置长度下大致转了多少圈”的两个阈值,_yarn_find_correction_dim 把它们反解成维度下标,_yarn_linear_ramp_mask 再在这两个下标之间做线性截断。extrapolation_factor 是额外的可调项,默认 1——把它设大于 1 会让原本属于插值段的维度也部分外推,通常是调参时的最后手段。
-
按周期阈值截掉高频段:
high_freq_cycle_threshold换算成频率阈值inv_freq_hi = 2π / high_freq_cycle_threshold,然后取inv_freq <= inv_freq_hi的第一个下标作为采样起点。含义是:周期比这个阈值短(频率比它高)的那些维度,在目标长度下的行为已经和原模型一致,无需保留在表里。这是一种可选的剪枝——只保留”真正需要按新频率旋转的那部分维度”的 cos/sin,用更窄的表覆盖更长的文本。 -
降采样
rope_freq_sample_interval:在截断之后,再每隔interval个维度取一个,等同于将剩余维度的频率稀疏化。这一步和上一步都是可选的:默认interval=1、阈值为空,表宽不变。
代码里还有一个排序断言 assert inv_freq.equal(inv_freq.sort(descending=True).values)——这要求 inv_freq 按降序排列,否则”第一个小于阈值的下标”就不代表真正的截断点。这是截断剪枝的正确性前提。
这两步最终都会让 inv_freq 的长度变短,而 cos_sin_cache 的宽度直接等于 len(inv_freq) * 2。
设计边界说明:
rope_freq_sample_interval和high_freq_cycle_threshold在源码里只出现在 YaRN 变体的_compute_inv_freq中,默认取自rope_scaling字典的额外字段。DeepInfer 的_rope_yarn_params(hugging_face/config.py)只从 HF 配置转写四项:original_max_position_embeddings、factor、beta_fast、beta_slow;这两个采样字段虽然被get_rope的extra_kwargs白名单接受,但当前 HF 配置解析路径不会写入。也就是说,V4.1 权重按默认配置不会触发这两个剪枝,它们是为其他模型变体预留的扩展点。另外convert_rope构造 YaRN 字典时同样只写这四项与mscale,也不带采样参数。
3.3 一次真正的 RoPE:MLA 上下文里的 conjugate=True
RotaryEmbedding.forward 的签名是 (positions, query, key=None, conjugate=False),它把真正的旋转交给 tile_kernels.transform.apply_rotary(一个按位置就地修改的 kernel)。在 v4_modules/attn.py 中,RoPE 出现了多处,而最有意思的一处是”反向”用的:
def _wv_and_o_proj(self, context, positions): if not self.use_fused_norm_rope_attn_rope_cast: self.rotary_emb(positions, context[..., -self.qk_rope_head_dim :], conjugate=True)在 MLA 里,注意力输出的 context 是按 KV 的打包顺序组织的,尾部 qk_rope_head_dim 维对应 KV 的 rope 段;写入缓存时这段已经带着与 K 相同的位置旋转。为了让 O 投影看到原始基下的 V 语义,标准 MLA 实现会先对 context 的 rope 段做一次逆旋转(用 而不是 ),再做 O 投影。conjugate=True 就是这一逆旋转的开关。在 fused_transform.py 的参考实现里,conjugate 被作为 apply_rotary(..., conjugate=conjugate) 的参数传入,取负号的处理在 apply_rotary 内部完成。当 use_fused_norm_rope_attn_rope_cast=True 时,这一步由注意力 kernel 内部完成,_wv_and_o_proj 里的显式逆旋转被跳过。
这里的意义是:RoPE 在引擎里不是”只在 Q/K 上做正向旋转”这一种用法——它对同一张 cos/sin 表取反,实现了 MLA 的”旋转 → 注意力 → 逆旋转”闭环。所以那张表既要有正频率,也要能按相反方向使用;forward(..., conjugate=False/True) 这个单一接口就已经覆盖了两者。
3.4 RotaryEmbedding.forward 的 key=None:为什么 K 可以单独旋转
签名里 key 是可选的。在常规 MHA 里,Q 和 K 的形状都是 [num_tokens, num_heads, head_dim],apply_rotary 可以一次把两者都旋转。但当模型使用 MLA 或 GQA 且 K 以”单头”压缩形式存在时,K 的形状是 [num_tokens, 1, head_dim]——它在 forward 的注释里被写成:
# `key` shape: [num_tokens, 1, qk_rope_head_dim]单头 K 和 Q 各自调用 apply_rotary,可以省去把两者拼成一个大张量再拆开的开销。这也与 RoPE 的数学性质吻合:Q 和 K 的旋转彼此独立,唯一的约束是它们必须共享同一张表和同一组位置。
3.5 一次建表、全局复用:_ROPE_DICT 与 CUDA Graph 的配合
rotary_embedding.py 的末尾有一个全局缓存:
_ROPE_DICT: dict[tuple, RotaryEmbedding] = {}
def get_rope(head_size, rotary_dim, max_position, base, is_neox_style=True, rope_scaling=None): key = (head_size, rotary_dim, max_position, base, is_neox_style, tuple(rope_scaling.items()) if rope_scaling is not None else None) if key in _ROPE_DICT: return _ROPE_DICT[key] ... _ROPE_DICT[key] = rotary_emb return rotary_emb这把”同样的一组 RoPE 参数”映射到同一个对象,从而共享同一张 cos_sin_cache。DeepInfer 的 V4.1 注意力族里,主干的完整注意力层、SWA 层、压缩 KV 层和 DFlash 草稿层各自需要不同 base 的 RoPE(压缩层用 compress_rope_theta,主干层用 rope_theta),但同一组参数会被很多个 layer 实例复用——V4.1 是几十层堆叠,如果每层各建一张 max_len × rotary_dim 的表,显存里会多出几十份完全相同的 cache。_ROPE_DICT 把这件事收敛成一个字典查找,代价可以忽略。
更重要的是它对 CUDA Graph 的影响:cos_sin_cache 是一个注册 buffer,CUDA Graph 捕获时它的地址被烘焙进 kernel 参数。如果每层各建一张表,那么每层捕获出的图就要引用不同地址的 cache,显存占用和捕获次数都翻倍。共享一张表后,所有层复用同一个地址,CUDA Graph 的指针稳定性更好——这正是 DeepInfer 源码完全拆解(十二):CUDA Graph 捕获与重放 里那张”分档捕获”的表能保持简洁的前提之一。
3.6 MLA 解耦 RoPE 的完整旋转链
把本篇讲的三块拼到 MLA 上,会看到一条完整的旋转链。先看维度:MLA 的 qk_head_dim 被拆成 qk_nope_head_dim + qk_rope_head_dim,只有后一段参与旋转。attn.py 在构造 RoPE 时传的是:
self.qk_rope_head_dim = cfg.qk_rope_head_dim...self.rotary_emb = convert_rope(attn_module.rotary_emb, self.qk_rope_head_dim, self.max_model_len)...RopeArgs(positions, self.rotary_emb.cos_sin_cache, self.qk_rope_head_dim, self.rotary_emb.is_neox_style, offset=self.qk_head_dim - self.qk_rope_head_dim)offset 就是”跳过前 qk_nope_head_dim 维”的偏移;fused_transform.py 的参考实现里对应 work_3d[..., offset: offset + rotary_dim]。于是同一次 apply_rotary 调用只碰尾部 64 维(DeepSeek 系模型的典型值),nope 部分原样保留。这样做有两个直接后果:
- Q 的 nope 部分和 K 的 nope 部分不做旋转,它们的相对位置信息完全由 K 的 rope 段承载;因此 K 的 rope 段必须与 Q 的 rope 段共享同一张表和同一组
positions。代码里_project_q_b先做q_a_norm → q_b_proj → unflatten,再调用_q_b_norm_rope,正是把这个约束写进调用顺序。 - V 的 rope 段要逆旋转。在 packed KV 布局下,
context的尾部qk_rope_head_dim维与写入时的 KV rope 段共享同一组位置;_wv_and_o_proj在 O 投影前调用self.rotary_emb(positions, context[..., -qk_rope_head_dim:], conjugate=True),把这段旋回原基,再做fp8_einsum与out_proj。如果漏掉这一步,O 投影会把R_m的相位当成权重的一部分,等价于给输出乘了一个随位置变化的旋转——短文本上看不出大问题,长文本会系统性偏移。
注意 conjugate=True 只影响 rope 段,不影响 out_proj 的权重;这也是为什么 _wv_and_o_proj 可以先把 context cast 成 FP8、再做 fp8_einsum,而不必担心逆旋转引入的数值放大——旋转是正交变换,FP8 误差不会被放大,只会被旋转到另一个方向。这个性质在 MLA 完全拆解 里有更完整的矩阵推导。
3.7 KV 写入前的 Hadamard 旋转:为什么 RoPE 之后还要再转一次
fused_transform.py 的融合签名里还有一个不显眼的参数 hadamard_args。本篇读到的 attn.py::_prepare_swa_kv 调用没有传它;但算子本身支持在 norm、rope 之后、cast 之前插入一次归一化 Hadamard 变换:
if hadamard_args is not None: work_3d = hadamard_transform_ref(work_3d, hadamard_args.scale)未归一化的 Sylvester–Hadamard 矩阵满足 ;乘上 scale 之后得到正交版本。它的作用是把能量均匀摊到所有维度上。对一个向量做 ,原本集中在少数通道上的离群值会被分散;如果这些离群值正好落在 FP8 的 per-32 分组里,它们会把该组的 scale 抬高,导致同组其他通道的量化精度下降。先做一次 Hadamard,再按同样粒度 cast,组内动态范围变小,e4m3 的有效位数就能用在真正有信息的方向上。
这个技巧和本篇的 RoPE 并不冲突:RoPE 只旋转尾部 64 维,Hadamard 作用于整个 head_dim,两者都是正交变换,组合起来仍然保范数。区别在于 RoPE 是”按位置旋转”,Hadamard 是”与位置无关的白化”——前者为了相对位置,后者为了量化。算子把两者放在同一个 kernel 里,省掉的是一次单独的读写和一次 kernel 启动;这也是 DeepInfer 把 KV 写入做成融合算子的原因之一。下一篇会完整走一遍这条 norm → rope → hadamard → cast → store 的路径。
四、三块部件的接口约定:从零件到契约
到这里,三个部件各自的实现都看完了。把它们的接口并排放在一起,会发现一条共同的线索:
| 部件 | 关键接口约定 | 为什么是这个约定 |
|---|---|---|
ReplicatedLinear | 输出行宽按 32 字节对齐;out_acc 传入时必须是已对齐的张量 | 下游 TMA/向量化算子要求行首对齐;累加器与输出物理一致 |
RMSNorm | 返回嵌套元组;residual 在 BF16 里相加,统计才升 FP32 | Pre-LN 残差链;避开精度分叉;同时服务 FP8 GEMM、BF16 router 和残差链 |
RotaryEmbedding | cos/sin 拼成一行;conjugate=True 做逆旋转;_ROPE_DICT 共享同一张表 | 单次按行加载;MLA 闭环需要逆旋转;CUDA Graph 需要稳定地址 |
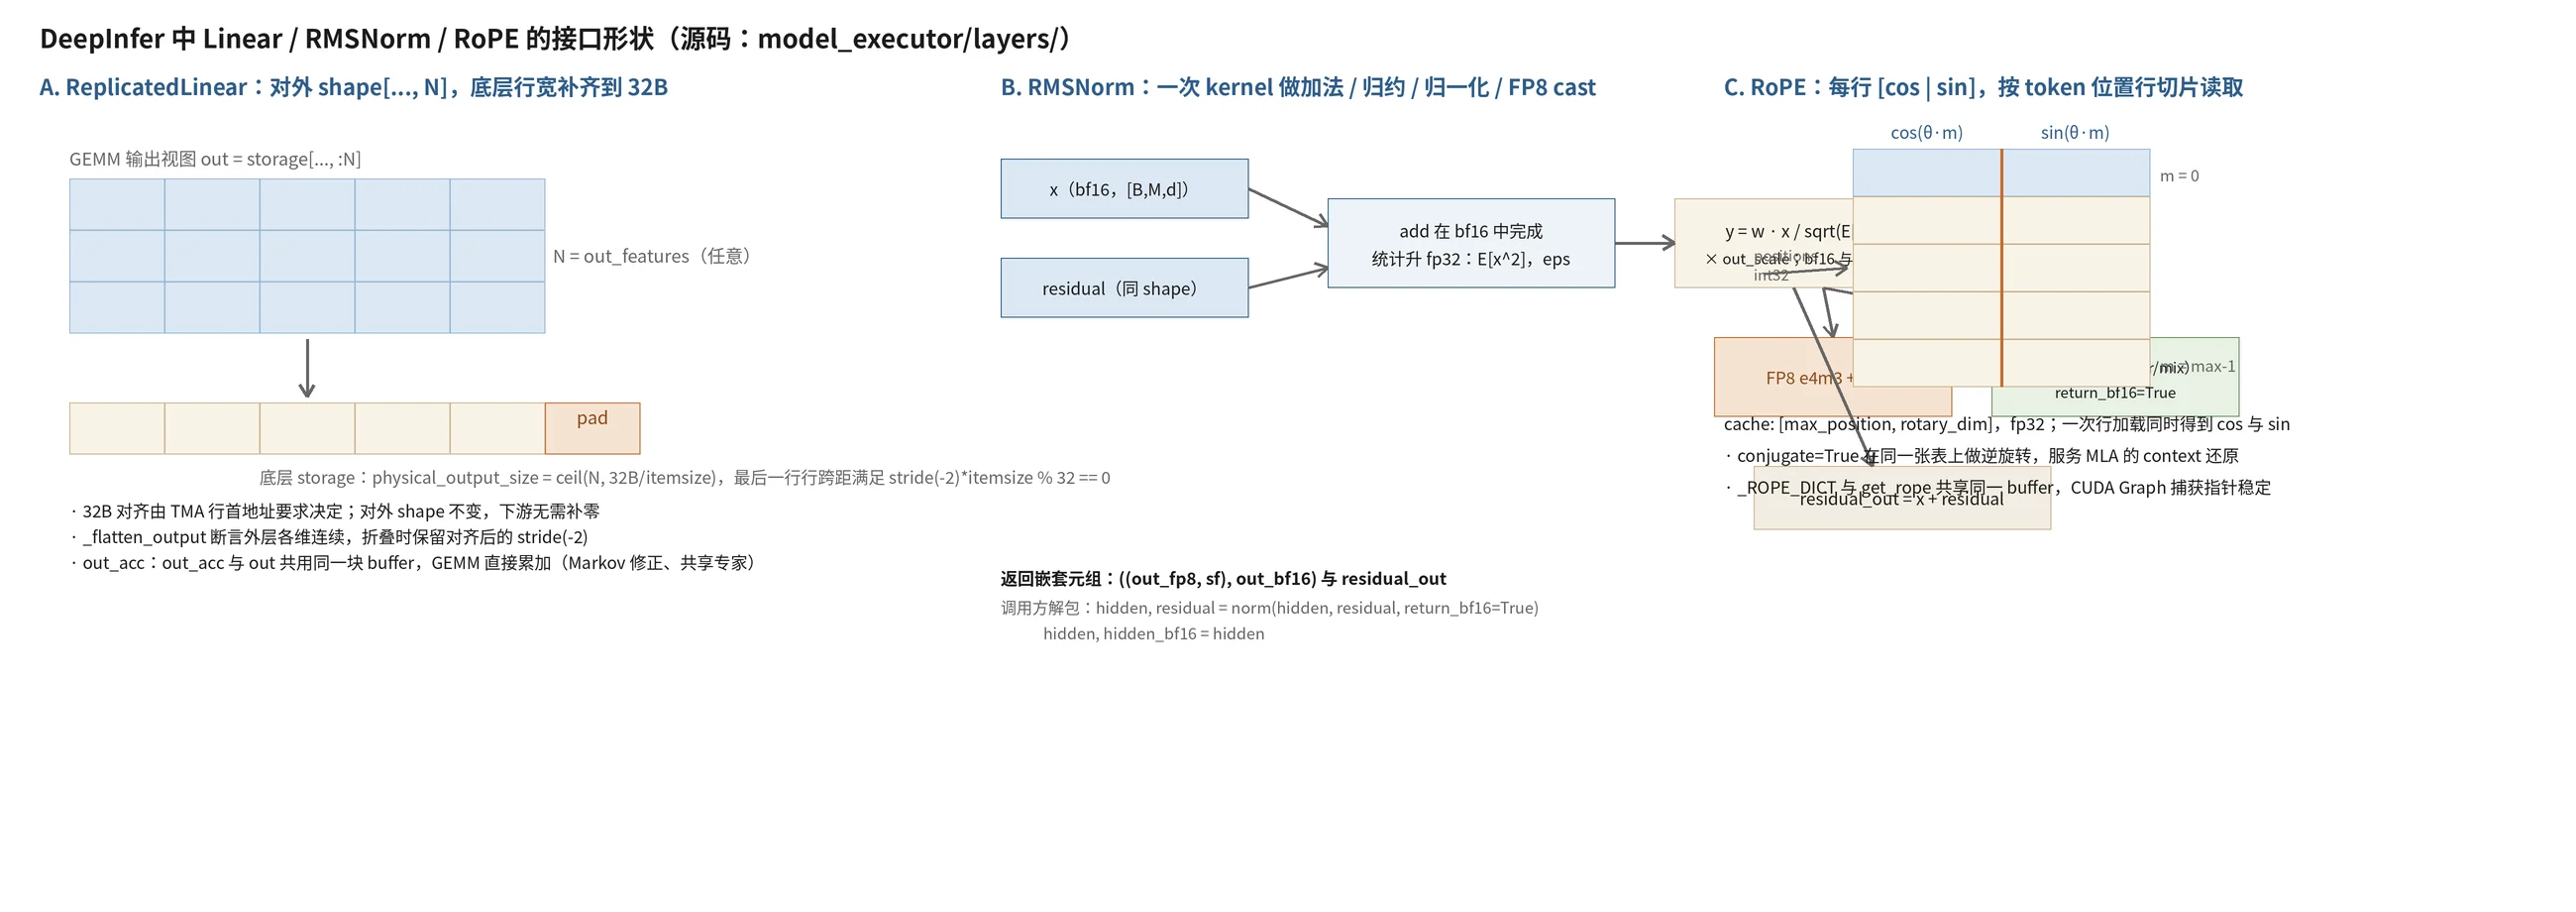
图:本站自制的接口示意图,用来把前文三节的物理布局放在一张图里。A 是
_allocate_output的逻辑视图与补齐后的底层行;B 是norm()在 residual、FP8 与 BF16 三路输出之间的往返;C 是cos_sin_cache的一行布局。信息均取自model_executor/layers/下的源码。
三条约定最终都指向同一个结果:每个部件都在替下游削减”要额外拷贝一次”或”要额外分配一次”的机会。Linear 替下游省掉一次 contiguous(),Norm 替下游省掉两次读、两次写和一次升精度,RoPE 替下游省掉一次表拷贝、一份显存冗余和一堆 CUDA Graph 指针。
4.1 同一部件的四种”方言”:与 vLLM / SGLang / llama.cpp / TensorRT-LLM 对照
把 DeepInfer 的选择放到其他框架里看,差异主要来自三个前提:是否做张量并行、GEMM 后端是否由自己控制、以及融合发生在哪一层。
| 框架 | 线性层 | RMSNorm | RoPE | 融合边界 |
|---|---|---|---|---|
| vLLM | LinearBase 派生 ColumnParallelLinear / RowParallelLinear / ReplicatedLinear,TP 由 world_size 驱动 | RMSNorm custom op,支持 fused residual;GemmaRMSNorm 等变体单独实现 | RotaryEmbedding custom op,按 cos/sin 表查行 | 融合停在算子层,注意力前端由各 backend 自己处理 |
| SGLang | 并行线性层由 TP 组切分,权重加载阶段完成分片 | RMSNorm 融合 residual,与 DeepInfer 的返回约定相近 | apply_rotary_pos_emb 按 backend 选择实现 | 前缀缓存与调度在 RadixCache 层,norm/rope 不跨进注意力 kernel |
| llama.cpp | ggml_mul_mat 按量化类型选择 type_traits 内核,权重以块量化格式常驻 | ggml_rms_norm 图算子,可选融合 mul | ggml_rope / ggml_rope_ext 图算子,支持 neox/interleaved | 融合在 ggml 图构建阶段,运行时只负责调度图 |
| TensorRT-LLM | Linear 带 tp_mode 与量化方法,TRT 路径走 plugin,PyTorch 路径走 LinearMethodBase | RMSNorm 在 PyTorch 后端是模块,在 TRT 路径是 plugin | RotaryEmbedding 模块/plugin,cos/sin 表缓存 | 融合由 builder/plugin 决定,图在构建期固化 |
差异可以归纳成三点:
- TP 决定了 linear 的形状。vLLM、SGLang、TensorRT-LLM 都允许把
N或K切到多卡上,因此它们的 linear 必须携带tp_size、tp_rank与通信原语;DeepInfer 不做 TP,linear 只需要关心”本卡的完整权重 + 对齐输出”,代码因此能缩到一百多行。代价是它必须用 EP/DP 把省下的并行度补回来——这正是 Wide-EP 与 DP Attention 存在的原因。 - GEMM 后端的控制权决定了 norm 的返回形状。DeepGEMM 要 TMA 列主序 SF,DeepInfer 的 norm 就必须能直接吐出这种布局;vLLM 的 custom op 只需返回
(out, residual)这组常规张量,布局转换留给量化 backend 或 GEMM wrapper。两者不是谁更先进,而是”谁拥有 kernel”决定了”谁承担布局”。 - 融合边界决定了 RoPE 在哪一层执行。llama.cpp 把 rope 作为图算子,融合由
ggml图优化器做;DeepInfer 把 norm+rope+cast+store 融进fused_transform的一个 kernel,由模型代码显式调用;vLLM/SGLang 在模型层调用独立的 rope 算子,再把旋转后的 Q/K 交给注意力 backend。三种做法对应三种可调试性:图算子最容易单独验证,显式融合最容易控制布局,模型层算子最容易替换后端。
如果想沿着这条线继续读,本站的 vLLM 源码完全拆解(一)、SGLang 源码完全拆解(一)、llama.cpp 源码完全拆解(一) 与 TensorRT-LLM 源码完全拆解(一) 分别给出了四个框架的模块全景,可以对照本篇的接口约定看它们的 layers/ 目录。
五、工程边界与常见陷阱
ReplicatedLinear不是张量并行安全的。本模块的权重每 rank 完整一份。如果哪里试图把它当作ColumnParallelLinear用,权重加载会静默出错(shape 对得上但语义错)。DeepInfer 的并行切分在model_executor/parallel_utils与attn.py的 SWA/压缩 KV 投影拆分里,本篇不展开。out_acc的 dtype 必须与输出一致。apply_weight_bf16里assert out.dtype == (torch.float if self.use_fp32_output else x.dtype);apply_weight_fp8里输出永远是 BF16,且assert bias is None——混合精度时沿用out_acc需要额外注意类型转换与”无 bias”前提。DeepseekMoE.shared_forward和 DFlash 的 Markov 修正恰好都满足”权重无 bias”这一条件,所以调用方无须额外处理;自己新加一个带 bias 的层去累加 Markov logits 时,第一个 assert 就会失败。- RMSNorm 的
residual必须与x形状、dtype 完全一致,且最后一维连续、其余维跨距为 16 的倍数,否则在_check_vectorized_strides处直接断言失败。mHC 的layer_input在进入 norm 前已经过squeeze(0)与 kernel 的 batch 维约定对齐,调用方不必担心;但自己手写调用时容易踩到。 return_bf16和fp8_cast_params必须一致地选择。如果use_fp8=False,fp8_cast_params会是空 dict,此时out_origin为 None,out_bf16 = (out_origin if do_fp8_cast else out).to(torch.bfloat16)——非 FP8 路径下它只是对out做了一次to(),在 dtype 已经是 BF16 时可能返回同一块存储;不要对其中一方写却期望另一方保持不变。- RoPE 表的
mscale只作用于 cos 与 sin 的幅度,不改旋转角本身。自行替换 YaRN 参数时注意mscale在YaRNScalingRotaryEmbedding.__init__里被算成yarn_get_mscale(scaling_factor, mscale) / yarn_get_mscale(scaling_factor, mscale_all_dim) * attn_factor,然后乘在 cos/sin 上,而不是加在 logits 上。 rope_freq_sample_interval/high_freq_cycle_threshold会让cos_sin_cache的宽度小于rotary_dim:_build_cos_sin_cache的宽度是len(inv_freq) * 2,一旦截断或降采样,len(inv_freq)就小于rotary_dim / 2。而RotaryEmbedding.forward断言query.shape[-1] == self.rotary_dim、fused_transform.py断言rope_args.cos_sin_cache.shape[1] == rope_args.rotary_dim——这两处的前提都是”表宽等于旋转维”。开启采样前必须同时确认注意力 kernel 只旋转cos_sin_cache.shape[1]对应的那部分维度,否则断言会在第一个 batch 直接失败。默认配置(无采样参数)下两者一致。out_scale与 FP8 的 scale 不是一回事。out_scale是模型 checkpoint 里约定好的归一化幅度缩放,它先乘进归一化结果,再参与 FP8 的 per-block scale 计算;若把它的语义误解成”logits 温度”或”KV 缩放”,会把归一化后的数值整体偏移,但断言和 shape 都不会报错,只能从下游 logits 的分布看出异常。
5.1 一次解码步里三块部件被调用几次
以一次标准 decode step(batch 里有 B 条请求,每条生成 1 个 token)为例,把它们在时间轴上的位置数一遍:
- 每个 decoder layer 调用 2 次
RMSNorm:一次在 attention 前(attn_norm_forward),一次在 MLP 前(ffn_norm_forward);mHC 路径下这两次都由_hc_pre统一发起。 - 每个 decoder layer 至少调用 两次 dense GEMM 入口:Q/KV 投影链(
q_a_kv_proj或q_a_kv_swa_proj,后面可能还跟q_b_proj)与 O 投影(out_proj);MLP 内部还有 gate/up/down,走DeepseekMoE的融合路径,不在本篇的 linear 类里。 - RoPE 在 attention 内调用 两次(Q 的正向旋转与 KV 写入前的旋转),输出侧再调用 一次 逆旋转。
- 最后在模型头之前还有一次
output_norm(RMSNorm实例)和一次 lm_head 前的HCHead混合。
把这些次数乘起来,一个几十层的 V4.1 主干一次 decode 就要执行上百次 norm、上百次 rope 段旋转和上百次 dense GEMM。每一次 kernel 启动都带着自己的参数装配、自己的缓冲区、自己的 launch 开销——这就是为什么这三块部件必须把”能省的一次分配、能省的一次拷贝、能省的一次精度转换”全部提前省掉。本篇反复强调的对齐、嵌套返回、共享表,放回这个调用次数里看才显出分量。
六、小结与下一篇
这一篇把解码层里三块”小而密”的部件讲完了:
- Linear 的核心是”用对齐吸收硬件约束,用
out_acc消掉冗余分配”; - RMSNorm 的核心是”一次 kernel 融合 residual、归一化和 FP8 cast,并用嵌套返回值同时喂三类下游”;
- RoPE 的核心是”一张按 token 位置行切片读取的 cos/sin 表,正向、逆旋转共用,全局共享”。
它们看起来是零件,实际上写的是引擎和算子层之间的契约。后面讲 KV 写入与读取路径(store_kv_cache 与 slot_mapping 的索引算术)、mHC 的融合 kernel(mega_mhc、mega_moe),以及 TileLang 特化算子族时,都会反复看到这些契约的体现。
下一篇讨论 DeepInfer 的 KV 写入与读取路径:fused_norm_rope_hadamard_cast_store_kvcache 如何把本篇的 norm、RoPE 与 FP8 cast 融合成一次写入,slot_mapping 如何把”逻辑位置”翻成”物理页”。
参考资料
- DeepInfer 官方仓库
- DeepGEMM:DeepSeek 的高性能 FP8/FP4 GEMM 库
- Root Mean Square Layer Normalization(Zhang & Sennrich, 2019)
- rmsnorm 官方实现(论文表 1 原图所在仓库)
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- YaRN: Efficient Context Window Extension of Large Language Models
- jquesnelle/yarn:YaRN 参考实现
- TileLang:Tile 级 DSL 与代码生成框架
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



