


vLLM 源码完全拆解(八):MoE 层的前向执行——Router、FusedMoE Kernel 与通信融合
背景:为什么 MoE 层是推理框架的”硬骨头”
vLLM 前 7 篇已经把一条请求从入队到 GPU 执行的主路径讲通了:调度器分 token 预算和 KV Block → GPUModelRunner 把动态请求拼成 InputBatch → Attention Backend 完成注意力计算 → PagedAttention Kernel 逐 block 完成 Softmax 归约。如果模型是标准的 Dense Transformer(如 Llama-3),到这里就已经跑完一次 step 了。
但 MoE(Mixture of Experts,混合专家)模型不一样。以一个典型的 DeepSeek-V3 级 MoE 模型为例:每层有 256 个专家,每 token 只激活其中的 8 个。这意味着每个 token 只和全局权重的一小部分交互,而另一个 token 可能走完全不同的专家路径。
这是好事也是坏事。好在计算的”有效宽度”远小于模型的名义宽度,总 FLOPs 中只有一小部分实际执行;坏在专家选择和负载的天然不均匀、跨 GPU 的 All-to-All 通信、以及传统 GEMM Kernel 无法直接处理分组专家权重——这些都给推理框架带来了 Dense 模型没有的问题。
vLLM V1 的 MoE 支持主要在 vllm/model_executor/layers/fused_moe/ 下实现。本文将沿 V1 源码,拆解 vLLM 如何从一次 step 中完成 Router → 专家执行 → 输出合并的完整流程,重点讲清楚四个核心机制:
- Router 的分组 Top-K:
grouped_topk如何让同一 batch 的不同 token 各自选对专家 - RoutedExperts 的权重组织:专家权重如何按并行配置切分、如何被 MoE Kernel 高效访问
- MoERunner 的执行编排:从 gate 计算 router_logits 到 dispatch/combine 的全流程
- 通信与并行:Expert Parallelism、All-to-All 通信、序列并行如何与计算流水线重叠
本文延续 vLLM 源码完全拆解(五):GPUModelRunner 中 _execute_moe_layer 的调用点,把 MoE 层从 router 输出 logits 到专家执行完毕的完整链路走到底。
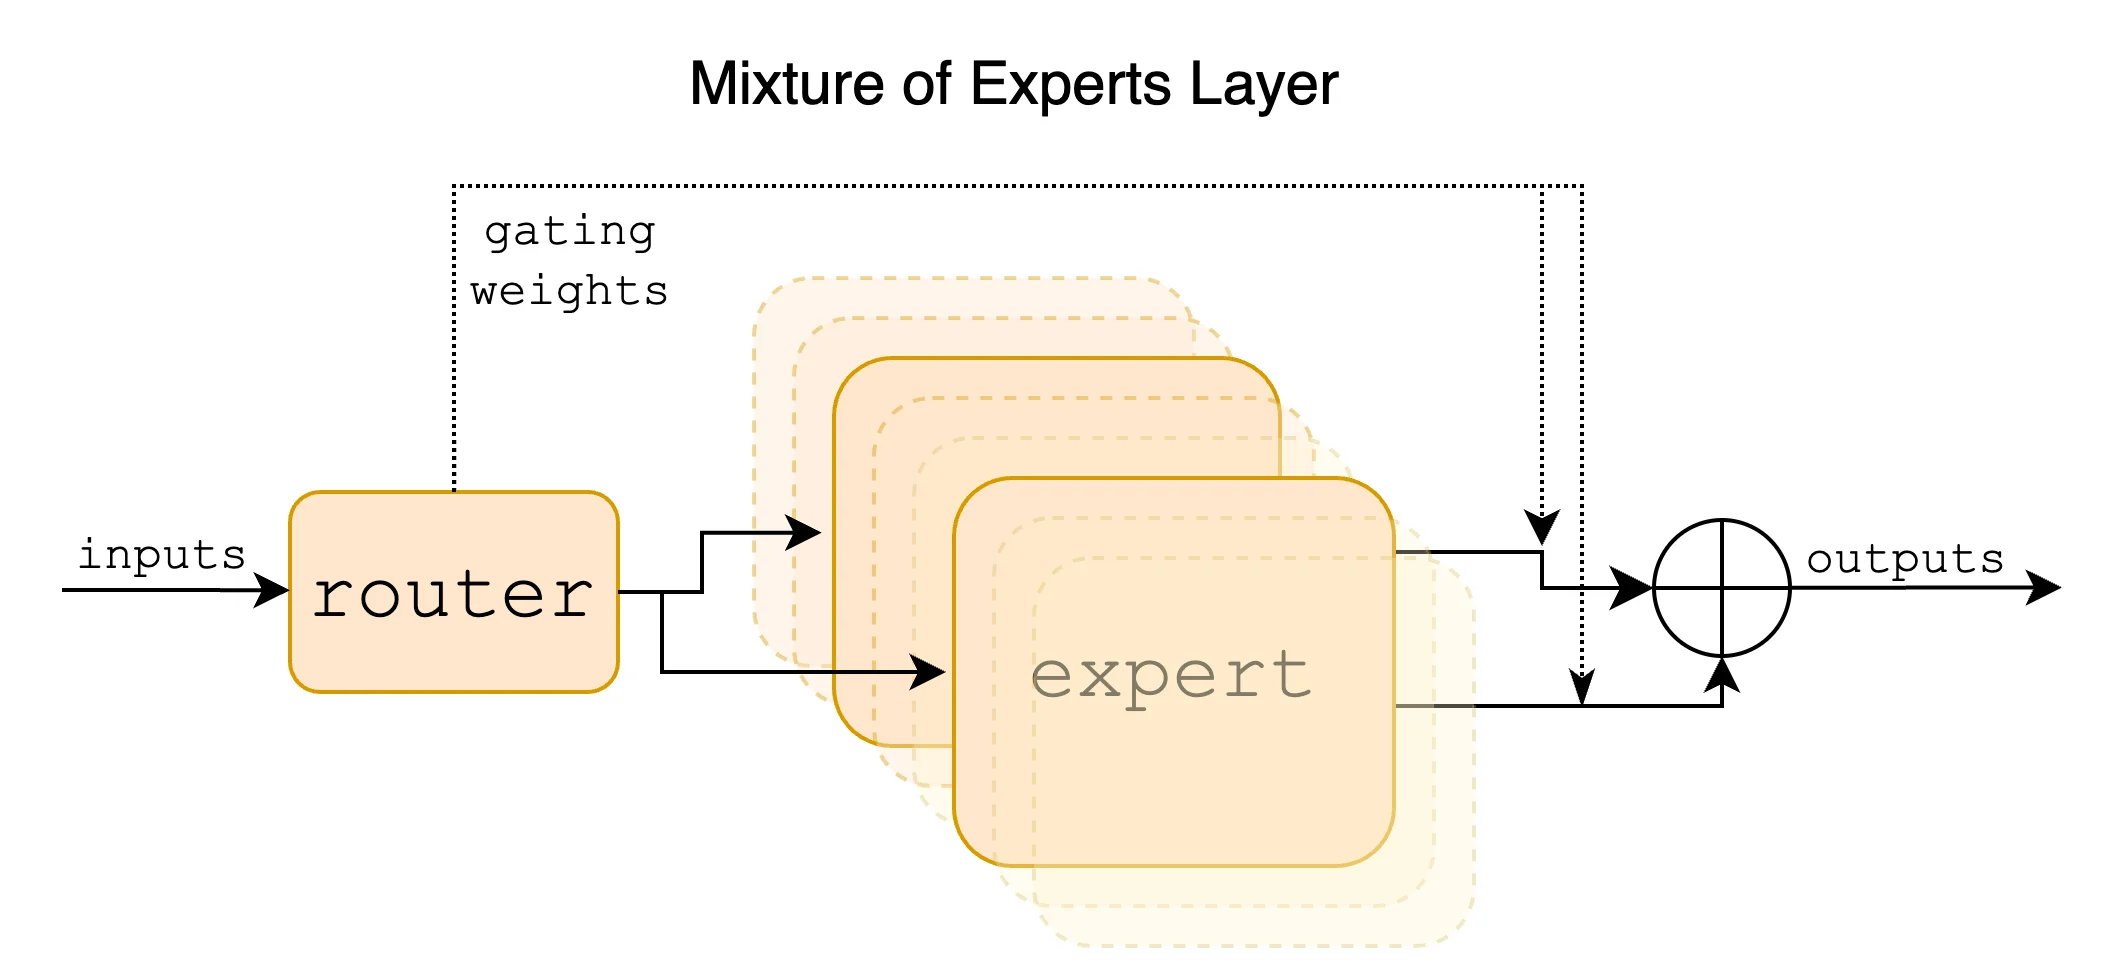
vLLM FusedMoE 总体架构:Runner-Router-Experts 三层
vLLM 的 MoE 实现经过了一次大规模重构。早期版本中 MoE 逻辑分散在 FusedMoE 类、model 代码和 kernel 实现中,耦合严重。当前版本(vLLM main 分支,2025 年底以后)采用了一种清晰的三层架构,入口统一为 FusedMoEFactory 工厂函数。
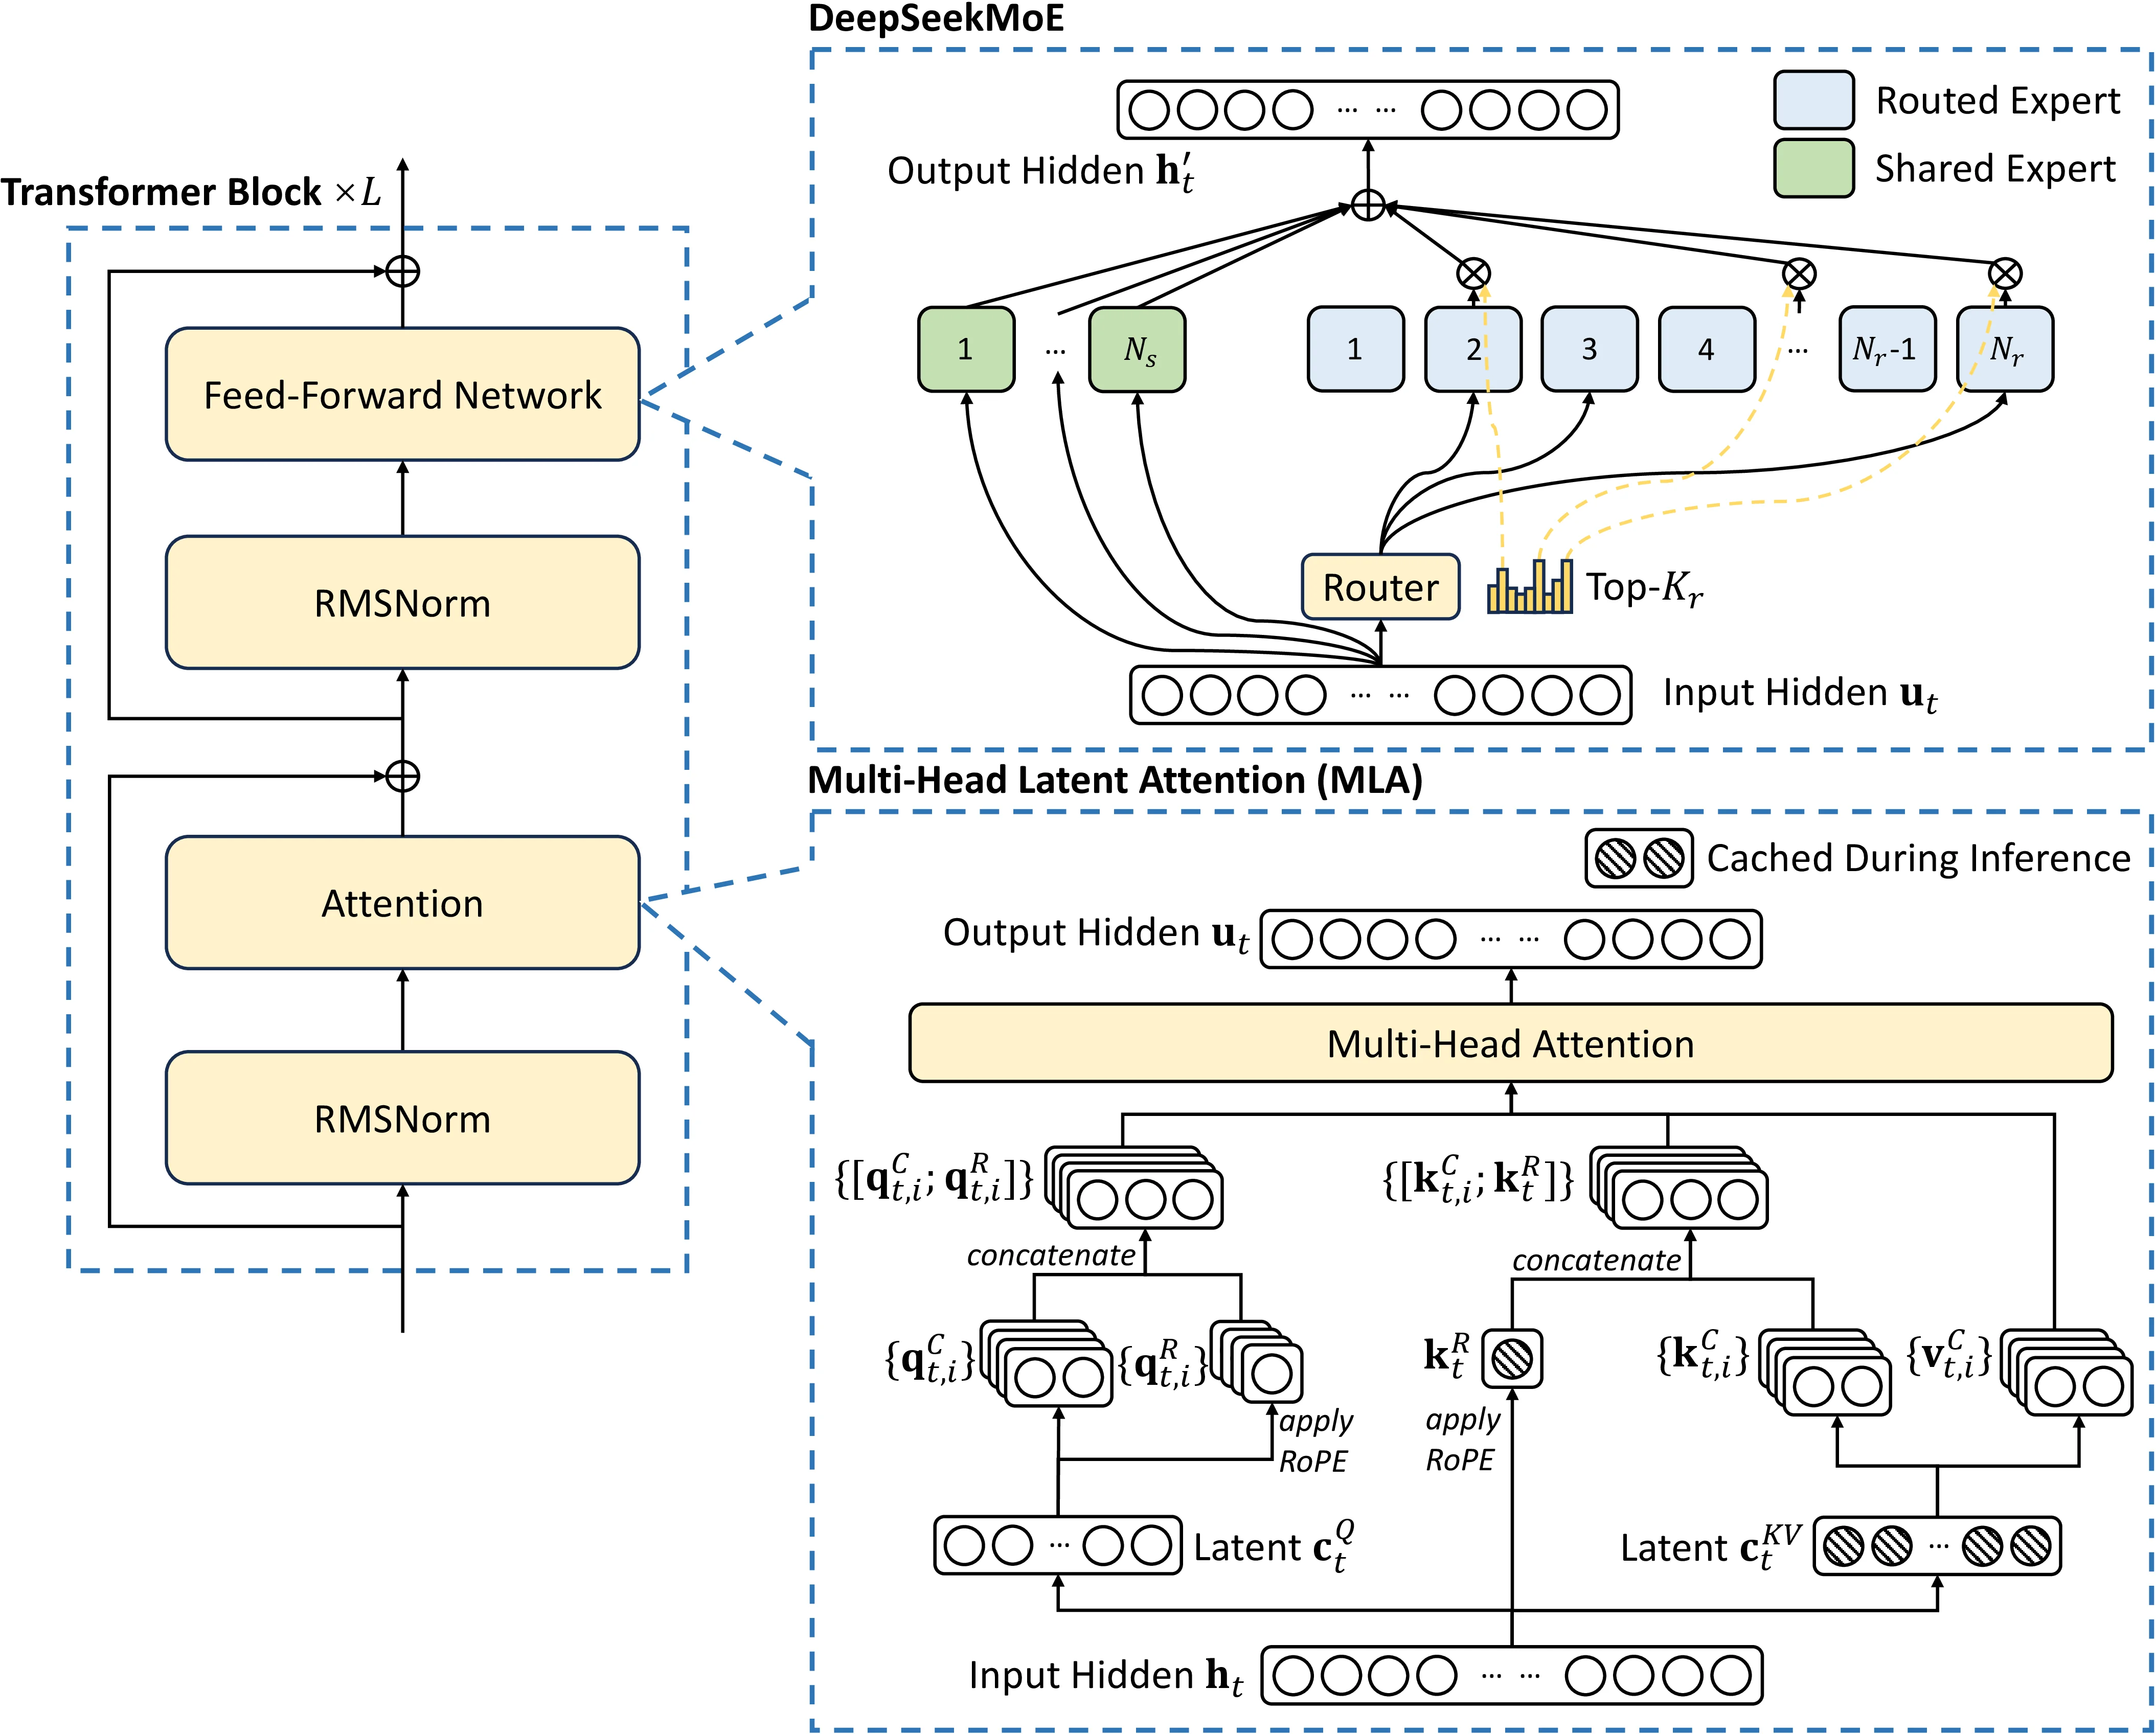
DeepSeek-V3 的基本架构(来源:DeepSeek-V3 技术报告)。图中每个 Transformer Block 内的 MoE 层就是本文重点拆解的对象——vLLM 的 FusedMoEFactory 创建的 MoERunner 会接管这一层的前向执行。
三层架构总览
FusedMoEFactory 接收约 40 个参数(num_experts、top_k、hidden_size、intermediate_size、use_grouped_topk、scoring_func 等),组装出三个核心对象:
-
Router(
FusedMoERouter):负责从router_logits中选出每个 token 的top_k个专家,返回(topk_weights, topk_ids)。通过router_factory.py中的create_fused_moe_router()根据参数选择具体子类:FusedTopKRouter、GroupedTopKRouter、FusedTopKBiasRouter、ZeroExpertRouter等。 -
RoutedExperts:管理所有专家权重参数(
gate_proj、up_proj、down_proj),持有quant_method——即 MoE 的实际计算实现。quant_method可以是 Monolithic(一个 kernel 搞定路由+计算+激活,如 TRT-LLM 的 fused MoE kernel)或 Modular(先 router 选专家,再调 kernel 计算)。 -
MoERunner:编排器,把 Router 和 RoutedExperts 组合成完整的前向流程。它持有
gate(router_logits 的线性层)、shared_experts(可选,共享专家的独立计算)、routed_input_transform/routed_output_transform(Latent MoE 的纬度变换),并负责 dispatch/combine 通信与 All-Reduce 时机。
FusedMoEFactory 的返回类型就是 MoERunner——模型代码拿到它后,在 forward 中调用 runner.forward(hidden_states, router_logits) 即可。
从哪里被调用
回顾前文,在 GPUModelRunner 的模型执行中,每个 MoE 层被封装成了 FusedMoEFactory 的返回值。在模型的 forward 方法中,对每个 MoE 层:
# 伪代码:模型 forward 中的 MoE 层调用router_logits = self.gate(hidden_states) # gate 计算 router logitshidden_states = self.moe_runner.forward( hidden_states, router_logits,)而 MoERunner.forward() 内部通过一个自定义 PyTorch op(torch.ops.vllm.moe_forward)进入 _forward_impl(),完成从 dispatch 到 combine 的全部工作。这个自定义 op 的设计动机是让 Dynamo / torch.compile 能把 MoE 层当作一个不透明的 kernel 来看待,避免 trace 内部的复杂控制流。
FusedMoEConfig:所有配置的汇聚点
在工厂函数中,各种分散的参数被汇聚到一个 FusedMoEConfig 对象中:
moe_config = FusedMoEConfig( num_experts=global_num_experts, # 全局专家数(含冗余) experts_per_token=top_k, # 每个 token 激活的专家数 hidden_dim=hidden_size, # 输入 hidden size intermediate_size=intermediate_size, # 专家中间层尺寸 num_local_experts=expert_map_manager.local_num_experts, # 本地专家数(EP 后) num_logical_experts=logical_num_experts, # 逻辑专家数 moe_parallel_config=moe_parallel_config, # TP/EP/DP 配置 ...)这个 config 随后被传给 RoutedExperts 和 MoERunner,是整个 MoE 层所有模块决策的单一事实来源。
Router 层:grouped_topk 与专家选择
Router 是 MoE 前向的第一步:给定 [num_tokens, num_experts] 的 router logits,输出每个 token 应该走哪几个专家、权重多少。听起来简单,但做起来有大量细节。
Router 的子类选择逻辑
create_fused_moe_router() 的优先级链(按先后顺序):
- 如果设置了环境变量
VLLM_MOE_ROUTING_SIMULATION_STRATEGY→RoutingSimulatorRouter(用于模拟路由策略,非生产路径) - 如果
zero_expert_type is not None→ZeroExpertRouter(处理 identity zero expert,用于 EPLB 等场景) - 如果
use_grouped_topk=True→GroupedTopKRouter(DeepSeek-V3 类型模型的最常见选择) - 如果
custom_routing_function is not None→CustomRoutingRouter - 如果
e_score_correction_bias is not None或hash_indices_table is not None→FusedTopKBiasRouter(DeepSeek-V4 的 hash routing + bias 路径) - 如果
num_fused_shared_experts > 0(ROCm AITER)→AiterSharedRoutedFusedMoERouter - 默认 →
FusedTopKRouter(标准 softmax top-k,用于 Mixtral 等)
生产环境中最常见的是 3(GroupedTopKRouter)和 7(FusedTopKRouter)。
FusedTopKRouter:标准 softmax Top-K
这是最简单的路由方式,适用于 Mixtral 8x7B 这类没有专家分组的模型:
# FusedTopKRouter._select_experts() 的核心逻辑(伪代码)def _select_experts(self, hidden_states, router_logits): # 1. 对 router_logits 做 softmax(如果 scoring_func == "softmax") if self.scoring_func == "softmax": routing_weights = router_logits.softmax(dim=-1) elif self.scoring_func == "sigmoid": routing_weights = router_logits.sigmoid() # sqrtsoftplus 等特殊评分函数也在此处理
# 2. 取 top_k 个最大值的专家索引和权重 topk_weights, topk_ids = torch.topk(routing_weights, self.top_k, dim=-1)
# 3. 可选:重新归一化 top_k 权重,使它们和为 1 if self.renormalize: topk_weights = topk_weights / topk_weights.sum(dim=-1, keepdim=True)
return topk_weights, topk_ids关键点:
scoring_func不只是softmax和sigmoid。DeepSeek-V4 使用了sqrtsoftplus——对 logits 先做sqrt(softplus(x))再 topk,实验表明这种评分函数在专家数极大时更稳定。renormalize控制了 top_k 权重是否重新归一化。大部分模型(DeepSeek-V3、Mixtral)都设为True。routed_scaling_factor是 DeepSeek-V3 引入的机制——选出的专家权重先乘以这个 factor,论文中设为1.0 / top_k的某种变体,实际效果是调整 routed expert 输出与 shared expert(如果有的话)的相对比例。
GroupedTopKRouter:分组的专家选择
这是 DeepSeek-V3 式 MoE 的核心机制。在 V3 中,256 个专家被分成 8 组,每组 32 个专家。路由不是从全部 256 个中选 top-8,而是先从 8 组中选出 top-4 组(topk_group=4),再从这 4 组中各自选出 top-2 专家(top_k=8 / 4 = 2),合起来就是 8 个专家。
为什么要分组?因为 DeepSeek-V3 的专家之间有”设备亲缘性”(affinity)——同一组的专家放在同一个 GPU 上,这样 All-to-All 通信只需要在组间发生,组内的专家选择不产生额外跨 GPU 通信。分组路由天然对齐了硬件拓扑。
GroupedTopKRouter._select_experts() 的流程:
- 将 router_logits reshape 为
[num_tokens, num_expert_group, experts_per_group] - 在每个 group 内做 scoring(softmax/sigmoid)
- 对每个 group 求和得到 group scores → 选出
topk_group个最好的组 - 在选中的组内,各自做 top-k per group → 总共得到
top_k个专家 - 对选出的专家权重做 renormalize
# GroupedTopKRouter 的核心逻辑(简化伪代码)def _select_experts(self, hidden_states, router_logits): # router_logits: [num_tokens, num_experts] # reshape: [num_tokens, num_expert_group, experts_per_group] scores = router_logits.view(-1, self.num_expert_group, self.experts_per_group)
# 组内 softmax if self.scoring_func == "softmax": group_scores = scores.softmax(dim=-1) # per-group softmax
# 每组求和作为组分数 group_total = group_scores.sum(dim=-1) # [num_tokens, num_expert_group]
# 选出 topk_group 个组 _, top_group_idx = torch.topk(group_total, self.topk_group, dim=-1)
# 只在选中的组内取 top-k per group # 这里 mask 掉未选中组的分数,再做 per-group topk ... return topk_weights, topk_ids注意:DeepSeek-V3 的每组内 per-group softmax 然后取组内 top-k,这和先全局 softmax 再取全局 top-k 是不同的——前者保证了组间比较的公平性(每组先内部归一化),后者则是直接比原始 logits 的绝对大小。
topk_weights 和 topk_ids 的语义
路由完成后,返回两个张量:
topk_weights:[num_tokens, top_k],float,每个 token 对每个选中专家的权重。如果renormalize=True,这 top_k 个权重之和为 1。topk_ids:[num_tokens, top_k],int32/int64,每个 token 选中专家的全局 ID。
这两个张量随后传入 RoutedExperts.forward_modular() 或直接被 Monolithic kernel 消费。
RoutedExperts:专家权重的组织、量化与访问
Router 选完专家后,下一步是用选中的专家权重对每个 token 做计算。这看起来像是一个 batched GEMM 问题:有 N 个 token,每个 token 需要用自己的 (gate_proj, up_proj, down_proj) 权重做矩阵乘,但不同 token 的权重不同。这正是 FusedMoE Kernel 存在的理由。
专家权重如何存储
RoutedExperts 是 torch.nn.Module 的子类,持有所有专家的权重参数。对于标准的 gated MoE(如 SwiGLU 激活):
gate_up_proj(或w13):[num_local_experts, intermediate_size * 2, hidden_size]——gate 和 up 两个投影合并在一起。之所以合并,是因为它们共享输入,合并后在 kernel 内部只需一次读取 hidden_states。down_proj(或w2):[num_local_experts, hidden_size, intermediate_size]——从中间维度投影回 hidden_size。
这里 num_local_experts 是经过 Expert Parallelism 切分后,当前 GPU 实际持有的专家数。如果 256 个专家分布在 8 个 GPU 上做 EP,每个 GPU 持有 256/8 = 32 个专家。
MergedColumnParallel 与 RowParallelLinear
对于张量并行(TP),vLLM 会把专家的权重沿 hidden_size 或 intermediate_size 维度切分:
gate_up_proj使用MergedColumnParallelLinear,沿 output 维度切分(列并行),输入是完整的 hidden_states,输出被 TP group 内各 GPU 分片持有。down_proj使用RowParallelLinear,沿 input 维度切分(行并行),输入来自上一个 All-Reduce(或 TP group 内的 partial output),输出需要 All-Reduce。
MoE 层中这两个并行策略的交互比较复杂:EP 把专家按数量切分到不同 GPU,TP 把单个专家的权重矩阵按维度切分到同组 GPU。FusedMoEParallelConfig 记录了所有这些并行维度:
class FusedMoEParallelConfig: tp_size: int # 张量并行度 ep_size: int # 专家并行度 dp_size: int # 数据并行度(含弹性 EP 的最大 DP size) sp_size: int # 序列并行度 use_ep: bool # 是否开启 EP use_all2all_kernels: bool # 是否使用融合的 all-to-all kernel量化与 MoE Kernel 选择
RoutedExperts 的核心属性是 quant_method——决定 MoE 计算以什么精度、什么 kernel 执行。常见选择:
- 未量化(FP16/BF16):使用
fused_moeTriton kernel(或 CUDA kernel),直接做 FP16 的 batched GEMM。 - FP8 量化:使用 FP8 fused MoE kernel,参考 DeepSeek-V3 的 FP8 混合精度方案。
- INT8 / INT4 量化:使用对应的量化 kernel。
- TRT-LLM 后端:使用 TensorRT-LLM 的 MoE kernel,通常是 Monolithic 模式(路由和计算合并在一个 kernel 中)。
quant_method 还决定了 modular vs monolithic 的执行路径:
- Modular:Router 先出 topk_weights/topk_ids,再传入
forward_modular(x, topk_weights, topk_ids)。 - Monolithic:Router 不单独执行,
forward_monolithic(x, router_logits)在一个 kernel 中完成路由 softmax + top-k + batched GEMM + 激活函数。
Monolithic 的优势是避免 router 输出的显存读写往返,适合 TRT-LLM 这类高度优化的闭源 kernel。Modular 的优势是灵活——可以在 router 后插入 EPLB 重映射、shared expert 融合等逻辑。vLLM 目前两者都支持,但新架构倾向于 Modular。
MoERunner:执行编排
MoERunner 是三大件的黏合剂。它的 forward() 方法把 Router、RoutedExperts、通信、All-Reduce、shared experts 等等组装成一个完整的前向过程。
调用链:forward → _forward_impl
MoERunner.forward(hidden_states, router_logits) ├─ apply_routed_input_transform() # Latent MoE: 压缩输入维度 ├─ _maybe_pad_hidden_states() # 对齐 hidden_dim ├─ self._forward_entry(...) # 自定义 PyTorch op → _forward_impl │ └─ _forward_impl() │ ├─ _maybe_fuse_gate_weights() # 首次调用时合并 gate 权重 │ ├─ shared_experts.maybe_forward_async() # 异步启动 shared experts │ ├─ gate(hidden_states) → router_logits # (如果 gate 在 runner 内部) │ ├─ sequence_parallel_context() │ ├─ _maybe_dispatch() # EP/DP dispatch │ ├─ _apply_quant_method() # 核心:路由 + fused MoE kernel │ │ ├─ router.select_experts() │ │ ├─ routed_experts.forward_modular() / forward_monolithic() │ │ └─ shared_experts.wait() # 等待异步 shared experts 完成 │ └─ _maybe_combine() # EP/DP combine ├─ 截断输出 # 去掉 padding ├─ _maybe_reduce_routed_output_before_transform() # Latent MoE 提前 all-reduce ├─ _maybe_reduce_shared_expert_output() ├─ _maybe_apply_routed_scale_to_output() ├─ apply_routed_output_transform() # Latent MoE: 恢复输出维度 ├─ shared + routed 输出相加 ├─ _maybe_reduce_final_output() # 最终 All-Reduce └─ _maybe_add_zero_expert_output()这个调用链看起来很长,但大部分步骤在标准 MoE(无 Latent、无 shared expert)下都是 no-op。对于最简情况(Mixtral 8x7B,TP=1,EP=1),实际执行的只有 dispatch → router → forward_modular → combine → final all-reduce。
Gate 计算与 FSE(Fused Shared Expert gate)
MoERunner 可以选择在内部持有 gate(router logits 的计算层)。如果模型的 gate 权重已经加载到 runner 上,_forward_impl 会直接在这里做 gate 的前向:
if self.gate is not None: if self._fse_fuse_gate: self._maybe_fuse_gate_weights() router_logits = dispatch_unquantized_gemm()( self, hidden_states, self._combined_gate_weight, None ) else: router_logits, _ = self.gate(hidden_states)FSE(Fused Shared Expert)模式下,routed gate 和 shared expert gate 的权重矩阵被拼成一个 [num_experts + num_shared, hidden] 的大矩阵,一次 GEMM 算出所有 logits。TopK kernel 再从中分离出 routed topk 和 shared expert 的激活值(通常用 sigmoid 而非 softmax),省掉一次单独的 shared expert gate 前向。
Dispatch:EP 下的 token 分发
当 ep_size > 1 时,每个 token 需要被送到持有其选中专家的 GPU 上去计算。传统做法是通过 All-to-All 通信来交换 token——每个 GPU 把自己的 token 中属于其他 GPU 专家的部分发送过去,同时接收其他 GPU 发来的、属于自己专家的 token。
vLLM 的 dispatch 有两种路径:
-
MoE Kernel 内部 dispatch(新路径):如果
quant_method.supports_internal_mk,则 dispatch/combine 完全在 fused MoE kernel 内部完成。这是 vLLM 新架构的目标状态——kernel 直接通过 NVSHMEM 或类似机制做 RDMA,不经过 host 端显存中转。 -
Naive dispatch(旧路径,过渡期):
get_ep_group().dispatch_router_logits()负责在 EP group 内分发 hidden_states 和 router_logits。实际上就是 All-to-All 通信。代码在_maybe_dispatch()中:
def _maybe_dispatch(self, hidden_states, router_logits): if self.do_naive_dispatch_combine: result = get_ep_group().dispatch_router_logits( hidden_states, router_logits, self.moe_config.is_sequence_parallel, ) hidden_states, router_logits = result
# PCP (Pipeline Context Parallelism) 的 all_gather if self.moe_config.pcp_size > 1 and not use_all2all_kernels: hidden_states = get_pcp_group().all_gather(hidden_states, dim=0) router_logits = get_pcp_group().all_gather(router_logits, dim=0)
return hidden_states, router_logitsdo_naive_dispatch_combine 的条件是 dp_size > 1 or is_sequence_parallel(且 kernel 不支持 internal MK)。这意味着在 DP + EP 混合并行和序列并行场景,dispatch 仍然走旧路径。
_apply_quant_method:路由与 kernel 执行
这是 MoE 层的核心。代码很紧凑:
def _apply_quant_method(self, hidden_states, router_logits, shared_experts_input, shared_experts_overlapping=False): # 1. 先执行 shared experts(如果不需要 overlap) self._maybe_apply_shared_experts(shared_experts_input, SharedExpertsOrder.NO_OVERLAP)
# 2. 路由 + 计算 if self.routed_experts.quant_method.is_monolithic: # Monolithic: router_logits 直接传入 kernel fused_out = self.routed_experts.forward_monolithic( x=hidden_states, router_logits=router_logits ) else: # Modular: 先 router 选专家,再计算 topk_weights, topk_ids = self.router.select_experts( hidden_states=hidden_states, router_logits=router_logits, topk_indices_dtype=self._quant_method.topk_indices_dtype, ) fused_out = self.routed_experts.forward_modular( x=hidden_states, topk_weights=topk_weights, topk_ids=topk_ids, shared_experts=self._shared_experts, shared_experts_input=shared_experts_input, )
# 3. 等待异步 shared experts if shared_experts_overlapping: self._shared_experts.wait()
return shared_output, fused_out这里的关键设计决策:
- Shared experts 提前执行:在 router 执行之前或同时启动,这样 shared experts 的计算可以和 routed experts 的路由+计算 overlap。如果
shared_experts_overlapping=True,shared experts 在_forward_impl的最开始就用单独 CUDA stream 启动了。 - Monolithic vs Modular:取决于
quant_method.is_monolithic,由 kernel 能力决定。TRT-LLM 的 MoE kernel 是 monolithic 的,vLLM 自己的 Triton/CUDA kernel 是 modular 的。
输出处理与 All-Reduce 时机
MoE 输出处理有三个 All-Reduce 要点(互斥,不会同时触发):
-
Kernel 内部已 reduce(
_fused_output_is_reduced=True):fused kernel 做完 expert 计算后内部做了 All-Reduce,fused_output 已经是完整结果。此时需要单独对 shared_output 做 All-Reduce(_maybe_reduce_shared_expert_output),然后跳过最终 All-Reduce。 -
Latent MoE 提前 reduce(
_maybe_reduce_routed_output_before_transform):当 MoE 在压缩的 latent 空间做计算(如 NemotronH),输出需要经过可能有非线性的 transform 恢复到完整维度。如果 fused_output 还没 reduce,必须在 transform 之前先 All-Reduce,否则非线性和 partial sum 不交换。 -
最终 All-Reduce(
_maybe_reduce_final_output):最常见的路径。fused_output 和 shared_output 都还没 reduce,把它们相加后再做一次 All-Reduce。
Shared Experts 的 Overlap 机制
SharedExperts 类封装了共享专家的异步执行。核心方法是 maybe_forward_async():在当前 CUDA stream 上启动 shared experts 的前向,返回是否成功启动了 overlap。
如果 overlap 成功,router + routed experts 在主 stream 上执行,shared experts 在另一个 stream 上执行,最后通过 wait() 同步两个 stream 的结果。这种设计让 shared experts 的 compute-heavy 部分(两个 GEMM + 激活)和 router 的 score compute + topk + dispatch 完全重叠。
DeepSeek-V2 的稀疏 MoE 架构(来源:DeepSeekMoE 论文)。图中展示了 Shared Expert(共享专家)和 Routed Expert(路由专家)的分离——前者对所有 token 一律执行,后者只对路由选中的 token 执行。vLLM 的 SharedExperts 异步 overlap 正是利用了这两条路径的天然独立性。
Expert Map:全局 ID 到物理专家的映射
在 EP 场景下,一个 token 选中的是”全局专家 ID”(0 到 global_num_experts-1),但这个专家可能不在当前 GPU 上。ExpertMapManager 负责维护三张映射表:
global_to_physical:全局专家 ID → 物理专家 ID(哪个 GPU 上的第几个 slot)physical_to_global:物理专家 ID → 全局专家 ID(反向查表)local_to_global:本地专家 ID(当前 GPU 上的 0 到 num_local_experts-1)→ 全局专家 ID
这些表在 EPLB(Expert Parallelism Load Balancer)场景下会动态更新——EPLB 根据各 GPU 的专家负载情况,重新分配专家到 GPU 的映射。ExpertMapManager 的 placement_strategy 字段可以指定不同的放置策略(负载均衡、最小通信等)。
在 forward_modular 内部,topk_ids(全局专家 ID)先经过 global_to_physical 映射,确定每个选中的专家实际在哪个 GPU 上、对应哪个本地权重 slot。同一个 GPU 内的多个 token 共享的专家,可以通过 grouped GEMM 一次性完成。
MoE 路由的负载不均衡:EPLB 与冗余专家
MoE 推理最大的工程痛点是负载不均衡。某些”热门专家”(通常是捕获通用语言知识的专家)会被大量 token 同时选中,而”冷门专家”几乎没有负载。这导致:
- 热门专家所在 GPU 成为瓶颈,其他 GPU 空闲等待
- 批处理效率(MFU)严重下降
vLLM 的 EPLB(Expert Parallelism Load Balancer)通过两个机制应对:
-
冗余专家(
num_redundant_experts):把热门专家复制多份放在不同 GPU 上,token 路由到最近的副本。这本质上是专家级的”缓存复制”——热门专家的权重跨 GPU 镜像。 -
动态重映射(
EplbLayerState):在每个 step 中收集各专家的实际 token 数(记录在expert_load_view中),周期性重新计算专家到 GPU 的映射(logical_to_physical_map、logical_replica_count),把热点分散。
EPLB 状态在 MoERunner 中通过 set_eplb_state() 注入,每次 forward 时 router 使用最新的映射表。当前 EPLB 只支持专家在 EP 维度均匀分布(num_experts % ep_size == 0)。
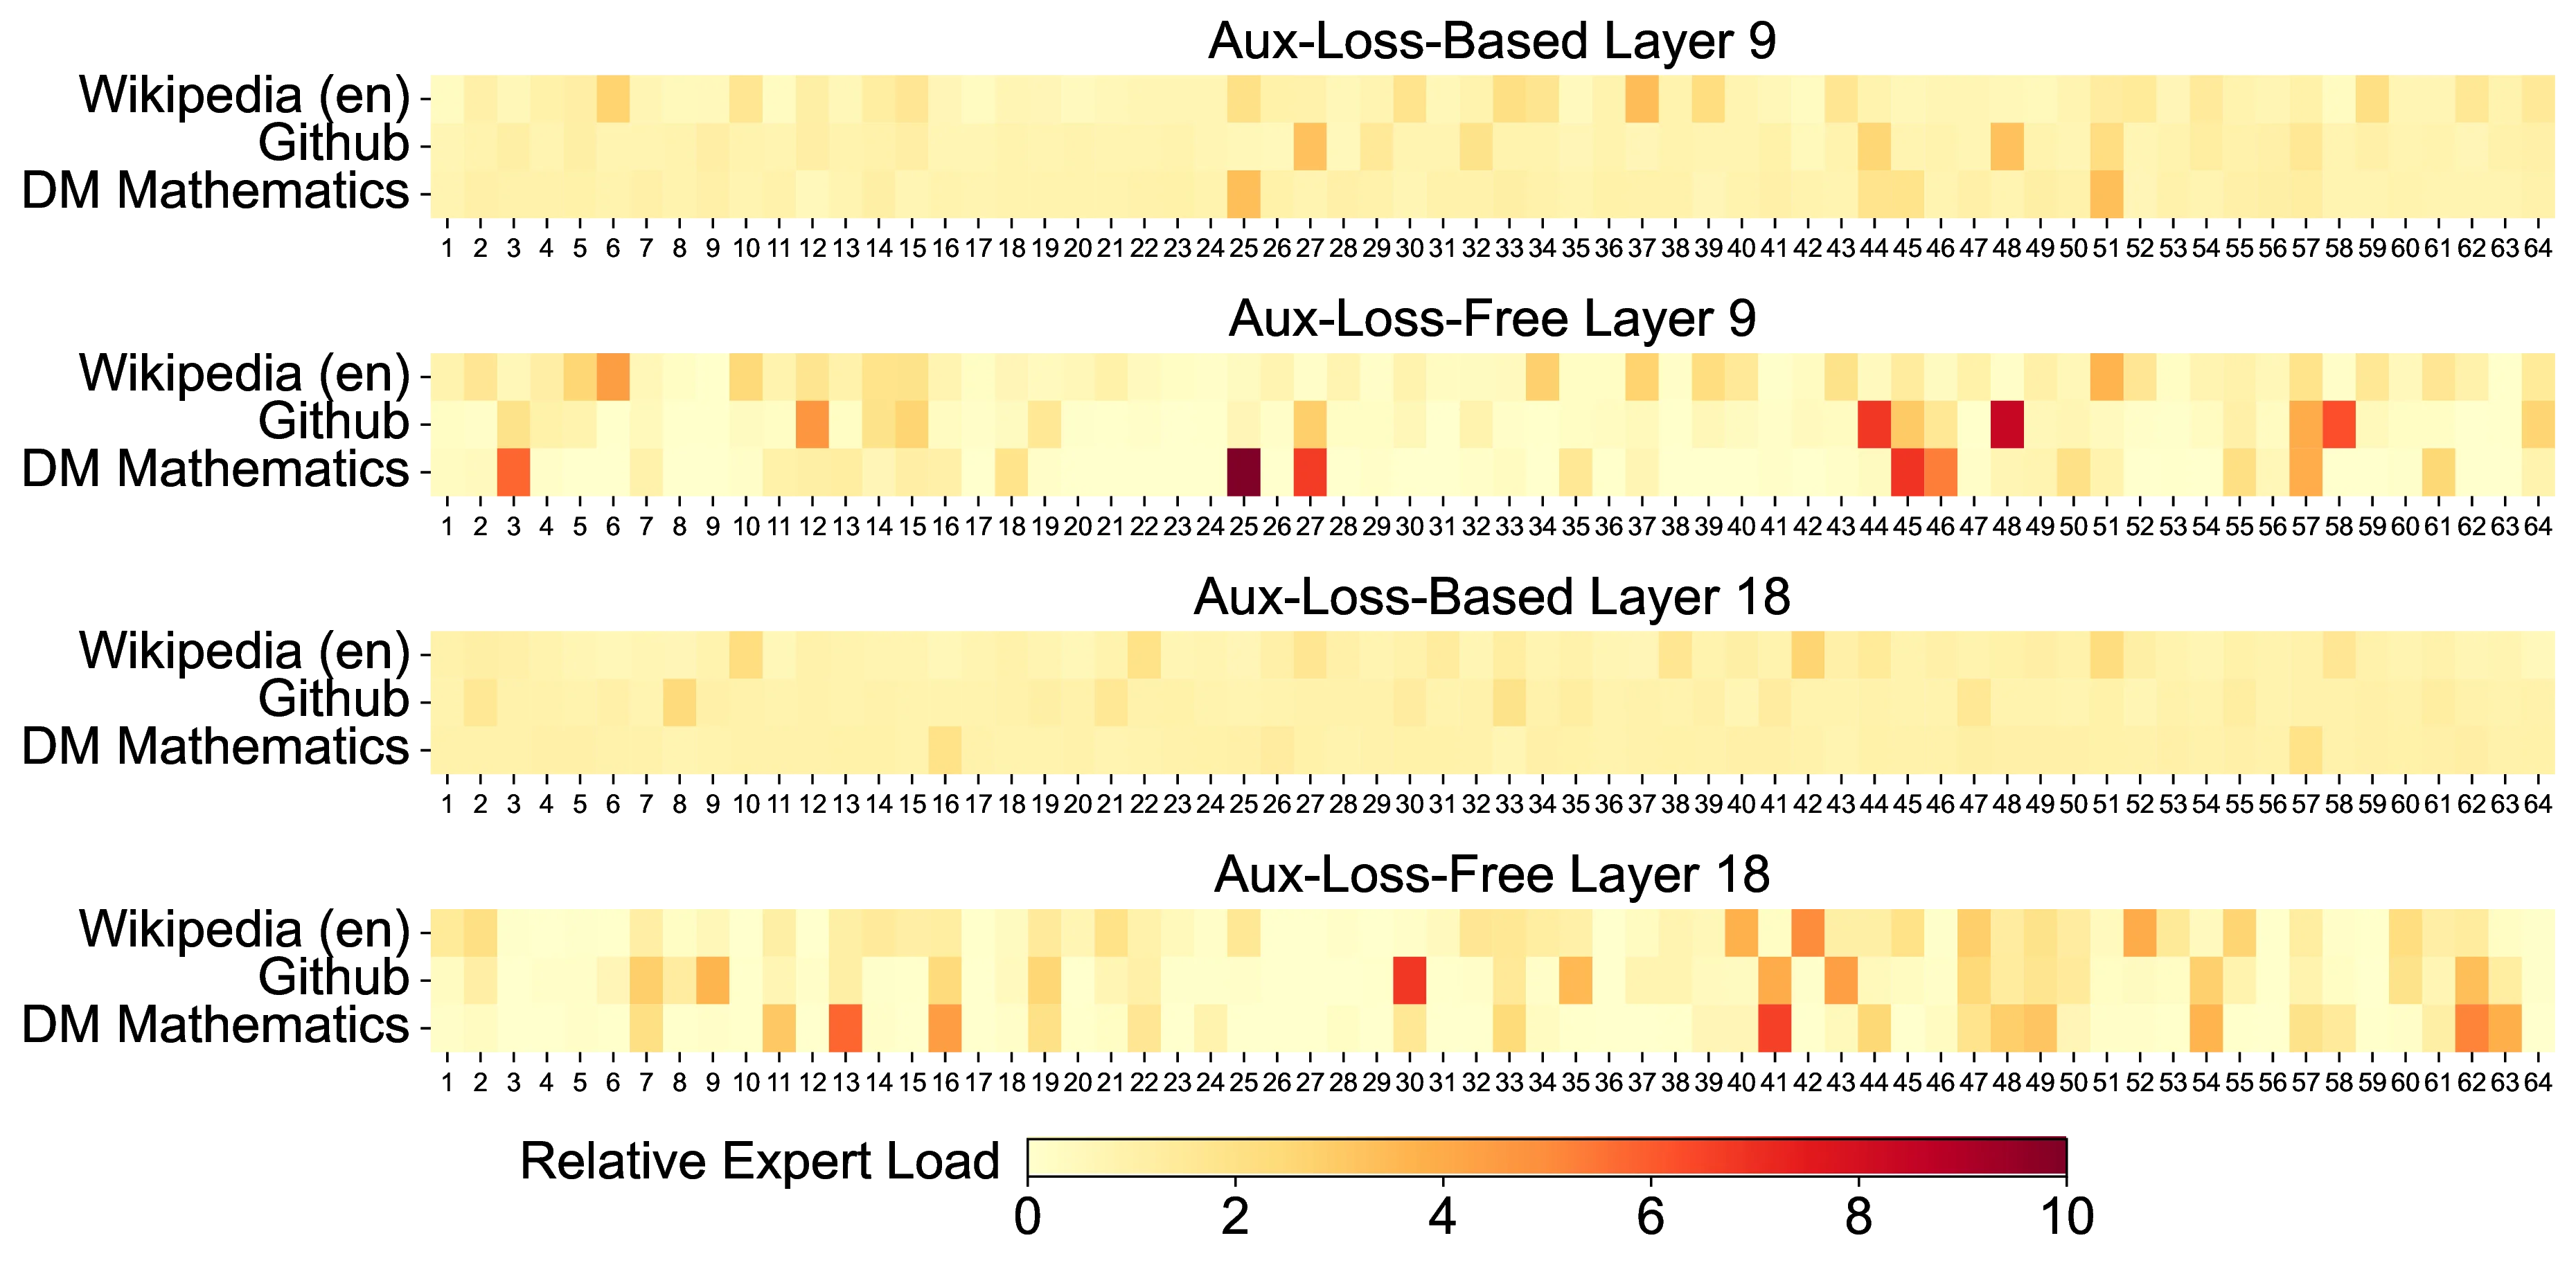
DeepSeek-V3 各层的专家负载分布(来源:DeepSeek-V3技术报告)。横轴是专家编号,纵轴是相对负载。不同层的负载分布差异显著——有的层专家负载相对均匀,有的层呈现明显的热点专家现象。这正是 EPLB 需要动态调整专家放置的原因。
通信融合:Custom Op、CUDA Graph 与流水线
MoE 层的通信(All-to-All dispatch/combine、All-Reduce for TP)是性能开销的大头。vLLM 通过几个机制来降低或隐藏通信开销:
Custom PyTorch Op(moe_forward)
MoERunner 的 forward 入口被封装为 torch.ops.vllm.moe_forward 自定义 op。这对 torch.compile/Dynamo 非常关键——Dynamo 无法 trace 复杂控制流(条件 dispatch、EPLB 映射、多种 kernel 路径),但面对一个 opaque custom op 时,它可以把它当作单个 kernel 来调度,不影响整个图的编译。
自定义 op 的 fake 实现也简洁:直接返回和输入同 dtype、同 shape 的空张量。这让 Dynamo 在 fake tensor 阶段就能推断整个图的 shape 和 dtype,提前完成编译。
CUDA Graph 中的 MoE 层
vLLM V1 的 CUDA Graph 对 MoE 有多层支持。FusedMoEConfig 中记录了 max_capture_size——CUDA Graph 能捕获的最大 batch size。当 batch size 在 capture 范围内,整个 MoE 层(包括路由、kernel 计算、通信)被重放而非重新 launch。当 batch size 超出时,退回到 eager 执行。
MoE 层在 CUDA Graph 中的特殊之处在于路由输出的大小不固定——不同 step 的 topk_ids 可能指向不同的专家组合,导致后续 kernel 的 launch config 变化。vLLM 通过 _routing_replay_out 机制处理这个问题:在 graph capture 时预分配一个最大尺寸的 buffer,每次重放时 router 把结果写入这个 buffer,kernel 从 buffer 读取。
通信与计算的重叠
在 EP 场景中,dispatch All-to-All 和 combine All-to-All 是必须的两次通信。vLLM 的融合 All-to-All kernel(use_all2all_kernels=True 时)尝试把 dispatch 通信和路由计算重叠:
- Router 先完成 softmax + topk(这是纯计算,不依赖通信)
- All-to-All dispatch 把 token 送到专家所在 GPU
- 专家计算(GEMM+激活)在本地 GPU 上执行
- All-to-All combine 把结果送回原始 GPU
步骤 1 和步骤 2 可以部分重叠——在 topk 完成后立即开始 dispatch,不需要等所有 token 的路由都完成。但这需要精细的 stream 管理和 barrier 插入,当前 vLLM 主要在 DeepEP 后端(DeepSeek 开源的通信库,本站已有DeepEP完全拆解文章)实现这种细粒度重叠。
小结
vLLM 的 MoE 实现经历了从”能用”到”架构清晰”的演进。当前架构的三个核心抽象——Router(选专家)、RoutedExperts(管权重和 kernel)、MoERunner(编排全流程)——各自职责明确,为不同模型的 MoE 变体(DeepSeek V3/V4 的分组路由、Mixtral 的简单 top-k、Nemotron 的 Latent MoE)提供了统一的扩展框架。
站在推理框架工程师的视角,这篇文章覆盖了从 gate 计算 router_logits 到最终输出合并的完整链路。下一篇将继续深入,拆解 vLLM MoE 的 Kernel 层——fused_moe Triton/CUDA kernel 如何实现 batched GEMM、如何做 FP8 量化推理、以及 modular_kernel.py 中的 MoE Kernel 插件化架构如何让不同的量化方案和硬件后端(CUDA/ROCm/TPU)接入同一套接口。
参考资料
- DeepSeek-V3 Technical Report
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- vLLM FusedMoE Source Code
- SGLang DeepEP 后端文档
- DeepSeek-V4 混合注意力完全拆解
- DeepEP 完全拆解
- DeepSeek-V3/R1 推理系统完全拆解
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


