


Quest 完全拆解:查询感知的页级稀疏注意力,让长上下文解码只读有用的 KV
背景与问题定义:KV Cache 读取撑爆了长上下文解码
长上下文推理的困境是一个算术问题。decode 阶段每生成一个 token,自注意力层都要把之前所有 token 的 K、V 向量从显存里读一遍:先算 Q 和每个 K 的点积,softmax 归一化,再对 V 加权求和。序列越长,每次要读的 KV 越多,而模型参数那一侧的读取量是固定的——KV Cache 成了唯一的增长项。
Quest 论文(MIT 韩松组与华盛顿大学等,2024 年 5 月发布于 arXiv)给这笔账算得很清楚:Llama-7B 在 32K 上下文时,KV Cache 达到 16 GB。按每层 32 个头、每个头 128 维、FP16 存储,可以精确算出来:
其中因子 2 表示 K 和 V 各存一份, 是序列长度, 是 KV 头数(Llama-2-7B 是 MHA,KV 头数等于 query 头数), 是每头维度。RTX 4090 的显存带宽约 1 TB/s,把这 16 GB 全读一遍至少要 11 ms(论文实测 FlashInfer FP16 实现),占单个 decode 步延迟的一半以上。也就是说,模型前向里最贵的不是 FFN 的矩阵乘,而是把 KV Cache 搬进计算单元的过程。
更不利的是这一成本出现在每个 decode 步上。以 16K token 的 prompt、512 token 的回复为例,prefill 只发生一次,decode 要发生 512 次,decode 阶段合计占端到端延迟的 86% 以上。长上下文场景把这个结构性问题放大:prefill 便宜了——可以并行、可以用 FlashAttention 一遍过,decode 却在每一步都要为不断膨胀的 KV Cache 付出等价的读取代价。
如果把「读满整个 KV Cache」换成「只读对当前输出真正有影响的那一小撮 KV」,decode 的延迟增长就能被斩断。要做到这一点,先得确认两件事:注意力输出是否真的只需要一小部分 token;以及这一小部分能不能提前挑出来。
注意力天然是稀疏的,且关键 token 随查询而变
稀疏性来自注意力的重尾分布
稀疏注意力(sparse attention)这条路线的经验前提是:注意力权重高度不均匀,一小部分「关键 token」(critical tokens)就足以累积绝大部分 softmax 分数。Quest 引用的 H2O、FastGen 等工作都验证过这一点。论文在 LongChat-7B 上做了一个更直接的量化实验:逐层删 KV token,删到 PG19 困惑度上升不超过 0.01 为止,看每层到底需要保留多少 token。结果是除了前两层,其余层的稀疏率都超过 90%——也就是说,绝大多数层里不到 10% 的 token 就能撑住原有的精度。这个 Oracle 实验给整条路线标定了上限:如果选择器足够准,理论上可以丢掉 90% 以上的 KV 读取。
但「哪一小撮」取决于当前的 query
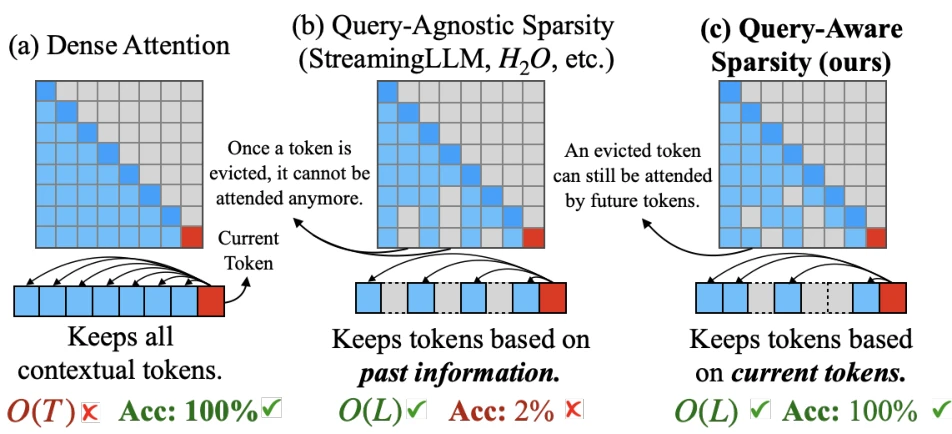
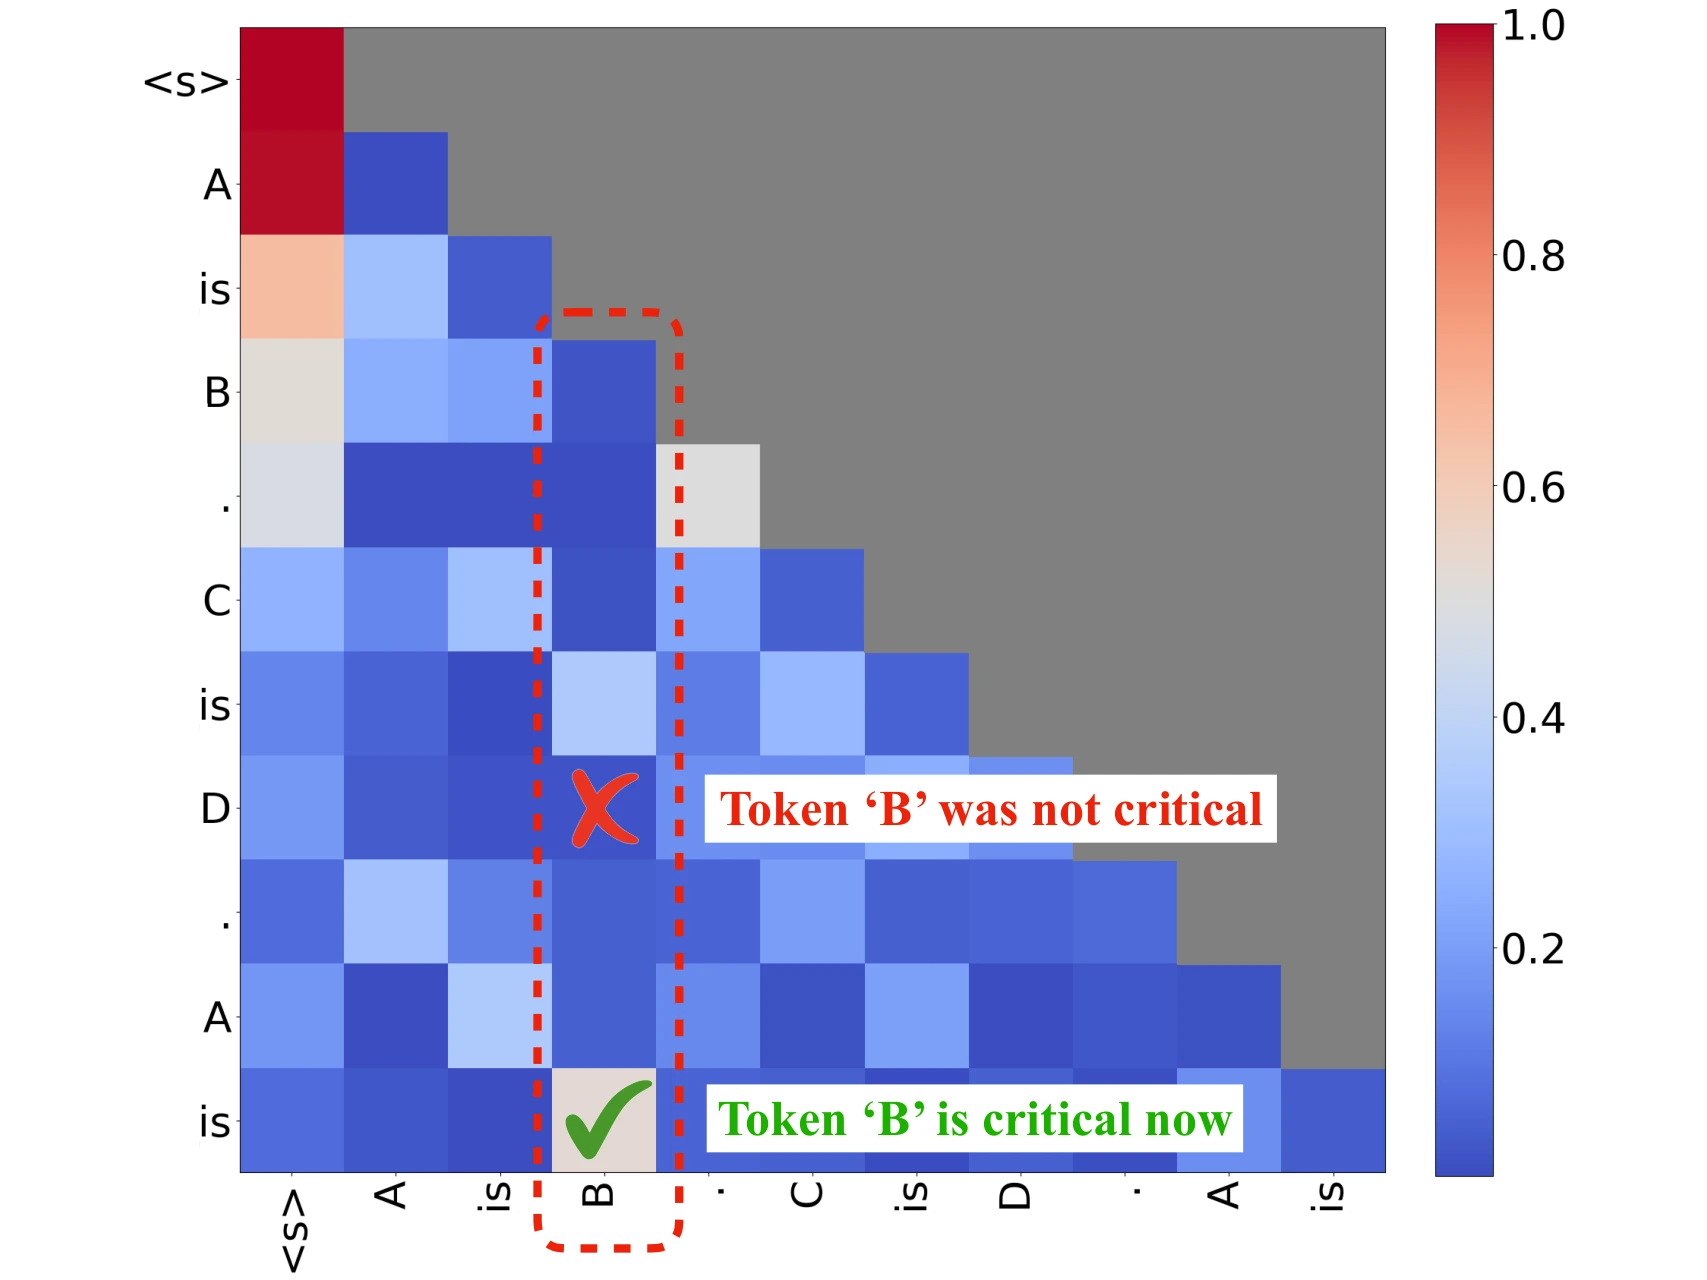
真正的难点在第二个问题。「哪些 token 重要」并不是 KV Cache 的固有属性,而是随查询变化的。论文里有个很直观的例子:prompt 是「A is B. C is D. A is」,模型要续写的是「B」。在最后一层的注意力图里,查询「is」强烈关注 token「B」;但在这条查询出现之前的所有解码步里,「B」的注意力得分一直很低——没有任何历史信号能预示它即将变得关键。
论文用 recall 指标量化了这个现象:以全注意力的 Top-10 注意力 token 集合为标准,统计各种方法选出的 token 与它的重合率。KV Cache 驱逐类方法(H2O 等)的 recall 很低,因为关键 token 早就在之前的迭代步中被丢弃了;而 Quest 因为每一步都基于当前查询重新打分,recall 接近全注意力。
这组对照把两条路线的本质差别讲清楚了:
| 路线 | 代表方法 | 关键性判定时机 | KV 命运 | 主要风险 |
|---|---|---|---|---|
| 查询无关驱逐 | H2O、TOVA、StreamingLLM | 基于历史注意力分数 | token 被永久删除 | 未来查询需要时已丢失 |
| 事后重打分 | SparQ | 用通道剪枝近似重算分数 | 可恢复但通道级稀疏难做 kernel | 长依赖任务未充分验证 |
| 查询感知选择 | Quest | 每个解码步用当前查询打分 | 全量保留、按需读取 | 选择器估计误差 |
驱逐方法省的是内存占用,但代价是把「未来可能重要」的 token 删掉了;Quest 把判断推迟到每一步解码时——全量 KV 全都在显存里,只是当前这一步不读它们。存储没省,读的时间省了。这也正是它对 passkey retrieval 这类长依赖任务几乎无损的原因:答案的 KV 一直在,只要查询到了,选择器就能找到它。
页级管理:把选择的开销压到可接受
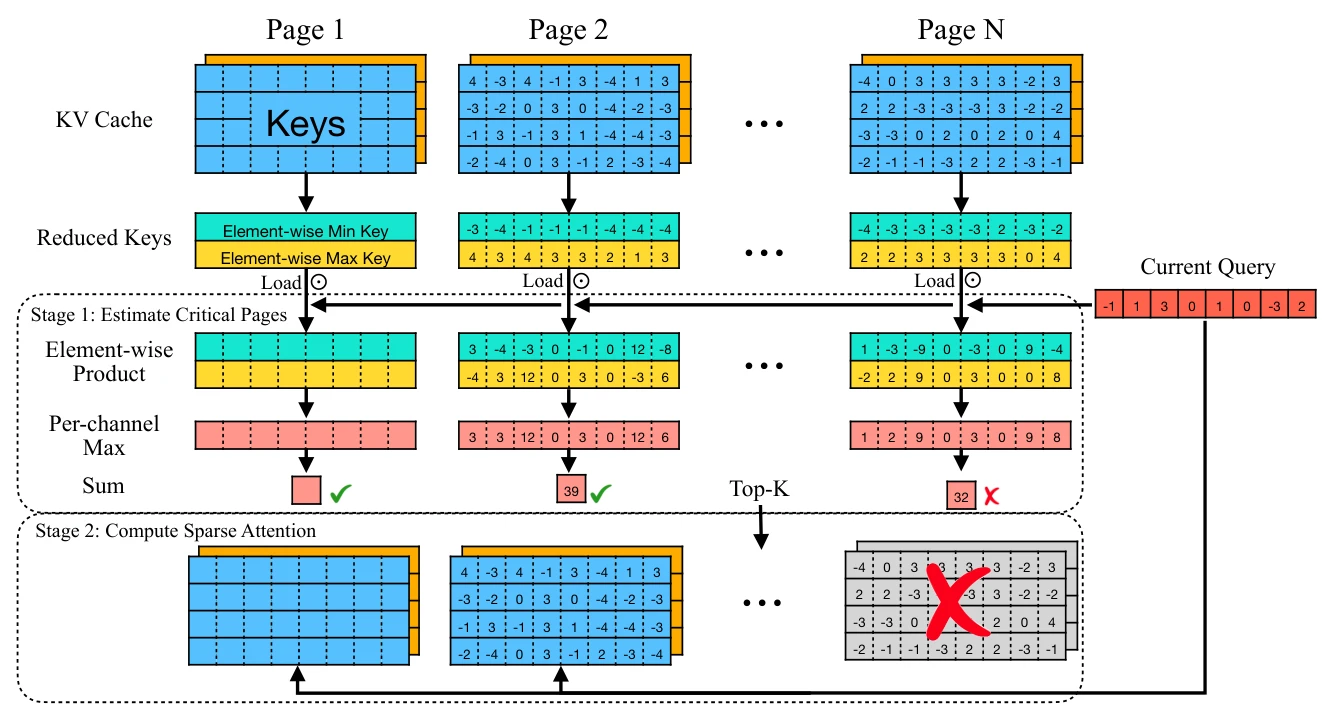
逐 token 打分的开销不可忽略:如果一个序列有 L 个 token,每个头都要对全部 L 个 K 向量各做一次点积再排序,这个 precompute 本身就是一次近似注意力,抵消了后面的收益。Quest 的做法是借用 PagedAttention 的页式管理(站内 PagedAttention 完全拆解 详细拆过 vLLM 的分页机制):把 KV Cache 按 16 对 KV 一个 page 切分,关键性估计以页为单位。每页的打分只需要读该页的元数据——每维的最小值和最大值两个向量,数据量是整页的 1/S(S 为页大小),而不是 S 个 token 的完整 K 向量。
核心机制:用 Min/Max 元数据求注意力权重的上界
为什么每维最大值能给出页级上界
Quest 打分的核心是一个不等式。同一个 page 里所有 token 的 K 向量共享每维的统计量: 是该页内所有 K 向量的第 维最小值, 是第 维最大值。给定当前查询 和该页内任意一个 token 的键向量 ,有:
证明只需要分两种情况讨论:当 时, 的最大值在 处取得,即 ;当 时, 处取得最大值 。无论 在页内取什么值, 都不会超过 。
注意这个上界有两个好性质。第一,它是逐维独立计算的——不需要知道页内任意一个 token 的完整 K 向量,只需要每维两个标量( 与 ),这就是每头 个数的量级而不是 。第二,它对页内任何 token 都成立,所以「 最大的页」必然覆盖「点积最大的 token」所在页:一个页如果含有全序列点积最高的 token,它的上界 至少不会低于那个真实点积。这个性质保证了 Top-K 选择的召回下界:真正的冠军页一定在候选集里,除非被其他上界更高的页挤出前 K。
当然,上界必然是松弛的。极端情况下,一个页每维都存在单侧大值,但不同 token 之间不相关的页也可以刷出同样的高分——这就是误报(false positive)被选进 Top-K 的来源,代价是浪费了几个页的读取,但不影响正确性(真正的关键页仍在集合内)。反过来,误杀不会发生,这是选择器质量的关键。
关键性估计算法
算法流程可以拆成两段。「插入 token 到 KV Cache 时」更新元数据,是增量维护,每个新 token 只触发每维一次比较:
「执行自注意力时」执行打分,对当前查询 与每页的 做:
注意 、 本身按 FP16 存,元数据大小为每头 个数,只占该页 K 向量的 ( 时是 1/8)。Top-K 从这些分数里挑出 K 个页号,用它们的页面索引做稀疏加载索引喂给 approximate-attention kernel。
这个打分本质上是把一个 的问题压缩成 的常数级近似,精度损失全部落在「排序可能错」而不是「真值可能算错」。上界选页的边界可以概括成:排序可能把无关页错排进来,但不会把真正该选的页漏掉(只要 K 取得合理)。这就是近似注意力仍能保持精度的直觉原因。
实现细节:从选择到近似的整套 kernel 流水线
三段式 kernel 与内存流水
Quest 的完整 decode 自注意力过程分三个算子(论文基于 FlashInfer 实现专用 CUDA kernel,Top-K 步用 vector search 库 RAFT 的 batched Top-K):
- Criticality estimation:读每页的 元数据,与当前查询逐维乘积取 max 求和,输出每页一个分数。内存占用是全量 KV 的 。
- Top-K filtering:从分数里选 K 个页号。数据量只有页数个标量,延迟 5-10 微秒(序列长度 128K 以内),论文在效率分析里忽略这一步。
- Approximate attention:只把选中的 K 个页的完整 K、V 加载进 FlashAttention 式的 kernel 做正常注意力计算。
每一层的 KV 读总量变成:
读入比就是论文给的公式:
这里 是单个 K 或 V 向量的字节数, 是序列长度, 是页大小, 是 token 预算对应的页数(token budget )。代入论文的例子:页大小 、上下文 64K(即 Page Num = 4096 个页)、Top-K 取 256 个页(对应 4K token 预算),读入比就是 ,等价于 8 倍内存读取削减。
推理复杂度如何随序列长度变化
这个公式最有价值的地方是第二项 :K 在解码步之间是固定常数(token budget 是预设定值,如 2048 或 4096),但 Page Num 随序列长度增长而增长,所以 approximate attention 的读入是常数——decode 的注意力延迟不再随序列长度增长,这与 Figure 8(b)、Figure 10 的实验观察完全一致。相比之下,FlashInfer 的完整 KV 读取与 成线性正比,32K 序列时 Quest 的注意力加速比达到 7.03 倍(token budget 2048)。
线性增长的读取被压成两项衰减的和后,还有两个次级效应值得注意:
- 元数据项 是衰减下界。Page Size 取太小,元数据占比高;取太大,Top-K 内冗余 token 多。S = 16 是论文的折中。
- 打分核本身也要吃带宽。短序列时元数据不足以喂满显存带宽,criticality estimation 的效率反而低于 FlashInfer;序列拉长后逼近 的理论比值。这决定了 Quest 在短上下文场景里不值得开——这也是所有推理期稀疏方法共同的经济性边界。
与量化、GQA、多页并行的兼容性
Quest 的选择算法与数值表示基本正交:、 元数据既可以在写入 FP16 KV 时顺手维护,也可以在 KV 量化(如 KIVI 这类 2/4-bit 方案)后从量化值直接取,选择阶段因此几乎不增加额外读取。另一方面,它借用的 PagedAttention 页表结构意味着与 vLLM 式推理引擎的集成几乎零侵入——vLLM 的 KVCacheManager 本来就把 KV 组织成物理块(block),Quest 需要的只是在每个块上多维护两个统计向量,并把选块结果变成 kernel 的稀疏加载索引。站内拆解过的 PagedAttention kernel 里按 block 表寻址的方式,正是 approximate attention 能够「只读选中的页」的工程前提。
首两层为什么不做稀疏
一个容易被略过的实现细节:Quest 不对模型前两层做任何稀疏(全量 KV 全读)。前面 Oracle 实验给出的逐层稀疏率分布显示,第 1、2 层的稀疏率低于 10%——这些层接近稠密注意力,即使不删 token 也换不来多少加速;强行稀疏反而伤精度。同理,对 H2O、TOVA 等对照方法的评测也保留前两层全量,保证对比公平。「跳过前两层」与选择算法本身正交,是一条针对层间异质性的通用实践。
精度与性能实测:从 recall 到端到端延迟
passkey retrieval:长依赖能力的试金石
passkey 任务在大量噪声文本里埋一个随机 passkey,让模型复述。这个任务对「被删掉的 KV 是否还能被找回」极端敏感,正好把查询感知选择和查询无关驱逐的差异放到最大。10K/100K 两种长度的结果:
| 方法 | 10K 上下文,budget 32/64/128/256/512 | 100K 上下文,budget 256/512/1024/2048/4096 |
|---|---|---|
| H2O | 0% / 1% / 1% / 1% / 3% | 2% / 2% / 2% / 2% / 4% |
| TOVA | 0% / 1% / 1% / 3% / 8% | 2% / 2% / 2% / 2% / 10% |
| StreamingLLM | 1% / 1% / 1% / 3% / 5% | 1% / 1% / 1% / 2% / 4% |
| Quest | 65% / 99% / 99% / 99% / 100% | 88% / 92% / 96% / 100% / 100% |
驱逐方法的失败模式是结构性的:在答案(passkey)尚未被查询时就把它当「低分 token」删掉,之后无论预算给多大都救不回来。StreamingLLM 只保留开头的 attention sink 和最近滑窗,passkey 一旦落到窗外也必然丢失。Quest 的 2K budget(10K 上下文的 1/5)就能做到 99% 到 100%,因为 passkey 的 K、V 一直都在,选择的只是当前查询读哪一份。
LongBench 六项任务的预算效率
在 NarrativeQA、HotpotQA、Qasper、TrivialQA、GovReport、MultifieldQA 六个数据集上,Quest 用 1K token budget 就能追平全 KV Cache 的精度;换成「无损精度所需的最小 budget」口径,六个任务分别做到 1/6、1/6、1/5、1/10、1/5、1/6 的 KV 稀疏度。同样的精度目标下,TOVA 在 NarrativeQA(平均 24K 上下文)需要 14K budget,Quest 只要 5K。
注意这组实验的一个细节:材料部分用 FlashAttention 完整 prefill,问题部分模拟逐 token decode。也就是说 Quest 省的是 decode 阶段的 KV 读取,prefill 仍走稠密注意力(后来很多工作专门攻 prefill,比如 MInference、XAttention,是另一条战线)。
kernel 与端到端性能
Llama-2-7B、RTX 4090、CUDA 12.2 下的 kernel 层实测:
- Criticality estimation 相对 FlashInfer 完整注意力的开销随序列增长收敛到 (页大小 16 时约 6%),且打分核每个页只需要读两个 维向量的元数据。
- Approximate attention 在固定 token budget B 下延迟为常数,与序列长度无关;序列长度恰为 B 时其延迟与 FlashInfer 相当(读的量一样多),之后拉开差距。
- Top-K filtering 延迟 5-10 微秒,可忽略。
- 三段合计:32K 序列、token budget 2048 时,自注意力加速 7.03 倍。
端到端(Ada 6000,decode 均延迟,含 4-bit 权重量化):32K 序列、budget 2048 下,FP16 权重 1.74 倍,4-bit 权重 2.23 倍。权重量化让 FFN 相应变快(权重读取变少),KV 读取在总时间里占比更大,稀疏注意力的相对收益随之放大——这与「KV 读入占比决定收益」的分析一致。论文在同一精度约束下与 TOVA 对比 GovReport 时达到 3.82 倍、TriviaQA 达到 4.54 倍的推理加速(定性比较,对照基线没有 kernel 实现,用 FlashInfer 延迟折算)。
边界与代价:什么时候 Quest 不是答案
GQA 下的并集放大
Quest 的页选择按每个注意力头独立进行。MHA 下这没有问题——每个头的 KV 本来就是独立的。但现代长上下文模型普遍采用 GQA(Grouped-Query Attention,分组查询注意力):每组只有一个共享 KV 头。对 GQA 模型做 per-head 选择,同一组内所有头选出的页的并集才是真正要读的 KV,稀疏度被组内头的数量稀释。NSA 的分析文章 里把这一点列为查询感知稀疏落地的第一道坎,NSA 的解法是把块选择改成组内共享(组内所有 query 头用同一份选择结果)。这是用 Quest 时必须评估的一点——模型架构决定了理论稀疏度能兑现多少内存读取削减。
prefill 不加速,收益集中在 decode
Quest 的近似注意力只作用于 decode 阶段。Prefill 依然是稠密注意力(O(n²) 的计算),不过 prefill 可以用 FlashAttention 高效并行处理,通常不是长上下文场景的第一瓶颈。工作负载以长生成为主(多轮对话、长思考链)时收益才明显;以长 prompt 单次问答为主时,prefill 端的其他方案更有针对性。
短序列的负收益
读入比 中的常数项意味着:序列长度接近 token budget 时,Quest 不但不再省,还多付了打分开销(元数据读取 + 估计 kernel)。论文实测打分核在短序列时效率不如 FlashInfer。因此它适合的区间是「序列长度远大于 token budget」的场景,一阶判断标准是 Page Num 至少要几倍于 K 取的页数。
排序误差的累积效应
Top-K 页的召回依赖 min-max 上界的紧致度。某些层的 K 分布离群值突出(局部激活异常),上界会显著松弛,把与当前查询无关的页也拉进 Top-K,挤掉真正相关的页。站内 BLASST 一文的实测里,Quest 在 RULER-32K 上只有 56.23(稠密 91.90)——同一模型下基于估计量的候选选择在检索任务上确实会漏页,而用真实 softmax 统计量做判定的方法可以免疫这类误差。这不是 Quest 实现的 bug,而是「用元数据近似排序」这一设计的内在代价:省下的读取换来的排序噪声。后续工作(组内共享选择、可学习选择器、多级验证)都在试图压缩这个误差。
相关工作与延伸阅读
与站内已有文章的关系
- 驱逐路线的起点是 H2O(按累计注意力分数做重击者驱逐),它的局限正是 Quest 的出发点——被驱逐的 token 对未来查询不可恢复。查询无关驱逐的另一端是 StreamingLLM,用 attention sink 加滑窗解决无限流式生成,牺牲的同样是窗口外的可检索性。
- 块/页粒度管理的工程基础是 PagedAttention,vLLM 的 KVCacheManager 与 PagedAttention kernel 拆解了页表寻址和分块 softmax 的实现,Quest 的 approximate attention 把「读哪些块」的选择层叠加在同一套结构上。
- 同为查询感知但走可训练路线的是 NSA:压缩、选择、滑窗三分支,块选择器端到端训练,选择在 GQA 组内共享;Quest 的启发式打分正是 NSA 消融实验里的对照之一。可训练路线的 kernel 落地在 NSA(二)。
- 简要提及 Quest 对比结论的还有 BLASST 和 MAC-Attention,分别从「免预计算的实时阈值」和「注意力复用」两个角度回应查询感知选择的成本问题。
- FlashInfer 是 Quest kernel 的实现基座,其稀疏 KV 表示与 JIT 模板是承载自定义选择核的方式。
后续演进
Quest 之后,查询感知稀疏注意力沿着三个方向继续推进。一是把启发式打分换成可学习模块,让选择器和模型一起训练,代表是 NSA/DSA、SeerAttention;二是把粒度做细,从页级到 token 级配额,比如 SparQ 用通道剪枝近似全序列分数后再逐 token 选择;三是回答「预算怎么定」的问题——DLoop、ELM 等把 token budget 变成自适应的,用置信度门控动态决定当步拉多少候选。Quest 本身的定位是这条谱系里最早的「零训练、纯系统侧」方案:不改模型、不重训、靠两个统计量加一个排序就吃到 query-aware 稀疏的收益,这个工程取向让它在长上下文推理刚成为问题的 2024 年就成了被广泛对比的基线。
小结
长上下文 decode 的瓶颈是 KV Cache 读取,而注意力权重天然重尾——多数 token 对当前输出的贡献接近零,关键 token 的集合又随查询剧烈变动。Quest 用三个机制把这件事变成可行的 kernel 流水线:以页为单位管理 KV,继承 PagedAttention 的全部工程基础;每页维护每维 min/max 两个标量,在线增量更新;解码时用查询与元数据的逐维 max 乘积求页级点积上界,选 Top-K 页做近似注意力。上界保证了候选集的召回下界——真正的关键页不会漏,被错选进来的页只是浪费少量带宽。结果是 32K 序列下自注意力 7.03 倍加速、4-bit 权重量化端到端 2.23 倍,passkey 与 LongBench 上以约 1/5 到 1/10 的 token budget 保住精度。它的适用边界同样清晰:GQA 架构会稀释 per-head 选择的稀疏度,prefill 阶段不在受益范围内,短序列下收益为负;当层的 K 分布离群时,元数据排序的噪声会让检索型任务掉分。这些边界指明了后续工作的改进方向,也说明了为什么「查询感知」这四个字值得整个子领域追着做。
参考资料
- Quest: Query-Aware Sparsity for Efficient Long-Context LLM Inference (arXiv 2406.10774)
- Quest 官方代码仓库 mit-han-lab/Quest
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models (arXiv 2306.14048)
- StreamingLLM: Efficient Streaming Language Models with Attention Sinks (arXiv 2309.17453)
- SparQ Attention: Bandwidth-Efficient LLM Inference (arXiv 2312.04985)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving (arXiv 2501.01005)
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention (arXiv 2502.11089)
- PagedAttention / vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention (SOSP 2023)
- RAFT: GPU-accelerated library for vector search and clustering
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


