


HySparse 混合稀疏注意力(一):用全注意力当 Oracle,打通 Token 选择与 KV 复用
从“少算注意力”到“少存 KV”
长上下文推理有两本彼此独立的账。
第一本是计算账。对长度为 的因果序列,标准自注意力在 Prefill 阶段要处理约 个 Query-Key 配对,复杂度为 ;到了 Decode 阶段,每生成一个 token,当前 Query 仍要扫描此前的 个 Key,单步复杂度为 。FlashAttention 能避免把完整注意力矩阵写回显存,却不会减少必须计算的配对数量。
第二本是容量账。设批量为 ,注意力层数为 ,KV 头数为 ,头维为 ,每个元素占 字节,那么不计分页元数据和对齐碎片,一份完整 KV Cache 约为:
系数 2 分别来自 Key 与 Value。GQA 通过减小 压低常数,PagedAttention 通过分页减少分配碎片,但二者都没有消掉 。因此,动态稀疏注意力即使让每个 Query 只读取 Top- 个历史 token,只要未来 Query 可能重新选中任意旧位置,系统就仍须保留完整 KV。少算不自动等于少存。
这正是许多稀疏方案最容易被混为一谈的三件事:
| 问题 | 真正要减少的对象 | 只做 Top- 是否足够 |
|---|---|---|
| 注意力计算 | 实际参与 与 的配对 | 通常足够 |
| HBM 读取 | 当前步搬入计算单元的 K/V | 取决于索引粒度与 kernel |
| KV Cache 容量 | 为未来步骤保留的历史状态 | 不足够,未选中的 KV 仍可能再次变重要 |
HySparse(Hybrid Sparse Attention)由小米 LLM-Core 团队在 2026 年 2 月发表于 arXiv。它不是继续改进一个独立的轻量索引器,而是重新安排层与层之间的分工:少数全注意力层负责产生高质量的全局注意力信号和完整 KV,随后若干稀疏层同时复用这两项产物。这样,一个全注意力层既是计算层,也是后续层的选择器和缓存生产者。
这项设计试图同时回答两个问题:
- 稀疏层怎样在不增加代理误差的前提下找到重要历史块?
- 稀疏层怎样不再为整段上下文各存一份 KV?
答案分别是“用前置全注意力层充当 Oracle”和“让全局稀疏分支跨层复用这份 KV”。这里的 Oracle 需要加一个限定:它知道的是前置全注意力层自己的精确注意力分布,并不直接知道后续稀疏层本来会产生什么分布。HySparse 能成立,依赖的是相邻层显著 token 往往较稳定这一经验事实,再通过原生架构让后续层适应这种跨层复用。它不是对后续层注意力真值的数学等价替换,也不能直接塞进任意现成全注意力模型。
HySparse 的总体结构
HySparse 把主干重复单元改成一个混合块:先放 1 个全注意力层,再接 个稀疏注意力层。记全注意力层输出的完整缓存为 ,它额外产生块级重要性分数 ,经 TopK 得到块索引集合 。后面的 个稀疏层不再生成和保存全长的全局 K/V,而是共享 。
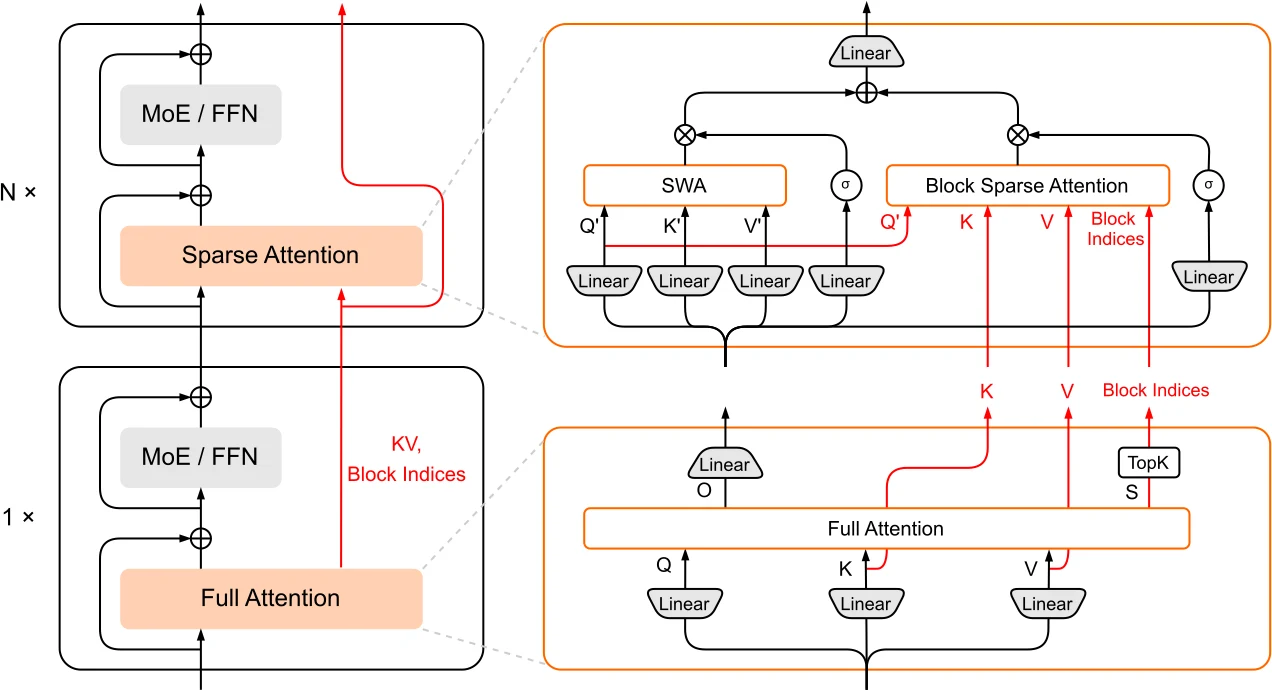
图片来源:HySparse 论文 Figure 1。红线是跨层复用路径:全注意力层向后续稀疏层同时提供 K、V 和块索引;黑线是各层自己的残差与局部计算路径。
图的左侧描述层间关系:一个全注意力层之后重复 次“稀疏注意力 + FFN/MoE”。图的右下角放大全注意力层,它正常输出注意力结果 ,同时从注意力计算中抽取分数 ,再用 TopK 生成 Block Indices。图的右上角放大一个稀疏层,它有两条并行路径:
- 块稀疏分支接收本层 Query,却读取前置全注意力层的 、,并按照 只访问少量历史块;
- 滑动窗口分支使用同一个 Query,但拥有本层自己的局部 、,只保留最近 个 token;
- 两条分支分别经过 sigmoid 门控,再相加并通过输出投影。
用数据依赖写成一行,就是:
是混合块中全注意力层的深度。需要注意,红线沿模型深度传播,不是沿生成时间传播。Decode 第 步时,当前 token 先经过这个混合块的全注意力层,得到针对位置 的选择结果;随后同一个 token 再依次经过块内的稀疏层。因此不存在“先知道未来 Query”或跨 token 偷看答案的问题。
论文采用两种配置。7B 稠密模型共有 36 层,全注意力与稀疏层之比为 1:3;80B-A3B MoE 模型共有 49 层,比例推进到 1:11,并让最后一层保持全注意力。后一配置实际只有 5 个全注意力层。两种规模都使用块大小 、稀疏预算 个 token,以及 的局部窗口。也就是说,每个稀疏 Query 的全局分支读取 16 个块,局部分支再读取最近 128 个位置。
| 配置 | 7B Dense | 80B-A3B MoE |
|---|---|---|
| 总层数 | 36 | 49 |
| Query / KV 头数 | 32 / 8 | 64 / 4 |
| Full : Sparse | 1 : 3 | 1 : 11 |
| 稀疏块大小 | 64 | 64 |
| 全局 TopK token 数 | 1024 | 1024 |
| 局部窗口 | 128 | 128 |
这组参数揭示了 HySparse 的核心取舍:全注意力层越少,计算和缓存越省,但同一组索引与 KV 必须跨越更多层,层间语义漂移也越大;局部窗口和门控正是为这段“共享距离”提供补偿。
全注意力层怎样成为稀疏层的 Oracle
从精确注意力里提取块级分数
对位置 ,标准缩放点积注意力为:
是注意力头维度, 是未归一化 logit, 是 softmax 后的注意力概率。若直接保存所有 ,就会重新引入 的注意力矩阵物化,抵消 FlashAttention 的 IO 优势。HySparse 因而不输出逐 token 矩阵,而是把 Key 轴按连续的 个 token 划块。
第 个历史块记作:
对当前 Query,它只保留每个块里的最大注意力概率:
随后选择分数最高的 个块:
默认 、,所以 。这里用最大值而不是块内求和,有明确的检索语义:一个块里只要藏着一个对 Query 极关键的 token,就应该避免它被大量低权重邻居稀释。代价则是“尖峰块”会优先于“许多中等相关 token 的块”。HySparse 论文没有给出 max、sum、log-sum-exp 三种聚合的系统消融,因此不能把最大值理解成已经被证明普遍最优;它首先是一种与 FlashAttention tile 统计相容、对检索尖峰敏感的工程选择。
为什么不需要重新物化注意力矩阵
FlashAttention 按 Query tile 与 Key/Value tile 流式计算。对 Query tile 、Key tile ,先得到局部 logits:
在线 softmax 为每一行维护运行最大值 和归一化累加量 。当新的 Key tile 到来时,局部行最大值 本来就是数值稳定归一化所需的中间量。若稀疏块大小与 Key tile 宽度相同,即 ,那么这份局部最大值恰好对应一个候选块的最大 logit。扫描结束后,把它换算到全局 softmax 尺度即可:
这就是“Oracle 分数几乎白捡”的来源:昂贵的 已经为全注意力输出计算过,额外工作主要是保存每个 tile 的行最大值、归一化并做 TopK,而不是再运行一个索引网络。
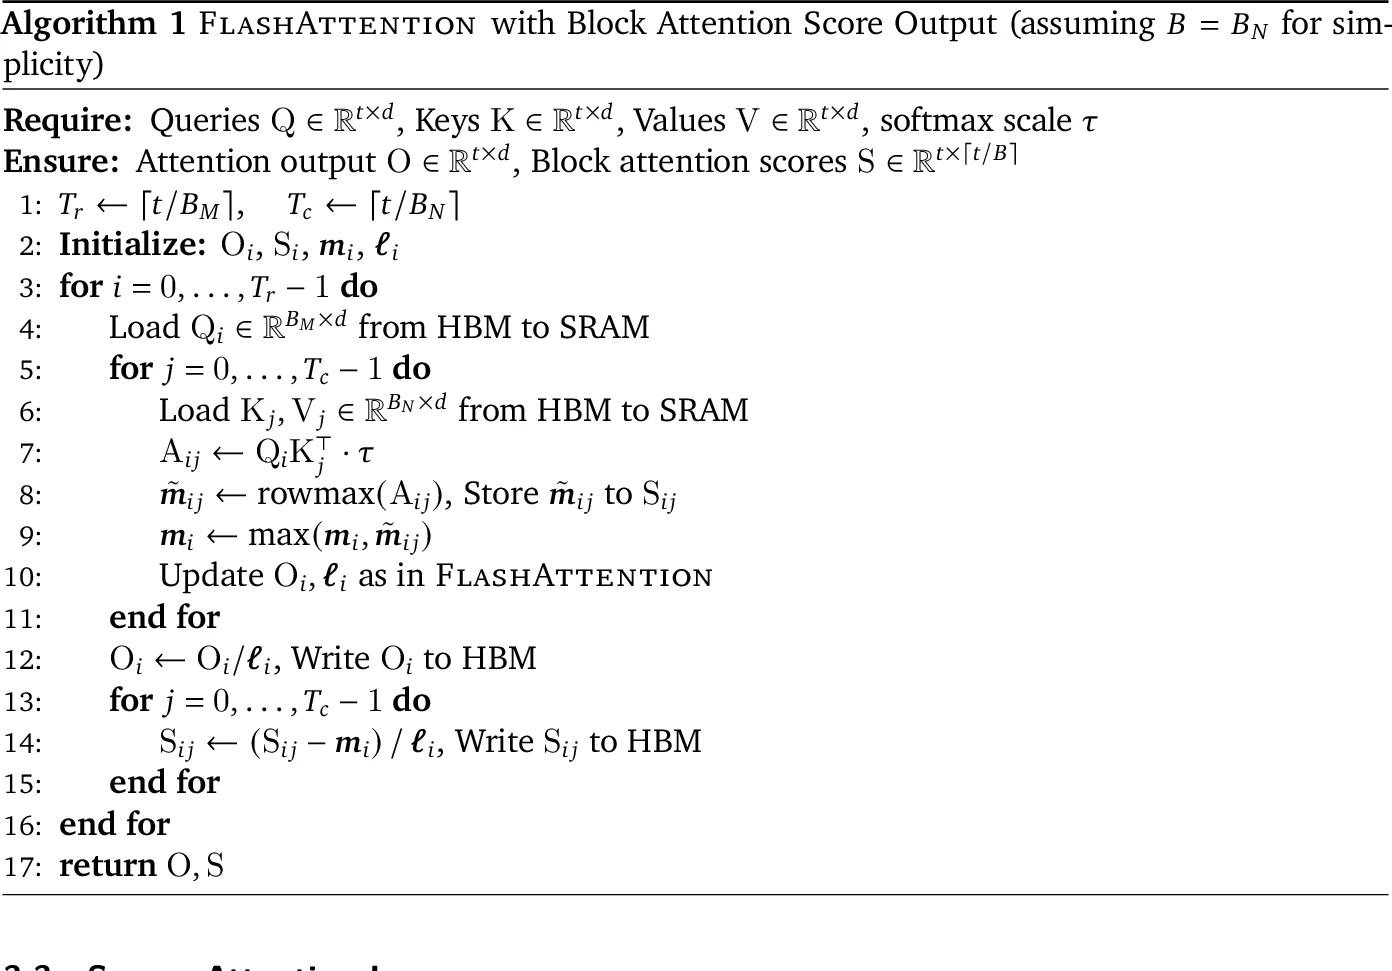
图片来源:HySparse 论文 Algorithm 1。主循环仍是标准 tiled attention,只额外保存每个 tile 的 rowmax,结束后输出块分数矩阵 。
论文伪代码第 14 行写成 ,而正文定义的是归一化后的最大注意力概率。两者要一致,中间必须有指数,即上式的 ;否则量纲仍是 logit,且可能为负。实现时应以正文公式与 online softmax 的数学关系为准,把伪代码这一行视为记号省略,而不能逐字照抄。
GQA 下为什么要组内共享索引
在 GQA 中,一组 Query heads 共享同一个 KV head。假设组内有 个 Query heads,若每个 head 各选 16 个块,kernel 实际要读取这些集合的并集;最坏情况下会膨胀到 个块,KV 共享带来的带宽收益随即消失。
HySparse 先对同组 Query heads 的块分数取最大值:
是第 个 GQA 组中的 Query heads。TopK 作用在 上,于是整组 head 共用同一份 。最大聚合意味着只要组内任意 head 强烈需要某个块,这个块就有机会入选;共享索引又让相应 KV 只需加载一次。准确率与规则访存由此落到同一个选择粒度上。
“Oracle”究竟精确在哪里
把 HySparse 和独立代理索引器对比,Oracle 这个名字有三层含义:
- 分数来自真正参与模型计算的 full-softmax attention,不是压缩 Key、min/max 包围盒或另一个低维网络的估计;
- 选择信号与全注意力输出在同一次 中产生,不存在单独索引器和主注意力的目标错位;
- 后续多层复用同一选择,因此选择成本被一组稀疏层摊销。
但它不是逐层精确。第 层的 Query 已经过 次残差、注意力和 FFN/MoE 变换,本来可能偏好不同历史位置。HySparse 实际采用的是:
这个近似把“给每层配一个代理索引器”的误差,换成“显著块在相邻深度内保持稳定”的假设。 越大,摊销越充分,选择过时的风险也越高。因而 1:3 与 1:11 不是单纯的速度旋钮,而是模型质量、全局计算频率与层间稳定性的共同折中。
TopK 只需要排序,为什么还要归一化分数
对同一个 Query head,softmax 分母对所有历史块相同,而且指数函数单调,因此三种排序完全一致:
如果只是给单个 head 取 TopK,直接比较每个 tile 的最大 logit 就够了,不必把它还原成概率。这能省掉一次显式归一化。论文仍把 定义成注意力概率,有两个好处:分数语义清楚,并且不同 Query head 的 logit 尺度可能不同。当 GQA 组内要对多个 head 的分数取最大值时,用各自 softmax 后的概率更接近“哪个 head 真正把较多注意力质量放在此块”,而不是让 logit 方差较大的 head 主导组内选择。
实现因此有两条路线:若每个 head 先独立 TopK,再合并候选,可以主要使用 logit 排序;若先跨 head 聚合再 TopK,就应严格处理各 head 的 online-softmax 尺度。选择哪条路线会改变临时存储、同步次数和最终集合,不能把“TopK 对单调变换不敏感”直接推广到跨 head 比较。
从保留的注意力质量理解误差
设某个后续稀疏层如果对共享全长 KV 做完整注意力,会得到概率 。选中集合为 ,集合内总概率质量为:
在选中集合内重新 softmax 的稀疏输出记作 ,未选集合归一化后的输出记作 。完整输出可以分解为:
所以:
其中假设所有 value 向量范数不超过 。这个简单上界说明,稀疏误差的关键不是“选中了多少 token”,而是选中集合覆盖了多少当前层的注意力质量。HySparse 的 Oracle 来自前置层,因此真正需要关注的是:前置层选出的 16 个块,在后续层仍能获得多大的 。层间 TopK 重合率只是间接指标,按注意力质量加权的召回率更接近最终误差。
块最大值还带来一个特殊风险:它偏向保护单个尖峰,却不直接最大化 。一个包含单个 0.10 权重 token 的块会压过一个包含十个 0.02 权重 token 的块,尽管后者总质量更大。固定读取整块能部分保住尖峰邻域,SWA 负责兜住近期密集依赖,但远程“宽而不尖”的相关区域仍可能漏选。这是理解 max 聚合边界的一把尺子。
跨层 KV Cache 复用怎样成立
选出块索引只解决了“读哪些位置”。若每个稀疏层仍保存自己的全长 ,容量账没有改变。HySparse 的第二步是让全局稀疏分支直接查询前置全注意力层的缓存:
第 层仍从自己的隐藏状态生成 Query ,只是 Key/Value 来自深度 。因此它不是重复前置层的注意力:Query 已经变了,注意力权重与读出的内容也会变。共享的是“历史记忆的编码”,不是“如何查询这份记忆”。这与 YOCO 的共享全局 KV 有相似思想,但粒度不同:YOCO 在 Decoder-Decoder 边界生成全局 KV,供整个 Cross-Decoder 读取;HySparse 则在每个混合块内部,用一个全注意力层服务其后的若干稀疏层,并同时复用选择索引。
为什么局部分支不能也复用同一份 KV
最省显存的做法似乎是让滑窗分支也读 。论文的消融却表明,这会明显损伤效果。原因可以从表示分工理解:
- 全注意力层的 KV 要在整段历史上承担全局检索,适合成为稳定的共享记忆;
- 局部分支只服务最近 128 个 token,需要跟随当前层的隐藏状态继续加工短程组合、语法和局部状态;
- 若局部分支也被锁定在前置层的表示上,连续多个稀疏层只能改变 Query,无法逐层改写本地 Key/Value,局部通路的深度表达能力被削弱。
所以每个稀疏层仍计算自己的 ,但只保留长度为 的环形窗口。全局状态跨层共享,局部状态逐层更新,这是 HySparse 的真实缓存结构。
设模型有 个全注意力层、 个稀疏层,忽略索引、门控与尾块对齐,HySparse 的 KV 容量近似为:
相对全注意力模型的比例是:
当 时,第二项很小,容量主要由全注意力层占比 决定。对 49 层、5 个全注意力层、 的 80B 配置,极限比例约为 ,对应约 的缩减。这也是论文“近 10 倍”的来源,不是把每层 KV 做了 10 倍量化或压缩,而是绝大多数层根本不保存全长 KV。
把数字代入会更直观。仍用 80B 配置的 4 个 KV heads、head dimension 128,取 batch size 1、BF16、上下文 :
49 层全注意力需要约 。HySparse 的 5 份全长 KV 占 320 MiB;每个稀疏层的 128-token 局部缓存约 0.25 MiB,44 层合计 11 MiB,总计约 331 MiB。该长度下缩减约 ,尚未达到极限 ,因为局部窗口项仍占 11 MiB。批量增大时两者都线性增长,这个比例基本不变;若 KV 量化,两者也会按相同字节数比例下降。
还要加上一个公平比较:Hybrid SWA 若采用同样的 Full : SWA 层比,也只为全注意力层保存全长 KV,为 SWA 层保存窗口 KV。因此 HySparse 相对 Hybrid SWA 并没有进一步降低缓存阶数。它的价值是,在近似相同的缓存容量下,让原本只能看局部窗口的层多出一条可访问全局关键块的路径。换句话说,KV 复用不是让 HySparse 比同层比的 SWA 更省,而是让它在不增加全长缓存的前提下恢复全局检索。
三条分支如何拼成一次稀疏注意力
这里的“三条”不是三个并行注意力分支,而是三类数据来源:本层 Query、共享的全局 KV、本层的局部 KV。真正并行计算的是块稀疏全局分支与 SWA 局部分支。
同一个 Query,查询两种记忆
稀疏层先从当前隐藏状态 生成一套投影:
同时送往两个分支; 只写入该层的局部环形缓存。SWA 输出为:
块稀疏分支则根据 从共享缓存 gather 出 个 token,再重新计算当前层 Query 对这些 Key 的精确 softmax:
“复用索引”不等于复用注意力概率。前置层的分数只负责决定候选集合;后续每个稀疏层都用自己的 对入选 KV 重新打分和归一化。因此,即使多个层访问同样的 16 个块,它们仍能从这些块里读出不同信息。
两个 sigmoid gate,而不是二选一
两个输出分别经过输入相关的 sigmoid 门:
与 可以是按 head 或通道作用的门值, 表示逐元素乘法。这里用两个独立 sigmoid,而不是在两分支间做 softmax,意味着它们不必竞争一份总权重:模型可以同时放大全局检索与局部连贯性,也可以同时抑制两者,再依靠残差路径保留输入。门控不是装饰性的加权平均,而是给两种表示来源一个可学习的幅度控制。
为什么局部窗口仍不可替代
一个看似合理的质疑是:Oracle 已从完整历史中挑出最重要的块,最近 token 如果重要,自然也会被选中,何必再固定留一个窗口?问题在于“选中局部位置”和“拥有当前层的局部表示”不是一回事。
全局分支选中的近期块仍使用前置全注意力层的 。它能找回位置,却无法提供本层新生成的局部 Key/Value。SWA 分支则在每一层重新投影最近上下文,让局部表示随深度演化,同时给所有 Query 一条稳定、连续、无需 TopK 命中的短程路径。
论文在 7B 模型上做的消融印证了这一点。在不启用 KV 共享、只考察 Oracle 选择时,加入层内 SWA 后,DROP 从 46.4 提升到 52.2,GSM8K 从 29.7 提升到 37.7,BBH 从 48.2 提升到 52.4。另一组消融比较两种共享方式:让全局与局部分支都共享前置层 KV 时,MMLU 为 52.8、MMLU-Pro 为 23.2;只让全局稀疏分支共享、给 SWA 保留独立 KV 后,两项分别变为 58.4 和 29.0。
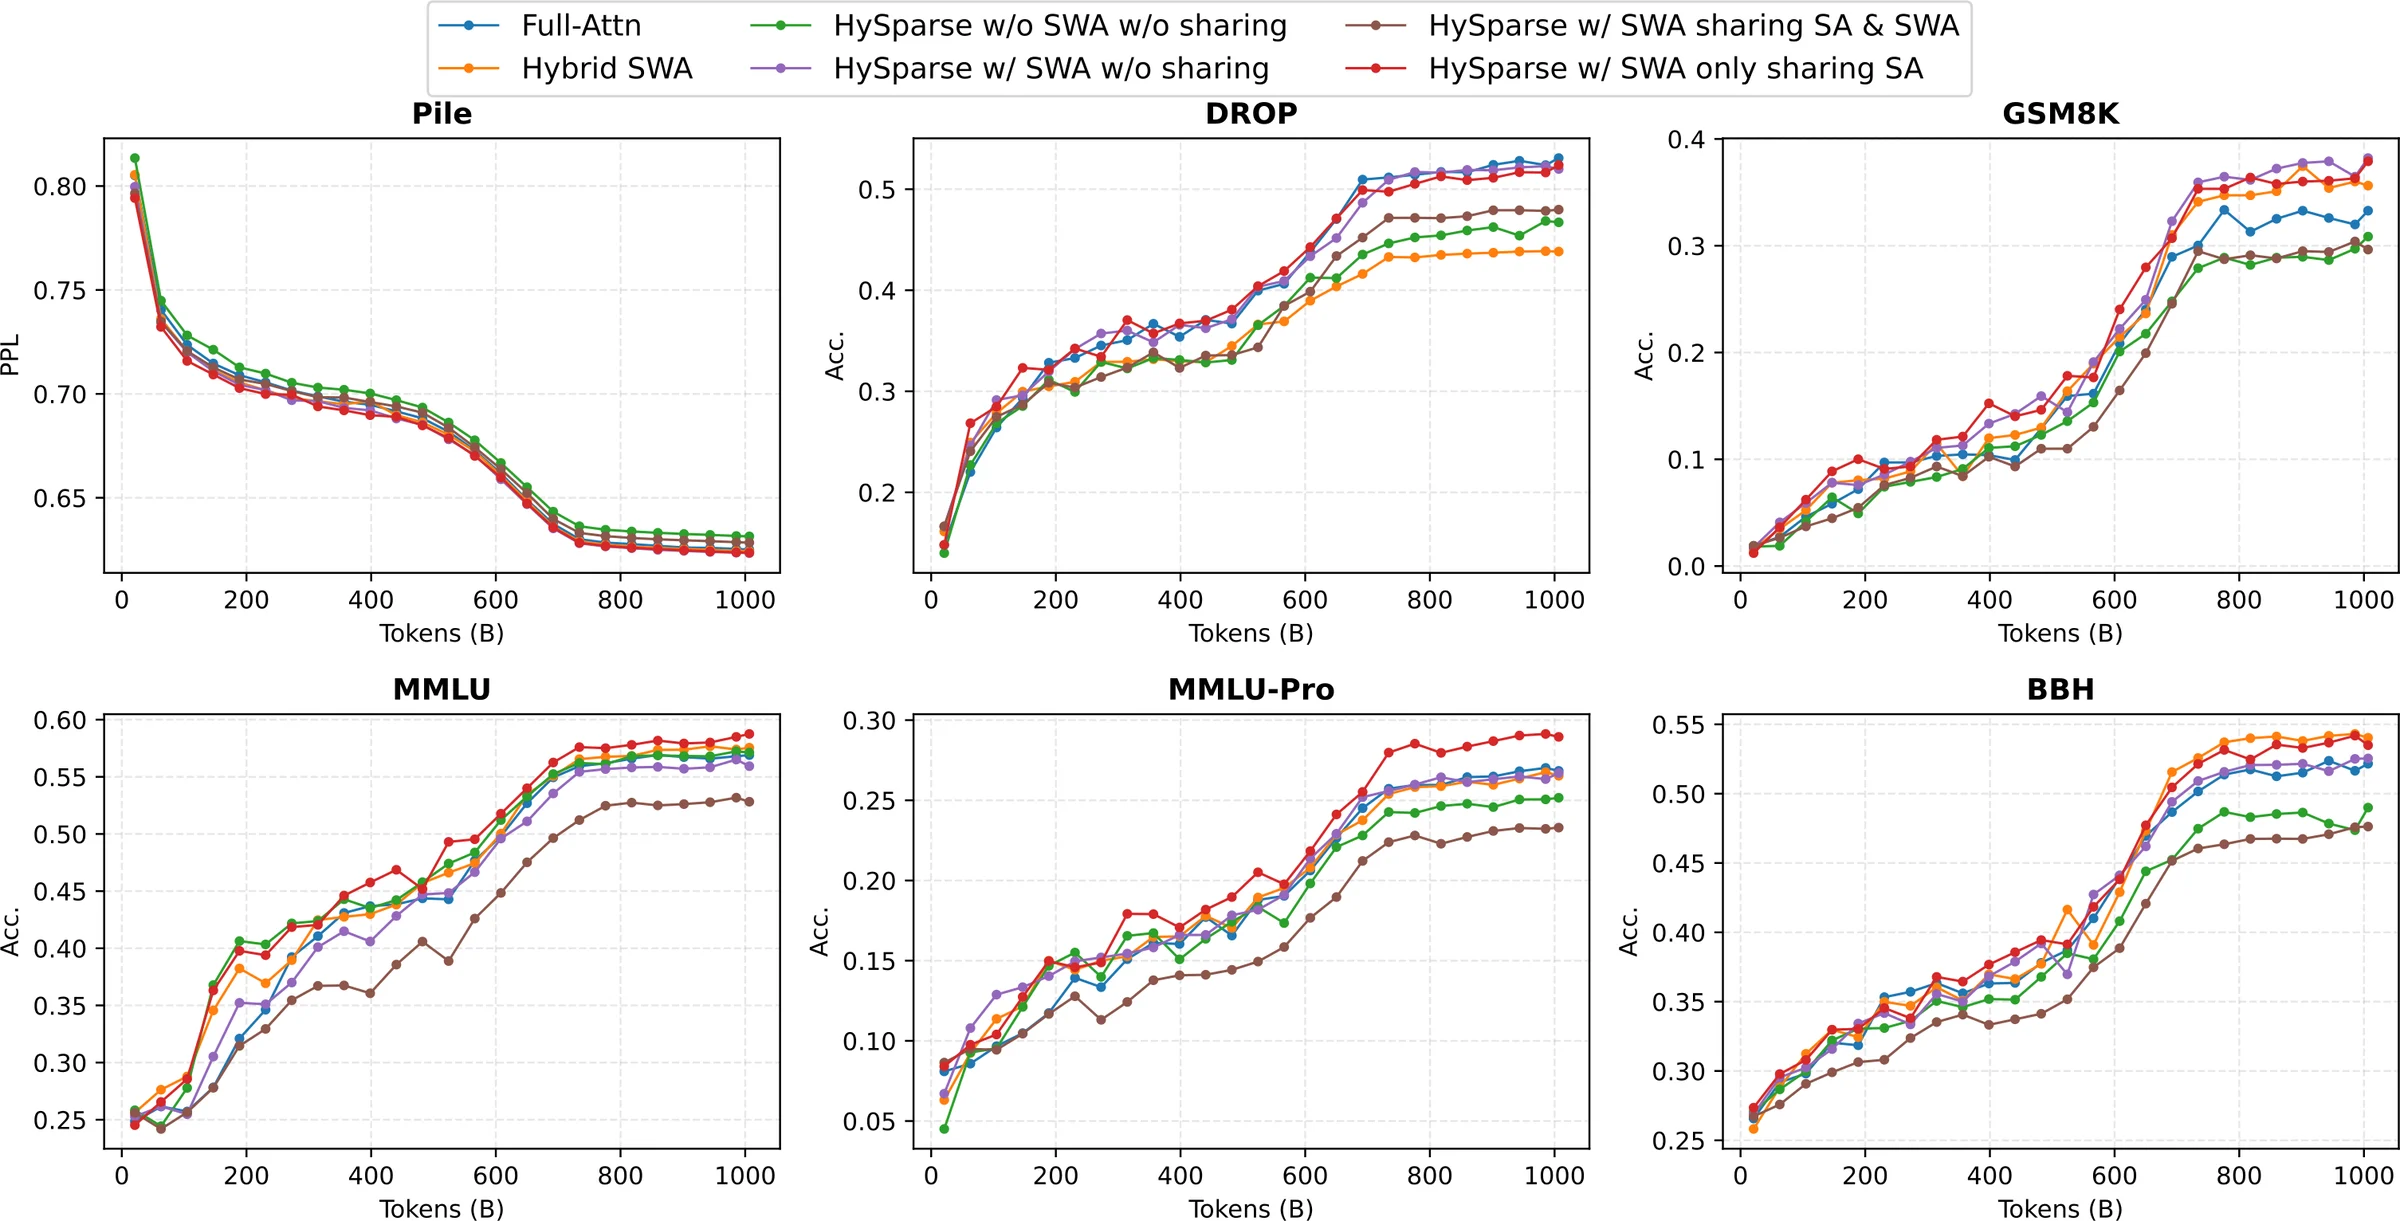
图片来源:HySparse 论文 Figure 2。红线代表最终设计:保留 SWA,且只让块稀疏分支共享 KV;棕线把 SA 与 SWA 都接到共享 KV,在多个任务上持续落后。横轴是已处理 token 数(十亿),本文只把曲线作为架构消融证据,不展开训练过程。
这组结果支持的是一个结构性结论:全局与局部通路需要不同的记忆更新频率。全局 KV 可以跨若干层保持稳定以换取容量,局部 KV 则必须逐层刷新以保留表达力。它并不证明 对所有模型都最优;窗口大小、混合比例与稀疏预算仍需共同选择。
成本模型:计算量、访存量与缓存容量
Prefill:二次项没有消失,只是系数变小
对长度为 的整段输入, 个全注意力层仍各自承担 计算; 个稀疏层中,每个 Query 处理 个全局 token 与 个局部 token,近似为 。忽略投影、FFN/MoE、TopK 和常数项:
与 层全注意力相比,注意力主体计算比例约为:
取 80B 配置 、、、。当 时,第一项约 0.102,第二项约 0.031,总和约 0.133。这个 13.3% 是只计算注意力主体的理想化比例,不是端到端延迟,也没有计入 FFN/MoE、投影、索引排序和不规则 gather。它说明的是:长序列越长,固定稀疏预算的相对收益越明显;短序列下,TopK 与 kernel 启动等固定开销更难摊薄。
Decode:关键收益来自少读 KV
自回归 Decode 的每一步只有一个新 Query。全注意力层读取 个历史 KV,稀疏层读取 个,因此注意力部分近似为:
对长上下文,Decode 通常受 HBM 带宽限制,所以上式也近似描述 KV 读取量。但“读取 个 token”只有在实现能够按块合并访存时才成立。HySparse 用 64-token 连续块,并让 GQA 组共享索引,就是为了把 1024 次潜在的随机 token gather 变成 16 次规则块读取。理论 FLOPs 相同的两种稀疏模式,若一个是连续块、另一个是离散 token,实际速度可能完全不同。
还有三笔容易漏掉的开销
第一笔是分数与索引。论文算法在全注意力 kernel 中输出形状约为 的块分数,再做 TopK。它比 小 倍,却仍随 增长。以 、 为例,每个评分 head 有约 1678 万个元素。工程实现若把完整 写回 HBM,开销不能简单视为零;更激进的实现应考虑在 tile 流中维护候选或分段 TopK,减少中间张量物化。
第二笔是索引元数据。每个 Query、每个 GQA 组需要保存或即时消费 16 个块号。与 KV 本体相比它很小,但会影响 CUDA Graph 的静态形状、分页 KV 的地址翻译和批处理调度。
第三笔是共享缓存的生命周期。一个混合块中的 个稀疏层都依赖前置全注意力层的 KV,服务系统不能像普通逐层流水那样随意回收或迁移它。缓存管理器必须把“生产者层 + 消费者层组”当成一个生命周期单元,否则计算图正确,运行时仍可能读到已经复用的物理页。
可以用 32k Decode 的一次新 token 粗算读取规模。若只数 attention 访问的 token-KV 对,49 层全注意力约读取 份历史位置;HySparse 约读取:
比例约 13.4%。这与前面的 Prefill 理想注意力比例接近,却仍不是 7.5 倍端到端加速承诺:全注意力层的访问更连续,稀疏层还要解析 16 个块地址;两者 kernel 效率不同,模型中 FFN/MoE 与通信也没有计入。
容量收益不等于端到端吞吐收益
HySparse 论文主要证明架构质量与 KV 容量优势,没有给出完整服务系统中的 tokens/s、TTFT、TPOT 或多并发调度结果。因此可以从公式判断它有更低的注意力计算量和缓存占用,却不能仅凭“近 10 倍 KV 缩减”推导“端到端快 10 倍”。端到端收益还取决于:
- 稀疏 kernel 是否真正跳过未选 KV,而不是先 gather 成大临时张量;
- TopK、地址解析和块重排能否与注意力融合;
- FFN 或 MoE 是否已成为新的主瓶颈;
- 更小缓存能否转化成更大 batch,而不是留下未利用显存;
- Prefill 与 Decode 是否采用不同的调度和数据布局。
这一区分很重要:HySparse 首先是一种模型架构,它给系统创造了“可少存、可少读、可少算”的条件;把条件兑现成服务吞吐,还需要 kernel 与运行时共同完成。
与 NSA、DSA、SWA 的边界
HySparse 很容易被概括成“全注意力 + 稀疏注意力 + 滑窗”,但这会掩盖它和其他路线最关键的差异:选择信号从哪里来,哪一份 KV 必须长期保存,以及稀疏性作用在 token 还是模型层。
| 方法 | 全局选择信号 | 稀疏粒度 | 全长 KV 是否逐层保存 | 局部路径 | 核心目标 |
|---|---|---|---|---|---|
| Hybrid SWA | 没有动态选择 | 固定窗口 | 只在少数 Full 层保存 | SWA | 用局部层替换多数全局层 |
| NSA | 压缩分支产生选择分数 | 64-token 块 | 各层保留其分支所需状态 | 独立滑窗分支 | 原生三分支稀疏与硬件对齐 |
| DSA | 轻量 Lightning Indexer | token 级 TopK | 通常仍需完整候选 KV | 依模型设计 | 用可学习索引器做细粒度动态选择 |
| HySparse | 前置 Full 层的真实注意力统计 | 64-token 块 | 全局 KV 按混合块共享 | 每个稀疏层独立 SWA | 同时复用选择与 KV |
相比 Hybrid SWA:同样的容量,多了一条全局细读路径
Hybrid SWA 每隔若干层插入一次全注意力,其余层只看固定窗口。优点是规则、简单、缓存小;缺点是当 Full : SWA 比例推到 1:11 时,大多数层无法直接读取窗口外的信息。HySparse 保留同样的层间骨架,却让每个 SWA 层旁边增加一个块稀疏分支。这条分支不新增全长 KV,所以缓存量仍与同层比的 Hybrid SWA 接近,却能读取由最近全注意力层选出的远程证据。
论文的 RULER 总分能看出这种差异。80B 配置在 32k 上下文下,Full-Attn、Hybrid SWA、HySparse 分别得到 82.1、69.5、87.4;16k 下分别为 93.6、72.7、90.6。这里不能据此宣称稀疏结构普遍胜过全注意力,因为模型架构与评测方差都会影响结果;更稳妥的结论是,纯局部层在激进的 1:11 比例下出现明显能力缺口,而共享全局稀疏分支能大幅补回这一缺口。
| RULER 总分 | Full-Attn | Hybrid SWA | HySparse |
|---|---|---|---|
| 7B,16k | 93.0 | 91.6 | 94.1 |
| 7B,32k | 88.2 | 84.2 | 89.3 |
| 80B,16k | 93.6 | 72.7 | 90.6 |
| 80B,32k | 82.1 | 69.5 | 87.4 |
相比 NSA:选择器从“压缩代理”变成“前层真值”
NSA 原生稀疏注意力用压缩分支建立全局粗视图,再用压缩注意力分数选择 64-token 原始块,另设滑窗分支保留局部细节。它的优势是每个稀疏层都能依据当前 Query 产生自己的动态选择,压缩分支也直接贡献输出;代价是需要维护压缩表示,选择质量受压缩代理限制。
HySparse 把选择时机上移到少数全注意力层。它不需要额外压缩索引器,分数来自真实 full-softmax;随后多个稀疏层共享一次选择,进一步摊薄开销。代价是选择不再逐层更新,且每个混合块仍有一个二次复杂度的全注意力层。两者不是简单的替代关系:NSA 更像“每层都用便宜代理做当前层检索”,HySparse 更像“偶尔做一次昂贵但高质量的全局扫描,让后续层沿用结果”。
相比 DSA:避免额外 Indexer,但牺牲 token 级分辨率
DSA 让轻量索引器预测当前 Query 最需要的历史 token,再只对入选 token 运行主注意力。它把选择做到 token 粒度,检索分辨率高;索引器却需要自己的参数、状态、计算路径与对齐目标,而且动态选择通常仍要求所有候选 KV 可用。
HySparse 没有独立索引器,把全注意力层已经算出的统计量当选择依据,并顺便共享同一层 KV。块级选择让 gather 更规则,却会带来内部浪费:一个块可能只有 1 个关键 token,其余 63 个也要被读取和计算。默认的 正是在索引精度与 GPU 连续访存之间取折中。把 减小会减少无效 token,却增加块号、TopK 和随机访存压力;把 放大则相反。
不要和 HiSparse 混淆
HySparse 的拼写是 “Hy”,指 Hybrid Sparse Attention,是模型架构;2026 年另有一篇名为 HiSparse 的工作,拼写是 “Hi”,研究稀疏注意力服务中的分层 KV Cache 管理,把完整历史放在主存、热点 KV 留在 GPU。前者决定哪些层生产与共享 KV,后者决定已有 KV 在 GPU/CPU 层次中怎样驻留。二者可以讨论组合,但不是同一个系统,也没有论文给出二者组合后的实测结论。
工程实现中的关键约束
1. 它不是现成模型的无损插件
后续层用自己的 Query 查询前层 KV,会改变注意力的数据依赖。一个普通 Transformer 的第 层原本使用 ;直接替换成 后,即便选择集合包含全部 token,输出也不再等于原模型。因此,HySparse 是需要在模型架构阶段采用的方案,不是像 PagedAttention 那样只改服务运行时,也不是给任意 checkpoint 换一个 kernel 就能保持输出不变。
2. 块索引必须与物理 KV 布局对齐
论文的逻辑块大小是 64 token。真实服务框架可能用 16、32 或其他大小的 KV page。若一个 HySparse 逻辑块跨越多个不连续物理页,kernel 就需要额外页表查询;若直接强制 page size 等于 64,又可能增加尾部碎片并影响普通请求。较合理的接口是让稀疏索引保存逻辑 token 区间,由块表把它翻译成一组物理页片段,并在 kernel 中完成合并读取。相关的分页原理可参考 PagedAttention 完全拆解。
3. Prefill 与 Decode 不该共用一套朴素实现
Prefill 同时处理大量 Query,适合把相同稀疏模式的行分组,形成 block-sparse GEMM/attention;Decode 每步 Query 很少,瓶颈更接近索引解析与 KV 带宽。若实现先按索引把 KV 复制到连续临时缓冲,再调用普通 attention,可能在 Decode 中多付一次读写,吞掉稀疏收益。更理想的 kernel 应直接消费块表,在加载 KV tile 时完成地址解析,并让同一 GQA 组复用已进入共享内存或寄存器的数据。
4. 因果掩码必须细化到块内
Prefill 时,一个 64-token 块可能与当前 Query 所在位置相交。TopK 选中这个块不代表块内所有 token 都可见;晚于 Query 的位置仍必须被因果 mask 屏蔽。最后一个不满 64 token 的尾块也需要长度 mask。只在块级判断“选中/未选中”而忽略块内边界,会造成未来信息泄漏。
5. RoPE 与跨层共享并不冲突,但位置约定必须一致
共享的 已在原位置应用 RoPE,后续层的 也在当前位置应用同一套旋转规则。点积仍表达相对位置信息。真正的约束是共享双方必须使用兼容的 head dimension、KV head 分组、RoPE base 与缩放方式;若不同层采用不同的频率缩放或部分旋转维度,同一份 Key 就无法被直接复用。
6. 分数不必永久保存,索引却要被一组层稳定消费
全注意力层输出块分数 后,TopK 一旦完成,后续层只需要索引 ,无需长期保留全部 。运行时可以尽早释放分数缓冲区。相反, 要在 个稀疏层之间保持一致,批内请求发生完成、抢占或重排时,索引必须和对应序列的共享 KV 页一起迁移,不能只按 layer id 查一块全局数组。
7. “最后一层全注意力”是质量保险,不是缓存优化
论文两种配置都让最终层使用全注意力。这样最终隐藏状态能再次聚合完整上下文,缓解最后一个稀疏组遗漏证据的风险。但最后一层仍需自己的全长 KV,也会增加一次完整扫描。若为了极致延迟删掉它,已经超出论文验证范围;若保留它,成本模型中的 必须把它计入,不能只按周期性的 1: 机械取整。
8. 共享距离决定故障模式
当一段上下文的关键证据在后续层才变得显著,而前置全注意力层没有把其所在块排进 TopK,这组稀疏层就无法通过全局分支访问它。局部窗口只能补救最近位置,无法补救远处漏选。可行的系统级观察指标包括:相邻层 TopK 重合率、Oracle 选块对后续层高权重块的召回率、不同上下文长度下的漏选率,以及门控对全局分支的使用分布。只看最终 benchmark 分数,很难定位问题究竟来自索引过时、块粒度过粗,还是共享 KV 表示不合适。
本篇小结与下一篇预告
HySparse 的核心不是单独的一种稀疏模式,而是一份被跨层复用的“全局检查点”。全注意力层完成三项工作:计算本层输出、生成块级选择信号、保存供后续层共享的全局 KV。稀疏层则用当前 Query 对共享 KV 中的 16 个关键块重新计算注意力,同时维护一个 128-token 的独立局部窗口,最后用两个 sigmoid gate 融合。
这套结构把两条已有经验接到了一起:相邻层的显著 token 往往稳定,所以索引可以跨层复用;相邻层的 KV 表示存在冗余,所以全局缓存也可以跨层共享。它由此绕开了动态稀疏注意力“计算少了、缓存没少”的常见困境。49 层模型只有 5 层保存全长 KV,长上下文下容量极限约为全注意力的 ;其余层仍能通过共享 KV 访问远程证据,而不是退化成纯滑窗。
边界同样清晰:Oracle 只对前置层自身精确,对后续层仍是近似;全注意力二次项只是按层数缩小,没有彻底消失;论文也没有给出完整服务栈的端到端吞吐结果。HySparse 提供的是一个有利于推理的模型数据流,性能兑现仍取决于 score/TopK 融合、块稀疏 kernel、分页地址解析和批调度。
下一篇将沿实现路径继续:拆解 modified FlashAttention 如何边算 full attention 边产出块分数,分析 block-sparse gather 在 Prefill 与 Decode 中的不同 kernel 组织,再结合完整消融和 HySparse2 的两级 KV Sharing,判断这条路线如何从模型结构走向百万上下文服务。
参考资料
- HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models
- Reducing Transformer Key-Value Cache Size with Cross-Layer Attention
- You Only Cache Once: Decoder-Decoder Architectures for Language Models
- Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free
- TidalDecode: Fast and Accurate LLM Decoding with Position Persistent Sparse Attention
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


