


YOCO 完全拆解:Decoder-Decoder 架构如何让 KV Cache 只存一次
为什么逐层缓存会成为长上下文瓶颈
自回归模型每生成一个 token,都要让当前 Query 看见此前所有 token。标准 decoder-only Transformer 不会重新计算历史 token 的 Key 和 Value,而是把每一层已经得到的 K/V 留在显存里;下一步只计算新 token 的 K/V,再把它们追加到缓存。这正是 KV Cache 能把逐 token 解码从反复重算历史变成增量计算的原因,却也制造了一个随“序列长度 × 层数”同步增长的状态。
设批大小为 ,上下文长度为 ,注意力层数为 ,每层有 个 KV 头,每个头的维度为 ,每个元素占 字节。忽略页表与对齐碎片,一份标准 KV Cache 大约需要:
系数 2 来自 Key 和 Value 两组张量。以 BF16 为例,;GQA 可以通过减小 压低常数,却没有消掉 与 的乘积。也就是说,窗口扩到原来的 32 倍,或者并发批量增大 32 倍,KV 占用同样会增大 32 倍。至于分页、写时复制和前缀复用,它们解决的是分配碎片与重复存储,并不会改变“每个有效 token 在每个注意力层都有一份 K/V”这个架构事实。内存管理层面的办法可参考 PagedAttention 完全拆解,按头共享的办法可参考 GQA 完全拆解。
微软研究院与清华大学团队在 2024 年提出 YOCO(You Only Cache Once),论文入选 NeurIPS 2024。它没有继续压缩每一层的缓存,而是改写模型的数据依赖:模型下半段先把历史压成一组全局 K/V,上半段所有层都查询同一组 K/V。于是“逐层缓存”变成“全局缓存一次”。这是模型架构变化,不是给既有 Transformer 外挂一个缓存算法。
“只缓存一次”也需要准确理解。YOCO 的 Self-Decoder 仍要保留滑动窗口 K/V 或门控保留状态,只是这部分状态不随总上下文无限增长;真正长度为 的全局 K/V 只有一份。论文将总缓存复杂度写成:
这里 是固定窗口或等价的有界状态尺度, 是隐藏维度。当 时,主导项近似为 ;标准 Transformer 则是 。YOCO 的名字描述的是这一个长序列主导项,而不是声称整个推理过程只保存一块张量。
论文给出的动机数字很直接:一个采用 GQA 和 8-bit KV 的 65B 模型,512K token 的缓存约占 86 GB,已经超过单张 H100 80GB 的容量。另一边,长 Prompt 的 Prefill 还要执行多层全局注意力;论文基线中,带 Flash-Decoding 与 kernel fusion 的 7B 模型在四张 H100 上处理 450K 和 1M 输入,分别约需 110 秒和 380 秒。YOCO 同时瞄准了两件事:让全局缓存不再乘层数,并让 Prompt 不必经过后半段 Cross-Decoder。
YOCO 的总架构:两个 Decoder,各司其职
YOCO 仍然从 token embedding 开始,仍然用因果掩码预测下一个 token,外部接口也仍是自回归语言模型。变化发生在内部:总共 个 block 被近似均分成前后两段,前 层组成 Self-Decoder,后 层组成 Cross-Decoder。
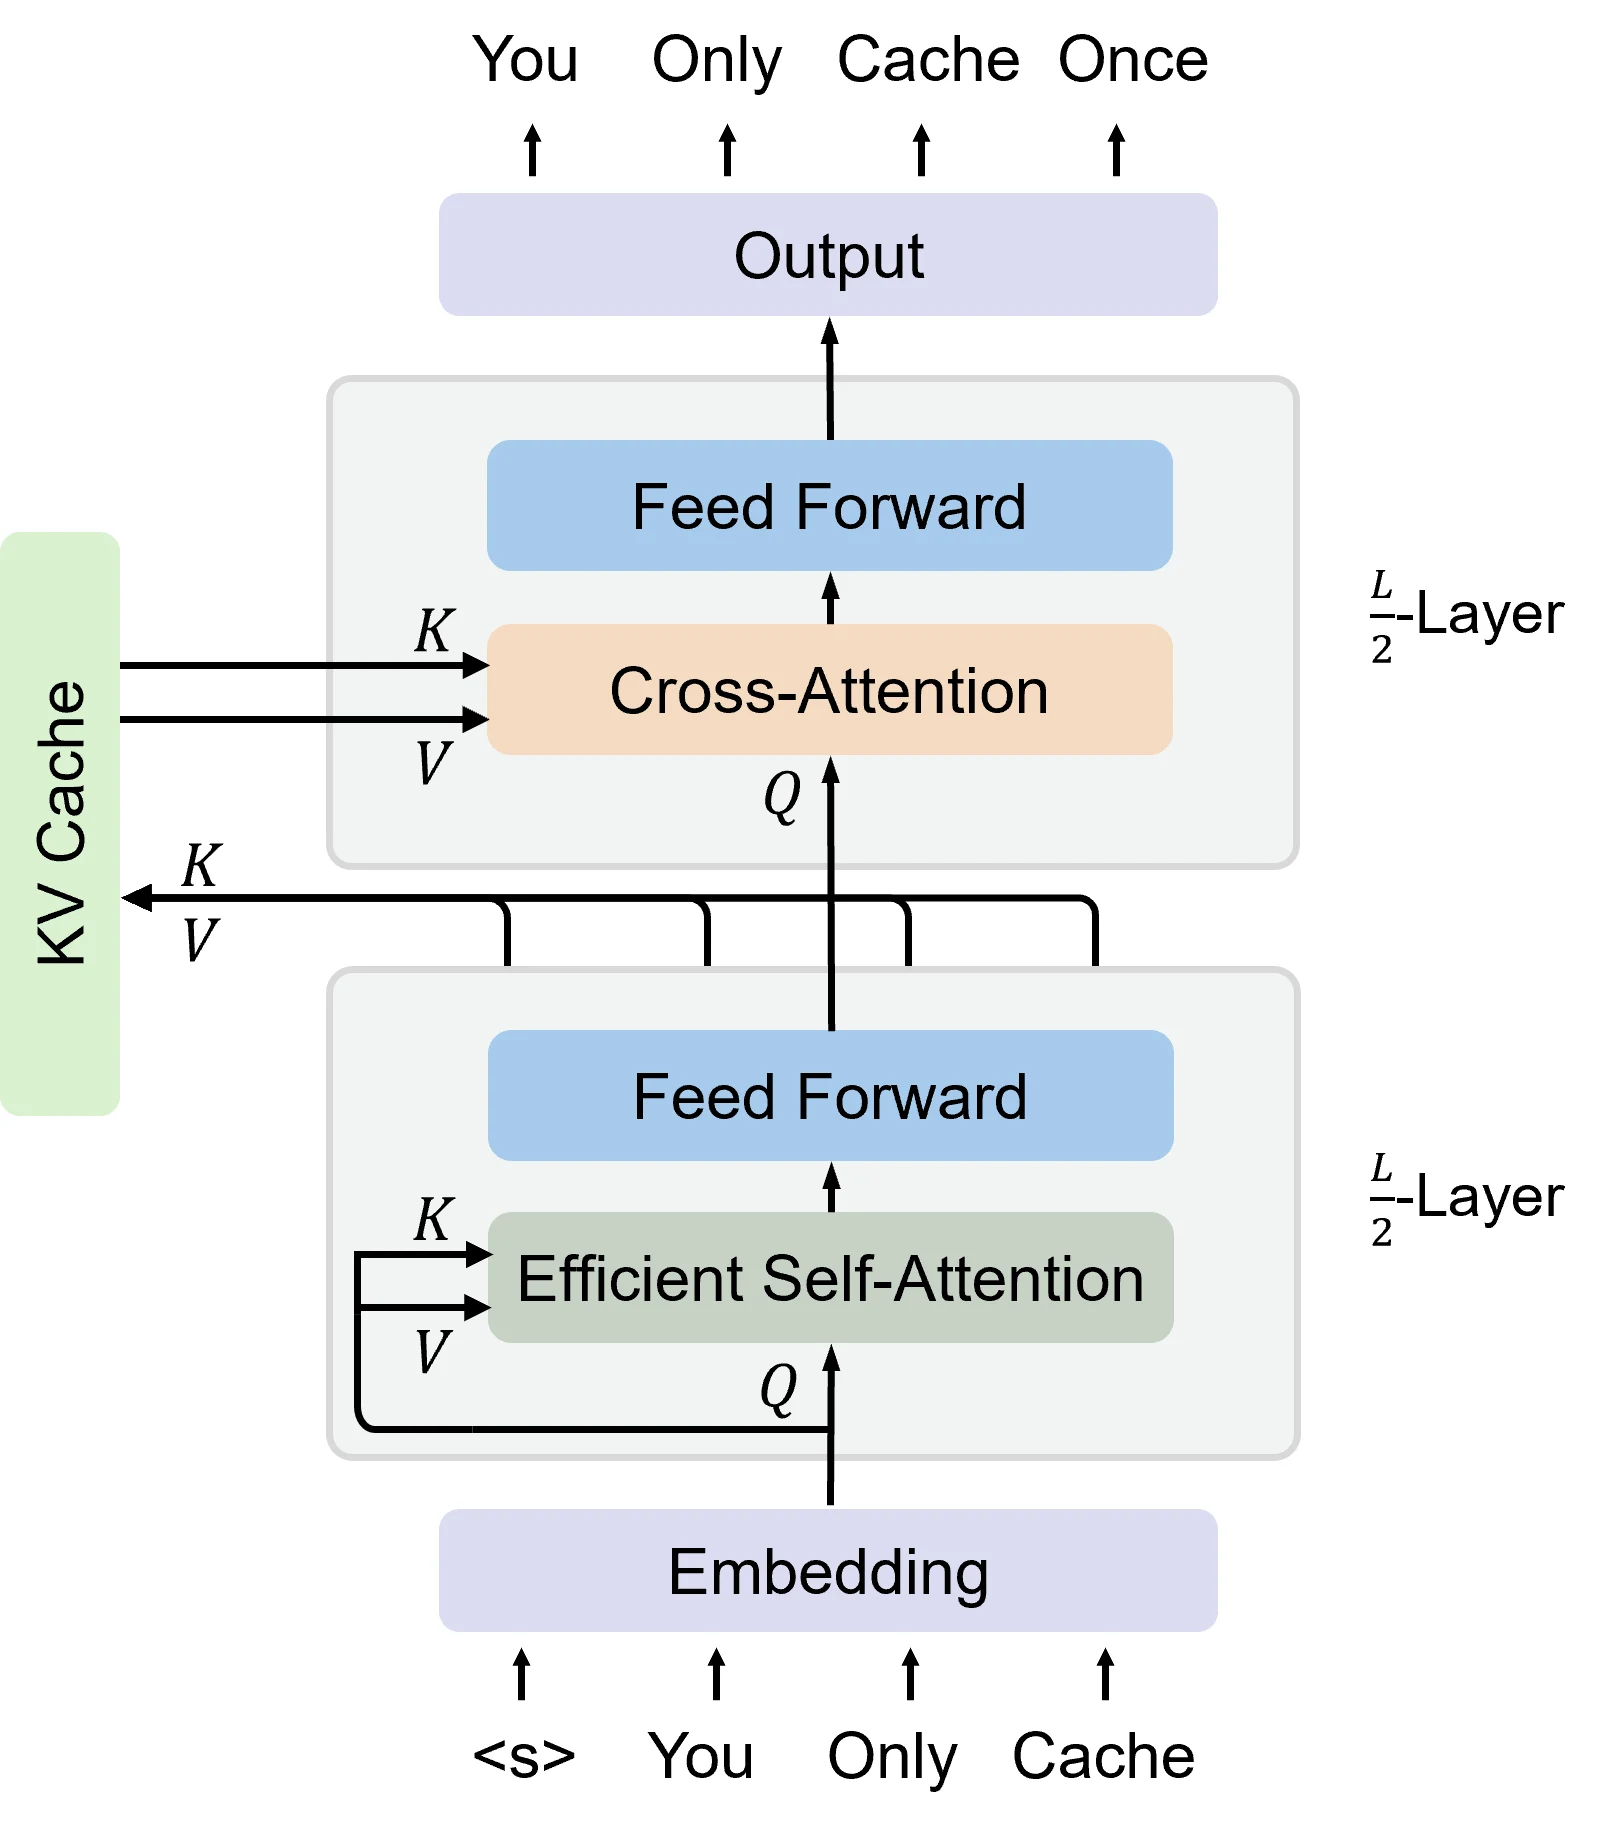
YOCO 的 Self-Decoder 用高效因果注意力加工序列,并在边界处生成一份全局 KV Cache;所有 Cross-Decoder 层只生成自己的 Query,共享读取这份 K/V。图源:YOCO 论文 Figure 2。
给定长度为 的输入 embedding:
Self-Decoder 逐层计算:
表示 Efficient Self-Attention,可以是滑动窗口注意力,也可以是论文默认采用的 Multi-Head Gated Retention。残差连接、Pre-Norm 和 SwiGLU 与现代 Transformer block 的习惯一致,关键限制只有一个:ESA 在增量推理时必须只需要有界状态,不能又为每一层保留长度为 的全局 K/V。
Self-Decoder 的最终输出记为中间记忆 。边界处仅执行一次 K/V 投影:
与 都覆盖完整因果上下文,因而承担长期记忆。进入 Cross-Decoder 后,第 层只用自己的隐藏状态产生 Query:
每层的 不同,所以不同深度仍能以不同查询方式读取历史;被共享的是历史的 K/V 表示,不是整层注意力输出。Cross-Decoder 的隐藏状态会在残差流和 FFN 中继续变化,下一层得到的 Query 也随之变化。把共享 KV 理解成一座固定资料库、把每层 Query 理解成逐步改写的检索请求,比“所有层做了同一次注意力”更准确。
它与传统 encoder-decoder 还有三点本质区别:
- Self-Decoder 与 Cross-Decoder 都使用因果掩码,位置 不能读取未来位置;传统文本 encoder 通常是双向的。
- 两段共同服务同一条自回归序列,不存在“源语言输入”和“目标语言输出”两套 token 流。
- 新生成 token 依次经过两段,最终 logits 使用了完整模型深度;只有已经给定的 Prompt 能利用后文所述的提前退出。
因此,Decoder-Decoder 不是把 T5 式 encoder-decoder 换了名字。它保留 decoder-only 模型的自回归语义,却人为制造了一个清晰的记忆接口:前半段负责“写一次”,后半段负责“读多次”。
Self-Decoder:用有界状态加工上下文
Self-Decoder 要完成一项看似矛盾的工作:一方面,它必须让边界表示 包含足够的上下文信息,以便后半段建立全局记忆;另一方面,它自己不能像标准 Transformer 那样在每层积累无限增长的 KV Cache。YOCO 给出两种实现,分别对应“保留最近局部细节”和“把远历史折叠进递归状态”。
路线一:滑动窗口注意力
滑动窗口注意力只允许位置 看见最近 个位置:
其中因果窗口掩码 为:
解码到第 个 token 时,每个 Self-Decoder 层只保留区间 的 K/V,旧位置可以环形覆盖,所以状态从 变成 。论文的缩放实验把窗口设为 1024。它的长处是保留 softmax 注意力熟悉的归一化与精确局部匹配,kernel 也容易由局部版 FlashAttention 实现;短处是单层看不到窗口以外的位置。
“局部窗口会不会使模型失去全局上下文”是理解 YOCO 的关键问题。答案分两层:Self-Decoder 堆叠会扩大有效感受野,但这还不是完整答案;更重要的是,它在边界处为所有历史 token 都生成一个向量 ,并把所有 投影成全局 。Cross-Decoder 的每个生成位置可以对这份全长记忆做因果全局注意力。局部混合负责把邻域加工好,全局读取则被集中到后半段。
路线二:Multi-Head Gated Retention
论文默认采用 Gated Retention(gRet)。它继承 RetNet 将注意力写成递推状态的思路,并让遗忘率由当前数据决定。对一个 head,在第 个位置先计算 以及门值 :
是可学习投影, 是温度;论文解释,温度用于让 更倾向于接近 1,从而避免状态过快遗忘。状态与输出递推为:
是当前 head 的矩阵状态, 把新 token 的键值外积写入状态; 则把旧状态整体衰减。把递推式展开,可以看到任意历史位置 对位置 的贡献:
括号中的连乘是从 到 的存活系数。若途中门值都接近 1,这段信息长期保留;若某些位置给出较小门值,之前的信息会被快速淡化。它不是“只记最后几个 token”,而是把任意长度历史压入固定形状的充分统计量。状态大小依赖 head 维度而不依赖 ,因此增量解码是 状态。
YOCO 采用 head-wise 而不是 element-wise 的衰减门。同一 head 内共享一个标量衰减看起来表达力较弱,却能让 和外积更新保持规则矩阵形状,更容易利用 Tensor Core;若每个状态元素都有不同门控,算子会变得碎片化,实际硬件效率可能抵消理论收益。
多头输出还要经过逐 head 归一化与输出门:
GroupNorm 防止不同 head 的状态尺度漂移, 再按元素控制哪些通道写回残差流。这里的门与 分工不同: 管历史状态保留多久,输出门管当前 block 向残差流暴露哪些特征。
Prefill 与 Decode 为什么使用两种计算形态
递推形式适合一次一个 token 的 Decode,却不适合长 Prompt:若真的在 GPU 上循环 100 万次,状态虽省,串行依赖仍会让 Prefill 很慢。gRet 因而还提供等价的分块形式。块内一次性计算并行 retention,块间只传递末端状态 :
表示第 块内部所有位置之间的贡献, 表示此前块压缩状态对当前块的贡献。官方评测的 Prefill chunk size 为 256;生成阶段则切回递推形式,只更新 。这不是近似:在相同数值精度下,并行、递推和分块递推是同一公式的不同结合顺序。工程上选择不同形态,是为了让 Prefill 吃到矩阵并行、Decode 避免保存长序列。
可以用一个块的边界状态证明这种等价性。设第 块从位置 到 ,块内第 个位置的累计衰减为:
从上一块传来的状态记为 。块内位置 的状态可拆成两项:
第一项只依赖块入口状态,可以让整块所有 Query 一次性与 相乘;第二项只涉及块内的三角因果矩阵,可以用常规矩阵乘并行计算。到块末尾,再把两项合并成 传给下一块。这样,跨块方向仍有顺序依赖,但顺序步数从 降到约 ,每个块内部的 个位置则并行展开。
分块大小 因而是硬件旋钮,不是模型语义参数。 太小,跨块循环次数多,GPU 启动与同步开销占比上升; 太大,块内三角矩阵和临时张量膨胀,片上空间与访存压力增加。论文实现选 256 是对应其 Triton kernel 与 H100 评测的工程点,迁移到其他 head 维度、精度或加速器时应重新测量,而不应把 256 当作公式要求。
两条 Self-Decoder 路线的差异可以压缩成一张表:
| 方案 | 每层增量状态 | 远历史表示 | 主要优势 | 主要代价 |
|---|---|---|---|---|
| 滑动窗口注意力 | 最近 个 token 的 K/V | 超窗信息只能经层叠表示间接传播 | softmax 语义直观,局部匹配精确 | 窗口状态仍乘 Self-Decoder 层数 |
| Gated Retention | 固定形状矩阵 | 数据门控衰减后的递归摘要 | 状态与序列长度无关,Prefill 可分块 | 需要专用 kernel,历史被压缩而非逐 token 保留 |
两者都满足 YOCO 的架构契约:Self-Decoder 只维护有界状态,并在中间边界产出一份可供全局查询的完整 KV。
Cross-Decoder:一份全局 KV 如何服务所有层
Cross-Decoder 的名字容易让人误以为它在查询另一条序列。实际上,Query 和共享 K/V 都来自同一条序列,只是处于不同深度:Query 来自后半段正在演化的残差流,K/V 来自 Self-Decoder 边界。两者做标准缩放点积注意力:
仍把未来位置屏蔽为 。即使整段 Prompt 已经生成了 ,位置 也只能看 的记忆,因而不会泄漏未来 token。每个 Cross-Decoder block 仍有自己的 Query 投影、输出投影、RMSNorm、FFN 和残差连接;共享仅发生在 。
这产生了一种不对称但很有用的参数安排:
- 写入端只有一套 ,决定全局记忆以什么坐标保存;
- 读取端每层都有独立 ,决定这一层提出什么问题;
- 读取结果进入不同深度的 FFN,逐层变换后再形成下一次查询。
标准 Transformer 每层既重新“写历史”,又重新“读历史”。YOCO 把写入统一到一个接口,把模型深度更多地用于迭代读取与变换。显存收益来自写入结果不再复制 份,而表达能力则主要依赖多层 Query 和非线性残差流保留。
增量生成时究竟追加什么
假设 Prompt 长度为 ,现在生成第 个 token。它先经过每一个 Self-Decoder block:滑窗版本向每层环形缓冲追加一组局部 K/V,gRet 版本更新每层的 。到达中间边界后,只为这个新 token 计算一次:
然后把它们追加到唯一的全局缓存。后半段每层生成各自的 ,对 和对应 Value 做注意力。新 token 仍完整穿过全部 层,因此 YOCO 没有用“少跑一半网络”换取 Decode 质量。
如果 Cross-Decoder 使用 GQA,缓存形状还可以从 Query 头数 解耦为更小的 KV 头数 。以论文 3B 配置为例,Query 有 24 个头,KV 只有 8 个头;三个 Query 头共享一组 K/V。于是 YOCO 与 GQA 的收益相乘:GQA 在头维上少存,YOCO 在层维上少存。
共享为何可能成立,又会损失什么
跨层 K/V 并非天然等价。标准 Transformer 的第 2 层与第 30 层面对的是不同抽象层级的隐藏状态,各自投影的 K/V 理论上可以编码不同关系。YOCO 主动施加一个信息瓶颈:所有后半层必须从同一份中间记忆中取信息。它之所以不等同于把层“复制粘贴”,是因为后半层保留了独立 Query 与 FFN;它之所以仍可能有损,则是因为共享 K/V 无法为每个深度重新编码整段历史。
论文用从 160M 到 13B 的等参数缩放曲线验证这种瓶颈没有破坏总体可扩展性:YOCO 与采用 Llama 式 RMSNorm、SwiGLU 的 Transformer 基线相当,gRet 版本优于论文中的 SWA 版本。这个结果只说明论文设置下质量—效率折中可行,不能推出任意已训练 Transformer 都能无损改成 YOCO。因为 K/V 共享位置、Self-Decoder 的 mixer 与后半段读取方式都改变了,YOCO 必须作为原生架构获得相匹配的参数;它不是推理时对普通模型做一次配置开关。
Prefill 提前退出为什么不改变输出
YOCO 最容易被误解的卖点不是缓存,而是 Prefill early exit。它不是在 Prompt 上少算一些层后接受近似结果,也不是动态判断“这段输入比较简单”。它利用的是计算图中的严格依赖:Cross-Decoder 的历史位置输出既不参与共享 KV 的构造,也不会成为未来 token 的 Self-Decoder 输入,因此没有必要为每个 Prompt 位置生成这些输出。
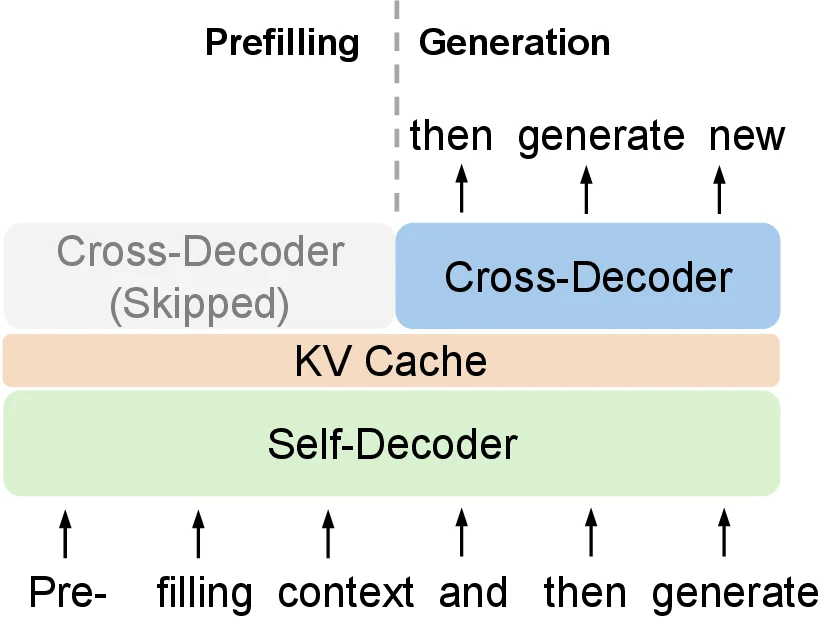
Prefill 批量运行 Self-Decoder 并建立共享 KV,Cross-Decoder 的大块 Prompt 计算被跳过;Generation 中每个新 token 仍经过两段。图源:YOCO 论文 Figure 3。
用函数依赖可以看得更清楚。先令:
是完整 Self-Decoder, 是边界 K/V 投影。第 个 Cross-Decoder block 对位置 的更新可抽象为:
要预测 Prompt 后的第一个 token,只需要最后一个 Prompt 位置的最终状态 。由于 在序列位置之间唯一的交互来自固定的 ,计算 不需要先得到 。所以执行流程可以变成:
- Self-Decoder 并行处理整个 Prompt,生成 与完整共享 。
- 丢弃“让所有 Prompt 位置穿过 Cross-Decoder”的任务,只把预测前沿所需的位置送过后半段,得到第一个 next-token logits。
- 此后每个新 token 都先更新 Self-Decoder 的有界状态与全局缓存,再完整经过 Cross-Decoder 生成 logits。
为什么标准 Transformer 不能照做?在第 层,历史位置输出会被投影成第 层需要的 K/V。若跳过 Prompt 在第 层的计算,就无法得到下一层的历史缓存,依赖链会断裂。YOCO 则把未来所有 Cross-Decoder 层需要的历史 K/V 提前固定在中间边界,后半段不再逐层写历史,只逐层读同一份历史。
从复杂度看,标准全局注意力的 Prompt attention 主项是:
YOCO 的 gRet Self-Decoder 采用分块递推,主项随 线性增长;Cross-Decoder 只对前沿 Query 读取全局 K/V,而不为全部 个 Prompt Query 形成 注意力矩阵,所以论文将 attention Prefill 主项写为:
这里讨论的是注意力主项,不意味着整个模型的所有操作都没有 :QKV 投影和 FFN 仍有逐 token 的稠密线性层成本。所谓线性 Prefill,是相对于序列长度 而言。
提前退出还有一个经常被忽略的边界:它加速的是已有 Prompt 的 Prefill,不会让每个输出 token 只跑半个模型。若生成长度远大于输入长度,端到端收益会更多取决于 Decode 的 KV 读取量与可承载 batch;若输入是 512K 文档而只生成短答案,跳过后半段对整段 Prompt 的计算就会成为主要收益。
复杂度、显存与性能数据
YOCO 论文的推理对比使用 3B 配置,序列长度从 32K 扩到 1M,设定最后 1024 个 token 为生成结果,其余为输入上下文,硬件为 H100 80GB。Transformer 基线不是朴素实现:它使用 GQA、Flash-Decoding 和 kernel fusion;YOCO 的 gRet Prefill 使用 chunk size 256 的 Triton kernel,Decode 使用递推实现。理解这些口径很重要,因为曲线同时反映架构、kernel 和可用 batch,并不是只替换一个 Python 模块所得的通用倍数。
用 3B 配置手算一遍
论文 3B 模型有 26 层,隐藏维度 3072,24 个 Query 头、8 个 KV 头,因此每个 Cross-Attention head 的维度是 。若标准 26 层 GQA Transformer 用 BF16 保存缓存,单 token、单请求的理论 KV 字节数为:
YOCO 的全局缓存只做一份同样的 8-head 投影:
因此,仅比较随上下文增长的 global KV 主项,恰好是 26 倍差距。32K 上下文对应约 3.25GiB 对 128MiB,1M 上下文则约为 101.6GiB 对 3.9GiB。这里还没有加入 gRet 的固定状态:13 个 Self 层、24 个 head、每个 状态,若按 BF16 粗算约为 9.75MiB/请求。它在 32K 已明显小于 global cache,在 1M 更接近可忽略常数,但高并发时仍要计入调度预算。
这次手算也解释了“约省 倍”为什么不是永远等于总层数。若比较对象的层数、KV 头数、精度或 Self/Cross 切分改变,比例也会改变;如果采用 SWA,固定项还会变成每个 Self 层的 个 K/V。论文 Figure 7 中 65B 配置达到 80 倍,来自该配置更深的层数,而不是 YOCO 对大模型使用了另一种压缩公式。
容量减少也不等于每步只从 HBM 读 4KiB/token。13 个 Cross 层都会读取同一份 4KiB/token 全局缓存,层与层之间还隔着输出投影和 FFN;若缓存无法长期驻留片上,它可能被反复从 HBM 取回。YOCO 消除了 26 份物理存储,并把全局扫描集中到后半层,但不会自动把 13 次逻辑读取合并成一次。这正是容量复杂度和带宽复杂度必须分开分析的原因。
总显存:权重不变,缓存斜率改变
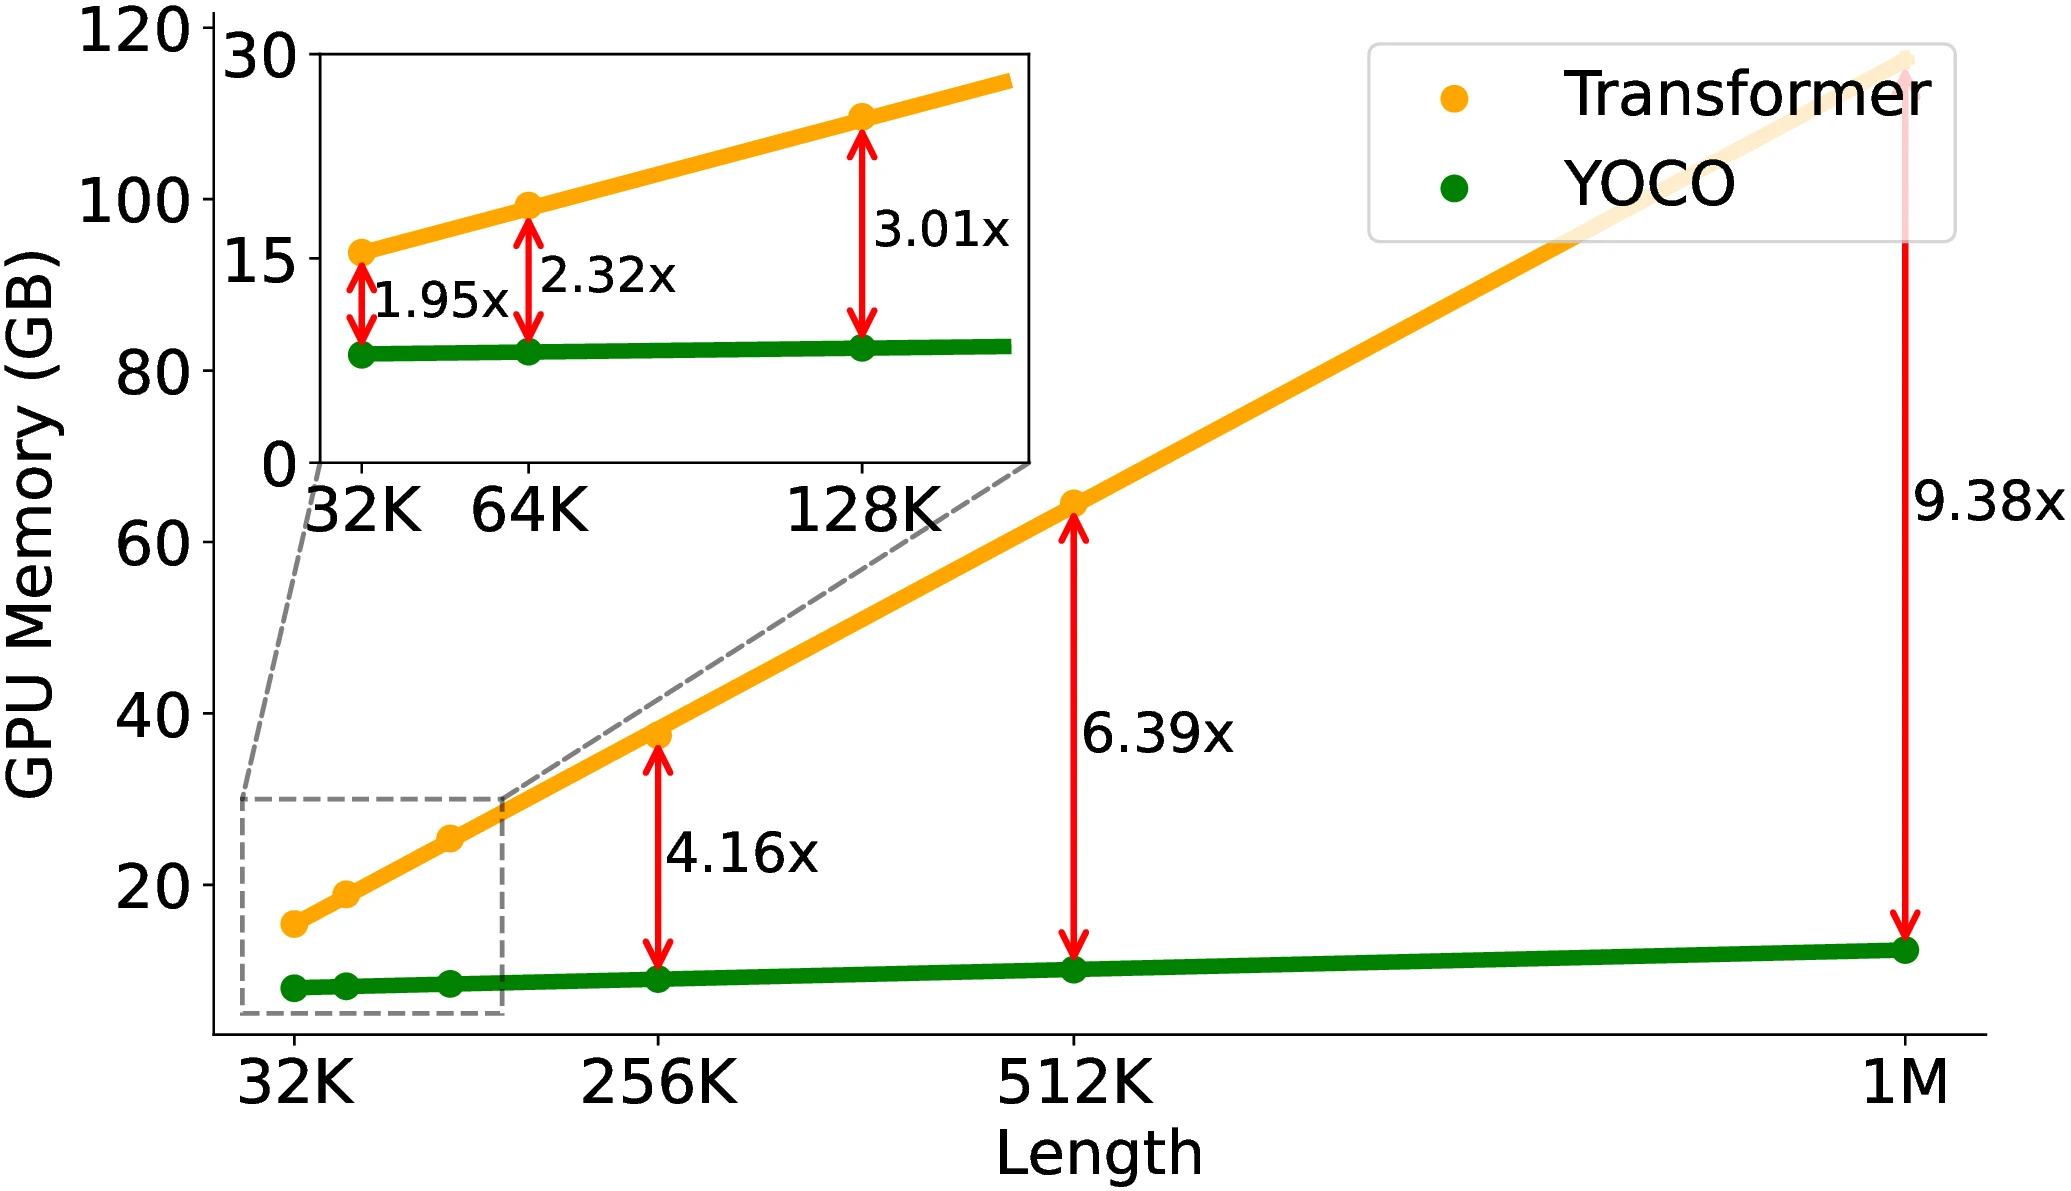
3B 配置的总推理显存。32K 时 YOCO 约省 1.95 倍,1M 时差距扩大到 9.38 倍;YOCO 在 1M 时为 12.4GB。图源:YOCO 论文 Figure 6。
32K 时,模型权重和中间激活仍占显著比例,因此理论上的缓存缩减不会等比例变成总显存缩减,图中只有约 1.95 倍。上下文继续增长后,Transformer 的逐层 KV 成为主导,YOCO 曲线则只缓慢上升;到 1M,论文报告 YOCO 总占用 12.4GB,Transformer 是其 9.38 倍。这个趋势比单个倍数更重要:YOCO 改变的是长上下文下显存增长的斜率。
每 token 缓存:模型越深,层共享越值钱
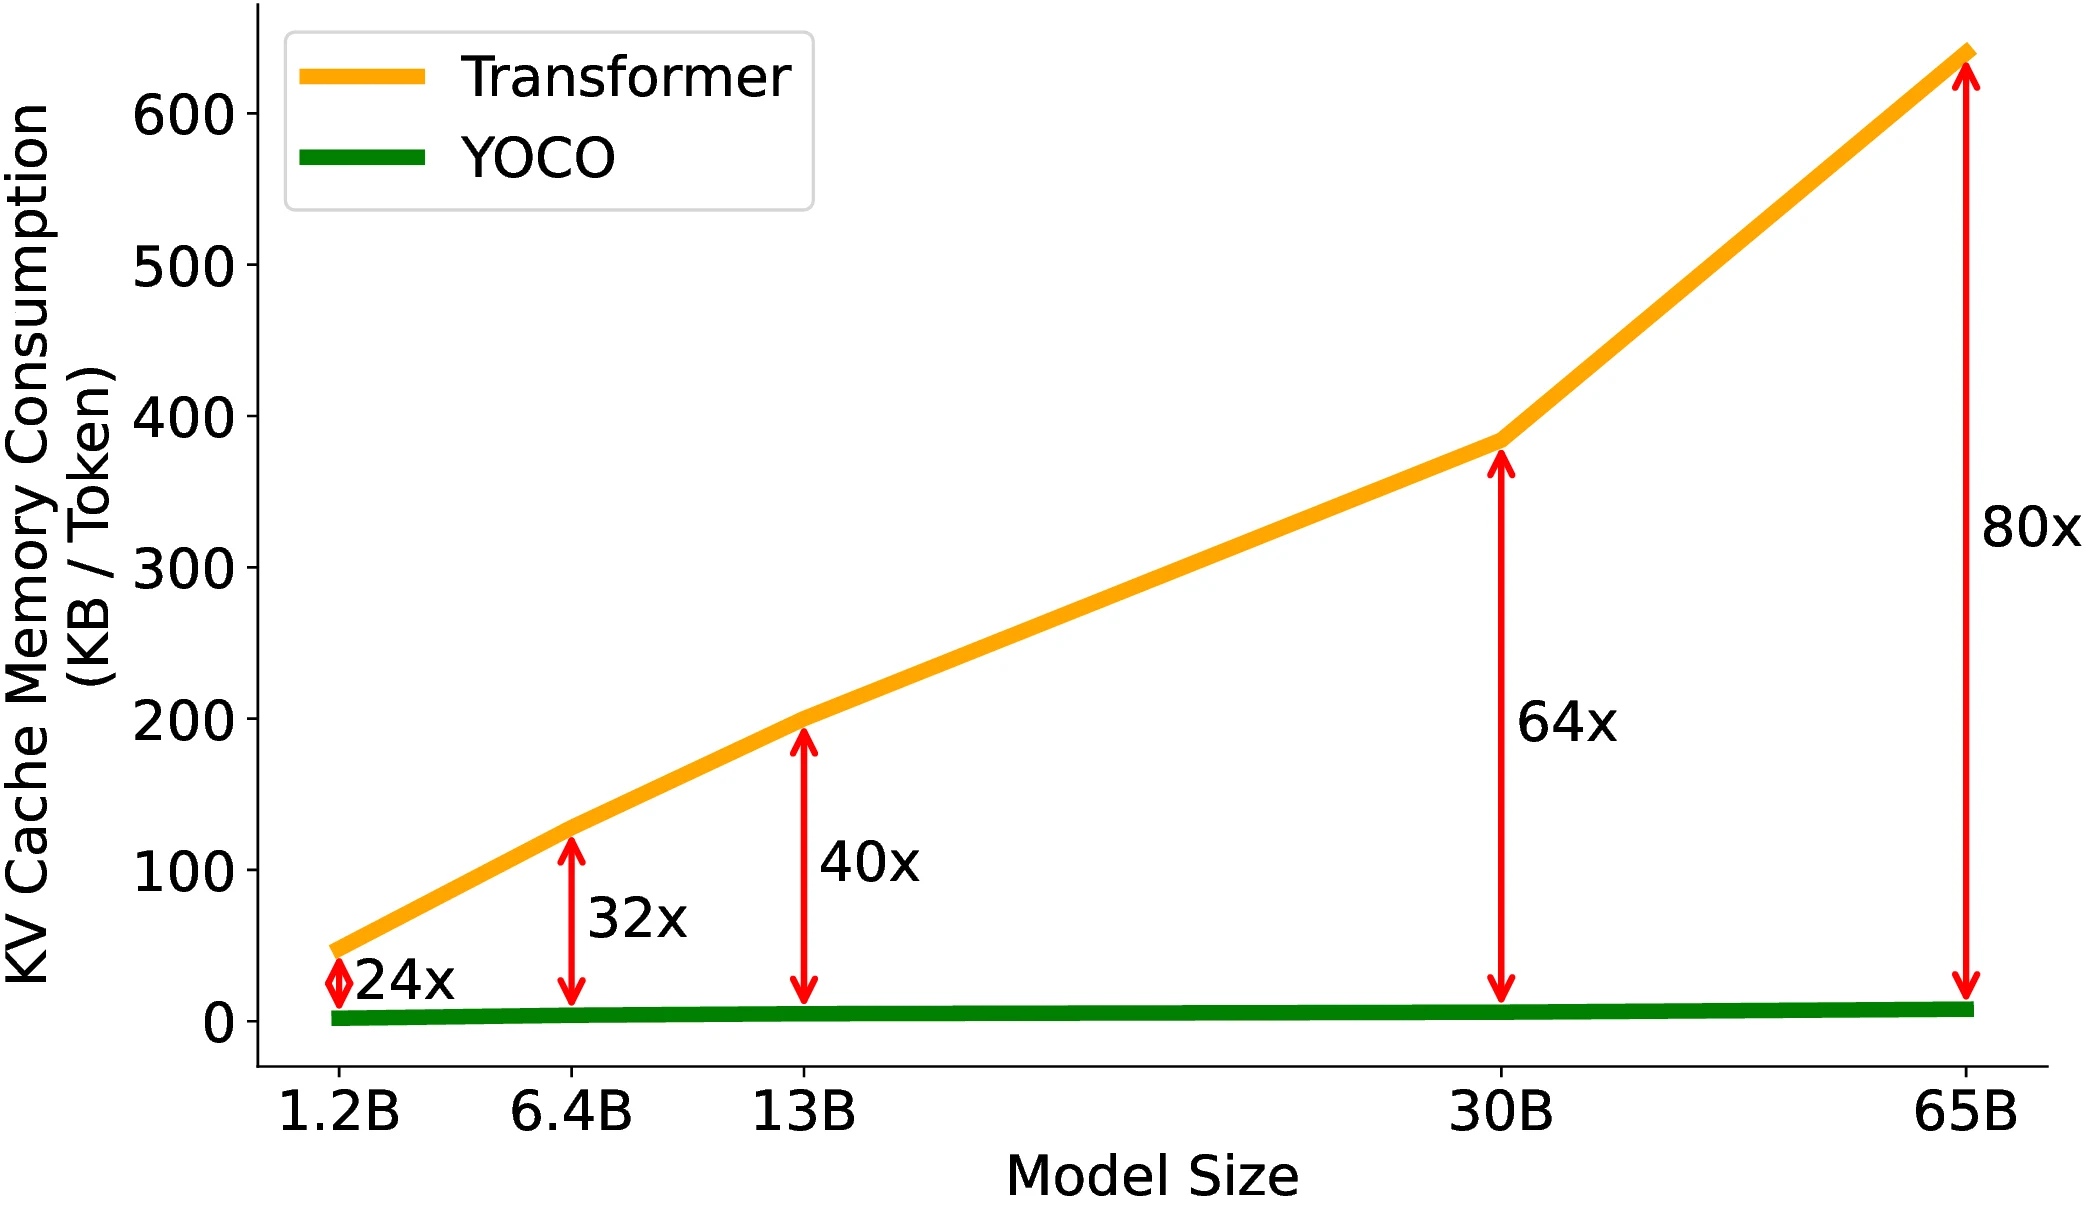
按论文模型配置估算的每 token KV 占用。模型从 1.2B 扩到 65B,YOCO 相对 Transformer 的缓存缩减从 24 倍扩大到 80 倍。图源:YOCO 论文 Figure 7。
图中 Transformer 从约 40KB/token 增长到约 640KB/token,YOCO 的增长小得多。原因并非“大模型每层 KV 更容易压缩”,而是更大模型通常层数更多,标准缓存付出的层数乘数更大;共享一次的价值随深度增加。论文据此给出一个容量化例子:在 65B 配置上,1GB KV 预算约能容纳 128K 个 YOCO token,而 GQA Transformer 约为 1.6K 个 token,对应 80 倍差距。这个数字只比较缓存预算,不包含权重、激活、碎片和服务框架元数据。
Prefill:提前退出与线性 mixer 叠加
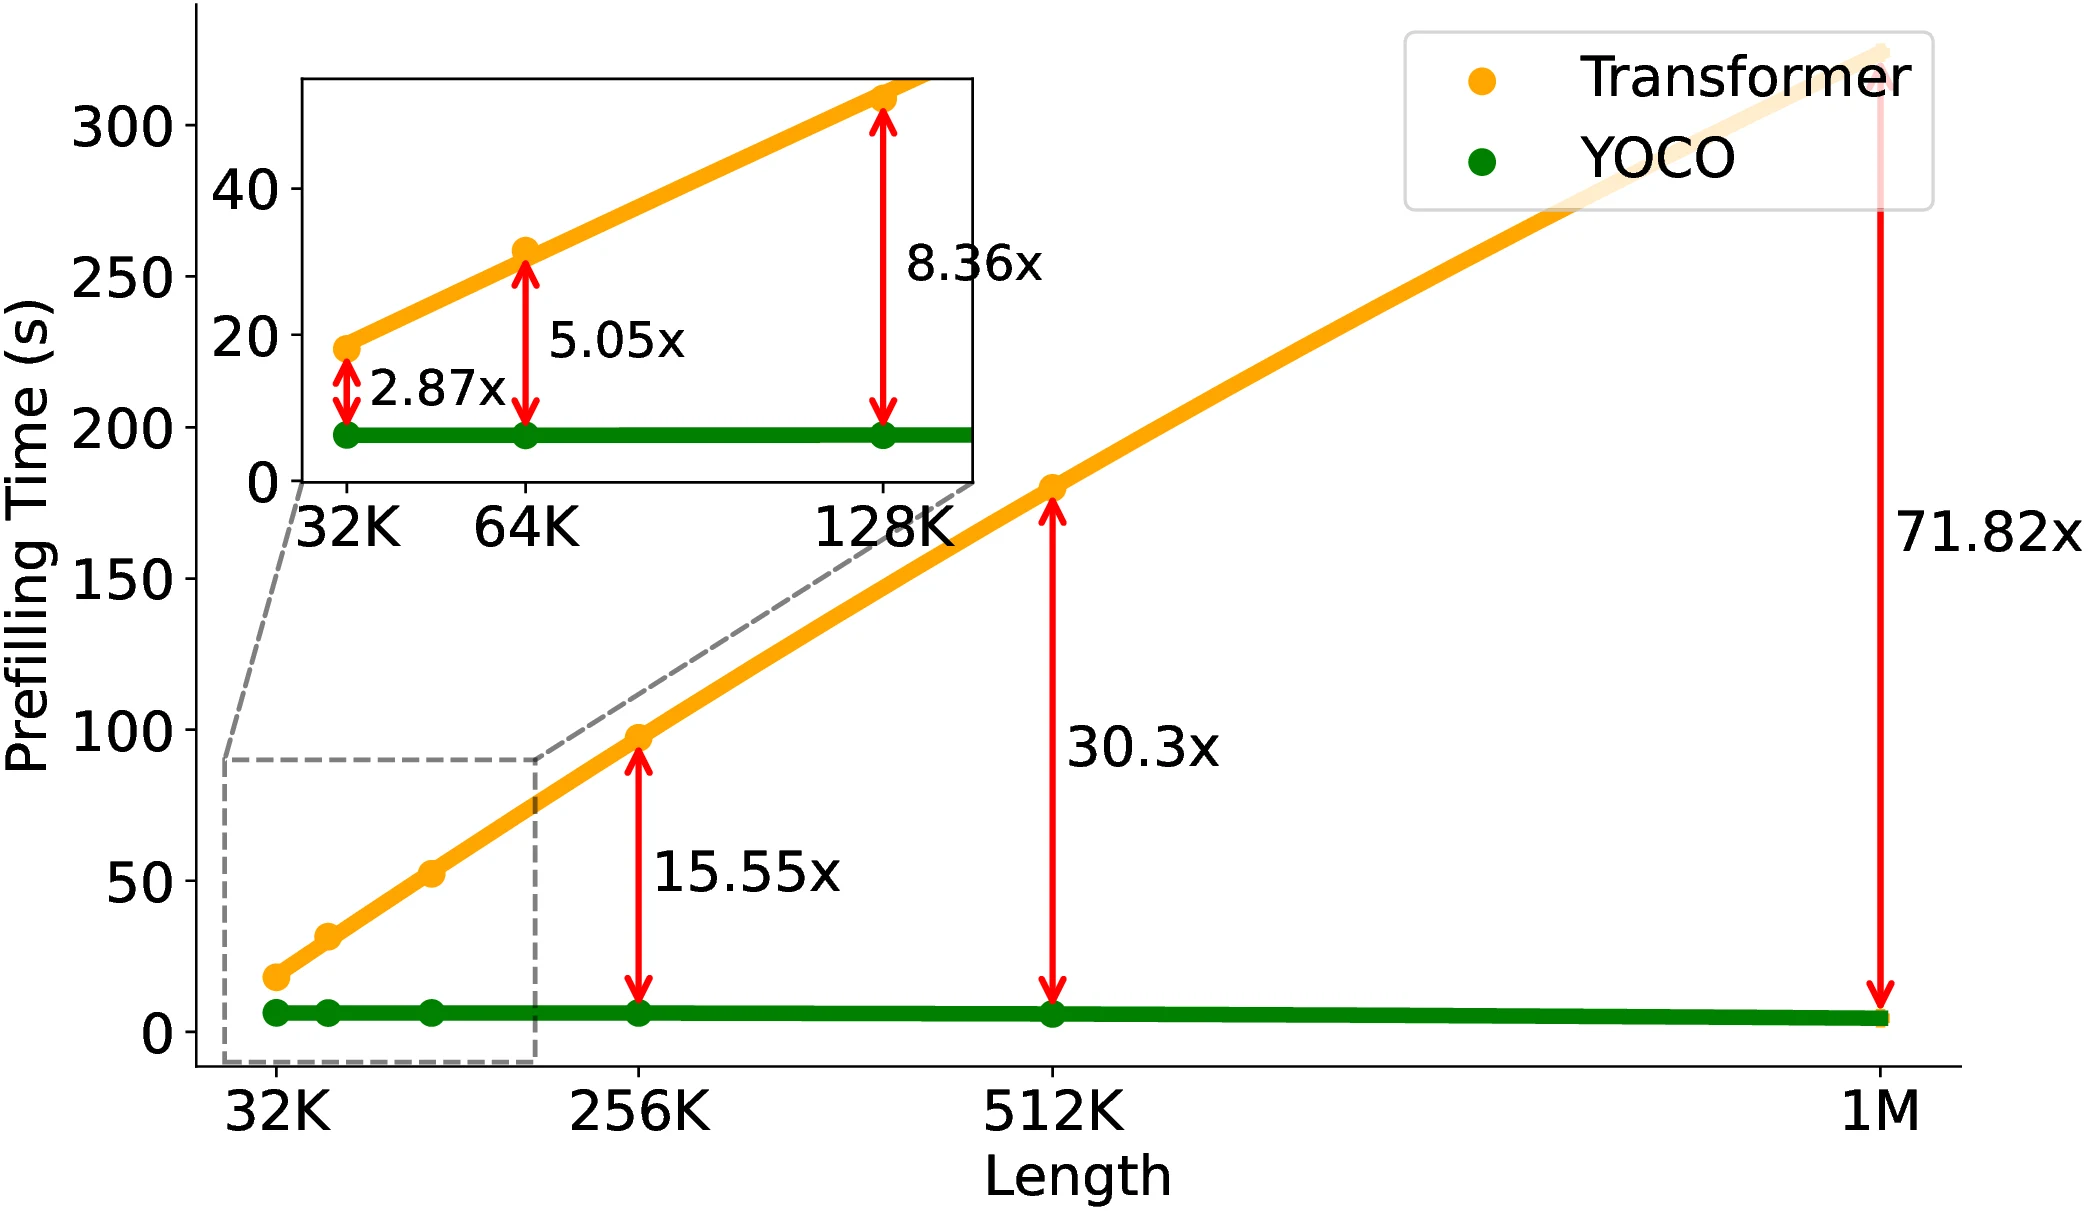
输入长度从 32K 增至 1M 时的 Prefill 延迟。Transformer 的全局注意力接近平方增长,YOCO 的 gRet Self-Decoder 近似线性增长。图源:YOCO 论文 Figure 8。
32K 时 YOCO 已有 2.87 倍加速,因为 bulk Prompt 不进入后半段;上下文增长后,全局注意力的 项开始主导,差距扩大。512K 时基线约 180 秒,YOCO 不到 6 秒,对应约 30.3 倍;1M 时图中从约 300 秒降到约 4 秒,论文标注 71.82 倍。图中 YOCO 在超长区间没有随长度明显上升,除了线性复杂度之外,也受到固定开销、并行效率和测量尺度影响,不能据此推断 Prefill 在现实中与长度完全无关。
吞吐:不只是单请求 kernel 更快
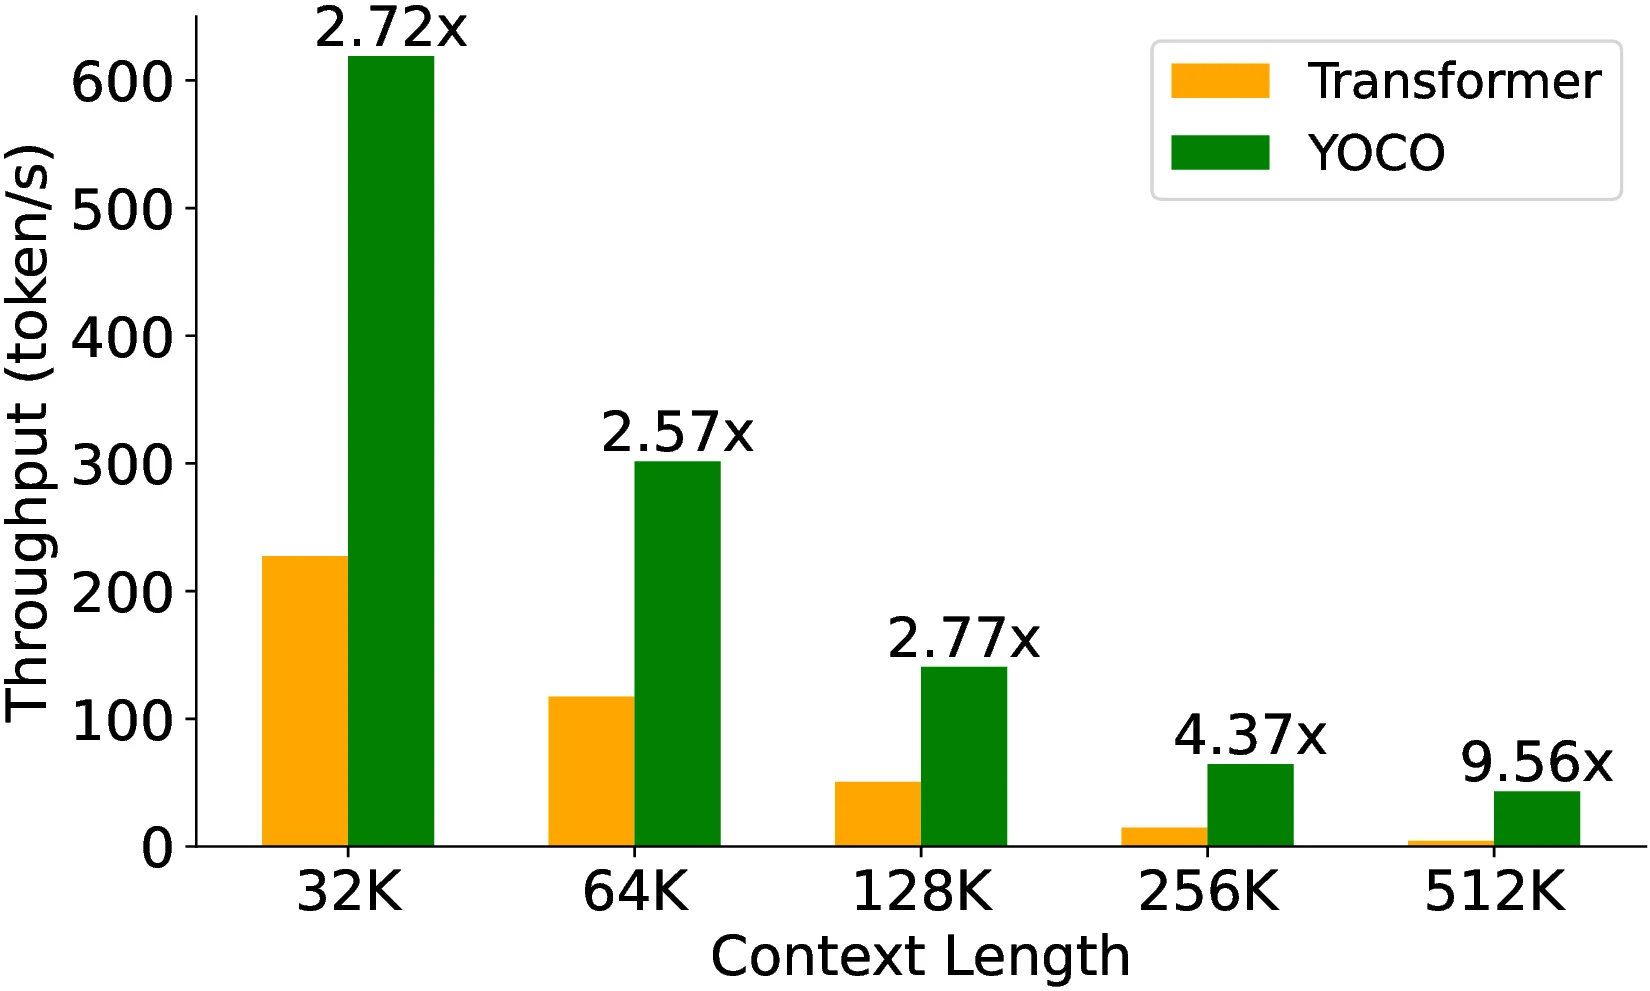
吞吐同时计入 Prefill 和 Generation。上下文越长,YOCO 相对优势越大;512K 时从 4.5 token/s 提升到 43.1 token/s。图源:YOCO 论文 Figure 9。
512K 上下文时,论文报告 Transformer 为 4.5 token/s,YOCO 为 43.1 token/s,即 9.56 倍。这个收益有两条来源:第一,单请求的 Prefill 工作量下降;第二,缓存变小后,同样显存可以放入更大的 batch,GPU 更容易维持足够并行度。后者说明 KV 优化常有“二阶收益”:省下的容量不只避免 OOM,还会反过来提高吞吐。
把四组数据放在一起,可以避免两个常见误判。其一,理论上的约 倍 KV 缩减不能直接写成 倍总显存或吞吐,因为权重、激活和计算仍在;其二,论文报告的 71.82 倍 Prefill 与 9.56 倍吞吐属于特定 3B、H100、超长输入和实现条件,不应外推为所有请求长度与硬件上的固定加速比。
从公式到实现:一次增量解码怎样流过 YOCO
官方实现位于 Microsoft UniLM 仓库的 YOCO/yoco/models/decoder/。代码把一个 block 的 mixer 抽象成三选一:Cross 层实例化 CrossAttention,Self 层在设置 sliding_window 时实例化 SlidingWindowAttention,否则实例化 GateRetention。这种组织揭示了 YOCO 真正的架构边界:共享 KV 并不依赖某个特定 retention kernel,只要求前半段 mixer 能维护有界增量状态。
推理状态应分成两类
一个服务引擎至少要维护以下状态:
RequestState├── self_state[0 ... L_self-1]│ ├── gRet: last_hidden_state│ └── SWA: prev_key[C], prev_value[C]└── global_cache ├── key[0 ... current_length-1] └── value[0 ... current_length-1]self_state 按 Self-Decoder 层各有一份,但长度有界;global_cache 随序列增长,却只有一份并被所有 Cross-Decoder 层引用。若把后者错误地在每层各注册一份张量,即使内容相同,也会把 YOCO 的核心收益重新复制掉。工程实现应传递同一 storage 的视图或句柄,而不是逐层拷贝。
官方 CrossDecoder 先对边界隐藏状态做一次 RMSNorm 和 K/V 投影,再把结果写入 incremental_state["prev_key"] 与 incremental_state["prev_value"];随后循环所有 Cross layer,把同一 key, value 参数传入。它还分别对 K 与 Query 应用 RoPE,因此共享并没有取消位置信息。CrossAttention 内部使用 FlashAttention 接口,并支持 Query 头多于 KV 头的 GQA 布局。
Prefill 的实现骨架
下面的伪代码只保留推理依赖,不对应仓库中的逐行复制:
def prefill(prompt, state): # 1. 整段 Prompt 通过 Self-Decoder。 hidden = embed(prompt) for layer_id, layer in enumerate(self_layers): hidden, state.self_state[layer_id] = layer.prefill( hidden, state.self_state[layer_id], )
# 2. 只投影一次全局 K/V,并写入唯一缓存。 k, v = boundary_kv_project(rms_norm(hidden)) state.global_cache.append(k, v)
# 3. Prompt 的非前沿位置不跑 Cross-Decoder。 frontier = hidden[:, -1:, :] for layer in cross_layers: frontier = layer( frontier, state.global_cache.key, state.global_cache.value, causal=True, )
return lm_head(final_norm(frontier)), stategRet 路径会先把 Prompt padding 到 256 的倍数以适配分块 kernel,再用 mask 排除填充位置;同时计算每个 Self 层 Prefill 结束后的 last_hidden_state,供下一次递推 Decode 继续使用。SWA 路径则把各层最后 个 K/V 留在固定缓冲区。两者都不能只保留边界层状态,因为新 token 仍要逐层穿过 Self-Decoder。
论文图把 Prefill 阶段的 Cross-Decoder 标为 skipped,代码中也有 skip_cross_decoder 开关。官方 needle 评测的生成循环先用该开关处理区间 ,特意留下最后一个 Prompt token;随后在 start_pos=N-1 处让这个 token 同时通过 Self-Decoder 与 Cross-Decoder,得到首个 next-token logits。另一种等价组织是先让 Self-Decoder 处理完整 Prompt,再单独把边界的最后位置送入 Cross-Decoder。无论采用哪种接口,都不能漏掉首个输出所需的前沿计算。可以把它视作 Prefill 收尾,也可以视作 Generation 的第零步;性能计时必须统一这个边界,否则不同实现的 TTFT 会少算或多算一段。
单 token Decode 的实现骨架
def decode_one(token, position, state): hidden = embed(token)
# 每层只更新有界状态。 for layer_id, layer in enumerate(self_layers): hidden, state.self_state[layer_id] = layer.decode_one( hidden, position, state.self_state[layer_id], )
# 新 token 的全局 K/V 只生成、追加一次。 k_new, v_new = boundary_kv_project(rms_norm(hidden)) state.global_cache.append(k_new, v_new)
# 所有 Cross 层共享读取完整缓存,各自计算 Query。 for layer in cross_layers: hidden = layer( hidden, state.global_cache.key, state.global_cache.value, causal=True, )
logits = lm_head(final_norm(hidden)) return sample(logits), state对 gRet,每个 Self 层的核心更新就是 current_state = exp(gate) * old_state + outer(k, v);官方实现把门控 logit 除以 16,并对 K 乘 的缩放。对 SWA,代码预分配窗口大小的 prev_key、prev_value,超过窗口后只保留尾部。对全局缓存,参考实现按 max_seq_len 预分配连续张量并按 start_pos 写入,逻辑简单但可能浪费保留空间。
接入推理引擎时的四个关键点
第一,全局缓存仍然适合分页。YOCO 消掉的是层维复制,不是请求长度不确定性;服务端依旧可能遇到不同请求长度、抢占、beam 分叉与前缀共享。把唯一的 global cache 接到块式分配器,可以叠加 PagedAttention 的低碎片优势。
第二,调度器要分别核算两类状态。每个请求的预算可以近似写成“所有 Self 层的常量状态 + 一份随 token 增长的 global KV”。若仍沿用 num_layers × bytes_per_token 估算,准入控制会严重低估可服务并发。
第三,Cross-Decoder 的长 KV 读取仍是带宽热点。缓存只存一份不等于每步只读一遍:每个 Cross 层都会扫描或分块读取同一份 K/V。容量复杂度从 份降到 1 份,但 Decode 的全局注意力计算仍大致乘 Cross 层数。FlashAttention、GQA、量化或稀疏检索仍有叠加空间。
第四,Prefix Cache 的共享单位会变得更简单。同一模型、同一 Prompt 前缀只需要缓存一套边界 K/V,加上能够恢复各 Self 层递归状态或窗口状态的快照。相比逐层前缀块,这降低了长前缀存储量;但如果只保存全局 K/V 而没有 Self 状态,续写时无法从前缀末端正确推进 Self-Decoder。
设计边界与适用场景
YOCO 对长上下文的容量与 Prefill 很有吸引力,但它没有同时消灭所有推理瓶颈。判断是否适用,需要把“存多少”“每步读多少”“模型能否直接迁移”分开。
它不是已有权重的无损插件
普通 Transformer 的每层都有自己的 K/V 投影和历史表征,YOCO 则要求在模型中间形成一个可被所有后半层读取的共享接口。直接删掉已有模型的逐层缓存、把某一层 K/V 广播给所有层,会同时遇到维度、语义和质量问题。部署 YOCO 需要原生 YOCO checkpoint,或者经历针对新架构的适配过程;不能像切换 FlashAttention kernel 一样只改推理后端。
它省容量,但 dense Decode 仍反复扫描长缓存
每个 Cross-Decoder 层都读取同一份全局 K/V。物理存储只有一份,但若上下文为 ,每个新 Query 的 dense attention 仍需在每个 Cross 层处理 个位置。粗略地说,Decode 的注意力读取与计算仍为:
所以 YOCO 首先解决“缓存复制 次”和“Prompt 的 Prefill”,并没有让 dense 长上下文 Decode 变成与 无关。长输出、长历史的任务最终仍可能受 HBM 带宽限制。这也解释了为什么后续工作会在共享缓存之上继续做稀疏索引,而不是认为 YOCO 已经结束了长上下文优化。
有界状态不是免费状态
SWA 每个 Self 层仍保存 个位置, 过大会抬高常量;gRet 每个 head 的递归矩阵状态与 head 维度相关,同样要占显存并执行外积更新。 只表示不随序列长度 增长,不表示字节数为零。对于短 Prompt,权重与这些固定状态可能占主导,YOCO 的总显存优势自然小于超长上下文。
一百万上下文不等于一百万有效推理能力
论文的单针检索在 1M 长度上接近满分,多针实验中 YOCO-3B-1M 在 128K 长度、针数 时准确率分别为 。它证明模型能在极长输入中访问远处信息,也同时显示任务变复杂后准确率会下降。Needle-in-a-Haystack 主要测试精确召回,不能代替跨章节综合、代码库推理或多跳归因等长上下文能力评估。
与其他 KV 优化不是替代关系
| 方法 | 主要削减的维度 | 是否改变模型架构 | 与 YOCO 的关系 |
|---|---|---|---|
| GQA | KV 头数 | 是 | YOCO 论文已组合使用 |
| MLA | K/V 表示维度 | 是 | 都从源头改写缓存,可探索组合但投影接口不同 |
| KIVI、KVQuant | 每元素位数 | 否或轻量适配 | 可量化 YOCO 的唯一 global cache |
| H2O、SnapKV | 保留 token 数 | 通常是推理策略 | 可进一步驱逐或压缩共享缓存,但会引入近似 |
| PagedAttention | 分配碎片与共享方式 | 否 | 可为 YOCO global cache 提供分页管理 |
| YOCO | 跨层份数 | 是 | 从层维消掉重复缓存 |
这张表对应前文公式 的不同因子。GQA 减少头数,量化减少字节数,驱逐减少 token 数,YOCO 减少长缓存的层数副本,PagedAttention 则降低物理分配浪费。它们瞄准的轴不同,因而不是只能择一。关于低秩缓存接口可参考 MLA 完全拆解,关于 2-bit KV 可参考 KIVI 完全拆解。
最适合与不太适合的负载
YOCO 最适合长输入、共享前缀多、KV 容量限制并发、输出相对较短的服务,例如长文档问答、代码库检索增强和多轮会话。此时 Prefill early exit 与单份全局缓存都会直接命中瓶颈。
如果上下文很短、batch 已经能把 GPU 算满,权重与 FFN 计算占主导,节省 KV 未必带来显著端到端收益。如果任务要求在百万历史上持续生成极长结果,dense Cross-Decoder 的反复全局扫描又会成为新瓶颈。最后,现有部署生态大量围绕标准 Transformer 的逐层 paged KV、连续批处理和成熟 fused kernel 建设;原生 YOCO 还需要调度器、缓存核算和 kernel 路径的专门支持,论文原型性能不能自动等价为所有框架里的生产性能。
YOCO 留下的架构启示
YOCO 最重要的价值不只是把 KV Cache 除以一个层数,而是把隐含在 decoder-only Transformer 里的“记忆系统”显式化。标准模型让每层同时负责写入和读取自己的历史;YOCO 把它拆成 Self-Decoder 写共享记忆、Cross-Decoder 反复读取共享记忆。这个接口带来三条可以继续扩展的路线。
第一,缓存与索引可以共同共享。2026 年的 You Only Index Once 直接建立在 YOCO 式共享 KV 上:一个轻量 indexer 只做一次 token-level top-k 路由,随后所有 Cross-Decoder 层复用同一组索引。原始 YOCO 解决“只存一份”,但 dense 层仍扫描全缓存;CLSA 进一步解决“每层都扫描、每层都重新路由”。论文在 128K 上报告最高 7.6 倍 Decode 加速和 17.1 倍总体吞吐提升。更关键的系统逻辑是:既然被查询的记忆对象相同,绑定在记忆上的检索元数据也应该共享。
第二,计算深度可以与缓存深度解耦。2026 年的 Universal YOCO 在浅层高效 Self-Decoder 上做参数共享的递归迭代,而全局 KV 仍只生成一次。普通 Transformer 增加循环深度时,计算与缓存压力容易一起增长;YOCO 的中间记忆接口允许把更多计算放在不扩大全局缓存的局部模块中。它展示的不是某个固定循环次数,而是一种“增加计算不必线性复制长期状态”的设计空间。
第三,共享记忆让存储优化的收益更集中。若全局缓存只有一份,对它做量化、分层放置、分页、稀疏索引或前缀持久化,不需要为每层维护一套独立元数据。代价也同样集中:这份记忆一旦量化误差过大或错误驱逐某个 token,所有 Cross 层都会受到影响,无法依靠其他层的独立 K/V 提供冗余。因此,共享会放大优化收益,也会放大缓存错误,质量控制需要比逐层缓存更谨慎。
从推理系统视角,YOCO 可以归结为四个结论:
- KV Cache 的层数因子不是不可改变的定律,而是标准 Transformer 数据依赖的结果。
- Self-Decoder 用有界状态持续写入一份全局记忆,Cross-Decoder 用不同 Query 多次读取,因而“共享 K/V”不等于“共享注意力结果”。
- Prompt 的 Cross 历史输出不再是未来缓存的前置依赖,所以 bulk Prefill 能在中间边界提前退出;生成 token 仍完整经过两段。
- YOCO 显著降低容量与 Prefill 成本,但 dense Cross attention 的长缓存读取仍随上下文增长,稀疏检索与专用服务引擎仍是下一步。
它把优化问题从“怎样管理每层都存在的 KV”向前推进了一步:为什么长期记忆必须在每一层重复写入?一旦这一假设被拆掉,缓存、检索、递归深度和服务调度就能围绕一个统一的共享记忆接口重新设计。
参考资料
- You Only Cache Once: Decoder-Decoder Architectures for Language Models(arXiv)
- You Only Cache Once(NeurIPS 2024 论文页)
- Microsoft UniLM:YOCO 官方实现
- YOCO 官方 Decoder 实现
- YOCO 官方 Needle-in-a-Haystack 增量生成实现
- Retentive Network: A Successor to Transformer for Large Language Models
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- You Only Index Once: Cross-Layer Sparse Attention with Shared Routing
- Universal YOCO for Efficient Depth Scaling
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


