SnapKV 完全拆解:LLM 在生成之前就知道你在找什么——观察窗口投票与聚类压缩 Prompt KV(NeurIPS 2024)
站内拆 KV Cache 的文章已经覆盖了不少角度:PagedAttention 管内存怎么分块分配(详见 PagedAttention 完全拆解),GQA 与 MLA 从架构上减小每个 token 的 KV 体积(详见 GQA 完全拆解 与 MLA 完全拆解),KIVI 把 KV 的存储精度压到 2-bit(详见 KIVI 完全拆解),H2O 在解码过程中驱逐不重要的 token(详见 H2O 完全拆解),StreamingLLM 用 attention sink 稳住无限流式生成(详见 StreamingLLM 完全拆解)。这一篇要拆的是这些方案共同忽略的一个场景:prompt 本身比生成结果大得多的时候,该怎么办。
背景:长 Prompt 的 KV Cache,一块被系统性忽视的内存
先纠正一个默认印象。说到”KV Cache 随序列长度膨胀”,直觉上指的是生成结果越来越长——聊得越久缓存越大。但现实中真正喂给模型的长文本几乎都在输入侧:聊天机器人的系统提示词与多轮历史、agent 的任务说明与工具定义、RAG 里检索回来的几十上百篇文档、代码仓库的上下文、长文档问答的全文。一个典型的 RAG 请求可能携带 2 万到 4 万 token 的检索文档,而模型只需回答几百 token;agent 的上下文管理里,输入与输出的悬殊比例同样普遍。
这对 KV Cache 意味着两件事:
第一,内存被 prompt 的 KV 占满。 KV Cache 的字节数随序列长度线性增长,序列长度的大部分由输入构成,因此 prefill 阶段结束时缓存里的绝大部分 KV 都属于 prompt。比如用 Command-R(35B,128K 上下文)处理 100 篇检索文档、约 40K token 的输入,prompt KV 几乎决定了整张卡能不能装下这个请求。
第二,解码每步的注意力开销大部分花在 prompt 的 KV 上。 解码第 个 token 时,新的 query 要对全部历史 KV 求注意力——其中包括全部 prompt KV。输入 30K、生成 500 token 的请求,每一步的注意力扫描里有超过 98% 的开销落在那些 prompt KV 上,哪怕其中绝大多数与当前输出毫无关系。所以 prompt KV 同时是容量问题和带宽问题:把它砍掉,省下的不只是显存,还有每一步解码都要重复支付的那笔”过路费”。
然而既有的 KV 压缩方法几乎都在管生成过程中追加进缓存的那部分。H2O 的驱逐发生在解码的每一步,打分从第一个生成 token 开始累积;StreamingLLM 保留 sink 加滚动窗口,是为”无限生成”设计的;FastGen 和 Scissorhands 也都是在生成阶段动态丢弃。它们不是不能碰到 prompt 的 KV(H2O 的驱逐范围其实覆盖全部缓存),而是没有把”在生成开始前、一次性把 prompt KV 裁掉”当作一个独立问题来解。用论文里的话说,这些方法”主要压缩解码步骤中追加的 KV,忽视了在真实应用中通常是内存瓶颈的 prompt KV”。
这个缺口在 2024 年 4 月 22 日被一篇挂在 arXiv 上的论文补上——SnapKV,全称 SnapKV: LLM Knows What You are Looking for Before Generation,同年 12 月发表于 NeurIPS 2024。作者来自伊利诺伊大学厄巴纳-香槟分校(UIUC,Deming Chen 课题组,Yuhong Li 与 Yingbing Huang 并列一作)、Cohere(Bowen Yang、Patrick Lewis 等)与普林斯顿大学(Tianle Cai),官方代码开源在 FasterDecoding/SnapKV。
SnapKV 的核心断言用一句话说就是:LLM 在开始生成之前,就已经”知道”自己在 prompt 的哪些位置找答案——而这份”知情”藏在 prompt 尾部那几个 token(指令、问题)的注意力模式里。因此可以在 prefill 结束后做一次性的快照压缩:把 prompt KV 从几万 token 砍到几百上千 token,之后整个解码阶段都不再需要被丢掉的那部分。
两个关键观察:注意力模式在生成之前就已定型
SnapKV 的方法完全建立在两个经验观察上。论文用 UltraChat 多轮指令数据集做分析,过滤出”回复长于 512 token、prompt 长于 3K token”的样本,逐层把注意力特征(query 与各个 key 位置之间的 softmax 权重)按 128 token 一个窗切开,研究不同位置的窗各自”认出了”哪些重要的 prompt 位置。
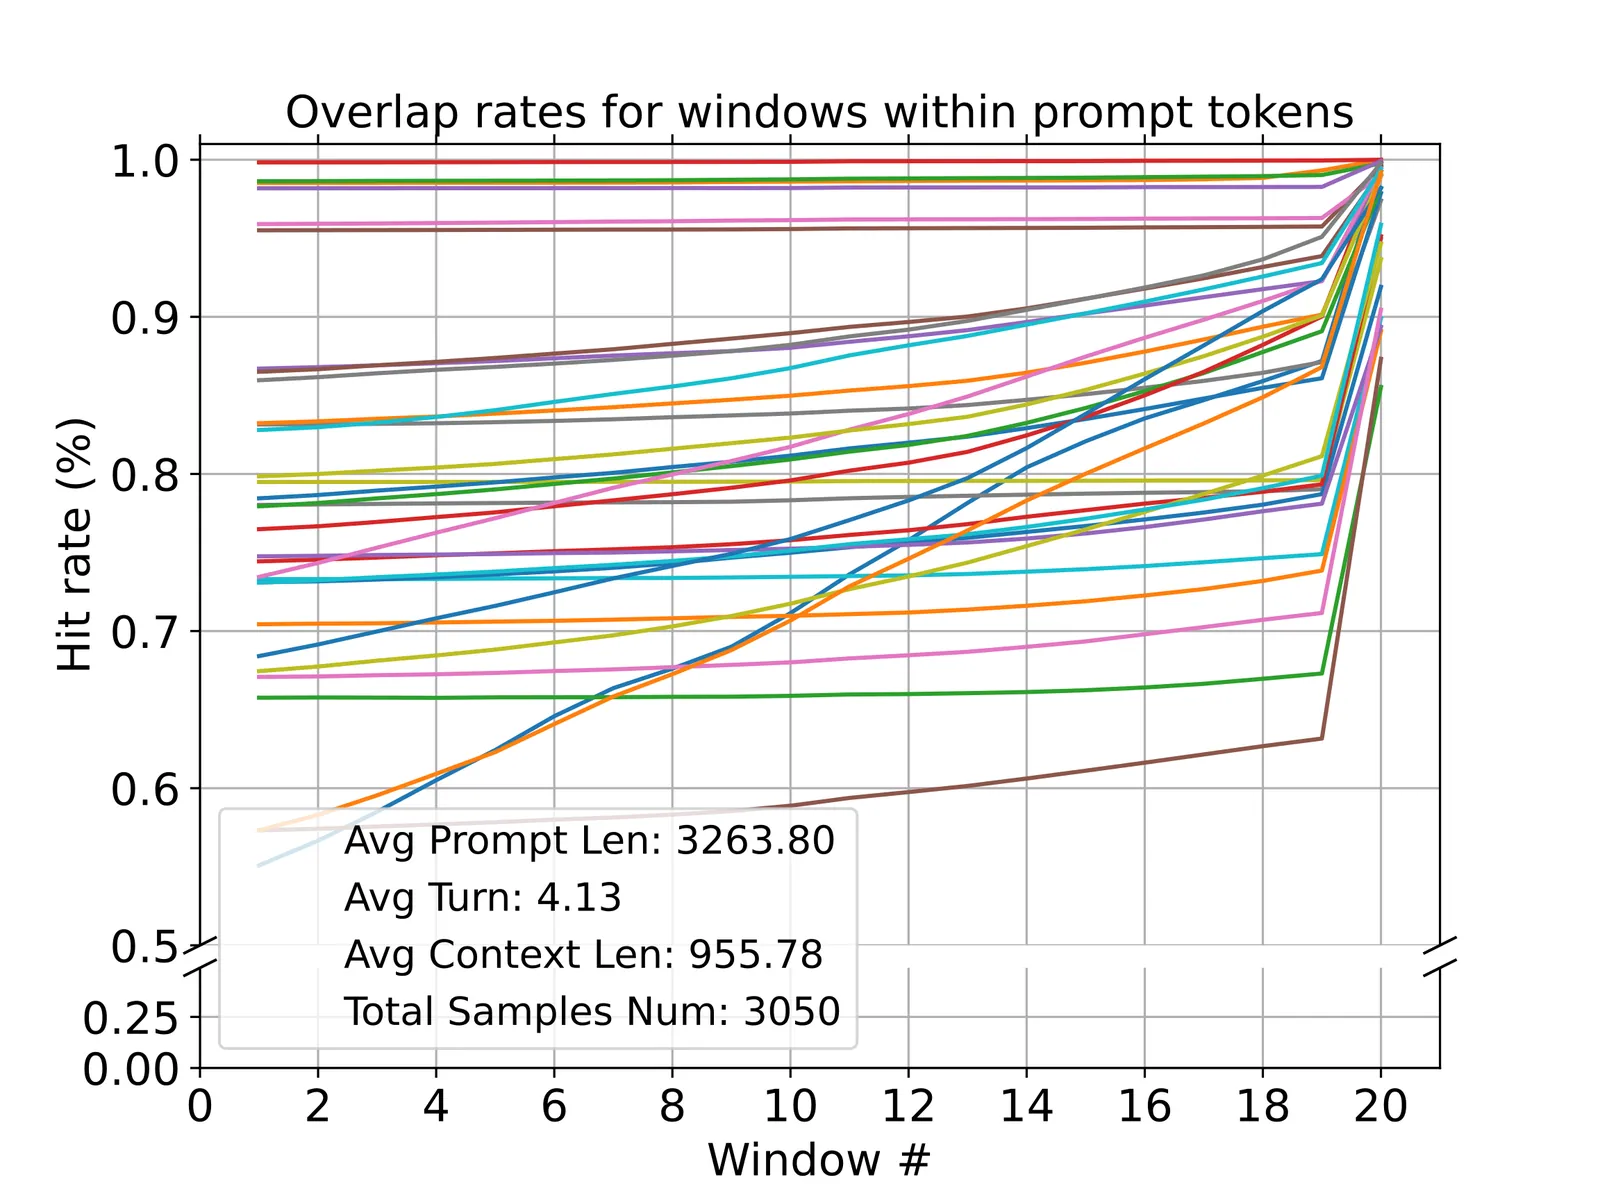
观察一:注意力分配模式在生成之前就可以确定。 论文把输入序列的特征按位置切成若干窗(每窗 128 token),分别统计每个输入窗的 query 平均注意力权重较高的位置集合(即该窗认为重要的前缀位置),再与生成过程中实际用到的重要位置比较重合率。结果如图 2 所示(每条线是一个模型层):越靠近输入尾部的窗,与生成实际注意力分布的重合率越高;输入序列最后一个窗识别出的注意力分配模式,与真实生成时的模式高度一致。这毫不意外地对应着一个常识性结构:prompt 末尾承载的是指令与问题——正是它们决定了”接下来该看上下文里的哪里”。
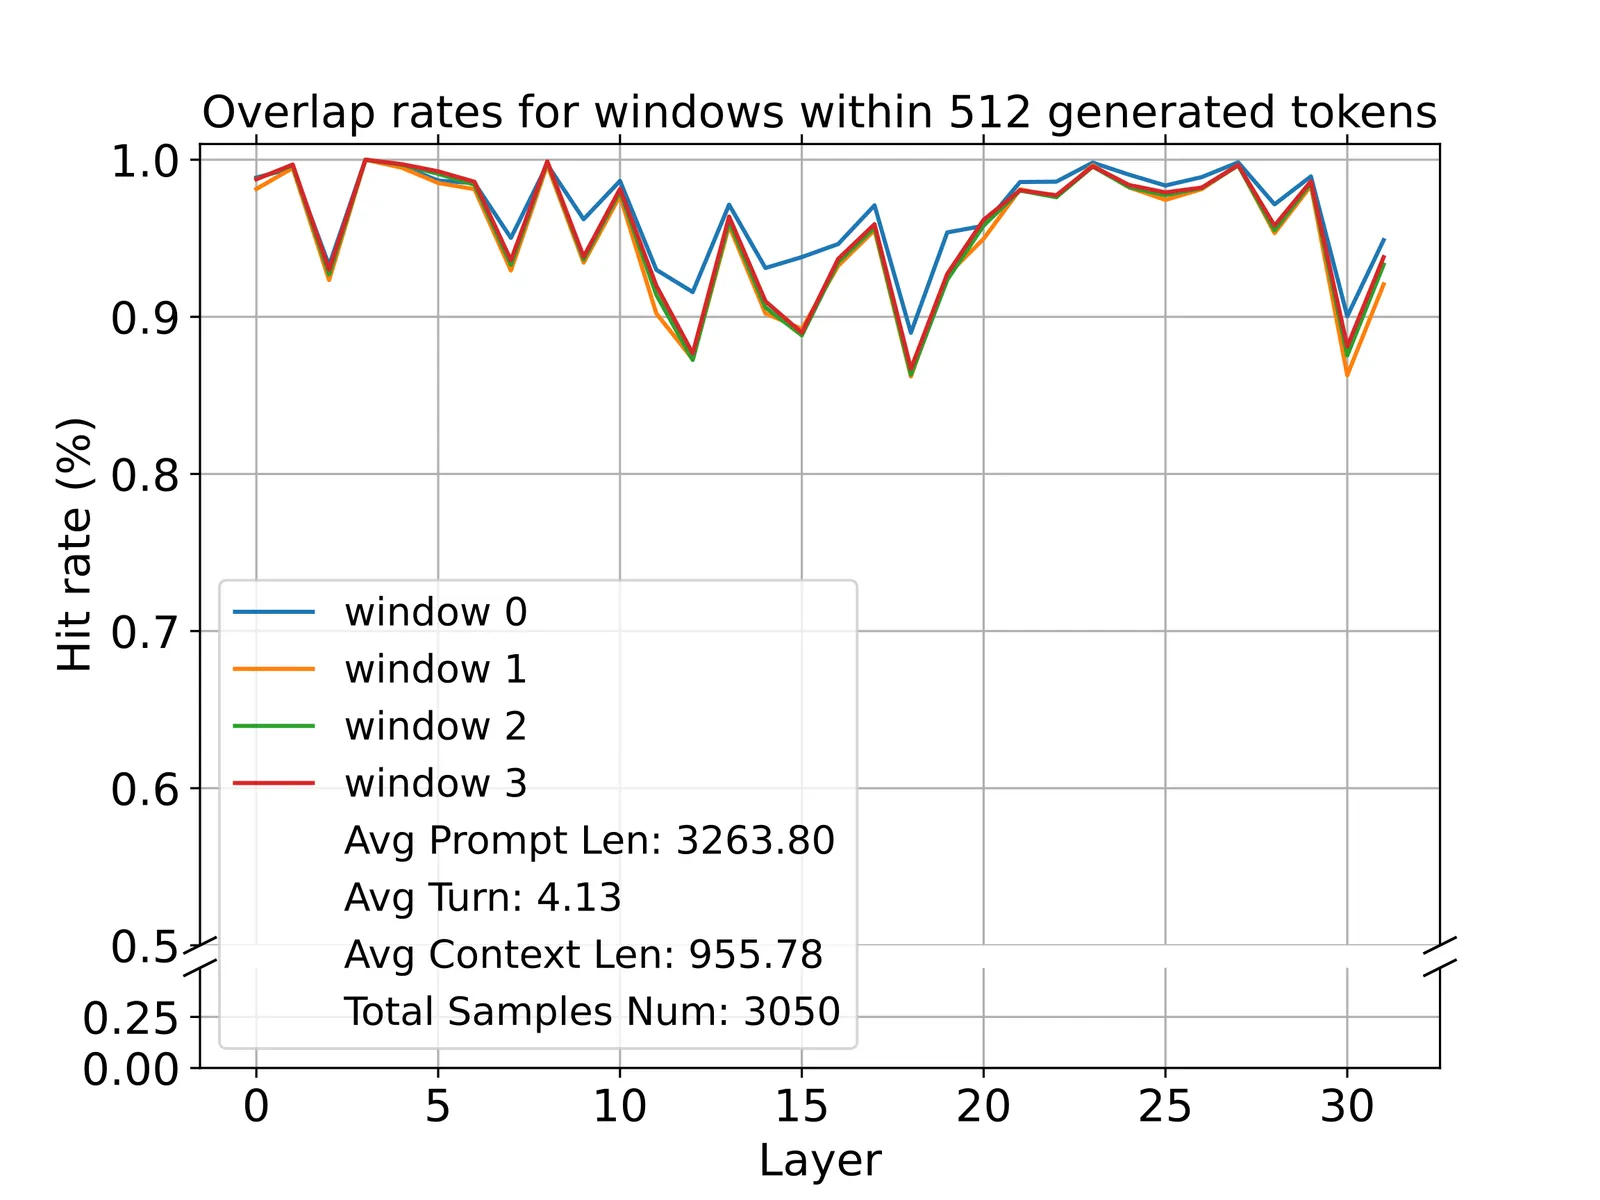
观察二:这个模式在生成过程中保持稳定。 论文进一步把生成出来的 token 按每 128 个切窗(共 4 窗),逐层计算”输入最后一个窗选出的重要位置”与”各生成窗实际用到的重要位置”的重合率。结果(图 3)显示重合率持续保持在很高的水平:生成开始前被认定为重要的 prompt 位置,在整段生成中都持续被用到。解码过程中的 query 一直在”问同一件事”,所以它们反复回到同一批 prompt 位置取信息。
这两个观察与站内拆过的 H2O 形成有趣的互补。H2O 发现的是语篇层面的规律:主题词、高频实体这类”重击者”token 在整个对话里反复吸收注意力,因此历史累计注意力可以预测未来;SnapKV 发现的是意图层面的规律:指令/问题一旦出现,就锁定了一批上下文位置,且这批位置几乎不随生成推进而漂移。H2O 需要解码启动后才能开始累积分数、逐步换血;SnapKV 则把决策时间点提前到任何生成 token 出现之前——它手里有完整的问题,可以一次性、全局地做选择。
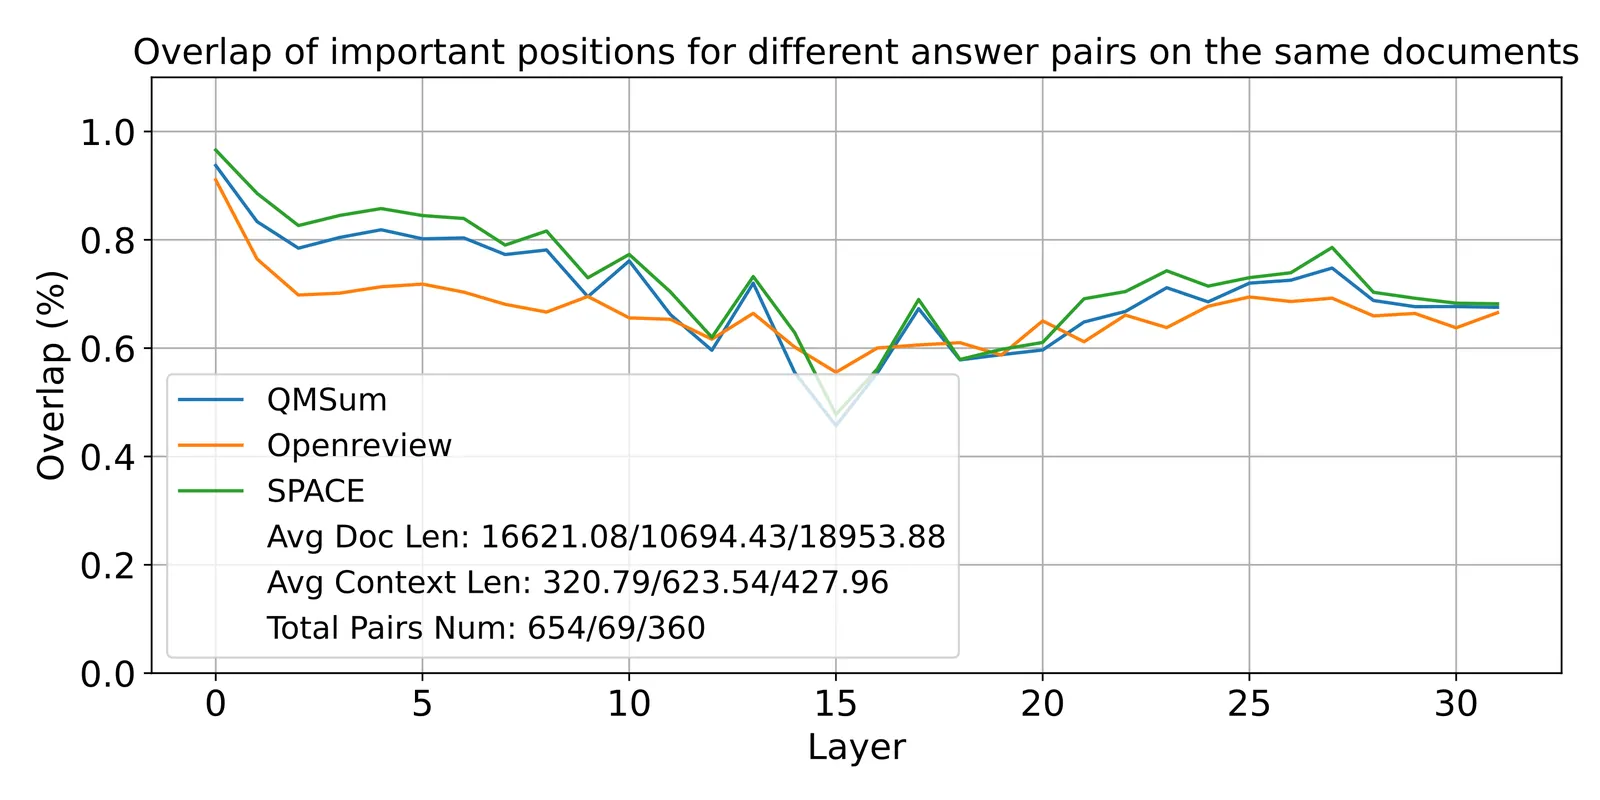
不过,光有这两个观察还不够——它们隐含一个前提:观察窗选出的位置确实由”问题”驱动,而不是某种固定的位置癖好。论文针对性地做了两组稳健性实验(第 4.2 节),用 QMSum(会议纪要问答)、Openreview(论文库问答,来自 L-Eval)与 SPACE(观点摘要)三个长文档数据集、Mistral-7B-Instruct-v0.2 做探测:
- 上下文依赖(contextual dependency):对同一篇文档提出不同问题,观察窗选出的重要位置明显分化(重合率下降,图 4)。这说明”prompt 里哪里重要”是跟着当前指令走的,而不是文档本身固定的属性。由此引出一个重要推论:任何”静态”压缩策略——无论按固定权重、固定位置还是预计算的文档级重要性——在理论上都会吃亏;压缩必须用当前指令现场投票。
- 对问题位置的鲁棒性:把问题放在长文档的前部与后部分别测试,观察窗投票的命中率都稳定地高(论文图 5,此处未贴出)。也就是说,SnapKV 并不依赖”问题恰好挨着文档末尾”这种巧合——即使指令在前、文档在后,末尾窗的注意力仍然能经由长程路径命中真正重要的位置。
SnapKV 方法:观察窗口投票 + 池化聚类的单次压缩
先引入论文的三个术语。设 prompt 总长度为 ,把它切成两段:末尾的 观察窗口(observation window,长度 ,通常 16–64 token)与前面的 前缀(prefix,长度 ):
观察窗口在概念上就是”问题的载体”——对话的最后一轮指令、文档问答里的问题、摘要任务的指示语,都落在 prompt 末尾。SnapKV 用这个窗口的 query 去”询问”前缀里的每个位置,然后只保留被问得最多的那些位置。整个过程分两步,且只在 prefill 完成后执行一次:
第一步:投票(voting),选出每个注意力头的重要位置。 对每一个注意力头,把观察窗口内所有 query 对前缀所有 key 的 softmax 归一化注意力权重沿 query 维求和,得到前缀每个位置在该头上的”得票”:
其中 是注意力头数, 是观察窗口 query 对前缀 key 的注意力权重张量。然后对每个头独立取前 名:
是压缩率(例如 表示只保留 10% 的前缀位置), 是每个头各自选出的位置索引集合。
第二步:截断拼接,生成压缩缓存。 把每个头在 中选中的前缀位置的 Key/Value 抽出来,与完整的观察窗口 KV(永不压缩)拼接,构成新的 KV Cache。此后解码正常进行:新 token 的 KV 照常追加,但被裁掉的前缀位置永远不再进入注意力计算。
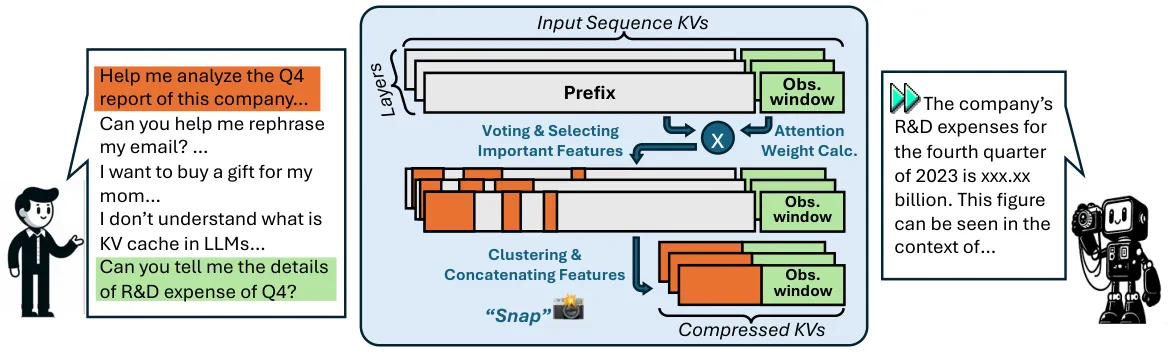
算法朴素到可以用十几行 PyTorch 写完(论文的 Listing 1 即是),但每个设计决策背后都有讲究。下面逐条拆。
为什么用观察窗口投票,而不是整个 prompt 投票?
最自然的做法似乎是”所有 prompt token 一起投票”:把 prefill 注意力矩阵沿 query 维全部求和,选出全局重要位置。SnapKV 偏偏只用末尾 16–64 个 query。原因有两层。
计算上,观察窗口把投票的开销压到可以忽略。每层投票本质上是一次 的 QK 矩阵乘加 softmax,而 prefill 主计算是 量级,投票的额外开销约为 ——当观察窗口 32、prompt 上万 token 时只有不到 1%。若用全部 prompt 做投票,要么让 FlashAttention 物化整张 注意力矩阵(吃掉 FlashAttention 的全部内存红利),要么白做一遍完整 QK,都不划算。
语义上,观察一已经回答了”为什么够用”:与生成注意力分布最吻合的正是末尾窗。prompt 的结构决定了”谁来决定看哪里”的权力集中在尾部——系统提示规定了任务、检索文档是被查询的对象、问题是触发器。真正承载”意图”的 query 只占 prompt 的极小部分,其余 token 的注意力只是这份意图的噪声副本。用整个 prompt 投票,等于让几万个”被查询的文档 token”和几十个”提出问题的 token”拥有同等投票权,反而稀释信号。
为什么要逐头独立选择?
公式里的 是沿每个头单独做的。多头上投影(MHA)里不同头在预训练中分化出不同职能:有的头追踪实体指代,有的头匹配问答对结构,有的头只负责句法近邻。一个位置对”实体头”是命门,对”位置头”可能毫无意义;若跨头合并投票,少数派头的关键位置会被多数派稀释掉。逐头独立预算等于给每个职能独立的配额——这一点与 H2O 逐头驱逐的设计逻辑完全一致(详见 H2O 完全拆解 中”为什么要按头独立驱逐”一节)。代价是不同头保留的位置集合不同,但 KV Cache 本来就是逐头存储的,没有任何额外成本。
为什么要池化聚类,而不是直接取 Top-k 单点?
这是 SnapKV 最容易被忽略、也最体现工程直觉的一步。直觉上,“得票最高的 个位置”不就是最优解吗?论文指出了它的缺陷:LLM 的检索本质上依赖”锚点 + 复制补全”机制。解释学的研究(Olsson 等人的 induction heads 工作,详见论文引用的 In-context Learning and Induction Heads)表明,模型找到高注意力锚点后,倾向于从锚点附近的原文连续片段复制细节来完成输出。因此,真正对生成有用的信息以簇(cluster)的形式存在——不是孤立的单点,而是连续的一段(一句引文、一个号码、一份条款)。直接取 top-k 单点会把这些连续片段拆成残片:论文举的例子是,压缩可能只保住电话号码里的国家代码,模型随即幻觉出剩下的数字。
SnapKV 的处理是在投票向量上先做一维池化,再取 top-k:对长度为 的得票向量 ,用 kernel 大小为 (实验里 5 到 13 之间)、stride 1、padding 的池化窗滑过(max 或 average 均可,论文消融显示两者无显著差异),把每个位置邻域的注意力”摊”进该位置,然后对池化后的向量取 top-k。效果是:高注意力点周围的一整片邻域都会获得高池化得分,top-k 的结果自然落在簇内及簇的邻接位置上——保留的是成团的位置,而不是被拆散的孤点。
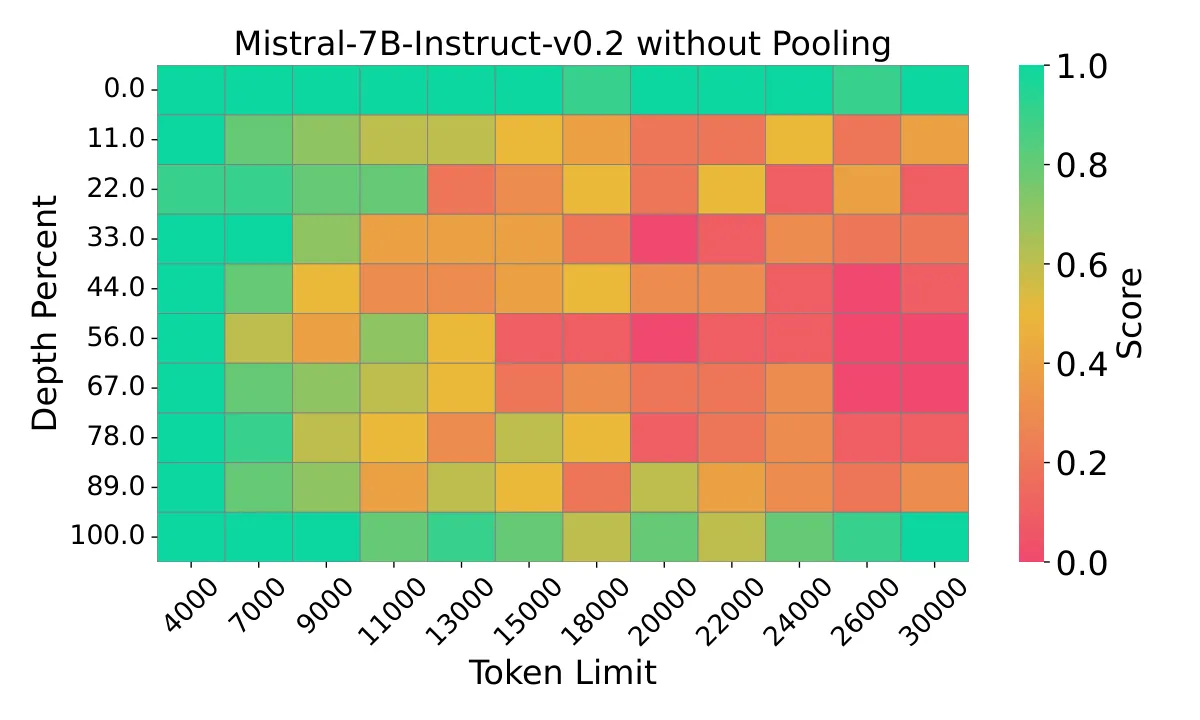
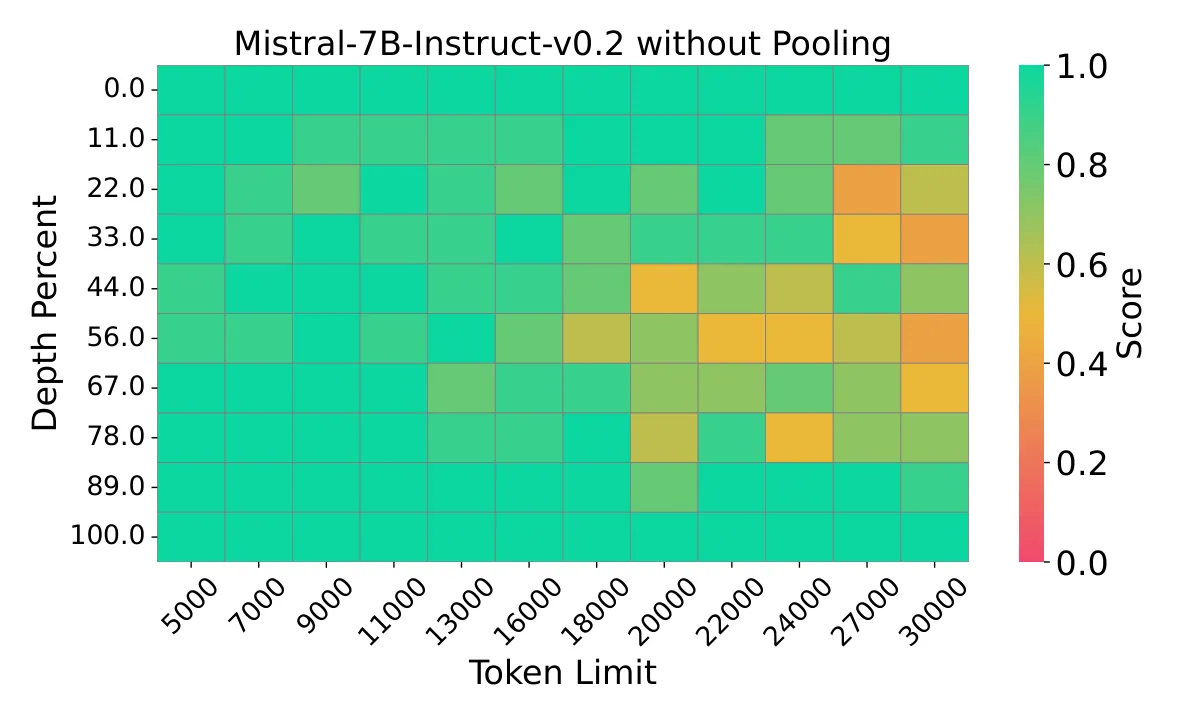
为什么观察窗口本身永不压缩?
观察窗口的 KV 被无条件完整保留,有两个理由。第一,它承载的是指令本身——生成时模型需要反复”看着”任务要求行事,把问题裁掉等于让模型在不知道要干什么的情况下作答。第二,它天然充当解码初期的近端上下文:压缩缓存 = 选中的前缀片段 + 观察窗口,观察窗口恰好处于 prompt 的尾部位置,与随后的生成 token 相邻,承担了”最近 token”的局部性功能。因此 SnapKV 的保留集合在结构上可以类比为 H2O 的”重击者区 + 最近区”双缓冲:池化选簇负责”重击者”角色,完整观察窗口负责”最近区”角色(详见 H2O 完全拆解)。
位置编码:为什么 SnapKV 不需要重新编号
这是与 StreamingLLM 最鲜明的一个机制差异。StreamingLLM 的缓存是”4 个 sink + 滚动窗口”,token 被逐出后缓存内部要重新连续编号,否则 RoPE/ALiBi 的相对距离会跳号失配(详见 StreamingLLM 完全拆解 中的位置编码一节)。SnapKV 完全不需要处理这个问题,因为它的压缩点发生在 RoPE 旋转之后:在 HuggingFace 的实现路径里,key 先被施加位置旋转、再进入压缩逻辑,被选中的 K 向量已经携带了各自的绝对位置旋转角。截断或重排只改变缓存的存储布局,不改变任何 K 的位置语义——注意力是内容寻址的,K 与后续 query 的相对距离由双方各自的旋转角决定,与它们在缓存里的存放顺序无关。代价则是被保留的前缀 K 仍然以原始绝对位置参与注意力,生成推进后相对距离会继续增长,但这与不压缩时的行为完全一致,没有引入新的位置失配。
这个”无需重编号”的性质还带来一个隐藏好处:被裁掉的位置可以物理释放(或卸载到 CPU/SSD),而不像”软屏蔽”类方案那样仍占着显存。压缩后 prompt KV 的显存占用被真正收回,这正是 8.2 倍内存收益的来源。
实现:Monkeypatch 与 HuggingFace 生态的”外科手术”
SnapKV 官方仓库的实现方式非常轻量:以 monkeypatch 的方式劫持 HuggingFace Transformers 中 Llama/Mistral/Mixtral 的 FlashAttention 前向函数(replace_mistral() / replace_llama() / replace_mixtral()),在 attention 内部插入压缩逻辑,模型其余部分一行不动。核心逻辑全部集中在 snapkv/monkeypatch/snapkv_utils.py 的一个类里,论文 Listing 1 的伪代码与之等价:
def update_kv(self, key_states, query_states, value_states, attention_mask, num_key_value_groups): # 只处理 prefill:此刻 key 长度 == query 长度(整段 prompt 一次前向) assert key_states.shape[-2] == query_states.shape[-2] bsz, num_heads, q_len, head_dim = query_states.shape if q_len < self.max_capacity_prompt: # prompt 不够长就不压缩 return key_states, value_states
# 1. 观察窗口 query × 全部 key,取 softmax 注意力权重 attn_weights = torch.matmul( query_states[..., -self.window_size:, :], key_states.transpose(2, 3)) / math.sqrt(head_dim) # (因果掩码只作用于观察窗口自身那块右下角, # 观察窗口 query 对前缀的位置天然可见) ... # 构造 window x window 的下三角掩码并加到右下角块 attn_weights = nn.functional.softmax(attn_weights, dim=-1, dtype=torch.float32)
# 2. 投票:沿观察窗口 query 维求和(前缀部分),得到每头 L_prefix 长的得票向量 vote = attn_weights[..., -self.window_size:, :-self.window_size].sum(dim=-2)
# 3. 池化聚类后取 top-k(k = 容量上限 - 观察窗口长度) pool_vote = pool1d(vote, kernel_size=self.kernel_size, padding=self.kernel_size // 2, stride=1) indices = pool_vote.topk(self.max_capacity_prompt - self.window_size, dim=-1).indices
# 4. 抽出选中的前缀 K/V,与完整观察窗口 K/V 拼接成压缩缓存 k_past_compress = key_states[:, :, :-self.window_size, :].gather( dim=2, index=indices.unsqueeze(-1).expand(-1, -1, -1, head_dim)) v_past_compress = value_states[:, :, :-self.window_size, :].gather(...) key_states = torch.cat([k_past_compress, key_states[..., -self.window_size:, :]], dim=2) value_states = torch.cat([v_past_compress, value_states[..., -self.window_size:, :]], dim=2) return key_states, value_states几个值得注意的工程细节:
- 压缩只触发一次。
update_kv在 prefill 那一次前向里被调用(此时 key 与 query 等长),压缩后的 KV 通过past_key_value.update(...)存入缓存;此后的解码步 query 长度恒为 1,走标准的追加路径,update_kv的断言直接拦住——解码路径零改动、零额外开销。这也是”解码速度与输入长度无关”的实现基础。 - 掩码只做一小块。 因果掩码只需覆盖观察窗口 query 与观察窗口自身 key 之间的右下角 块(防止窗口内 query 偷看未来的窗口 token);窗口 query 对前缀的注意力天然合法,不需要掩码。代价是这次投票的 QK 计算不能用现成的 FlashAttention 融合核(它要的是完整因果掩码),仓库用显式
torch.matmul实现——好在它只占 prefill 计算量的极小部分。 - softmax 用 float32。 投票对数值精度比生成更敏感(要跨窗口求和),实现里特意把 softmax 提升到 float32 计算再转回原 dtype。
- 默认超参。 仓库默认
window_size=32、max_capacity_prompt=2048、kernel_size=5、池化方式avgpool;论文实验则按任务分别用 max 池化、kernel 5–13、窗口 16–64。这些都作为模型 config 暴露,改起来不需要动代码。 - 依赖面很窄。 官方 README 声明仅需
transformers>=4.36(实测 4.37)与flash-attn==2.4.0。仓库 issue 里有人问”不用 flash-attention 行不行”——因为劫持的是 FlashAttention 前向,无 FA 环境需要换用 SDPA 前向的劫持分支,属于集成时的常见摩擦点。
实验:压掉 92% 的 prompt KV 后还剩什么
LongBench:16 个数据集、4 个模型,1024 token 容量几乎无损
论文在 LongBench 的 16 个数据集(单文档/多文档问答、摘要、少样本、合成检索、代码补全六类任务)上评测了 4 个长上下文模型:LWM-Text-Chat-1M、LongChat-7B-v1.5-32K、Mistral-7B-Instruct-v0.2 与 Mixtral-8x7B-Instruct-v0.1。实验设置:max 池化、kernel 7、观察窗口 32,prompt KV 容量分别取 1024/2048/4096。这批模型的平均输入约 13K token——也就是说 1024 容量意味着平均压掉 92% 的 prompt KV,4096 容量压掉 68%。
结果(论文 Table 1):几乎所有模型、几乎所有任务上,1024 容量的 SnapKV 与全量 KV 基线差距都在误差范围内,部分任务甚至反超。以 Mistral-7B-Instruct-v0.2 为例(下表摘自论文 Table 1,数字为各数据集分数):
| 配置 | NrtvQA | HotpotQA | Musique | GovReport | MultiNews | TriviaQA | SAMSum | PCount |
|---|---|---|---|---|---|---|---|---|
| 全量 KV | 26.82 | 42.77 | 19.27 | 32.85 | 27.06 | 86.23 | 42.98 | 2.75 |
| SnapKV 1024 | 25.54 | 40.94 | 19.42 | 25.89 | 26.11 | 86.48 | 42.06 | 2.98 |
| SnapKV 4096 | 26.41 | 42.32 | 18.76 | 30.74 | 27.08 | 86.25 | 43.01 | 2.73 |
| H2O 4096 | 22.61 | 36.54 | 16.25 | 30.00 | 26.75 | 86.16 | 42.97 | 3.46 |
(列名缩写:NrtvQA=NarrativeQA、PCount=PassageCount;完整 16 列见论文 Table 1。)
两个值得细读的现象。第一,1024 容量下掉点最明显的是长摘要类任务:GovReport 从 32.85 掉到 25.89(摘要必须引用文档各处的细节,压缩最伤它),加到 4096 恢复到 30.74;Qasper 也类似。而问答、检索、代码类任务几乎不动。第二,SnapKV 用 1024 就显著胜过 H2O 用 4096:论文统计,Mistral 上 SnapKV-1024 在 16 个数据集中的 11 个上超过 H2O-4096。上表可见 H2O 在 NarrativeQA(22.61 vs 25.54)、HotpotQA(36.54 vs 40.94)、Musique(16.25 vs 19.42)上被拉开明显差距。原因正在于二者机制不同:H2O 的累计分数在解码中逐步形成、且一旦驱逐不可逆,对”生成前就该一次选好”的 prompt 场景并不合适;SnapKV 在拿到完整问题后一次性做全局选择,信息损失更小。
压力测试:单卡 A100 处理 38 万 token 上下文
论文用 LWM-Text-Chat-1M(一个上下文长达 100 万的 7B 模型)做压力测试:prompt KV 容量 1024、观察窗口 16、池化 kernel 5,把”大海捞针”测试的文档长度一路推到 38 万 token——这是单张 A100-80GB 在原生 HuggingFace 实现下能装下的极限。结果如图 6 所示:
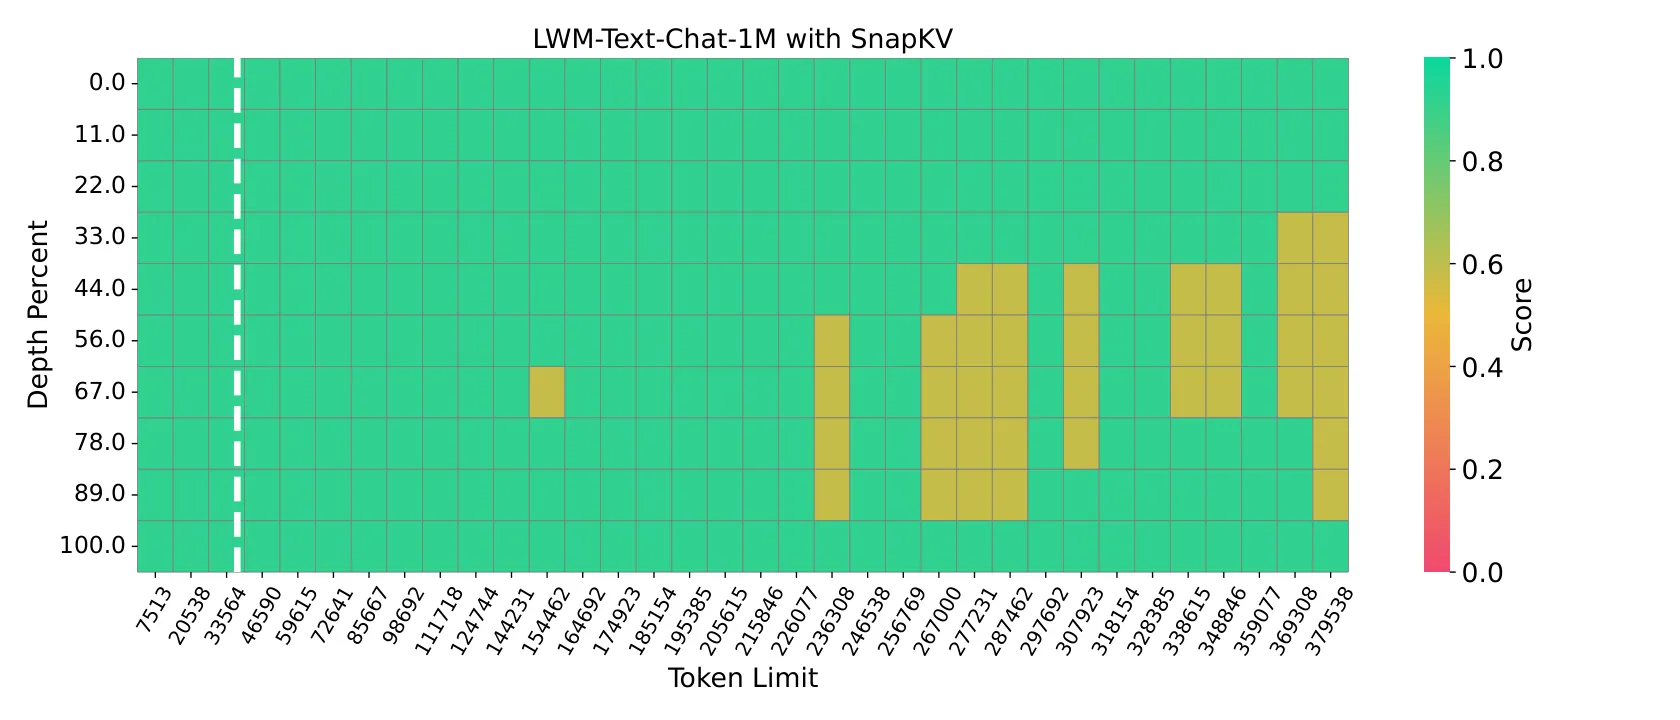
注意横轴的含义:不是”SnapKV 让模型理解了更长的上下文”,而是”压缩后显存只与容量有关,与输入多长无关”——基线 3.3 万 token 就 OOM 的同一套代码,加了几行压缩逻辑后能把 38 万 token 的输入装进同一张卡。针被埋在中段也基本能捞到,说明 1024 个被保留位置确实覆盖了”问题关心的那一处”。
解码速度与内存:与输入长度解耦
论文在 LWM-Text-Chat-1M 上对比了解码延迟(容量 2048,固定生成 512 token),结果如图 7:
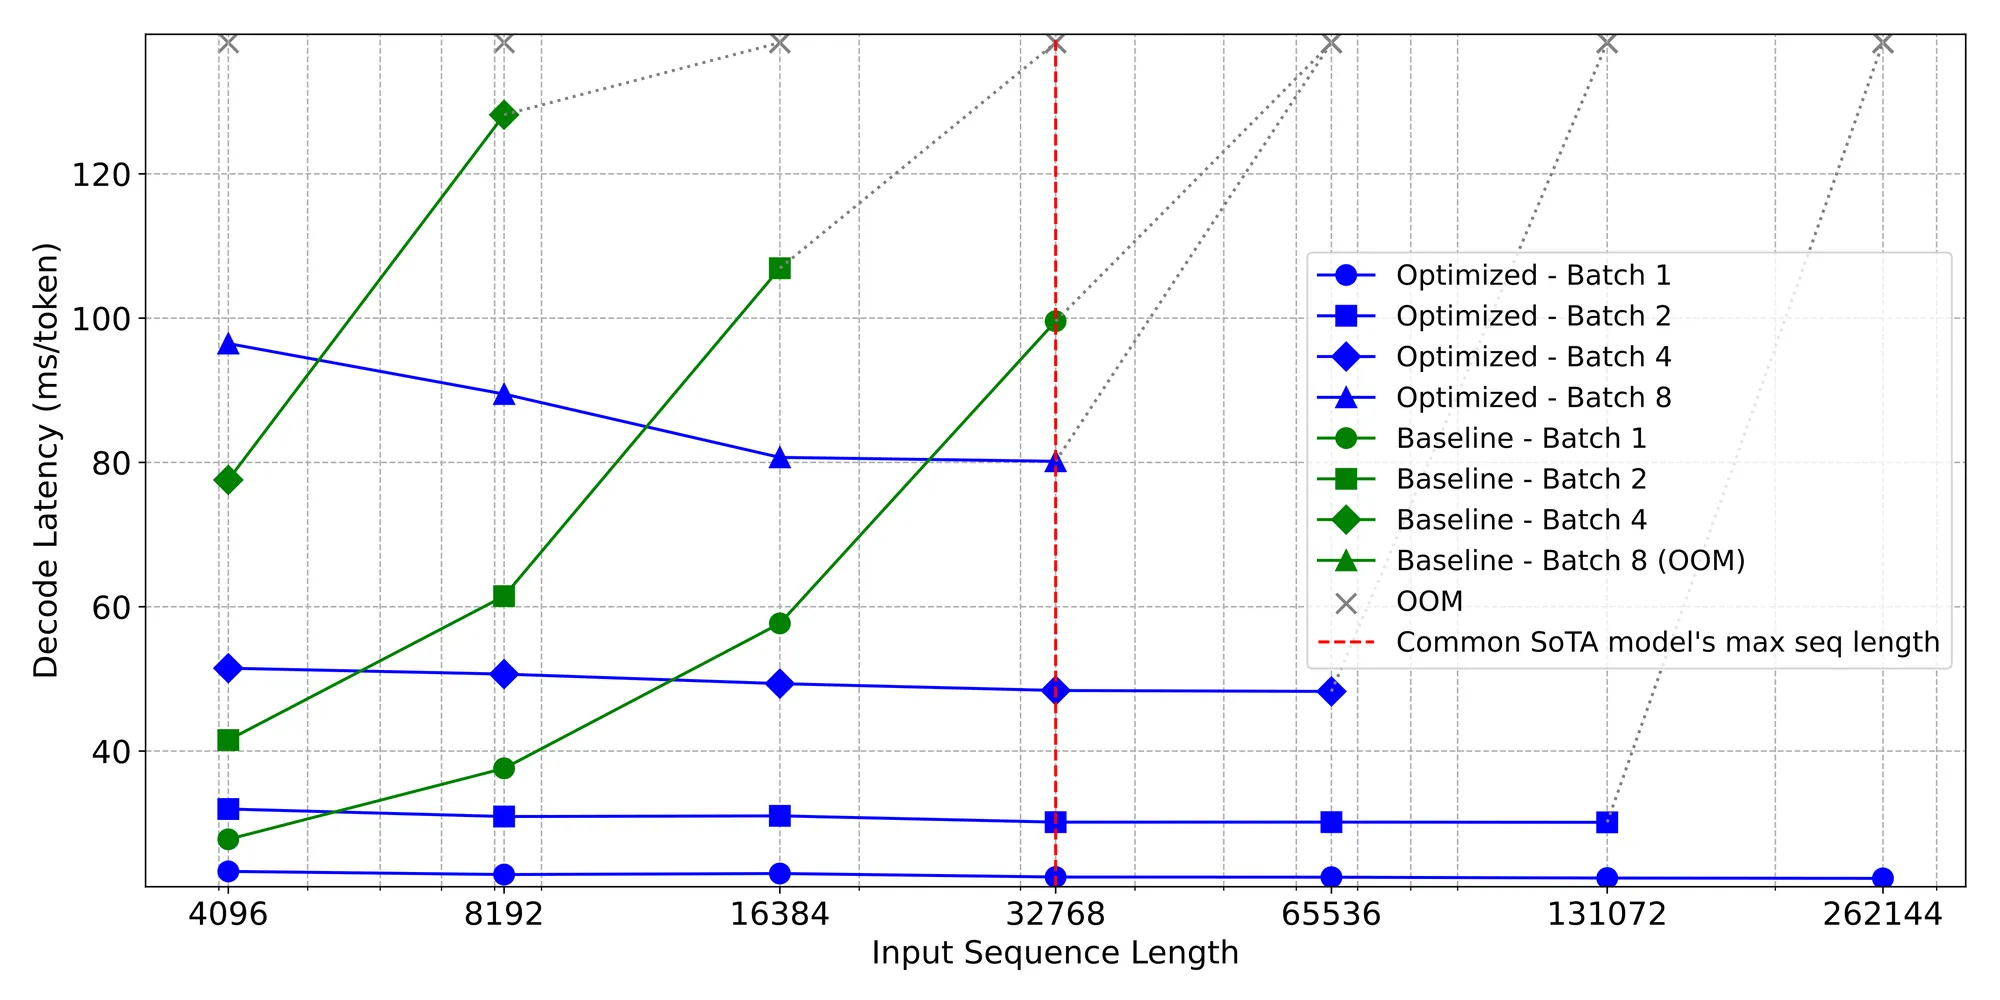
两条结论都在图中一目了然。速度上:解码每 token 的注意力扫描量从”全部 prompt KV”降为”固定容量”,于是基线那条随输入长度线性上涨的延迟曲线被拍平成常数——16K 输入、batch 2 时约 3.6 倍加速,输入越长加速比越大。内存上:batch 2 的基线在输入超过 16K 后 OOM,SnapKV 把同样配置撑到 131K——约 8.2 倍的可服务输入长度。论文附录还给出了 Mistral 上”输入处理时间 vs 生成时间”的分解:长输入下生成时间原本占支配地位(每步扫全量 prompt KV 的累积),压缩后两者在 100K 输入内达到平衡。
RAG 与 Command-R:真实生产形态的检验
论文用 Cohere 自家的 Command-R(35B,128K 上下文)做了最贴近生产的评估。配置:容量 4096、池化 kernel 13、观察窗口 64,对应 2 到 32 倍的 KV 压缩。
- 大海捞针(改进版):针对”捞针测试结果随具体上下文内容波动”的批评,论文把每档长度/深度下的上下文随机打乱 8 次取平均。总分 9.866 → 9.819,仅下降 0.5%,即使在 128K 长度(32 倍压缩)下也无退化。
- RAG 引文(citation):每个 prompt 配 100 篇相关文档(含正确答案与负样本),上下文 2 万到 4 万 token,用 F1 衡量是否成功引用含答案的文档。压缩 5 到 10 倍后保留约 98.8% 的性能(-1.2%);端到端 RAG 流水线(检索 + 重排 100 篇后喂给模型)为 -2.1%。
- 生成质量与 lost-in-the-middle:在 bioasq 数据集上分别采样 30/100/200 篇文档,把正确答案分别放在开头、中间、末尾测试。结果:30 篇平均 -1.7%、100 篇平均 -0.6%、200 篇平均 +5.4%——不仅没有出现”信息在中间就变差”的经典病态,文档越多反而越优于基线。论文给出的解释与 H2O 实验中的”驱逐正则化”现象同源:大量负文档本身是噪声,压缩把它们滤掉后,模型的注意力被迫更聚焦在相关文档上。
与投机解码组合:1.3 倍叠加加速
SnapKV 的论文还展示了一个常被忽略的组合视角:KV 压缩与投机解码(speculative decoding)天然互补。投机解码的验证阶段要把多个草稿 token 并行前向,长序列下每步的 QK 平铺与 KV 扫描开销会显著拖慢验证步——序列越长,投机解码的收益衰减越厉害。论文把 SnapKV 与 Medusa(多 token 并行解码框架,详见论文引用的 Medusa 论文)叠加:prompt KV 恒定后,验证步的注意力成本不再随输入长度增长。实验里,10K 长度的序列上,SnapKV + Medusa 比纯 Medusa 快 1.3 倍、比原生解码快 2.2 倍——两种加速机制一个省”每步读多少 KV”,一个省”每步生成多少 token”,正交可乘。
局限与边界
SnapKV 的论文在讨论部分对自己的边界交代得很清楚,这里结合后续研究的发现展开:
它只压缩 prompt,不管解码中新生成的 KV。 压缩发生在 prefill 之后、解码开始之前的一次性快照,解码过程中追加的 KV 仍然线性增长。因此 SnapKV 解决的是”超长输入 + 有限输出”的场景(RAG、文档问答、agent 单轮任务),不是无限流式对话场景——后者的 KV 增长来自输出侧,需要叠加 H2O/StreamingLLM 这类解码期策略。论文没有做这种组合实验,但从机制上看二者正交(一个管输入、一个管输出)。
投票是”向后看”的,选错不可逆。 被裁掉的 token 在整个生成阶段都无法恢复。如果一个关键信息从未被观察窗口的注意力显著命中(例如针埋在中段、且与问题没有直接的注意力路径),它就会被当作”不重要”丢弃——这与 H2O 驱逐的固有风险同源(详见 H2O 完全拆解 的局限一节),只是决策从”每一步”变成了”一次”:一次性决策错了,整个生成都基于残缺的上下文。论文的捞针实验显示 14 万 token 内表现良好,但 LongEval-Lines 的消融同样诚实:答案位置推到 20K 之后,即使有池化,检索准确率仍明显下滑——压缩对”最远端、最隐蔽信息”的召回存在硬上限。
观察窗口的”尾部假设”在多指令场景会失效。 观察窗口位于 prompt 末尾,隐含假设是”决定看哪里的指令在末尾”。系统提示词较长、或同一上下文里有多条指令时,末尾窗只能反映最后一条指令的意图,更早指令关心的位置可能拿不到票。ACL 2026 的论文 The Pitfalls of KV Cache Compression 在 IFEval 多指令评测(Llama-3.1-8B、Qwen2.5-14B,统一在 KVPress 框架里对比 StreamingLLM/SnapKV/H2O/TOVA/K-Norm)中发现:压缩会结构性放大”系统提示泄露”等指令跟随失败,且不存在普适的”安全压缩比”——不同方法、不同模型的退化曲线互不一致。该研究提出的缓解措施(给关键指令加白名单、均衡驱逐策略)对所有驱逐类方法都适用,SnapKV 也不例外。
它不加速 prefill,也不扩展模型能力。 投票计算发生在 prefill 阶段,prefill 本身依旧要处理完整输入(这部分计算没有被跳过),因此首个 token 的延迟(TTFT)没有改善;收益从解码的第一个 token 才开始兑现。同样,压缩不会让模型突然”理解”原本理解不了的长上下文——它能做的是把显存瓶颈移开,让模型在原有能力范围内处理更长的输入。
超参没有自动化的选择方法。 容量、池化 kernel、观察窗口长度都需要按模型与任务调(论文经验值:kernel 5–13、窗口 16–64、容量 1024–4096),论文没有给出自动调参方案;kernel 太小聚类失效、太大则压缩粒度变粗,观察窗口过长会挤占容量预算(它永远全额保留)。
影响与定位:补上”输入侧压缩”这块拼图
把站内拆解过的 KV Cache 技术放在一张场景表里,SnapKV 的位置就很清晰:
| 技术 | 管理哪段 KV | 时机与机制 | 站内文章 |
|---|---|---|---|
| PagedAttention | 全部 KV | 分页块表消灭内存碎片 | PagedAttention 完全拆解 |
| GQA / MLA | 每 token 的 KV 体积 | 架构层共享/低秩压缩 | GQA / MLA |
| KIVI | KV 存储精度 | 2-bit 量化,K 按通道、V 按 token | KIVI 完全拆解 |
| H2O | 解码期全部缓存 | 每步贪心驱逐低分 token | H2O 完全拆解 |
| StreamingLLM | 解码期输出侧 | sink + 滚动窗口,位置重编号 | StreamingLLM 完全拆解 |
| RadixAttention | 共享前缀 | 前缀树复用,让相同前缀只算一次 | RadixAttention 完全拆解 |
| SnapKV | prompt(输入侧) | prefill 后一次性投票压缩,观察窗口全保留 | 本文 |
SnapKV 的贡献是把 KV Cache 压缩的讨论从”生成时怎么扔”推进到”生成前怎么选”:决策时间点提前、但信息一分不少。这个定位让它成为后续工作的公共基线——2025 年之后的 KV 压缩论文几乎都会在 LongBench 或 IFEval 上与它对表;对推理模型的专门评估也证实了它的观察窗思路可以外推:Hold Onto That Thought(arXiv 2512.12008)把观察窗口滑入解码阶段,提出 SnapKV-Decoding 扩展,在推理类模型(思维链长、长程依赖强)的压缩评测中,SnapKV-Decoding 与 H2O 一起在所有预算与数据集下胜出、且以 SnapKV-Decoding 表现最突出——注意力驱动的选择比”只看最近”的位置策略更能保住推理链条上的关键中间步骤。
小结
SnapKV 的故事可以压缩成一条完整的推理链:观察到”prompt 末尾的指令 token 决定注意力分布”(意图层面的规律)→ 验证该分布在整个生成期间稳定(可以做一次性决策)→ 用观察窗口投票选出每头的重要位置(决策提前到生成前)→ 用池化把单点选择升级为簇选择(保住复制补全所需的连续上下文)→ 在 RoPE 之后截断拼接(位置编码零改动)→ 用 monkeypatch 把整个算法压成几十行代码(工程上开箱即用)→ 用 LongBench/38 万 token 捞针/RAG/Medusa 组合证明”压掉 92% 依然几乎无损、解码速度与输入长度解耦”。
它留给后续工作的心智模型是:KV Cache 里哪些 token 值得留,往往不是由缓存本身决定的,而是由”模型接下来要回答的问题”决定的——而问题在生成开始前就已经躺在 prompt 末尾了。SnapKV 用 32 个 token 的观察窗口证明了这一点:找对”问问题的人”,几万 token 的上下文可以被裁到千分之一而不丢失答案。它与 H2O 的驱逐、StreamingLLM 的流式稳定彼此正交,分别回答了 KV Cache 管理里三个不同的问题:输入太长怎么办、输出太长怎么办、如何让注意力持续稳定——SnapKV 是其中”输入侧”那块长期缺失的拼图。
参考资料
- SnapKV: LLM Knows What You are Looking for Before Generation(论文,arXiv:2404.14469)
- SnapKV 论文 HTML 版(arXiv v2,含全部图表)
- SnapKV NeurIPS 2024 会议版(Proceedings of NeurIPS 2024)
- GitHub: FasterDecoding/SnapKV(官方实现,monkeypatch 与 snapkv_utils)
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models(arXiv:2306.14048)
- Efficient Streaming Language Models with Attention Sinks(StreamingLLM,arXiv:2309.17453)
- LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding(arXiv:2308.14508)
- World Model on Million-Length Video and Language with RingAttention(LWM-Text-Chat-1M 出处,arXiv:2402.08268)
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads(arXiv:2401.10774)
- In-context Learning and Induction Heads(Olsson et al.,arXiv:2209.11895)
- The Pitfalls of KV Cache Compression(arXiv:2510.00231,ACL 2026,对 SnapKV 等五种压缩方法的多指令评测)
- Hold Onto That Thought: Assessing KV Cache Compression on Reasoning(arXiv:2512.12008,含 SnapKV-Decoding 扩展)
- Model Tells You What to Discard: Adaptive KV Cache Compression for LLMs(FastGen,arXiv:2310.01801)
- SnapKV: KV Cache 稀疏化,零微调加速长序列 LLM 推理(中文社区解读)
- SnapKV 中文解读(CSDN:SnapKV: LLM在生成内容之前就知道您在寻找什么)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放