


AdaRound 完全拆解:为什么四舍五入不是最优权重量化——软舍入与逐层重构(ICML 2020 经典)
引言:一篇把「四舍五入」变成学术问题的论文
AdaRound 出自 Qualcomm AI Research 的 Markus Nagel、Rana Ali Amjad、Mart van Baalen、Christos Louizos、Tijmen Blankevoort 等人,于 2020 年发表在 ICML(论文题目是 Up or Down? Adaptive Rounding for Post-Training Quantization,arXiv 编号 2004.10568)。在模型量化这个领域里,它的地位很特殊:之前所有做训练后量化(Post-Training Quantization,PTQ)的工作,都默认「把一个浮点权重变成离它最近的量化网格点」是天经地义的操作;AdaRound 是第一个严肃地质疑这一步、并给出完整理论分析与实用求解方案的工作。
如果你已经读过本站的 GPTQ 完全拆解、AWQ 完全拆解、LLM.int8() 完全拆解 这些文章,会发现在现代 LLM 量化里,「拿一小批校准数据、最小化逐层输出误差」几乎是无处不在的默认范式——GPTQ 在每层上用二阶信息选舍入方向,AWQ 在讨论哪些权重「显著」,SmoothQuant 在调整激活的量化难度。这套范式公认的源头之一,就是本文要讲的 AdaRound:它最早把「每个权重向上取整还是向下取整」当作一个有大量候选解的组合优化问题,并发明了「软舍入 + 逐层重构损失 + 退火正则」这套至今仍被沿用的求解框架。
本文会从最基础的最近邻舍入讲起,完整推导论文的动机分析,逐行解释目标函数里每一个项的来历,用论文的消融实验回答「为什么这样设计」,最后把 AdaRound 放回 2020 到 2026 年的 PTQ 谱系里,看它如何演化成 BRECQ、QDrop、OmniQuant 乃至 GPTQ 这些你更熟悉的名字。
背景:2020 年时 PTQ 能做到什么,做不到什么
训练后量化:不想重训的部署方
量化的动机不必多讲:把权重从 FP32 压到 8 bit 乃至 4 bit,内存占用直接除以 4 或 8,访存带宽压力同步下降,在带宽受限的解码场景里几乎线性转化为加速。但怎么压,在 2020 年有个明显的分野:
- 量化感知训练(Quantization-Aware Training,QAT):把量化噪声塞进训练过程,让网络学着抵抗它,效果最好,但要重新训练模型、调超参,成本高。经典代表是 Jacob 等人的整数算术推理工作(CVPR 2018)以及 LSQ 这类可学习步长方法。
- 训练后量化(PTQ):拿到一个已经训练好的模型,直接做转换,几分钟到几小时完成,不需要训练数据标签,也不需要动训练流程。部署方(尤其是手机、边缘设备上的推理引擎)几乎必然倾向这条路。
在 2020 年,PTQ 的「舒适区」是 8 bit。做到 4 bit 权重呢?主流结论是必须逐通道甚至逐层地重新微调(per-channel retraining),否则精度崩掉。AdaRound 出现之前,业内普遍把「4 bit 权重 + 不重训」视为禁区。这篇论文把这层窗户纸捅破了。
PTQ 的四件套与一个被忽略的环节
把一个浮点权重矩阵 量化到低比特,工程上其实要回答四个问题:
- 网格(grid):量化值落在哪些点上?均匀网格还是非均匀?对称还是带零点偏移?
- 范围(clipping):权重的截断上下界 取多少?min-max 取满范围会被离群值拉伸,按 MSE 找最优截断点更好(如 Choukroun 等人的 OMSE 工作、Banner 等人的 ACIQ)。
- 误差补偿:量化引入的统计偏差怎么消?Nagel 等人的 DFQ(ICCV 2019)提出权重均衡化(weight equalization)+ 偏差校正(bias correction)。
- 舍入(rounding):浮点权重落在两个网格点之间时,取上面那个还是下面那个?
2020 年之前的所有 PTQ 工作,在前三件事上花了大量力气,唯独第四件事被当成了免费的默认操作:一律四舍五入到最近(Round-to-Nearest,RTN)。这看起来毫无争议——每个权重都取离自己最近的网格点,每个权重的量化误差都最小,四个环节里它最不该出问题。AdaRound 的全部故事,就是从「这里恰恰有问题」开始的。
先建立记号。对称均匀量化下,RTN 定义为:
其中 是量化步长(scale),、 是截断整数阈值(对应量化范围的最小/最大整数码值), 表示四舍五入取整, 把结果限制在 内。如果去掉取整的「四舍五入」而只用向下取整 或向上取整 ,就得到 floor 舍入和 ceil 舍入。每个权重量化后只有两个候选值——它所在量化区间的下界和上界(落在截断边界外的权重只有一个候选,即被 clip 的端点)。
反直觉现象:只动第一层的舍入方向,精度差了 40 个点
AdaRound 论文先用一个极简实验立住了「舍入方向真的重要」这个论点。实验设置:把 ResNet18 的第一层权重单独量化到 4 bit(其余层保持全精度),评估 ImageNet 验证集准确率,然后尝试不同的舍入方案。结果见表 1(论文 Table 1):
| 舍入方案 | ImageNet 准确率(%) |
|---|---|
| 最近邻(RTN) | 52.29 |
| 全向上取整(Ceil) | 0.10 |
| 全向下取整(Floor) | 0.10 |
| 随机舍入(100 次均值 ± 标准差) | 52.06 ± 5.52 |
| 随机舍入(100 次中的最好一次) | 63.06 |
只量化一层就有几个值得玩味的结论:
- 全上/全下取整直接毁灭模型:0.10% 基本等于瞎猜。这说明量化误差的方向不是无关紧要的——当所有权重误差同号时,它们沿输入方向的贡献系统性叠加,而不是随机抵消。随机误差是 量级的累积,系统误差是 量级的累积。
- 随机舍入(每个权重独立地以 50% 概率取上或取下)平均并不比 RTN 好,说明 RTN 确实是个不错的起点——随便乱改方向,平均而言没有收益。
- 但随机舍入 100 次里有 48 次超过 RTN,最好的那次达到 63.06%,比 RTN 高出 10.77 个点。也就是说:存在大量比最近邻更好的舍入组合,问题只是怎么把它们系统地找出来,而不是靠掷骰子。
一个 4 bit、单层的量化就能把精度在 52% 到 63% 之间摆布,这强烈暗示:对整网做 4 bit 量化时 RTN 造成的巨大损失(后面会看到 ResNet18 全网络 4 bit 权重 RTN 只有 23.99%,比随机初始化好不了太多),其中相当一部分不是量化本身不可避免的,而是「舍入选得不好」造成的。这给了 PTQ 一条全新的优化空间。
理论框架:为什么最近邻不是最优
把量化看成对权重的一个扰动
光有实验现象还不够,论文需要解释「为什么」以及「怎么找更好的解」。出发点是一个非常朴素的观点:量化就是把权重从 扰动到 ,其中 是每个权重到其量化值的位移。如果模型本来已经训练到收敛、处于损失曲面的极小点附近,那么任务损失 对这个扰动的响应可以用泰勒展开近似:
这里 是任务损失对权重的期望梯度, 是期望 Hessian,期望都相对于数据分布 取。两个符号的含义要分开讲: 告诉你损失曲面在 处朝哪个方向倾斜, 告诉你曲面在 处的曲率——也就是各个权重扰动相互之间如何影响损失。一阶项(梯度)我们已经知道该怎么处理:网络收敛后 ,把它丢掉。于是量化带来的损失增量近似为纯二次型:
量化误差 落在损失曲面上的「成本」,由权重间的二阶交互决定。这就是「为什么舍入是组合问题」的理论入口:对角项 只关心每个扰动的大小——取最近点(扰动最小)当然最优;非对角项 同时关心两个扰动的符号——两个扰动异号且 时,交叉项是负的,等于说一个权重的量化误差可以被另一个权重的量化误差「部分报销」。RTN 逐权重独立地最小化每个 ,完全看不见非对角项,于是在存在显著相互作用的层里系统性次优。
论文里的数字反例
论文给了一个两权重玩具例子。设 ,且
则扰动引起的损失增量正比于
前两项来自对角,只与扰动大小有关,RTN 在这两项上确实最优;但交叉项 里,符号相反的两个扰动反而降低损失。用一组具体数字走一遍:假设 RTN 下两个权重各自的量化位移(取最近点产生的误差)是 、,则成本为 。现在把第一个权重故意舍到更远的那一侧,位移变成 (方向与 相反、幅度翻倍),成本变成 ——权重 1 的单项误差多了 0.03,但符号相反的交叉项贡献了 ,整体反而省了 0.06。这就是「四舍五入不是最优」的微观机制:当 的非对角项显著时,最小化整体二次型的解不是逐元素最优的解,需要在各项之间做权衡。QUBO(二次无约束二元优化)这个名词此时登场:每个权重只能取两个值(floor 或 ceil),等价于一个二元变量(0 或 1),目标函数是这些二元变量的二次型——正是组合优化文献里研究了几十年的 QUBO 问题(二元二次规划,NP-hard 那一族)。
为什么 Hessian 版本不可行
于是问题被精确地定义为:找到使 最小的舍入组合。论文图 1(下方)验证了这个二次型代理与真实任务损失的吻合度:对 ResNet18 第一层 4 bit 量化随机采样 100 个舍入向量,横轴是式中的二次型成本,纵轴是模型真实验证准确率,可以看到清晰的单调相关——代理损失确实能预测哪个舍入方案更好。
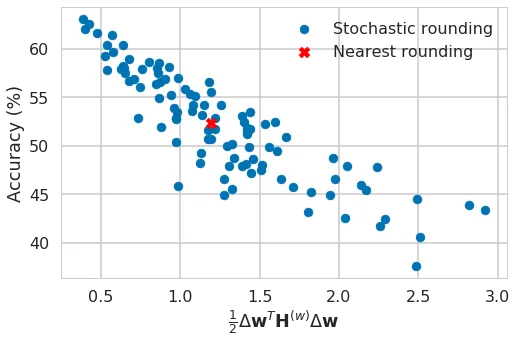
(图源:AdaRound 论文 Figure 1,arXiv:2004.10568。100 个随机舍入向量,仅量化 ResNet18 第一层至 4 bit。)
但直接优化这个目标有两个致命问题:
- Hessian 算不动: 是 的矩阵, 是权重总数。单层权重动辄百万级, 的内存和计算在 2020 年的显卡上完全不可行。而且这个 Hessian 是任务损失对所有权重的二阶导,计算它需要把二阶导数反向传播过后续所有层(用 Botev 等人的广义 Gauss-Newton 那套 Kronecker 分解也只能缓解、不能消除)。
- NP-hard:即使 Hessian 给得出来,QUBO 求解也是组合爆炸。论文附录里用两种 QUBO 求解器(交叉熵法与 D-Wave 的 qbsolv)做过对比(附录表 10):交叉熵法把第一层精度从 RTN 的 52.29% 提到 68.62 ± 0.17%,但耗时数小时级别(论文正文说从「几小时」量级);qbsolv 这类通用 QUBO 求解器则只有 41.98 ± 3.04%——比 RTN 还差。论文把差异归因于初始化:交叉熵法可以从 RTN 附近的分布出发采样(把「好的解聚集在 RTN 邻域内」这个先验注入搜索),通用求解器 API 做不到这一点,而随机舍入的平均水平(52.06%)恰恰说明没有先验的搜索就是在浪费算力。这个「从最近邻附近出发」的教训后来被几乎所有 PTQ 方法继承——包括 GPTQ 的逐列贪心也是以 RTN 解为起点逐个修正的。
所以论文要做两件事:把不可算的目标化简到可算,再把可算但离散的目标松弛成可微的。
从全局 Hessian 到逐层局部 MSE:目标函数的可算化
两步近似
第一步处理 Hessian 的结构。对全连接层,设 是第 层的预激活,则任务损失对同一层内两个权重 、 的二阶导可以写成(细节见论文公式 14–16):
其中 是 Kronecker 积, 是任务损失对预激活的 Hessian。这个分解说明权重的 Hessian 由两块构成:输入的二阶矩 (数据统计,可以算)和预激活 Hessian(需要穿透后续层的二阶反向传播,很难算)。论文做两个假设把它拆掉:
- 假设 是对角阵;
- 再假设对角元与输入样本无关(对每个输出单元是常数 )。
在这两个假设下,权重间的交叉交互被压成「同一输出行内、通过共享输入产生的交互」,不同输出行之间完全解耦,目标分解为对每个输出通道独立的小问题(卷积层的完整推导见论文附录 B,结论相同:每个输出通道独立):
这个式子值得停下来读三遍,因为它就是 AdaRound 全部实践的起点:最优舍入就是让「量化权重矩阵与原始权重矩阵的输出之差」的期望平方(预激活 MSE)最小。注意它不再需要任何后续层的信息,也不再需要任务损失——只剩本层权重、本层输入统计。
为什么「局部 MSE」是能力范围内最好的目标
细想一下,这个化简其实是从「最优但算不动」到「次优但能算」的退让,论文的高明之处在于给出了退让的边界论证:
- 反向推演:如果完全不假设任何后续层信息,那么本层输出的 MSE 就是你唯一能控制的量——后续层只会放大或缩小这个误差,但任何不知道后续层结构的优化者都无从利用这种放大。所以在「不知道网络其余部分」的约束下,最小化逐层输出 MSE 是理论上能做得最好的(论文原文的表述是 this is the best we can do)。
- 这个目标其实不新鲜:神经网络压缩里的重建损失(如 He 等人的通道剪枝工作、Zhang 等人的加速方法)和若干量化工作都用过类似的形式。AdaRound 的贡献不在于发明这个损失,而在于从任务损失的泰勒展开一步步把它推导出来,从而明确知道代价是什么、假设在哪里,以及后续(BRECQ、QDrop)从哪个假设下手改进。
- 表 2 的消融验证了这套近似几乎不损失质量:只量化 ResNet18 第一层时,用真实任务损失 Hessian 优化(式 13 的 QUBO)得 68.62%,直接优化局部 MSE(式 20)得 69.39%,连续松弛版 69.58%——逐步近似不仅没变差,反而因为优化得更充分而略好。
AdaRound 主体:软舍入、退火与逐层重构
从离散二选一到连续插值
局部 MSE 目标(式 20)虽然可算,但舍入决策仍是离散的:每个权重只能取 floor 或 ceil。AdaRound 的核心工程贡献,是把「向上还是向下」这个离散选择松弛成一个连续的、可微的插值问题。
做法:给每个权重配一个与权重同形状的连续优化变量 ,定义量化权重为
其中 是任意可微的「软舍入」函数。理解这个式子的关键是: 是量化区间下界的整数码值, 则决定了权重落在这个区间内的具体位置—— 时量化值就是下界(等价于向下取整), 时是上界(等价于向上取整),中间的 对应一个「悬在区间中间」的非法量化值。优化收敛后让所有 都回到 0 或 1,软量化就退化成真正的舍入。于是离散的组合搜索变成了对 的连续梯度优化:
第一项是数据依赖的重构误差(Frobenius 范数的平方,逐样本求和再平均),第二项 是正则项,负责把 往端点推。这是「软量化连续优化」的通用配方,后来的可学习量化方法(QAT 里的 STE 也是这个思路的亲戚)都能在这张骨架上找到对应物。
整流 sigmoid:一个被很多复现忽略的细节
选什么函数?论文用的是 整流 sigmoid(rectified sigmoid,来自 Louizos 等人的 L0 正则化论文):
其中 是标准 sigmoid。为什么要做这个拉伸再截断的处理?普通 sigmoid 的问题在于两端饱和:当 趋近 0 或 1 时,梯度 趋近 0。而正则项恰恰要把 推向 0/1 端点——越接近端点梯度越小,优化就越难真正抵达端点,最终 会停在端点附近、硬舍入(hard rounding)时产生额外误差。整流 sigmoid 把 sigmoid 的输出先拉伸到 再 clamp 回 :由于在 处对应的内部值是 (sigmoid 输出约 0.045,还没饱和),在 处对应内部值 (sigmoid 输出约 0.955,也还没饱和),两端都保留了非零梯度,优化器能把变量干净地推到端点。论文表 3 里,整流 sigmoid + 显式正则(69.58/66.56)一致地好于普通 sigmoid + 显式正则(69.58/66.25)与普通 sigmoid + 温度退火(69.31/65.22),差距虽小但跨模型稳定。
退火正则:先自由探索,后收敛二值
正则项选什么形状?论文用:
逐项看:当 时 ,该项取最大值 1——正则在区间正中间惩罚最重;当 或 时该项趋近 0——端点无惩罚。指数 控制惩罚曲线的形状,如图 2 所示。
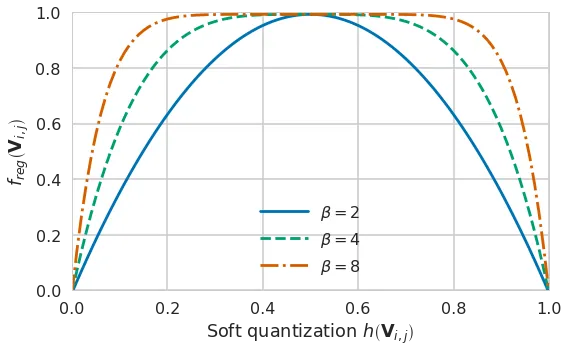
(图源:AdaRound 论文 Figure 2。横轴为 h,纵轴为对应 β 下的正则项取值;β 从大退火到小。)
的作用方向值得细讲,因为它和直觉相反——早期用大的 β,后期用小 β:
- 很大时(如 20), 在中间区域几乎处处为 0,正则项几乎恒等于 1,是一条平坦高原:对 的梯度趋近于零,等于正则「罢工」, 可以自由移动去最小化重构损失;
- 很小时(如 2), 是开口向下的碗形(准确说是两端为 0 的谷形),处处有指向端点的梯度,把 强力推向 0/1。
所以退火计划是:优化前期让重构损失主导、舍入位置自由调整(甚至允许暂时停在区间中间),后期正则逐步收紧,把变量压成真正的二元选择。AIMET 参考实现里具体的退火安排是:前 20% 迭代为 warm-up 期(正则完全不生效,等价于 ),之后 按余弦从 20 退火到 2,正则权重 (论文正文只给了定性描述,这些数值来自官方实现)。这套「先松弛、后退火、再硬化」的流程与 Hopfield 网络求解组合优化的经典路线同源——论文也明确承认 AdaRound 是 Hopfield 类方法的一个实例,退火温度在这里换成了 。
优化结果:多数权重其实「故意舍错」
论文图 3 展示了优化前后 的分布,这是理解 AdaRound 收益来源最关键的一张图。
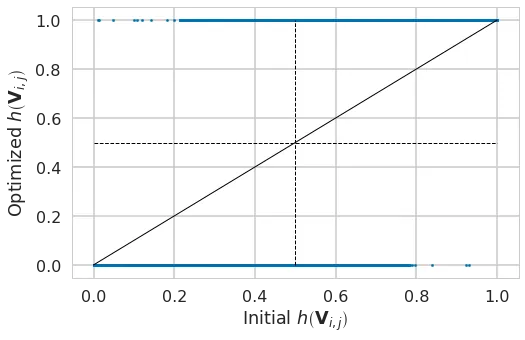
(图源:AdaRound 论文 Figure 3。横轴为优化前(对应浮点权重位置),纵轴为优化后(软舍入变量收敛值);点收敛到 0 或 1 两条水平线上。)
图里可以看到两个事实:其一,所有点最终都落在 与 两条线上——正则确实把所有 收敛成了硬性的 0/1 决策;其二,落在左上象限(优化前接近下界、优化后选上界)和右下象限(优化前接近上界、优化后选下界)的点占比可观——相当一部分权重在 AdaRound 看来应当「故意」舍向更远的那一侧。这正是 RTN 与 AdaRound 的本质差别:RTN 永远选近的一侧,AdaRound 会为了输出重构而选择远的一侧来与同层其他权重的误差相互补偿。这也解释了为什么随机舍入偶尔能大幅超越 RTN——好的解空间里充满了「系统性偏离最近邻」的组合,AdaRound 只是用可微优化把它们找了出来。
为什么不用 STE:软量化的归纳偏置
一个自然的替代方案是直通估计器(Straight-Through Estimator,STE):直接对硬舍入后的 求梯度、把取整操作当恒等函数回传,这也是 QAT 的标准做法。论文做了对比(表 5,全网络 4 bit):STE 优化得 66.63%,AdaRound 得 68.60%。
为什么更「自由」的 STE 反而差?两种方法的搜索空间不同:STE 允许量化权重在网格之间自由滑动(每次更新都可能落回区间中间的非网格值,靠不断前推逼近某个隐含解);AdaRound 把变量限制在「每个权重最终二选一」的软版本上。论文的解释是 STE 的梯度有偏——把取整当恒等函数回传,等于用「量化点邻域外的梯度」冒充「量化点处的梯度」,在这个每一步都要落在网格上的受限问题里,偏置伤害更大;而 AdaRound 的解空间形状(每个权重独立选 0/1,正则逼到端点)本身就是对问题结构的正确编码——一个有益的归纳偏置。另外注意 STE 得到的「区间中间的权重」在部署时仍要做硬舍入,这会在优化目标与实际部署之间引入不一致,而 AdaRound 的软变量在优化结束时已经精确落在端点,天然一致。这个对比也顺带澄清一个常见误解:AdaRound 的「可学习」并不等同于 QAT——它不改动任何浮点权重数值、不触碰任务损失、只用无标签数据做前向,学的是每个权重「向上还是向下」这个决策本身。
逐层顺序优化与非对称重构
前面所有目标都假设只优化一层。整网量化时,AdaRound 按层从前到后逐个优化,前一层优化完、硬舍入定型,再优化下一层。这里有个细节问题:前面层被量化后,输入到当前层的激活已经带着误差漂移,如果还拿原始干净输入来算重构损失,就和实际部署状态不一致,深层误差会逐层累积。为此论文采用非对称重构目标:
其中 是「前面所有层都已经量化后」实际到达本层的输入, 是激活函数, 是参考支路(原始浮点权重作用在输入上得到的本层输出)。两条支路的输入来源不同,这正是「非对称」的含义:参考支路 跑在干净路径上——本层及前面各层的权重都是原始浮点值时到达本层的输入 ,产出理想输出 ;被优化支路跑在部署路径上——输入 是前面各层硬舍入定型后实际到达本层的数据,前层误差已经沉淀其中,权重则换成软舍入的 。两路输出过激活函数后做差,优化器要同时补偿本层权重的舍入误差与前层量化造成的输入漂移;激活函数 的形状也被纳入(ReLU 会把负侧误差直接截掉,损失对正负输出不再对称)。表 4 的消融量化了每一步的收益:基础逐层目标 66.56% → 换成非对称重构 68.37% → 加上激活函数 68.60%。在 ResNet18 上 2 个点的提升,对 4 bit PTQ 是相当可观的。
把整章合成算法流程(伪代码,省略批维度与卷积/全连接的差异):
输入:预训练模型 W(1..L),校准集 D(几百张未标注样本,论文默认 1024 张)输出:量化网格 {s(l), n(l), p(l)} 与每层硬舍入后的权重
1 对 l = 1, 2, ..., L: # 按前向顺序逐层2 确定 scale s(l)(先于舍入优化,最小化权重量化 MSE)3 用 D 前向收集:干净输入 x 与参考输出 f_a(W(l) x) # 来自浮点参考路径4 以及量化前缀输入 x̂(前层已定型) # 来自部署路径5 初始化 V ← 使 h(V) 对应 RTN 位置 # 从最近邻附近出发6 对 iter = 1, ..., 10000: # Adam,batch 327 W̃ ← s(l)·clip(⌊W(l)/s(l)⌋ + h(V), n(l), p(l)) # 软舍入权重8 loss ← ‖f_a(W(l)x) − f_a(W̃ x̂)‖² + λ·Σ(1−|2h(V)−1|^β)9 β 按余弦退火(前 20% 迭代为 warm-up,正则不生效)10 V ← V − lr·∇_V loss11 硬舍入:h(V) 取整到 {0, 1},该层权重定型,进入下一层论文报告这个流程跑完 ResNet18 全部层(默认 1 万次迭代/层)在单张 GTX 1080 Ti 上约 10 分钟——作为对比,同表里用交叉熵法解 QUBO 是数小时量级,连续松弛把优化时间从几小时压到了几分钟量级,还顺带小幅提升了精度。
设计空间与实验:每个选择都问过为什么
实验设置与消融总览
论文默认设置(后续消融都以此为准):BN 层先折叠进相邻卷积权重(消除 BN 对量化的干扰,这是 PTQ 的标准预处理);4 bit 对称权重量化,逐层(per-layer)共享一个 scale;scale 在优化舍入之前用「最小化权重量化 MSE」的方式定好;用 ImageNet 训练集中 1024 张未标注图片做校准;Adam 默认超参优化 1 万次迭代、batch 32;每张表报告 5 个随机种子的均值与标准差。ResNet18 全精度基线为 69.68%。
为什么逐层 scale 而不逐通道?2020 年时逐通道量化在推理硬件上支持差(很多移动端 NPU 只有逐层 scale),论文刻意在更吃亏的设置下比赛——这反而让后面「赢过逐通道竞品」的结论更有说服力。
网格(scale)的选择与舍入解耦
一个值得展开的消融是表 6:scale 用三种方式确定——min-max(按权重极值)、最小化权重量化 MSE、最小化预激活(输出)MSE——然后分别配 RTN 和 AdaRound:
| 定 scale 的方式 | RTN | AdaRound |
|---|---|---|
| min-max 网格 | 0.23 | 61.96 ± 0.04 |
| 最小化权重 MSE | 23.99 | 68.60 ± 0.09 |
| 最小化预激活 MSE | 42.89 | 68.62 ± 0.08 |
三个信息:其一,min-max 网格 + RTN 只有 0.23%——4 bit 一共只有 2^4 = 16 种码值,权重里的离群值会把步长拉得极大,绝大多数权重只能挤在少数几个码值上,这在 LLM 的激活离群值讨论(LLM.int8()、SmoothQuant)里是反复出现的主题,只是这里发生在权重侧;其二,即使给了最烂的网格,AdaRound 也能救回 61.96%——舍入优化与网格质量在一定程度上正交;其三,两个 MSE 网格下 AdaRound 结果几乎相同(68.60 vs 68.62),说明对 AdaRound 而言网格取哪种 MSE 目标不重要,论文因此统一用计算更省的权重 MSE 版本。
另一个问题:scale 和舍入方向能不能联合优化?论文明确说不能平凡地联合——步长一变,每个权重落在哪个区间都变了,QUBO 问题整体重写,两者不是两个独立的旋钮。这个「scale 与舍入解耦」的限制后来成了 OmniQuant 等工作的改进点(可学习的权重裁剪范围本质上是把 scale 也变成可学习量,见后文)。
与既有 PTQ 方法的对比
表 7 是论文的主结果(此表用了更充足的 2048 张图、2 万次迭代):
| 模型 | FP32 | RTN (4/32) | OMSE+opt(逐通道) | AdaRound (4/32) | AdaRound (4/8) |
|---|---|---|---|---|---|
| ResNet18 | 69.68 | 23.99 | 67.12 | 68.71 ± 0.06 | 68.55 ± 0.01 |
| ResNet50 | 76.07 | 35.60 | 74.67 | 75.23 ± 0.04 | 75.01 ± 0.05 |
| InceptionV3 | 77.40 | 1.67 | 73.66 | 75.76 ± 0.09 | 75.72 ± 0.09 |
| MobileNetV2 | 71.72 | 8.09 | — | 69.78 ± 0.05 | 69.25 ± 0.06 |
要点:
- ResNet18/50 的 4 bit 权重量化损失被压到 1 个百分点以内,直接兑现了摘要里「不重训、4 bit、掉点 <1%」的承诺;
- AdaRound 用的是逐层 scale,却赢过了用逐通道 scale 的 OMSE(ResNet18 上 68.71 vs 67.12)——舍入优化的收益大于量化粒度的收益,这个对比后来常被引用;
- MobileNetV2 是最难的案例(深度可分离卷积、权重分布窄,RTN 只剩 8.09%,同表里所有竞品在该行全部空缺——此前几乎没有方法能在它上面做好 4 bit PTQ,DFQ 的 4 bit 也只有 46.57%),AdaRound 用纯 PTQ 拿到 69.78%(FP32 为 71.72),把当时公认为 QAT 专属领地的模型拉回了 PTQ 射程;
- 最后一列是权重 4 bit + 激活 8 bit(W4A8)的结果,激活用观测 min-max 简单量化——掉点仍在一个点左右,说明 AdaRound 的权重优化在激活也量化时依然稳健(但它不负责激活量化的质量,激活侧的问题要等 SmoothQuant 一类方法)。
与 bias correction 的关系:同一个问题的两个解
DFQ 的 bias correction 是 AdaRound 最重要的对照组,值得单独一节,因为它能帮你理解「AdaRound 到底优化了什么」。量化改变层输出的期望:。bias correction 的做法是给层输出补一个常数偏置 ,把均值误差拉回来。论文 5.2 节指出,这个 的最优值恰好是同一个 MSE 问题的解:
也就是说,bias correction 与 AdaRound 在最小化同一个逐层输出 MSE——但 bias correction 把解限制在「每个输出通道一个常数」的极小子空间里,而 AdaRound 在每个权重上独立选择舍入方向,解空间大了几个数量级。表 8 的结果一目了然:RTN 23.99%,bias correction 救到 38.87%,AdaRound 68.60%。补偿「均值漂移」只是舍入问题的一个症状,AdaRound 治的是病根。
数据需求:到底需要多少、多「正宗」的数据?
AdaRound 需要校准数据(对比 DFQ 的 zero-data 路线),这是它最大的实用性顾虑,论文专门做了数据鲁棒性实验(图 4):
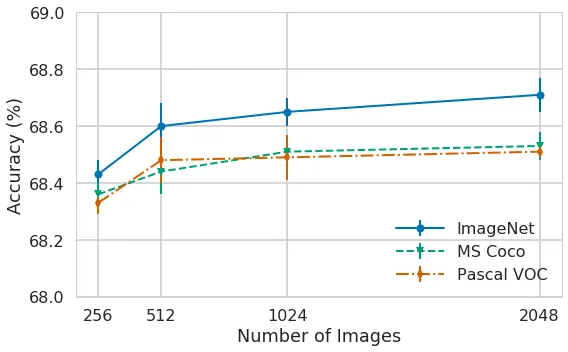
(图源:AdaRound 论文 Figure 4。左:不同校准图片数量;右:不同数据来源(ImageNet / Pascal VOC / MS COCO)。)
结论:256 张图就能把 ResNet18 4 bit 修到全精度 2% 以内;更宽松地说,用 Pascal VOC、MS COCO 这类域外数据(类别只是 ImageNet 的子集)优化,平均只比用 ImageNet 原训练集差不到 0.2%。对实践者的含义很直接:部署时从线上流量里随便抽几百张图、甚至用别的数据集,都足以完成校准——「未标注」的要求其实也几乎可以放宽成「没标签就行」,这在 2020 年之前并不明显。
论文还展示了语义分割上的泛化(DeepLabV3+ / Pascal VOC,表 9):4 bit 权重 + 8 bit 激活下 RTN 崩到 6.09 mIOU,DFQ 只能到 14.45,AdaRound 到 70.86(全精度 72.94),且只需 512 张校准图。AdaRound 对任务类型不挑——任何由卷积层或全连接层构成的网络都能套用,这也是后来它能被搬进 Transformer 世界的前提。
后续:AdaRound 如何在 LLM 量化时代延续
AdaRound 发表于 2020 年,彼时还没有人认真量化 175B 的模型。但 2026 年回看,它的思想脉络清晰贯穿了整个 PTQ 演进史,分成几条支线:
支线一:视觉模型上的直接深化(BRECQ、QDrop)
AdaRound 留下两个明确的改进接口:逐层独立的近似太粗(深层误差累积、跨层权重存在交互),以及只优化权重、不处理激活量化。沿着这两个口子:
- BRECQ(arXiv:2102.05426,ICLR 2021)把重构单元从单层升级为残差块(block),块内联合优化、用 Fisher 信息近似块输出 Hessian,第一次把 CNN 的 PTQ 推到 2 bit;
- QDrop(arXiv:2203.05740,ICLR 2022)处理激活量化:重构时随机「丢弃」一部分激活量化(dropout 式地随机关闭),证实了把激活量化纳入重构训练反而提升最终精度,把 CNN PTQ 的极限又往前推。
BRECQ 的块级重构几乎原封不动地成了后来 LLM PTQ 的标准配置——LLM 动辄几十上百层,逐层重构的误差在这么深的网络上根本压不住,OmniQuant 等 LLM 方法都是按「若干层为一个块」做重构的。
支线二:与 GPTQ 的对照——同一个问题的两种求解哲学
你在 GPTQ 完全拆解 里看到的技术,与 AdaRound 面对的是同一个问题:为每个权重选舍入方向、最小化量化带来的输出损失。两条路的哲学完全不同:
- AdaRound 走「数据 + 梯度」路线:把舍入松弛成连续变量,用小批量数据迭代优化。优点是通用、对目标函数形式不敏感;缺点是每层上万次迭代,对 175B 模型不可行。
- GPTQ(及其前身 OBS/OBQ)走「解析 + 二阶」路线:用 Hessian 逆的闭式公式逐列贪心决定哪个权重值得用更大的扰动去补偿。优点是单次前向内完成全部层、可扩展到千亿参数;缺点是需要能算、能近似的 Hessian 结构。
两者的共同祖先是对「权重量化误差必须放到输出/损失空间里衡量」的坚持——AdaRound 从数据分布出发,OBS 家族从损失曲率出发,最终在「局部重构 + 校准数据」这个实践层合流。这大概也是为什么 LLM 量化论文的 related work 里这两支总是并列出现。
支线三:AdaRound 配方在 LLM 时代的平移(OmniQuant 等)
严格说,AdaRound 本尊很少被直接用于 LLM(逐权重软舍入变量在千亿参数模型上参数太多,且 LLM 权重用 RTN + 逐通道/分组 scale 在 4 bit 已相当能打,见 AWQ 论文的基线讨论)。但它的「块级重构 + 可学习量化参数 + 退火/渐进优化」配方被 OmniQuant(ICLR 2024)平移到了 LLM 上:同样按块重构、同样在重建损失上加可学习项,只是把「可学习的对象」从舍入方向换成了权重裁剪范围(LWC,把 AdaRound 没能联合优化的 scale/clip 变成可学习)和等效变换(LET,把 SmoothQuant 的迁移强度变成可学习)。理解 AdaRound 之后再看 OmniQuant,会发现它几乎是 AdaRound 设计空间的一次系统平移——优化目标、块结构、数据需求全都对得上。
给读者的定位建议
如果按阅读顺序组织这几篇量化文章,AdaRound 应该放在 GPTQ/AWQ 之前读:它解释了你会在所有后来的论文里反复撞见的三个默认项——「为什么用校准数据最小化逐层输出误差」(因为舍入错误的正确度量在输出空间)、「为什么量化方法都从 RTN 附近开始搜索」(因为好的舍入解聚集在 RTN 邻域)、「为什么权重要逐个决定舍入方向」(因为权重误差经共享输入耦合,可以互相补偿)。而它没能回答的问题(激活量化怎么做、scale 怎么定、误差如何跨层积累)恰好是 SmoothQuant、AWQ、QuaRot 各自的出发点——把 AdaRound 放在这个序列的开头,量化这条知识线就闭合了。
局限与开放问题
- 仍需少量数据:对比 DFQ 的 zero-data 路线,AdaRound 依赖校准数据做前向。实验证明需求极宽松(几百张、域外也可),但「完全无数据」场景仍需别的方案。
- 逐层独立假设的代价:局部 MSE 推导依赖「忽略跨层交互」,深层网络里误差会积累。BRECQ 的块级重构部分修复了它,但「多大的块最优」至今没有理论答案(BRECQ 论文自己也承认块粒度是经验选择)。
- 只管权重:AdaRound 优化舍入时激活保持全精度;一旦激活也要压到 8 bit 以下,权重侧再优也会被激活噪声拖累。激活量化需要另一套工具(scale 迁移、旋转等),这是 AdaRound 边界之外的事。
- scale 与舍入解耦:论文明确放弃联合优化步长与舍入(步长改变会重写整个 QUBO)。这个缺口直到 OmniQuant 的 LWC 才被部分填上。
- 每层上万次迭代的成本:10 分钟量级对 ResNet 无妨,对百亿参数 LLM 是不可承受的——每层都要在完整模型上做前向收集激活。这也是 GPTQ 的解析路线在 LLM 时代胜出的现实原因之一。值得注意的是 AdaRound 的各输出通道彼此独立,天然可并行,但论文没有利用这一点做大规模并行验证。
- NP-hard 的阴影:2 的 N 次方个舍入组合意味着 AdaRound 只能保证找到良好局部解。图 1 里随机采样都能撞出比 RTN 好 10 个点的解,说明解空间里优质解密度不低,但「全局最优舍入长什么样」仍然是开放问题。
小结
AdaRound 用一句话概括:把「四舍五入」从免费操作升级为需要认真求解的组合优化问题,再通过软舍入把它变成能对校准数据做梯度下降的连续优化。它完整的论证链条是:量化误差对任务损失的影响由权重 Hessian 的二次型决定 → 非对角项让逐权重的最近邻选择系统性次优 → 两层近似把不可算的全局目标化简为逐层(甚至逐输出通道)的预激活 MSE → 整流 sigmoid 软舍入 + β 退火正则把离散搜索变成可微优化 → 逐层顺序执行并用「前层已量化的真实输入 + 激活函数」做非对称重构。
这套设计的每个环节——数据依赖、输出空间度量、软变量、退火、从 RTN 邻域出发——都被后来十年的 PTQ 工作反复继承,从 BRECQ/QDrop 到 OmniQuant,再到与你更熟悉的 GPTQ/AWQ 的对照。作为「数据依赖 PTQ」范式的源头文献,它值得每个想真正理解模型量化的人精读。
参考资料
- Up or Down? Adaptive Rounding for Post-Training Quantization(AdaRound 论文,ICML 2020)
- AIMET 官方文档:Adaptive Rounding(AdaRound)PTQ 技术页
- AIMET PyTorch API 文档:aimet_torch.adaround
- Qualcomm AIMET 开源仓库(AdaRound 官方参考实现所在)
- Data-Free Quantization through Weight Equalization and Bias Correction(DFQ,ICCV 2019)
- Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference(Jacob 等人,CVPR 2018)
- BRECQ: Pushing the Limit of Post-Training Quantization by Block Reconstruction(ICLR 2021)
- QDrop: Randomly Dropping Quantization for Extremely Low-bit Post-Training Quantization(ICLR 2022)
- OmniQuant: Omnidirectionally Calibrated Quantization for Large Language Models(ICLR 2024)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(NeurIPS 2023)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


