


DepthBench 完全拆解:10 种残差连接,谁真正解锁了有效计算深度
先说结论:深度不是层数,而是被真正用掉的串行计算
把一个 Transformer 从 24 层改成 70 层,只能说明它的架构深度增加了。若后半段层反复做相似的小修补,删掉、交换这些层几乎不影响输出,那么新增层数并没有等量变成计算能力。真正需要度量的是有效计算深度:在控制参数与数据预算后,更多顺序层是否仍能带来不可替代、前后依赖的计算。
Keyu Wang、Yangyi Huang、Jiale Kang 等人在 2026 年 9 月发布 DepthBench,把这个问题变成了一组受控实验。它在同一套 LLaMA 风格骨干、数据与预算下比较 10 种设计,并把模型从“浅而宽”逐步移到“深而窄”。论文给出的答案很鲜明:
- Pre-LN、Sandwich-LN、LNS、DeepNorm、KEEL 等单流设计大多会撞上深度墙,最佳宽深比仍落在 42.7—76.0 一带;
- HC 与 Full AttnRes 能把更多容量搬到深度,400M 实验一直推进到 70 层、宽深比约 9.1 仍未出现同样的转折;
- 这种差别不能只用“更稳定”解释。层间角距离、跳层因果分数与换层置换分数都显示,HC 与 Full AttnRes 的深层计算更异质、更依赖顺序;
- 更深并不等于更快。固定参数量后,投影 FLOPs 大致不变,但注意力、KV Cache、串行 kernel 数和硬件利用率会变差。
所以“有效计算深度是新的 scaling 维度”需要加一个前提:残差拓扑必须让早期计算以可区分的方式抵达后层,同时让后层拥有选择、重组历史信息的能力。DepthBench 测的不是“层越多越好”,而是哪些连接方法能让层数值得存在。
为什么 Pre-LN 能堆深,却未必能用深
一个 Pre-LN 子层可写为:
是进入第 个子层的残差流, 是注意力或前馈网络, 通常实现为 RMSNorm。恒等支路把 原样送到下一层,使梯度有一条不穿过复杂变换的短路;这正是 Pre-LN 比 Post-LN 容易训练深网络的重要原因。
问题也来自同一条短路。展开递推式可得:
残差流范数会随着累加不断增长,而 RMSNorm 把每层输入重新压回单位尺度附近。若深层产生的 相对已经很大的 越来越小,网络虽然仍能稳定前向和反向传播,却逐渐退化成“在一个巨大公共底座上叠加微小修正”。稳定可训练与有效利用不是同一件事:前者只要求数值和梯度不炸,后者要求新增层继续改变后续计算。
这也解释了为何单看最终 loss 不够。两个模型可能得到接近的 loss,但一个模型后半段层具有明确分工,另一个模型后半段近似可交换。DepthBench 因此同时问三个问题:
- 表征还在随深度改变吗?
- 跳过某层会改变后续层的更新方向吗?
- 交换两层的顺序会破坏结果吗?
只有三个答案共同指向“是”,架构深度才更接近有效计算深度。
统一坐标系:残差连接到底在决定什么
十种方法表面上有的改归一化、有的加注意力、有的扩展状态,但都可以放进两个坐标轴。
第一个轴是信息源。局部单流方法只读取上一层 ;多流方法读取同一深度上的 条残差流;跨层方法还能直接访问 中的若干历史状态。信息源越丰富,早期特征越不必经过层层相加才能到达深层。
第二个轴是混合权重。固定连接始终执行同一种加法或缩放;动态连接根据当前 token 和状态生成权重。动态并不自动更好,但它允许同一层对不同 token 选择不同历史路径。
| 家族 | 方法 | 可访问的信息 | 权重 | 核心作用 |
|---|---|---|---|---|
| 基线 | Pre-LN | 上一层单流 | 固定 | 保留恒等梯度通路 |
| 归一化变体 | Sandwich-LN、LNS、DeepNorm、KEEL | 上一层单流 | 固定 | 控制分支尺度或梯度 |
| 多流残差 | HC、mHC | 同深度的 条流 | 动态 | 读、写并混合并行残差通道 |
| 跨层访问 | Full/Block AttnRes、MoDA | 多个历史深度 | 动态 | 显式检索早期计算 |
这张表揭示了 DepthBench 的核心对照:只修正数值尺度,是否足以让深层变得有用;还是必须改变信息可以走的路径。
十种残差与归一化设计逐一拆解
Pre-LN:只从上一层接力
Pre-LN 的加法可看成最简单的“读—算—写”:从唯一残差流读取,经过归一化和 ,再以系数 1 写回同一条流。它没有额外参数,也没有路由开销。所有早期更新都会出现在后续残差和中,但它们只能以统一系数 1 被累计,后层无法单独取回“第 7 层算出的东西”。
这种无条件累加对优化很友好,却容易产生表示稀释:历史信息并未丢失,但不同深度的来源被压成一个和,来源身份消失了。后层面对的是混合后的总量,而不是可寻址的历史计算。
Sandwich-LN:约束分支输出,但不改变信息来源
Sandwich-LN 也称 Peri-LN,在变换分支两侧都做归一化:
内侧归一化控制 的输入,外侧归一化控制写回残差流的更新幅度。每个 Transformer block 因此有四个归一化层,比 Pre-LN 多 个缩放参数。它能缓解激活方差和梯度的不平衡,但连接图没有改变:仍然只从上一层单流读取、写回同一条流。DepthBench 中它与 Pre-LN 一样,没有持续偏好越来越深的形状。
LNS:随深度缩小归一化输入
LayerNorm Scaling 针对“残差流越来越大、归一化分支相对越来越弱”重新配平深度尺度:
第 个 block 的注意力与 FFN 共用 。在 24 层和 32 层末端,这个系数分别约为 0.20 和 0.18。LNS 不增加参数,但 DepthBench 为它单独搜索了更大的学习率,最优峰值学习率为 ,是多数方法的 5 倍。
缩放能改变深层更新的优化动力学,却依然不能给后层新增一条访问历史的路径。因此它改善“怎样写入”,没有改变“可以读什么”。
DeepNorm:重标定恒等支路与变换支路
DeepNorm 回到 Post-LN 形态,在归一化前放大残差支路,并配套缩小部分权重初始化:
是 block 数。DepthBench 的 16—32 层模型中, 从 2.38 增至 2.83;Value、输出投影及 FFN 矩阵还按 缩小初始化。DeepNorm 的目标是限制模型更新,使极深 Post-LN 可优化。它回答的是“怎样把网络安全堆深”,而不是“怎样让后层区分所有早期来源”,因此在本基准的等参数宽深迁移中没有表现出 HC/Full AttnRes 那样的单调收益。
KEEL:用深度相关增益维持更新强度
KEEL 把 Pre-LN 的分支输入和 Post-LN 的输出约束组合起来:
在 DepthBench 实现中, 取 attention 与 FFN 子层总数。首个 block 做特殊处理,避免一开始就施加强残差增益。KEEL 试图以“高速公路式”主支路维持深层信号,但其信息源仍是 。它说明一个重要边界:更好的深网络稳定性不必然转化为更好的等参数深度 scaling。
Full AttnRes:让当前层直接检索所有历史层
Full Attention Residuals 不再把所有更新压进一个累计和,而是保存 embedding 及每个历史子层的独立输出 。当前子层用学习到的深度查询 计算权重:
每个 token 都可得到不同的 ,因此同一层能为不同内容检索不同深度。查询向量零初始化,起点是对历史源均匀平均;每个子层增加查询和 key 的 RMSNorm gain,共约 参数。24 层模型的 LM head 能在 embedding 与 48 个 attention/FFN 子层输出之间混合,共 49 个源。
它与普通 token 注意力的差别在轴:普通注意力沿序列位置检索,AttnRes 沿网络深度检索。代价也来自这里,历史子层输出要保留并参与深度 softmax,显存和访存压力会随深度增长。
Block AttnRes:以分块换取可部署性
Full AttnRes 的源数量随深度线性增长。Block AttnRes 把连续子层输出先累加成 running sum,只在边界处冻结为新源:
是当前块累计值, 是已经冻结的块输出集合。DepthBench 沿用约 8 个边界的设置,所以模型越深,块也越长。其参数量与 Full AttnRes 基本相同,深度混合的源却被压到常数级。
压缩源的代价是寻址粒度下降。Full AttnRes 可直接选某个子层,Block 版本只能选择整块摘要或当前累计值。后文会看到,固定边界数还制造了随深度变长的“死区”。
HC:把单条残差流扩成多条并行流
Hyper-Connections 不保存全部历史层,而是把当前状态扩为 条流组成的矩阵 :
决定从多流中读出什么, 决定旧流怎样互相混合, 决定新计算写回哪些流。三组系数既含静态参数,也含输入相关的动态修正。DepthBench 使用 。
HC 的关键不是“复制四份 hidden state”,而是历史贡献能沿多条不同路径传播。第 个子层输出影响第 个子层的显式权重为:
同一个早期输出到不同后层会经过不同矩阵乘积,因此不会像 Pre-LN 那样永远以系数 1 混在公共和里。它的长程访问是递归传播,而不是 Full AttnRes 的随机访问。
mHC:用双随机约束管住残差混合
mHC 保留四流结构,但用非负门和 Sinkhorn–Knopp 归一化约束路由:
残差混合矩阵被投影为近似双随机矩阵,即每行、每列之和都接近 1。这能恢复接近恒等映射的稳定输运,避免无约束 HC 在大规模下的信号放大或塌缩。站内的 mHC 完全拆解 已详细推导流形约束和 Sinkhorn 过程。
但“稳定”仍可能付出表达代价。DepthBench 发现反复施加双随机混合会把四条流推向近似相同的平均方向,有效秩下降,恰好削弱 HC 原本依靠的多路径多样性。
MoDA:按 token 动态选择深度信息
Mixture-of-Depths Attention 把序列维 KV 与同一 token 的历史深度 KV 放进一次 softmax:
保存更早层在当前 token 位置的深度 KV。查询一方面看当前层之前的因果序列,另一方面看当前 token 在更浅层形成的表示,因此同时混合“时间”和“深度”。
DepthBench 采用 Pre-LN MoDA,因为原论文偏好的 Post-LN 版本在统一配方下优化较差;24 层、学习率 时两者验证交叉熵分别是 2.764 与 3.842。这个实现还为 FFN 增加深度 KV 投影,24 层模型比 Pre-LN 多约 48.2M 参数。它提供了动态跨层访问,却没有在该基准中形成持续的深窄收益,说明“能看历史层”只是必要线索,不是充分条件;访问位置、残差底座和额外参数都影响结果。
DepthBench 如何把宽度—深度变成可控变量
直接给一个 24 层模型再加 24 层,参数与 FLOPs也一起增加,无法判断收益来自深度还是单纯来自更多容量。DepthBench 固定总参数近似不变,改变宽深比:
大表示浅而宽, 小表示深而窄。对 LLaMA 风格稠密 Transformer,参数量可近似写成:
主要来自每层注意力的 Q/K/V/O 投影与 SwiGLU FFN, 是不共享的输入 embedding 和 LM head, 是词表大小。固定 时增加 ,就必须近似按 缩窄 hidden dimension。
主实验在约 400M 总参数上比较 10 种架构,形状从 L16/d1216、宽深比 76.0,一直到 L70/d640、宽深比 9.1。为了排除“窄模型的 embedding 更小,因而给 Transformer 主干偷到了更多参数”这一混淆,论文又固定主干约 300M:从 L16/d1248 到 L84/d544,越深时总模型反而从约 425M 降至 354M。
其他控制项也尽量统一:子十亿模型均用 16 头 MHA、RoPE、RMSNorm、SwiGLU、50280 词表和 2048 序列长度;1.6B 组改用 16 个 Q 头、8 个 KV 头的 GQA。数据来自 FineWeb-Edu,token 预算为参数量的 20 倍。每种架构都搜索学习率,再让其不同宽深形状共享该架构的最优学习率,避免用不合适的学习率制造输赢。
这种设计仍不是绝对等 FLOPs。它严格控制的是参数与数据配方,残差方法本身的额外计算、不同形状的注意力项、embedding 占比和硬件效率都需要另列账本。论文显式做 iso-backbone 与系统测量,正是为了避免把“近似等参数”误写成“所有成本完全相等”。
实验结果:谁在深而窄的区域继续获益
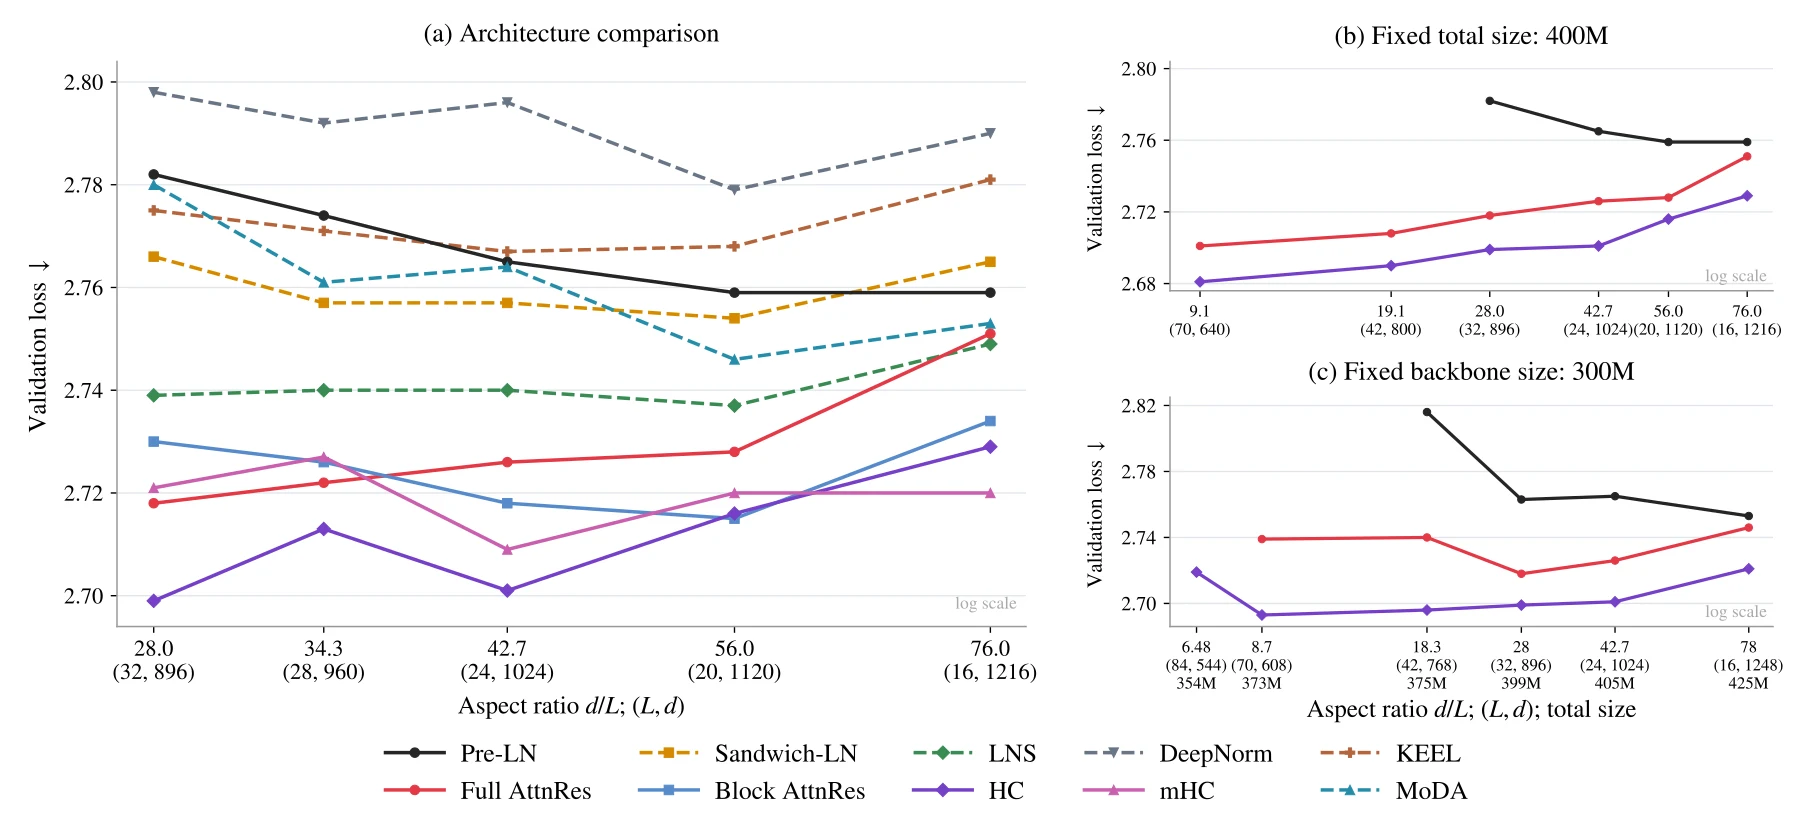
图源:DepthBench 论文 Figure 2。横轴越向右,宽深比越小、模型越深窄;纵轴是验证 loss,越低越好。读图要分三层。
第一层是 Pre-LN 的反例。在 400M 主实验中,Pre-LN 从 L16 的 2.759 恶化到 L32 的 2.782。也就是说,把相同参数从宽度搬到深度,不但没有赚到更多顺序计算,反而损失了单层表征容量。Sandwich-LN、LNS、DeepNorm、KEEL 与 MoDA 的曲线或趋平、或非单调,最优点仍停在较浅或中间形状。
第二层是 HC 与 Full AttnRes 的相反趋势。Full AttnRes 从 L16 的 2.751 持续降至 L32 的 2.718;HC 从 2.729 降至 2.699。扩展到 L70/d640 后,两者在约 400M 总参数组仍继续改善。更关键的是固定 300M 主干后趋势仍在:此时深窄模型总参数更少,不可能再用“主干参数偷偷变多”解释。
第三层是衍生版本没有自动继承性质。Block AttnRes 在 L20 达到 2.715,到了 L32 回升至 2.730;mHC 整体很强,却在 L24 最好,继续加深不再单调获益。Full AttnRes 压成块、HC 加上流形约束,均改善了某类工程或稳定性问题,却改变了跨深度信息传播的几何结构。
论文还在 200M、300M、400M、500M 和 1.6B 上检查三个代表性形状。Full AttnRes 的深窄偏好跨尺度保持得最一致;HC 在较小规模趋势清楚,但 500M 的浅宽点出现梯度爆炸,1.6B 也没有同样清晰的单调性。因而最稳妥的结论不是“HC 已在任意规模证明深度无限扩展”,而是:HC 在主实验显示强有效深度,Full AttnRes 的跨尺度证据更稳定,极大规模仍需要更多实验。
层级诊断:怎样证明新增层不是摆设
最终 loss 只能说某个形状更好,不能说明好在哪里。DepthBench 用三类干预把“有效”拆成可测量性质。
角距离:各层有没有继续改变方向
对两个深度的表征,论文计算归一化角距离:
余弦相似度只看方向,不会把单纯的范数增长误当成新表征;除以 后距离落在 。值越小,两个深度越相似。
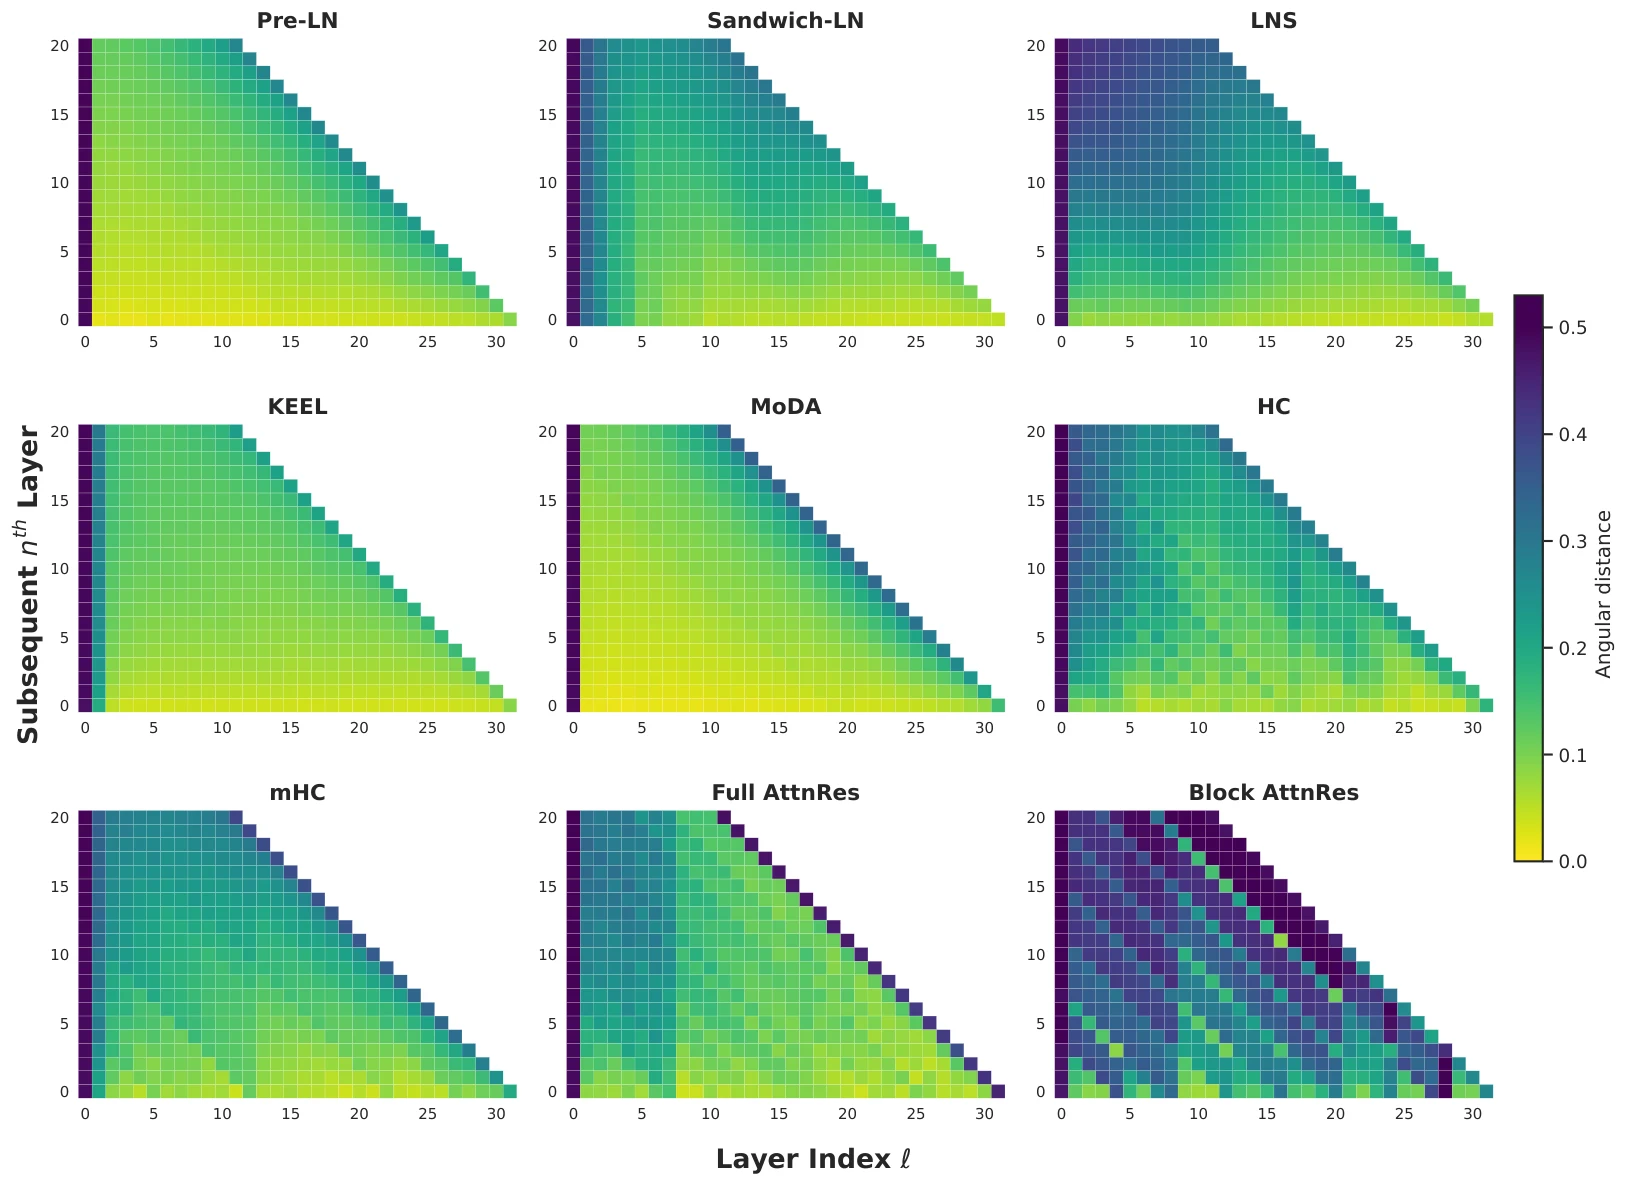
图源:DepthBench 论文 Figure 5。黄色区域代表距离小。Pre-LN、Sandwich-LN、LNS 与 KEEL 的深层逐渐形成平滑、相似的大片区域;HC 和 AttnRes 不仅距离较大,还呈现非平滑的层特定结构。Block AttnRes 显示清楚的方块:块内相似、跨边界突变。这与它只在块边界保存新源的设计吻合。
角距离大并不天然等于好。随机噪声也能制造大距离,所以还要做因果干预。
因果分数:跳过早期层会不会改变后续更新
跳过第 层后,以 表示干预轨迹。对后续第 层定义:
分子比较“跳层前后,第 层实际做出的更新差了多少”,分母用原更新归一化。 大,说明第 层不仅改变了自己的输出,还真正重塑了后续计算。
置换分数:层的顺序能不能随便换
再把第 、 层交换,比较 loss:
若两层只做相似的渐进修补,交换顺序影响有限;若层已形成专门化的顺序程序,置换会明显破坏结果。
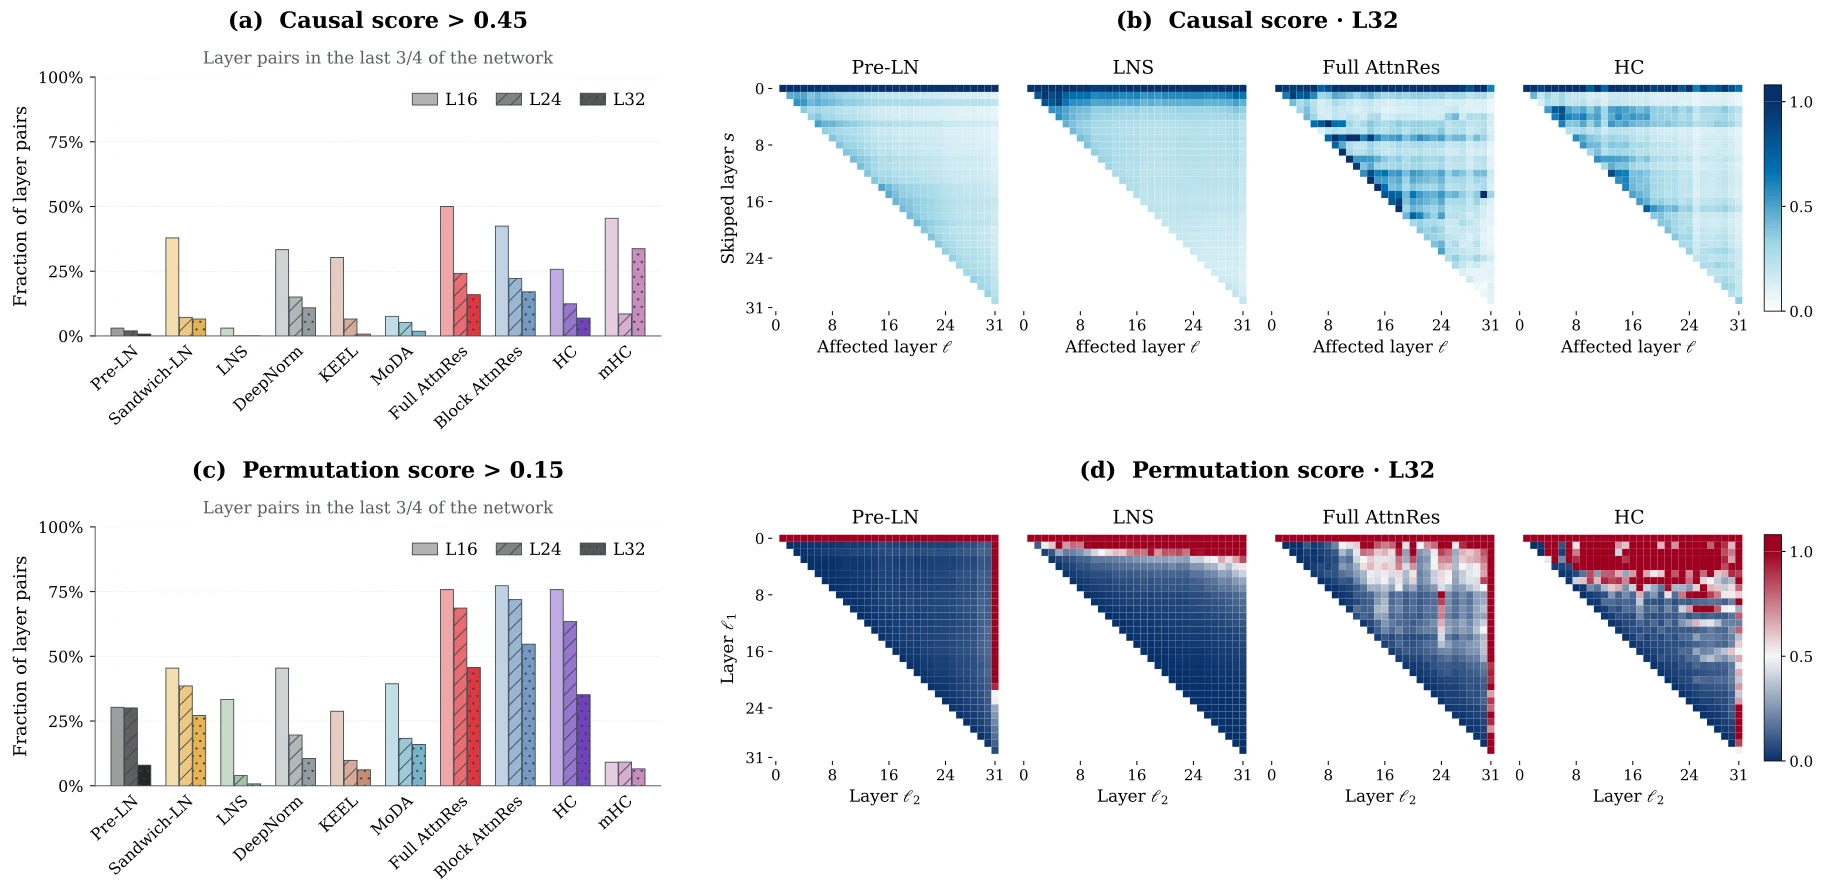
图源:DepthBench 论文 Figure 6。为了避免几乎所有架构都很重要的前几层掩盖差异,统计只看网络后四分之三。32 层模型中,超过因果阈值 0.45 的深层配对,Pre-LN 约 1%,Full AttnRes 约 16%,HC 约 7%;超过置换阈值 0.15 的配对分别约 8%、46% 与 35%。
三个探针合在一起才构成完整证据:HC 与 Full AttnRes 的后层既产生不同方向的表征,又会因删层而改变后续更新,还对层序敏感。这比“梯度能传到第 70 层”更接近有效计算深度的定义。
Full AttnRes 与 HC 为什么走出了两条不同路径
两种胜出方法都打破单残差流,却不是同一种机制。
Full AttnRes 像一个可随机访问的深度存储器。第 个子层输出 被独立保存,第 个子层直接用 softmax 权重 取回它。路径长度始终为 1,早期源不必经历中间 次混合。好处是来源身份保存完整;代价是源库、打分和混合规模随深度增加。
HC 更像一个容量为四条流的递归状态机。它不保存每层的独立副本,而是用 不断搬运和重组现有状态。早期输出到后层的权重是多个矩阵的乘积,因此路径长度随层距增加,但存储规模不随 线性扩张。它用有限状态换取了比单流更丰富的历史编码。
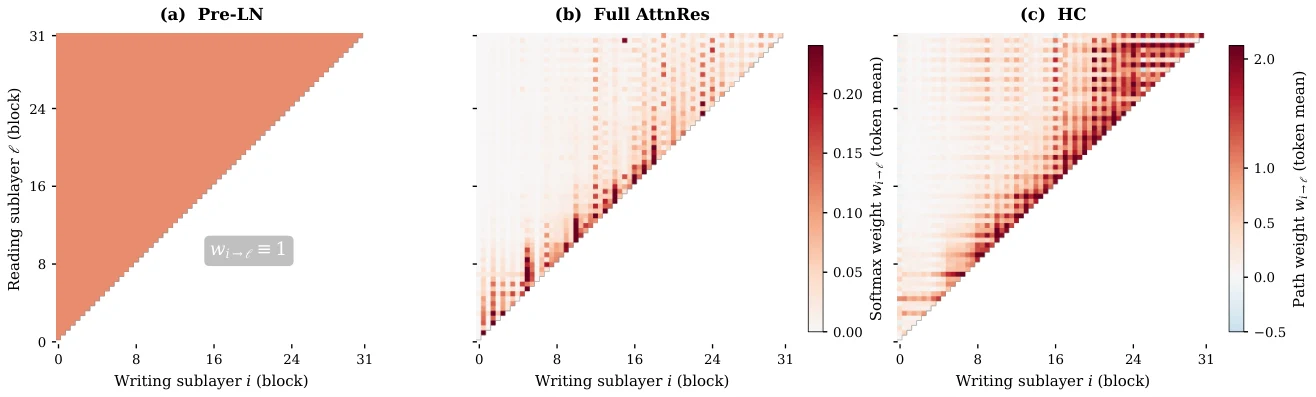
图源:DepthBench 论文 Figure 7。Pre-LN 图中所有可达历史分支的显式系数都是 1,因为它们已被直接相加;Full AttnRes 出现按 token 变化的稀疏选择;HC 的权重主要集中在局部对角附近,但也保留跨越较远层的通路。
LogitLens 进一步显示两者的计算风格不同。Pre-LN 的中间预测平滑、近似单调地接近最终分布;HC 也较平滑,但早层距离最终预测更远,说明多流状态还需逐步重组;Full AttnRes 明显非单调,后层会重新取回较早来源再做晚期整合。因而“有效深度”并不要求每层都独自不可删除,也不要求表示单调收敛。关键是连接拓扑保留了差异化历史,使后续计算依赖此前的路径与顺序。
mHC 与 Block AttnRes 的隐藏成本
Block AttnRes:固定 8 个边界,让死区随深度变长
Block AttnRes 为控制源数,把边界固定在约 8 个。L16、L24、L32 对应的块长逐渐变大。论文检查当前 running sum 的混合权重 后发现,在第一个块输出被冻结前,模型几乎把 压到 0,反复读取 embedding,而刚算出的层输出没有进入下一次混合。
这个初始死区在 L16、L24、L32 分别约为 2、5、8 层。到了 L32,相当于四分之一网络尚未形成第一个有效块源。模型名义上加了层,能重新路由信息的边界数却没有增加,块内层因而更像被捆成一个粗粒度步骤。Full AttnRes 的细粒度访问优势正是在这里被压缩掉的。
mHC:双随机稳定性把多流推向同一个平均方向
mHC 的 Sinkhorn 矩阵 近似双随机。令四流的均匀混合矩阵为:
对任意精确双随机矩阵都有:
是共同不动点。若反复混合持续收缩非主方向,长矩阵乘积就会靠近 ,不同流逐渐变得难以区分。论文用归一化奇异值 定义有效秩:
奇异值均匀时有效秩高,只有一个主奇异值时接近 1。mHC 的残差乘积有效秩仅 1.44—1.65,HC 为 2.53—2.81;L32 时 mHC 的传播方向几乎共线。
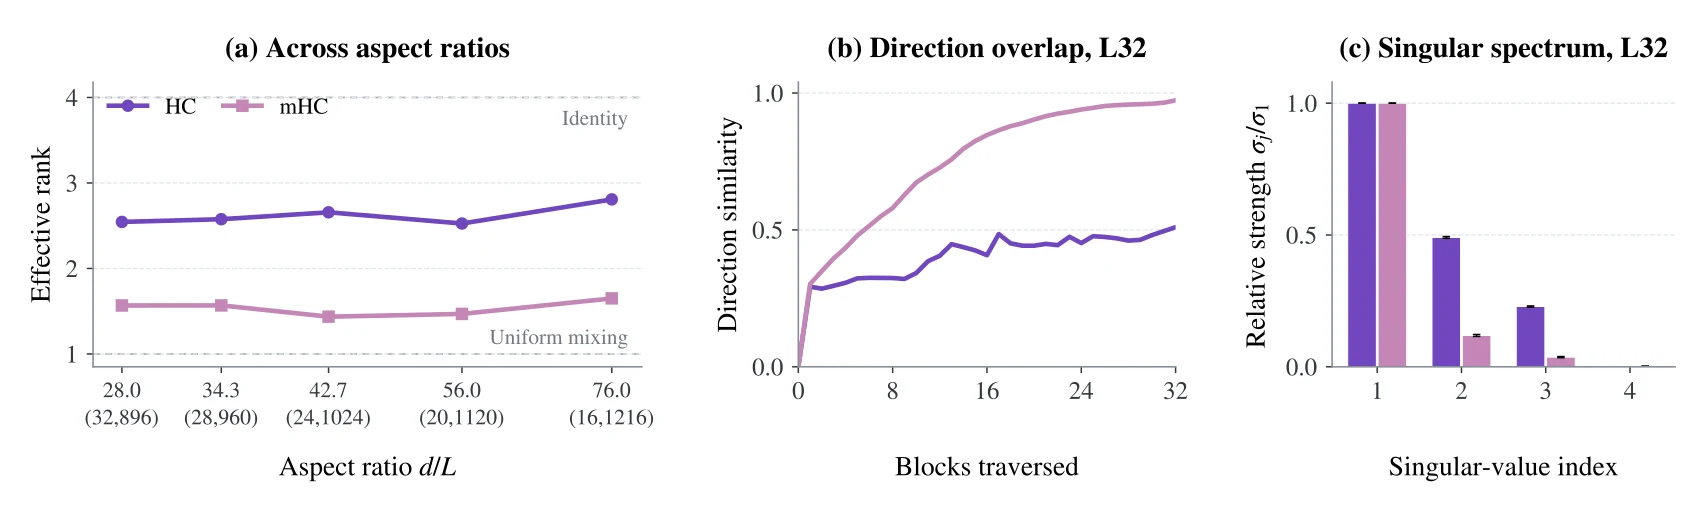
图源:DepthBench 论文 Figure 10。左图比较不同宽深形状的有效秩,中图显示 L32 的流方向余弦相似度,右图给出完整残差乘积的归一化奇异值。mHC 仍可能比普通残差连接强,也更容易稳定扩大规模;DepthBench 指出的只是另一面:对稳定输运的强约束,可能抹平 HC 用来承载多样历史路径的自由度。
这不是对 mHC 的全盘否定。它解决的是无约束 HC 的大规模稳定性,DepthBench 测的是等参数下继续向深窄移动的收益,两者目标不同。工程选择要看瓶颈究竟是训练稳定、有效深度,还是推理成本。
推理侧账本:有效深度不是免费的午餐
对固定参数量的深窄模型, 大致稳定,但 会随深度上升。由此产生四笔推理成本。
第一笔是注意力计算。长度为 的因果 prefill 中,QK 和 PV 的序列二次项近似为:
固定参数只能约束投影项 ,不能约束 。长上下文中 ,深窄模型的序列二次项会更突出。
第二笔是 KV Cache。若每层保存 K、V,元素数与 成正比。MHA 中 ,于是相同参数量下,层数变多会增加 KV Cache;GQA 能降低每层 KV 宽度,却不会消除其对 的线性关系。
第三笔是 kernel 与串行依赖。70 个小 GEMM 不能等价替代 24 个大 GEMM:矩阵变窄后 Tensor Core tile 更难铺满,kernel launch、归一化、激活和同步的固定成本占比提高;层间依赖又限制了跨层并行。参数量相同并不意味着延迟相同。
第四笔是新残差结构自身。HC 每个 attention/FFN 子层增加动态路由、四流读写和 混合;mHC 还多路由投影与 Sinkhorn。Full AttnRes 需要保存、读取历史子层源,并沿深度做归一化加权。论文的 FLOP 估算中, 时 HC 与 mHC 的额外量分别约为 与 ;mHC 的大头来自把 状态投影到 个路由 logit,而非小矩阵上的 Sinkhorn 迭代。
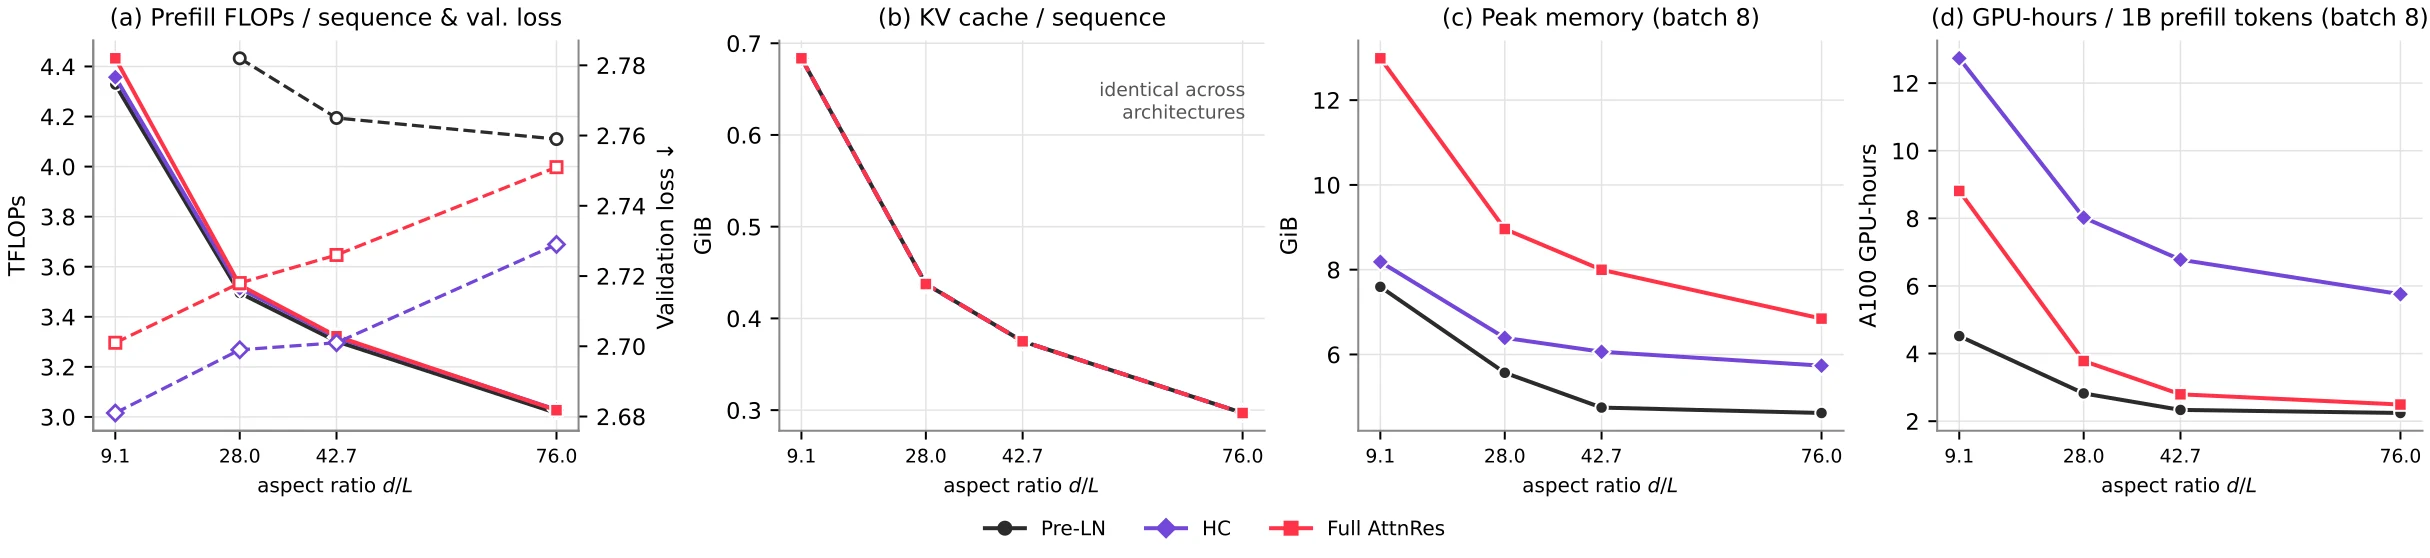
图源:DepthBench 论文 Figure 11。测试使用约 400M 参数、BF16、序列长度 4096、A100-SXM4-40GB。宽深比从 76.0 降至 9.1 时,单序列 prefill 从约 3.0 增至 4.4 TFLOPs,KV Cache 超过 2 倍;Full AttnRes 峰值显存最高,HC 的实测 GPU-hour 最高。后两者与名义 FLOPs 并不完全一致,说明访存、并行度和 kernel 效率同样重要。
对在线自回归解码还要再加一层判断。每生成一个 token 都必须顺序穿过全部层,batch 小时窄 GEMM 更难饱和;KV 读取又随层数增加。因此有效深度更可能先改善质量—参数前沿,而不是直接改善质量—延迟前沿。要把它变成服务收益,至少需要融合残差路由与归一化、减少中间状态落回 HBM、为深窄 GEMM 选择专用 tile,并重新评估流水线并行切分。
怎样正确解读“深度是新的 scaling 维度”
DepthBench 支持的是一个有条件的新维度,而不是无限堆层定律。
第一,横轴实际是宽深比,不是独立增加深度。固定参数量时,向右移动同时增加层数并降低 hidden width;实验回答的是“容量分给宽还是分给深”,不是“其他不变再加层是否更好”。
第二,当前证据覆盖到 1.6B,其中 Full AttnRes 的趋势最稳定,HC 的大尺度结果已有波动。不能从 400M 的 L70 直接外推到数百 B 或万亿参数。模型变大后,优化敏感性、并行策略、MoE、GQA 与通信都会改变最优点。
第三,论文以语言建模 loss、领域 NLL 和层级探针验证机制,没有证明某个固定延迟或固定能耗预算下深模型更优。真正面向部署的 scaling law 至少应把目标写成:
表示残差拓扑, 是参数预算, 是 KV 内存上限, 是每 token 延迟上限。只有把系统约束一起纳入,才能判断“有效计算深度”是不是某个产品场景里的有效 scaling 维度。
第四,三个诊断指标也各有盲点。角距离高可能只是噪声;跳层会制造分布外中间状态,可能高估某层重要性;置换两个不相邻层会同时破坏位置相关参数与统计。它们相互印证比单项可靠,但还不是有效深度的唯一标准。更完整的后续研究应增加层重复、早退、局部重算、Jacobian 谱,以及在真实下游生成任务上的受控干预。
第五,残差设计不应只按“是否动态”二分。MoDA 同样动态访问跨层 KV,却未得到 Full AttnRes 的深度曲线;mHC 同样有四流动态路由,却没有继承 HC 的单调收益。真正关键的是信息源是否保持可区分、路由是否保留足够秩,以及可访问的历史粒度是否随深度共同增长。
从体系结构视角看,这项工作的价值在于把残差连接从“防止梯度消失的小技巧”提升成了一个信息输运网络。层是计算节点,残差拓扑决定历史结果如何被寻址、压缩与搬运。Full AttnRes 选择保留更多历史状态,HC 选择维护固定数量的并行状态,mHC 再给状态转移增加守恒约束。模型深度能否有效,最终取决于这个跨层存储与互连系统是否允许后层继续看到有区别的过去。
小结
DepthBench 最重要的结论不是某一条 loss 曲线,而是把三个容易混淆的概念拆开了:能训练得很深、架构上层数很多、真正使用了更多顺序计算,彼此并不等价。
Pre-LN 通过恒等通路解决了可训练性,却把所有历史更新压进单一累计和;归一化和缩放变体能改善数值动力学,却通常没有改变信息源。Full AttnRes 让每层直接检索独立历史输出,HC 用四条流递归保存多样路径,两者因此在 DepthBench 中展现出更强的深窄 scaling 与深层顺序依赖。
衍生方案揭示了设计张力:Block AttnRes 的固定边界压低了访问成本,也让有效路由步数跟不上名义深度;mHC 的双随机约束提高稳定性,也可能把多流收缩到低秩平均方向。残差连接没有单一最优点,而是在历史可寻址性、路径多样性、稳定性、显存和 kernel 效率之间做选择。
因此更准确的工程结论是:有效计算深度已经成为值得独立搜索的架构维度,但它必须与残差拓扑和推理系统共同设计。层数只有在后层仍然产生异质、因果相关且不可随意置换的计算时,才不只是模型配置表上的数字。
参考资料
- DepthBench: Measuring How Residual Connections Enable More Computational Depth
- DepthBench 官方代码与检查点说明
- Attention Residuals
- Hyper-Connections
- mHC: Manifold-Constrained Hyper-Connections
- Mixture-of-Depths Attention
- The Curse of Depth in Large Language Models
- Post-LayerNorm Is Back: Stable, Expressive, and Deep
- DeepNet: Scaling Transformers to 1,000 Layers
- Peri-LN: Revisiting Normalization Layer in the Transformer Architecture
- On Layer Normalization in the Transformer Architecture
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


