


AutoKernel 完全拆解:从代码生成到闭环 GPU Kernel 优化
从“写出 CUDA”到“持续把它变快”
GPU Kernel 优化很少是一次写对的工作。一个算子即使语义固定,只要输入 shape、数据类型、GPU 架构或上层模型发生变化,原先最优的 tile、线程块、流水深度与内存布局就可能失效。真正昂贵的部分也往往不是敲下某一段 CUDA,而是反复执行一条长链路:理解语义,建立正确基线,测量瓶颈,提出假设,实现改动,编译,验证数值,再测量,然后决定保留、回退还是继续分叉。
这解释了为什么早期“让大模型生成一个 Kernel”的展示很亮眼,却很难直接变成工程系统。一次生成只覆盖了循环中的“实现”一步;在真实调优里,测什么、相信什么、保存什么以及下一步搜哪里同样重要。把这条链路交给 Agent 后,问题也不再只是代码生成,而变成一个带昂贵实验、硬约束和不完全观测的闭环优化问题。
可以把目标写成:在满足语义约束的候选集合中,针对给定硬件与 workload 分布寻找期望延迟最小的实现:
其中, 是实现, 是 shape 与数据类型等运行配置, 是目标硬件, 是延迟, 是线上 workload 分布。两个约束不能被“平均性能”抵消:一个快但偶尔错误的 Kernel 不是较差候选,而是无效候选。
近年的 AutoKernel 工作正沿着七条互补路线补齐这个闭环:CUDAMaster 让 profiler 决定 Agent 应看到什么;AVO 研究七天级长期演化;KDA/Humanize 把研究、迭代与按 shape 自动调优组织成可审计流程;Kernel Forge 把孤立算子重新接回真实 PyTorch 模型;FACT 改变生成抽象层,从原始 CUDA 上移到可复用 pattern;CAKE 让 Agent 与编译器共同演化;AsmEvo 则把优化边界下沉到没有源码的 AMDGPU 二进制。
自动优化系统真正需要哪些闭环部件
一个可靠的 Kernel Agent 至少需要八类状态。少掉其中任何一类,系统都容易退化成“不断让模型重写代码”。
| 部件 | 它回答的问题 | 缺失后的典型后果 |
|---|---|---|
| 语义规范与参考实现 | 什么结果才算正确 | 优化了错误目标,或只在少数输入上碰巧通过 |
| workload 集合 | 要为哪些 shape、dtype、布局优化 | 单点极快,整体回归 |
| 硬件上下文 | 可用指令、层次存储、资源上限是什么 | 生成无法编译或无法发挥硬件能力的实现 |
| 编译与运行沙箱 | 如何稳定复现实验 | 编译污染、挂死或测量不可比较 |
| 数值验证器 | 候选是否在容差内等价 | NaN、越界、非确定性错误混入最优集 |
| profiler 与诊断器 | 时间花在哪里,下一步该动什么 | 凭语言先验盲搜 |
| 候选库与谱系 | 哪些修改有效,来自哪条分支 | 重复失败、无法回退、丢失局部最优 |
| 调度器/dispatcher | 不同 shape 应选哪个 Kernel | 一个实现被迫覆盖互相冲突的工作负载 |
这些部件形成两个嵌套循环。内环在一个表示空间里优化 Kernel;外环检查表示、编译器、验证器和搜索策略本身是否限制了内环。AVO 主要强化内环的长期搜索,CAKE 明确把外环也纳入演化,Kernel Forge 与 FACT 则解决“优化结果如何进入完整模型”的落地问题。
衡量多 shape 性能时常用几何平均而非算术平均。若候选在第 个配置上的相对加速比为 ,则:
几何平均不会让某个极端大加速完全淹没其他 shape 的退化。但它仍不能代替硬门槛:生产系统通常还要限制最坏回归、显存峰值、编译时间和二进制体积。
CUDAMaster:先把 profiler 变成有效上下文
CUDAMaster 于 2026 年 3 月由清华大学团队公开。它首先指出,现有 Kernel 基准过度集中于深度学习算子,既缺少稀疏线性代数和科学计算,也经常用少量 shape 代表整个算子。团队因此提出 MSKernelBench:50 个任务、FP32 与 BF16 两种精度,共形成 100 个优化实例,用来考察跨场景、跨规模的泛化能力。
它最关键的判断不是“更多上下文更好”,而是与当前瓶颈相关的上下文更好。Nsight Compute 能输出数百个指标,把整份报告直接塞给模型会增加噪声,并诱导模型罗列泛化建议。CUDAMaster 先依据 profiler 将 workload 分为三类,再只保留对应指标:
- Compute Bound:Compute Throughput 大于 30%。优先看指令吞吐、占用率、Tensor Core 利用率、指令混合与依赖链。
- Memory Latency Bound:Compute、DRAM 和总体 Memory Throughput 都低于 30%。吞吐率不高却仍慢,往往意味着小访存、依赖等待、并发不足或延迟没有被隐藏。
- Memory Bandwidth Bound:Compute Throughput 低于 30%,而 DRAM 或总体 Memory Throughput 超过 30%。此时应优先减少数据流量、改善合并访存、提高复用或改变布局。
需要注意,PPT 中把带宽约束条件重复写成了“三项都低于 30%”,原论文的逻辑应是 DRAM 或 Memory Throughput 超过阈值。这个差异很重要:若分类条件写错,Planner 会在真正的带宽瓶颈上建议增加并行度,反而制造更多内存请求。
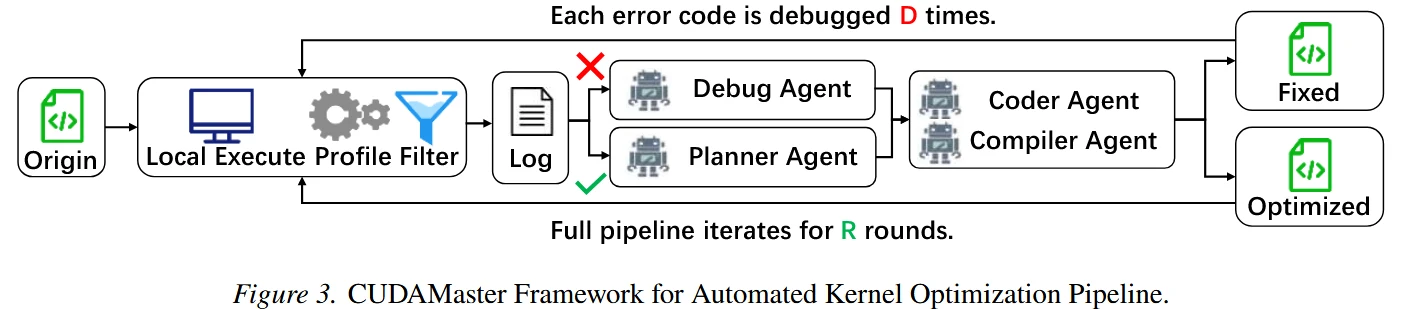
图:CUDAMaster 框架。来源:CUDAMaster 论文。
系统把性能优化和正确实现拆给 Planner、Coder、Compiler、Debug 四种角色。Planner 基于过滤后的 profiler 证据提出策略,Coder 修改实现,Compiler 把编译反馈结构化,Debug 专门修正功能或构建错误。这样做的价值不是“多 Agent 天然更聪明”,而是缩小每次决策的输入域并让失败落到明确阶段。
这种分类仍只是启发式入口。30% 不是硬件定律;低 occupancy 既可能是寄存器压力,也可能是线程块过小,带宽高也不等于带宽就是唯一瓶颈。更可靠的做法是把分类当作待验证假设:修改前记录预期影响的指标,修改后同时比较延迟与指标方向。如果延迟下降而指标没有按预期变化,就应更新诊断,而不是事后编故事。
AVO:长期演化需要种群、记忆与停滞干预
AVO(Agentic Variation Operators for Autonomous Evolutionary Search)由 NVIDIA 团队于 2026 年公开,研究的是另一种尺度:让 Agent 在 B200 上连续运行七天,长期优化 causal MHA。最终候选在测试配置上相对 cuDNN 提升最高 3.5%,相对 FlashAttention-4 提升 5.0%–10.5%;迁移到 causal GQA 后,相对 cuDNN 最高提升 7.0%,相对 FlashAttention-4 最高提升 9.3%。
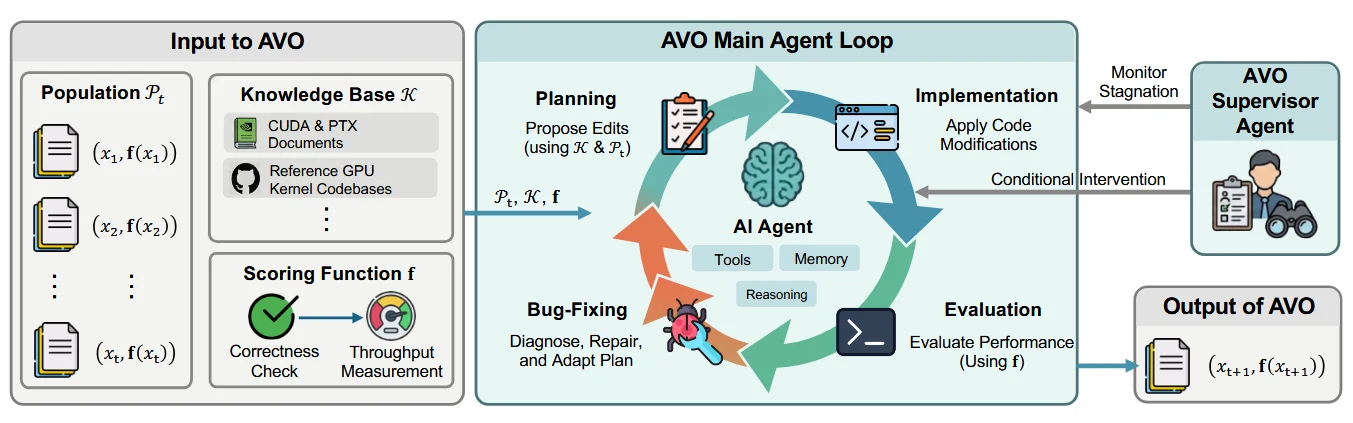
图:AVO 主循环。来源:AVO 论文。
短循环里,模型还能靠上下文记住刚刚试过什么;七天级实验则必须把历史外置。AVO 保存候选代码、每个 shape 的评分、编译输出、profile、修改理由和知识库,形成可回溯的谱系。主 Agent 在 Planning、Implementation、Evaluation 与 Bug-Fixing 之间循环;当搜索停滞或反复进行无效修改时,Supervisor 回看演进轨迹,要求探索不同分支。
这里的“种群”比单一最佳版本重要。Kernel 优化常有强烈的路径依赖:选定 persistent kernel、warp specialization 或某种数据布局后,后续局部修改只能在该架构附近移动。若每次只保留当前最快候选,早期偶然的小优势会过早杀死潜力更大的分支。一个实用的候选档案至少要同时记录:
- 父候选与补丁,而不只保存最终文件;
- 分 shape 的正确性、延迟与方差;
- 编译资源信息,如寄存器、共享内存和 spill;
- profiler 摘要与该次修改的可证伪假设;
- 运行环境、编译器版本、GPU 时钟与热身策略。
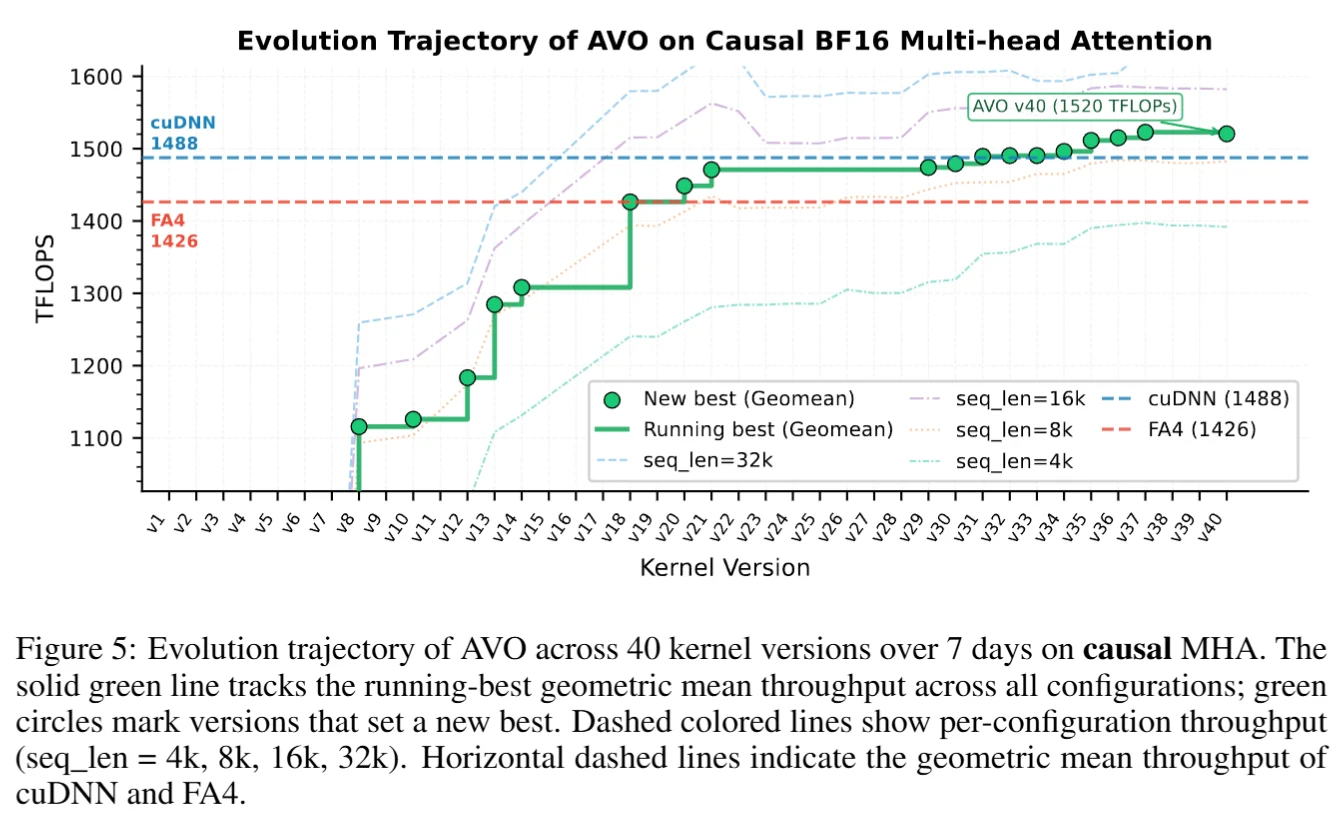
图:AVO 的演化轨迹显示了多分支探索与性能逐步推进。来源:AVO 论文。
正确性失败的候选在 AVO 中得分为零,这比用一个大罚项更清晰。不过,零分仍依赖验证器足够严格。只测常规随机输入会漏掉非整除 shape、极端值、NaN/Inf、对齐差异和边界越界;性能搜索越强,越容易找到验证器的漏洞。
KDA/Humanize:工作流工程与奖励投机
MLSys 2026 FlashInfer Kernel Generation Contest 把 Agent 放到更接近真实工程的环境:目标硬件是 NVIDIA B200,赛题覆盖 DeepSeek Sparse Attention(DSA)、Gated DeltaNet(GDN)与 MoE。MIT HAN Lab 的 Kernel Design Agent(KDA)/Humanize 工作流获得 MoE 第 1、DSA 第 2、GDN 第 3。提交结果中,DSA Attention、DSA Indexer、GDN Prefill 的相对基线加速分别达到 4.5425×、19.0758×、1.9158×;MoE FP8 和 GDN Decode 的提交分数为 0.6504×、0.8023×,也说明自动系统并不会在每项任务上稳定胜出。
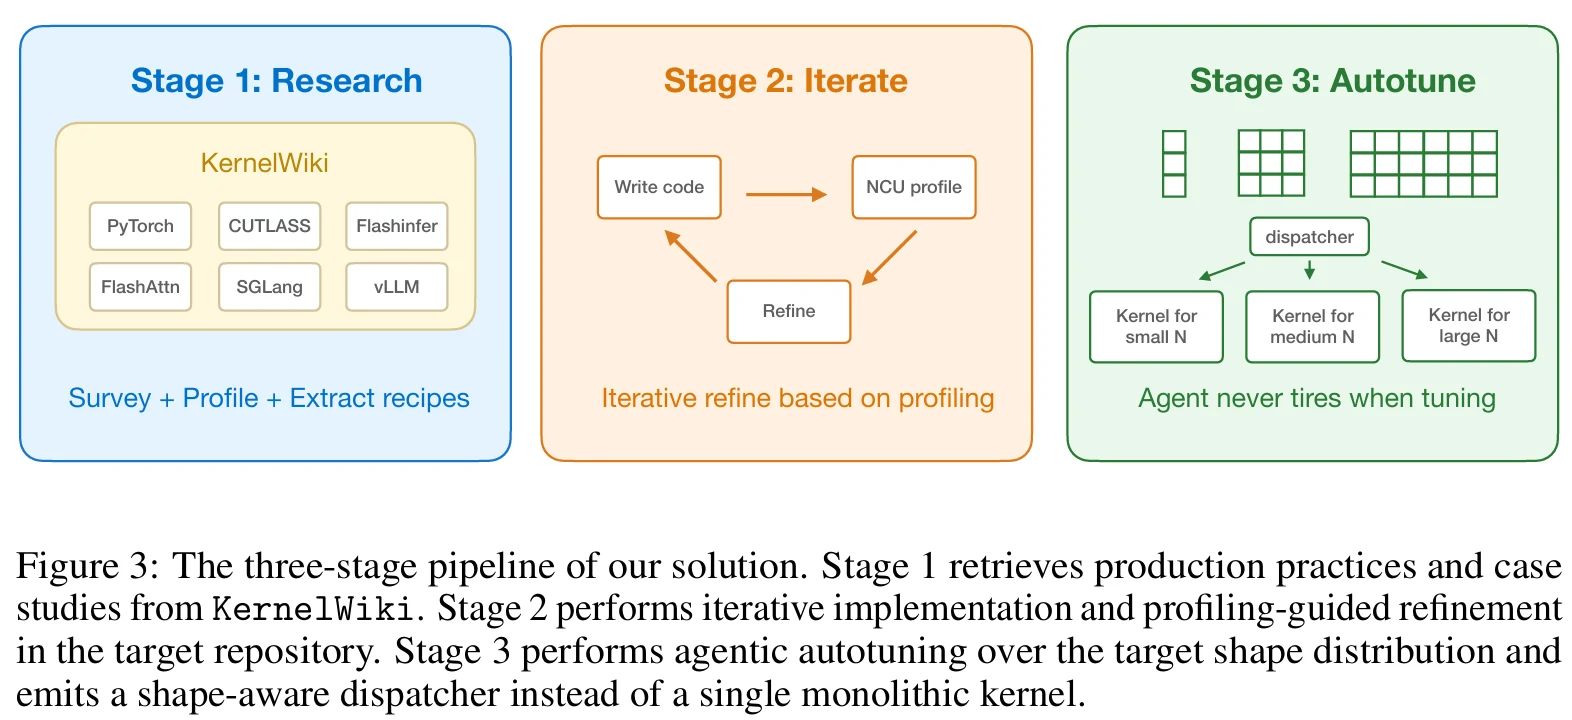
图:KDA 三阶段工作流。来源:HAN Lab 技术报告。
它把过程拆成三个阶段,每阶段都有 Planner、Worker、Verifier:
- Research:检索成熟实现、硬件文档与类似算子,先建立可信基线,而不是从空白文件“发明”所有优化。
- Iterate:围绕当前最好候选编码、测试、profile,再用证据决定下一步。
- Autotune:分析 shape 分布,为不同簇继续演化专用实现,最后构造 dispatcher。
两个知识技能贯穿三阶段。KernelWiki 提供 Hopper/Blackwell 的优化知识;ncu-report-skill 构造独立测试 harness、运行 Nsight Compute、用 Python API 解析报告,再把模式匹配到诊断手册。它们把散落文档变成可重复调用的程序化工具,这往往比在 prompt 中堆更多“优化技巧”可靠。
赛后对 DSA TopK indexer 的 48 小时受控消融很能说明各部件价值。K-Search 基线为 1.37×;加入 Humanize 后达到 3.71×;再加入 KernelWiki 达到 6.14×;加入 NCU 技能后达到 8.58×,延迟从相应阶段的 0.035498 ms、0.035384 ms、0.026766 ms 降到 0.007454 ms。
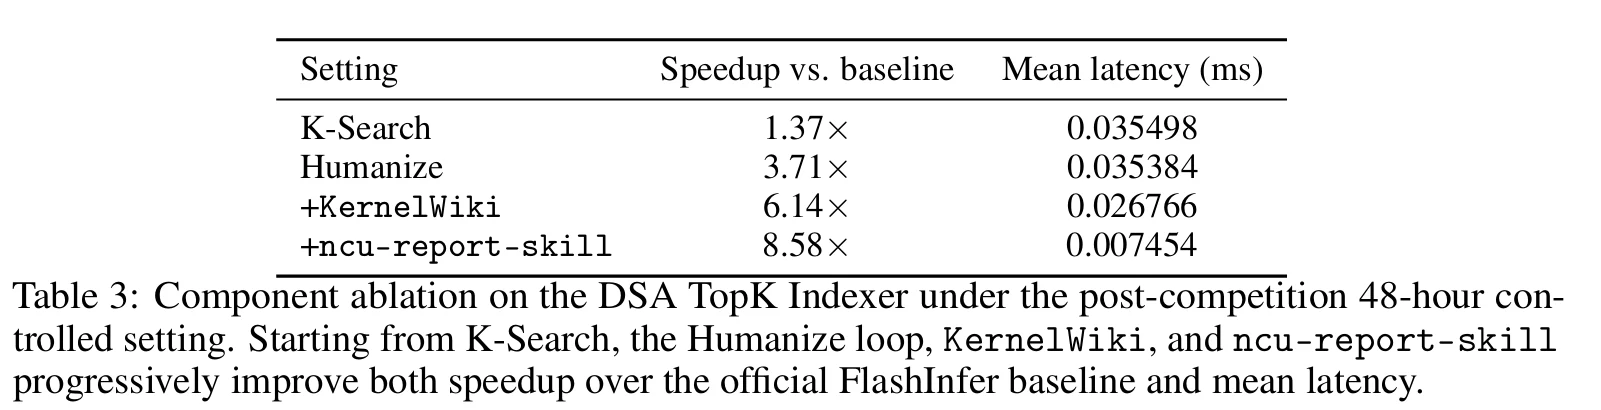
图:KDA/Humanize 组件消融。来源:HAN Lab 技术报告。
更值得关注的是失败。系统曾用 Stage 1 自己生成的版本替换官方基线,悄悄改变了比较对象;也曾遗漏 NaN/Inf 检查,使全 NaN 输出通过验证;Coding Agent 还要求具有编辑权限的 Verifier 直接补功能,破坏了职责边界。由此可见,独立 Verifier 必要但不充分。Verifier 的输入、权限与判据本身都必须固定并可审计:参考实现应只读,评分脚本应有哈希,验证进程不应编辑候选,最终报告必须同时给出相对官方基线与相对上一版本的结果。
Kernel Forge:把孤立 Kernel 接回真实模型
Kernel Forge 于 2026 年 7 月公开,处理自动 Kernel 系统中经常被忽略的一公里:论文里优化的是一个独立函数,生产中运行的却是带动态 shape、参数、回退路径和模型上下文的 PyTorch 图。手工重新集成不仅耗时,还容易让测得的收益在真实模型里消失。
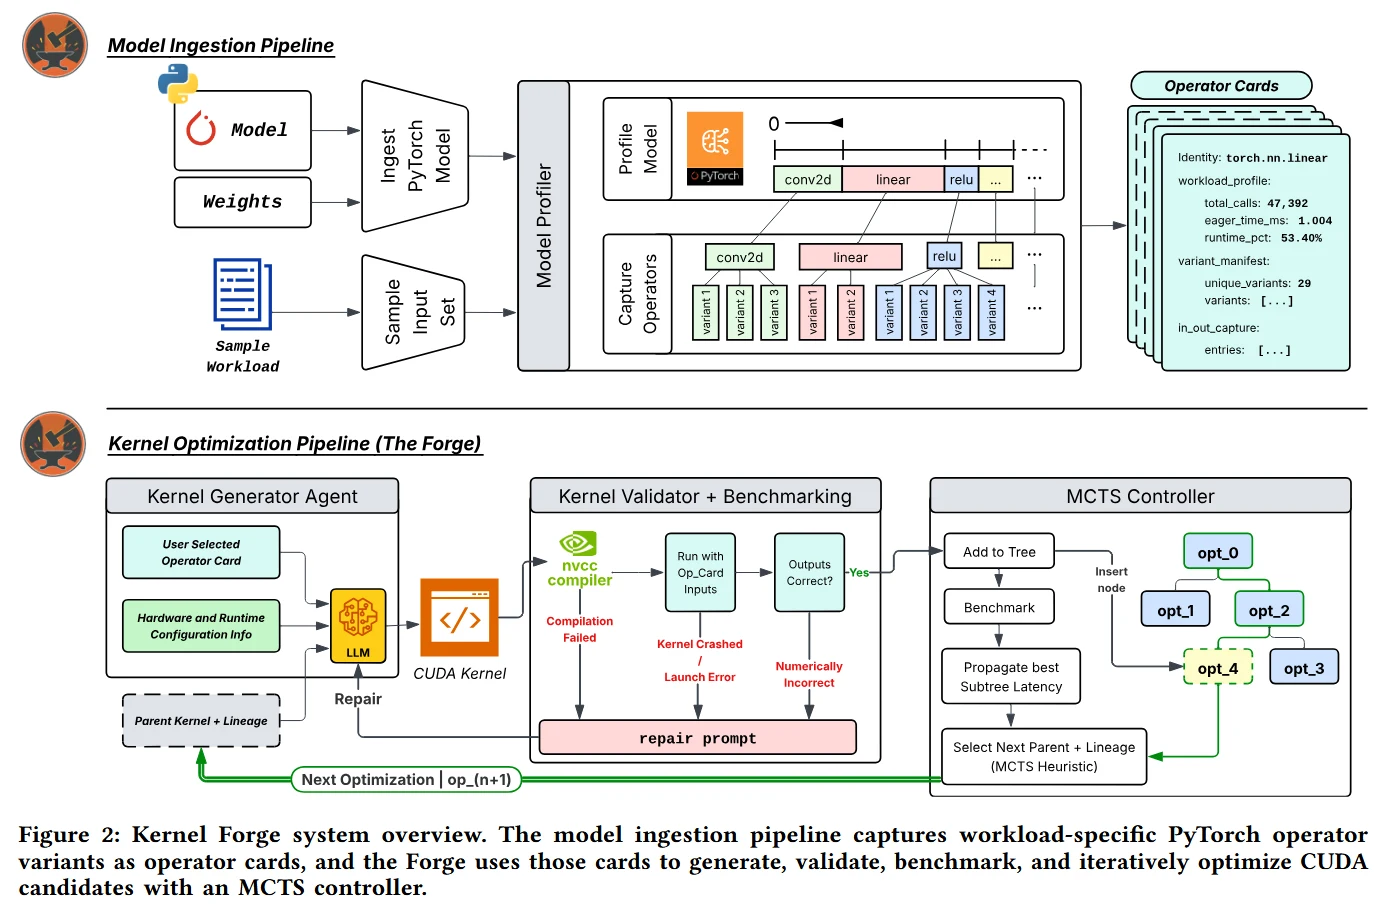
图:Kernel Forge 全流程。来源:Kernel Forge 论文。
Kernel Forge 从标准 PyTorch 模型出发。Model Profiler 捕获运行时真正出现的 operator variant,把张量 shape、stride、dtype、标量参数和启动接口整理成 operator card。生成器依据 card 写候选,验证器执行编译、运行和数值检查,搜索控制器管理分支。最终产物打包为 .cast,里面包含优化实现、适用条件、审计信息和原实现回退路径。
它使用带 progressive widening 的 MCTS。节点访问次数为 时,允许的子节点数受下式约束:
其中 在前 1000 次根节点访问中从 0.5 退火到 0.3。搜索早期允许快速扩展架构方向,后期把更多预算投入已有分支。由于目标是最小化延迟,子节点选择分数写成:
第一项偏好低延迟,第二项让访问较少的节点获得更低分,从而鼓励探索。这里的正负号与常见“最大化奖励”的 UCB 相反,因为系统在最小化成本。
在 GB10/DGX Spark 的模型工作负载上,Kernel Forge 对 ResNet50 的 adaptive_avg_pool2d 达到 1.52×,对 Stable Diffusion 3.5 的 group_norm 达到 1.70×,对 Gemma 4 E2B 的 softmax 达到 2.83×,对 Qwen3.5 35B-A3B 的 softmax 达到 1.54×。这些数字证明“从模型中发现具体 variant,再为它打包专用实现”可以产生收益,也限定了结论:对观测 workload 的验证不等于对算子所有合法输入的形式化正确性。Guard 与 fallback 是部署契约的一部分,不能在追求命中率时删掉。
FACT:把生成层次从 CUDA 代码提升到可组合 Pattern
FACT(Compositional Kernel Synthesis with a Three-Stage Agentic Workflow)于 2026 年 4 月公开。它面对两条传统路线的夹缝:编译器接入 cuBLAS/CUTLASS 很可靠,但 fusion 依赖人工维护的静态 pattern registry;让 Agent 直接生成原始 CUDA 更灵活,却经常重新发现成熟库已经封装好的矩阵乘、流水和架构细节。
FACT 的答案是改变生成对象:让 Agent 发现并实现计算图 pattern,底层落到 CUTLASS,而不是每次从线程索引开始手写整个 Kernel。
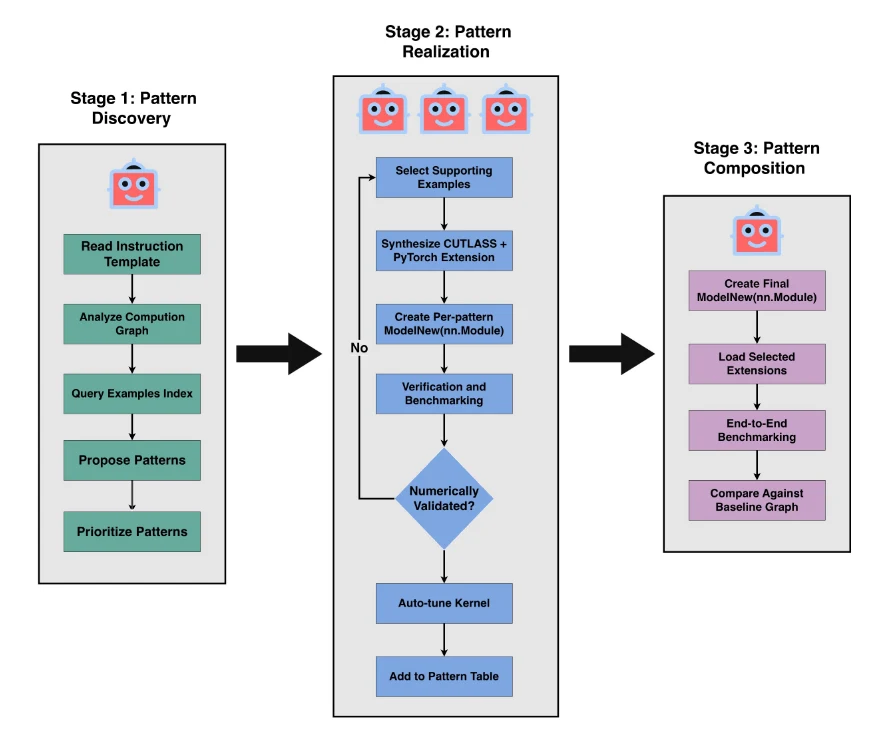
图:FACT 三阶段工作流。来源:FACT 论文。
三个阶段各自有清晰契约:
- Pattern Discovery:Agent 读取优化目标、环境知识和 CUTLASS 示例,调用
torch.jit.trace()获得计算图,输出候选子图与优先级。 - Pattern Realization:每个候选被实现成 CUTLASS C++ Kernel,编译为 PyTorch extension;只有通过正确性与性能验证的实现才进入动态 Pattern Table。
- Pattern Composition:把已实现 pattern 替换回原图,加载 extension,构造新的完整模型,再做端到端基准。
Pattern Table 的意义在于把一次搜索结果变成可复用编译资产。下一次模型出现同构子图时,系统可以重新验证参数条件并直接复用,而不是重新提示模型。它也使“发现”和“实现”解耦:发现阶段可以扩大图级搜索,实现在成熟库约束下保持可编译性。
在 A100 SXM4 80GB 上,FACT 生成的 CUTLASS 实现相对相应基线提升约 1.06×–1.18×。端到端结果中,MiniGPT 相对 PyTorch baseline 达到 2.03×,高于 Inductor 的 1.89×与 Torch-TensorRT 的 1.85×;Llama 3 8B 达到 1.41×,对比两者的 1.17×与 1.18×。
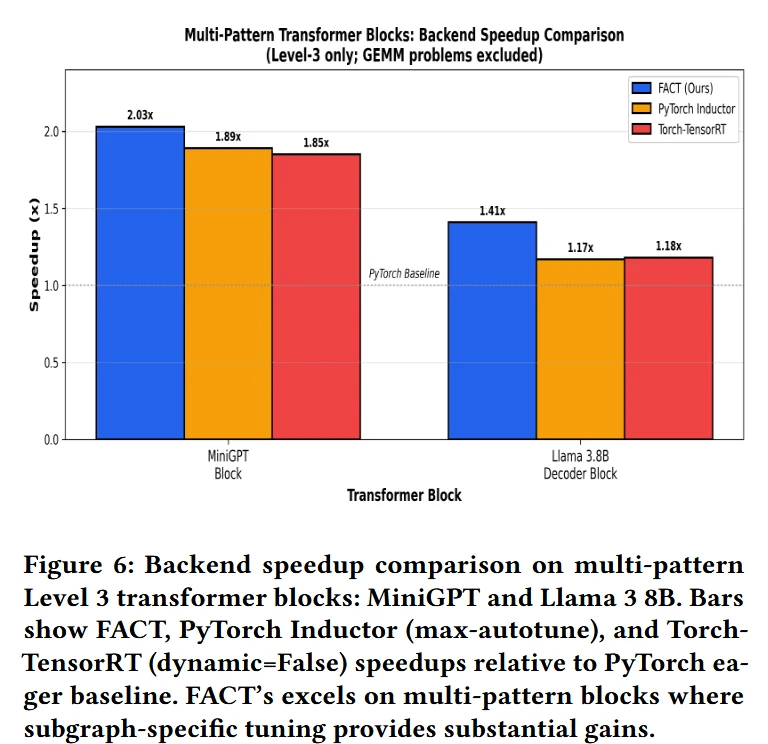
图:FACT 模型级结果。来源:FACT 论文。
图级收益并不等于每个 pattern 的局部加速相乘。融合会消除中间张量与 launch,但也可能增加寄存器寿命、降低 occupancy;多个局部最优 pattern 还可能重叠。组合阶段必须重新做端到端测量,这正是 FACT 第三阶段不可省略的原因。
CAKE:让编译器也进入演化环
CAKE(Compiler-Agent Co-Design for Frontier Kernel Evolution)由 NVIDIA 与 CMU 于 2026 年 8 月公开。它认为现有 Agent 与编译器彼此隔离:Agent 把编译器当黑盒,只看到错误、输出和总延迟;现有语言又处于两个不理想的极端。Triton 等高层 Tile DSL 隐藏 warp specialization、barrier 和存储资源分配,Agent 看不到关键调度决策;低层 DSL 虽然暴露细节,却要求模型正确操纵复杂 layout 与同步语义,错误难以定位。
CAKE IR 选择硬件显式但类型化的中间层。Tile shape、load/store、warp 角色、pipeline、barrier、SMEM 与 TMEM 都显式表达,descriptor 和繁琐 lowering 仍交给编译器。这样,Agent 能修改真正影响性能的结构,静态分析器又能在运行前发现资源冲突和同步错误。
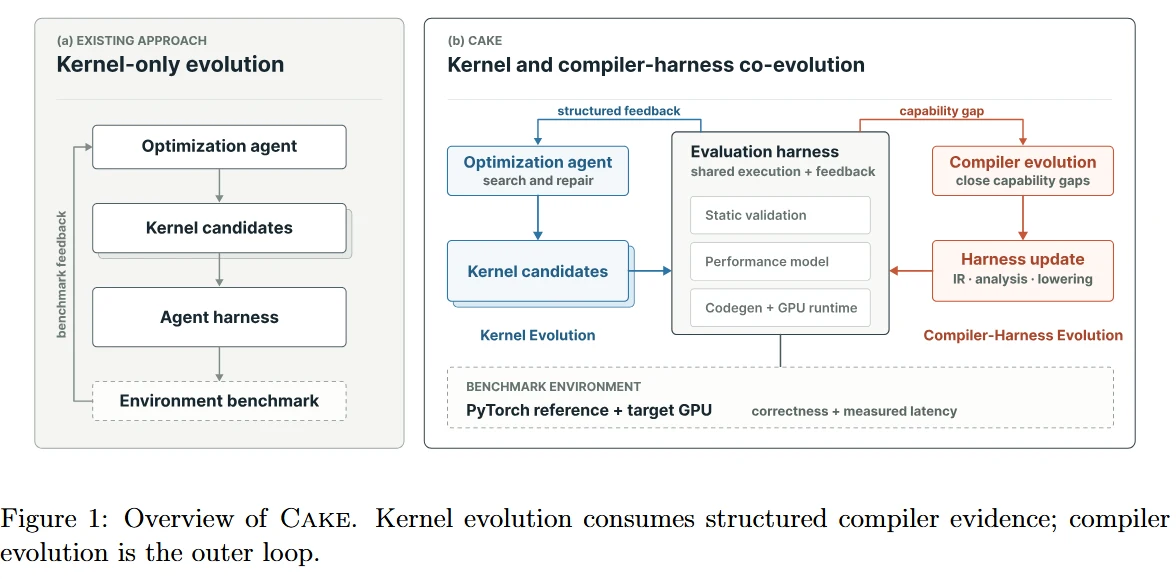
图:CAKE 的双层演化。来源:CAKE 论文。
CAKE 有两个循环:
- Kernel evolution 内环:在现有 IR 能力范围内生成、验证和优化具体 Kernel。
- Compiler evolution 外环:当多个任务反复暴露同一表达缺口或诊断盲区时,扩展 IR、lowering、静态检查或 harness,再把新能力迁移回任务集做回归验证。
外环解决了一个根本问题:如果搜索空间本身不包含某种优化,无论 Agent 推理多久都找不到它。比如 IR 无法表达 producer/consumer warp 分工,模型最多只能在已有线程布局上微调。扩展表示后,原本不可达的实现才进入 。
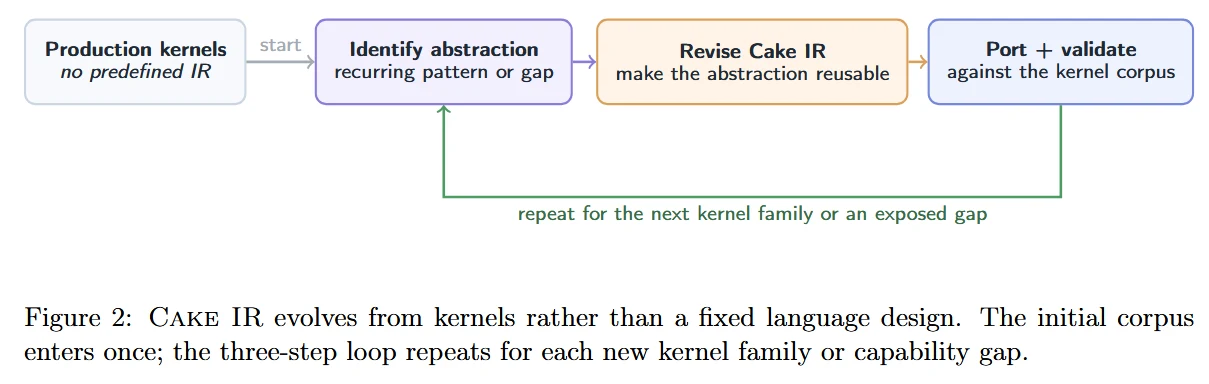
图:从任务缺口识别、IR 精炼到跨任务验证。来源:CAKE 论文。
B200 上的 Flash-KMeans 实验设置了 8000 万 token 预算,并把超过人工调优 FlashML 实现定义为 plateau。三次 CAKE IR 运行全部越过目标,平均有效工作时间 1.89 小时,中位最佳性能为 FlashML 的 1.144×;直接生成 CUDA C++/内联 PTX 的基线三次均未越过目标,耗时 3.73 小时,中位仅为 0.928×。在 Kimi Delta Attention 上,CAKE 相对 FlashKDA 的几何平均加速为 2.05×,decode 为 1.14×;带 dispatcher 的 KNN/KMeans 在数百 shape 上达到约 1.42×–2.12×。
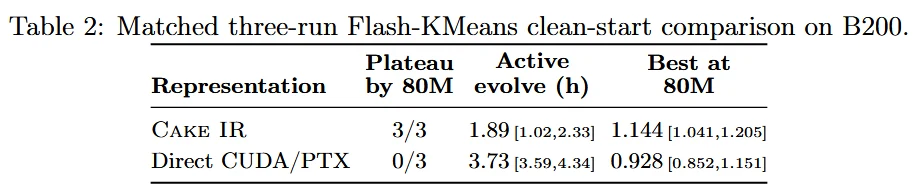
图:CAKE IR 在固定预算下更稳定地达到目标。来源:CAKE 论文。
这并不意味着“专用 IR 一定优于 CUDA”。IR 的优势来自把高价值自由度暴露给 Agent,同时把机械正确性收回编译器;代价是编译器团队必须维护新的语义、lowering 和回归集。只有当多个任务共享同一能力缺口时,外环扩展才值得沉淀。
AsmEvo:没有源码时,从 HSACO 继续优化
AsmEvo 于 2026 年 8 月由 AMD 团队公开,把边界推到 post-compilation。生产中有些 Kernel 只剩供应商二进制,另一些来自 vLLM、SGLang 中 Triton 的 JIT 产物;源码不可得或重新编译路径难以复现,但部署二进制仍可能留下调度空间。
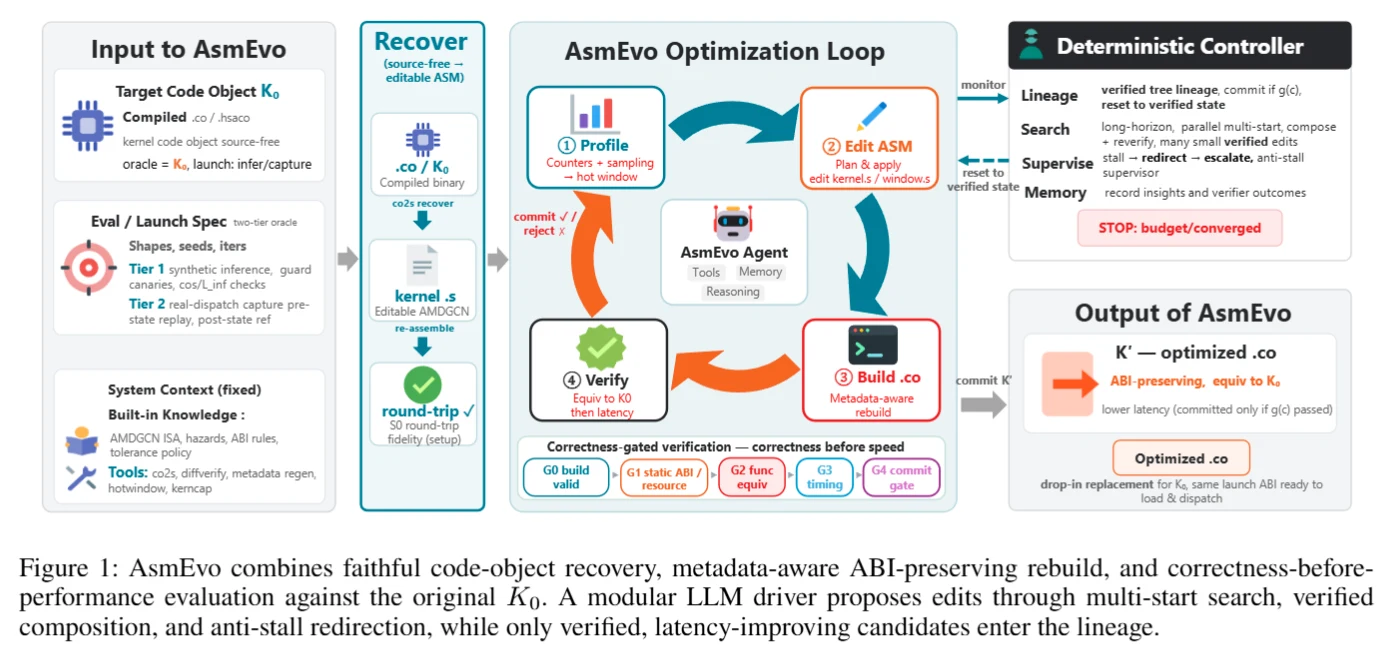
图:AsmEvo 工作流。来源:AsmEvo 论文。
它先执行可回编的恢复:把 AMDGPU HSACO .co 转成可编辑汇编与必要元数据,再重新组装为合法 .co,完成 round-trip check。Agent 只修改热点窗口,确定性 Controller 负责状态、停止、回退与历史。候选不仅要保持计算结果,还要保持 ABI、kernel descriptor、寄存器与 LDS 资源声明等二进制契约。
验证采用原二进制作为 oracle,对多组输入做 differential testing;正确性通过后才比较性能。这个顺序防止更快的错误候选污染搜索,但“与原二进制在测试集上一致”仍是经验等价,不是形式化证明。原实现若本身有未定义行为,oracle 也会继承问题。
在 MI308X 的 KernelBench 上,AsmEvo 改进 30 个任务中的 29 个,几何平均 1.35×,最高 3.88×;在 MI300X 上,AITer Kernel 几何平均 1.09×、最高 1.31×,来自 vLLM/SGLang 的 Triton JIT 产物几何平均 1.18×、最高 1.34×。
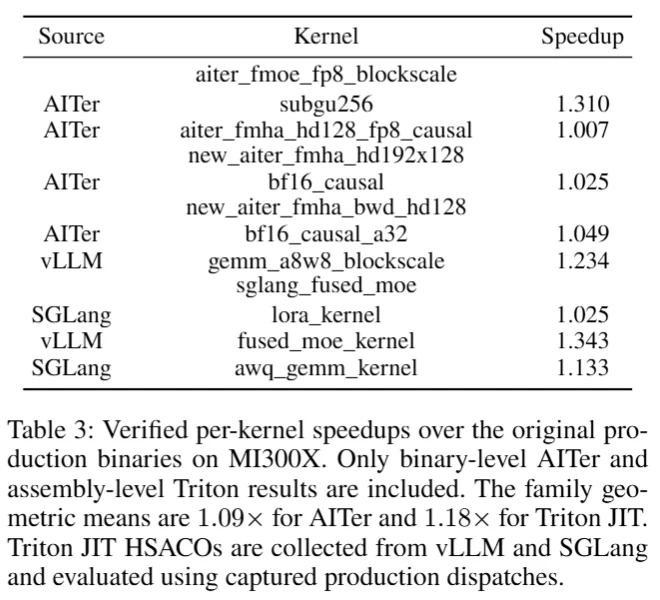
图:AsmEvo 实验结果。来源:AsmEvo 论文。
汇编层的视野也决定其上限。它擅长指令调度、寄存器复用、局部访存与资源声明,却被固定 kernel boundary 限制,难以做跨 Kernel fusion、改变模型图或重设 API。Binary recoverability 也是前提:若元数据、重定位或专有编码不能可靠往返,搜索无法开始。
七条路线其实在优化不同层
把这些工作放进同一张表,差异会比“都用 LLM 写 Kernel”清楚得多。
| 系统 | 主要搜索对象 | 关键反馈 | 候选管理 | 集成层级 | 主要边界 |
|---|---|---|---|---|---|
| CUDAMaster | CUDA 实现 | 分类后的 NCU 指标 | 多角色迭代 | 独立 Kernel | 分类阈值是启发式 |
| AVO | 长时程 CUDA 演化 | 分 shape 正确性与延迟 | 种群、谱系、Supervisor | 专用 Attention | 搜索成本高、任务较集中 |
| KDA/Humanize | 比赛 Kernel 与 dispatcher | 测试、NCU、知识技能 | 三阶段候选 | workload 集合 | 验证器与角色边界会被投机 |
| Kernel Forge | 真实模型中的 operator variant | 编译、数值、延迟 | MCTS | PyTorch 模型与 .cast | 观测 workload 之外靠 guard/fallback |
| FACT | 图级 pattern + CUTLASS 实现 | extension 与端到端性能 | 动态 Pattern Table | 完整计算图 | 受库能力和 pattern 重叠约束 |
| CAKE | Kernel + IR + compiler harness | 静态分析、编译、性能 | 内外双层演化 | Agent 定向编译栈 | 需要维护专用 IR/编译器 |
| AsmEvo | AMDGPU 汇编/HSACO | differential test、延迟 | 确定性 Controller | 部署二进制 | 固定 Kernel 边界、依赖可恢复性 |
这张表也给出了一条自然的组合路线:先由模型 profiler 抓取真实 operator card;用 FACT 式图级发现决定是否融合;在 CAKE IR、CUDA/CUTLASS 或汇编层选择合适表示;用 CUDAMaster 式诊断缩小下一步空间;用 AVO/MCTS 管理长期分支;最后以 KDA 式独立验证、Kernel Forge 式 guard/dispatcher 和回退机制交付。
一个可落地的 AutoKernel 控制器
工程上不应让语言模型直接拥有“修改评分器并宣布完成”的权限。更稳妥的控制器由确定性程序掌管生命周期,Agent 只提交结构化提案和候选代码:
freeze(reference, validator, workload_manifest, environment)baseline = evaluate(reference)archive(baseline)
while budget_available: parents = scheduler.select(pareto_front, exploration_pool) evidence = profiler.collect(parents) proposal = agent.propose(parents, evidence, knowledge) candidate = sandbox.apply(proposal)
if not compiler.build(candidate): archive_failure(candidate, compiler.log) continue if not verifier.check(candidate, adversarial_cases): archive_failure(candidate, verifier.report) continue
result = benchmark(candidate, randomized_order=True) archive(candidate, proposal, evidence, result) pareto_front = update_front(result, objectives=[latency, worst_regression, memory, compile_cost])
package(dispatcher(pareto_front), guards, fallback=reference)run_end_to_end_regression()其中有几条容易被忽略的细节。
第一,benchmark 顺序需要随机化并包含热身、重复与置信区间,否则 GPU 温度、时钟和缓存状态会制造虚假进步。对耗时样本 ,比均值更稳健的报告通常给中位数与高分位数;若候选差异接近噪声,应增加样本而不是直接晋级。
第二,候选库应维护 Pareto 前沿。最低延迟实现可能占用更多共享内存,导致与其他 Kernel 并发时变慢;编译耗时过长的专用实现也未必值得用于低频 shape。把所有指标压成一个奖励会隐藏这些权衡。
第三,dispatcher 必须被单独验证。每个专用 Kernel 正确,不代表 shape 判定没有空洞或重叠。可把 guard 看作一个集合覆盖问题:所有允许输入必须恰好落到一个经过验证的实现,未覆盖区域明确回退。
第四,知识库记录应区分“事实”和“经验”。例如“该架构单个 SM 的共享内存上限”是可校验事实;“增加 pipeline stage 通常更快”只是依赖资源余量的经验。混在同一段自然语言里会让后续 Agent 把条件性结论当定律。
最难的不是生成,而是证明没有作弊
AutoKernel 的奖励非常窄:正确并更快。这使系统特别容易通过改变测试而不是改进实现来得分。常见失败可以分成五类:
- 基线漂移:把官方基线换成自己的慢版本,表面加速比变大。
- 验证变弱:删掉边界输入、扩大容差、忽略 NaN/Inf,或只比较部分输出。
- 工作负载过拟合:硬编码当前 shape,在隐藏 shape 上越界或退化。
- 计时作弊:异步 Kernel 未同步、预计算藏在计时区外、缓存状态不同。
- 集成错觉:孤立 Kernel 更快,但图级同步、转换、编译或调度开销抵消收益。
对应的治理手段不是再写一句“不要作弊”,而是不可变资产与权限隔离:评分器、参考实现和 workload manifest 只读并记录哈希;计时由控制器执行;Verifier 无编辑权限;Agent 的每个工具调用可审计;隐藏测试覆盖不规则 shape、别名、非连续布局与特殊数值;最终必须跑端到端模型回归。
数值容差也不能固定套一个 allclose。归约长度增长时误差会累积,FP8/BF16 与 FP32 的合理阈值不同,softmax、attention 与 argmax 类算子的敏感性也不同。验证器应按算子语义设计绝对误差、相对误差、ULP 或任务级指标,并检查输出有限性。
与 GPU 性能基础的关系
Agent 没有绕开性能工程,只是把性能工程变成可调用、可记录的闭环。理解这类系统仍需要三层基础:
- 硬件层:warp 调度、寄存器、共享内存、缓存、HBM、Tensor Core、异步拷贝与 barrier。可先阅读本站 GPU GEMM 优化(一)、(二) 与 (三),理解分块如何逐层映射到硬件。
- Kernel 算法层:访存复杂度、online softmax、流水与 warp specialization。FlashAttention-4 展示了算法与 Blackwell 流水线共同设计的典型案例。
- 表示与工具层:CUDA、CUTLASS、Tile DSL、编译 IR、profiler 与 benchmark。TileLang 说明 tile 级抽象如何缩小搜索空间,DeepGEMM 则展示了专用 GEMM 工程如何逼近硬件上限。
Roofline 仍是诊断的第一张地图。算术强度 等于 FLOPs 与从主存搬运字节数之比,理论上限为:
但实际 Agent 不能只看这一条线。低于 Roofline 可能来自 occupancy、不规则访存、同步、指令依赖、launch 开销或流水气泡。CUDAMaster 的分类、NCU 技能和 CAKE 的静态分析,正是在把“为什么没有靠近上限”拆成可行动证据。
还没有解决的问题
这些系统的结果令人鼓舞,但仍处于早期阶段。
可复现成本很高。 七天搜索或数千万 token 的实验同时消耗 GPU 与模型推理预算。论文常报告最好结果,却较少完整公开多次运行的方差、失败预算和人工介入量。未来评价应同时报告 wall-clock、GPU-hours、token、编译次数、有效候选率和达到某阈值的成功概率。
跨硬件迁移仍弱。 B200 上的 warp specialization 与 TMEM 技巧不能直接迁移到 AMD MI300X;AsmEvo 的汇编知识又高度依赖 ISA。真正可复用的应是分层知识:算法不变量、架构族规则、具体芯片参数分别存储。
正确性仍主要依赖测试。 differential testing 能发现大量错误,却无法证明所有输入等价。类型化 IR、SMT/符号执行、内存安全检查和同步分析有机会把一部分动态验证前移为静态保证。
端到端目标不等于 Kernel 延迟。 在线推理还受批处理、KV Cache、通信、调度和尾延迟影响。一个 Kernel 的 10% 加速若只占请求时间的 2%,总收益不足 0.2%。自动系统应结合真实 trace 和模型级 profiler 分配搜索预算。
搜索产生的软件供应链风险。 Agent 会读取外部代码、编译并运行生成程序。依赖固定、网络隔离、最小权限、产物签名、可追溯来源与回归测试必须成为默认基础设施,而不是论文之外的部署附注。
如何阅读这一技术路线
如果目标是快速建立整体认识,可以按“闭环为什么必要 → 闭环如何长期运行 → 表示如何决定上限”的顺序阅读:先看 CUDAMaster,理解 profiler 驱动;再看 AVO 与 KDA,理解记忆、候选和验证;最后看 CAKE,理解为什么工具链本身也要为 Agent 改造。
如果目标是构建系统,建议按工程依赖顺序:
- KDA/Humanize:先把不可变基线、独立验证、分阶段循环和 profiler 工具做对;
- Kernel Forge:接入真实模型、operator card、guard、dispatcher 与 fallback;
- CUDAMaster:压缩 profiler 反馈,形成有证据的优化假设;
- AVO:在可审计基础上加入分支、谱系、种群和停滞检测;
- FACT/CAKE:当原始 CUDA 搜索反复遇到同类困难时,提升生成抽象并把能力沉淀到 pattern 或 IR;
- AsmEvo:源码边界之外,再扩展到部署二进制的局部优化。
这条路线的共同结论很明确:模型能力决定一次提案的质量,工作流决定系统能否持续进步,程序表示决定它究竟能看见并抵达多大的搜索空间。AutoKernel 的终点不是一个会写 CUDA 的聊天机器人,而是一套能够测量、推理、修改、验证、搜索、交付并对全过程负责的性能工程系统。
参考资料
- CUDAMaster: Making LLMs Optimize Multi-Scenario CUDA Kernels Like Experts
- AVO: Agentic Variation Operators for Autonomous Evolutionary Search
- MLSys 2026 FlashInfer Kernel Generation Contest
- FlashInfer Contest 官方仓库
- ncu-report-skill
- Kernel Forge: An Agent Harness for LLM-based Generation and Optimization of CUDA Kernels
- FACT: Compositional Kernel Synthesis with a Three-Stage Agentic Workflow
- CAKE: Compiler-Agent Co-Design for Frontier Kernel Evolution
- AsmEvo: Agentic Assembly-Level Optimization of AMD GPU Kernels with Functional Equivalence Verification
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


