


2026 大模型市场全景调查:主流模型能力、参数量与 API 价格总表
这篇是一次「非知识型」的市场调查:把 2026 年 9 月这个时间点上,国内外还在牌桌上的主流大模型摊开来看——它们各自擅长什么、体量多大、API 卖多少钱、开源还是闭源。数据快照日期为 2026-09-04,全部来自各家官方公告、官方定价页与公开评测渠道的交叉核对,文中会明确区分「厂商自报」与「第三方口径」两类数字。
先说三个口径问题
调查类文章最容易误导人,先把口径说清楚:
- 价格只认「官方标准 API 直连价」,且只认快照日。 2026 年的模型定价变动极快:DeepSeek 8 月 17 日大幅调价并引入峰谷计价,OpenAI 8 月 21 日给 GPT-5.6 Sol 限时降价 20% 以上。本文价格均标注生效时间,下单前以各家官网为准。
- benchmark 分数要分清「谁测的」。 厂商发布时公布的分数全是自报口径,Artificial Analysis、LMArena 等第三方机构的分数才是同一尺度上的横评。本文两套数字都列,横向对比优先用第三方。
- Artificial Analysis 智能指数在 2026 年 8 月改过版(v4.1),改版前后分数不可跨期比较。例如 Gemini 3.1 Pro 今年 2 月首发时在该指数上 57 分登顶,8 月重测只有 46.5——不是模型变笨了,是尺子变严了。
- 人民币与美元的粗略换算按 1 美元 ≈ 7.2 元,只用于直觉对比。
谁在牌桌上:2026 年中的模型版图
过去九个月是模型发布密度极高的时期,各家节奏大致是:
- Anthropic:6 月 9 日 Fable 5,6 月 30 日 Sonnet 5 成为所有订阅档默认模型;7 月 24 日 Opus 5;9 月 1 日 Fable 5.1 / Mythos 5.1,缓存读取费下调 75%。
- OpenAI:7 月 9 日 GPT-5.6 家族(Sol / Terra / Luna)全面可用;9 月 3 日发布 GPT-6 Astra,主打「像人一样操作电脑」。
- Google:2 月 19 日 Gemini 3.1 Pro 预览版;此后 Flash 线快速迭代(3.6 → 3.7 → 3.8),9 月 2 日发布 Gemini 3.8 Flash 与其网络安全变体。
- Meta:品牌从 Llama 转向 Muse。8 月 5 日 Muse Spark 1.2,8 月 10 日开源本地模型 Muse Glimmer 30B,9 月 2 日旗舰 Muse Spark 1.3。
- xAI:8 月 12 日发布 Grok 4.6,定价约为同级旗舰的一半。
- 国内:DeepSeek 4 月底发布 V4(Flash 开源 284B、Pro 为 1.6T API),8 月 17 日调价并引入峰谷计费;阿里 Qwen3.7-Max 5 月上线;月之暗面 7 月开源 Kimi K3(2.8 万亿参数,全球最大);智谱 6 月 GLM-5.2 开源、8 月 26 日 GLM-5.3-Flash 开源并主打国产算力;字节豆包 2.0、MiniMax、阶跃星辰持续低价迭代。
- 新玩家:8 月 30 日上海原点星辉发布 StartLux-27B,主打消费级电脑本地运行,走「本地 Agent 模型」路线。
几条贯穿全文的主线:涨价潮与「算力通胀」(智谱两次上调 API 价格、DeepSeek 高峰时段加倍,低价补贴时代在收敛);开源许可开始设置商业门槛(Kimi K3 对大规模转售推理的云厂商收费);「本地模型」成为新叙事(30B 级模型密集发布,都能跑在消费级硬件上)。
厂商与模型全景:一张表看全家桶
下表覆盖 2026 年 9 月仍活跃的主要模型。参数量只填官方或可靠报道公开的口径;闭源模型的「参数量」在 2026 年已经越来越不重要——头部闭源模型基本不再公布参数量(规模与能力的强相关叙事已被 MoE 打破,公布规模也等于泄露成本结构),所以判断一个闭源模型「贵不贵」,看价格与速度比看参数量可靠得多。
| 厂商 | 模型(版本) | 发布 | 规模(公开口径) | 上下文 | 一句话定位 |
|---|---|---|---|---|---|
| Anthropic | Claude Fable 5.1 / Mythos 5.1 | 2026-09-01 | 未公开(与受限版 Mythos 5.1 同一权重家族) | 1M 输入 / 128K 输出 | 编码与知识工作旗舰;Mythos 为受限安全版(网络/生物) |
| Anthropic | Claude Opus 5 | 2026-07-24 | 未公开 | 1M / 128K | 通用旗舰,约 Fable 一半价格、能力差半个百分点 |
| Anthropic | Claude Sonnet 5 | 2026-06-30 | 未公开 | 1M / 128K | 中端默认档,Agent 能力接近 Opus 4.8 |
| Anthropic | Claude Haiku 4.5 | 2025-10 | 未公开 | 200K / 64K | 轻量低价档,仅 API |
| OpenAI | GPT-6 Astra | 2026-09-03 | 未公开 | 1.05M / 128K | 旗舰,自主操作电脑;网络安全能力达「Critical」阈值,受限发放 |
| OpenAI | GPT-5.6 Sol / Terra / Luna | 2026-07-09(GA) | 报道称基于约 4T 参数的 GPT-5.5 底座(未官方证实) | 1.05M / 128K | 天体系三档:Sol 深度推理、Terra 生产主力、Luna 低延迟低价 |
| Gemini 3.1 Pro | 2026-02-19(预览) | 未公开 | 1M / 64K | Pro 档最新;此后仅迭代 Flash 线 | |
| Gemini 3.8 Flash(含 Cyber 版) | 2026-09-02 | 未公开 | 1M / ~64K | 快速档,面向 Agent 高频调用 | |
| Meta | Muse Spark 1.3 | 2026-09-02 | 未公开 | 1M | 编码与长程 Agent 旗舰(开源版待定) |
| Meta | Muse Glimmer 30B | 2026-08-10 | 约 296 亿稠密(278 亿 LM + 18 亿视觉编码器) | 131K+ | 本地开源模型,24GB 显存可跑,Apache 2.0 |
| xAI | Grok 4.6 | 2026-08-12 | 未公开 | 500K | 旗舰;同分数档位里约半价 |
| NVIDIA | Nemotron 3.5 Lightning | 2026-08-11 | 316 亿总参 / 36 亿激活(MoE + Mamba-2 混合) | 1M | 本地「高频执行层」,NVFP4 下约 670 token/s |
| DeepSeek | V4-Pro | 2026-04 预览,08-17 正式 | 约 1.6T 总参 MoE(激活参数未官方公布) | 1M | 国内旗舰推理模型,Agent 与编码见长 |
| DeepSeek | V4-Flash(0731) | 2026-04-24 开源 | 284B 总参 / 13B 激活(MIT) | 1M | 开源低价主力,编码基准强 |
| 阿里 | Qwen3.7-Max | 2026-05-21 | 未公开 | 1M(纯文本) | 国内闭源旗舰,5 月时 AA 指数最高的中国模型 |
| 阿里 | Qwen3.6-27B / 35B-A3B | 2026-04-22 | 27B 稠密 / 35B 总参 3B 激活 | 262K(可扩 1M) | 开源谱系(Apache 2.0),本地部署主力 |
| 月之暗面 | Kimi K3 | 2026-07-17(07-27 开源权重) | 2.8T 总参 / 1040 亿激活 MoE | 1M | 全球最大开放权重模型;KDA 混合线性注意力 |
| 智谱 | GLM-5.2 | 2026-06-13 | 753B 总参 / 约 40B 激活(MIT 开源) | 1M / 128K | 长程 Agent 编码旗舰,企业编码接近 Opus 4.8 |
| 智谱 | GLM-5.3-Flash | 2026-08-26 | 320B 总参 / 18B 激活 | — | 「牛来」;原生多模态轻旗舰,10 万张国产芯片承载 |
| 字节 | Doubao Seed 2.0 Pro | 2026-02-14 | 未公开 | 256K | 全栈多模态 Agent,对标 Gemini 3 Pro |
| MiniMax | M2.7 / M3 | 2026 上半年 | 未公开 | — | 低价高吞吐;M3 为价格上探的旗舰 |
| 阶跃星辰 | Step-3.7-Flash | 2026 上半年 | 198B(MoE) | — | 低价 Flash 档 |
| 原点星辉 | StartLux-V1.0-27B-Preview | 2026-08-30 | 27B 稠密(基于 Qwen3.6-27B) | — | 本地 Agent 模型,消费级电脑运行 |
能力对比:一张表看谁最强
综合 Artificial Analysis 智能指数、LMArena 与各家官方/第三方基准,2026-09-04 快照,「最强」之外只列最值得考虑的替代:
| 能力维度 | 目前最强 | 值得考虑的替代 | 一句话依据 |
|---|---|---|---|
| 综合智能 | Claude Fable 5.1(AA 智能指数 66 分,改版后历史最高) | Claude Opus 5(63,成本低 26%);61 分档:GPT-6 Astra、GPT-5.6 Sol、Grok 4.6、Muse Spark 1.3 | 第三方 AA 指数 2026-09-02 快照;Gemini 3.1 Pro、Qwen3.7-Max 发布于改版前未上榜 |
| 编程与软件工程 | Claude Fable 5.1 / Opus 5(SWE-bench Pro 79–80%) | Muse Spark 1.3(DeepSWE 75.4,Meta 自报);GPT-5.6 Sol(Terminal-Bench 88.8%);开源看 DeepSeek V4-Flash(52.6%) | 各家在更难的新基准上互有胜负;Fable 5.1 的 Terminal-Bench 4.0 55.8% 与 Astra 的 57.7% 同级 |
| 数学与科学 | GPT-6 Astra(GPQA Diamond 96.0%、FrontierMath 97.6%,均自报) | Claude Fable 5.1(HLE 65%,科学 Agent 最强);DeepSeek V4-Flash 是开源数学天花板(AIME 94.4%) | Astra 宣传的 ARC-AGI-3 99.9% 出自定制 harness,默认 harness 只有 62.7%,勿直接采信 |
| Agent / 电脑操作 | GPT-6 Astra(OSWorld 2.0 72.6%、BrowseComp 91.5%,断层第一) | GPT-5.6 Sol(65.7% / 90.4%);Anthropic 系主推 AutomationBench(Fable 5.1 31.4%,近乎翻倍) | 干活类基准厂商环境口径差异大,只能同版本比 |
| 知识工作与事实性 | Claude Fable 5.1(GDPval-AA 1853、AA Omniscience 43.3%) | Claude Opus 5(1824);中文模型靠「学会拒绝」在追(Qwen3.7-Max 幻觉率从 44.2% 降到 22.9%) | Anthropic 系断层领先;GPT-5.6 Sol 的 Omniscience 仅 22.0% |
| 长上下文 | 闭源旗舰基本全进原生 1M(Fable 5.1 / Opus 5 / Astra / Sol / Gemini 3.1 Pro / Kimi K3 / GLM-5.2 / V4) | 1M 下召回最好的是 Astra(256K–512K 100%、512K–1M 96.3%,OpenAI 自报);Grok 4.6 只有 500K | 1M 已是标配,差异在「1M 下还能不能干活」与计费方式(见价格节) |
| 中文与国内场景 | 没有统一第三方榜;国产旗舰 DeepSeek V4-Pro、Qwen3.7-Max、GLM-5.2 各擅胜场 | 信通院 MCP-Universe(2026-08):V4-Pro 第一、StartLux-27B 第二(超 V4-Flash 与 Step-3.7-Flash) | 国内选型很多时候是在选芯片生态:DeepSeek 与智谱的国产卡适配最全 |
| 人类盲测 | Claude Fable 5(LMArena Elo 1508,2026-08-21 快照) | Claude Opus 4.6/4.7、Muse Spark 1.2(1490–1504) | 榜单混排思考档位;Astra 与 Fable 5.1 发布太晚上榜票数不足 |
| 开源权重(总榜) | Kimi K3(2.8T 总参,全球最大开放权重) | GLM-5.2(753B / MIT)、DeepSeek V4-Flash(284B / MIT) | 各有侧重,编码/数学/本地分别看下文开源表 |
| 低价 / 性价比 | DeepSeek V4-Flash、GLM-5.3-Flash(国内);Gemini 3.8 Flash、Muse Spark 1.3(海外) | 走量档:Doubao Seed 1.6 Lite(¥0.3 起)、Luna、Haiku 4.5 | 谷时价 + 缓存命中价还能再低一个数量级(V4-Flash 命中 ¥0.05) |
| 本地可跑(消费级硬件) | Muse Glimmer 30B(24GB 显存,Apache 2.0) | Qwen3.6-35B-A3B(64GB MacBook)、Nemotron 3.5 Lightning(RTX 5090 级)、StartLux-27B(任意消费机) | 30B 级本地模型在 2026 年已是实用工具 |
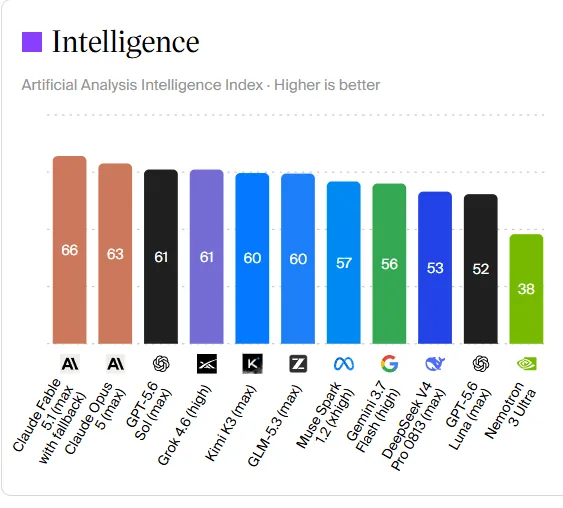
读表注意三点:第一,除标注「自报」的数字外,横向对比均优先采用第三方口径;第二,同一模型在 high/max 等不同思考档位下,分数可差出 5 个指数点,比量级前先确认档位;第三,本表是 2026-09-04 的快照——头部模型几乎每周都在发布新品,最强之位随时可能易主。
API 价格总表
以下两张表是本次调查的核心交付物。原则:官方直连价、标注生效时间、缓存价单列。所有价格为每百万 token。
海外厂商(美元 / 百万 token)
| 厂商 | 模型 | 输入(缓存未命中) | 输出 | 缓存读取 | 备注 |
|---|---|---|---|---|---|
| Anthropic | Claude Fable 5.1 / Mythos 5.1 | $10.00 | $50.00 | $0.25 | 9/1 起缓存费降 75%;批量半价;1M 上下文无附加费 |
| Anthropic | Claude Opus 5 | $5.00 | $25.00 | $0.50 | 批量 $2.50/$12.50;Fast 模式 $10/$50 |
| Anthropic | Claude Sonnet 5 | $3.00 | $15.00 | $0.30 | 9/1 起生效(8/31 前促销价 $2/$10);新 tokenizer 使输入膨胀 1.0–1.35 倍 |
| Anthropic | Claude Haiku 4.5 | $1.00 | $5.00 | $0.10 | 批量 $0.50/$2.50 |
| OpenAI | GPT-6 Astra | $10.00 | $50.00 | $1.00 | >272K 输入的请求整段 2×/1.5×;批量与 Flex 半价;Fast 2× |
| OpenAI | GPT-5.6 Sol | $4.00 | $20.00 | $0.40 | 8/21 起限时降价(原 $5/$30),至少到 11/21;>272K 档 $8/$30 |
| OpenAI | GPT-5.6 Terra | $2.50 | $15.00 | 约 $0.25 | 缓存读取约 9 折 |
| OpenAI | GPT-5.6 Luna | $1.00 | $6.00 | 约 $0.10 | 最低速档 |
| Gemini 3.1 Pro | $2.00 | $12.00 | $0.20 | 输入 >200K 时整段 $4/$18(缓存 $0.40);批量半价 | |
| Gemini 3.8 Flash | $0.75 | $3.75 | $0.075 | 促销价到 2026-12-31,2027-01-01 起翻倍为 $1.50/$7.50 | |
| xAI | Grok 4.6 | $2.00 | $6.00 | $0.50 | 输入 ≥200K 整段 $4/$12(缓存 $1);Fast 2× |
| Meta | Muse Spark 1.3 | $1.25 | $4.25 | $0.15 | 授权数据贡献档低至 $0.10/$0.20 |
国内厂商(人民币 / 百万 token)
| 厂商 | 模型 | 输入(缓存未命中) | 输出 | 缓存命中 | 备注 |
|---|---|---|---|---|---|
| DeepSeek | V4-Pro | 峰时 ¥9 / 谷时 ¥4.5 | 峰时 ¥27 / 谷时 ¥13.5 | ¥0.30(峰时) | 8/17 正式版调价,工作日 9–12 点、14–18 点为峰时 |
| DeepSeek | V4-Flash | 峰时 ¥3 / 谷时 ¥1.5 | 峰时 ¥9 / 谷时 ¥4.5 | ¥0.05(峰时) | 缓存命中价全行业最低档之一 |
| 阿里 | Qwen3.7-Max | ¥12 | ¥36 | — | 5/22 上线价;另有 Token Plan 订阅 |
| 月之暗面 | Kimi K3 | ¥20($3) | ¥100($15) | ¥2($0.3) | 国际站美元价同表;1M 上下文无附加费 |
| 智谱 | GLM-5.3-Flash | ¥0.8 | ¥2.8 | ¥0.23 | 8/26 上线,限时五折(¥0.4/¥1.4)至 9/9;对标 Opus 4.8 的约 1/40 |
| 智谱 | GLM-5.2 | 国际站 $1.40 | 国际站 $4.40 | $0.26 | 753B 开源 MIT,可自托管;国内站旗舰经多次提价,报道口径输出约 ¥28 |
| 字节 | Doubao Seed 2.0 Pro | ¥3.2(≤32K 输入档) | ¥16 | ¥0.64 | 2/14 上线;Fast 档 ¥9.6/¥48 |
| 字节 | Doubao Seed 1.6 Lite | ¥0.3 | ¥0.6 | — | 走量低价档 |
| MiniMax | M2.7 | ¥2.1 | ¥8.4 | ¥0.42 | highspeed 档 2×;M3 旗舰价上探(输入 ¥4.2 起 / 输出 ¥16.8 起) |
| 阶跃星辰 | Step-3.7-Flash | ¥1.35 | ¥8.1 | ¥0.27 | 官方开放平台价 |
看懂价格表:五条提醒
token 单价只是表象,2026 年「实际账单」的差距来自五个机制:
- 缓存命中价是最大的一刀:DeepSeek V4-Flash 未命中 ¥3、命中 ¥0.05(差 60 倍),Fable 5.1 是 $10 对 $0.25。长前缀复用型负载的真实成本可比标价低一个数量级——比价先算自己的缓存命中率。
- 峰谷计价与超长加价:DeepSeek 峰时是谷时的 2 倍;OpenAI/Google 对超长输入(Astra >272K、Gemini Pro >200K)整段加价 1.5–2 倍。Kimi K3、GLM-5.2 的「1M 不加价」在国内是稀缺卖点。
- 思考(thinking)token 是账单里的隐形大头:Fable 5.1 每任务 $3.76、比 Fable 5 贵 20%,不是单价涨了,而是输出 token 用量多了 1.7 倍;同一个模型的 effort 档位能把单任务成本拉开 4 倍。
- 长上下文单次调用的绝对成本:填满 1M 输入的一次调用,Astra 约 $10(+输出),Kimi K3 国内约 ¥20(缓存命中只要 ¥2),DeepSeek V4-Pro 峰时 ¥9 / 谷时 ¥4.5——「读一本书再回答」这类应用,选错模型单次成本差 20 倍。
- tokenizer 差异:Anthropic 官方提醒 Sonnet 5 的新 tokenizer 会让同样内容的 token 数膨胀 1.0–1.35 倍,实付随你的文本语言分布浮动。
订阅套餐:个人使用才划算
如果只用于个人聊天/编码,订阅比 API 划算。2026 年各家的订阅格局如下(美元/月,综合各渠道 2026 年中快照):
| 产品 | 标准档 | 高级档 | 说明 |
|---|---|---|---|
| ChatGPT | Plus $20;Go $8 | Pro $100(5× 用量)/ $200(约 20×) | 2026 年 4 月 Pro 拆成两档;Astra 向 Plus 及以上逐步开放 |
| Claude | Pro $20 | Max 5×:$100 / Max 20×:$200 | Opus 5 在 $20 档即可用 |
| Google AI | AI Pro $19.99 | AI Ultra $99.99(5×)或 $199.99(20×) | Ultra 在 I/O 2026 从 $249.99 大幅降价 |
| Grok | SuperGrok $30(年付约 $25) | SuperGrok Heavy $300 | Heavy 是唯一完整解锁最新旗舰的消费级档 |
| Kimi | 年付 468 / 948 / 1908 元 | 全能尊享 6708 元/年 | 年付制,含多 Agent 与百万 token 对话额度 |
订阅的坑在于用量上限:$20 档与 $200 档能用的模型完全相同,差的是额度。重度编码用户一天就能撞穿 $20 档;普通使用则 $20 是 2026 年的事实行业基准价——ChatGPT Plus、Claude Pro、Google AI Pro 三家几乎同价,按生态选即可(重度 Google Workspace 用户选 Gemini、纯编码选 Claude/Codex)。
开源与本地:不被 API 定价绑架
2026 年 8–9 月开源阵营的格局:
| 模型 | 规模(总参/激活) | 许可 | 本地运行门槛 | 值得注意的点 |
|---|---|---|---|---|
| Kimi K3 | 2.8T / 1040 亿 | Kimi K3 License(修改版 MIT + MaaS 门槛) | 权重文件约 1.5TB,运行约需 1.4TB 显存,生产需 64+ 加速器 | 全球最大开放权重;KDA 混合线性注意力 |
| GLM-5.2 | 753B / 约 40B | MIT | 多卡集群 | 企业编码≈Opus 4.8、成本低 34%(Databricks 实测) |
| DeepSeek V4-Flash | 284B / 13B | MIT | 8 卡级 | 1M 上下文 + 编码基准强 + 国产芯片全适配 |
| Muse Glimmer 30B | 约 296 亿稠密 | Apache 2.0 | 24GB 显存消费卡 | KV 缓存仅 52KiB/token(Gemma 4 31B 是 840KiB) |
| Qwen3.6-35B-A3B | 35B / 3B | Apache 2.0 | 64GB MacBook 可跑(MLX) | 90–172 token/s,多模态输入 |
| Nemotron 3.5 Lightning | 31.6B / 3.6B | OpenMDW-1.1 | RTX 5090 级 | Mamba-2+注意力混合,1M 上下文,NVFP4 下约 670 token/s |
| Qwen3.6-27B | 27B 稠密 | Apache 2.0 | 消费级 | StartLux 的基座 |
| StartLux-27B | 27B 稠密 | 本地免费 | 消费级电脑 | 信通院 MCP 评测综合第二的「本地 Agent」 |
| AgentCPM-Explore | 4B | 开源 | 任意笔记本 | 最小的 Agent 尝试之一 |
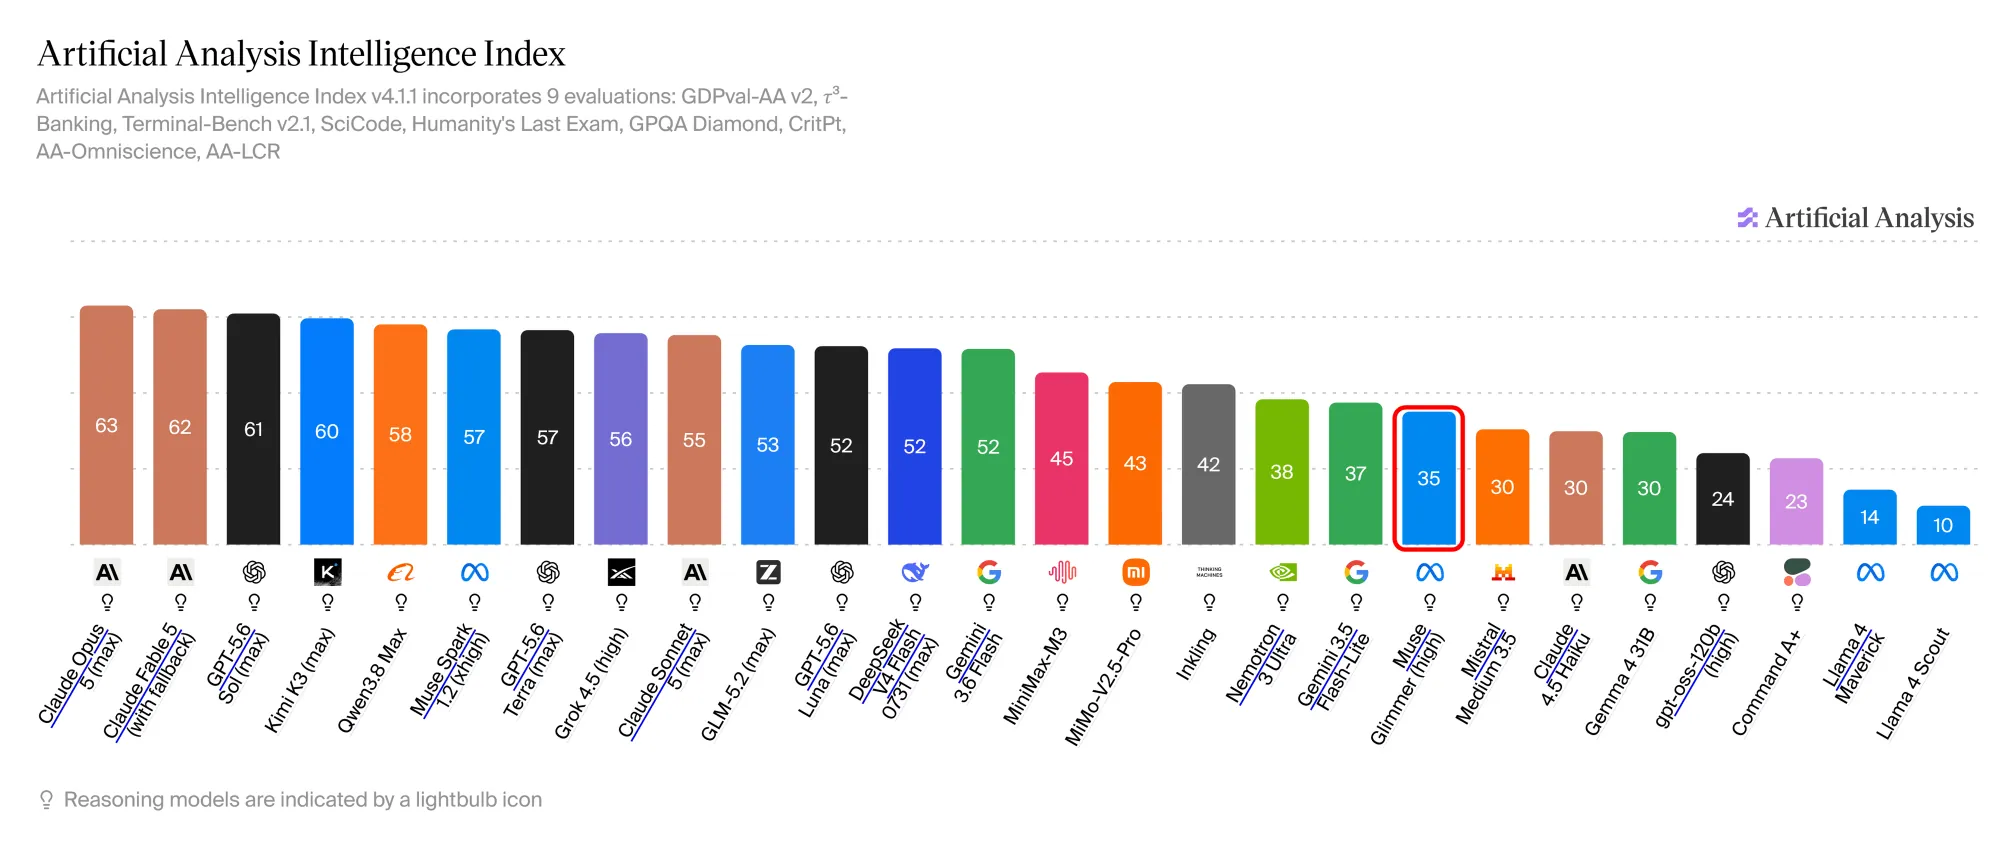
值得单独说的三点:
- K3 License 是开源许可史上的一个转折点:主体是 MIT 式的自由条款,但向第三方提供推理/微调服务、且 12 个月收入超 2000 万美元的服务商必须与月之暗面另签商业协议。直白地说:权重免费,但「拿它开云」不再免费。
- 30B 级本地模型的差异在「每 token 的内存成本」而不只是分数:Muse Glimmer 用 16:1 的 GQA 把 KV 缓存压到 52KiB/token(Gemma 4 31B 的十六分之一);Nemotron 3.5 Lightning 直接换 Mamba-2 混合架构拿 1M 上下文。规划交给云端旗舰、工具调用这类重复劳动交给本地小模型,是 2026 年主流的分工方式。
- StartLux 代表「后训练大于基座」的路线:它不训基座,买 Qwen3.6-27B 的底座做三个月深度后训练,就让模型在信通院 MCP 评测里超过了十倍大的 V4-Flash-0731 与 Step-3.7-Flash。
选型速查:按你的场景
把上面的结论压缩成一张速查表。价格为 2026-09-04 快照,选型前请自行复测:
| 你的场景 | 首选 | 理由 |
|---|---|---|
| 预算充足的旗舰级编码/知识工作 | Claude Fable 5.1 或 Opus 5 | AA 前三占二;预算敏感直接 Opus 5(每任务成本低 26%–38%) |
| 需要「模型自己操作电脑/浏览器」 | GPT-6 Astra(API 全量开放后) | OSWorld 2.0 72.6%、BrowseComp 91.5%,断层第一;注意网络安全任务受限 |
| 性价比编程(个人/创业团队) | Claude Sonnet 5 / Grok 4.6 / Muse Spark 1.3 | Sonnet 5 是 $20 订阅默认模型;后两者 API 单价低且编码分接近第一梯队 |
| 大规模低成本文本处理 | Gemini 3.8 Flash / GLM-5.3-Flash / DeepSeek V4-Flash 谷时 | 前三档价格在 $0.75–¥3 区间,DeepSeek 缓存命中 ¥0.05 适合长前缀复用 |
| 中文任务 + 国内合规/国产算力 | DeepSeek V4 / Qwen3.7-Max / GLM 系 | 昇腾/寒武纪/摩尔线程适配最全的是 DeepSeek 与智谱 |
| 本地运行 + 隐私 | Muse Glimmer 30B(24GB 卡)/ StartLux-27B / Qwen3.6-35B-A3B(笔记本) | 按显存选:24GB / 消费机 / 64GB Mac |
| 数学/科学深度推理 | Astra(API 开放后)或自托管 DeepSeek V4-Flash | FrontierMath 97.6%(自报);开源 AIME 94.4% |
| 学习与研究(免费) | DeepSeek V4-Flash、GLM-5.2、Qwen3.6 系 | MIT/Apache 权重,论文复现与 kernel 优化都自由 |
| 网络安全防御研究 | Mythos 5.1 / Astra(Daybreak Blue 白名单) | 受限发放,需申请,别拿通用版做攻防 |
局限:这些数字怎么读
- 价格时效:DeepSeek 8 月 17 日、OpenAI 8 月 21 日都调过价,9 月内仍可能再变;GLM-5.3-Flash 的五折到 9 月 9 日截止。表中价格全部标注了生效时点。
- 自报 vs 第三方:凡未标「第三方」的 benchmark 分数都是厂商自报;同一厂商在不同版本测试(SWE-bench Pro / Verified、OSWorld 2.0 / Verified)上的口径经常不一致,横向对比优先看 AA 智能指数与 LMArena。
- 配置敏感:2026 年的推理模型分数高度依赖 thinking effort 档位(low/max 可差出 5 个指数点),比价与比能力时都要确认对方用的是哪个档。
- 本文未覆盖:多模态(图像/视频生成与理解)仅顺带提及、语音未展开;欧洲(Mistral 等)与日韩厂商未纳入;企业私有化部署的市场报价(通常按年签约、不公开)不在 API 价格表内。这些是后续调查的候选主题。
参考资料
- Introducing Claude Sonnet 5(Anthropic 官方)
- Claude Fable 5 API Pricing, Context Window & Benchmarks(llm-stats)
- Anthropic 上新 Fable 5.1:综合成本最高降 45%(澎湃新闻)
- Claude Fable 5.1 and Mythos 5.1 arrive with 75% cache-read cut(VentureBeat)
- Anthropic 发布 Claude Fable 5.1 和 Mythos 5.1(IT之家,正文配图来源)
- Claude Sonnet 5 发布:比 Opus 4.8 低 60%(VentureBeat)
- Claude Opus 5 Pricing: same sticker, different bill(CloudZero)
- GPT-6 Astra Model(OpenAI 开发者文档)
- Introducing GPT-6-Astra(OpenAI 开发者社区公告)
- OpenAI begins rolling out Astra model(CNBC)
- OpenAI starts rolling out GPT-6 Astra(SiliconANGLE,配图来源)
- GPT-6 Astra: Flagship With a Launch Table(llm-stats)
- The new GPT-5.6 family: Luna, Terra, Sol(Simon Willison)
- GPT-5.6 Sol API Pricing(llm-stats)
- Claude Fable 5.1 tops the Artificial Analysis Intelligence Index(AA 官方文章)
- Opus 5: Fable 5 level intelligence at a lower cost per task(AA 官方文章)
- Fable 5.1 Scores Tops AA Intelligence Index With Score of 66(OfficeChai,配图来源)
- Artificial Analysis Intelligence Index Leaderboard(BenchLM 榜单快照)
- Text Generation Arena 文本生成排行榜(DataLearner/LMArena 快照)
- Meta 发布 Muse Spark 1.3(网易科技)
- Meta unveils Muse Spark 1.3(SiliconANGLE)
- Meta 公开本地开源模型 Muse Glimmer(Gigazine,配图来源)
- Muse Glimmer 30B Architecture Notes(Sebastian Raschka)
- NVIDIA 开源 Nemotron 3.5 Lightning(The Decoder)
- Grok 4.6 API Pricing, Context Window & Benchmarks(llm-stats)
- Gemini 3.8 Flash API Pricing & Benchmarks(llm-stats)
- Gemini 3.1 Pro Benchmarks, Pricing & Speed(BenchLM)
- DeepSeek V4 API Pricing(Apidog)
- 最高涨幅 1100%!DeepSeek 逆势调价(三沙财经)
- DeepSeek V4 Flash 284B 发布与开源(ZOL)
- 阿里云百炼上线 Qwen3.7-Max(证券时报)
- Qwen 3.7 Max Becomes Highest-Placed Chinese Model On AA Index(OfficeChai)
- 月之暗面发布全球最大开源模型 Kimi K3(CNMO)
- Kimi K3 开源全解:2.8T 参数、KDA 架构与 96 分片部署实录(七牛云)
- Kimi K3 正式开源(21 世纪经济报道)
- GLM-5.2: 753B Open-Weight Coding Model(MorphLLM)
- 智谱开源 GLM-5.3-Flash,10 万张国产卡承载(36 氪)
- 智譜開源 GLM-5.3-Flash 定價為 Opus 4.8 的 1/40(觀點網)
- 字节跳动发布豆包大模型 2.0(DoNews)
- 阶跃星辰开放平台定价文档(StepFun 官方)
- StartLux-27B 本地大模型打赢 DeepSeek V4 Flash(新浪财经)
- 本地大模型 StartLux-27B 通过 MCP-Universe 测评(新浪财经)
- Kimi K3 多少钱?API 定价与订阅费用全解析(AI-Indeed)
- MiniMax 与 Doubao 等国内模型价格对比(TrakToken)
- 2026 各模型 API 定价一览表(OpenClaw 省钱指南)
- AI Pricing Guide 2026: What ChatGPT, Claude, Gemini and Grok Cost(PerspectiveAI)
- Doubao Seed 2.0 Pro vs MiniMax M2.7 对比(LumiChats)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


