


DeepSeek-OCR 完全拆解:光学上下文压缩——10 倍压缩下 97% 还原
这篇论文在时间线上的位置
2025 年 10 月 20 日,DeepSeek 放出了 DeepSeek-OCR,论文标题直接写明主张:DeepSeek-OCR: Contexts Optical Compression(光学上下文压缩),arXiv 编号 2510.18234,作者是韦浩然、孙耀峰、李宇坤三人,隶属 DeepSeek-AI。放在 DeepSeek 技术全景那条从 67B 稠密模型到 1.6T 稀疏模型的时间线上,它是一个明显的”岔路”:同一时期的主力工作是 MoE、MLA、稀疏注意力、FP8 这些把文本 token 处理得更便宜的手段,而这篇论文问的是一个更根本的问题——能不能不把信息编码成文本 token。
2026 年 1 月 27 日,同一个三人小组又放出 DeepSeek-OCR 2(arXiv:2601.20552),标题是 Visual Causal Flow(视觉因果流),把一代中承担”知识压缩”角色的 CLIP 换成了一个轻量语言模型,让编码器在把视觉 token 交给解码器之前先按语义重排顺序。两篇加起来,构成了”用视觉模态做上下文压缩”这条路线目前的完整公开记录。
这篇把它拆开讲:成本账怎么算、DeepEncoder 每一段为什么这么设计、压缩比与精度的完整曲线、OmniDocBench 上的横向对比,以及二代为什么要动编码器的注意力掩码。
问题:长上下文为什么需要”换一种模态”
文本 token 的二次方账
先说清楚这篇论文要绕开的是什么。一个标准的自回归 Transformer,处理长度为 的 token 序列时:
- 注意力计算量与 成正比。 从 32K 涨到 128K,注意力部分的 FLOPs 涨 16 倍。
- KV Cache 显存与 成正比。这是更硬的那堵墙——它不随算力增长而缓解,只随序列长度线性膨胀,且必须在整个解码过程中常驻。
- 解码时的显存带宽消耗同样与 成正比。每生成一个 token 都要把全部历史 KV 读一遍,长上下文解码因此极易从”计算受限”滑向”带宽受限”。
工业界对付这三笔账的路线已经相当丰富,本站在 DeepSeek-V4 混合注意力完全拆解中拆过 CSA+HCA 的混合压缩,在 MLA 完全拆解中拆过把 KV 压成低秩潜向量的做法,在 DeepSeek-V4.1-Flash 推理侧完全拆解中甚至算到过 890 字节/token 这个量级。这些工作方向不同,但有一个共同的隐含前提:信息仍然以文本 token 为单位存在,压缩只是让每个 token 变便宜、或者让一部分 token 被丢掉。
DeepSeek-OCR 换了个问法:如果一个 token 的”信息密度”本身可以提高,那 是不是可以更小?
视觉 token 的信息密度
论文的出发点是一个几乎算常识、但很少有人认真量化的观察:同样一页纸的内容,渲染成图片再编码,需要的 token 数远少于直接编码文本。
它给这件事设了一个可量化的形式。令:
- = 把页面真值文本用 tokenizer 编码后的 token 数(论文用的是 DeepSeek-OCR 自己的 tokenizer,词表约 129k);
- = DeepEncoder 从这张页面图片里输出的视觉 token 数。
定义压缩比为 。论文在 Fox 基准(一个多页文档理解基准)上筛出 100 页英文文档,其真值文本长度落在 600–1300 个 token 区间——正好对应一页普通文档——然后用 Tiny(64 视觉 token)和 Small(100 视觉 token)两种模式去解码,看能还原到什么程度。
这个设定本身就说明了问题:一页文档大约 1000 个文本 token,而模型只需要 100 个视觉 token 就能把它读回来。同一份信息,视觉模态的编码成本是文本模态的约 1/10。
为什么这个压缩”不要钱”
这里有个容易被忽略的论证。任何多模态系统本来就必须配一个视觉编码器,它是系统的基础设施而不是额外开销。所以论文说,把历史上下文渲染成图再编码,“does not bring any overhead because it can leverage VLM infrastructure”——这笔压缩的固定成本已经由多模态能力本身付掉了,剩下的是纯粹的 token 节省。
这个论证有个前提:系统已经决定要做多模态。如果是一个纯文本 LLM,为了压缩上下文而外挂一个视觉编码器,那这笔账要另算。论文显然把自己定位成前一种情况。
DeepEncoder:为什么要自己造一个编码器
论文要验证的命题决定了编码器必须具备五个特征,这五条是设计空间的约束条件:
- 能处理高分辨率(文档是密集文本,分辨率低了字就糊);
- 高分辨率下激活显存要低(否则 1024×1024 的图直接把显存打爆);
- 输出的视觉 token 要少(这是压缩比的分母);
- 支持多种分辨率输入(同一个模型要能应对不同信息密度的页面);
- 参数量适中(不能为了 OCR 塞一个 7B 的 ViT)。
论文在第 2.1 节论证了当时开源界三类主流视觉编码器都满足不了全部五条,并且各自死在不同的地方。
- 双塔架构(以 Vary 为代表):并行挂一个 SAM 编码器来扩充”视觉词表”。参数和激活可控,但需要两套图像预处理流程,部署复杂,且训练时编码器部分的流水线并行很难编排。
- 切块(tile)架构(以 InternVL2.0 为代表):把大图切成小块并行计算,降低高分辨率下的激活。能处理极高分辨率,但原生编码器分辨率通常不到 512×512,大图会被切得过碎,产生海量视觉 token——这与”token 要少”直接冲突。
- 自适应分辨率编码(以 Qwen2-VL 为代表):走 NaViT 范式,直接按 patch 切分整图,不做 tile 并行。分辨率灵活,但大图的激活显存巨大、可能直接 OOM;训练时序列 packing 需要极长序列;而且长视觉 token 序列会同时拖慢 prefill 和解码两个阶段。
三类方案的问题可以归结成一句话:要么激活爆掉,要么 token 太多,二者不可兼得。DeepEncoder 的解法是把”处理高分辨率”和”维持少量 token”这两件事拆到序列的两端去做,中间用一个下采样器隔开。
三段式结构
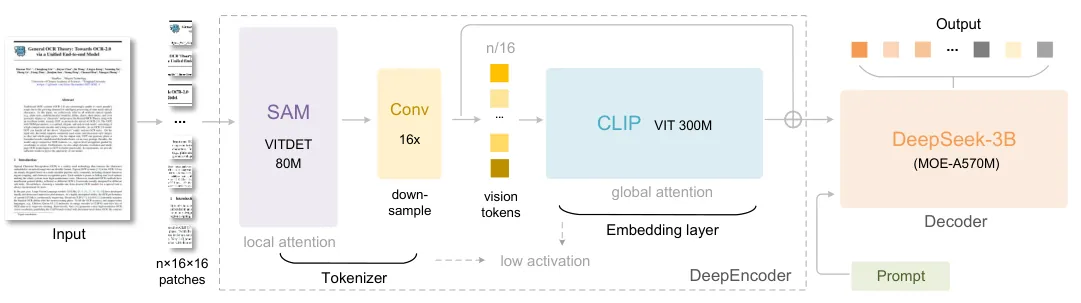
图:论文 Figure 3。左侧输入文档图片被切成 n 个 16×16 patch;中间是 DeepEncoder,由 SAM 感知塔、16× 卷积压缩器、CLIP 知识塔串联而成;右侧是 DeepSeek-3B(MoE-A570M)解码器。图片来源:DeepSeek-OCR 论文。
整个模型约 380M 参数的编码器加 3B 参数(激活 570M)的解码器。编码器三段是这样串起来的:
第一段,SAM-base 感知塔(约 80M 参数)。 用 SAM(Segment Anything Model)的 base 版本,patch size 为 16,注意力以窗口注意力为主。它的职责是在高分辨率下抽取局部视觉特征。为什么用 SAM 而不是 CLIP 打头?因为 SAM 的窗口注意力复杂度对 token 数近似线性,而且它只有 80M 参数——这两点叠加,使得即便前面有 4096 个 patch token,激活显存仍然可以接受。论文原话是 “the activation is acceptable”。
第二段,16× 卷积压缩器。 这是全篇最关键的一处设计。它从 Vary 借来,是两层卷积模块:每层 kernel size 3、stride 2、padding 1,通道数从 256 增加到 1024。两层 stride 2 的卷积叠加,空间尺寸各减半一次,总共 倍下采样;但由于 patch 本身已经是 16×16 的,patch 层面看到的等效下采样是 16 倍——所以论文说这是 “16× downsampling of vision tokens”。
第三段,CLIP-large 知识塔(约 300M 参数)。 使用稠密全局注意力,负责语义层面的知识聚合。论文做了一个看似微小但必要的改动:去掉 CLIP 的第一层 patch embedding。因为 CLIP 的输入已经不再是原图,而是上一级压缩器输出的 token 序列,重做一次 patch embedding 既无意义也会破坏已压缩的表示。
把这三段和它们各自处理的 token 数量放在一起,就能看清设计意图:
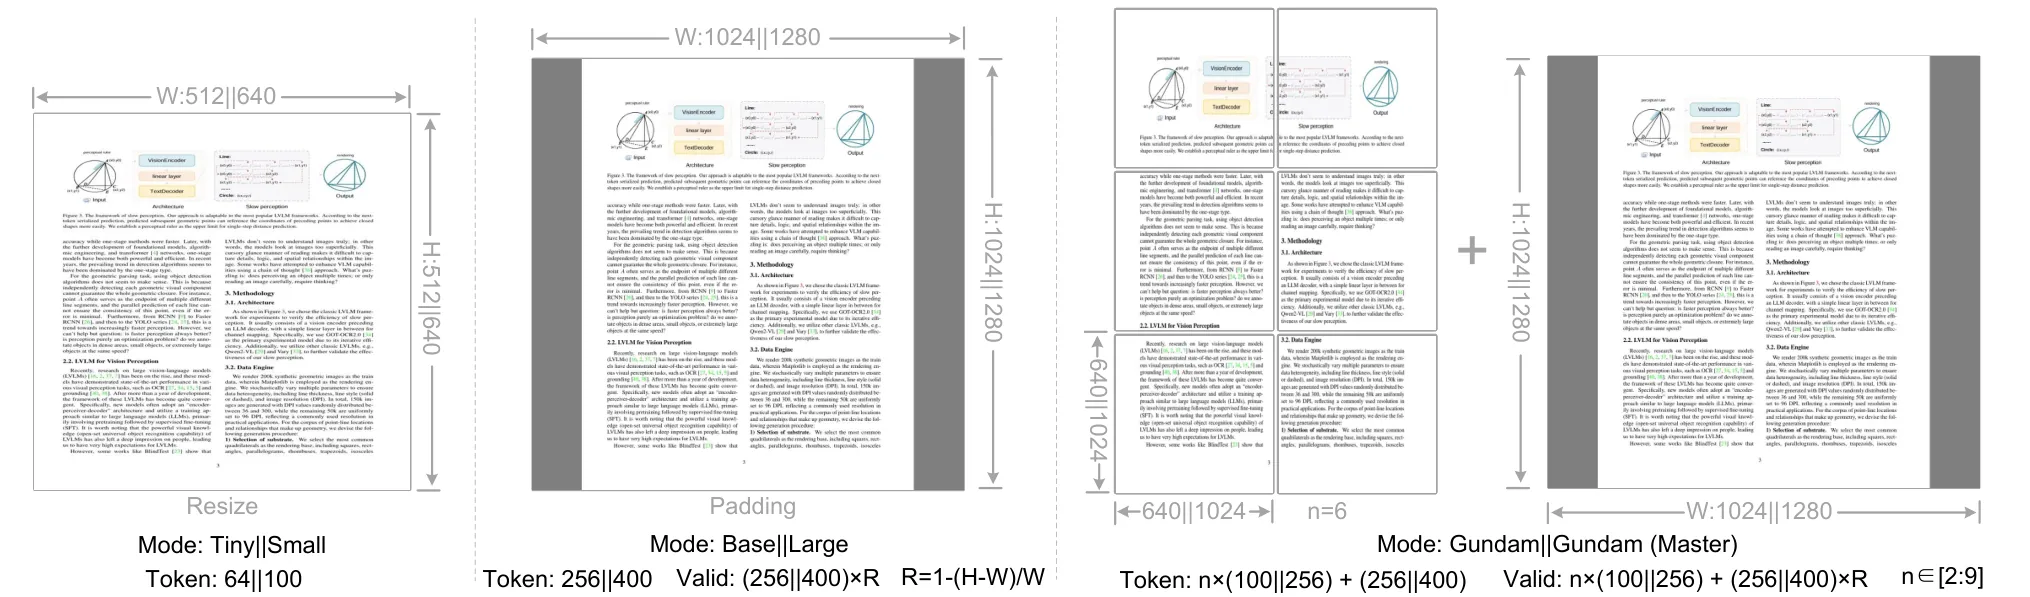
图:论文 Figure 4。Tiny/Small 走 resize,Base/Large 走 padding 并保持宽高比,Gundam 系列用 resize+padding 的多分辨率拼接。图片来源:DeepSeek-OCR 论文。
以 1024×1024 输入为例,完整走一遍:
这 4096 个 token 进入 80M 参数的窗口注意力塔——因为窗口注意力不产生全局的 注意力矩阵,而且参数只有 80M,激活可控。出来后经过卷积压缩器:
压缩发生在全局注意力之前,所以那 300M 的 CLIP 塔只需要处理 256 个 token,而不是 4096 个。如果顺序反过来——先全局注意力再压缩——CLIP 就要面对 4096 个 token 的稠密注意力矩阵,激活直接失控。
这就是 DeepEncoder 全部的设计精髓:用廉价的窗口注意力吃下高分辨率,在进入昂贵全局注意力之前把 token 数砍掉 16 倍。 论文把这称为 “serial connection through a 16× convolutional compressor”,串联顺序本身就是设计。
多分辨率模式:真正可用的 token 旋钮
有了可变 token 数的编码器,还需要让同一个模型能输出不同数量的 token,否则就得为每种分辨率各训一个模型。论文通过位置编码的动态插值实现这一点,并在一轮训练中把所有分辨率模式混在一起训,让单个模型支持全部模式。
| 模式 | 原生分辨率 | 动态分辨率 | 视觉 token 数 | 图像处理方式 |
|---|---|---|---|---|
| Tiny | 512 | — | 64 | resize |
| Small | 640 | — | 100 | resize |
| Base | 1024 | — | 256 | padding |
| Large | 1280 | — | 400 | padding |
| Gundam | 640+1024 | 局部块 + 1024 全局 | resize + padding | |
| Gundam-M | 1024+1280 | 局部块 + 1280 全局 | resize + padding |
表:论文 Table 1 的完整分辨率模式。
几个值得说明的取舍:
为什么 Tiny/Small 用 resize,Base/Large 用 padding? 因为 Tiny(512)和 Small(640)本身分辨率就低于多数文档图的原始尺寸,如果不 resize 而是 padding,会有大量 token 浪费在边框上——这些 token 携带零信息却仍然占位置。而 Base/Large 分辨率足够高,此时保持原始宽高比更重要(否则文字会被拉伸变形),所以选择 padding 到目标尺寸。代价是有效 token 数少于名义 token 数,论文给出了精确的折算公式:
公式(论文式 1):、 是原图宽高, 是名义 token 数, 是真正承载内容的 token 数。方括号里的项是有用面积占比:一幅长宽比极端的图(比如一条很长的表格),padding 后有效区域占比很低,大量 token 落在纯色边框上。这个公式在论文后面对比 OmniDocBench 结果时会反复用到——Base 模式的 256 个 token 实际只有 182 个有效,Large 模式的 400 个只有 285 个有效。
Gundam 模式是什么? 它是”原生分辨率”之外的另一大类——动态分辨率,由两个原生分辨率拼出来。具体做法是:把大图按 InternVL2.0 的方式切成 个 640×640 局部块(local views),再加一张 1024×1024 的全局视图(global view)。输出 token 数就是 。
这里有个细节值得琢磨:分块本质上是一种”二级窗口注意力”,它是 DeepEncoder 里窗口注意力的第二层应用,能进一步压激活显存。而因为 DeepEncoder 的原生分辨率本来就比较高,切块时不会像 InternVL2.0 那样把图切得过碎——论文明确说 tile 数量控制在 2 到 9 之间。
还有个边界条件:如果图像的宽和高都小于 640, 取 0,此时 Gundam 模式退化成 Base 模式(只有全局视图)。 的范围是 2 到 9,所以 Gundam 输出的 token 数在 456 到 1156 之间。
Gundam-M 为什么要单独继续训练? 它的分辨率是 局部块加 1280×1280 全局视图,比 Gundam 大一档。论文没有把它和其他模式一起训,而是在训练好的 DeepSeek-OCR 上继续训练得到。理由写得很直白——负载均衡:Gundam-M 的分辨率太大,一起训会拖慢整体训练速度。这是一个典型的大规模训练工程权衡,与算法优劣无关。
解码器:为什么是 3B MoE
解码器用的是 DeepSeekMoE 的 DeepSeek-3B-MoE。关键数字:
- 总参数 3B,共 64 个路由专家 + 2 个共享专家;
- 推理时每个 token 激活 6 个路由专家和 2 个共享专家;
- 激活参数约 570M。
论文对这个选择的解释是本次拆解里最值得记住的一句:3B 的 DeepSeekMoE “obtains the expressive capability of a 3B model while enjoying the inference efficiency of a 500M small model”——它同时拿到了 3B 模型的能力和 500M 小模型的推理成本。
为什么这个组合特别适合 OCR 这类任务?MoE 的收益来自”专家分工”:当任务域足够窄、子任务足够多样时(OCR 恰好如此——正文、公式、表格、版面、图表各有各的规律),不同专家可以被分配到不同的子模式上,路由一次只激活一小部分参数。相反,如果任务域宽而无结构,MoE 的分工收益就会变小。论文把 OCR 称为 “domain-centric” 任务,这正是 MoE 的舒适区。
为什么用大参数、小激活? 因为这里真正的瓶颈不是算力,而是吞吐。DeepSeek-OCR 的两个核心用途是:作为在线服务读取用户上传的图片和文档,以及作为数据流水线批量处理 PDF 生成预训练语料。两者都是高并发、批量场景,单 token 的解码成本直接决定每天的产出页数。3B 的存储占用加上 570M 的激活量,让单张 A100-40G 就能跑出可观的吞吐。
解码器要做的事情,论文用式 2 形式化了。它是一种从压缩潜空间到文本空间的非线性重建:
公式(论文式 2): 是 DeepEncoder 输出的压缩视觉 token, 是重建出的文本表示。 是视觉 token 数, 是文本 token 数, 就是”压缩”这个概念的数学表述——输入维度严格小于输出维度,所以这是一个信息瓶颈,重建必然有损。
论文对这一步的期望写得很克制但很关键:这个非线性映射”can be effectively learned by compact language models through OCR-style training”,并推测更大的 LLM 只要在预训练阶段做相应设计,就能自然地获得这种能力。这句话是整篇论文的赌注所在——它不认为解码压缩视觉表示是一件需要特殊架构的事,而认为这是语言模型规模上去之后会自己长出来的能力。
压缩比与精度:完整账本
这是全文最硬的部分。实验设置:Fox 基准的英文文档部分,用 DeepSeek-OCR 自己的 tokenizer(词表约 129k)编码真值文本,筛选长度在 600–1300 token 的文档,正好得到 100 页。因为文本 token 数不大,只需要测 Tiny(64)和 Small(100)两种模式。prompt 用不带版面的 <image> \n Free OCR.。
下表是论文 Table 2 的完整数据,一列不漏:
| 文本 token 数 | 64 视觉 token 精度 | 64 压缩比 | 100 视觉 token 精度 | 100 压缩比 | 页数 |
|---|---|---|---|---|---|
| 600–700 | 96.5% | 10.5× | 98.5% | 6.7× | 7 |
| 700–800 | 93.8% | 11.8× | 97.3% | 7.5× | 28 |
| 800–900 | 83.8% | 13.2× | 96.8% | 8.5× | 28 |
| 900–1000 | 85.9% | 15.1× | 96.8% | 9.7× | 14 |
| 1000–1100 | 79.3% | 16.5× | 91.5% | 10.6× | 11 |
| 1100–1200 | 76.4% | 17.7× | 89.8% | 11.3× | 8 |
| 1200–1300 | 59.1% | 19.7× | 87.1% | 12.6× | 4 |
表:论文 Table 2,Fox 基准 100 页英文文档,压缩比 = 真值文本 token 数 / 视觉 token 数。
这张表把三条结论同时讲清楚了。
第一条:10 倍以内,还原精度约 97%。 看 100 视觉 token 那一列——压缩比 9.7× 时精度 96.8%,8.5× 时 96.8%,7.5× 时 97.3%,6.7× 时 98.5%。全部在 96.5% 以上。再看 64 视觉 token 列,压缩比 10.5× 时精度 96.5%,仍然守住这条线。论文摘要里那句”when the number of text tokens is within 10 times that of vision tokens, the model can achieve decoding precision of 97%“,说的就是这个区间。
第二条:10 倍到 12 倍,精度约 90%。 100 token 列在 10.6× 时降到 91.5%,11.3× 时 89.8%——论文正文写的是 “90% at 10-12× compression”。这是一个可用的降级区间。
第三条:接近 20 倍压缩时,精度仍能维持约 60%。 表里最极端的一格是 64 token 处理 1200–1300 token 的文档,压缩比 19.7×,精度 59.1%——论文说的”20× 时约 60%“就是指这一格。
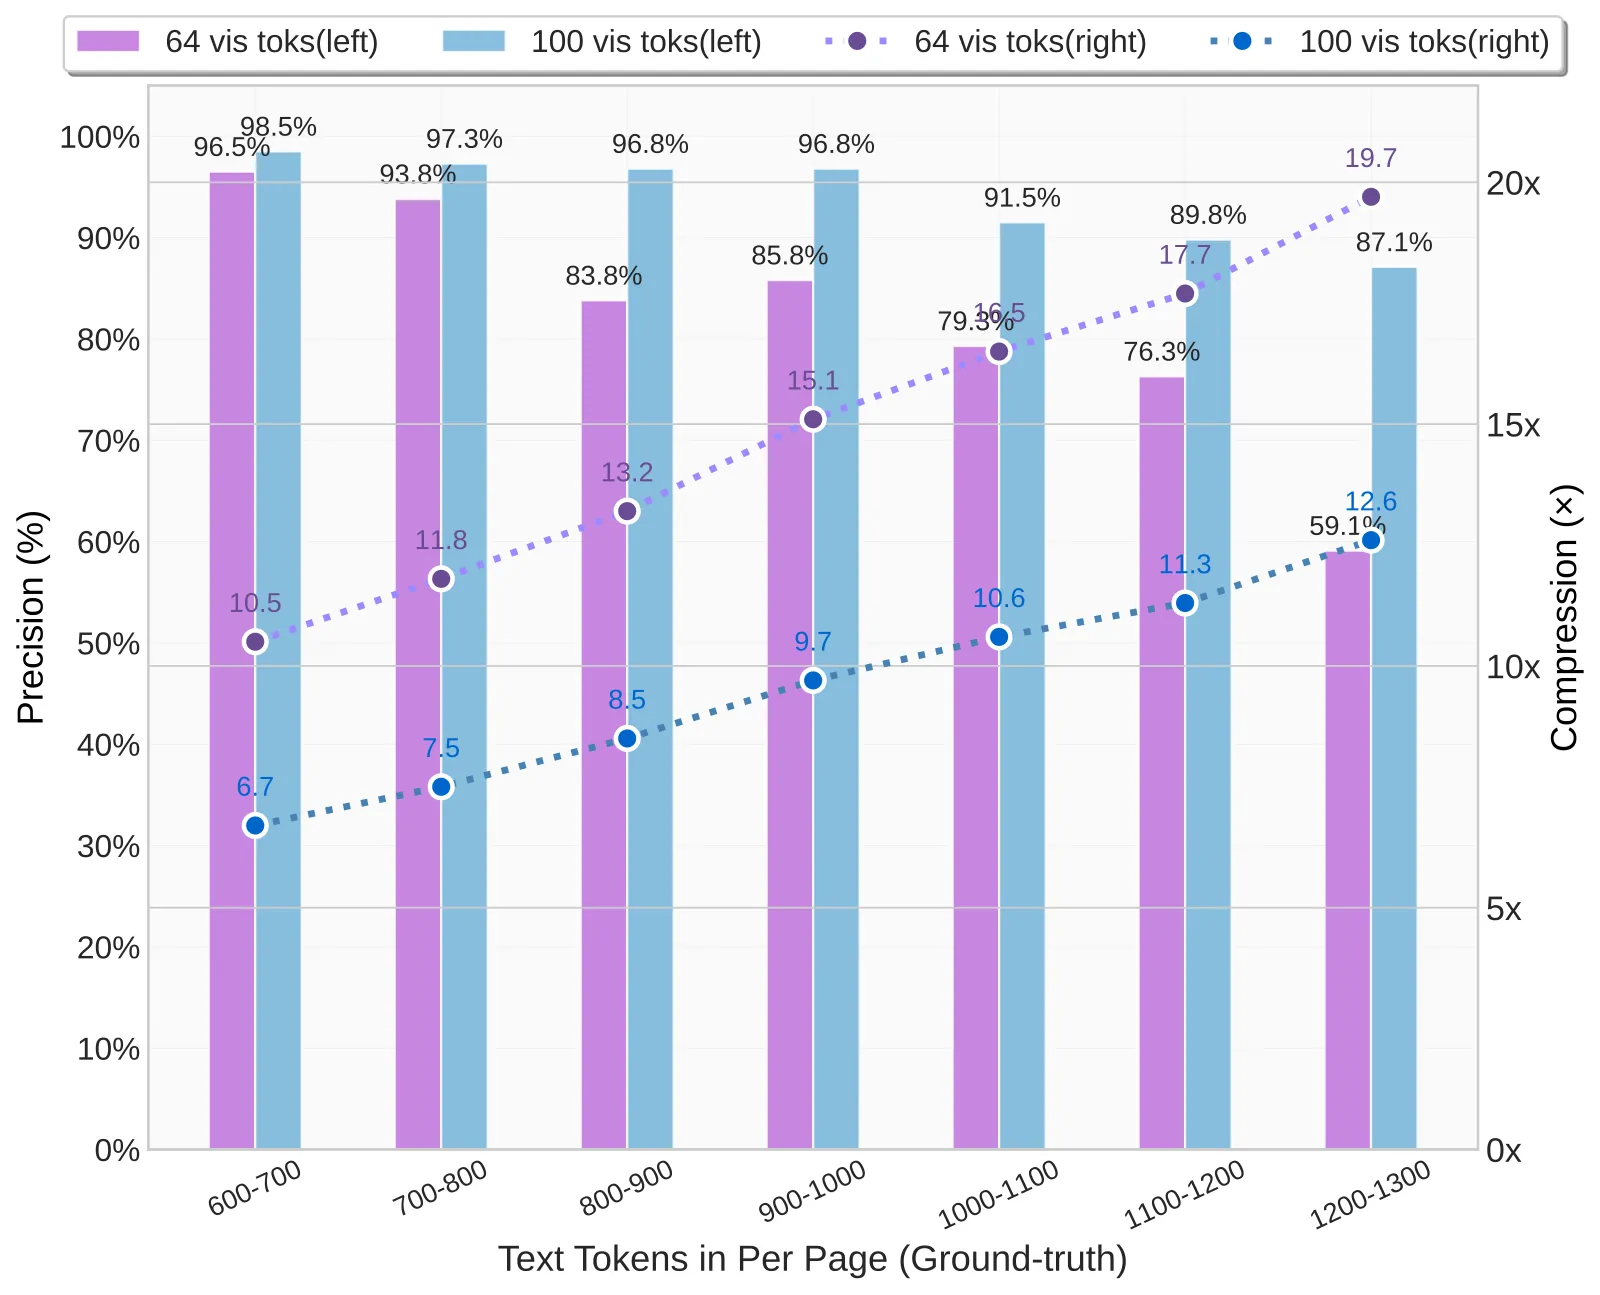
图:论文 Figure 1(a)。紫色柱/虚线是 64 视觉 token,蓝色柱/虚线是 100 视觉 token;横轴是每页真值文本 token 数,左纵轴是精度,右纵轴是压缩比。可以清楚看到超过 10× 之后两条精度曲线开始陡降。图片来源:DeepSeek-OCR 论文。
这张图里有个容易被误读的地方:64 token 的精度始终低于 100 token,而不是在低压缩区反超。它的意义在于同一条压缩比水平上的对比——64 token 处理 600–700 token 的文档时压缩比是 10.5×、精度 96.5%,而 100 token 处理 800–900 token 的文档时压缩比是 8.5×、精度 96.8%。同样的渲染分辨率下,页面信息量越大,压缩比越高、精度越低,这才是这张图的读法。
为什么超过 10× 就掉得这么快
论文给了两个原因,第一个可以工程解决,第二个不能:
版面复杂度上升。 长文档的版面结构本身更复杂——多栏、表格、公式、图注混排。视觉 token 预算固定时,版面信息会挤占内容信息的份额。论文说这个问题可以通过把文本重新渲染成单一版式的页面来解决,也就是说这是一个渲染侧的工程问题,不是方法的根本限制。
低分辨率下小字发糊。 512×512 或 640×640 的分辨率容纳 1200 个 token 的文本时,字体会被压到非常小的像素尺寸,视觉上已经不可辨认。论文对这一点给了一个出人意料的解读:它认为这不是缺陷,而可以成为一种特性——
我们认为第二个问题会成为遗忘机制的一个特征(we believe the second issue will become a feature of the forgetting mechanism)。
这个化缺点为特性的思路,就是后面”记忆衰减”那节的来源。
一个必须说明的评测口径问题
论文自己承认,用 <image> \n Free OCR. 这个不带版面的 prompt 时,“the output format still cannot completely match Fox benchmarks”——模型输出的格式与 Fox 的真值格式无法完全对齐,而评测是拿输出和真值直接比的。论文明确说,实际性能会比测试结果更高(“the actual performance would be somewhat higher than the test results”)。
反过来说,这也意味着上面那张表里的数字是在偏保守的口径下测出来的。任何引用”10 倍压缩 97% 精度”的场合,都应该带上这个前提:这是 Fox 基准上 100 页英文文档、无版面 prompt 条件下的结果,不是任意文档、任意 prompt 都能复现的通用指标。
OmniDocBench:和 GOT-OCR2.0、MinerU、dots.ocr 的正面比较
压缩比—精度曲线回答的是”能压多狠”,OmniDocBench 回答的是”实际好不好用”。OmniDocBench 是真实 PDF 文档解析基准,评测指标是编辑距离,越小越好。
下表是论文 Table 3 的核心部分(完整表中还有 Dolphin、Marker、Mathpix、MonkeyOCR、PPstructure-v3 等流水线模型,以及 Nougat、SmolDocling、InternVL 系列、Qwen 系列、GPT4o、Gemini2.5-Pro 等端到端模型):
| 模型 | 平均视觉 token/页 | 英文整体 | 中文整体 |
|---|---|---|---|
| GOT-OCR2.0 | 256 | 0.287 | 0.411 |
| dots.ocr | 3949 | 0.182 | 0.261 |
| Qwen2.5-VL-72B | 3949 | 0.214 | 0.261 |
| InternVL3-78B | 6790 | 0.218 | 0.296 |
| MinerU2.0 | 6790 | 0.133 | 0.238 |
| dots.ocr †200dpi | 5545 | 0.125 | 0.066 |
| Gemini2.5-Pro | — | 0.148 | 0.212 |
| DeepSeek-OCR Tiny | 64 | 0.386 | 0.361 |
| DeepSeek-OCR Small | 100 | 0.221 | 0.284 |
| DeepSeek-OCR Base | 256(有效 182) | 0.137 | 0.240 |
| DeepSeek-OCR Large | 400(有效 285) | 0.138 | 0.208 |
| DeepSeek-OCR Gundam | 795 | 0.127 | 0.181 |
| DeepSeek-OCR Gundam-M | 1853(†200dpi) | 0.123 | 0.157 |
表:论文 Table 3 摘编,编辑距离越小越好。†200dpi 表示用 fitz 把原图插值到 200dpi 再输入。
论文摘要里那两句话,在这张表里可以逐格核对:
“只用 100 个视觉 token 就超过 GOT-OCR2.0 的 256 token/页”:DeepSeek-OCR Small 用 100 token 拿到英文 0.221,GOT-OCR2.0 用 256 token 拿到 0.287。token 数只有 39%,编辑距离反而更低。
“用不到 800 个视觉 token 超过 MinerU2.0 的 6000+ token/页”:DeepSeek-OCR Gundam 用 795 token 拿到英文 0.127,MinerU2.0 用 6790 token 拿到 0.133。这里 token 比例是 11.7%。这就是论文说的 “state-of-the-art performance among end-to-end models enjoying the fewest vision tokens”。
一个诚实的观察:表里最强的一格其实是 dots.ocr †200dpi 的中文 0.066,但它用的是 5545 个视觉 token,是 Gundam-M 的 3 倍。这条曲线的形状是”用 token 换精度”,而 DeepSeek-OCR 的价值在于把曲线的左端(少 token 区间)整个向左推了一截。
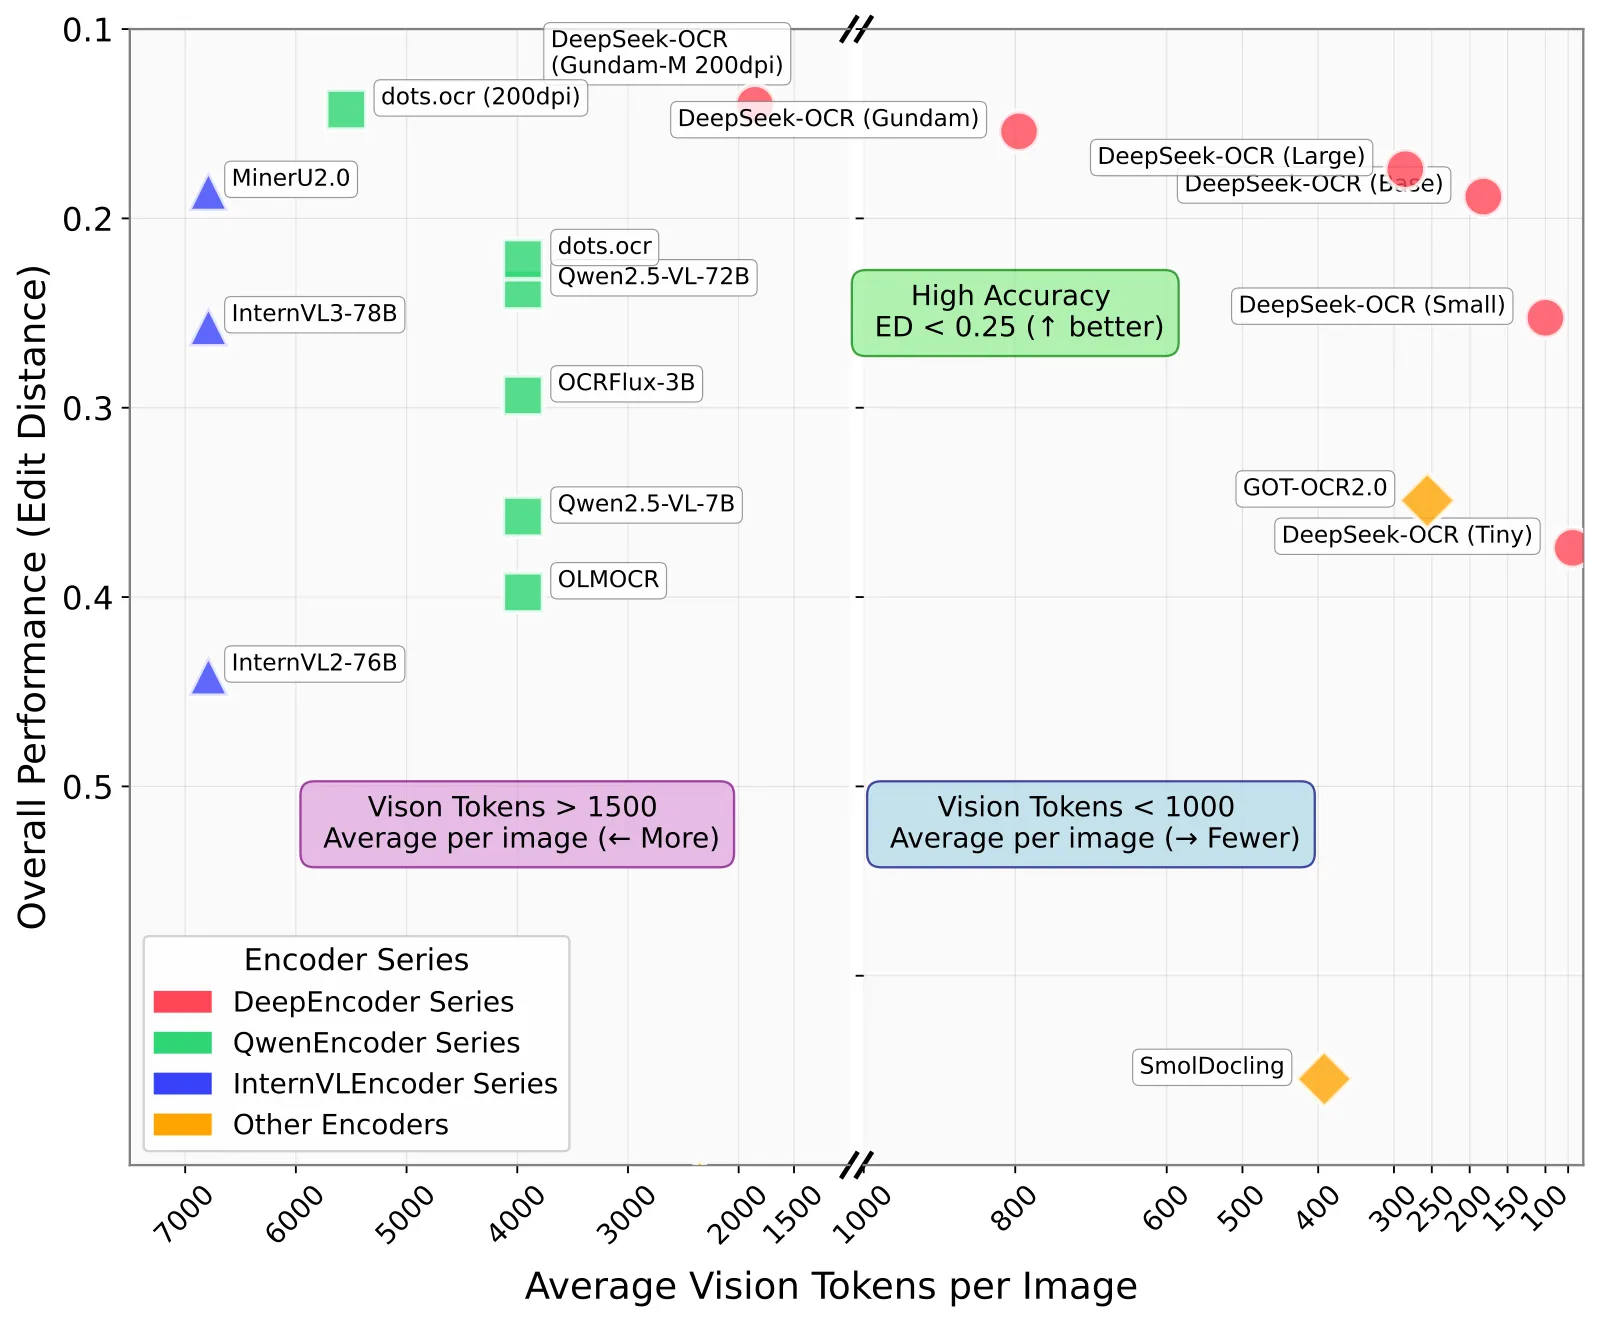
图:论文 Figure 1(b)。横轴是平均视觉 token 数(注意横轴方向是从左到右递减,且中间有断轴),纵轴是整体编辑距离。红色圆点是 DeepEncoder 系列,绿色方块是 QwenEncoder 系列,蓝色三角是 InternVLEncoder 系列,橙色菱形是其他编码器。左上角绿色方框标注的是 “High Accuracy(ED < 0.25)“,右侧浅蓝区域标注 “Vision Tokens < 1000”。图片来源:DeepSeek-OCR 论文。
这张图的信息量比表格更大:DeepSeek-OCR 的六个模式在横轴上从 1853 一直延伸到 64,是全场唯一一条横跨两个数量级的曲线。 其他模型基本固定在某个 token 预算上,要么多 token 高精度,要么少 token 低精度,没有”旋钮”。
分文档类型看:哪些文档真的需要更多 token
论文 Table 4 按文档类型拆开,这张表比总表更能说明”光学压缩的边界在哪”:
| 模式 | Book | Slides | Financial Report | Textbook | Exam Paper | Magazine | Academic Papers | Notes | Newspaper | 整体 |
|---|---|---|---|---|---|---|---|---|---|---|
| Tiny | 0.147 | 0.116 | 0.207 | 0.173 | 0.294 | 0.201 | 0.395 | 0.297 | 0.940 | 0.320 |
| Small | 0.085 | 0.111 | 0.079 | 0.147 | 0.171 | 0.107 | 0.131 | 0.187 | 0.744 | 0.205 |
| Base | 0.037 | 0.080 | 0.027 | 0.100 | 0.130 | 0.073 | 0.052 | 0.176 | 0.645 | 0.156 |
| Large | 0.038 | 0.108 | 0.022 | 0.084 | 0.109 | 0.060 | 0.053 | 0.155 | 0.353 | 0.117 |
| Gundam | 0.035 | 0.085 | 0.289 | 0.095 | 0.094 | 0.059 | 0.039 | 0.153 | 0.122 | 0.083 |
| Gundam-M | 0.052 | 0.090 | 0.034 | 0.091 | 0.079 | 0.079 | 0.048 | 0.100 | 0.099 | 0.077 |
表:论文 Table 4,各文档类型的编辑距离。
Slides 是全场最”便宜”的类型:Tiny 模式(64 视觉 token)就能拿到 0.116。这符合直觉——幻灯片本身就设计成大字号、少文字、留白多,页面文本 token 数远小于 1000,压缩比不超过 10×。
Book、Financial Report、Academic Papers 在 Small(100 token)下已经很可用:0.085、0.079、0.131。论文的判断是,这几类文档的文本 token 大多在 1000 以内,压缩比不超过 10×。
Newspaper 是唯一的”钉子户”:Tiny 0.940、Small 0.744、Base 0.645,一路到 Large 才降到 0.353,必须上 Gundam(0.122)甚至 Gundam-M(0.099)才可接受。
为什么报纸这么特殊?论文的解释很清楚:报纸一页的文本 token 数是 4000–5000,远超其他模式的 10× 压缩区间。Base 模式 256 个 token 对 4000+ 个文本 token,压缩比接近 16×,正好落在精度陡降区。报纸因此成了”光学压缩边界”的直接证据——它不是模型不行,是这一页的信息量确实超过了当前 token 预算能承载的量。
论文把这一观察上升成了对 VLM 的一般性建议:这些实验为 VLM 的视觉 token 分配优化提供了经验参考——与其给所有图片统一分配 token,不如按内容密度动态分配。
数据引擎与训练流程
数据构成
DeepSeek-OCR 的训练数据分四类,比例是 OCR 数据 70%、通用视觉数据 20%、纯文本数据 10%。
OCR 1.0 数据(传统 OCR:文档 OCR 和自然场景 OCR)。文档部分从互联网收集了 3000 万页 PDF,覆盖约 100 种语言,其中中文和英文合计约 2500 万页,其他语言约 500 万页。真值分两种:
- 粗标注:用
fitz直接从 PDF 抽取全文,目的是教模型识别光学文本,尤其是小语种; - 细标注:中英文各 200 万页,用 PP-DocLayout 这类先进版面模型加 MinerU、GOT-OCR2.0 这类 OCR 模型标注,构造成”检测 + 识别”交错的数据(每段文本前面带它在原图中的坐标和类别标签,坐标归一化到 1000 个 bin)。训练时用不同的 prompt 区分粗标注和细标注。
小语种部分有个值得一提的工程技巧——模型飞轮:版面模型对小语种已有一定泛化能力,检测部分可以直接用;识别部分则先用 fitz 造小 patch 数据训一个 GOT-OCR2.0,再用训好的模型去标注版面处理后的 patch,如此产出 60 万条数据。
另外还收集了 300 万条 Word 数据(直接抽取内容,不做版面),主要收益在公式和 HTML 格式表格。自然场景 OCR 覆盖中英文,图像来自 LAION 和 Wukong,用 PaddleOCR 标注,中英文各 1000 万条。
OCR 2.0 数据(复杂人工图像的解析):图表 1000 万张,用 pyecharts 和 matplotlib 渲染,包含折线、柱状、饼图、复合图,解析任务定义为图到 HTML 表格的转换;化学式 500 万对,从 PubChem 取 SMILES 用 RDKit 渲染;平面几何 100 万条,遵循 Slow Perception 的生成方式,感知标尺大小取 4,即每条线段用 4 个点建模,并引入了几何平移不变的数据增强。
通用视觉数据占 20%,跟 DeepSeek-VL2 的做法生成 caption、detection、grounding 等任务的数据。论文特别说明:DeepSeek-OCR 不是通用 VLM,加这部分数据的目的只是保留通用视觉接口,方便后续研究者在上面继续工作。
纯文本数据占 10%,用内部预训练语料,统一处理到 8192 token 长度——这也是 DeepSeek-OCR 的训练序列长度。引入它是为了保证模型的语言能力不退化的。
两阶段训练
训练流程被刻意设计得很简单,只有两步。
第一步:单独训练 DeepEncoder。 沿用 Vary 的做法,把编码器接一个紧凑语言模型,用下一 token 预测目标联合优化。数据用全部 OCR 1.0 和 2.0 数据,加上从 LAION 采样的 1 亿条通用数据。所有数据训 2 个 epoch,batch size 1280,AdamW 优化器配余弦退火,学习率 5e-5,训练序列长度 4096。
第二步:训练完整 DeepSeek-OCR。 在 HAI-LLM 平台上做,用流水线并行(PP)切成 4 段,编码器占 2 段、解码器占 2 段。切分方式很讲究:
- SAM 和卷积压缩器被当作 vision tokenizer,放在 PP0,参数冻结;
- CLIP 部分被当作输入 embedding 层,放在 PP1,参数不冻结,参与训练;
- DeepSeek3B-MoE 有 12 层,PP2 和 PP3 各放 6 层。
这个切分本身就是对”编码器三段角色不同”这一设计的延续:最前面的 SAM+压缩器承担的是”分词”职能(和文本 tokenizer 一样,不需要训),CLIP 承担的是”嵌入”职能(需要跟着语言模型一起适配)。
规模是 20 个节点,每节点 8 张 A100-40G,即 160 张卡;数据并行度 DP=40,全局 batch size 640;AdamW 配 step-based scheduler,初始学习率 3e-5。吞吐数据:纯文本数据 90B tokens/天,多模态数据 70B tokens/天。
生产规模
论文给了两个口径的数据,二者互相印证:
- 摘要:单张 A100-40G 每天可生成 20 万页以上训练数据;
- 正文:用 20 个节点(每节点 8 张 A100-40G,共 160 张卡)每天可生成 3300 万页数据。
万页/卡/天,与摘要口径一致。GitHub 仓库里 vLLM 推理脚本的注释给的是 PDF 并发场景下约 2500 tokens/s(单张 A100-40G)。
DeepSeek-OCR 2:视觉因果流
一代解决了”压多少”,二代要解决的是”读的顺序对不对”。
一代遗留的问题:光栅扫描顺序
常规 VLM 处理图像的方式是:切 patch → 按光栅扫描顺序(左上到右下)拍平成 1D 序列 → 配固定位置编码 → 送进 LLM。论文指出这与人类视觉不符。
人眼的注视序列不是机械扫描,而是由语义逻辑驱动的、因果相连的柔性序列。读一份多栏排版的论文时,人会先扫标题、找摘要,再顺着推导逻辑跳读;看一张表格时会先定位表头再读单元格。论文用了一个很形象的类比:沿螺旋线追踪时,每次注视都因果地依赖于前一次。
对编码器来说,把 2D 图像拍平成 1D 再配面向文本的位置编码(论文点名了 RoPE),等于强行注入了一个不成立的归纳偏置。在复杂版式(多栏、表格、公式)的光学文档上,这个偏置直接导致阅读顺序错误——而阅读顺序错误会连锁地毁掉整页的解析结果。
DeepEncoder V2 的三个改动
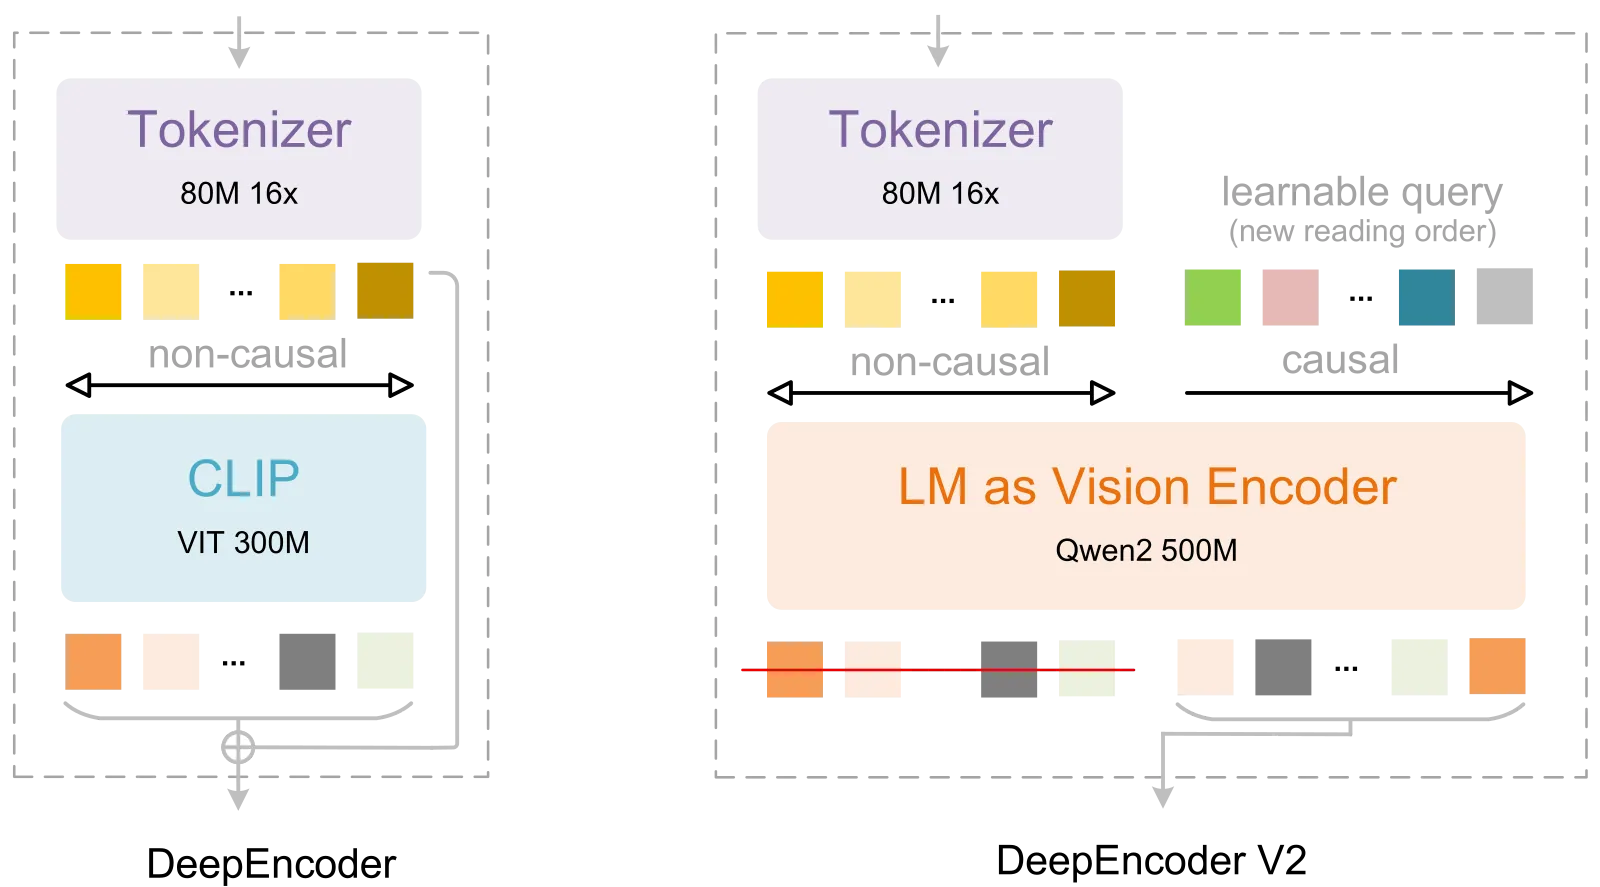
图:DeepSeek-OCR 2 论文 Figure 1。左边是一代的 DeepEncoder:80M 16× tokenizer 接 CLIP VIT 300M,视觉 token 走非因果(双向)注意力。右边是 DeepEncoder V2:tokenizer 不变,CLIP 换成 500M 的 “LM as Vision Encoder”,并在视觉 token 右侧追加一组等量的可学习 query(learnable query,承载”新的阅读顺序”),query 之间走因果注意力。图片来源:DeepSeek-OCR 2 论文。
改动一:vision tokenizer 原样保留,但收窄输出维度。 仍然是 80M 的 SAM-base 加两层卷积,仍然做 16× token 压缩。唯一的变化是最后一层卷积的输出维度从 1024 降到 896,以对齐后面的语言模型管线。
论文对保留这个 tokenizer 的解释是:它明确说这个基于压缩的 tokenizer 不是必需的,可以直接换成简单的 patch embedding。保留它的理由是”用最小的参数量换来 16× 压缩,大幅降低后续全局注意力模块的计算和激活开销”,而且——这句话很关键——“它的参数量(80M)与 LLM 文本输入 embedding 通常用的约 100M 参数是可比的”。也就是说,在论文的构想里,这个 tokenizer 的角色就是一个视觉模态的 embedding 层,和文本 embedding 层对等。
改动二:把 CLIP 换成 LLM 风格的编码器。 这是二代最大的一处结构变化。CLIP ViT 被换成一个双流注意力的 LLM 式架构:视觉 token 走双向注意力(保持 CLIP 的全局建模能力),新引入的因果流 query 走因果注意力。
实例化用的是 Qwen2-0.5B,500M 参数——与 CLIP ViT 的 300M 在同一量级,论文明确说不引入过多计算开销。
这里有一个非常值得单独拎出来的失败实验:论文尝试过 mBART 式的 encoder-decoder 结构 + cross-attention,结果无法收敛。作者给出的假设是——视觉 token 被隔离在独立编码器里,交互不足。相比之下,decoder-only + 前缀拼接的设计让视觉 token 在所有层都保持活跃,能与因果 query 充分交换信息。
这是一个典型的”架构自由度很高、但只有一种能训起来”的案例。它提醒我们:在多模态结构里,视觉 token 与语言表示”在多少层里共同参与计算”往往比”用哪种注意力形式”更决定成败。
改动三:因果流 query 与定制注意力掩码。 这是实现”重排”的机制本体。
在视觉 token 之后追加一组可学习的 query(注意:论文明确说这些 query 是 “appended after visual tokens as a suffix”,而在 decoder-only 的前缀拼接视角下,视觉 token 就是前缀)。每个 query 可以注意所有视觉 token 以及它之前的 query。
query 的数量与视觉 token 数量严格相等(equal cardinality),论文给的计算式是:
公式(论文式 3.2.3 节):、 是输入编码器的图像宽高。分母 是 patch 尺寸(16×16),再乘 16 是卷积压缩器的 16× 下采样——所以这个式子算的就是压缩后的视觉 token 数。
论文特别说明了”等量”这个约束的两个作用:一是在不改变 token 总数的前提下对视觉特征施加语义排序与蒸馏;二是为”重新注视”(re-fixation)留出足够容量——注意这里提到”with redundancy such as padding and borders”,即 query 数按含 padding 和边框的名义 token 数算,本身就留了冗余。
注意力掩码是两块拼接起来的:
公式(DeepSeek-OCR 2 论文式 1): 是原始视觉 token 数, 是因果 query 数(二者相等)。矩阵分四个区块——左上 是视觉 token 之间的全 1 块(双向可见,ViT 式);右上 是全 0 块,表示视觉 token 看不到 query;左下 是全 1 块,表示每个 query 都能看到所有视觉 token;右下 是下三角矩阵,表示 query 只能看到自己和之前的 query(因果注意力)。
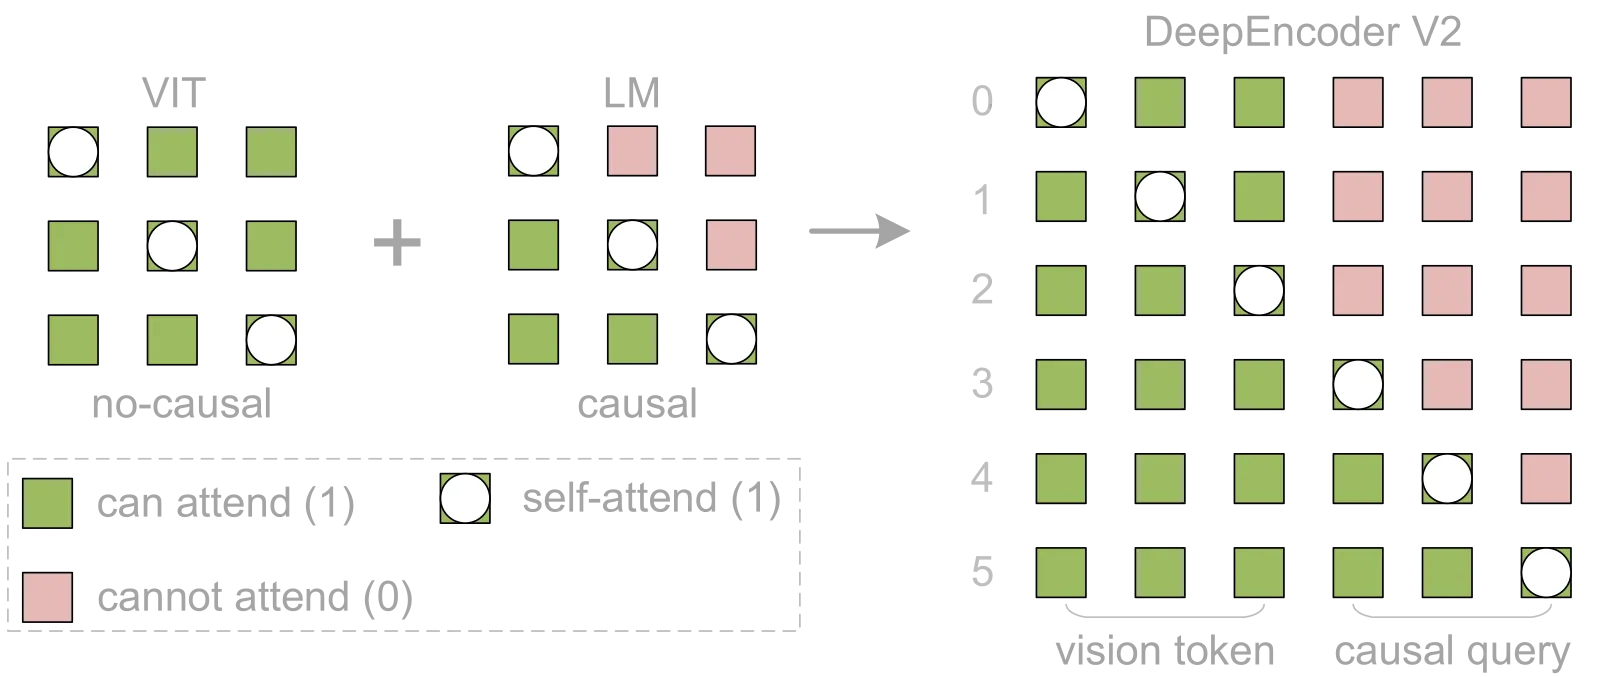
图:DeepSeek-OCR 2 论文 Figure 5。左侧分别是 VIT 式的非因果(双向)掩码和 LM 式的因果掩码,两者沿序列维度拼接形成右侧的 DeepEncoder V2 完整掩码。绿色方块表示可以注意(值 1),粉色表示不可注意(值 0),白圈是自身。图中前 3 列/行是 vision token,后 3 列/行是 causal query。图片来源:DeepSeek-OCR 2 论文。
这个掩码设计有一个必须解释清楚的地方:为什么视觉 token 看不到 query(右上角全 0)?
因为视觉 token 需要保持纯粹的、不依赖 query 顺序的表示。如果视觉 token 能反过来看到 query,那么”重排”就变成了一个循环依赖——query 在重排视觉 token,而视觉 token 又在表示里编码了 query 的顺序信息,双向注意力会让这个顺序逐渐退化成冗余的、自我强化的信号。切断这条边之后,视觉 token 的双向编码是干净的,排序信息只单向地沉淀在 query 里。
最终只把 causal query 的输出送进 LLM 解码器——也就是图中 输出的后 个 token 经投影 后交给解码器。完整的计算式是:
公式(DeepSeek-OCR 2 论文式 2): 是输入图像; 是 vision tokenizer,把图像映射成 个视觉 token ; 是可学习的因果 query embedding; 表示沿序列维度拼接; 是带掩码注意力的 层 Transformer; 就是上面那个 的分块因果掩码; 是取出最后 个 token 的投影算子; 是语言解码器; 是词表上的输出 logits。
论文把这一整套称为两级级联的因果推理:编码器用可学习 query 完成”阅读逻辑推理”(按语义把视觉 token 重排成符合阅读逻辑的序列),解码器在这个已排序的序列上做”视觉任务推理”(自回归生成)。论文认为把 2D 理解分解成两个互补/正交的 1D 因果推理子任务,可能是通向真正 2D 推理的一条路径。
token 预算:256 到 1120
DeepEncoder V2 输出的视觉 token 数被约束在 区间,上下界的选取都很有讲究:
- 下界 256:对应 DeepSeek-OCR 对 1024×1024 图像的 tokenization 结果;
- 上界 1120:对齐 Gemini-3-Pro 的最大视觉 token 预算。同时它低于一代 Gundam 模式的 1156。
具体由多裁剪策略 + 固定 query 配置实现。为了避免为每种分辨率各维护一套 query,论文把 query 固定成两组:
- 全局视图用 1024×1024,对应 256 个 query embedding();
- 局部裁剪用 768×768,数量 从 0 到 6(图像宽高都小于 768 时不裁剪),所有局部视图共享一套 144 个 query()。
总输出 token 数为:
时是 256(只有全局视图), 时是 。注意局部视图共享同一套 query 参数——这是”用固定 query 配置适配任意裁剪数”的关键,否则每个 都要一套独立参数。
三级训练流程
相比一代的两阶段,二代拆成了三级:
阶段一:编码器预训练。 沿用一代和 Vary 的方式,把编码器接一个轻量解码器用下一 token 预测联合优化。两个 dataloader 分别在 768×768 和 1024×1024 分辨率上取数据。vision tokenizer 从一代 DeepEncoder 初始化,LLM 式编码器从 Qwen2-0.5B-base 初始化。用 AdamW 配余弦学习率衰减(1e-4 降到 1e-6),在 160 张 A100 上训练,batch size 640,跑 40k 迭代(序列打包到 8K 长度,约 1 亿图文对样本)。
阶段二:query 增强。 把训好的 DeepEncoder V2 和 DeepSeek-3B-A500M 拼成完整管线,冻结 vision tokenizer,联合优化 LLM 编码器和 LLM 解码器,强化 query 表示。这一步用多裁剪策略把两个分辨率统一到单个 dataloader。流水线并行切 4 段:vision tokenizer 在 PP0,LLM 式编码器在 PP1,DeepSeek-LLM 各 6 层在 PP2 和 PP3。160 张 40GB 卡,配 40 个数据并行副本(每个副本 4 卡),全局 batch 1280,学习率从 5e-5 衰减到 1e-6,跑 15k 迭代。
阶段三:继续训练 LLM。 冻结全部 DeepEncoder V2 参数,只更新 DeepSeek-LLM 的参数。论文给出的理由是纯工程性的——这样做能在相同全局 batch size 下把训练速度提高一倍以上,同时帮助 LLM 更好地理解编码器重排后的视觉 token。学习率从 1e-6 衰减到 5e-8,跑 20k 迭代。
这个三段式设计里藏着一个普遍的规律:编码器的训练目标(学特征、学压缩、学重排)和解码器的训练目标(适配编码器输出、学生成)性质不同,分开训比混在一起训更省算力。
实验结果
评测基准是 OmniDocBench v1.5,含 1355 页文档、9 大类(杂志、学术论文、研究报告等),中英文都有。
| 模型 | 视觉 token 上限 | 整体 | 文本编辑距离 | 公式 CDM | 表格 TEDS | 表格 TEDSₛ | 阅读顺序编辑距离 |
|---|---|---|---|---|---|---|---|
| PaddleOCR-VL | — | 92.86 | 0.035 | 91.22 | 90.89 | 94.76 | 0.043 |
| MinerU2.5 | — | 90.67 | 0.047 | 88.46 | 88.22 | 92.38 | 0.044 |
| Qwen3-VL-235B | >6000 | 89.15 | 0.069 | 88.14 | 86.21 | 90.55 | 0.068 |
| dots.ocr | >6000 | 88.41 | 0.048 | 83.22 | 86.78 | 90.62 | 0.053 |
| Gemini-2.5 Pro | — | 88.03 | 0.075 | 85.82 | 85.71 | 90.29 | 0.097 |
| DeepSeek-OCR(9-crops) | 1156 | 87.36 | 0.073 | 84.14 | 85.25 | 89.01 | 0.085 |
| DeepSeek-OCR 2 | 1120 | 91.09 | 0.048 | 90.31 | 87.75 | 92.06 | 0.057 |
表:DeepSeek-OCR 2 论文 Table 1 摘编(整体和阅读顺序指标越高越好,编辑距离越低越好)。
相对一代基线,DeepSeek-OCR 2 的提升是:整体 +3.73(87.36 → 91.09),文本编辑距离 −0.025,公式 CDM +6.17,表格 TEDS +2.5、TEDSₛ +3.05,阅读顺序编辑距离 −0.028(0.085 → 0.057)。视觉 token 上限还从 1156 降到了 1120。
阅读顺序这个指标的改善最值得单独说。 它是一个”重排能力是否真的生效”的直接证据——论文的架构动机就是让编码器按语义排好顺序,而 R-order 编辑距离从 0.085 降到 0.057,降幅与整体提升同量级。论文也强调,在 9 类文档上 R-order 指标是全面优于一代的,而文本识别指标则在少数类型上(报纸)出现退化。
与外部模型的对比有一个很关键的配置:在相近的视觉 token 预算下,DeepSeek-OCR 2(1120 token)的整体编辑距离是 0.100,Gemini-3 Pro(1120 token)是 0.115。同样的预算,更低的误差。
生产环境的指标也在论文里:
| 场景 | DeepSeek-OCR | DeepSeek-OCR 2 |
|---|---|---|
| 在线用户日志(图片)重复率 | 6.25% | 4.17%(−2.08%) |
| 预训练数据(PDF)重复率 | 3.69% | 2.88%(−0.81%) |
表:论文 Table 4。生产环境中拿不到真值,所以用”重复率”作为主要可观测质量指标,越低越好。
为什么生产环境用”重复率”而不是精度? 论文的解释很实际:OCR 模型在服务 LLM 流水线时拿不到真值,没法算编辑距离。而生成退化(repetition)是这类模型最典型、也最容易被自动化检测的失败模式——一旦模型开始复读同一段内容,输出就废了。所以重复率成了生产环境唯一可靠的质量代理指标。
论文也坦白了二代的短板:报纸类文档的文本编辑距离仍在 0.13 以上。原因有两条,一是 1120 的 token 上限对文本极密的报纸不够用(论文说以后增加局部裁剪数就能解决),二是训练数据里只有 25 万条报纸样本,不足以让 DeepEncoder V2 在这个类别上学到好的重排策略。
这条路线对推理系统意味着什么
把两篇论文读完,可以做一个冷静的系统侧评估。
视觉 token 在 KV Cache 里和文本 token 完全等价
这是最容易讲清楚、也最容易被忽略的一点:DeepEncoder 输出的视觉 token,进入解码器之后就变成了普通的 embedding 向量,在 KV Cache 里占的位置和文本 token 一模一样。
没有任何特殊机制让视觉 token 更便宜。节省 100% 来自数量变少——一页 1000 个文本 token 的内容,用 100 个视觉 token 表示,KV Cache 就少 10 倍。这也是为什么论文反复强调”压缩比”这一个数字:在 KV Cache 这个维度上,压缩比就是收益比。
在这个意义上,光学压缩和本站在 H2O、SnapKV、Prefix Sliding 拆过的 KV 驱逐方法处在同一个战场,但打法完全不同:那些方法在已有的 token 集合里做减法(丢掉一部分 KV,赌它不重要),光学压缩是在编码阶段就换一种更紧凑的表示(不丢,但每个 token 承载更多信息)。前者的代价是不可逆的信息删除,后者的代价是重建误差。
三笔账要一起算
把光学压缩当成一个系统方案看,收益和成本都要算:
收益侧,三笔一起省。 设压缩比为 ,序列长度从 降到 :
- KV Cache 显存:降为 (线性项);
- prefill 的注意力计算量:降为约 (二次方项,长上下文下这是最大的一笔);
- 解码时每步的 KV 读取带宽:降为 (线性项)。
时,二次方项是 100 倍的减少。这个数字在长上下文场景下是碾压性的——它比任何 KV 量化(2-bit 也就是 8 倍)和任何块稀疏(通常 4–10 倍稀疏率)都要大一个量级。
成本侧有三项。
第一,编码器本身的算力。输入 1024×1024 的图要先过 4096 个 patch token 的 80M 窗口注意力塔,再过 256 个 token 的 300M CLIP 塔。这部分算力不随上下文长度增长(每页固定),但它是一次不可省的 prefill 前置开销。
第二,解码阶段要重新生成文本。如果目的是让 LLM”回忆”这段历史,那么视觉 token 要解码成文本 token 才能被后续消费——这是一次额外的自回归生成,长度等于原本的文本长度。这一项的成本可能抵消掉 prefill 的节省,具体取决于应用:如果是”读回来当上下文用”,就得付这笔钱;如果是”让模型自己去理解图里的内容”,就不需要。
第三,重建误差。这是最本质的一项。10 倍压缩下 97% 的还原精度,意味着每 100 个 token 里有 3 个是错的。对于长上下文里的关键事实(一个数字、一个变量名、一个日期),3% 的字符级误差足以毁掉整条推理链。论文在结论里也划了这条界线:“OCR alone is insufficient to fully validate true context optical compression”——仅靠 OCR 不足以验证真正的上下文光学压缩,未来需要做数字-光学文本交错的预训练、大海捞针测试等评测。这句话表明作者自己清楚:从”能读回文档”到”能当上下文用”,中间还差一大截验证。
记忆衰减:最值得跟进的想象空间
论文第 5 节提出的机制,是整个工作里最有延展性的部分。
既然”低分辨率下小字发糊”是压缩的必然结果,那它就可以被用来实现有意的遗忘。具体做法是:把早先几轮对话的历史文本渲染成图片做初次压缩,然后随着时间推移逐步缩小老图片,实现多级压缩——token 数逐级下降,文字逐级模糊,从而完成”文本遗忘”。
论文把这件事和人类记忆做了个对照:记忆随时间衰减与视觉随距离退化,在模式上是同构的,都是”渐进的信息损失”。
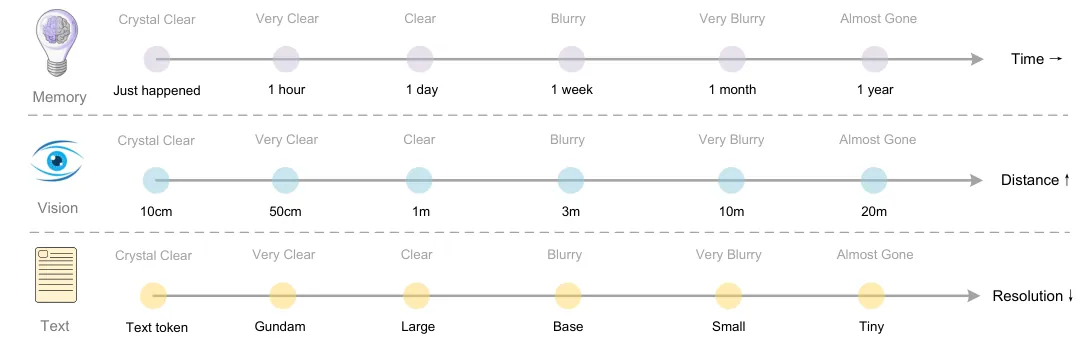
图:论文 Figure 13。三条轴并列——记忆随时间(刚发生 → 1 小时 → 1 天 → 1 周 → 1 月 → 1 年)、视觉随距离(10cm → 50cm → 1m → 3m → 10m → 20m)、文本随分辨率(Text token → Gundam → Large → Base → Small → Tiny)。三者都从 “Crystal Clear” 走到 “Almost Gone”。图片来源:DeepSeek-OCR 论文。
这张图的妙处在于它把模型侧的六个分辨率模式,直接对应到了记忆的六个清晰度档位。对于多轮对话而言,这意味着一个连续可调的上下文预算:最近的 轮保持高分辨率(甚至直接用文本 token), 轮之前的渲染成图并逐步降分辨率。论文的说法是,这样可以为超过 轮的对话历史实现约 10 倍的压缩效率。
论文对这一步的措辞很谨慎:“we acknowledge this is early-stage work that requires further investigation”——这是早期工作,需要进一步研究。但它勾勒出的图景是明确的:一条理论上可以无限长的上下文架构——近期内容保持高保真、远期内容只占少量资源——而不是靠硬截断或硬驱逐。
工程落地:vLLM 已经支持
2025 年 10 月 23 日,DeepSeek-OCR 被 vLLM 上游正式支持。官方示例里有一个细节很能说明这类模型的工程特性:
from vllm import LLM, SamplingParamsfrom vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor
llm = LLM( model="deepseek-ai/DeepSeek-OCR", enable_prefix_caching=False, mm_processor_cache_gb=0, logits_processors=[NGramPerReqLogitsProcessor])
sampling_param = SamplingParams( temperature=0.0, max_tokens=8192, extra_args=dict( ngram_size=30, window_size=90, whitelist_token_ids={128821, 128822}, # whitelist: <td>, </td> ), skip_special_tokens=False,)代码:vLLM 官方 DeepSeek-OCR 推理示例。
两个设置值得解释:
NGramPerReqLogitsProcessor 是一个 n-gram 级别的 logits 处理器,用来抑制重复生成。参数 ngram_size=30、window_size=90 的意思是:在最近 90 个 token 的窗口里,如果检测到 30-gram 重复,就对相关 token 做惩罚。这正好呼应了二代论文把”重复率”当作生产核心指标的做法——生成退化是这类模型的头号工程问题。whitelist_token_ids 里放的是 <td> 和 </td>,因为表格里这些标签天然会大量重复,属于合法重复,不能被抑制。
enable_prefix_caching=False 和 mm_processor_cache_gb=0 是关闭前缀缓存和多模态处理缓存。这看起来反直觉(RadixAttention 这类前缀缓存对长上下文收益很大),但对批量文档处理这个主场景是合理的:每页文档都是独立的一次性输入,没有共享前缀可复用,开着缓存只增加内存和管理开销。这也侧面说明 DeepSeek-OCR 的定位是批处理吞吐型而不是多轮对话型负载。
局限与未解决的问题
把两篇论文的自我评价和我的观察合在一起,这条路线的边界大致是这样:
第一,OCR 不等于通用上下文压缩。 这是论文自己在结论里明确写的。OCR 是这条路线最容易验证的试验台——它有天然的压缩-解压映射(文本 ↔ 图像),也有现成的量化指标(编辑距离)。但自然语言上下文里没有这么干净的映射,一段推理链、一个 API 定义、一段代码,渲染成图像再解压回来,误差会以什么形式累积,目前没有任何数据。
第二,重建误差不可忽视,且缺乏误差传播分析。 10 倍压缩下 3% 的编辑距离误差是字符级的。论文没有给出”如果把这些重建文本当上下文喂给 LLM 做推理,端到端准确率是多少”的实验。这是从”OCR 指标”到”上下文可用性”之间最关键的一个空白。
第三,精度上限受页面上限压制。 两代都把最大 token 预算压得很紧(一代 Gundam 1156、二代 1120),代价是文本极密的页面(报纸,一页 4000–5000 文本 token)明显退化。论文给的解法是”增加局部裁剪数”,但那会直接推高 token 预算,与压缩目标相冲突。信息密度和 token 预算之间存在一条无法绕开的权衡曲线。
第四,二代的报纸短板还有数据侧的原因。 论文说训练数据里只有 25 万条报纸样本。这个量级对一个新的编码器架构来说明显不足——也就是说,二代在报纸上的退化部分是数据问题而非架构问题,未来可能有改善空间。
第五,两级因果推理的容量问题。 论文在讨论中提了一句很关键的话:如果要支持对视觉内容的多次复核(re-examination)和多跳重排(multi-hop reordering),可能需要远多于原始视觉 token 数量的因果流 token。这与”等量 query”的设计约束直接冲突。也就是说,当前”query 数与视觉 token 数严格相等”的设计在重排能力上有一个硬天花板。
第六,编码器算力是固定前置开销。 无论上下文多短,每页都要走一遍完整的编码流程。对于短输入的场景,这笔开销占比会很高,光学压缩没有优势。
小结
把这篇拆解压缩成几条能记住的结论:
核心命题:同样一页文档,用视觉 token 承载比用文本 token 承载便宜约一个数量级。DeepSeek-OCR 在 Fox 基准上给出了完整曲线——10 倍压缩内约 97% 还原精度,10–12 倍约 90%,20 倍约 60%。
架构上的关键决策只有三个:一是把压缩放在两次注意力之间,让廉价的窗口注意力吃下 4096 个 patch token、昂贵的全局注意力只处理压缩后的 256 个;二是用 MoE 做解码器,拿 3B 的表达能力付 570M 的推理成本;三是用位置编码动态插值让一个模型支持从 64 到 1156 个 token 的全分辨率谱系。前两个解决”跑得动”,第三个解决”能用”。
工程价值已经被验证:OmniDocBench 上用 100 token 超过 GOT-OCR2.0 的 256 token,用 795 token 超过 MinerU2.0 的 6790 token;生产上用 160 张 A100-40G 每天产出 3300 万页训练数据。
二代把战场从”压多少”推进到”按什么顺序读”:用 Qwen2-0.5B 替换 CLIP、用等量因果 query 加定制掩码让编码器先做一遍语义重排,整体指标提升 3.73 个点,阅读顺序编辑距离从 0.085 降到 0.057。其中”mBART 式 cross-attention 结构训不收敛、必须用 decoder-only 前缀拼接”这个失败实验,可能比成功本身更有参考价值。
对推理系统的意义:视觉 token 在 KV Cache 里与文本 token 完全等价,10 倍压缩直接带来 10 倍 KV 节省和 100 倍注意力计算量削减,这是任何 KV 量化或稀疏化都达不到的量级。但代价是重建误差——而论文自己承认,从”能读回文档”到”能当上下文用”,中间还需要数字-光学交错的预训练和大海捞针这类验证。
参考资料
- DeepSeek-OCR: Contexts Optical Compression(arXiv:2510.18234)
- DeepSeek-OCR 2: Visual Causal Flow(arXiv:2601.20552)
- DeepSeek-OCR 官方 GitHub 仓库
- DeepSeek-OCR-2 官方 GitHub 仓库
- DeepSeek-OCR 模型权重(Hugging Face)
- DeepSeek-OCR-2 模型权重(Hugging Face)
- vLLM 官方 DeepSeek-OCR 部署指南
- OmniDocBench:多样化 PDF 文档解析基准(CVPR 2025)
- Vary: Scaling up the Vision Vocabulary for Large Vision-Language Models(ECCV 2024)
- GOT-OCR2.0: General OCR Theory(arXiv:2409.01704)
- Segment Anything(SAM,arXiv:2304.02643)
- MinerU: An Open-Source Solution for Precise Document Content Extraction
- Slow Perception: Let’s Perceive Geometric Figures Step-by-step
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


