


Engram 完全拆解:条件记忆——MoE 之外的第二条稀疏轴
这篇论文在 DeepSeek 技术线上的位置
沿着 DeepSeek 技术全景 这条时间线看,DeepSeek 过去三年在架构上做的事情可以概括成一句话:把稠密计算换成稀疏计算。MoE 把 FFN 换成按 token 激活的专家子集(DeepSeekMoE 完全拆解),MLA 把 KV Cache 压成低秩潜向量(MLA 完全拆解),DSA 与 V4 的混合注意力把注意力的二次复杂度砍成线性(DeepSeek-V4 混合注意力完全拆解、DeepSeek-V4.1-Flash 推理侧完全拆解)。这些工作全部在优化同一件事:怎么算。
2026 年 1 月 12 日,DeepSeek 与北京大学王选计算机研究所联合提交了论文 Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models(arXiv:2601.07372,2026 年 7 月更新 v2 版),把矛头指向另一个问题:哪些东西根本不该算。论文提出的 Engram 模块,第一次把「记忆」提升到与「计算」平级的稀疏轴——MoE 提供条件计算(conditional computation),Engram 提供条件记忆(conditional memory)。官方代码已开源于 deepseek-ai/Engram。
这篇论文最有价值的地方不在于某个模块设计,而在于它给出了一个可量化的分配律:在固定参数与算力预算下,应该花多少容量去「记住」,多少去「推理」。答案是 U 形的,且最优比例在不同算力规模下稳定——这比「我们也加了个记忆模块」要有信息量得多。
问题:Transformer 在用昂贵的计算模拟廉价的查表
语言建模其实是两类任务
论文的出发点是一个非常朴素的观察:语言建模这个目标函数里混着两类性质完全不同的子任务。
第一类是组合推理(compositional reasoning):理解一段逻辑、做多步推导、根据上下文改变结论。这类任务没有捷径,必须经过深度的、动态的计算。
第二类是知识检索(knowledge retrieval):识别一个命名实体、匹配一个固定搭配、认出一句套话。论文引用的语料统计指出,文本中相当大一部分是局部的、静态的、高度程式化的(formulaic)。经典 N-gram 模型之所以能在这些位置上做得不错,恰恰因为它们就是查表——而这些规律天然就适合用计算成本极低的查找来表示。
问题在于,标准 Transformer 没有原生的查表原语。它只有注意力(做加权求和)和前馈网络(做矩阵乘法)。于是它被迫用计算去模拟检索。
一个具体的代价:识别「Diana, Princess of Wales」需要六层
论文引用并复现了 Ghandeharioun 等人(2024)的一个经典实验,用 PatchScope 把每一层的隐状态翻译成人话,观察模型是怎么一步步「想起」戴安娜王妃的。论文表 3 给出了这个过程:
| 层 | 隐状态翻译出的文本 | 解读 |
|---|---|---|
| 1-2 | Country in the United Kingdom | Wales(只是「英国的一部分」) |
| 3 | Country in Europe | Wales |
| 4 | Title held by female sovereigns… | Princess of Wales(还不确定指谁) |
| 5 | Title given to the wife of the Prince of Wales | Princess of Wales(仍不具体) |
| 6 | Diana, Princess of Wales (1961-1997), … | 终于还原出完整实体 |
一个静态的、写死在语料里的多 token 实体,居然要烧掉六层的注意力与 FFN 才能拼出来。前五层在做的事情,本质上是在运行时重建一张本来就可以预先存好的查找表。
论文把这个现象提炼成一句很锋利的判断:这等于把宝贵的序列深度(sequential depth)浪费在了琐碎操作上,而这些深度本可以分配给更高层的推理。这句话后面会被 LogitLens 和 CKA 两个实验从机理上证实——也是「Engram 等效于加深网络」这个结论的来源。
已有的两条路,各缺一半
在 Engram 之前,工业界和学术界其实已经沿着两条路走过了:
条件计算这条路由 MoE 走到极致。它解决了「参数规模不被算力绑架」的问题,但注意它的稀疏性作用在计算上:被激活的专家参与矩阵乘法,没被激活的专家纯粹是闲置的容量。MoE 并没有提供一种机制,让某些参数以「查表」而非「计算」的方式被访问。
外部检索这条路由 RAG 一系走到极致。它在输入端拼接检索到的文档,粒度是文档或段落级别,检索过程不可微,且检索质量取决于一个独立的外部索引系统。它解决的是「知识更新」,不是「架构效率」。
论文要的是一条介于两者之间、且能直接参与端到端训练的路:把静态知识存成参数,但用常数时间寻址访问,而不是用矩阵乘法算出来。
核心思想:把 N-gram 查表做成一级建模原语
Engram 这个名字来自神经科学:engram 指记忆在脑中留下的物理痕迹。模块本身做的事情可以用一句话概括:
给定当前位置的前缀,用哈希函数算出它在若干张巨大嵌入表里的地址,直接把向量取出来。
这个想法本身不新——FastText、N-Grammer、OverEncoding、SCON、Byte Latent Transformer 都做过类似的事。论文自己也承认这一点。它的创新点在于三个「不」:
第一,不用平均,用拼接与门控。早期工作(如 OverEncoding)把 N-gram embedding 与词表 embedding 直接平均,这在稀疏 MoE 主干上几乎没有收益。Engram 改用多头哈希取出多个向量拼接,再用上下文感知的门控做非线性筛选。
第二,不放在输入层,插到中间层。这是与所有前作最根本的分歧。放在第 0 层意味着内存访问与计算严格串行——你必须先把 embedding 取回来,才能算第一层。插到第 2 层、第 15 层,则可以让前几层的计算去掩盖 PCIe 传输延迟,这是后面「100B 参数表卸载仍只损失 2.8% 吞吐」的关键。
第三,不当作附加组件,当作与 MoE 竞争同一预算的一等公民。这直接引出了第 3 节的稀疏分配问题。
把 MoE 和 Engram 放在一起看,两者的对称性非常漂亮:
| 维度 | 条件计算(MoE) | 条件记忆(Engram) |
|---|---|---|
| 稀疏的是什么 | 被激活的参数子集 | 被检索的嵌入槽位 |
| 寻址依据 | 运行时隐状态(动态路由) | 输入 token ID(确定性哈希) |
| 访问代价 | 每 token 若干次专家矩阵乘 | 每 token 若干次 查表 |
| 擅长什么 | 动态、上下文相关的组合 | 静态、局部、程式化的模式 |
| 扩展时的瓶颈 | 算力与通信 | 存储容量与访存带宽 |
| 参数是否增加算力 | 否(只增加总参数) | 否(只增加总参数) |
最后一行是两条轴的共同点,也是它们能放在一起比的前提:两条轴都能在几乎不增加每 token FLOPs 的情况下扩大模型容量,区别只在于容量被用来做什么。
架构详解(一):哈希 N-gram 检索
Engram 模块处理每个位置 时分两个功能阶段:检索(retrieval)和融合(fusion)。先看检索。
整体流程可以用论文 Figure 1 看清楚:输入序列在底部,虚线框里是 Engram 模块的内部结构。序列被切成 2-gram 与 3-gram 两组,各自经过哈希(Hash)后到对应的嵌入表(2-Gram Embedding / 3-Gram Embedding)里取出向量,拼接(Concat)后分两路:一路做 Key 与门控信号做点积,一路做 Value,两者相乘得到门控后的输出。
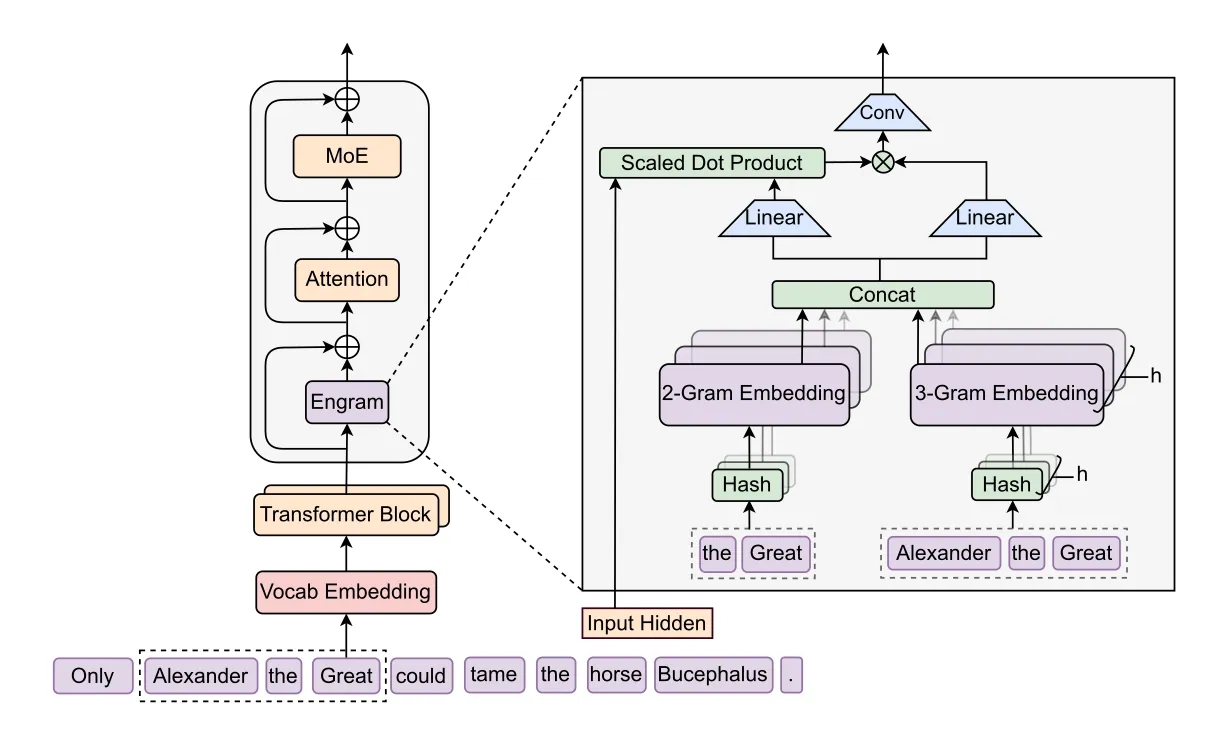
图源:arXiv:2601.07372 Figure 1,The Engram Architecture
第一步:tokenizer 压缩——先让词表变得「语义密集」
标准 BPE 分词器的设计目标是无损重建(lossless reconstruction),而不是语义密度。这导致语义上完全等价的字符串会拿到互不相干的 ID。论文举的例子是 Apple 与 ␣apple(带前导空格),在词表里是两个不同的 token;中文、日文场景下,全角与半角、大小写、变音符号同样会炸出大量等价变体。
论文用一层词表投影(vocabulary projection)解决这个问题:预先计算一个满射函数
其中 是原始词表, 是归一化后的规范词表。 把原始 token ID 折叠成规范 ID,折叠依据是文本归一化后的等价性——使用 NFKC 规范化、小写化等手段。
对一个位置 上的 token,映射写作 。
效果:论文正文说,对 128k 词表实现了约 23% 的有效词表缩减;附录 C 的表 6 给出了精确值——压缩比 23.43%。附录还列出了合并数量最多的前 5 个规范 token:
| 排名 | 合并数 | 规范 token | 被合并的原始 token(部分) |
|---|---|---|---|
| 1 | 163 | ␣(空格) | \t、\n、\r、␣、␣␣、\n\n、␣␣␣、␣\n … |
| 2 | 54 | a | A、a、␣a、␣A、á、ä、~a、ą … |
| 3 | 40 | o | O、o、␣o、␣O、ó、ö、^o、~o … |
| 4 | 35 | e | E、e、␣e、␣E、é、è、ę … |
| 5 | 30 | i | I、i、␣I、␣i、í、ì、ī、ï … |
这张表很说明问题:排名第一的竟然是空白字符,163 种换行、制表、空格变体被合并成一个 token。这直接印证了论文的动机——原始词表里有大量参数被浪费在编码「同一个东西的不同写法」上。
官方 demo 里 CompressedTokenizer 的归一化管线是:
self.normalizer = normalizers.Sequence([ normalizers.NFKC(), # 兼容性归一化(全角→半角等) normalizers.NFD(), # 规范分解 normalizers.StripAccents(), # 去变音符号:é → e normalizers.Lowercase(), # 小写化:A → a normalizers.Replace(Regex(r"[ \t\r\n]+"), " "), # 连续空白折叠成一个空格 normalizers.Replace(Regex(r"^ $"), SENTINEL), # 保护「单个空格」不被 Strip 吃掉 normalizers.Strip(), # 去首尾空白 normalizers.Replace(SENTINEL, " "), # 还原被保护的空格])注意第 6 行那个 SENTINEL 技巧:先做空白折叠,此时一个原本带空格的 token(如 ␣apple)会变成 " apple";如果紧接着 Strip(),它会变成 "apple",就和不带空格的 apple 撞车了——但这两个在语义上确实应该合并,所以设计者其实想让它们合并。真正要保护的是「token 本身就是一个空格」这种情况(␣ 单独一个 token),它 Strip 之后会变成空串。所以先用 ^ $ 正则把这个孤立的空格替换成私用区字符 U+E000,Strip 之后再换回来。
为什么要做这一步,代价是什么:收益是嵌入表的有效容量变大——同样的槽位数能覆盖更多真实语义模式,哈希碰撞概率也随之下降。代价是丢失了大小写与重音信息。对「记住 Apple 和 apple 是同一家公司」这类任务,这正是想要的;但如果模型需要区分 US(美国)和 us(我们),或者依赖德语名词大写的句法线索,这层压缩就会引入噪声。论文的消融实验显示,去掉 tokenizer 压缩是性能退化最严重的三个消融之一(见后文),说明这个看似琐碎的预处理步骤实际贡献很大。
第二步:构造后缀 N-gram
压缩后的 token 序列上,定义位置 处的 阶后缀 N-gram:
这个记号里, 是阶数, 是当前 token 往前数第 个 token 的规范 ID。之所以叫「后缀」(suffix),是因为这个元组总是以当前位置 结尾——预测任务里,我们正是在位置 上做下一个 token 的预测,所以「以 结尾的局部上下文」才是有效特征。
论文在 Table 5 中给出的 Engram-27B / 40B 配置是 Engram N-gram = [2, 3],即只取 2-gram 与 3-gram。 被排除在外:1-gram 就是词表本身,已经被输入层的 Vocab Embedding 覆盖了,再来一遍是纯冗余。论文公式 (2) 里的连乘下标也明确从 开始。
第三步:多头哈希——用 K 个头把碰撞的伤害摊薄
直接参数化所有可能的 N-gram 组合是不可行的。128k 词表的三阶组合有 种,即使每槽只存一个向量也放不下。
Engram 沿用哈希做法(论文援引 Tito Svenstrup 等人 2017 年在推荐系统领域的多头哈希工作)。为缓解碰撞,它对每个 N-gram 阶数 使用 个独立的哈希头。第 个头把压缩后的上下文映射到一张素数大小为 的嵌入表 的一个下标上,映射函数 是确定性的:
逐符号拆解:
- :位置 、 阶、第 个哈希头算出的表内下标,一个非负整数,取值范围 。
- :第 个头的哈希函数。它把变长的 token ID 元组 压成一个整数。
- :该头的嵌入表, 行、每行 维。
- :取出的一行,就是一次 访存的结果。
最后把所有头、所有阶数的结果拼接成记忆向量:
是拼接(concatenation)。,维度 。
为什么是「多头」而不是「一张大表」
这是整个检索阶段最值得讲清楚的设计决策。
单头哈希的问题是:一旦两个不同的 N-gram 哈希到同一个槽位,它们就共享了同一行参数,梯度会互相污染,而且推理时模型无法察觉这个错误——它拿到的就是一行「错误的」向量。
多头哈希并不消除碰撞,但它改变了碰撞的后果。假设某个头发生了碰撞,那么 里只有 的维度被污染,其余 个头的分量仍然正确。可以这样理解:单头是「一个键对应一个完整向量」,多头是「一个键对应 K 个独立证据,各自独立可能出错」,而下游的门控与投影层有能力基于多数正确分量做出判断。
代价是: 个头意味着 次独立的哈希计算与 次访存。当 、阶数 2 时,每个 token 每个 Engram 层要做 16 次查表。论文的 Engram-27B 配置正是 。
为什么表大小取素数
素数模数在哈希中能提供更均匀的分布。若模数是合数,恰好含小质因子的乘数或低位模式会被映射到有限的余数类上,形成规律性的聚集。官方 demo 里 find_next_prime 的实现还多做了一件事:保证所有头的表大小是互不相同的素数。这一点配合 demo 的 MultiHeadEmbedding 实现才有意义——它把所有头的表拼成一张扁平的 nn.Embedding,用 offsets 记录每张子表的起始偏移,从而实现一次 embedding 调用完成所有头的查表(对 GPU 来说,一次批量 gather 远快于 次单独调用)。如果两张子表的素数相同,偏移就只起到「加常数」的作用,索引空间的分散性会变差。
哈希函数长什么样
论文说 实现为轻量级乘法-XOR 哈希(multiplicative-XOR hash)。官方 demo 给出了完整实现:
# 每个 (层, 阶数) 对应一个随机奇数乘子multipliers = r * 2 + 1 # r 为随机整数,保证乘子为奇数
# n 阶 N-gram 的混合:先乘后异或mix = tokens[0] * multipliers[0]for k in range(1, n): mix = np.bitwise_xor(mix, tokens[k] * multipliers[k])
# 每个头对混合结果取模(素数)head_hash = mix % mod逐行解释:
tokens[0]是当前 token(经过shift_k对齐),tokens[k]是往前第 个 token。每个位置有独立的乘子。- 乘子强制为奇数(
r * 2 + 1)。奇数的低位比特分布更均匀,且与模数为奇素数配合时不会出现「因式分解塌缩」。 - 混合用异或而非加法。异或用的是无进位加法,每个比特独立混合,不会出现低位向高位进位导致的信息串扰;而乘法负责把单个 token 的 ID 扩散到整个字长。
- 乘子由
np.random.default_rng(seed + 10007 * layer_id)生成。注意种子里带了layer_id——不同的 Engram 层使用完全不同的哈希函数。这很重要:如果两层用同一套哈希,那么两层里发生碰撞的 N-gram 对会完全相同,错误会跨层重复叠加;不同的哈希函数让各层的碰撞模式互相独立。 - 最后
mix % mod取模得到表内下标。
这个哈希是纯整数运算,没有浮点、没有查表、没有随机性,可以在 CPU 上以极高的吞吐批量计算——这正是「确定性寻址」的物理基础。
检索阶段的伪代码
把上面三步串起来:
def engram_retrieve(input_ids, layer_id, vocab_projection, hash_mapping): """Engram 检索阶段:token 序列 -> 记忆向量 e_t""" # 1. 词表投影:128k 原始 ID -> 归一化后的规范 ID(约 23% 压缩) x = vocab_projection[input_ids] # [B, T]
# 2. 为每个 n-gram 阶数对齐出 n 个移位版本(左移用 pad 补齐) shifts = [shift_right(x, k, pad_id) for k in range(max_ngram)] # 每个 [B, T]
hashes = [] # 3. 对每个阶数 n = 2..N,每个哈希头 k = 1..K for n in range(2, max_ngram + 1): mix = shifts[0] * multipliers[layer_id][0] for j in range(1, n): mix = mix ^ (shifts[j] * multipliers[layer_id][j]) # 乘法-异或混合 for k in range(n_head_per_ngram): hashes.append(mix % prime_table_size[layer_id][n][k]) # 素数次模
ids = stack(hashes, dim=-1) # [B, T, (N-1)*K] # 4. 一张扁平大表 + offsets 实现一次批量 gather e = multi_head_embedding(ids) # [B, T, (N-1)*K*d_head] = e_t return e注意第 3 步里 multipliers[layer_id] 的取值只依赖层号,prime_table_size 是编译期常量——整条检索链上没有一处依赖隐藏状态。这就是论文反复强调的确定性:索引在 token 序列确定的那一刻就完全确定了。
架构详解(二):上下文感知门控与深度卷积
检索阶段拿到的 是一个与上下文无关的先验。它只由 token ID 决定,因此有三个天然缺陷:
- 哈希碰撞:不同的 N-gram 可能落到同一槽位,取出错误的记忆。
- 多义性(polysemy):同一个 N-gram 在不同语境下含义不同。
苹果在「苹果发布了新手机」和「苹果富含维生素」里指两个东西,但哈希键完全相同。 - 静态性:查表结果不会随上下文变化,模型缺少一个「这个记忆现在适用吗」的判断环节。
论文用一个受注意力启发的门控机制解决这个问题。
角色反转:隐状态当 Query,记忆当 Key/Value
标准注意力里,Query、Key、Value 通常来自同一组输入。Engram 的门控做了一次角色反转:
- :检索到的记忆向量,是这一阶段的输入。
- :可学习的投影矩阵,把记忆映射到主干的隐藏维度 。
- :投影后的 Key 与 Value。Key 用来算相关性分数,Value 用来被加权输出。
论文特别指出:这里的 Query 用的是当前隐藏状态 ,而它「已经通过前面的注意力层聚合了全局上下文」。这一点是整个设计的逻辑支点:记忆是死的,隐状态是活的;活的那个来提问,死的那个来回答。
为什么不直接用 加上去(像位置编码那样)?因为加法无法表达「这条记忆与当前语境矛盾,应该丢弃」。论文要的是一个可学习的、依赖于上下文的开关。
为什么是标量门控而不是向量门控?这是很多人第一次读会疑惑的点。公式给出的是 ,一个标量。向量门控(逐维度加权)表达力更强,但代价是额外的参数与计算,而且在实现上会破坏后面提到的「融合进单个 FP8 GEMM」的优化。论文选择标量,赌的是「记忆向量的各个维度是一个语义整体,要么整体可信、要么整体不可信」——后面第 6.5 节的门控可视化实验(Figure 7)证实了这个赌注:门控确实在「多 token 命名实体」「固定搭配」这样的整体模式上打开,而不是在某个维度上零散地打开。
门控公式与 RMSNorm 的作用
- :sigmoid 函数,把实数压到 ,确保门控是「通过比例」而非「带符号增益」。
- :均方根归一化,。注意这里是对 和 分别做归一化。
- :转置, 是点积,衡量两个向量的方向一致性。
- :主干的隐藏维度(Engram-27B 中为 2560)。除以 是标准的缩放,把点积的方差拉回 。
为什么必须加 RMSNorm:这是门控能否正常工作的关键。如果不归一化,点积的大小会随 与 的范数一起漂移——训练早期隐状态范数很小,点积接近 0,sigmoid 输出恒为 0.5,门控形同虚设;训练后期隐状态范数变大,点积绝对值变大,sigmoid 饱和到 0 或 1,梯度消失,门控学不动。RMSNorm 把两个向量的尺度都钉死在 ,使门控的输入分布在整个训练过程中保持稳定。论文引用 Dehghani 等人(2023)的结论,明确说这是为了梯度稳定性。
为什么值域是 而不是 :sigmoid 而非 tanh,意味着门控只能衰减、不能反转符号。论文的意图是抑制噪声,而不是让记忆反向注入。如果允许负门控,一个错误的记忆就可能把正确答案从隐状态里「减掉」,风险远大于收益。
官方 demo 的一个实现细节:论文公式是理想形式,demo 里在 sigmoid 之前多做了一步变换:
gate = (normed_key * normed_query).sum(dim=-1) / math.sqrt(hidden_size)gate = gate.abs().clamp_min(1e-6).sqrt() * gate.sign() # 带符号的平方根gate = gate.sigmoid().unsqueeze(-1)abs().clamp_min(1e-6).sqrt() * sign() 是一个带符号的平方根压缩。它的作用是把点积的幅度分布往中间拉:原始点积的分布重尾(少数位置数值很大),sigmoid 会在这少数位置饱和;开方之后大值被压得更狠、小值被抬得更高,整体分布更集中在 0 附近,sigmoid 处在敏感区间内的样本比例更高,梯度更健康。clamp_min(1e-6) 是为了避免对 0 开方时梯度出现 NaN。
消融证据:论文第 6.2 节的组件消融(Figure 5)显示,去掉上下文感知门控(w/o gating)是性能退化最大的三个消融之一,与「去掉多分支融合」「去掉 tokenizer 压缩」并列。这个结果的直观解释是:没有门控,哈希碰撞的噪声会无差别地注入每一个 token,模型学到的不是「记忆」而是「噪声」。
深度因果卷积:把感受野拓宽
门控输出定义为单位置加权:。序列版本记作 。
接下来论文加了一个短卷积:
- :对门控输出做归一化,作用同样是把尺度钉死,让卷积核的输入分布稳定。
- :深度可分离(depthwise)的一维卷积,每个通道独立卷积,通道间不混合。论文设定的核大小 ,扩张率 设为最大 N-gram 阶数(即 )。
- :,平滑版 ReLU,在负半轴保留小梯度,实践中比 ReLU 更稳。
- 末尾的 :残差连接。
为什么是深度可分离而不是普通卷积:普通 1D 卷积的参数量是 (、 时约 2620 万,且计算量随 平方增长);深度可分离只有 (约 1 万参数)。Engram 模块被要求「轻量」,不能喧宾夺主。论文消融也确认了这一点:去掉短卷积(w/o short conv)的退化是最轻微的一项——它有用,但不是核心。这与参数量级的判断一致。
为什么是因果(causal):因为这是自回归语言模型。位置 的输出不能看到 之后的信息。实现上就是只在左侧 padding:demo 里 padding=(kernel_size - 1) * dilation,卷完之后截断到原长度 y_bct[..., :T],等价于左填充的因果卷积。
为什么 dilation 取最大 N-gram 阶数:核大小 的普通卷积只能覆盖相邻 4 个位置;但当扩张率 时,4 个采样点跨越的位置范围是 个 token。也就是说,卷积的有效感受野大约等于 3 阶 N-gram 覆盖范围的三倍。论文的意图是让卷积去捕捉那些比 3-gram 更长、但仍然是局部的模式——比如 5-gram、6-gram 级别的固定搭配,这些模式超出了哈希表的阶数范围,却仍然不值得动用全局注意力。这是一个「用极低成本覆盖中间尺度」的设计。
融合阶段的伪代码
def engram_fuse(e_t, hidden_states, W_K, W_V, short_conv): """Engram 融合阶段:记忆向量 + 隐状态 -> 模块输出 Y""" # e_t: [B, T, d_mem];hidden_states: [B, T, M, d],M 为多分支数 k = W_K(e_t) # [B, T, d] 记忆投影出的 Key v = W_V(e_t) # [B, T, d] 记忆投影出的 Value(各分支共享)
gates = [] for m in range(num_branches): h = hidden_states[:, :, m, :] # 第 m 条分支的隐状态 # 门控:隐状态作 Query,记忆作 Key,RMSNorm 稳定尺度 score = (rmsnorm(h) * rmsnorm(k_m)).sum(-1) / sqrt(d) score = score.abs().clamp_min(1e-6).sqrt() * score.sign() gates.append(score.sigmoid().unsqueeze(-1)) alpha = stack(gates, dim=2) # [B, T, M, 1]
u = alpha * v.unsqueeze(2) # [B, T, M, d] 门控后的记忆 y = u + short_conv(u) # 深度因果卷积 + 残差 return y
# 插入方式:残差连接,且只插在选定的层# hidden_states = hidden_states + engram_fuse(...) 然后才是 Attention 与 MoE注意最后两行注释——Engram 的输出是通过残差加到隐状态上的,而且加完之后才进入该层的 Attention 和 MoE。这个顺序有讲究:Engram 提供的记忆信息会先污染(或者说丰富)隐状态,然后才被注意力消费。论文 Figure 1 左侧画的就是这个顺序:输入 → Engram → Attention → MoE。
架构详解(三):插在哪里,怎么与多分支共存
残差插入与「不是每层都插」
是第 层的隐藏状态, 是 Engram 模块输出。论文明确指出:Engram 不是每一层都插。这个决定本身就是一个需要实验回答的设计问题。
层位置扫描:第 2 层最好,但分成两层更好
论文第 6.2 节做了一个很干净的消融:主干固定为 12 层、3B 参数、激活 0.56B 的 MoE,训练 100B token,挂一个 1.6B 参数的 Engram 记忆。参考配置把 Engram 插在第 2 层和第 6 层,使用 2-gram 与 3-gram,验证损失 1.768;纯 MoE 基线是 1.808,改善 0.04。
然后把 1.6B 预算全部集中到一个 Engram 模块,扫插入层从 1 到 12:
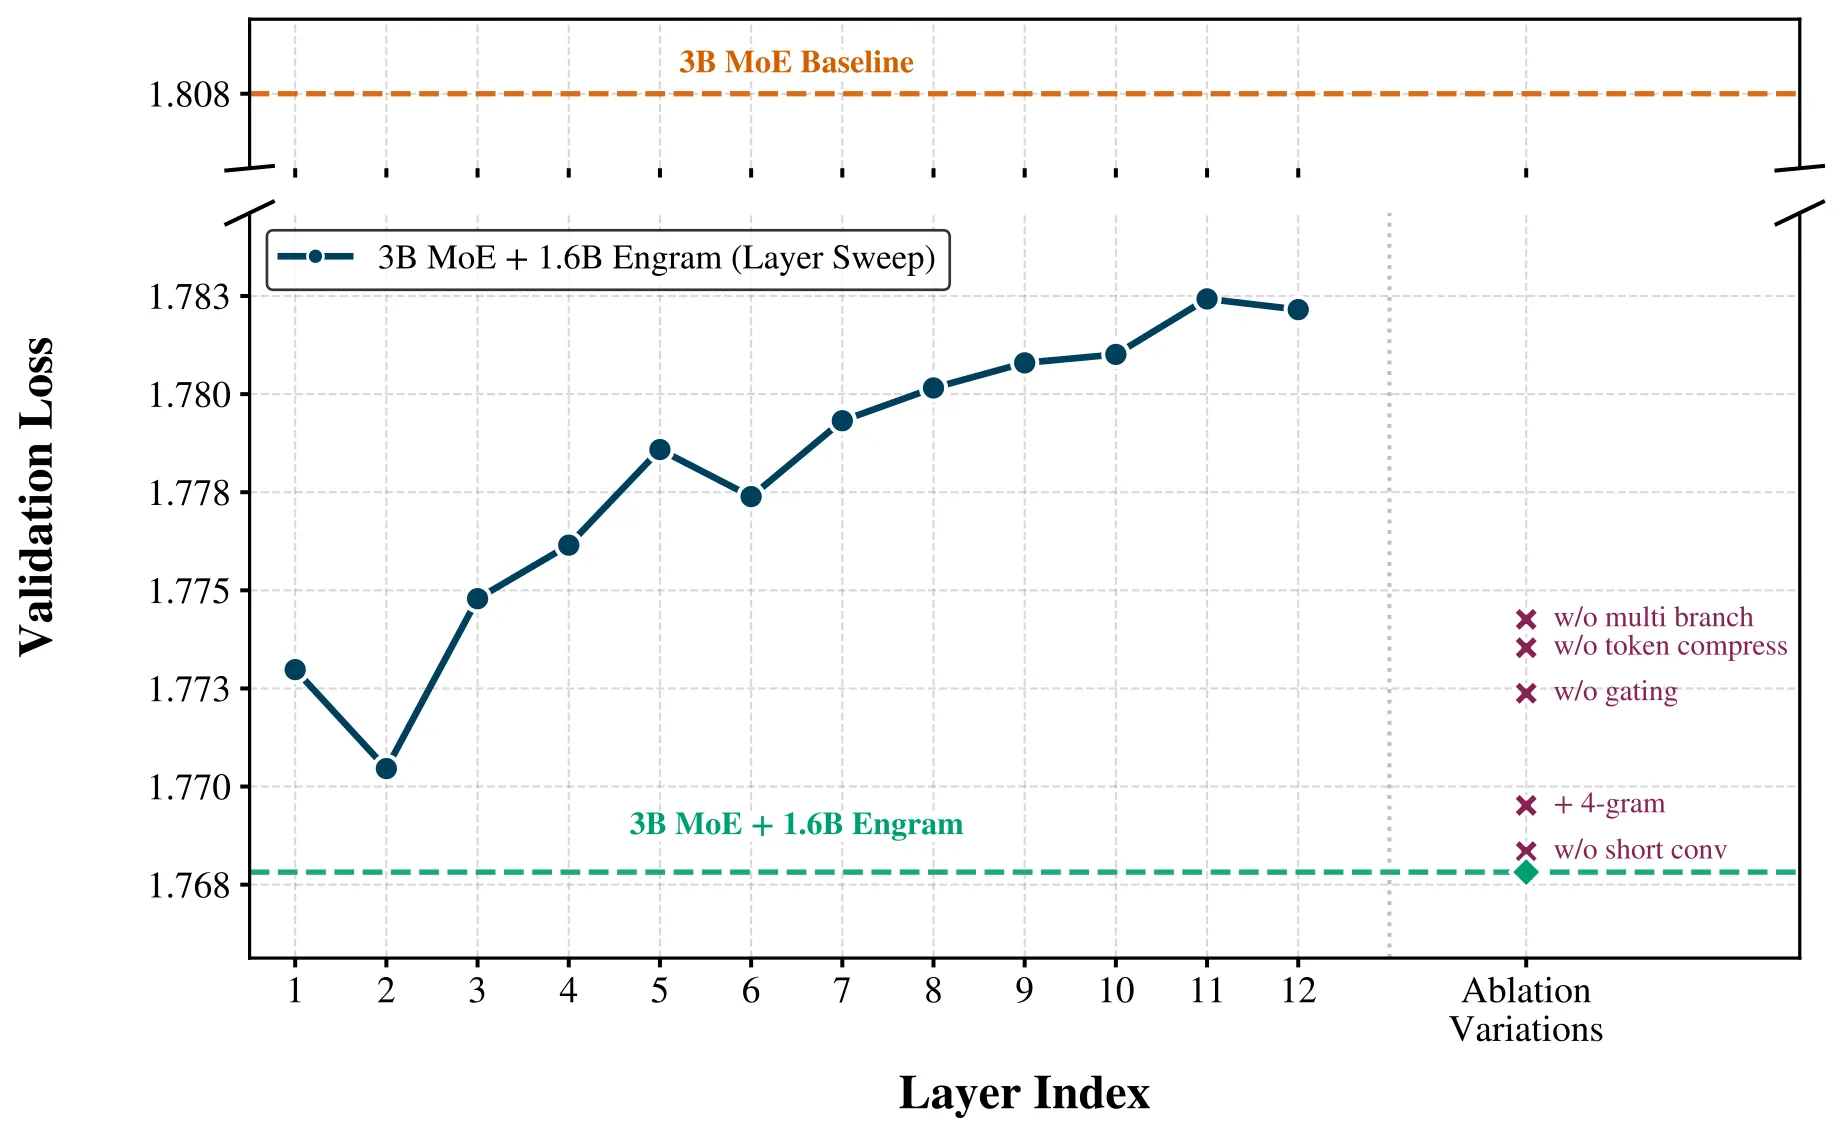
图源:arXiv:2601.07372 Figure 5,Architecture ablation results
图上可以读出几个关键点:
- 第 1 层不如第 2 层。论文明确给出第 2 层的最优值 Val Loss = 1.770,第 1 层则明显更差(图上读数约 1.7735)。论文的解释是:一轮注意力已经足够给 提供有意义的上下文,用于门控;放在第 1 层时隐状态还没聚合任何全局信息,门控精度不足。
- 从第 3 层开始单调退化,越深越差:图上读数约为第 3 层 1.775、第 5 层 1.779、第 12 层 1.783。全部高于第 2 层的 1.770。
- 参考配置的两层方案(1.768)优于任何单层方案(最好单层 1.7705)。
这个扫描暴露了 Engram 位置的内在权衡:
- 早插:能在主干消耗计算深度之前,先把「局部模式重建」这件苦力活卸载掉。这与 Transformer 天然的层级处理顺序一致(浅层处理局部、表层特征,深层处理抽象、语义)——论文引用 Tenney 等人(2019)和 Ghandeharioun 等人(2024)的工作支持这一层级观。
- 晚插:门控精度更高。因为深层隐状态已经通过注意力聚合了充分的全局上下文,作为 Query 更有信息量;同时多分支架构在深层已经有了足够的分化,能支撑更细粒度的调制。
分成两层就是对这一权衡的折中:第 2 层承担「早卸载」,第 6 层提供「强门控」。论文指出,分层插入还带来一个系统层面的额外好处——多个 Engram 层可以把不同频率的记忆条目缓存到不同层级的存储介质上,更好地利用内存层次(见后文)。
在实际的 Engram-27B 中,论文选择的是第 2 层和第 15 层(总层数 30),把折中思路放大到了更深的网络上。
多分支集成:共享表、共享 Value、独立 Key
论文的主干不是标准单流残差,而是多分支架构(multi-branch)。论文引用其团队自己的 mHC(Manifold-Constrained Hyper-Connections,arXiv:2512.24880)作为默认骨架,把残差流扩展成 条并行分支,分支间信息流由可学习的连接权重调制。论文所有实验都用 。
把 Engram 适配到多分支框架需要做结构优化,论文的方案是参数共享:
- 一份稀疏嵌入表和一个 Value 投影矩阵 在所有 条分支间共享。
- 个独立的 Key 投影矩阵 用来产生分支各自的门控行为。
第 条分支的门控信号是:
记忆经过独立门控调制后,作用在共享的 Value 向量上:
为什么这样切分参数,论文给的理由很工程:这样切之后,线性投影(一个 加 个 )可以融合成单个稠密 FP8 矩阵乘法,最大化现代 GPU 的算力利用率。
这句话值得展开。如果每条分支都有自己独立的 和 ,那么 条分支就需要 次独立的矩阵乘,每次的 batch 都很小,GPU 的 Tensor Core 利用率会很低(小矩阵乘是典型的访存受限算子)。而把 个 在输出维度上拼接成一个 的大矩阵、把 单独留着,就可以把「 个 Key 投影」合并成一次矩阵乘。共享 则进一步省掉了 次冗余计算。
为什么门控必须分支独立:因为 条分支承载的是不同的表示子空间,同一条记忆在不同分支里的适用程度本就不同。如果门控也共享,那 Engram 就退化成了「给所有分支注入同一个固定扰动」,失去了与分支结构协同的能力。消融实验印证了这一点——w/o multi branch(保留 mHC 骨架,但把所有分支的门控合并成一次融合,作用在 pre-mapping 之后的隐藏状态上)是退化最大的三个消融之一。
代价是什么: 个独立的 意味着 Key 侧参数量随 线性增长。在 、、 的配置下,这是 4 个 的矩阵,约 1310 万参数——相对于 5.7B 的嵌入表可以忽略。这个切分是划算的。
稀疏预算怎么分:U 形缩放律
这是论文最核心、也最可复用的贡献。
三个参数口径
论文先把「参数量」这件事拆成三个互不相同的量:
- :总可训练参数,排除词表 embedding 与 LM head。这决定了模型的存储开销。
- :每 token 激活的参数。这个量决定训练成本(FLOPs),因为只有被激活的参数参与前向与反向的矩阵乘。
- :非激活参数,也就是「免费的」参数预算——它们扩大了模型容量,却不增加每 token 的计算。
第三个量是整篇论文的枢纽。MoE 的稀疏性来源是「没被选中的专家」,Engram 的稀疏性来源是「没被检索到的嵌入槽位」,两者都落进 。既然两条轴争夺的是同一池免费参数,那就存在一个分配问题。
分配比例
论文定义:
是分给 MoE 专家容量的比例。两个极端:
- :纯 MoE,所有非激活参数都是路由专家。
- :减少路由专家数量,把腾出来的参数换成 Engram 嵌入槽位。
实验设计上,每个 FLOPs 预算内固定 与 ,保证等参数、等算力;两个实验点都维持稀疏比 :
| 预算 | 基线()专家数 | ||
|---|---|---|---|
| FLOPs | 约 5.7B | 568M | 106 |
| FLOPs | 约 9.9B | 993M | 99 |
对每个 ,只调整路由专家数量与 Engram 槽位数,其余训练管线与超参完全一致。
结果:U 形
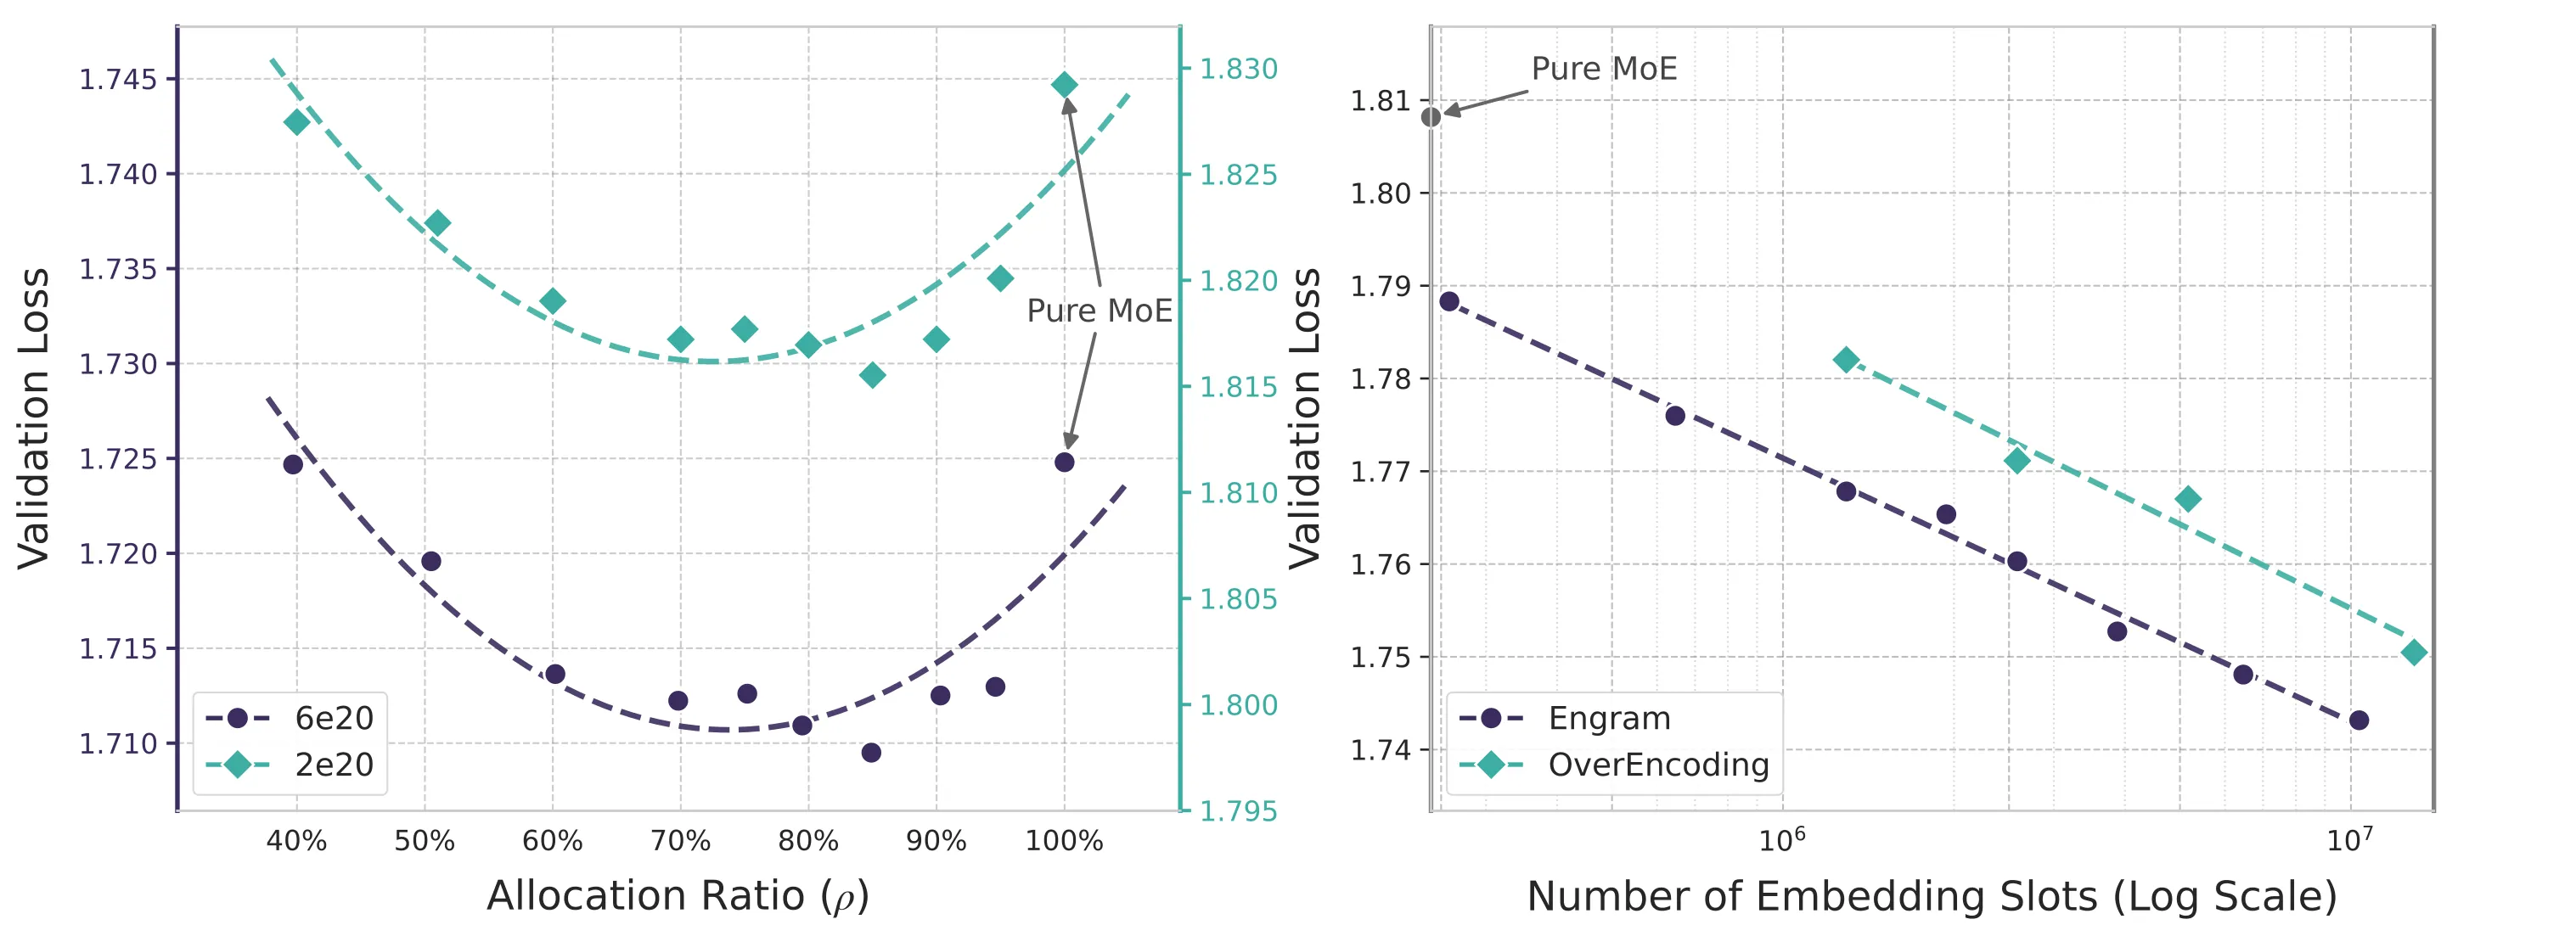
图源:arXiv:2601.07372 Figure 3,Sparsity allocation and Engram scaling
三个结论,每一个都有数据支撑:
第一,纯 MoE 是次优的。 把大约 20%–25% 的稀疏参数预算重新分配给 Engram,性能最好。定量地看,在 10B 那一档(),验证损失从 时的 1.7248 降到最优点 附近的 1.7109,改善 。
第二,一个反直觉的结论:即使把 MoE 容量砍到 40%,性能仍然追平纯 MoE。 论文原文说,当 MoE 分配降到 时(5.7B 模型剩 46 个专家,9.9B 模型剩 43 个专家),Engram 模型与纯 MoE 基线的性能相当。注意左边那条深紫色曲线(6e20)在 处的点仍低于 的端点,右边青色曲线(2e20)同理。这意味着:超过一半的专家容量被换成了查表,而性能没有损失。这是对 MoE 容量边际效用的一记重击——那些被砍掉的专家,本质上在干查表的活。
第三,最优点的位置在不同算力规模下稳定。 论文明确说最优在 –80%,并强调「在受检的规模范围内表现出稳健的分配偏好(在固定稀疏比下)」。这一点比具体数值更重要:它意味着 20%–25% 这个比例有希望作为一个可迁移的设计常数,而不是「只在某个规模上碰巧成立」。
为什么是 U 形:两个方向的失败模式
U 形曲线的两端对应两种不同的失败:
右侧(,MoE 主导):模型缺少专门存储静态模式的记忆,被迫用深度和计算去低效重建它们。这正是第 1 节里「识别戴安娜王妃要六层」的代价。沿着这条曲线往左走,每砍掉一些专家、换成记忆,就把这部分重建工作从「计算」转成了「查找」,于是损失下降。
左侧(,Engram 主导):模型失去了条件计算能力,在需要动态、上下文相关推理的任务上受损。论文的措辞很直接:在这个区间里,记忆无法替代计算。
这句话是整篇论文的立场宣示。它没有宣称「记忆比计算更重要」,恰恰相反——它给出了计算与记忆之间的交换比:在这个实验设定下,用 1 份记忆容量换掉大约 3 到 4 份专家容量是划算的(因为 从 100% 降到 75%–80%,意味着 20%–25% 的稀疏预算改投记忆,而这部分预算在纯 MoE 里对应约 4 到 5 倍的专家容量占比……需要说明的是,论文并未给出严格的「交换比」数字,这里只是从 U 形最优点位置做的定性推断)。一定要强调:最优点的存在本身就证明了记忆不能无限替代计算。如果记忆能完全替代计算,曲线应该单调下降到 。
无限记忆区间:一个干净的幂律
第 3.1 节是在固定参数预算下做分配。第 3.2 节反过来问:如果记忆容量可以无限放宽呢?
实验设置:固定一个 、 的 MoE 主干,训练 100B token 确保收敛;在它之上挂 Engram 表,槽位数 从 扫到 ,最多增加约 130 亿参数。
结果(Figure 3 右图):验证损失随槽位数的对数呈严格的线性下降——也就是幂律。图中蓝色曲线是 Engram,青色是 OverEncoding(把 N-gram embedding 与词表 embedding 平均的早期做法)。两条曲线都在下降,但 Engram 的斜率更陡,同样的记忆预算能换来更大的损失下降。
论文的结论是:Engram 提供了一个可预测的缩放旋钮(scaling knob)——更大的记忆持续带来收益,且不需要额外算力。对工程实践而言,这意味着记忆容量可以像「加硬盘」一样规划,而不是像「加层数」那样要重新平衡整个训练配方。
顺带一提,论文在这里做了一个排除性说明:SCONE(Yu 等人,2025)也研究大规模 embedding,但它是面向推理的,且引入了额外模块(f-gram model)与额外的训练 FLOPs,与本文严格的等算力约束不兼容,所以没有作为基线。这一段透露出论文的方法论洁癖:任何额外算力都要计入账本。
大规模预训练:Engram-27B
有了分配律做指导,论文把 Engram 放大到 27B 规模做验证。
四个模型
所有模型共享同一套 30 层主干、隐藏维度 2560、序列长度 4096、词表 129280、batch size 1280、训练 50000 步(262B token)。注意力是 MLA(32 个头),FFN 通过 mHC(扩张率 4)连接,优化器用 Muon(嵌入参数用 Adam),基础学习率 4e-4,step decay,权重衰减 0.1。
| 配置 | Dense-4B | MoE-27B | Engram-27B | Engram-40B |
|---|---|---|---|---|
| 总参数 | 4.1B | 26.7B | 26.7B | 39.5B |
| 激活参数(不含 token embed) | 3.8B | 3.8B | 3.8B | 3.8B |
| 路由专家 | - | 72 | 55 | 55 |
| 共享专家 | - | 2 | 2 | 2 |
| 每 token 激活专家 | - | top-6 | top-6 | top-6 |
| Engram 参数 | - | - | 5.7B | 18.5B |
| Engram 维度 | - | - | 1280 | 1280 |
| Engram 表大小 | - | - | 2,262,400 | 7,239,680 |
| Engram 头数 | - | - | 8 | 8 |
| Engram 层 | - | - | [2, 15] | [2, 15] |
| Engram N-gram | - | - | [2, 3] | [2, 3] |
几个关键设计:
Engram-27B 是从 MoE-27B 严格推导出来的。路由专家从 72 减到 55,腾出的参数原封不动变成 5.7B 的嵌入模块——总参数保持 26.7B 不变。对应的分配比例是 ,正好落在 U 形最优点 75%–80% 的区间边缘。这不是巧合,是分配律的直接应用。
表 5 的配置可以反推出 5.7B 这个数字。 由 组成,即 ,解得每个头 。于是嵌入表总参数为:
2 层 × 2 个 N-gram 阶数 × 8 个头 × 2,262,400 槽 × 80 维 ≈ 5.79B
与论文声明的 5.7B 一致。Engram-40B 用同样公式:2 × 2 × 8 × 7,239,680 × 80 ≈ 18.53B,与声明的 18.5B 精确吻合。这说明论文表 5 里的「Engram Vocab Size」是单头单阶数的表大小。
优化细节值得单独记一笔:嵌入参数用 Adam、学习率放大 5 倍、不做权重衰减;卷积参数零初始化。
- 学习率放大 5 倍:嵌入表是高基数稀疏查找,每个槽位在一步内只被极少数 token 命中,天然处于「低样本」状态。用主干的 4e-4 会让槽位更新过慢,学不出来。
- 权重衰减为 0:嵌入槽位不是稠密权重,对它们做 L2 收缩没有正则意义,反而会把罕见 N-gram 的记忆抹掉。
- 卷积零初始化:这是一个精妙的工程细节。卷积核初始为 0,意味着训练第一步时 ,于是 ——模块退化为恒等映射。主干的初始行为与没有 Engram 时完全一致,训练从一个「已经能正常工作」的状态开始,再逐渐学习如何利用记忆。如果不零初始化,训练初期随机的卷积输出会作为噪声注入前向,干扰主干已有的收敛路径。
主结果
表 1 给出了完整对比(所有模型训练 262B token,激活参数 3.8B)。下表摘出最关键的几组:
| 基准(指标) | 采样 | Dense-4B | MoE-27B | Engram-27B | 相对 MoE-27B | Engram-40B |
|---|---|---|---|---|---|---|
| Pile(loss) | - | 2.091 | 1.960 | 1.950 | −0.010 | 1.942 |
| 验证集(loss) | - | 1.768 | 1.634 | 1.622 | −0.012 | 1.610 |
| MMLU(Acc.) | 5-shot | 48.6 | 57.4 | 60.4 | +3.0 | 60.6 |
| MMLU-Redux(Acc.) | 5-shot | 50.7 | 60.6 | 64.0 | +3.4 | 64.5 |
| MMLU-Pro(Acc.) | 5-shot | 21.1 | 28.3 | 30.1 | +1.8 | 31.3 |
| CMMLU(Acc.) | 5-shot | 47.9 | 57.9 | 61.9 | +4.0 | 63.4 |
| C-Eval(Acc.) | 5-shot | 46.9 | 58.0 | 62.7 | +4.7 | 63.3 |
| AGIEval(Acc.) | 0-shot | 29.1 | 38.6 | 41.8 | +3.2 | 45.9 |
| ARC-Easy(Acc.) | 25-shot | 76.8 | 86.5 | 89.0 | +2.5 | 90.1 |
| ARC-Challenge(Acc.) | 25-shot | 59.3 | 70.1 | 73.8 | +3.7 | 76.4 |
| TriviaQA(EM) | 5-shot | 33.0 | 48.8 | 50.7 | +1.9 | 51.8 |
| PopQA(EM) | 15-shot | 15.1 | 19.2 | 19.4 | +0.2 | 21.2 |
| CCPM(Acc.) | 0-shot | 72.2 | 79.6 | 87.1 | +7.5 | 87.7 |
| BBH(EM) | 3-shot | 42.8 | 50.9 | 55.9 | +5.0 | 57.5 |
| HellaSwag(Acc.) | 0-shot | 64.3 | 71.8 | 72.7 | +0.9 | 73.1 |
| PIQA(Acc.) | 0-shot | 63.8 | 71.9 | 73.5 | +1.6 | 76.5 |
| WinoGrande(Acc.) | 5-shot | 64.0 | 67.6 | 67.8 | +0.2 | 68.1 |
| DROP(F1) | 1-shot | 41.6 | 55.7 | 59.0 | +3.3 | 60.7 |
| RACE-Middle(Acc.) | 5-shot | 72.4 | 80.9 | 82.8 | +1.9 | 83.3 |
| RACE-High(Acc.) | 5-shot | 66.0 | 75.4 | 78.2 | +2.8 | 79.2 |
| C3(Acc.) | 0-shot | 57.7 | 60.1 | 63.6 | +3.5 | 61.8 |
| HumanEval(Pass@1) | 0-shot | 26.8 | 37.8 | 40.8 | +3.0 | 38.4 |
| MBPP(Pass@1) | 3-shot | 35.4 | 46.6 | 48.2 | +1.6 | 46.2 |
| CruxEval-i(EM) | 0-shot | 27.6 | 30.7 | 32.2 | +1.5 | 36.2 |
| GSM8K(EM) | 8-shot | 35.5 | 58.4 | 60.6 | +2.2 | 62.6 |
| MGSM(EM) | 8-shot | 27.0 | 46.8 | 49.4 | +2.6 | 52.4 |
| MATH(EM) | 4-shot | 15.2 | 28.3 | 30.7 | +2.4 | 30.6 |
(表中「相对 MoE-27B」一列由表中数值相减得出。需要说明一处不一致:论文摘要写 MMLU 提升 +3.4,而正文第 4.2 节与表 1 的数值都对应 +3.0;这里以表 1 与正文为准。)
最反直觉的一点:收益在推理和代码上更大
按论文自己的预期,记忆模块最该帮助的是知识类任务——MMLU、CMMLU、TriviaQA 这些「记没记住」的题。数据确实显示知识类有提升(CMMLU +4.0、MMLU +3.0、CCPM +7.5)。
但真正的意外在于:推理与代码/数学上的提升更大。BBH +5.0、ARC-Challenge +3.7、DROP +3.3;代码数学侧 HumanEval +3.0、MATH +2.4、GSM8K +2.2、MGSM +2.6。注意这些模型是等参数、等 FLOPs、同数据、同配方的,唯一的差别是 5.7B 参数从专家挪到了记忆表。
论文对此的解释是:记忆不是冗余,它把算力让给了推理。当浅层不需要再花力气去重建静态模式,这些层的表征能力就被释放出来,用于更高阶的组合。这正好呼应 LogitLens 和 CKA 的机理发现——也是整篇论文最值得记住的洞察。如果一个模型的推理能力受限于「深度不够」,那么把浅层从查表工作中解放出来,等效于增加深度。
Engram-40B:容量还没吃满
Engram-40B 把记忆从 5.7B 扩到 18.5B(总参数 39.5B),激活参数不变。结果:预训练损失进一步下降,多数基准继续提升(AGIEval 41.8 → 45.9、ARC-Challenge 73.8 → 76.4、GSM8K 60.6 → 62.6、MGSM 49.4 → 52.4、CruxEval-i 32.2 → 36.2)。
但它并非在每个任务上严格优于 Engram-27B——HumanEval 从 40.8 掉到 38.4,MBPP 从 48.2 掉到 46.2,MATH 基本持平(30.7 → 30.6)。论文对此的判断是训练不足(under-training)而非容量无用:训练损失曲线显示,Engram-40B 与基线的差距在训练末期仍在扩大,说明「扩大的记忆容量在当前 token 预算内尚未饱和」。这是一个诚实的结论——它同时也意味着 Table 1 里 Engram-40B 的数字是下限。
长上下文:把局部依赖交出去,把注意力留给自己
预训练实验证明了 Engram 在通用能力上的收益。但论文提出了一个更结构性的假设:如果局部依赖由查表承担,注意力容量就被释放出来处理全局上下文。长上下文任务正是检验这个假设的最佳试验场。
实验设置
上下文扩展沿用 DeepSeek-V3 的策略:预训练结束后,用 YaRN 在 32768 token 的上下文长度上训练 5000 步(30B token 高质量长文本)。超参为 scale 、、、缩放因子 。这四个参数是 YaRN 的标准配置,含义分别是: 是整体缩放倍率, 与 控制 NTK 插值的过渡区间, 是注意力温度补偿系数。
评价基准用两个:
- LongPPL:长上下文困惑度,分四类语料——长书籍(Book)、研究论文(Paper)、代码仓库(Code)、长思维链轨迹(L-CoT)。
- RULER:14 个子集归成 8 类——单键/多键/多值/多查询的「大海捞针」(S / MK / MV / MQ),以及多跳变量追踪(VT)、常见词提取(CWE)、高频词提取(FWE)、问答(QA)。
一个方法学上的讲究:Iso-Loss 对照
论文在这里展示了一个值得学习的实验设计。如果直接拿「训练了 50000 步的 Engram-27B」对比「训练了 50000 步的 MoE-27B」,结论会被一个混杂变量污染:长上下文能力与基础模型本身的好坏强相关。
论文为此设了三组对照:
- Iso-FLOPs 设置:Engram-27B(50k)对比 MoE-27B(50k)。同等算力,最标准的对比。
- Iso-Loss 设置:Engram-27B(46k)对比 MoE-27B(50k)。46k 这个检查点是特意挑的——它的预训练损失(1.63)与充分训练的 MoE-27B(1.63)完全相同。这样两边的「基础能力」被对齐,任何差异都只能归因于架构。
- 极端设置:Engram-27B(41k,只用了约 82% 的预训练算力)对比 MoE-27B(50k)。
这个设计本身就是论文的一个隐含主张:做架构对比时,对齐损失比对齐步数更有意义。它还顺带观察到一个现象——Engram-27B 从 41k 到 50k,长上下文性能随预训练进程单调提升,说明长上下文能力与基础建模能力是耦合的。
结果
| 模型(步数,预训练损失) | Book | Paper | Code | L-CoT | S | MK | MV | MQ | VT | CWE | FWE | QA |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| MoE-27B(50k, 1.63) | 4.38 | 2.91 | 2.49 | 14.16 | 100.0 | 88.0 | 92.7 | 84.2 | 77.0 | 4.5 | 73.0 | 34.5 |
| Engram-27B(41k, 1.66) | 4.37 | 2.92 | 2.50 | 14.26 | 99.6 | 88.3 | 93.0 | 89.5 | 83.2 | 3.8 | 99.6 | 44.0 |
| Engram-27B(46k, 1.63) | 4.19 | 2.84 | 2.45 | 13.59 | 97.6 | 89.0 | 95.5 | 97.0 | 87.2 | 4.3 | 98.6 | 37.5 |
| Engram-27B(50k, 1.62) | 4.14 | 2.82 | 2.44 | 13.41 | 99.3 | 89.3 | 96.5 | 97.0 | 89.0 | 5.9 | 99.3 | 40.5 |
(左侧四列为 LongPPL 困惑度,越低越好;右侧八列为 RULER 准确率,越高越好。S/MK/MV/MQ 为大海捞针,VT 为变量追踪,CWE/FWE 为词提取,QA 为问答。)
几个必须点出来的数字:
Multi-Query NIAH(MQ):84.2 → 97.0,提升 12.8 个点。 这个提升在46k 检查点上就已经拿到(同样是 97.0),也就是说,用比基线少 8% 的预训练算力、且基础损失完全对齐的条件下,架构本身就贡献了这 12.8 个点。
Variable Tracking(VT):77.0 → 87.2(46k)/ 89.0(50k),提升 10.2 到 12.0 个点。 变量追踪是多跳任务——需要跟踪多个变量在长文本中的赋值与重绑定,是纯粹的长程依赖测试。这个任务的提升最能支持「注意力容量被释放」的假设。
Frequent Words Extraction(FWE):73.0 → 98.6(46k)/ 99.3(50k),提升 25 个点以上。
最极端的一组:Engram-27B(41k)只用 82% 的预训练算力,在 LongPPL 上与完全训练的 MoE-27B 打平(4.37 vs 4.38、2.92 vs 2.91、2.50 vs 2.49),在 RULER 上全面超过(MQ 89.5 vs 84.2、VT 83.2 vs 77.0、FWE 99.6 vs 73.0、QA 44.0 vs 34.5)。论文原文的措辞是「underscoring the intrinsic superiority of the Engram architecture」。
为什么会有这个结果,论文的逻辑链条是:注意力是一种有限资源。在标准 Transformer 里,注意力既要处理「这个代词指谁」这种局部绑定,又要处理「这份文档的主旨是什么」这种全局关系。局部绑定大量、廉价、模式固定;全局关系少量、昂贵、需要容量。当 Engram 把前者接过来,注意力头就可以专门服务后者——于是长上下文检索类任务的提升远大于平均水平的提升。
这条观察与站内已经拆过的 KV Cache 那条线正好互补:StreamingLLM 讨论的是「哪些 KV 可以丢」,H2O 讨论的是「哪些 KV 是重击者」,SnapKV 讨论的是「怎么在生成前投票压掉 prompt KV」——它们都在优化注意力的成本;而 Engram 的思路是减少注意力需要处理的东西。两条路不冲突,可以叠加。
机理分析:Engram 等效于增加网络深度
论文没有停在「性能更好」这一步,而是用两个可解释性工具去验证一个具体假设:
通过给模型一个显式的知识查找能力,Engram 把早期阶段的特征组合工作卸载掉,从而等效于增加了模型的有效深度。
证据一:LogitLens 显示预测收敛更快
LogitLens 的做法是:拿每一层的中间隐状态,直接用最终的 LM Head 投影出词表分布。论文计算这个中间分布与模型最终输出分布之间的 KL 散度——散度越小,说明该层的表征越「接近可以直接下预测」,也就是越「prediction-ready」。
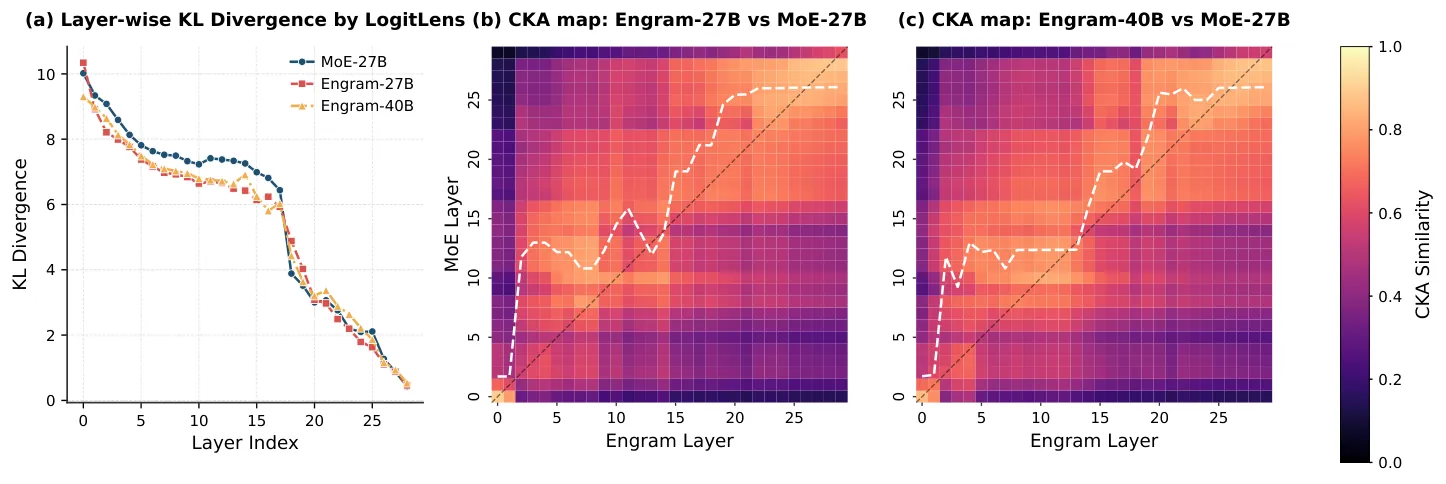
图源:arXiv:2601.07372 Figure 4,Analysis of representational alignment and convergence speed
结果(Figure 4a):与 MoE 基线相比,两个 Engram 变体的逐层 KL 散度系统性地更小,且差距在早期层最明显。曲线下降更陡,意味着模型更早完成特征组合。论文的解读是:通过显式访问外部知识,Engram 减少了所需的计算步数,从而在网络层级中更早达到高置信度的有效预测。
证据二:CKA 显示「第 5 层 ≈ MoE 的第 12 层」
第二个证据更硬。论文用中心核对齐(Centered Kernel Alignment,CKA)比较两个模型各层表征的相似度结构。CKA 的定义是:
- 与 是两组表征 的格拉姆矩阵(Gram matrix,用线性核), 分别来自两个模型(或两层)的激活。
- 是希尔伯特-施密特独立性准则(Hilbert-Schmidt Independence Criterion,Gretton 等人 2005)。它度量两个格拉姆矩阵所代表的相似度结构有多接近。
- 分母的 是归一化项,把 CKA 压到 ,使得不同尺度、不同维度的表征可以公平比较。
实现上论文用的是 minibatch 版本与 HSIC 的无偏估计(Davari 等人 2023),在 Few-NERD 数据集上提取命名实体最后一个 token 的隐状态。
仅有相似度矩阵还不够——他们进一步定义了软对齐指数 :
逐符号解释:
- :逐对的 CKA 相似度矩阵, 是层数。 表示 MoE 的第 层与 Engram 的第 层的相似度。
- :对固定的 Engram 层 ,在所有 MoE 层 中取相似度最高的前 个(论文取 )。用 top- 过滤是为了排除低相似度的噪声——如果不做筛选,一堆 0.3 的弱相似会拖偏重心。
- :这 个 MoE 层下标的加权质心,权重就是相似度本身。它充当「Engram 第 层对应的有效 MoE 深度」这一概念的稳健代理。
结果(Figure 4b–c):相似度热图中出现了明显的对角线上移——即 在很大范围的层上都成立。论文给出的具体例子是:Engram-27B 第 5 层的表征,最接近 MoE 基线第 12 层左右的表征。
7 层的「免费深度」。这个结论把前面所有零散观察串成了一条线:Engram 通过显式查表绕过了早期的特征组合,从而在功能上等效于加深了网络。
系统效率:确定性寻址带来的预取能力
这是 Engram 与 MoE 在系统层面最本质的差别,也是论文反复强调的「基础设施感知效率」(infrastructure-aware efficiency)作为一等设计原则的含义。
关键差异:确定性 vs 动态
MoE 的路由依赖运行时的隐藏状态。一个 token 在到达第 5 层之前,你无法知道它会被路由到哪些专家——因为路由决策本身是第 5 层注意力与 FFN 计算的结果。这意味着,参数必须就在计算设备上(或者至少在同一高速互连域内),否则每次路由都要发起一次通信,延迟无法隐藏。这就是为什么 MoE 服务必须做专家并行——专家参数必须在设备上,通信也就被绑死在关键路径上。
Engram 的寻址只依赖输入 token ID。这个信息在请求进入系统的那一刻就完全确定了。论文的措辞是:内存索引在前向传播之前就已经知道,因此系统可以通过 PCIe 从充裕的主机内存异步检索嵌入。
训练阶段:分片 + All-to-All
训练时,嵌入表太大,装不进单卡。论文用标准模型并行:把表分片到所有可用 GPU 上;前向传播用 All-to-All 通信原语收集激活的行,反向传播再派发梯度。这样总内存容量随加速器数量线性扩展。
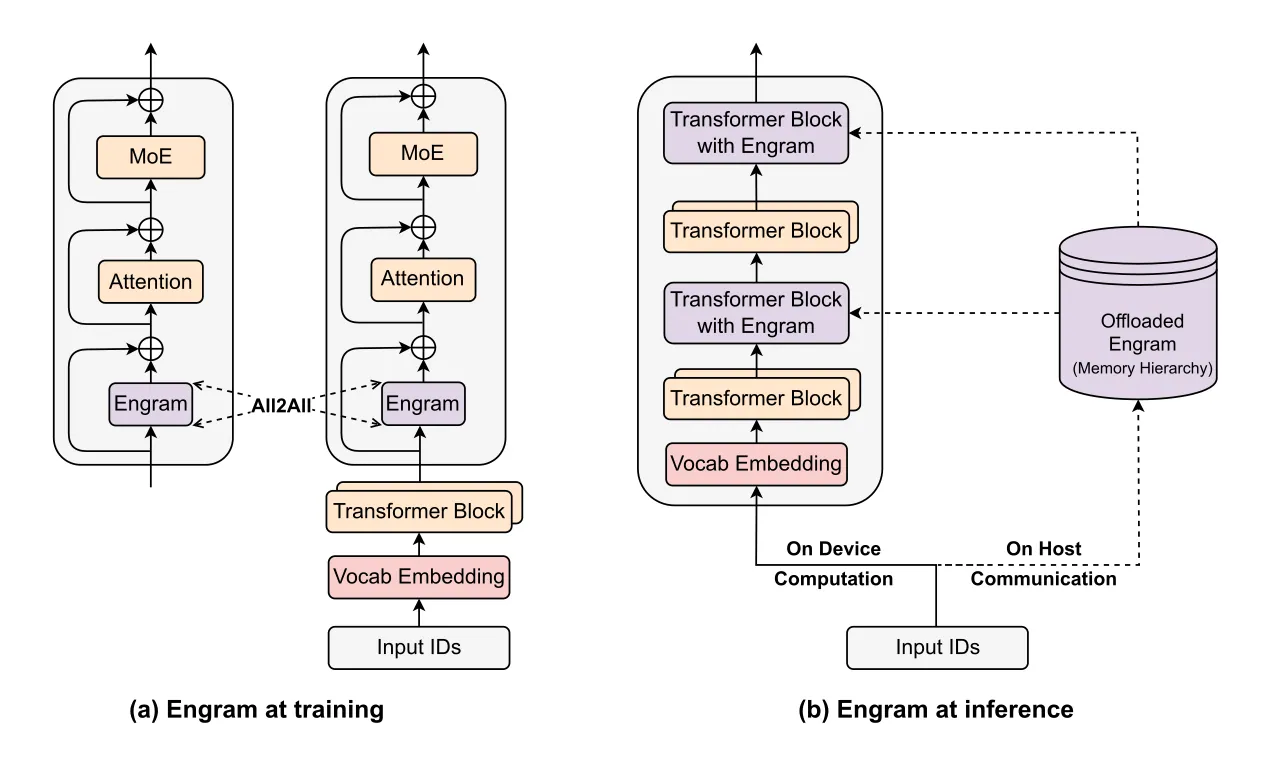
图源:arXiv:2601.07372 Figure 2,System implementation of Engram
推理阶段:预取与重叠
推理时,由于索引已知,系统可以在需要它们之前就把嵌入取回来。要掩盖 PCIe 传输延迟,关键是让 Engram 模块放在足够深的层——前面几层的计算时间就是隐藏延迟的窗口。论文把这个称为硬件-算法协同设计:
一方面,把 Engram 放得更深能延长可用于隐藏延迟的计算窗口;另一方面,第 6.2 节的消融显示,建模性能偏好早期介入(第 2 层)以卸载局部模式重建。因此最优位置必须同时满足建模性能和系统延迟两个约束。
这段是整篇论文里「算法-系统协同」体现得最清楚的一处。它解释了一个看似矛盾的配置选择:既然第 2 层建模最好,为什么实际模型用第 2 层和第 15 层? 答案是第 15 层那个位置承担了系统职责——它离输入足够远,PCIe 预取有充分的隐藏窗口;同时它提供了更强的门控 Query。
多级缓存层次
论文还指出一个统计性质:自然语言的 N-gram 服从 Zipf 分布——极少数模式占据了绝大多数访问。这个性质直接支持多级缓存层次的设计:高频嵌入缓存在更快的介质(GPU HBM 或主机 DRAM),长尾的罕见模式放在更慢但容量更大的介质(NVMe SSD)。这种分层让 Engram 能以极小的有效延迟代价扩展到海量记忆容量。
实测:100B 参数表卸载,损失不到 3%
论文用一个基于 nano-vLLM(vLLM 的精简原型)搭建的推理实验台做了实测。为了避开专家并行带来的通信干扰,测试跑在两个纯稠密主干上(Dense-4B 和 Dense-8B),在第 2 个 Transformer 块插入一个1000 亿参数的 Engram 层,整个嵌入表驻留在主机 DRAM。推理时系统异步预取该层的嵌入,把 PCIe 传输与前一个块的计算重叠。
硬件:NVIDIA H800。负载:512 条序列,长度在 100 到 1024 之间均匀分布。
| 基础模型 | 配置 | 吞吐(tok/s) | 相对变化 |
|---|---|---|---|
| 4B-Dense | 基线 | 9,031.62 | - |
| 4B-Dense | + 100B Engram(CPU 卸载) | 8,858.28 | −1.92% |
| 8B-Dense | 基线 | 6,315.52 | - |
| 8B-Dense | + 100B Engram(CPU 卸载) | 6,140.02 | −2.78% |
结论:卸载 1000 亿参数的嵌入表,吞吐损失峰值只有 2.8%(8B 主干),4B 主干上只有 1.92%。论文原文的表述是「negligible throughput penalty, peaking at only 2.8% on the 8B backbone」。
论文还强调这个实验是保守下界:它强制所有检索都走 PCIe 从主机内存取,完全没有利用 Zipf 局部性做分层缓存。一个真正优化过的、局部性感知的实现,损失应该更小。
这个数字的工程含义是颠覆性的。它意味着参数存储与计算可以彻底解耦:GPU 只需要承担计算,知识库可以放在便宜得多的主机 DRAM(乃至 SSD)上。参数规模的扩展不再受限于 HBM 容量,也不需要用专家并行把表拆到几十张卡上。论文的措辞是「Engram 有效地绕开了 GPU 内存约束,使得激进的参数扩展成为可能」。
同时要注意一个前提:每一步的有效通信量随激活槽位数而非表的总体积缩放。每个 token 每层只取 行向量(每行 80 维,bf16 下 160 字节),合计约 2.5 KB/token/层。表再大,这个数字不变——这才是 O(1) 的真正含义。
敏感性与消融:记忆里到底存了什么
推理时把 Engram 关掉会怎样
论文做了一个相当激进的实验:推理时完全抑制稀疏嵌入的输出(相当于把 Engram 模块摘掉),保持主干不变,观察各基准掉了多少。
必须说明,这种事后消融会造成训练-推理不一致,在复杂的混合能力任务上会引入噪声。所以论文明智地只分析敏感度谱的两个极端——事实知识与阅读理解——这两类任务在压力测试下的信噪比最高。
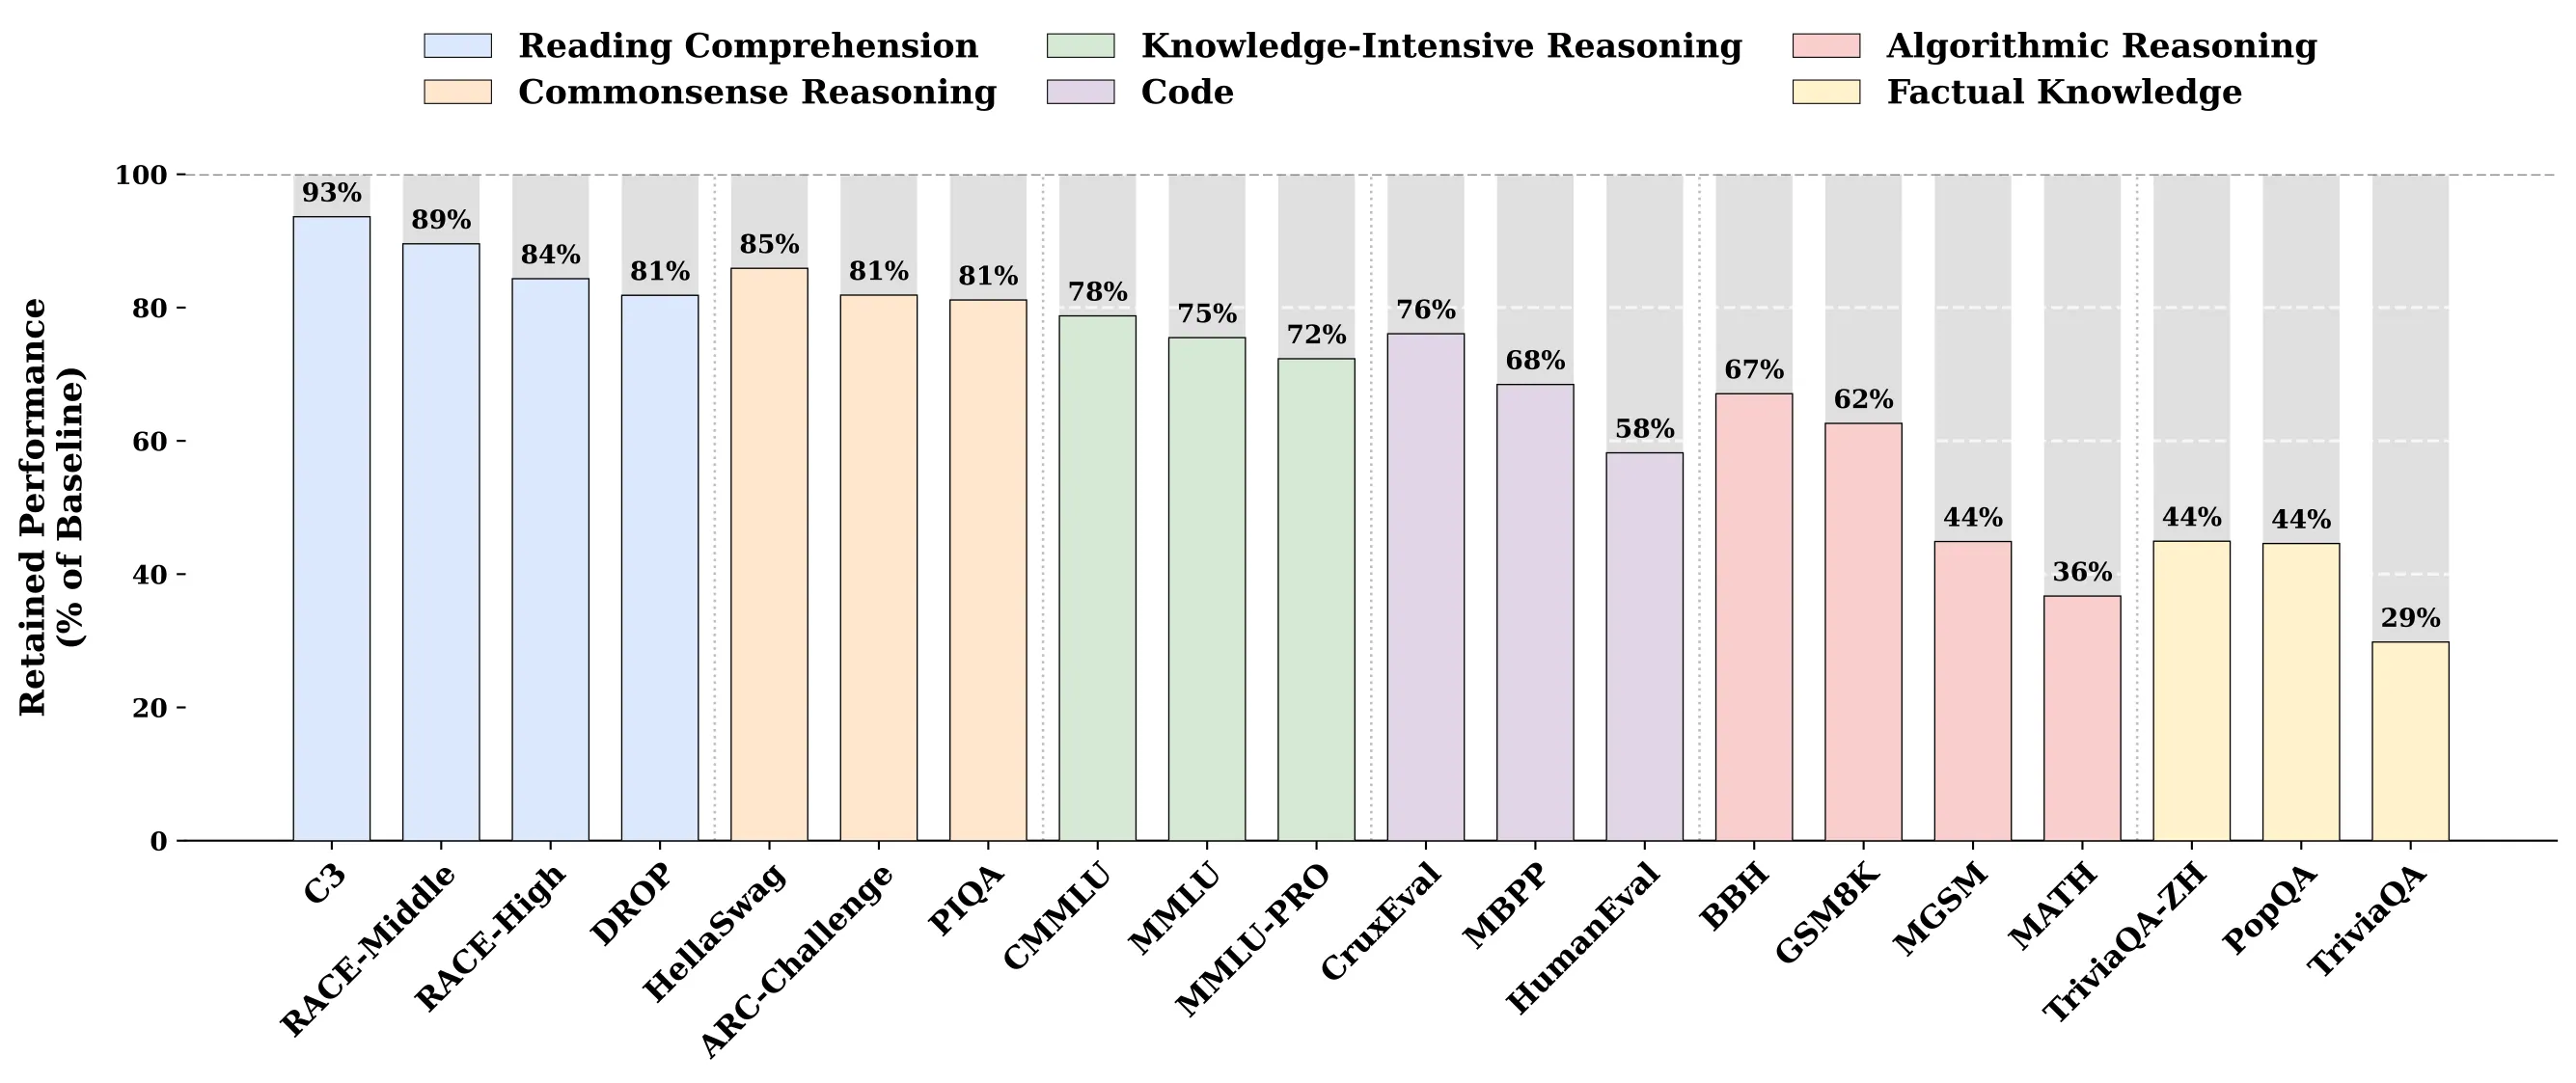
图源:arXiv:2601.07372 Figure 6,Retained performance under Engram ablation
结果呈现一个尖锐的功能二分:
- 事实知识类:灾难性崩塌,只保留 29%–44% 的性能。其中 TriviaQA 掉到 29%。
- 阅读理解类:韧性极强,保留 81%–93%。其中 C3 保留 93%。
论文的解读:前者证明 Engram 模块是参数化知识的主要仓库——这一点与「FFN 作为键值记忆」的既有理论(Geva 等人 2021)形成对照,说明在 Engram 架构里,知识的存储位置发生了迁移;后者说明依赖上下文的问答任务主要依赖主干的注意力机制,而不是 Engram。
这组数字回答了一个自然会被问到的问题:Engram 是不是把 FFN 的活抢了? 答案是部分是的——它抢走了「存储静态事实」这部分工作,而把「基于上下文推理」留给了主干。这正是论文想达到的分工。
组件消融:什么最重要
回到 Figure 5 右侧的消融标记(基于 12 层 3B MoE + 1.6B Engram 的参考配置,参考验证损失 1.768):
| 消融项 | 影响 |
|---|---|
| 去掉多分支融合(w/o multi branch) | 退化显著(三大瓶颈之一) |
| 去掉 tokenizer 压缩(w/o token compress) | 退化显著(三大瓶颈之一) |
| 去掉上下文感知门控(w/o gating) | 退化显著(三大瓶颈之一) |
| 扩展到 4-gram(+ 4-gram) | 轻微退化 |
| 去掉短卷积(w/o short conv) | 最轻微 |
两点值得展开:
4-gram 在固定预算下反而略差。 论文的解释是:在 1.6B 参数固定的前提下,加入 4-gram 会稀释更频繁的 2-gram / 3-gram 模式的容量。这个判断很关键——它说明记忆容量不是「越多阶越好」,而是一个需要与语料频率分布匹配的预算分配问题。论文也谨慎地补充:不排除在更大的记忆规模下更高阶 N-gram 会变得有益。
三大瓶颈的组合很说明问题。 它们分别对应:与主干结构的耦合方式(多分支)、输入表示的语义密度(tokenizer 压缩)、以及噪声抑制能力(门控)。换句话说,Engram 的收益不来自「查表」这个动作本身,而来自这三个配套设计。这也解释了为什么早期直接把 N-gram embedding 平均进输入层的做法收效有限——缺的正是这套「如何把静态记忆安全地注入动态主干」的机制。
门控可视化:它真的在学「固定搭配」吗
论文最后给了一个定性但很有说服力的案例研究。他们把 Engram-27B 的门控标量 在若干真实样本上做了热力图。
注意一个细节:Engram-27B 用 mHC()+ 第 2、15 两层 Engram,所以每个 token 实际上会算出 个门控标量。论文坦言并非每条分支都编码了可解释的激活模式,所以图中只挑选了与语义模式匹配最相关的那些门控值展示。
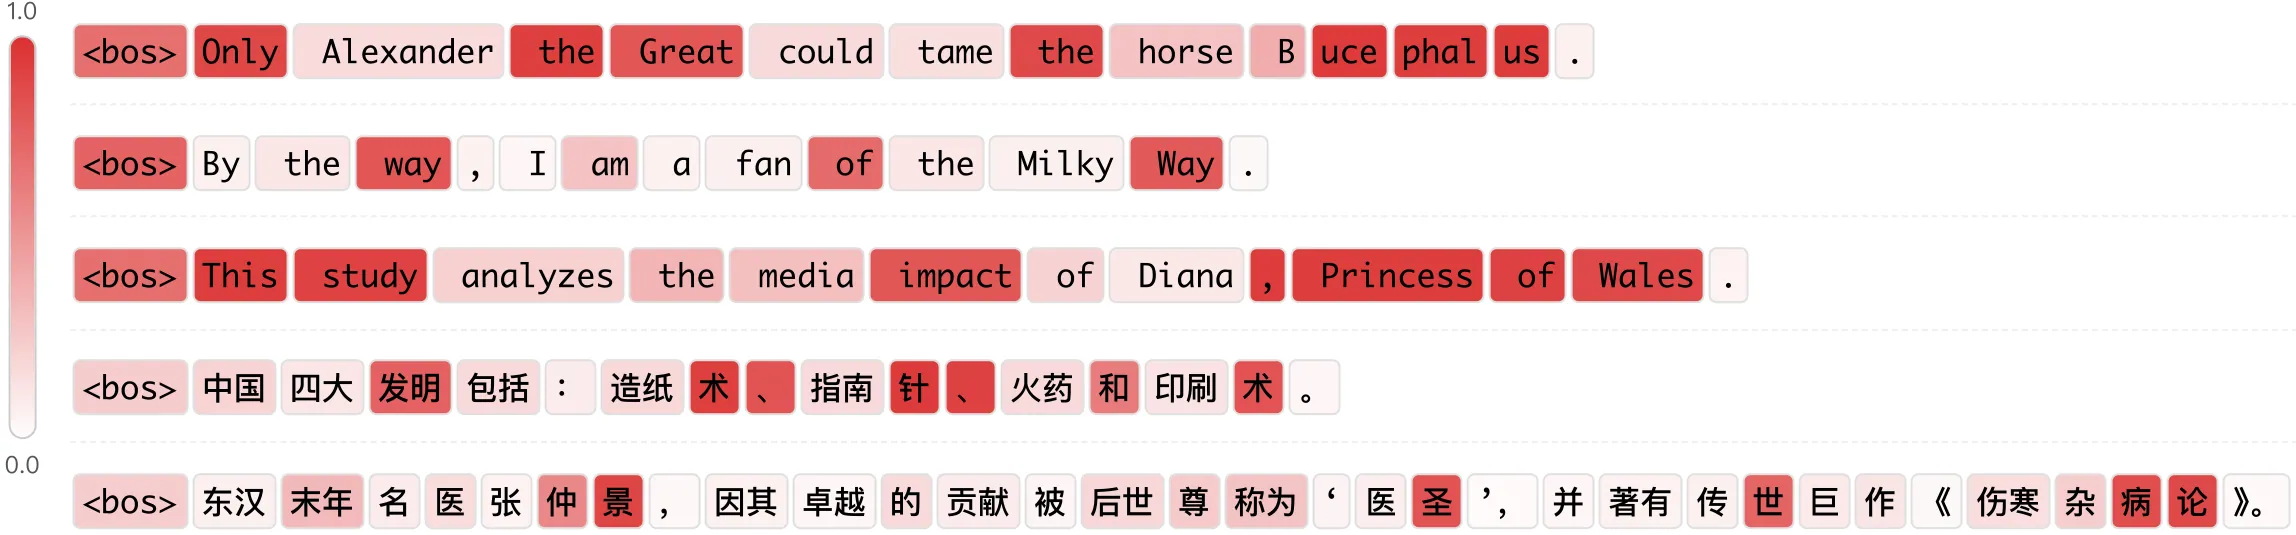
图源:arXiv:2601.07372 Figure 7,Visualization of the gating mechanism of Engram
读图方法:颜色越红表示门控值越大。由于 Engram 作用于后缀 N-gram(此处 ),某个 token 上的高激活意味着「以该 token 结尾的那个短语」被识别为静态模式并成功从记忆中检索。
图上呈现的规律非常干净:
英文样本:
Only Alexander the Great could tame the horse Bucephalus.—the、Great高亮,正好是实体Alexander the Great的收尾。By the way, I am a fan of the Milky Way.—way与Milky、Way高亮。注意the way与the Milky Way是同一段字面文本的两个不同解读,门控在Milky上打开,说明它确实在做多 token 层面的模式识别,而不是看单个 token。This study analyzes the media impact of Diana, Princess of Wales.—impact、Princess、Wales高亮,Diana本身反而不高——因为「以 Diana 结尾的前缀」还不足以确定是哪个固定模式,要等到Princess of Wales补全。
中文样本:
中国四大发明包括:造纸术、指南针、火药和印刷术。— 门控在四大、发明、以及各个术上高亮,准确切出了「四大发明」以及四个并列的「XX术」固定词。东汉末年名医张仲景,因其卓越的贡献被后世尊称为'医圣',并著有传世巨作《伤寒杂病论》。—张、仲、景三个字连续高亮(实体内部逐字确认),医圣、伤寒杂病论也高亮。
论文的结论是:门控机制一致地在完成局部静态模式时激活,且这个行为跨语言有效。这些定性结果证实 Engram 成功识别并处理了程式化的语言依赖,把主干从记忆这些静态关联中解放出来。
这个可视化还回答了一个设计上的疑问:门控会不会学成一个常数(要么全开要么全关)? 从热力图看没有——它在同一句话内既有深红也有浅色,是真正逐位置的判别式行为。
相关工作与本文的定位
论文的相关工作部分写得相当扎实,值得完整梳理一遍,因为它把 Engram 放在了四条文脉的交点上。
N-gram 建模与嵌入缩放。这条线从 Shannon(1948)的框架出发,历经 Kneser-Ney、Katz 平滑等经典方法;神经化之后有了 Bengio 等人(2003)的神经概率语言模型,以及 FastText(Bojanowski 等人 2017)保留的查表效率。近期这条线以「嵌入缩放」的形式复兴:Per-Layer Embeddings、STEM、L3、DeepEmbed 通过巨型表扩充容量;更相关的一支把组合式 N-gram 结构直接嵌入表示空间——N-Grammer、SuperBPE、SCONE、OverEncoding、Byte Latent Transformer。
论文在这里划了两条清晰的分界线:
- 建模与评测协议上:前作常把 N-gram embedding 当外部增强,没有在严格公平的协议下验证效率。SCONE 面向推理且依赖引入额外训练 FLOPs 的辅助模块;OverEncoding 即使在非等参数设置下也无法在稀疏 MoE 主干上产生有意义的提升。Engram 把条件记忆当作一等建模原语,在严格等参数、等 FLOPs 下对比。
- 系统视角上:现有方法把嵌入严格放在输入层(第 0 层),这天然使访存与计算串行化。Engram 主动把记忆注入更深的层以实现通信-计算重叠,并利用 N-gram 的 Zipf 分布榨取硬件内存层次的价值。
高基数类别嵌入。这是一个来自推荐系统的平行问题:模型要为成百上千个类别特征学习嵌入,词表可能有百万到十亿量级。这条线上有大量与 Engram 相通的技术:多哈希与组合表示、频率感知的哈希与碰撞管理、频率或重要性自适应的容量分配、基于量化/张量分解/共享内存布局的结构化压缩。论文承认与这条线共享「在高度偏斜的访问分布下表示超大离散键空间」的挑战,区别在于 Engram 的键是从有序文本 N-gram 构造的,且检索结果是通过上下文感知门控注入中间层的。
有意思的是,Engram 的双约束(素数模 × 多头)正是推荐系统多哈希文献的标准配方——论文把这一成熟工程实践搬到了语言模型上。
MoE。从 Shazeer 等人(2017)提出,经 GShard、BASE、Switch Transformer、GLaM 走向超线性参数扩展;DeepSeekMoE 通过细粒度专家切分与共享专家隔离大幅提升效率,DeepSeek-V3 与 Kimi-k2 把总参数推到数百 B 量级。对于这条线,本站已经有 DeepSeekMoE 完全拆解 系统拆过,这里只强调一点:Engram 是在 MoE 已经做到极致之后,指出还有另一条正交的轴。
记忆网络。分参数化与非参数化两支。参数化记忆(PKM、PEER、Selfmem、Memory+、UltraMem)把大规模稀疏键值存储直接集成进模型层,显著增加容量且几乎不影响 FLOPs;非参数化记忆(REALM、RETRO、CoG、PlugLM)把知识存储与模型处理解耦,把外部记忆当作可编辑、可扩展的键值存储。
注意这里的一个微妙区别:PKM/PEER 这类参数化记忆在形态上与 Engram 最接近(都是模型内部的稀疏大表),但它们通常用可学习的键(key)做寻址——而 Engram 用的是确定性的哈希键。这个差别直接决定了系统可实现性:可学习键必须先在设备上算出相似度才能确定地址,而哈希键在 CPU 上就能算出来,从而支持预取。
知识存储机理。Geva 等人(2021)提出 FFN 可以被理解为键值记忆——第一层作为模式检测器(键),第二层把具体信息投影进残差流(值);Dai 等人(2022)找到了存储特定事实的「知识神经元」;Meng 等人(2022, 2023)用因果追踪把事实回忆的信息流映射到具体 FFN 层,并据此开发了 ROME、MEMIT 等模型编辑算法。论文把 Engram 与这条线的关系处理得很巧妙:它没有否定「FFN 是记忆」的结论,而是提供了一个更专门、更高效、更容易编辑的替代位置。
后续工作与社区复现
论文发表后,这条路线有了真实的后续进展,也出现了一些值得记录的坑。
tokenizer-agnostic Engram
Engram 有一个明显的耦合问题:哈希建立在 token 级的 N-gram 上,所以换一个 tokenizer 就等于换了一套键空间——模型必须从头训练自己的 Engram 嵌入。这对「Engram 权重作为可复用资产」是致命的。
2026 年 7 月 31 日提交的 Tokenizer-Agnostic Engram Module(arXiv:2607.29065)直接针对这一点:它把 token 级的 XOR 哈希换成字节级的多项式哈希,并在所有 N-gram 阶数间共享一个联合嵌入空间。论文的主张是,这样处理后不同 tokenizer 的 Engram 模型之间可以做到哈希等价(对字节等价的 token 序列),从而复用 Engram 嵌入。摘要称这种替换「产生了可比的性能并实现了 tokenizer 无关性」。
这个工作的意义在于:如果 Engram 表真的成为一种可移植的知识资产,那它的经济学就完全变了——你可以训练一次记忆、在多个模型上复用。
官方仓库与社区实现
deepseek-ai/Engram 官方仓库提供了论文、架构图,以及一个单文件 demo(engram_demo_v1.py)。要注意官方自己的免责声明:
提供的是演示版本,用于说明数据流。标准组件(Attention/MoE/mHC)被 mock 掉以聚焦 Engram 模块本身;生产使用还需要进一步优化(自定义 CUDA kernel、分布式训练支持)。
也就是说,官方给的是「逻辑参考」,不是「可训练实现」。这直接催生了社区实现:
- QingGo/engram-peft:一个非官方实现,把它包装成 PEFT 风格的接口,可以往任意 HuggingFace Transformer 里注入 Engram 层,支持
engram_only、stacked-adapter 与全量微调等训练模式,并可选叠加 LoRA。作者在知乎上说明动机:官方只发布了简单 demo,没有便于快速集成的库,也没有开源训练代码,从论文重新实现容易出错或有遗漏。README 称其与论文对齐,并支持 Ascend NPU 后端。 - softwarewrighter/engram-poc 及其配套的博客系列:在 SmolLM-135M 上做了两阶段复现(先用 LoRA 做行为模拟,再接入真实的哈希记忆模块)。他们验证了查找时间近似常数(64 token 时 0.15 ms,2048 token 时 2.77 ms,而按线性外推应约 4.8 ms),同时报告了一个重要的负面结果——Engram 在可枚举的结构化查找任务上收益显著(缩写展开、元素符号),但在世界首都、模式补全这类任务上反而变差,结论是「Engram 是专用工具,而非通用增强」。
- 还有一个值得记录的实现陷阱:HuggingFace 上
Quazim0t0/Escarda-86M-Base的一条 engram repair 记录指出,原实现存在退化问题——冻结的 LSH 压缩器把所有 token 都哈希到 bucket 0,导致只有一行嵌入收到梯度。修复后输出保持 bit-identical,但哈希变得分散到全表,每个 bucket 才可独立训练。
把这些放在一起看,社区复现给出的共识是:可以跑通,收益高度任务相关,门控与防碰撞是成败关键。这与论文在 27B 规模上的结论方向一致,但社区在小模型上看到的负面案例(世界首都 −19%)也提醒我们:论文报告的是在严格等参数等算力的、经过充分调参的配方下的净收益,把这个模块随手插进一个小模型并不保证有效。
局限与未解决的问题
论文没有专门的 Limitations 一节,但从正文和实验设计里可以读出几条明确的边界:
规模上限。全部结论建立在 27B / 40B 参数、262B 训练 token 的规模上。Engram 是否在前沿规模(数百 B 到 T 级)仍然保持同样的收益和同样的最优 ,论文没有回答。论文自己声明最优比例「在受检的规模范围内稳定」,措辞谨慎地限定了范围——–80% 是否是一个普适常数,需要更大规模的验证。
Engram-40B 尚未饱和。论文承认 40B 变体在部分任务上未严格优于 27B,并归因于训练不足。这意味着 Table 1 中 40B 那一列是下限而非收敛值,也意味着「记忆越多越好」这个幂律在更大规模上的斜率还是未知数。
超参数与配方的敏感性。分配律是在固定稀疏比()下得到的。改变稀疏比、改变主干架构(比如换成非多分支的骨架)、改变数据配比,最优点是否移动,论文没有系统扫描。第 6.2 节的消融也全部在 12 层 3B 这一档完成,与 30 层 27B 的实际配置存在规模断层。
哈希碰撞的量化分析缺失。论文给出多头哈希作为缓解手段,也给出了表大小的选取方式(素数、demo 里每头约 5 倍词表大小),但没有报告实测的碰撞率,也没有做「头数 扫多少」的消融。从工程角度, 是要和访存开销一起折中的——多一个头就多一次 gather,而 gather 是访存受限操作,在长上下文、大 batch 的推理场景里未必免费。
门控的可解释性只是定性。Figure 7 的案例研究很有说服力,但它只展示了「门控在固定搭配上打开」这一类行为。论文也承认并非所有分支都学到可解释的模式(、两层共 8 个门控标量,只挑了最相关的展示)。门控在训练中是否会出现坍塌(退化成常数)、在分布外输入上是否依然可靠,都没有回答。
训练-推理一致性。第 6.3 节的敏感性实验通过在推理时抑制 Engram 输出来测量其贡献,但这个操作会造成训练-推理不一致,论文明确承认这会引入噪声,因此只分析了两个极端类别的任务。更一般的任务上 Engram 的贡献有多大,无法从这组数字推断。
与真正的「知识编辑」能力的关系未验证。虽然论文在相关工作中讨论了 ROME/MEMIT 这条线,也暗示 Engram 表是「更容易编辑的存储位置」,但全文没有做任何知识编辑实验——比如直接改写某个嵌入槽位来更新一条事实。如果 Engram 真能做到这一点,那将是一个非常有价值的下游能力;论文没有提供证据。
小结
把这篇论文的贡献按重要性排序:
第一,概念上,它补上了稀疏性的第二条轴。 MoE 之后,稀疏化的讨论几乎全部围绕「条件计算」展开。Engram 指出语言信号本身是不均匀的——一部分需要动态计算,一部分只是静态模式——因此架构上应该有两套互补的稀疏机制,分别服务这两类信号。这个框架的价值不依赖于 Engram 的具体实现是否最优。
第二,定量上,它给出了一个可操作的分配律。 在固定参数与算力下,把约 20%–25% 的稀疏容量分给记忆、75%–80% 留给计算是接近最优的;而且这个最优点在不同算力规模下稳定,纯 MoE()严格次优。即使用极简的哈希查表来实现记忆,这个规律依然成立——这才是论文标题里「a new axis of sparsity」的实证依据。
第三,机理上,它解释了收益从哪来。 LogitLens 的 KL 散度与 CKA 的对齐分析共同指向一个结论:Engram 让浅层从静态重建中解放,等效于增加有效深度(第 5 层表征对齐到 MoE 第 12 层)。由此推出的两个推论——「推理与代码的收益大于知识类收益」(BBH +5.0、HumanEval +3.0 对 MMLU +3.0)以及「长上下文检索大幅改善」(MQ NIAH 84.2 → 97.0、VT 77.0 → 89.0)——都在数据上成立。记忆不是冗余的存储,它把注意力容量和序列深度这两样稀缺资源让给了推理。
第四,系统上,它证明了确定性的价值。 因为寻址只依赖输入 token ID,索引可以在前向传播前算出,于是 1000 亿参数的嵌入表可以整体放在主机内存,通过 PCIe 异步预取而只损失 2.8% 吞吐(8B 主干实测)。这打破了一个长期假设:大参数必须住在 HBM 里。
当然,边界也很清楚:所有结论都在 27B–40B 规模验证,分配律的最优比例能否外推到前沿规模仍是开放问题;门控与哈希碰撞的理论刻画还很粗;知识编辑这类下游能力还没有被验证。但作为「第二条稀疏轴」的开篇工作,它给出的框架与数据已经足够扎实。
对做推理系统的人来说,最值得带走的一条可能是这个:当参数可以按确定性规则寻址时,存储与计算就解耦了。MoE 的路由必须依赖运行时隐状态,所以它注定要被通信绑住;而哈希查表只需要 token ID,这个信息在请求进入系统的第一毫秒就已知。同样的推理逻辑,在这篇论文里被用来做预取,但它的适用范围可能远不止于此。
参考资料
- Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models(arXiv:2601.07372 摘要页)
- 同论文 HTML 全文版(含全部图表与附录)
- DeepSeek 官方代码仓库 deepseek-ai/Engram
- 官方单文件演示实现 engram_demo_v1.py
- Engram-PEFT:DeepSeek Engram 的非官方 PEFT 实现
- Tokenizer-Agnostic Engram Module(arXiv:2607.29065)
- Deepseek Papers (3/3): Engram Revisited - From Emulation to Implementation
- mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880)
- nano-vLLM:论文推理实验台所用的 vLLM 精简原型
- deepseek-news-research 的 Engram 笔记
- The Pile: An 800GB Dataset of Diverse Text for Language Modeling(arXiv:2101.00027)
- RULER: What’s the Real Context Size of Your Long-Context Language Models?(arXiv:2404.06654)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


