


Muon 优化器完全拆解:矩阵级正交化更新如何撑起万亿 MoE 训练
2026 年 4 月 26 日,DeepSeek 在 arXiv 上放出了 DeepSeek-V4 技术报告,同时开源了 DeepSeek-V4-Pro(1.6T 总参数 / 49B 激活)与 DeepSeek-V4-Flash(284B 总参数 / 13B 激活)两个 MoE 模型的权重。报告列出的三项架构级升级里,前两项——混合注意力 CSA/HCA 与流形约束超连接 mHC——都是网络结构上的改动,第三项则完全不同:把优化器从 AdamW 换成了 Muon。
这一项改动看似只是”换了个更新公式”,实际难度却在于它把一个元素级的、可以任意切分到几千张卡上的优化器,换成了一个以整个矩阵为最小更新单位的优化器。在 1.6T 参数、33T token 的训练规模上,这意味着分布式训练框架要在 ZeRO 分片、通信量、数值精度、梯度重计算这几个环节上全部重做一遍。
本文是 DeepSeek 技术全景 这条时间线上的最新一环。V4 的注意力侧改动可以看 DeepSeek-V4 混合注意力拆解,长上下文 KV Cache 的进一步压缩看 V4.1-Flash 的 KV Cache 拆解,MoE 架构本身看 DeepSeekMoE 拆解。本文只聚焦一件事:Muon 到底在算什么、为什么这么算、以及万亿参数下怎么把它跑起来。
时间线与谱系:Muon 不是 DeepSeek 发明的
先把来龙去脉说清楚,因为 Muon 是过去两年优化器领域最典型的一次”社区先行、大厂验证”。
2024 年 12 月 8 日,Keller Jordan 在自己的博客上发布了 Muon: An optimizer for hidden layers in neural networks。它当时最出名的身份是 NanoGPT 和 CIFAR-10 两个 speedrun 竞赛的刷榜工具:把 CIFAR-10 训练到 94% 准确率的速度纪录从 3.3 A100-秒压到 2.6 A100-秒,把 FineWeb 上 NanoGPT 跑到 3.28 验证损失的墙钟时间缩短 1.35 倍,还把 1.5B 参数 Transformer 训到 GPT-2 XL 在 HellaSwag 上的水平只花了 10 个 8×H100-小时(用 AdamW 需要 13.3 小时)。
但 speedrun 是小规模游戏,工业界真正开始认真对待 Muon,是 2025 年 2 月 24 日 Moonshot AI 的 Muon is Scalable for LLM Training(arXiv:2502.16982)。这篇报告做了两件关键的事:一是补上了 Muon 缺失的权重衰减与更新尺度控制,让它能以 3B/16B 的 MoE 架构、5.7T token 训出 Moonlight 模型;二是给出了 Distributed Muon 的完整实现,解决了 Muon 与 ZeRO 分片的冲突。缩放律实验显示,在算力最优训练下 Muon 只需要约 52% 的训练 FLOPs 就能达到 AdamW 的同等性能,也就是常说的”约 2 倍计算效率”。
再往后是 2025 年 7 月 28 日的 Kimi K2 技术报告(arXiv:2507.20534)。Kimi K2 是一个 1T 总参数 / 32B 激活的 MoE 模型,用的是 Muon 的改良版 MuonClip:在 Muon 之外加了 QK-Clip 来抑制注意力 logit 爆炸。报告称 K2 在 15.5T token 的预训练中零 loss spike,这是 Muon 系优化器第一次在万亿参数级公开宣称全程无损失尖峰。
最后是 DeepSeek-V4。它把 Muon 用在了 1.6T 参数的 MoE 上,并且是第一次公开把 Muon 的分布式实现细节完整写进技术报告——这正是本文的重点之一。有意思的是,V4 并没有照抄 Kimi 的 QK-Clip:报告明确写道,V4 的注意力结构允许直接对 query 和 KV entry 做 RMSNorm,本身就能防住 logit 爆炸,所以不需要 QK-Clip。同一个稳定性问题,两条技术路线给出了不同答案。
AdamW 到底哪里”不协调”
要理解 Muon 为什么值得换,得先看清 AdamW 在矩阵上的行为。
AdamW 的更新是逐元素的。对权重矩阵 的第 行第 列元素:
其中 是一阶梯度的偏差修正指数滑动平均, 是二阶梯度的偏差修正滑动平均, 是防止除零的小常数。这个公式的精妙之处在于每个元素都有自己的自适应学习率:梯度一直很大的元素被 除下去,梯度一直很小的元素被抬上来。它把优化问题拆成了几千万个独立的一维问题。
问题恰恰出在这个”独立”上。
权重矩阵不是一个装着独立数字的容器,它是一个线性算子:它把输入空间(隐状态空间)里的向量映射到输出空间。衡量一个算子”改变了多少”的自然度量是它的奇异值谱,不是它每个元素的绝对值。而 AdamW 对矩阵的每个元素单独归一化,等于在说”每个元素同等重要”,这会导出一个被很多方向共享的更新。
Keller Jordan 在博客里的原话是:SGD-momentum 和 Adam 在 Transformer 的二维参数上产生的更新矩阵,条件数通常都非常高——也就是说这些更新矩阵几乎是低秩的,所有神经元的更新都被少数几个方向支配。他推测,正交化的作用就是把那些”幅度很小但依然重要”的稀有方向放大。
用奇异值分解写出来更清楚。设某一步的更新矩阵 的 SVD 为 ,,。AdamW 会把这样一个谱形几乎原样地传给权重:最大的奇异方向每一步走得很远,最小的奇异方向几乎不动。训练在”有效秩”上被卡住了。
在深度堆叠的网络里这件事还要更糟一层:一个方向上权重的微小偏差会逐层放大。关于深层信号增益与残差连接的关系,V4 的 mHC 做的是结构侧的工作;而在优化器侧,正好对应同样的问题。
Moonlight 报告里有一张非常直接的图可以说明差异:他们统计了训练过程中各类权重矩阵的 SVD 熵,定义为
这个量衡量”谱有多分散”:如果能量全集中在第一个奇异值上,熵接近 0;如果所有奇异值一样大,熵接近 1。在 1.2T token 训练的多个 checkpoint 上,Muon 训练出的权重矩阵 SVD 熵在所有 checkpoint、所有权重分组上都高于 AdamW,其中差距最大的是专家路由(Router)权重。换言之,Muon 让权重矩阵的谱更平、用上了更多的方向,而 MoE 模型从这种”谱多样性”里获益更多。
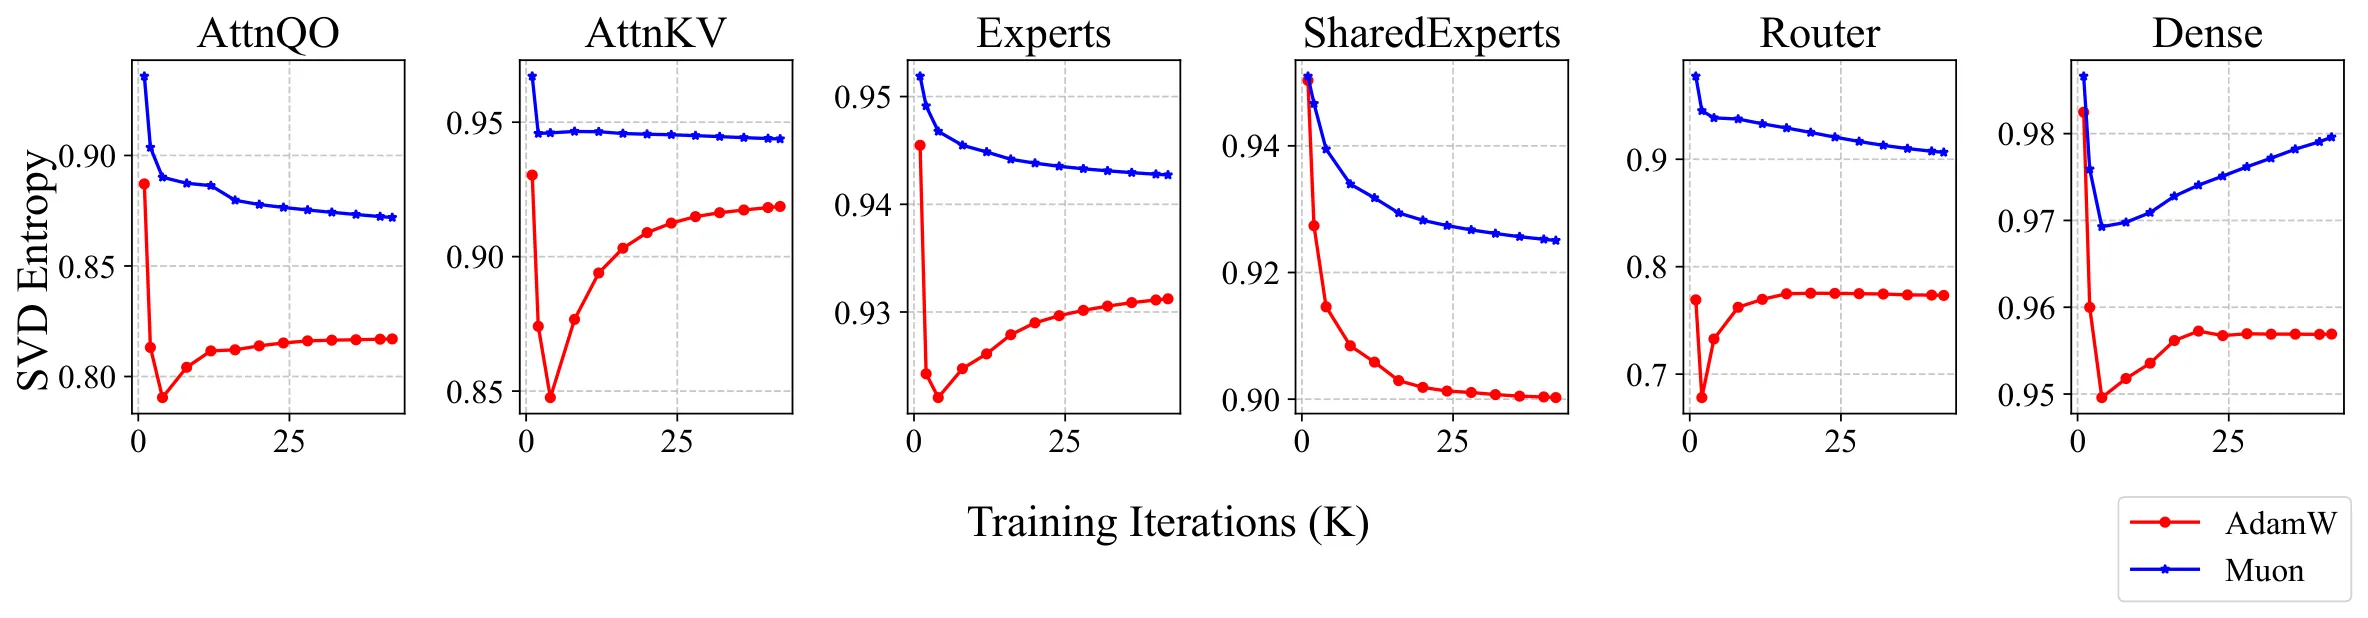
图源:Moonshot AI,Muon is Scalable for LLM Training(arXiv:2502.16982)Figure 4
还有一个更形式化的视角。Bernstein 与 Newhouse 在 2024 年的 Old Optimizer, New Norm: An Anthology(arXiv:2409.20325)里指出,可以把优化器看成”在某个范数约束下的最速下降”。从这个角度看,AdamW 对应的是从一个 Max-of-Max 范数动态调整出来的约束,而 Muon 对应的是 Schatten- 范数( 很大时逼近谱范数)的约束。Moonlight 报告接着说:神经网络权重是作用在(局部)欧氏空间上的算子,所以对权重真正合适的范数是诱导算子范数,也就是矩阵的谱范数。在这个意义上,Muon 提供的约束比 AdamW 更贴合权重矩阵的几何本质。
Muon 的定义:动量 + 正交化
Muon 的全称是 MomentUm Orthogonalized by Newton-Schulz,名字已经把算法写完了:先做 SGD-momentum 得到更新矩阵,再对它做一次 Newton-Schulz 迭代近似正交化,然后才作用到权重上。
Keller Jordan 博客里给出的原始形式非常简洁:
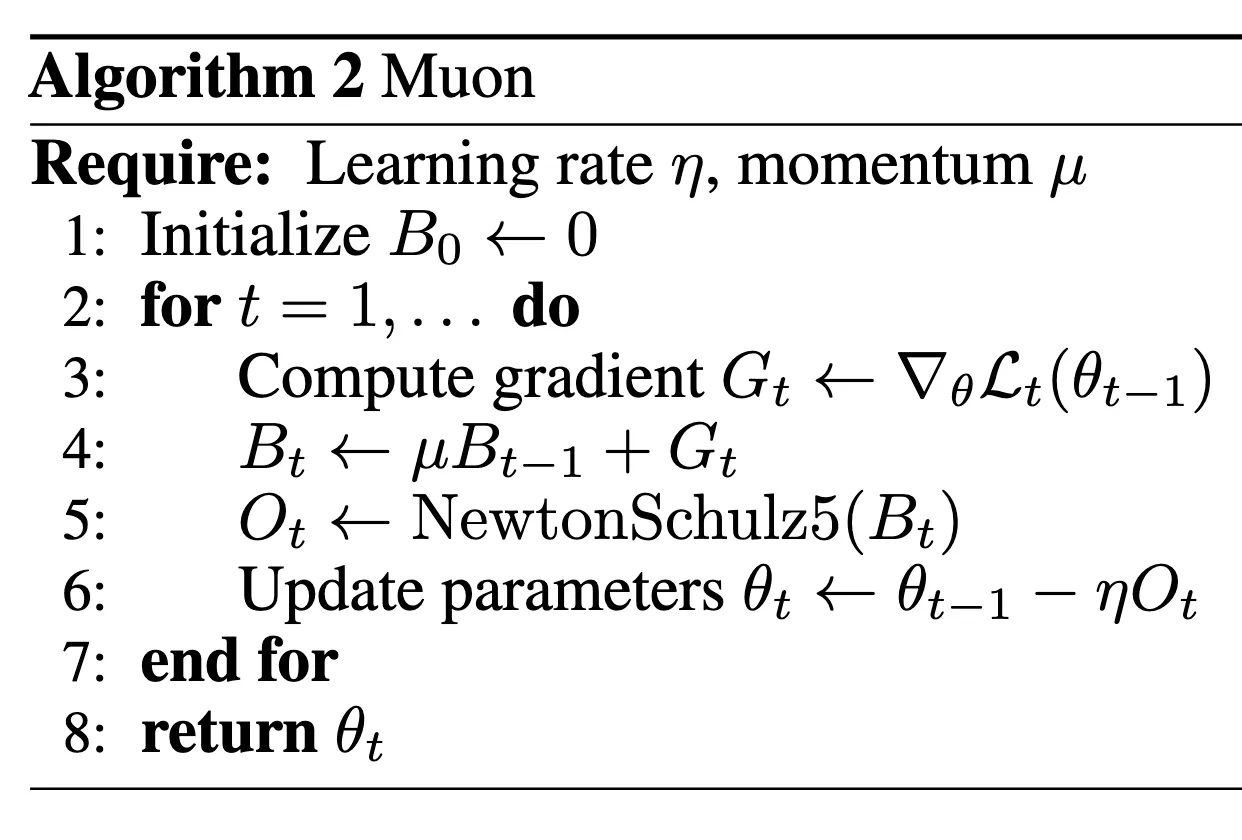
图源:Keller Jordan,Muon: An optimizer for hidden layers in neural networks Algorithm 2
“正交化”在这里有精确定义。记 为待处理矩阵,正交化的目标是求一个离 最近的半正交矩阵:
这个最小化问题有闭式解:若 是它的 SVD,则最优解就是
也就是说,正交化把 SVD 里的奇异值矩阵 整个丢掉,只保留旋转部分。如果 的条件数很高,正交化后 的所有奇异值都变成 1,更新矩阵的谱被”压平”了——这正是上一节说的那个目的。
这里有两个容易混淆的细节值得强调。
第一,动量在正交化之前。Tuddenham 等人 2022 年提出的 Orthogonal-SGDM 是先用 SVD 正交化梯度、再加动量、用动量项作为更新。Muon 把顺序倒过来:先累积动量,再对动量正交化。Keller Jordan 说他们实验发现前者的效果更好。这个顺序差别是有意义的:逐梯度的正交化会把每个 minibatch 的噪声方向也一起”拉平”;而先做动量累积,噪声在 EMA 里被平均掉,正交化作用在更干净的信号上。
第二,Muon 与 Shampoo 的关系。Shampoo 的更新里含 ,把 代进去:
结果就是正交化后的梯度。所以如果把 Shampoo 的预条件子累积去掉、再补上动量,得到的正是 Muon 的更新,只不过 Shampoo 用的是逆四次根的耦合牛顿迭代,墙钟时间和 FLOPs 都更高。Muon 因此可以被理解为一种”瞬时的、不做累积的 Shampoo”。
V4 的完整更新公式,逐行拆解
DeepSeek-V4 报告里的 Algorithm 1 把 Muon 的更新写成了五步。这部分值得逐行拆开看,因为 V4 和原始 Muon 的差异全在这里。
Algorithm 1 Muon Optimizer for DeepSeek-V4输入:学习率 eta,动量 mu,权重衰减 lambda,更新缩放因子 gammafor 每个训练步 t: for 每个逻辑独立的权重 W ∈ R^{n×m}: G_t = ∇_W L_t(W_{t-1}) # 计算梯度 M_t = mu * M_{t-1} + G_t # 累积动量缓冲 O'_t = HybridNewtonSchulz(mu * M_t + G_t) # Nesterov 技巧 + 混合 Newton-Schulz O_t = O'_t * sqrt(max(n, m)) * gamma # 缩放更新 RMS W_t = W_{t-1} * (1 - eta*lambda) - eta * O_t # 权重衰减 + 更新第一步:动量累积。 。这里的 不是常见优化器里的”速度”变量,而是梯度的指数滑动平均(EMA)。V4 与 Moonlight 都把 设为 0.95。
第二步:Nesterov 技巧。 正交化的输入不是 ,而是 。把它展开:
这正是经典 Nesterov 动量的”前瞻”形式。标准 Nesterov 写法是先算 ,再用 作为更新方向,展开同样得到 。两者形式完全一致,所以 Moonshot 与 DeepSeek 都直接用 这一个缓冲区实现了 Nesterov,不需要额外存一份变量——省下一半的优化器状态显存。这个细节在万亿参数下不是小事:优化器状态是每参数一份,能省就省。
第三步:混合 Newton-Schulz 正交化。 ,得到近似 的矩阵。这是本文的核心,下一节展开。
第四步:更新尺度缩放。 。这一步是为了让 Muon 的更新幅度和 AdamW 可比,从而直接复用为 AdamW 调好的学习率和权重衰减。详细推导见后面”更新尺度”一节。V4 取 。
第五步:解耦权重衰减 + 更新。 。把权重衰减写成乘 的形式而不是减 ,是 AdamW 引入的”解耦权重衰减”做法——它让衰减项不受自适应学习率的影响。V4 里 Muon 的 也设为 0.1,和 AdamW 组一致。
这里要补一段历史:原始 Muon 是没有权重衰减的,这也正是它在小规模上表现惊艳、放大后收益却缩水的原因。Moonlight 报告记录了他们的排查过程:直接放大 Muon 训练时,权重和层输出的 RMS 会持续增长到很大,超出 bf16 的高精度表示范围,损害模型长期表现。他们用 800M 参数模型、100B token(约 5 倍算力最优)做了对照实验,比较 AdamW、无权重衰减的原始 Muon、带权重衰减的 Muon 三条验证损失曲线:原始 Muon 前期收敛更快,但长期会掉队;加上权重衰减后,Muon 同时胜过原始 Muon 和 AdamW。这条结论对今天的工程实践依然有直接参考价值。
Newton-Schulz 迭代:为什么不用 SVD
正交化最直接的做法就是算 SVD,然后丢掉 。但 Keller Jordan 说得很直白:SVD 太慢了,不能用。
除了 SVD,还有两条件路:一是耦合牛顿迭代(Coupled Newton iteration),Shampoo 系列实现里用它做逆四次根,稍作改造就能做正交化;二是 Newton-Schulz 迭代。前者被否掉的原因是必须跑在 float32 精度才能避免数值不稳定,在现代 GPU 上太慢。而 Newton-Schulz 迭代的优势恰恰在于:它可以在 bfloat16 下稳定运行。
把这三条路放在一起对比,Newton-Schulz 胜出的理由可以总结成四条:
- 纯矩阵乘法。迭代体里只有 和矩阵乘法,没有任何分解、求逆或特征值计算,能直接打到 Tensor Core 上;
- 可并行、可批量。不同权重矩阵之间彼此独立,同一形状的矩阵还能拼成一个 batch 一起算(V4 报告里明确提到这点,见后文分布式工程部分);
- 可低精度。bf16 下依然稳定,这直接决定了通信量和显存;
- 可截断。迭代次数是可调的旋钮,精度和时间的权衡完全由使用者掌握。
迭代式与收敛原理
Newton-Schulz 迭代的形式是:
由待正交化矩阵 归一化得到。为了看清它在做什么,把 的 SVD 代进单步迭代:
注意 ,于是 。代回去:
关键结论:迭代不改变左右奇异向量 和 ,只逐元素地作用在每个奇异值上。定义一个五次多项式
那么跑 步迭代的结果就是 ,其中 表示把 作用 次。要让它收敛到 (也就是所有奇异值都变成 1),只需要两个条件:
- 初始奇异值都落在 区间内。做法是把 除以它的 Frobenius 范数:。这一步之所以成立,是因为矩阵的谱范数(最大奇异值)永远不超过 Frobenius 范数,所以 。而且这个缩放是无害的:,正交化对全局缩放不变。
- 系数 要使得 对区间内所有 都成立。
先看最简单的基线系数 ,即 。它的不动点满足 ,解得 或 ,即 或 ,所以正的不动点是 和 。在 上 ,在 上 ,所以 是稳定不动点, 内的初值都会被拉向 1。基线系数是”能工作”的。
但它有个明显的毛病:。当奇异值非常小的时候,迭代近似退化成 ,每步只把幅度翻一倍。要把 量级的奇异值抬到 1 附近,需要大约 步。
系数怎么调出来的
Keller Jordan 的调参逻辑值得原样复述,因为它解释了为什么最终的系数看起来”不太讲道理”。他的三条考虑是:
- 要尽可能大,因为 控制了小奇异值的收敛速度;
- 对每个 ,希望 收敛到 区间内;
- 实验上, 大到 0.3 左右都不会损害 Muon 的损失曲线。
第三条是整件事的关键。也就是说,正交化不需要做得精确——奇异值只要落在 1 附近的一个带内就行。有了这个宽松条件,就能把优化目标写成”在 的约束下最大化 “,用梯度方法解出
从 2 提到 3.4445,小奇异值的爬升速度提升了近一倍。Keller Jordan 用这套系数跑 Transformer 语言模型和小型卷积网络,5 步迭代就够了。他还试过三阶(cubic)和七阶多项式,发现都无法进一步降低墙钟开销。
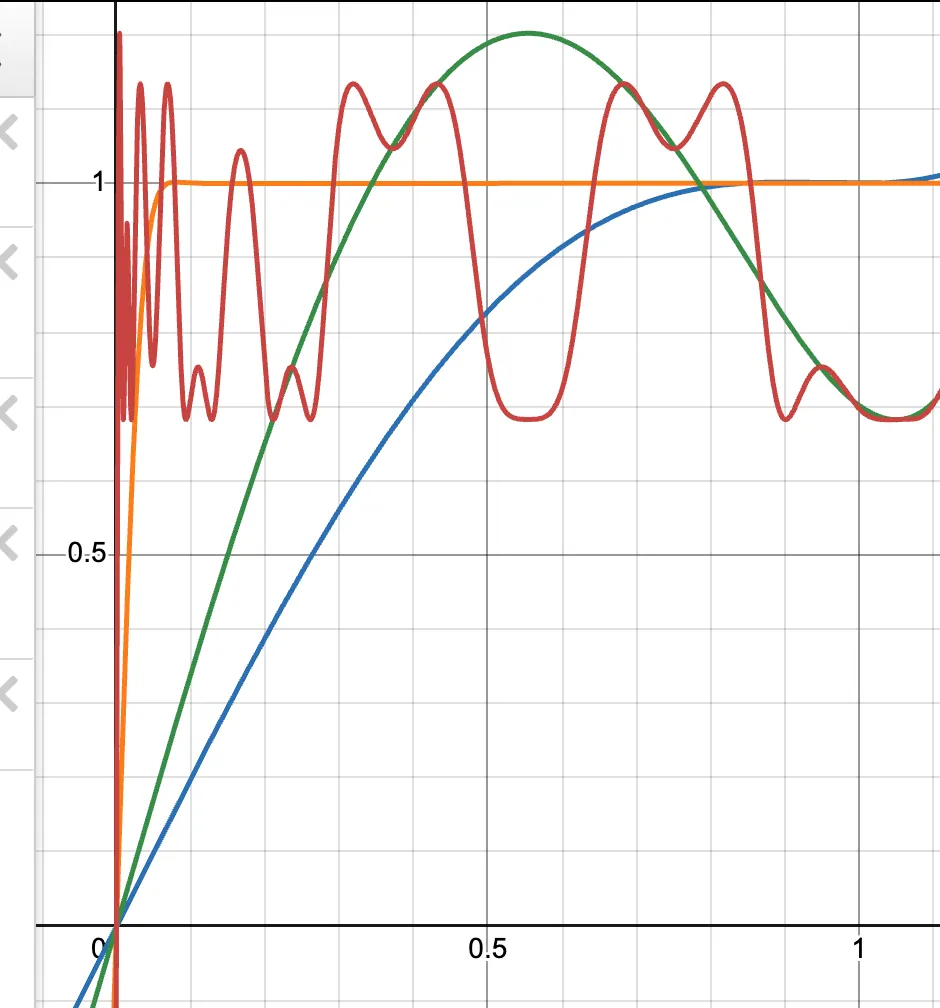
图源:Keller Jordan,Muon: An optimizer for hidden layers in neural networks Figure 3 / Figure 4
为什么 V4 用 10 步,还分成两段
这是 V4 相对 Muon 原始实现最实质的改动:报告称其为 Hybrid Newton-Schulz(混合 Newton-Schulz)。
- 前 8 步:用系数 ,目的是”驱动快速收敛,把奇异值带到 1 附近”;
- 后 2 步:换成系数 ,目的是”把奇异值精确稳定在 1”。
需要注意的是,Moonshot 在 Moonlight 报告里的结论是相反的:他们观察到 时正交化结果比 更精确,但并没有带来更好的性能,因此出于效率考虑选了 。V4 却选了 10 步两段式。这两份报告之间的差异是公开资料里的一个真实分歧,V4 报告没有给出定量的对比实验,所以这里只能说明事实、不能替它下结论。
不过把这个两段式迭代的动力学算一遍,就能看出它想解决什么。下面这张表是本文用 Python 直接复现的标量迭代表( 逐元素作用于奇异值,与矩阵情形等价),列出几步之后每个初始奇异值落在哪:
| 初始奇异值 | 5 步激进系数 | 8 步激进系数 | 8 步激进 + 2 步温和 (V4) | 5 步温和系数 (基线) |
|---|---|---|---|---|
| 0.0485 | 1.2023 | 1.0020 | 0.0032 | |
| 0.4705 | 0.9179 | 1.0000 | 0.0320 | |
| 0.6989 | 1.0860 | 1.0000 | 0.3120 | |
| 0.7581 | 1.1334 | 1.0002 | 0.9647 | |
| 0.7121 | 1.1082 | 1.0001 | 1.0005 | |
| 1.0796 | 0.7390 | 1.0001 | 1.0000 | |
| 0.7654 | 1.1306 | 1.0002 | 1.0000 | |
| 0.6820 | 1.0471 | 1.0000 | 1.0000 | |
| 0.6964 | 1.0810 | 1.0000 | 1.0000 |
这张表说明了两件事。
第一,激进系数确实有代价。5 步激进系数跑完,奇异值散落在 之间(对应 Keller Jordan 说的 容忍带);加到 8 步,散落范围反而更宽,到 ——因为这个多项式的迭代在这里不是单调收敛的,而是在 1 附近振荡。V4 报告用词是”stabilize the singular values precisely at 1”,落到数值上就是从”噪声带”变成 1.0000。
第二,温和系数单独用是灾难。基线系数 在 时 5 步内都能收敛,但 时 5 步后只有 0.032, 时只有 0.0032——小奇异值几乎没被抬起来。这就是 带来的爬升瓶颈。反过来,激进系数把 在 8 步内抬到 1.2,正是它 的功劳。
两段式合起来就同时拿到了两边的优点:前 8 步用大 把小奇异值快速拽进 1 附近,后 2 步用稳定不动点在 1 的温和多项式把振荡抹平。表里最后一列”8 步激进 + 2 步温和”从 到 五个数量级的初值全部落在 ,比任何单组系数的任何步数都干净。
代价是什么?V4 从 5 步提到 10 步,Newton-Schulz 的 FLOPs 翻倍。后面会算这笔账:即便翻倍,相对整步训练的 FLOPs 占比依然在 1% 量级,用这么小的代价换来一个几乎精确的正交化和更可控的奇异值谱,在万亿参数规模上是很划算的交易。
低精度下的稳定性从哪来
Newton-Schulz 能在 bf16 下跑,是它能进生产环境的前提。V4 报告明确写道:他们观察到 Muon 里的 Newton-Schulz 迭代在用 BF16 矩阵乘法计算时依然保持稳定,并且基于这个观察,进一步把跨数据并行 rank 同步的 MoE 梯度用随机舍入量化到 BF16,把通信量砍了一半。
为什么它经得起低精度?可以从迭代结构上看:每一步 都是”旧值 + 修正量”的形式,多项式映射在 1 附近是收缩的,单步的舍入误差不会被放大,而是在后续迭代里被重新拉回不动点附近。加上 Tensor Core 的矩阵乘法本身以 FP32 累加,主要的精度损失只发生在把中间结果写回 bf16 的那一次舍入上。这也是为什么耦合牛顿迭代做不到——那里面含求逆相关运算,对条件数敏感得多。
顺带一提,低精度正交化在社区里还在快速演进。NVIDIA NeMo 的 emerging-optimizers 库里,Newton-Schulz 的系数集已经攒了一整排:除了 DeepSeek-V4 的混合集,还有 Polar Express(arXiv:2505.16932)、CANS(arXiv:2506.10935)、AOL,以及 2026 年 5 月专门针对低精度奇异值带宽推导的 relaxed cubic 调度(arXiv:2606.00371)——后者干脆把 设成 0 变成三次迭代,省掉一次 Gram 矩阵平方乘法。这条支线说明:Newton-Schulz 的迭代次数和系数调度,已经成了低精度训练时代一个独立的研究方向。
更新尺度:让 Muon 借用 AdamW 的超参
Muon 的更新是近正交矩阵,AdamW 的更新是逐元素归一化的向量,两者量级差得很远。如果不做处理,换优化器就得重新扫一遍学习率——而这恰恰是工业界最不愿意付的成本。
Moonlight 报告用一个引理把这件事变得干净。对于形状为 的满秩矩阵参数:
(一般形式是 , 为秩;满秩时 , 给出 。)推导思路很直接:正交矩阵 的每一列范数为 1, 的每一行范数为 1,交叉相乘后矩阵的 Frobenius 范数平方为 ,除以元素总数 再开方就得到上式。
这个引理说明 Muon 的更新 RMS 是依赖于矩阵形状的。形状越”扁长”,更新就越小。Moonlight 报告列出了两个后果:
- 当 很大时(比如稠密 MLP 矩阵),更新太小,限制了模型的表示能力;
- 当 很小时(比如把 GQA 或 MLA 的每个 KV head 当成独立参数),更新太大,会引起训练不稳定。
(MLA 的低秩压缩结构可以看 MLA 完全拆解——那里的 KV 压缩矩阵正是”形状极不均衡”的典型。)
所以需要一个形状相关的补偿因子。乘上 就把引理里的形状依赖消掉了,更新 RMS 变成 1。而 AdamW 的更新 RMS 在理论上是 1(因为 的尺度),实测通常在 0.2 到 0.4 之间。Moonlight 因此再乘一个 0.2,把 Muon 的更新 RMS 对齐到 AdamW 的量级上:
这样一来,Muon 可以直接复用为 AdamW 调好的学习率和权重衰减,不需要单独扫参。
DeepSeek-V4 沿用同一套框架,只是把这个系数从 0.2 调成了 0.18。报告的原话是 “rescale the RMS of each update matrix to 0.18 for reutilization of the AdamW learning rate”。这个 0.18 与 Algorithm 1 里 中 的位置完全对应: 的 RMS 约为 ,乘上 后 RMS 变成 1,再乘 即得 0.18。
0.2 到 0.18 是 10% 的差异,看着不起眼,但它意味着 DeepSeek 在自己 33T token 的训练上重新标定了这个系数。V4 报告没有解释这个数字是怎么选的,也没有公开它与 AdamW 更新 RMS 的实测对比曲线,所以这里只能记录事实。
Moonlight 报告还做过一个横向对比,比较三种控制更新 RMS 的方案:直接乘 ( 为隐藏维度)、显式除以更新自身 RMS 归一到 0.2、以及按 缩放学习率。他们用 800M 模型做了 4B token 的训练,专门把 MLP 的矩阵形状从 改成 来放大形状差异,结论是形状相关的缩放方案表现最好。这也解释了为什么 V4 的公式里写的是 而不是一个固定的常数。
为什么嵌入层、输出头、bias、RMSNorm 还在用 AdamW
V4 报告在这一点上两处表述略有差异。第 2.4 节的完整列表是:
对嵌入模块、预测头模块、mHC 模块的静态 bias 与门控因子、以及所有 RMSNorm 模块的权重保留 AdamW 优化器,其余所有模块用 Muon 更新。
第 4.2.2 节训练设置里则简写为”嵌入模块、预测头模块、以及所有 RMSNorm 模块的权重”。以第 2.4 节的完整清单为准。
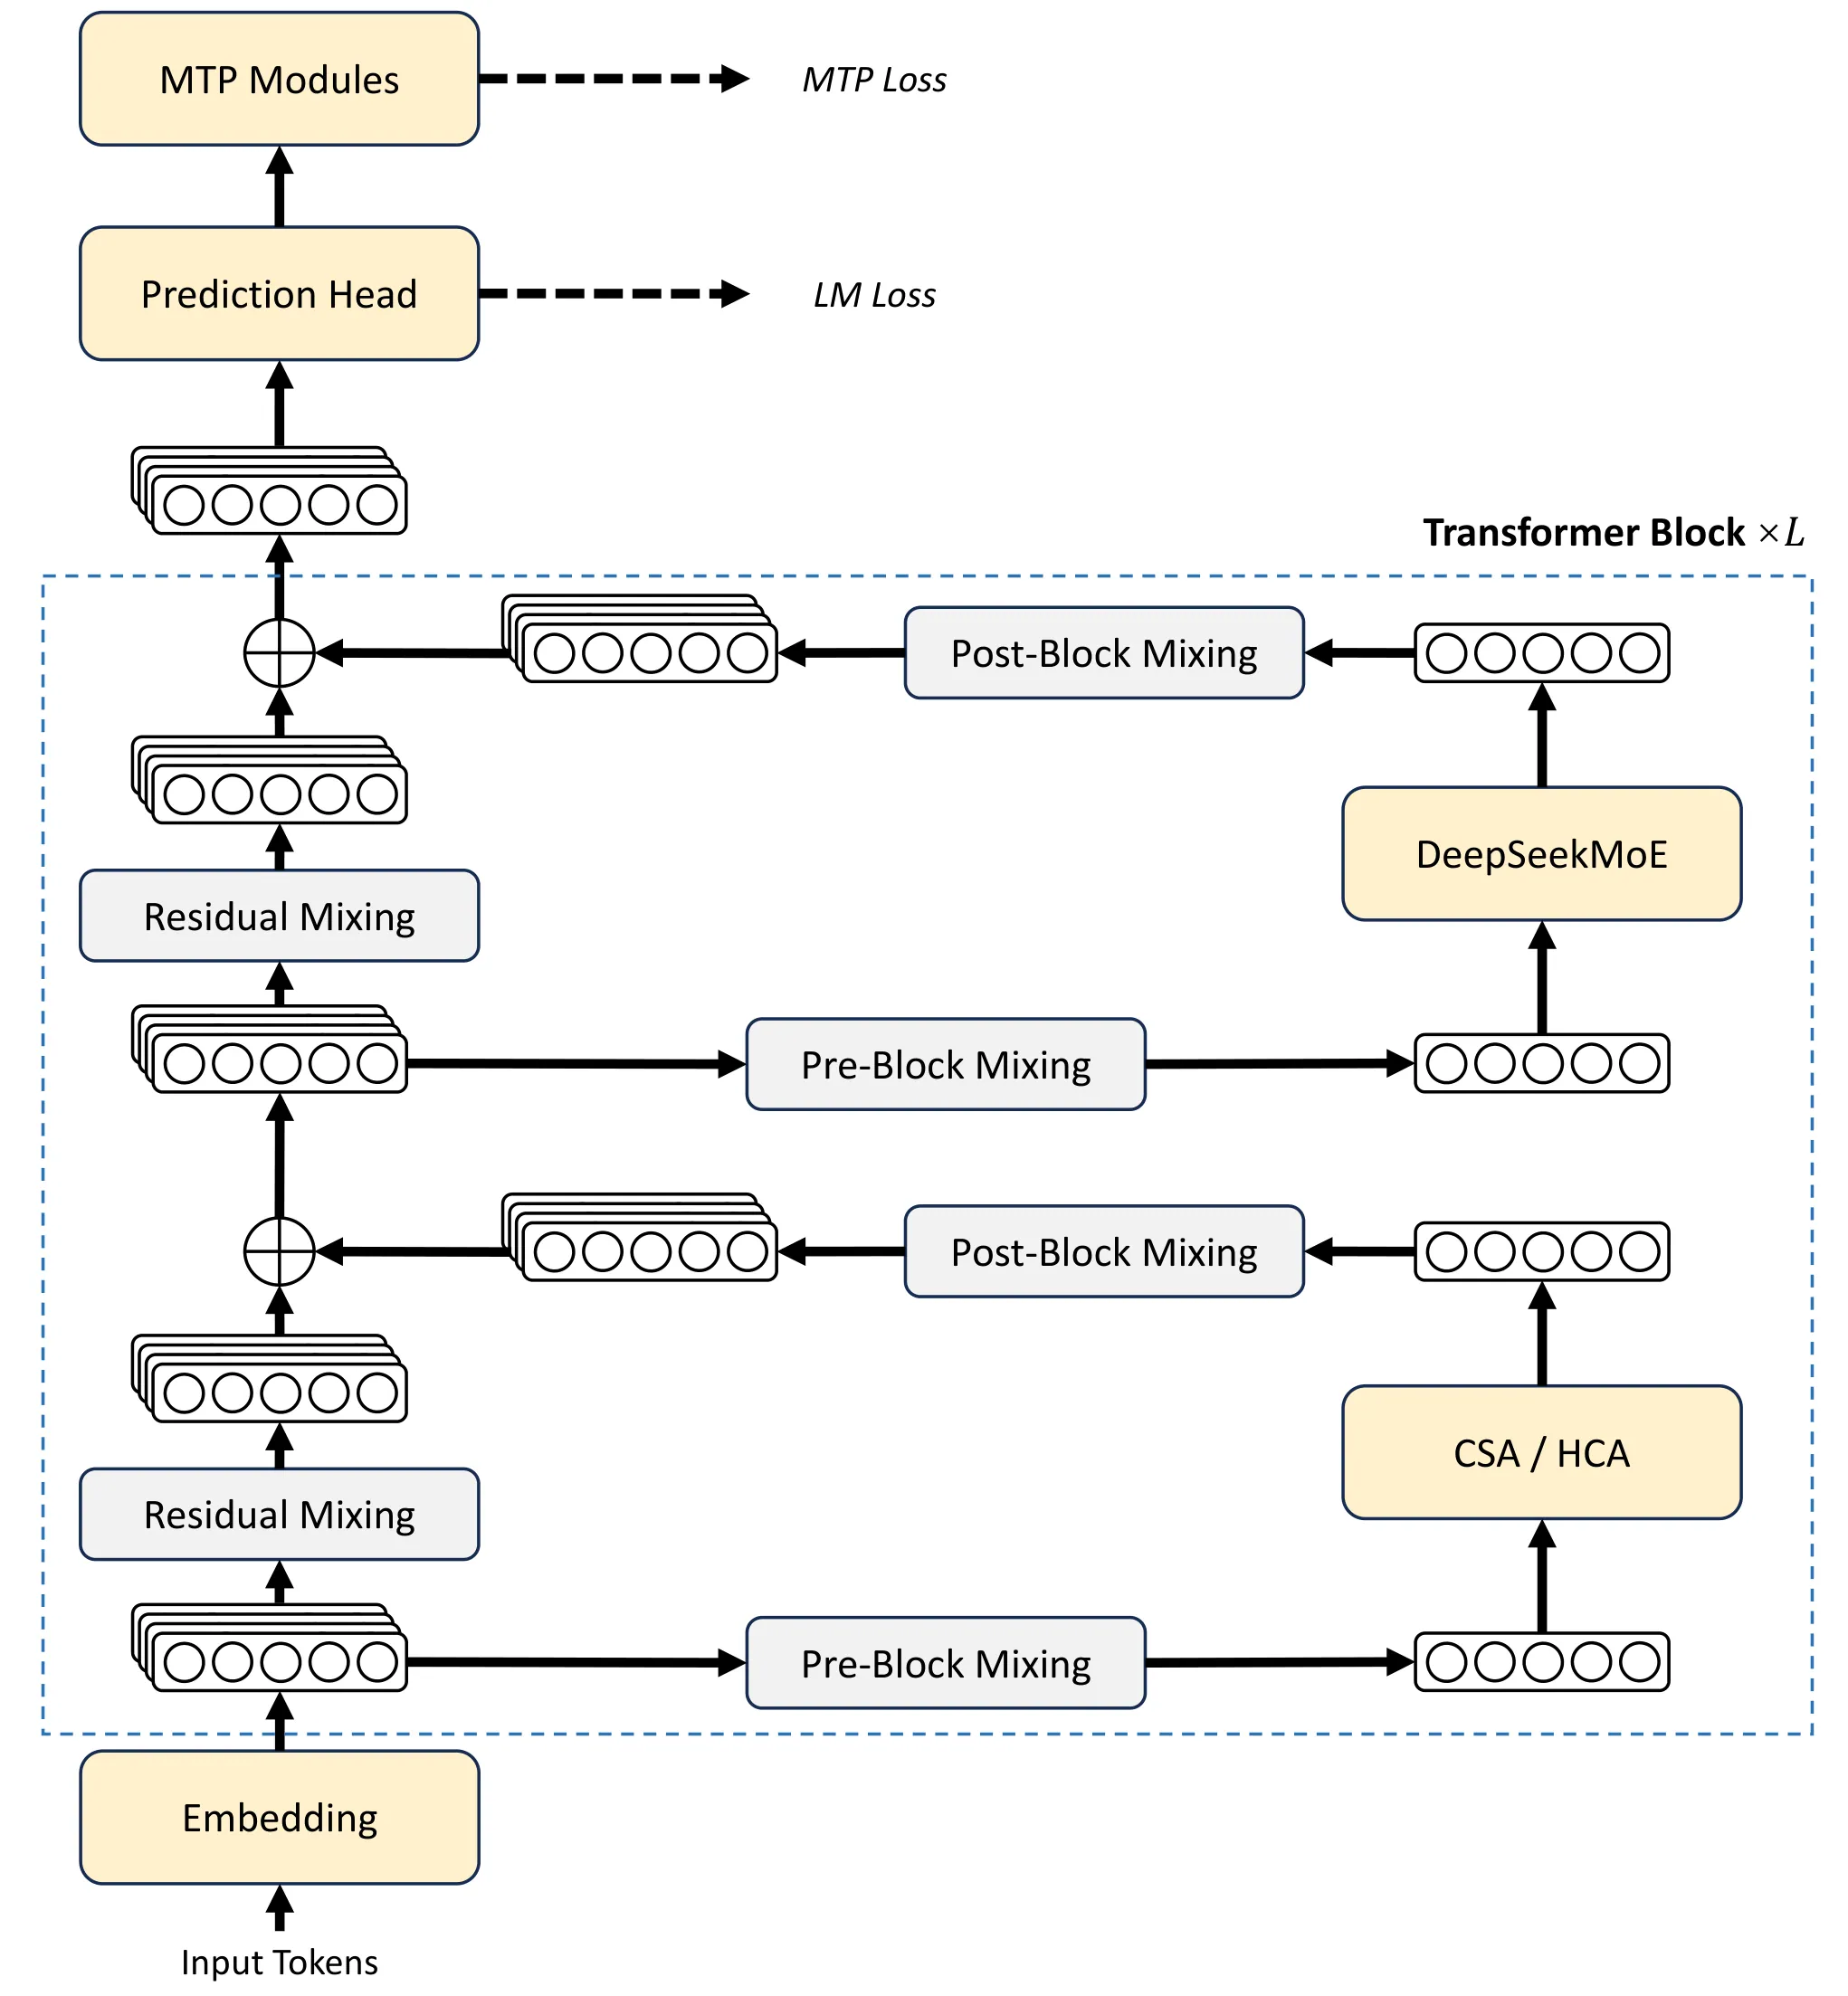
图源:DeepSeek-AI,DeepSeek-V4 技术报告(arXiv:2606.19348)Figure 2
为什么是这些模块?原因是它们根本不是矩阵,或者说不适合用谱范数来约束。
RMSNorm 的缩放权重、各种 bias、mHC 的门控因子都是向量或标量。Muon 的正交化定义在二维矩阵上,对一个 维向量做”正交化”会退化成把它归一化成单位范数——那就丢掉了全部幅度信息,等于给这个参数强行套了一个错误的谱先验。这些参数在模型里的作用恰恰是逐通道/逐元素的缩放与偏置,与 AdamW 那种逐元素的自适应更新天然匹配。Keller Jordan 在博客里的原话是:标量参数和向量参数、以及网络的输入输出层,应该用 AdamW 这类标准方法优化。
嵌入模块与预测头更特殊。它们的维度是词表大小,每一行(或每一列)对应一个 token。词频分布是极端长尾的:高频 token 的梯度密集且方向稳定,低频 token 的梯度稀疏、方向噪声很大。如果对整张嵌入矩阵做正交化,等价于要求”所有 token 的嵌入更新方向互相正交且范数相同”——低频 token 会被高频 token 的方向挤掉。而且嵌入矩阵绝大部分元素在一个 batch 里根本没有梯度(只有被采样到的 token 对应的行有梯度),对这样稀疏的更新做正交化,得到的矩阵在没被更新到的行上的行为缺乏意义。预测头与嵌入层往往还是权重绑定的,问题同样存在。谱范数这个约束对象是”算子乘以向量的增益”,对词表级的嵌入查表来说不是一个有意义的几何量。
这个混合方案也意味着训练时每个参数都要先判断归属:哪些走 Muon、哪些走 AdamW。在 1.6T 参数、几千种形状各异的矩阵上,这个判断和分组本身就是工程问题——后面分布式部分会看到,V4 正是按这个归属来组织 ZeRO bucket 的。
分布式工程:矩阵级更新撞上 ZeRO
现在进入本文的重点。前面所有内容都是”算法对不对”的问题,这一节是”能不能跑起来”的问题。
冲突在哪
ZeRO(Rajbhandari et al., 2020,SC20)的核心思想是把优化器状态、梯度、参数按 rank 切分,让每张卡只存一份切片。对 AdamW 这毫无障碍:更新是逐元素的,所以一张卡只需要知道自己切片的那些元素的梯度,就能算出这些元素的更新。
Muon 做不到。因为 Newton-Schulz 需要完整的矩阵: 要把整个矩阵的行和列都卷进来,正交化的结果也是全局性质(奇异向量 、 依赖于整个矩阵)。如果按 ZeRO 把矩阵切成四块分在四张卡上,每张卡只看到四分之一,它算出来的不是这个矩阵的正交化结果。
Moonlight 报告的措辞是:“ZeRO-1 对 AdamW 高效是因为它逐元素地计算更新,而 Muon 需要完整的梯度矩阵,因此原生 ZeRO-1 无法直接用于 Muon。“
Moonlight 的解法:Distributed Muon
Moonshot 给的方案叫 Distributed Muon,在标准 ZeRO-1 上加了两个操作:
# Algorithm 1 Distributed Muon(Moonshot AI)# G: 完整梯度矩阵;m: DP 分片的动量;p: DP 分片的参数;mu: 动量系数g = reduce_scatter(G, dp_group) # 1. 在 DP 组上 reduce-scatter,得到本地分片的梯度g' = update_with_momentum(g, m, mu) # 2. 用本地分片的动量做动量更新G = gather(g', dp_group) # 3. DP Gather:把分片梯度聚成完整矩阵U = NewtonSchulz(G) # 4. 对完整矩阵做 Newton-Schulzu = U 的本地分片 # 5. 丢掉其余部分,只保留本地分片p' = apply_update(p, u) # 6. 用本地分片的更新作用到本地分片参数P = all_gather(p', dp_group) # 7. all-gather 得到更新后的完整参数第 3 步和第 5 步是新增的:一次 DP gather 拿到完整矩阵,算完之后把非本地的部分全部丢掉。这个”算完就扔”的设计让它没有引入额外显存——一张卡上任意时刻只持有一个完整矩阵。
Moonlight 对这个方案做了三维度的开销分析:
- 显存:Muon 只用一个动量缓冲区,AdamW 用两个(一阶矩和二阶矩)。所以 Muon 的优化器状态显存是 Distributed AdamW 的一半。
- 通信:额外通信只发生在”本地分片参数对应的梯度”上,所以比 的 reduce-scatter 或 的 all-gather 都便宜;再加上 Newton-Schulz 只需要 bf16,通信量再降一半。整体上 Distributed Muon 的通信量是 Distributed AdamW 的 倍。上界算法是:Muon 是 4(fp32 的 reduce-scatter)+ 2(bf16 的 Muon gather)+ 4(fp32 的 all-gather),AdamW 是 4 + 4。实际训练中 DP 通常不止一个,经验值更接近下界的 1.44。如果开了张量并行(TP),还需要额外一次 bf16 的 TP gather。
- 延迟:Distributed Muon 端到端延迟更高,因为多了通信,还要跑 Newton-Schulz。但这不是大问题:一方面 5 步 NS 就够用,另一方面优化器导致的延迟相对前向反向本来就微不足道(通常占 1% 到 3%)。而且 gather 和计算可以重叠、优化器的 reduce-scatter 可以和参数 gather 重叠。Moonshot 说在他们的大规模集群训练里,Distributed Muon 相对 AdamW 没有可感知的延迟开销。
V4 的 hybrid ZeRO:更细的桶分配
DeepSeek 的方案在报告第 3.4.1 节,标题就是”Efficient Implementation of Muon”。他们走得更远,做了三件事。
第一,稠密参数:限制 ZeRO 并行度 + 背包分配。
V4 的做法不是”每个矩阵全量复制”,也不是”按元素切分”,而是限制 ZeRO 并行度的最大值,然后用背包算法(knapsack)把参数矩阵分配给各个 rank,让每个 rank 管理的负载大致均衡。每个 rank 上的 bucket 会被 padding 到与全局最大 bucket 等长,以便高效做 reduce-scatter。
代价是 padding 带来的显存浪费,报告给出的实测数字是:每个 rank 最多管理 5 个参数矩阵时,padding 造成的显存开销通常低于 10%。
当数据并行的规模超过 ZeRO 并行度上限时,V4 的选择是在多余的数据并行组上冗余地重复计算 Muon 更新——用计算换显存,避免 bucket 显存随 DP 规模线性膨胀。这是一个明确的工程取舍:多算几遍正交化(本来就只占训练 FLOPs 的 1% 量级),换掉一大块优化器状态显存。
第二,MoE 参数:展平后均匀切分。
MoE 层是 V4 的主体,参数矩阵数量巨大但单个很小。V4 的处理方式是先按类型展平,再均匀分配:把所有权重里所有专家的 SwiGLU 的 down projection 矩阵先展平,然后是 up projection 矩阵,然后是 gate 矩阵。展平后的向量再 padding,以保证能在所有 rank 间均匀切分,同时不切开任何一个逻辑独立的矩阵。
因为专家数量足够大,MoE 参数的切分粒度可以很细,报告说”padding 开销可以忽略”,而且对 MoE 参数不设 ZeRO 并行度上限——稠密参数上那个”每 rank 最多 5 个矩阵”的限制在这里被取消了。
第三,同形状矩阵合并做批量正交化。
这是很实用的一步:在同一个 rank 上,形状相同且相邻的参数会被自动合并,从而把 Newton-Schulz 迭代以 batch 的形式执行。MoE 的一层里有几百个专家的同形状矩阵,合并之后就是一次批量矩阵乘法,硬件利用率完全不同。前面讲 Newton-Schulz 优点时提到的”可批量”,在这里落到了实处。
精度换通信:bf16 的两次玩法
V4 在数值精度上做了两个很聪明的处理,都建立在”NS 在 BF16 下稳定”这个观察之上。
第一个:把跨 rank 同步的 MoE 梯度量化到 BF16。 报告原文是:他们用随机舍入(stochastic rounding)的方式把需要在数据并行 rank 间同步的 MoE 梯度量化到 BF16 精度,把通信量砍半。这里随机舍入是关键——直接截断会让小梯度系统性地变成 0(偏差累积),随机舍入则让舍入误差在期望上为零。
第二个:换掉 reduce-scatter 的通信原语。 低精度加法器会累积误差,所以 V4 用”all-to-all + 本地 FP32 求和”的两阶段方案替代了传统的树形或环形 reduce-scatter:先做一次 all-to-all 把各 rank 的局部梯度交换开,然后每个 rank 在本地用 FP32 做求和。报告说这个设计”维持了数值鲁棒性”。这是一个很典型的取舍:通信模式换了一种(all-to-all 的带宽需求形态和 ring 不同),换来的是累加精度从低精度提升到 FP32。
把这几条串起来看,V4 的 hybrid ZeRO 策略实际上是一整套围绕”矩阵是更新单位”这个约束重新设计的分片方案:稠密参数限制并行度、用背包算法找均衡、MoE 参数展平细切、同形状合并批量化、通信降精度但累加保精度。报告没有给出这套方案的绝对开销数字,只在摘要里说这是”训练框架的一项增强”。
另一条路:开源生态干脆不分片
一个有意思的对照来自 NVIDIA 的 Megatron-Bridge。它在 recipes/deepseek/gb200/deepseek_v4.py 里放了一个 DeepSeek-V4-Flash 的 Muon 预训练配方,关键配置是这样的:
# Megatron-Bridge: deepseek_v4_flash_pretrain_64gpu_gb200_bf16_muon_configopt_cfg, scheduler_cfg = distributed_muon_with_cosine_annealing( muon_momentum=0.95, muon_use_nesterov=True, muon_scale_mode="unit_rms_norm", muon_fp32_matmul_prec="highest", muon_num_ns_steps=5, muon_extra_scale_factor=0.2, lr_warmup_iters=2000, max_lr=2.7e-4, min_lr=2.7e-5, weight_decay=0.1, clip_grad=1.0,)opt_cfg.optimizer = "muon"opt_cfg.muon_coefficient_type = "quintic"
cfg.ddp.use_distributed_optimizer = False # 不启用分布式优化器cfg.ddp.data_parallel_sharding_strategy = "no_shard" # 优化器状态完全不分片cfg.ddp.overlap_grad_reduce = Truecfg.ddp.grad_reduce_in_fp32 = True(PP=8、EP=8,64 张 GB200 的配方。)
几个地方和 DeepSeek 内部实现不同,值得逐条指出:
- 没有做优化器状态分片。
no_shard意味着每张卡都持有完整的优化器状态副本——这直接绕开了 Muon 与 ZeRO 的冲突,代价是显存。在 64 张 GB200、每个模型用几百 GB 显存的规模下这个代价可以接受,但显然不能线性外推到几千张卡。 - 缩放方式和 V4 不同。
muon_scale_mode="unit_rms_norm"对应的是”把更新显式归一到单位 RMS 再乘 0.2”这条路,而 V4 用的是按 缩放的形状相关方案。两者在理论上等价(因为正交化后的 RMS 本来就近似 ),但数值行为在低精度下会有差别。 - 系数集用的是
quintic而不是deepseekv4。Megatron-Bridge 的系数表里确实登记了deepseekv4这一项(注释里写明来自 DeepSeek-V4 的模型卡 PDF),值是[(3.4445, -4.7750, 2.0315)] * 8 + [(2.0, -1.5, 0.5)] * 2,正是 V4 的混合调度;但配方默认跑的是 5 步的quintic循环系数集——和 Moonshot 的选择一致。 - 学习率 2.7e-4 到 2.7e-5,正好是 V4-Flash 报告的峰值/结束学习率,权重衰减 0.1 也与报告一致。
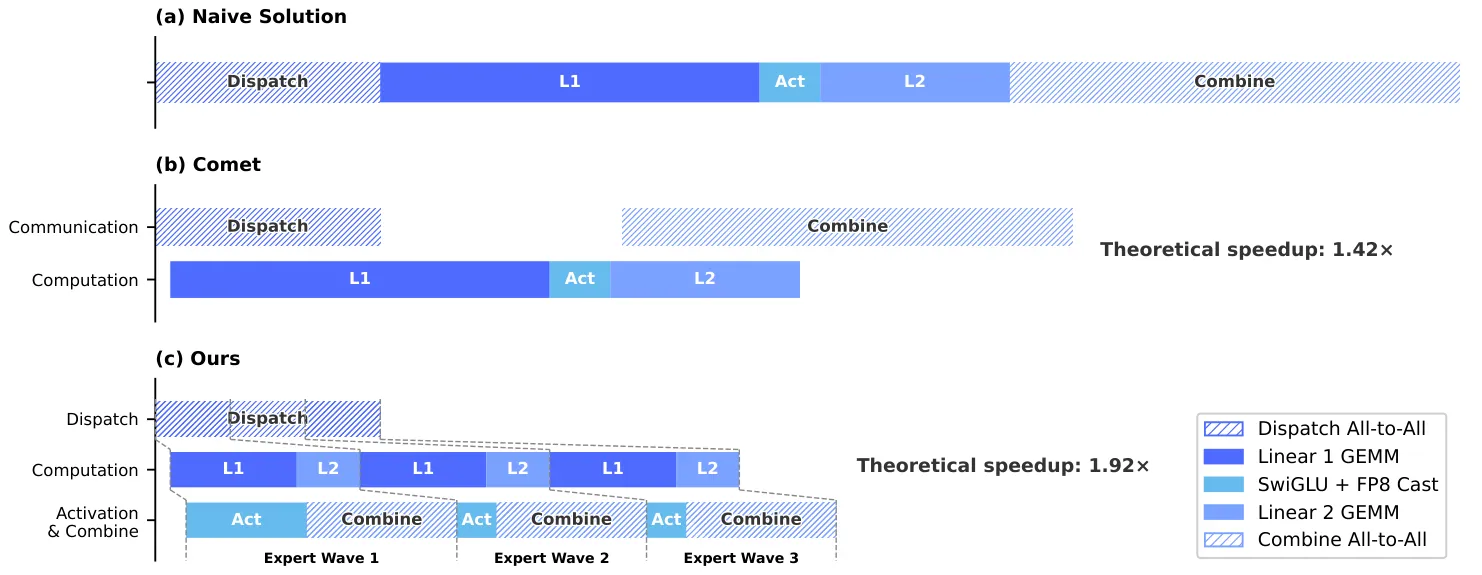
图源:DeepSeek-AI,DeepSeek-V4 技术报告(arXiv:2606.19348)Figure 5
也就是说,开源生态目前复现出来的是一个”保守版”的 V4 训练配置:配方层面放弃 ZeRO 分片、缩放用更简单的单位 RMS 归一、迭代步数回到 5。这从侧面说明 V4 报告里那套 hybrid ZeRO 的工程复杂度有多高——它不是一份配置能表达的东西,需要框架层的深度改造。
连带改造:重计算与优化器一致性
张量级激活重计算
Muon 本身不直接引入重计算需求,但 V4 的训练框架在这一版做了配套改造,报告把它们打包在”训练框架”一节里。第 3.4.4 节介绍了张量级激活检查点(tensor-level activation checkpointing)。
传统做法是模块级的:以整个模块为粒度,决定它的输出激活是保留还是反向时重算。这个粒度太粗,重算成本和激活显存之间的权衡做不到最优。另一条路是手写整个 layer 的前向反向、显式管理张量的检查点状态——控制精细了,但丢掉了自动微分的便利,开发复杂度陡增。
V4 的方案是两者之间:开发者只写前向,然后对个别张量打标注,框架负责检查点与重算。具体实现是:
- 用 TorchFX(arXiv:2112.08429)跟踪完整计算图;
- 对每个被标注的张量,做一次反向遍历,找出重算它所需的最小子图,报告称之为重算图(recomputation graph);
- 把这个重算图插到反向逻辑里、对应梯度计算之前。
报告强调这个设计”相对手工实现没有引入额外的训练开销”,重算的实现方式是直接释放被标注张量的 GPU 显存并复用重算结果的存储指针。这套机制同时被用于 mHC 与压缩注意力的实现(第 3.4.2、3.4.3 节)。
优化器一致性与生态适配
优化器换掉之后还有一堆”周边”要跟着动,这是换优化器最容易被低估的成本。
Moonlight 报告在 SFT 阶段做了一个很关键的消融实验:用同一个 1.2T token 的 MoE 模型(Moonlight 与 Moonlight-A,后者是同样设置但用 AdamW 训练的对照),交叉组合”预训练优化器”和”SFT 优化器”四种情况。结果在 MMLU 上:
| 预训练优化器 | SFT 优化器 | MMLU | HumanEval | GSM8K |
|---|---|---|---|---|
| Muon | Muon | 55.7 | 57.3 | 68.0 |
| AdamW | Muon | 55.3 | 53.7 | 62.1 |
| Muon | AdamW | 50.2 | 52.4 | 64.9 |
| AdamW | AdamW | 52.0 | 53.1 | 64.6 |
只有”预训练和 SFT 都用 Muon”这一组在各项上全面领先。一旦两个阶段的优化器不一致,Muon 带来的收益就基本消失了——用 Muon 预训练再用 AdamW 微调(第三行),MMLU 甚至掉到 50.2,比全程 AdamW 还低。Moonlight 的结论是:要拿到最优性能,Muon 应该用在预训练阶段而不是微调阶段;他们还把”预训练-微调不匹配”的成因列为未来的开放问题。
此外他们还试了在公开预训练模型上加 Muon 做 SFT:Qwen2.5-7B 上用 Muon 微调相对 Adam 微调基本持平(MMLU 70.8 对 71.4,HumanEval 77.4 对 79.3,GSM8K 85.8 对 89.8),进一步佐证了上面的结论。
这条结论对 V4 的直接含义是:后训练阶段的优化器选择不是一个可以随便拍的决定。V4 报告没有公开后训练阶段使用的优化器配置,所以它是否遵循了 Moonlight 的这条经验,目前无法从公开资料确认。这是”未公开”的部分。
生态侧的情况则是另一条线。从 Megatron-LM 的更新记录看,2026 年 4 月官方支持了 Muon 等新兴优化器(通过新的 Emerging-Optimizers 库),2026 年 5 月增加了 DeepSeek-V4 的初步支持;Megatron-Bridge 提供了模型转换、推理与预训练配方,并在 2026 年补上了 V4-Flash 的 Muon 预训练配方。NVIDIA NeMo 的 emerging-optimizers 库里,newton_schulz 函数的 coefficient_type 参数已经支持 simple、quintic、polar_express、cans、aol、deepseekv4、cubic5、custom 八种取值。这套生态的成熟,是 Muon 从”论文里的方法”变成”能开工的优化器”的必要条件。
收益与代价
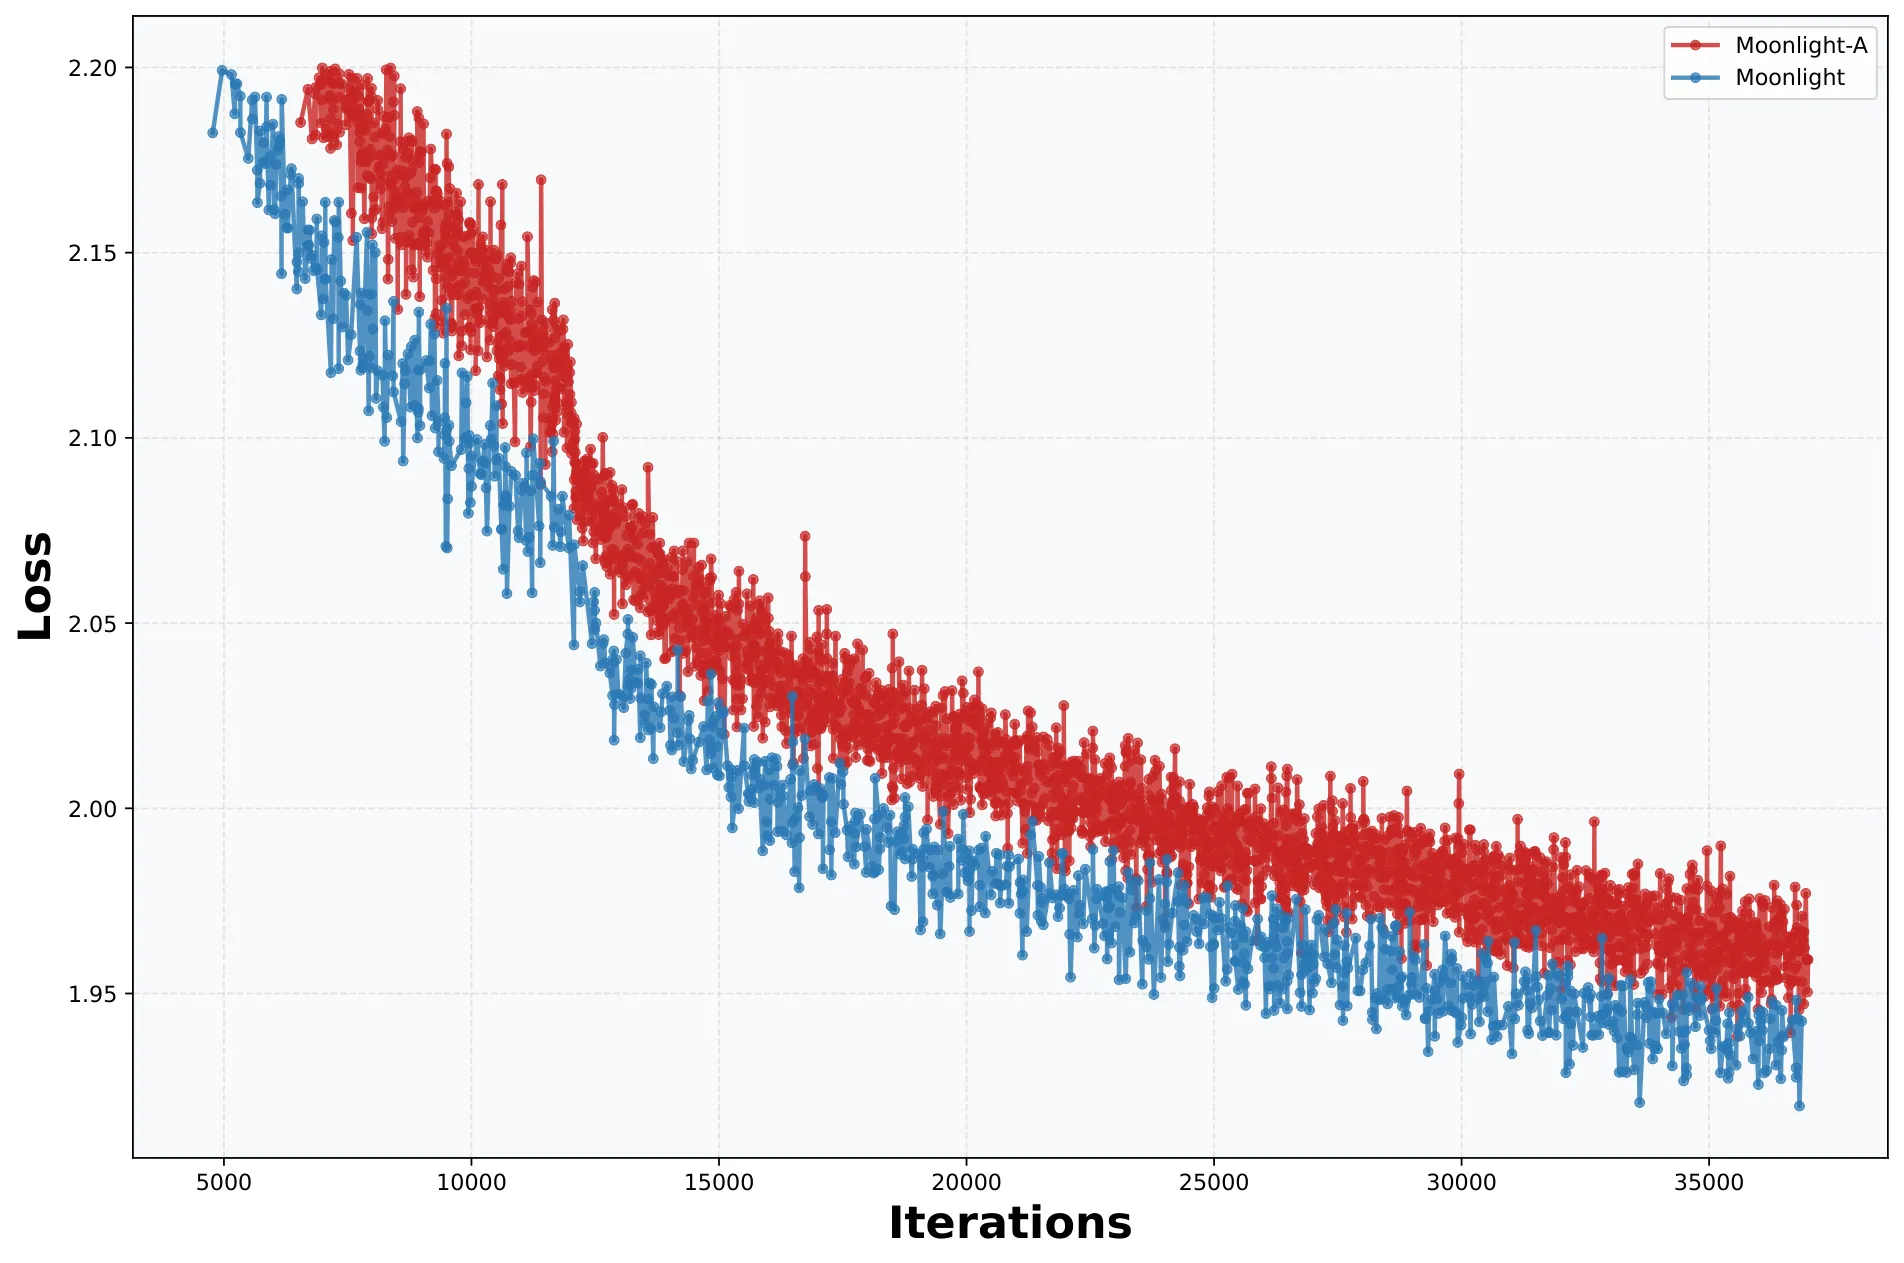
图源:Moonshot AI,Muon is Scalable for LLM Training(arXiv:2502.16982)Appendix D
把公开资料里的数字汇总一遍。
收益侧:
- 计算效率:Moonlight 的缩放律实验给出”约 52% 的训练 FLOPs 达到 AdamW 同等性能”,即约 2 倍的算力效率。这是一个拟合出来的缩放律结论(Muon 的损失曲线拟合为 ,AdamW 为 , 为算力预算),不是单点实验。
- 谱多样性:Muon 训练出的权重矩阵 SVD 熵在全部 checkpoint、全部权重分组上都高于 AdamW。
- 下游任务:在 1.2T token 的中间 checkpoint 上,Moonlight(Muon)相对 Moonlight-A(AdamW)的提升在代码和数学上尤其显著——HumanEval 37.2 对 29.3,MATH 19.8 对 16.1,MBPP 52.9 对 49.2,GSM8K 45.0 对 43.8。但也有反向的例子:BBH 上 Muon 是 43.2,低于 AdamW 的 45.3。Muon 不是全面碾压,它在需要多步推理的任务上优势明显,在部分综合理解任务上并不占优。
- 训练稳定性:V4 报告把”Muron 带来更快的收敛和更好的训练稳定性”作为采用它的第一条理由;Kimi K2 报告用 MuonClip 在 15.5T token 上实现了零 loss spike。
代价侧:
- FLOPs 开销。Keller Jordan 给出了精确的公式:对每个 矩阵(设 ),单步 NS 需要 次矩阵乘法 FLOPs,方阵时最多 。所以相对 SGD 的额外 FLOPs 是 , 为迭代步数。如果这个参数属于一个线性层,单步前向反向的基线 FLOPs 是 ( 为该层在一个训练步里通过的 token 数),于是
代入 NanoGPT speedrun:、,5 步迭代的开销是 。代入 Llama 405B:、,开销是 0.5%。在从 1.5B 到 405B 的整个尺度范围里,Muon 的 FLOPs 开销都在 1% 以下。 这就是 V4 敢把 NS 步数从 5 提到 10 的底气——翻倍之后也还在 1% 到 2% 的量级。
-
显存。Muon 只需要一个动量缓冲区,是 AdamW 优化器状态的一半;但反过来,分布式方案里需要临时聚出完整矩阵(V4 的 padding 开销低于 10%)。
-
通信。Distributed Muon 相对 Distributed AdamW 是 倍,实测更接近下界 1.44 分之一的水平。V4 通过 bf16 随机舍入把 MoE 梯度的同步通信砍半。
-
延迟。优化器本身的延迟占整步的 1% 到 3%,Moonlight 称大规模集群上”没有可感知的延迟开销”。
-
稳定性仍未彻底解决。这一点必须说清楚:换了 Muon 不等于训练就稳了。V4 报告第 4.2.3 节明确写道,他们在训练中遇到了”显著的不稳定挑战”,简单的回滚只能临时恢复、无法阻止尖峰复发;最终定位到尖峰与 MoE 层的离群值有关,而路由机制本身会加剧离群值的出现。他们用了两个手段——Anticipatory Routing(把骨干网络与路由网络的计算解耦,用历史参数 预先计算并缓存路由索引,配合自动检测机制,只在检测到 loss spike 时短暂回滚并启用,之后恢复正常训练,把墙钟开销控制在约 20% 以内)与 SwiGLU clamping——才把训练稳住。报告还坦承”对它们背后的机制尚缺乏完整的理论理解”。
值得玩味的是,这和 Kimi 用 QK-Clip 解决的是同一个病症(注意力 logit 爆炸)的不同表现。V4 因为注意力结构里已经对 query 和 KV entry 直接做了 RMSNorm,不需要 QK-Clip;但它仍然需要 Anticipatory Routing 和 SwiGLU clamping。Muon 提高的是优化的几何质量,不是数值稳定性的万能药。
还有一篇 2026 年 6 月的工作值得放在结尾提一下。Why Muon Outperforms Adam: A Curvature Perspective(arXiv:2606.04662)用二阶泰勒展开分析了这个问题:在匹配验证损失的前提下,Muon 的单步损失下降比 Adam 更大;两者的一阶增益相当,差别在二阶的曲率惩罚项。把这个惩罚项拆成”更新范数的平方”和”归一化方向锐度”(Normalized Directional Sharpness, NDS)之后,作者发现 Muon 和 Adam 的更新范数其实差不多,Muon 的优势来自更低的 NDS,而不是更大的更新幅度。他们还证明了在曲率异质的二次问题上,Muon 通过在曲率分组之间平衡更新能量来获得更低的平均 NDS:曲率异质性越强,Muon 相对梯度下降的优势越大。
这个结论和本文开头的直觉是吻合的:Muon 的价值不在于”走得更远”,而在于”不走那条最陡的沟”。高曲率方向对应损失曲面上极其敏感的少数方向,AdamW 逐元素归一化之后恰恰会往这些方向猛冲;正交化则把更新能量从这些方向摊开。对万亿参数的 MoE 来说,专家层与路由的曲率异质性本来就比稠密模型更强,这大概也是 Moonlight 报告里”Router 权重上的 SVD 熵差距最大”这条观察的另一种解读。
小结
把整篇的要点收一下:
- Muon 的核心是把优化单元从”元素”提升到”矩阵”:先做 SGD-momentum(V4 用 Nesterov 前瞻形式),再对动量矩阵做正交化,把更新矩阵的奇异值谱从”几乎低秩”压平成全 1。
- 正交化用 Newton-Schulz 迭代实现而不是 SVD,因为它只有矩阵乘法、可批量并行、能在 bf16 下稳定运行、迭代次数可调。迭代的本质是五次多项式 逐元素作用于奇异值;只要初始奇异值在 内且 ,就收敛到 。
- 系数 的调参目标不是”精确收敛”,而是在”结果落在 1 附近 ±0.3 的带内”这个宽松约束下最大化 ,从而加快小奇异值的爬升。V4 进一步做了 8 步激进 + 2 步温和的混合调度,把散落在 的奇异值收敛到 。
- 更新尺度用 补偿形状依赖(Lemma 1:正交矩阵的更新 RMS 是 ),再乘 0.2(V4 用 0.18)对齐到 AdamW 的更新 RMS,从而直接复用 AdamW 的学习率与权重衰减。
- 嵌入层、预测头、bias、RMSNorm 权重仍用 AdamW,因为它们不是矩阵,谱范数约束对它们没有意义。
- 分布式的核心矛盾是”Newton-Schulz 需要完整矩阵”与”ZeRO 把矩阵切碎了”的冲突。Moonlight 用 DP gather 聚出完整矩阵、算完只留本地分片;V4 更进一步,用背包算法分配 bucket、限制 ZeRO 并行度、MoE 参数展平细切、同形状矩阵合并做批量正交化、bf16 随机舍入砍半通信、all-to-all 加本地 FP32 求和保精度。
- 收益是约 2 倍的算力效率、更高的权重谱熵、代码与数学任务上的显著提升,代价是 1% 量级的额外 FLOPs、略高的通信量,以及一个尚未被完全理解的稳定性问题——即便在 V4 上,也仍然要靠 Anticipatory Routing 与 SwiGLU clamping 兜底。
如果你接下来要动手,最省事的起点是 Megatron-Bridge 的 V4-Flash Muon 配方加上 NVIDIA NeMo 的 Emerging-Optimizers 库:前者给了可运行的并行与超参配置,后者给了八种 Newton-Schulz 系数集和 newton_schulz 的实现。至于 V4 报告里那套 hybrid ZeRO,目前还没有等价的公开实现——这也是从”能训”到”能大规模训”之间最实际的一道门槛。
参考资料
- DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence(arXiv:2606.19348,2026-04-26)
- Muon: An optimizer for hidden layers in neural networks(Keller Jordan,2024-12-08)
- Muon is Scalable for LLM Training(arXiv:2502.16982,Moonshot AI,2025-02-24)
- Kimi K2: Open Agentic Intelligence(arXiv:2507.20534,2025-07-28)
- Why Muon Outperforms Adam: A Curvature Perspective(arXiv:2606.04662,2026-06-03)
- How Much Orthogonalization Does Muon Need?(arXiv:2606.00371,2026-05-29)
- The Polar Express: Optimal Matrix Sign Methods and Their Application to the Muon Algorithm(arXiv:2505.16932)
- Accelerating Newton-Schulz Iteration for Orthogonalization via Chebyshev-type Polynomials(arXiv:2506.10935)
- Old Optimizer, New Norm: An Anthology(arXiv:2409.20325,Bernstein & Newhouse)
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models(arXiv:2001.08361,Rajbhandari et al.,SC20)
- NVIDIA NeMo Emerging-Optimizers: muon_utils 源码(Newton-Schulz 系数集
simple/quintic/polar_express/cans/aol/deepseekv4/cubic5) - NVIDIA Megatron-Bridge: DeepSeek-V4 预训练配方(
recipes/deepseek/gb200/deepseek_v4.py) - Torch.fx: Practical Program Capture and Transformation for Deep Learning in Python(arXiv:2112.08429)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


