


GRPO 与 DeepSeek-R1 完全拆解:纯强化学习如何涌现长思维链
在 DeepSeek 技术全景 那条时间线上,DeepSeek 的技术栈大致可以分成三条线:模型架构、推理系统、训练方法。前两条线本站已经逐块拆过——注意力与 KV 压缩有 MLA 完全拆解,服务侧有 DeepSeek-V3/R1 推理系统完全拆解,投机解码有 MTP 完全拆解。唯独训练方法这条线一直没有展开,而它恰好是 2025 年初那件让整个行业重新估算大模型训练成本的事情的核心:DeepSeek-R1 证明了不需要任何人工标注的推理过程,只靠强化学习,就能让一个基座模型自己长出长思维链,并在数学、代码竞赛这类可验证任务上追平当时最好的闭源推理模型。
本文拆这条线。主角是两个东西:GRPO(Group Relative Policy Optimization,组相对策略优化),以及 DeepSeek-R1 的四阶段训练管线。前者出自 DeepSeekMath(arXiv:2402.03300,2024 年 2 月提交),后者出自 DeepSeek-R1 技术报告(arXiv:2501.12948,2025 年 1 月 22 日提交,2026 年 1 月 4 日修订)。文章会先把 GRPO 的目标函数、优势估计与梯度完整推一遍,再逐阶段还原 R1 的管线与每个阶段的失败模式,最后给出蒸馏结果和与 o1 系列的评测对照。
起点:RLHF 的四模型结构,与一个训不好的价值模型
要理解 GRPO 为什么存在,得先看清它替换掉的东西有多重。
大模型对齐的主流流程是 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习):先做 SFT(Supervised Fine-Tuning,监督微调),再用 PPO(Proximal Policy Optimization,近端策略优化)做强化学习。R1 论文的附录 A.2 把这件事讲得很直白:SFT 用人工挑选的输入输出对把模型拉到”能用”的水平,RL 则把这个水平继续往上推,让它对齐更宽泛的人类偏好。麻烦出在 PPO 那一侧。
PPO 是一个 actor-critic 算法,跑起来内存里同时要有四个模型:
| 角色 | 作用 | 是否训练 | 规模 |
|---|---|---|---|
| 策略模型(actor) | 生成回答,就是要更新的模型 | 是 | 与基座同规模 |
| 奖励模型(reward) | 给整条回答打一个标量分 | 否(冻结) | 通常与策略同量级 |
| 参考模型(reference) | 提供 KL 约束的锚点,防止策略跑偏 | 否(冻结) | 与策略同规模 |
| 价值模型(critic / value) | 预测从当前位置往后的期望累计回报,为 GAE 提供基线 | 是 | 与策略同规模 |
关键在于最后一行。策略模型要训练,价值模型也要训练,而价值模型的规模通常和策略模型一样大。在 671B 总参数、37B 激活参数的 DeepSeek-V3 架构上,这意味着除了推理时要加载的策略模型之外,训练时还要再准备一整个同规格的价值模型,并且它要参与前向和反向。R1 论文在附录 A.3 里用了”significant memory and computational overhead”这个词组来描述这件事,说得非常克制。
显存只是问题的一半,另一半是价值模型在语言模型场景里本身就很难训。R1 论文指出了两个原因,值得一字不落地理解:
第一,奖励信号的稀疏程度。在 LLM 的 RL 里,通常是整条回答生成完之后,奖励模型才给最后一个 token 一个分数。价值函数要做的是预测”从当前位置往后的期望累计回报”,而在只有最终结果奖励的情况下,中间每一个位置的正确答案其实是同一个数——这让”逐 token 都准确”的价值估计变成一件没什么意义、又必须去拟合的苦差事。
第二,长思维链特有的困难:已经生成的内容会被后面的内容推翻。R1 论文的原话是,随着输出长度增加,模型在生成过程中更可能进行反思和改写,前面写下的内容可能在后面被修改甚至被否定,于是”根据部分回答预测最终奖励”这件事变得更加不可行。这句话点出了一个结构性矛盾:PPO 的价值模型假设的是回报沿轨迹单调累积,而推理模型的行为恰恰是”边写边反悔”,轨迹的中间状态和最终结果之间的相关性被主动削弱了。
第三个隐藏成本是超参敏感度。PPO 用 GAE(Generalized Advantage Estimation,广义优势估计)计算优势,GAE 里有一个 λ 系数控制偏差与方差的权衡。R1 论文在 MATH 任务上用 DeepSeek-Coder-V2-Lite(16B MoE,2.4B 激活)做了对照实验,结论是 PPO 对 λ 高度敏感:按大多数开源 PPO 实现的默认值 λ=0.95 跑,PPO 明显差于 GRPO;只有把它调到 λ=1.0 并配合细致的调参,PPO 才追到 GRPO 附近。换句话说,PPO 能打,但代价是你得额外花算力去把它调对。
前史:PRM、MCTS 与闭源 o1——R1 之前的三条推理路线
在 R1 之前,“让模型会推理”这件事有三条主流思路,R1 论文在附录 G.2 里逐条复盘了它们为什么没有走通。这部分内容很少被二手解读提到,但对理解 R1 路线的独特性非常重要。
第一条是 PRM(Process Reward Model,过程奖励模型)。它的想法是给推理的每一个中间步骤打分,而不是只给最终答案打分,从而提供更细粒度的监督信号。R1 论文给出了三条实际限制:其一,在通用推理里”什么是细粒度的一步”很难明确定义;其二,判断当前中间步骤是否正确本身是难题——用模型自动标注效果不理想,人工标注又完全不具备可扩展性;其三,一旦引入基于模型的 PRM,奖励 hacking 几乎不可避免,而且重新训练奖励模型需要额外算力、让整条训练管线复杂化。论文的结论是:PRM 在给模型生成的前 N 条回答重排序、或者辅助引导搜索时表现不错,但在他们的实验里,它带来的收益远不及它在大规模 RL 过程中引入的额外计算开销。
第二条是 MCTS(Monte Carlo Tree Search,蒙特卡洛树搜索)。这条路线明显受 AlphaGo 和 AlphaZero 启发:把答案拆成若干部分,让模型系统性地探索解空间,用预训练的价值模型引导搜索,再用搜索得到的问答对反过来训练 actor 和价值模型,迭代提升。R1 论文的复盘是:第一,和棋类相比,token 生成的搜索空间是指数级大得多的,只能给每个节点设最大扩展限制,而这会让模型困在局部最优;第二,价值模型直接决定生成质量,而训练一个细粒度的价值模型本身就是难题。AlphaGo 成功的核心在于”训好一个价值模型就能稳步提升”,这套机制在 token 生成场景难以复刻。结论是:MCTS 配上预训练好的价值模型可以在推理时提升表现,但想靠自搜索迭代地提升模型能力,仍然是一个巨大的挑战。
第三条是 o1 代表的闭源路线。OpenAI 的 o1 在 2024 年 9 月发布,展示了长思维链带来的推理能力跃升,但没有公开训练方法。R1 论文把 o1-0912 和 o1-1217 作为主要对照基线(论文提到,由于在中国大陆访问 o1-1217 的 API 有困难,其成绩按官方报告的数字记录)。
R1 的路子在这三条之外:不做过程奖励,不做树搜索,也不依赖人工标注的推理轨迹,而是只用最终答案可验证的结果奖励,做大规模强化学习。论文在附录 H.3 里把这层意思说得很清楚:传统 RL 管线从高质量人工示范开始做 SFT,这提供了强初始化、避免了模式坍缩,但也让模型倾向于模仿人类的推理模式,可能阻碍它发现新的解题策略。而 R1 直接对基座模型做基于结果的 RL,跳过初始 SFT 阶段,目的就是让不受约束的推理策略自己涌现出来。
GRPO 目标函数:把 critic 换成一组样本
从 PPO 的目标函数说起
DeepSeekMath 论文先用标准形式给出了 PPO 的代理目标(论文式 1):
符号逐个解释:
- 是从问题集 里采样的题目, 是从旧策略 采样出来的整条回答, 是回答的 token 数。
- 是当前要更新的策略, 是这一轮采样时用的策略(在 LLM 场景里就是”上一次参数更新后的模型”)。两者之比是重要性采样比,衡量当前策略相对采样时策略对同一个 token 的偏好变化了多少。比值大于 1 表示当前策略更倾向于这个 token。
- 是第 个 token 的优势,在 PPO 里由 GAE 计算:它既用到了奖励,也用到了学出来的价值函数 。
- 是裁剪超参。 取”未裁剪项”和”裁剪项”里更小的那个,构成一个下界式的保守更新:当优势为正时,比值超过 的部分不再产生梯度;当优势为负时,比值低于 的部分也不再产生梯度。
- 最外层的 是按长度做平均,让不同长度的回答对梯度的贡献处在同一量级。
PPO 还有一个关键设计:把 KL 惩罚做成逐 token 的密集奖励(论文式 2):
其中 是奖励模型, 是参考模型(通常是初始的 SFT 模型), 是 KL 惩罚系数。也就是说,在 PPO 里,KL 不是加在损失上,而是逐 token 扣在奖励里,然后一起进 GAE 去算优势。
GRPO 的目标函数逐项拆解
GRPO 的目标函数(DeepSeekMath 论文式 3)长这样:
和 PPO 逐项对照,变化只有三处,但每一处都很重:
- 采样单位从”一条回答”变成”一组回答”。对每个问题 ,从 采样 条输出 ,外层用 在组内做平均。 就是所谓的组大小(group size)。
- 优势 换成了 。这是组内相对优势,只依赖组内这 个奖励,完全不需要价值模型。它的下标同时带 (组内第几条)和 (第几个 token),含义是:同一个优势值被赋给该条输出里的每一个 token。
- KL 项从奖励里搬到了损失里,并且换成了一个无偏估计量(论文式 4):
这个估计量来自 Schulman 2020 年的 KL 估计笔记,常被称作 估计量。它有个漂亮的性质:对任意正数 ,函数 恒大于等于 0(因为 ),所以它不会像朴素的 那样采出负值来。论文特意强调了一句:“which is guaranteed to be positive.”——每一步算出来的 KL 都是非负的,这对训练稳定性不是小事。
KL 项为什么放在损失里,而不是奖励里
这是 GRPO 和 PPO 最容易被忽略、但影响最大的差异。
DeepSeekMath 论文的原话是:GRPO 不在奖励里加 KL 惩罚,而是把训练策略与参考策略之间的 KL 散度直接加到损失里,这样做避免让优势的计算复杂化。逻辑很直白:如果 KL 进奖励,那它就会参与优势估计——在 PPO 里意味着它要进 GAE,在 GRPO 里意味着它要进组内归一化;而 KL 是逐 token 的稠密信号,把它混进一个”整条回答一个标量分”的相对比较框架里,只会让组内的均值标准差被长度相关的噪声污染。
R1 论文在附录 A.3 里补充了一个更本质的后果:强化学习的目标是最大化累计奖励,所以 PPO 那种”逐 token 扣 KL”的做法,惩罚的是累计 KL,这会隐式地惩罚回答长度,从而阻碍模型把回答写长。而 R1 这一系列工作的核心现象之一就是”思考时间随训练增长”,长度必须能涨上去。把 KL 从奖励里拿出来、直接加到损失上,就绕开了这层隐式长度惩罚。
顺带一提,这也是为什么读论文时要分清论文原文与实际实现。同一个 GRPO,在不同版本和不同代码库里的写法并不完全一致:
- DeepSeekMath 原文是严格的 token 级:优势带 下标,KL 也带 下标,外层还有 做长度归一。
- R1 论文第 2.1 节给出的目标函数在写法上更”粗”:公式里写的是 而不是 ,KL 项写的是整条输出 的概率比而不是逐 token 形式,外层也没有了 。
- 工程实现里,逐 token 计算重要性采样比与 KL 才是常态——因为只有逐 token 的 KL 才能对每个生成位置施加约束,也只有逐 token 的形式才能和裁剪机制配合。
R1 论文的 KL 系数是 0.001,DeepSeekMath 是 0.04,差了 40 倍。这个差距本身也说明:KL 项的强度不是原则问题,而是随训练规模、参考模型更新频率一起调的工程参数。
组内相对优势:去掉 critic 之后为什么还可信
优势估计公式
GRPO 的组内相对优势(DeepSeekMath 论文式 3 之后的定义,R1 论文式 3):
其中 是第 条输出的奖励(在 R1-Zero 里就是规则奖励:答案对不对、格式对不对), 是组内平均, 是组内标准差。 是归一化之后的奖励,把它赋给第 条输出里的所有 token。
这个式子做了两件事:减均值提供了一个基线,除以标准差做了一次尺度归一。
无偏性:组均值为什么是合法基线
先说减均值。有一个通用结论:任何只依赖问题 、不依赖被评分的那条输出本身的基线,都不会改变策略梯度的期望。 推导只要三行:
设基线为 ,考虑它对梯度期望的贡献项
第一步把 提出期望(它不依赖 ),第二步把梯度算子搬进求和号,第三步用”概率之和恒为 1”这个事实——常数的梯度是 0。所以减去基线只改变方差,不改变梯度的方向。这正是”基线是免费的午餐”这句话的数学来源:方差降了,偏差没来。
GRPO 的组均值就是这样一个基线:它由同一问题下的 条输出的实际奖励算出来,衡量的是”这个问题在当前策略下能拿到什么分”。比它高的输出得到正优势、被强化,比它低的得到负优势、被抑制。它不需要泛化到没见过的状态——这恰恰是价值模型最难的部分。
严格地说,这里有一个细节值得点破:组均值里包含了 自己的一份,所以它并不是严格的”与 无关”的基线。把 展开写, 中 的自相关项会残留 ,这一项的期望一般不为 0,因此理论上会引入 量级的偏差。当 取 16 到 64 时,这个偏差很小;而它换来的是完全省掉一个与策略同规模的价值模型。这是一笔明确划算的偏差-方差交易:不是”GRPO 完全没有偏差”,而是”用一点点可控的偏差,换掉一整个训练不动、还占显存的 critic”。
方差: 个样本换来什么
再说方差。设单条输出的奖励服从均值 、标准差 的分布,那么用 条其他输出的均值做基线的优势估计,噪声标准差是
对比”不做任何基线”的情形(用 做尺度),基线把优势的噪声压到了接近 1 倍标准差——也就是说,优势被标准化到了 的量级,与具体任务、具体奖励尺度无关。再对比”减掉一个完美的价值函数”的理想情形(噪声就是 ),组均值基线的代价只是 这个系数: 时约 1.03, 时约 1.008。换句话说,用 16 条样本估出来的组均值,其质量已经非常接近一个训得很好的价值函数所提供的基线,而后者需要在训练中同步拟合、随策略漂移不断重建。
代价在采样那头:每条问题要生成 条完整回答。R1 用的是 ,DeepSeekMath 用的是 。这也是 GRPO 把成本从”训练侧多一个模型”转移到了”采样侧多几条输出”——在推理引擎足够快的系统里,采样比训练便宜得多。
为什么还要除以组内标准差
只减均值也能去基线,为什么还要除以 ?
因为不同问题的奖励尺度差别很大。有的题目模型基本都对,组内奖励接近全 1,减完均值后优势全接近 0;有的题目难度适中,组内奖励一半 0 一半 1,减完均值后优势分布在 附近;还有的题目用连续奖励(比如带部分分的奖励模型),尺度又不一样。如果不归一化,梯度就会被”刚好落在难度甜区”的那批题目主导——这也是一种隐式的课程偏差。除以组内标准差之后,来自不同问题的优势都变成同一量级,训练更像是对”同一批问题里相对更好/更差的回答”做比较。
论文还补充了一个设计上的自洽性论证:奖励模型通常是在”同问题下不同输出之间的比较”数据上训练的,所以奖励值本身就有强烈的相对含义。用组内相对的方式去算优势,正好和奖励模型的比较性质对齐。
输出监督与过程监督两种用法
GRPO 的优势估计有两种用法,DeepSeekMath 都写了:
结果监督(outcome supervision):奖励模型只给整条输出的末尾一个分,归一化之后赋给该输出的所有 token,也就是 。R1-Zero 和 R1 的推理 RL 用的就是这种。
过程监督(process supervision):过程奖励模型给每个推理步骤的末尾打分,得到 ,同样用全局均值和标准差归一化:
然后某个 token 的优势取”它之后所有步骤归一化奖励之和”,即 。这样靠后的步骤只累加剩下的奖励,靠前的步骤能看到全局。
DeepSeekMath 的实验结论是:GRPO+PS 优于 GRPO+OS,说明更细粒度、步骤感知的梯度系数是有价值的。但要注意,这与 R1 的结论并不矛盾——R1 拒绝的是基于模型的过程奖励模型(因为难定义、难标注、易被 hack),而 DeepSeekMath 里这个过程监督同样是用奖励模型实现的,只是在小规模数学任务上还没暴露出问题。
梯度长什么样:统一范式的视角
DeepSeekMath 有一节很值得读的内容:它把 SFT、RFT、DPO、PPO、GRPO 全都写成同一个形式(论文式 5):
三种方法只有三处不同:数据来源 、奖励函数 、以及梯度系数 。这个框架的价值在于:它把”不同算法”的差别压缩成了一个标量——同一个 token,它的对数概率该被抬多高、压多低。
在这个框架下,GRPO 的梯度是(论文式 21,注意论文原文此处漏写了条件中的 ):
对应的梯度系数是:
逐项读这个式子,能看出三件事:
第一,主项就是优势乘对数概率的梯度,形式上和一切策略梯度方法相同。这验证了裁剪机制没有改变梯度的基本形状,只是把”策略偏离太远”的那些 token 的系数截断。
第二,KL 项出现在梯度系数里,而不是出现在奖励里,且它的形状是 。当当前策略对某个 token 的偏好超过参考模型(,比值小于 1)时,括号里是负数,把这个 token 的概率往下压;反过来则往上抬。这就是”直接加在损失里的 KL”在梯度层面的样子——它是逐 token 的、稠密的、与优势无关的正则项。
第三,把它和 Online RFT(在线拒绝采样微调)的梯度系数对比能看出 GRPO 的独特之处。Online RFT 的梯度系数是 ,也就是”答案对就给 1、答案错就给 0”。论文的原话是:GRPO 会根据奖励模型给出的奖励值调整梯度系数,从而对不同大小的奖励做差异化的强化与惩罚;而 Online RFT 没有这个能力——它不惩罚错误答案,并且对所有正确答案给同样的强化强度。 这个差别在实验中体现得很明显:GRPO 优于 Online RFT,说明”正负梯度系数可调”本身就有价值。
DeepSeekMath 还报告了另一个反直觉的观察。论文对比了 SFT 模型和 RL 模型在 GSM8K 与 MATH 上的 Pass@K 与 Maj@K(多数投票):RL 提升了 Maj@K,但没有提升 Pass@K。 论文的解读是,RL 提升的是输出分布的鲁棒性——它让正确答案更容易从 TopK 里被采样到,而不是提升了模型的基础能力上限。作者也坦白说,这可能与他们只用了指令微调阶段的问题、以及朴素的核采样有关,并把这个现象列为未来方向。这个结论在 R1 身上得到了呼应:R1 在 AIME 2024 上 Pass@1 是 79.8%,Pass@64 却高达 90.0%——单条轨迹的正确率远低于”允许采 64 条”的上限。
GRPO 与 PPO 的逐项对比
把上面几节的内容收成一张表:
| 维度 | PPO | GRPO |
|---|---|---|
| 需要加载的模型 | 策略、奖励、参考、价值(critic) | 策略、奖励、参考 |
| 优势估计 | GAE,依赖学出来的价值函数 | 组内奖励的均值/标准差归一化 |
| 是否需要训练 critic | 需要,且规模与策略相当 | 不需要 |
| 额外采样开销 | 无 | 每个问题采样 条输出 |
| 主要超参 | 、、GAE 的 、价值函数学习率 | 、、组大小 |
| 超参敏感度 | 高,λ 从 0.95 调到 1.0 才有可比表现 | 无 λ,维度更少 |
| KL 项位置 | 逐 token 加进奖励,进 GAE | 直接加进损失,不进优势计算 |
| KL 估计量 | 朴素形式,可能为负 | 无偏估计量,恒非负 |
| 对长输出的影响 | 累计 KL 惩罚隐式压制长度增长 | 不压制长度 |
| 奖励模型的匹配度 | 优势来自价值函数,与奖励模型的比较性质无关 | 组内相对,天然匹配奖励模型的比较性质 |
R1 论文在附录 A.3 里给出的实验对照(MATH 任务,DeepSeek-Coder-V2-Lite,16B MoE、2.4B 激活)可以从图里读出量级:λ=0.95 的 PPO 收敛到约 0.50 的准确率,λ=1.0 的 PPO 约 0.54,GRPO 约 0.555,且 GRPO 的曲线在前 2000 步里几乎全程领先。
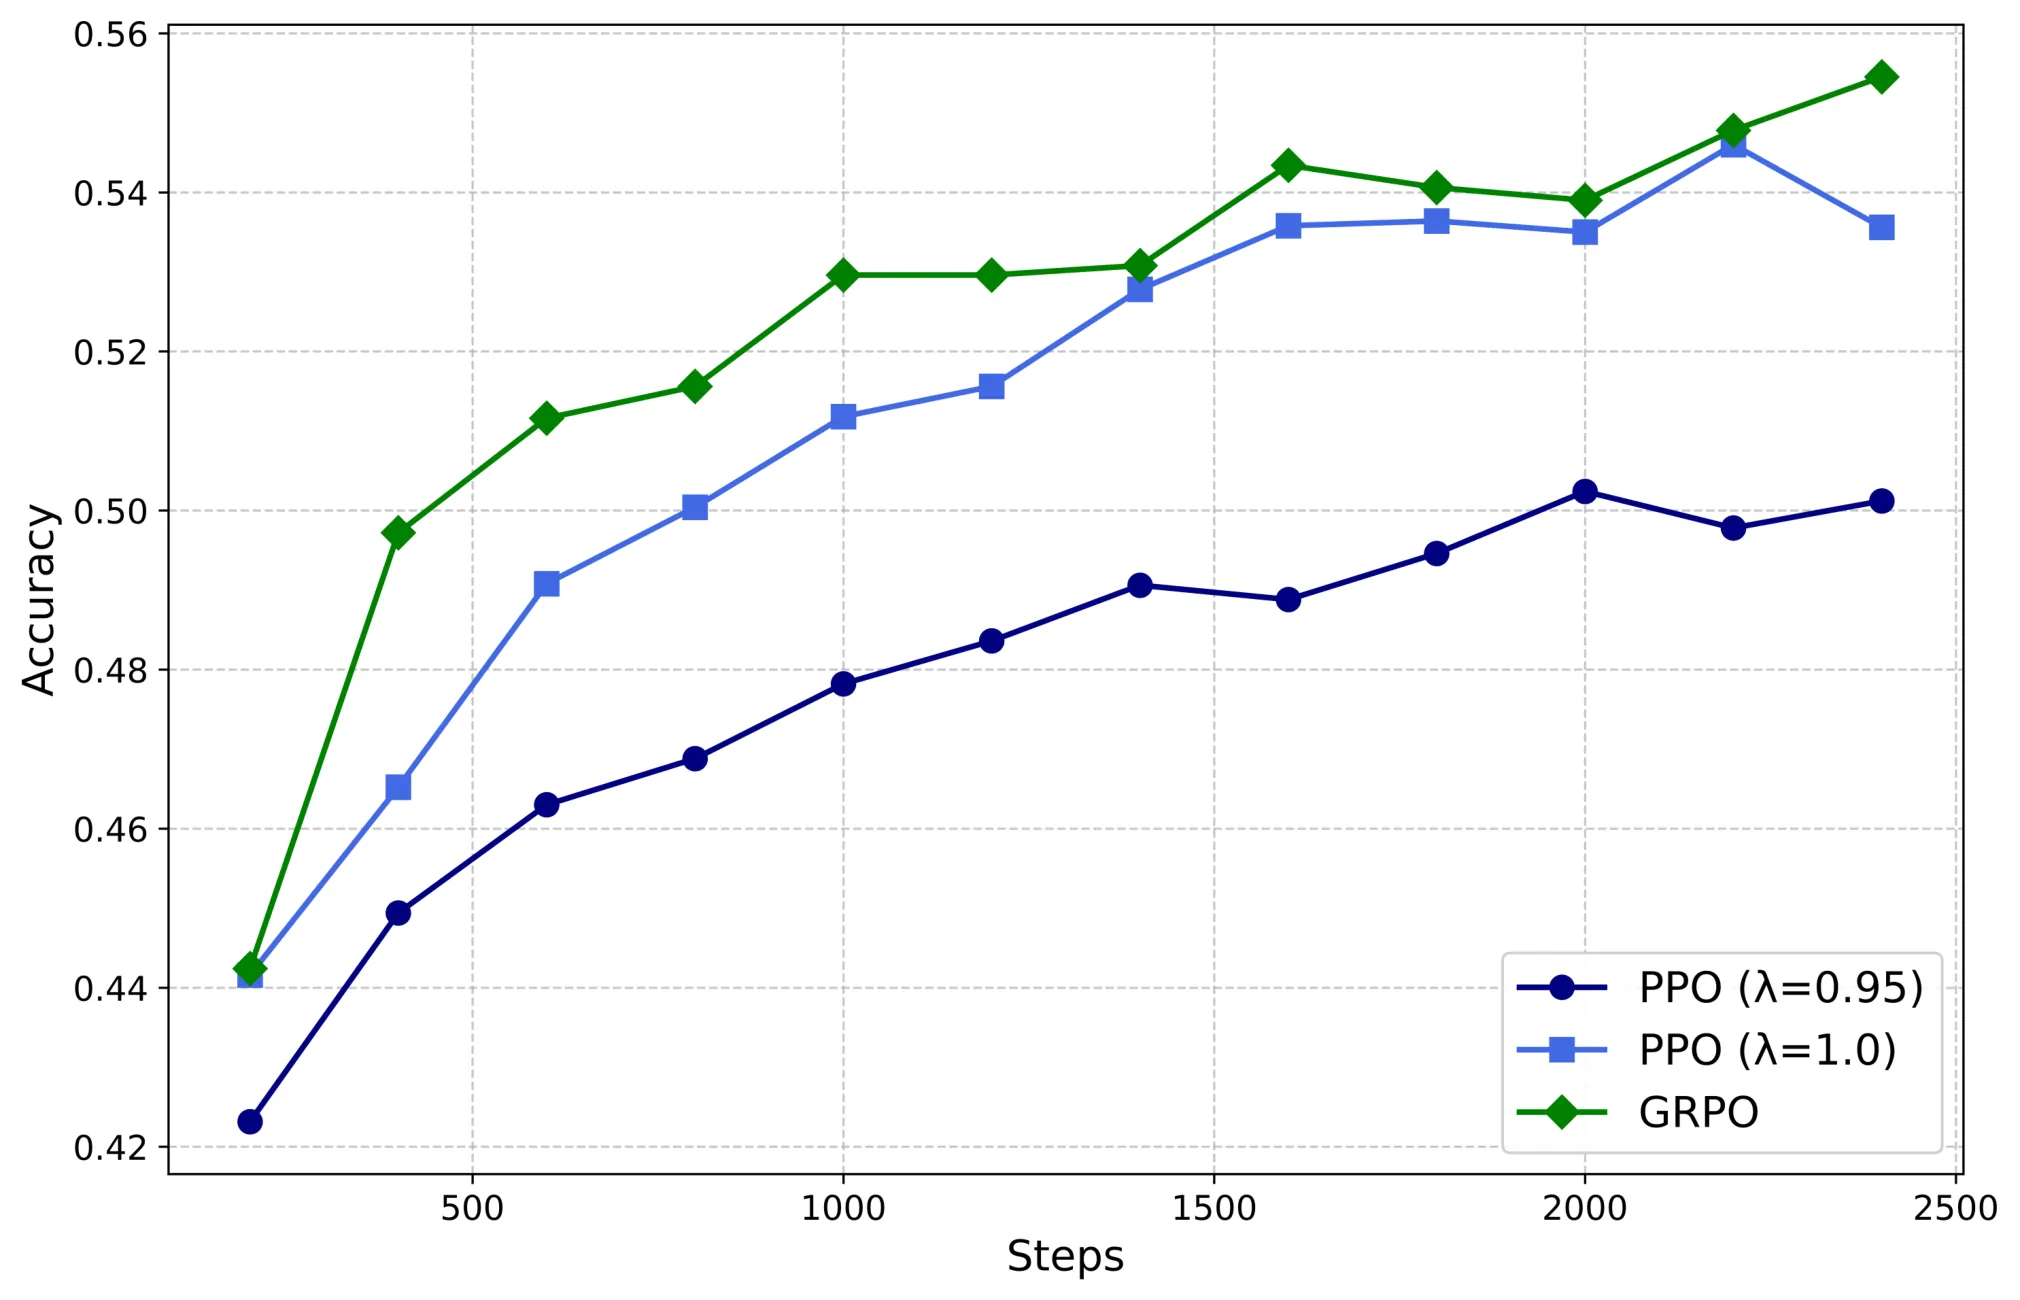
图源:DeepSeek-R1 技术报告 arXiv:2501.12948v2 附录 A.3 图 4。图中深蓝为 PPO(λ=0.95),浅蓝为 PPO(λ=1.0),绿色为 GRPO。
论文对此的总结是:PPO 在调好的情况下能达到接近 GRPO 的表现,但它需要额外的算力去做超参搜索;更重要的是,训练一个额外的价值模型所带来的内存与计算开销是实打实的。在大规模、资源受限的场景下,GRPO 是更务实的选择。
为了看清结构上的差别,下面这张图把两个算法并排画了出来:
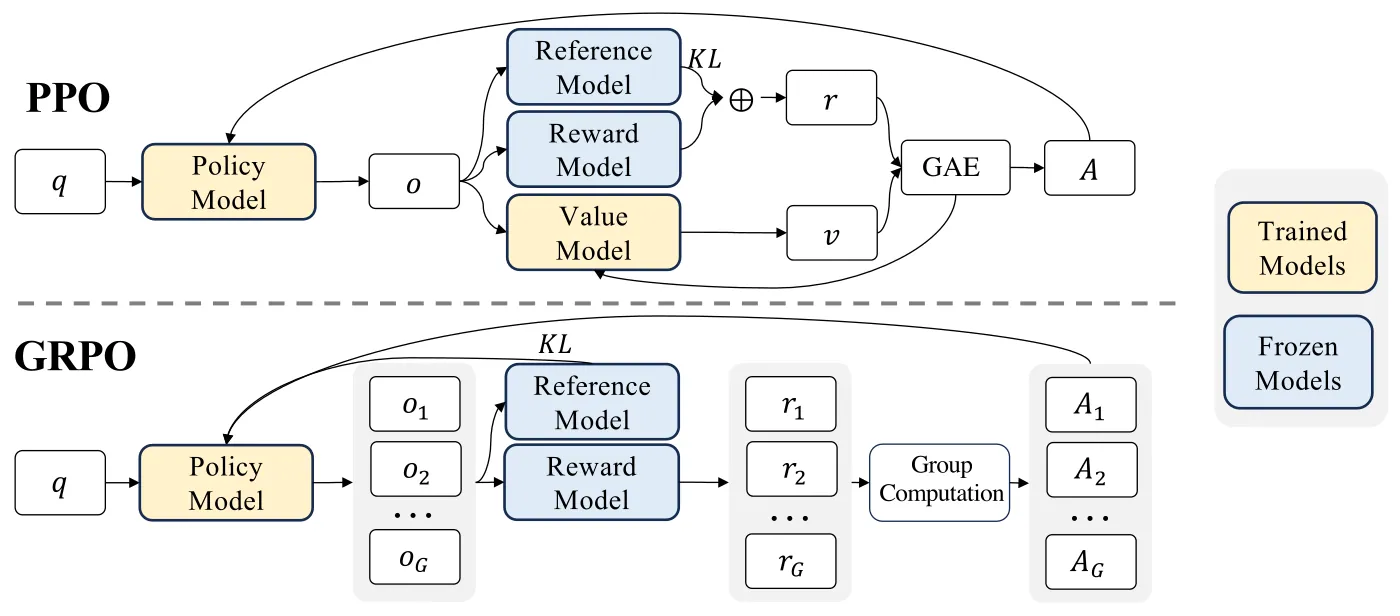
图源:DeepSeekMath 论文 arXiv:2402.03300v3 图 4。黄色为需要训练的模型,蓝色为冻结模型。
图的上半部分是 PPO:策略模型生成一条输出 ,输出同时被送进参考模型(算 KL)、奖励模型(算 )和价值模型(算 ),、 和 KL 一起进 GAE 得到优势 。注意图上这条从 绕回策略模型的弧线——那里同时走着”更新策略”和”通过价值函数的学习信号更新 critic”两件事。下半部分是 GRPO:策略模型生成 条输出,参考模型和奖励模型各跑一遍,得到 个奖励,再经过一个 Group Computation 模块算出 个优势。图上没有价值模型,蓝色的冻结模型只有两个,且从 KL 到策略模型的那条弧线不再需要经过优势计算——KL 直接进损失。
超参数与敏感性:从 DeepSeekMath 到 R1
DeepSeekMath 的配置
DeepSeekMath 论文给出的是最”教科书”的一组配置:
- 策略模型学习率
- KL 系数
- 组大小
- 最大长度 1024,训练 batch size 1024
- 每个问题在每次探索阶段之后只做一次策略更新(对应算法 1 里的内层迭代 )
- 奖励模型基于 DeepSeekMath-Base 7B 训练,学习率
- RL 数据是指令微调数据里 GSM8K 与 MATH 的思维链题目,约 144K 条
“每组样本只更新一次”这个设置值得强调。它意味着 GRPO 放弃了 PPO 那种”同一批采样数据反复多轮更新”的做法——因为一旦反复更新,重要性采样比会迅速偏离 1,裁剪频繁触发,梯度大面积被截断。用一次性更新,采样和更新严格配对,训练更稳,代价是样本效率低一些。R1 的配置同样是这个思路。
R1-Zero 与 R1 的配置
R1-Zero 的训练配置(R1 技术报告 v2 第 2.1 节):
- 学习率 ,KL 系数 0.001,rollout 采样温度 1
- 每个问题采样 16 条输出;在 8200 步之前最大长度 32768 token,之后放宽到 65536 token
- 每个训练步包含 32 个不同问题,训练 batch size 为 512
- 每 400 步把参考模型替换为最新的策略模型
- 每次 rollout 生成 8192 条输出,随机切成 16 个 minibatch,每个只训一个内层 epoch
- 总共训练 10400 步,约 1.6 个 epoch
注意 32768 → 65536 这个长度切换发生在第 8200 步。论文说,正是因为放开了最大长度限制,R1-Zero 的性能和响应长度在第 8200 步同时出现明显跳变——这直接印证了”长度上限是纯 RL 涌现长思维链的硬约束”。
R1 第一阶段 RL 的配置与 R1-Zero 基本一致,只有两处关键差异:GRPO 的裁剪比 被显式设为 10,以及引入了语言一致性奖励。第二阶段 RL 把采样温度降到 0.7(论文说这一阶段更高的温度会导致生成不连贯),总步数 1700 步,其中通用指令数据与偏好奖励只在最后 400 步引入。
裁剪比 :一个容易被忽略的关键超参
R1 论文专门用一句话强调裁剪比的作用:裁剪比较低会导致大量 token 的梯度被截断,从而降低模型性能;较高则可能导致训练不稳定。 而 R1 第一阶段把 设为 10。
把 10 代进裁剪区间 得到 。重要性采样比是一个概率之比,恒为非负,所以下界 -9 永远不会被触发;上界 11 意味着只有当当前策略对某个 token 的概率超过采样时策略的 11 倍时才会被截断。换句话说,在这组超参下,裁剪机制实际上几乎不生效,策略更新的幅度基本不受裁剪约束。论文给出的解释方向是”低裁剪值会截断大量 token 的梯度”,配合”每 400 步刷新参考模型”,R1 选择了放开更新幅度、用 KL 项和参考模型刷新来兜住稳定性。这也是一个典型的”论文数字要看上下文”的例子:单独看 会觉得离谱,放进”KL 系数 0.001 + 参考模型周期刷新 + 每组只更新一次”的整体配置里,它的角色就清楚了。
参考模型为什么要周期性刷新
R1 与 DeepSeekMath 都提到,随着训练进行,初始参考模型会越来越不能反映当前策略的分布。R1 的附录 A.3 说得更直白:在长思维链场景下训练动辄上千步,训练策略可能与初始参考策略差异巨大;为了在”允许探索的范围”和”训练稳定性”之间取得平衡,实际训练中会周期性地把参考模型更新为最新策略。R1-Zero 和 R1 第一阶段都是每 400 步刷新一次。
这个设计有一个容易被误读的后果:KL 项约束的不再是”离初始 SFT 模型有多远”,而是”离 400 步之前的自己有多远”。参考模型变成了一个滑动的锚点,防的是单步之间的剧烈漂移,而不是长期的能力偏移。
组大小 怎么选
是 GRPO 独有的超参,它同时决定了三件事:
- 优势估计的质量。前面算过,基线噪声的惩罚系数是 ,从 到 ,这个系数从 1.033 降到 1.008,改善非常有限。真正重要的是另一个效应: 越大,组内奖励越可能覆盖”全对”或”全错”之外的中间状态,优势信号越丰富。
- 采样成本。每个问题要生成 条完整回答, 意味着 64 倍于单条输出的解码开销。R1-Zero 每次 rollout 产出 8192 条输出、切成 16 个 minibatch,可以反推出一个训练步的采样规模是相当大的。
- 组内奖励的方差。如果 太小、任务又太简单(组内全是 1)或太难(组内全是 0),,优势全部退化为 0,这条问题就白采了。这是 GRPO 里一个实打实的工程坑:需要靠难度筛选(论文里的 RL 数据构成就是按难度挑过的)和足够大的 来避免。
DeepSeekMath 选 64,R1 选 16。这个差异不是对错问题,而是任务难度分布、单条输出长度、以及推理系统吞吐共同决定的——R1 的输出长度动辄几千 token, 再翻四倍的采样成本极其可观。
DeepSeek-R1-Zero:完全跳过 SFT 的纯 RL
R1-Zero 的实验设计目标只有一个:把”人类先验”这个变量彻底移除,看纯 RL 能走多远。所以它跳过 SFT 冷启动,直接对 DeepSeek-V3-Base 做 RL。
训练模板与规则奖励
R1-Zero 的提示词模板刻意做得很朴素(论文表 1),大意是:
A conversation between User and Assistant. The user asks a question, and theAssistant solves it. The assistant first thinks about the reasoning process inthe mind and then provides the user with the answer. The reasoning process andanswer are enclosed within <think>...</think> and <answer>...</answer> tags,respectively.
User: {prompt}. Assistant:论文强调,模板只约束结构格式,不注入任何内容层面的偏好——不要求反思、不推荐某种解题策略,目的就是干净地观察模型在 RL 过程中的自然演化。这一点是理解后续”aha moment”的前提:如果模板里写了”请检查你的答案”,那自我检查就只是指令跟随,而不是涌现。
奖励同样只有两个来源,都是规则化的:
- 准确性奖励:数学题要求把最终答案写在指定的框里,用规则做字符串匹配;代码题用编译器跑预定义测试用例。对就是对,错就是错。
- 格式奖励:要求把推理过程包在
<think>与</think>之间。两个奖励等权相加。
R1 论文明确说明,他们不使用神经奖励模型,无论基于结果还是基于过程。理由是:神经奖励模型在大规模 RL 中容易 reward hacking,重新训练它需要额外算力,还会让整条管线变复杂。
长度增长与 AIME 曲线
下面两张图是这篇文章里最重要的两张经验证据。
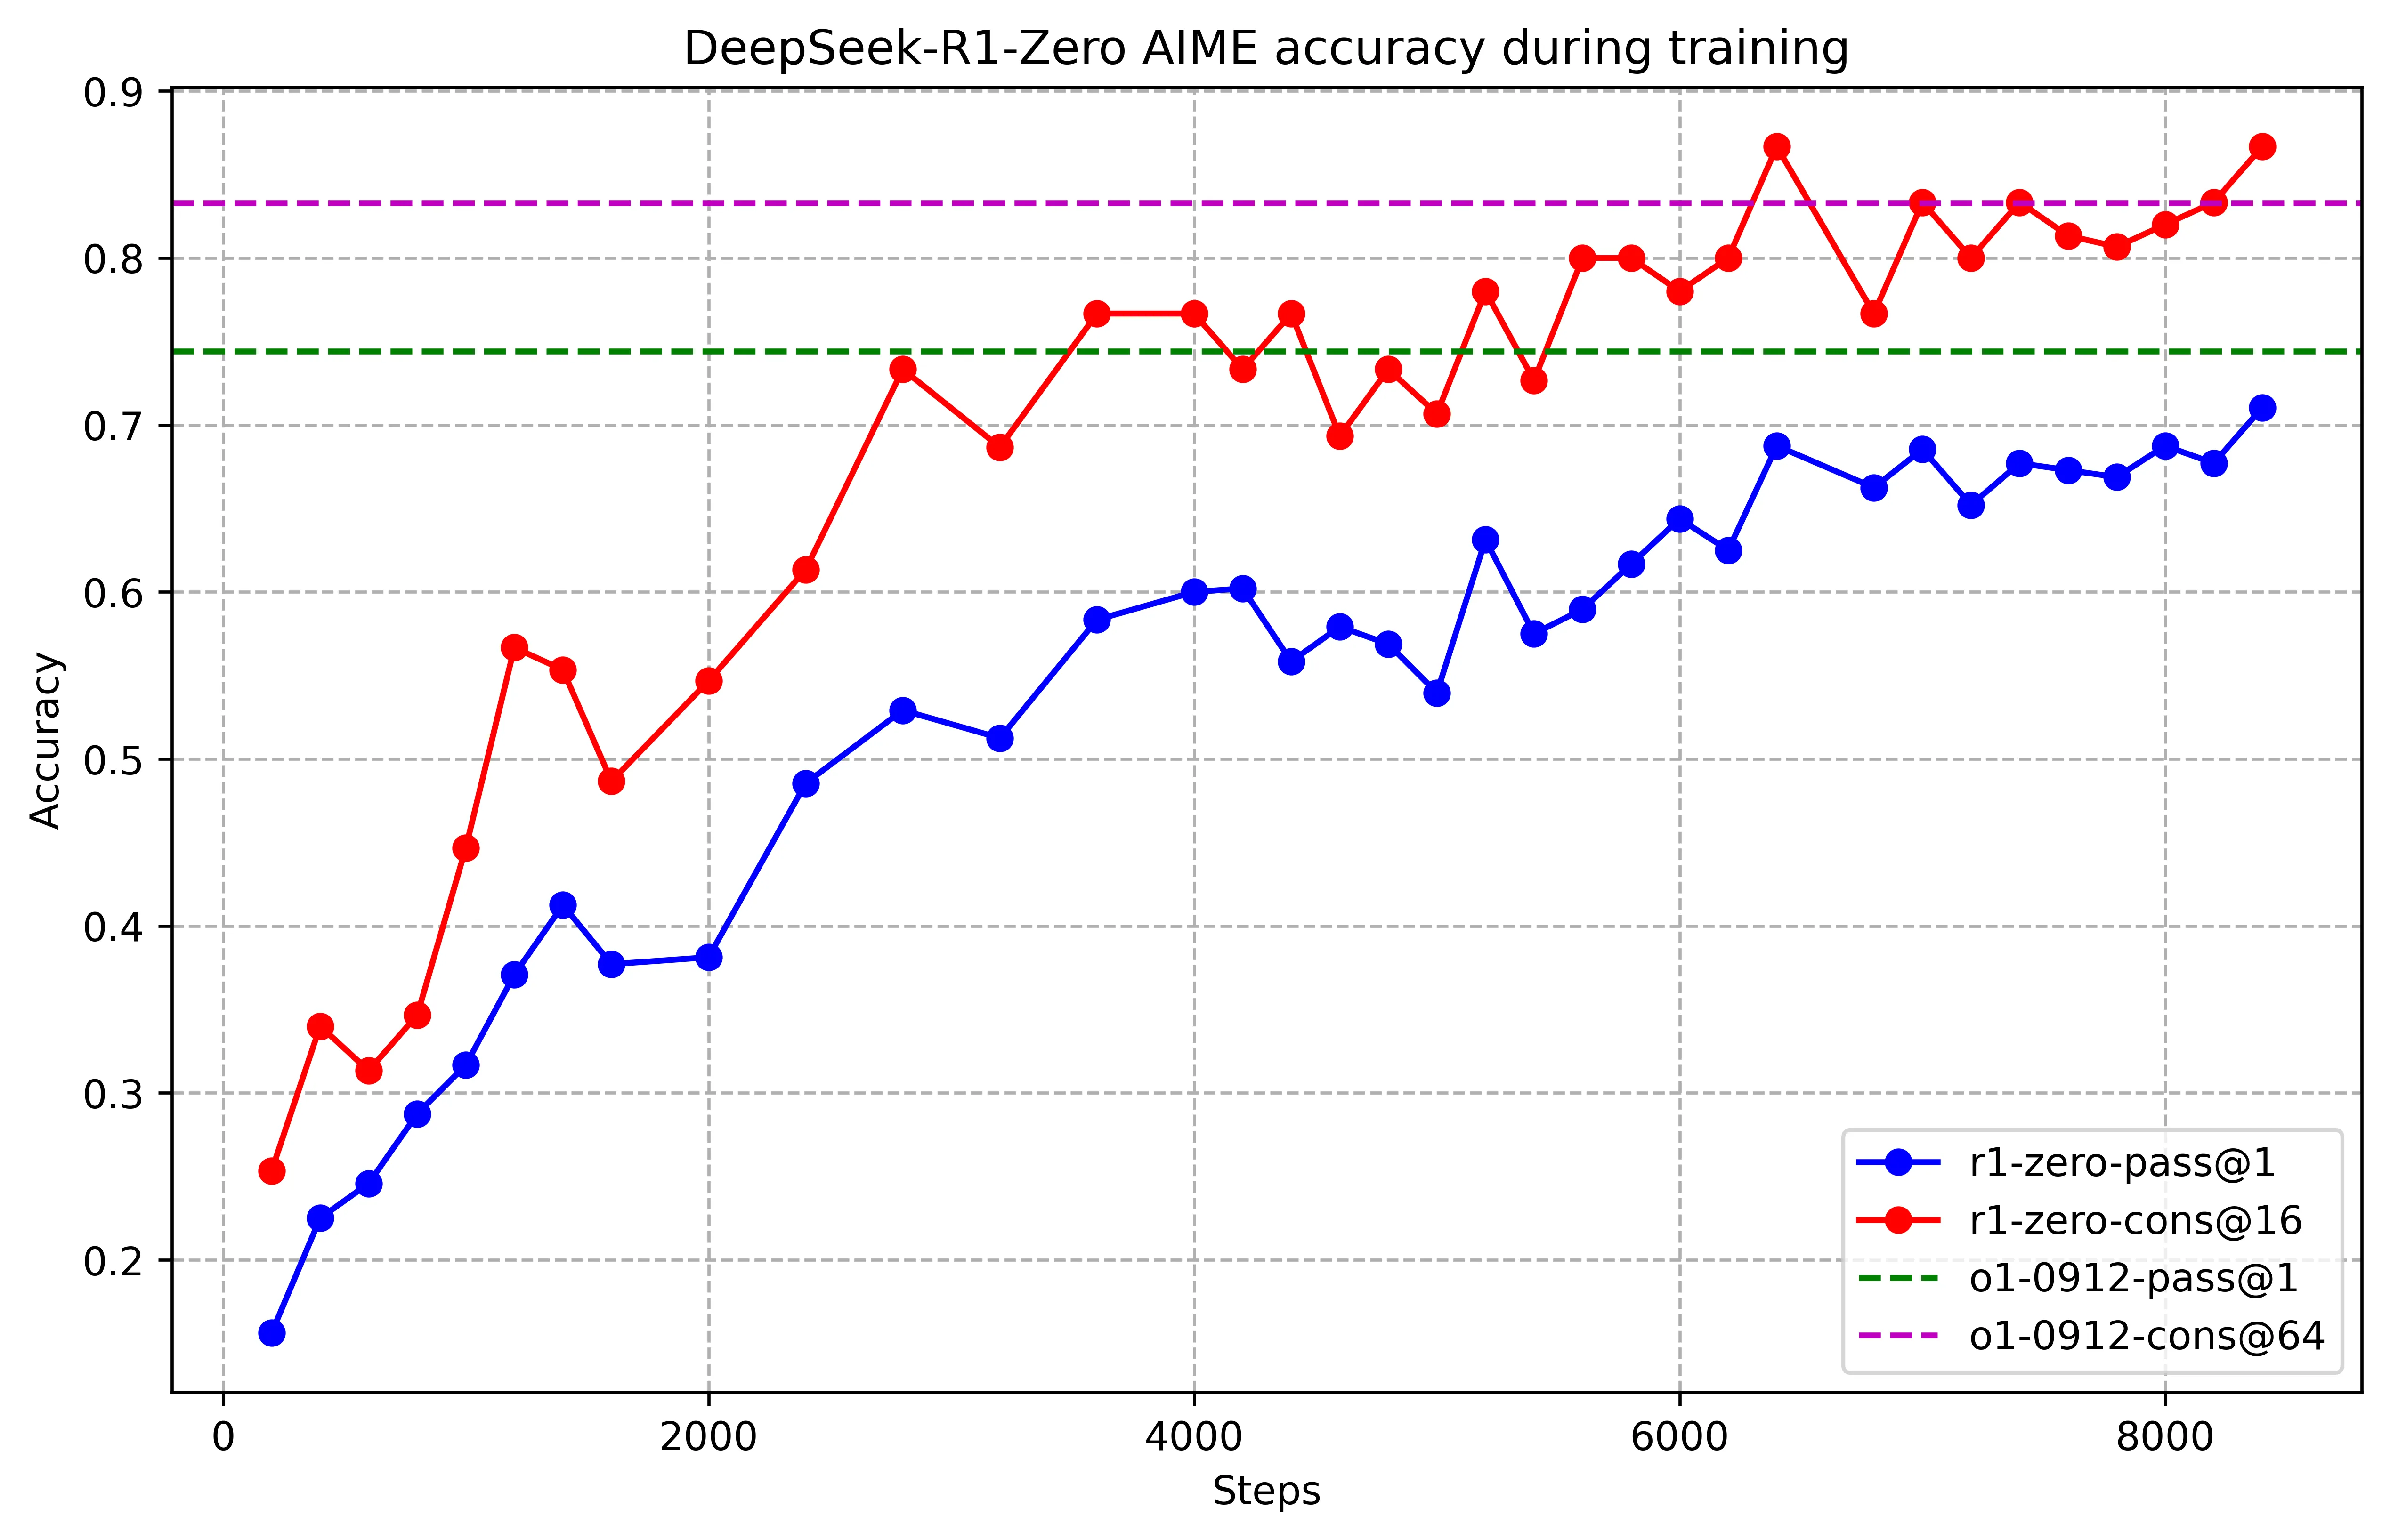
图源:DeepSeek-R1 技术报告 arXiv:2501.12948v1 图 2。红线为 cons@16(多数投票),蓝线为 pass@1,绿色虚线为 o1-0912 的 pass@1,紫色虚线为其 cons@64。
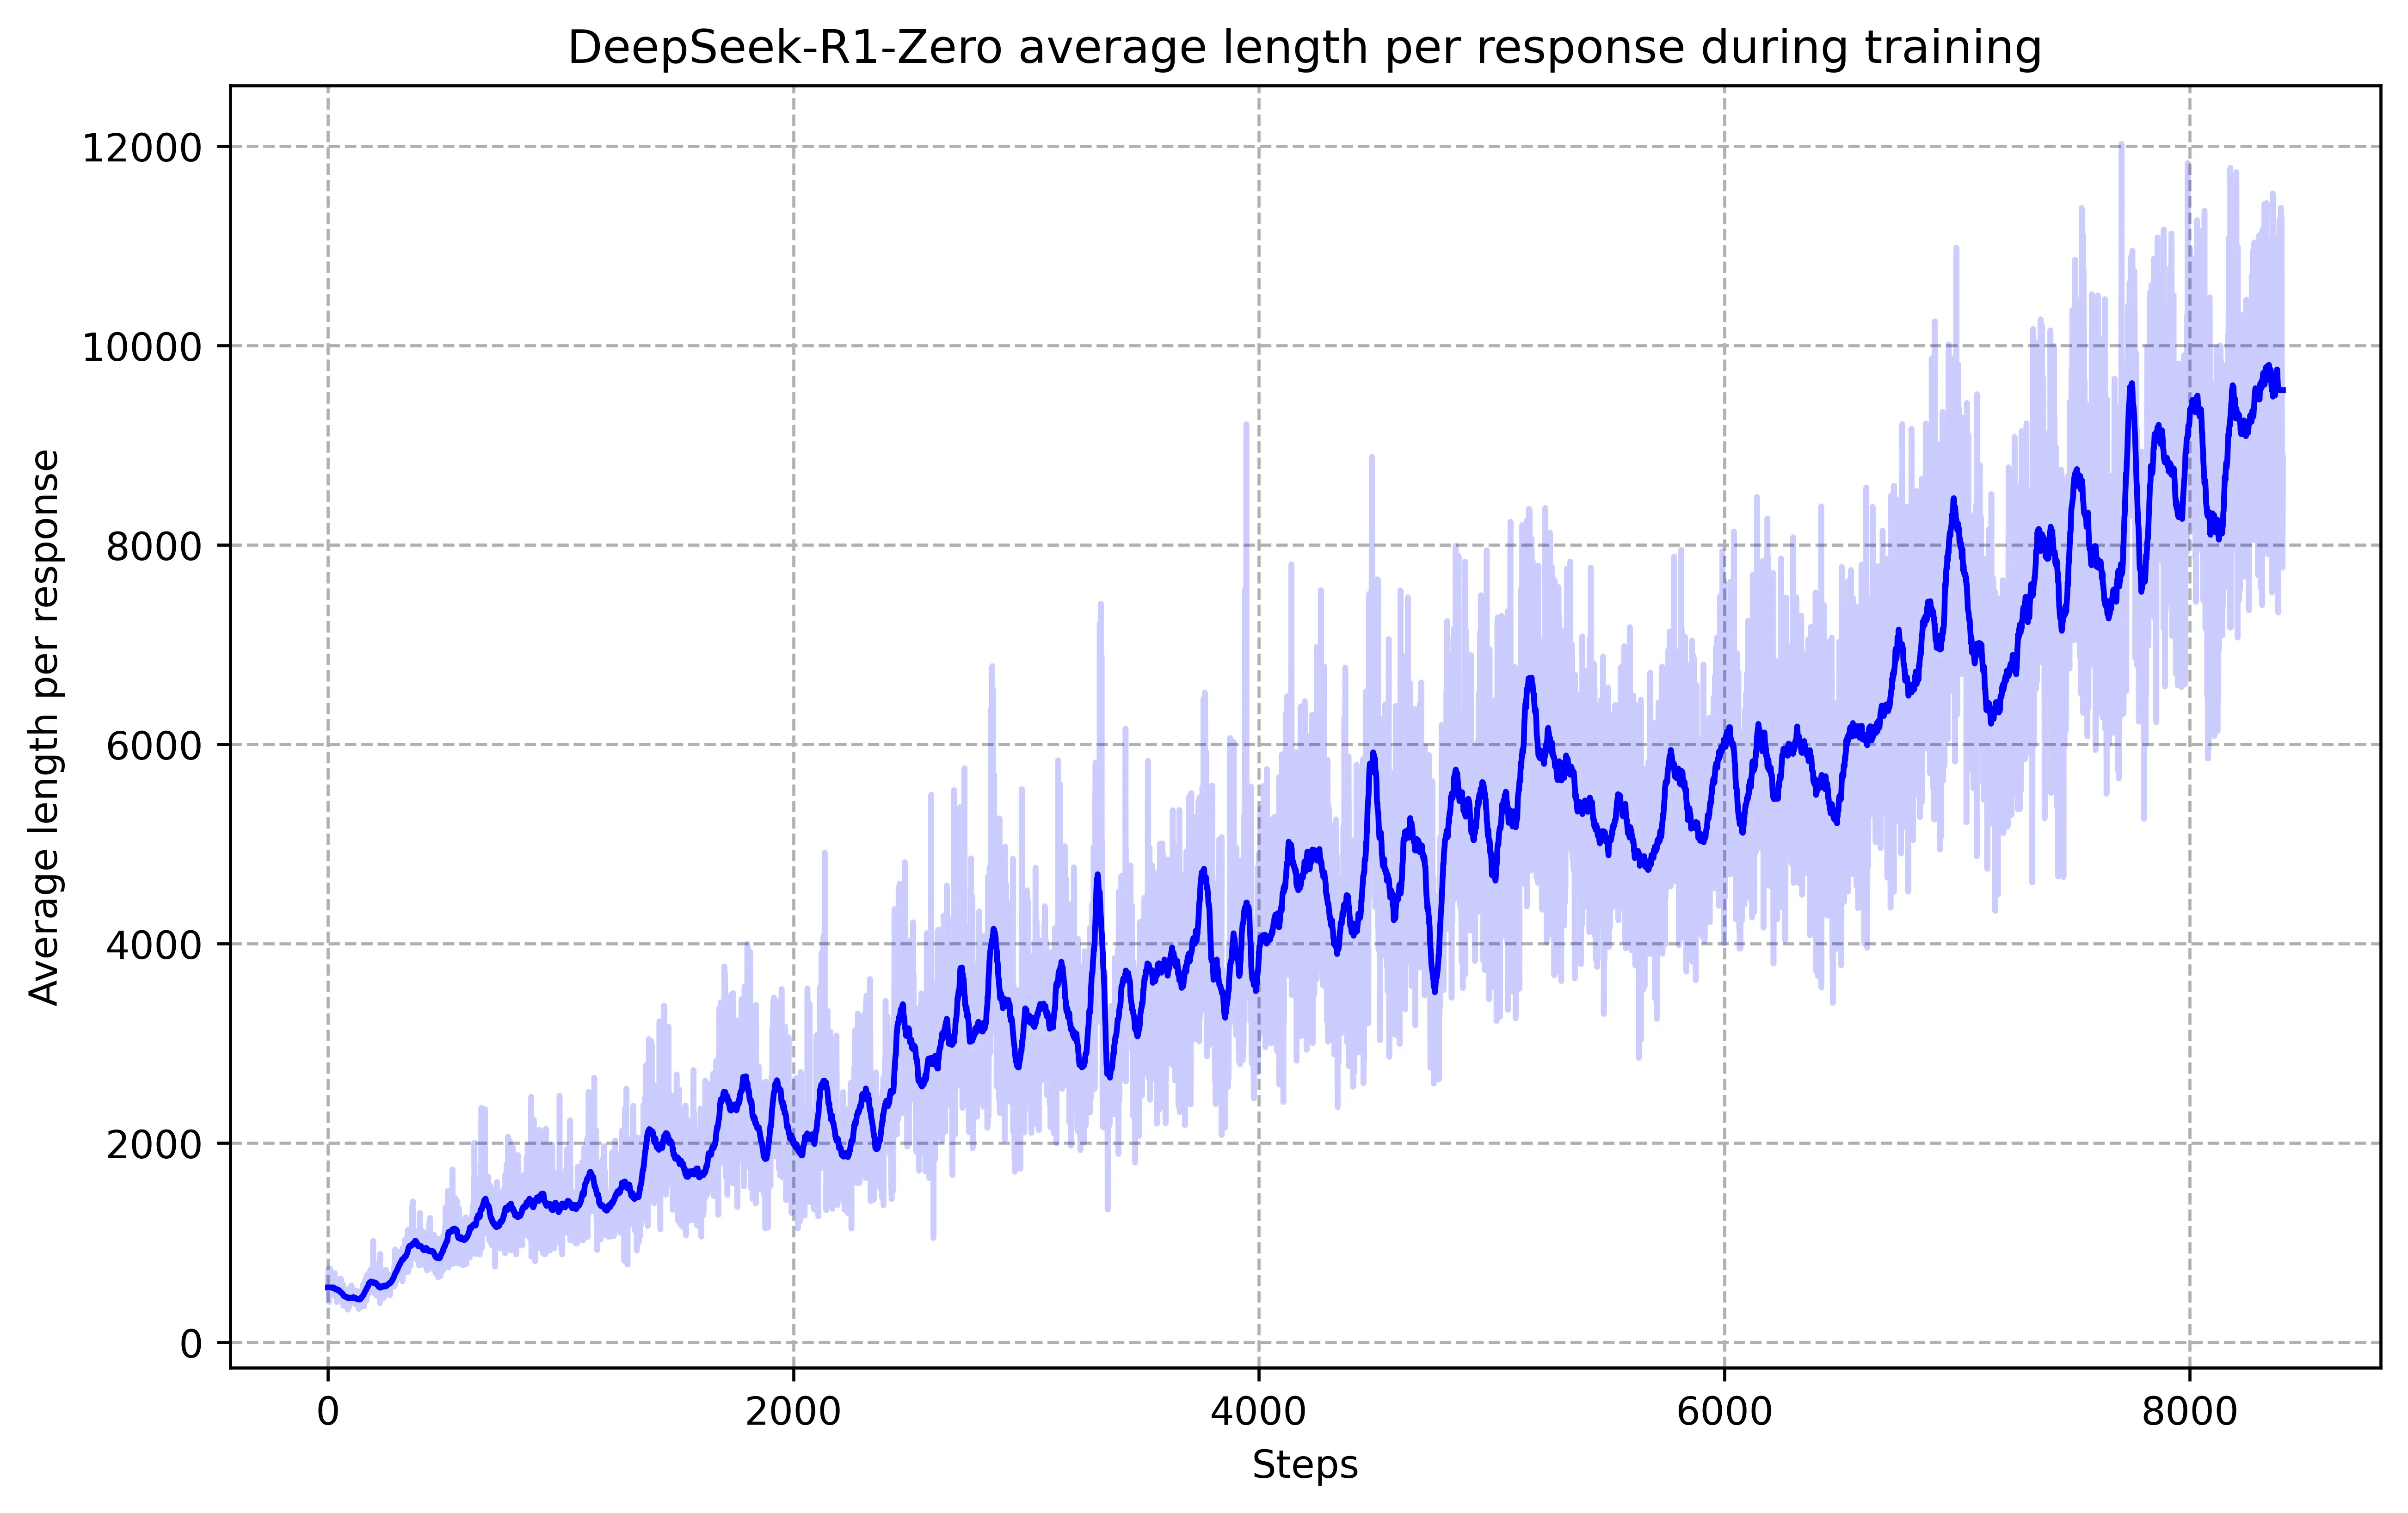
图源:DeepSeek-R1 技术报告 arXiv:2501.12948v1 图 3。深蓝为平均长度,浅蓝色带为波动范围。
两张图放在一起看,故事就完整了:
- AIME 2024 的 pass@1 从最初的 15.6% 一路涨到 71.0%(v1 数字;v2 修订版把这个数字更新为 77.9%),加上多数投票后 cons@64 达到 86.7%,超过了人类参赛者的平均成绩。
- 平均响应长度从最初的几百 token 单调涨到接近 10000 token,没有任何外部干预在推它变长——没有长度奖励,没有长度惩罚,唯一在变的只是”答对了给分”。
- 长度曲线在训练后期出现明显的锯齿放大,这与”模型开始学会在难题上多花、在简单题上少花”的行为一致。
论文的表述是:R1-Zero 通过延长测试时计算(test-time computation)自然获得了解决更复杂推理任务的能力,计算量从几百 token 扩展到几千 token;随着测试时计算增加,反思(回头重看并重新评估之前的步骤)和探索替代解法这类行为自发出现,它们不是被显式编程进去的,而是模型与 RL 环境交互的结果。
aha moment
论文表 2 记录了一个中间版本检查点的输出片段,这是整篇报告里传播最广的一段:
(前略,模型正在解 sqrt(a - sqrt(a+x)) = x,做完两次平方后得到四次方程)...Wait, wait. Wait. That's an aha moment I can flag here.Let's reevaluate this step-by-step to identify if the correct sum can be ...论文把这段称为 “aha moment”:模型在一段已经推进下去的推理中途突然停下来,用拟人化的口吻标记”这里有个顿悟点”,然后回头重新检查前面的步骤。论文的评价是:这不仅是模型的顿悟时刻,也是研究者的顿悟时刻,让人看到强化学习的力量与美感——研究者没有教模型怎么解题,只是给了它正确的激励,它自己发展出了高级的解题策略。
论文附录 C.2 给了这个现象一个量化版本:他们统计了一组反思词(wait、mistake、however、but、retry、error、verify、wrong、evaluate、check,由 3 位人类专家选出并合并成词表),发现随着训练推进,反思行为的频次相比训练初期上升了 5 到 7 倍;而更细的观察显示,“wait”这个词在训练早期几乎不出现,4000 到 7000 步之间偶尔使用,8000 步之后出现显著尖峰。也就是说,不同形式的反思是在训练的不同阶段分别学会的,而不是同步出现的。
论文附录 C.1 还按 MATH 数据集的难度分层(1 到 5 级)做了细分:简单题(1 到 3 级)很快达到 0.90 到 0.95 的准确率并保持稳定,4 级题从约 0.78 提升到 0.95,最难的 5 级题从约 0.55 提升到 0.90。真正的收益集中在困难问题上。
纯 RL 的代价:可读性与语言混杂
R1-Zero 的推理能力很强,但产出很难读。论文列了两个问题:
可读性差。回答里缺少便于阅读的 markdown 格式,答案不突出。更麻烦的是,它不天然使用第一人称——论文在讲冷启动数据构造时提到,R1-Zero 在解题时更倾向用”we”或者干脆回避人称,而 R1 更常用”I”。
语言混杂(language mixing)。这是 R1-Zero 最典型的问题:一条思维链里可能中英文混着写。R1 论文给出了归因——基座模型 DeepSeek-V3-Base 的训练数据以中英文为主,当 RL 提示词涉及多种语言时,CoT 就常常出现语言混杂。论文甚至单独做了一个消融实验(附录 B.6):在 DeepSeek-R1-Distill-Qwen-7B 上,不加语言一致性奖励时,语言一致性随训练步数逐渐恶化;加上之后能稳定保持。代价是数学基准上表现持平,代码基准上有轻微下降——论文承认这种对齐会带来性能的轻微退化,但它符合人类偏好,让输出更可读。
语言一致性奖励的形式非常朴素,就是目标语言词数占比:
它被直接加到最终奖励上,并且同时应用于推理数据和非推理数据——因为在第二阶段的全场景 RL 里,当提示词涉及多语言时,语言混杂同样会出现。
DeepSeek-R1 的四阶段管线
R1-Zero 证明了纯 RL 能激发出推理能力,但它不是个能用的产品:读起来难受,会中英混杂,而且只擅长可验证的推理任务,写作和开放问答能力有限。R1 的管线就是为了把这些缺口逐个补上。四个阶段的结构如下:
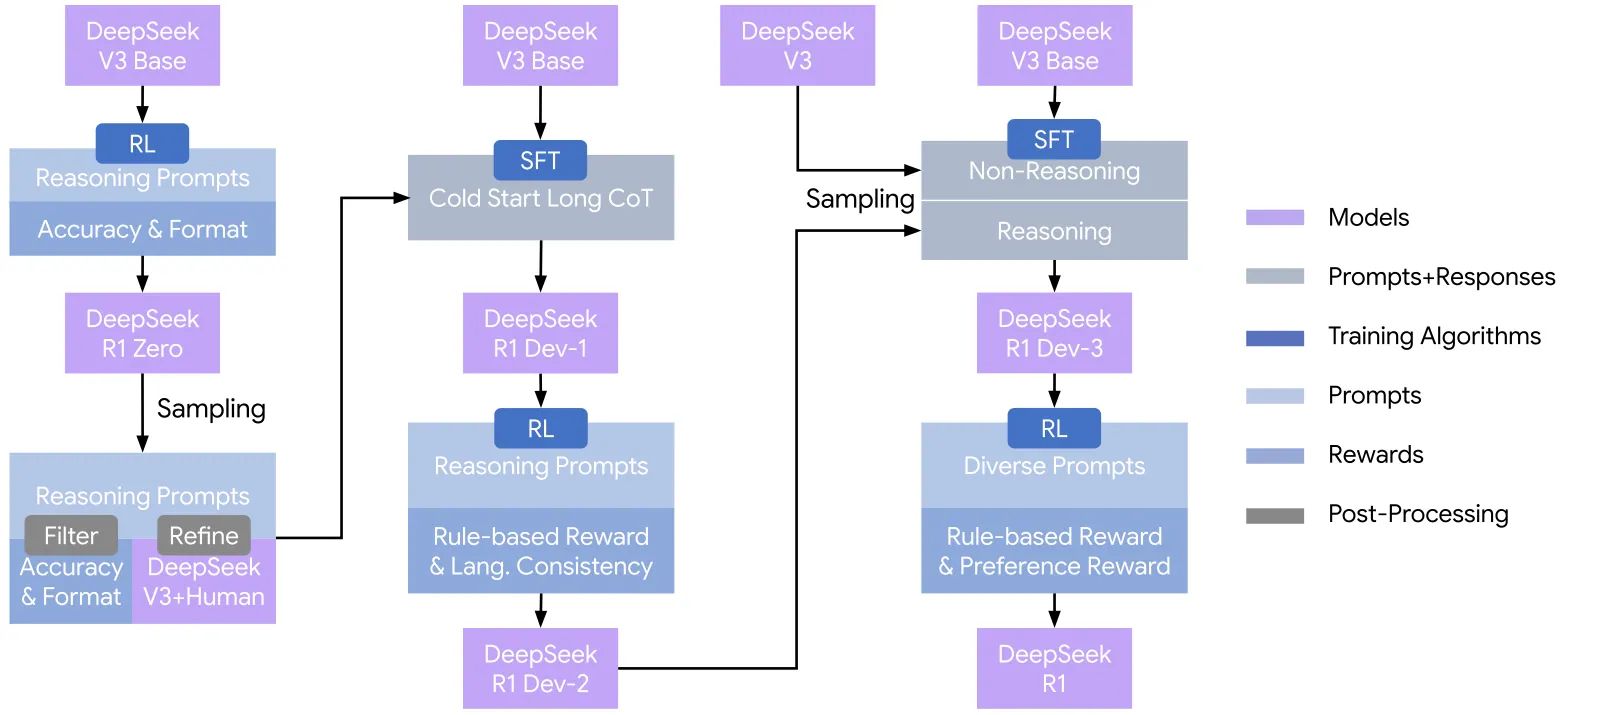
图源:DeepSeek-R1 技术报告 arXiv:2501.12948v2 图 2。紫色为模型,深蓝为训练算法,浅蓝为提示词,中蓝为奖励,灰色为后处理。
图里有四列,从左到右对应四个阶段,中间还夹着 Dev1、Dev2、Dev3 三个中间检查点,后面会逐个讲。
阶段一:冷启动 SFT
动机很直接:从基座模型直接做 RL,早期会有一段不稳定的冷启动期。R1 用一小批长思维链数据做微调,把它作为 RL 的初始 actor。论文也点出了这次冷启动的两个收益:可读性(设计了统一的输出格式,并在每条回答末尾附上总结,同时过滤掉不适合阅读的样本)和潜力(用带人类先验的冷启动数据后,表现优于 R1-Zero,论文认为迭代训练是更好的路径)。
冷启动数据是这样造出来的(附录 B.3.2):先让人类标注者把推理轨迹改写成更自然、更口语的对话风格;再用改写后的数据作为示例,提示一个大模型批量重写更多数据;所有模型生成的输出再经过第二轮人工验证以保证质量与一致性。论文给出的输出格式是 |special_token|<reasoning_process>|special_token|<summary>,其中 reasoning_process 是思维链,summary 用来总结推理结果。
这里有一段值得完整引述的自我限定。论文说,冷启动数据的动机主要是产品驱动的,重点是提升用户体验:用户会觉得推理过程符合第一人称思考模式时更直观、更有代入感;而对于 R1-Zero 那种要么用”we”要么不用人称的风格,论文承认这类生动的推理模式主要反映的是 DeepSeek 设计的启发式,不代表模型真的获得了类人的智能或自主解题能力。
阶段二:面向推理的 RL
冷启动微调之后,R1 复用与 R1-Zero 完全相同的大规模 RL 流程,目标是把推理能力继续做深,集中在代码、数学、科学、逻辑这类”问题定义清晰、答案可判定”的任务上。这一阶段的奖励是规则奖励加上语言一致性奖励,两者直接相加。
结果从检查点能看出来:R1-Dev1 在 IF-Eval 上从 R1-Zero 的 46.6 跳到 71.7,ArenaHard 从 53.6 跳到 77.0,可读性和指令跟随明显改善。但代价也很实在——由于冷启动数据集规模有限,Dev1 的推理性能相比 R1-Zero 出现了局部回退,AIME 2024 从 77.9 掉到 59.0。随后面向推理的 RL 才把这个能力重新拉回来并推得更高:Dev2 的 AIME 回到 74.0,Codeforces 从 R1-Zero 的 1444 分(80.4 百分位)涨到 1687 分(90.5 百分位),LiveCodeBench 从 50.0 涨到 63.5。
这条”先降后升”的曲线是四阶段管线里最反直觉的一段,也是最值得记住的一课:用人类风格的数据约束输出形式,会暂时损伤推理性能,需要靠后续 RL 重新赚回来。 论文的数据表明这笔账最终是划算的,但它不是免费的。
阶段三:拒绝采样与监督微调
当面向推理的 RL 收敛之后,用得到的检查点做拒绝采样,构造下一轮 SFT 数据。这一阶段的数据配比很关键:
推理数据(约 600k):从上一阶段 RL 的检查点做拒绝采样生成推理轨迹。这里有两个扩展:一是前一阶段只纳入能用规则奖励评估的数据,这一阶段引入了额外的数据,其中一部分用生成式奖励模型——把标准答案和模型预测一起喂给 DeepSeek-V3 让它判断对错;二是做了可读性过滤,把中英混杂的思维链、超长段落、以及含有代码块的思维链过滤掉。对每个提示采样多条回答,只保留正确的。
非推理数据(约 200k):写作、事实问答、自我认知、翻译等,直接复用 DeepSeek-V3 的 SFT 数据集;同时加入了软件工程相关数据,包括程序修复和前端网页开发。对于某些非推理任务,会先让 DeepSeek-V3 生成一段潜在的思维链再作答;但对”hello”这类简单查询不提供思维链。
两部分合起来约 800k 条样本,对 DeepSeek-V3-Base 微调 2 个 epoch。附录 B.3.3 给出了完整的数据统计:
| 领域 | 样本数 | 平均轮数 | 平均 token 数 |
|---|---|---|---|
| 数学 | 395285 | 1.0 | 6094.2 |
| 代码 | 211129 | 1.1 | 7435.7 |
| STEM | 10124 | 1.0 | 4928.8 |
| 逻辑 | 10395 | 1.0 | 2739.0 |
| 通用 | 177812 | 1.1 | 1419.8 |
| 合计 | 804745 | 1.0 | 5355.3 |
这张表里藏着一个容易被忽略的事实:数学与代码两类加起来占了全部样本的 75%,平均长度超过 6000 token,而通用领域样本的平均长度只有 1420 token。 这解释了为什么 R1 在推理基准上表现极强、而在通用任务上只是”够用”。论文也提醒,数据集里绝大部分是单轮交互,这会限制多轮对话能力。
对 800k 数据做 SFT 的超参是:学习率从 余弦衰减到 ,最大上下文 32768 token,batch size 128,训练 2 到 3 个 epoch。
Dev3 检查点的数字印证了这一阶段的作用:AlpacaEval 2.0 从 Dev2 的 55.8 跳到 62.1,Aider-Polyglot 从 25.6 跳到 44.8,同时推理能力基本保持(AIME 78.1、MATH-500 95.4)。
阶段四:全场景 RL
最后一个阶段是把模型拉回人类偏好上:既要提升有用性和无害性,又不能让推理能力退化。做法是混合奖励信号与混合提示词分布。
推理数据沿用 R1-Zero 的规则奖励体系(数学、代码、逻辑)。通用数据则引入两个奖励模型:
- 有用性奖励模型:用竞技场式的成对比较数据训练。构造偏好对时,每个 pair 让 DeepSeek-V3 判 4 次、随机交换 A/B 位置以抵消位置偏差,取 4 次判断的平均作为最终分数,只保留分差大于 1 的 pair;同时控制被选与拒绝两条回答的长度可比,以减少长度偏差。最终得到 66000 条偏好对。它的架构与 R1 一致,只是加了一个预测标量偏好分的奖励头。训练 1 个 epoch,batch 256,学习率 ,最大序列长度 8192。
- 安全性奖励模型:106000 条带”安全/不安全”标注的提示词,用逐点(point-wise)而非成对的方式训练,区分安全与不安全回答,其余超参与有用性奖励模型相同。
最终的奖励是三项相加:
其中 reasoning 项就是规则奖励,general 项是奖励模型分加上格式奖励。这一阶段总步数 1700 步,通用指令数据与偏好奖励只在最后 400 步引入,采样温度降到 0.7(论文发现更高温度在这一阶段会导致生成不连贯)。论文明确写了后半句原因:如果带着基于模型的偏好奖励信号训练更多步,就会出现 reward hacking。
失败模式:奖励 hacking 出现的时刻
R1 论文附录 B.5 记录了这件事的具体形态:在使用有用性奖励模型时,如果奖励模型本身含系统性偏差或不准确,模型会学会生成”被奖励模型打高分、但偏离真实人类偏好”的回答。这种错配的表现是复杂推理任务上的性能退化——论文给出的证据是,训练过程中奖励值持续上升,而 Codeforces 上的表现却在下降。
这就是为什么阶段四被卡在 1700 步、通用数据只在最后 400 步引入。也解释了 R1 论文在结论部分的一段判断:纯 RL 的成功依赖可靠的奖励信号,在推理域可以用规则奖励保证,但在写作这类任务上很难构造出同样可靠的奖励模型;一旦奖励由模型而非规则给出,它就更随训练推进而被钻空子。论文的应对是——对拿不到可靠信号的任务,用人工标注构造监督数据,并且只做几百步 RL。
四个阶段的总览数字
把各检查点的关键指标放在一起(R1 论文表 3 与表 8):
| 基准 | R1-Zero | R1-Dev1 | R1-Dev2 | R1-Dev3 | R1 |
|---|---|---|---|---|---|
| AIME 2024 (Pass@1) | 77.9 | 59.0 | 74.0 | 78.1 | 79.8 |
| MATH-500 (Pass@1) | 95.9 | 94.2 | 95.9 | 95.4 | 97.3 |
| Codeforces (Rating) | 1444 | 1534 | 1687 | 1746 | 2029 |
| LiveCodeBench (Pass@1-COT) | 50.0 | 57.5 | 63.5 | 64.6 | 65.9 |
| GPQA Diamond (Pass@1) | 75.8 | 66.1 | 70.7 | 71.2 | 71.5 |
| IF-Eval (Prompt Strict) | 46.6 | 71.7 | 72.0 | 78.1 | 83.3 |
| AlpacaEval 2.0 (LC-winrate) | 24.7 | 50.1 | 55.8 | 62.1 | 87.6 |
| ArenaHard (GPT-4-1106) | 53.6 | 77.0 | 73.2 | 75.6 | 92.3 |
读这张表有几个要点:
- IF-Eval 和 ArenaHard 的大跳跃发生在 Dev1,那是冷启动 SFT 的功劳。
- AIME 与 GPQA 在 Dev1 明显回退,Dev2 才恢复并超越,那是面向推理 RL 的功劳。
- AlpacaEval 2.0 在 Dev3 大幅提升(62.1),那是 200k 非推理数据的功劳;而最终从 62.1 到 87.6 的跃升发生在阶段四,那是全场景 RL 的功劳。论文对这一阶段的总结是:代码与数学基准只有边际改善——因为大量推理相关的 RL 已经在前面几个阶段做完了——最终 R1 的主要进步集中在通用指令跟随与用户偏好基准上。
- GPQA Diamond 从 R1-Zero 的 75.8 一路跌到 R1 的 71.5,这是个值得注意的反例:安全与偏好对齐确实带来了一些代价。
训练基础设施与成本
R1 论文的附录 B.1 给出了 RL 框架的结构,值得单独讲,因为它解释了”为什么 GRPO 省下来的显存能真正变成吞吐”。
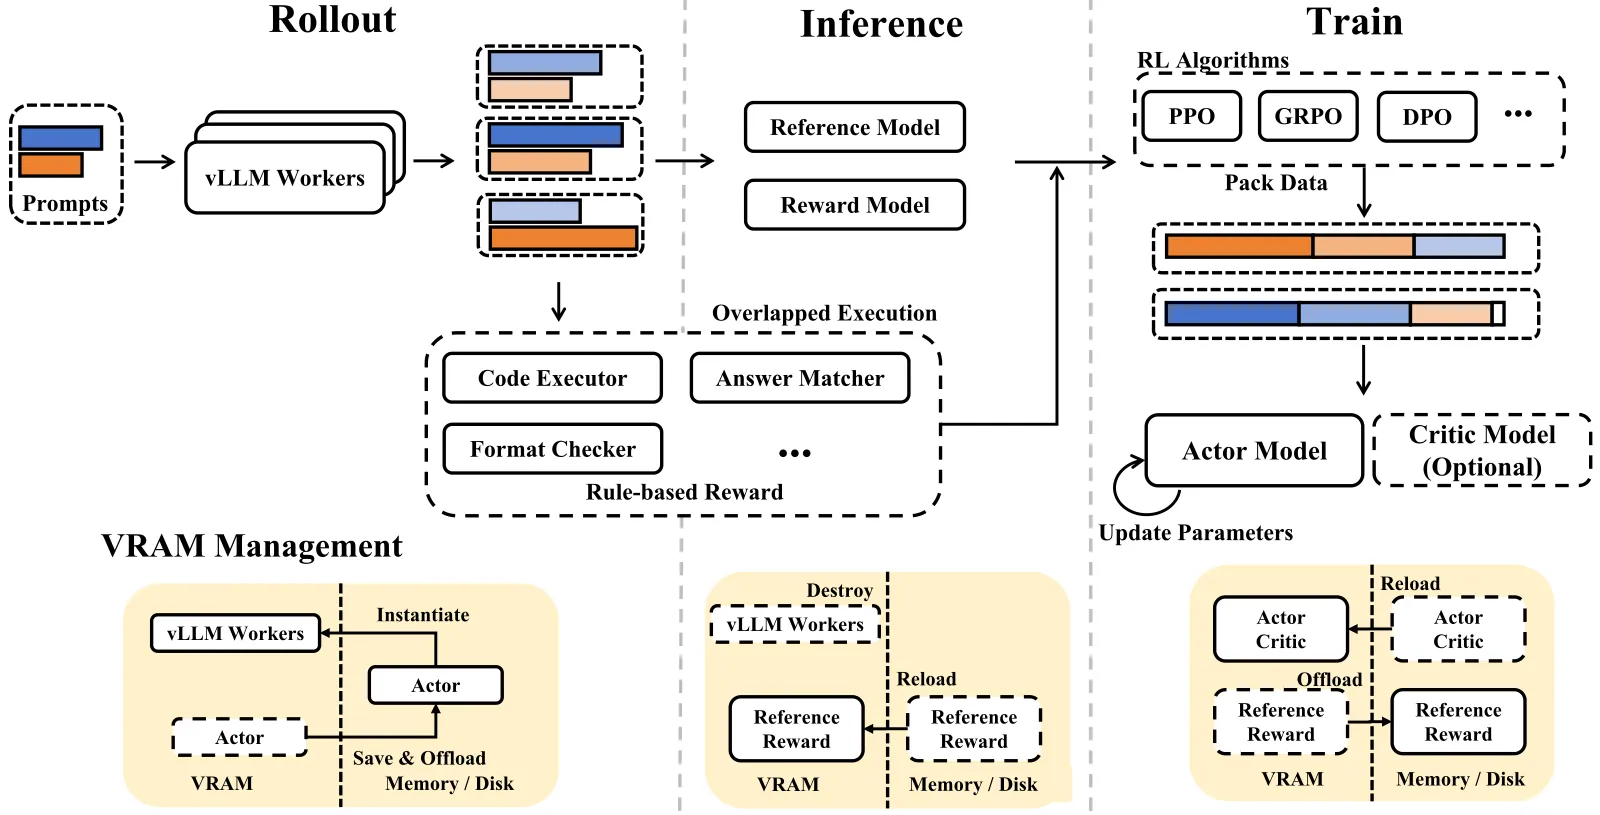
图源:DeepSeek-R1 技术报告 arXiv:2501.12948v2 图 5。
框架被切成四个模块,对应 RL 流水线的四个阶段:
- Rollout 模块:把提示词均匀分发到多个 vLLM worker,每个 worker 装载 actor 模型,采样多条回答。针对 DeepSeek-V3 的 MoE 架构,跨节点实现专家并行以降低访存开销,并为热点专家部署冗余副本以均衡负载。这里还用到了 MTP 组件做自投机解码(可参考 MTP 完全拆解,MTP 的共享主干未来 token 预测在这里被当成草稿引擎用),显著加快解码速度、压低最长样本的完成时间。
- Inference 模块:加载奖励模型与参考模型,对 rollout 阶段生成的样本做前向,得到基于模型的奖励和其他必要信息。
- 规则奖励模块:计算规则奖励。它不需要把模型加载到显存里,但执行往往很耗时(跑测试用例、匹配答案),所以采用异步调度,与 Rollout 和 Inference 模块重叠执行,把延迟藏起来。
- 训练模块:装载 actor,需要时也装载 critic,算损失并更新参数。它支持 PPO、GRPO、DPO 等多种算法。为了减少 padding 浪费并均衡负载,做了两级数据打包:先把全局 batch 按长度排序分到数据并行组的各进程,再在各进程内用 Best-Fit 策略装箱到固定长度块里,最后把所有进程的块数调成一致;并接入了 DeepSeek-V3 训练时用的 DualPipe 做流水线并行。
最下面一行是显存管理,也是这套框架的关键:每个模块执行完之后(规则奖励模块除外),该阶段用到的模型实例会自动从显存卸载到内存或磁盘,把显存让给下一个阶段。这正是 GRPO 能落地的原因——省掉 critic 之后,同一组 GPU 上需要共存的模型副本只剩策略、参考和奖励三个,再配合阶段间的 offload/reload,显存压力才真正降下来。
成本方面,论文附录 B.4.4 给出了非常具体的数字,按 H800 每小时 2 美元的租用价估算:
| 项目 | H800 GPU 小时 | 折算成本 |
|---|---|---|
| DeepSeek-R1-Zero 训练 | 101K | 202K 美元 |
| SFT 数据构造 | 5K | 10K 美元 |
| DeepSeek-R1 训练 | 41K | 82K 美元 |
| 合计 | 147K | 294K 美元 |
论文还写了执行细节:R1-Zero 用 64 台 8 卡 H800(共 512 张卡)训练约 198 小时,R1 用同样的配置约 80 小时(约 4 天)。前期他们先用 30B 参数的小模型在 A100 上做实验,结果可信之后才放大到 660B 级别的 R1-Zero 和 R1。
把这张表和”训练一个与 671B 策略同规模的 critic”放在一起看,GRPO 到底节省了多少就不需要再解释了。
蒸馏:把长思维链搬到 1.5B 到 70B
R1 的最后一个贡献是蒸馏。论文的动机很朴素:大模型能耗高,需要高性能 GPU 和大量电力,这构成了普惠 AI 的现实门槛。做法是把 R1 生成的 800k 样本直接拿去微调开源小模型——注意,蒸馏的是数据,不是 logits。
蒸馏数据与训练细节
基础模型与初始学习率的对应关系(论文表 6):
| 蒸馏模型 | 基座模型 | 初始学习率 |
|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct |
训练超参:用 800k 数据微调 2 到 3 个 epoch,余弦衰减到初始学习率的十分之一,最大上下文长度 32768 token,batch size 64。论文特意选了 Llama-3.3 而不是 Llama-3.1 的 70B,因为它的推理能力略好。
有一点必须强调:这些蒸馏模型只做了 SFT,没有做任何 RL 阶段。论文说得很清楚——加上 RL 本可以进一步提升性能,但这里的主要目的是展示蒸馏本身的效果,RL 的部分留给社区去探索。
各尺寸的结果
| 模型 | AIME 2024 Pass@1 | AIME 2024 cons@64 | MATH-500 | GPQA Diamond | LiveCodeBench | Codeforces 评分 |
|---|---|---|---|---|---|---|
| GPT-4o-0513 | 9.3 | 13.4 | 74.6 | 49.9 | 32.9 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 26.7 | 78.3 | 65.0 | 38.9 | 717 |
| OpenAI-o1-mini | 63.6 | 80.0 | 90.0 | 60.0 | 53.8 | 1820 |
| QwQ-32B-Preview | 50.0 | 60.0 | 90.6 | 54.5 | 41.9 | 1316 |
| R1-Distill-Qwen-1.5B | 28.9 | 52.7 | 83.9 | 33.8 | 16.9 | 954 |
| R1-Distill-Qwen-7B | 55.5 | 83.3 | 92.8 | 49.1 | 37.6 | 1189 |
| R1-Distill-Qwen-14B | 69.7 | 80.0 | 93.9 | 59.1 | 53.1 | 1481 |
| R1-Distill-Qwen-32B | 72.6 | 83.3 | 94.3 | 62.1 | 57.2 | 1691 |
| R1-Distill-Llama-8B | 50.4 | 80.0 | 89.1 | 49.0 | 39.6 | 1205 |
| R1-Distill-Llama-70B | 70.0 | 86.7 | 94.5 | 65.2 | 57.5 | 1633 |
论文从这张表里读出的结论有三条:1.5B 的蒸馏模型在 AIME 上拿到 28.9%、MATH-500 上拿到 83.9%,已经全面超过 GPT-4o 和 Claude-3.5-Sonnet;14B 的模型在所有评测指标上超过 QwQ-32B-Preview——用一个不到一半参数量的模型;32B 和 70B 的版本在大多数基准上显著超过 o1-mini。
一个特别值得注意的对比是 1.5B 与 32B 的 cons@64:1.5B 的 pass@1 只有 28.9%,但 cons@64 冲到 52.7%;32B 是 72.6% 对 83.3%。这说明蒸馏学到的不仅是”答对”,还有”长思维链 + 多数投票”这套测试时计算的用法——小模型也学会了写完长链再聚合。
蒸馏 vs 直接对 小模型做 RL
这是 R1 论文里最有分量的一个对照实验。问题很直接:不蒸馏,直接按 R1 的方法对小模型做大规模 RL,能追平蒸馏吗?
论文在 Qwen2.5-32B-Base 上做了超过 10000 步的大规模 RL,用数学、代码、STEM 数据训练,得到 Qwen2.5-32B-Zero,然后三方对比:
| 模型 | AIME 2024 Pass@1 | AIME 2024 cons@64 | MATH-500 | GPQA Diamond | LiveCodeBench |
|---|---|---|---|---|---|
| QwQ-32B-Preview | 50.0 | 60.0 | 90.6 | 54.5 | 41.9 |
| Qwen2.5-32B-Zero(直接 RL) | 47.0 | 60.0 | 91.6 | 55.0 | 40.2 |
| R1-Distill-Qwen-32B(蒸馏) | 72.6 | 83.3 | 94.3 | 62.1 | 57.2 |
论文的结论有两条:
第一,把更强的模型蒸馏到小模型上效果极好,而小模型自己靠大规模 RL 需要极大的算力,甚至可能达不到蒸馏的效果。 32B 的纯 RL 模型只能和 QwQ-32B-Preview 打平,而蒸馏版本在所有基准上大幅领先。
第二,蒸馏既经济又有效,但想突破智能的边界,仍然需要更强的基座模型和更大规模的强化学习。
论文还给了一个控制变量更严的实验来支撑”纯 RL 确实能提升推理”,用的是 2024 年 8 月发布的 Qwen2-Math-7B——它早于 2024 年 9 月的 o1,可以确保基座模型没有接触过任何推理轨迹数据。他们训练了约 10000 步策略梯度更新,得到 Qwen2-Math-7B-Zero:AIME 2024 平均分 22.3%、AIME 2025 平均分 18.1%,而同源的 Qwen2-Math-7B-Instruct 只有 7.9% 和 4.6%,GPT-4o-0513 在 AIME 2024 上是 9.3%。纯 RL 确实从零拉起了推理能力,只是拉起的幅度远不如”蒸馏一个更强的模型”。
论文附录 G.1 还记录了一条失败经验,很有参考价值:早期他们用 7B 稠密模型和 16B MoE 模型作为 RL 的基座,在 AIME 上始终无法获得有意义的提升——随着响应长度增加,这些小模型表现出重复倾向,无法有效利用长思维链来提升准确率。换成 32B 稠密、230B MoE、671B MoE 之后才观察到显著收益。论文的结论是:从基座做 RL 的效果高度依赖模型容量。 这一条与前面”蒸馏 vs RL”的结论互为印证:小模型的瓶颈不在训练算法,在容量本身。
评测:R1 与 o1 系列的对照
最终 R1 与主流模型的对照(R1 论文表 8,此处挑选关键行;o1-1217 由于中国大陆访问 API 不便,其数字按官方报告记录):
| 基准(指标) | Claude-3.5-Sonnet-1022 | GPT-4o-0513 | DeepSeek-V3 | OpenAI-o1-mini | OpenAI-o1-1217 | DeepSeek-R1 |
|---|---|---|---|---|---|---|
| MMLU (Pass@1) | 88.3 | 87.2 | 88.5 | 85.2 | 91.8 | 90.8 |
| MMLU-Pro (EM) | 78.0 | 72.6 | 75.9 | 80.3 | - | 84.0 |
| DROP (3-shot F1) | 88.3 | 83.7 | 91.6 | 83.9 | 90.2 | 92.2 |
| GPQA Diamond (Pass@1) | 65.0 | 49.9 | 59.1 | 60.0 | 75.7 | 71.5 |
| SimpleQA (Correct) | 28.4 | 38.2 | 24.9 | 7.0 | 47.0 | 30.1 |
| FRAMES (Acc.) | 72.5 | 80.5 | 73.3 | 76.9 | - | 82.5 |
| AlpacaEval2.0 (LC-winrate) | 52.0 | 51.1 | 70.0 | 57.8 | - | 87.6 |
| ArenaHard (GPT-4-1106) | 85.2 | 80.4 | 85.5 | 92.0 | - | 92.3 |
| LiveCodeBench (Pass@1-COT) | 38.9 | 32.9 | 36.2 | 53.8 | 63.4 | 65.9 |
| Codeforces (Percentile) | 20.3 | 23.6 | 58.7 | 93.4 | 96.6 | 96.3 |
| Codeforces (Rating) | 717 | 759 | 1134 | 1820 | 2061 | 2029 |
| SWE Verified (Resolved) | 50.8 | 38.8 | 42.0 | 41.6 | 48.9 | 49.2 |
| Aider-Polyglot (Acc.) | 45.3 | 16.0 | 49.6 | 32.9 | 61.7 | 53.3 |
| AIME 2024 (Pass@1) | 16.0 | 9.3 | 39.2 | 63.6 | 79.2 | 79.8 |
| MATH-500 (Pass@1) | 78.3 | 74.6 | 90.2 | 90.0 | 96.4 | 97.3 |
| CNMO 2024 (Pass@1) | 13.1 | 10.8 | 43.2 | 67.6 | - | 78.8 |
| C-Eval (EM) | 76.7 | 76.0 | 86.5 | 68.9 | - | 91.8 |
论文对这张表的解读可以分成几组:
知识类基准(MMLU、MMLU-Pro、GPQA Diamond)R1 明显优于 DeepSeek-V3,主要来自 STEM 题目的准确率提升,而那正是大规模 RL 的收益所在。FRAMES(依赖长上下文的问答)上 R1 也表现突出,论文认为这说明推理模型在 AI 搜索与数据分析任务上有潜力。SimpleQA 上 R1 超过 V3,但中文的 C-SimpleQA 反而低于 V3——论文解释是因为安全 RL 之后模型倾向于拒答某些查询;如果没有安全 RL,中文 SimpleQA 的准确率可以超过 70%。
格式跟随(IF-Eval)与开放生成(AlpacaEval 2.0、ArenaHard) 上是 R1 最强的一组:ArenaHard 92.3 与 o1-1217 大体持平(o1-1217 该列未公开),AlpacaEval 2.0 的 87.6 显著高于 V3 的 70.0。论文特意补充了一个细节:R1 生成的总结很简洁,ArenaHard 上平均 689 token,AlpacaEval 2.0 上平均 2218 字符——这说明它在 GPT 评判的评测里没有靠长度刷分。
数学与算法竞赛是推理模型的主场:AIME 2024 的 79.8 与 o1-1217 的 79.2 基本持平,MATH-500 的 97.3 高于 o1-1217 的 96.4,Codeforces 百分位 96.3 略低于 o1-1217 的 96.6,但评分 2029 对 2061 也在同一档。
工程类编码任务是 R1 的短板:Aider-Polyglot 上 o1-1217 的 61.7 明显高于 R1 的 53.3,SWE Verified 上两者接近(48.9 对 49.2)。论文对此的解释很直接——软件工程任务的评测时间太长,影响 RL 过程的效率,所以大规模 RL 还没有在软件工程任务上充分展开;后续版本会用拒绝采样或者引入异步评测来解决。
论文的局限性一节还列了几条:结构化输出与工具使用能力弱于同期模型,DeepSeek-R1 不能调用搜索引擎或计算器;token 效率仍有优化空间,简单问题上存在明显的过度思考(overthinking);语言混杂问题只解决了中英文场景,其他语言仍可能用英文推理;对提示词敏感,few-shot 提示会持续降低它的表现,因此建议零样本直接描述问题并指定输出格式。
关于”自适应测试时计算”,论文附录 E.4 给了一组很有说服力的数字:在 2024 年数学竞赛题上,R1 以平均 8793 个思考 token 达到 61.8% 的 solve rate(Pass@1),简单问题用不到 7000 token,最难的问题超过 18000 token。作为对比,GPT-4o-0513 在同一批题上只有 24.7% 的 solve rate,平均只生成 711 个输出 token——差了一个数量级。 论文还指出,非推理模型可以靠多数投票来扩大测试时计算,但这追赶不上:在 AIME 2024 上,GPT-4o 采 64 条做多数投票,成绩只从 9.3% 升到 13.4%,而 R1 的 Pass@1 是 79.8%。原因在于多数投票的各条样本是独立生成的、不会互相修正,而非推理模型没有回溯和自我纠错的能力,扩大采样数只是重复采样同一个错误的分布。反过来,R1 自己也能受益于多数投票:从 79.8% 提升到 86.7%。
之后:从推理模型到 Agent
R1 之后这条线还在往前走,这里只按官方发布说明讲两件事。
DeepSeek-V3.1:一个模型,两种模式。 2025 年 8 月 21 日的官方发布说明里,V3.1 的第一条变化就是”混合推理架构:一个模型同时支持思考模式与非思考模式”。API 侧 deepseek-chat 对应非思考模式、deepseek-reasoner 对应思考模式,上下文都扩展到 128K。官方同时给出了思考效率的数字:经过思维链压缩训练后,V3.1-Think 在输出 token 数减少 20% 到 50% 的情况下,各项任务的平均表现与 R1-0528 持平。模型卡把切换机制说得很清楚——同一个模型通过改变 chat template 来支持两种模式,非思考模式下直接在助手前缀后接上 </think>,让模型跳过思考直接作答。
这件事的意义在于:R1 那套”长思维链 + 可验证奖励”的训练成果,被固化成了一个可切换的能力,而不是一个只能长思考的独立模型。日常问答不用为推理付 token 费,复杂任务再打开思考。
DeepSeek-V3.2:思考融入工具调用。 2025 年 12 月 1 日的正式版发布说明给出的定位是:“不同于过往版本在思考模式下无法调用工具的局限,DeepSeek-V3.2 是我们推出的首个将思考融入工具使用的模型,并且同时支持思考模式与非思考模式的工具调用。“训练侧的做法是大规模 Agent 训练数据合成,构造了大量”难解答、易验证”的强化学习任务:1800 多个环境、85000 多条复杂指令。
“保留记录”这件事在 API 层面有明确的对应:官方文档说明,思考模式下思维链通过 reasoning_content 返回;如果请求携带了 tools 参数,历史轮次的 reasoning_content 需要回传给 API 并会被拼接进上下文;如果不带 tools,则无需回传。
从推理模型到 Agent,这条线的逻辑是一致的:R1 证明了”可验证 + 大规模 RL”能教会模型长思考,V3.1 把长思考变成开关,V3.2 让思考能中途调用代码执行、数据库检索这类外部工具并把调用记录带进后续推理。当一个模型的思维链里可以插入工具调用时,“难解答、易验证”这个 RL 任务模板的覆盖面就被大幅拓宽了——此前只有数学和竞赛代码这类能自动判正确性的任务适合做 RL,现在”调用工具能否真正解决问题”也成了一个可判定的信号。R1 论文结论里那句”未来属于任何能被验证器有效评估的任务”,在这里开始落地。
小结
把这篇的关键内容收一下:
GRPO 解决的是一个非常具体的问题——PPO 的价值模型在 LLM 场景里既是显存与计算负担,又在”只有最终结果奖励”和”生成长思维链时会自我修订”的双重压力下难以训准。它的做法是:对同一个问题采样 条输出,用组内奖励的均值做基线、标准差做尺度归一,得到组内相对优势 ,彻底去掉价值模型。减均值因为”基线不改变梯度期望”这一步恒等式而无偏(组均值包含自身带来 的小偏差),归一化让不同难度问题的优势处在同一尺度,并且与奖励模型的比较性质天然对齐。KL 项则从奖励里搬进损失,用 无偏估计量保证非负,顺带绕开了 PPO 那套”累计 KL 惩罚隐式压制回答长度”的副作用。代价是采样开销从一份变成 份;收益是 GRPO 与 PPO 在 MATH 上打出 0.555 对 0.50(λ=0.95)的差距,且不需要额外的超参搜索。
R1-Zero 证明了纯 RL 能激发出长思维链:不做 SFT 冷启动,只用规则化的准确性与格式奖励,AIME 2024 的 pass@1 从 15.6% 涨到 71.0%(v2 更新为 77.9%),cons@64 达到 86.7%;响应长度从几百 token 自然增长到近万,反思词频上升 5 到 7 倍,“wait”的出现在 8000 步之后形成尖峰。代价是可读性差和语言混杂,后者用”目标语言词占比”这样朴素的奖励来缓解,代价是数学持平的条件下代码略微下降。
R1 用四阶段管线把 R1-Zero 的推理能力和人类偏好的可用性拼到一起:冷启动 SFT 换来可读性(Dev1 的 AIME 从 77.9 掉到 59.0 是显性代价)、面向推理的 RL 把推理拉回来并推高(Dev2 的 Codeforces 从 1444 涨到 1687)、拒绝采样加 SFT 补上通用能力(600k 推理 + 200k 非推理,Dev3 的 AlpacaEval 从 55.8 涨到 62.1)、全场景 RL 做最后的人类偏好对齐(AlpacaEval 从 62.1 涨到 87.6,但通用奖励只敢在最后 400 步引入,因为再多就会出现 reward hacking)。整套训练的总成本是 147K H800 GPU 小时,约 294K 美元。
蒸馏是性价比最高的那一环:800k 数据、只做 SFT、不做 RL,就能让 1.5B 的模型全面超过 GPT-4o,让 32B 的模型在几乎所有基准上超过 o1-mini。反过来,直接对 32B 做万步规模的 RL 只能和 QwQ-32B-Preview 打平,被同尺寸的蒸馏版本大幅甩开——蒸馏把”强模型探索出的推理轨迹”变成了可以批量复制的资产,而小模型自己从零探索的代价高得多、效果还更差。论文同时留了一句冷静的注脚:蒸馏经济有效,但想突破智能边界,仍然需要更强的基座和更大规模的 RL。
参考资料
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- DeepSeekMath 论文 HTML 全文(含 GRPO 目标函数、统一范式与梯度系数推导)
- DeepSeek-R1 论文 HTML 全文(v1,含 AIME 曲线、长度曲线与蒸馏对照)
- DeepSeek-R1 论文 HTML 全文(v2,含四阶段管线图、RL 框架图与训练成本表)
- DeepSeek-V3.1 发布(混合推理架构与思考效率)
- DeepSeek-V3.2 正式版发布:强化 Agent 能力,融入思考推理
- DeepSeek API 文档:思考模式(reasoning_content 的回传与拼接规则)
- DeepSeek-R1 官方开源模型集合(含六个蒸馏模型权重)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


