


世界模型从零讲起(二十八):模型怎么听懂一句话——语言条件、指代接地与任务分解
承接前二十七篇:一个始终空着的变量
这个系列从第一篇把世界模型写进 POMDP 开始,已经走完了四条主干路线:重建式(Dreamer 的 RSSM)、联合嵌入(JEPA)、视频生成(Sora、GAIA-1、Cosmos、Genie)与动作条件/世界动作模型(WAM)。围绕它们,系列拆过评测栈、部署与推理系统、能耗下界、潜空间规划、Dyna 谱系、几何表示、物体中心表示、分层抽象、动作接口、长程记忆、共享状态、闭环误差、跨会话迁移、物理先验、触觉、身体模型、数据引擎,最后落在自动驾驶上。
回看这二十七篇,会发现所有讨论都默认了两件事。第一,动作序列是给定的:无论做 rollout、规划还是评测,总有一个 摆在模型面前。第二,场景是已知的:世界就是眼前这一段观测,物体已经在画面里,任务就是预测它们怎么动。
真实系统不是这样运转的。机器人听到的是「把台面上的红色马克杯放到水槽左边」,这句话既没有给出动作序列,也没有指出哪个像素属于哪个杯子。世界模型回答的是「如果这样做,世界会变成什么样」,但「这样做」里的这个「这样」,本身需要先被解析出来。
这就是本篇要补的接口层。它包含三个问题,层层递进:
- 任务条件 怎么进入模型?文本在扩散或自回归主干里到底变成一个向量、一串 token,还是一组空间约束?
- 指令里的名词怎么落到世界里的具体对象上?「红色马克杯」如何变成一个可查询、可验证的对象引用?
- 一个跨房间、跨小时的长任务,怎么切分成世界模型能够评估的小段?
先把结论放在前面:语言在具身系统里主要不是一种新的观测模态,而是一套寻址系统。它指向外部世界状态中的某个子结构,给出一段可检查的成功条件,并把长任务切成「世界模型算得动」的小块。理解这一点,才能理解为什么大语言模型规划器与视频世界模型谁也替代不了谁。
一句话里的四个空洞
取一个具体指令:「把厨房台面上的红色马克杯放到水槽左边」。对一个站在客厅的机器人,这句话至少有四个空洞。
空洞一:地图。是这间公寓的厨房,还是隔壁的厨房?「台面」是哪一个台面?这需要一张跨房间的语义地图,把「厨房」这个字符串解析到空间中的一个区域。
空洞二:指代。台面上可能有两个红色杯子,一个带把手一个不带;也可能只有一个杯子,但被纸巾挡住一半。系统需要把「红色马克杯」这个名词短语绑定到一组具体的三维点、一个物体节点,或者至少一个候选集合。
空洞三:关系。「水槽左边」不是一个绝对坐标,而是一个以水槽为参照物、以机器人的观察方向为默认朝向的空间关系。如果机器人绕到水槽另一侧,「左边」就反了。这个关系必须被解析成一个可计算的目标区域,而不是停留在文字上。
空洞四:成功条件。杯子放在水槽左侧 10 厘米处算不算成功?放在水槽里呢?杯口朝下呢?世界模型可以预测画面,但画面「看起来对了」并不等于任务完成。
把这四个空洞写进公式,世界模型的条件形式就从
变成
其中 是系统在模型之外维护的世界状态(地图、物体集合、关系图、任务进度), 是把自然语言指令解析成模型可用条件的映射。本文关心的不是 怎么训练,而是 怎么工作、需要什么数据结构、代价落在哪里。
一个有用的类比是指针与堆。程序里的变量名不是数据本身,它是指向内存的地址;地址可能失效(对象被回收)、可能错指(两个对象同名)、可能悬空(对象已移动)。自然语言里的名词短语就是指针, 就是堆,所谓「接地」就是做一次安全的地址解析:找到对象、确认身份、在需要时更新地址。「红色马克杯」被拿走后,原来那个地址就必须失效,否则机器人会去抓空气。
接法一:整句变成一个向量
最省事的接法是让整句话过一个文本编码器,得到一个向量,再把这个向量送进生成主干。今天的视频世界模型几乎都支持这种做法。
以 CLIP 文本编码器为例。文本先被切成最多 77 个 token,经过 Transformer 得到每个 token 的隐状态,再取出一个全局表示(或用整串 token 的隐状态)。在潜扩散主干(DiT 一类)里,这个表示通过交叉注意力注入:图像侧的潜变量 token 产生 query,文本 token 产生 key 与 value,
其中 是潜帧 token, 是文本 token, 往往上万(视频生成世界模型一篇算过,一段 720p 视频按 压缩后每帧就有一万多个 token), 只有几十。注意力矩阵的尺寸是 ,相比自注意力的 ,文本条件本身的开销不到百分之一。
这也解释了一个常见误解:语言不是视频世界模型的成本瓶颈。真正的成本在 的自注意力与几十步去噪上。把提示词从 20 个 token 加到 77 个 token,对延迟的影响几乎可以忽略。
文本条件的强度通常用一个旋钮调节:无分类器引导(classifier-free guidance, CFG)。训练时以一定概率把文本置空,推理时同时算一次有条件与一次无条件的噪声预测,再做外推:
是引导尺度。 等价于只用条件预测; 放大「有文本」与「无文本」的差,让生成结果更贴合提示; 太大则画面饱和、运动僵化,因为模型被推到了训练分布之外。这个公式在图像生成里很常见,在视频世界模型里同样适用,只是文本之外还常有动作、历史帧等条件,需要各自设置引导强度。
整句向量接法的局限也很清楚:它没有绑定关系。「红色」和「马克杯」在编码器里被压进同一个向量,模型无法指出画面中哪一块对应「红色」、哪一块对应「马克杯」。当场景里只有一个杯子时,这种模糊无关紧要;当有两个杯子、三种红色、四个台面时,模型只能靠训练数据里的统计相关性去猜。它擅长的是全局属性——「夜晚」「雨天」「木质桌面」「卡通风格」,不擅长「第二个抽屉」「左边那个把手」。
在自动驾驶世界模型里,这种接法已经够用,因为动作条件(轨迹、速度、航向)承担了精确控制,文本只负责场景风格与天气。到了桌面操作,指令的精确性要求高一个量级,就必须往下走到对象层。
接法二:开放词汇检测与分割,把名词钉到像素上
要让「红色马克杯」落到具体区域,第一步是把任意名词短语变成图像上的框或掩码。这件事在 2023 年之后有了通用解法:开放词汇检测(open-vocabulary detection)与可提示分割(promptable segmentation)。
Grounding DINO 的四个部件
Grounding DINO 于 2023 年由 IDEA Research 等机构提出,把 DINO 的检测结构与「图文 grounding」预训练结合,输入是一张图与一句文本(如「红色马克杯 . 台面 . 水槽」),输出是每个短语对应的框。它的结构可以拆成四段:
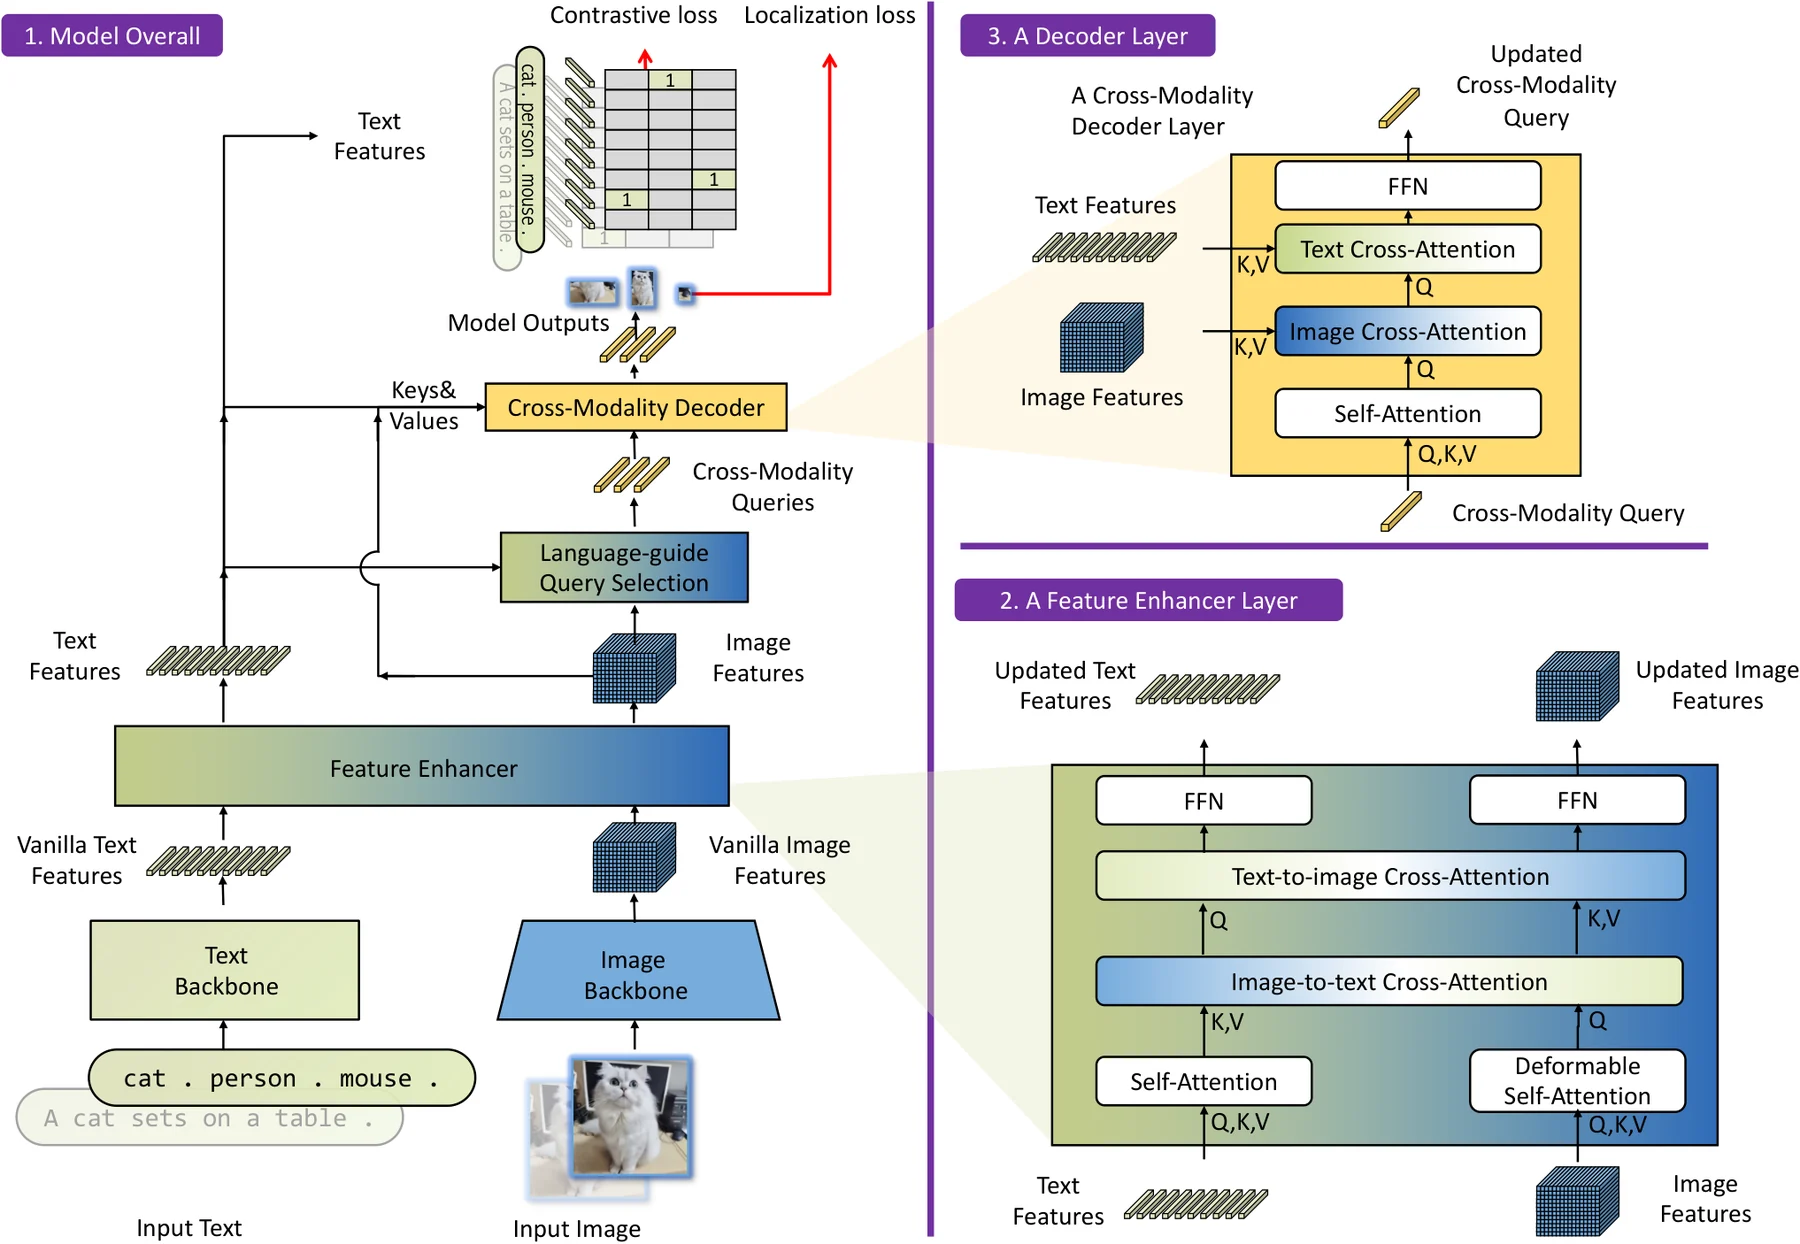
图源:Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection(arXiv:2303.05499)Figure 3。左侧是文本与图像两个主干,中间是跨模态特征增强,右侧是语言引导的查询选择与跨模态解码器,输出框与短语的对应关系。
第一段是双主干。图像走 Swin Transformer,文本走 BERT 一类编码器,各自抽特征。第二段是跨模态特征增强:把图像特征与文本特征放进同一个编码器做深度融合,让每个图像位置都能「看到」整句文本,每个文本 token 也能「看到」图像。第三段是语言引导的查询选择:从融合后的图像特征里挑出与文本最相关的区域作为解码器查询,而不是像传统 DETR 那样使用固定数量的无内容查询。第四段是跨模态解码器:每个查询与文本 token 做交叉注意力,最终输出框坐标与「这个框对应哪个短语 token」的对齐分数。
用公式描述最后一步。设第 个查询与第 个文本 token 的对齐分数为 ,则一个框被判定为「红色马克杯」的依据是
再对所有框做阈值筛选与非极大值抑制(NMS),得到候选集合。这里的 是解码器输出的区域表示, 是文本 token 的表示。分数高只说明「这个区域和这个词相关」,不说明区域完整、不说明属性绑定正确。
SAM 补上掩码
检测给出的是矩形框,机器人抓取需要的是像素级掩码。Segment Anything(SAM)于 2023 年由 Meta 发布,是一个可提示的分割模型:输入一张图与一个提示(点、框或粗掩码),输出该提示对应的掩码。工程上的常见组合是「Grounding DINO 出框 → SAM 以框为提示出掩码」,这样既保留了开放词汇能力,又拿到了边界清晰的掩码。
SAM 的结构是「图像编码器 + 提示编码器 + 轻量掩码解码器」。图像只编码一次,提示可以反复查询,因此同一张图上查询多个物体时,边际成本很低。这一点在机器人上很重要:一帧图像上可能要问十个名词,如果每个名词都重跑一遍图像主干,成本会翻十倍。
接地这一步的真实成本
把这一步放进整条流水线,成本不在 FLOPs,而在调用次数与稳定性。
- 一条指令里的名词短语数量通常是 1 到 4 个,每个短语要过一次检测;同一帧还要过一次分割。
- 开放词汇检测对提示措辞敏感。「马克杯」与「杯子」可能给出不同的框;加上颜色、材质、位置限定词又会改变结果。工程上往往要维护一套提示模板,并对多个措辞的结果做合并。
- 检测器不理解否定与数量。「除了红色那个」这类指令不能直接交给检测器,必须先由语言侧解析成集合运算。
- 遮挡、小物体、透明物体是稳定的失败点。杯子被手挡住一半时,框会缩到可见部分,掩码也会缺一块;世界模型如果拿这个残缺掩码去做几何推理,位姿估计会偏。
所以接地不是一个函数调用,而是一个带置信度的候选生成过程。系统拿到的不是一个物体,而是一组带分数的候选:。后面所有环节都必须能处理「候选不唯一」这件事。
接法三:三维场景图,给语言一个可查询的地址空间
二维框只能回答「这一帧里哪里像杯子」。机器人需要的是「这个杯子上一次出现在哪、现在还在不在、和台面是什么关系」。这需要把多帧观测融合成一个持久的三维结构。
ConceptGraphs 的流水线
ConceptGraphs 于 2023 年提出(ICRA 2024),把开放词汇感知与三维场景图结合起来,目标就是给机器人与语言模型提供一个可查询的物体级世界表示。它的流水线可以分成五步:
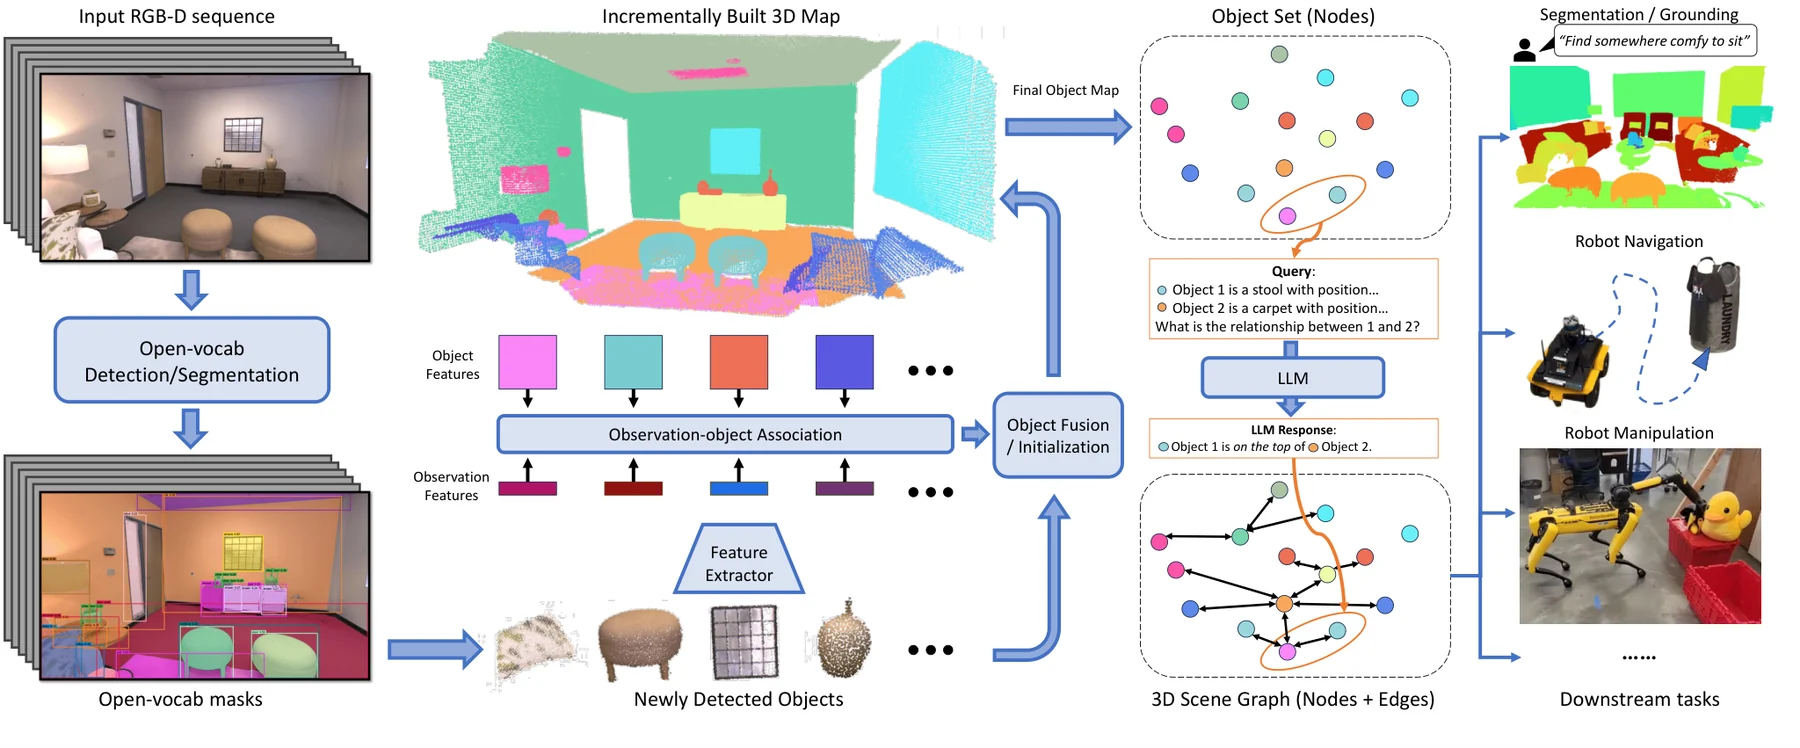
图源:ConceptGraphs: Open-Vocabulary 3D Scene Graphs for Perception and Planning(arXiv:2309.16650)Figure 2。左侧输入 RGB-D 序列,中间经过开放词汇检测/分割、物体融合与新物体初始化,得到物体节点与关系边,右侧是语言查询与导航、操作等下游任务。
第一步,逐帧开放词汇分割。对每一帧跑检测与分割,得到一组带名词标签的二维掩码。第二步,物体融合。把当前帧的掩码与已有三维物体做关联:如果掩码投影到三维后与某个已有物体的点云重叠足够多,就并入该物体;否则新建一个物体节点。第三步,节点特征。每个物体节点挂上点云、位姿、CLIP 特征、由视觉语言模型生成的简短描述。第四步,关系边。用语言模型读物体描述与空间位置,生成「A 在 B 上」「A 靠近 B」「A 是 B 的一部分」这类关系。第五步,查询。给定一句自然语言问题,先用 CLIP 特征做粗检索,再把候选子图交给语言模型做关系推理。
用一个形式化的写法,场景图是
其中 是物体点云, 是语义特征, 是标签与描述, 是位姿, 是关系类型, 是置信度。语言查询被解析成一个检索问题:
再叠加关系约束,例如「在水槽左边」对应 且 是水槽节点。
为什么图结构适合做地址空间
第一,可组合。「红色马克杯」可以拆成属性检索(颜色)与类别检索(杯子),图上的节点带描述,语言模型可以在子图上做多跳查询。第二,可持久。机器人走出厨房后,节点仍然在图上,回来时可以直接查询「杯子还在不在」,不必重新看一遍。第三,可编辑。重新观测到某个物体后,可以更新它的位姿与特征;长时间未观测的节点可以降权或标记为陈旧。第四,成本可控。一次查询只碰候选子图,不需要把整张地图塞进模型上下文。
这正好补上了第 12 篇与第 13 篇留下的接口。几何式世界模型讲的是怎么表示场景、怎么查询几何;物体中心表示讲的是怎么把画面拆成槽位。那两篇关心的是表示与动力学,本篇关心的是地址:同一个杯子在几何层是一个高斯集合、在物体层是一个槽位、在场景图层是一个带名字的节点,语言只能寻址到最后一层,再把查询结果翻译成前两层的坐标。三者是同一世界的三种视图,不是三个互相替代的方案。
关联算法与存在性概率
场景图能否稳定,取决于「新观测属于哪个旧物体」这一步。工程上它通常被写成一个二分图匹配问题。设已有物体集合为 ,当前帧的掩码投影到三维后得到点集 ,先算几何重叠:
再叠加语义相似度,构成代价矩阵
用匈牙利算法求最优匹配,代价超过阈值的新掩码则初始化成新节点。 是几何与语义的权重。几何权重大、语义权重小时,两个紧挨着的同款杯子容易被并成一个节点;语义权重大、几何权重小时,同一个杯子换一个视角就可能被拆成两个。工程上常见的做法是先用几何做门控(重叠低于阈值直接不匹配),再用语义在同一物体的候选里区分。
物体是否会「消失」也需要一个概率,而不是布尔值。一个简单的做法是维护存在性的对数几率:
其中 是第 次观测, 是这一次观测的对数似然比:看见了就给正值,本该看见却没看见就给负值。这个更新式的价值在于它允许系统表达「可能还在,但最近没看到」,下游查询可以据此决定是先确认还是直接执行。它也解释了为什么被遮挡的物体会在图上「半死不活」:不是算法坏了,而是观测本身不充分。
跨房间:层次图与查询路由
一个房间的平铺图还能接受,一栋楼不行。上千个物体节点如果都放在一张平铺图里,一次查询要在全部节点上做特征比较,语言模型也不可能把整张图读进上下文。实际系统会把图做成层次的:
房间之间还有一张拓扑导航图,节点是房间或走廊,边是门与通道,边上带通行代价。语言查询先被解析到房间一级(「厨房」对应哪个节点的哪个区域),再在该房间的物体子图上做检索。这样一次查询的成本从整栋楼降到单个房间,语言模型看到的子图也只有几十个节点。
路由本身也会出错。「把楼下的杯子拿上来」需要先判断杯子在哪个房间;如果图里没有记录,系统要么主动搜索,要么追问。拓扑图还承担了导航与物体图之间的对齐:机器人从客厅走到厨房,靠的是拓扑图上的路径,而不是物体图上的边。两套图各管一段,接口是房间节点。
场景图的账本与失效点
场景图不是免费的。每个物体节点至少要存点云、特征、描述与位姿;一个普通房间几十到上百个物体,一栋房子上千个节点。每新增一帧,都要做一次关联:把 个新掩码与 个已有物体比较,代价是 的几何重叠计算,外加特征相似度。每新增一个物体,还要调用一次视觉语言模型写描述、若干次语言模型判断关系。这些都是按物体计费的开销,和按像素计费的扩散推理完全不同。
失效点也很集中:
- 关联错误。两个外观相似、位置相邻的物体被并成一个节点,或者同一个物体因为视角变化被拆成两个节点。前者让机器人以为只有一个杯子,后者让它以为有两个。
- 别名。同一个物体在不同帧被标成「杯子」「马克杯」「容器」,节点描述里混着多个名字,检索时反而不稳定。
- 陈旧。物体被移动后,图上的位姿没有及时更新。机器人按旧位姿去抓,抓空。
- 遮挡导致的节点丢失。被挡住的目标没有新观测,关联算法可能把它判为消失,也可能保留一个过时的节点。两种处理都需要额外的存在性概率,而不是简单的存在/不存在。
- 关系幻觉。关系边由语言模型生成,模型可能把「杯子在桌上」说成「杯子在桌旁」。关系错了,基于关系的查询就会指错。
这些问题在系统层有一个共同的缓解手段:把图上的每个断言都带上时间戳与置信度,并让下游查询能表达「不确定」。机器人可以先去确认,而不是直接执行。
接法四:把语言编译成空间代价
检测与场景图解决的是「词指哪个物体」。还有一类指令关心的是空间关系与约束,例如「打开最上面的抽屉,注意别碰到花瓶」。这类指令的难点不在物体识别,而在把「最上面」「别碰到」变成运动规划器能读的代价。
VoxPoser 于 2023 年由斯坦福团队提出,走的是「让语言模型写代码,代码调用感知接口,合成三维代价图」的路线。它的结构是:
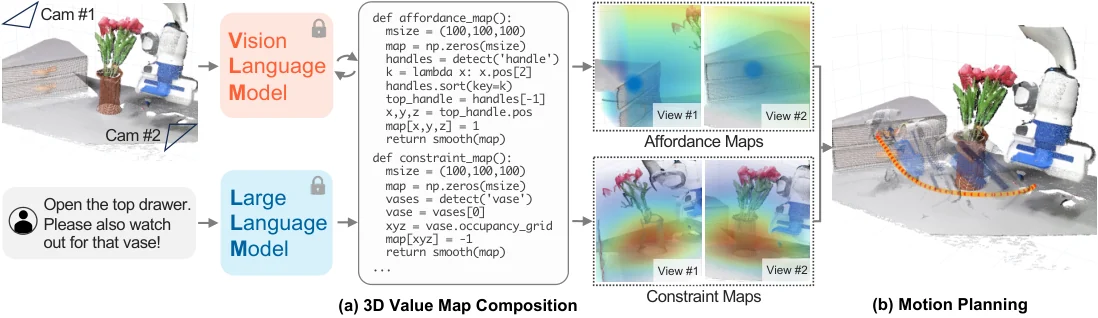
图源:VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models(arXiv:2307.05973)Figure 2(方法总览)。左侧语言模型根据指令写出调用检测接口的代码,中间合成可供性图与约束图,右侧交给运动规划器求解轨迹。
具体做法分三步。第一步,语言模型读指令,输出一段 Python 代码;代码里调用的是系统预先注册的感知原语,例如 detect("handle")、detect("vase"),以及取位置、排序、取最后一个等操作。第二步,代码在三维网格上写入数值:对目标物体写正值(吸引),对要避开的物体写负值(排斥),得到一张三维代价图
第三步,运动规划器在这张图上求解一条轨迹,使沿轨迹的累计代价最小:
以「打开最上面的抽屉」为例,代码会先检测所有把手,按高度排序,取最高的那个,在它的位置写一个吸引峰;「注意别碰到花瓶」则检测花瓶,把它的占据区域写成负值。语言模型不需要看像素,它只需要知道有哪些原语、每个原语返回什么字段。
这个设计的好处是把常识与几何分开了:语言模型负责「最上面」「别碰到」这类语义,感知接口负责「把手在哪」「花瓶占多大空间」,规划器负责「怎么绕过去」。代价是语言模型必须写出正确的代码,而它对 API 的想象经常出错——调用不存在的函数、把字段名写错、把「最上面」理解成「离相机最近」。工程上要加代码校验、沙箱执行与失败重试。
成本结构也值得算一笔。这套代码里的三维网格按 的分辨率初始化, ,也就是 个体素;单张 FP32 代价图约 4 MB,多张图叠加后仍在显存里放得下。真正的开销在语言模型生成代码(一次长输出)与规划器采样(数百到数千条候选轨迹),不在三维网格本身。这与扩散世界模型的成本分布相反:后者几乎全部花在像素级生成上。
从语言到动作:可供性、闭环反馈与技能库
前面几节解决的是「词指什么」。还有一个更基本的问题:动作从哪里来。世界模型能评估动作的后果,但它不负责提出动作。提出动作的是策略、规划器或语言模型。
SayCan:语言先验乘上物理可行性
SayCan 于 2022 年由 Google 提出,核心是一个乘积形式的打分:
其中 是指令, 是当前状态, 是一个候选技能(「拿起海绵」「去垃圾桶」「用吸尘器」)。第一项是语言模型给这个技能的语言合理性:在一句「我打翻了饮料,你能帮忙吗」后面,「拿海绵」比「拿苹果」更可能。第二项是当前状态下这个技能能不能执行:海绵不在视野里、机械臂够不到、抽屉关着,可行性就低。第二项通常由一个在真实机器人上训练的价值函数给出;为了让两项量级可比,工程上常把它归一化成概率:
是温度, 是价值函数对「在状态 执行技能 的前景」的估计。两项相乘之后取最大值,就得到下一步技能。这个设计的精髓在于:语言模型负责「应该」,价值函数负责「能够」。只有「应该」会说出「用吸尘器清理洒出的咖啡」这种正确但当前做不到的计划;只有「能够」会在没有指令时乱拿东西。
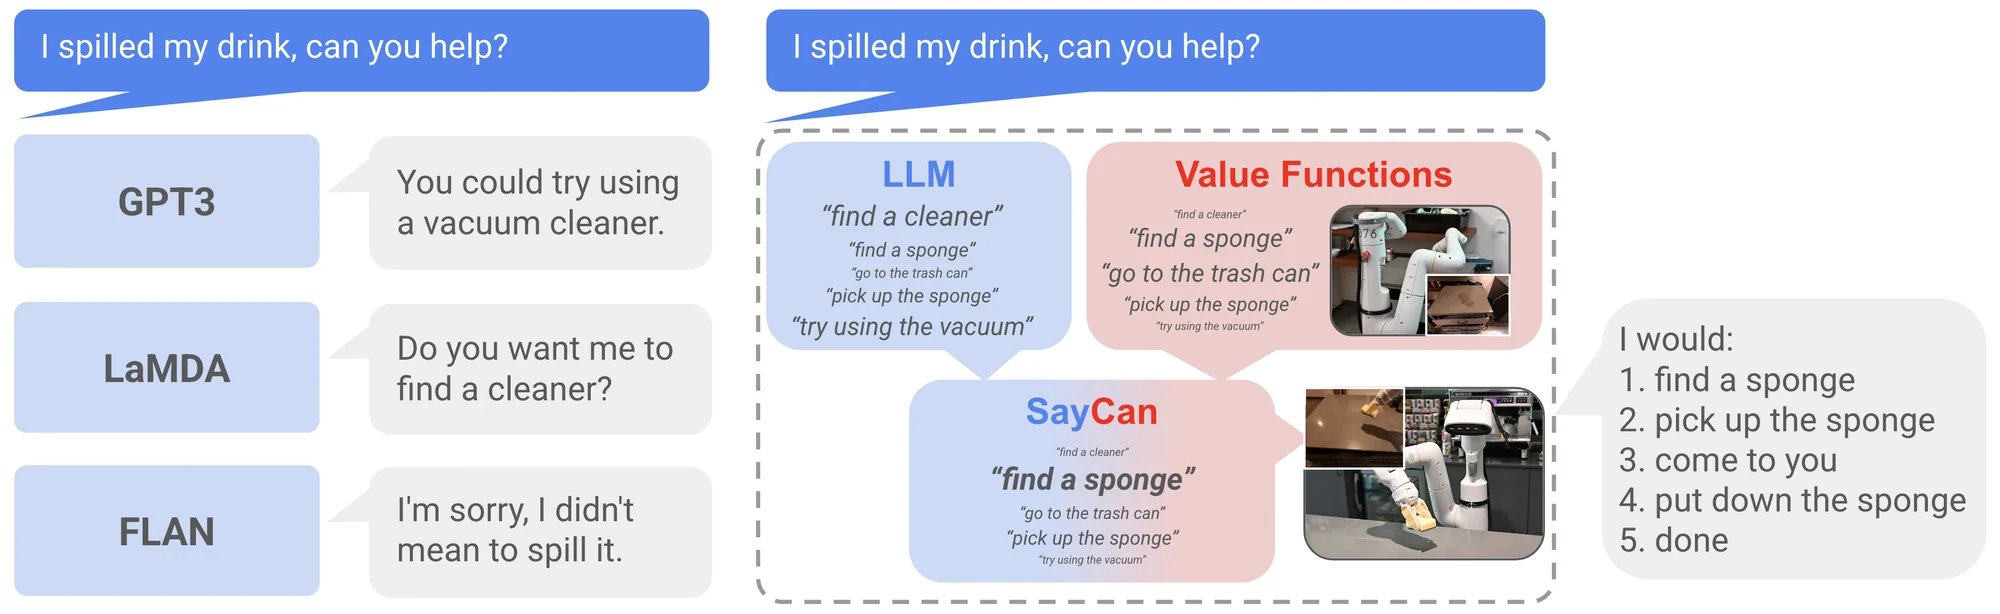
图源:Do As I Can, Not As I Say: Grounding Language in Robotic Affordances(arXiv:2204.01691)Figure 1。左侧是用户指令与语言模型生成的候选步骤,中间价值函数为每个候选打分,右侧是机器人执行与对话回应。
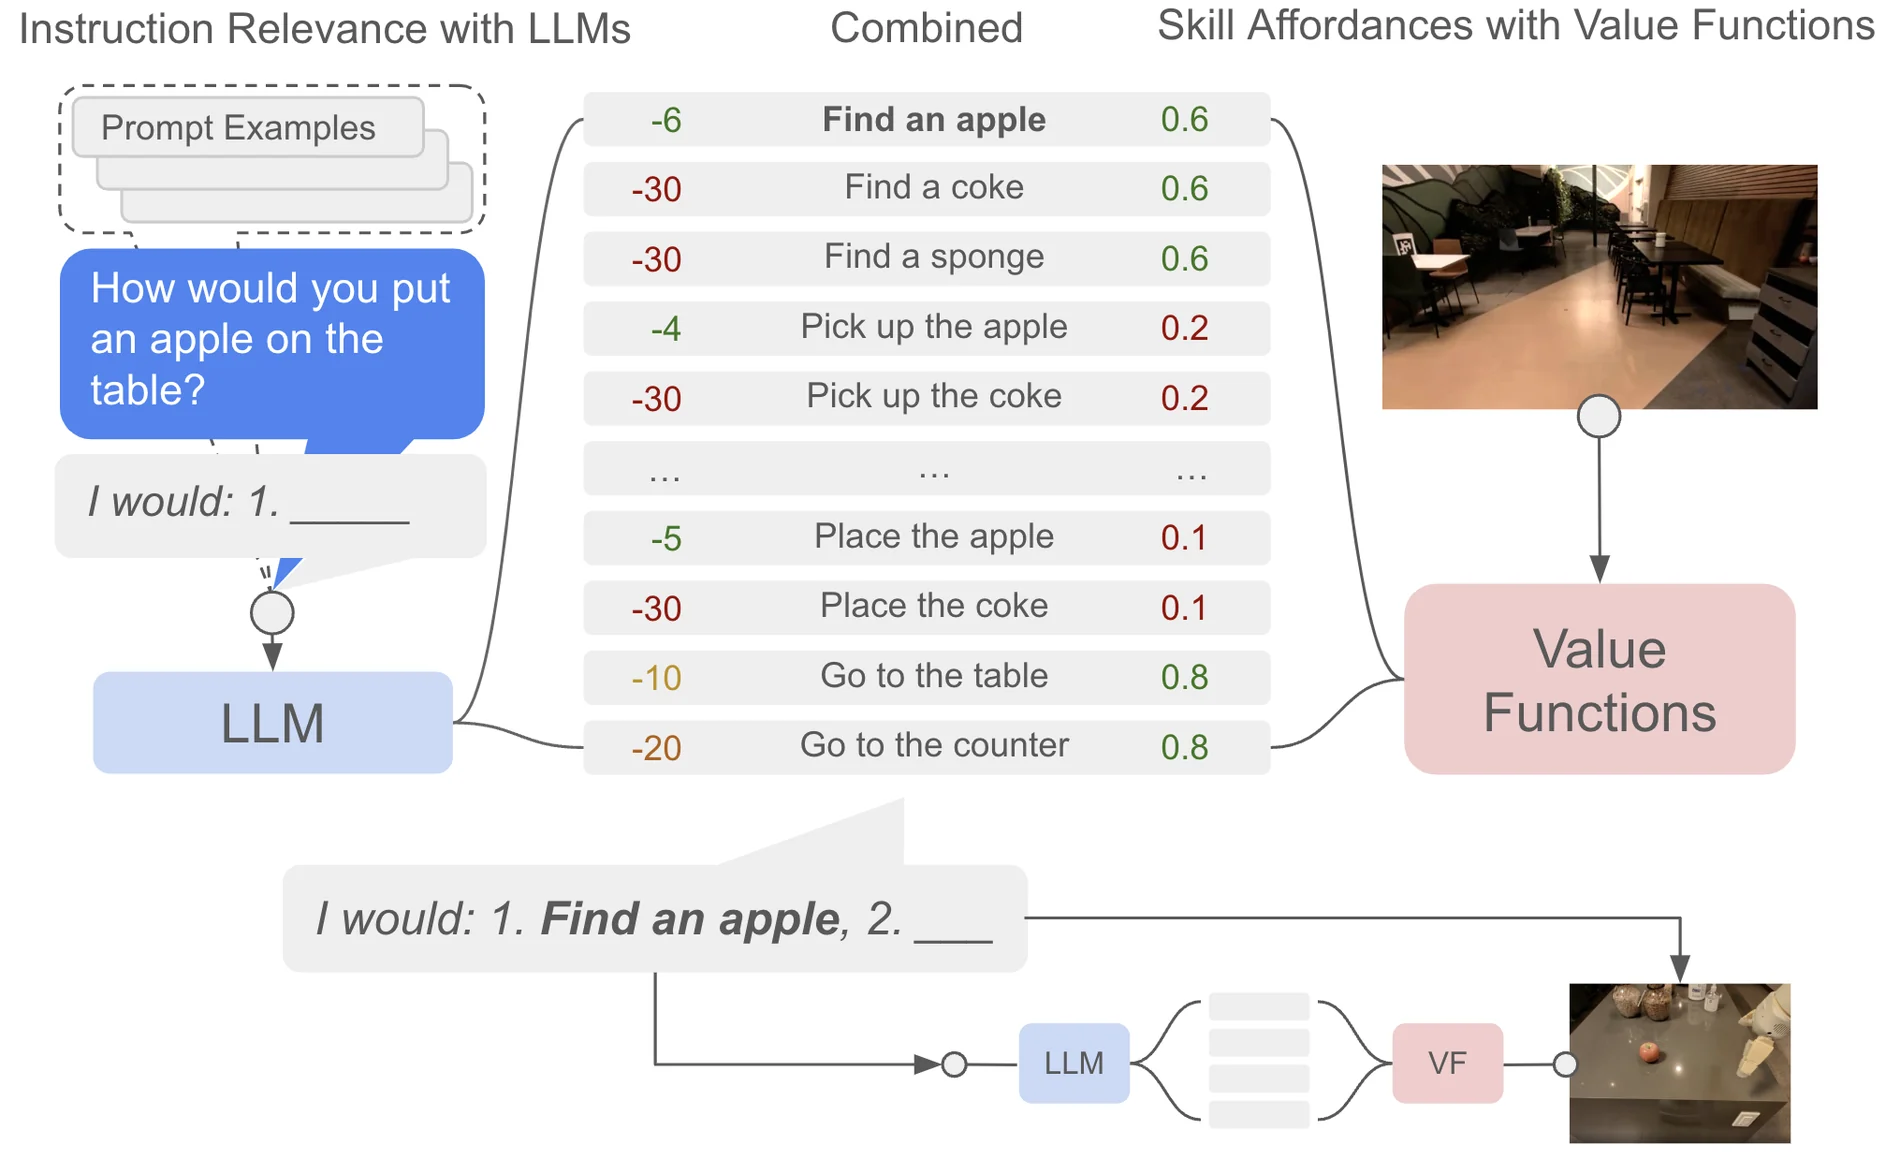
图源:Do As I Can, Not As I Say(arXiv:2204.01691)Figure 4。左列是语言模型给出的「这个技能与指令有多相关」概率,中列是价值函数在当前场景里给出的「这个技能此刻能不能做成」分数,右列是两者相乘的结果。同一个技能在不同场景里语言分不变、可供性分变化,最终排序也随之变化——这正是乘积形式要表达的「应该」与「能够」的分离。
上图还暴露了一个容易忽略的细节:打分是逐步进行的。语言模型一次给出多个候选技能,系统只执行当前状态下得分最高的那一个;执行完再重新打分。这意味着一次长任务要进行多轮语言模型调用,每轮的输出很短,但轮数随任务长度线性增长。延迟预算里必须把这项算进去。
Inner Monologue:把执行结果写回提示
SayCan 的一轮一轮打分仍然是开环的:语言模型看不到执行结果,只能看到初始指令与当前状态的价值。Inner Monologue 于 2022 年由 Google 提出,把执行过程中的反馈——成功检测器的判断、场景描述、人的口头反馈——转成文本,注入下一轮提示,让语言模型在闭环里修正计划。
它解决的是「计划与世界脱节」的问题。比如语言模型计划「打开抽屉拿杯子」,但抽屉是锁着的;没有反馈时,模型会继续执行后续步骤;有反馈时,它看到「打开抽屉失败」,就会改计划。这里的反馈不是梯度,而是自然语言,因此可以直接进入提示,不需要重新训练。
代价是每一轮都要重新编码一段变长的上下文,且反馈本身可能错。成功检测器如果把「抽屉开了一条缝」判成成功,模型会继续往下走,错误被放大。这与闭环误差讨论的同一个结构:反馈既能压住偏差,也能放大偏差,取决于反馈的准确率与延迟。
Code as Policies 与技能库
Code as Policies 于 2022 年由 Google 提出,让语言模型直接生成调用感知 API 的策略代码,而不是生成一步步的自然语言计划。代码可以包含循环、条件、算术,因此能表达「对所有红色块,按 x 坐标排序,依次放到左边」这类组合指令。它的优点是表达力强、执行快;缺点是错误更难发现——一段代码可能语法正确、语义错误,执行后才发现。
Voyager 于 2023 年提出在开放世界(Minecraft)里维护一个技能库:把执行成功的代码存起来,给每段代码写描述与嵌入,遇到新任务时先检索可复用技能,再让语言模型组合或修改。这个技能库是一种非参数化的策略记忆,与长程记忆讨论的状态记忆不同:它记的不是「世界曾经是什么样」,而是「这类事曾经怎么做成」。
技能库的工程价值在于降低重复推理。同一类子任务第二次出现时,不需要重新让语言模型从零生成代码,只需要检索与改写。它的风险在于技能过时:环境变了、API 变了、前置条件不满足,旧技能会以很高的置信度被执行,然后失败。因此技能条目上必须挂前置条件与适用范围的检查,而不是只存代码。
目标图像作为条件:不用语言的另一种接口
语言不是唯一的任务条件。另一条路线直接用目标图像或目标视频作为条件:给模型看「做完之后应该是什么样」,让它生成一段从当前观测到目标观测的规划,再从规划里反推动作。
UniPi 于 2023 年由 MIT 团队提出,把文本指令先转成一段视频计划,再用逆动力学模型把相邻帧变成动作:
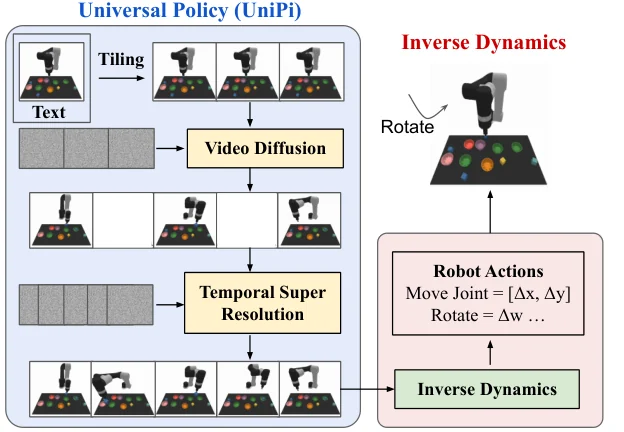
图源:Learning Universal Policies via Text-Guided Video Generation(arXiv:2302.00111)Figure 2。上方是通用策略把文本与当前观测变成视频计划,下方是逆动力学模型把相邻帧对转成动作。
形式化地,设视频计划为 ,逆动力学模型为 ,则
通常是一个小网络,输入两帧(或两帧的潜表示),输出动作。它可以在有动作标签的机器人数据上训练,也可以与视频模型联合训练。
这条路线的好处是空间信息密度高。一句话说「把杯子放到架子上」,没有说清路径、姿态、避障;一段目标视频把这些都画出来了。对于接触丰富、姿态敏感的任务,视频条件的表达能力明显强于文本。
代价有三点。第一,生成成本。一段计划视频要走完整的扩散采样,帧数乘以去噪步数,比生成一句文本贵几个数量级。第二,逆动力学的歧义。同一个视觉 transition 可能由多种动作造成:杯子从 A 到 B,可以是直线推、绕路搬、用工具勾。 只能给出一个最可能的动作,物理上未必可行。第三,误差串联。视频计划本身可能不物理,逆动力学再把不物理的帧转成动作,两层误差叠加。闭环误差的分析在这里同样适用。
RT-2 一类视觉语言动作模型走的是另一条路:把动作离散成 token,与文本 token 放在同一个序列里预测。这样动作预测就变成了语言模型式的下一 token 预测,可以直接复用互联网预训练带来的常识。这条路线在动作接口拆过动作 token 化的细节,这里只强调它对条件接口的意义:语言、图像、动作被放进同一个 token 空间,条件与输出的边界消失了。代价是离散化带来的精度损失与逐 token 解码的延迟,这也是后来流匹配动作头重新流行的原因。
世界模型怎么给候选打分
候选有了,接下来要回答「哪一个更好」。这一步在世界模型里不是生成,而是评估,形式可以写得很简单。设任务层给出 个候选子目标 ,世界模型对每个候选做一段短程 rollout,得到预测观测 ,再用一个打分函数排序:
三项各有明确的含义。第一项是终局成功率:把 rollout 的最后一帧交给成功判别器,估计「到了那里算不算完成」。 可以是一个在人工标注的终局画面上训练的二分类器,也可以是一个视觉语言模型的判断,还可以是几何规则(物体中心落在目标区域内)。第二项是过程代价:沿途的碰撞风险、能量、时间。第三项是置信度,用来惩罚那些预测本身就不可靠的候选——同一个模型对两个候选的预测方差不同,方差大的那个不应该因为碰巧猜出一个高分就被选中。
这个打分函数有两个工程上的坑。
第一个坑是判别器的分布偏移。成功判别器通常在真实画面上训练,而 rollout 的画面是模型生成的,纹理与物理细节都不同。判别器在生成画面上可能过度乐观:杯子被画到了目标位置,但形状已经变形,判别器仍然给高分。缓解办法是在训练判别器时混入生成画面,或者让判别器只看几何量(物体中心、接触关系)而不看纹理。
第二个坑是分数不可比。不同候选的 rollout 长度可能不同、预测方差不同,原始分数不能直接比较。工程上通常只关心排序,因此更稳妥的做法是用同一批候选做配对比较,或者对分数做归一化,而不是把绝对分数当成概率。
还有一个更根本的限制:世界模型能评估的只是短程后果。 通常只有十几到几十步,超出这个窗口的后果它看不到。长任务因此必须切成一段一段,每段都在窗口内评估——这正是任务分层的意义所在。
三层分工:谁提议,谁打分,谁执行
把前面的部件放在一起,一个完整的具身系统至少有三层,时间尺度与职责都不同。
| 层 | 典型部件 | 时间尺度 | 输出 | 主要错误 |
|---|---|---|---|---|
| 任务层 | 语言模型 / 视觉语言模型 | 秒级 | 子目标序列、技能调用 | 常识错误、指代错误、计划不可行 |
| 评估层 | 世界模型 / 价值函数 / 场景图查询 | 百毫秒到秒级 | 候选打分、后果预测、可行性 | 预测漂移、图过期、打分偏差 |
| 执行层 | 运动规划器 / 控制器 / 策略 | 毫秒级 | 关节指令、轨迹 | 跟踪误差、碰撞、执行失败 |
世界模型的位置在中间层,而且它的主要职责是评估,不是提议。这个定位很重要,因为它决定了两件事。
第一,世界模型不需要生成所有候选。语言模型可以先给出 5 到 10 个候选子目标,世界模型只对这十几个候选做短程 rollout,比较它们的后果。这样 rollout 的条数被候选数限制住,而不是在连续动作空间里盲目搜索。潜空间规划(CEM、MPPI、MCTS)是另一条路:没有语言先验时,只能在动作空间里采样。两条路的成本差别很大,前者是「十几个候选各推演一次」,后者是「上千条轨迹各推演一次」。
第二,世界模型不能替代语言模型。语言模型知道「打翻饮料应该拿海绵」,世界模型只知道「海绵移动后画面会怎样」。后者可以验证前者的可行性,但无法产生「海绵」这个名词。反过来,语言模型也不能替代世界模型:它能说出「把杯子放好」,但不知道杯子的具体位置、路径上有没有障碍、放下去会不会倒。
三层之间的接口是本文反复讲的那三样东西:条件(任务层给评估层的子目标)、地址(评估层查询场景图得到的对象引用)、成功判定(执行层回报给任务层的反馈)。任何一层缺失,系统就会退化成开环脚本或盲目搜索。
一笔可算的延迟预算
把一次指令的执行拆开,可以得到一张延迟表。下面的数字是假设值,用来说明各项的相对量级,不是某一台机器的实测:
| 环节 | 假设耗时 | 说明 |
|---|---|---|
| 语音识别 / 文本输入 | 100–300 ms | 可离线,可流式 |
| 文本编码(77 token) | 2–5 ms | 相对可忽略 |
| 开放词汇检测(每短语) | 30–80 ms | 与图像分辨率、模型大小相关 |
| 分割(每物体) | 10–30 ms | 图像编码一次,掩码查询便宜 |
| 场景图关联与查询 | 5–20 ms | 几何比较,可用空间索引加速 |
| 语言模型规划一轮 | 0.5–3 s | 输出 token 数决定 |
| 世界模型短程 rollout | 0.1–2 s | 帧数 × 去噪步数 |
| 运动规划 | 10–100 ms | 取决于自由度与障碍数 |
表里最刺眼的是语言模型规划那一行。一次长任务要调用多轮,每轮几百毫秒到几秒,累计起来就是数秒到数十秒。这也是为什么工程上要把「哪些步骤可以合并成一次调用」「哪些技能可以缓存」当成核心优化,而不是只盯着世界模型的推理速度。
反过来,世界模型的 rollout 在整个预算里往往不是最大项。它贵,但只在需要比较候选时才调用;语言模型则是每一轮都要调用。这个成本结构决定了系统设计的优先级:先优化调用次数,再优化单次延迟。
失效模式:语言先验压过物理事实
把语言接进世界模型,会引入一类新的错误:语言说得通,世界不答应。下面几种在真实系统里反复出现。
指代歧义。 「把杯子拿过来」在有两个杯子时无法解析。系统可以选择追问,也可以按显著性猜一个。追问的代价是交互轮次,猜错的代价是执行错误。工程上通常设一个置信度阈值:候选分数差距大就直接执行,差距小就追问。SayCan 的对话里就有「I’m sorry, I didn’t understand」这类澄清回应,这不是礼貌,而是接口设计的一部分。
属性绑定错误。 「红色马克杯」被检测成「红色」与「马克杯」两个独立概念,系统可能拿到一个蓝色马克杯加一个红色盘子。开放词汇检测的对齐分数只保证区域与短语相关,不保证属性组合正确。缓解办法是把属性作为查询的一部分(「red mug」整体作为一个短语),或者在图节点上存属性字段并在查询时做过滤。
空间参照系错误。 「水槽左边」默认以机器人当前朝向为参照。机器人转身后,同一个字符串指向相反方向。系统必须把参照系显式写进查询:以哪个物体为原点、以哪个方向为「左」。这类错误在跨房间任务里尤其常见,因为机器人在路上会改变朝向。
陈旧状态。 场景图里的位姿是上一次观测的结果。人把杯子挪走后,图没有更新,机器人按旧位置去抓。缓解办法是查询时检查节点的时间戳与置信度,必要时先做一次主动观测(转头看一眼),而不是直接执行。
关系幻觉。 由语言模型生成的关系边可能不符合几何事实。缓解办法是用几何验证关系:left-of 可以用位姿投影验证,on 可以用支撑面与接触验证。语言模型提出关系,几何做校验,这和数据引擎的失效边界讲过的「生成模型提议、验证器过滤」是同一个模式。
否定与数量。 「不要拿那个有缺口的」包含否定与比较,检测器无法直接处理。这类指令必须先由语言侧转成集合运算,再交给感知。当前系统的常见做法是把否定降级成「先列出所有候选,再按属性过滤」,代价是多一轮感知调用。
这些失效模式的共同点是:它们都发生在接口层,而不是模型层。世界模型本身可能预测得很准,但条件给错了,输出就没有意义。这也是为什么具身系统的评测不能只看世界模型的 FVD 或成功率,还要看接地的准确率、追问率、陈旧率。评测栈的三层针对的是世界模型本身;接口层需要另一套指标。
小结
本篇补的是系列里一直空着的条件接口。可以收成四句话:
- 语言是寻址系统,不是观测模态。 它把指令解析成世界状态中的对象引用、空间关系与成功条件,再交给世界模型去评估后果。整句向量接法便宜但无绑定,适合全局属性;对象级接地才能支撑精确操作。
- 接地需要外部状态。 开放词汇检测与分割把名词钉到像素,三维场景图把多帧观测融合成持久、可查询、可编辑的物体图。场景图的成本按物体计费,失效点集中在关联、别名、陈旧与关系幻觉。
- 动作来自语言先验与物理可行性的乘积。 SayCan 的乘积打分、Inner Monologue 的文本闭环、Code as Policies 的策略代码、Voyager 的技能库,本质上都是在「应该」与「能够」之间做分工。世界模型在这条链里的角色是评估候选,不是产生候选。
- 三层分工决定了成本结构。 任务层秒级、评估层百毫秒级、执行层毫秒级;语言模型每轮都要调用,世界模型只在比较候选时调用。优化优先级是先减调用次数,再减单次延迟。
下一站可以往两个方向走。一个方向是主动感知:当场景图不确定时,机器人如何选择下一个观察动作来消除歧义——这本质上是把信息增益当成规划目标,与潜空间规划接得上。另一个方向是多模态指令:手势、视线与示范视频与语言同时给出时,条件怎么融合、冲突怎么裁决。这两个方向都在把「听懂一句话」从一次性解析变成闭环过程。
参考资料
- Do As I Can, Not As I Say: Grounding Language in Robotic Affordances
- Inner Monologue: Embodied Reasoning through Planning with Language Models
- Code as Policies: Language Model Programs for Embodied Control
- VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models
- ConceptGraphs: Open-Vocabulary 3D Scene Graphs for Perception and Planning
- Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection
- Segment Anything
- Learning Transferable Visual Models From Natural Language Supervision
- Learning Universal Policies via Text-Guided Video Generation
- RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
- Voyager: An Open-Ended Embodied Agent with Large Language Models
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



