


世界模型从零讲起(二十九):不确定的时候该往哪看——主动感知、信息增益与下一次观测的选择
承接前二十八篇:一个一直被当作免费的变量
这个系列从第一篇把世界模型写进 POMDP 开始,依次拆过四条主干路线:Dreamer 的潜空间重建、JEPA 的联合嵌入预测、视频生成式世界模型,以及把动作和画面一起生成的世界动作模型。围绕它们,又写了评测栈、部署与推理系统、能耗下界、潜空间规划、Dyna 谱系、几何表示、物体中心表示、分层抽象、动作接口、长程记忆、共享状态、闭环误差、跨会话迁移、物理先验、触觉、身体模型、数据引擎、自动驾驶,最后落在语言条件上。
回看这二十八篇,会发现一个共同的默认假设:观测是免费的。无论是 rollout、规划、评测还是语言接地,模型面前总有一帧或多帧已经到位的图像;讨论的焦点是「给定这一帧,下一步世界会变成什么样」。传感器被当成一个恒定速率、全向覆盖、无成本的输入源,就像训练脚本里读一个预先录好的数据集。
真实机器人不是这样。相机的视场角通常只有六十到九十度,机械臂会挡住镜头,柜门后面是黑的,深度相机照到玻璃会返回零,云台转过去要一秒多,底盘移动一米要两秒并且耗电。更关键的是,机器人在任一时刻只能看到一个局部的世界,而任务往往需要它掌握视野之外的物体状态。它必须做选择:现在就动手,还是先转过去看一眼?看左边还是看右边?看一次够不够?
这个选择在系列里其实已经出现过,只是没有被当成正题。第二十八篇讲语言接地的失效模式时,「陈旧状态」的缓解办法是「必要时先做一次主动观测(转头看一眼)」;第十七篇讲长程记忆时,隐含了一个替代方案——不重新看,而是从记忆里取;第十九篇讲闭环误差时,误差的源头正是「观测不到的那部分状态」。这些都指向同一个变量:下一次观测从哪里来,要花多少代价,能换回多少确定性。
本篇要补的就是这个变量。它包含三个问题:
- 一次观测的价值怎么量化?「多看一眼」到底值多少?
- 世界模型在其中扮演什么角色?它能算出信息增益,还是只能给出一个未经校准的猜测?
- 算出价值之后,怎么把它和移动成本、任务收益放在同一张账上,变成下一次观测动作?
先把结论放在前面:主动感知(active perception)的本质,是把感知本身当成动作——它不改变世界,只改变信念;它有权衡,因为时间、能量和暴露风险都是有限的;它的收益可以用信息增益(information gain)来定价,而世界模型正是那个提供「观测前预测分布」的部件。难点不在公式,而在三处工程现实:信息增益的估计必须校准、候选观测之间的信息高度相关、以及信息只有能改变决策时才有价值。
问题定义:感知本身也是一个动作
主动感知这个概念并不新。Bajcsy 在 1988 年的论文里把它定义为「观察者主动控制传感器的感知过程」,并提出感知策略应当由当前的不确定性驱动。机器人学后来把这条思路发展成主动建图、下一最佳视角(next-best-view)、主动 SLAM 等一串子领域。它的反命题是「被动感知」:传感器固定,数据来了就处理,处理不了就认了。
用 POMDP 的语言写下来会更清楚。第一篇已经给出过标准形式 :状态 、动作 、转移 、观测 、观测模型 、奖励 。主动感知只是把动作集合拆成两类:
- 执行动作 改变世界状态:移动基座、开柜门、抓取物体。它通常不可逆,有物理风险,失败要付出额外代价。
- 感知动作 近似不改变世界状态:转动相机、移动云台、改变视角、伸手触摸探测。它改变的是智能体对世界的信念,代价是时间和能量。
用转移函数说,感知动作满足 ——世界几乎没动,动的只是「我知道了多少」。观测则从观测模型采样:
这里 是先验信念, 是看到 之后的信念。写成贝叶斯形式后可以看到一件重要的事:感知动作只通过观测模型进入更新,执行动作只通过转移模型进入更新。两者在同一条信念更新式里扮演不同角色,这就是为什么「动力学模型」与「观测模型」在主动感知里必须分开讨论:前者预测状态怎么演化,后者预测从某个状态会看到什么。
一个最小的数值例子能把权衡说清楚。机械臂要找一只杯子,先验认为它在左侧架子的概率是 ,右侧 。抓取动作固定耗时 秒;抓空的代价是 秒(退回、重新瞄准、再抓一次)。看一眼某个架子的代价是 秒,并且能完全确定杯子在不在那里。两个策略的期望耗时是:
- 直接抓左边: 秒。
- 先看一眼左边: 秒。
看的收益是 秒。如果看一次要 秒(比如需要展开机械臂、避开遮挡、再收回来),直接抓反而更划算()。这个例子里的所有数字都可以换成别的,结论不变:
主动感知的整套形式化,都是在这条不等式上做文章。信息增益负责量化「决策改善」的那一半,成本模型负责另一半。
| 维度 | 执行动作 | 感知动作 |
|---|---|---|
| 是否改变世界状态 | 是 | 近似否 |
| 是否可逆 | 通常不可逆 | 可逆(转回去即可) |
| 主要代价 | 物理风险、不可撤销的后果 | 时间、能量、运动模糊 |
| 收益形式 | 任务进度 | 信念收缩、不确定性下降 |
| 失败模式 | 碰撞、掉落、损坏 | 看了但没看懂、看完世界已变 |
把感知当动作,会顺带解释一个常见困惑:为什么「多传感器融合」不等于「主动感知」。融合是把已经拿到的多路数据合成一个估计,感知动作集合是空的;主动感知要决定的是「下一路数据从哪里拿、要不要拿」。前者是估计问题,后者是控制问题。
信息增益是什么:从熵到互信息
要给一次观测定价,需要一个能衡量「不确定性减少了多少」的量。香农熵是标准答案。对离散信念 :
的单位是比特(以 2 为底),含义是「要把状态确定下来,平均还需要多少二进制问题」。当 集中在单一状态上时 ;当 有 个等概率取值时 。对于前面那个杯子例子,先验 :
完全确定杯子位置后,熵降到 。所以「看一眼能完全确定」带来的熵下降是 比特。但请注意,这里是无条件地认为看一眼就能确定;如果这一眼有噪声(比如玻璃反光导致看错),就得不到完整的一比特。
在有噪声的情况下,真正的度量不是熵的下降,而是预期熵下降,也就是观察前与观察后的互信息。设候选观测为随机变量 (取自某个观测动作 ),世界状态为 ,互信息定义为:
是看到观测值之后的平均剩余熵。第一项 是当前的先验不确定性,第二项是「看完之后平均还剩多少不确定性」。互信息的对称形式 有一个很好用的直觉:一次观测携带的信息,最多等于它自身的意外程度。如果观测结果在开看之前就能大概率猜到(比如某个区域必然是空的),那么 很小,信息量也很小。
把 展开成对所有可能观测值的期望:
这两行式子说明了一件会被反复用到的工程事实:计算互信息需要枚举所有可能的观测值 。真实的相机观测值是一个 的图像,取值空间不可枚举。这就是为什么实际系统里几乎从来不精确计算互信息,而是用代理指标——这一点会在下一节展开。
看一个带噪声的数值例子。设杯子只有「在左」 与「在右」 两种状态,先验 。相机看一眼,有 概率给出错误读数(对称噪声):
读数分布为 ,。看到 后按贝叶斯更新:
看到 后:
这两个残余熵并不相等。熵函数 关于 对称,而 离 比 更远:先验偏向左边时,「看到左边」把信念推得更极端,「看到右边」只能把它拉回接近五五开。按读数出现的概率加权:
用信道的另一侧验算:。 比特, 比特,差值同样是约 比特。
这里有两条容易混淆的上限:
- 信道容量上限:二元对称信道的容量是 , 时约 比特。这是无论先验如何都拿不到更多的上限。
- 先验熵上限:任何观测的互信息都不超过状态本身的熵。这个例子里先验熵只有 比特,即使相机完全无噪声,也只能拿到 比特。
两条上限一起看,得到一个实用的校准口径:当观测精度已经高于先验不确定性时,继续提高传感器精度没有意义。杯子只有两种可能位置时,把误码率从 降到 ,互信息最多从 升到 ;花在更高精度相机上的钱,不如花在「先看哪一边」的决策上。
把上面的计算整理成一张流程,就是任何主动感知系统的评估骨架:先验信念 → 候选观测的观测模型 → 对每个可能观测值做贝叶斯更新 → 算残余熵 → 取期望 → 与先验熵相减。真实系统只是给每一格换一个近似。
| 环节 | 精确形式 | 真实系统的近似 |
|---|---|---|
| 先验信念 | 离散状态上的分布 | 栅格占用概率 / 高斯 / 粒子集 |
| 观测模型 | 已知信道矩阵 | 传感器模型 + 深度不确定性建模 |
| 枚举观测值 | 有限集合 | 样本平均 / 特征级代理 / 方差 |
| 后验更新 | 贝叶斯 | 占据栅格的对数几率更新 / Kalman 更新 |
| 收益 | 熵下降、协方差行列式、模型分歧度 |
下节讨论「真实系统的近似」这一列时,会看到不同流派其实是在选择不同的代理量,而代理量选得好不好,直接决定了系统会不会把预算花在毫无价值的观察上。
世界模型怎么给出信息增益的估计
上一节的流程里,每一步都需要一个「给定观测动作,我会看到什么」的模型,以及一个「这个观测之后状态还剩多少不确定」的模型。这两件事,在系列的广义定义里都属于世界模型:动力学部分负责「状态怎么演化」,解码部分负责「状态会渲染成什么观测」。这也是为什么主动感知和世界模型天然耦合:世界模型不只能预测「世界会变成什么样」,还能预测「不同视角下会看到什么」,后者就是信息增益的基础。
按世界模型的路线,估计方法可以分成四类。它们的计算成本、校准难度和适用场景差别很大。
第一类:模型分歧度(latent disagreement)
Plan2Explore 是这一类最干净的样本。它于 2020 年由 Sekar 等人提出(arXiv:2005.05960),核心做法是训练一个集成世界模型,每个成员 给出自己的潜空间预测 ,然后用成员之间的方差代替信息增益:
这里 是集成成员数, 是第 个成员在潜空间给出的下一状态预测, 是它们的均值。方差大,说明「模型们意见不一致」,通常意味着这个区域的数据少、模型没把握,所以多看这里能学到更多。
这个量在信息论上有出处:在模型参数 不确定性主导的情况下,集成方差近似于认知不确定性(epistemic uncertainty),而信息增益正是认知不确定性的减少量。把它写成互信息的形式,可以把「参数不确定性」显式化:
严格说,互信息不能移进期望内部;上面的式子是常见的近似写法:把「用平均模型算出的熵」减「成员熵的平均」,在单峰、单参数的后验里与真实互信息同号且同量级。用高斯近似,两项都退化为协方差的对数行列式,差值近似正比于成员预测的均值方差。这也是为什么很多实现直接用方差当分数,而不是用完整的互信息。
Plan2Explore 的用法值得细看:它在探索阶段没有外部奖励函数,把分歧度当成内在奖励,训练一个「探索策略」;同时它不只学一个策略,而是学一族带不同偏好权重的探索策略,让每个策略各自去访问擅长采集的那片区域。测试时才给出真正的奖励,从探索阶段攒下的数据拟合任务策略与价值网络,再零样本或少样本地解决新任务。下面这张图来自论文原图。
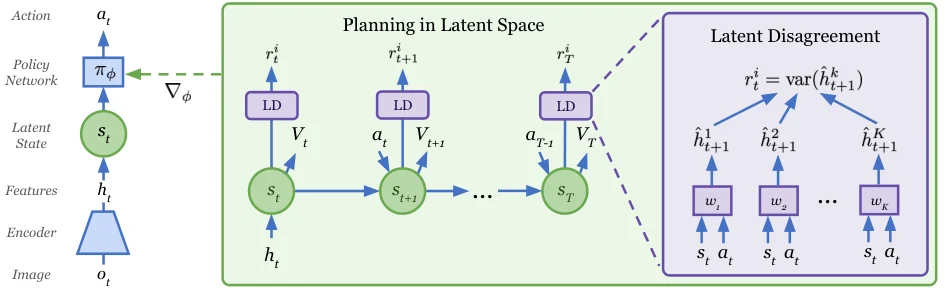
上图对应 Plan2Explore 的 Figure 2。左侧是观测编码器与循环潜状态推断,中间是「潜空间中的动作规划」,右侧是「潜空间分歧」模块:多个集成成员各自给出下一潜状态的预测,方差被转化为探索奖励。这张图的重点在于,分歧度是在潜空间里算的,而不是在像素空间里。潜空间的低维特性使得方差有意义、噪声可控——如果直接在像素上算方差,纹理细节的背景会让方差爆炸,即使那个区域对决策毫无影响。
Plan2Explore 的论文还给出了一个值得记住的实现细节:分歧度不是只比「一步预测」,而是在潜空间里对多步想象做比较。探索策略在潜空间里做 rollout,对每一步的预测都累计分歧度,然后把累计值写成内在奖励。这一点让「信息增益」从「下一步会看到什么」上升到「接下来一段轨迹里会出现多少新奇」,也就是从单步互信息走向多步累积的路径信息。代价是 rollout 深度越长,计算量越大,所以论文给出的深度是一个经验折中。
这一类方法的代价与局限很明确:需要训练和维护 个模型成员,推理时要前向 次,训练时显存与算力都按 放大;成员之间的分歧是否真能代表信息增益,强烈依赖于集成是否足够多样,也依赖于潜空间里「距离」是否有语义。在真实机器人上,这类方法更适合用在学习阶段(探索数据收集),而不是每一个控制周期。
第二类:显式概率模型上的熵
如果世界状态用显式概率模型表示,信息增益就可以直接按定义计算。最常见的是占用栅格(occupancy grid):每个栅格 存储「被占据」的概率 ,或者更方便地存储对数几率 。栅格地图的整体不确定性用所有栅格熵的和:
一次候选观测(从某位置、某朝向往某个方向看)由射线投射给出:射线扫过的栅格集合 会获得观测,其余的保持原样。信息增益近似为被观测栅格熵下降之和:
是按传感器模型更新后的概率。这个式子在栅格上可以逐格精确计算,因为每格的观测模型都是二元的(「射线到达前碰到物体」与「射线穿过」)。代价是它忽略了栅格之间的相关性:实际地图里相邻栅格高度相关,相加求熵会系统性高估(这也是「栅格熵地图」方法被批评的原因之一,后面讲失效模式时还会回到)。更严重的缺陷是,栅格的信息增益只关心「地图覆盖了多少面积」,而不关心「这些面积对任务有没有用」。房间角落的地图熵再高,对「把杯子放进水槽」也没有任何帮助。
占用栅格之上可以叠加语义与几何约束。GenNBV 是 2024 年的一篇代表性工作(arXiv:2402.16174),它把下一步最佳视角变成了一个端到端可训练的策略,并改用强化学习训练:动作空间扩成能自由移动位置的五维空间(位置加朝向),奖励与下一步视角的收益挂钩,输入是历史多源观测(RGB、深度、位姿)编码成的混合场景表示。下图是该论文的 Figure 2。
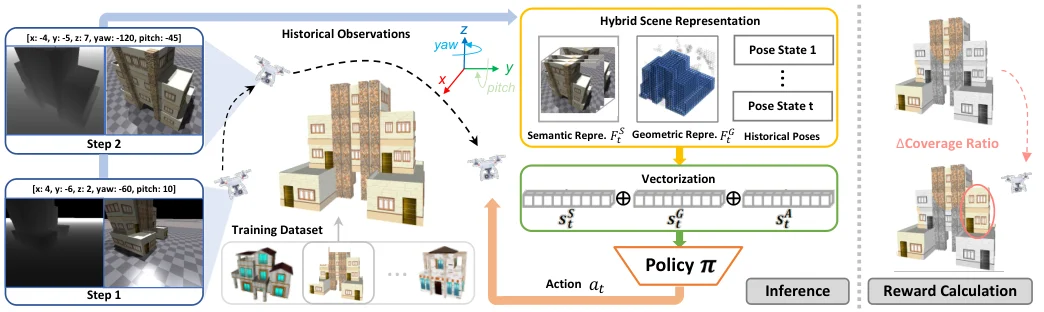
这张图表达的是「从手工设计的信息增益公式,转向学习出来的视角策略」。左半部分是历史观测的多源输入与它们到混合表示的编码,右半部分是端到端的下一个视角动作与训练信号。它回避了显式互信息的计算,代价是训练分布之外的场景可能表现不稳——这也是为什么原文强调跨数据集泛化实验(Houses3K 到 OmniObject3D)。对「信息增益估计」来说,这是一种用数据换公式的路线:先学出一个近似,再用覆盖面、精度等终局指标反推它是否可信。
第三类:从观测结果反推(渲染—比较)
几何式世界模型(第十二篇讲过 NeRF 与 3D Gaussian Splatting)可以渲染从任意视角看到的图像。于是信息增益可以绕开「先验分布」的计算,改用「渲染一致性」来度量:在候选视角 渲染一张图,与当前已有的重建比较,差异越大说明该视角的信息越新。ActiveSplat(arXiv:2410.21955,2024)就属这类,它把高斯地图与 Voronoi 拓扑图结合,在局部区域内优先选择「信息量高、覆盖少」的节点,用分层规划决定先扩充哪片区域(下图是它的系统总览图)。
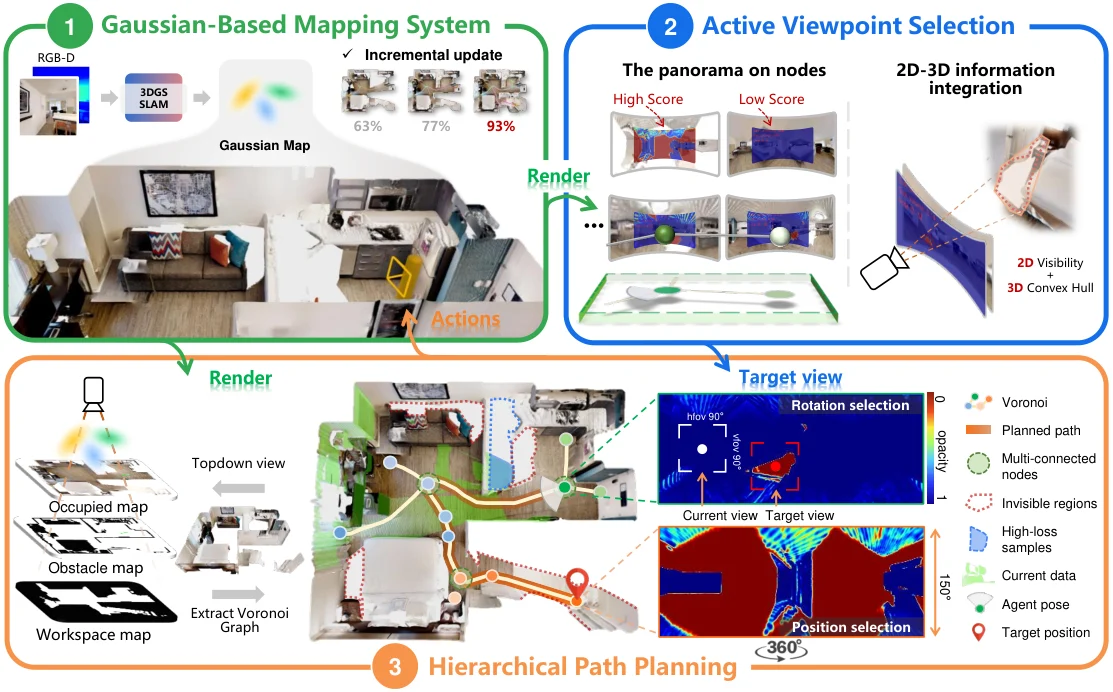
图的左侧是高斯地图的增量更新(SLAM 一体化),中间是「按节点打分选择主动视角」——对每个可见节点渲染并计算信息量/损失;右侧是分层路径规划,把选中的区域落到可执行的移动与旋转动作上。这里的信息增益不是熵,而是「渲染出来的图和已有观测差多少」。这种代理在重建任务里非常合理,因为重建的目标就是让所有视角都渲染得准;但它把「看见」等同于「对重建有增益」,对任务导向的机器人来说,重建得很好的空墙面并不值得再看一眼。
第四类:直接学习一个视角价值网络
第四类把「下一次看哪里」直接做成一个学习任务。VIN-NBV(arXiv:2505.06219,2025)用一个「视角内省网络」(View Introspection Network, VIN)对候选视角直接打分,预测的相对重建改进(relative reconstruction improvement)。原文强调这个网络不需要真的采集新图像,而是利用已有的多视角观测「内省」出候选视角的价值;得到分数后用顺序采样的贪心策略逐个选视角(下图是该论文的架构图)。
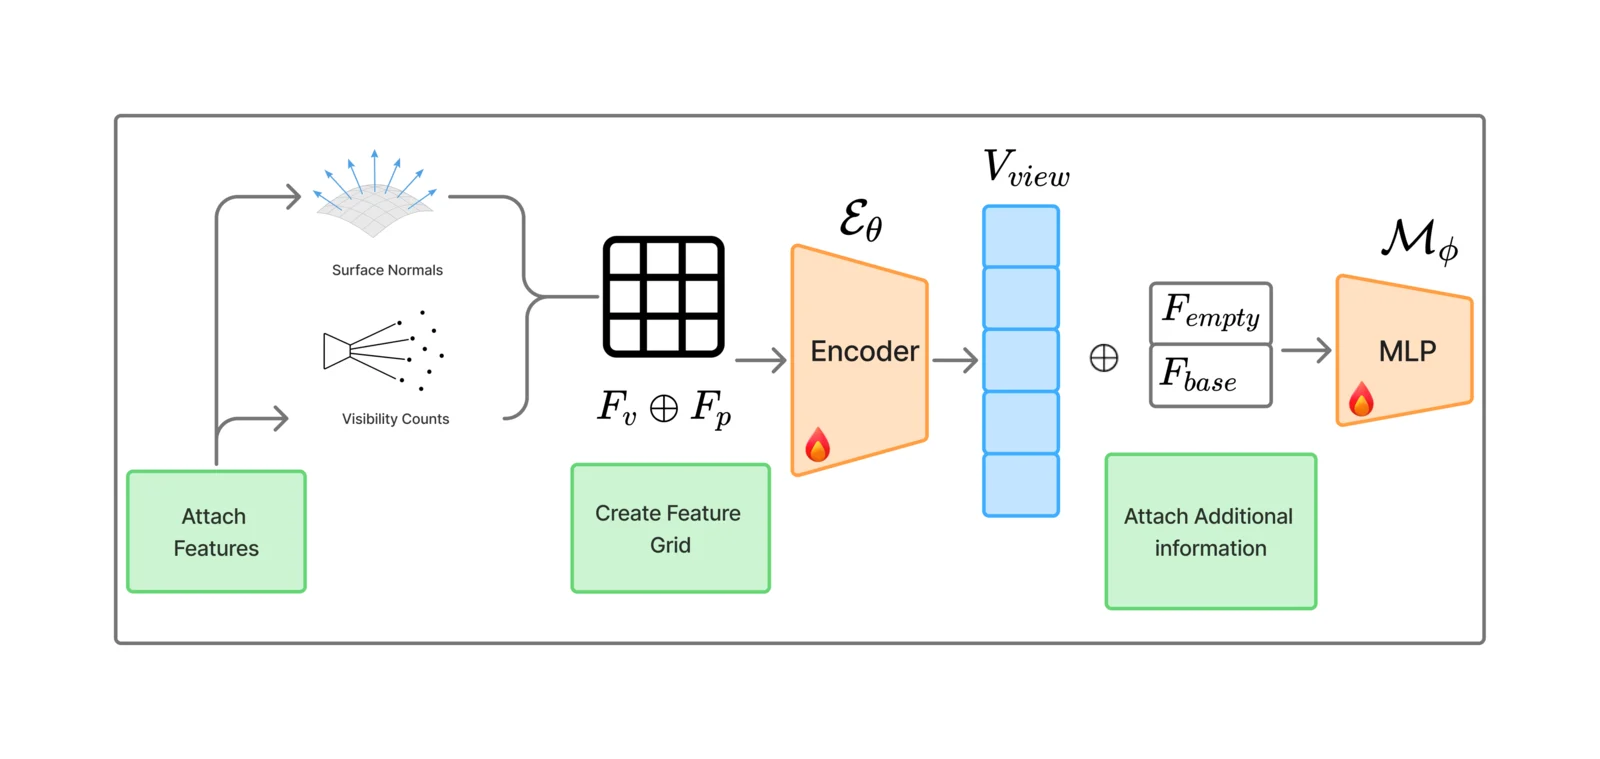
这一类方法的优点是:训练完成后,推理只需要对候选集合做网络前向,不必为每个候选做一次真实采集或完整渲染,单次决策的成本可控。缺点是分数是「经验性」的,必须用大量轨迹与终局指标校准(比如固定视角数之后的重构质量),而不是每一条轨迹上每一步的真正信息量。原文明确把「覆盖率」当作粗糙代理、把「相对重建改进」当作更贴近目标的信号,这组对照本身就是对「代理指标够不够用」的一次校准实验。
把这四类放在一张表里:
| 流派 | 信息量代理 | 代表工作 | 单次决策成本 | 主要弱点 |
|---|---|---|---|---|
| 模型分歧度 | 集成成员潜空间方差 | Plan2Explore | $K$ 次前向 | 只适合学习期、需多样集成 |
| 显式概率地图 | 栅格/地图熵下降 | 占用栅格、GenNBV | 射线投射 + 逐格更新 | 忽略栅格相关、与任务无关 |
| 渲染—比较 | 渲染差异/重建损失 | ActiveSplat | 渲染候选视角 | 服务重建而非任务 |
| 学习打分 | 视角价值网络 | VIN-NBV | 一次批量前向 | 依赖校准数据分布 |
一条完整的估算链:粒子滤波上的熵
前面三类方法都在「如何打分」上做取舍,还有一个方向是把不确定性本身表示得更细,让信息增益能逐时刻计算。粒子滤波是其中最有代表性的做法。
粒子滤波用一组带权粒子 近似信念 ,每个粒子是一个具体的状态样本,权重和为 。观测 到来后,权重按似然更新:
粒子的熵没有闭式表达,实践中用有效样本数(effective sample size)当代理:
越大,说明权重分布越均匀,信念越分散; 越小,说明少数粒子吞掉了大部分权重,信念越集中。熵越高, 越大,所以可以用预期 当熵的反向代理:候选观测的预期 越小,说明它能带来的信念收缩越强。对候选观测 ,可以对每个粒子按观测模型采样出一组可能的观测值,再各自做一次权重更新,取 的期望。这个过程不需要假设状态是离散的,也不需要栅格化——这是粒子滤波相对占用栅格的优势:它天然支持连续、多模态的信念(比如「杯子可能在这两个位置的任一个」)。
代价是计算量随粒子数 线性增长,且每次候选观测都要采样:。若 ,射线 64 条,候选 32 个,每步就要跑 次似然评估。在机载 CPU 上这通常已经超出一帧预算,因此常被限制在「高价值区域」上:先用栅格粗筛选区,再在区域内用粒子精细估计。
粒子滤波还有两个工程细节值得知道。第一是退化:长时间运行后,绝大多数权重集中到少数粒子上, 长期偏低,此时即使观测很精确,熵也很难再下降——「再怎么看也一样」,主动感知会误判为「没有信息可拿」。缓解办法是重采样(resampling)与注入新粒子(roughening),把多样性恢复回来。第二是采样偏置:如果没有对观测模型做正确的归一化,候选观测之间的 比较会带上系统性偏差,导致系统总是偏好某类视角。
四类的共同点比差异更重要:它们都不是在计算真正的 ,而是在计算一个与该值单调相关的、更容易计算的代理。因此主动感知系统质量的第一道关,不是「公式是否优雅」,而是「代理是否在真正需要的地方给出高价值」。下一节讨论的正是:拿到代理分数之后,怎么把它变成一次观测动作,以及这一步为什么比打分本身更容易出问题。
高斯信念下的信息增益:一个可以手算的特例
前面所有的计算都是二元离散的。真实系统里更常见的是连续状态 + 高斯后验:物体的位姿、相机的外参、机械臂末端的偏移,都可以用均值与协方差表示。高斯情形的好处是信息增益有闭式,可以拿来检验各种近似是否靠谱。
设状态 ,先验 。一次线性高斯观测写成 ,, 是观测矩阵(比如某个视角下「投影矩阵」的线性化), 是传感器噪声协方差。高斯分布的信息熵是
后验协方差按卡尔曼更新式为
于是信息增益退化为对数行列式之比:
这个式子有一个很直观的读法: 是「通过这个视角、在这个噪声水平下,能获得多少关于各状态方向的信息」;它与先验协方差 相乘再取对数行列式,等于「在信息最缺的方向上能得到多少互补」。如果某个方向先验已经被钉死( 在该方向很小),再去看也拿不到增益;如果某个方向传感器噪声太大( 大),看了也白看。
用前面的杯子例子做个对照:设位置的一维坐标 的先验标准差为 ,观测的标准差为 (等价于约「十档里看错一档」的精度),。代入上式: nat,换算成比特约 比特。与二元情形下带噪声的 比特接近,差异来自两者对「状态」的定义不同。这解释了为什么工程上常在高斯假设下直接算对数行列式,而不去处理离散的贝叶斯更新。
高斯特例还揭示了一个工程上很有用的性质:增益只取决于「先验与新观测的不确定性之比」,与绝对尺度无关。把单位从米换成厘米, 乘以 、 也乘以 ,比值不变,增益也不变。因此可以放心把不同量纲的状态(位置、角度、速度)放进同一个高斯里计算,只要各自的噪声模型一致。
局限也很明显:高斯假设要求后验是单峰的。真实的物体位置可能有两个模态(杯子可能在两个架子上),此时高斯会把两个模态平均成一个「中间位置」,信息增益的估计会失真。这是「粒子滤波」一节存在的理由:粒子能表示多峰分布,代价是计算量。
从信息增益到动作:下一次看哪里
有了分数,下一步是把分数变成一个可执行的观测动作。这一步看起来只是「取最大值」,实际上有三层决策:候选从哪里来、怎么和成本合并、要不要考虑多步。
候选观测集合
最直观的做法是离散化:在机器人周围放一圈候选位姿,或者在三维空间里撒一组视角。视角由位置 与朝向 决定,通常还要加上相机内参限制。离散化的密度决定了两件事:太稀,可能错过真正有信息的位置;太密,每个候选都要做一次射线投射或渲染,决策延迟会线性增长。
工业界的常用折中是分层候选:先在粗粒度(每个房间、每个区域)上选「去哪一片」,再在细粒度上选具体位姿。ActiveSplat 把这个想法做成显式的两层结构:
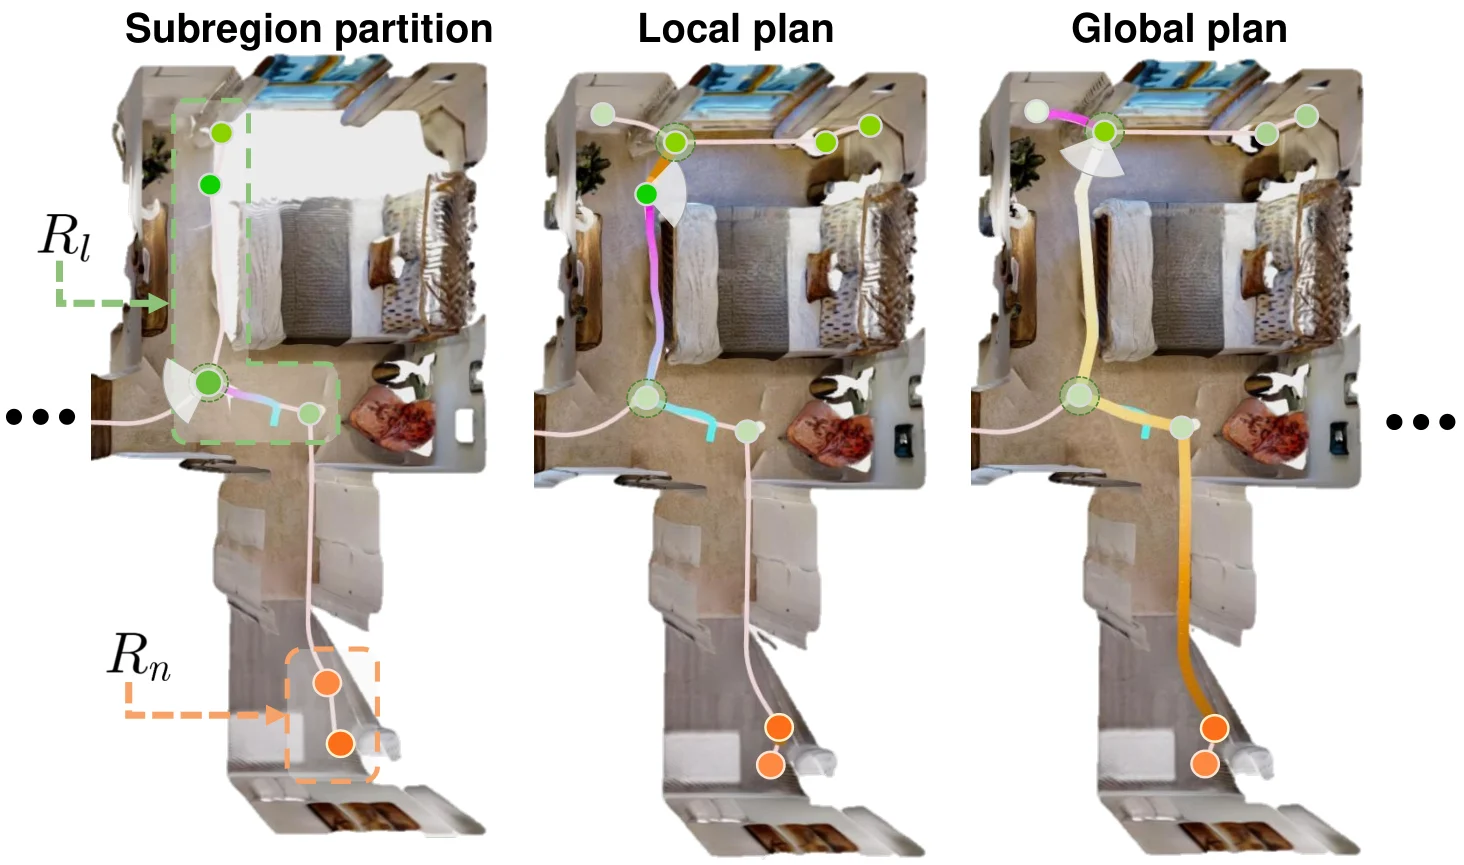
图中的绿色节点是已经获得足够观测的局部区域,橙色节点是全局得分最高的待探索子区域。分层的好处不只是省算力,更重要的是避免局部贪心:如果只在最近的候选里选信息增益最高的,机器人容易在一个信息密集的角落反复打转(那里始终有新的遮挡和视角),而迟迟不去另一个房间。分层结构用一个全局分数来强制它「看完一片就换一片」。
成本项怎么进分数
常见有两种合成方式,各有适用场景:
是观测成本,通常由三部分组成:移动距离/时间、云台或机械臂的动作时间、以及风险(进入狭窄区域、靠近人)。 是把比特换算成秒的汇率。
两式的区别在于对尺度的敏感性。差值形式对「信息量」的绝对大小敏感:当所有候选的信息量都很小(比如场景已经基本看全)时,差值形式会自动抑制一切动作, 占主导,系统停止观察——这正是我们想要的停止行为。比值形式则天然鼓励「顺路看一眼」,即使信息量很小,只要成本更低,比值仍然可能最高;代价是它没有内建的停止准则,需要额外设阈值,否则系统会永远追着「便宜的微小信息」跑。
选择哪个形式,取决于任务:重建类任务(追求覆盖率)适合比值,因为边际信息再多也值得拿;任务导向的机器人适合差值,因为信息必须能换成任务收益,且在信息饱和后应当停止。
一个容易忽略的细节:观测之间不独立
贪心地逐个选「当前最高分」的视角,会遇到一个系统性问题:相邻视角高度相关。选完左边 30 度,再选左边 31 度,信息增益几乎为零,但分数仍然会显示为正。原因是评分时用的是「当前信念」,而信念在两次观测之间并没有被真正更新(如果更新了,第二次的分数自然会降下来)。工程上有三种处理:
- 串行更新:选一个、真的看一个、更新信念、再选下一个。代价是决策次数多,时间开销大。
- 批量去相关:在批量选择时加入惩罚项,把已选视角的邻域从候选里剔除,或者用信息矩阵的联合增益近似。
- 利用子模性:互信息在许多常见模型下是近似子模的(submodular)——新增一个视角带来的增益,随着已选集合变大而递减。子模函数(或近似子模函数)的最大化可以用贪心算法得到接近 的保证。这条性质是批量主动感知的理论依据,也是「贪心为什么常常够用」的答案。需要说明的是:子模性对一般 POMDP 并非普遍成立,传感器噪声较大时熵函数甚至可能呈超模的局部行为,所以工程上把它当经验规律,而不是定理。
第三条值得多写两句,因为它在工程上很实用。设候选集合为 ,要选 个视角,目标是最大化 。直接枚举组合是 ,不可行。在满足子模性的前提下,有 ,只要 。于是贪心地每次选增益最大者,得到的解至少是最优解的 (对无约束的最大化;如果附带成本预算,则是 倍的带权版本)。这解释了为什么大量实际系统用贪心:多数时候它与最优相差不大,并且实现简单、可解释。
单步贪心之外
贪心还有第二个问题:短视。有些观测单独看收益不高,但它解锁了后续更高收益的观测。比如从远处看货架只能看到模糊的色块,走近一步后才能看清标签;第一步的「信息增益」很小,但两步合起来的收益很大。单步贪心会跳过它。
处理短视有几种办法,成本依次上升:
- 折扣前瞻:对候选动作的分数加上「执行后一步的最优分数」的折扣估计。相当于做两步搜索。
- 把 VOI 纳入蒙特卡洛树搜索:把观测动作和执行动作放进同一棵树,用 rollout 估计长期收益。第八篇讲潜空间规划时拆过 MCTS 的机制,这里的差别只是动作集合里多了感知动作,树的每一层都要为「看一眼」留出分支。
- 学出来的价值函数:直接训练一个「看这里值多少」的网络,把长期收益压进单次打分。VIN-NBV 属于这一类的简化版。
短视与成本的权衡很直接:前瞻越深,单次决策越慢,而主动感知本身是有时限的(机器人不能站着想十秒再转头)。多数实时系统采用「一步打分 + 分层候选 + 少量前瞻」的组合,而不是完整的多步搜索。
什么时候停止看
停止准则常被忽略,但它决定了系统的实际效率。最朴素的做法是固定次数(「每个任务最多看三次」),简单但僵硬。更合理的是当边际收益低于阈值时停止:
这个准则在差值形式下是内建的,在比值形式下需要人为设定。还有一类停止准则来自决策稳定性:如果当前最优执行动作在多种可能的观测结果下都不变,那么再看也不会改变决策,应当停止。这正是下一节要讲的「信息价值」的核心:信息之所以有价值,是因为它能改变你将要做什么。
实现:占用栅格、射线投射与候选视角的批量评估
这一节把上面的公式落到一个能跑的实现上。选占用栅格作为载体,不是因为它最好,而是因为它把「信念、观测模型、更新」三件事都摆在了明面上,而且第十二篇已经铺垫过占用栅格与几何表示,可以接着讲。
栅格与对数几率
每个栅格单元存一个概率 ,工程上存对数几率更稳:
对数几率的好处是贝叶斯更新变成加法。传感器的一次读数(射线穿过、或射线在此终止)对应一个对数几率增量:
这个量在文献里叫逆传感器模型(inverse sensor model)。命中时给正值(更可能是被占据),穿过时给负值(更可能是空的),同时要限幅,因为重复观测会不断累加,若不加限制,概率会饱和到 0 或 1,再也无法被新证据修正。常见做法是把 截断在 ,对应概率下限约 到上限 (例如 时对应约 )。限幅是工程上的近似,代价是地图不再严格贝叶斯,但换来的是对传感器故障的鲁棒性——一次错误读数不会永久烧死一个栅格。
一次候选视角的评估
对一个候选视角,评估分四步:把视锥内的栅格找出来、沿每条射线走到第一个未知或占据的单元、对沿途单元模拟更新、累加熵的变化。用伪代码表示:
def evaluate_view(grid, pose, rays, sensor_model, max_range): gain_expected = 0.0 for ray in rays: # 通常几百到几千条 cells, hit = cast_ray(grid, pose, ray, max_range) for (i, j) in cells: # 射线扫过的栅格 l_old = grid.log_odds[i, j] p_old = sigmoid(l_old) # 两种可能读数:命中 / 穿过 p_hit_reading = expected_hit_prob(grid, cells, ray) gain = 0.0 for reading, p_read in (("hit", p_hit_reading), ("pass", 1 - p_hit_reading)): l_new = clamp(l_old + sensor_model.log_odds(reading, i, j)) gain += p_read * (entropy(p_old) - entropy(sigmoid(l_new))) gain_expected += gain if hit is not None: # 命中点之外的栅格不变 break return gain_expected这段代码背后有三个容易被忽略的工程点。
第一,射线扫描到的栅格数按深度增长。一条 10 米长的射线在 5 厘米分辨率下最多扫过 200 格。若每帧评估 512 条射线、64 个候选视角,单次决策的栅格更新次数是 。这个量级在 CPU 上要几十到上百毫秒,在 GPU 上可以做到几毫秒——前提是把「候选视角」这一维也并行起来。实际实现里,候选视角是 batch 维,射线是另一个维,栅格更新用 gather/scatter 完成。
第二,期望更新需要预测读数分布。上面的 expected_hit_prob 是「这条射线在半路遇到物体的概率」,它由当前地图沿射线方向的占据概率累积得到。精确计算要沿射线做一次生存分析:射线走到第 格仍未终止的概率,等于前面所有格都为空且在第 格终止的概率。很多实现为了省时间直接用「第一个未知格」或「第一个概率超过阈值的格」当作命中点,这会让信息增益系统性偏高——因为它在「未知区域很大」的地方给出过高的期望收益,机器人于是总往黑暗处跑。
第三,深度传感器的噪声随距离增长,典型模型是 (三角测量原理)。如果把每个栅格的观测模型当成距离无关的常数,远处的读数会被赋予与近处相同的可信度,信息增益的估计就会高估远处视角的价值。缓解办法是给对数几率增量乘以一个随距离衰减的置信权重,或者在候选评分时直接引入「距离惩罚」。
一张账:分辨率与内存
占据栅格的内存很容易估算。以 的室内空间、5 厘米分辨率为例:
若每格用 2 字节(半精度对数几率)加 1 字节置信度,约 29 MB;若用 1 字节近似,约 9.6 MB,可以放进显存和地图一起常驻。降到 10 厘米分辨率,格数减少到八分之一,主动感知的决策速度会明显提升,但细小的遮挡(桌腿、线缆)会被抹平,信息增益的空间分布也随之改变。分辨率的选择没有标准答案,必须和任务尺度对齐:抓取任务关心厘米级,房间级导航关心十厘米级。
一条可以跑的伪代码:带成本的候选排序
把前面的「候选—打分—成本—裁决」串起来,给出一个完整的伪代码。它不依赖具体的信息代理,任何实现都可以嵌入 score_view:
def choose_next_view(belief, candidates, budget_ms, ig_fn, voimap_fn): scored = [] for pose in candidates: ig = ig_fn(belief, pose) # 信息代理:栅格熵 / 渲染差 / 网络分 cost = path_cost(belief.pose, pose) # 移动 + 稳定时间 + 风险 scored.append((ig - lambda_s * cost, pose, ig, cost))
# 粗筛:只对前 K 个候选做贵计算 scored.sort(key=lambda t: t[0], reverse=True) topk = scored[:K]
# 裁决:VOI 只关心「会不会改变执行动作」 for rank, (s, pose, ig, cost) in enumerate(topk): if s <= 0: # 差值形式的内建停止条件 return None # 停止观测 if voimap_fn(pose) > cost * lambda_v: # 信息能换成任务收益 if time_left(budget_ms) > cost: return pose # 若 VOI 不足以抵消成本,跳过该候选 return None这段伪代码有三处值得注意。
第一,score_view 的返回值必须是可比的。如果不同模块用不同代理(比如地图熵以比特计、渲染差以 PSNR 计),直接把它们的输出混在一起排序会得到无意义的结果。工程上通常把所有代理归一化成同一个标尺(比如都转成「预期减少的决策后悔」),或者在候选集合内部各自归一化后再混合——但后者在不同场景之间不可比,不能用来做跨场景的阈值。
第二,path_cost 要包含非运动的时间。稳定时间、遮挡调整、安全等待往往在数值上超过移动时间,如果漏掉,系统会以为「转一下很近」而过度观察。
第三,voimap_fn 的粒度。一个常见错误是把 VOI 做成「每个候选视角的精确值」,计算量爆炸。更实用的做法是把它做成一个粗糙的「任务相关区域得分表」:语言指令解析出目标物体,生成一个空间掩码,候选视角在掩码内得高分、掩码外得分低。这个表便宜到几乎免费,但能过滤掉大多数「任务无关」的观测。
批量评估的加速结构
工程上通常叠三层加速:
- 粗筛:先用视锥与地图的快速相交,剔掉视野完全已知的候选;通常能筛掉一半以上。
- 低分辨率预评分:在 10 厘米或 20 厘米栅格上先算一遍增益,取前 个候选进入细评。
- 增量计算:相邻候选视角共享大量射线(转动一度,射线只偏移一点),可以复用上一轮的部分结果,只重算增量部分。
这三层的顺序不能反。先细评再粗筛会把时间浪费在明显无用的候选上;先增量再粗筛则会让增量结构变得复杂,得不偿失。一个可用的经验是:粗筛决定延迟的下限,细评决定决策的质量。延迟超标时先砍细评的候选数,而不是砍粗筛的阈值。
感知与执行的双环:信息价值如何进入规划
到目前为止,「看」还是一个独立于任务的决策。真实系统里,看是为了做,所以有必要把两者放进同一个规划框架里比较。这个框架在决策论里有现成的名字:信息价值(value of information, VOI)。
设执行动作集合为 ,奖励为 。注意,真实场景里机器人面对的通常是 POMDP 而不是 MDP:观测不直接给出 ,智能体只能看到 。VOI 在这两种情形下都成立,区别在于「先看再选」的期望是对观测量 和隐藏状态 同时取期望。为了简化,下面用「完全观测」写成直觉版本,实现时把 换成后验 即可。
它的期望值是 。若先做一次观测得到 ,再按后验 选动作,则先观测再执行的期望值是:
信息价值定义为两者之差:
这一个式子值得反复看,因为它把前几节的碎片串了起来:
- 它天然考虑了任务。不改变最优动作的观测,,即使信息量的绝对值很大。
- 它是有界的: 永远不超过「完全知道状态时的最优期望奖励」减去 ;这来自 Jensen 不等式——对凸的 max 函数取期望,结果不小于先取期望再取 max。所以再精确的传感器也有上限,超过上限的钱是白花的。
- 它与互信息正相关,但只在特定条件下可以写成互信息的函数。在「奖励是状态的确定性函数且状态空间是线性高斯」等简化模型里,二者有单调关系;一般情况下它们只是正相关,不是相等。这个区别在实践中很重要:用 IG 排序、用 VOI 裁决,正是为了弥补两者之间的缺口。
对前面那个杯子例子算一下 VOI。两种执行动作(抓左、抓右),奖励「抓对 +10,抓错 -10」(前面用时间成本表述,这里换成奖励表述以便对照)。先验 :
无噪声观测下,看到左就去左,看到右就去右,,所以 。带 噪声时,看到左后后验是 ,期望奖励 ;看到右后后验是 ,选右的期望奖励 。两个读数出现的概率分别是 与 ,加权得到
所以 :噪声让信息价值从 掉到 ,衰减 。同一组数字下,互信息从 掉到 ,衰减约 。两者都下降,但幅度不同,这正说明互信息与信息价值不是同一个量:信念收缩了一半,决策收益只损失四分之一,因为即使后验不完美,最优动作被正确选中的概率仍然很高。
把 VOI 和上一节的观测成本放在一起,就得到了完整的决策准则:
这与前面的「」是同一条不等式的两种写法,区别在于左边用的是任务相关的 VOI,而不是任务无关的信息增益。
实现 VOI 并不比实现信息增益简单,它带来两个新的计算负担:
第一,要枚举执行动作并估计每个动作在各种后验下的期望奖励。执行动作空间通常连续(抓取位姿是 6 自由度),只能采样。这部分计算可以复用世界模型:用世界模型 rollout 每个候选动作在每种可能观测下的后果,再按奖励函数评估。于是世界模型的推理成本被乘上了「候选动作数 × 可能观测数」。这正是第九篇讲推理系统账本时提到的乘数问题。
第二,要枚举可能的观测结果,同上一节。区别是这里枚举观测的粒度可以更粗——因为 VOI 只关心「观测结果的划分是否改变了最优动作」,不需要每个像素级结果都精确。一个实用的近似是:把观测结果按「是否会让最优动作翻转」聚成几类,只对类别的概率做粗估。比如杯子例子只需要区分「看到左」「看到右」两类;真实任务可以区分「看得到/看不清/看不到」。
工程上常见的折中是用 VOI 做裁决,用信息增益做排序。信息增益负责给出候选观测的排序(便宜、任务无关),VOI 只对最高分的少数几个候选做精细评估(贵、任务相关)。这样兼顾了速度与相关性。
把两环画成一个决策循环:
- 信念:从世界模型与地图中得到当前状态分布与不确定性图。
- 打分:对候选观测算信息增益,得到排序。
- 裁决:对前几名计算 VOI,与成本比较,决定是否看、看哪里。
- 执行观测:移动云台/底盘,更新地图与信念。
- 执行动作:若裁决为「不看」或观测完成,进入任务动作。
- 回环:执行动作之后世界改变,回到第 1 步。
这个循环与第七篇讲的部署环节是同一套东西的不同视角:那里关心的是延迟预算,这里关心的是每一步「看还是做」的裁决。两篇合起来,才是一个完整的「感知—决策—执行」运行时。
观测一次要多久:一个端到端的延迟估算
主动感知的决策如果要落在控制周期里,必须知道每一步「看」要花多久。把一次观测的链路拆开,每一项都有典型量级:
| 环节 | 典型耗时 | 可否并行 |
|---|---|---|
| 候选生成与粗筛 | 1–5 ms | 与地图更新可重叠 |
| 栅格/粒子的增益评估 | 5–50 ms(CPU),1–5 ms(GPU 批量) | batch 维并行 |
| VOI 裁决(前 K 个) | 10–100 ms | 只对少数候选做 |
| 云台/底盘运动 | 300 ms–3 s | 不可并行,是瓶颈 |
| 运动后的稳定与采集 | 100 ms–1 s | 不可并行 |
| 地图与信念更新 | 5–30 ms | 与下一次决策可重叠 |
第一眼看上去,计算部分并不慢——慢的是物理运动。这也决定了优化的优先级:先减少无效观测,再优化计算。一个每步多花 20 毫秒计算、但能把三次观测压缩到两次的系统,整体延迟下降远大于把计算从 20 毫秒压到 5 毫秒的系统。这个结论在实践中常常被反过来:大家先优化计算,再发现物理运动才是主要开销。
工程坑与失效模式
把主动感知跑起来之后,出问题的往往不是公式,而是公式与物理世界之间的缝隙。下面几种失效在真实系统里反复出现,每一种都给出机制与缓解。
把「不确定」当成「值得看」
这是最常见的一类。信息增益的定义里有一个隐含前提:看过之后不确定性会真的下降。但在两类情况下它不成立。
第一类是偶然不确定性(aleatoric uncertainty):传感器本身的噪声、场景的随机纹理、透明物体的深度缺失。这一项在第七篇讲部署观测与第十九篇讲闭环误差时都出现过:前者以「传感器噪声底」的形式进入延迟与精度预算,后者以「观测误差」的形式放大长程偏差。这些不确定性再怎么看也不会下降。若系统用总方差当分数,它会把全部预算花在这些「永远看不清楚」的地方。Pathak 等人在 2017 年的好奇心驱动(ICM)工作里就遇到了这个问题:智能体把内在奖励的预算花在随机噪声源上,因为那里的预测误差永远最大。后来 Burda 等人在 2018 年的随机网络蒸馏(RND)工作里把这个现象命名为「噪声电视问题」:面对一个随机闪烁的电视,预测误差无法消除,内在奖励却一直很高。
第二类是模型自身的认知不确定性与环境的真实不确定性混淆。2026 年的工作《Breaking the Epistemic Trap》把这种复合不确定性单独拿出来分析:世界模型对「自己不知道什么」也可能判断错误,于是它自信地去看一个其实没用的地方,或者忽略一个其实关键的区域。缓解办法是显式区分两类不确定度:用集成分歧估计认知不确定性,用异方差输出估计偶然不确定性,只在认知部分上做主动感知;同时对同一区域的重复访问加惩罚,避免「噪声电视」式打转。
潜空间里的熵不可比
第四节的集成方差有一个隐蔽问题:它是在学习出来的潜空间里算的。潜空间的坐标是任意的——把某一维乘 10、另一维除 10,模型行为不变,但方差会变。这意味着两件事:
- 同一个模型内部的相对比较是可行的(同一套坐标下,分歧大的区域确实更陌生);
- 不同模型、不同训练轮次、不同潜空间维度之间的数值不可比。把 A 模型的「0.3」和 B 模型的「0.3」当成同样的信息量,是错误的。
缓解办法是尽量用无量纲的代理:比如把分歧度除以该维度的历史标准差,或者改用「预测误差在特征空间的余弦距离」,或者干脆回到显式的概率地图上算熵。这也是为什么占用栅格方法在工程上活得更久:它的熵是比特,物理意义清楚,跨系统可比。
代价模型低估
主动感知的收益是「比特」,成本是「秒」。如果成本项少算了一块,系统就会过度观察。常见的漏算:
- 转向与加减速:云台从 0 转到 90 度不是匀速的,启停各占几百毫秒;底盘掉头要减速、原地转、再加速。
- 稳定时间:移动之后相机要等振动衰减,机械臂要等伺服收敛,这段等待常常比移动本身更长。
- 遮挡与自碰撞:为了看一个角落,机械臂可能要收起来、换个姿态,这个动作序列的代价远超「转一下相机」。
- 暴露风险:在人机共处场景里,靠近人的观测动作有安全成本,不能按纯时间算。
一个实用的校准方法是离线测量:在真实硬件上记录每个基本感知动作的实际耗时分布(不是平均值,而是分位数),把分布的下游影响带进成本项。用平均值会让系统在长尾情况下频繁超时。
观测之间的相关性被忽略
第五节讲过贪心的短视,这里补一个更细的失效:相邻观测的增益被重复计算。如果系统在批量评分时用同一个先验信念给所有候选打分,那么「看左边 30 度」和「看左边 31 度」会被各自算出一份完整增益,两份相加远超它们联合的真实增益。结果是系统选了十个几乎一样的视角,实际只获得了一个视角的信息。
缓解有三种:串行更新(真看再选)、去相关惩罚(邻域剔除)、子模贪心(按联合增益的边际增量选)。第三种在理论上最干净,代价是要维护一个「已选集合」并重算边际增益,计算量随选择数增长。实践中常把「去相关惩罚」和「子模贪心」结合:先用便宜的邻域惩罚做粗排,再对前几名做精确的边际增益计算。
动态世界:看完就过期
主动感知默认「世界在观测期间不变」。真实的房间里有走动的人、被风吹动的窗帘、正在被另一只手移动的物体。观测本身需要时间,等看完,被观测的对象可能已经不在原位。更麻烦的是,观测动作本身也可能引发世界变化:机器人靠近时,宠物跑开;云台转动时,线缆被带动。
这在第二十八篇的「陈旧状态」里已经出现过一次,当时的缓解是「查时间戳」。在主动感知的语境下,还要多一层:信息的有效期应当进入评分。一个即将过期的记忆,其价值应当打折;而一次需要两秒的观测,其收益应当按「两秒后世界仍然如此」的概率折算。这个折算系数很难精确估计,工程上通常用「动态区域掩码」:把检测到运动的区域标记出来,在这些区域上提高重新观测的优先级,同时降低旧记忆的权重。
传感器模型与真实物理不匹配
占用栅格的逆传感器模型通常假设「射线打到物体就返回」。玻璃、镜面、黑色绒布、水下环境都会打破这个假设。玻璃会让射线穿过去,于是地图上出现一个「空的」区域,机器人以为那里可以走;镜面会让射线折返,地图上出现一个不存在的物体。信息增益的计算建立在这些错误读数上,会给出一个看似合理、实际错误的价值。
缓解办法是多模态交叉验证:深度相机与超声/红外/触觉的读数不一致时,降低该区域的置信度而不是二选一。另一个办法是显式建模「不可靠表面」:把高反射、透明材质的检测结果作为地图的一个属性,在规划观测时优先用其他模态确认。这类处理不会让信息增益的公式更漂亮,但它决定了系统在真实场景里是否可用。
计算预算挤占控制回路
主动感知的评分通常要占用 CPU/GPU 几十毫秒。如果这个计算与控制器共享资源,会出现「想得越久、控制越抖」的耦合:评分线程占满 CPU,控制线程的周期抖动,机械臂轨迹变得不平滑,反而降低了观测质量。第七篇讲部署时提过延迟预算,这里的具体表现是优先级反转:感知规划是「可以等」的任务,控制是「不能等」的任务,但两者抢同一块算力。
工程上的做法是把评分放到独立线程或独立进程,用固定周期的控制回路做硬实时,评分结果以「建议」的形式异步送达;如果评分超时,控制回路按上一次的建议执行(或者执行默认的安全动作),而不是阻塞等待。
任务无关的信息收集
最后一种失效不来自实现,而来自目标函数。信息增益是任务无关的:它奖励「知道得更多」,而不是「知道对任务有用的」。一个把整个房间扫一遍的机器人,信息增益很高,但它可能始终没去看那只杯子。第二十八篇结尾提到,语言接地的评测需要「另一套指标」,指的就是这类问题。
缓解的办法是把任务相关性注入评分:用语言指令或任务计划生成一个「相关区域掩码」,只在掩码内计算信息增益;或者直接用上一节的 VOI 做裁决。前者便宜、后者准确,实际系统常两者并用:掩码做粗筛,VOI 做最终裁决。
把这些失效放在一起看,会发现它们有一个共同结构:信息增益的公式假设了一个理想化的观测者——准确、廉价、瞬时、任务无关。工程实现必须逐条打破这些假设,而每打破一条,就要引入一个校准项或一个保守的折扣。主动感知系统的成熟度,基本上就体现在这些折扣项是否被认真对待。
怎么评测一次「主动地看」
系列第六篇拆过世界模型的评测栈:三层指标分别针对物理一致性、反事实响应与长程记忆。主动感知需要一套不同的指标,因为它要回答的不是「世界模型准不准」,而是「怎么看值不值」。下面按从粗到细的顺序列出可以实际使用的几类。
终局指标:覆盖率、精度与完成任务数
最直接的做法是看终局结果。重建类任务用覆盖率(coverage ratio,最终重建的几何占真实几何的比例)和渲染精度(PSNR、深度误差);抓取类任务用成功率与平均完成时间。GenNBV 与 ActiveSplat 的论文都给出了这类数字,但在本站的写作规范下,更重要的是这些指标的比较口径:在相同视角预算下的覆盖率,才是主动感知的公平比较;否则一个多看几倍的基线总能赢。
每比特的收益
把信息增益的估计值与实际的不确定性下降对比,可以检验代理指标是否校准:
若这个比值长期偏离 1(比如总在 0.3 左右),说明系统每次「以为能拿到一比特,实际只拿到三成」,预算应当按比例收缩。这个检验在离线评估时容易做:跑一批任务,记录每次观测前后的真实熵变化(在仿真里可以精确计算),与估计值对照。
决策翻转率
对 VOI 类系统,最有价值的指标是决策翻转率:一次观测之后,最优执行动作改变的比例。翻转率高,说明观测确实在改变决策;翻转率长期为零,说明系统在看「看了也不改决策」的地方。这个指标可以和成功率一起看:高翻转率但成功率不升反降,说明系统被噪声观测带偏了。
后悔值
把实际执行的策略与「全知策略」(假设状态完全已知)的奖励差称作后悔值。主动感知系统的目标是最小化后悔值,而不是最大化信息量。离线评估时可以用仿真环境算出全知基线,再对比实际策略的差距。这个方法的好处是它有明确的物理含义:后悔值就是「因为没看对地方而损失的分数」。
效率指标:单位时间的信息与单位能量的信息
在真实的移动机器人上,时间与能量是稀缺资源。可以用每秒获得的比特数、每焦耳获得的比特数来比较不同策略。这类指标会暴露一些隐藏问题:一个「每步信息增益最高」的策略,可能因为每步耗时太长而整体效率低下。
稳健性评测
主动感知的系统性风险是对场景分布的依赖。要专门测三类场景:结构外场景(训练分布里没有的房间布局)、传感器退化场景(玻璃、低光、反光)、动态场景(有人走动、物体被移动)。评测时不只看平均分数,要看最差分位的表现,因为主动感知的失效往往是「去看了一个错的地方,导致后续全错」的连锁反应。
把这些指标放在一张表里,可以作为上线前的最小评测集:
| 层 | 指标 | 回答的问题 |
|---|---|---|
| 终局 | 覆盖率、成功率、完成时间 | 看的结果有没有用 |
| 价值 | 校准比、每比特收益 | 信息增益的估计准不准 |
| 决策 | 翻转率、后悔值 | 看有没有改变将要做什么 |
| 效率 | 每秒/每焦耳比特数 | 花得值不值 |
| 稳健 | 分布外与最差分位 | 换场景会不会崩 |
与系列其它篇的接口
主动感知不是一个孤立模块,它与系列里已经讲过的几篇在数据流上有明确接口。把接口列出来,比再讲一遍公式更有用:
| 系列篇目 | 接口 | 本篇怎么用 |
|---|---|---|
| 第十七篇:长程记忆 | 记忆可以作为「免观测」的替代 | 记忆价值与观测价值的比较,是停止准则的一部分 |
| 第十八篇:共享世界状态 | 多入口共享同一份信念 | 多智能体的观测分配与「别人已看过」的判定 |
| 第十九篇:闭环误差 | 观测误差如何放大 | 观测预算不足时,误差在闭环里被放大的机制 |
| 第六篇:评测栈 | 物理一致性、反事实、长程记忆 | 主动感知的终局指标叠在它之上 |
| 第七篇:部署与延迟预算 | 每个环节的延迟 | 观测动作的耗时进入成本项 |
| 第八篇:潜空间规划 | MCTS 与 rollout | 前瞻式观测评估的骨架 |
| 第十二篇:几何表示 | NeRF / 高斯 / 栅格 | 渲染式与栅格式信息代理的载体 |
| 第二十八篇:语言接地 | 任务条件与目标对象 | 任务相关掩码与 VOI 的来源 |
这张表也解释了为什么本篇反复强调「代理指标」与「任务相关性」:系列里每一篇都在构建信念的一层,而主动感知是把这些层串成一次决策的那根线。没有这根线,前面各层再精确,系统也不知道下一步该做什么。
小结
本篇补的是系列里一个被当作免费变量、却决定系统成败的环节。收成四句话:
- 感知是动作。 它进入 POMDP 的方式与执行动作不同:只通过观测模型改变信念,不改变世界。这条区分带来一整套决策问题——什么时候看、看哪里、看几次、什么时候停。
- 信息增益是定价工具,世界模型是它的供给方。 精确的互信息需要枚举观测值,真实系统用的是四种代理:模型分歧度、显式概率地图的熵、渲染差异、学习出来的价值网络。四者的共同点是「与真实信息量单调相关」,而非相等;代理是否可靠,决定了系统会不会把预算花在无用之处。
- 分数不等于行动。 候选集合的粒度、成本的合成形式、观测之间的相关性、贪心的短视与停止准则,每一步都会改变最终行为。子模性解释了为什么贪心常常够用,也给出了它失效的边界。
- 信息只有在改变决策时才有价值。 VOI 把信息增益从「任务无关的比特」拉回「任务相关的收益」,但它计算更贵;实践中常用的结构是「信息增益排序、VOI 裁决」。
这一篇有意避开了多模态指令这个方向,虽然第二十八篇把它和主动感知并列为两个续篇方向。原因很简单:手势、视线与示范视频的融合,本质上是把「条件」扩成多路输入,而本篇要讲的是「观测」的选择;两者在接口上相邻,但机制不同。沿着本篇往下走,顺着的一条路是感知与执行的整体调度:把观测动作、移动动作与操作动作放进同一个时间轴上做联合优化,处理它们之间的抢占与依赖——这在本质上是把系列第七篇的延迟预算、第八篇的潜空间规划与本篇的 VOI 裁决合并成一个调度器。另一条路是多智能体的主动感知:当一个场景有多个观察者时,谁去看什么、信息怎么共享,与第十八篇的共享世界状态接得上,但要额外解决「重复观测」与「观测分配」的协调问题。
参考资料
- Active Perception (Bajcsy, 1988)
- Planning to Explore via Self-Supervised World Models (Plan2Explore)
- GenNBV: Generalizable Next-Best-View Policy for Active 3D Reconstruction
- ActiveSplat: High-Fidelity Scene Reconstruction through Active Gaussian Splatting
- VIN-NBV: A View Introspection Network for Next-Best-View Selection
- MaxInfoRL: Boosting Exploration in Reinforcement Learning through Information Gain Maximization
- Breaking the Epistemic Trap: Active Perception Under Compound Uncertainty
- Curiosity-driven Exploration by Self-supervised Prediction (ICM)
- Exploration by Random Network Distillation (RND)
- On a Measure of the Information Provided by an Experiment (Lindley, Annals of Mathematical Statistics, 1956)
- Planning and Acting in Partially Observable Stochastic Domains (Kaelbling et al., Artificial Intelligence, 1998)
- Maximize to Explore: One Objective Function Fusing Estimation, Planning, and Exploration
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



