


视频分词器完全拆解:从 VideoGPT 的 3D-VQ 到 MAGVIT-v2 的因果 LFQ
这一篇要解决的问题
把视频交给语言模型之前,必须先回答一个问题:视频怎么变成一串离散 token。
这个问题和图像分词看起来只差一维,但实际拆解下来,几乎每一个设计决策都要重做。图像分词器只需要回答「一张图压成多少个 token、每个 token 有多大容量」;视频分词器还要回答「时间维上压多少、每个 token 能不能看到未来帧、条件帧到底是输入还是目标」。不同的答案会把同一个离散生成框架引向完全不同的架构:VideoGPT 的 3D-VQ、MAGVIT 的 COMMIT、Phenaki 的 C-ViViT、MAGVIT-v2 的因果 tokenizer,以及 Cosmos Tokenizer 的一整组变体,正是对这几道题的不同回答。
本文按演进顺序拆解这四个绕不开的组件:
- 压缩比:一段 16 帧 128×128 的视频有 个原始数值,压到多少 token 才能让后续 Transformer 在显存里跑得动;
- 时间压缩:时间维降采样多少倍,决定了 token 序列长度与运动细节之间的取舍;
- 因果性:tokenizer 在时间维上是全向观察还是只看过去,决定了它能否支持任意长度视频、能否与图像共用码本、条件帧的信息会不会「泄漏」进结果;
- 码本结构:码本多大、量化时要不要查表,决定了语言模型的词表能不能做大。
图像侧的分词器机制已经单独讲过,可参考 图像离散分词器完全拆解。本文只讲视频多出来的那一维带来了什么,以及各篇论文具体怎么解决。
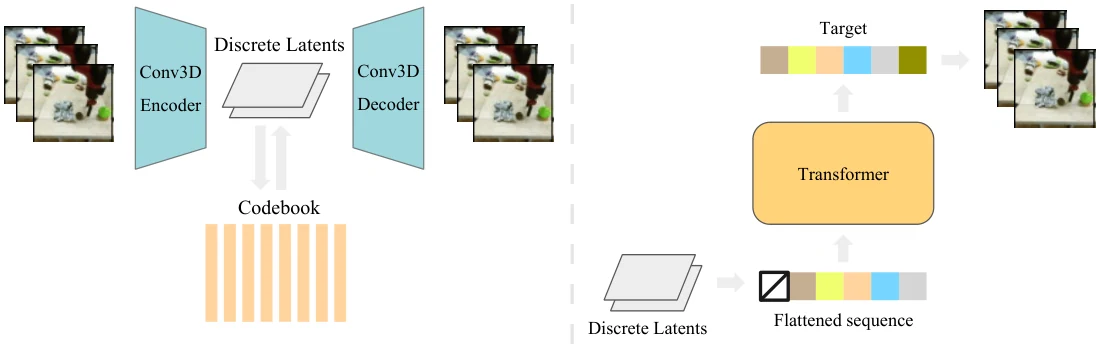
上图是 VideoGPT 的整体数据流,也是后面所有方案共享的骨架:左边是编码器把视频压成离散 latent,中间的码本完成向量量化,右边把离散索引展平成一个一维序列交给自回归 Transformer。后面每一节讨论的「改动」,本质上都是在改写这张图里的某一块。
统一的记号
本文统一使用下面的记号,避免在各篇论文的符号之间来回切换:
| 符号 | 含义 |
|---|---|
| 视频的帧数、高、宽 | |
| 时间、空间的压缩倍率 | |
| 压缩后的 token 总数 | |
| 码本大小 | |
| 编码器输出的特征维度(量化前) | |
| 编码器输出的连续潜变量 | |
| 量化结果,即最接近的码字 |
对常见的各向异性压缩,token 数量为
这个式子在后面会反复出现: 和 的取值直接决定了 ,而 决定了自回归前向要跑多少步、注意力要覆盖多长的序列。
为什么不能用图像分词器逐帧处理
最直接的省事方案是:把视频每一帧当作一张图,用图像分词器逐帧压成 token。这条路线在早期确实被用过,但它在两件事上直接失败。
第一是冗余。相邻帧在像素空间里高度相似,逐帧编码会把相同的背景、相同的静止物体反复编码成几乎一样的 token 序列。一帧 128×128 的图若压成 16×16 = 256 个 token,16 帧就是 4096 个 token,其中绝大部分熵已经被前一帧携带过。Phenaki 在这一点上给出过一个量化对比:C-ViViT 利用时间冗余,在同等重建质量下把 token 数量减少约 40% 以上,这是「时间维压缩」的直接收益。
第二是序列长度与采样代价。自回归 Transformer 的采样代价大致随序列长度 线性增长(即便有 KV 缓存,每一步都要读一遍已缓存的历史),4096 个 token 意味着 4096 次前向。序列一长,噪声累积、误差传播、显存占用全部放大。
所以视频分词器的核心任务被定义清楚了:在时间维上额外压缩一次,压缩的同时保住跨帧的时空结构。接下来各篇论文的差异,全部来自「时间维压缩放在网络的哪一层做、是否允许看到未来」。
分段压缩这件事:VideoGPT 的 3D-VQ
VideoGPT 由 Wilson Yan 等人在 2021 年发表于 arXiv(VideoGPT 论文),思路是对 Image-GPT 的直接改造:先用 VQ-VAE 把视频压成离散 latent,再用 Transformer 学 latent 上的分布。它对 3D-VQ 的处理方式最朴素,却也把几个基础权衡暴露得最清楚。
3D 卷积 + 轴向注意力:压缩在网络里完成
VideoGPT 的 VQ-VAE 编码器是「一串 3D 卷积做时空降采样 + 若干 attention residual block」,解码器是其镜像,用 3D 转置卷积上采样。这里的 attention residual block 用的是轴向注意力(axial attention):分别沿高度、宽度、时间三个轴做一维注意力,再叠加。
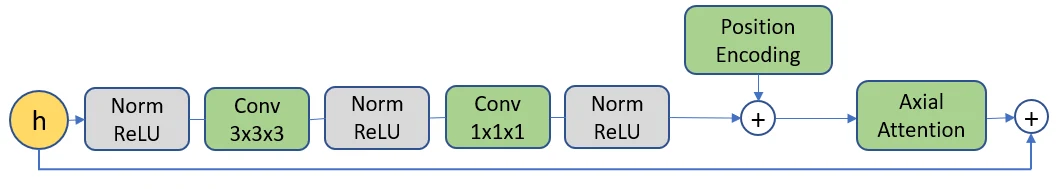
轴向注意力这个选择值得解释。标准空间注意力对特征图做 的全连接注意力,代价是 ;而轴向注意力先沿高度轴做 注意力、再沿宽度轴做 ,代价降到 。视频里再加上时间轴,就多一层 。它的好处在于把「全向观察」拆成沿三个方向分别观察,既保留了大感受野,又避免了三维全注意力在视频上的爆炸代价。代价是它无法在一个 attention 里同时建模「第 3 帧左上角」和「第 7 帧右下角」的关联,需要跨 block 累积。
VideoGPT 的消融很直接:去掉轴向注意力后,VQ-VAE 的重建 NMSE 从 0.0033 升到 0.0041,重建 FVD 从 14.9 升到 15.3。提升不大,但对一个主要靠卷积做压缩的编码器来说,这个差距说明感受野的扩展是有效的。
时间压缩比例:不是压得越狠越好
VideoGPT 最有信息量的实验,是它对 latent 尺寸系统的消融(论文 Table 5)。在固定 token 总量的前提下,改变时间维与空间维的分配,结果如下(BAIR 数据集):
| latent 尺寸 | 重建 FVD | 生成 FVD |
|---|---|---|
| 82.1 | 135.4 | |
| 108.1 | 166.9 | |
| 49.9 | 124.7 | |
| 41.6 | 126.7 | |
| 28.3 | 104.6 | |
| 32.8 | 113.4 | |
| 22.4 | 124.3 | |
| 14.9 | 103.6 | |
| 15.7 | 109.4 | |
| 10.1 | 118.4 |
这张表要分两栏读。重建 FVD 这一栏随着 token 总量变多(表的下半部分)单调变好,说明容量越大,还原越准,这是预料之中的。生成 FVD 这一栏不是单调的:最优出现在 ,token 总数 8192,也就是时间维只降采样 2 倍(16 帧变 8 帧)、空间降采样 4 倍(32×32)。把时间压得更狠( 或 )重建更好,但生成变差,因为时间细节在 latent 里已经丢了;把时间完全不压()序列最长,生成也变差,因为先验 Transformer 在有限的算力预算下学不动更长的序列。
原文的结论是:空间与时间上均衡的降采样(2×2×2 近似,对应 )最有利于生成质量,而不是把所有压缩都堆在时间上。这条结论奠定了后续所有视频分词器的工作方式:时间压缩必须克制,因为一旦时间信息在 token 里被抹掉,后续任何生成网络都无法补回来。
码本大小:256 到 4096 几乎没有影响
VideoGPT 另一张消融表(Table 6)在固定 latent 尺寸的前提下改变码本大小:
| 码字数 | 重建 FVD | 生成 FVD |
|---|---|---|
| 256 | 18.2 | 103.8 |
| 1024 | 14.9 | 103.6 |
| 4096 | 11.3 | 103.9 |
码本从 256 加到 4096,重建显著变好(18.2 → 11.3),但生成 FVD 几乎不动。这个结果和后面 MAGVIT-v2 的动机直接对上了:在传统 VQ-VAE 里,单纯把码本做大,提升只体现在重建上,传不到生成上。原因在 MAGVIT-v2 一节会展开。
VideoGPT 的结论是:视频离散生成的瓶颈不在 VQ-VAE 本身,而在「latent 序列要交给一个 Transformer 去建模」这一步。这也是 MAGVIT 要换掉自回归解码的原因。
自回归 Transformer:Sparse Transformer 压序列长度
VideoGPT 的第二阶段是 Image-GPT 风格的自回归 Transformer,但把稠密注意力换成了 Sparse Transformer:局部窗口注意力 + 跨时空的 strided 注意力。这个选择同样是因为序列太长:BAIR 上 8192 个 token,稠密注意力的 显存无法承受。
作为基线,VideoGPT 在 BAIR 上的成绩是 FVD 103.3,与当时最好的 GAN 路线(TrIVD-GAN-FP 103.3)持平;Transformer 层数的消融显示 8 层之后收益饱和(2 层 120.4、4 层 110.0、8 层 103.3、16 层 103.6)。这两组数字说明:在分段压缩的框架里,自回归先验的规模已经接近这个范式的上限,下一步的提升必须来自解码方式或 tokenizer 本身。
MAGVIT:把一个 tokenizer 变成十个任务的共用入口
MAGVIT 由 Google Research 与 CMU 团队于 2022 年提出(MAGVIT 论文,CVPR 2023 highlight),它把视频生成看成「视频版 BERT」:在一个双向 Transformer 里做掩码 token 建模(masked token modeling,MTM),多步并行解码。
这个转变的直接动机,是 VideoGPT 暴露出来的自回归瓶颈——想生成视频就得一个 token 一个 token 地解码,序列越长越慢。MAGVIT 换了条路:所有 token 同时预测,用多步迭代把 [MASK] 逐步填满,每一步只做一次前向。
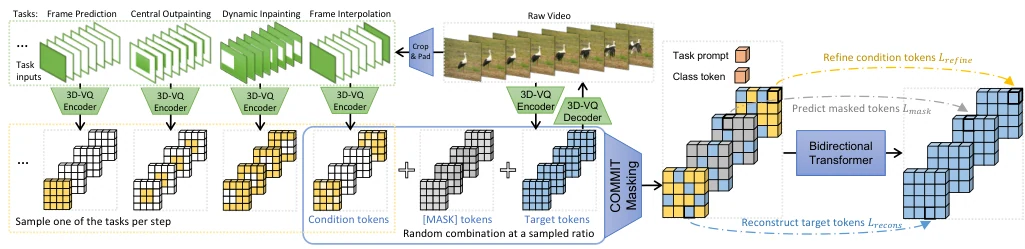
上图把 MAGVIT 的训练流程拆成三段,正好对应本节要讲的三个问题:
- 左边:一个任务 prompt 从十种任务里随机挑一个(帧预测、中间外绘、动态内绘、帧插值……),每种任务对应不同的内部条件区域;
- 中间:原始视频与带条件、带 padding 的视频分别经过同一个 3D-VQ 编码器,得到目标 token 与条件 token ;
- 右边:按一个采样比例,把部分目标 token 替换成条件 token 或 [MASK],剩下的保持原样,三类 token 分别计入 refine 损失、mask 损失和 recon 损失的统计。
MAGVIT 的 3D-VQ 改了什么
MAGVIT 的 3D-VQ 与 TATS 同属一档,但论文明确对比了若干设计差异,每一条都是针对视频这一维的:
- 下采样用平均池化而不是步长卷积,上采样用最近邻缩放加卷积。平均池化在时间轴上等价于在相邻帧之间取平均,对运动模糊和细小抖动更稳健;步长卷积在时间轴上会把「哪一帧」的选择交给可学习的权重,训练早期容易学出闪烁感。
- 镜像的编解码结构:靠近潜空间处只做空间下/上采样,靠近像素空间的层才做时空下/上采样。这条设计的意思是「空间先缩、最后再把时间收一下」,与 VideoGPT 消融得出的「时间压缩要克制」一致。
- 单个更深的 3D 判别器,替代 2D 与 3D 两个浅判别器。视觉上 2D 判别器负责单帧质量、3D 判别器负责运动连贯,但两个判别器会互相干扰(前者不管时间、后者不管细节),合并成一个 3D 判别器后梯度冲突减少。
- 码本缩到 1024(TATS 是 16384)。小码本配合更细的时空压缩比 来控制容量:base 模型 41M 参数,large 模型 158M。
- 归一化换 GroupNorm、激活换 Swish,并用 LeCAM 正则稳定 GAN 训练。
这里码本缩到 1024 是反直觉的:VideoGPT 的消融显示码本变大对生成无益,MAGVIT 索性把码本压小,把容量让给时空压缩比和 Transformer 规模。两个实验指向同一个结论:离散视频生成里,码本的「广度」不如压缩比的「纵深」重要。
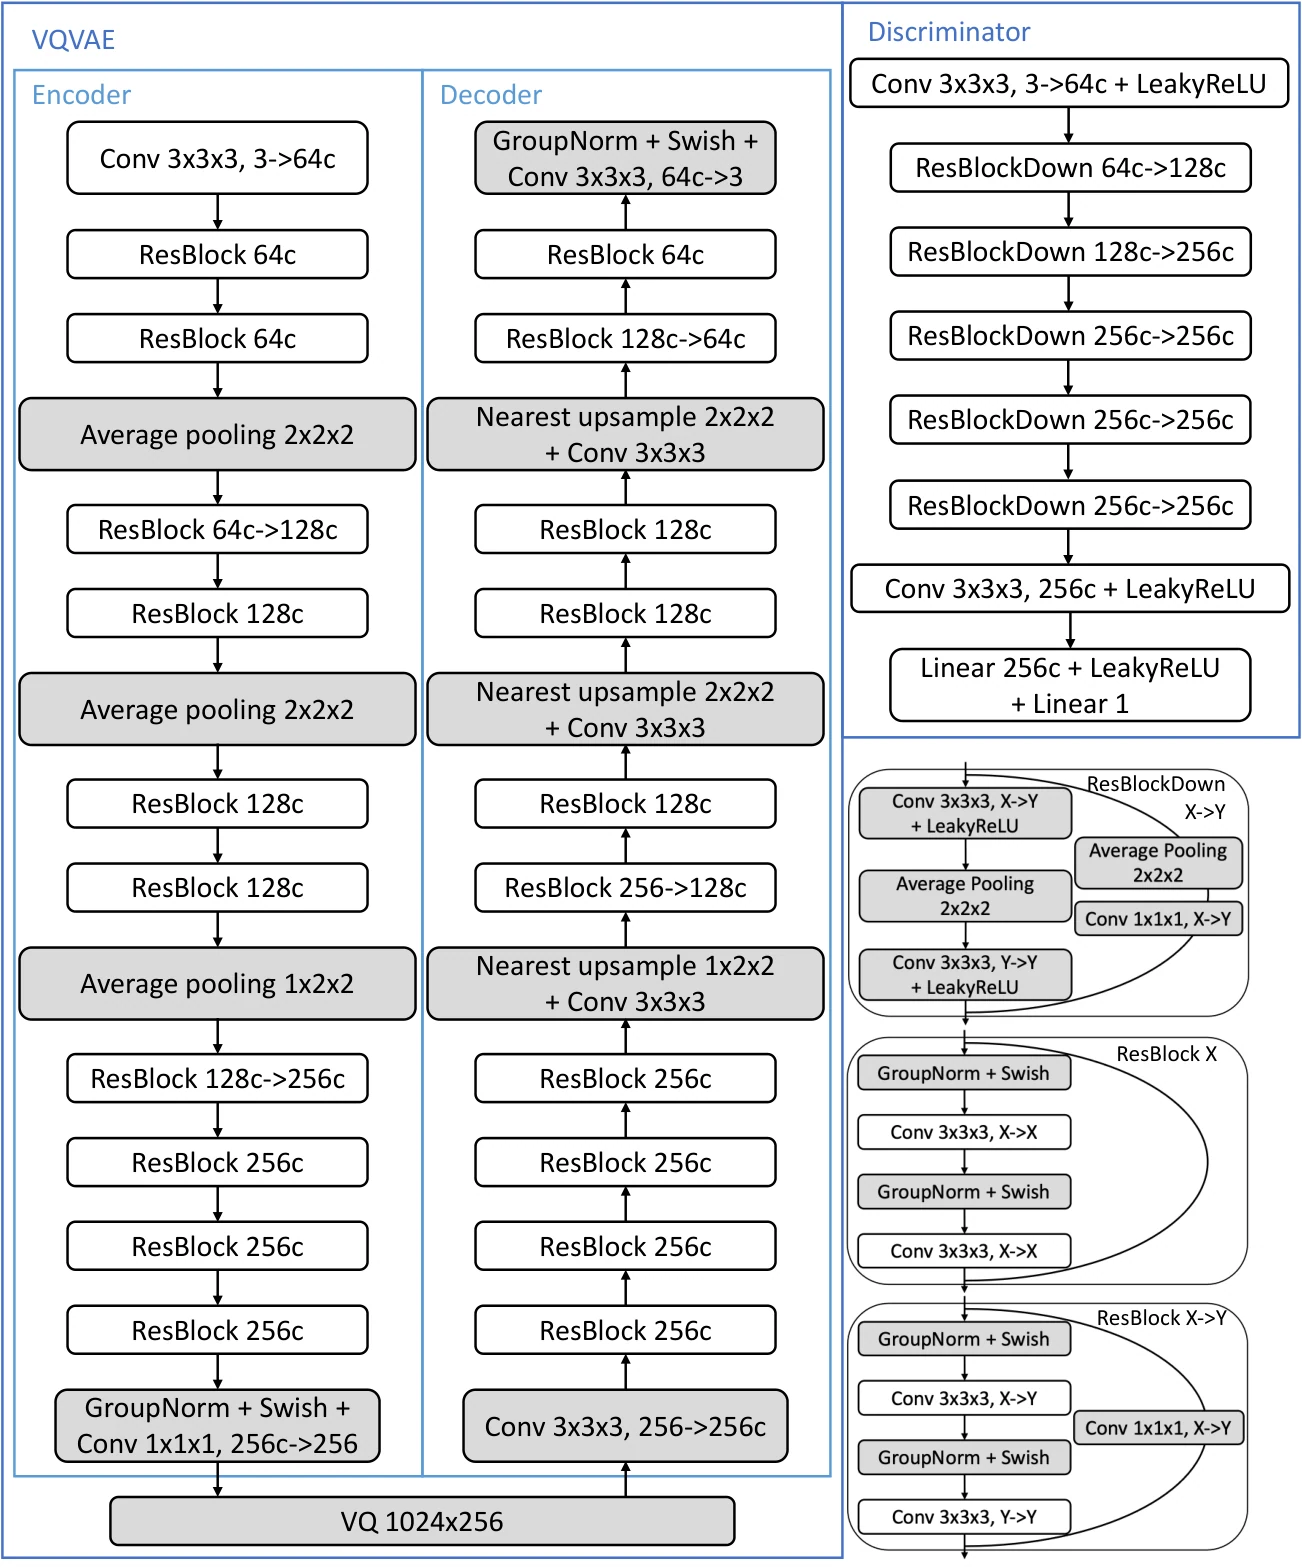
上图把 TATS 与 MAGVIT 的 3D-VQ 并排放在一起。两者都采用「编码器下采样 → 码本 → 解码器上采样」,但 MAGVIT 把时空下采样层集中在靠近像素的一端,把纯空间层放在靠近 latent 的一端,并在每个分辨率上配一组残差块。这个排布让时间维只被少量层接触,空间细节则被多层处理——与 VideoGPT 消融中「时间压缩要克制」的结论相呼应。
多任务掩码:十个任务共用一个模型
MAGVIT 把视频生成的不同场景统一成「内部条件」问题:给定视频的一部分像素,预测其余部分。
| 任务 | 内部条件 |
|---|---|
| 帧预测(FP) | 首几帧 |
| 帧插值(FI) | 首尾各几帧 |
| 中心外绘(OPC) | 中间一个矩形块 |
| 垂直/水平外绘(OPV/OPH) | 一条竖条/横条 |
| 动态外绘(OPD) | 与轨迹相关的一块 |
| 中心内绘(IPC) | 去掉中间一块 |
| 动态内绘(IPD) | 去掉与轨迹相关的一块 |
| 类别条件生成(CG) | 无像素条件,只有类别 |
| 类别条件帧预测(CFP) | 首帧 + 类别 |
这个统一点很重要:一旦「条件」被抽象成「某个时空区域的像素已知」,任务差异就只剩下条件区域的几何形状。后面的 COMMIT 正是基于这一点,把「条件 token」直接当作「已经填好的 token」来处理,不再需要在序列里为条件额外占位。
COMMIT 解码:条件 token 也是「被遮住」的 token
MAGVIT 最值得细看的设计是 COMMIT(COnditional Masked modeling by Interior Tokens)。它解决了 3D tokenizer 特有的一个陷阱:条件帧的信息会泄漏到非条件 token 里。
问题的来源:感受野不会停在区域边界
在图像掩码建模里,如果条件是一块已知区域,常规做法是把这块区域的 token 当作「未缺失」保留在序列里,然后把其余位置设为 [MASK]。这个做法隐含一个假设:已知区域的 token 只携带已知区域的信息。
3D tokenizer 打破了这个假设。因为编码器的卷积和注意力感受野是局部的、但跨时空的:一个 token 虽然「对应」第 5 帧的某个块,但它的编码在计算时看过相邻帧、相邻块的像素。如果一个 token 对应的块部分落在条件区域内、部分落在 padding 里,它的编码就同时包含了条件信息和非条件信息。训练时这个 token 被当作「已知」保留,模型就学到一个捷径:从这些「污染」的 token 里读出目标区域的真值。推理时真实场景没有这种污染,模型立刻退化。
论文的表述是「tokenizer 的非局部感受野会把真值信息泄漏进未遮挡的 token,造成非因果的掩码和较差的泛化」。这句话背后是一个很具体的现象:训练 loss 很好看,但一旦换成真实的帧预测场景,结果就崩。
COMMIT 的解法:先把条件编码进来,再按比例遮掉
COMMIT 的做法可以拆成两步:
- 先把条件编码成完整视频的 token。把条件区域按任务定义 pad 成与原始视频同形状(例如帧预测时用最后一帧复制到后面所有帧),再送入同一 3D-VQ 编码器,得到 。这样每个条件 token 的编码里既包含了条件像素,也包含了 padding 像素——它携带的是「如果把这段区域当作已知,编码出来是什么」,而不是单纯的已知信息。
- 按统一比例把所有 token 分成三类。对一个采样比例 ,对每个 token :
- 若 对应的区域的分数 且其对应区域不完全由 padding 组成,就用条件 token 替换;
- 若 对应区域完全由 padding 组成,就用 [MASK] 替换;
- 其余保持目标 token 。
形式化写成:
其中 是 token 的掩码分数, 是这一步的截断分数, 判断该 token 的超体(supervoxel)是否完全落在 padding 上。这个式子看起来只是把「两种 token」变成「三种 token」,关键差别在于:条件 token 不在序列外面做条件,而是混进序列里当作一个被「部分遮住」的 token。模型必须从其余 token 里推断出它在上下文里应该是什么样子,而不是直接读取它。
对应的训练目标为:
再按三类 token 拆开:
其中 是最终的输入序列, 是任务 prompt、类别条件与输入序列的拼接。三部分各管一件事:
- 让模型修正条件 token,也就是从上下文推断「这个位置原本应该是什么」,而不是原样抄条件;
- 是常规的掩码预测损失;
- 让模型对未被遮挡的 token 也保持重建能力,充当正则项。
这个拆分是 COMMIT 的核心直觉:条件不是给定的答案,而是待修正的草稿。
为什么 COMMIT 能抑制泄漏
泄漏的根源是「条件 token 被当作干净的已知值」。COMMIT 把条件 token 放回「被污染的上下文」里,让模型学习「给定周边 token,这个位置最可能是什么」——注意,这里的目标是原始视频的 token ,不是条件 token 。所以在训练时,模型要做的恰恰是「纠正」条件 token 里可能混进来的伪造信息。
这与去噪扩散的过程有相似之处:从一个不完美的草稿出发,通过上下文把它推到正确的位置。区别在于 MAGVIT 的训练是按 token 随机遮、按比例遮,而不是按固定的噪声时间表。
推理时:从条件出发逐步替换
推理过程(论文 Algorithm 1)与训练一一对应。给定条件 token 与步数 (论文里常用 ),先初始化所有 token 的分数 、截断 ,然后循环 步。每一步:
- 用当前输出 与条件 构造输入 ;
- 对所有未决 token 预测分布并采样 ;
- 把每个采样 token 的概率作为分数 ;
- 给分数加 Gumbel 噪声:,其中 是温度;
- 取第 小的分数作为新的截断,把低于截断的 token 当作「已定稿」,其余继续迭代。
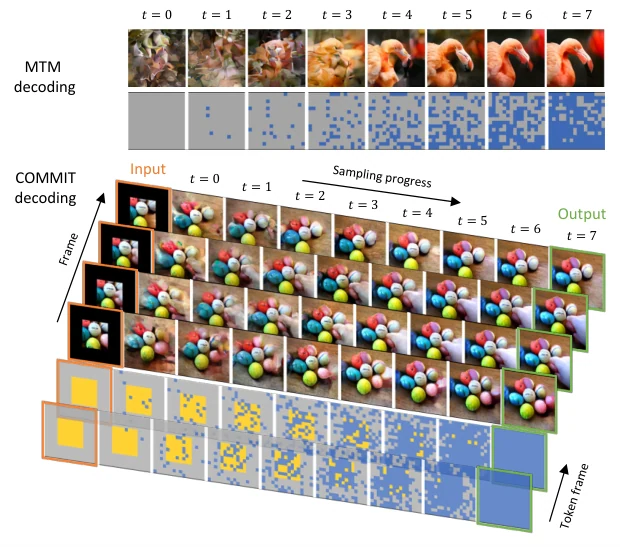
上图把两种解码过程放在一起对比:图像侧的 MTM 是从全 [MASK] 出发、逐步填满;视频侧的 COMMIT 是从条件 token 出发,逐步替换条件 token、向外扩展。区别在于「起点」:前者是空图,后者是一张带已知区域的草稿。这也解释了为什么 COMMIT 需要「修正」损失:起点本身就有内容。
代价与收益
COMMIT 的收益有两层。第一层是正确性:它给出了对 3D tokenizer 而言真正因果的掩码方式,条件区域的信息不再从「干净的 token」泄漏出去。第二层是效率:条件区域不论体积大小,都会先被编码成同长度序列,训练与推理时序列长度固定,不需要为不同形状的条件设置不同的 padding。
代价是训练时必须两路编码(原始视频与带 padding 的条件视频)共用同一个 tokenizer,且每次训练要按任务采样、按比例遮盖,逻辑比单任务掩码复杂。另一个隐性代价是条件 token 的编码本身也要走一遍 3D-VQ,对于超大条件区域(例如内绘时只挖掉一小块),这一步的额外计算在推理阶段是实打实的开销。
MAGVIT 在效果上的收益有多任务的结果支撑(论文 Table 4,BAIR 八任务与 SSV2 十任务,FVD 越低越好):
| 模型 | BAIR 多任务(Multi)平均 FVD | SSV2(CG) |
|---|---|---|
| MAGVIT-B,单任务 | 150.6 | 258.8 |
| MAGVIT-B,帧预测单任务 | 201.1 | 402.9 |
| MAGVIT-B,多任务 | 32.8 | 94.7 |
| MAGVIT-L,多任务 | 22.8 | 79.1 |
单任务训练的模型在没见过的任务上完全失效(单任务 FP 模型在插值任务上是 247.1,而多任务模型是 47.2),这验证了「十个任务共用一个模型」这个设计本身的必要性。COMMIT 提供的正是让多任务训练不退化到捷径的那块关键机制。
推理效率
论文报告了单卡 V100 上的逐帧生成时间:MAGVIT-B 在 128×128 下达到 37 帧/秒;在 TPUv4i 上 MAGVIT-B 为 190 帧/秒、MAGVIT-L 为 65 帧/秒。论文给出的相对结论是:与扩散模型(256 到 1000 步的三维 U-Net)相比快约两个数量级,与同期自回归模型 TATS 相比快约 60 倍,与同期的非自回归图像方案 MaskViT 相比快 4 到 16 倍。这些对比的背后不是模型变小了,而是解码步数从「随序列长度线性增长」变成了「固定的 12 步」。
MAGVIT-v2:因果 tokenizer 与无查表量化
MAGVIT 在多任务上表现不错,但它继承了 3D-CNN tokenizer 的两个结构性限制:时间维感受野是全向的(第 5 帧的 token 能看到第 8 帧),且 token 结构依赖空间位置。MAGVIT-v2 是同一团队于 2023 年提出的升级(MAGVIT-v2 论文,ICLR 2024),它从 tokenizer 而不是解码方式改起。
动机一:词表大 ≠ 生成好
MAGVIT-v2 的出发点是一张曲线图(论文 Figure 1):把 tokenizer 的码本从几千一路加大,重建质量持续变好,但语言模型的生成质量先变好后变差。这解释了为什么此前视觉语言模型的词表普遍停在 1 到 8k,远小于自然语言的 20 万以上。
原因不复杂:传统 VQ 的量化是对 的码本做最近邻查找,码本越大,每个码字的语义越稀疏,语言模型要在这么大的词表上做分类头,训练信号被摊薄。MAGVIT-v2 的解法是把码本的「查表」行为本身去掉。
动机二:时间维必须因果
第二个动机是因果性。3D 卷积的 tokenizer 在时间维做全向卷积,意味着第 5 帧的 token 的编码看过第 8 帧。这对帧预测任务有两个坏处:
- 泄漏:如果条件帧在尾部(例如插值的结尾帧),尾部 token 的编码会带着它前后的信息,训练时模型可以从这些 token 里读出「未来」。
- 无法做任意长度:全向卷积需要固定长度的输入窗口,长视频只能切段,段与段之间不连续。
论文的直接目标很明确:一个 tokenizer 要么支持任意长度推断、要么就不支持;它选择了前者。
架构:T-Causal Conv 替代 3D CNN
MAGVIT-v2 的 tokenizer 把 3D 卷积换成时间因果卷积(T-Causal Conv)。普通的 3D 卷积在时间轴上用对称 padding:核大小 时,前面补 帧、后面补 帧。因果卷积只在前面补 帧,后面不补,因此每个输出时间片的计算只依赖于当前和之前的帧。
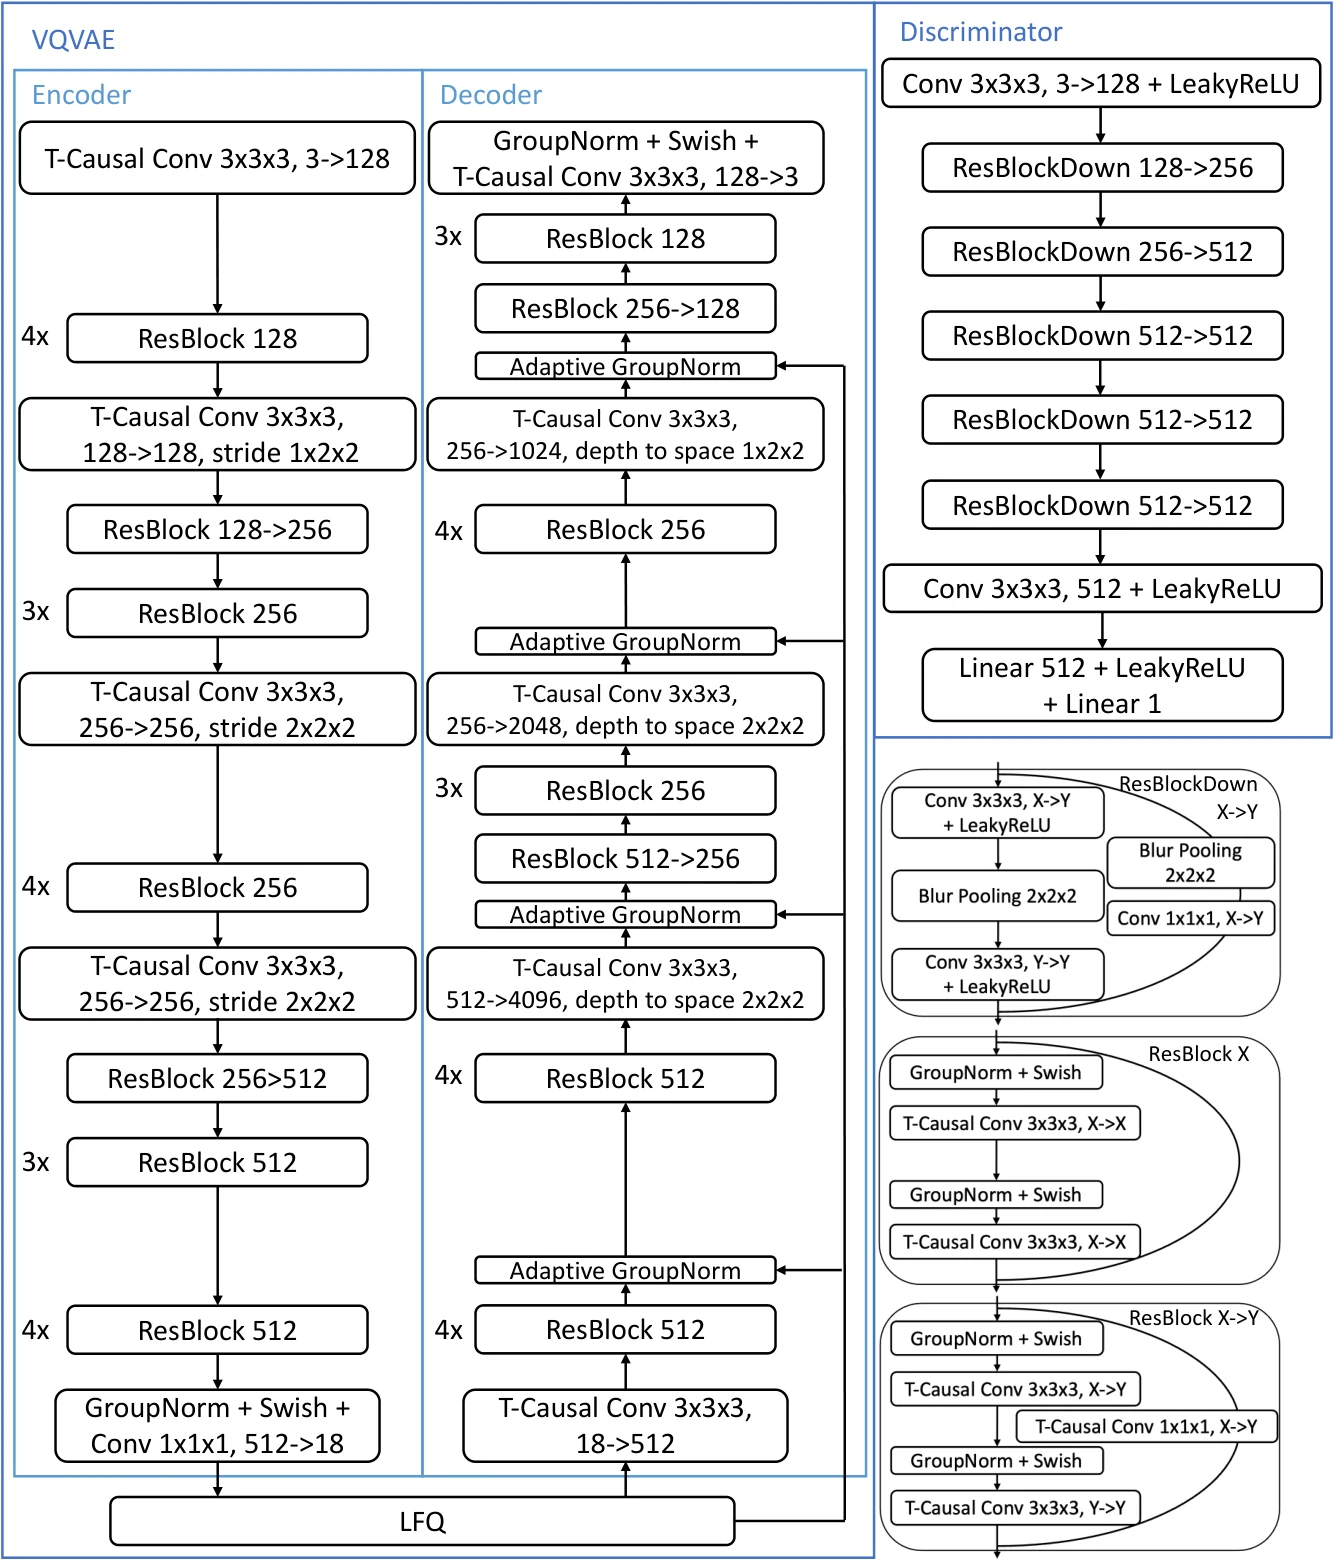
上图是 MAGVIT-v2 的完整结构,编码器与解码器镜像对称,时间维上的下采样/上采样层都使用因果卷积。空间维保持常规卷积,因此单张图像可以在时间维长度为 1 的输入下被编码,这就是「图像与视频共用码本」的基础:T=1 时因果卷积退化为普通卷积,输出 token 就是图像 token。
因果性的一个附带好处:条件帧是「前缀」
因果 tokenizer 让帧预测的条件变成真正的「前缀」。因果意味着给定前 帧,第 帧的输出只依赖于前 帧;在训练和推理中,只需要把条件帧编码成前若干 token,后面的 token 就完全不含条件帧的信息。这比 COMMIT 的「按比例遮盖」更彻底:在因果 tokenizer 下,不存在信息能从未来流向过去,因此也不存在从已知区域向待生成区域的泄漏。
MAGVIT-v2 的论文给出了非因果 vs 因果的对照:同样的 MLM Transformer(307M 参数),非因果 baseline 在 Kinetics-600 帧预测上的 FVD 是 11.6,因果 tokenizer 的版本是 5.2。压缩后的形状也变了:一个 17 帧 128×128 的片段被压成 的 latent——时间维留 5 个时间片,每片 16×16,共 1280 个 token。这对应时间 4 倍、空间 8 倍压缩,序列长度比逐帧方案少一个数量级。
LFQ:把码本改成「不用查表」的笛卡尔积
MAGVIT-v2 的核心量化改动是无查表量化(lookup-free quantization,LFQ)。它的做法是:码本 被替换成一个整数集合 ,且这个集合是若干个单维小集合的笛卡尔积:
对编码器输出的特征向量 ,每一维独立量化:
token 索引直接用各维的符号拼出来:
这个式子把「查表」彻底去掉了:量化就是逐维取符号,索引就是符号序列的二进制编码。码本大小 由特征向量维度决定(维度是 ),扩大词表与加宽特征维度是同一件事。
这对语言模型的意义是:词表大到 (约 26.2 万)时,码字仍然互相独立(因为每维独立),语言模型学习的是 18 个独立的二分类问题,而不是从 26 万个候选里挑一个。同时,LFQ 引入熵惩罚改善码本利用率:
第一项鼓励每个样本的量化结果有较高的熵(即各维尽量分散),第二项惩罚 batch 中码字的平均分布集中在少数几个(即码本共享)。两项相减的效果是「尽量让样本各自用不同的码字」。因为各维独立,第一项可以逐维累加,避免直接对 大小的分布做熵估计。
token factorization:大词表拆成多个小头
词表做到 26 万后,即使 LFM 量化把码本「去查表」了,语言模型的输出头仍有 26 万个类别。MAGVIT-v2 的解法是 token factorization:把一个 token 的特征拆成若干等长的子空间,每个子空间只包含 个码字,输出头也拆成若干小头。例如 18 维特征可以拆成两个 9 维子空间,两个 9 维子空间的联合索引与原 18 维索引一一对应,但每个头的分类维度从 降到 。
这个设计对训练的意义在于:分类头从 26 万类的一层 softmax 变成两个 512 类的 softmax,输出层的参数和梯度规模都下降一个数量级;而子空间之间的独立性又保证了联合分布的表达能力。
结果
MAGVIT-v2 在视频与图像上都给出了与扩散对等或更好的结果。视频侧(论文 Table 1,MLM + LFQ):
| 方法 | K600 FVD | UCF FVD | 参数 | 步数 |
|---|---|---|---|---|
| Phenaki(MLM + VQ) | 36.4 | — | 227M | 48 |
| MAGVIT(MLM + VQ) | 9.9 | 76 | 306M | 12 |
| MAGVIT-v2(非因果 LFQ) | 11.6 | — | 307M | 12 |
| MAGVIT-v2(因果 LFQ) | 5.2 | 4.3 | 307M | 12 |
图像侧的一个对照更能说明 tokenizer 的作用(论文 Table 2,ImageNet 512×512 类别条件生成):MaskGIT(MLM + 小 VQ 码本)FID 7.32,MAGVIT-v2(MLM + LFQ)FID 4.61(无引导)、3.07(有引导)。两者共享同类 MLM Transformer,差异主要来自 tokenizer 的码本大小与因果结构。
论文的口号「语言模型击败扩散」需要客观看待:它针对的是「在相同数据、相近模型规模和训练预算下,配合更好的 tokenizer 可以追平扩散」。这不意味着离散 token 路线全面优于扩散,而是说明视觉分词器的质量是离散生成的上限。
变长与长视频:Phenaki 的 C-ViViT
MAGVIT-v2 的因果卷积是从卷积侧解决「时间维不能看未来」;更早的 Phenaki(Google,2022 年,Phenaki 论文)则从 Transformer 侧给出了同一个问题的另一种答案,而且它把「变长」这个性质用到了长视频生成上。
为什么固定长度 tokenizer 不够用
Phenaki 的出发点是文本到视频的两个现实约束:训练数据里的视频长度不固定,用户想要的视频长度也不固定。此前的视频 tokenizer 分两类,各有硬伤:
- 逐帧图像编码器(如 VQ-GAN):能处理任意长度,但时间维完全不压缩,相邻帧 token 高度冗余,视频一长序列就爆炸;
- 固定长度 3D 编码器(如 VideoVQ-VAE):时间维压缩了,但输入窗口固定,只能生成固定帧数,无法做「继续往后生成」。
Phenaki 需要的是第三种:时间维压缩 + 时间维因果,既能压掉冗余,又能一段一段往后接。
C-ViViT:空间全向、时间因果
C-ViViT 的结构可以概括成一句话:先做空间注意力,再做时间因果注意力。
输入是 帧、分辨率 的视频。第一帧用二维图像 patch()切分,其余帧用三维视频 patch()切分,每个 patch 展平后线性投影到 维。于是 token 张量的形状是 ,其中第一帧的 个 token 是独立编码的,不依赖后面的帧。
接下来分两步:
- 空间 Transformer:在每一帧内部做全向注意力,把 个空间 token 互相看一遍;
- 时间 Transformer:在所有空间位置上做因果注意力,第 帧的 token 只能看 到 帧。
这个分解与 ViViT 的 factorized encoder 同源,但有两处关键改动:去掉 [CLS] token,让时间 Transformer 作用在所有空间 token 上(而不是只作用在 [CLS] 上);把时间维的 all-to-all 注意力换成因果注意力。第二处改动正是「可变长度」的来源:因果结构允许任意长度的输入,也允许把已有 token 当作前缀继续往后生成。解码器是编码器的倒序:token → 时间 Transformer → 空间 Transformer → 线性投影回像素。
在压缩率上,论文给出的结论是:与逐帧图像 tokenizer 相比,C-ViViT 利用时间冗余,在同等重建质量下把 token 数量减少 40% 以上。这个数字不算激进,但它是在「保持因果、支持变长」的前提下拿到的,含金量比单纯的压缩比更高。
生成:固定 48 步,而不是随长度线性增长
Phenaki 的第二阶段是一个双向掩码 Transformer,训练方式与 MaskGIT 相同:随机遮住比例 的 token,让模型预测被遮住的部分。文本条件来自预训练的 T5X 编码器。
这里有一个容易被忽略的设计动机。自回归 Transformer 的采样时间随序列长度线性增长,即便有 KV 缓存,长视频也要一个 token 一个 token 地解码。Phenaki 选择双向掩码,就是为了把采样步数固定下来:不论视频多长,都用固定的步数(论文的实现里是 48 步)并行地填 token。论文在 K600 帧预测上的配置是 227M 参数、48 步,FVD 36.4——这个成绩不如同期的 MAGVIT,但它的目标是长视频而不是单段短视频。
长视频:冻结过去,逐段续写
有了因果 tokenizer,长视频生成可以写成「滑动窗口」:已经生成的 token 全部冻结,作为下一段的前缀条件,只对新的一段做掩码生成;生成完一段后,把新 token 追加到前缀里,继续下一段。因为 tokenizer 是因果的,新一段的编码不会反过来改变旧 token,整个序列在时间上是自洽的。
这套机制还带来一个额外的能力:提示词可以随时间变化。前缀里可以按时间片拼接不同的文本条件,于是「先下雨、再放晴、最后出现一个人」这类叙事型视频可以在一个自回归过程中完成,而不需要把整段视频塞进一个固定的文本条件里。
它在演进中的位置
Phenaki 的 C-ViViT 是「Transformer 版因果 tokenizer」的代表。它的问题也被后来的 MAGVIT-v2 明确点出:一是位置嵌入让模型难以处理训练时没见过的空间分辨率;二是纯 Transformer 的空间 token 在空间因果性上不如 3D 卷积——一个 token 对应的块边界不够干净。MAGVIT-v2 因此改用因果 3D 卷积,同时保留「第一帧独立、后续帧因果」的总体结构。两条路线在这一点上汇合:因果性来自时间维的注意力/卷积设计,而不是来自把视频切段。
Cosmos Tokenizer:一套 tokenizer 工厂
前面几节都是在回答「一个 tokenizer 怎么写」,到 Cosmos 这一步,问题变成了「tokenizer 该给谁用、该覆盖哪些压缩比」。Cosmos Tokenizer 来自 NVIDIA 的 Cosmos World Foundation Model 平台(Cosmos 平台论文,2025 年 1 月),它是世界模型前置的视觉 tokenizer,定位是一组可配置的变体,而不是单一模型。
Cosmos 的 tokenizer 管线与前面几节一致:编码器把视频压成 token,解码器从 token 还原视频;训练目标是「在给定的 token 密度下,尽可能完整地保留视觉信息」。下游的 Cosmos-Predict1-Video2World 模型把这条管线接进一个自回归 Transformer:
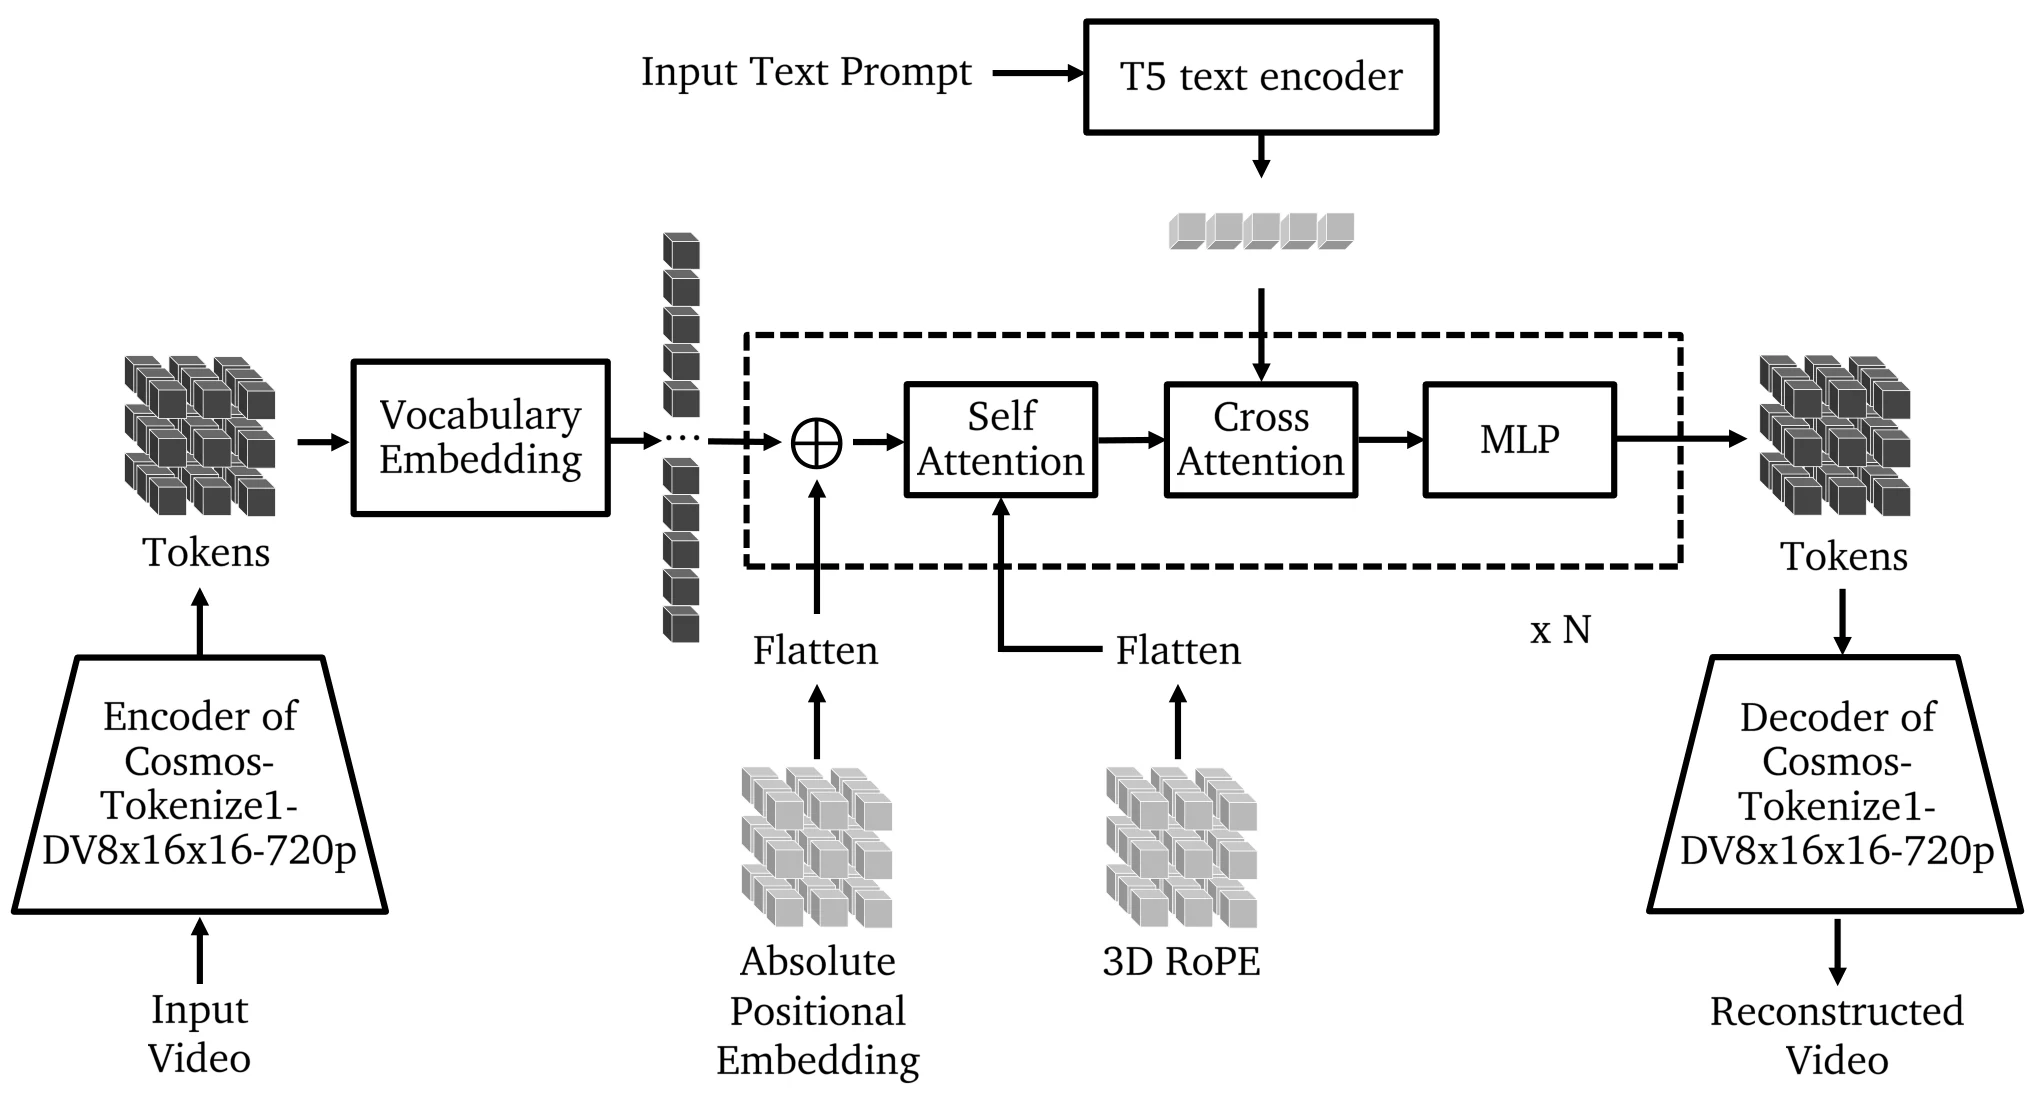
图中左侧是文本 prompt 经 T5 编码后进入跨注意力,视频输入经 Cosmos-Tokenize1-DV8×16×16 的编码器变成离散 token,再变成嵌入进入 Transformer 主干;主干每个块里同时存在 3D RoPE(相对位置)与 3D 绝对位置嵌入,并包含一个文本跨注意力模块。最右侧的 token 由同一 tokenizer 的解码器还原为视频。这张图说明了「分词器即接口」:同一套编码器/解码器的权重在输入端与输出端被复用,语言模型的输出直接是 tokenizer 的词表索引。
Cosmos 把这条管线的两个关键参数变成可选项,形成一组变体:
- 连续 vs 离散:连续 token 是浮点嵌入(给扩散、流匹配这类连续生成模型用),离散 token 是量化索引(给自回归或掩码语言模型用)。这对应上一节与图像分词器里讨论过的「潜变量形态」问题。
- 图像 vs 视频 vs 联合:图像 tokenizer(CI/DI)只处理单帧;视频 tokenizer(CV/DV)在时间维压缩;Cosmos-0.1-Tokenizer 同时支持两者,通过「首帧单独成 token、后续帧成时空 token」实现图像与视频共用同一潜空间。
- 压缩比:空间 8×8、8×16、16×16,时间 4×、8×、16× 多个档次。压缩比越高,token 越少、序列越短;压缩比越低,重建越细。
架构要点:因果时间卷积 + 因果时间注意力
Cosmos Tokenizer 在视频变体上使用「因果时间卷积 + 因果时间注意力」。前者与 MAGVIT-v2 的 T-Causal Conv 同源,后者保证时间维上每个 token 只关注之前的帧。两者的组合让 tokenizer 满足两个性质:
- 图像与视频共用:第一帧在时间维长度为 1 时走因果路径,产出与图像 tokenizer 一致的 token;
- 任意长度:因果结构使推理时可以流式处理,视频长度不限于训练时的固定窗口。
论文中给出的 tokenizer 对比表特别强调这两点:VideoGPT 的 tokenizer 是因果的,但不支持联合图像-视频、也不支持离散;CogVideoX 的 tokenizer 支持因果与联合,但只有连续 token;Cosmos-0.1-Tokenizer 是表里唯一同时满足因果、图像-视频联合、连续与离散都有的方案。
变体与成本
论文给出了各 tokenizer 在 720×1280 分辨率下的运行时间(论文 Table 9,单帧或单图耗时):
| tokenizer | 类型 | 分辨率 | 参数 | 单帧耗时 |
|---|---|---|---|---|
| CogVideoX-Tokenizer 4×8×8 | 连续视频 | 720×1280 | 216M | 414 ms |
| Omni-Tokenizer 4×8×8 | 连续视频 | 720×1280 | 54M | 82.9 ms |
| Cosmos-0.1-Tokenizer-CV4×8×8 | 连续视频 | 720×1280 | 105M | 34.8 ms |
| Omni-Tokenizer 4×8×8 | 离散视频 | 720×1280 | 54M | 53.2 ms |
| Cosmos-0.1-Tokenizer-DV4×8×8 | 离散视频 | 720×1280 | 105M | 51.5 ms |
| FLUX-Tokenizer 8×8 | 连续图像 | 1024×1024 | 84M | 242 ms |
| Cosmos-0.1-Tokenizer-CI8×8 | 连续图像 | 1024×1024 | 77M | 62.7 ms |
| LlamaGen-Tokenizer 8×8 | 离散图像 | 1024×1024 | 70M | 475 ms |
| Cosmos-0.1-Tokenizer-DI8×8 | 离散图像 | 1024×1024 | 79M | 64.2 ms |
这张表的读法要注意:Cosmos 的变体参数普遍在 77M 到 105M 之间,比 CogVideoX 的 216M 小一半以上,但单帧耗时只有后者的约十分之一。这不是「模型变小所以变快」这么简单,而是架构上的因果卷积 + 因果注意力可以在时间维上复用已计算的部分,并且避免了全向卷积带来的时间维开销。
压缩比与 token 数
Cosmos 把压缩比的选择权交给下游:世界模型要预测的视频越长,越需要大压缩比;要保留的细节越细,越需要小压缩比。以 720×1280、49 帧为例:
- 时间压缩 4×、空间 8×8:token 数约 ;
- 时间压缩 8×、空间 16×16:token 数约 。
两者相差近一个数量级。前者适合下游是扩散模型(token 不必是离散的,序列长度可以交给注意力机制处理),后者适合下游是自回归语言模型(序列长度直接决定采样步数)。Cosmos 把「压缩比 × 连续/离散 × 图像/视频」组合成一个矩阵,就是因为不同下游对 token 密度的需求本来就不同。
从 tokenizer 视角看视频生成的推理账
把四个方案放在一起,可以得到一条贯穿全文的主线:视频分词器的每一个设计,都在为下游生成模型削减推理成本。
| 方案 | 时间压缩方式 | 因果性 | 量化 | 下游解码 |
|---|---|---|---|---|
| VideoGPT | 3D 卷积,全向 | 非因果 | VQ 查表,码本 256–4096 | 自回归 |
| MAGVIT | 3D-VQ,全向 | 非因果(靠 COMMIT 修正) | VQ 查表,码本 1024 | 掩码多步并行(12 步) |
| MAGVIT-v2 | T-Causal Conv | 因果 | LFQ 不查表,码本 26 万 | 掩码(12 步),词表可做大 |
| Cosmos | 因果时间卷积 + 因果时间注意力 | 因果 | 连续 / LFQ 离散可选 | 扩散或自回归均可 |
四者对照下来,成本项几乎是一一对应的:
- 序列长度由压缩比决定。VideoGPT 的消融表明时间维不能压太狠,MAGVIT-v2 把 17 帧压成 5 个时间片,Cosmos 允许 4× 到 16× 的多档。压缩比是第一道成本闸门。
- 解码步数由解码方式决定。自回归随序列长度线性增长;掩码解码固定 12 步。MAGVIT 的 60 倍提速主要来自这里。
- 词表大小由量化方式决定。查表 VQ 的词表被限制在几千量级,LFQ 可以放心做到 26 万。词表越大,token 的「语义粒度」越粗、同样视频的序列可以越短——这是 LFQ 对序列长度的间接贡献。
- tokenizer 自身开销由是否因果决定。因果 tokenizer 可以在时间维上增量编码、支持流式,而非因果方案必须等整段视频就绪。Cosmos 的单帧 34.8 ms 与 CogVideoX 的 414 ms 之间的差距,就是这个性质的具体表现。
如果给一个选型建议:下游用自回归或掩码语言模型时,优先「因果 + LFQ」的 tokenizer(MAGVIT-v2 一类),因为词表大、序列短、无泄漏;下游用扩散或流匹配时,优先「因果 + 连续」的 tokenizer(Cosmos 的 CV 变体),因为连续潜变量更贴合扩散的采样过程;如果只有单帧图像需求,标准图像分词器的效率仍然最好。
小结
视频分词器的拆解可以收敛到五条结论:
- 时间维必须压缩,但压得太狠会伤到生成质量。VideoGPT 在固定 token 总量下的消融给出了最优的时空分配,MAGVIT-v2 用 4 倍时间压缩给出了长片段下的可行点。
- 因果性不是可选项,而是正确性问题。3D 全向卷积的 tokenizer 必须依赖 COMMIT 这类补偿机制来抑制条件信息泄漏;因果 tokenizer 把问题从「修正泄漏」变成「不可能泄漏」。
- 因果性有两种实现路径,结果一致:Transformer 侧的因果时间注意力(C-ViViT)与卷积侧的因果时间卷积(MAGVIT-v2)都是「时间维只看过去」,前者天然支持变长续写,后者空间因果性更好、运行更快。
- 码本要「宽」但不能「散」。查表 VQ 的码本做大后,提升只体现在重建上;LFQ 用逐维独立二值化的方式,让词表扩展到 26 万的同时保持语言模型可学。
- tokenizer 的开销要算进端到端预算。Cosmos 的单帧耗时对比说明,因果结构不仅是正确性问题,也是吞吐问题。
图像侧的分词器机制与音频侧的离散 token 路线分别可参考 图像离散分词器完全拆解 与 音频生成的离散 token 路线。视频与音频的分词器在「时间维因果压缩」这一点上高度相通:二者都要在时间维上压缩冗余,又都要允许任意长度。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



