


视频插帧架构入门:两帧之间那一帧是怎么算出来的
问题定义:中间那一帧为什么难算
视频插帧(video frame interpolation,VFI)要解决的问题只有一句话:给定时间轴上相邻的两帧 与 ,合成它们之间在时刻 应该存在的那一帧 。这里的 是归一化时间, 对应第一帧, 对应第二帧, 就是正中间。
这个任务看起来只是”把两张图混合一下”,但真正困难的地方在于:像素本身不会告诉你它去了哪里。若把两张图直接做线性平均 ,对于静止的背景没有任何问题,可只要画面里有运动,边缘就会变成两层重影。原因是运动物体在两张图中位于不同位置,平均之后两个位置各留下半透明的物体,背景也被物体”擦过”的地方染了色。运动越快、位移越大,重影越宽。
所以插帧的本质问题不是”如何融合两张图”,而是两件事:
第一,估计像素在两帧之间如何运动。对每个像素位置做出”它从 的哪里来、将去往 的哪里”的判断,这就是运动建模。
第二,决定新位置的像素该从哪里取。在插帧的中间时刻,某个位置上的颜色可能只来自 (物体刚要离开)、只来自 (物体刚刚到达),或者两者的一部分(物体边缘)。如果取错了来源,就会出现拖影、鬼影、边缘模糊。
这两件事在文献中分别对应光流估计(optical flow)与遮挡推理(occlusion reasoning)。几乎每一个插帧架构,都是在这两件事上做不同的取舍:有的是”先请一个专门的光流网络来估计,再用一个合成网络融合”,有的是”把光流估计和融合压进同一个网络一起端到端学”,还有的是”干脆绕开显式光流,让网络直接在特征层上完成运动对齐”。
理解这张技术地图之前,需要先补一段最基础的背景:光流到底是什么,以及它为什么是插帧在数学上最自然的表示。
光流:像素级运动的基本表示
亮度恒定假设与光流方程
光流(optical flow)指的是图像平面上每个像素点在相邻两帧之间的位移向量。设图像上位置 处的亮度为 ,视频在时间上连续变化。最经典的光流推导来自亮度恒定假设(brightness constancy assumption):同一个物理点在相邻两帧之间被投影到图像上的不同位置,但它的亮度在很短时间内基本不变。如果把该点在时刻 的位置记为 ,则该点沿时间方向的亮度不变:
对 求全导数并令其为零:
记 、 为像素的水平与竖直速度分量, 为空间梯度, 为时间梯度,就得到著名的光流约束方程(optical flow constraint equation):
这个方程只给出一个约束,却有两个未知量 ,这是一个欠定问题,也就是光流文献中常说的孔径问题(aperture problem):在一条边缘内部,梯度只沿着垂直于边缘的方向变化,沿边缘方向的运动完全无法从局部亮度变化中看出来。例如一条水平放置的黑白边界向上或向下移动时,像素值变化非常明显;但如果同时还有横向滑动,横向分量无法单独确定。
经典方法因此要加入额外的先验:Lucas-Kanade 方法假设小窗口内位移相同,用最小二乘在邻域内合并约束;Horn-Schlick 方法加入全局平滑项。这些方法在平滑、小位移场景下工作良好,但面对大位移、纹理缺失和遮挡时容易失效。
为什么插帧天然需要光流
有了光流,插帧的数学形式就极其简洁。设 表示”从 到 的运动场”,即在 中位置 的像素到 时移到了 。如果假设运动在 与 之间是匀速的,那么在中间时刻 该像素的位置就是:
这就是光流线性插值假设的核心。它把”两个端点帧之间的未知帧”变成了”沿光流场行走 倍路程”。对整张图做这件事,就得到中间帧:
用 向另一边也可以同样写出:从 位置 反向回推到 ,等价于用后向光流 和因子 进行反向采样。
这种反向采样在 GPU 上有一个专门的名字叫双线性 warping(bilinear warping)。对一个目标像素位置 ,计算出它在源图中的浮点坐标 ,然后对源图坐标 周围四个整像素做双线性插值。之所以叫反向(backward),是因为它从目标位置出发去源图里”取”值,而不是把源位置的像素”推”到目标位置,后者会在一对多和多对一的采样密度不一致时留下空洞,反向采样则保证每个目标像素都有确定的值。
式中 是坐标 周围最近的四个整数格点,权重 按到 的距离(水平和竖直两个方向的距离乘积)分配。
如果光流完全准确、没有遮挡,那么用 与 分别 warp 到中间时刻后取平均,就是理论上最优的中间帧。问题在于真实光流几乎从不准,并且遮挡几乎必然存在,所以所有实用架构都在这两步上加修正。
遮挡:插帧里最麻烦的部分
在 中可见的像素,到 时可能被别的物体挡住了;反之亦然。这类像素只在一帧中被观测到。对它们来说,中间帧应该使用能看到它的那一帧的颜色,而不应该做平均——把一帧的颜色和一帧被遮挡后的背景颜色平均,会得到”半透明的鬼影”。
更微妙的是,中间时刻的遮挡状态可能和两端都不同:一个物体在 时可能刚好从另一物体后面露出,但在 与 两端都被挡住。这类”中间时刻才出现或消失”的像素,两个端点帧都没有它的颜色,任何插帧方法都只能靠推断,这是 VFI 的根本上限之一。文献中把这类情形称为双向遮挡或不可见区域。
因此,一个合格的插帧管线除了要有光流,还要有某种可见性图(visibility map):对每个位置、每一侧,给出该位置的颜色可以在多大程度上被信任。可见性越接近 1,该帧贡献越大;越接近 0,则越不应当参与融合。
第一代:双向光流 + warping 的合成管线
第一代实用插帧方法的共同结构是:一个网络估计双向光流,一个网络或后处理修正光流并给出可见性,最后用可见性加权融合两端 warp 结果。代表性工作是 Super SloMo,2017 年由 NVIDIA 团队提出。它把插帧拆成清晰的四步,每一步都可以单独理解。
步一:用 U-Net 估计双向光流
Super SloMo 采用一个 U-Net 结构的编码器-解码器来估计 与 的前后向光流。这里为什么用 U-Net,而不是像 FlowNet 那样的大网络?U-Net 的跳跃连接把高分辨率浅层特征与低分辨率深层特征拼接,使得网络既能获取足够大的感受野来捕捉大运动,又能在最终的输出上保留边缘细节。对插帧这种对边缘高度敏感的任务,这一点很重要:光流边缘估计粗一点,warp 之后的物体轮廓就会出现锯齿或模糊。
U-Net 的另一个关键性质是训练数据可以用真实图像自动构造。视频中有连续多帧 ,把中间的 作为监督目标,而不是需要标注的光流。这使 Super SloMo 的监督信号直接对齐任务目标——不需要昂贵的光流标注(如 Sintel 的稠密真值),只用普通视频即可训练。这种”以中间帧为监督”的思想后续被几乎所有”端到端插帧网络”继承。
步二:近似中间时刻的双向光流
真实的光流网络给的是 这一整段的位移,而插帧需要的是 与 之间、 与 之间的两段位移。如果假设运动近似匀速,就有一个非常优雅的代数近似:
这两个式子并不是凭感觉构造的,它们有一个最小二乘解释。设 时刻的像素位置为 ,匀速假设下从 出发的预测位置是 ,从 出发的预测位置是 。若希望中间时刻的光流同时”贴近”这两条两端预测轨迹,就构造两条轨迹点的加权拟合,并选择让残余误差最小、且对前后向两个估计都有最小二乘意义下的权重的组合。论文给出的正是这一组系数。
直觉上看这些系数也很合理:当 时, 退化为 , 退化为 0,即中间帧恰好是 ,后向光流为零。当 时反过来,,,中间帧恰好是 。两端自洽是这组公式必须满足的起码条件,而线性组合恰好同时满足了这个条件和”匀速”约束。
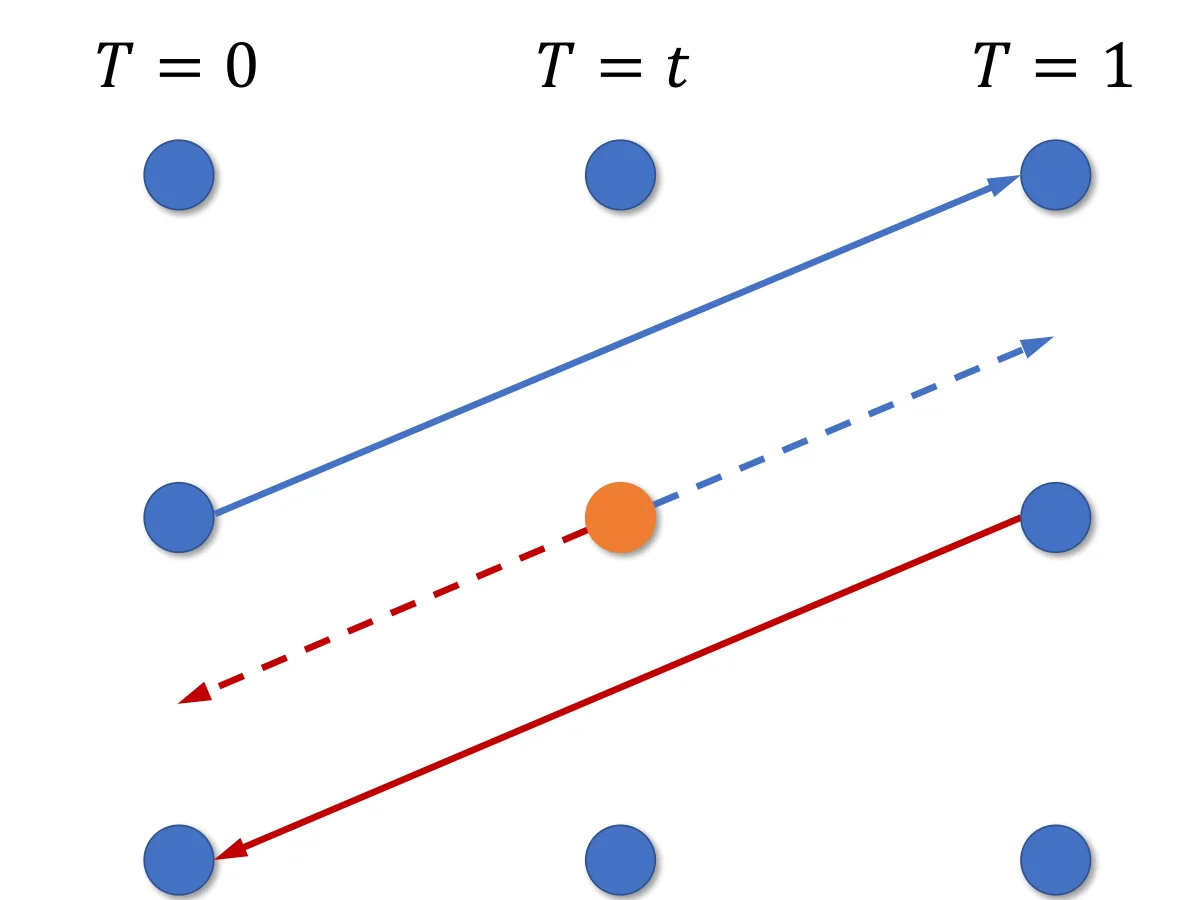
上图来自 Super SloMo 论文,展示了两端光流如何沿时间轴合成中间时刻的光流。可以看到从 向 时刻推进的轨迹与从 向回推进的轨迹在中间汇合,线性组合系数正是沿这两条轨迹按时间比例加权的结果。
不过这一近似有一个明确的失效条件:它只适用于局部平滑且无遮挡的匀速运动。在运动边界上,光流本身不连续;在有遮挡时,向前向后的两条轨迹并不真的指向同一个像素;在变速运动(例如抛物线、加减速)时,线性组合会产生明显偏移。所以第二步只是给出”初步中间光流”,真正的质量提升要靠第三步。
步三:用第二个 U-Net 修正近似光流并预测可见性
Super SloMo 用一个额外的 U-Net 接收”两端原始帧 + 近似中间光流 + 时间 “作为输入,输出三类量:修正后的中间前后向光流,以及两个软可见性图 与 。这是一个很值得注意的工程选择——运动修正与遮挡预测共用同一个网络。因为两者信息高度耦合:光流哪里不准,哪里就大概率是边缘或遮挡区域,网络同时看到二者的上下文,能比分开的两个网络更一致。
软可见性图是关键设计。它不是二值遮挡掩码,而是连续值,允许”部分可见”的情形(如物体边缘的半透明过渡、运动模糊)。融合时:
式中 是把 用 warp 到中间时刻的图, 同理。分母是归一化,保证权重和为 1。 与 的前置因子编码了一个先验:越接近 的时刻,越应信任 ;越接近 的时刻,越应信任 。这与遮挡逻辑一致——刚离开 的物体边缘处 更可信,刚进入 的物体边缘处 更可信。
步四:warp 与加权融合
最后一步把两端帧分别 warp 到中间时刻并加权。注意这里没有再做显式的”填补遮挡”步骤,遮挡的填补完全由可见性权重完成:被遮挡区域的可见性接近 0,权重自动流向另一侧。这一结构的好处是简单、可解释,每一步都可以独立诊断;代价是两级光流的误差会级联。
训练损失:四项监督与消融证据
Super SloMo 的监督信号不是单一的重构误差,而是四项损失叠加,每一项都对应管线中一个具体环节,这也是理解这类架构的好入口:
- 重构损失 :对生成的中间帧与真实中间帧做 距离,直接约束最终输出;
- 感知损失 :把生成帧与真值帧送入 ImageNet 预训练的 VGG16,取
conv4_3层特征做 距离。论文明确说这一项是为了解决”只用 会导致预测模糊”的问题——像素级平均在数学上会倾向于生成模糊解,感知损失把监督拉到特征层,迫使结果保留细节; - warping 损失 :用估计出的光流把一帧重建到另一帧,再与目标帧比较,直接约束光流本身的质量。这一项很关键,因为最终重构损失只能间接影响光流,信号要穿过 warping 与融合两层才回传,容易变弱;
- 平滑损失 :对 与 的空间梯度取 ,鼓励相邻像素的光流接近。
消融结果很能说明每一项的必要性。论文在 Adobe240-fps 数据集上报告:完整模型为 31.19 dB PSNR / 0.918 SSIM;去掉光流插值(改用其他方式构造中间流)降到 30.34 dB,是四项中影响最大的;去掉可见性图降到 31.16 dB、插值误差 IE 从 8.30 升到 8.33;去掉感知损失降到 30.96 dB;去掉 warping 损失降到 30.52 dB;去掉平滑损失 PSNR 几乎不变(31.19),但 IE 从 8.30 升到 8.26——注意 IE 是越小越好,这里反而略降,说明平滑损失主要作用在光流的空间连续性上,对单帧保真度的直接贡献有限。这组数字给出了一个很实用的判断:在插帧里,“光流怎么来”比”怎么融合”更决定上限。
多帧递归:一次请求生成多帧
Super SloMo 还有一个工程上很重要的性质:网络参数与时间 无关,因此同一个网络可以生成任意多帧。要 4 倍插帧,先在 生成中间帧,再以 与生成的 为新的两端,在 处生成四分之一帧,同时在 与 之间生成四分之三帧。这样递归下去, 级就能得到 个中间帧。
代价是误差递归累积:第二级插帧的”端点”之一是第一级的生成结果,它本身带有误差,而这些误差会作为新的输入继续传播。因此递归深度越深,越靠后的中间帧质量越差。实用系统通常只在最关键的时间点做一级插帧,或者每一级都用原始真实帧重新锚定,避免误差沿树状结构扩散。
光流估计器本身怎么进化:从相关层到全对相关
第一代插帧架构中,插帧质量的上限很大程度上取决于它的光流估计器有多好。因此光流估计本身经历了一条独立的技术演进线,这条线对理解插帧系统非常关键。
FlowNet 与相关层
2015 年 FlowNet 由 Fischer 等提出,第一次用 CNN 端到端学习光流。它有两个变体:FlowNetSimple 把两帧直接堆叠进一个编码器;FlowNetCorr 先把两帧各自编码成特征,再用一个相关层(correlation layer)在特征空间里计算局部块之间的相似度。
相关层的计算是:对第一帧特征在位置 的特征向量 ,与第二帧特征在 的特征向量 ,计算内积:
把所有 相对 的偏移限制在一个局部窗口内,得到的是一个”四维相关体”(4D correlation volume),前两维是 的坐标,后两维是偏移量 。这个相关体把”哪里和哪里最像”变成了一张可以学习的查找表——后续的解码器只需从相关体中读出峰值位置,就得到了位移。
FlowNetCorr 证明了相关层在光流中非常有效,但它的局部窗口假设意味着它只能捕捉小范围位移;大位移需要依赖金字塔层级逐级放大,或者扩大窗口导致计算量暴增——一个 窗口在每个位置的代价是 次内积。
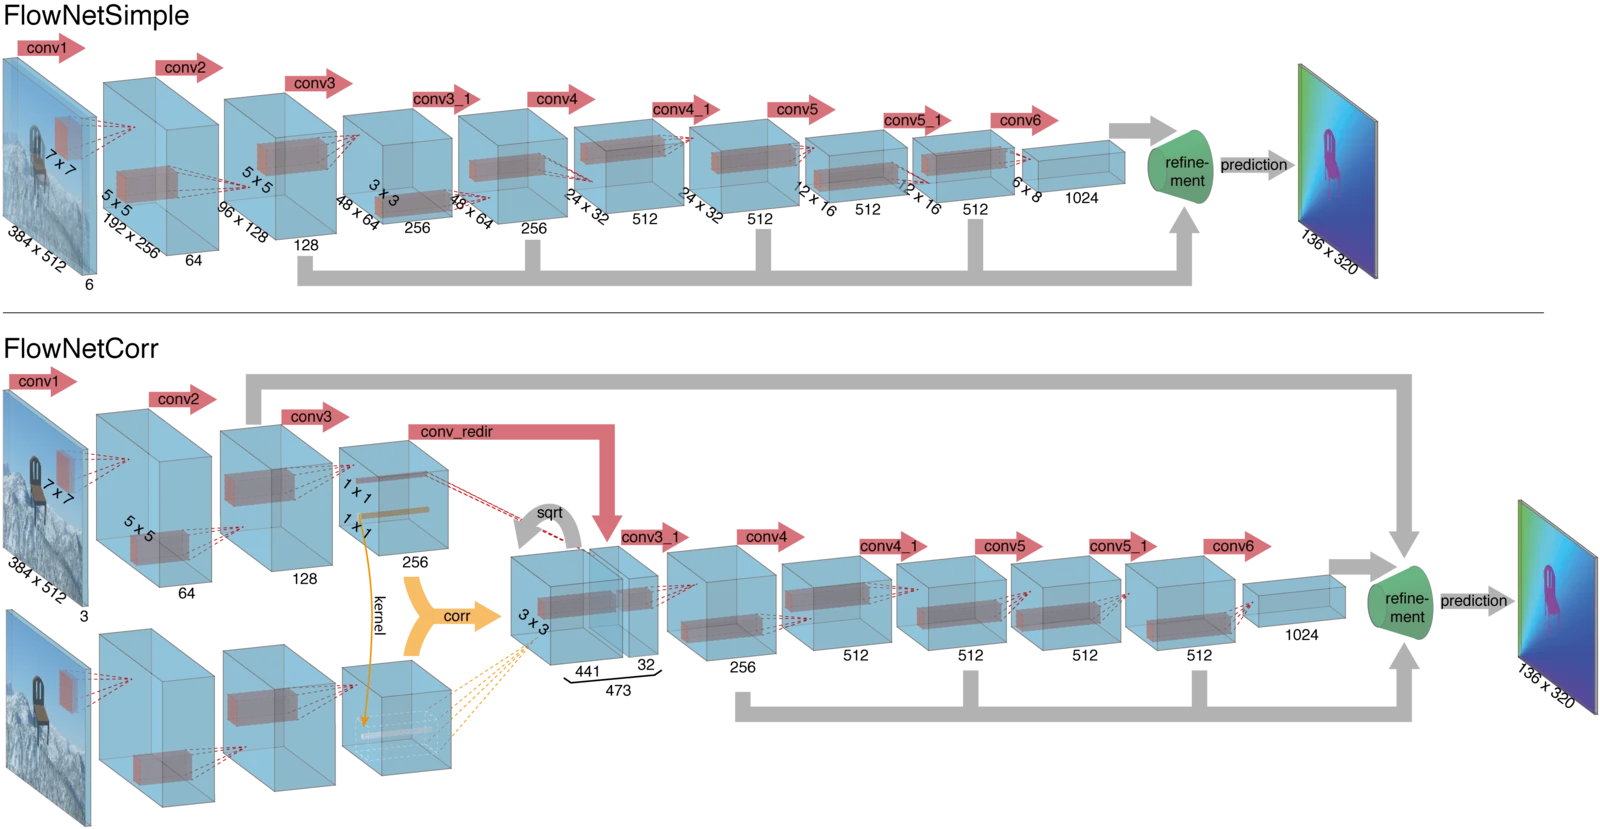
上图是 FlowNet 论文中的两种结构对比。上方的 FlowNetSimple 直接把两帧拼接后进一个大编码器;下方的 FlowNetCorr 在编码器后插入相关层(contracting 部分的紫色模块),让网络在特征空间中显式搜索匹配。这一对比清楚说明了一个转折:早期 CNN 光流网络的区别在于”是否显式做匹配”,而不是单纯叠加层数。
金字塔 + warping + cost volume
之后的 PWC-Net(2018)把这些成熟的计算机视觉组件显式组合起来,并归纳出一条设计原则:不要在大分辨率上做匹配搜索。PWC-Net 的做法是金字塔:每一层先在低分辨率上估计粗光流,再把它上采样后 warp 高分辨率特征到当前层,然后在这一层的”已对齐特征”上构建代价体(cost volume),估计增量光流。这样每一层只需要搜索残差位移,搜索窗口很小,计算量大幅降低。
这条原则的影响极深,因为它揭示了一个结构性事实:光流估计中大部分计算在匹配搜索,而匹配搜索在低分辨率下做和高分辨率下做,搜索结果的物理分辨率差很多,但计算量差一个平方量级。所以所有后续既追求质量又追求效率的光流网络,都在金字塔/多尺度结构上做文章。
RAFT:全对相关与循环迭代
2020 年 Princeton 的 RAFT(Recurrent All-Pairs Field Transforms)把光流估计推到新高度。它的设计非常干净,只有三个部件:
- 特征编码器:一个 CNN 分别对两帧提取特征图,特征图通常取输入分辨率的 1/8。
- 4D 全对相关体积:对 1/8 分辨率下所有特征点两两计算内积,不做局部窗口剪枝。规模是 ,看起来很大,但由于分辨率降低了 8 倍,实际存储可控。
- 循环更新单元:用一个 GRU 式的小型循环网络迭代地修正光流。每次迭代,更新单元在当前光流估计上做局部查找(在相关体上按当前预测位移附近采样),结合上下文特征,输出一个增量 :
迭代次数通常是 12 到 32 次。
RAFT 有两个关键创新。第一,全对相关 + 局部查找替代了传统金字塔的显式多层级搜索:低分辨率全对相关覆盖了很大范围,而迭代时只在当前估计附近查找,相当于”先粗后细”的搜索被组织成”固定一次构建 + 反复局部读取”。第二,多尺度池化金字塔(1x1、2x2、4x4 的池化)让一个大位移也能在当前估计附近的小窗口里被”找到”,避免了只依赖精确初值。
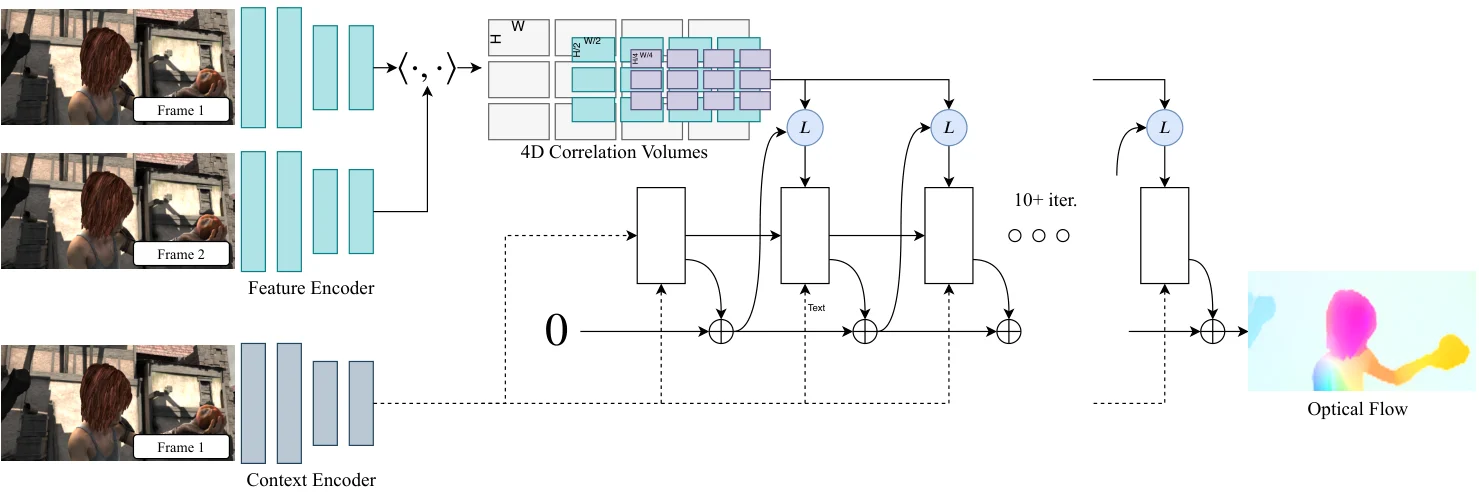
上图来自 RAFT 论文,左侧的两个编码器分别处理两帧,中间生成 4D 相关体积,右侧的上下文编码器提供更新单元的输入。整体结构非常简短:特征、相关体、循环更新三步,没有明显的多级金字塔解码器,这种简洁性正是其质量提升的重要原因。
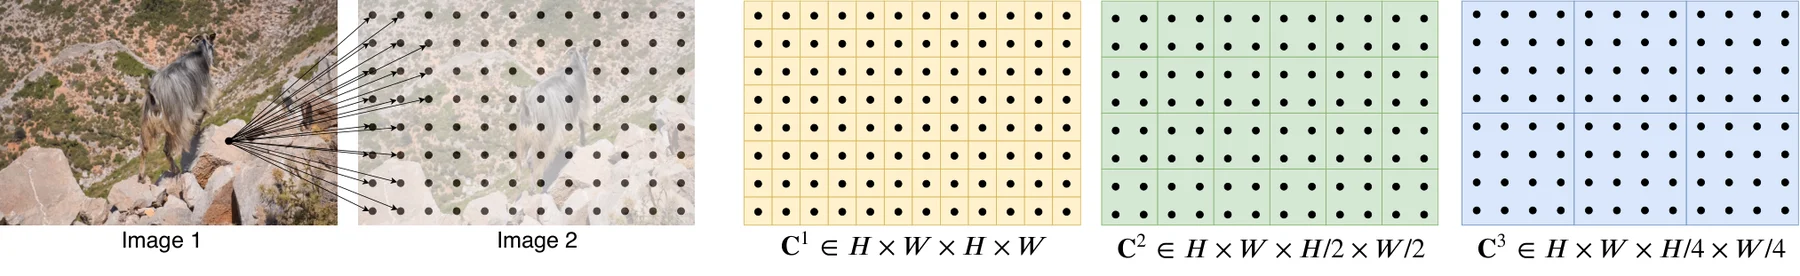
上图来自 RAFT 论文,展示了全对相关体积如何从两帧特征计算得到,以及 1/2、1/4 尺度的池化金字塔如何为迭代时的查找提供多尺度邻域。池化的作用很微妙:它让查找的范围在池化后等效扩大到数倍,这样即使当前估计偏离真实位移较多,也仍能找到正确的匹配峰值。
RAFT 在 KITTI 上取得 F1-all 约 5.10%、Sintel final 端点误差约 2.855 像素,均为此前的明显提升。更重要的是它的结构成为后续很多方法(包括 GMFlow、以及后续不少插帧架构)的直接参考。
全局运动聚合:用注意力解决遮挡
RAFT 本身在遮挡区域的光流质量仍然有限。2021 年 GMFlow(Global Motion Aggregation)的出发点正是针对遮挡。它的核心观察是:对遮挡区域的点,局部匹配找不到可靠线索;但在无遮挡区域,相似纹理点之间的运动往往相互关联,可以借助长距离上下文推断。
GMFlow 加入了一个 Transformer 式的全局运动聚合模块:在第一帧的特征上计算全局自注意力(self-attention),得到每个像素对所有其他像素的注意力权重;然后用这些权重对所有其他像素的运动特征做加权聚合,得到被聚合的运动特征 :
式中 是光流解码器中间层的运动特征, 是注意力权重, 是特征维度。这个操作把”局部看不见”的遮挡点与”别处可见”的相似区域关联起来,从而修正遮挡处的光流。
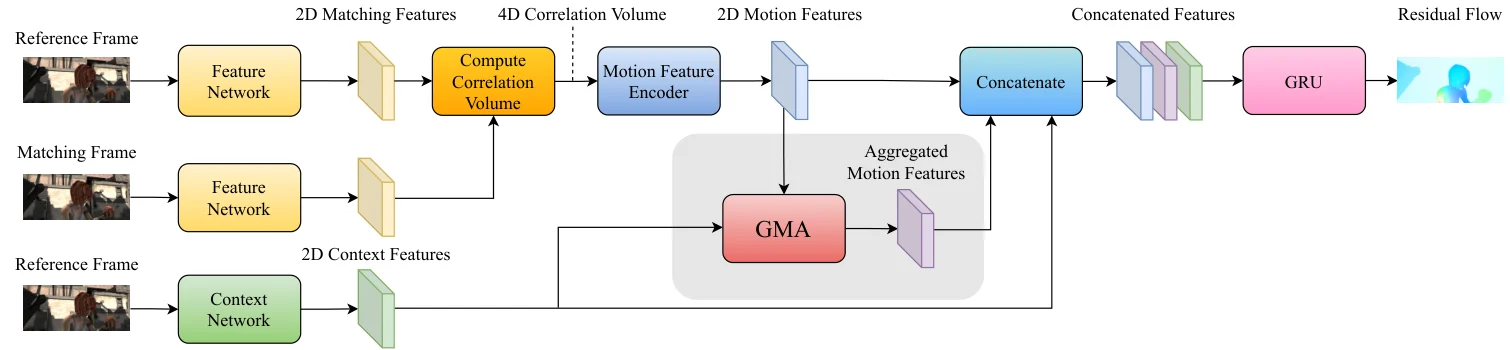
上图来自 GMFlow 论文,核心是在光流预测的中间阶段插入注意力聚合模块(图右侧的 global aggregation 部分),将各处的运动特征跨空间融合后再生成最终光流。这一设计证明了注意力机制对遮挡问题有实质帮助,也为后面第三条路线”绕开显式光流”做了技术预热。
光流:像素级运动的基本表示
(待写)
第一代:双向光流 + warping 的合成管线
(待写)
光流估计器本身怎么进化:从相关层到全对相关
(待写)
第二代:把光流估计压进插帧网络
第一代架构有一个内在成本问题:它需要先估计两整段的完整光流,再做两段光流的合成与修正,最后才融合。无论光流估计器多快,这一步都是为插帧之外的用途服务的通用光流——它输出的不是”两端之间的中间流”,而是” 到 “这一整段。在插帧任务里,中间时刻只关心两段更小的运动,用通用光流再压缩,等于先算大再算小,成本上并不合算。
第二代架构的核心理念可以概括为:训练一个专门估计”中间光流”的网络,把粗略融合与细化修正作为同一个网络的内部步骤。代表工作是 RIFE(Real-time Intermediate Flow Estimation),2021 年由旷视的 Huang 等提出,随后在 ECCV 2022 扩刊。
IFNet:直接输出中间光流
RIFE 的网络叫 IFNet(Intermediate Flow estimation Network)。它的输入是两帧 以及目标时刻 ,输出 时刻的前向与后向中间光流 。与第一代”先整段后压缩”不同,IFNet 从一开始就在学习任务真正需要的那两段小位移。
这带来一个训练上的困难:中间光流没有直接的监督目标。普通视频里只有真实中间帧 ,没有”像素 A 在 时刻去了哪里”的标注。RIFE 的解法是特权蒸馏(privileged distillation)。
特权蒸馏:用教师网络提供光流监督
特权蒸馏的思路是:训练时同时存在一个教师网络和一个学生网络。教师网络结构更深,可以接收额外的”特权信息”,例如真实中间帧 附近的帧,从而先估计出更准的中间光流;学生网络只看两端帧和 ,被训练去模仿教师的光流输出。推理时只部署学生网络,教师被丢弃。
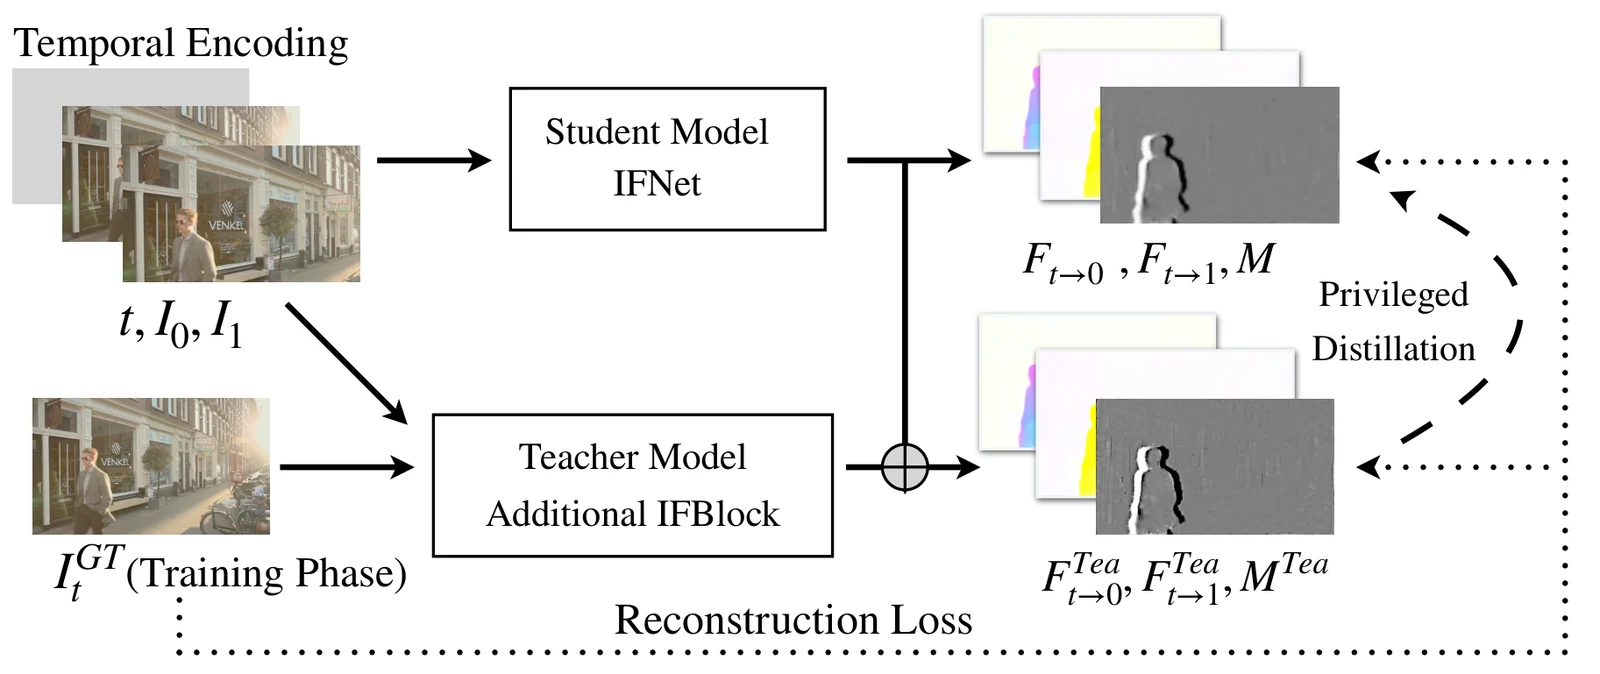
上图来自 RIFE 论文,左侧是训练时的教师模型,右侧是实际部署的学生模型 IFNet。图中清晰标出两种误差来源:重构损失(学生只能看两端帧)与蒸馏损失(学生要逼近教师对中间光流更好的估计)。特权蒸馏的工程优点很直接——它使 IFNet 能在不依赖任何外部光流标注的情况下收敛,又能借助教师网络获得较准确的中等光流监督。训练完成后,学生网络就是一个轻量的”专用中间光流估计器”。
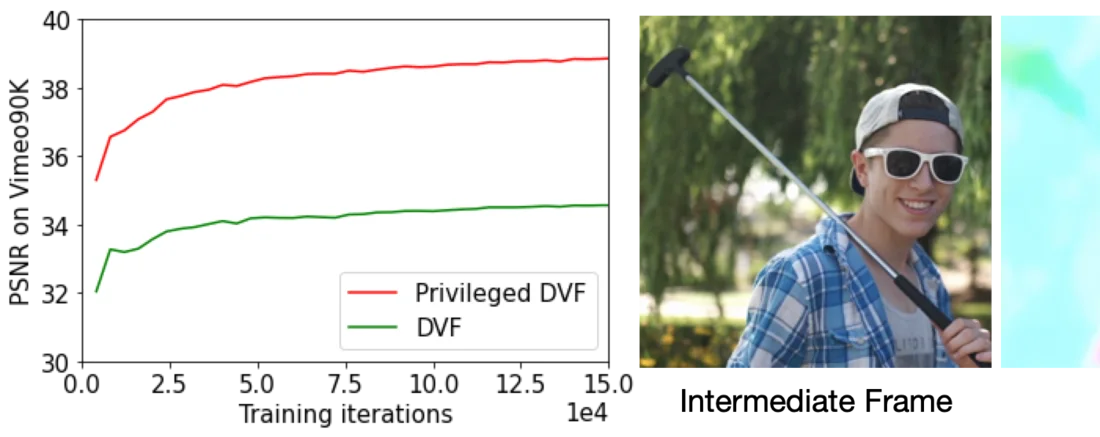
上图来自 RIFE 论文,对比了普通 DVF(普通位移场估计,即只从两帧估计中间光流)与特权 DVF(额外输入真实中间帧的边缘图作为特权信息)在训练迭代轮次上的表现。论文的观察非常直接:只给两帧时,估计出的中间光流是模糊的;而一旦模型能看到一点中间帧的信息(哪怕只是边缘图),光流的量化结果就”出乎意料地高”。这组对比正是特权蒸馏的动机——教师网络正是借助这类中间帧信息来给出高质量的光流监督,再通过蒸馏把这一能力转移给只能看两帧的学生网络 IFNet。
IFBlock:由粗到细的迭代修正
IFNet 的第二阶段是迭代的 IFBlock,采取由粗到细(coarse-to-fine)的策略,每一级分辨率逐渐提高。每个 IFBlock 做两件事,并且都输出给下一级使用:修正中间光流 ,以及修正软融合掩码 。
其直觉可以这样理解:按当前的光流估计,把两个输入帧中对应的像素搬到潜在中间帧的同一位置,再用融合掩码把两侧像素组合起来。掩码的作用与第一代的可见性图相同——它逐像素决定在当前位置上该相信 搬来的颜色,还是相信 搬来的颜色,或者两者的中等混合。因为掩码和光流一起被迭代更新,每轮输出更准的光流又会让下一轮的”搬运”与掩码估计更可靠,二者互相促进。
一个工程上的关键选择是:IFBlock 内部不使用代价体(cost volume),只用 卷积和反卷积作为基本构件。代价体是光流网络的经典重武器(FlowNetCorr、PWC-Net、RAFT 都大量依赖它),省掉它使 IFNet 的计算量大幅下降,并且这种纯卷积结构对嵌入式显示设备上的 NPU 支持非常好。这正是 RIFE 能把插帧做进实时播放链路的根本原因:它牺牲了显式全局匹配,换来的是低延迟与可部署性。
时间编码:任意时刻插帧
IFNet 输入中带有显式的 编码。这意味着同一次两帧请求可以合成任意整数倍帧率:4 倍插帧就是在 三个时刻各跑一次,8 倍就是在七个时刻各跑一次。但要注意,多次插帧的光流精度会随 变小而下降:当 时,两段位移很接近零位移,光流估计的信号噪声占比更大,边缘的模糊更容易出现。这是所有”时间编码插帧”方法的共性:越靠近端点,对光流估计的精度要求越高,因为小幅位移在颜色变化里产生的对比度越小。
第三代:绕开显式光流的注意力路线
第二代已经把光流估计的效率提得很高,但”光流”这个中间表示本身仍有代价:它必须是一个稠密的位移场,必须经过 warping,且对遮挡的处理几乎全部依赖”光流准不准”。第三代架构的出发点有两个:一是光流在遮挡处和大幅运动处本身就不准;二是双线性 warping 是不可微的离散操作,会丢失高频细节。
FILM:多尺度特征 + Gram 矩阵损失
2022 年 FILM(Frame Interpolation for Large Motion)的方案是:用一个在所有尺度上共享权重的特征提取器,构建一个”尺度无关”(scale-agnostic)的双向运动估计模块,再输出中间帧。它不需要外部预训练的光流模型或深度模型,运动估计与帧合成被收进同一个网络,训练时只依赖三帧(两个端点加一个中间帧)即可完成。
“尺度无关”这个设计背后有一个很朴素的直觉:细尺度上的大运动,看起来等价于粗尺度上的小运动。于是在不同尺度上复用同一套权重,既让同一组参数见过”从小位移到大位移”的各种情形,又让大位移在粗尺度上获得更多可用的监督像素。这直接针对了第一代方法在大位移处退化的结构性缺陷。
FILM 最值得单独讲的设计是 Gram 矩阵损失(Gram matrix loss)。它的出发点是:插帧结果如果只是在像素颜色上接近真值、但纹理结构不一致,人眼仍会看出模糊或重影。Gram 矩阵是特征图上通道之间的相关矩阵:
其中 是把特征图展平成”通道 × 像素”的矩阵(此处省略批维与位置归一化), 的每个元素 衡量第 个通道与第 个通道在空间上的相关性。用 Gram 矩阵差作为损失:
式中 是高层特征提取器(如 VGG 的某些层), 是 Frobenius 范数。这个损失约束的不是”每个像素颜色对不对”,而是”特征通道之间的相关结构像不像”——也就是纹理的统计风格。这对插帧非常关键,因为插帧的典型失败不是颜色偏了,而是大遮挡区域被”抹平”成一片模糊;像素级损失对这类模糊不敏感(模糊区域的平均颜色可能很接近真值),Gram 损失却能显著惩罚纹理统计的塌陷。
FILM 论文明确把 Gram 损失与”大运动造成的宽遮挡区域”联系在一起:大位移会撕开较大的遮挡带,这些区域只能由网络”修补”(inpaint),而 Gram 损失正是让修补结果保有真实纹理的关键。
EMA-VFI:用同一张注意力图同时做运动与外观
2023 年 EMA-VFI(Extracting Motion and Appearance via Inter-Frame Attention)走得更远,它把注意力机制作为插帧的核心操作,并指出了一个此前被忽视的问题:现有方法把”运动信息”和”外观信息”混合处理,导致表示有歧义、效率低。
EMA-VFI 的做法是对帧间注意力(inter-frame attention)重新审视:标准的帧间注意力把一帧作为 query、另一帧作为 key/value,注意力图(attention map)表达的就是”两帧之间的相似匹配”。这张注意力图同时承载了两类信息:
- 运动信息:注意力峰值的位置就是两帧中对应像素之间的位移,从注意力图上可以直接读出运动;
- 外观信息:注意力图在无匹配处的分布情况反映了该区域的可靠性,可以用于外观特征增强。
EMA-VFI 用同一套注意力计算同时完成这两件事,因此既节省计算,又避免了”运动模块 + 外观模块”两套设计带来的表示不一致。这个观察在概念上很重要:它说明”运动”和”外观”在插帧网络里本就不是两个独立要学的东西,而是同一张图景的两个投影。
EMA-VFI 还把这种模块嵌入混合 CNN 与 Transformer 的架构中:CNN 部分保留低层的细节,注意力部分处理大范围匹配,最终合成中间帧。
三条路线的横向比较
把三代插帧架构放在一张表里对比,能更清楚地看到各自的取舍:
| 维度 | 第一代(Super SloMo 类) | 第二代(RIFE 类) | 第三代(FILM/EMA-VFI 类) |
|---|---|---|---|
| 显式光流 | 有,双向 + 中间近似 | 有,但只估计中间流 | 不显式输出,特征层对齐 |
| 遮挡处理 | 显式软可见性图 | IFBlock 隐式学习融权 | 注意力匹配 + 特征统计 |
| 训练监督 | 中间帧真值 | 中间帧真值 + 特权蒸馏 | 中间帧真值 + Gram 损失 |
| 实时性 | 低(两段光流 + 两 U-Net) | 高(单网络,适合 4K 实时) | 中到高(多尺度特征) |
| 大位移 | 依赖金字塔 | 依赖多尺度 + 蒸馏 | 注意力匹配天然覆盖长程 |
| 高频细节 | warping 易糊 | 迭代修正后可接受 | Gram 损失保纹理 |
这张表有一个容易被忽略的结论:三条路线并不是严格替代关系。第一代的可见性图思想、第二代的中间流估计、第三代的注意力匹配,在实践中常常被混合使用。例如部分实用系统会用一个轻量注意力模块先给出匹配先验,再交给光流解码器细化;也有方法在第二代的 IFBlock 里加入 Gram 式纹理损失。理解这三条线的演进逻辑,比记住”谁优于谁”更重要。
遮挡、大运动与尺度:三类失效模式
运动边界:光流不连续处的模糊
光流本质上是一个平滑的位移场,但真实场景中运动边界是不连续的:前景物体和背景在同一图像位置上的位移完全不同。光流网络在训练中倾向于产生”平均”的平滑流,导致物体轮廓附近发生拉伸。表现是插帧后物体边缘有一圈明显的拖影。这类误差在低分辨率或快速运动时尤其明显。
解决办法大致分两类:一类是显式建模不连续,用边缘感知的平滑项或分段光流;另一类是在融合阶段用可见性权重抑制边缘处的错误混合。后者本质上承认”我无法在光流层解决”,转而用权重去掩盖,但代价是掩错了就产生”边缘被切断”的新伪影。
遮挡:可见性权重如何工作
遮挡的核心逻辑是:如果一个像素只在一侧可见,那么它的颜色不应被另一侧污染。用可见性 加权融合时,遮挡区域的 ,权重自动流向可见侧。但这里有一个关键前提:可见性本身也要被估计准确。如果可见性错误地认为某区域两侧都可见,就会把一侧的背景也平均进来,产生鬼影。
可见性估计的困难在于它也是无监督的:模型只看到中间帧真值,看不到”遮挡掩码”的真值。所以可见性只能从中间帧重构误差中反向学出来。这解释了为什么所有可见性图输出都很”软”,很少是干净的 0/1。
大位移:线性组合假设何时失效
第一代的近似式 隐含了”匀速”假设。大位移场景中有两个额外因素破坏它:
- 遮挡随时间变化:大位移通常意味着物体在这段时间内从可见变为遮挡或反之,两端的位移向量在中间时刻已不能同时表达;
- 运动边界附近的多重假设:一个像素在中间时刻可能对应到不同的物体,线性的光流组合只能给出一个折中值。
所以大位移场景下,第一代方法的退化是结构性的,不是参数调优能解决的。这也是为什么实时插帧的实用系统往往先做场景分割或运动分层,对前景与背景分别插帧,再合成。
尺度:高分辨率下的细节保持
插帧在 1080p 以上分辨率时的难点是:光流的误差在像素级被放大。一个 1 像素的光流误差在 480p 上几乎不可见,在 4K 上却足以让细小的边缘模糊。因此工业级插帧系统普遍使用”多尺度估计 + 高分辨率细化”的结构:光流在低分辨率上估计,再上采样后用局部小块修正,最后用原始分辨率做高保真融合。RIFE 的 IFBlock 迭代和 FILM 的权重共享特征提取器,都是在高分辨率上保护细节的手段。
在典型场景里的落点
插帧的架构选择高度依赖它被部署在哪里,而不同场景对”质量、延迟、功耗”的排序完全不同。
视频播放与显示设备。 这是插帧最成熟的落地场景:把 24/30 帧的片源补到 60/120 帧,或为高刷屏幕做运动补偿。这一场景的核心约束是功耗与片内算力:显示芯片上的 NPU 往往只支持非常简单的卷积算子,代价体、大范围匹配与 Transformer 注意力都很难跑起来。RIFE 刻意不用代价体、只用 卷积与反卷积,正是为这一场景设计的——它能在显示设备上以较低功耗实现实时插帧,这也是论文强调”适合资源受限设备”的原因。另外,这一场景天然需要流式处理:播放到哪一对帧就插哪一对,没有回看未来的余地,所以依赖多帧时序的架构在这种场景里反而受限。
影视后期与慢动作制作。 这一场景对质量的要求远高于延迟:离线渲染可以跑几十个 IFBlock 迭代,也可以用更重的特征匹配网络。对大位移、宽遮挡的素材,FILM 类”尺度无关 + Gram 损失”的设计更合适,因为它专门针对大遮挡区域的纹理修补。但代价是训练与推理都更重,且对遮挡区域的”修补”本质上是让网络编造纹理——在影视级别的素材上,这种编造可能以不合物理规律的方式出现(例如背景纹理被重复粘贴),需要人工检查。
实时视频通话与直播。 这一场景对延迟极其敏感,通常只有几毫秒的预算,同时分辨率较低、码率压缩带来的运动模糊严重。插帧在这里的主要作用不是”更流畅”,而是”降低带宽”——发送端降低帧率、接收端插帧补齐。这类系统的关键指标是端到端延迟,因此一般只跑单级轻量网络,光流估计器往往与解码器协同设计。
三维重建、超分与世界模型里的运动对齐。 光流与插帧用到的中间流估计在这里是通用组件:视频超分要沿着帧间运动做对齐,世界模型要把当前状态推进到未来时刻,三维重建要靠运动把多视角观测对齐。这些场景用到的往往是 RAFT 式的迭代光流、或 GMFlow 式的全局运动聚合,而不一定是插帧专用的轻量网络。理解插帧的架构演进,同时也是理解这些系统里”运动从哪来、误差如何累积”的重要途径。
推理账:一次插帧到底花在哪里
对部署者来说,插帧的成本可以拆成三项。
第一项是光流估计的成本。 这一项通常是主要开销。以第一代为例,要估计两段完整光流,需要对两张图都做多次卷积,且有两次(甚至更多)U-Net。以第二代为例,IFNet 的卷积层数显著更少,因此是”实时插帧”的关键。以第三代为例,特征提取器共享权重、多尺度对齐,每个尺度都要计算匹配,成本随尺度数量增长。
第二项是 warping 与融合的成本。 双线性 warping 需要为每个输出像素做一次坐标计算和四次采样,融合再做一次加权。这部分是像素级的粗粒度并行操作,在 GPU 上通常很快,但内存带宽开销与分辨率成正比——4K 插帧时,单次 warp 往返的内存量就不可忽视。
第三项是细化迭代的成本。 RIFE 的 IFBlock 迭代次数越多,光流修正越精细,但延迟线性增加。对实时播放器,往往只跑 1–2 个 IFBlock;对离线渲染,可以跑更多。
工程上有一个常被低估的延迟来源:时间编码 的”复用性”。如果一次请求要把 30fps 提升到 120fps,需要每个间隔插入三帧,即每对端帧跑三次网络。如果网络支持一次输出多个 ,就能共享特征提取的计算,降低总成本;如果网络不能,那三次就是三份完整成本。这是选择插帧架构时需要问的第一个问题:它在一次两帧请求中能不能复用特征。
另一个容易被忽视的细节是帧率与分辨率之间的成本权衡。插帧是”时间轴上的复制”,它不能恢复原视频里不存在的信息——如果原视频在空间上已经糊了,插帧只会让”糊”更连续,不会变清晰。所以插帧系统的输入端是否降分辨率、降多少,会直接决定插帧的输出质量上限。
还有一个成本项与数据格式相关:插帧输入通常以 YUV 的 luma(Y)平面为主。如果只在亮度通道插帧、色度通道做简单复制或上采样,可以大幅削减带宽与算力,但会在快速运动的彩色边缘处出现”色度拖尾”。这一取舍在嵌入式显示设备上非常常见。跨素材对比插帧速度时,必须核对两点——分辨率与是否只插亮度通道,否则”几倍加速”的数字不可比。RIFE 论文本身也在评测中暴露了另一个可比性问题:在 HD 基准上,DAIN、BMBC、DSepconv、CDFI 等方法在 1080p 视频上直接 OOM(显存不足),只有部分方法能跑满全部分辨率。这意味着”速度快若干倍”以及”画质更好”的结论,往往只在双方都能跑起来的子集上成立,选型时应当确认对比口径。
小结
视频插帧的架构演进可以用一条主线概括:从”借通用光流来缝合两张图”,到”训练专用网络直接估计中间运动”,再到”在特征层上绕开显式光流做对齐与合成”。
- 第一代(Super SloMo)确立了基本骨架:双向光流、近似中间流、软可见性与加权融合,四步都可单独诊断,适合理解与实现。
- 第二代(RIFE)把成本压缩到实时级别,用特权蒸馏解决了中间光流无监督的难题,并把粗融合与细化迭代做成网络内部结构。
- 第三代(FILM/EMA-VFI)不再显式输出光流,用多尺度特征对齐、Gram 矩阵损失和帧间注意力解决大位移与纹理保持。
三类失效模式——运动边界模糊、遮挡鬼影、大位移处的线性假设失效——是所有插帧架构共同面临的边界。理解这些失效模式,比记住某个模型的精度排名更有用:它决定了你的插帧系统在面对特定素材时会坏在哪里。光流估计那条演进线(FlowNet 的相关层、PWC-Net 的金字塔、RAFT 的全对相关与迭代、GMFlow 的全局运动聚合)也并非插帧专用,它同时支撑着视频超分、世界模型、三维重建中的运动对齐,理解它的设计动机对后续这些系统同样有帮助。
参考资料
- Super SloMo: High Quality Estimation of Multiple Intermediate Frames for Video Interpolation
- Real-Time Intermediate Flow Estimation for Video Frame Interpolation (RIFE)
- RAFT: Recurrent All-Pairs Field Transforms for Optical Flow
- Learning to Estimate Hidden Motions with Global Motion Aggregation (GMFlow)
- PWC-Net: CNNs for Optical Flow Using Pyramid, Warping, and Cost Volume
- FlowNet: Learning Optical Flow with Convolutional Networks
- FILM: Frame Interpolation for Large Motion
- Extracting Motion and Appearance via Inter-Frame Attention for Efficient Video Frame Interpolation (EMA-VFI)
- X4K1000FPS:高帧率 4K 视频数据集(X-TEST)
- RIFE 官方实现(ECCV 2022)
- RAFT 官方实现
- PWC-Net 官方实现
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



