


图文生视频模型架构入门:一张首帧图如何被「时间化」——潜空间条件注入、时序注意力与运动先验
背景与问题定义:I2V 到底比 T2V 多做了什么
文生视频(Text-to-Video,T2V)模型在 2023 年到 2024 年之间从「几秒的抖动视频」走到了「几十秒的高清片段」。但工业界很快发现,用户真正想用的场景大多不是「给我生成一段符合这句话的视频」,而是「我有一张图,让画面动起来、让相机转起来、让这张产品图开口说话」。这条路线叫图文生视频(Image-to-Video,I2V),输入是一张首帧图像加(可选的)文字描述,输出是以这张图为第一帧、向后延续若干秒的视频。
从使用者角度看这只是一次输入形态的扩展,从模型角度看它却改变了整个条件系统的结构。T2V 的条件只有文本,文本是一个全局的、语义层级的描述,模型可以自由决定画面里有什么、布局如何、色彩如何。而 I2V 的首帧图像是逐像素的、带具体身份信息的条件:它规定了第一帧里每个物体长什么样、在哪、什么颜色、什么纹理,还隐含了光照方向、相机内参、景深等大量未被文字写出的信息。模型的任务从「生成一个符合描述的视频」变成了「生成一个在时间维度上延续给定状态、同时遵守文字要求的视频」。
这两件事的难度差在哪里:
- 身份一致性。T2V 只需要整段视频内部自洽,第一帧和最后一帧不必对应任何外部事物。I2V 要求第一帧和用户输入逐像素对齐,后续帧里同一个物体要保持同样的纹理、同样的脸、同样的文字排版。
- 运动合理性。首帧图像本身不携带运动信息。一片海浪的静止照片可以意味着浪正在拍岸,也可以意味着水面正在回退;用户希望它朝哪个方向动,既写在文字里,也隐含在图像构图里。模型必须从「一张图 + 一句话」里推断出运动方向和幅度。
- 不泄漏未来。首帧是完整信息,模型很容易学到「把首帧当成完整条件,后面随便补一段」,于是出现常见失败:后面帧逐渐与首帧脱节,或者干脆整段视频几乎静止(把输入图像原封不动复制 T 次)。I2V 训练的难点很大一部分在于抑制这两种退化解。
先看一个典型的 I2V 系统实际在做什么。下面这张图来自 DynamiCrafter(2023 年 10 月 arXiv 首发,香港中文大学、腾讯 AI Lab 与北京大学联合完成),它的输入是「一张图像 + 一句运动描述」,输出是一段短视频,整条流水线把所有部件都放在同一个潜空间里:
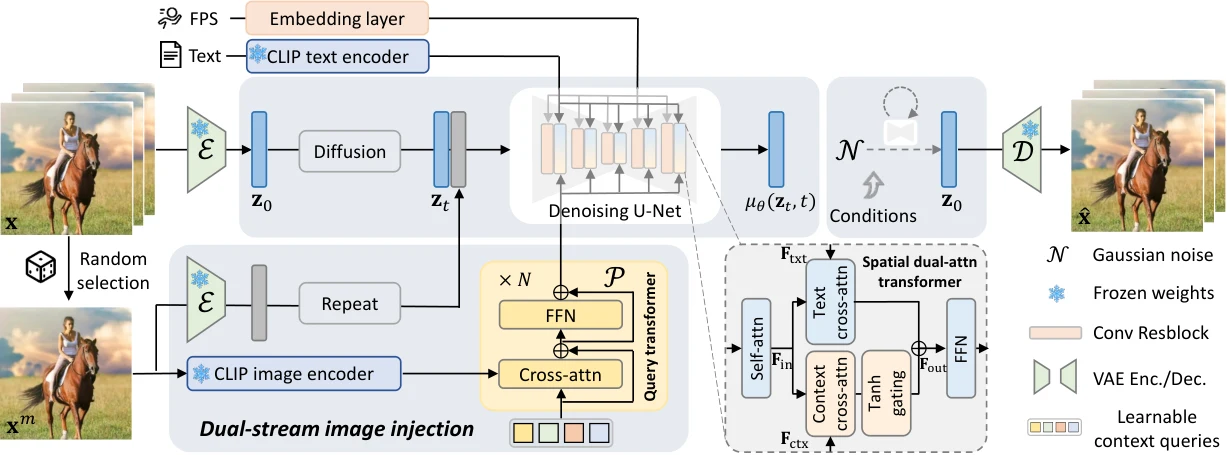
图里能读出几件关键的事:图像先经 CLIP image encoder 编码成上下文向量,再通过一个叫 dual-stream image injection 的投影(双流投影)注入预训练的 T2V 主干——第一阶段冻结主干权重,只训练条件接口,第二阶段才放开空间层;主干本身的 QKV 投影层带一个「学习得到的上下文查询」(learnable context queries),让注入的图像信息能参与注意力;整个去噪发生在 VAE 编码后的潜空间里,最后再经 VAE 解码器回到像素。这套「冻结主干 + 学习条件接口」的思路,是 2023 年下半年多个开源 I2V 工作的共同出发点,只是各家的条件走法不同。
在具体路线之前,先把两个基础概念讲清楚,后面的模块全部建立在这两个概念上。
前置:3D VAE 与时空注意力——视频为什么必须先在「压缩后的时间」上建模
为什么不能逐帧独立处理
如果把一段 16 帧、分辨率 576×1024 的视频当作 16 张独立图像,用图像扩散模型逐帧生成,会出现两个无法回避的问题:
- 帧间不连续。每帧独立去噪,噪声种子不同,同一物体在相邻帧里就会在纹理上逐帧漂移,形成闪烁(flickering)。即便用「后一帧以前一帧为条件」的方法串起来,误差也会累积成漂移。
- 成本。直接在高分辨率像素上做扩散,单帧的计算量已经很大,视频再乘一个 T。工业界普遍的做法是先用一个自编码器把像素压到潜空间,再在潜空间里扩散。
对图像来说,潜空间自编码器(如 SD 系列用的 VAE)把 512×512×3 的图像压成 64×64×4 的潜变量,空间上做了 8 倍下采样。视频版本的 VAE 在此基础上还要压缩时间,常见做法是沿时间轴做 4 倍下采样:16 帧 → 4 个潜帧。于是 576×1024×16×3 的视频被压成形状约为 的潜张量(通道 16、潜帧 4、高 72、宽 128),token 数下降两个量级。这一点与图像扩散的推理结构是同一套账,可参考 扩散模型从零讲起(四):潜空间扩散与条件生成。
3D VAE 的压缩率设计是一个真实的工程权衡。时间压缩比太小,后续扩散要处理的帧数量太多,注意力成本呈平方增长;时间压缩比太大,快速运动的细节(比如飞鸟扇翅膀的每一拍)会在编码时被抹平,去噪网络无从恢复。CogVideoX(2024 年 8 月,Zhipu AI 等)用的 3D 因果 VAE 在空间上压缩 8 倍、时间上压缩 4 倍,并且用因果卷积保证解码时任意一个时间块只依赖它之前的块,这样才可以流式输出。这条约束对 I2V 特别重要:I2V 往往要求首帧严格还原,如果 3D VAE 的时间感受野是双向的,首帧潜变量会混入后续帧的信息,解码时首帧就容易发生细微改动;因果 3D VAE 则能保证潜帧 只由原视频前若干帧决定。
时空注意力的三种排布
潜张量压好之后,去噪网络要在上面同时建模空间结构与时间结构。主流做法是在堆叠的 Transformer 或 U-Net 块之间插入注意力,按「哪些 token 之间允许互相看」分成三种基本排布。下面这张图来自 2024 年 5 月的《Video Diffusion Models: A Survey》(arXiv:2405.03150),把三种排布画在一张网格上:每个小格是一帧内的图像块(image patches),整列是时间方向上的帧序列。
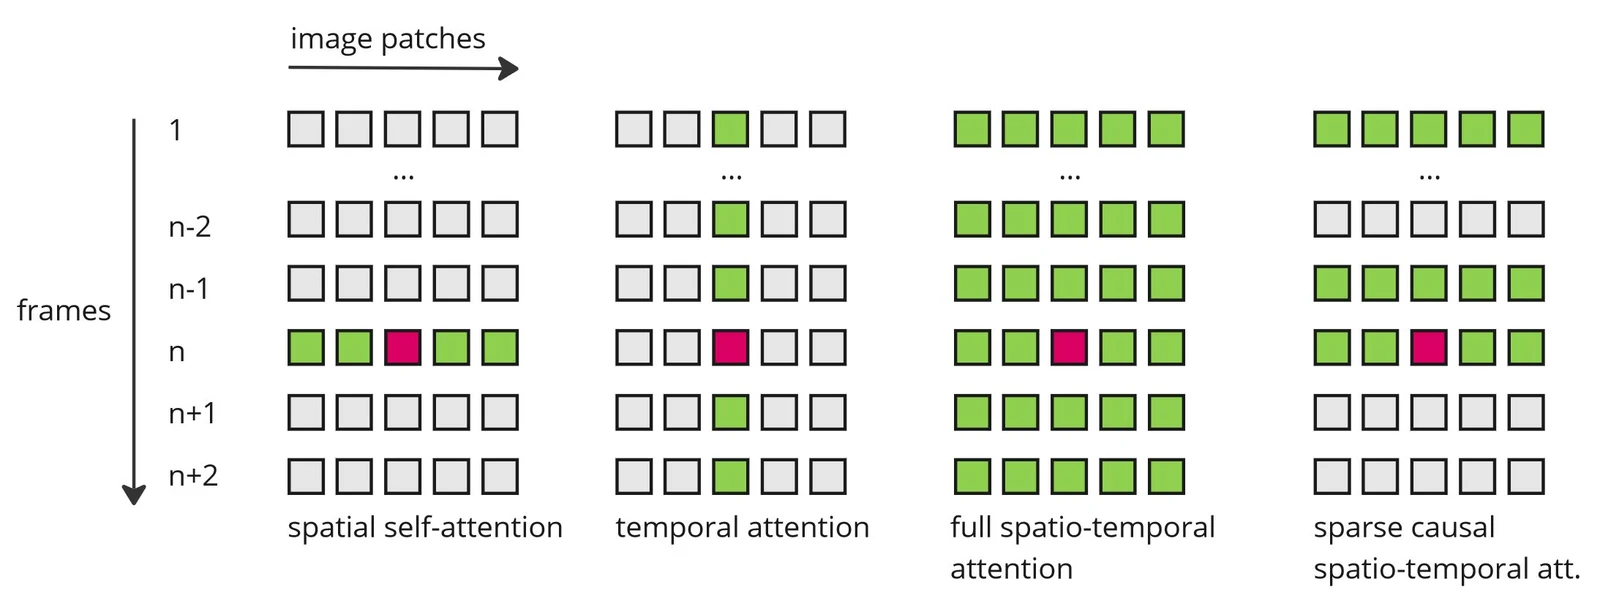
- 空间自注意力(spatial self-attention):只在同一帧内部,让图像块之间互相看。每一帧独立建模空间结构,完全不跨帧。
- 时间注意力(temporal attention):只在同一位置、跨帧之间看。同一个图像块位置(比如第 3 行第 5 列那块「山脊」)在 n-2、n-1、n、n+1、n+2 各帧的表示互相对照。它把「这个位置随时间怎么变化」单独建模出来。
- 完全时空注意力(full spatio-temporal attention):所有帧的所有块在一个注意力里互相看。表达力最强,成本也最高。注意力矩阵规模是 , 是一帧的 token 数, 是潜帧数,任何一边加倍,成本变四倍。
- 稀疏因果时空注意力(sparse causal attention):只在「当前帧看当前帧 + 前几帧的若干窗口」这种受限连通图上做注意力,常用于需要长视频流式生成的场景。
Video Diffusion Models(VDM,2022 年 4 月的 Ho 等人的工作,arXiv:2204.03458)的经典设计是:在 U-Net 的空间块里保持图像扩散的 2D 卷积和空间注意力不变,另加一个时间块(3D 卷积 + 1D 时间注意力)。这样「空间怎么画」的能力和「时间怎么动」的能力可以分开演化,且图像预训练权重能直接复用。AnimateDiff(2023 年 7 月,arXiv:2307.04725)走得更彻底:冻结所有图像层,只在其中插入一个用短视频训练得到的 motion module(运动模块),motion module 内全是 1D 的时间自注意力加上时间正弦位置编码。于是「画什么」由冻结的图像模型决定,「怎么动」由运动模块决定,二者通过时间位置编码对齐。这是后面讲「运动先验」时要反复用到的结构。
有了潜空间表征和时空注意力的概念,可以开始定义 I2V 的形式化问题。
I2V 的形式化定义:条件、目标与退化解
设首帧图像为 ,文本描述为 ,目标视频为 ( 帧,第 0 帧固定为 )。经编码器 得到潜变量序列:
去噪网络的参数为 ,I2V 的训练目标仍然是扩散模型的标准(条件)去噪损失,区别只是条件集合从 扩展到 :
其中 是对整段潜变量按同一条噪声时间表 加噪后的结果, 是标准高斯噪声。这里隐含了一个约定:整段视频共享同一个时间步 。几乎所有主流的 I2V 模型都遵守这个约定,原因有两个:一是整段视频在同一个噪声水平上去噪,时间一致性最容易保证;二是采样器(DDIM、DPM-Solver、流匹配 Euler 等)都是按「整段张量同步走一步」设计的,逐帧不同步会破坏采样器推导出来的误差累积性质。代价则是首帧条件的可读性与当前噪声水平绑定: 很大时首帧潜变量几乎被噪声淹没, 很小时又几乎等于干净图像,同一份条件在不同步上的「信息量」完全不同。拼接路线用噪声增强来缓解这个错位,语义流路线则靠 CLIP 语义向量本身对噪声不敏感这一点绕开——语义向量是独立于扩散步计算的,不会随 变化。
更根本的是退化解。给定首帧 ,最简单满足目标的解是「输出 」,损失会非常低。任何以 MSE 为核心的训练目标都天然偏向平滑、低动的解。工业界用来对抗这个问题的有几种手段:
- 条件注入方式上避免「干净且可复制」的通道。如果把干净的 直接以「每帧拼接在通道上」的方式喂给网络,网络很容易学会「抄通道」,得到的模型几乎不动。DynamiCrafter 的做法是从结构上切断复制源:改用 CLIP 编码的语义向量 + 交叉注意力,网络拿得到「这张图是什么」,但拿不到逐像素的复制源。拼接路线则退一步,用噪声增强让条件「不可直接复制」。
- 训练数据构造上控制退化程度。从真实视频里截取一段,把第一帧作为条件、把后续帧作为目标,模型会学到真实运动分布;但若训练集里存在大量几乎静止的片段,模型就倾向于生成静止结果。Stable Video Diffusion(SVD,2023 年 11 月,Stability AI)花了大量精力在视频数据清洗上(运动幅度、美学、字幕/水印检测、切分),并且用高 FPS/低 FPS 采样等技巧控制运动分布。
- 多任务混合。同一套权重同时用 T2V 数据(无首帧条件)和 I2V 数据训练,让模型保留运动生成的先验;纯 I2V 数据训练出来的模型容易在「只有文字要求的运动幅度」上塌缩。
- 首帧条件以加噪方式注入而不是干净注入。这是很多现代 I2V 模型的做法:不是把干净的 直接给网络,而是给 加上一条独立噪声(或与当前步相关的噪声),网络必须从中「读出来」而不是「抄出来」。
理解了这几个难点,就能看懂后面几条架构路线各自是在哪个环节上做的取舍。按条件进入主干的方式划分,工业界与学术界的 I2V 模型基本落在三条路线上:
- 潜空间拼接:把首帧潜变量和噪声潜变量在通道上拼起来。SVD 用「复制 + 噪声增强」隐式表达「哪里已知」,Wan-I2V 与 CogVideoX 的 I2V 版本再加一条二值掩码把「这一帧是给定的、不要去噪」写成网络可读的显式信号。
- 语义流 + 细节流:用 CLIP 把图像压成语义向量经交叉注意力注入,DynamiCrafter 更进一步把完整图像拼进每一帧的噪声作为细节补充。VideoCrafter1 的 I2V 版本是这条路线里只有语义流的早期形态(它的结构确实给出一条「视觉细节引导」路径,但论文正文没有展开)。
- 冻结主干加运动模块:图像部分保持冻结的 T2I 权重,只训练时间方向的运动模块,用时间位置编码把「静止图像」和「它在时间轴上的位置」区分开。AnimateDiff 是这条路线,它严格说只能做「给定若干帧的动画」,但它的运动模块设计被后来的大量 I2V 工作借用。
下面按这三条路线逐条拆。先看第一条——它在今天的主流闭源/开源模型里占比最高,也是结构上最容易理解的一条。
路线一:潜空间拼接与掩码——SVD 与 Wan-I2V 的「给定帧」条件
3D U-Net 的通道是怎么被首帧扩充的
Stable Video Diffusion(SVD)于 2023 年 11 月由 Stability AI 发布,它走的是「先在 Stable Diffusion 2.1 的 2D U-Net 里插入时间层,改造成视频 U-Net,再微调成 I2V 模型」的路线。它的 I2V 模型接受的输入不是「噪声潜变量 + 文本」,而是「噪声潜变量 + 加噪的首帧潜变量」,文本条件则被 CLIP 图像嵌入整体替换。
先看通道记账。原本 SD 2.1 的 U-Net 输入是 4 通道潜变量。做图像修复(inpainting)时,输入变成 9 通道:4 通道加噪潜变量 + 4 通道原图潜变量 + 1 通道掩码。SVD 的 I2V 把这个做法搬到时间轴上,但做了一步简化:它把首帧潜变量沿时间轴直接复制成与目标视频同长度的序列,形状为 ,与噪声输入通道拼接,U-Net 输入从 4 通道变成 8 通道。原文明说「不使用任何掩码技术,直接把帧沿时间轴复制」。
这个「复制、不加掩码」的做法乍看很粗糙,但配上一个关键细节就成立了:噪声增强。给网络干净的首帧潜变量会诱发「抄通道」——网络只要把首帧通道复制到输出通道,损失就下降。SVD 因此在训练时先给首帧加一点强度 的高斯噪声,再送进 SD 2.1 的 VAE 编码器,取编码器输出分布的均值,才是真正拼进 U-Net 的那份条件。于是网络看到的首帧是「有噪的」,必须结合当前扩散步 判断「这一帧近似已知、但需要去噪」,不能无脑复制。用公式描述就是
这里 表示通道拼接, 表示把单帧潜变量沿时间轴复制 份, 取 VAE 编码器分布的均值, 是只在训练时加入的增强噪声。由于没有掩码通道,网络完全靠「这份条件被噪声污染过」这一事实来区分「哪里已知、哪里待生成」——已知性不再是一个显式的二值信号,而是一个关于噪声水平的连续判断。
顺带说明,SVD 论文里的掩码拼接出现在另一个任务上:帧插值模型。它把左右两张条件帧分别编码,空位用一个可学习的掩码嵌入 填充,并额外拼一条二值掩码指明哪两帧是给定的,U-Net 输入是 的三段结构。也就是说,「掩码条件」在 SVD 体系里是插值模型的结构,「无掩码复制」才是它 I2V 模型的结构——这两者常被混为一谈,实际是两个不同任务的输入约定。
Wan-I2V:为什么要把首帧「单独压缩」
Wan(阿里,2025 年 3 月,arXiv:2503.20314)的 I2V 模型在同样的「通道拼接」框架下把条件做得更显式:它把首帧之外的帧在像素空间填零,和首帧一起送进 Wan-VAE 编码成条件潜变量 ;再构造一条与目标视频潜帧数等长的二值掩码 ,给定帧位置为 1、待生成位置为 0;最后把噪声潜变量、条件潜变量、掩码三者沿通道拼接后送入 DiT。相比 SVD 的「复制 + 噪声增强」,这套做法用一条显式的掩码通道把「哪里已知」变成网络可以查表读取的信息,代价是输入多了一份与视频等长的掩码张量,通道数从 8 涨到 33(16 通道噪声 + 16 通道条件 + 1 通道掩码,掩码按 VAE 时间压缩比在时间轴上重排)。
在这套「拼接 + 掩码」框架下,Wan 做了两处值得细看的改动,直接决定了它的 1.3B 小模型能在 480p 分辨率下把显存压到 8 GB 量级。
第一处是 Wan-VAE 对首帧的空间压缩处理。Wan-VAE 是一个参数量只有 127M 的 3D 因果 VAE,空间压缩 8 倍、时间压缩 4 倍。它沿用了 MAGVIT-v2 的一个技巧:首帧只做空间压缩,不做时间压缩。原因是首帧本身没有时间信息,如果时间压缩把首帧和后面零帧混在一起编码,首帧的潜变量就会被稀释;更糟的是,如果 VAE 的时间卷积是非因果的,首帧的潜变量会混入后续帧的信息,解码时首帧就不是用户给的图了。
第二处是 掩码在时间轴上的重排。Wan-VAE 的时间压缩比为 4,所以目标视频的潜帧数 ,而条件潜变量因为包含首帧那一个「单独压缩」的帧,形状上需要时间方向对齐。Wan 把掩码 在时间方向上也按 4 倍重排成 的形状(16 是 Wan-VAE 的潜通道数),这样掩码、条件潜变量、噪声潜变量三者在通道上可以无损拼接。这步重排看起来只是形状对齐,实际上承载了一件事:告诉网络「潜帧 里的每个时间槽位,哪些是从首帧来的,哪些是要生成的」。Wan 原文对这一点写得很直白:the mask mechanism enables the model to selectively focus on input frame。
Wan 在数据侧还做了一件事,和 I2V 的退化解问题完全对应:训练前用 SigLIP 特征计算首帧与其余帧平均特征的余弦相似度,只保留超过阈值的视频。原文给出的理由是「首帧和视频内容差异太大时模型学不到稳定的图像驱动生成」。这条筛选的作用是让训练数据的「首帧—后续帧」关系更接近推理时的分布:用户输入的图通常就是视频内容的一部分,模型不应该在这种「图与视频不同对象」的数据上学 I2V。
下面是 Wan-I2V 的框架示意,噪声潜变量、条件潜变量和重排后的掩码三者在通道维度拼接后一起进入 DiT 主干:
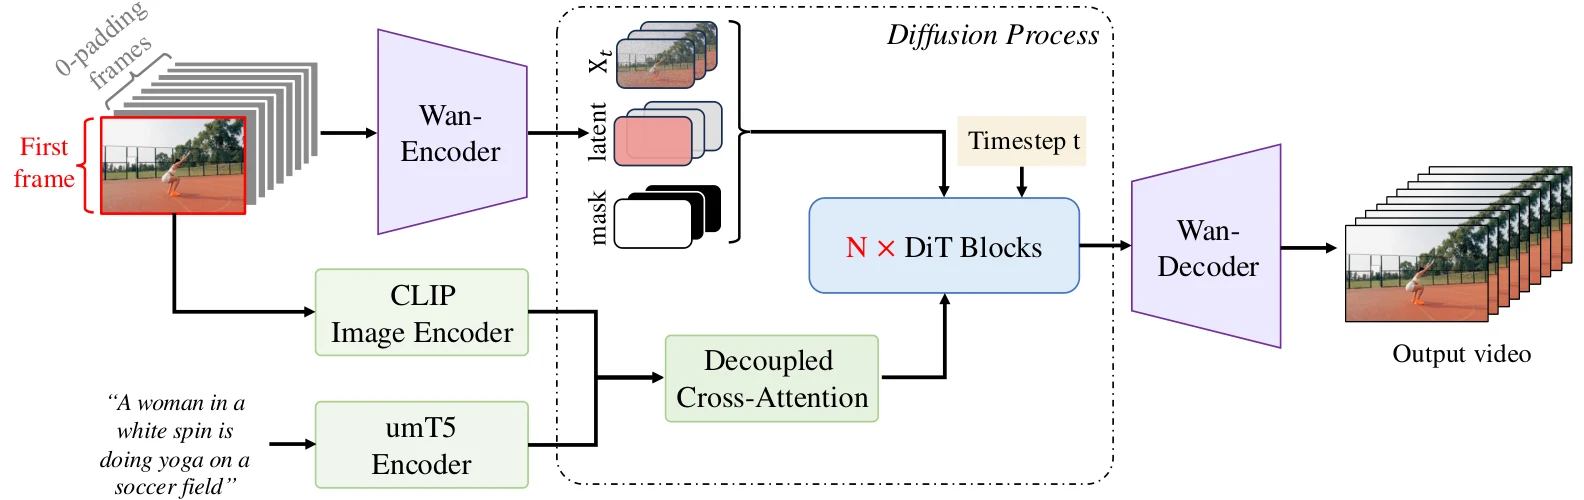
图中能看出「拼接」这条约束在 DiT 架构里没有被绕开:DiT 的输入投影层在第一层就把拼接后的多通道输入投影成一个 token 序列,之后的 transformer 块完全不知道哪一通道是条件。所以「哪些位置是给定的」完全靠掩码通道在投影后的 token 里留下痕迹,主干本身只看到一堆混在一起的通道。这是这条路线与后面「语义流」路线最大的区别:条件不经过语义抽象,而是原样进入 token 序列。
掩码路线的得与失
把这条路线相对「语义流」路线的收益和代价对比一下:
- 首帧逐像素保真。条件潜变量来自首帧的真实潜变量,只要 VAE 编码—解码一致,输出首帧就与用户给的图对齐,不需要额外的「首帧还原损失」。这对产品级 I2V 很关键,用户看到的首帧最好就是自己上传的图。Wan-VAE 把首帧单独做空间压缩,正是为了把这种保真度在压缩这一步先守住。
- 训练数据要求高。拼接路线的训练目标就是「把拼接的部分搬运 + 在空位上生成后续」,网络很容易把整个任务塌缩成「复制首帧到每一帧」。SVD 用噪声增强压这个倾向,Wan 用 SigLIP 相似度筛选压这个倾向,但两者都只是在降低概率,不是消除。
- 推理侧灵活性受掩码设计约束。拼接路线的一个天然好处是掩码本身可编程:想做首尾帧插值,就把掩码首帧和末帧都置 1;想做关键帧插值,就置多个 1。代价是网络必须在训练时见过这类掩码分布,否则推理时新插入的「中间掩码」会落在分布外。
- 通道数变多带来的计算与显存成本。输入通道从 4 变成 8(SVD)或 33(Wan),第一层投影的参数量、显存占用和首个 kernel 的计算量都随之上升。Wan 在空间上采样层额外减半了一次输入特征通道,把推理显存压了 33%,本质上也是在给这套「三路拼接」付账。
把拼接路线的代价记下来,再看第二条路线——它试图把「抄通道」的倾向从结构上切断。
路线二:语义流 + 细节流——DynamiCrafter 的双流注入
两条流各自解决什么问题
拼接路线把「首帧长什么样」原样交给网络,网络必须自己从像素里抽象出「这是什么物体、应该怎么动」。语义流路线反过来:先把图像抽象成一个语义向量,让网络在语义层理解它,再从细节通道把外观补回来。DynamiCrafter(2023 年 10 月首发,2023 年 11 月更新 v2,香港中文大学、腾讯 AI Lab、北京大学)把这条路线拆成了两条互补的流:
- 文本对齐的上下文表示(text-aligned context representation):用 CLIP 图像编码器提取图像特征,经过一个可学习的 query transformer 转换成与文本嵌入同构的「上下文 token」,再通过交叉注意力进入去噪 U-Net。它解决的是「理解这张图是什么、应该产生什么样的动态」。
- 视觉细节引导(visual detail guidance,VDG):把完整图像经 VAE 编码后拼到每一帧的初始噪声上,直接给网络提供外观细节。它解决的是「语义向量丢掉的纹理、颜色、文字排版」。
原文对这条双流设计的论证很值得读:CLIP 图像编码器的目标是让图像特征与文本对齐,它在语义层面很强,但在细节层面是有损的——它与语言对齐得越好,那些「与语言无关」的信息丢得越多,比如一块特定纹理、一段小字、一个边缘的精确形状。只用语义流,生成的视频会「看起来像」输入图但不像「同一张图」;只用细节流,网络没有语义层面的运动先验,动作会退化成局部抖动。两条流互补,一条负责「动得合理」,一条负责「长得一样」。
上下文流的内部结构
上下文流不是简单地把 CLIP 的全局 token 塞进交叉注意力。DynamiCrafter 用的是 CLIP ViT 最后一层的全部视觉 token,而不是那一个 [CLS] 全局 token。原因是全局 token 已经把整张图压缩成一个语义摘要,空间布局和局部内容都被抹平了;全 token 保留了 patch 级的位置信息。全 token 的维度与文本嵌入不一致,直接喂进去 U-Net 无法消化,所以要过一个轻量 query transformer:用一组可学习的查询向量去「问」这些视觉 token,输出固定长度(论文中设为 16)的上下文 token 序列,维度对齐到文本嵌入所在的 1024 维空间。
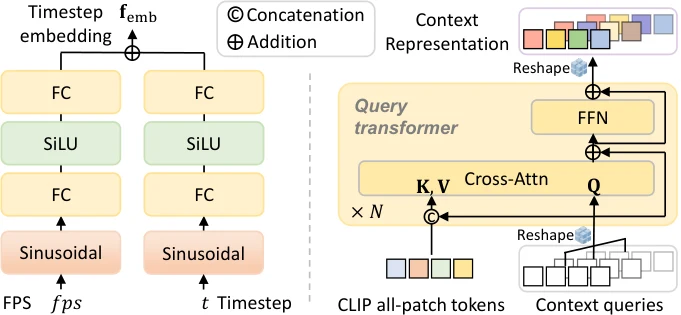
图中上半部分是上下文流:CLIP 全 patch token 作为 key/value,可学习的 context queries 作为 query,经过若干层交叉注意力后得到 16 个上下文 token;下半部分是 FPS 条件与时间步的嵌入路径,正弦嵌入经两层 FC 与 SiLU 映射成一个学习到的嵌入,再与时间步嵌入相加后调制中间特征。两条路径汇合的层级不同:上下文 token 在 U-Net 的交叉注意力处注入,FPS 嵌入则加在卷积特征上做整体调制。
这里有一个容易忽略的设计:上下文 token 与文本 token 各自走一次交叉注意力,再经过一个逐层可学习的门控 加权合并。设文本上下文为 、图像上下文为 ,U-Net 某一层的中间特征为 ,则
其中 , 是注意力头维度; 是第 层的新增可学习标量,论文把它称为自适应门控。这个式子是对「两路交叉注意力 + 门控合并」的等价写法,论文没有逐项展开每个投影矩阵,但门控按层学习、图像与文本各走一次注意力这两点与原文描述一致。论文把 称为自适应门控,并把它画成逐层的学习曲线——它让网络自己决定「哪一层应该更多看图像、哪一层应该更多看文本」。
值得一提的对照是 VideoCrafter1 的做法。它的 I2V 分支(2023 年 10 月,腾讯 AI Lab)用「双交叉注意力层」把文本与图像嵌入并行注入 U-Net,两者共用同一组 query,因此每层只新增两组投影矩阵(key 与 value),参数量很省。它的 image embedding 同样取自 CLIP ViT 最后一层的全 patch token,而不是全局 token——原文图 5 并排展示了两种取法的结果:(b) 只用全局语义 token 时,生成的女孩发型与输入图不一致;(c) 用全 patch token 时,发型细节被保留下来。这一个对比就说明了「为什么上下文流必须保留空间信息」,也是后来 DynamiCrafter 用 query transformer 而非单个全局 token 的直接动机。
VideoCrafter1 与 DynamiCrafter 的差别在于融合权重是否可调。VideoCrafter1 的双交叉注意力是固定结构,图像与文本的注入强度只能通过推理时的引导尺度影响;DynamiCrafter 加上逐层门控 后,融合权重成为可学习参数,网络可以针对不同深度的层分配不同强度。这个改动很小,但它让「图像条件注入多深」变成可以被数据回答的问题——也就是前面那张逐层 学习曲线的来源。
下面的图展示了训练后学到的 在 U-Net 各层的分布,以及人工调节中间层 时的效果对比。左图横轴是 U-Net 层号(1 到 16),纵轴是学到的系数值;可以看到两端层(靠近输入和输出)的系数明显高于中间层:
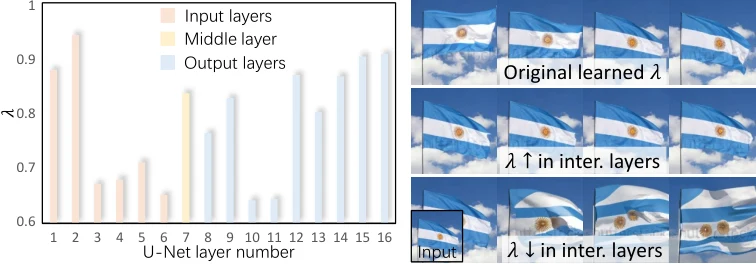
这张图是整篇文章里信息密度最高的一张,它把「图像条件该注入多深」这个设计问题直接量化了。原文的解读是:U-Net 靠近两端的层更多与外观相关,中间层更多与物体形状、姿态相关;因此学到的 在两端更高,说明网络希望图像信息主要影响外观。进一步的人工实验更说明问题:调大中间层的 ,跨帧运动会被压制;调小中间层的 ,物体的形状保真度会下降。换句话说,中间层的图像条件同时承担了「保持形状」和「允许运动」两个互相拉扯的职责,这个平衡点不是拍脑袋定的,是训练学出来的。
这段结论对理解 I2V 的本质很有帮助:I2V 不是「在 T2V 上多加一个条件」那么简单,它要求网络在同一组权重里同时维持「首帧的外观」和「后续帧的自由度」。语义流把这两件事分到了不同深度:浅层给外观、深层给语义,中间层做权衡。
细节流与两阶段训练
细节流的实现比语义流朴素:把输入图像经 VAE 编码成潜变量,沿时间轴复制到每一帧的位置,与每一帧的初始噪声在通道上拼接。注意这里是「与每一帧的噪声拼接」,不是「只在第一帧拼接」——这是它和 SVD 的差别之一。这样做的效果是让网络在生成每一帧时都能看到原图,而不仅仅是第一帧。
两阶段训练是这条路线能收敛的关键,也是论文里少数直接讲「为什么这样训」的地方:
- 第一阶段:冻结 T2V 主干,只训练上下文表示网络(query transformer 与门控)。先让「语义条件」与冻结主干的接口对齐。原文观察到,如果一上来就同时加细节流和语义流,收敛会明显变慢,学到的只是粗粒度的上下文条件。
- 第二阶段:在上下文流可用之后,再加入细节流,同时联合微调上下文网络与 T2V 主干的空间层(时间层保持冻结或小学习率)。原文对比了「全模型微调」的基线,结论是全模型微调会让模型不稳定、容易崩坏,破坏 T2V 原有的时间先验。
这里的设计动机可以这样理解:T2V 主干的时间层里存的是「视频应该怎么动」的先验,这是最贵的资产。I2V 微调要借用它,就不能让 I2V 的数据把这份先验冲掉。冻结时间层、只动空间层与条件接口,等于把「运动先验」保护起来,只改「外观如何被条件约束」这一部分。
训练时随机选帧:一个反直觉但关键的细节
DynamiCrafter 在训练时不是固定用视频的第一帧作条件,而是随机选视频中的某一帧作为条件图像,并要求模型生成整段视频。推理时,输入图像可以出现在生成序列的任意位置(论文的表述是 the still image can appear in the arbitrary location)。
这个设计直接来自对退化解的观察。论文做了一个「固定用第一帧作条件」的基线(1st frame cond.),结果在两个指标上都更差(FVD 309.23 对 234.66,PIC 0.5673 对 0.5803),而且生成视频出现「内容突变」:第一帧和输入图一致,后面几帧突然跳变。原文的推测很直接:固定首帧作条件时,模型会学到一条捷径——把拼接进来的图像直接映射到第一帧输出,而忽略其余帧。随机选帧让这条捷径失效:条件帧可能出现在序列中间,模型必须真正学会「以这张图为锚点,向前向后延展时间」。
这与拼接路线的「噪声增强」是同一个问题的两种解法:都是为了防止网络把条件当成可复制的输出。区别在于 DynamiCrafter 是在训练数据的位置上做随机化,SVD 是在条件的噪声水平上做随机化。
消融数据说明了什么
论文的消融表给出了几个可以直接引用的数字(UCF-101 与 MSR-VTT 零样本评测,16 帧,FVD 越低越好、PIC 越高越好):
| 变体 | FVD(UCF-101) | PIC(UCF-101) | 结论 |
|---|---|---|---|
| 完整方法 | 234.66 | 0.5803 | 基线 |
| 去掉上下文流(w/o ctx) | 372.80 | 0.4916 | 语义理解缺失,时间一致性明显变差 |
| 去掉细节流(w/o VDG) | 159.24 | 0.6945 | 指标反而更好,但出现形状畸变、运动幅度不足 |
| 去掉门控 | 241.38 | 0.5708 | 轻微下降,视频出现抖动与不自然运动 |
| 只用 CLIP 全局 token | 286.84 | 0.5717 | 缺少空间细节,只能做到语义相似 |
| 全模型微调(Ft. ent.) | 364.11 | 0.5564 | 模型不稳定,易崩坏,破坏时间先验 |
| 固定首帧作条件 | 309.23 | 0.5673 | 出现「内容突变」捷径 |
(数据来自 DynamiCrafter 论文表 3,UCF-101 零样本设置。)
这张表里最值得注意的一行是「去掉细节流」:FVD 和 PIC 都变好了。这不是说细节流没用,而是说明指标与人的感知不是一回事。FVD 衡量的是分布距离,PIC 衡量的是感知相似度,两者都不直接惩罚「形状畸变」——而形状畸变恰恰是去掉细节流后最明显的问题。原文对此的表述是:去掉 VDG 会带来严重的形状畸变和有限的运动幅度。这条现象在讲 I2V 评测时经常被引用:不能只看 FVD,因为「更平滑、更保守」的生成往往在分布指标上更好看。
VideoCrafter1 的 I2V 分支:最早的「首帧条件 + 语义注入」组合
VideoCrafter1 是这条路线更早的形态,也是第一个开源的通用 I2V 基础模型之一。它的做法是:在 T2V 模型的基础上加一个 image conditional branch,图像嵌入与文本嵌入分别经双交叉注意力注入同一个 U-Net,同时把首帧作为「frame condition」与噪声潜变量做逐元素相加(element-wise addition),而不是通道拼接。
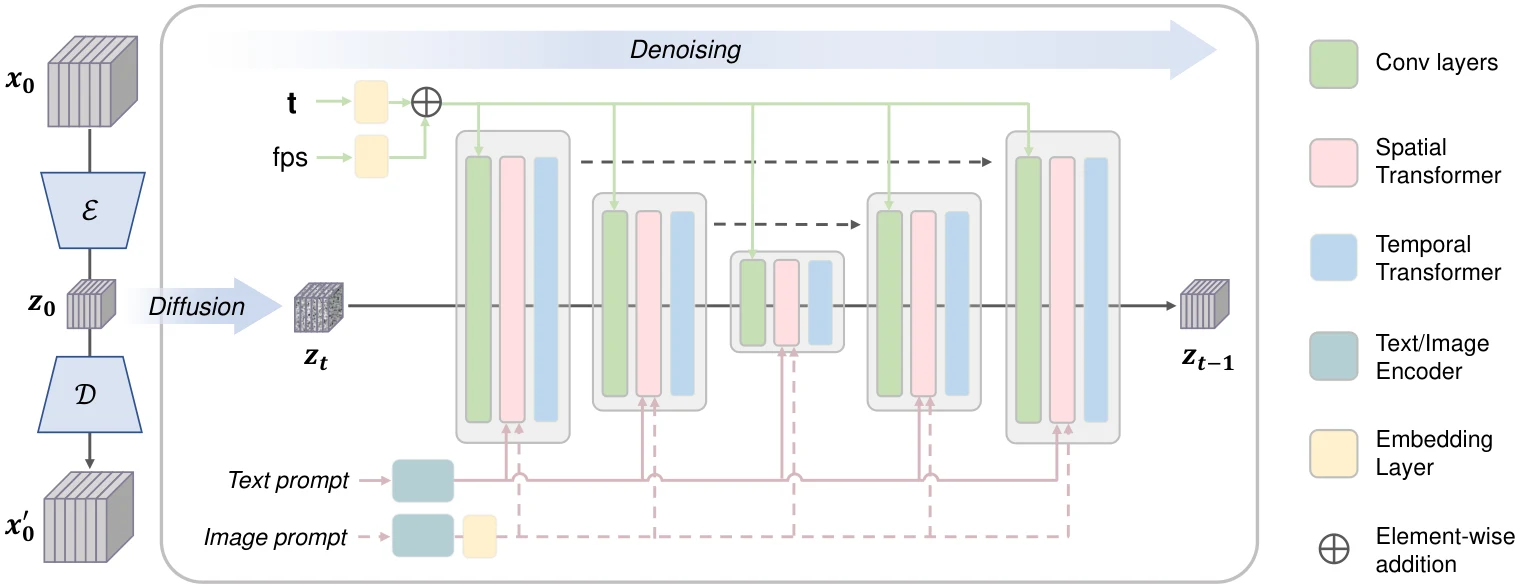
这张图把 VideoCrafter1 的骨架画得很清楚:去噪 U-Net 由「空间 Transformer」与「时间 Transformer」交替堆叠,空间 Transformer 里做自注意力与交叉注意力(文本与图像嵌入都从这里进入),时间 Transformer 只沿帧轴做注意力;右侧的文本/图像编码器分别输出两路嵌入,经 embedding layer 送进空间 Transformer;首帧条件则作为一路额外的输入,与噪声潜变量相加。
「相加」而不是「拼接」是一个值得注意的选择:相加不增加通道数,U-Net 第一层不用改,改动最小;但它也意味着条件与噪声在同一个通道空间里混合,网络必须学会「把首帧信息从混合信号里分离出来」。通道拼接把条件放在独立通道上,分离负担更轻,但需要改第一层权重。「相加」的另一面是首帧的保真度更依赖后续微调,VideoCrafter1 自己在论文里也承认,I2V 模型的首帧虽然几乎与输入图一致,但后续帧的运动幅度有限,且对笑脸等细节的处理仍有失败案例。
VideoCrafter1 的 I2V 模型输出 1024×576、约 2 秒的片段。论文对这条路线局限的总结相当坦率:时长、分辨率、运动质量都还有很大提升空间,延长时长需要更多帧的训练加插值模型,提升分辨率需要空间上采样模块。这段话基本预言了后面两年 I2V 的演进方向:先在「首帧保真」上做扎实,再去解决「更长、更清晰、更可控」。
到这里,第二条路线的骨架就完整了:语义流负责「怎么动」,细节流负责「长什么样」,门控负责「在哪一层注入多少」,随机选帧负责「不要抄首帧」。这套结构在 2023 年底是开源 I2V 里保真度最好的一批,但它也有明确的代价:交叉注意力带来的额外计算、两阶段训练的复杂度、以及对 T2V 主干结构的强依赖(主干必须有交叉注意力层,纯 DiT 的 adaLN 条件结构就不适用)。
路线三:冻结主干加运动模块——把「时间」做成可插拔的层
AnimateDiff 的运动模块
AnimateDiff(2023 年 7 月,arXiv:2307.04725)严格说不是 I2V 模型,它做的是「给一个个性化的 T2I 模型加上运动能力」。但它的结构选择解释了为什么后来很多 I2V 模型长成「冻结空间层 + 训练时间层」的样子,值得单独拆。
它的做法是三步:
- 取一个已经预训练好的 T2I 模型(论文里是 Stable Diffusion 1.5 系列的个性化模型),冻结它的全部权重。
- 在 U-Net 的每个空间块之后插入一个 motion module。motion module 里只有时间方向的注意力:把同一位置、不同帧的 token 沿时间轴排成一个序列,做 1D 自注意力,再经过一个时间方向的 FFN。它不看空间邻域,只看「同一个位置随时间怎么变」。
- 用短视频数据单独训练 motion module,训练时图像层完全不动。
这个设计的核心是时间位置编码。motion module 在每个 token 上加一个正弦时间位置编码,告诉注意力「这是第几帧」。原文把这一点写成硬性要求:正弦位置编码是必需的,否则模块根本不知道帧的顺序。除了位置编码,还有两个「让插拔不伤主干」的工程细节:一是时间 Transformer 的输出投影层零初始化并加残差连接,训练开始时 motion module 是一个恒等映射,不会把冻结主干的输出搞坏;二是 motion module 的输入先做空间维合并到 batch 轴,只在时间轴这一个维度上做注意力,所以它完全不知道空间位置,只负责「同一个位置怎么随时间变」。这个设计的好处是 motion module 与图像模型的空间结构解耦,可以直接插到任何一个同源的个性化 T2I 模型里。
为什么这条路线在 I2V 里重要?因为它给出了「最小改动」的范式:不动空间权重,只加一层时间注意力。SVD 的 I2V 模型本质上也是这个思路的进化版——SD 2.1 的空间层基本保留,时间层新加,然后整体微调成 I2V。区别在于 SVD 需要整段微调才能接受首帧条件,AnimateDiff 则把「条件」留在了文本层,没有首帧条件通路。
帧条件与插值:把「给定帧」扩展到多个位置
一旦接受「时间层是可插拔的」这个视角,把首帧条件扩展成「任意给定帧」就很自然:掩码里给多个位置置 1 即可。SVD 的帧插值模型正是这么做的:把左右两帧分别编码,空位用可学习的掩码嵌入填充,额外拼一条二值掩码,模型学习在两张给定帧之间预测三帧,等效于把帧率提高四倍。原文提到这个模型只需要非常少的迭代就能收敛(论文的表述是 a very small number of iterations suffices),原因是主干的时间先验已经很强,插值只是把「给定帧」从一帧扩展到两帧。
这个扩展也暴露了拼接路线的一个边界:给定帧的位置必须在训练分布内。SVD 的插值模型训练时固定是「左、右」两帧,推理时如果只给中间一帧,模型没有见过这种掩码分布,输出会退化。后来的生成式插值工作(Generative Inbetweening,2024 年 8 月,arXiv:2408.15239)专门处理这个问题:它的出发点是「I2V 模型只会向前推演,首尾帧插值要求同时向两端对齐」。做法分两步——先用轻量微调让 3D-U-Net 也接受末帧条件(把视频翻转后训练,得到 backward motion 网络),再在采样时把「前向去噪」与「反向去噪」的预测做一致性融合。这套改动只动一小部分参数,却把 I2V 的「单向延展」变成了「双向约束」,也说明拼接路线的条件通路是可改造的:真正决定能力的不是通道数,而是训练时见过哪些掩码分布。
三条路线的对照
把三条路线放在一张表里,各自的适用场景就清楚了:
| 维度 | 潜空间拼接(SVD / Wan) | 语义流 + 细节流(DynamiCrafter) | 冻结主干 + 运动模块(AnimateDiff) |
|---|---|---|---|
| 首帧保真 | 最高,逐像素对齐 | 较高,但依赖 VAE 与细节流 | 无首帧条件(需额外改造) |
| 运动先验来源 | 整段视频预训练的 T2V 主干 | 冻结 T2V 主干 + 上下文条件 | 冻结 T2I + 单独训练的时间层 |
| 训练成本 | 中,需微调主干 | 高,两阶段 + 双流 | 低,只训 motion module |
| 条件位置灵活性 | 高,掩码可编程 | 低,条件帧位置靠随机训练覆盖 | 中,靠掩码扩展 |
| 主要风险 | 抄首帧、通道成本 | 形状畸变、交叉注意力开销 | 长度外推、无首帧约束 |
三条路线不是互斥的:Wan-I2V 的 DiT 主干里也有文本交叉注意力,只是首帧条件走拼接;DynamiCrafter 的细节流本质也是拼接,只是拼接位置在每一帧而不是只复制首帧。真正决定模型行为的,是「首帧信息以什么形式、在哪个深度、以多大的强度进入主干」这三个问题的答案。
还有一个架构分水岭值得单独点出:上面前两条路线都长在 U-Net 主干上(SVD、DynamiCrafter、VideoCrafter1 都是 SD 2.1 系的 U-Net),原因是 U-Net 有交叉注意力层,语义条件可以直接插进去。2024 年下半年以后,主流视频模型陆续换成 DiT 主干(Wan、CogVideoX、HunyuanVideo 等),交叉注意力不再是标配,文本条件改为 adaLN 调制或保留少量交叉注意力块。这直接改变了语义路线的实现方式:DiT 里没有那么多「层」可以挂门控,图像条件更多退回拼接 + 掩码这条更朴素的路线上。Wan-I2V 选择掩码拼接,是因为它复用同源的 T2V 主干:拼接只改输入投影层,条件接口的改动面最小,训练时可以整套权重一起微调而不需要两阶段。
条件强度:FPS 嵌入、运动幅度与双尺度 CFG
到了推理侧,I2V 模型还有几个「旋钮」决定一段视频动多少、首帧像不像。理解这些旋钮的设计,比背模型名更实用。
FPS 嵌入与运动幅度
DynamiCrafter 除了图像上下文和文本,还额外接受一个帧率条件。训练时它从 5 到 30 的区间里随机采样帧率,推理时这个值就是一个可调的旋钮:调高「FPS」,运动幅度变大、变化更剧烈;调低则接近缓慢的推镜或呼吸感。这看起来有点反直觉——为什么帧率能控制运动幅度?原因在于训练数据的构造:同一段真实视频如果按高帧率采样 16 帧,覆盖的时间跨度就短,画面变化幅度小;按低帧率采样 16 帧,覆盖的时间跨度长,画面变化大。模型通过帧率这个标量把「16 帧覆盖多长的时间」与「画面应该变化多少」绑定在一起,于是推理时给一个高的帧率值,模型就按「短时间内应该有较大变化」来生成。
这与 Stable Video Diffusion 的 micro conditioning 是同一类设计。SVD 的公开权重接受了两个微条件:帧率与 motion bucket id(运动桶编号),后者由训练时计算的光流幅度分桶而来,值越高代表该片段运动越剧烈。生成式插值论文在附录 A.2 里专门分析了这个参数:更高取值带来越动态的视频,反之越安静。插值任务比 I2V 更受限,因为末帧给了额外约束,但运动桶仍然显著影响最终效果。
与标量旋钮互补的是「模式旋钮」。SVD 还训练了三种相机运动 LoRA(横向移动、缩放、静止),只改时间注意力块里的低秩旁路,用同一张首帧就能得到完全不同的镜头行为:
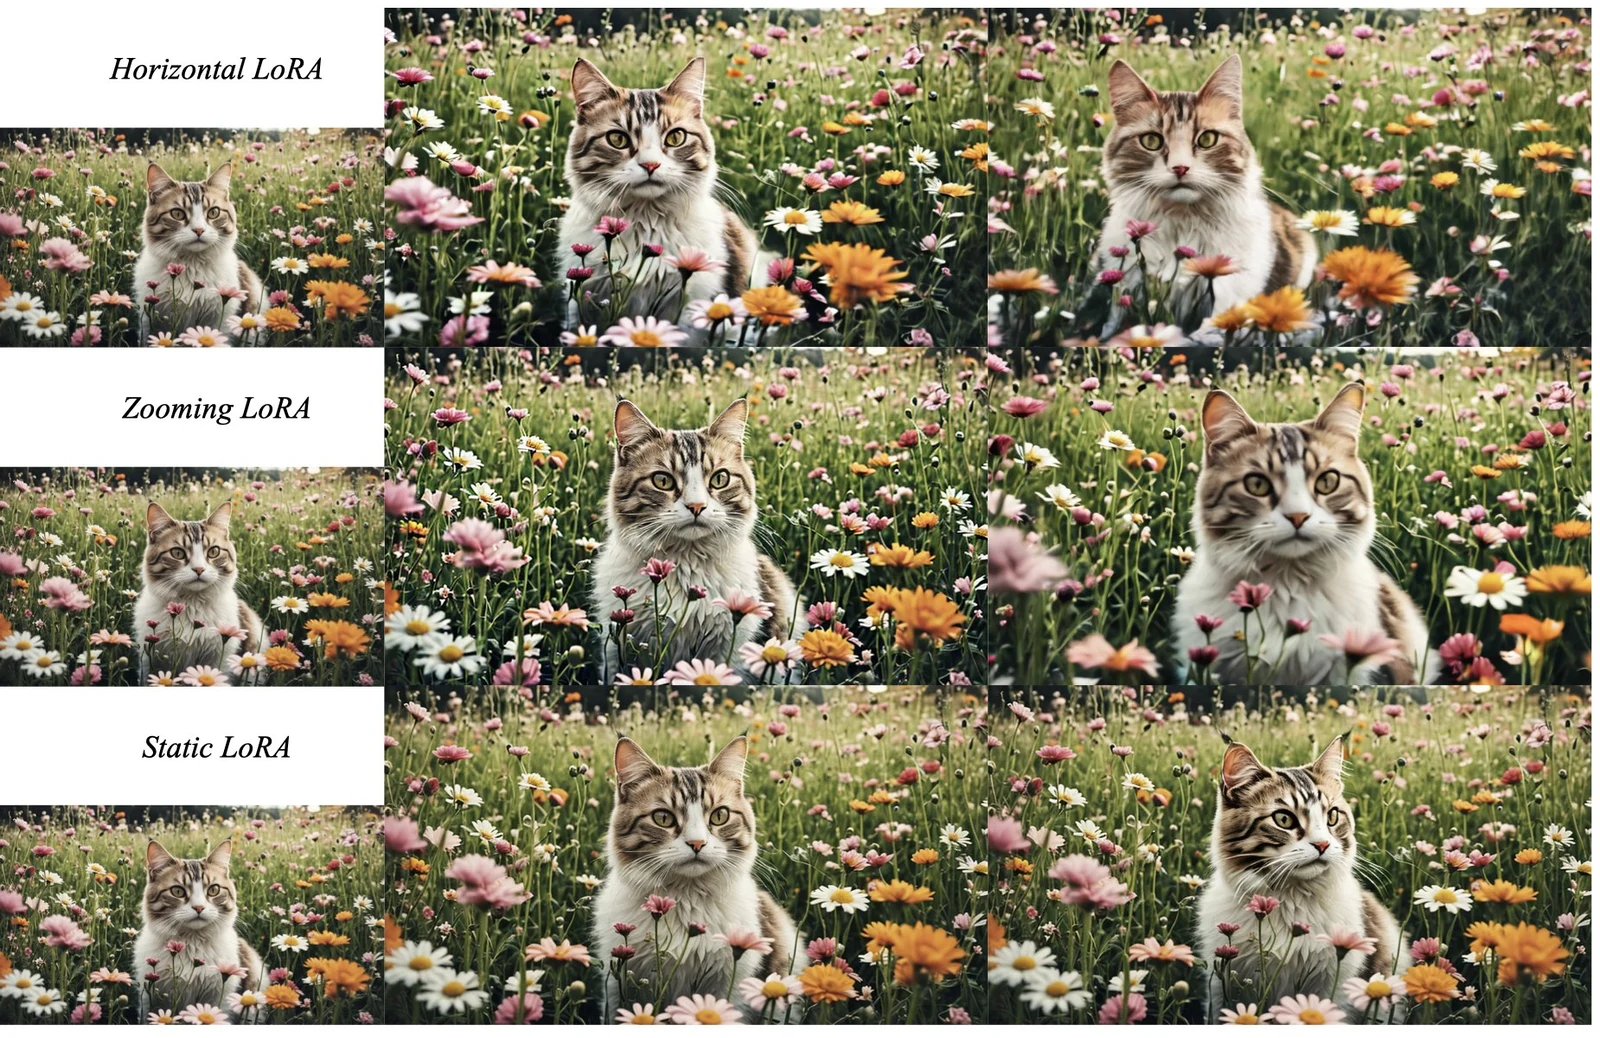
图中左侧是同一张输入图,三行分别对应横向移动、缩放与静止三种 LoRA 的输出。这张图说明了「运动」在 I2V 里可以进一步分解成物体运动与相机运动两类:前者由主干的时间先验生成,后者可以用极小的适配参数单独学习。这也是当前产品里「运镜控制」的原型——不让用户用文字描述镜头,而是直接给一个镜头模式。
这类「运动量条件」的本质,是把训练数据里运动幅度的分布压成一个可查询的标量,暴露给推理侧当作旋钮。它解决了一个 I2V 的核心矛盾:同一个首帧可以对应多种运动强度,用户不总是想要最大的运动。没有这个旋钮,模型只能给一个「平均运动量」的输出,无法区分「让水面轻轻流动」和「让海浪拍岸」。
双尺度 CFG:图像与文本分开引导
DynamiCrafter 的推理使用多条件 classifier-free guidance(CFG),把两个条件分开引导:
符号含义: 是空条件(对应 CFG 训练时以一定概率丢弃条件得到的「无条件」分支); 与 分别是图像与文本的引导尺度。第一项是无条件预测,第二项沿「图像条件」方向放大,第三项沿「文本条件」方向放大。
把引导拆成两项而不是一个,是因为两个条件的作用互相拉扯:图像条件过强会让画面「锁死在首帧附近」、运动被压制;文本条件过强会让画面远离输入图像、去追文字描述。两个尺度分开调节,用户可以在「更像首帧」与「更听文字」之间取一个点。这比单尺度 CFG 多一次前向,是 I2V 服务里一个真实存在的推理成本项。
Stable Video Diffusion 则从另一个角度处理同一问题:它用的是逐帧线性递增的引导尺度。原文明说常规 CFG 会出现「引导不足则与条件帧不一致,引导过强则过饱和」的问题,因此改成沿帧轴从低到高线性递增:越靠后的帧,引导越强。直觉是首帧附近本来就有强条件,过强引导会锁死;越往后越依赖文本与运动先验,需要更强引导来防止漂移。
长视频与漂移:把 I2V 当自回归用
目前主流 I2V 模型的单次生成长度通常在 2 到 5 秒量级(十几到二十几帧,具体取决于帧率)。要生成更长的视频,最常见的做法是自回归延展:生成第一段,取最后若干帧作为下一段的首帧条件,继续生成。这个做法会引入「漂移」(drifting):每一段都以「上一段的生成结果」为条件,误差逐段累积,画面逐渐失真、运动逐渐失控、语义逐渐偏离。
针对漂移的处理手段分几类,可以按「在哪一层干预」来看:
- 噪声层面:修改噪声调度,降低后段对过去帧的依赖强度。
- 锚定层面:用原始输入图或参考帧作为锚点,定期把某一段的条件强制拉回原始图像。
- 采样层面:修改采样策略,比如对给定帧位置使用受控噪声,让模型在每一步「重新确认」锚点。
- 训练层面:SVI(Stable Video Infinity,2025 年 10 月,EPFL VITA)提出的 error-recycling fine-tuning 指出核心问题不只是误差累积,而是「训练时模型看到的是干净数据,测试时它自己生成的输出是有误差的」。它的做法是把模型自生成的误差「回收」进训练监督里:用模型自己的错误输出当输入、以真实数据为监督,让模型学会识别并修正自己的错误。这等于把自回归推理时的分布搬进训练,缩小训练与推理的差距。
这条线说明 I2V 的「一张图变一段视频」在工程上已经不止是一次前向:真实产品里往往是「I2V 模型 + 自回归延展 + 漂移修正」的组合,每一段都依赖上一段的画面,延迟是累积的。
推理账:一张图变成一段视频要花什么
前面的结构差异最终都会落到推理成本上。这里把 I2V 的一次生成拆成几段开销,和图像扩散的账对比着看。
图像扩散里,单次前向的计算量大致正比于 token 数 (空间块)与注意力成本 (空间注意力)。视频扩散里,token 数从 变成 ,时空注意力(若走完全时空注意力)成本变成 。如果把帧轴和空间都按 倍缩放,token 数按 增长,完全时空注意力的成本按 增长——这就是为什么大多数工业模型宁可拆成「空间注意力 + 时间注意力」,把成本压回到「空间 乘 帧 + 时间 乘 位置」。
I2V 额外的开销主要在这几处:
- VAE 编解码。3D VAE 要把整段视频编码一次、解码一次;Wan-VAE 用因果结构和 feature cache 把长视频的编码成本压下来,但这一步仍然存在,且首帧「单独压缩」意味着不能简单地把整段视频当成一个张量批量处理。
- 条件分支的额外前向。DynamiCrafter 这类用双尺度 CFG 的模型,每步采样需要三次前向(无条件、仅图像条件、图像加文本条件),比标准 CFG 的两次多一次;如果两个条件各自都做独立的「有条件/无条件」对比,前向次数还会继续增加。步数乘以多出来的这几倍前向,是 I2V 服务延迟里最直接的一块。
- 条件编码的固定开销。首帧要用 VAE(拼接路线)或 CLIP(语义路线)编码一次;Wan 的 I2V 还要把填零帧和首帧一起过 VAE。这部分可以缓存,但在高并发服务里仍然是首 token 延迟的一部分。
- 重复生成与延长。用户要更长的视频,就得自回归多跑几轮;每一段都要重新跑完整的采样,且后段以生成结果为条件,没法跳步。
- 步数与分辨率。采样步数决定了前向总数;分辨率决定了每步的 token 数与注意力成本。在 720p 以上、几十帧的配置里,单次 I2V 生成的显存很容易踩到上限,于是「分段生成 + 拼接」成为主流工程手段。
把这套账与图像扩散的推理账对比可以看得更清楚:视频的「时间」这一维并不是免费的。它是 token 数的乘子、注意力成本的放大器,也是 I2V 里「条件在哪一帧、条件怎样传递到后续帧」这一切设计问题的根源。图像扩散服务里的批处理、KV 缓存、特征缓存等手段,在视频里需要针对「时间轴」重新设计——例如跨帧的特征复用、对首帧条件的缓存、以及分段生成时的条件帧复用,这些内容在 扩散模型从零讲起(五):视频扩散 与 扩散模型从零讲起(八):推理加速工程 里都有更系统的拆解。
局限与仍在演进的方向
I2V 的几条基础路线各自都有明确的边界:
- 拼接路线的形状—运动权衡。掩码把「哪里已知」说得清清楚楚,但它不告诉网络「该动多少」。拼接路线里运动幅度很大程度上依赖训练数据分布与 CFG 尺度,结构上没有一个显式的运动条件。Wan-I2V 通过数据筛选压住「首帧与视频不一致」的样本,但这也意味着模型在「首帧与后续内容差异很大」的输入上表现会受限。
- 语义流路线的形状畸变风险。DynamiCrafter 自己的消融显示,去掉细节流后 FVD 变好但形状畸变严重;反过来,细节流过强也会压制运动(与门控 的人工实验一致)。这条路线把两件事分到不同流、不同层,但它们的平衡点依赖训练,难以在推理时精确控制。
- 多帧条件与插值。一旦给定帧的位置与数量变化,模型就需要见过对应的掩码分布。SVD 的插值模型只支持「左右两帧」,后续工作(如 Generative Inbetweening)通过轻量微调加双向采样扩展了这一能力,但这也说明「条件位置」的泛化不是免费的。
- 长视频与漂移。自回归延展的误差累积是结构性问题,现有方法(噪声修改、锚定、采样修正、误差回收训练)都是分别从不同层面缓解,还没有一套被普遍接受的统一方案。
- 一致性与物理合理性。首帧给定了场景,但后续帧里物体的形变、遮挡关系、光照变化是否合理,仍然是 I2V 的难点。DynamiCrafter 原文在失败案例里明确列出了人脸畸变与语义理解失败。
- 条件维度单一。上面三条路线讨论的都是「给一帧」。一旦引入骨架、音频、深度、轨迹等额外条件,I2V 就变成了多条件生成问题:条件之间可能冲突(比如骨架要求手抬起来,首帧里手却垂着),需要额外的对齐机制。姿态驱动的人体图像动画就是这条路的典型代表,其架构与三条件(首帧、骨架、文本)的融合方式可参考 人体图像动画架构拆解。
从这些边界回看三条路线,可以发现它们解决的是不同层次的子问题:拼接路线解决「首帧如何逐像素保真」,语义流路线解决「首帧如何被理解成可运动的语义」,运动模块路线解决「时间能力如何与空间能力解耦」。真实的系统往往是组合而非单选:Wan-I2V 在拼接之上保留了文本交叉注意力;DynamiCrafter 的细节流本质也是拼接,只是每一帧都拼上完整图像而不是只复制首帧;SVD 的运动模块思想则被大量后续模型继承为「时间层单独初始化、单独调学习率」。把这三件事拆开看,比记住某个模型属于哪一类更有用。
小结
I2V 的形式化问题可以归纳成一句话:在「整段视频共享同一个扩散步 」的约定下,把一张逐像素的具体图像,以某种形式注入到一个已经具备运动先验的视频主干中,并让网络在「保持首帧」与「自由运动」之间找到平衡。围绕这句话,工业界形成了三条基本路线:
- 潜空间拼接(SVD、Wan-I2V):首帧潜变量直接与噪声潜变量拼接,用噪声增强(SVD)或显式掩码(Wan)防止抄首帧;首帧保真度最高,代价是训练数据要求与通道成本。
- 语义流 + 细节流(DynamiCrafter、VideoCrafter1 I2V):CLIP 语义经可学习 query transformer 与门控注入交叉注意力,细节流补外观;对 T2V 主干的依赖强,需要两阶段训练。
- 冻结主干 + 运动模块(AnimateDiff 及其衍生):时间层可插拔,空间权重不变;训练成本最低,但首帧条件需要额外改造。
推理侧的旋钮(FPS 嵌入、运动桶、双尺度 CFG、逐帧递增引导)都指向同一个事实:I2V 的一个首帧对应的是一个运动幅度分布,而不是单一答案;能不能让用户把「动多少」变成可调的量,是 I2V 从研究模型变成产品能力的关键一步。
参考资料
- DynamiCrafter: Animating Open-domain Images with Video Diffusion Priors(Xing 等,2023 年 10 月首发,香港中文大学、腾讯 AI Lab、北京大学)
- Stable Video Diffusion: Scaling Latent Video Diffusion Models to Large Datasets(Blattmann 等,Stability AI,2023 年 11 月)
- Wan: Open and Advanced Large-Scale Video Generative Models(阿里 Wan 团队,2025 年 3 月)
- VideoCrafter1: Open Diffusion Models for High-Quality Video Generation(Chen 等,腾讯 AI Lab,2023 年 10 月)
- AnimateDiff: Animate Your Personalized Text-to-Image Diffusion Models without Specific Tuning(Guo 等,2023 年 7 月)
- Generative Inbetweening: Adapting Image-to-Video Models for Keyframe Interpolation(Wang 等,华盛顿大学、Google DeepMind、UC Berkeley,2024 年 8 月首发)
- Stable Video Infinity: Infinite-Length Video Generation with Error Recycling(Li 等,EPFL VITA,2025 年 10 月)
- Video Diffusion Models: A Survey(视频扩散架构与时空注意力的分类综述,2024 年 5 月)
- Video Diffusion Models(Ho 等,2022 年 4 月)
- CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer(Zhipu AI 等,2024 年 8 月)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



