


文生动作生成模型架构入门:扩散直接在动作空间去噪,还是离散 token 掩码补全
多模态生成模型这几年主要在三条模态轴上铺开:图像、视频、声音。文本驱动的人体动作(text-to-motion)属于”看得见但不在屏幕上”的那一类:模型输出的不是像素,而是若干帧的人体关节旋转、位置和速度,后面再由渲染器、游戏引擎或机器人播放出来。动画制作、游戏 NPC 动画、虚拟主播、运动合成、人形机器人动作库都依赖这条链路,而它的基础架构和图像生成几乎完全同构——这也是把它作为多模态入门章节的理由:同样的扩散、同样的量化、同样的潜空间,只是”数据的形状”从二维网格换成了时间序列上的关节。
本文只讲基础:三类工业界主流的动作生成架构如何把文本变成一段动作,各自的核心模块是什么、条件从哪里进入、生成过程要迭代多少步、推理时每一步在算什么。至于动作数据如何表示、如何清洗、如何训练,不在本文重点内,只在必要处用一句话交代。
阅读路线按”生成决策发生在哪里”来组织:先看最早把扩散用于动作生成的 MotionDiffuse(连续动作空间去噪),再看把扩散搬进潜空间的 MLD,最后看把动作切成 token 后用掩码并行生成的 MoMask。三者分别对应”直接在数据空间生成""压缩后生成""离散化后生成”三种思路,和图像/视频生成里的三条路线一一对应。
扩散侧的基础机制(DDPM 的前向/反向链、CFG、潜空间扩散)在本站 扩散模型从零讲起(一):从 DDPM 的加噪/去噪到 DiT 与 Flow Matching 与 扩散模型从零讲起(四):潜空间扩散与条件生成 已有系统展开,本文不再重复推导,只保留与动作数据形态相关的差异。
先说问题:一段动作到底是什么数据
要把文本变成动作,首先要明确”动作”在模型里是什么。主流做法沿用 HumanML3D 一类数据集定义的动作表示:每一帧包含
- 22 个 SMPL 关节的根相对 3D 旋转,用旋转矩阵或 6D 旋转表示展开;
- 根关节的世界坐标位置与线速度;
- 以及各关节的位置或速度特征、左右脚触地标签等。
把这些分量拼起来,一帧的特征向量典型维度是 263 维;一段 6 秒、20 fps 的动作大约 120 帧,也就是 的矩阵。本文沿用记号:动作序列 , 为帧数, 为每帧特征维度。
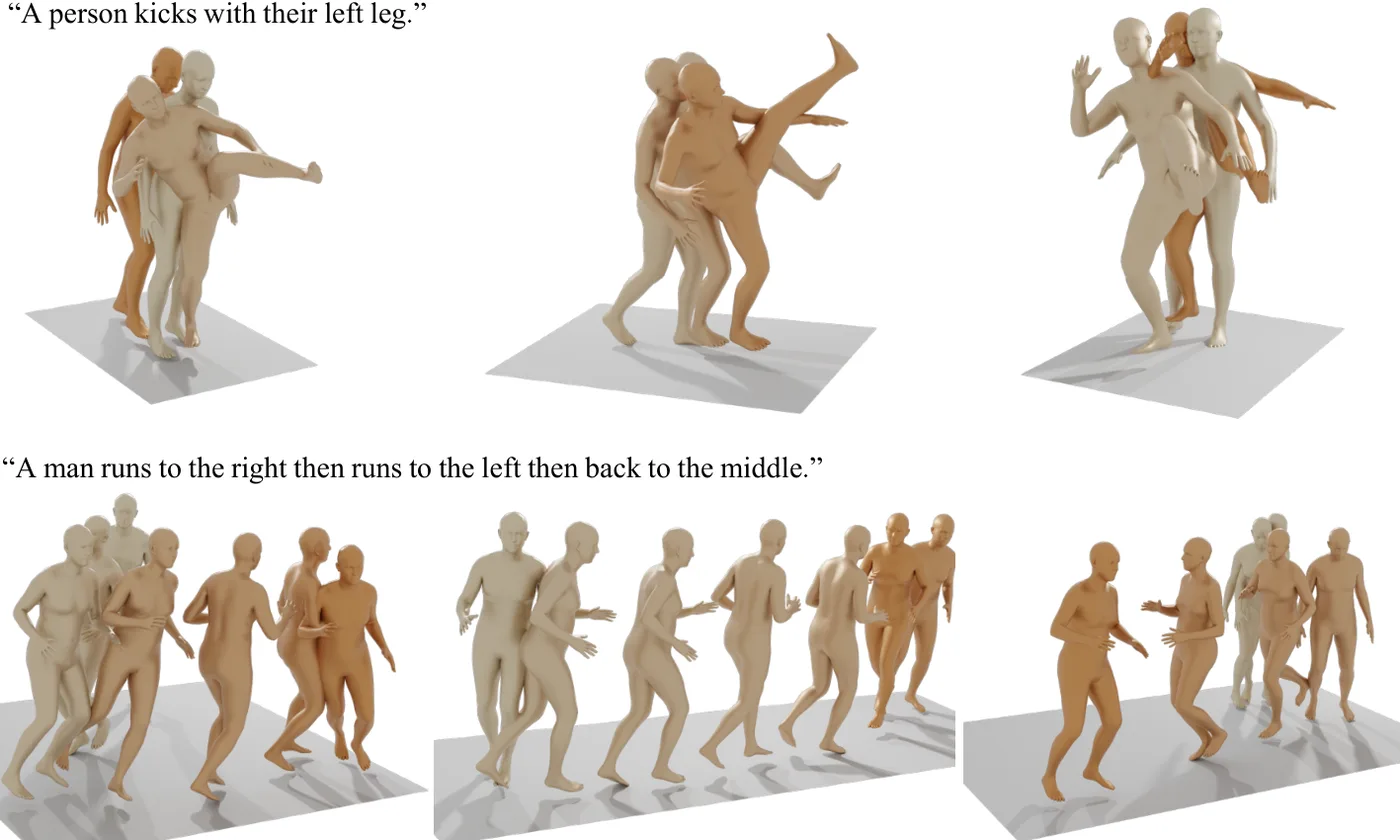
上图是 MDM 论文中对多个文本生成动作的可视化(来源:MDM 论文 arXiv:2209.14916)。可以看到同一句话在不同采样下会生成不同的动作走向——这正是这类模型”一对多”的性质:文本只约束语义方向,具体轨迹由采样决定,多个动作都能”符合描述”。
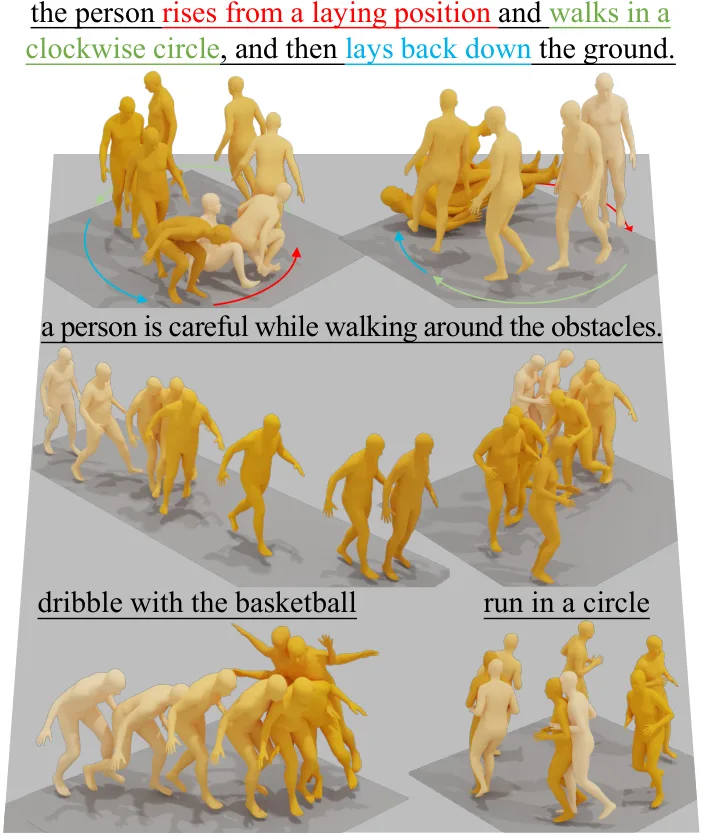
上图是 MLD 论文首页的示例(来源:MLD 论文 arXiv:2212.04048),展示”一句话生成一段动作”的效果:绕障碍行走、运球、投篮这类动作都由文本驱动。图中的深色轨迹是根关节在地面上的运动路径——这个根轨迹在模型里只是一个 2 维或 3 维的数值序列,但决定了一个动作”在空间里怎么走”,是后文讲”根速度约束”和”拼接时朝向对齐”时绕不开的部分。
动作生成和视频生成很容易被混为一谈,但两者的输出层完全不同:视频模型输出的是像素帧,动作模型输出的是骨骼参数。像素输出可以直接观看,但难以精确控制、难以重定向到另一个角色;骨骼参数不可直接观看,却可以被游戏引擎驱动任意角色、被物理引擎执行、被动作编辑工具修改。工业管线里两者常常串联:文生动作模型产出骨骼动画,渲染器再把它变成画面。理解这个分工,才能理解为什么动作模型执着于”根速度""脚触地”这类像素模型根本不关心的量——它们是骨骼动画在引擎里播放时是否可信的直接决定因素。
这个数据形态和图像有一个关键差别:帧与帧之间存在强时间结构。每一帧的关节必须与前后帧连续,根速度必须与位置变化一致,脚触地标签必须与脚掌高度一致。因此生成模型不能把 120 帧当 120 个独立样本去画,而必须建模整段序列的联合分布。这一点直接决定了架构里的注意力形态、噪声注入方式、以及能不能像图像那样”逐像素”生成。
第一类架构:直接在动作空间去噪
MotionDiffuse:第一条能用的条件扩散管线
最早把扩散模型用于文本驱动动作生成的工作,是南洋理工大学 S-Lab 与商汤团队 2022 年 8 月发布的 MotionDiffuse(arXiv:2208.15001),作者 Mingyuan Zhang、Zhongang Cai 等人。它提出的动机很明确:此前的文本驱动动作生成(T2M 一类方法)是”一句文本 → 一段动作”的确定性映射,同一句话每次生成同一个动作,而且只能对整段动作做控制;扩散模型可以借助随机采样给出多样结果,并且能在去噪过程中对任意子序列施加不同文本。
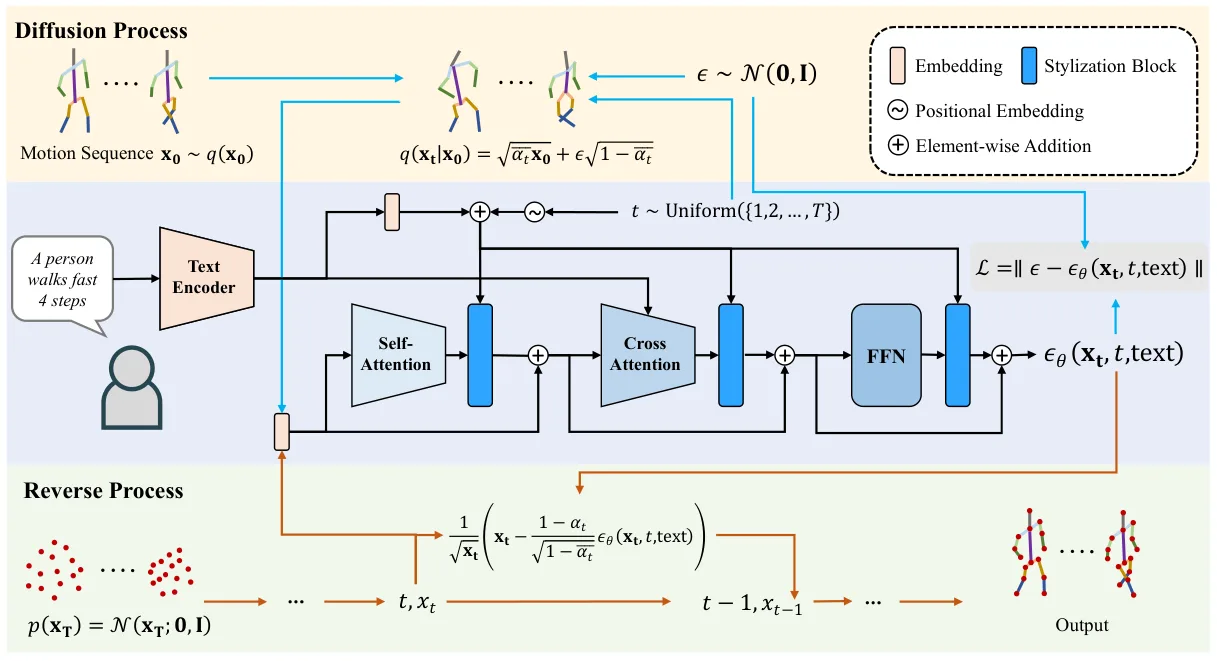
上图是 MotionDiffuse 的主管线(来源:MotionDiffuse 论文 arXiv:2208.15001)。左半部分是前向过程:动作序列 按采样得到的时间步 加噪成 ,右侧把时间步与文本一起编码后用 Element-wise Addition 叠加到每一帧上;右半部分是反向过程:网络 预测噪声,沿着 逐步去噪。中间的 “Stylization Block” 就是 MotionDiffuse 自己设计的时间步注入模块,下面单独讲。
MotionDiffuse 的前向过程与标准 DDPM 相同:给定方差调度 (论文取 , 从 线性增长到 ),
其中 是累计保留系数, 表示整段动作的展平向量(帧 × 特征维度)。反向过程中网络预测的是噪声 ,损失为
这里 是去噪网络,输入加噪动作、时间步和文本条件。注意 MotionDiffuse 预测的是噪声,而不是 MDM 后来的”干净样本”——这是两篇工作在目标函数上的一个区别,下文会讲它导致推理侧行为不同。
模型的主干:每帧动作先经过线性层投影成 token 向量(论文用 CLIP 的权重初始化前几层,并冻结这部分参数),再加上位置编码(帧在序列中的位置),然后依次通过若干层跨模态线性 transformer(论文中的 Cross-Modality Linear Transformer,每层由线性自注意力 + 线性跨注意力 + Stylization Block + FFN 组成)。所谓”线性”指的是用 efficient attention 代替标准 softmax 注意力:标准注意力的注意力矩阵是 ,序列长度上百帧时代价过高;efficient attention 先对键做 softmax 聚合得到一个 的全局摘要,再用查询去取:
其中 分别是查询、键、值矩阵, 表示矩阵乘法, 是该注意力层的输出。第一步把 个键-值对压成 的矩阵,第二步再用 个查询回取,两个步骤相乘的总复杂度约 ,相对序列长度 是线性的。这与 FlashAttention 一类”精确注意力但换计算顺序”的优化不同,它会丢弃部分注意力分布的形状信息,换来长序列上的成本可控。
每一层里的两个注意力分工是:
- 线性自注意力:让各帧之间交换信息,这是”整段动作联合建模”的核心,也是保证时间连续性的关键。没有这一层,模型会把每一帧当独立样本,生成的动作帧间会抖。
- 线性跨注意力:把当前动作帧作为 query,去文本 token 集合里取信息。文本先经 CLIP 编码器(论文用 CLIP ViT-B/32 再加 4 层 transformer encoder),得到一串 token 向量;跨注意力在每层都刷新一次文本信息,因此文本条件不是”一次性注入”,而是在整条去噪链的每一层都在起作用。
Stylization Block 是时间步注入模块,公式为
其中 是时间步嵌入, 是三个不同的线性投影, 是归一化后的特征, 是调制后的输出, 表示逐元素乘法。它把”第几步”变成一组逐通道的缩放因子 和偏置 ,让每一层都能按噪声水平调整自己的工作方式。这与后来 DiT 里的 adaLN 是同一个思路——MotionDiffuse 在 2022 年就用了这个结构。
为什么必须把时间步注入到每一层而不是只加到输入上?因为在扩散去噪里,“现在处于第几步”决定了网络应该做什么:第 900 步的主要任务是”把整体轮廓从噪声里提出来”,第 50 步的任务是”微调局部关节”。如果网络本身不知道当前的 ,它只能学到一个”平均所有步”的去噪行为,每一步都做得不彻底。把 通过调制参数注入每一层,等价于让每层都能根据噪声水平改变自己的工作点。
生成时的多级控制:MotionDiffuse 最巧的一点,是它能在同一次反向过程中对不同时间片段施加不同文本。做法是给定一组带时间区间的文本 ,对每个区间 先独立估计出该区间动作帧对应的噪声 (区间外的帧用零填充补到目标长度 ),再把各区间噪声按
融合成这一步的去噪方向。其中 是区间数量, 是补零扩展后的第 个区间噪声, 是超参数;括号里的梯度项是”修正项”,它惩罚相邻区间噪声差异的突变,使区间交界处过渡更平滑。于是”先走两步再跳一下”这种复合指令可以生成——这种控制在确定性映射模型里无法表达,因为输入只有一个整句。
它还能做身体部位独立控制。论文把全身动作按骨架分成若干近似独立的部位(例如上半身与下半身),每个部位用各自的细粒度文本独立估计噪声,再用同样的”噪声插值”方式融合:不是拼接各部位的动作预测,而是在噪声层面把各部位的估计相加,并加一个修正项惩罚相邻部位噪声的突变,让部位之间的相关性通过共享的噪声样本传递,保证上半身和下半身的动作在躯干处平滑衔接。这个设计的动机很实际:一句”一个人边跑边用左手挥手”在训练数据里几乎不存在,模型无法从数据分布里学到;把它拆成”跑步”与”左手挥手”两条文本、分别控制下半身与上半身,再靠噪声插值融合,就能生成训练分布之外的组合动作。
MDM:去掉 U-Net,换用”预测干净样本”
同年内,特拉维夫大学的 Guy Tevet 等人发布了 Human Motion Diffusion Model(MDM,arXiv:2209.14916,后发表于 ICLR 2023)。它针对的是连续扩散在原始动作空间做去噪留下的一项工程代价:网络每一帧都要处理 263 维特征,帧数一多,输入序列就长达数万维,模型容量和推理时间都紧张。
MDM 的设计是:用 transformer 直接在动作空间上做去噪,把文本和任意辅助条件统一塞进 token 序列的预测里,并把训练目标从”预测噪声”改成”预测干净动作”。论文给出的动机很具体:动作的数值范围与语义直接对应(比如根速度就是物理速度),预测干净样本后,可以在输出上直接施加几何损失(脚触地、根速度、关节点位置),不必像噪声预测那样先反推。
MDM 的扩散过程本身是标准的 DDPM:前向过程第 步
其中 是累计保留系数( 表示无噪声, 表示纯高斯噪声), 是逐元素高斯噪声。网络输入噪声样本 、时间步 、文本描述 和辅助条件 (如某个关节的目标位置、动作类别标签),输出预测的干净动作 。
时间步怎么进网络是 MDM 的关键设计之一。MDM 采用时间步嵌入:把 编码成一个与特征同维的向量,再作为额外输入提供给网络,使网络每一层都能知道”现在处于噪声水平的哪一档”。训练时扩散损失为
这里 就是整个 transformer 去噪网络,输入包括加噪动作、时间步、文本和辅助条件;损失是干净动作与预测动作的均方误差。注意 MDM 用的是”预测干净样本”的损失,而不是”预测噪声”,这与 DDPM 原始目标不同,但对动作这种数值有物理含义的数据更直接。
文本和辅助条件如何进入
MDM 把所有条件都当作 token 序列的一部分:文本经 CLIP 编码器得到若干 token 向量,辅助条件(例如要约束的某个关节)也编码成 token,连同动作帧 token 一起送进 transformer 做自注意力。于是 transformer 的注意力矩阵同时覆盖”动作帧之间”和”动作帧与条件之间”两类关系,文本约束不是通过额外的 cross-attention 层,而是与动作帧共享序列维度的自注意力实现。
这种设计的动机是:动作帧与辅助条件之间往往存在局部对应(例如”左手举起”只影响左臂的若干关节),共享自注意力让每个动作帧可以直接”看到”与它相关的条件 token,而不必经过一层固定权重的 cross-attention。代价是序列长度变长: 帧 + 若干条件 token,自注意力复杂度 ,当帧数超过几百时计算量迅速上升——这也是后来潜空间扩散方法的出发点。
训练时的一个工程细节:几何损失
MDM 值得单独讲”预测干净样本”,核心原因就在这里:一旦网络每一层都输出 ,就可以在网络输出上直接施加几何损失,不需要像噪声预测那样先反推出干净样本。MDM 用了三项常见的几何损失:
注意公式里的 是逐维度的 0/1 掩码向量,不是单个标量:它只对脚关节位置对应的那几维非零(触地时脚的位置差应为 0),其余维度为 0,因此脚部约束只作用在脚上、不影响身体其他关节。其中 是正向运动学,把关节旋转还原成 3D 关节位置(若网络直接预测关节位置,则 退化为恒等映射); 是帧数。 约束关节点位置误差, 约束”触地脚在相邻两帧之间不能滑动”,第三项 约束逐帧位移(速度)与真值一致。总损失是重建损失加这三项的加权和,权重由论文在消融里定。这些损失之所以能做,正是因为网络输出是动作本身而不是噪声——这是”预测干净样本”范式在动作领域最直接的好处。
需要指出,MDM 并没有用”额外接一个分类头预测脚触地”这种做法;它的监督就是上面的几何损失,直接作用在预测的关节位置与速度上。脚触地标签 来自数据集标注,只作为损失里的掩码使用。
第二类架构:把扩散搬到动作潜空间
MotionDiffuse 和 MDM 都在”原始动作空间”去噪:每一帧的 263 维全部参与网络计算,序列长度 越大,去噪网络的 token 数越多。MLD 的作者对此的批评更具体:原始动作序列在时间轴上相当冗余(相邻帧高度相似),直接在这上面做扩散既浪费算力;而且动捕数据里本身就带高频离群值(传感器抖动、标记点跳变),这些噪声会和扩散施加的噪声混在一起,让网络学到的分布偏离真实动作。
2022 年 12 月腾讯 PCG 与复旦大学团队提出的 MLD(Motion Latent Diffusion)(arXiv:2212.04048,后发表于 CVPR 2023)把图像生成里的”潜空间扩散”思路迁移到动作上:先用一个自编码器把整段动作压到低维潜空间,再在潜空间上做扩散,最后解码回动作。
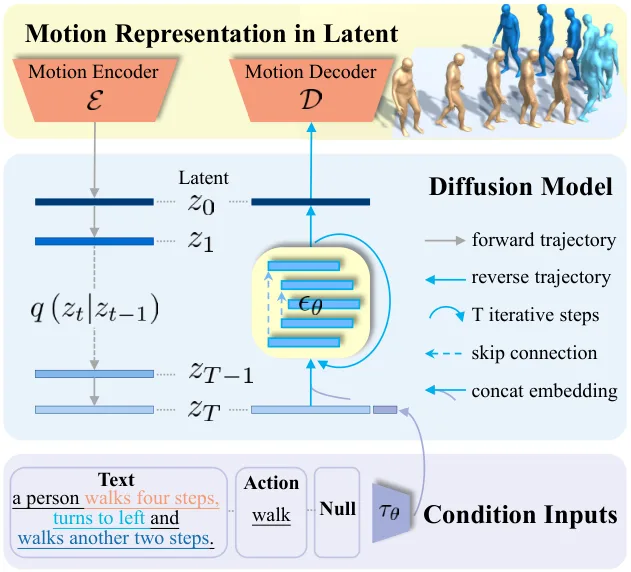
上图是 MLD 论文的流程示意(来源:MLD 论文 arXiv:2212.04048)。左侧是动作表示 “Motion Representation as H”,中间是 VAE 编码器把整段序列压成潜变量(图上标出的 “20×H”/“41” 等数值是隐空间形状示意),右侧是 Latent Diffusion Model:上排灰色箭头是前向轨迹 ,下排是反向轨迹,中间的 “T iterative steps” 表示潜空间里的多步去噪,底部 Text 与 Action 是条件输入,另有 Null Condition 对应无条件分支。最后解码器把干净的潜变量还原成动作序列。注意 MLD 的扩散模型本身是一个 transformer,而不是图像那套 U-Net——因为潜变量仍是”时间 × 通道”的形态,transformer 的自注意力天然适配时间轴。
编码器、解码器与潜空间
MLD 的动作 VAE(名为 Motion VAE)由 transformer 编码器 与解码器 组成,训练目标是动作重建均方误差加 KL 正则:
其中 是长度为 的动作, 是编码器输出的潜变量(由可学习的分布 token 输出均值 与标准差 后重参数化采样), 是先验, 控制 KL 项的强度。为什么要用 VAE 而不是普通自编码器:扩散模型需要潜空间的分布接近高斯,前向加噪才能”从数据出发”;只用 MSE 的自编码器学到的潜空间往往是散乱的、被离群值拉伸的,从高斯噪声出发去噪会撞上巨大的分布偏移。KL 项把潜空间往标准正态”拉”,代价是过大的 会损失重建细节。MLD 论文在附录消融里对比了”无 KL 正则的自编码器 + 扩散”与”VAE + 扩散”:同一潜空间配置下,前者文本生成 FID 为 5.033,后者为 0.473。这说明潜空间的分布形状对扩散起点的质量影响极大,KL 正则不是可选项。
值得说明的是,潜空间压缩不仅在算力上等价于省 token,在生成质量上也有关键作用:MDM 类直接在动作空间扩散的方法,噪声直接加在关节旋转上,反向过程要去掉噪声的同时保持旋转矩阵合法性(若用 6D 表示则要处理非正交性),而潜空间扩散的噪声加在 VAE 学到的紧凑表示上,网络更容易学到”去噪”这件事。这也是图像领域已经从像素扩散全面转向潜空间扩散的同一个道理。
条件如何进入潜空间扩散
MLD 的扩散模型在一个更短的序列上工作,而条件嵌入的注入方式与图像潜空间扩散不同:它没有用 cross-attention,而是把条件向量与潜变量直接拼接(concatenation)。文本经冻结的 CLIP ViT-L-14 编码器得到 的条件向量 ,与同样 的潜变量 拼在一起送入 transformer denoiser;动作类别条件则是一个可学习的嵌入表 。条件扩散的训练目标就是在这个拼接输入上预测噪声:
其中 是第 步的加噪潜变量, 是 transformer denoiser, 表示拼接。文本编码器冻结,只训练条件投影与去噪网络。
论文明确比较了 concatenation 与 cross-attention 两种注入方式,结论是拼接更有效。在论文的消融里,同一潜空间配置下用拼接的 MLD-1 在文本匹配与 FID 上都明显优于用 cross-attention 的版本;论文的解释是动作条件向量少,拼接让条件与潜变量在同一个 token 位置上”合二为一”,网络不必再去学注意力路由。从计算角度也能看出来:拼接不增加序列长度(条件作为一个额外 token 计入),而 cross-attention 要额外维护一套条件 key/value。这是”条件 token 数量少”时的一个实用设计选择,与图像领域的默认做法相反。
denoiser 本身是 9 层、4 头、256 维的 transformer,并带长跳跃连接(long skip connection)——把中间层特征直接接到后面层,缓解深层 transformer 对时序细节的丢失。论文消融显示,有长跳跃连接的版本在重建与生成上都更好、收敛也更快。
时间步的注入这里需要说明一句:MLD 论文的方法部分没有把 单独展开讲(详细结构在附录 F 的网络架构里),但所有动作扩散模型都必须让网络感知噪声水平,否则每层无法按 调整行为;MLD 与 MDM、MotionDiffuse 一样属于”从条件到潜变量的映射学习”,时间步与条件嵌入在输入侧合并后进入 denoiser。
重建误差:为什么动作 VAE 必须”记得住”
潜空间扩散有一个容易被忽略的前提:生成质量的上限由 VAE 重建决定。如果 VAE 自己的重建就丢了细节,扩散再准也只是”准确地生成一个残缺的动作”。MLD 论文用三个重建指标——MPJPE(关节点位置误差)、PAMPJPE(对齐后的位置误差)、ACCL(关节加速度误差)——来衡量 VAE 的还原能力,并在同一套表示空间里对比了当时的 VPoser-t 与 ACTOR。结论是 transformer VAE + 长跳跃连接的组合在这三项上都明显更好;潜空间越大()重建越好。
这个”重建上限”对推理侧有一个直接后果:部署时不能只看扩散模型,还要看 VAE 解码器的成本与保真度。VAE 解码器要以 个 token 为 query 做 cross-attention 还原 帧,它的计算量随帧数线性增长,而且是与扩散步数无关的一次性开销。在短动作上 VAE 解码可能占主要成本,在长动作上扩散去噪才成为瓶颈。MLD 论文的训练设置也体现了这种”两段式成本结构”:VAE 训练 8 小时、denoiser 训练 4 小时(8 张 V100),推理时单张 V100 即可跑。
一个容易忽略的事实:整段动作可以被压成一个向量
MLD 论文的最佳配置 MLD-1 把整段 120 帧左右的动作用一个 的潜变量表示——不是每帧一个 token,而是整段一个向量。这看起来违反直觉:一个向量怎么承载 120 帧的时序信息?答案在解码器:解码器以 个”零动作 token”作为 query,通过 cross-attention 去查询这个潜变量, 是目标帧数。换句话说,动作长度不是由潜变量长度决定的,而是解码时传入的参数;潜变量只承载”这段动作是什么”,解码器负责”把它展开成多少帧”。
这个设计对推理侧有两个直接影响:
- 扩散去噪的计算量与动作长度几乎无关。MLD-1 每一步只处理 1 个潜变量位置,50 步去噪的总计算量非常小;论文报告 MDM 在单张 V100 上平均需要 24.74 秒,而 MLD 快两个数量级。
- 长度控制变成一个”解码参数”,同一段动作语义可以生成不同时长的版本,这在游戏动画里很实用(同一个”挥手”动作,2 秒版和 4 秒版可以复用同一潜变量)。
代价是潜空间的容量上限:一个 256 维向量不可能无损表达特别复杂的长动作,所以论文也提供了 MLD-2、MLD-5、MLD-7、MLD-10 等变体(潜变量形状分别为 、…、),潜变量越大重建越好,但每步扩散计算量随之上升——MLD-7、MLD-10 的重建指标明显优于 MLD-1,而 MLD-1 在文本生成任务上的综合表现更好,这就是论文所说的”最小潜空间配跳跃连接反而最优”。这是一个典型的”潜空间容量 vs 推理成本”的权衡。
无分类器引导
MotionDiffuse、MDM 与 MLD 都采用同一种条件增强技巧——无分类器引导(classifier-free guidance,CFG):训练时以一定概率把文本条件置空(MLD 用 10% dropout),让模型同时学会”有条件”和”无条件”两种去噪;推理时把两次预测组合起来。MLD 论文给的组合形式是
其中 是引导尺度, 时放大条件预测的作用, 是无条件预测。等价写法是 ,与常见的”外推”写法完全一样。 就是直接用条件预测。
为什么 CFG 有效:无条件预测可以看作”所有符合条件的动作的平均”,条件预测是”这一句话对应的动作子集”;把两者之差乘以 再外推,等于沿着”这句话比平均多出来的那部分”多走几步,结果更贴合文本、但采样多样性下降。MLD 论文里 的最优值在 7.5 附近(配合 0.1 的条件 drop 率), 从 7.5 降到 2.5 时,文本匹配度变差、动作质量(FID)变好——这就是”忠实文本 vs 动作自然”的权衡。
MDM 的论文本身是”classifier-free”训练的,它把 CFG 作为可选的推理开关;MotionDiffuse 的论文没有大篇幅使用 CFG,而是依赖”条件文本通过多层 decoder 作用于每一步”来保持多样性——它甚至强调”条件不应以确定的方式主导生成”,这与 CFG 的动机(增强条件)方向相反。两篇工作对”扩散 + 文本”的处理没有统一配方,这是读原始论文时容易混淆的一点。
第三类架构:离散 token + 掩码建模
第三类架构把动作切成离散 token,再用语言模型式的”预测下一 token”或”补全被遮住的 token”来生成。这类方法里最有代表性的两条路径,一条是残差向量量化 + 掩码 transformer,另一种是纯自回归。前者以 MoMask 为代表,后者以 T2M-GPT 等为代表。本文重点拆 MoMask,因为它在”基础架构”这一层面把离散化、层次化和并行解码三件事同时讲清楚了。
MoMask 来自阿尔伯塔大学团队,2023 年 11 月发布在 arXiv(arXiv:2312.00063)。它的目标是解决”单层量化信息损失”和”自回归逐 token 解码慢”两个问题。
第一步:用残差量化把动作拆成多层 token
动作先经过一个 1D 卷积编码器 压缩:帧数按比例 下采样(MoMask 用下采样倍率 4,即 120 帧压成 30 个位置),每个位置得到一个 维潜向量。然后进入残差向量量化(Residual VQ):
第一层:把每个潜向量替换成码本 里离它最近的向量,得到第一层 token 与重建误差 ; 第二层:把这个残差当作新的”待量化向量”,再到码本 里找最近的向量……如此迭代 层。
用公式写出来,第 层的量化与残差为
其中 是编码器输出的潜向量, 是第 层选中的码本向量, 是第 层的 token 索引, 是进入第 层时应被量化的残差。解码时把所有层 加回去,再经过解码器 还原动作。
MoMask 的配置是 6 个量化层(即 ,其中一层基础层加五层残差层),每层码本 512 个 512 维码字,量化 dropout 比率 0.2。 关于 VQ、RVQ 与图像 tokenizer 的一般原理,可参考 图像离散分词器完全拆解:VQ-VAE、VQGAN、FSQ 与 LFQ;MoMask 的差别是把残差量化用在时间序列上,并让残差层承担”细节补全”而不是”语义压缩”。
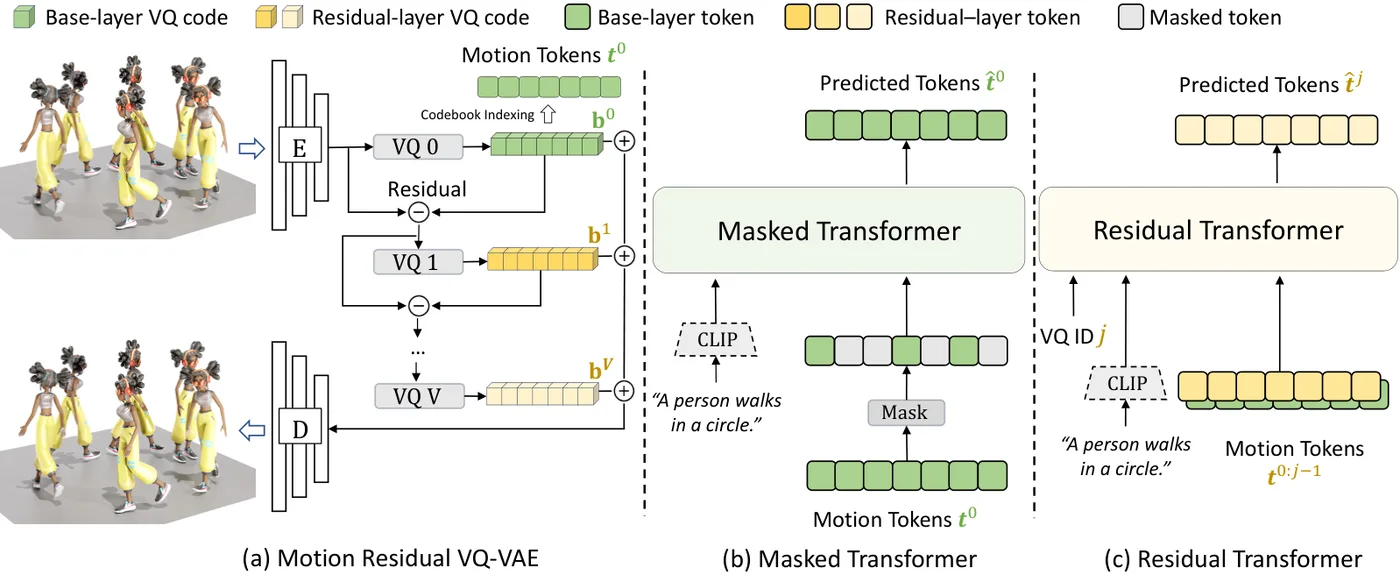
上图是 MoMask 论文的架构总览(来源:MoMask 论文 arXiv:2312.00063)。可以沿箭头读:左侧的 CLIP 文本编码给出条件;上方”VQ0 / VQ1 / … / VQ5”是六层码本;中间是掩码 transformer 负责基础层,右下是残差 transformer 负责其余各层;最终所有层 token 相加送入解码器。图里的 “[MASK]” 标记就是生成阶段每一轮的起点——整条序列一开始全部是掩码。
为什么要用残差量化而不是单层量化:单层量化的重建误差直接成为”不可恢复的损失”,而动作里的幅度、抖动等细节在高频上是稀疏的,单层码本容量一定时,高细节部分被抹平;残差层可以看作”用一层码字补另一层补不干净的部分”,效果类似图像压缩里的分层残差编码。MoMask 的消融里,增加残差层数显著提升了重建质量,同时基础层 token(用于”整体语义”)与残差层 token(用于”细节”)可以分开建模——这正是下一节两步生成的前提。
第二步:掩码 transformer 生成基础层
基础层 token 序列 由 Masked Transformer(M-Transformer)建模。训练时采用 BERT 式的随机遮盖:按遮罩比例 从序列里选出一部分位置替换成特殊 token [MASK],其中 。遮罩比例从 0 到 1 的余弦调度意味着模型同时见过”几乎全遮”和”几乎不遮”的输入,而不是像 BERT 固定 15%。被选中的位置按 80% / 10% / 10% 的概率分别被替换成 [MASK]、随机 token、原 token。训练目标是预测被遮住的 token:
这里 是加过遮罩的序列, 是 CLIP 文本条件, 是 M-Transformer 输出的逐位置分类分布。这个损失的意义很直接:给定”周围的 token + 文本”,预测”被遮的位置本来该是什么”。与自回归模型”只能看左边”不同,双向掩码建模同时看到左右两侧,这要求训练时遮罩足够密、足够随机,否则模型可以只靠相邻位置”抄答案”。
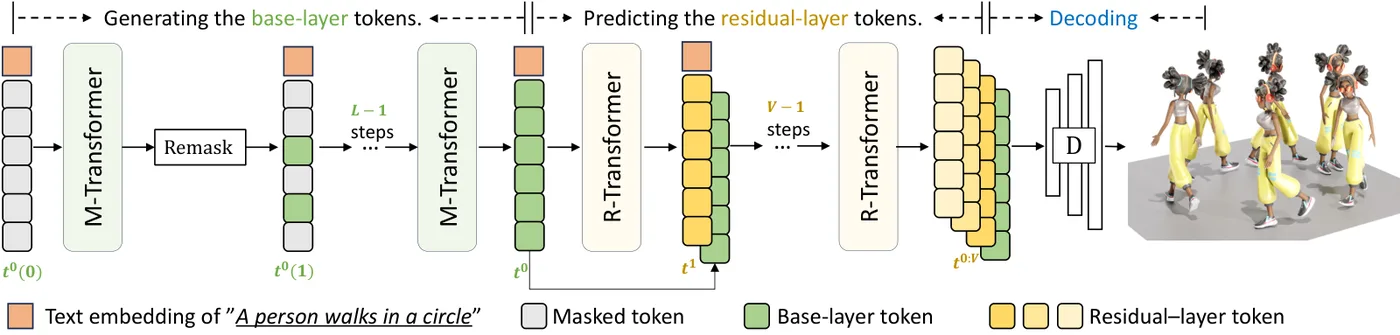
上图是 MoMask 论文的推理示意(来源:MoMask 论文 arXiv:2312.00063)。从左到右:从全 [MASK] 的序列出发,每一轮 M-Transformer 并行预测所有被遮位置的 token,然后只保留置信度最高的一批(图中高亮的部分),其余重新打回 [MASK] 进入下一轮;基础层填满后,残差 transformer 从第 1 层开始逐层补全残差层 token。
单轮解码的具体形式是:第 轮,模型对所有被遮位置输出分布并采样出 token ,同时给出该 token 的置信度;按置信度排序,保留置信度最高的 个 token 固定不变,其余位置重新置为 [MASK],进入第 轮。这里 是总轮数, 是当前轮数, 与训练时同一条余弦曲线,意味着”早期遮得多、后期遮得少”——前面先确定最可靠的部分,后面再补模糊部分,这与并行解码的”由易到难”直觉一致。
MoMask 论文里发现 左右即可收敛,再加轮数收益很小;整条链路(基础层 10 轮 + 残差层若干轮)总体上十几轮就把整段动作生成完毕,与文本长度无关——因为所有位置在同一轮里并行预测。
第三步:残差 transformer 逐层补全
基础层 token 定下来后,Residual Transformer(R-Transformer)负责第 到 层。同一轮里它预测”下一层”的全部位置,输入是前面所有层 token 的嵌入之和、文本嵌入以及层号 :
其中 是正在预测的层号, 是序列位置, 是同一位置前几层的 token 嵌入之和。注意这里与 M-Transformer 的根本区别:残差层预测时没有遮罩,输入是完整的前一层结果,每个位置独立地预测下一层;模型是同一个,只是用层号区分”现在补第几层”。这样做的工程原因是——残差层之间的依赖比基础层弱得多,基础层决定大体走向,残差层只是逐层加细节,逐层串行补全比”每层都做多轮掩码迭代”简单,而且质量足够。
这里还有一个训练技巧:R-Transformer 里”第 层预测头”与”第 层 token 嵌入层”共享参数。因为这两层的维度相同,语义上也都是”同一套码本空间”,共享参数让训练数据在不同层之间复用,减少过拟合。
条件引导:同样走 classifier-free guidance
MoMask 的两类 transformer 都采用 CFG,训练时以 10% 概率把文本条件置空,推理时把条件与无条件 logits 按
组合,其中 、 分别为条件与无条件的最终 logits, 为引导强度, 是用于采样的最终 logits。M-Transformer 与 R-Transformer 的 分别取约 4 和 5。注意这里是 logits 层面的组合,而不是像扩散那样在样本空间插值——因为离散 token 的”插值”没有意义,只能在概率分布(softmax 之前)上做线性组合再采样。
一个免费的附加能力:时序补全。 因为生成过程本来就是”从掩码补全”,MoMask 可以不做任何微调就做动作补间(temporal inpainting):把序列中某一段(开头、中间或结尾)的 token 全部遮住,文本给出”这一段应该是什么动作”,然后走同一套推理流程,模型就会在上下文约束下把缺失段补出来。论文的用户研究里,40 个相同输入下 68% 的结果被认为优于 MDM 的补全结果。这是掩码范式相对扩散范式的一个结构性优势——扩散模型做补全需要额外的”已知区域回填”步骤(如 RePaint 式的方法),而掩码模型天然把”已知”和”待生成”放在同一条序列里。
旁支:纯自回归的动作语言模型
MoMask 之外,离散路线的另一条基础分支是纯自回归:把动作 token 序列当作一句话,用因果 transformer 从左到右预测下一个 token。T2M-GPT(arXiv:2301.06052,CVPR 2023)是这条分支的代表,它的结构非常接近”GPT 换了一套词表”:
- 一个单层 VQ-VAE 把动作压成离散 token 序列(1D 卷积、时间下采样、EMA + Code Reset 防码本坍缩);
- 一个因果 transformer 以”文本嵌入 + 已生成的 token”为条件,逐位置预测下一个 token;
- 词表里额外加一个可学习的
Endtoken,模型自己决定何时停止,因而不需要外部输入动作长度——这是它相对扩散类方法的一个结构性优势。
自回归训练的经典问题是”训练时看真值、推理时看自己预测”的曝光偏差(exposure bias):一步错,后面全错。T2M-GPT 的处理很轻量——训练时以概率 把真实 token 随机替换成词表里的随机 token,其中 从 采样或设为固定值。这样模型见过”上下文有错”的情况,推理时对自身错误更鲁棒。这个技巧与掩码建模里的”80/10/10 替换”是同一类思路:让训练输入分布覆盖推理时的误差分布。
自回归的推理代价是 token 数:一段 120 帧的动作经时间下采样后仍有几十个 token,每个 token 一次前向,且不能像 MoMask 那样并行。但它换来两个能力:一是长度自适应(End token),二是天然支持流式生成(生成一个 token 就能解码播放一小段)。这两点对交互式应用很关键,所以自回归路线在工业界并没有因为”慢”而被淘汰。
三个架构的同一个问题:文本条件怎么”对齐”
三类架构虽然生成机制完全不同,但对文本条件的处理有共同结构:文本先被编码成一串向量,再以某种方式与动作侧表示产生交互。MotionDiffuse 用逐层线性跨注意力;MDM 把文本塞进共享自注意力序列;MLD 把整句文本压成一个向量后与潜变量拼接;MoMask 用 CLIP 文本嵌入作为全局条件加逐位置分类。区别在于交互粒度:MotionDiffuse 与 MDM 最细(每一帧都能查询文本 token),MLD 与 MoMask 最粗(整句一个向量,不区分时间位置)。
粗粒度交互在离散模型里是划算的:基础层 token 序列本来就承载”整体语义”,文本直接作为全局条件即可;细粒度交互的优势在长序列、细节约束多的场景更明显。这也是为什么离散模型在”整段动作语义”上表现好、在”精确到某一个关节的文本约束”上相对困难——文本条件没有在时间位置层面被细化,只能靠训练时的数据分布去学会。
动作生成怎么评测:五个指标分别在量什么
理解架构之后还要理解评测,因为”哪个架构更好”的结论全由这些指标定义。文本到动作领域基本沿用 HumanML3D 论文提出的一套指标,它们的共同前提是:先把生成动作与真实动作都过一个动作特征提取器(基于 T2M 的 motion encoder,输出 263 维特征序列的池化版本),再在特征空间里比较。注意这里的”特征”不是图像像素,所以指标名字里的 FID 不是图像生成那个 Inception FID,而是动作特征分布之间的距离。
- R-Precision(Top-1/2/3):用生成动作的特征去检索文本,看正确文本是否排在前 k 位。它衡量”动作是否忠实于文本”,值越高越好。
- FID(Fréchet Inception Distance):生成动作特征分布与真实动作特征分布之间的 Fréchet 距离。它衡量”动作看起来像不像真实动捕数据”,值越低越好。由于动作特征维度低、样本少,这个 FID 的数值范围与图像 FID 完全不同(HumanML3D 上 0.045 已经是很低的水平)。
- MM-Dist(MultiModal Distance):配对文本与动作在联合嵌入空间里的平均欧氏距离,衡量文本-动作对齐程度,越低越好。
- Diversity:从不同文本生成的若干动作之间的平均两两距离,衡量”整体输出的丰富程度”,不是越高越好也不是越低越好,通常与真实分布的 Diversity 对比。
- MultiModality:同一句文本生成多个动作之间的平均两两距离,衡量”同一句话能生成多少种不同动作”。它高说明多样性好,但也可能意味着动作偏离文本。
这五个指标之间存在结构性矛盾:R-Precision 与 MM-Dist 奖励”贴合文本”,Diversity 与 MultiModality 奖励”多样”,FID 奖励”像真实数据”。一个模型可以通过”只生成训练集里最常见的动作”同时拿到高 R-Precision 和低 FID,但 MultiModality 会很低。读论文表格时必须同时看这几列,单看 FID 会误判。
另一个容易被忽略的评测细节:HumanML3D 上的多数方法使用真实动作长度作为生成长度输入,也就是说模型不负责”决定这段文本该多长”。这会让结果偏乐观——真实部署里长度是未知的。MoMask 论文在局限里也明确提到它需要目标长度作为输入,建议先用 text-to-length 模型预测。
推理侧的实际账:三类方法一次生成各在算什么
把这三类方法放在推理成本上对比,结论会更清楚。下面三组数字摘自各论文自己的报告(均为单张 Tesla V100、不含模型加载与数据加载的时间):
- MotionDiffuse:训练时扩散步数 ,主实验默认用完整 DDPM 反向链采样,每步都要做一次跨模态线性 transformer 前向;论文没有报告端到端秒数,但反向链的步数是三类方法里最多的。开销主要在”步数多”。
- MLD:训练 1000 步、推理 50 步。MLD-1 的潜变量形状是 ,每一步 denoiser 只处理 1 个潜变量位置加一个条件向量,9 层 4 头的模型规模仅约 26.9M 参数(不含 CLIP),因此每步的计算量极小。论文自己报告”比 MDM 快两个数量级”。
- MoMask:基础层 M-Transformer 约 10 轮 + 残差层 5 轮(每轮补一层),整条链路约 15 次前向;序列长度是下采样 4 倍后的约 30 个位置,transformer 为 6 层 6 头、384 维。论文强调”无论动作多长,整段动作都在约 15 次迭代内生成完毕”。
把一次生成拆成可数的前向次数,会更直观。以 HumanML3D 的典型设置(196 帧、20 fps,约 9.8 秒)为例:
- MotionDiffuse / MDM:序列长度约 196 个帧 token,每步一次全序列自注意力;若走完整 DDPM,前向次数是 1000 量级;即使用 DDIM 压到 50 步,每步仍然是 196 个帧 token;CFG 开启时,条件与无条件各算一次,前向次数再翻倍。
- MLD:MLD-1 的潜变量只有 1 个位置,推理 50 步;每步 denoiser 的序列是 1 个潜变量 token 加 1 个条件 token,自注意力矩阵是 2×2 量级;VAE 解码器再做一次约 196 个 query 的 cross-attention。总前向次数约 51 次,但每次极小。
- MoMask:基础层 10 轮 + 残差层 5 轮,约 15 次前向;每次处理的 token 数是 49(196 帧经下采样 4 倍),而不是 196。CFG 同样使每次前向翻倍。
这个账本解释了一个反直觉现象:MLD 的”50 步”听起来比 MoMask 的”15 轮”多,但 MLD 每一步只有 2 个 token,MoMask 每一步有 49 个 token;按”前向次数 × 每次 token 数”粗算,两者可能落在同一量级。真正决定服务成本的是这个乘积,以及每次前向能否凑够 batch。
这三组数字说明的不是”谁快”,而是加速方向不同:扩散类省在”每步更轻”(MLD 把步内 token 数压到 1),离散类省在”步数更少”(MoMask 把步数压到 15)。两种加速可以叠加——扩散模型也可以蒸馏到 4 步甚至 1 步,离散模型也可以把基础层轮数从 10 继续往下压,但两者的下限受不同因素约束:扩散的步数下限受采样器精度约束,离散的轮数下限受”每轮能可靠确定多少 token”的置信度约束。
需要谨慎的是:计算量少不等于延迟低。MoMask 的 15 次前向可以流水化,但每次前向都有采样、置信度排序、重遮罩等 CPU 操作;扩散类每一步是纯 GPU 计算,可以用 CUDA Graph 批量执行。工程上真正决定延迟的是每步是否足够大、是否可批量化。这也是后来许多离散动作模型在服务化时遇到的问题:轮数少的小 forward 比轮数多的大 forward 更难并行。
三种架构的边界与工业实践
先把前面几篇论文在 HumanML3D 上的报告值放在一起,作为”边界”的注脚(评测口径见上一节):
| 方法 | 生成机制 | 关键结构 | 训练目标 | 推理步数 | FID |
|---|---|---|---|---|---|
| MotionDiffuse | 连续动作扩散 | 跨模态线性 transformer + Stylization Block | 预测噪声 | 完整 DDPM 反向链 | 0.630 |
| MDM | 连续动作扩散 | 共享自注意力 transformer + 几何损失 | 预测干净样本 | DDIM 加速后仍 24.74 s/样本 | 0.544 |
| T2M-GPT | 单层 VQ + 自回归 | 因果 transformer + End token | 下一 token 预测 | 逐 token | 0.116 |
| MLD | 潜空间扩散 | 动作 VAE + 拼接条件的 denoiser | 预测噪声 | 50 | 0.473 |
| MoMask | 残差量化 + 掩码 | M-Transformer + R-Transformer | 掩码补全 + 逐层残差 | 约 15 | 0.045 |
这张表最值得注意的不是 FID 排序,而是同一族方法的内部差距:MotionDiffuse 与 MDM 都是连续扩散,FID 相差 0.086;MLD 只是把扩散搬进潜空间,又降到 0.473;MoMask 的残差量化把 FID 压到 0.045。原因不是”离散一定优于连续”,而是残差量化给了模型 6 层码本、每层 512 个码字,总表达容量远超单层量化或单一连续表示——FID 的高低更多反映表示容量与训练数据规模,而不是生成机制本身。不同论文的 FID 计算代码版本可能不同,这些数字不应跨论文直接横向比较。
三类架构在工业界的选用不是”谁优谁劣”,而是看场景约束:
- 需要精确空间约束(比如某个关节必须到位、必须从某个姿势开始)时,扩散模型能通过”条件 token + 额外辅助损失”直接施加硬约束,MDM 的辅助条件设计就是为此;离散模型要把关节约束变成”token 序列的部分已知”,在掩码里写进去,更别扭。
- 需要极低延迟的交互式场景(游戏 NPC 实时反应、虚拟主播口型同步、机器人高频动作库)时,离散模型的小前向次数更有优势,但要注意采样和重遮罩的工程开销。
- 需要与语言模型共用基础设施(例如把动作当作另一种”语言”、让 LLM 直接输出动作 token)时,离散 token 模型是天然选择——MoMask 的 token 结构、T2M-GPT 的自回归结构,都是把动作塞进语言模型生态的桥。
另外一类在工业里很常见的工程手段是动作检索 + 拼接:不生成整段动作,而是从动作库里检索片段再过渡拼接,成本远低于生成模型,但它不属于本文讨论的”生成架构”,只能作为对照。
部署时真正要设计的四个环节
第一,帧率与长度的解耦。 动作生成模型通常在 20 fps、最长 196 帧(约 10 秒)的数据上训练,而实际游戏引擎要 30/60 fps、可能要求任意时长。部署时要么把生成结果做重采样与插值,要么把长动作拆成多个 196 帧以内的片段再拼接。拼接处最容易出问题:两段动作的根朝向、根速度、脚触地状态必须对齐,否则播放时会出现瞬间平移或脚滑。工程上常用的做法是让相邻片段共享一段重叠帧,在重叠区间做线性混合,并用脚触地标签约束混合权重。
第二,骨架与重定向。 模型输出的是特定骨架(HumanML3D 用 SMPL 的 22 关节)的旋转与根位置,而目标角色可能是不同比例、不同关节数的骨架(Unity Humanoid、UE Mannequin)。重定向不是简单的”把关节旋转抄过去”:骨骼长度不同会导致脚穿地或悬空,需要按腿长比例调整根高度、按脚触地标签做 IK 修正。这一步通常放在模型之外,属于后处理管线。
第三,批处理与调度。 动作生成的服务化比文本模型简单(没有 KV Cache),但有自己的批处理约束:不同请求的动作长度不同,而 transformer 和 VAE 解码器都要求固定形状,所以服务端一般按长度分桶(如 64/128/196 帧三档)并 padding。MLD 这类”整段压成一个潜变量”的模型对长度不敏感,分桶收益小;MoMask 这类”token 序列长度 = 帧数/4”的模型,长度分桶直接决定 batch 内利用率。
第四,流式生成与播放。 实时动画场景(虚拟主播、游戏 NPC)不能等整段动作生成完再播放,而要”边生成边播”。扩散模型的逐步去噪天然不适合流式——不到最后一步,动作都还是带噪的;离散模型的逐层补全也不适合,因为残差层要等基础层全部确定。工业上常见的折中是分块生成:每次只生成未来 1–2 秒的动作块,块与块之间用上一块的末帧作为条件(首帧约束),播放时维持一个 1–2 秒的缓冲。代价是块边界的一致性需要额外约束,且总延迟随块大小线性增长。
“文本到动作”的基础架构分歧,本质上是”用什么方式生成一段有强时间结构的序列”:直接连续去噪(MotionDiffuse / MDM)、压缩后连续去噪(MLD)、离散化后并行补全(MoMask)。这三种路径与图像、视频、语音生成里的三条路径一一对应,差别只在数据形态和约束强度上。
局限与仍未解决的问题
数据规模是硬约束。 HumanML3D 只有约 1.46 万段动作、4.5 万条文本描述,KIT-ML 更小(约 3.9 千段)。与图像生成动辄十亿级图文对相比,动作-文本数据少三个数量级。这直接导致两个现象:一是模型容易记住训练动作的”套路”,二是文本描述的多样性极低(同一段动作的三条描述往往只差几个词)。MoMask 论文自己也把”多样性有限”列为局限。
文本太粗,动作太细。 一句”一个人向左转身并挥手”包含多个同时发生的子动作、方向、速度、风格,而文本只有十几个词;反过来,一段 120 帧的动作有数万个数值。这个信息不对称意味着:模型必须自己”编造”大量未被文本指定的细节(手臂摆幅、步频、躯干前倾),而这些细节恰恰是动画质量的关键。当前的做法是靠数据分布先验,没有显式的”风格控制”接口;工业上要控制风格,通常要额外训一个条件分支或做微调。
物理合理性没有被真正建模。 MDM 的脚触地损失是一种”软约束”,它惩罚脚滑,但不保证动力学可行(关节力矩、平衡、地面反作用力)。生成的动作可能看起来自然,放到物理仿真里却站不住。这也是为什么机器人领域更倾向用强化学习或物理约束生成,而不是直接拿文生动作模型的动作去执行。
评测指标本身有争议。 前面讲过,五个指标互相拉扯;更根本的问题是它们都依赖一个动作特征提取器,而这个提取器的训练数据与评测数据同源,指标可能奖励”特征空间里像”而非”视觉上合理”。此外,使用真实动作长度作为输入让评测偏乐观,实际部署时长度未知。
长动作与交互仍是开放问题。 现有方法基本在 10 秒以内;更长的动作需要分块或自回归拼接,容易出现语义漂移(越走越偏)和风格断裂。人与物体、人与人交互的动作生成(坐下、开门、握手)需要场景与对象的显式建模,当前多数模型只处理”单人、无场景”的设定。
小结
本文沿着”条件如何进入、序列如何生成”两条线索拆了三类基础架构:
- MotionDiffuse 用 efficient attention 的跨模态 transformer 直接在动作空间做扩散,逐层线性跨注意力注入文本、Stylization Block 注入时间步,并用”同一次反向过程对不同帧段施加不同文本”实现多级控制;它是第一条可用的文本条件动作扩散管线。
- MDM 同样直接在动作空间去噪,但把目标从”预测噪声”换成”预测干净样本”,从而能在输出上直接施加正向运动学、脚触地、根速度等几何损失;共享自注意力让文本与辅助条件都作为 token 参与,是”可控扩散”的基础设计。
- MLD 用动作 VAE 建立低维潜空间(最佳配置把整段动作压成 ),在潜空间里用拼接而非 cross-attention 注入文本,推理 50 步,比 MDM 快两个数量级;它证明了潜空间压缩对动作同样必要。
- MoMask 用残差量化把动作拆成多层离散 token,用双向掩码 transformer 并行解码基础层、用残差 transformer 串行补全残差层,约 15 次前向生成整段动作;它把”离散化 + 并行解码”这条路线讲成了可用的基础范式。
三类架构共同的三条结论:
- 文本条件是”全局语义”,它的交互粒度要和生成机制匹配——连续模型可以细到每个文本 token,潜空间与离散模型更适合把整句压成一个全局条件。
- 一次生成的成本不只是前向次数,还包括采样、排序、重遮罩等周边操作;离散模型轮数少不等于端到端延迟低,扩散模型步数多也不等于每步都重。
- 动作的强时间结构决定了架构里不能省略”整段序列联合建模”这一环,无论它是自注意力、跨注意力还是掩码预测。
参考资料
- MotionDiffuse: Text-Driven Human Motion Generation with Diffusion Model
- MotionDiffuse 项目主页
- Human Motion Diffusion Model (MDM)
- MDM 官方代码
- Executing your Commands via Motion Diffusion in Latent Space (MLD)
- MLD 官方代码
- MoMask: Generative Masked Modeling of 3D Human Motions
- T2M-GPT: Generating Human Motion from Textual Descriptions with Discrete Representations
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



